


Dove sono le cose: geometria, corrispondenze e profondità#
Nei primi decenni del Quattrocento, sulla piazza del Duomo di Firenze, Filippo Brunelleschi fece una cosa che nessuno aveva mai fatto. Aveva dipinto su una tavoletta di mezzo braccio di lato (una trentina di centimetri) il Battistero di San Giovanni, intarsi di marmo compresi, e nella tavoletta aveva praticato un foro passante. Lo racconta, decenni dopo, il suo biografo Antonio Manetti, che quella tavoletta l’aveva avuta in mano.
L’esperimento andava fatto così. Ti metti dentro il portale del Duomo, nello stesso punto esatto da cui Brunelleschi aveva dipinto, con il Battistero davanti. Impugni la tavoletta a un palmo dall’occhio, ma girata: il dipinto guarda dalla parte opposta alla tua, quindi tu vedi solo il retro. Accosti l’occhio al foro e guardi attraverso: dall’altra parte c’è il Battistero vero. Con l’altra mano alzi uno specchietto a un braccio di distanza, davanti alla tavoletta, e adesso attraverso il foro non vedi più il Battistero vero, ma il riflesso del dipinto che gli sta di fronte. Togli lo specchio, torna il Battistero vero; lo rimetti, torna il dipinto. Erano identici. La parte alta della tavoletta, dove ci sarebbe stato il cielo, era coperta d’argento brunito, così che nel riflesso si vedessero le nuvole vere che passavano.
Quella tavoletta, perduta e nota soltanto da quel racconto, è la più antica dimostrazione sperimentale della prospettiva lineare di cui si abbia notizia: un punto di vista, un foro, e il mondo tridimensionale si schiaccia su una superficie piatta in un modo prevedibile e calcolabile. Nel 1435 Leon Battista Alberti ne scrisse le regole nel De pictura, e la prospettiva lineare diventò una tecnica insegnabile.
La geometria del foro di Brunelleschi è quella del modello di fotocamera che usiamo ancora oggi. L’obiettivo di vetro del telefono non cambia le carte in tavola: serve a far entrare più luce di quanta ne passi da un buco di spillo, e i raggi che passano per il suo centro non vengono deviati, così che quel centro fa la parte del foro.
E il foro porta con sé un problema di fondo. Un punto del mondo, per dire dov’è, ha bisogno di tre numeri: quanto a destra, quanto in alto, quanto lontano. Un punto sulla foto ne ha due, la riga e la colonna del suo pixel. Proiettare significa quindi buttare via un numero per ogni punto, e quel numero è proprio la distanza. Finora si trattava di stabilire che cosa c’è in un’immagine, e dove sta nel piano della foto; qui si tratta di stabilire dove si trova nello spazio, e la domanda è più difficile di quanto sembri, perché quel numero nell’immagine non c’è più: cercarlo meglio non serve a niente.
La proiezione perde una dimensione#
Cominciamo da come un punto del mondo diventa un pixel.
Una scatola chiusa ha un foro piccolissimo su una faccia e un foglio sulla faccia opposta. La luce che parte da un punto della scena può entrare solo passando per il foro, e da lì colpisce il foglio in un solo posto. Ogni punto del mondo, quindi, ha il suo pixel: è per questo che la foto assomiglia alla scena.
Il guaio è che il legame funziona in un senso solo. Un punto del mondo dà un pixel, ma un pixel non dà un punto del mondo: tutti i punti allineati con il foro, il vicino e quello dieci metri più in là, colpiscono lo stesso identico posto sul foglio. È il motivo per cui nelle foto ricordo si può «reggere» la Torre di Pisa con una mano: la mano è vicina, la torre è lontana, ma dal punto di vista dell’obiettivo sono allineate, e la foto non conosce la differenza.
Un oggetto piccolo e vicino e uno grande e lontano fanno lo stesso pixel. La distanza non è nascosta nell’immagine, è andata perduta nel momento dello scatto. Per riaverla bisogna rimetterla da fuori, e ci sono tre modi: guardare la scena da un secondo punto, muoversi e guardare come le cose scorrono, o mettere in campo quello che già si sa di com’è fatto il mondo.
Nel modello stenopeico (in inglese pinhole), un punto \(\mathbf{p} = (X, Y, Z)\) espresso nel sistema di riferimento della fotocamera si proietta sul piano immagine in
dove \(f\) è la lunghezza focale espressa in pixel e \((c_x, c_y)\) è il punto principale, cioè dove l’asse ottico buca il sensore. In coordinate omogenee la stessa cosa è lineare, ed è questo il motivo per cui si usano:
dove \(\mathbf{K}\) raccoglie i parametri intrinseci (com’è fatta la fotocamera) e \([\mathbf{R} \mid \mathbf{t}]\) gli estrinseci (dov’è e come è orientata). Il simbolo \(\sim\) ricorda che l’uguaglianza vale a meno di un fattore di scala: per tornare ai pixel si divide per la terza componente.
È quella divisione a distruggere l’informazione. La mappa \((X,Y,Z) \mapsto (u,v)\) non è invertibile: l’insieme dei punti che finiscono nello stesso pixel è l’intera semiretta uscente dal centro ottico, e \(\mathbf{p}\) e \(\lambda \mathbf{p}\) con \(\lambda > 0\) sono indistinguibili. Un’immagine determina una direzione per ogni pixel, mai una posizione.
Le fotocamere vere aggiungono due complicazioni che in pratica si misurano e si tolgono. La prima è la distorsione dell’obiettivo, che curva le rette soprattutto verso i bordi e si modella con pochi coefficienti radiali e tangenziali. La seconda riguarda i valori dei pixel: quello che il file contiene non è proporzionale alla luce entrata, perché in mezzo c’è una codifica gamma (grossolanamente \(I_{\text{file}} \approx I_{\text{luce}} ^{1/2{,}2}\) per sRGB). Ha una conseguenza pratica che va ben oltre la geometria: mediare, sfocare o comporre immagini sui valori codificati è sbagliato in senso fisico, e va fatto dopo averli riportati in scala lineare [Sze22].
Prima di fare qualunque conto, la fotocamera va misurata. Tre cose servono. Quanto ingrandisce, cioè quanti pixel occupa nella foto un oggetto largo un metro che sta a un metro di distanza: si chiama focale, dipende dall’obiettivo, e la distanza va detta perché lo stesso oggetto, più lontano, occupa meno pixel. Dove cade il punto in cui l’asse dell’obiettivo buca il sensore, che uno immaginerebbe al centro esatto della foto e nella pratica quasi mai lo è, perché sensore e lente vengono incollati da una macchina con la sua tolleranza. E di quanto quell’obiettivo incurva le linee rette, cosa che si vede soprattutto ai bordi. Quei numeri, presi insieme, descrivono com’è fatta la fotocamera e si chiamano i suoi parametri intrinseci; ricavarli si chiama calibrazione, e si fa mostrando alla fotocamera un oggetto di cui si conoscono le misure, tipicamente una scacchiera stampata, e guardando come viene deformata. E conta: senza quelle misure i numeri dei pixel non si traducono in direzioni, e nessuna delle ricostruzioni che seguono può dare una risposta metrica. Per i metri, poi, serve in più una lunghezza nota, come la distanza fra i due obiettivi di una telecamera stereo.
Trovare la stessa cosa in due foto#
Se una foto sola non basta, se ne prendono due. Ma perché due foto aiutino bisogna prima risolvere un problema che sembra banale e non lo è: capire quale punto della prima corrisponde a quale punto della seconda.
Metti due fotografie della stessa piazza, scattate da due posizioni diverse, e prova a indicare in entrambe lo stesso spigolo della stessa finestra. Tu lo fai in un secondo. Un programma no: per lui le due immagini sono due griglie di numeri, e i numeri sono cambiati tutti, perché è cambiato il punto di vista, la luce, forse l’ora del giorno.
La soluzione trovata negli anni Ottanta e Novanta mette insieme tre mestieri. Il primo è scegliere i punti facili da ritrovare, e non tutti lo sono allo stesso modo. Un pezzetto di cielo azzurro non serve a niente, perché tutte le sue parti si somigliano, e nella seconda foto un pezzetto di cielo vale l’altro. Il bordo di un tetto va meglio, ma solo a metà: se il pezzetto che stai guardando scivola in su o in giù te ne accorgi subito, perché il bordo esce dall’inquadratura; se scivola lungo il tetto non te ne accorgi affatto, perché in quella direzione il bordo è uguale a sé stesso. Uno spigolo, dove due bordi si incontrano, è quello buono: da qualunque parte lo si sposti, qualcosa cambia.
Il secondo mestiere è descrivere ogni punto scelto con una piccola scheda segnaletica, costruita in modo da non cambiare se l’immagine viene ingrandita, ruotata o schiarita. Poi si confrontano le schede.
Il terzo è buttare via gli accoppiamenti sbagliati, che ci saranno di sicuro; basta un errore grosso per rovinare un calcolo fatto sulla media. Il rimedio si chiama consenso. Quello che si cerca è la posizione reciproca delle due fotocamere, cioè la regola che dice dove deve cadere, nella seconda foto, il gemello di ogni punto della prima. Invece di usare tutti gli accoppiamenti, se ne prendono a caso quanti bastano a fissare quella regola, si calcola la regola che danno, e si contano quanti altri accoppiamenti la rispettano, entro uno scarto deciso prima. Si ripete centinaia di volte e si tiene la regola con più sostenitori. Chi sbaglia non ha compagni, e resta fuori da solo.
Quel «quanti bastano» va preso alla lettera, perché un punto in più da estrarre si paga caro. La regola ha sette numeri liberi, e ogni accoppiamento ne fissa uno: ne servono sette. Se metà degli accoppiamenti è sbagliata, un gruppetto di sette punti presi a caso è tutto buono una volta su centoventotto; uno di otto, una volta su duecentocinquantasei. Stessa fiducia nel risultato, il doppio dei tentativi.
I tre pezzi hanno nomi precisi ed età ben definita.
Il rilevatore: quello di angoli proposto da Harris e Stephens (1988) valuta la matrice di autocorrelazione dei gradienti in un intorno,
dove \(I_x\) e \(I_y\) sono le derivate parziali dell’immagine e la somma corre sui pixel di una finestra \(w\) attorno al punto (di solito pesata da una gaussiana), e cerca i punti dove entrambi gli autovalori sono grandi (variazione in ogni direzione, cioè un angolo), distinguendoli da quelli dove uno solo lo è (un bordo, ambiguo lungo la sua direzione) [HS88]. Senza però calcolarli, ed è il contributo del paper: la risposta \(R = \det(\mathbf{M}) - k\,\mathrm{tr}(\mathbf{M})^2\) (con \(k \approx 0{,}04\)) dice la stessa cosa a costo di quattro moltiplicazioni e di nessuna radice quadrata, perché \(\det(\mathbf{M}) = \lambda_1\lambda_2\) e \(\mathrm{tr}(\mathbf{M}) = \lambda_1 + \lambda_2\). Guardare direttamente \(\min(\lambda_1, \lambda_2)\) è invece la variante di Shi e Tomasi (1994), che è un rilevatore diverso.
Il descrittore: SIFT di David Lowe cerca gli estremi di una differenza di gaussiane su più scale, il che dà la posizione e la scala, assegna un’orientazione dominante e costruisce un vettore di 128 numeri fatto di istogrammi di gradienti orientati, normalizzato. Invarianza a scala e rotazione per costruzione, robustezza all’illuminazione per normalizzazione [Low04].
La stima robusta: RANSAC di Fischler e Bolles (1981) campiona il minimo numero di corrispondenze necessarie a determinare il modello (quattro per un’omografia[1]; sette per la matrice fondamentale, che di gradi di libertà ne ha sette, o cinque per l’essenziale se le fotocamere sono calibrate), conta gli inlier entro una soglia, e itera. Con una frazione \(w\) di corrispondenze buone e un modello che ne richiede \(s\), la probabilità di aver estratto almeno un campione interamente pulito in \(N\) tentativi è \(1 - (1 - w^s)^N\): si sceglie \(N\) per portarla dove serve [FB81]. Ed è qui che il minimo conta davvero, perché \(s\) sta all’esponente: con \(w = 0{,}5\) e obiettivo \(0{,}99\) servono circa \(1177\) tentativi con \(s = 8\), \(588\) con \(s = 7\) e \(146\) con \(s = 5\). Usare l’algoritmo a otto punti dentro RANSAC, come si legge spesso, costa il doppio dei campioni necessari.
Questo passaggio dice qualcosa che va oltre la geometria. Trovare punti facili da ritrovare, descriverli con una scheda che non cambia se l’immagine cambia, buttare via gli accoppiamenti sbagliati: sono tre pezzi di ingegneria umana raffinatissima, frutto di vent’anni di lavoro. All’inizio del capitolo si diceva che si è smesso di scrivere a mano le regole per riconoscere e si è cominciato a farle imparare; qui la storia è andata solo a metà. Esistono rilevatori e descrittori appresi, addestrati apposta a ritrovare gli stessi punti fra fotografie diverse, ma le schede disegnate a mano restano il punto di partenza di strumenti di ricostruzione molto usati [SchonbergerF16], e gli accoppiamenti sbagliati si buttano via ancora con il consenso.
Il confronto va guardato anche dall’altro lato, ed è la parte che sorprende. La geometria è rimasta dov’era. Le formule che legano due fotografie della stessa scena furono dimostrate fra il 1981 e i primi anni Novanta, e si usano oggi identiche, perché sono teoremi e non ricette che funzionano più o meno bene. Le reti hanno sostituito una parte di quella fragile, e niente di quella dimostrata.
Il vincolo epipolare: da un piano a una retta#
Trovare le corrispondenze costerebbe carissimo: ogni pixel della prima immagine andrebbe confrontato con tutti i pixel della seconda, e siccome i pixel sono un milione per parte i confronti sarebbero mille miliardi (per questo si dice che il costo è quadratico: raddoppiando i pixel, il lavoro quadruplica). Non è così, grazie a una proprietà geometrica che invece di farci cercare in tutta la superficie della seconda immagine ci fa cercare lungo una linea sola, e questo si chiama, in linguaggio tecnico, «ridurre la ricerca di una dimensione»: da un piano a una retta.

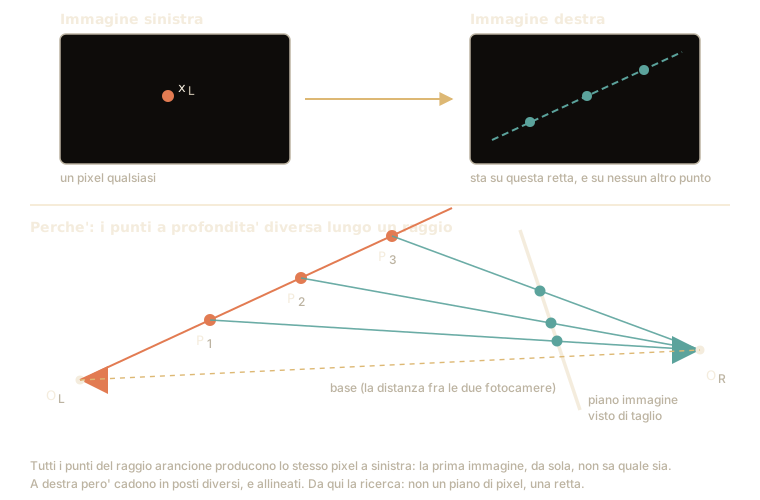
Fig. 11.12 Un punto nella prima immagine non corrisponde a un punto nella seconda, ma a una retta. Tutti i punti del raggio che esce dal foro della prima fotocamera (il suo centro ottico) danno lo stesso pixel a sinistra; a destra cadono in posti diversi, e allineati.#
In Fig. 11.12 hai scelto un pixel nella foto di sinistra. Sappiamo che il punto del mondo che l’ha prodotto sta da qualche parte lungo un raggio: potrebbe essere a due metri o a venti, la foto non lo dice. Adesso però immagina di guardare quel raggio dalla seconda fotocamera.
Un raggio è una retta nello spazio, e nella foto di una scatola a foro una retta resta una retta. Lo si vede nei binari: la prospettiva li fa convergere, ma ciascuna rotaia, nella foto, è ancora dritta. Il motivo è che tutti i punti della retta e il foro della seconda fotocamera stanno su uno stesso piano, come un foglio di carta teso che passa per il foro, e quel foglio incontra il foglio di fondo della scatola lungo una linea dritta. La prospettiva schiaccia le distanze; le rette le lascia dritte. Le linee che si incurvano ai bordi di certe foto le piega l’obiettivo vero, con i suoi difetti, ed è la distorsione che la misura della fotocamera serve a togliere.
Quindi: il punto che cerchi nella seconda foto, qualunque sia la profondità vera, sta su una retta ben precisa, che si può calcolare in anticipo conoscendo solo la posizione reciproca delle due fotocamere. Quella retta si chiama retta epipolare, e l’epipolo da cui prende il nome è il punto in cui ciascuna fotocamera vedrebbe l’altra. Non devi cercare in tutta l’immagine, devi cercare lungo una riga.
È il passaggio che rende praticabile tutto il resto. Milioni di candidati diventano qualche centinaio, e a lavorare è una legge geometrica che vale sempre, per qualsiasi scena, non un modello di come sono fatte le cose.
E la legge si può usare anche al contrario. Se le fotocamere sono misurate, da abbastanza coppie di punti corrispondenti si ricava la loro posizione reciproca: di quanto è girata la seconda rispetto alla prima, e in che direzione si è spostata. Di quanto si sia spostata, invece, le foto da sole non lo dicono: la scala resta da fissare con qualcosa che venga da fuori.
Il piano che contiene i due centri ottici e il punto \(\mathbf{p}\) si chiama piano epipolare; la sua intersezione con ciascun piano immagine è la retta epipolare corrispondente. Tutte le rette epipolari di un’immagine passano per uno stesso punto, l’epipolo, che è la proiezione dell’altro centro ottico e può cadere fuori dall’immagine. Va all’infinito quando è la base, cioè il segmento che unisce i due centri ottici, a essere parallela al piano immagine: è il caso della coppia stereo affiancata, ed è il motivo per cui rettificare una coppia consiste proprio nel mandare gli epipoli all’infinito. Non c’entra il parallelismo fra gli assi ottici: due fotocamere con assi perfettamente paralleli che si muovono in avanti hanno l’epipolo dentro l’immagine, nel punto da cui la scena sembra espandersi (è il caso di ogni telecamera montata su un’auto). La condizione va poi verificata su un’immagine alla volta, perché i piani immagine sono due: ruotando verso l’interno una sola delle due fotocamere, con la base laterale di prima, il suo piano smette di essere parallelo alla base e il suo epipolo torna a distanza finita, mentre l’altro resta all’infinito.
In coordinate normalizzate, con fotocamere calibrate, il vincolo si scrive con la matrice essenziale \(\mathbf{E} = [\mathbf{t}]_\times \mathbf{R}\), introdotta da Longuet-Higgins su Nature nel 1981 insieme all’algoritmo a otto punti che la stima [LH81]:
Qui \(\tilde{\mathbf{x}}_L\) e \(\tilde{\mathbf{x}}_R\) sono i punti corrispondenti nelle due immagini, in coordinate omogenee normalizzate (i pixel moltiplicati per \(\mathbf{K}^{-1}\)), e \((\mathbf{R}, \mathbf{t})\) porta le coordinate della prima fotocamera in quelle della seconda, \(\mathbf{p}_R = \mathbf{R}\,\mathbf{p}_L + \mathbf{t}\): è la convenzione della proiezione scritta sopra quando la prima fotocamera sta nell’origine del mondo.
In pixel, con fotocamere non calibrate, lo stesso vincolo passa per la matrice fondamentale \(\mathbf{F} = \mathbf{K}_R^{-\top}\, [\mathbf{t}]_\times \mathbf{R}\, \mathbf{K}_L^{-1}\), e
dove \([\mathbf{t}]_\times\) è la matrice antisimmetrica associata al prodotto vettoriale per \(\mathbf{t}\). Il prodotto \(\mathbf{F}\tilde{\mathbf{x}}_L\) è la retta epipolare nella seconda immagine, scritta come terna di coefficienti \((a,b,c)\) dell’equazione \(au + bv + c = 0\): il vincolo dice semplicemente che \(\tilde{\mathbf{x}}_R\) le appartiene. \(\mathbf{F}\) ha rango 2 e sette gradi di libertà, ed è definita a meno di scala [HZ04]. Da otto o più corrispondenze la si stima con un sistema lineare: ogni coppia dà un’equazione lineare nei nove elementi di \(\mathbf{F}\), e impilandole si ottiene \(\mathbf{A}\mathbf{f} = \mathbf{0}\). La soluzione ai minimi quadrati con \(\lVert\mathbf{f}\rVert = 1\) è il vettore singolare destro di \(\mathbf{A}\) associato al valore singolare più piccolo (è la SVD della sezione su ortogonalità e proiezioni). La matrice che ne esce in genere ha rango 3, e il rango 2 si impone dopo, azzerandone il valore singolare più piccolo. È l’algoritmo a otto punti, che dà stime buone solo con le coordinate prima normalizzate, cioè centrate e riscalate [HZ04].
Dalla \(\mathbf{E}\), a fotocamere calibrate, si ricavano le pose. Una matrice essenziale ha due valori singolari uguali e il terzo nullo, \(\mathbf{E} = \mathbf{U}\,\mathrm{diag}(\sigma, \sigma, 0)\,\mathbf{V}^\top\), con \(\sigma = \lVert\mathbf{t}\rVert\), e ne seguono quattro coppie candidate: \(\mathbf{R} = \mathbf{U}\mathbf{W}\mathbf{V}^\top\) oppure \(\mathbf{U}\mathbf{W}^\top\mathbf{V}^\top\), dove \(\mathbf{W}\) è la rotazione di \(90^\circ\) attorno all’asse \(z\) (con il segno scelto perché \(\det\mathbf{R} = +1\)), e \(\mathbf{t} = \pm\mathbf{u}_3\), la terza colonna di \(\mathbf{U}\). Una sola mette i punti triangolati davanti a entrambe le fotocamere (il vincolo detto di cheirality), ed è quella giusta. La traslazione resta nota solo a meno di scala, perché il vincolo è omogeneo in \(\mathbf{E}\): è l’ambiguità di scala della structure from motion. La stima degenera in due casi: se la scena è piana, perché le corrispondenze sono legate da un’omografia e non bastano a fissare \(\mathbf{E}\); e se la fotocamera ruota senza traslare, perché allora \(\mathbf{t} = \mathbf{0}\) ed \(\mathbf{E}\) è nulla [HZ04].
In pratica si rettificano le due immagini, cioè si applica a ciascuna un’omografia che porta gli epipoli all’infinito. Dopo la rettificazione le rette epipolari sono orizzontali e allineate fra le due immagini, e la ricerca della corrispondenza diventa uno scorrimento lungo la stessa riga di pixel: è la ragione per cui le telecamere stereo si montano affiancate e allineate.
Dalla disparità alla profondità#
Il caso più comodo è quello in cui tutte le rette epipolari sono orizzontali e la riga numero cento della prima immagine corrisponde alla riga numero cento della seconda: allora cercare il gemello vuol dire scorrere una riga di pixel, e basta. Quel caso lo si ottiene in due modi, montando le due fotocamere affiancate e ben allineate, oppure raddrizzando le immagini dopo, con un calcolo che le deforma quel tanto che basta a metterle in quella posizione. In tutti e due i casi si dice che le immagini sono rettificate, e da lì la geometria si riduce a una formula sola, \(Z = fB/d\), che lega la profondità \(Z\) alla focale \(f\), alla distanza \(B\) fra le due fotocamere e allo spostamento \(d\) di un punto fra un’immagine e l’altra. È anche il principio della visione con due occhi, e in generale della visione stereo, quella a due fotocamere.
Tieni un dito davanti al naso e chiudi alternativamente un occhio: il dito salta. Ora allontanalo il più possibile: salta molto meno. Quel salto si chiama disparità, e la sua misura è la misura della distanza. Vicino, salto grande; lontano, salto piccolo; infinitamente lontano, nessun salto.
La relazione è un’inversa, non una proporzione: raddoppiando la distanza il salto si dimezza. Su una telecamera con trenta centimetri fra i due obiettivi e una focale di \(700\) pixel (un oggetto largo un metro, a un metro, ne occupa \(700\)), un oggetto a un metro salta \(700 \times 0{,}30 = 210\) pixel, a due metri \(105\), a quattro metri \(52{,}5\), a otto metri poco più di \(26\). Il primo di questi numeri dipende dalla focale e dalla distanza fra gli obiettivi; il dimezzarsi a ogni raddoppio, invece, vale sempre.
Ha due conseguenze che si toccano con mano. La prima è che la visione stereo è precisa da vicino e vaga da lontano: con quella telecamera, mezzo pixel di salto misurato male vale un centimetro a due metri e sei metri a cinquanta. La seconda riguarda le leve su cui si può agire, e sono due: allontanare le telecamere fra loro ingrandisce i salti e quindi la precisione, ma restringe la zona che entrambe vedono; e lo stesso fa lo zoom, che ingrandisce i salti e insieme rimpicciolisce la porzione di mondo inquadrata. È il compromesso che decide come si costruisce una telecamera stereo, e vale anche per i nostri occhi, a sei centimetri l’uno dall’altro.
E c’è un caso in cui il metodo fallisce del tutto: un muro bianco. Se lungo la riga da esplorare tutti i pixel si somigliano, non c’è modo di dire quale corrisponda a quale. La geometria ha fatto il suo dovere riducendo la ricerca a una retta; su quella retta, però, ci vuole qualcosa da riconoscere.
Chi vuole la distanza di ogni singolo pixel se la cava aggiungendo qualcosa che la geometria non contiene: la scommessa che le superfici siano per lo più lisce, cioè che due pixel vicini stiano quasi sempre più o meno alla stessa distanza. Il muro bianco viene riempito così, tirando dentro le distanze misurate sui suoi bordi, dove qualcosa da riconoscere c’era. È una scommessa che di solito paga, e che a volte fa danni: davanti a una vetrata, o al bordo di un tavolo che si affaccia sul vuoto, smussa in una rampa dolce un salto che nella realtà è netto.
Con due fotocamere identiche, assi ottici paralleli e base \(B\) (la distanza fra i centri ottici), un punto a profondità \(Z\) si proietta a
da cui la disparità \(d = u_L - u_R = fB/Z\) e quindi
Le due conseguenze si leggono derivando: \(\partial Z / \partial d = -fB/d^2 = -Z^2/(fB)\). Per un errore di disparità \(\delta d\) l’errore in profondità è \(\delta Z \approx Z^2\,\delta d/(fB)\): cresce con il quadrato della profondità, e si riduce allargando la base o allungando la focale. Con \(f = 700\) pixel e \(B = 0{,}30\) m, cioè \(fB = 210\), un errore di mezzo pixel vale \(4 \cdot 0{,}5/210 \approx 0{,}01\) m a \(2\) m e \(2500 \cdot 0{,}5/210 \approx 6\) m a \(50\) m. È il motivo per cui la disparità (che è proporzionale a \(1/Z\)) è spesso una parametrizzazione numericamente migliore della profondità stessa: campionarla uniformemente significa campionare finemente il vicino e grossolanamente il lontano, che è esattamente dove serve precisione.
Il calcolo denso della disparità è un problema di ottimizzazione, e la sua tassonomia classica [SS02] distingue quattro pezzi: una misura di somiglianza fra finestre (differenze assolute, correlazione normalizzata, census transform), un’aggregazione spaziale, un’ottimizzazione globale con un termine di regolarità che favorisce disparità localmente costanti, e un raffinamento sub-pixel. Nel raffinamento entra di solito anche il controllo incrociato (left-right check): la disparità si calcola due volte, prendendo come riferimento prima l’immagine sinistra e poi la destra, e si scartano i pixel su cui le due stime non si corrispondono. Restano fuori soprattutto le occlusioni, dove un punto visto da una sola fotocamera non ha un gemello a cui tornare. Il termine di regolarità è ciò che tappa i buchi nelle zone senza tessitura, ed è un prior sulla forma delle superfici più che geometria. Le reti moderne lo sostituiscono con un prior appreso da grandi collezioni di scene.
Quando di mezzo c’è il tempo: il flusso ottico#
La visione stereo confronta due immagini prese nello stesso istante da posizioni diverse. Il flusso ottico confronta due immagini prese in istanti diversi e stima per ogni pixel di quanto si è spostato. Misura il moto relativo, e non si chiede se a muoversi sia la scena o la fotocamera: se tutta la scena rigida scorre verso sinistra, o se la telecamera si sposta verso destra, la ripresa è la stessa.
È lo stesso problema di corrispondenza di prima, ma il vincolo epipolare qui in generale non c’è. La riga su cui cercare si poteva calcolare perché sapevamo dove stavano le due fotocamere, mentre adesso non sappiamo di quanto si è mossa la nostra, e per giunta la scena può cambiare forma da sola: una bandiera, un viso, dell’acqua. Quando invece la scena è rigida, cioè si muove tutta d’un pezzo, e il movimento della fotocamera è noto, la retta epipolare torna eccome, ed è così che si ricava la profondità da un video preso camminando.
Guarda un palo attraverso il finestrino di un treno che parte: scorre in fretta. Guarda una montagna all’orizzonte: sta quasi ferma. Anche il movimento, come il salto fra i due occhi, dice qualcosa sulla distanza, e infatti si chiama parallasse. È così che stimiamo la profondità di una scena muovendo la testa, con un occhio solo.
Per misurare quello scorrimento bisogna ritrovare, nel fotogramma dopo, il pezzo di scena che nel primo aveva un certo colore. Sotto c’è una promessa: che lo stesso pezzo di scena si presenti con lo stesso colore da un fotogramma al successivo. Il mondo di solito la mantiene; quando la rompe, il conto va a sbattere. Una nuvola copre il sole: la piazza si scurisce tutta insieme, non si è mosso niente, e il calcolo vede movimento dappertutto. Fa lo stesso effetto l’ombra di una persona che scivola su un muro fermo.
C’è poi un limite curioso, e si chiama problema dell’apertura. Punta un tubo di cartone stretto verso un palo che si muove: dentro il tubo si vede solo un bordo che scivola, e da lì non si può dire se il palo va di lato o anche in diagonale, perché scivolando lungo sé stesso non produce alcun cambiamento visibile. Guardando un pezzo di bordo, il movimento lungo il bordo è invisibile. Serve uno spigolo, o serve mettere insieme quello che dicono le zone vicine.
L’ipotesi di partenza è la costanza della luminosità: lo stesso punto della scena ha lo stesso valore in due fotogrammi consecutivi, \(I(x, y, t) = I(x + \delta x,\, y + \delta y,\, t + \delta t)\). Sviluppando al primo ordine si ottiene l’equazione del flusso ottico
dove \((\dot{x}, \dot{y})\) è il flusso incognito, cioè la velocità con cui l’immagine del punto scorre sul sensore, e \(I_x, I_y, I_t\) sono le derivate dell’immagine nelle due direzioni e nel tempo. È un’equazione in due incognite per ogni pixel: da qui il problema dell’apertura, in forma algebrica. Solo la componente del flusso parallela al gradiente è determinata.
Le due soluzioni storiche, entrambe del 1981, chiudono il sistema in modi diversi. Lucas e Kanade assumono flusso costante in una finestra e risolvono ai minimi quadrati il sistema sovradeterminato che ne risulta: la matrice da invertire è la stessa \(\mathbf{M}\) di Harris, e il flusso è ben determinato esattamente dove c’è un angolo [LK81]. Horn e Schunck aggiungono invece un termine globale di regolarità che penalizza le variazioni del flusso, ottenendo una stima densa [HS81]. Dato locale più prior di regolarità: è la stessa struttura della stereo densa, e la stessa che ritroveremo nei metodi appresi.
I metodi appresi conservano quella struttura invece di buttarla. RAFT costruisce esplicitamente il volume di correlazione fra tutte le coppie di pixel (il «dato») e poi lo interroga con un aggiornamento ricorrente che raffina il campo di flusso un passo alla volta (il «prior») [TD20]: i due pezzi si riconoscono uno per uno nella tassonomia di quarant’anni prima. L’architettura è nuova, l’anatomia del problema è quella del 1981.
Il tubo di cartone è il problema dell’apertura: guardando un pezzo di bordo si misura soltanto la parte del movimento che attraversa il bordo, e quella che scivola lungo il bordo non si vede. Fig. 11.13 lo fa vedere muoversi: il palo si sposta, e la finestrella di sinistra non riesce a dire di quanto.

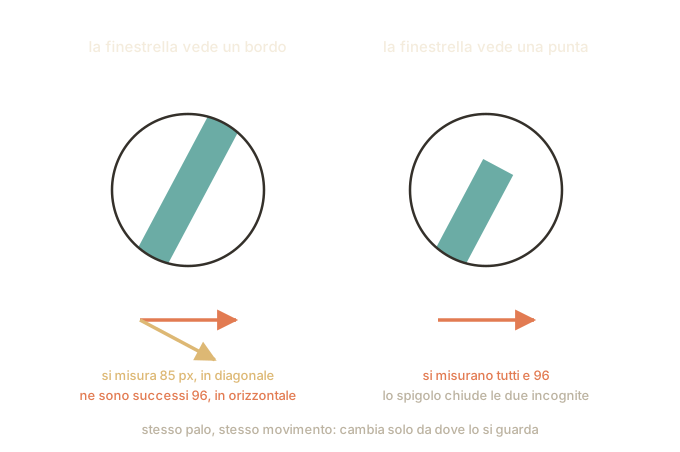
Fig. 11.13 Lo stesso palo e lo stesso identico movimento, guardati da due finestrelle diverse. A sinistra si vede solo un tratto di bordo, e di quel movimento si recupera la sola componente perpendicolare al bordo. A destra la finestrella contiene la punta, e non manca più niente.#
I due numeri sotto le finestrelle sono un conto vero, non un’illustrazione, e conviene leggerli piano perché nascondono una trappola. Il palo si sposta di 96 pixel in orizzontale; la finestrella di sinistra, che vede solo un tratto di bordo, ne misura 85, e per giunta in una direzione sbagliata, obliqua invece che orizzontale.
Verrebbe da dire: pazienza, sbaglia di undici pixel su novantasei, poco più del dieci per cento. È qui la trappola, perché quegli undici non sono l’errore. La freccia misurata e la freccia che manca per arrivare al movimento vero stanno ad angolo retto fra loro, e due frecce ad angolo retto non si sommano come si sommano i numeri: si sommano come i cateti di un triangolo rettangolo, con Pitagora. Quella che manca è lunga 45 pixel, e infatti \(\sqrt{85^2 + 45^2} = \sqrt{9250} = 96{,}2\), cioè i novantasei di partenza a meno degli arrotondamenti. L’informazione persa è quasi la metà e non un decimo, e sfugge perché si nasconde in una direzione diversa da quella che si sta guardando.
Quei 45 pixel sono scivolati lungo il bordo, ed è esattamente lì che il palo, muovendosi, non cambia niente di ciò che si vede: la finestrella non li può recuperare per quanto la si guardi bene, perché non hanno lasciato traccia. Ed è la ragione per cui la finestra di Lucas e Kanade va messa dove c’è uno spigolo: non perché lì l’immagine sia più nitida, ma perché uno spigolo ha due bordi in due direzioni diverse, e quello che scivola lungo il primo si vede scivolare attraverso il secondo.
Da dove escono l’85 e il 45, se il movimento è di 96? Dall’inclinazione del palo, che nel disegno è di 62 gradi. In un triangolo rettangolo con un angolo di 62 gradi, il lato opposto a quell’angolo è sempre \(0{,}883\) volte il lato più lungo, e il lato accanto \(0{,}469\) volte: sono due numeri fissi per quell’angolo, e una calcolatrice li dà con i tasti «sin» e «cos». Il pezzo che sopravvive è \(96 \times 0{,}883\), quasi \(85\); il pezzo che si perde è \(96 \times 0{,}469\), poco più di \(45\). Un palo verticale avrebbe i due fattori \(1\) e \(0\) (il movimento orizzontale si misurerebbe tutto); un palo orizzontale \(0\) e \(1\) (non se ne misurerebbe niente).
I due fattori sono \(\sin 62^\circ = 0{,}883\) e \(\cos 62^\circ = 0{,}469\): la componente normale al bordo vale \(96 \sin 62^\circ = 84{,}8\) pixel e quella tangenziale \(96 \cos 62^\circ = 45{,}1\). Solo la prima è determinata dall’equazione del flusso, perché è la proiezione del moto sul gradiente dell’immagine, e il gradiente è per costruzione ortogonale al bordo. La seconda sta nel nucleo dell’equazione, dove il vincolo non dice nulla.
Molte viste: structure from motion e SLAM#
Con due immagini, e con le fotocamere misurate come si diceva all’inizio, si ricava la forma della scena ma non la sua taglia. Attenzione a non confonderlo con quello che si è appena visto: nel caso dei due occhi la distanza fra loro la conoscevamo, ed è quella a dare i metri. Se invece le due foto le ha scattate una persona camminando, di quanto abbia camminato non lo sa nessuno, e allora un palazzo fotografato da lontano e un plastico fotografato da vicino danno esattamente le stesse due immagini. A rompere il pareggio dev’essere qualcosa che viene da fuori: un oggetto di misura nota inquadrato nella scena, oppure una centralina inerziale, il sensorino che nel telefono si accorge degli spostamenti e delle rotazioni e che, sommando istante per istante le accelerazioni che misura, sa dire di quanti centimetri ci si è mossi. Con molte immagini si può fare di più, e il problema prende il nome di structure from motion: stimare insieme dove erano le fotocamere e dov’erano i punti, avendo solo le foto.
È un problema dell’uovo e della gallina. Se sapessi dove sono le fotocamere, calcolare i punti 3D sarebbe geometria elementare. Se sapessi dove sono i punti, calcolare le posizioni delle fotocamere lo sarebbe altrettanto. Non sai né l’uno né l’altro, e devi trovare entrambi insieme.
Si fa a tentativi organizzati: si parte da due foto, si stima una soluzione approssimata, si aggiungono le altre una alla volta, e ogni tanto si aggiusta tutto insieme minimizzando un unico errore, la distanza fra dove ogni punto appare nelle foto e dove il modello attuale dice che dovrebbe apparire. Quasi sempre un punto non si vede in gran parte delle foto, e il conto tiene in considerazione soltanto quelle in cui c’è. Quando la distanza è piccola per ogni punto, in ognuna delle foto che lo contengono, la ricostruzione è coerente.
L’ordine in cui si procede ha una ragione. L’aggiustamento sa solo scendere: prende la sistemazione che ha fra le mani e la ritocca finché ogni altro ritocco peggiora le cose. Partendo da una disposizione a caso si finisce in una sistemazione tutta sbagliata da cui nessun ritocco fa uscire, con le fotocamere messe dove non erano e i punti piazzati di conseguenza, a dar loro ragione. Le due foto iniziali servono a partire già abbastanza vicini alla risposta giusta.
Quando lo stesso calcolo si fa in tempo reale, mentre il dispositivo si muove, si chiama SLAM, sigla di simultaneous localization and mapping, cioè «localizzarsi e disegnare la mappa nello stesso momento», che è poi l’uovo e la gallina di prima con l’aggravante della fretta. È quello che fa un robot aspirapolvere, un visore per la realtà aumentata, un drone che rientra da solo.
Il criterio è l’errore di riproiezione. Date le posizioni \(\mathbf{u}_{ij}\) in cui i punti sono stati osservati, le incognite sono i parametri delle fotocamere \(\{\mathbf{K}_j, \mathbf{R}_j, \mathbf{t}_j\}\) e i punti \(\{\mathbf{p}_i\}\):
dove \(\pi\) è la proiezione, \(\mathbf{u}_{ij}\) è dove il punto \(i\) è stato osservato nell’immagine \(j\), e \(m_{ij}\) vale 1 se quell’osservazione esiste e 0 altrimenti. La minimizzazione congiunta si chiama bundle adjustment e si risolve con Levenberg-Marquardt sfruttando la struttura sparsa del problema. Ogni residuo dipende da un punto solo e da una fotocamera sola, quindi nella matrice normale il blocco dei punti è diagonale a blocchi \(3 \times 3\) e si elimina per complemento di Schur [TMHF00]: resta un sistema ridotto nelle sole fotocamere, di dimensione proporzionale al loro numero, che con un solutore denso costa come il cubo di quel numero a ogni iterazione. Inoltre, il fatto che ogni punto compaia in poche immagini rende sparso il blocco che lega punti e fotocamere.
Due cose meritano di essere notate. La prima è che il problema è non convesso e serve una buona inizializzazione, che è il motivo per cui le pipeline procedono in modo incrementale invece di ottimizzare tutto da subito [SchonbergerF16]. La seconda è che la soluzione è definita a meno di una similarità (sette gradi di libertà: rotazione, traslazione, scala), e la scala globale resta indeterminata senza informazione esterna.
Quel «a meno di una similarità» vale però solo con gli intrinseci noti. Senza calibrazione l’ambiguità è molto più larga: si ottiene una ricostruzione proiettiva, che non conserva né gli angoli né i rapporti fra lunghezze, ed è come guardare il palazzo attraverso una deformazione prospettica arbitraria. Per riportarla a una forma metrica bisogna stimare gli intrinseci a posteriori, ed è quello che si chiama auto-calibrazione: un’altra ragione per calibrare prima.
Apparentemente la più tecnica, la geometria a più viste è quella che serve di più subito dopo. Le pose delle fotocamere, cioè dove stava e da che parte guardava ognuna, sono quello che una ricostruzione structure from motion calcola insieme ai punti, e sono l’ingresso dei metodi della sezione sul rendering neurale, che ricostruiscono una scena dalle sue fotografie: NeRF addestrando una piccola rete a dire, per ogni punto e ogni direzione, di che colore è e quanto è densa la materia lì; lo splatting ottimizzando direttamente milioni di granelli sfumati. Nessuno dei due controlla le pose che riceve: se sono sbagliate, la ricostruzione esce confusa, e il difetto non sta nella rete.
Profondità da una sola immagine#
Restava un fatto: da un’immagine sola la profondità è matematicamente indeterminata, perché è andata perduta nello scatto e nessun calcolo la rimette. Eppure noi la vediamo, guardando una fotografia con un occhio solo, e da qualche anno la vedono anche le reti. Non è una contraddizione, e capire perché insegna dove finisce la geometria.
Guardando una foto di una strada sai benissimo che le case in fondo sono lontane. Non lo sai per geometria: lo sai perché conosci il mondo. Sai quanto è grande una porta, sai che le righe della carreggiata sono parallele e quindi se convergono è per prospettiva, sai che il cielo è dietro, sai che se un oggetto ne copre un altro sta davanti, sai che la foschia sbianca il lontano.
Una rete addestrata su milioni di foto con la profondità misurata impara la stessa cosa: non calcola, riconosce. Ha visto abbastanza scene da sapere come si dispongono di solito. È un’ottima cosa e ha un limite preciso, che conviene tenere a mente: essendo un ricordo statistico e non una misura, si può ingannare. Una fotografia di una fotografia viene letta come una scena vera, e un plastico ben fatto viene letto come un palazzo.
C’è poi un limite che viene dalla geometria: la scala, da sola, la foto non la dà. Una rete addestrata a mettere la scena in fila dal vicino al lontano dice senza esitare che l’auto sta più indietro dell’albero; se siano a dieci metri o a cento, e di quante volte l’una sia più lontana dell’altra, non lo dice. A dirlo può essere soltanto quello che si sa del mondo, come la taglia di una porta o di un’auto, e allora la risposta vale quanto quel ricordo: un plastico fatto bene la manda fuori strada di tante volte quante il plastico è più piccolo del vero.
Il problema è mal posto in senso stretto: infinite scene generano la stessa immagine, e la classe di ambiguità include almeno la scala globale. Un modello monoculare non risolve la geometria: della distribuzione della profondità data l’immagine stima soltanto la statistica che la loss premia (la media con l’errore quadratico, la mediana con quello assoluto). La distinzione terminologica che ne discende è utile: si distingue la profondità relativa (l’ordinamento, oppure l’inversa della profondità a meno di scala e offset, che è ciò che predice MiDaS) dalla profondità metrica (in metri). Dalla profondità relativa non si ricavano nemmeno i rapporti fra le distanze, perché uno spostamento costante della disparità non equivale a uno spostamento costante della profondità. La seconda chiede che il prior contenga anche le taglie degli oggetti e che la focale sia nota o stimata, perché la stessa scena ripresa con un grandangolo o con un teleobiettivo suggerisce distanze diverse; con più viste bastano invece la base nota o un sensore inerziale.
Il progresso decisivo è stato di dati, non di architettura. MiDaS mostra che mescolando dataset molto diversi (scansioni 3D, stereo da film, ricostruzioni structure from motion, sintetici), ognuno con la sua nozione di profondità e la sua scala, si ottiene un modello che generalizza a scene mai viste. La chiave è una loss invariante a scala e offset, che permette di sommare gradienti provenienti da sorgenti non commensurabili [RLH+22]. Depth Anything spinge la stessa strategia sul non etichettato, usando un modello maestro per pseudo-etichettare milioni di immagini [YKH+24].
Il quadro che ne esce è questo: la geometria dà vincoli esatti ma insufficienti, l’apprendimento dà un prior sufficiente ma fallibile, e i sistemi che funzionano davvero usano entrambi. Uno stereo appreso mantiene la ricerca lungo la retta epipolare e impara solo la parte ambigua; una pipeline di ricostruzione usa la profondità monoculare per inizializzare e la geometria multi-vista per correggerla. E c’è chi sposta il confine ancora più in là: reti addestrate su moltissime scene che da una coppia di fotografie non calibrate regrediscono direttamente la geometria, pose comprese [WLC+24], cioè un prior appreso al posto della catena di corrispondenze, consenso e bundle adjustment.
In pratica: la geometria si può verificare#
Tutto quello che si è detto fin qui si può controllare con un calcolo, senza addestrare niente. Costruiamo una scena finta di cui conosciamo le risposte, proiettiamola in due fotocamere e verifichiamo le due affermazioni centrali. La prima è quella del dito davanti al naso: se misuro di quanto un punto salta fra la prima e la seconda immagine, posso risalire a quanto è lontano. La seconda è quella della retta: il punto che nella prima immagine sta in un certo posto, nella seconda deve cadere su una riga precisa, calcolabile in anticipo. Se sono vere davvero, il computer deve ridarci i numeri esatti da cui siamo partiti.
import numpy as np

# --- una fotocamera: matrice degli intrinseci ---
f, cx, cy = 700.0, 320.0, 240.0          # focale e centro, in pixel
K = np.array([[f, 0, cx],
              [0, f, cy],
              [0, 0,  1]])

def proietta(K, R, t, P):
    """Porta i punti 3D P (N,3) nel sistema della fotocamera e li proietta."""
    Pc = P @ R.T + t                      # rototraslazione nel sistema camera
    x = Pc @ K.T                          # proiezione prospettica (omogenea)
    return x[:, :2] / x[:, 2:3]           # la divisione per Z: qui si perde la profondità

rng = np.random.default_rng(0)
P = np.column_stack([rng.uniform(-1.5, 1.5, 8),
                     rng.uniform(-1.0, 1.0, 8),
                     rng.uniform( 4.0, 9.0, 8)])   # otto punti davanti alle camere

# --- caso rettificato: seconda camera traslata di B lungo x, stessa orientazione ---
B = 0.30                                   # base, in metri
R1, t1 = np.eye(3), np.zeros(3)
R2, t2 = np.eye(3), np.array([-B, 0.0, 0.0])

u1 = proietta(K, R1, t1, P)
u2 = proietta(K, R2, t2, P)

disparita = u1[:, 0] - u2[:, 0]
Z_stimata = f * B / disparita

print("profondità vera   :", [round(float(z), 3) for z in P[:, 2]])
print("profondità stimata:", [round(float(z), 3) for z in Z_stimata])
print("errore massimo sotto 1e-12:", np.abs(Z_stimata - P[:, 2]).max() < 1e-12)
print("righe uguali (rettificato):", np.allclose(u1[:, 1], u2[:, 1]))
profondità vera   : [8.316, 6.707, 5.499, 6.113, 4.142, 4.621, 7.353, 7.236]
profondità stimata: [8.316, 6.707, 5.499, 6.113, 4.142, 4.621, 7.353, 7.236]
errore massimo sotto 1e-12: True
righe uguali (rettificato): True
Le due file di numeri coincidono, e l’errore massimo sta sotto \(10^{-12}\) metri:
cioè zero, a meno degli arrotondamenti che il computer fa quando scrive un
numero con la virgola. La regola dice che la profondità si ottiene moltiplicando
la focale (quanto la fotocamera ingrandisce, qui \(700\)) per la base (la distanza
fra le due fotocamere, qui \(30\) centimetri) e dividendo per il salto misurato:
\(Z = fB/d\). È un’identità, e o si applica alla lettera o non si applica affatto.
E righe uguali conferma la seconda affermazione: con le due fotocamere
affiancate e allineate, il gemello di un pixel sta sulla stessa riga dell’altra
immagine, così che a cercarlo basta scorrere quella.
Ora il caso generale, con la seconda fotocamera ruotata di otto gradi attorno
alla verticale, come due telecamere puntate un po’ l’una verso l’altra. Qui non
c’è più nessuna riga comoda, ma la retta esiste ancora. Il programma raccoglie
la posizione reciproca delle due fotocamere in una tabella di tre righe per tre
colonne, la matrice fondamentale (nel codice F): moltiplicata per un pixel
della prima immagine, dà i tre coefficienti \(a\), \(b\), \(c\) della retta \(au + bv +
c = 0\) su cui cercarlo nella seconda. Poi verifica, punto per punto, se il pixel
della seconda immagine cade sulla retta o fuori. Quel «quanto fuori» è il
residuo, lo stesso nome che nella sezione su ortogonalità e proiezioni porta lo scarto fra un punto e la sua
ombra: la parte che il modello non spiega. Vale esattamente zero quando il pixel
sta sulla retta; in pixel, però, non ci si legge ancora, e va convertito.
ang = np.deg2rad(8.0)
Ry = np.array([[ np.cos(ang), 0, np.sin(ang)],   # rotazione attorno all'asse y
               [ 0,           1, 0          ],   # (la verticale): la seconda riga
               [-np.sin(ang), 0, np.cos(ang)]])  # e colonna restano identiche
t3 = np.array([-B, 0.02, 0.0])
u3 = proietta(K, Ry, t3, P)

def antisimmetrica(v):
    """La matrice che realizza il prodotto vettoriale: [v]_x @ w == np.cross(v, w)."""
    return np.array([[0, -v[2], v[1]],
                     [v[2], 0, -v[0]],
                     [-v[1], v[0], 0]])

F = np.linalg.inv(K).T @ antisimmetrica(t3) @ Ry @ np.linalg.inv(K)

def omogenee(u):
    return np.column_stack([u, np.ones(len(u))])

residuo = np.einsum('ij,jk,ik->i', omogenee(u3), F, omogenee(u1))
rette = omogenee(u1) @ F.T                  # la retta di ogni punto: (a, b, c)
norma = np.hypot(rette[:, 0], rette[:, 1])  # la lunghezza di (a, b)
print("residuo massimo sotto 1e-12:", np.abs(residuo).max() < 1e-12)
print("sqrt(a^2+b^2), min e max   :",
      f"{norma.min():.1e}", f"{norma.max():.1e}")
rapporti = np.linalg.norm(rette, axis=1) / norma
print("tutti e tre contro (a, b)  :", [round(float(r)) for r in rapporti])
print("distanza in pixel sotto 1e-9:", (np.abs(residuo) / norma).max() < 1e-9)
print("residuo 0,3 in pixel       :", round(0.3 / norma.mean()))
residuo massimo sotto 1e-12: True
sqrt(a^2+b^2), min e max   : 4.1e-04 4.4e-04
tutti e tre contro (a, b)  : [277, 353, 334, 145, 404, 133, 314, 208]
distanza in pixel sotto 1e-9: True
residuo 0,3 in pixel       : 706
Il residuo resta sotto \(10^{-12}\), cioè ancora una volta zero. Per leggerlo in pixel va diviso per la lunghezza dei due primi coefficienti della retta, \(\sqrt{a^2+b^2}\), che qui sta fra \(4{,}1 \cdot 10^{-4}\) e \(4{,}4 \cdot 10^{-4}\): è quella divisione a trasformare un numero algebrico in una distanza. Dividerlo invece per la lunghezza di tutti e tre i coefficienti darebbe un numero da centotrenta a quattrocento volte più piccolo, secondo il punto, e senza significato.
Il metro con cui guardare il risultato è questo: un residuo di \(0{,}3\) vorrebbe dire settecento pixel fuori posto, più dell’intera larghezza dell’immagine, che nel programma è di seicentoquaranta (il centro sta a \(320\)). Diviso per quella lunghezza, il residuo resta sotto un miliardesimo di pixel: per ognuno degli otto punti, il pixel nella seconda immagine sta esattamente sulla retta calcolata dalla prima. Nessuna rete, nessun dato: è un’identità algebrica che dipende solo da come è fatta la proiezione, ed è la ragione per cui questa parte della visione artificiale non è invecchiata.
Da ricordare
Scattare una foto butta via la distanza. Un pixel dice da che parte guardare, non quanto lontano: la mano vicina e la Torre di Pisa lontana, se sono allineate con l’obiettivo, finiscono nello stesso punto della foto. Nell’immagine non c’è niente da scovare: quella distanza va ricostruita da fuori.
Prima di qualunque conto la fotocamera va misurata (quanto ingrandisce, dove cade il centro dell’immagine, quanto l’obiettivo incurva le rette), e si fa fotografando una scacchiera. Senza quelle misure i pixel non si traducono in direzioni, e nessuna risposta può essere in metri; per i metri, poi, serve in più una lunghezza nota.
Con due foto la ricerca del punto corrispondente non è una caccia in tutta l’immagine: è una caccia lungo una riga, e quale riga si calcola in anticipo dalla posizione reciproca delle due fotocamere. Se le si monta affiancate e allineate, quella riga è la stessa riga di pixel.
La distanza si legge nel salto di un punto fra le due immagini, ed è una relazione inversa: raddoppiando la distanza il salto si dimezza. Perciò la visione a due occhi è precisa da vicino e vaga da lontano, e allontanare le telecamere aumenta la precisione ma restringe la zona che entrambe vedono.
Lo stesso ragionamento vale nel tempo invece che nello spazio (guardare un palo dal finestrino di un treno), con due limiti da tenere a mente: su una superficie senza disegni non c’è niente da riconoscere, e guardando solo un pezzo di bordo non si vede il movimento lungo il bordo stesso.
Con molte foto si stima tutto insieme, dov’erano le fotocamere e dov’erano i punti, aggiustando finché ogni punto non cade dove il modello dice che dovrebbe cadere. Una cosa resta comunque indeterminata: quanto è grande la scena, cioè se sia un palazzo o un plastico.
Da una foto sola la distanza è indeterminata per legge, eppure le reti la stimano bene: non la calcolano, la riconoscono, perché hanno visto milioni di scene. Ottimo in pratica, ingannabile per costruzione (una fotografia di una fotografia le inganna), e cieco alla scala, salvo quella che indovina dalle taglie che ricorda.
Da ricordare
Proiettare perde una dimensione. Un pixel determina una direzione, mai una posizione: tutti i punti di una semiretta uscente dal centro ottico danno lo stesso pixel. La profondità è stata cancellata dalla divisione per \(Z\).
Il modello stenopeico con la matrice degli intrinseci \(\mathbf{K}\) descrive la fotocamera; stimarla si chiama calibrazione, e senza di essa i pixel non si traducono in direzioni e la ricostruzione resta proiettiva.
Il vincolo epipolare riduce la ricerca della corrispondenza da un piano a una retta: \(\tilde{\mathbf{x}}_R^\top \mathbf{F} \tilde{\mathbf{x}}_L = 0\). Rettificando le immagini quelle rette diventano orizzontali, il che equivale a mandare gli epipoli all’infinito. Dentro RANSAC, il minimo di corrispondenze è sette per \(\mathbf{F}\) e cinque per \(\mathbf{E}\), non otto. Dalla \(\mathbf{E}\) si ricavano \(\mathbf{R}\) e \(\mathbf{t}\), quest’ultima a meno di scala: delle quattro soluzioni vale quella che mette i punti davanti a entrambe le fotocamere.
Nel caso rettificato, \(Z = fB/d\): la profondità è inversamente proporzionale alla disparità, quindi la stereo è precisa da vicino e vaga da lontano, e l’errore cresce come \(Z^2\).
Il flusso ottico è lo stesso problema nel tempo, indifferente a chi si muova fra scena e fotocamera; la sua equazione ha due incognite per pixel (problema dell’apertura), e si chiude con un’ipotesi locale (Lucas-Kanade) o globale (Horn-Schunck).
Structure from motion stima insieme pose e punti minimizzando l’errore di riproiezione (bundle adjustment); con intrinseci noti la scala globale resta indeterminata, senza calibrazione l’ambiguità è l’intero gruppo proiettivo. Le sue pose sono l’ingresso dei metodi di rendering neurale che ottimizzano una scena alla volta.
La profondità da una sola immagine è matematicamente indeterminata: le reti non la calcolano, applicano un prior appreso. Ottimo in pratica, ingannabile per costruzione, e cieco alla scala assoluta, salvo quella che il prior suggerisce dalle taglie note degli oggetti.