


L’attenzione nello spazio e nel tempo#
Una persona attraversa l’inquadratura da sinistra a destra. Nel fotogramma \(i\) la sua testa sta in un punto dell’immagine, nel fotogramma \(i+1\) un po’ più in là, e perché il video sia coerente le due apparizioni devono essere la stessa testa, con la stessa forma e lo stesso colore. Per generare un video bisogna quindi mettere in comunicazione pezzi di fotogrammi diversi che occupano posti diversi dell’immagine.
Il generatore non lavora sui pixel ma sul latente, la versione compressa del video che produce l’autoencoder video: \(F'\) fotogrammi latenti, ciascuno tagliato in \(S\) pezzi detti token, per un totale di \(N = F'S\) token. Il rumore diventa video un passo alla volta, e a ogni passo il denoiser, la rete che stima come ripulire il latente, lavora su questa sequenza. Nei generatori recenti il denoiser è un Transformer di diffusione come il DiT, e procede per strati: in ogni strato, cioè in ogni passata, ciascun token raccoglie informazione da altri token con l’attenzione, pesandoli secondo quanto gli servono.
Chi guarda chi, in uno strato, decide quanto costa lo strato, che cosa si può riutilizzare di un modello di immagini già addestrato, e se la testa del fotogramma \(i+1\) vede direttamente quella del fotogramma \(i\) o la raggiunge per vie traverse. Le risposte sono arrivate in due tempi. L’attenzione fattorizzata separa lo spazio dal tempo: alterna uno strato in cui ogni token guarda solo i token del proprio fotogramma e uno in cui guarda solo i token nello stesso posto degli altri fotogrammi. L’attenzione piena mette invece tutti i token in una sola sequenza, e ognuno guarda tutti gli altri (Fig. 33.3). Resta poi da far arrivare al video il testo della richiesta.
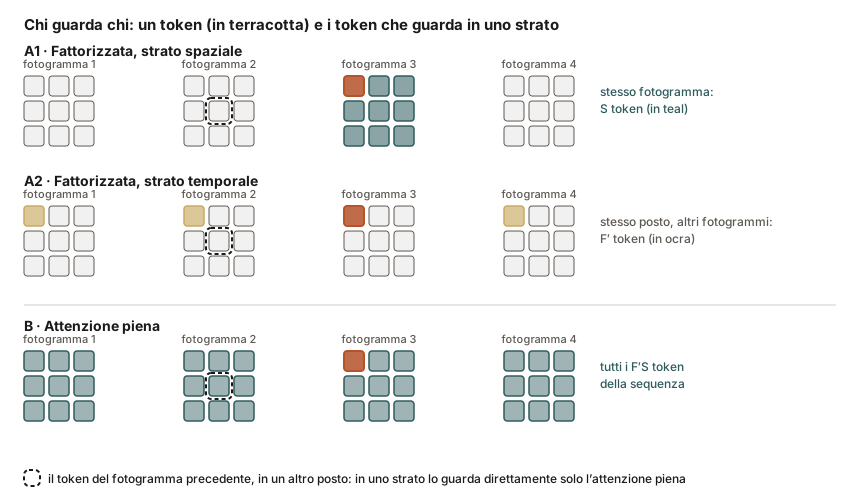
Fig. 33.3 Chi guarda chi in uno strato, cioè in una passata in cui ogni token raccoglie informazione da altri token. L’attenzione fattorizzata alterna uno strato spaziale (i token dello stesso fotogramma) e uno temporale (i token nello stesso posto degli altri fotogrammi); quella piena mette tutti i token nella stessa sequenza.#
Innestare il tempo in un modello di immagini: l’attenzione fattorizzata#
Le prime architetture partono da un generatore di immagini che funziona e gli aggiungono il tempo. Video Diffusion Models [HSG+22] prende la U-Net, la rete che nei primi modelli di diffusione stima il rumore, e la fa lavorare su una pila di fotogrammi. Le convoluzioni continuano a guardare dentro il singolo fotogramma; dopo ogni blocco di attenzione spaziale, in cui si guardano i token di uno stesso fotogramma, si inserisce un blocco di attenzione temporale, in cui ogni token guarda soltanto i token che occupano il suo stesso posto negli altri fotogrammi. Ne esce una U-Net 3D fattorizzata nello spazio e nel tempo, che gli autori presentano come una scelta già nota nei Transformer per video, per il suo costo contenuto. Make-A-Video, pochi mesi dopo, considera del tutto impraticabile, per la memoria che richiederebbe, un’attenzione estesa a tutti i token del video [SPH+23].
Lo stesso modello si addestra anche su immagini singole. Basta fissare all’identità la matrice di attenzione temporale, cioè la tabella che dice quanto ogni token ascolta gli altri: ogni fotogramma guarda allora soltanto sé stesso, e nessuna informazione passa da un fotogramma all’altro. Il modello può così ricevere, insieme ai video, fotogrammi singoli che non comunicano con nessun altro (come si addestrano insieme i due tipi di dato lo racconta la sezione su come si insegna il movimento).
Make-A-Video fa la stessa operazione su un modello da testo a immagine, e fa partire spento il pezzo nuovo: nell’attenzione temporale la proiezione d’uscita, la matrice con cui il risultato si somma a quello che c’era, è inizializzata a zero [SPH+23]. È lo stesso accorgimento dell’adaLN-zero della sezione su DiT: all’inizio dell’addestramento il pezzo nuovo non cambia niente, e il modello è ancora quello di immagini, che genera fotogrammi indipendenti, ciascuno fedele al testo e nessuno coerente con gli altri. Il vantaggio pratico, dicono gli autori, è che il movimento si impara da video senza didascalie, mentre l’aspetto e il legame con il testo restano quelli delle coppie testo-immagine.
Video LDM [BRL+23] lo fa su un modello di diffusione latente di immagini congelato, i cui parametri \(\theta\) non vengono più toccati. Fra i suoi strati spaziali si intercalano strati temporali, con parametri propri \(\phi\) (attenzione temporale e blocchi residui con convoluzioni 3D), e si addestra solo \(\phi\). L’uscita dei due viene fusa con un coefficiente appreso \(\alpha \in [0, 1]\), uno per strato, e con \(\alpha = 1\) torna il modello di immagini. Quello che il modello di immagini ha imparato resta così intatto, e gli strati temporali addestrati su un modello si trasferiscono anche a versioni affinate dello stesso modello di immagini, per esempio a una personalizzata su un soggetto.
Imagen Video [HCS+22] resta fattorizzato nel modello di base e affida il resto a una cascata di sette modelli di diffusione: uno di base, tre che aumentano la risoluzione dei fotogrammi e tre che aggiungono fotogrammi intermedi. Solo il modello di base ha l’attenzione temporale; gli altri, che lavorano a risoluzioni e frequenze più alte, usano convoluzioni temporali per risparmiare memoria e calcolo.
Che l’innesto lasci intatto il modello di partenza si verifica su un tensore casuale: uno strato temporale con la proiezione d’uscita a zero restituisce l’ingresso, e lo stesso vale per la fusione con \(\alpha = 1\).
import numpy as np

rng = np.random.default_rng(0)
Fl, S, d = 4, 9, 16
z = rng.normal(size=(Fl, S, d))           # uscita di uno strato spaziale
Wq, Wk, Wv = (rng.normal(size=(d, d)) / np.sqrt(d) for _ in range(3))

def con_tempo(z, Wo):
    """Attenzione temporale: i posti spaziali fanno da batch, il tempo da sequenza."""
    q, k, v = ((z @ W).transpose(1, 0, 2) for W in (Wq, Wk, Wv))   # (S, F', d)
    p = np.exp(q @ k.transpose(0, 2, 1) / np.sqrt(d))
    p /= p.sum(-1, keepdims=True)
    return z + (p @ v @ Wo).transpose(1, 0, 2)                     # residuo

def scarto(a, b):
    return np.abs(a - b).max()

zero = np.zeros((d, d))                    # proiezione di uscita inizializzata a zero
print("proiezione a zero, scarto dall'uscita spaziale:", scarto(con_tempo(z, zero), z))

Wo = rng.normal(size=(d, d)) / np.sqrt(d)  # dopo l'addestramento sarebbe diversa
zt = con_tempo(z, Wo)
for alfa in (1.0, 0.5):
    fuso = alfa * z + (1 - alfa) * zt      # fusione di Video LDM
    print(f"alfa = {alfa}: scarto dal modello di immagini = {scarto(fuso, z):.3f}")
print(f"massimo modulo dell'uscita spaziale: {np.abs(z).max():.3f}")
proiezione a zero, scarto dall'uscita spaziale: 0.0
alfa = 1.0: scarto dal modello di immagini = 0.000
alfa = 0.5: scarto dal modello di immagini = 2.140
massimo modulo dell'uscita spaziale: 3.899
Con la proiezione a zero lo scarto è esattamente nullo, e lo è anche con \(\alpha = 1\). Con \(\alpha = 0{,}5\) lo strato temporale, qui con pesi casuali al posto di quelli addestrati, sposta l’uscita fino a 2,140, più della metà del valore più grande che l’uscita spaziale contiene (3,899): in quello spostamento l’addestramento mette il movimento, partendo da un modello che sa già generare immagini.
Fattorizzare ha un prezzo, che CogVideoX [YTZ+25] descrive nella didascalia della sua Fig. 5: la testa di una persona nel fotogramma \(i+1\) non può guardare direttamente la testa nel fotogramma \(i\), e l’informazione visiva passa solo implicitamente attraverso altri token dello sfondo. Su un esempio piccolo il conto si fa subito: quattro fotogrammi da nove token, un token \(q\) nell’angolo del terzo fotogramma e un token \(x\) al centro del secondo.
import numpy as np

Fl, S = 4, 9                       # fotogrammi latenti e token per fotogramma
N = Fl * S
n = np.arange(N)
fotogramma, posto = n // S, n % S   # il token n sta nel fotogramma n // S

spaziale = fotogramma[:, None] == fotogramma[None, :]   # stesso fotogramma
temporale = posto[:, None] == posto[None, :]            # stesso posto
piena = np.ones((N, N), dtype=bool)

print("coppie, attenzione piena:", piena.sum())
print("coppie, spaziale + temporale:", spaziale.sum() + temporale.sum(),
      f"({spaziale.sum()} + {temporale.sum()})")
print(f"rapporto: {piena.sum() / (spaziale.sum() + temporale.sum()):.2f}",
      f"(F'S/(F'+S) = {Fl * S / (Fl + S):.2f})")

# q: fotogramma 2, angolo (posto 0). x: fotogramma 1, centro (posto 4)
q, x = 2 * S + 0, 1 * S + 4
print("q guarda x in uno strato, piena:", piena[q, x])
print("q guarda x in uno strato, spaziale:", spaziale[q, x])
print("q guarda x in uno strato, temporale:", temporale[q, x])
due = (temporale.astype(int) @ spaziale.astype(int)) > 0   # spaziale, poi temporale
print("dopo spaziale e temporale, q riceve da x:", due[q, x])
print("coppie raggiunte dopo i due strati:", due.sum(), "su", N * N)
coppie, attenzione piena: 1296
coppie, spaziale + temporale: 468 (324 + 144)
rapporto: 2.77 (F'S/(F'+S) = 2.77)
q guarda x in uno strato, piena: True
q guarda x in uno strato, spaziale: False
q guarda x in uno strato, temporale: False
dopo spaziale e temporale, q riceve da x: True
coppie raggiunte dopo i due strati: 1296 su 1296
Le coppie di attenzione sono 1296 per la piena e 468 per i due strati fattorizzati, con un rapporto di 2,77 che è \(F'S/(F'+S)\). Il token \(q\) non guarda \(x\) né nello strato spaziale né in quello temporale, ma dopo uno spaziale e uno temporale riceve da \(x\) lo stesso: la strada passa per un terzo token, quello del fotogramma precedente nello stesso posto di \(q\), che nello strato spaziale aveva già raccolto \(x\). Dopo la coppia ogni token ha raggiunto ogni altro (1296 su 1296).
La fattorizzazione non perde raggiungibilità: la fa passare da due strati e da un intermediario, che consegna \(x\) già mescolato con il resto del suo fotogramma. Secondo gli autori di CogVideoX questo passaggio implicito complica l’apprendimento e rende difficile mantenere coerenti gli oggetti che si spostano molto.
Un disegnatore bravissimo a fare un disegno solo riceve una pila di quattro fogli, i fotogrammi di una scena, e gli si chiede di disegnarli come un film. Ogni foglio è tagliato in nove tessere, come un mosaico, e le tessere sono i pezzetti che la rete legge come se fossero parole. Il disegnatore sa già lavorare così: un foglio alla volta, con ogni tessera che guarda le altre otto dello stesso foglio e si regola di conseguenza. Il guaio è che ogni foglio esce bello e diverso dagli altri: la porta cambia colore, il cappello compare e sparisce.
Allora gli si siede accanto un collaboratore, che lavora dopo ogni passata del disegnatore. Prende una tessera, per esempio quella in alto a sinistra, e guarda soltanto la tessera nello stesso posto degli altri tre fogli, come fa chi sfoglia il quaderno col pollice tenendo d’occhio un angolo che deve restare fermo. Le due passate si alternano per tutto il lavoro, e ognuna si chiama strato: quella del disegnatore, che cura un foglio alla volta, è uno strato di attenzione spaziale; quella del collaboratore, che cura un posto alla volta attraverso i fogli, è uno strato di attenzione temporale.
Il primo giorno il collaboratore ha il volume a zero: ciò che dice viene sommato al lavoro già fatto dopo essere stato moltiplicato per niente, quindi il disegnatore continua a produrre i suoi disegni di sempre, belli e scollegati fra loro. Il volume sale man mano che il collaboratore impara, e se nel frattempo anche il disegnatore ha ripreso a studiare, i disegni di partenza non si ritrovano più. Un’altra organizzazione non rimanda mai a scuola il disegnatore e mette fra i due una manopola che mescola i loro lavori: girata tutta da una parte restituisce i disegni del disegnatore, e poiché lui non è cambiato, quei disegni si ritrovano identici in qualunque momento. Ritrovarli conta, perché il disegnatore ha imparato il mestiere su un’enorme quantità di disegni, e il collaboratore deve aggiungere il movimento senza fargli perdere la mano.
Le consultazioni diminuiscono. Ogni tessera ne fa 13, le nove del suo foglio e le quattro del suo posto, una per foglio, invece di 36, e il conto totale scende da 1296 a 468. Il prezzo è il cappello: se sta al centro del secondo foglio e nell’angolo del terzo, chi guarda l’angolo attraverso i fogli non lo vede. Lo vede solo perché, nella passata precedente, la tessera dell’angolo del secondo foglio ha raccolto il cappello dal centro. Il cappello arriva, ma di rimbalzo, per interposta tessera, e insieme a tutto il resto del secondo foglio che quella tessera aveva raccolto.
Disegnatore e collaboratore devono quindi imparare a far passare il cappello per queste vie traverse, e più il cappello si sposta, più è difficile. Messo a confronto con un sistema in cui ogni tessera guarda direttamente tutte le altre, il lavoro a passate alterne impara peggio, e a volte si perde del tutto.
Sia \(\mathbf{X} \in \mathbb{R}^{F' \times S \times d}\) il tensore dei token. Lo strato spaziale tratta ogni fotogramma \(\mathbf{X}^{i} \in \mathbb{R}^{S \times d}\) come un elemento di un batch,
e lo strato temporale ripete la stessa formula su ogni sequenza \(\mathbf{X}_{:,s} \in \mathbb{R}^{F' \times d}\), cioè sui token che occupano il posto \(s\) nei vari fotogrammi, trattando gli assi spaziali come batch e con posizioni relative nel tempo (i pesi sono propri di ciascuno strato, e le teste si omettono). In VDM le convoluzioni \(3 \times 3\) della U-Net diventano \(1 \times 3 \times 3\), cioè solo spaziali [HSG+22]. Le coppie query-chiave sono \(F'S^2\) nello strato spaziale e \(SF'^2\) in quello temporale, contro \((F'S)^2\) dell’attenzione piena: un rapporto \(F'S/(F'+S)\), che per \(S \gg F'\) vale circa \(F'\). Il costo lineare nei token, proiezioni e feed-forward, non diminuisce, e anzi cresce delle proiezioni della seconda attenzione.
Lo strato temporale entra come residuo,
e Make-A-Video inizializza \(\mathbf{W}_O = \mathbf{0}\) [SPH+23]: all’inizio il modello coincide con quello di immagini applicato a ogni fotogramma, per la stessa ragione per cui un blocco con l’adaLN-zero parte dall’identità. Nello stesso modello la convoluzione diventa pseudo-3D, una 2D seguita da una 1D temporale inizializzata all’identità. La garanzia vale però solo al passo zero, perché poi \(\mathbf{W}_O\) si allontana da zero, e Make-A-Video affina insieme agli strati nuovi anche quelli spaziali. Video LDM congela invece i parametri spaziali \(\theta\) e fonde le due uscite, \(\alpha\,\mathbf{z} + (1-\alpha)\,\mathbf{z}'\), con \(\mathbf{z}\) l’uscita dello strato spaziale, \(\mathbf{z}'\) quella dello strato temporale e \(\alpha \in [0, 1]\) appreso per ogni strato [BRL+23]. Con \(\theta\) fisso, \(\alpha = 1\) restituisce esattamente il modello di immagini in qualunque momento dell’addestramento, non solo all’inizio. La proprietà interessa perché il modello di partenza porta con sé ciò che ha appreso dalle coppie testo-immagine, e l’innesto deve aggiungere il movimento senza disperderlo; Video LDM ne ricava anche il trasferimento degli strati temporali a versioni affinate dello stesso modello di immagini.
Il limite sta nell’accoppiamento. Lo strato temporale mette in relazione solo token con lo stesso indice \(s\). Se un oggetto passa dal posto \(s\) al posto \(s'\) fra il fotogramma \(i\) e il fotogramma \(i+1\), il legame fra le sue due apparizioni non esiste in nessuno dei due strati presi da soli. Esiste dopo la coppia (spaziale, temporale), attraverso il token \((i, s')\), e arriva già mescolato, perché l’uscita spaziale di quel token combina i valori di tutti gli \(S\) token del fotogramma \(i\). Il conto sull’esempio piccolo lo mostra: dopo i due strati le coppie raggiunte sono 1296 su 1296, ma \(q\) non raggiunge \(x\) in nessuno dei due strati preso da solo. Nelle ablazioni di CogVideoX, sostituire l’attenzione piena con la fattorizzata (2D+1D) dà video nettamente peggiori nelle prime fasi dell’addestramento e un addestramento instabile, incline a collassare; gli autori suppongono che l’instabilità cresca con la taglia del modello [YTZ+25].
Tutti i token in una sola sequenza: l’attenzione 3D piena#
I generatori successivi abbandonano la fattorizzazione. Nell’attenzione 3D piena gli \(N = F'S\) token del latente video entrano in un’unica sequenza e ogni token guarda tutti gli altri. La adottano CogVideoX [YTZ+25], che concatena nella stessa sequenza anche i token del testo, HunyuanVideo [KTZ+24], Wan [WanTeamWA+25] e Movie Gen [PZB+24], che parte dal blocco di Llama 3 e ne sostituisce l’attenzione causale con una bidirezionale piena. Il latente è tagliato in patch da una convoluzione 3D con kernel \((p_t, p_h, p_w)\): in Wan il kernel è \((1, 2, 2)\), quindi con \(c_s = 8\) la sequenza ha \(N = F' \cdot \frac{H}{16} \cdot \frac{W}{16}\) token. È la patchify di DiT con una dimensione in più.
Quando \(p_t > 1\), CogVideoX ripete il primo fotogramma all’inizio della sequenza, in modo che anche un’immagine, che è un solo fotogramma, riempia una patch intera nel tempo e si possa addestrare insieme ai video. Le sequenze che ne escono sono lunghe: Movie Gen si addestra su sequenze fino a circa 73.000 token di video, che corrispondono a 16 secondi a 16 fotogrammi al secondo [PZB+24].
HunyuanVideo dà tre ragioni per l’attenzione unificata: rende meglio di quella divisa in spazio e tempo, consente di generare immagini e video con lo stesso modello, e permette di riusare le accelerazioni sviluppate per i modelli di linguaggio [KTZ+24]. CogVideoX motiva la scelta con il successo dell’addestramento a contesto lungo nei modelli di linguaggio e con l’efficienza di FlashAttention (la sezione su FlashAttention ne spiega il meccanismo).
Con tutti i token nella stessa sequenza, ogni token deve portare con sé la propria posizione, che ora ha tre coordinate: il fotogramma, la riga e la colonna. CogVideoX e HunyuanVideo usano una RoPE a tre componenti, un’estensione della RoPE della sezione sull’architettura del Transformer: i canali di ogni testa di attenzione, cioè i numeri con cui la testa descrive un token, si dividono in tre gruppi, e ogni gruppo ruota secondo una delle tre coordinate. Negli stessi mesi un’estensione analoga compare in Qwen2-VL, un modello di visione e linguaggio, per tempo, altezza e larghezza (si veda come si innestano gli occhi a un modello di linguaggio). In HunyuanVideo i 128 canali di una testa si dividono in 16 per il fotogramma, 56 per la riga e 56 per la colonna. Movie Gen sceglie un’altra strada: somma all’ingresso di ogni strato, e non solo del primo, un vettore di posizione appreso, perché secondo gli autori così le deformazioni diminuiscono, soprattutto nel tempo.
import numpy as np

rng = np.random.default_rng(0)
gruppi = (16, 56, 56)                  # canali per fotogramma, riga, colonna
dk = sum(gruppi)                       # 128 canali, la testa di HunyuanVideo

def ruota(v, pos):
    """RoPE a tre componenti: ogni gruppo di canali ruota con la sua coordinata."""
    out, a = [], 0
    for g, p in zip(gruppi, pos):
        ang = p * 10000.0 ** (-np.arange(g // 2) / (g // 2))
        x1, x2 = v[a:a + g:2], v[a + 1:a + g:2]
        r = np.empty(g)
        r[0::2] = x1 * np.cos(ang) - x2 * np.sin(ang)
        r[1::2] = x1 * np.sin(ang) + x2 * np.cos(ang)
        out.append(r)
        a += g
    return np.concatenate(out)

q, k = rng.normal(size=dk), rng.normal(size=dk)
def punteggio(pn, pm):
    return ruota(q, pn) @ ruota(k, pm)

a = punteggio((2, 5, 7), (1, 3, 9))        # differenze (-1, -2, +2)
b = punteggio((10, 0, 20), (9, -2, 22))    # stesse differenze, altre posizioni
c = punteggio((2, 5, 7), (1, 3, 10))       # una differenza cambiata: colonna +3
print(f"stesse differenze, posizioni diverse: {a:.6f} {b:.6f}")
print(f"differenza in colonna cambiata:       {c:.6f}")
print("coppie ruotate per gruppo:", [g // 2 for g in gruppi])
stesse differenze, posizioni diverse: 11.196085 11.196085
differenza in colonna cambiata:       14.745137
coppie ruotate per gruppo: [8, 28, 28]
La rotazione si fa su ciascun gruppo con la sua coordinata, e il punteggio fra \(\mathbf{q}\) e \(\mathbf{k}\) dipende soltanto dalle tre differenze. Due coppie di token con le stesse differenze (un fotogramma indietro, due righe indietro, due colonne avanti) ma in punti diversi della griglia hanno lo stesso punteggio, 11,196085; basta cambiare una sola differenza, la colonna, perché il punteggio diventi 14,745137. Nei 128 canali di HunyuanVideo i gruppi ruotano 8, 28 e 28 coppie di canali.
Le trentasei tessere dei quattro fogli vengono staccate e messe in fila su un tavolo lungo, e ciascuna può guardare tutte le altre. L’angolo del foglio tre e il centro del foglio due si guardano senza intermediari, quindi il cappello, ovunque sia, lo vede subito chi deve vederlo.
Su un tavolo così le tessere rischiano di diventare un mucchio, perché non si sa più da quale foglio vengano. Ogni tessera porta allora un’etichetta con tre scomparti: il numero del foglio, la riga, la colonna. Quando due tessere si confrontano non leggono i loro indirizzi, leggono la distanza: di quanti fogli, di quante righe e di quante colonne sono separate, scomparto per scomparto. Gli scomparti non sono uguali, e uno scomparto più largo ha più spazio per scrivere la distanza in quella direzione. In uno dei modelli lo scomparto del foglio è largo poco più di un quarto di quelli di riga e di colonna, e chi l’ha costruito non dice perché.
Lo stesso tavolo regge anche una sola fotografia, che è un film da un foglio solo: le stesse tessere e gli stessi attrezzi servono per i due lavori. E tutti gli accorgimenti inventati per far girare più in fretta i tavoli di parole, quelli dei modelli di linguaggio, funzionano anche qui. Il tavolo però ha un prezzo, che sale con la sua lunghezza: più tessere ci sono, più confronti servono.
La RoPE ruota a coppie i canali di \(\mathbf{q}\) e \(\mathbf{k}\) di un angolo proporzionale alla posizione, e il punteggio fra due token dipende solo dalla loro differenza di posizione [SAL+24]. Con le tre coordinate \((i_n, h_n, w_n)\) del token \(n\), cioè il fotogramma, la riga (la posizione lungo l’altezza) e la colonna (lungo la larghezza), la matrice di rotazione relativa è diagonale a blocchi,
dove \(\mathbf{R}_{d}(\delta)\) è la rotazione a coppie di canali, con le frequenze della RoPE, di un angolo proporzionale a \(\delta\), e \(d_F + d_H + d_W\) è la dimensione di una testa, con ciascun termine pari. In HunyuanVideo \(d_F = 16\) e \(d_H = d_W = 56\) su 128 canali; in CogVideoX le frazioni sono 2/8, 3/8 e 3/8. Nessuno dei due report motiva la ripartizione. Il punteggio dipende dunque dalle tre distanze e non dalle posizioni assolute, e ogni coppia di canali ruota alla propria frequenza: un gruppo più largo copre la sua coordinata con più frequenze. Movie Gen percorre l’altra strada: somma agli ingressi di ogni strato un embedding assoluto, la somma di tre vettori appresi, uno per coordinata, e non ruota \(\mathbf{q}\) e \(\mathbf{k}\).
Con l’attenzione piena il token \(q\) guarda direttamente \(x\) in un solo strato, qualunque sia la loro distanza in fotogrammi, righe e colonne. Un’immagine è il caso \(F' = 1\), che passa dagli stessi pesi, e questo rende possibile l’addestramento congiunto di immagini e video; la sequenza unica, inoltre, accetta i kernel d’attenzione sviluppati per i modelli di linguaggio. Il prezzo si paga tutto sul termine \(N^2\) dei punteggi, che nella fattorizzata era \(F'S^2 + SF'^2\).
Il costo dell’attenzione piena rispetto al resto dello strato#
Nella sezione su DiT il termine quadratico dell’attenzione pesava per blocco \(2N^2 d\) contro i \(12Nd^2\) del resto, cioè un rapporto \(N/(6d)\) che a 256 token è piccolo. Con le sequenze dei video quel rapporto smette di esserlo. Per un feed-forward di larghezza qualunque, il rapporto fra il costo dell’attenzione e quello del resto dello strato è
dove \(N\) è il numero di token, \(d\) la larghezza del modello (quanti numeri descrivono ogni token) e \(d_{\text{ff}}\) la larghezza dello strato feed-forward. Al numeratore c’è il lavoro che cresce con le coppie di token, i punteggi e la loro media pesata; al denominatore il lavoro che ogni token fa per conto suo, le proiezioni e il feed-forward. Con \(d_{\text{ff}} = 4d\) si ritrova l’\(N/(6d)\) di DiT. Wan 14B ha \(d = 5120\) e \(d_{\text{ff}} = 13\,824\) (dalla tabella delle configurazioni nel README di Wan 2.1), e un clip di 81 fotogrammi a 1280×720 diventa una sequenza di 75.600 token, quindi \(\rho = 75\,600 / (2 \cdot 5120 + 13\,824) = 75\,600 / 24\,064 \approx 3{,}14\).
# Wan 14B (README di Wan 2.1): larghezza d e strato feed-forward dff
d, dff = 5120, 13824
print(f"2d + dff = {2 * d + dff:,}")

def rapporto(N, d, dff):
    attenzione = 2 * N**2 * d                  # Q K^T e prodotto con V
    lineare = 4 * N * d**2 + 2 * N * d * dff   # proiezioni e feed-forward
    return attenzione / lineare

for N in (75_600, 1_000_000):
    r = rapporto(N, d, dff)
    print(f"N = {N:>9,}: attenzione/resto = {r:5.2f}, "
          f"quota dello strato = {r / (1 + r):.1%}")

# con dff = 4d il rapporto e' N/(6d), come nel DiT
print("dff = 4d, N = 75600:", round(rapporto(75_600, d, 4 * d), 2),
      "contro N/(6d) =", round(75_600 / (6 * d), 2))

# la cross-attention di Wan verso 512 token di testo: proiezioni di query e
# uscita sul video, di chiavi e valori sul testo, e i punteggi N x 512
N, Nt = 75_600, 512
croce = 2 * N * d**2 + 2 * Nt * d**2 + 2 * N * Nt * d
r = 2 * N**2 * d / (4 * N * d**2 + 2 * N * d * dff + croce)
print(f"con la cross-attention: attenzione/resto = {r:.2f}, "
      f"quota dello strato = {r / (1 + r):.1%}")

# fattorizzata contro piena sul clip di Wan: 21 fotogrammi latenti, 3600 token
Fl, S = 21, 3600
N = Fl * S
piena, fattorizzata = N**2, Fl * S**2 + S * Fl**2
print(f"coppie: piena {piena:,}, fattorizzata {fattorizzata:,}")
print(f"rapporto {piena / fattorizzata:.1f}, F'S/(F'+S) = {N / (Fl + S):.1f}")

# blocco fattorizzato: un'attenzione spaziale e una temporale (due serie
# di proiezioni, 8 N d^2) e un feed-forward
blocco_piena = 2 * N**2 * d + 4 * N * d**2 + 2 * N * d * dff
punteggi = 2 * N * (S + Fl) * d
blocco_fatt = punteggi + 8 * N * d**2 + 2 * N * d * dff
print(f"fattorizzata: punteggi = {punteggi / blocco_fatt:.1%} del blocco")
print(f"operazioni del blocco, piena / fattorizzata = "
      f"{blocco_piena / blocco_fatt:.2f}")
2d + dff = 24,064
N =    75,600: attenzione/resto =  3.14, quota dello strato = 75.9%
N = 1,000,000: attenzione/resto = 41.56, quota dello strato = 97.7%
dff = 4d, N = 75600: 2.46 contro N/(6d) = 2.46
con la cross-attention: attenzione/resto = 2.54, quota dello strato = 71.8%
coppie: piena 5,715,360,000, fattorizzata 273,747,600
rapporto 20.9, F'S/(F'+S) = 20.9
fattorizzata: punteggi = 9.5% del blocco
operazioni del blocco, piena / fattorizzata = 2.63
A 75.600 token l’attenzione pesa 3,14 volte il resto dello strato, il 75,9% del totale; a un milione di token 41,56 volte, il 97,7%. Il report di Wan arriva alla stessa conclusione misurando il tempo invece di contare le operazioni: a un milione di token l’attenzione può occupare fino al 95% del tempo di addestramento [WanTeamWA+25]. Con \(d_{\text{ff}} = 4d\) il rapporto sarebbe 2,46: il feed-forward di Wan è largo 2,7 volte \(d\) e non 4, e a parità di sequenza l’attenzione pesa di più. Il conto lascia fuori softmax e normalizzazioni, e anche l’attenzione con cui, in ogni blocco di Wan, i token del video leggono i 512 token del testo, che si chiama cross-attention: contandola, il rapporto scende a 2,54 e la quota al 71,8%.
La fattorizzata riduce le coppie di un fattore 20,9, quasi \(F'\), ma le operazioni del blocco di sole 2,63 volte. In un blocco con un’attenzione spaziale, una temporale e un feed-forward i punteggi scendono al 9,5% del lavoro, e il resto, che non diminuisce e anzi guadagna le proiezioni della seconda attenzione, diventa il grosso del conto.
Il tempo cresce con il quadrato della sequenza, la memoria no: kernel come FlashAttention calcolano i punteggi a pezzi, senza mai scrivere per intero la matrice \(N \times N\), e la memoria delle attivazioni resta lineare nella lunghezza. A un milione di token anche una memoria lineare è troppo grande per una GPU sola, e Wan divide la sequenza fra più GPU lungo l’asse dei token, con il context parallelism [WanTeamWA+25].
Abbassare il termine quadratico vuol dire rinunciare a una parte delle coppie, oppure cambiare l’attenzione. HunyuanVideo 1.5 prende la prima strada con un’attenzione sparsa: divide i token in blocchi tridimensionali, e ogni blocco guarda solo alcuni degli altri, scelti in base alla vicinanza nello spazio e nel tempo e alla somiglianza fra query e chiavi. Secondo il report, su un video di 10 secondi in 720p la generazione diventa così 1,87 volte più rapida che con l’attenzione piena calcolata da FlashAttention-3 [WZL+25]. La seconda strada, un’attenzione il cui costo cresce linearmente con la sequenza, è quella del capitolo sull’attenzione lineare.
Il tavolo lungo ha un conto da pagare, e si fa con le strette di mano. Ogni tessera ha due mestieri. Il primo è stringere la mano a tutte le altre per decidere chi ascoltare: con \(N\) tessere sono \(N\) strette per ciascuna, quindi \(N^2\) in tutto. Il secondo è il lavoro al banco, cioè preparare i propri appunti e poi rielaborarli, che costa uguale a ogni tessera e dipende da quanto è grande il banco, la larghezza del modello.
Finché le tessere sono poche, domina il banco e le strette sono un dettaglio. Con le 75.600 tessere di un clip di 81 fotogrammi a 1280×720, le strette costano 3,14 volte il lavoro al banco, il 75,9% del lavoro di uno strato; con un milione di tessere, 41,6 volte. Conta il rapporto fra il numero di tessere e la grandezza del banco: un banco più grande alleggerisce il peso delle strette, un tavolo più lungo lo appesantisce.
Con il disegnatore e il collaboratore delle prime architetture ogni tessera stringe la mano alle 3.600 del suo foglio e alle 21 che occupano il suo posto nei 21 fogli, invece che alle 75.600 del tavolo, e in tutto le strette sono 20,9 volte meno, un numero vicino ai 21 fogli. Il lavoro al banco però non cala, anzi cresce, perché il collaboratore ha un banco suo. Le strette scendono al 9,5% del lavoro di una passata del disegnatore e una del collaboratore prese insieme, e il lavoro totale si riduce di 2,6 volte, non di 21.
Per uno strato, in moltiplicazioni-somme, l’attenzione costa \(2N^2 d\) (\(\mathbf{Q}\mathbf{K}^{\top}\) e il prodotto con \(\mathbf{V}\)), le quattro proiezioni \(4Nd^2\) e il feed-forward a due matrici \(2Nd\,d_{\text{ff}}\), quindi
e la quota dell’attenzione nello strato è \(\rho/(1+\rho)\): con le dimensioni di Wan 14B, 75,9% a \(N = 75\,600\) e 97,7% a \(N = 10^6\). Il report di Wan [WanTeamWA+25] scrive il costo di uno strato come un termine in \(N d^2\) più uno in \(N^2 d\), con coefficiente 4 per il secondo nel passo in avanti e 8 in quello all’indietro: in operazioni in virgola mobile, due per ogni moltiplicazione-somma, è il numeratore \(2N^2 d\) di \(\rho\). Il suo «fino al 95%» del tempo a \(N = 10^6\) è una conferma d’ordine di grandezza e non un’uguaglianza, perché il tempo dipende dall’efficienza dei kernel, che per l’attenzione non è quella dei prodotti fra matrici dense. La formula vale per un blocco senza cross-attention; con \(N_{\text{testo}}\) token di testo in cross-attention il denominatore diventa \(3d + d_{\text{ff}} + N_{\text{testo}}(1 + d/N)\), e per Wan \(\rho\) scende a 2,54.
La fattorizzazione sostituisce \(N^2\) con \(N(S + F')\) nel termine dei punteggi, un rapporto \(F'S/(F'+S) \approx F'\) per \(S \gg F'\); con \(F' = 21\) e \(S = 3600\) vale 20,9. In un blocco con un’attenzione spaziale, una temporale e un feed-forward, però, le proiezioni raddoppiano, e il rapporto fra le operazioni del blocco pieno e di quello fattorizzato è
che sul clip di Wan vale 2,63. Il guadagno cresce con \(N\), ma resta lontano dal rapporto fra le coppie finché \(N\) è confrontabile con la larghezza dello strato.
Il conto non vede la memoria, e FlashAttention, che la tiene lineare in \(N\), riduce il traffico di memoria senza ridurre le operazioni. Il report di Wan scrive la memoria delle attivazioni come proporzionale a \(LNd\), con \(L\) il numero di strati, e per il modello da 14B a \(N = 10^6\) la stima supera comunque gli 8 TB [WanTeamWA+25]. Oltre a dividere la sequenza fra più GPU, Wan sposta le attivazioni nella memoria della CPU mentre calcola: con sequenze così lunghe il trasferimento delle attivazioni di uno strato si nasconde dietro il calcolo di uno, due o tre strati. In inferenza lo stesso report descrive una cache di diffusione: su alcuni passi, scelti su un insieme di validazione, il modello riusa il risultato dell’attenzione calcolato a un passo vicino, e calcola solo ogni qualche passo la parte incondizionata della guida senza classificatore.
Come entra il testo: cross-attention o flusso unico#
Il testo della richiesta arriva al generatore già codificato da un encoder testuale, come una sequenza di token di testo, e deve raggiungere i token del video. Le strade sono due.
La prima è la cross-attention, un’attenzione fra due sequenze diverse: i token del video fanno da query, i token del testo da chiavi e valori. Ogni token del video sceglie così quanto ascoltare ciascun token del testo, mentre il testo non viene mai modificato. Wan [WanTeamWA+25] e Movie Gen [PZB+24] hanno uno strato di cross-attention in ogni blocco, fra l’attenzione dei token del video fra loro (la self-attention) e il feed-forward.
La seconda strada mette i token del testo nella stessa sequenza dei token del video, come fa con le immagini l’MM-DiT: testo e video si guardano a vicenda, e anche il testo viene aggiornato strato dopo strato. HunyuanVideo [KTZ+24] lo fa in due tempi. Nei primi blocchi, a flusso doppio, testo e video hanno ciascuno i propri pesi, ma l’attenzione si calcola sulle due sequenze insieme; nei blocchi successivi, a flusso unico, anche i pesi diventano comuni. CogVideoX [YTZ+25] usa pesi comuni fin dal primo blocco.
In tutti questi modelli il passo di diffusione \(t\) entra per modulazione, come nell’adaLN-zero di DiT: una piccola rete, un MLP, traduce \(t\) nelle scale, negli spostamenti e nelle porte che regolano ogni strato. Wan usa un solo MLP per tutti i blocchi invece di uno per blocco. Il costo delle due strade per il testo e quello delle due scelte per la modulazione si contano sulle dimensioni di Wan e di DiT-XL/2.
# coppie di attenzione: il clip di Wan (75.600 token) e 512 token di testo
N, Nt = 75_600, 512
print(f"cross-attention: N x Nt = {N * Nt:,}, "
      f"{N * Nt / N**2:.2%} delle coppie della self-attention")
print(f"flusso unico: (N + Nt)^2 = {(N + Nt)**2:,}, "
      f"{(N + Nt)**2 / N**2 - 1:.2%} di coppie in piu'")

# modulazione dal passo t: uno strato lineare d -> 6d in ogni blocco,
# oppure uno solo condiviso piu' un bias di 6d numeri per blocco
for nome, L, d in (("DiT-XL/2", 28, 1152), ("Wan 1.3B", 30, 1536),
                   ("Wan 14B", 40, 5120)):
    per_blocco = L * 6 * d * d
    condiviso = 6 * d * d + L * 6 * d
    print(f"{nome:9}: un MLP per blocco {per_blocco / 1e9:.2f} miliardi "
          f"di pesi, condiviso {condiviso / 1e6:.1f} milioni")
cross-attention: N x Nt = 38,707,200, 0.68% delle coppie della self-attention
flusso unico: (N + Nt)^2 = 5,793,036,544, 1.36% di coppie in piu'
DiT-XL/2 : un MLP per blocco 0.22 miliardi di pesi, condiviso 8.2 milioni
Wan 1.3B : un MLP per blocco 0.42 miliardi di pesi, condiviso 14.4 milioni
Wan 14B  : un MLP per blocco 6.29 miliardi di pesi, condiviso 158.5 milioni
Con 512 token di testo contro 75.600 di video, la cross-attention aggiunge lo 0,68% delle coppie della self-attention e la sequenza comune l’1,36%: la scelta fra le due strade non si decide sul costo. La modulazione invece pesa. Nel Wan da 14 miliardi di parametri un MLP per blocco ne costerebbe 6,29 miliardi, uno condiviso 158,5 milioni.
La richiesta scritta del cliente deve arrivare al tavolo, già tradotta in una fila di parole che la rete sa leggere, e le strade sono due. La prima è appenderla a una bacheca che le tessere possono consultare a ogni strato: guardano la bacheca e si regolano, ma la bacheca non guarda le tessere e non cambia mai, per quanto lavoro ci sia intorno. È una consultazione a senso unico, e si chiama cross-attention.
La seconda è far sedere le parole della richiesta allo stesso tavolo delle tessere. Le parole sono poche rispetto alle tessere, quindi il tavolo si allunga appena. Nei primi strati parole e tessere si guardano già a vicenda, ma ciascun gruppo lavora con i suoi attrezzi, perché le parole sanno fare cose che le tessere non sanno fare e viceversa. Poi anche gli attrezzi diventano comuni, e per tutti gli strati successivi parole e tessere lavorano come un gruppo solo. In tutti e due i momenti le parole guardano le tessere e ne vengono cambiate: «acquerello» si accorge di che cosa sta succedendo nel disegno.
Con l’una e con l’altra strada c’è anche la regia, come nella torre di DiT: una voce in auricolare che a ogni strato dice a che punto della pulitura siamo, cioè quanto rumore resta da togliere. A ogni strato il messaggio viene tradotto in sei manopole, tre per lo sguardo fra le tessere e tre per il lavoro al banco, che regolano quanto forte arriva il materiale e quanto del lavoro nuovo si aggiunge. In un’organizzazione c’è un traduttore per ogni strato; in un’altra il traduttore è uno solo per tutti, e ogni strato si limita ad aggiungere la propria correzione personale a ciò che il traduttore consegna. La seconda organizzazione costa molte meno persone, e le persone risparmiate conviene metterle a lavorare in strati in più.
Nella cross-attention i token del video \(\mathbf{X}\) producono le query, e il testo codificato \(\mathbf{c} \in \mathbb{R}^{N_{\text{testo}} \times d}\), una riga per token di testo, produce chiavi e valori:
con \(\mathbf{c}\) fisso in tutti gli strati: l’informazione va in una direzione sola, e i punteggi sono \(N \times N_{\text{testo}}\), lineari in \(N\). Wan codifica il testo con umT5, un encoder multilingue e bidirezionale, in 512 token [WanTeamWA+25].
Nel flusso doppio di HunyuanVideo ciascuna modalità ha proiezioni, modulazione e feed-forward propri, e secondo il report così ognuna impara la propria modulazione senza interferenze. L’attenzione però, nel codice pubblicato, è congiunta, come nell’MM-DiT:
dove ogni matrice è proiettata con i pesi della propria modalità e \([\,\cdot\,;\,\cdot\,]\) concatena le righe. Anche \(\mathbf{c}\) viene quindi aggiornato a ogni blocco. Nel flusso unico la concatenazione \([\mathbf{X};\mathbf{c}]\) passa anche da pesi comuni. HunyuanVideo ha 20 blocchi a flusso doppio e 40 a flusso unico, larghezza 3072, feed-forward 12288 e 24 teste da 128 canali [KTZ+24]. In entrambi i casi i punteggi sono \((N + N_{\text{testo}})^2\), e con le dimensioni di Wan il testo aggiunge l’1,36% a \(N^2\). CogVideoX concatena video e testo con pesi comuni fin dal primo blocco, e tiene distinte soltanto le layer norm adattive dei token visivi e di quelli testuali, perché i due spazi possono avere perfino scale numeriche diverse [YTZ+25].
Anche la scelta dell’encoder è una scelta di architettura. Quello di Wan è bidirezionale; HunyuanVideo usa invece, al posto di T5, un modello linguistico multimodale decoder-only, con tre ragioni dichiarate: l’allineamento fra immagine e testo che il modello acquista con l’addestramento sulle istruzioni visive, la capacità di descrivere i dettagli e quella di seguire istruzioni di sistema. Poiché l’attenzione di un decoder è causale, un raffinatore bidirezionale dei token compensa; il token finale di CLIP-Large entra invece nell’embedding del passo, come guida globale, e non nella sequenza [KTZ+24]. Movie Gen concatena i token di tre encoder, UL2, ByT5 (solo per il testo che deve comparire scritto nel video) e un MetaCLIP esteso a 256 token, e regola la durata premettendo al prompt la frequenza di campionamento del clip, per esempio «FPS-16» [PZB+24].
Per il passo \(t\), come in DiT, un MLP predice scala, spostamento e porta di ciascun sotto-strato, sei vettori di dimensione \(d\). Un MLP per blocco, cioè uno strato lineare da \(d\) a \(6d\) in ognuno degli \(L\) blocchi, costa \(6Ld^2\) pesi: 0,22 miliardi in DiT-XL/2, quasi un terzo dei 675 milioni della rete, 0,42 nel Wan da 1,3 miliardi e 6,29 in quello da 14. In Wan l’MLP è unico (\(\mathrm{Linear}\) più SiLU) e ogni blocco somma alle sei uscite un proprio bias appreso, \(6d\) numeri: condiviso, costa 14,4 milioni di pesi nel modello da 1,3 miliardi e 158,5 milioni in quello da 14, e secondo il report la condivisione toglie circa un quarto dei parametri. Nell’ablazione del report, su un compito da testo a immagine, la modulazione per blocco porta il modello da 30 blocchi da 1,3 a 1,7 miliardi di parametri (la differenza è dell’ordine di quei 0,42 miliardi), e a parità di parametri conviene spenderli in profondità: con 1,5 miliardi, 35 blocchi a modulazione condivisa ottengono una perdita d’addestramento più bassa di 30 blocchi con la modulazione condivisa solo nella prima metà, e il modello da 1,7 miliardi con un MLP per blocco non fa meglio [WanTeamWA+25].
In Wan 2.2 il denoiser si divide in due esperti, uno per i livelli di rumore alti, che fissa l’impostazione generale, e uno per quelli bassi, che rifinisce i dettagli: circa 14B ciascuno, 27B in tutto e 14B attivi per passo [WanTeam25]. È una mixture of experts in cui la scelta dell’esperto dipende dal livello di rumore, tramite una soglia sul rapporto segnale-rumore, e non dal contenuto del token, a differenza dell’instradamento dei modelli di linguaggio.
Le due strade rispondono a una domanda diversa: se il testo debba solo orientare il video, come nella cross-attention, o anche essere aggiornato dal video strato dopo strato, come nei flussi di HunyuanVideo.
Da ricordare
I primi generatori video aggiungono il tempo a un disegnatore che sa fare un foglio solo: dopo ogni sua passata sul foglio, un collaboratore guarda la stessa tessera attraverso i fogli, e ogni passata è uno strato. Il collaboratore parte con il volume a zero, quindi all’inizio non cambia niente; con una manopola, e il disegnatore mai toccato, si ritrovano i disegni di partenza in qualunque momento.
Il prezzo è che l’oggetto che si sposta da una tessera all’altra fra due fogli non si vede direttamente: arriva per interposta tessera, mescolato al resto del foglio, e far passare le cose così è difficile da imparare. Per questo si è passati a un tavolo lungo dove ogni tessera guarda tutte le altre.
Sul tavolo lungo ogni tessera porta un’etichetta con tre scomparti, foglio, riga e colonna, e due tessere si confrontano sulle distanze, non sugli indirizzi.
Il tavolo lungo costa: con un clip di 81 fotogrammi a 1280×720 le strette di mano pesano 3,14 volte il lavoro al banco, e crescono con la lunghezza del tavolo. Le passate alterne tagliano le strette di quasi 21 volte, ma il lavoro totale solo di 2,6.
La richiesta scritta arriva o da una bacheca consultata a ogni strato, che non cambia mai, o da un tavolo condiviso dove parole e tessere si guardano e anche le parole si lasciano cambiare.
Da ricordare
L’attenzione fattorizzata [HSG+22] alterna uno strato spaziale (su \(S\) token, fotogramma per fotogramma) e uno temporale (su \(F'\) token, posto per posto), con \(F'S^2 + SF'^2\) coppie invece di \((F'S)^2\). Innestata in un modello di immagini con la proiezione d’uscita a zero, parte identica a quello [SPH+23]; con gli strati spaziali congelati e la fusione \(\alpha\mathbf{z} + (1-\alpha)\mathbf{z}'\), \(\alpha = 1\) lo restituisce in qualunque momento [BRL+23].
Il limite è l’accoppiamento per posto: due token di fotogrammi diversi e di posti diversi si raggiungono solo dopo la coppia di strati, attraverso un terzo token che li mescola al resto del fotogramma; nelle ablazioni di CogVideoX la versione fattorizzata impara peggio ed è instabile [YTZ+25].
L’attenzione 3D piena mette gli \(N = F'S\) token in una sequenza, con una RoPE a tre componenti (fotogramma, riga, colonna) che ruota gruppi di canali separati, così che il punteggio dipenda solo dalle tre differenze [KTZ+24].
Il rapporto fra attenzione e resto dello strato è \(\rho = N/(2d + d_{\text{ff}})\), che per \(d_{\text{ff}} = 4d\) è \(N/(6d)\); con le dimensioni di Wan 14B a 75.600 token vale 3,14 (2,54 contando la cross-attention). La fattorizzata riduce le coppie di circa \(F'\) volte, ma le operazioni del blocco solo di 2,63, perché il termine lineare resta e cresce.
Il testo entra per cross-attention (Wan, Movie Gen), a senso unico e lineare in \(N\), o per un flusso doppio e poi unico (HunyuanVideo), con l’attenzione congiunta fin dal primo blocco. Il passo \(t\) entra per modulazione; in Wan un MLP condiviso fra i blocchi, con bias propri, toglie circa un quarto dei parametri [WanTeamWA+25].
Il denoiser è completo: una sequenza di \(N\) token in cui ognuno guarda tutti gli altri, con il testo che entra per cross-attention o per un flusso comune. Resta da dire con quali dati e con quale obiettivo lo si addestra, e come si misura se muove davvero i fotogrammi: lo racconta la sezione su come si insegna il movimento.