


Alberi decisionali e metodi ensemble#
C’è un gioco da tavolo, Indovina chi?, in cui si scopre il personaggio misterioso dell’avversario a forza di domande sì/no: «Porta gli occhiali?», «Ha i capelli neri?». Ogni risposta abbatte a metà i sospetti, finché non ne resta uno solo. È così che ragiona un albero decisionale: una catena di domande sulle caratteristiche di un esempio, ciascuna scelta per dividere i casi nel modo più netto possibile, fino a una risposta.
Nelle sezioni precedenti abbiamo incontrato modelli lineari: la regressione lineare traccia una retta che segue i punti, la logistica una retta che li divide. Le spline e i modelli additivi quella retta la piegavano, tenendola una curva sola e liscia; gli alberi fanno la mossa opposta, che è spezzarla.
Gli alberi appartengono a un’altra famiglia, e hanno un terreno in cui eccellono: i dati in tabella, quelli a righe e colonne di un foglio di calcolo, dove ogni colonna è una caratteristica di natura diversa (un’età, un reddito, una categoria). Su questo terreno gli alberi, e ancora di più i gruppi di alberi messi a votare insieme, restano difficili da battere per le reti neurali sui dati di taglia media, dell’ordine dei diecimila esempi [GOV22]; fuori da quella scala il confronto resta aperto.
C’è poi una ragione in più per studiarli: un albero poco profondo è interpretabile. Lo si può leggere, stampare, seguire domanda per domanda: è un modello trasparente (white box), al contrario di una scatola nera (black box) che dà la risposta senza dire perché (una grande rete neurale, il modello dei prossimi capitoli, è il caso tipico). Quando la decisione conta (un prestito negato, una diagnosi), poter spiegare il perché è un requisito. La trasparenza ha però un limite di taglia: un albero di migliaia di foglie non si legge più, e una foresta di centinaia di alberi non si legge affatto.
L’albero decisionale: dividere per domande#
L’algoritmo classico per costruire questi alberi si chiama CART (Classification And Regression Trees), introdotto nel 1984 da Leo Breiman e colleghi [BFOS84]. L’idea è cercare, a ogni nodo, la domanda che separa meglio i dati, e ripeterla, ricorsivamente, su ciascuno dei due gruppi che ne risultano.
L’albero è fatto di nodi, e ogni nodo è una domanda: si parte da quello in cima (la radice), si scende a destra o a sinistra secondo la risposta, e si finisce in un nodo che non ha più domande sotto di sé (una foglia), dove sta la risposta finale. Sì, a testa in giù: in informatica gli alberi si disegnano con la radice in alto e le foglie in basso, per convenzione. Che poi la stessa procedura si applichi identica a ogni sottogruppo che si forma, all’infinito finché c’è qualcosa da dividere, è ciò che si intende dicendo che l’albero si costruisce ricorsivamente.
Ogni domanda è una soglia su una caratteristica: «reddito < 25 000 €?», «età < 30?». Una risposta manda l’esempio a sinistra, l’altra a destra, e un taglio del genere si chiama, in gergo, uno split. Ricordando che ogni colonna è una direzione e ogni esempio un punto, ogni split taglia lo spazio delle caratteristiche (il foglio su cui abbiamo disegnato i punti) in rettangoli con i lati paralleli agli assi (Fig. 4.22): una domanda sul reddito è una riga orizzontale, una sull’età una riga verticale, e non c’è modo di ottenere un taglio in diagonale. Ogni foglia dell’albero è una di quelle regioni, e a tutti i punti che vi cadono l’albero assegna la stessa risposta.

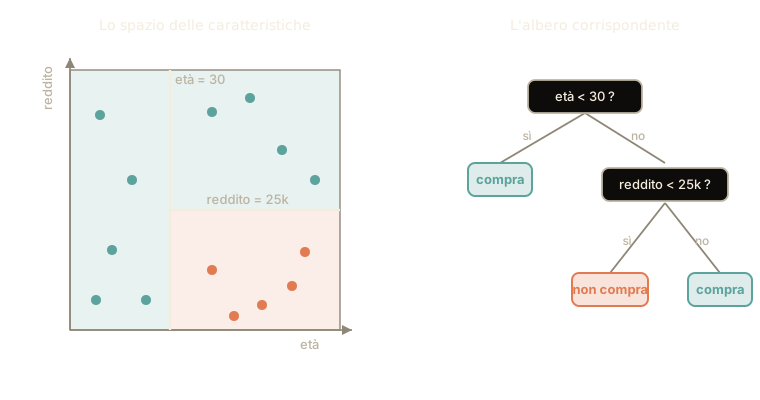
Fig. 4.22 Un albero decisionale partiziona lo spazio in rettangoli. A sinistra il piano età–reddito tagliato da due split; a destra l’albero corrispondente. Ogni foglia colorata è una regione del piano, e a tutta la regione l’albero assegna la stessa classe.#
Ma cosa vuol dire, in numeri, «separare meglio»? Serve una misura di quanto un gruppo è impuro, cioè mescolato tra classi diverse. Un gruppo tutto di una classe è puro (impurità zero); un gruppo metà e metà è il più impuro possibile. La domanda migliore è quella che, dopo lo split, lascia i due gruppi il più puri possibile.
Un negozio online vuole sapere in anticipo chi comprerà. Sul bancone c’è un barattolo con dieci biglietti, uno per ogni cliente già passato di lì, e sopra ciascuno c’è scritto se ha comprato. Cinque sì, cinque no.
Il proprietario ci gioca. Pesca un biglietto e quella diventa la sua scommessa; lo rimette dentro, ne pesca un altro, e su quel secondo cliente prova a indovinare. Ci prende quando i due pescati dicono la stessa cosa. Se chi compra occupa una frazione \(p\) del barattolo, pescarlo capita nel \(p\) dei casi alla prima pescata e nel \(p\) dei casi alla seconda, e siccome la seconda non sa niente della prima le probabilità si moltiplicano, \(p \cdot p = p^2\). La somma di quei quadrati sulle due risposte dà la probabilità che le pescate coincidano, cioè di indovinare. O coincidono o sono diverse, senza terze vie, e allora sbagliare ha probabilità \(1\) meno quella somma. Ecco da dove viene l’«uno meno la somma dei quadrati».
Quanto spesso il barattolo inganna chi ci gioca si chiama indice di Gini, ed è la misura di impurità più usata. Un barattolo di soli acquirenti non fa sbagliare mai, e il suo Gini vale zero; questo, metà e metà, inganna più di ogni altro.
Il proprietario ora divide i biglietti in due barattoli, secondo la domanda «ha visitato il sito almeno 3 volte?». Nel barattolo dei «sì», chi ha visitato il sito almeno 3 volte, finiscono 4 biglietti, e sono tutti e 4 acquirenti; in quello dei «no» ne finiscono 6, e uno solo ha comprato. (Il «padre» nei conti è il barattolo di partenza, prima della divisione.)
Nel primo barattolo non si sbaglia più, nel secondo quasi mai. Per sapere quanto inganna la coppia si gioca in tutti e due, ma non alla pari, perché nel barattolo da 6 si pesca più spesso che in quello da 4. Ognuno conta per la sua quota, ed è una media pesata:
Il guadagno è quanto è calato l’inganno, \(0{,}5 - 0{,}167 = 0{,}333\). Un bel taglio. Il proprietario prova ogni domanda su ogni colonna della tabella, tiene quella che gli rende di più, e ricomincia il gioco dentro ciascuno dei due barattoli nuovi.
Sul reddito le domande sembrano infinite, minore di 25 000, di 25 001, di 25 002… Allora mette i biglietti in fila per reddito e cerca dove infilare le forbici. Se fra 24 000 e 26 000 euro non c’è nessun cliente, tagliare a 24 500 o a 25 900 sposta gli stessi biglietti, ed è la stessa domanda scritta in mille modi. Contano solo i tagli fra un biglietto e il suo vicino di fila: con diecimila clienti in coda, al massimo novemilanovecentonovantanove per colonna.
Il proprietario non torna mai sui suoi passi. I barattoli non si rovesciano, e la prima domanda resta quella che rendeva di più subito. Una domanda un po’ peggiore in cima poteva preparare due domande ottime al giro dopo, e un albero finale migliore; nessuno lo scoprirà, perché quella strada non l’ha percorsa. In cambio l’albero si costruisce in fretta, e che sia il migliore possibile non glielo promette nessuno.
Sia \(p_k\) la frazione di esempi di classe \(k\) in un nodo. Le due misure di impurità classiche sono l’indice di Gini e l’entropia:
dove \(K\) è il numero di classi. Entrambe valgono \(0\) su un nodo puro (\(p_k = 1\) per una sola classe) e sono massime sulla distribuzione uniforme. La qualità di uno split che manda una frazione \(w_L\) degli esempi nel figlio sinistro e \(w_R = 1 - w_L\) nel destro si misura con la riduzione di impurità (con l’entropia si chiama information gain):
dove \(I\) è l’impurità scelta (Gini o entropia) e \(w_L, w_R\) pesano i figli per la loro numerosità. CART sceglie, tra tutte le coppie (caratteristica, soglia), quella che massimizza \(\Delta\), e procede in modo ricorsivo e greedy: nessun passo indietro, ogni split è ottimo solo localmente.
Perché non usare direttamente l’errore di classificazione \(1 - \max_k p_k\)? Perché non è strettamente concavo, e non distingue split che Gini ed entropia distinguono: da un padre con \((400, 400)\) esempi, gli split \((300,100) + (100,300)\) e \((200,400) + (200,0)\) hanno lo stesso errore, \(0{,}25\), ma Gini (\(0{,}375\) contro \(0{,}333\)) ed entropia (\(0{,}811\) contro \(0{,}689\) bit) preferiscono il secondo, che ha un figlio puro e lascia più spazio agli split successivi [HTF09]. E il procedimento è greedy per necessità: trovare l’albero binario ottimo è NP-completo [HR76].
Un esempio numerico con l’entropia. Una domanda sì/no divide dieci esempi, cinque per classe, in un figlio «sì» di quattro tutti della stessa classe e in un figlio «no» di sei, dove una delle due classi compare una volta sola. Il nodo padre bilanciato ha \(H_\text{padre} = -\tfrac{1}{2}\log_2\tfrac{1}{2} - \tfrac{1}{2}\log_2\tfrac{1}{2} = 1\) bit. Il figlio «sì» è puro (\(H = 0\)); il figlio «no» ha
L’entropia media dopo lo split è \(\tfrac{4}{10}\cdot 0 + \tfrac{6}{10}\cdot 0{,}650 = 0{,}390\) bit, e l’information gain vale \(1 - 0{,}390 = 0{,}610\) bit. Fra Gini ed entropia l’accuratezza finale cambia raramente, e la scelta si fa di solito per altro: gli alberi che ne escono, però, non coincidono, e senza un tetto di profondità, su dati rumorosi, possono dissentire su una parte non piccola degli esempi. Gini è un po’ più veloce (niente logaritmi) ed è la scelta di default in scikit-learn.
Per predire, un esempio nuovo scende lungo l’albero rispondendo alle domande, fino a una foglia: la sua classe è quella di maggioranza tra gli esempi di addestramento finiti in quella foglia.
Lo stesso meccanismo vale se la risposta da prevedere è un numero invece che una categoria, cioè in regressione. Cambiano due cose. La prima è cosa c’è scritto nella foglia: non più una classe, ma la media dei valori degli esempi che ci sono finiti dentro. La seconda è la misura da minimizzare: al posto del Gini si cerca il taglio che rende i valori di ciascun gruppo il più possibile vicini alla loro media, e la misura è quella già usata per la retta di best fit (scarto fra vero e previsto, al quadrato, mediato: l’errore quadratico medio). Il risultato non è una retta ma una funzione «a scalini», costante su ogni rettangolo.
Il tallone d’Achille: un albero è instabile#
Un albero lasciato crescere senza freni continua a dividere finché ogni foglia è pura, cioè finché dentro non c’è più di una classe: a quel punto classifica alla perfezione i dati di addestramento, e fra l’errore di addestramento e quello di test si apre un divario grande. Qualche foglia finisce con un esempio solo, ma non è la regola: quello che ferma la crescita è la purezza. È l’overfitting della sezione su overfitting e validazione, nella sua forma più estrema.
Un albero profondo è come lo studente che impara a memoria: costruisce domande su misura anche per i singoli esempi, rumore compreso. Il problema è che è anche instabile. Cambia appena qualche dato di addestramento (togline dieci, aggiungine altri dieci) e l’albero può risultare completamente diverso: uno split scelto in cima cambia, e tutto ciò che ci sta sotto cambia con lui.
Nella sezione sul compromesso bias-varianza avevamo dato un nome a questa irrequietezza: si chiama varianza. Un singolo albero profondo ha bias basso (sa adattarsi a qualsiasi forma) ma varianza alta (dipende troppo dal particolare campione di dati).
Il freno più ovvio è tenerlo corto: fermare la crescita a una certa profondità, pretendere che ogni foglia contenga almeno una ventina di esempi, oppure tagliare i rami più bassi dopo averlo cresciuto. Un albero corto sta fermo, e insieme all’irrequietezza perde anche la finezza: smette di seguire le forme che nei dati ci sono davvero, e comincia a sbagliare sempre allo stesso modo. La varianza scende, il bias sale, e il conto torna quasi uguale. Ridurre quella varianza senza perdere la flessibilità: è tutto il problema che gli ensemble risolvono.
Nel linguaggio del compromesso bias-varianza, un albero cresciuto a fondo è un modello a bias basso, varianza alta: la sua espressività gli permette di approssimare frontiere di decisione arbitrarie, ma la scelta greedy degli split è estremamente sensibile alle fluttuazioni del campione. Piccole perturbazioni dei dati si propagano dalla radice alle foglie, cambiando l’intera struttura.
Lo si può limitare vincolando la crescita (profondità massima, numero minimo di esempi per foglia) oppure con la potatura di costo-complessità di CART [BFOS84]: cresciuto l’albero pieno \(T_0\), fra i suoi sottoalberi \(T\) si minimizza
dove \(R(T)\) è l’errore sulle foglie e \(|T|\) il loro numero. Al crescere di
\(\alpha\) si toglie per primo il nodo interno che costa meno errore per foglia
risparmiata (weakest link pruning), e ne esce una successione annidata di
sottoalberi fra cui si sceglie per cross-validation: in scikit-learn è
ccp_alpha, e cost_complexity_pruning_path restituisce i valori critici.
Quanto al costo, con le colonne preordinate lo split migliore di un nodo con
\(m_t\) esempi si trova in \(O(d\,m_t)\), e un albero bilanciato costa
\(O(d\,m\log m)\) in addestramento e \(O(\log m)\) per predizione. Questi freni,
però,
scambiano varianza con bias, e un solo albero raramente compete con i modelli
migliori. La strada vincente è un’altra: tenere alberi flessibili (bias basso)
e abbattere la varianza combinandone molti. È il principio degli ensemble.
Ensemble: la saggezza della folla#
Chiedi a una sola persona quante caramelle ci sono nel barattolo e sbaglierà di parecchio. Chiedilo a mille persone e fai la media delle risposte: il numero sarà sorprendentemente vicino al vero. Gli errori individuali, se indipendenti, tendono a elidersi. È la saggezza della folla, e i metodi ensemble la mettono al lavoro: invece di un modello solo, ne addestrano molti e ne combinano le risposte.

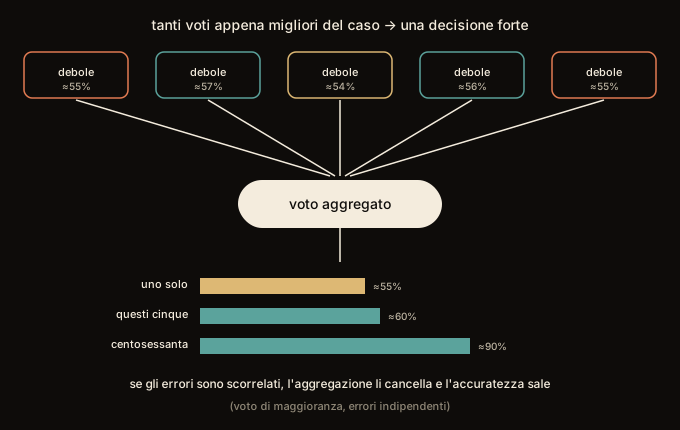
Fig. 4.23 Cinque modelli che da soli azzeccano poco più di una volta su due, messi a votare arrivano al sessanta: cinque punti guadagnati. Per arrivare al novanta di votanti ne servono centosessanta, e serve per giunta una condizione che il disegno non può mostrare.#
La condizione nascosta in Fig. 4.23 è l’indipendenza degli errori. Se i cinque modelli sbagliassero sugli stessi esempi e nello stesso modo, la media non correggerebbe niente: riprodurrebbe l’errore comune con più sicurezza di prima.
Ci sono due strategie profondamente diverse per farlo, e vanno tenute distinte fin da subito (Fig. 4.24): il bagging addestra i modelli in parallelo, indipendenti l’uno dall’altro, e ne fa la media; il boosting li addestra in sequenza, ognuno per correggere gli errori del precedente.

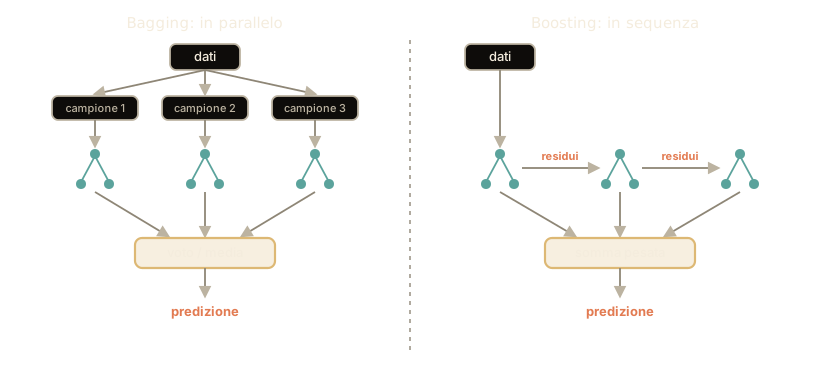
Fig. 4.24 Le due grandi famiglie di ensemble. Nel bagging (sinistra) gli alberi sono addestrati in parallelo su campioni diversi e votano alla pari. Nel boosting (destra) sono addestrati in sequenza, ognuno sugli errori del precedente, e sommati con pesi.#
Bagging: mediare per ridurre la varianza#
Il bagging (da bootstrap aggregating, proposto da Breiman nel 1996 [Bre96a]) attacca direttamente la varianza degli alberi. Da un training set di \(m\) esempi estrae \(B\) campioni bootstrap, ciascuno di \(m\) esempi presi a caso con reimmissione (lo stesso esempio può uscire più volte, e altri non uscire affatto), addestra un albero su ciascuno e ne fa votare le predizioni, o ne fa la media in regressione. Lo stesso ricampionamento, usato per misurare quanto è incerta una stima, è il tema della sezione sul bootstrap.
Come si ottengono dataset diversi avendone uno solo? Con il bootstrap: si pesca a caso dal mucchio degli esempi, rimettendo ogni volta dentro quello appena pescato. È come pescare da un mazzo di carte guardando la carta e rimettendola nel mazzo prima di pescare di nuovo: nella nuova mano qualche carta capiterà due o tre volte e qualche altra non uscirà affatto. Ogni campione così ottenuto è una versione un po’ storta dell’originale, e ogni volta storta in modo diverso.
Su ognuno di questi campioni si addestra un albero. Ne escono, poniamo, 100 alberi tutti diversi. Per classificare un esempio nuovo, li si interpella tutti e si fa votare a maggioranza (o, in regressione, la media delle loro risposte). Il singolo albero è nervoso e sbaglia in modo imprevedibile; ma se gli errori dei 100 alberi non sono tutti uguali, mediando si annullano a vicenda, e la risposta collettiva è molto più stabile. Il bias resta quello di un albero (basso), la varianza crolla.
Quanto crolla dipende da che cosa gli alberi hanno in comune. L’errore di un albero ha due parti: una che è sua e soltanto sua (dipende da quali esempi gli sono capitati in mano) e una che condivide con tutti gli altri (viene dal mucchio di partenza, che è uno solo). La prima si smorza contando gli alberi: mediandone cento, la sua varianza si divide per cento. La seconda non si smorza affatto, perché sta in tutte le risposte allo stesso modo, e la media la ritrova identica. C’è quindi un pavimento sotto il quale aggiungere alberi non fa scendere più niente, e quel pavimento è alto quanto gli alberi si somigliano fra loro.
Perché mediare abbassa la varianza si vede con un conto. Siano \(\hat{f}_1, \dots, \hat{f}_B\) le predizioni di \(B\) alberi, ciascuna con varianza \(\sigma^2\) e correlazione a due a due \(\rho\). La varianza della loro media è
dove \(\sigma^2\) è la varianza del singolo modello e \(\rho\) la correlazione tra due modelli distinti. Il secondo termine svanisce all’aumentare di \(B\): con molti alberi resta solo \(\rho\,\sigma^2\). La media riduce dunque la varianza tanto più quanto i modelli sono decorrelati (cioè quanto \(\rho\) è piccolo). Qui sta il limite del bagging puro: alberi addestrati su campioni bootstrap dello stesso dataset restano abbastanza correlati; se una caratteristica è molto predittiva, quasi tutti gli alberi la scelgono in cima e finiscono per somigliarsi. È il collo di bottiglia che la foresta casuale rimuove.
La formula dice quanto si guadagna, non che non si possa perdere. Per la perdita quadratica non si perde: detto \(\varphi(\mathbf{x}) = \mathbb{E}_{\mathcal{D}}[\hat f(\mathbf{x})]\) il predittore aggregato ideale, la disuguaglianza di Jensen dà \(\mathbb{E}_{\mathcal{D}}\bigl[(y - \hat f(\mathbf{x}))^2\bigr] \ge (y - \varphi(\mathbf{x}))^2\), e la differenza è la varianza di \(\hat f(\mathbf{x})\). Per la perdita 0-1 la garanzia non c’è: dove un classificatore sbaglia più spesso di quanto azzecchi, il voto lo fa sbagliare sempre, e aggregare un classificatore cattivo lo peggiora [HTF09]. Il voto di maggioranza amplifica: migliora i votanti sopra il \(50\%\), peggiora quelli sotto.
Random Forest: decorrelare gli alberi#
Il bagging ha un limite: la varianza che resta dipende da quanto gli alberi si somigliano, e gli alberi di un bagging tendono proprio a somigliarsi, perché sono cresciuti sugli stessi dati: se una colonna è nettamente la più informativa, ognuno la sceglierà come prima domanda, e da lì in poi le loro strade saranno parenti strette.
La foresta casuale (random forest), sempre di Breiman, nel 2001 [Bre01a], aggiunge al bagging una seconda dose di casualità mirata proprio a rompere quella somiglianza.

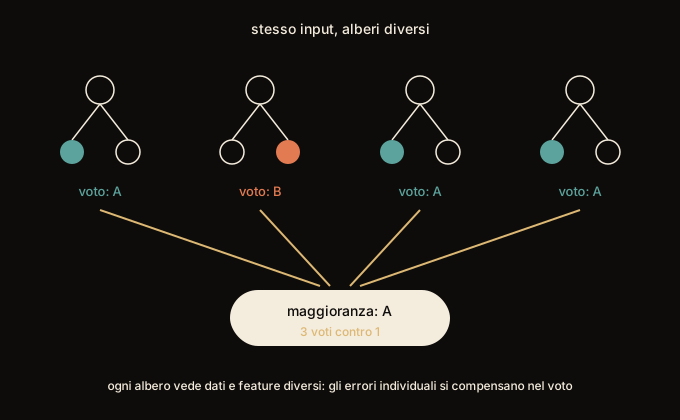
Fig. 4.25 La foresta al lavoro. La diversità è costruita apposta, con due sorteggi, uno sugli esempi dati a ciascun albero e uno sulle colonne fra cui ogni nodo sceglie la sua domanda.#
Il primo dei due sorteggi è il bootstrap, che c’era già nel bagging. Il secondo, quello sulle colonne, non era inedito: sorteggiarle una volta per albero è un’idea di Tin Kam Ho del 1998 [Ho98], mentre ripetere il sorteggio a ogni nodo viene da Amit e Geman nel 1997 [AG97]. È questa seconda forma che la foresta casuale adotta. Nei nodi in cui la colonna più informativa non è fra quelle sorteggiate, l’albero deve scegliere un’altra domanda, e gli alberi imboccano strade diverse. Il contributo di Breiman è la combinazione, e la teoria che spiega perché funziona.
L’idea è tanto semplice quanto efficace: a ogni split, invece di lasciar scegliere all’albero la domanda migliore tra tutte le caratteristiche, gliene mostriamo solo un sottoinsieme casuale, sorteggiato di nuovo a ogni domanda. Quante gliene mostriamo? Per classificare di solito la radice quadrata di quante sono: con cento colonne, dieci per volta. È un punto di partenza da tarare, non una risposta. Se la caratteristica dominante non è tra quelle proposte, l’albero è costretto a guardare altrove.
È come chiedere a una giuria di votare, ma a ogni domanda che un giurato si pone lo si benda su aspetti diversi del caso, scelti a sorte: nessuno può basarsi sempre sull’indizio più ovvio, e i loro pareri si somigliano molto meno. Alberi più diversi tra loro, media più efficace, varianza ancora più bassa. Il singolo albero diventa un po’ meno bravo (gli abbiamo nascosto delle carte), ma l’insieme diventa molto più forte.
Le bende, però, vanno chieste, e non sempre arrivano da sole: le librerie le mettono di serie quando la risposta è una categoria, e non quando è un numero. Se i giurati vedono tutto, tornano tutti sull’indizio più ovvio, e la giuria è di nuovo quella di prima: una media di alberi che si somigliano.
A ogni nodo, la ricerca dello split migliore è ristretta a un sottoinsieme
casuale di \(q\) caratteristiche estratte dalle \(d\) totali, dove \(d\) è il numero
di colonne della tabella e il sorteggio si ripete a ogni nodo. La convenzione
più diffusa è \(q = \sqrt{d}\) per la classificazione e \(q = d/3\) per la
regressione, ed è una convenzione da tarare più che una risposta: Breiman stesso
osserva che il risultato è poco sensibile a quel numero. In scikit-learn il
default segue la convenzione per la classificazione (RandomForestClassifier
estrae \(\sqrt{d}\) colonne) e non per la regressione: RandomForestRegressor ha
max_features=1.0, cioè le guarda tutte. Chi scrive RandomForestRegressor() e
basta ottiene quindi un bagging di alberi, senza il secondo sorteggio che
distingue la foresta dal bagging; se lo vuole, deve chiederlo
(max_features="sqrt", oppure 1/3). Il vincolo sulle colonne abbassa la
correlazione \(\rho\) tra gli alberi: nella formula della varianza della media, è
esattamente la leva che fa scendere il termine dominante \(\rho\,\sigma^2\). Si
accetta un lieve aumento del bias e della varianza del singolo albero in cambio
di una riduzione netta della varianza dell’ensemble. Per la classificazione
Breiman dà a questa leva un teorema [Bre01a]: detta \(s\) la
forza della foresta, cioè il margine atteso con cui il voto sceglie la classe
giusta, e \(\bar{\rho}\) la correlazione media fra i margini dei singoli alberi,
l’errore di generalizzazione soddisfa \(PE^\star \le \bar{\rho}\,(1-s^2)/s^2\). Il
limite è largo, ma dice in che verso muovere il numero di colonne sorteggiate:
abbassarlo fa calare \(\bar{\rho}\) e, oltre un certo punto, anche \(s\). Una
variante ancora più aggressiva, gli Extra-Trees (Extremely Randomized
Trees), estrae a caso anche le soglie di split invece di ottimizzarle,
guadagnando velocità e ulteriore decorrelazione.
La foresta casuale porta in dote due strumenti pratici molto amati.
Il primo è l’errore out-of-bag (OOB), e nasce da un fatto curioso del bootstrap. Ogni albero è addestrato su un campione pescato con reimmissione: da un mucchio di mille esempi se ne pescano mille, rimettendo dentro ogni volta quello appena uscito. Una parte del mucchio, per pura sfortuna, non viene pescata nemmeno una volta. Quanti restano fuori è sempre più o meno lo stesso, poco più di un terzo; quali restano fuori cambia da un albero all’altro, ed è proprio da lì che viene il regalo.
Il conto è questo. Un esempio preciso, a ogni pescata, ha \(999\) probabilità su \(1000\) di non essere quello estratto; per restare fuori dal campione deve scamparle tutte e mille, e siccome le pescate sono indipendenti le probabilità si moltiplicano fra loro: \((999/1000)^{1000} \approx 0{,}37\). Il valore dipende pochissimo dalla taglia del mucchio: con \(m\) esempi vale \((1 - 1/m)^m\), che fa \(0{,}35\) con dieci esempi e \(0{,}366\) con cento, e tende a \(1/e \approx 0{,}368\), dove \(e \approx 2{,}718\) è la costante di Nepero.
Quel terzo di esempi rimasti fuori si chiamano out-of-bag, «fuori dal sacchetto». Per ciascun esempio possiamo raccogliere il voto dei soli alberi che non l’hanno visto in addestramento: è una stima dell’errore di generalizzazione ottenuta gratis, senza mettere da parte un validation set separato.
Il secondo è la feature importance. Sommando, su tutti gli alberi, di quanto ciascuna caratteristica ha ridotto l’impurità nei suoi split, si ottiene una classifica di quanto ogni caratteristica «conta» per il modello. È un’informazione preziosa per capire i dati, ma con un’avvertenza che scikit-learn stessa segnala: questa misura tende a gonfiare l’importanza delle caratteristiche con molti valori distinti, e siccome è calcolata sui dati di addestramento può dare importanza perfino a una colonna di puro rumore. Va letta con prudenza. C’è una misura più affidabile, la permutation importance, e funziona così: si prende una colonna e la si mescola a caso, rovinandola di proposito, poi si guarda di quanto peggiora il modello su dati che non ha visto in addestramento. Se non peggiora, il modello quella colonna non la usa, o può farne a meno: una colonna quasi gemella di un’altra risulta poco importante anche quando porta informazione vera, perché la gemella la sostituisce. I limiti di tutte e due le misure li racconta la sezione sui modelli trasparenti.
Boosting: correggere gli errori, uno alla volta#
Il boosting ribalta la logica del bagging. Invece di addestrare tanti alberi forti in parallelo e mediarli, ne addestra molti deboli (alberi piccoli, di solito profondi fra i tre e i sei livelli) ma in sequenza, dove ognuno si concentra sugli errori commessi da chi lo precede. La somma di tanti correttori mediocri, ciascuno che ripara un pezzetto, diventa un modello molto accurato.
Uno studente ripassa per un esame. Fa un primo giro di esercizi, e sbaglia alcuni tipi di problema. Al secondo giro si concentra proprio su quelli che ha sbagliato. Al terzo, su ciò che ancora non gli riesce. Ogni ripasso non riparte da zero: aggiusta il tiro là dove serve. Alla fine padroneggia l’insieme, un errore corretto per volta.
AdaBoost (Freund e Schapire, 1997 [FS97]), dove la «A» sta per adaptive, fa proprio così con dei pesi: dopo ogni albero, gli esempi classificati male ricevono un peso maggiore, così l’albero successivo è spinto a occuparsi soprattutto di loro. Gli alberi che nel complesso sbagliano meno pesano di più nel voto finale. Il risultato è un comitato in cui ciascuno è specializzato sui casi difficili lasciati aperti dai colleghi precedenti.
C’è un secondo modo di dire «occupati di quello che gli altri hanno lasciato lì», ed è quello che oggi si usa di più: invece di ripesare gli esempi, si chiede al modello nuovo di indovinare quanto manca. Una valigia pesa 23 chili. Il primo che la solleva dice 20, tre chili sotto il vero. Il secondo non prova a pesare la valigia: prova a dire di quanto ha sbagliato il primo, e propone «più 2». La stima aggiornata è 22, e adesso manca un chilo. Il terzo lavora su quel chilo, e così via. Nessuno dei tre, da solo, saprebbe pesare una valigia; la somma delle loro correzioni sì. Questo secondo modo si chiama gradient boosting, e il nome viene da lì: lo scarto che ogni modello insegue indica anche la direzione in cui l’errore cala più in fretta.
AdaBoost [FS97], con \(y_i \in \{-1, +1\}\), parte da pesi
uniformi sugli esempi, \(v_i^{(1)} = 1/m\). Al passo \(t\) addestra un
classificatore debole \(h_t\) sui dati pesati, ne misura l’errore pesato
\(\varepsilon_t = \sum_i v_i^{(t)}\,\mathbb{1}[h_t(\mathbf{x}_i) \ne y_i]\), gli
dà il voto \(\alpha_t = \tfrac12\ln\frac{1-\varepsilon_t}{\varepsilon_t}\) e
aggiorna i pesi, \(v_i^{(t+1)} \propto v_i^{(t)}\,e^{-\alpha_t y_i
h_t(\mathbf{x}_i)}\), che moltiplica per \(e^{\alpha_t}\) quelli degli esempi
sbagliati e per \(e^{-\alpha_t}\) quelli giusti; il classificatore finale è
\(\operatorname{sign}\sum_t \alpha_t h_t(\mathbf{x})\). Freund e Schapire
dimostrano che l’errore di addestramento è al più \(\prod_t
2\sqrt{\varepsilon_t(1-\varepsilon_t)} \le \exp\bigl(-2\sum_t \gamma_t^2\bigr)\),
con \(\gamma_t = \tfrac12 - \varepsilon_t\): se ogni \(h_t\) fa anche solo un poco
meglio del caso, l’errore sui dati di addestramento scende esponenzialmente. È
la risposta costruttiva alla domanda di Kearns e Valiant (un apprendista
debole, appena migliore del caso, si può sempre potenziare in uno forte?), a
cui Schapire aveva risposto di sì nel 1990; sull’errore di test il limite non
dice niente. In scikit-learn estimator_weights_ vale \(2\alpha_t\): stesso
classificatore.
Il gradient boosting (Friedman, 2001 [Fri01]) generalizza l’idea di AdaBoost e la inquadra come una discesa del gradiente nello spazio delle funzioni. Il modello è additivo, costruito passo dopo passo:
dove \(B\) è il numero di alberi (la stessa lettera del bagging), \(F_0\) è la costante che da sola minimizza la loss sui dati (per la loss quadratica, la media dei target), \(h_t\) è l’albero aggiunto al passo \(t\) e \(\nu \in (0,1]\) è il learning rate. A ogni passo si vorrebbe muovere la funzione corrente \(F_{t-1}\) nella direzione che riduce di più la loss \(\mathcal{L}\); quella direzione, valutata su ciascun esempio, è l’opposto del gradiente
detto pseudo-residuo. Il nuovo albero \(h_t\) viene addestrato per approssimare proprio questi pseudo-residui. Nel caso della loss quadratica \(\ell = \tfrac{1}{2}(y - F)^2\) il gradiente si riduce a \(r_i = y_i - F_{t-1}(\mathbf{x}_i)\): cioè, semplicemente, l’errore residuo ancora da spiegare (al primo passo, lo scarto dalla media \(F_0\)). Detto a parole: ogni albero approssima ciò che i precedenti hanno sbagliato. Il legame con AdaBoost passa per un lavoro di poco precedente [FHT00]: AdaBoost coincide con la costruzione additiva un termine alla volta (forward stagewise additive modeling) sotto la exponential loss \(\ell = e^{-yF}\) con \(y \in \{-1,+1\}\), in cui ogni termine nuovo minimizza esattamente quella loss. Il gradient boosting sostituisce quella minimizzazione esatta con un passo di gradiente, e applicato alla loss esponenziale ne dà un’approssimazione, non una copia.
Quando si racconta l’algoritmo di Friedman si salta spesso un passaggio che cambia i numeri: dell’albero appena addestrato si tiene la partizione, non i valori nelle foglie. Quelli vengono ri-ottimizzati regione per regione, cercando in ciascuna la costante che minimizza la loss vera,
dove \(R_{jt}\) è la \(j\)-esima foglia dell’albero \(t\) e \(\gamma_{jt}\) il valore
che le viene assegnato. Con la loss quadratica il passaggio è invisibile,
perché quella costante è la media dei residui, cioè esattamente ciò che
l’albero aveva già messo nella foglia. Con la log-loss no, i due valori sono
diversi, e la log-loss è il default di GradientBoostingClassifier, che quel
minimo non lo cerca esattamente: lo approssima con un solo passo di Newton,
\(\gamma_{jt} = \sum_{i \in R_{jt}} r_i \big/ \sum_{i \in R_{jt}}
\hat{p}_i(1-\hat{p}_i)\), con \(y_i \in \{0,1\}\) e
\(\hat{p}_i = \sigma\big(F_{t-1}(\mathbf{x}_i)\big)\), come l’algoritmo di
Friedman.
XGBoost [CG16] porta il secondo ordine dentro la costruzione dell’albero. Dette \(g_i\) e \(s_i\) la derivata prima e seconda di \(\ell(y_i, F)\) rispetto a \(F\), calcolate in \(F_{t-1}(\mathbf{x}_i)\), il nuovo albero minimizza lo sviluppo di Taylor della loss più una penalità sulla sua forma,
dove \(J\) è il numero di foglie, \(w_j\) il valore della foglia \(j\), \(c\) il prezzo
di una foglia e \(\lambda\) il freno \(\ell_2\) sui valori (reg_lambda). Con \(G_j\)
e \(S_j\) le somme di \(g_i\) e \(s_i\) sulla foglia, il valore ottimo è \(w_j^\star =
-G_j/(S_j+\lambda)\), cioè il passo di Newton di Friedman ristretto verso zero, e
con la loss quadratica (\(s_i = 1\)) la media dei residui ristretta verso zero.
Uno split si accetta solo se il guadagno
è positivo: la potatura è incorporata nella crescita. La soglia della libreria,
gamma, vale \(2c\), perché la libreria la confronta con la parentesi quadra
senza il suo \(\tfrac{1}{2}\).
La somma che si accumula si guarda meglio di come si racconti (Fig. 4.26). Il modello di partenza è una costante, la media; ogni albero aggiunto è un taglio solo, e cambia il valore su una parte sola dell’asse; e quello che ogni albero insegue è la distanza fra i punti e la linea, cioè proprio quello che i precedenti hanno lasciato lì.
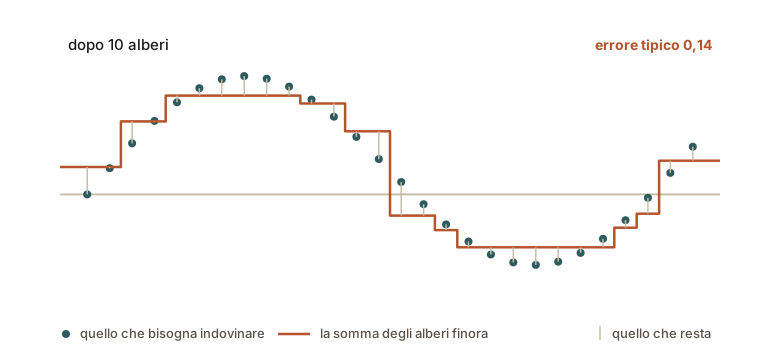
Fig. 4.26 Dieci alberi da una domanda sola, sommati uno alla volta. Ciascuno vale un gradino, e nessuno guarda i punti: guarda i trattini, cioè quello che i precedenti hanno sbagliato. L’errore tipico scende da \(0{,}60\) a \(0{,}14\).#
Nel mondo reale, due implementazioni del gradient boosting sono diventate lo standard sui dati tabellari: XGBoost (Chen e Guestrin, 2016 [CG16]) e LightGBM (Ke e colleghi, 2017 [KMF+17]). Sono estensioni dell’algoritmo di Friedman, più veloci e più regolarizzate; ecco che cosa le distingue:
Regolarizzazione esplicita. XGBoost aggiunge alla loss una penalità sulla complessità di ogni albero (numero di foglie, ampiezza dei valori nelle foglie), nello spirito del rasoio di Occam già visto per Ridge e Lasso. Questo tiene a bada l’overfitting, il vero rischio del boosting.
Il secondo ordine. XGBoost approssima la loss con il suo sviluppo di Taylor al secondo ordine: per ogni esempio usa il gradiente \(g_i\) e la derivata seconda \(s_i\), cioè non soltanto in che direzione la loss cala ma anche quanto in fretta quella pendenza cambia, e il valore di ogni foglia è un passo di Newton, \(-G_j/(S_j + \lambda)\), dove \(G_j\) e \(S_j\) sono le somme di \(g_i\) e \(s_i\) sulla foglia e \(\lambda\) il freno sui valori. Con la loss quadratica è la media dei residui, ristretta verso lo zero.
Istogrammi e velocità. Entrambi raggruppano i valori continui delle caratteristiche in poche centinaia di intervalli (bin: di default \(256\) in XGBoost e \(255\) in LightGBM), e trovare lo split migliore diventa scorrere un istogramma invece di ordinare tutti i valori. Entrambi, inoltre, sanno gestire da soli i valori mancanti, imparando per ogni split da che parte conviene mandare le righe con la casella vuota (in XGBoost è lo sparsity-aware split finding del paper del 2016).
Le due mosse di LightGBM. Quello che il suo paper aggiunge sono due modi di rimpicciolire il problema prima di costruire gli istogrammi. Il GOSS (gradient-based one-side sampling) tiene tutte le righe su cui il modello sta ancora sbagliando parecchio, e delle altre ne campiona solo una parte, ripesandola per non falsare il conto: righe che contano poco, invece di pesare quanto le altre, si fanno rappresentare. L’EFB (exclusive feature bundling) impacchetta in una colonna sola colonne che quasi mai sono diverse da zero contemporaneamente, e taglia il numero di colonne da scandire. La crescita leaf-wise (espandere sempre la foglia più promettente invece di completare un livello per volta) è un’opzione in più, non la vera differenza fra i due: la offre anche XGBoost (
grow_policy="lossguide"). In entrambi va tenuta a freno, perché un albero che cresce solo da un lato diventa profondo in fretta e va in overfitting più facilmente.
Bagging o boosting? Varianza contro bias#
Le due strategie curano mali opposti, e questo dice quando preferire l’una o l’altra.
Il bagging (e la sua incarnazione migliore, la random forest) parte da alberi a varianza alta e la abbatte mediando. È robusto e poco sensibile agli iperparametri: aggiungere alberi non causa overfitting, perché l’errore converge a un limite al crescere di \(B\) [Bre01a]. Quel limite è la media di alberi cresciuti a fondo e può essere un modello troppo ricco, ma in pratica costa poco [HTF09]. Ottima scelta di default, specie quando si vuole un modello solido con poca messa a punto, e si addestra in parallelo in modo naturale (ogni albero dipende solo dal proprio campione).
Il boosting parte da alberi deboli a bias alto e lo abbatte correggendo gli errori in sequenza. Tipicamente raggiunge l’accuratezza più alta sui dati tabellari, ma è più delicato: siccome ogni albero rincorre gli errori del precedente, può andare in overfitting se lo si lascia correre troppo.
I freni principali sono due. Il primo è il learning rate \(\nu\) (shrinkage): ogni nuovo albero entra nella somma moltiplicato per \(\nu\), quindi il passo della discesa del gradiente nello spazio delle funzioni viene accorciato [Fri01]. Passi piccoli rendono l’apprendimento più lento ma più stabile, e di solito si abbina un passo piccolo a molti alberi. Il secondo freno è l’early stopping, cioè fermarsi quando l’errore su un validation set smette di migliorare: il blocco con XGBoost, più in basso, lo mostra all’opera. Il boosting inoltre è sequenziale per costruzione: non si parallelizza sugli alberi come il bagging.
In sintesi: se cerchi robustezza con poco sforzo, parti dalla random forest; se cerchi l’ultimo punto di accuratezza e sei disposto a mettere a punto learning rate ed early stopping, passa al gradient boosting.
Combinare modelli diversi: voto e stacking#
Bagging e boosting combinano molte copie dello stesso tipo di modello. Resta la domanda che si pone chiunque abbia provato tre algoritmi diversi e li veda arrivare a punteggi simili: si possono mettere insieme quelli?
Sì, e in due modi, che si distinguono per chi decide come pesare i pareri.
Il primo è il voto. Ogni modello dice la sua e vince la maggioranza. C’è una variante che quasi sempre funziona meglio: invece di contare i voti secchi (il voto «duro») si mediano le probabilità (il voto «morbido»), così un modello sicurissimo pesa più di uno che era incerto. Contare i voti butta via l’informazione più utile, cioè quanto ciascuno ci credeva. Con una riserva: le sicurezze devono essere confrontabili fra loro. Un modello che si dichiara certo al 99 per cento anche quando tira a indovinare trascina la media dalla sua parte, e a quel punto mediare le probabilità rende meno che contare i voti secchi.
Il secondo è lo stacking, e l’idea è più ambiziosa: invece di decidere noi come pesare i modelli, si addestra un modello a farlo. Sopra i predittori di base si mette un ultimo modello, di solito semplicissimo, che riceve in ingresso le loro predizioni e impara quando fidarsi di chi. Può scoprire che il primo è affidabile sui casi facili e il secondo sui casi rari, cosa che una media fissa non può fare.
C’è una regola che sembra un dettaglio tecnico ed è invece tutto il punto: il combinatore va addestrato su predizioni che i modelli di base non hanno mai visto in addestramento. Se gli si danno le predizioni sui dati con cui quei modelli si sono allenati, lui vedrà tutti bravissimi, e si fiderà proprio di chi ha imparato a memoria. È lo stesso principio del test che non si tocca, applicato un piano più in su.
E la condizione perché tutto questo serva a qualcosa: i modelli devono sbagliare in modi diversi. Tre modelli che sbagliano sugli stessi casi non si correggono a vicenda, e combinarli non porta nulla. È la stessa ragione per cui una random forest decorrela gli alberi invece di limitarsi a fare la media.
Su che cosa si può contare, allora, mettendo insieme dei pareri a pesi fissi? Quando i pareri sono numeri e se ne fa la media, su una cosa sola: il risultato non viene peggio del parere medio del gruppo, e viene tanto meglio quanto più i pareri erano diversi fra loro. Battere il migliore dei membri, invece, non lo promette nessuno. Un comitato che perde contro il suo elemento più bravo non ha infranto nessuna regola, e capita proprio quando gli altri lo tirano giù. Con i voti contati a maggioranza, poi, una garanzia altrettanto pulita non c’è.
Il voting aggrega \(M\) modelli eterogenei \(f_1,\dots,f_M\). Nella forma hard si prende la moda delle etichette predette; nella forma soft la media (eventualmente pesata) delle probabilità, \(\hat{p}(y\mid \mathbf{x}) = \frac{1}{M}\sum_m \hat{p}_m(y\mid \mathbf{x})\), seguita da un \(\arg\max\). Il soft voting domina di norma perché conserva la confidenza, che nel voto duro viene scartata: ma richiede probabilità comparabili fra i modelli, e modelli mal calibrati possono peggiorarlo.
Lo stacking [Wol92] sostituisce la regola fissa con un meta-modello \(g\) addestrato su \(\hat{\mathbf{z}} = (f_1(\mathbf{x}), \dots, f_M(\mathbf{x}))\). La regola critica è che le \(\hat{\mathbf{z}}\) di addestramento siano fuori campione: si genera una matrice di predizioni per cross-validation (per ogni fold, i modelli di base sono addestrati sugli altri fold e predicono su quello tenuto fuori), e su quella si addestra \(g\). Senza questa precauzione il meta-modello osserva le predizioni in-sample dei modelli di base, che sono ottimisticamente buone in misura proporzionale a quanto ciascuno sovradatta, e impara a pesare la memorizzazione.
Come meta-modello si sceglie tipicamente qualcosa di semplice (una regressione logistica, spesso regolarizzata): la capacità serve sotto, non sopra, e un combinatore flessibile sovradatta la matrice delle predizioni, che ha poche colonne e forte collinearità.
La condizione di efficacia si legge nella scomposizione ambiguità-errore di Krogh e Vedelsby [KV95], che è un’identità esatta per la loss quadratica sulla media dell’ensemble: l’errore della media è l’errore medio dei membri meno la loro diversità, \(E_{\text{ens}} = \bar{E} - \bar{A}\) con \(\bar{A} \ge 0\). Combinare aiuta nella misura in cui i modelli sono decorrelati negli errori, e non aiuta affatto se sono d’accordo anche quando sbagliano.
Due cautele. La prima: l’identità non regge tutti gli ensemble, perché per la loss 0-1 (cioè per il voto di maggioranza) una scomposizione additiva analoga non esiste, e gli effetti della diversità dipendono dalla distribuzione delle etichette [WMW+23]. La seconda, più insidiosa: da \(\bar{A}\ge0\) segue che l’ensemble non è mai peggiore del membro medio, il che non dice nulla sul confronto con il membro migliore. Un ensemble peggiore del suo componente più bravo non contraddice affatto Krogh e Vedelsby.
Il risultato non è quello che ci si aspetta. Nell’esperimento i tre modelli di base sono una foresta casuale, un k-NN e un Bayes ingenuo (naive Bayes): un classificatore che stima, per ogni classe, la distribuzione di ciascuna colonna presa da sola (un valore come questo, quanto spesso capita fra i malati e quanto spesso fra i sani?), e moltiplica le probabilità come se le colonne fossero indipendenti dentro la classe, \(p(\mathbf{x}\mid y) = \prod_j p(x_j \mid y)\); poi sceglie la classe con il teorema di Bayes. L’indipendenza è quasi sempre falsa (reddito e quartiere non sono indipendenti), ed è la ragione principale per cui qui sarà nettamente il più debole dei tre. Lo riprende per esteso la sezione sui modelli generativi, e Classificare il testo lo mostra al lavoro sulle parole di un’email, dove invece funziona benissimo.
import numpy as np
from scipy.stats import binomtest, chi2
from sklearn.datasets import make_classification
from sklearn.ensemble import (RandomForestClassifier, StackingClassifier,
                              VotingClassifier)
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.neighbors import KNeighborsClassifier

X, y = make_classification(n_samples=3000, n_features=20, n_informative=8,
                           class_sep=0.7, random_state=0)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0)

# tre modelli che sbagliano in modi DIVERSI: è questa la condizione
base = [("foresta", RandomForestClassifier(n_estimators=200, random_state=0)),
        ("vicini",  KNeighborsClassifier(n_neighbors=15)),
        ("bayes",   GaussianNB())]

for nome, m in base:
    print(f"{nome:<12} {m.fit(X_tr, y_tr).score(X_te, y_te):.4f}")

duro = VotingClassifier(base, voting="hard").fit(X_tr, y_tr)
morbido = VotingClassifier(base, voting="soft").fit(X_tr, y_tr)
# il combinatore si addestra su predizioni FUORI CAMPIONE (cv=5): senza,
# imparerebbe a fidarsi di chi ha memorizzato il training set
pila = StackingClassifier(base, final_estimator=LogisticRegression(),
                          cv=5).fit(X_tr, y_tr)

print(f"{'voto duro':<12} {duro.score(X_te, y_te):.4f}")
print(f"{'voto morbido':<12} {morbido.score(X_te, y_te):.4f}")
print(f"{'stacking':<12} {pila.score(X_te, y_te):.4f}")

# la garanzia della media vale per una perdita convessa delle probabilità,
# come il punteggio di Brier (più basso è meglio), non per l'accuratezza
from sklearn.metrics import brier_score_loss
brier = [brier_score_loss(y_te, m.predict_proba(X_te)[:, 1]) for _, m in base]
print("Brier dei tre:", " ".join(f"{b:.4f}" for b in brier),
      f" media {sum(brier) / 3:.4f}")
print(f"Brier del voto morbido: "
      f"{brier_score_loss(y_te, morbido.predict_proba(X_te)[:, 1]):.4f}")
print("pesi del combinatore:", pila.final_estimator_.coef_.round(2))

def mcnemar(a, b):
    """I casi su cui uno azzecca e l'altro no: p esatto e p approssimato."""
    ok_a, ok_b = a.predict(X_te) == y_te, b.predict(X_te) == y_te
    solo_a, solo_b = int(np.sum(ok_a & ~ok_b)), int(np.sum(~ok_a & ok_b))
    esatto = binomtest(solo_a, solo_a + solo_b, 0.5).pvalue
    stat = (abs(solo_a - solo_b) - 1) ** 2 / (solo_a + solo_b)
    return solo_a, solo_b, esatto, chi2.sf(stat, 1)

foresta = base[0][1]
print(f"\n{'confronto':<30}{'solo a':>7}{'solo b':>7}"
      f"{'p esatto':>10}{'p approx.':>10}")
for testo, a, b in [("foresta contro voto duro", foresta, duro),
                    ("foresta contro voto morbido", foresta, morbido),
                    ("voto duro contro voto morbido", duro, morbido),
                    ("stacking contro voto morbido", pila, morbido),
                    ("stacking contro voto duro", pila, duro),
                    ("stacking contro foresta", pila, foresta)]:
    sa, sb, pe, pa = mcnemar(a, b)
    print(f"{testo:<30}{sa:7d}{sb:7d}{pe:10.4f}{pa:10.4f}")
foresta      0.8933
vicini       0.8889
bayes        0.8156
voto duro    0.8867
voto morbido 0.8822
stacking     0.9089
Brier dei tre: 0.0945 0.0889 0.1303  media 0.1046
Brier del voto morbido: 0.0961
pesi del combinatore: [[ 6.05  4.86 -1.14]]

confronto                      solo a solo b  p esatto p approx.
foresta contro voto duro           19     13    0.3771    0.3768
foresta contro voto morbido        30     20    0.2026    0.2031
voto duro contro voto morbido      14     10    0.5413    0.5403
stacking contro voto morbido       37     13    0.0009    0.0011
stacking contro voto duro          32     12    0.0037    0.0042
stacking contro foresta            29     15    0.0488    0.0500
I singoli arrivano a \(0{,}8933\) (foresta), \(0{,}8889\) (vicini) e \(0{,}8156\) (Bayes ingenuo); il voto duro dà \(0{,}8867\), quello morbido \(0{,}8822\), lo stacking \(0{,}9089\).
Prima di ricavarne una classifica, il promemoria della sezione sull’overfitting e la validazione: due punteggi che distano meno del rumore della misura non sono una classifica. Il test qui sono \(900\) esempi, e attorno a un’accuratezza dell’\(89\%\) un punteggio così oscilla tipicamente di circa un punto percentuale (è la deviazione standard di una proporzione, \(\sqrt{0{,}89 \cdot 0{,}11 / 900} = 0{,}010\); l’intervallo entro cui il valore vero cade quasi sempre è largo il doppio per parte). Fra la foresta e i due voti gli scarti sono \(0{,}007\) e \(0{,}011\): dello stesso ordine, cioè troppo piccoli per pronunciarsi con questo metro.
Il confronto va allora fatto in modo più fine, sulle predizioni appaiate: invece di guardare due punteggi complessivi si va esempio per esempio e si contano soltanto i casi su cui i due modelli dissentono, cioè quelli che uno azzecca e l’altro sbaglia. Se i due si equivalgono, quei casi dovrebbero dividersi più o meno a metà, come testa e croce; se uno è davvero migliore, la bilancia pende dalla sua parte. È il test di McNemar, e la sua risposta è il \(p\) della sezione su ipotesi nulla e p-value: quanto spesso il caso, da solo, produrrebbe uno sbilanciamento almeno così marcato se i due modelli fossero equivalenti. Sotto \(0{,}05\), per la convenzione di sempre, si smette di credere che siano equivalenti.
La tabella in fondo all’uscita li stampa tutti. Foresta contro voto duro dà \(p = 0{,}38\), foresta contro voto morbido \(p = 0{,}20\), voto duro contro voto morbido \(p = 0{,}54\): numeri grandi, cioè nessuna differenza dimostrabile. Su questo test, semplicemente, quei tre non si distinguono. Lo stacking invece sì: batte il voto morbido con \(p = 0{,}0009\), il voto duro con \(p = 0{,}0037\) e la foresta con \(p = 0{,}049\), cioè in modo netto rispetto ai due voti e per un soffio rispetto alla foresta. Su quest’ultimo la terza cifra decide, e il verdetto cambia con la forma del test: quei \(p\) vengono dal conto binomiale esatto, e la versione approssimata che quasi tutti i manuali chiamano test di McNemar, con la correzione di continuità, dà \(0{,}0500\), cioè la soglia stessa (alla quinta cifra, un soffio sopra). Un confronto che si gioca lì non è un confronto vinto.
Quello che invece i numeri possono dire riguarda un’altra domanda, e conviene tenerle distinte: mediare probabilità a pesi fissi mette al riparo dal membro medio, e non promette di superare il migliore. La garanzia vale per una perdita convessa delle probabilità mediate, come la distanza al quadrato fra probabilità ed esito (il punteggio di Brier, dove più basso è meglio) o la log-loss, e non per l’accuratezza: il voto morbido media e poi sceglie la classe più probabile, e quella scelta è di nuovo una perdita 0-1, dove un comitato può finire perfino sotto il membro medio. Sul punteggio di Brier il voto morbido fa \(0{,}0961\) contro una media dei tre di \(0{,}1046\), come la garanzia promette, e perde contro la foresta (\(0{,}0945\)) e contro il \(k\)-NN (\(0{,}0889\)), come la garanzia non esclude. Che sull’accuratezza superi la media dei tre punteggi (\(0{,}8822\) contro \(0{,}8659\)) è un fatto di questi dati, non una promessa.
Sul perché il voto non guadagni di più, invece, si può ragionare, e la ragione è il terzo modello. Il Bayes ingenuo è nettamente il più debole, e in una media a pesi fissi conta quanto gli altri: il voto lo tratta alla pari con la foresta. Lo stacking impara che di quel modello ci si può fidare poco, e i pesi del combinatore lo dicono: \(6{,}05\) alla foresta, \(4{,}86\) al \(k\)-NN e \(-1{,}14\) al Bayes ingenuo, cioè un peso piccolo e perfino di segno opposto (con tre colonne di probabilità così correlate fra loro, il segno del peso più piccolo non si legge come fiducia). È il vantaggio di far decidere i pesi ai dati invece che fissarli in anticipo, e la ragione per cui, in un ensemble eterogeneo, la media semplice è una scommessa sulla qualità uniforme dei membri.
Non è però un invito a impilare tutto: il guadagno qui è di poco più di un punto e mezzo, per giunta al limite della significatività, pagato con quattro modelli da mantenere in produzione e, per costruirli, diciannove addestramenti: i tre di base cinque volte ciascuno per la cross-validation interna, poi una volta sull’insieme intero, poi il combinatore. In produzione quel conto va fatto.
In pratica, con scikit-learn#
L’interfaccia fit/predict è la stessa vista per gli altri modelli
supervisionati; per una guida applicativa estesa a questi metodi rimandiamo al
manuale di Géron [Geron22]. I quattro protagonisti stanno in
poche righe:
from sklearn.datasets import make_classification
from sklearn.ensemble import GradientBoostingClassifier, RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

# una tabella con venti colonne, di cui otto che contano davvero
X, y = make_classification(n_samples=3000, n_features=20, n_informative=8,
                           class_sep=0.7, random_state=0)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3,
                                                    random_state=0)

# Un solo albero: interpretabile, ma ad alta varianza.
# max_depth frena la crescita per non memorizzare i dati.
albero = DecisionTreeClassifier(max_depth=4, criterion="gini", random_state=0)
albero.fit(X_train, y_train)   # senza seme il numero balla: fra split di pari
                               # merito l'albero ne sceglie uno a caso

# Random forest: 300 alberi in parallelo, split su un sottoinsieme di feature.
# oob_score chiede la stima out-of-bag dell'errore, gratis.
foresta = RandomForestClassifier(
    n_estimators=300, max_features="sqrt", oob_score=True, n_jobs=-1,
    random_state=0)   # senza seme, OOB e importanze cambiano a ogni esecuzione
foresta.fit(X_train, y_train)

# Gradient boosting: alberi piccoli in sequenza.
# learning_rate basso + molti alberi = più stabile.
gb = GradientBoostingClassifier(n_estimators=300, learning_rate=0.05,
                                max_depth=3, random_state=0)
gb.fit(X_train, y_train)

# la stessa foresta con il freno dell'albero solo: serve a separare il merito
# del votare da quello della profondita' in piu' che la foresta si prende
corta = RandomForestClassifier(n_estimators=300, max_features="sqrt",
                               max_depth=4, n_jobs=-1, random_state=0)
corta.fit(X_train, y_train)

for nome, m in (("albero", albero), ("foresta", foresta), ("boosting", gb),
                ("corta", corta)):
    print(f"{nome:9} accuratezza sul test: {m.score(X_test, y_test):.3f}")
print(f"foresta   accuratezza OOB      : {foresta.oob_score_:.3f}")

# l'importanza e' un vettore lungo quanto le colonne: si guardano le prime
ordine = foresta.feature_importances_.argsort()[::-1]
print("le cinque colonne che contano di piu':", ordine[:5])
albero    accuratezza sul test: 0.796
foresta   accuratezza sul test: 0.891
boosting  accuratezza sul test: 0.883
corta     accuratezza sul test: 0.836
foresta   accuratezza OOB      : 0.898
le cinque colonne che contano di piu': [14  8 16 11  4]
Le prime tre righe dicono tutto: un albero solo si ferma a \(0{,}796\), la
foresta arriva a \(0{,}891\) e la fila di alberi piccoli a \(0{,}883\).
Quasi dieci punti, senza cambiare famiglia di modelli. Attenzione però a quale
merito si assegna a chi: l’albero solo qui porta un freno, max_depth=4, e gli
alberi della foresta no, quindi in quei dieci punti c’è anche la profondità che
è stata tolta. La quarta riga stampata mette lo stesso freno anche alla
foresta, e dice quanto vale il solo votare: da \(0{,}796\) a \(0{,}836\), quattro
punti. Fra il voto e la fila,
invece, non c’è niente da leggere: otto millesimi su un test di novecento
esempi stanno sotto l’incertezza della misura, che a quell’accuratezza vale un
punto percentuale. Che sui dati in tabella il boosting arrivi di norma più in
alto resta vero come tendenza; su un problema solo, e per giunta fabbricato,
non si vede. La quinta riga è il regalo dell’out-of-bag: una stima dell’errore
ottenuta senza mettere da parte niente, che qui dà \(0{,}898\) contro lo
\(0{,}891\) misurato sul test vero. Sette millesimi di scarto, cioè meno degli
otto appena archiviati come rumore: sono due misure che, con questo metro, si
equivalgono, ed è quanto la stima gratis può promettere.
Per il gradient boosting «da competizione» si usa di norma la libreria dedicata, con la stessa interfaccia e l’early stopping integrato:
from sklearn.model_selection import train_test_split
from xgboost import XGBClassifier

# La validazione si stacca dal training, mai dal test: serve a decidere
# quando fermarsi, e un test usato per decidere non misura più niente.
X_fit, X_val, y_fit, y_val = train_test_split(
    X_train, y_train, test_size=0.2, random_state=0)

# eval_set + early_stopping_rounds: si ferma quando la validazione
# smette di migliorare, evitando l'overfitting del boosting.
xgb = XGBClassifier(
    n_estimators=1000, learning_rate=0.05, max_depth=4,
    subsample=0.8, early_stopping_rounds=30, random_state=0)
xgb.fit(X_fit, y_fit, eval_set=[(X_val, y_val)], verbose=False)
print("alberi usati:", xgb.best_iteration + 1, "su 1000")
alberi usati: 253 su 1000
Duecentocinquantatré alberi invece di mille: l’arresto anticipato ha fermato la sequenza quando la validazione non migliorava da trenta alberi. Il numero esatto dipende dal seme (il sorteggio dell’80% delle righe per albero) e dalla validazione, ma l’ordine di grandezza no: il modello smette di migliorare molto prima dei mille alberi richiesti.
Su un problema tabellare nuovo, una random forest con i parametri di default è
quasi sempre la prima cosa da provare (in regressione chiedendo esplicitamente
il sorteggio delle colonne, max_features="sqrt" o 1/3, che scikit-learn di
default non fa); è la linea di base onesta contro cui misurare tutto il
resto, cioè il termine di paragone volutamente semplice che un modello più
elaborato deve battere per giustificare quello che costa (in inglese baseline,
ed è la parola che si legge nel codice e nei manuali). Quando quel modello non
la batte, la risposta non è insistere: la foresta era già la risposta, e il
conto in più non si è pagato. Se serve spremere di più, si passa a XGBoost o
LightGBM con learning rate basso ed early stopping. Per il deep learning (che
affronteremo con PyTorch nei capitoli successivi), il turno arriva sui dati non
tabellari: immagini, testo, audio, dove queste stesse foreste e questi boosting
cedono il passo alle reti.
Da ricordare
Un albero decisionale è Indovina chi?: una catena di domande sì/no, ciascuna scelta perché divide i casi nel modo più netto possibile, fino a una risposta. Sul foglio dei punti, ogni domanda è un taglio dritto, e l’albero ritaglia rettangoli.
Si legge e si spiega («perché mi hai negato il prestito?»), ed è il suo pregio più raro. Ma un albero lasciato crescere impara a memoria ed è instabile: cambia dieci dati e viene fuori un albero diverso.
Il rimedio è non fidarsi di uno solo. Se ne addestrano tanti su versioni leggermente diverse degli stessi dati e si fanno votare: gli errori, se sono errori diversi, si annullano a vicenda. La foresta casuale aggiunge la mossa decisiva: a ogni domanda l’albero vede solo alcune colonne, sorteggiate di nuovo ogni volta, come una giuria in cui a ogni domanda ogni giurato è bendato su aspetti diversi, così i pareri si somigliano molto meno.
L’altra strada è metterli in fila invece che in parallelo: ogni nuovo modello si occupa solo di ciò che i precedenti hanno sbagliato, come lo studente che al secondo giro ripassa gli esercizi andati male. È il boosting, di norma il più accurato sui dati in tabella, ma va frenato: passi corti e stop appena smette di migliorare.
Per combinare modelli di tipo diverso si può votare, oppure far decidere a un ultimo modello quanto fidarsi di ciascuno (lo stacking). Nell’esperimento il secondo batte il voto perché impara a pesare poco il modello più debole, che una media a pesi fissi si porta appresso; contro il migliore dei tre, invece, il guadagno sta al limite della misura.
La condizione perché combinare serva è sempre la stessa: i modelli devono sbagliare in modi diversi. Combinarne tre che sbagliano insieme non corregge niente, ripete l’errore con più sicurezza.
Su un problema nuovo in tabella: prima una foresta casuale, ed è già una linea di partenza onesta contro cui misurare tutto il resto.
Da ricordare
Un albero decisionale (CART) classifica per domande sì/no che partizionano lo spazio in rettangoli; sceglie a ogni nodo lo split che riduce di più l’impurità (Gini o entropia; con l’entropia è l’information gain), con una ricerca greedy, perché l’albero ottimo è NP-completo. In regressione la foglia predice la media e si minimizza l’MSE.
Un albero poco profondo è interpretabile («scatola bianca»); un albero profondo memorizza i dati, ha alta varianza ed è instabile.
Il bagging addestra molti alberi in parallelo su campioni bootstrap e li fa votare: mediando modelli decorrelati, abbatte la varianza.
La random forest aggiunge il campionamento casuale delle feature a ogni split per decorrelare gli alberi; offre gratis l’errore out-of-bag e la feature importance.
Il boosting addestra alberi deboli in sequenza, ognuno sui residui del precedente: dal riequilibrio dei pesi di AdaBoost alla discesa del gradiente nello spazio delle funzioni del gradient boosting. XGBoost e LightGBM lo rendono veloce e regolarizzato, e sui dati tabellari di taglia media sono fra i metodi da battere.
Bagging vs boosting: il primo cura la varianza (robusto, aggiungere alberi non fa overfitting; per la perdita 0-1 aggregare un classificatore cattivo lo peggiora); il secondo cura il bias (più accurato di norma, ma va frenato con learning rate basso ed early stopping).
Per combinare modelli di tipo diverso ci sono il voto (meglio quello morbido, che media le probabilità invece di contare le etichette) e lo stacking, che addestra un meta-modello a pesare i predittori di base. Il meta-modello va addestrato su predizioni fuori campione, altrimenti impara a fidarsi di chi ha memorizzato.
La condizione perché un ensemble serva è che i membri sbaglino in modo diverso: per la loss quadratica l’errore della media è l’errore medio dei membri meno la loro diversità (Krogh–Vedelsby), quindi la media non è mai peggiore del membro medio; sul membro migliore non c’è nessuna garanzia, e sull’accuratezza non c’è nemmeno la prima, neanche col voto morbido, che media le probabilità ma poi sceglie una classe. Un componente debole il voto a pesi fissi se lo porta appresso, lo stacking impara a pesarlo poco.