


Panorama e limiti#
L’attenzione lineare e gli state space model partono da punti diversi e arrivano a una famiglia comune, quella delle reti ricorrenti lineari a stato di dimensione fissa. Il problema di partenza è quello del capitolo sui Transformer: l’attenzione piena costa un tempo che cresce col quadrato della lunghezza della sequenza, e una cache (le chiavi e i valori delle parole già viste) che cresce linearmente con essa; da lì nascono le finestre di contesto limitate. Una rete ricorrente lineare tiene invece uno stato di taglia fissa, lo aggiorna parola per parola e calcola lo stesso risultato in due modi: in parallelo per addestrare, in ricorrenza, a costo costante per token, per generare. Restano da confrontare le varianti, da dire che cosa uno stato di taglia fissa non può fare, e da vedere come ci si lavora intorno.
Un’unica famiglia#
La memoria che accomuna queste architetture è una matrice \(\mathbf{S}_t\) di dimensione fissa, che associa chiavi a valori: a ogni parola vi si scrive la coppia \((\mathbf{k}_t, \mathbf{v}_t)\) per prodotto esterno, e la si rilegge con una query \(\mathbf{q}_t\), come nella sezione dalla softmax alla ricorrenza. Prima di scrivere, lo stato viene moltiplicato per un fattore, la transizione: è lì che passa quasi tutta la differenza fra queste architetture. Da RetNet a Mamba-2 cambiano la forma di quel fattore e il fatto che dipenda o no dall’ingresso.
Riprendi il foglio-registro del capitolo precedente. A ogni parola ci si scrive una voce nuova, fatta di un’etichetta e di un contenuto, e per rileggere si presenta un’etichetta e si riceve indietro ciò che le somiglia di più. Il foglio ha un numero fisso di caselle, e la voce nuova si somma a quello che c’è già, lasciando un segno in tutte le caselle; prima di sommarla, però, il passato viene sbiadito un po’.
Quasi tutte le architetture dell’attenzione lineare e degli SSM sono un apparecchio solo, con poche manopole. Il corpo della macchina è sempre lo stesso: una memoria che a ogni parola scrive una nuova voce e ne rilegge le vecchie. Cambiare architettura non vuol dire cambiare macchina, ma girare tre manopole, e ognuna si paga con qualcosa.
La prima decide quanto è grande la memoria. Più caselle vuol dire più voci che ci stanno senza pestarsi i piedi. Il conto arriva a ogni parola: le caselle si toccano tutte, una per una, sia per scrivere sia per rileggere, quindi un foglio più capiente costa di più. Quanto di più, dipende da come si fanno i conti: una macchina che li fa in blocco, come Mamba-2 con la sua pressa, si permette un foglio molto più grande senza rallentare.
La seconda decide come sbiadisce il passato quando arriva il presente: si può non sbiadire affatto, sbiadire tutto in blocco della stessa quantità, sbiadire colonna per colonna, ciascuna al suo ritmo, oppure cancellare di mira solo la vecchia voce che sta per essere riscritta. Sbiadire alleggerisce tutto senza guardare che cosa butta via, cancellare di mira tiene in ordine una voce sola. Non sbiadire affatto, però, non vuol dire tenere tutto: le caselle restano quelle, le voci continuano ad ammucchiarsi una sopra l’altra, e più se ne ammucchiano meno pulita torna ciascuna. Anche questa manopola ha il suo prezzo, e si paga in velocità. Un calcolatore di oggi ha migliaia di piccoli operai che lavorano fianco a fianco, e rende quando gli si dà una cosa grossa sola invece di mille cose piccole in fila. Con una regola di sbiadire semplice, uguale per tutte le caselle, l’apparecchio sbriga la pagina intera in una volta e li tiene occupati tutti; più la regola guarda al dettaglio della singola voce, più quel lavoro in blocco si spezzetta, e chi resta senza il suo pezzo aspetta fermo. Quello che si compra in cambio è un registro tenuto in ordine, e riletture che tornano più precise.
La terza manopola decide se queste scelte sono fisse, uguali per ogni parola, o se invece è la parola stessa a deciderle, momento per momento. Una regola fissa sbiadisce allo stesso modo la data che servirà fra trecento pagine e l’intercalare che non serve a nessuno, perché guarda soltanto a quanto tempo è passato. Se decide la parola, la data si tiene intatta e l’intercalare cade subito: si dimentica in base a quello che si legge. Anche questo si paga: la scelta va rifatta a ogni parola, e non si può più preparare una volta sola all’inizio.
RetNet, GLA, DeltaNet e Mamba-2 sono lo stesso apparecchio con le manopole in posizioni diverse. E le posizioni si combinano: c’è chi gira insieme la manopola dello sbiadire in blocco e quella del cancellare di mira, e si chiama Gated DeltaNet. S4 e Mamba-1 gli somigliano molto, ma in loro ogni casella sbiadisce a un ritmo tutto suo, che dipende sia dalla riga sia dalla colonna, e nessuna posizione delle manopole lo riproduce: per entrare nell’apparecchio, Mamba-2 ci ha rinunciato.
In formule, lo stato è una matrice \(\mathbf{S}_t \in \mathbb{R}^{d\times d}\), una memoria che associa chiavi a valori; si scrive per prodotto esterno e si legge per proiezione:
dove \(\mathbf{q}_t, \mathbf{k}_t, \mathbf{v}_t\) sono query, chiave e valore del token \(t\) (gli stessi introdotti nell’attenzione dei Transformer) e \(\mathbf{v}_t \mathbf{k}_t^\top\) è la nuova coppia scritta in memoria. La transizione moltiplica a destra, e il lato conta: con lo stato fatto di colonne indicizzate dalle chiavi, è da quel lato che il fattore agisce sui canali di chiave (e che \(\mathbf{I} - \beta_t \mathbf{k}_t \mathbf{k}_t^\top\) cancella la traccia lasciata da \(\mathbf{k}_t\)); a sinistra sbiadirebbe i canali dei valori, che è un’altra cosa. Nelle sezioni precedenti la stessa transizione compariva a sinistra, \(\mathbf{h}_t = \bar{\mathbf{A}}\mathbf{h}_{t-1} + \dots\), e non è una contraddizione: lì lo stato era il vettore colonna \(\mathbf{h}\) di un singolo canale, cioè una riga di \(\mathbf{S}\) trasposta, e trasporre scambia i due lati. L’unico caso in cui il lato non conta davvero è quello di un fattore scalare, come l’\(\alpha_t\) di Mamba-2, che commuta con tutto.
Prima degli assi, i costi. Per il solo nucleo (senza le proiezioni lineari, che costano lo stesso in tutti i casi), su una sequenza di lunghezza \(L\) con \(D\) canali e stato \(N\) per canale:
addestramento |
un token in generazione |
memoria in generazione |
|
|---|---|---|---|
attenzione softmax |
\(O(L^2 D)\) |
\(O(LD)\) |
\(O(LD)\) (la cache) |
S4 (LTI, convoluzione) |
\(O(DL\log L)\), più il filtro in \(\tilde{O}(D(N+L))\) |
\(O(DN)\) |
\(O(DN)\) |
Mamba (scan selettivo) |
\(O(LDN)\) |
\(O(DN)\) |
\(O(DN)\) |
Mamba-2 (SSD a blocchi) |
\(O(LDN)\), quasi tutto in prodotti di matrici |
\(O(DN)\) |
\(O(DN)\) |
Le ultime due righe hanno lo stesso ordine: Mamba-2 non fa meno operazioni, le fa sui tensor core, ed è per questo che può permettersi un \(N\) di un ordine di grandezza più grande. La tabella dice come il costo cresce, e non quale modello sia più veloce: lo decidono le costanti e l’hardware.
Gli assi di progetto sono tre, e ciascuno ha un prezzo e un guadagno.
1. La dimensione dello stato. Quanto è grande \(d\) (o, per gli SSM, la dimensione \(N\) dello stato per canale). Uno stato più grande è una memoria più capiente (più coppie chiave-valore ci stanno senza pestarsi i piedi) ma costa più calcolo e più memoria a ogni passo, \(O(d^2)\) per l’aggiornamento. È la manopola della capacità grezza.
2. La struttura della transizione. È la vera firma di ogni architettura, e la tabella unificante del capitolo precedente la metteva in fila per struttura via via più ricca:
dove l’oblio è compreso fra \(0\) e \(1\) e cambia forma lungo la fila: dove moltiplica l’identità è lo scalare \(\alpha_t\), un numero solo; dentro \(\mathrm{Diag}\) è il vettore \(\boldsymbol{\alpha}_t \in (0,1)^d\), un valore per canale, e il grassetto è lì apposta per non far leggere le due cose come una sola. \(\beta_t \in (0,1)\) è invece la forza di scrittura della delta rule, e nelle due righe che la usano moltiplica anche il termine di scrittura, che diventa \(\beta_t\, \mathbf{v}_t \mathbf{k}_t^\top\). Si va dall’accumulo puro (identità, non si dimentica nulla) al decadimento scalare uniforme, a quello diagonale per-canale, alla correzione mirata di Householder che cancella la vecchia associazione prima di scrivere la nuova, fino alla combinazione dei due (decadimento globale più correzione mirata) del Gated DeltaNet [YKH25]. La fila però non è una scala regolare: i primi tre gradini sono nidificati (ciascuno contiene il precedente come caso particolare), mentre il decadimento diagonale e la correzione mirata di Householder sono capacità complementari, e il Gated DeltaNet unisce la seconda al decadimento scalare, lasciando fuori quello per canale (i suoi due casi limite sono discussi nella sezione sulla scrittura in memoria). Lungo tutta la catena, però, il conto è lo stesso: si paga in complessità della transizione (via via più difficile da rendere parallelizzabile) ciò che si guadagna in recall preciso. Non in state tracking. Grazzi e colleghi [GSZ+25] dimostrano che una ricorrenza lineare a precisione finita, le cui transizioni hanno autovalori tutti positivi, non risolve nemmeno la parità (dire se in una stringa di bit gli uni sono pari o dispari); con gli intervalli dichiarati per \(\alpha_t\) e \(\beta_t\) è il caso di ogni gradino della fila. La cura costa una riga: \(\beta_t \in (0,2)\) invece di \((0,1)\), così che l’autovalore \(1-\beta_t\lVert\mathbf{k}_t\rVert^2\) possa scendere fino a \(-1\) (e, per Mamba, \(\bar a_t \in (-1,1)\)). Con transizioni che sono prodotti di fattori di questo tipo, ciascuno con autovalori in \([-1,1]\), una pila di ricorrenze lineari, con tanti strati quanti ne chiede l’automa, riconosce qualunque linguaggio regolare; per contare modulo \(3\) serve invece un autovalore non reale, e una transizione triangolare a elementi reali non basta. È lo stesso segno meno, insieme a una transizione che copia una colonna dello stato su un’altra, che dà la sua capacità a RWKV-7, e l’autovalore non reale è l’esigenza a cui Mamba-3 risponde con le rotazioni.
3. Il grado di dipendenza dai dati. La transizione può essere fissa (scelta a priori, uguale per ogni token, come il \(\gamma\) di RetNet o il decadimento della RWKV-4) oppure dipendente dai dati, generata dall’input token per token, come in GLA, DeltaNet e Mamba [GD24]. La dipendenza dai dati è ciò che compra il ragionamento basato sul contenuto: decidere cosa tenere e cosa lasciar cadere in base a ciò che si legge, non solo a quanto tempo è passato. È il salto che separa un metal detector regolato una volta per tutte da una guardia che valuta caso per caso.
Su questa mappa gli SSM non sono un’isola, ma non ci stanno tutti allo stesso modo. Mamba-1 nella forma \(\mathbf{S}_{t-1}(\text{transizione}_t)\) non entra: il suo decadimento \(\exp(\Delta_{t,c}\, a_{c,n})\) ha un passo per canale del valore e un autovalore per dimensione dello stato, cioè un gate pieno applicato elemento per elemento, \(\mathbf{S}_t = \mathbf{G}_t \odot \mathbf{S}_{t-1} + \dots\), più ricco anche di quello di GLA e che nessun fattore a destra riproduce [YWS+24]: un fattore a destra agisce sulle colonne ed è uguale per tutte le righe, mentre qui cambia da riga a riga, cioè da canale a canale, attraverso \(\Delta_{t,c}\). Per la stessa ragione resta fuori S4, dove ogni canale ha il proprio passo \(\Delta_c\) (e, nella forma originale, una transizione piena, normale più basso rango). È la ricchezza a cui Mamba-2 rinuncia per tornare ai prodotti di matrici. La dualità stato-attenzione (SSD) di Mamba-2 [DG24], vista nella sezione sulla dualità, dimostra che un SSM con transizione scalare per identità (\(\alpha_t \mathbf{I}\)) calcola esattamente la stessa funzione di un’attenzione lineare mascherata: è la riga del decadimento scalare, raggiunta dal versante dei sistemi dinamici invece che da quello dell’attenzione. Le due famiglie si incontrano su quel gradino, e fuori da lì restano parenti.
Il collo di bottiglia dello stato fisso#
Il limite è strutturale: uno stato di taglia fissa non può contenere una quantità di informazione che cresce con la lunghezza del contesto. Si vede nel ritrovare alla lettera, in un contesto lunghissimo, un dettaglio letto centinaia di pagine prima; nel gergo del campo è il recall associativo esatto: data una chiave, restituire il valore che le era stato associato.
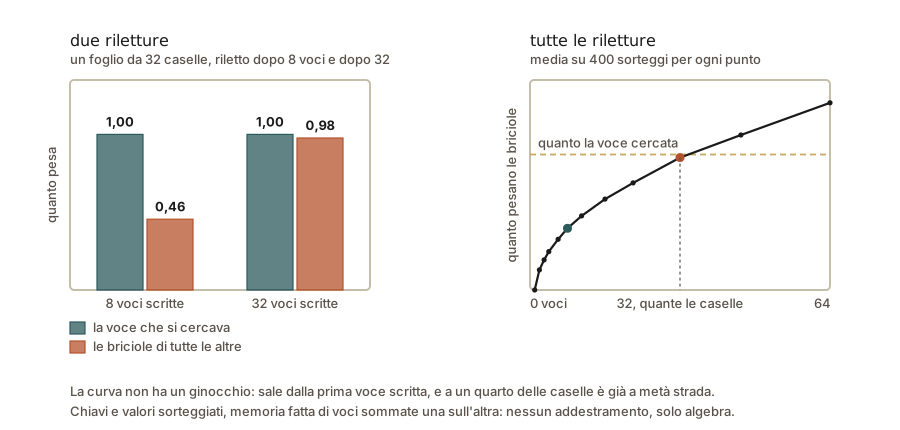
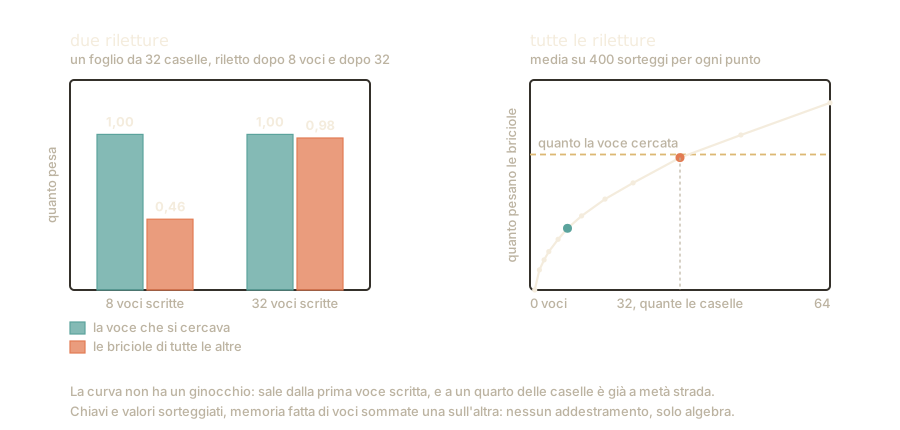
Fig. 18.6 Il guasto non aspetta che il foglio sia pieno. Scritte otto voci in un foglio da trentadue caselle, le briciole delle altre pesano già quasi la metà del valore che si cercava; scritte trentadue voci, cioè tante quante le caselle, pesano altrettanto. A destra la stessa misura per ogni numero di voci: una curva che sale dalla prima, senza nessun ginocchio a segnare una soglia.#
Un quaderno di appunti da una parte, una biblioteca dall’altra: la differenza è tutta lì. Il quaderno è il foglio-registro di sempre, che cambia nome per stare accanto alla biblioteca. L’attenzione piena dei Transformer è la biblioteca: conserva ogni parola letta, e quando le chiedi «cosa diceva esattamente quella frase a pagina 900?» va allo scaffale e la ripesca alla lettera. Il prezzo è doppio. Prima lo spazio: la biblioteca cresce senza fine, un ripiano per ogni pagina. Poi, e conta di più, il lavoro: ogni pagina nuova va confrontata con tutte quelle che sono già sugli scaffali, e così un libro lungo il doppio non costa il doppio ma il quadruplo. È il costo quadratico che volevamo evitare.
Le ricorrenze lineari sono invece un quaderno di appunti di taglia fissa. A ogni pagina che leggi aggiorni i tuoi appunti: riassumi, sovrascrivi, cancelli il vecchio per far posto al nuovo. Il quaderno peggiora da subito, un pochino a ogni pagina, finché quel pochino diventa troppo per la domanda che gli stai facendo. Quando le voci ammucchiate sono più o meno tante quante le caselle, quello che rileggi è per metà la voce che cercavi e per metà le briciole di tutte le altre, e in Fig. 18.6 si vede il conto, con quello che succede già molto prima. Il quaderno costa pochissimo: resta sempre dello stesso spessore per quante pagine tu legga. Ma proprio perché non cresce, non può contenere tutto: se dopo mille pagine ti chiedo di citare a memoria una frase precisa di pagina 900, il quaderno ti dà il senso generale, non le parole esatte. Le hai riassunte, non trascritte. Che sia proprio così lo si misura con due prove fatte apposta: nascondere una frase in un testo lunghissimo e chiedere di ripescarla alla lettera (è l’ago nel pagliaio), oppure riempire la memoria di centinaia di coppie nome-numero e chiedere a bruciapelo il numero di un nome qualsiasi. E l’abilità più comune, indovinare la parola che viene dopo, non lo rivela: un modello a quaderno ci riesce perfino meglio di uno a biblioteca della stessa taglia, e intanto sbaglia quando gli chiedi di ricopiare una pagina.
Non tutti i quaderni si tengono allo stesso modo, e si vede: chi cancella la voce vecchia prima di metterci la nuova, invece di lasciare che le scritte si sovrappongano, tiene nello stesso quaderno molta più roba leggibile. Ma sposta più in là la pagina che lo manda in crisi, non la toglie: lo spessore è quello, e prima o poi arriva la domanda a cui il quaderno non sa rispondere. Questo è il compromesso: memoria che costa poco e non cresce, in cambio della rinuncia al ricordo alla lettera di ogni singolo dettaglio.
La ragione è di capacità d’informazione. Uno stato \(\mathbf{S} \in \mathbb{R}^{d\times d}\) ha un numero finito di gradi di libertà: come osservato già nel lavoro sui fast weight programmer [SIS21], in dimensione \(d\) non esistono più di \(d\) direzioni mutuamente ortogonali. Attenzione a come si legge questo limite, perché la lettura sbagliata è la più comoda: l’interferenza fra associazioni non aspetta una soglia per comparire. Come si è visto nella sezione dalla softmax alla ricorrenza, con chiavi casuali il crosstalk cresce da subito, come \(\sqrt{N/d}\) nel numero \(N\) di coppie scritte (in questa formula e nel limite di Arora e colleghi più avanti, \(N\) conta le coppie: non è la dimensione dello stato di un SSM, che nel resto del capitolo porta la stessa lettera), e intorno a \(N \approx d\) vale ormai quanto il valore che si sta cercando. Non c’è un punto in cui la memoria «si riempie»: c’è un degrado continuo, che a un certo punto diventa intollerabile per il compito che si ha davanti. L’attenzione piena non ha questo tetto: la sua «memoria» è la KV cache, che conserva tutte le coppie chiave-valore dei token passati, al prezzo di crescere linearmente con la lunghezza (ed è quel prezzo a rendere il costo complessivo quadratico).
Questo divario si misura con i benchmark di recall. Nel needle in a haystack si nasconde un fatto preciso (l’ago) in un contesto molto lungo (il pagliaio) e si chiede al modello di recuperarlo verbatim. In MQAR (Multi-Query Associative Recall) [AET+23] si presentano molte coppie chiave-valore e si interroga il modello su chiavi arbitrarie. Sono proprio i compiti su cui la dimensione dello stato diventa il collo di bottiglia, e il limite è dimostrato, non solo osservato: qualunque modello ricorrente che legga l’ingresso in modo causale ha bisogno di uno stato di \(\Omega(N)\) bit per risolvere MQAR con \(N\) coppie [AEZ+24]. Uno stato di taglia fissa fallisce quindi oltre una certa quantità di coppie, qualunque sia la sua transizione; l’attenzione, che tiene \(O(N)\) coppie nella cache, lo risolve con un numero costante di strati. Per la copia vale un limite analogo: un modello a stato fisso con \(|\mathcal{S}|\) stati possibili, chiamato a copiare una stringa di \(L\) simboli presi a caso da un alfabeto \(\Sigma\), sbaglia con probabilità maggiore di \(1 - |\mathcal{S}|/|\Sigma|^{L}\), mentre un Transformer a due strati copia stringhe di lunghezza esponenziale nel numero delle sue teste [JBKM24]. Nei modelli addestrati il divario si vede nella copia e nella ricerca nel contesto più che nella perplessità: Mamba ha sul Pile una perplessità più bassa di Pythia di pari taglia, e nel copiare un testo o nel ritrovare un numero in un elenco perde nettamente. I progressi nella transizione aiutano (la delta rule di DeltaNet, che riscrive invece di accumulare, sposta in avanti la frontiera proprio perché usa meglio lo spazio disponibile) ma non spostano il tetto: finché lo stato è di taglia fissa, per il retrieval esatto su contesti sufficientemente lunghi l’attenzione piena resta superiore. Sul suo terreno conviene affiancarla, invece di sostituirla.
Il meglio dei due mondi: gli ibridi#
L’attenzione piena vince sul richiamo esatto, le ricorrenze lineari sul costo. Un modello è una pila di strati e ogni strato ha la sua memoria (la cache chiave-valore per l’attenzione, uno stato di taglia fissa per gli altri): niente impedisce di mescolare strati dei due tipi, pochi di attenzione dove serve ripescare un dettaglio preciso e molti lineari o SSM per il resto. Sono le architetture ibride, e ricorrono in gran parte dei lavori recenti. Il costo che cresce al quadrato non sparisce, ma lo paga una minoranza di strati, e finché il contesto non diventa smisurato pesa poco sul totale.
Un modello è una squadra di lettori in fila, e ognuno ha la sua memoria. Se a tutti dai una biblioteca, la squadra ricorda ogni parola ma costa come tante biblioteche; se a tutti dai un quaderno, costa poco, ma nessuno sa citare alla lettera. La squadra mista dà la biblioteca a pochi, quelli che servono quando bisogna ripescare la citazione esatta, e il quaderno a tutti gli altri, che tengono il filo a costo basso. Le architetture ibride sono organizzate così: qualche strato che conserva tutto e ricorda alla lettera, il resto a memoria costante. Sono fatti così Jamba, un modello di linguaggio dell’azienda AI21 Labs, e Samba, di Microsoft, tutti e due del 2024, e le versioni miste di architetture che abbiamo già incontrato. La divisione si può fare anche per tempo, ed è la ricetta di Samba: i lettori con la biblioteca tengono sugli scaffali soltanto le ultime pagine, e del lungo periodo si fidano dei quaderni dei compagni.
Due cose, però, la squadra mista non le fa sparire. Le biblioteche non sono abolite, solo ridotte a poche: se il testo si allunga a dismisura, quelle poche tornano a confrontare ogni pagina con tutte le altre, ed è di nuovo la spesa che si voleva evitare. E sulla citazione alla lettera una squadra di sole biblioteche resta più precisa: quella mista le arriva vicino, a una frazione del prezzo, e nelle prove più ampie sui compiti di tutti i giorni fa perfino meglio. I due tipi di memoria sono bravi in cose diverse, ed è tutto quello che serve perché convenga tenerli insieme.
L’idea compare, con dosaggi diversi, in gran parte dei lavori recenti, e i suoi autori se la passano dichiarandolo: il Gated DeltaNet scrive di seguire Griffin e Samba, e Mamba-2 cita Jamba. Ed è più vecchia di Mamba: già H3, fra il 2022 e il 2023, con due soli strati di attenzione superava il Transformer sullo stesso corpus [FDS+23]. Jamba (AI21 Labs, 2024) intervalla strati di attenzione e strati Mamba nel rapporto 1:7, con esperti selettivi (mixture-of-experts) a strati alterni; ha 52 miliardi di parametri, di cui 12 attivi per token, e regge contesti fino a 256 mila token con una cache chiave-valore otto volte più piccola di quella di un Transformer comparabile [LLB+24]. Samba [RLL+25] (Microsoft, 2024; ICLR 2025) combina strati Mamba con strati di attenzione a finestra scorrevole (sliding-window attention): l’attenzione locale copre il contesto ravvicinato, Mamba porta la memoria a lungo raggio, e insieme estrapolano a lunghezze molto oltre quella di addestramento. La stessa ricetta appare come variante ibrida sia del Gated DeltaNet [YKH25] (combinato con attenzione a finestra scorrevole o con strati Mamba-2) sia di Mamba-2 [DG24], il cui articolo studia esplicitamente l’aggiunta di pochi strati di attenzione a uno stack SSM e trova il punto migliore intorno al 10% di strati di attenzione.
La tendenza è la stessa in tutti questi lavori, e il messaggio è più solido e più modesto di «l’ibrido vince sempre». I due ingredienti hanno punti di forza complementari (recall verbatim l’uno, costo e memoria costanti l’altro), e i confronti controllati dicono che mescolarli in proporzione sbilanciata paga. Nello studio più ampio, a 8 miliardi di parametri e 3,5 mila miliardi di token di addestramento, un ibrido con il 43% di strati Mamba-2, il 7% di attenzione e il 50% di MLP supera il Transformer di pari taglia in tutti e dodici i compiti standard provati, di 2,65 punti in media, mentre i Mamba puri restano indietro dove serve copiare o imparare dal contesto [WBR+24]. È il motivo per cui la ricetta ricompare, con dosaggi diversi, in architetture per il resto lontanissime fra loro.
Dove sta andando#
Gli SSM e le ricorrenze lineari non hanno sostituito l’attenzione. Costano meno in tempo e memoria sui contesti lunghi e in generazione; su copia e richiamo esatto restano indietro, e per questo le versioni più riuscite sono ibride.
Un modello a stato fisso conviene anzitutto sui contesti molto lunghi, dove il costo quadratico dell’attenzione piena diventa proibitivo. In generazione, poi, non ha la cache chiave-valore (le chiavi e i valori di tutte le parole già viste) che in un Transformer cresce a ogni parola prodotta: la memoria che occupa mentre scrive resta quella con cui è partito, e la differenza si sente quando si serve il modello a molti utenti in parallelo. I flussi continui (streaming), dove i dati arrivano senza fine e non si può rileggere tutto a ogni passo, sono il suo terreno naturale. E sui dispositivi con poca memoria, come i telefoni, un’occupazione fissa e prevedibile vale più di qualche punto di qualità sul richiamo esatto.
La sezione sulle tendenze future del capitolo sui Transformer avvertiva che in questo campo le previsioni invecchiano in fretta, e già lì, fra le direzioni di ricerca, gli state space model comparivano come la linea che rimette in gioco idee ricorrenti dove l’attenzione costa troppo. La lezione di fondo è più generale: nessuna architettura ha vinto per sempre. Chi conosce le idee semplici che stanno sotto (una memoria in cui ogni parola scrive una coppia chiave-valore, un modo di decidere che cosa dimenticare, due forme dello stesso calcolo) riconosce lo stesso scheletro sotto il prossimo nome che farà rumore.
Da ricordare
Una sola famiglia: l’attenzione lineare (RetNet, GLA, DeltaNet, le versioni recenti di RWKV e la cella di xLSTM che tiene la memoria a griglia) e Mamba-2 sono lo stesso apparecchio, una memoria di taglia fissa che a ogni parola scrive una voce nuova e rilegge le vecchie. Si addestrano tutti insieme, in parallelo, e generano una parola alla volta con una memoria che non cresce mai. S4 e Mamba-1 gli somigliano molto, ma in loro ogni casella sbiadisce a un ritmo tutto suo, e nessuna posizione delle manopole lo riproduce.
Tre manopole di progetto: quanto è grande la memoria (la capacità grezza); come sbiadisce il passato quando arriva il presente (non dimenticare nulla, sbiadire tutto in blocco, sbiadire colonna per colonna, oppure cancellare di mira la vecchia voce che sta per essere riscritta); e se queste scelte sono fisse per ogni parola oppure decise dalla parola stessa, che è ciò che compra il ragionamento basato sul contenuto. Sbiadire e cancellare di mira la vecchia voce fanno cose diverse, e c’è un’architettura che le usa tutt’e due insieme, il Gated DeltaNet. È DeltaNet con in più la manopola dello sbiadire.
La dualità di Mamba-2 [DG24] dimostra che uno state space model che sbiadisce tutto in blocco fa esattamente lo stesso conto di un’attenzione lineare che guarda solo all’indietro e che per giunta sbiadisce man mano che si allontana, con lo sbiadire dentro il modo stesso in cui guarda. Le due famiglie si incontrano su quel gradino, e fuori da lì restano parenti.
Il limite onesto: una memoria che non cresce è un quaderno di appunti, non una biblioteca. Va benissimo per il senso del discorso, ma se dopo mille pagine chiedi di citare alla lettera una frase di pagina 900, il quaderno non ce l’ha: l’aveva riassunta, non trascritta. L’attenzione piena conserva ogni parola letta e su quel compito resta superiore, al prezzo di uno scaffale che cresce senza fine. Si misura con due prove fatte apposta: nascondere una frase in un testo lunghissimo e chiedere di ripescarla (è l’ago nel pagliaio), e riempire la memoria di centinaia di coppie nome-numero per poi chiedere a bruciapelo il numero di un nome qualsiasi. Indovinare la parola dopo, invece, non lo rivela.
Gli ibridi sono la ricetta che ricorre in gran parte dei lavori recenti: pochi strati di attenzione piena (quelli con la biblioteca, che ripescano la citazione esatta quando serve) intervallati a molti strati a memoria fissa (quelli col quaderno, che tengono il filo a costo basso), e nelle prove più ampie la squadra mista batte quella di sole biblioteche sui compiti di tutti i giorni. Fanno così Jamba [LLB+24], Samba [RLL+25] e le varianti ibride di Gated DeltaNet [YKH25] e Mamba-2.
Prospettiva sobria: le ricorrenze lineari non hanno sostituito l’attenzione, le si affiancano. Danno il meglio sui testi lunghissimi quando non serve ripescare una frase alla lettera, quando la memoria deve restare costante, sui dati che arrivano in flusso continuo e sui dispositivi con poca memoria. Nessuna architettura ha vinto per sempre: chi conosce le idee semplici riconosce lo stesso scheletro sotto ogni nuovo nome.
Da ricordare
Una sola famiglia: attenzione lineare (RetNet, GLA, DeltaNet, RWKV dalla v5, la cella mLSTM di xLSTM) e state space model a transizione scalare (Mamba-2) sono tutte RNN lineari a stato fisso \(\mathbf{S}_t = \mathbf{S}_{t-1}\, (\text{transizione}_t) + \mathbf{v}_t \mathbf{k}_t^\top\), con lettura \(\mathbf{o}_t = \mathbf{S}_t \mathbf{q}_t\). Si addestrano in parallelo, fanno inferenza ricorrente a memoria costante per token. Le due eccezioni ritagliate dal capitolo precedente restano fuori: la RWKV-4, il cui stato è un vettore per canale, e la cella sLSTM, che il mescolamento fra celle rende ricorrente e non parallelizzabile. Restano fuori anche S4 e Mamba-1: sono RNN lineari, ma con un decadimento che cambia da canale a canale (per Mamba-1 un gate elemento per elemento, \(\mathbf{S}_t = \mathbf{G}_t \odot \mathbf{S}_{t-1} + \dots\)), che nessun fattore a destra riproduce; è Mamba-2 a riportare l’SSM nella forma.
Tre manopole di progetto: la dimensione dello stato (capacità), la struttura della transizione (\(\mathbf{I} \to \alpha_t \mathbf{I} \to \mathrm{Diag}(\boldsymbol{\alpha}_t) \to \mathbf{I}-\beta_t \mathbf{k}_t \mathbf{k}_t^\top \to \alpha_t(\mathbf{I}-\beta_t \mathbf{k}_t \mathbf{k}_t^\top)\), via via più ricca, ma non è una scala in cui ogni gradino contiene il precedente: decadimento per canale e cancellazione mirata fanno cose diverse, e l’ultimo gradino unisce quest’ultima con il decadimento globale, non con quello per canale), e quanto dipende dai dati (fisso o generato dall’input, che compra il ragionamento basato sul contenuto).
La dualità SSD di Mamba-2 [DG24] dimostra che un SSM a transizione scalare (\(\alpha_t \mathbf{I}\)) calcola esattamente la stessa funzione di un’attenzione lineare mascherata: le due famiglie si incontrano su quel gradino, e fuori da lì si intersecano soltanto.
Il limite onesto: uno stato di dimensione fissa è un collo di bottiglia per il recall associativo esatto su contesti lunghissimi, e non perché si riempia a una certa soglia: l’interferenza fra associazioni cresce da subito, come \(\sqrt{N/d}\), e intorno a \(N\approx d\) coppie scritte vale quanto il valore cercato. L’attenzione piena, che conserva ogni token nella KV cache, resta superiore sul retrieval verbatim (benchmark needle in a haystack, MQAR) e sulla copia (errore \(> 1 - |\mathcal{S}|/|\Sigma|^L\) per uno stato con \(|\mathcal{S}|\) configurazioni): al prezzo del costo quadratico. La perplessità non lo rivela.
Gli ibridi sono la ricetta che ricorre in gran parte dei lavori recenti: pochi strati di attenzione piena intervallati a molti strati lineari o SSM (Jamba [LLB+24], Samba [RLL+25], le varianti ibride di Gated DeltaNet [YKH25] e Mamba-2). Recall esatto dove serve, costo basso per il resto: Jamba tiene un rapporto 1:7, Mamba-2 trova il meglio intorno al 10% di attenzione, e a 8 miliardi di parametri un ibrido con il 7% di attenzione supera il Transformer in dodici compiti su dodici [WBR+24].
Prospettiva sobria: le ricorrenze lineari non hanno sostituito l’attenzione, le si affiancano. I loro punti di forza sono il contesto lunghissimo quando non serve il richiamo alla lettera, l’inferenza a memoria costante, lo streaming e i dispositivi con poca memoria. Nessuna architettura ha vinto per sempre: chi conosce le idee semplici riconosce lo stesso scheletro sotto ogni nuovo nome.
Dall’attenzione lineare agli SSM escono una mappa e un limite. La mappa è quella delle ricorrenze lineari a stato fisso, che si distinguono per la forma della transizione, per la dimensione dello stato e per quanto dipendono dai dati, e su cui l’attenzione lineare e gli SSM si incontrano. Il limite è che uno stato di taglia fissa non restituisce alla lettera tutto ciò che ha letto: per questo l’attenzione piena resta il termine di paragone, e le versioni più usate sono ibride. Il capitolo su Visione e linguaggio cambia materia, e si chiede come far incontrare in una stessa rete le parole di una lingua e i puntini di luce di un’immagine, che hanno nature opposte.