


Prestazioni e scala: spremere l’hardware#
Nell’autunno del 2012 la gara mondiale di riconoscimento di immagini, ImageNet, fu vinta con un distacco mai visto da una rete neurale, AlexNet: 60 milioni di parametri addestrati su 1,2 milioni di fotografie [KSH12]. Il dettaglio che colpisce, riletto oggi, è l’attrezzatura: non un supercomputer, ma due schede grafiche da videogiocatori (GeForce GTX 580, circa 500 dollari l’una) montate in un normale PC, che macinarono il dataset per cinque-sei giorni. E già nell’introduzione gli autori scrissero, con disarmante franchezza, che i risultati sarebbero migliorati «semplicemente aspettando GPU più veloci e dataset più grandi». Avevano ragione: da allora il deep learning e l’hardware sono cresciuti insieme, ciascuno tirandosi dietro l’altro. Reti più grandi giustificano chip più potenti, chip più potenti rendono pensabili reti più grandi.
Finora hai costruito il cosa: tensori, moduli, training loop. Qui la
domanda è quanto in fretta: perché la GPU è lo strumento giusto, come
dimezzare i byte per (quasi) raddoppiare la velocità, come si misura un tempo
su una GPU, cosa fa torch.compile, come si addestra su più schede, da quali
valori conviene far partire i pesi, e cosa conta davvero quando di scheda ce
n’è una sola, o nessuna. Il capitolo successivo, «GPU e
calcolo parallelo», apre poi il cofano dell’hardware: com’è fatta una GPU,
cos’è davvero un kernel, da dove nasce la velocità di una moltiplicazione tra
matrici, e come si divide un modello che in una scheda sola non ci sta.
Perché la GPU: moltiplicazioni indipendenti#
Nella sezione sui tensori il gesto era .to(device); qui c’è
il perché. Il punto di partenza è che i conti di una rete neurale, visti
dall’hardware, sono quasi soltanto una cosa: moltiplicazioni fra tabelle di
numeri (le matrici dell’algebra lineare), cioè milioni di prodotti e somme
tutti uguali fra loro e, soprattutto, in gran parte indipendenti: ogni numero
del risultato si calcola senza aspettare gli altri.
Le squadre a cui affidare quel lavoro sono due. La prima è la CPU: otto operai straordinariamente qualificati, capaci di qualunque compito complicato (decisioni, eccezioni, lavori sempre diversi). La seconda è la GPU: decine di migliaia di manovali che sanno fare solo operazioni elementari, ma tutti insieme, nello stesso istante. Se il lavoro è «prendi questi due numeri, moltiplicali, somma il risultato» ripetuto milioni di volte, la squadra dei manovali stravince: non serve intelligenza, serve manodopera. E le reti neurali sono esattamente quel lavoro.
Un esempio con i numeri. Uno strato che collega 1000 neuroni ad altri 1000: ciascuno dei mille di destra deve raccogliere un contributo da ciascuno dei mille di sinistra, quindi sono un milione di moltiplicazioni per una sola immagine. Su un vassoio di 64 esempi diventano 64 milioni, per un singolo strato, a ogni passo dell’addestramento. Sono conti che una CPU macina in fila, uno dopo l’altro, mentre una scheda grafica li fa a migliaia nello stesso istante, perché era nata per fare esattamente questo con i pixel dei videogiochi.
C’è un modo di sprecare i manovali, ed è anche il più facile. Basta lasciarli senza materiale. Mille braccia ferme in attesa che arrivi il camion valgono quanto un operaio solo, e un camion che fa mille viaggi con un mattone per volta è molto peggio di uno che ne porta un bancale. Il materiale sono i numeri, e la strada che li porta dal magazzino, la memoria, al cantiere, le unità di calcolo, è stretta rispetto al piazzale: per buona parte della giornata quello che decide quanti muri si tirano su è quanto materiale riesce ad arrivare, non quante braccia ci sono ad aspettarlo.
Il prodotto tra una matrice \((M, K)\) e una \((K, N)\) costa circa \(2MNK\) operazioni in virgola mobile, e le \(MN\) componenti del risultato sono indipendenti fra loro (ciascuna è una somma di \(K\) prodotti): un parallelismo di dati quasi perfetto. Le GPU adottano un’architettura throughput oriented (migliaia di unità di calcolo semplici; modello SIMT, single instruction, multiple threads: i thread di un gruppo eseguono la stessa istruzione, ciascuno sui propri dati e con i propri registri), mentre le CPU sono latency oriented (pochi core complessi, ottimizzati per il singolo flusso di istruzioni). Alle unità semplici molte GPU NVIDIA affiancano i tensor core, dedicati proprio al prodotto tra piccole matrici. Il collo di bottiglia, più spesso del calcolo, è il movimento dei dati: la banda di memoria interna della GPU e, peggio ancora, il bus PCIe che separa CPU e GPU. Per questo i dati si spostano a batch interi invece che un esempio alla volta, perché ogni trasferimento paga una latenza fissa oltre ai byte, e per questo tenere la GPU rifornita conta quanto la GPU stessa.
Metà dei byte, quasi doppia velocità: la precisione mista#
Ogni numero di un tensore float32 occupa 4 byte, cioè 32 bit (un byte sono
otto bit, e il nome float32 viene da lì). Ma servono davvero tutti? L’idea
della precisione mista [MNA+18] è usare numeri da 16
bit, cioè lunghi la metà, nei punti dove la precisione piena non serve, e
tenere il float32 dove invece è indispensabile.
Perché numeri più corti facciano andare più veloce non è ovvio, e le ragioni sono due. La prima vale per le operazioni limitate dalla memoria, che in una rete sono molte (le attivazioni, le normalizzazioni, le somme dei residui): lì il tempo se ne va soprattutto a spostare i numeri fra la memoria e le unità di calcolo, che per gran parte del tempo aspettano. Dimezzare la lunghezza dei numeri dimezza il traffico, e il tempo scende quasi come lui.
La seconda vale per i prodotti fra matrici grandi, limitati dal calcolo, e riguarda i tensor core: circuiti costruiti apposta per moltiplicare piccole tabelle di numeri corti, accanto alle unità di calcolo normali, che entrano in funzione solo se i numeri sono corti davvero. Le schede NVIDIA per datacenter li hanno dal 2017, quelle da videogiocatori dalla serie GeForce RTX, del 2018.
Per pesare le patate non serve il bilancino del farmacista: la bilancia da
cucina basta, ed è più sbrigativa. Un numero in precisione piena porta con sé
circa 7 cifre significative; uno in mezza precisione circa 3. Per la maggior
parte dei conti di una rete (attivazioni, moltiplicazioni), tre cifre bastano,
e scrivere numeri lunghi la metà significa spostare metà dei byte: dove il
tempo se ne va a spostarli, quasi il doppio della velocità, quasi gratis, e
sulle schede che hanno circuiti apposta per i numeri corti vanno più in fretta
anche i conti. C’è però un’insidia: i numeri piccolissimi.
Certi gradienti sono così minuscoli che, arrotondati a 16 bit, diventano zero
spaccato, e un gradiente a zero è una lezione persa: quel peso non impara più.
Il rimedio è una lente d’ingrandimento: prima di calcolare i gradienti si
moltiplica la loss per un fattore grande, così anche i gradienti minuscoli
restano visibili; subito prima di aggiornare i pesi, si divide per lo stesso
fattore e tutto torna alla scala giusta. In PyTorch la lente si chiama
GradScaler, e il fattore non lo devi scegliere tu. Lo raddoppia finché tutto
fila, e quando ha ingrandito troppo, cioè quando qualche numero esce dai
margini del foglio, butta via quel giro di correzioni e riprende con la metà
dell’ingrandimento. I valori che sceglie sono sempre potenze di due
(\(65\,536\) è il più comune, cioè \(2^{16}\)), e c’è una ragione. Un numero in
virgola mobile è scritto in binario, e moltiplicarlo per una potenza di due fa
quello che moltiplicare per mille fa a un numero scritto in decimale: sposta la
virgola e lascia le cifre come sono. La lente ingrandisce e non sporca.
Corti però non sono tutti i numeri. Chi pesa segna man mano su un quaderno, e il totale sul quaderno lo tiene con tutte le cifre. Se sul quaderno c’è \(0{,}512\) e la correzione del giro vale \(0{,}0002\), tre cifre non bastano a farla entrare, e il totale segna ancora \(0{,}512\); con tutte le cifre la correzione entra e si somma alle altre. Diecimila correzioni di quella misura spostano il totale di due unità intere, oppure non lo spostano affatto, e la differenza sta tutta in quante cifre il quaderno tiene. Per questo le pesate si fanno sbrigative e la contabilità no, e i pesi della rete restano lunghi anche mentre i conti di passaggio viaggiano corti.
float32 ha 1 bit di segno, 8 di esponente, 23 di mantissa; float16
rispettivamente 1, 5, 10, quindi non solo meno precisione, ma anche un
intervallo dinamico molto più stretto: i gradienti sotto la soglia dei
denormali vanno in underflow a zero. Il loss scaling di
[MNA+18] moltiplica \(\mathcal{L}\) per un fattore \(s\)
prima del backward, i gradienti scalano linearmente,
\(\nabla(s\mathcal{L}) = s\nabla\mathcal{L}\), e divide per \(s\) prima dello
step; GradScaler adatta \(s\) dinamicamente: parte da \(s = 2^{16}\), lo
raddoppia dopo \(2000\) passi di fila senza traboccamenti, e appena un gradiente
è inf o NaN lo dimezza e salta l’aggiornamento (il float16 si ferma a
\(65\,504\), quindi un \(s\) troppo grande trabocca in alto invece che in
basso). I pesi del modello restano in float32 (autocast li converte
al volo solo dentro le singole operazioni), perché aggiornamenti piccoli su
pesi a 16 bit si perderebbero per arrotondamento (è l’idea della copia
master del paper). L’alternativa moderna è bfloat16 (1, 8, 7): stesso
esponente del float32, quindi stesso intervallo dinamico e niente scaler, al
prezzo di una mantissa più corta; è il formato preferito sulle GPU NVIDIA da
Ampere in poi e sulle TPU, dov’è nato. Un terzo formato lavora anche senza
essere chiesto: sulle GPU da Ampere in poi le convoluzioni di cuDNN usano per
default il TF32 (8 bit di esponente, 10 di mantissa) dentro i tensor core,
mentre i prodotti fra matrici restano in float32 pieno finché non si chiama
torch.set_float32_matmul_precision("high").
Nel ciclo di addestramento, la precisione mista aggiunge
cinque righe. La prima, all’inizio, crea il GradScaler, che moltiplica la
loss prima del backward(). Poi autocast, il gestore di contesto che si
scrive attorno alle due righe della previsione e della loss e che dentro
sceglie, operazione per operazione, quali eseguire in sedici bit e quali in
float32. Infine tre righe prendono il posto delle solite backward() e
step(): scaler.scale(loss).backward(), scaler.step(optimizer), che
riporta i gradienti in scala prima di aggiornare i pesi, e scaler.update(),
che ricalibra il fattore.
Una sola avvertenza, sul formato che autocast usa: di formati corti ne
esistono due, float16 e bfloat16, e il codice sceglie il secondo quando
gira senza scheda grafica. La differenza fra i due emergerà dall’esecuzione;
per ora basta sapere che sono due modi di scrivere un numero in sedici bit.
import torch
from torch import nn

torch.manual_seed(0)                             # stessi numeri a ogni lancio

dispositivo = "cuda" if torch.cuda.is_available() else "cpu"
# su GPU si usa float16, che ha bisogno del GradScaler; su CPU l'autocast
# lavora in bfloat16, che ne fa a meno
mezza = torch.float16 if dispositivo == "cuda" else torch.bfloat16

model = nn.Sequential(nn.Flatten(), nn.Linear(28 * 28, 128), nn.ReLU(),
                      nn.Linear(128, 10)).to(dispositivo)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
train_loader = [(torch.randn(16, 1, 28, 28), torch.randint(0, 10, (16,)))
                for _ in range(3)]               # tre batch finti, per far girare il ciclo

scaler = torch.amp.GradScaler(dispositivo)       # fattore di scala della loss

for i, (X, y) in enumerate(train_loader):
    X, y = X.to(dispositivo), y.to(dispositivo)
    optimizer.zero_grad()
    with torch.autocast(dispositivo, dtype=mezza):
        y_pred = model(X)                        # forward in mezza precisione
        loss = criterion(y_pred, y)
    scaler.scale(loss).backward()                # loss amplificata, poi backward
    scaler.step(optimizer)                       # gradienti riportati in scala
    scaler.update()                              # ricalibra il fattore di scala
    print(f"batch {i}: loss {loss.item():.4f} | uscita {y_pred.dtype}"
          f" | loss {loss.dtype}")
batch 0: loss 2.2802 | uscita torch.bfloat16 | loss torch.float32
batch 1: loss 2.3753 | uscita torch.bfloat16 | loss torch.float32
batch 2: loss 2.3972 | uscita torch.bfloat16 | loss torch.float32
Tre righe, una per batch, e su una scheda grafica l’uscita sarebbe
torch.float16 invece di torch.bfloat16. Dove autocast accetta i sedici
bit sono le moltiplicazioni fra tabelle (linear, le convoluzioni, matmul),
cioè il grosso del lavoro; dove li rifiuta sono le operazioni numericamente
delicate, e quali siano dipende dal dispositivo. Su GPU, in float16, la
documentazione di PyTorch elenca fra le operazioni tenute in float32 le somme
lunghe come sum e norm, softmax e log_softmax, exp e log, le
normalizzazioni e le loss; su CPU, in bfloat16, che ha lo stesso intervallo
del float32, l’elenco si accorcia alle loss e a poche altre operazioni, come
quelle di algebra lineare. La riga stampata lo fa vedere: l’uscita del modello
è davvero in mezza precisione, la loss in float32, e questo mentre i pesi,
sul disco e in memoria, sono rimasti tutti quanti a 32 bit. Le conversioni
avvengono al volo, dentro le singole operazioni, e il modello non lo tocca
nessuno.
Ed eccola, la differenza fra i due formati corti. Un numero, dentro un
computer, si scrive in due pezzi: uno dice quanto è grande (l’ordine di
grandezza: miliardi, oppure miliardesimi) e l’altro dice con quante cifre
lo si conosce. I sedici bit si possono spartire fra i due pezzi in modi
diversi, e i due formati corti fanno appunto scelte diverse. Il float16 tiene
più cifre e meno grandezza; il bfloat16 fa il contrario, e arriva agli
stessi estremi del float32, cioè in giù fino a numeri con trentasette zeri
dopo la virgola, e altrettanto in su.
La conseguenza pratica è che con il bfloat16 il problema dei gradienti
minuscoli, quello per cui serviva il GradScaler, non si pone proprio: nessun
gradiente finisce a zero perché era troppo piccolo per essere scritto. Si
perdono cifre decimali, che qui non servono, e si guadagna la semplicità: lo
scaler si può togliere del tutto. Sulle GPU recenti si sceglie scrivendo
dtype=torch.bfloat16.
Nel blocco della precisione mista lo scaler c’è comunque, perché il codice deve girare in tutti e due i casi, e con il bfloat16 non si spegne da solo: resta acceso e continua a moltiplicare per \(65\,536\), senza fare né bene né male, perché moltiplicare e poi dividere per una potenza di due restituisce i numeri identici a com’erano. In un programma scritto per il solo bfloat16 quelle righe si tolgono.
Misurare davvero: la coda asincrona#
Prima di ottimizzare qualcosa bisogna saperlo misurare, e qui c’è una trappola in cui cade praticamente chiunque la prima volta.
Quando scrivi un’operazione su GPU, Python non aspetta che venga eseguita. La mette in coda e prosegue subito con la riga successiva. È il motivo per cui la GPU riesce a stare occupata: mentre lavora su un’operazione, il programma le sta già preparando le prossime.
La conseguenza è che un cronometro attorno a un pezzo di codice misura il tempo di accodare le operazioni, non quello di eseguirle. È così che nascono i confronti assurdi, del tipo «PyTorch è mille volte più veloce di NumPy»: non è veloce, è che non ha ancora fatto niente.
Per misurare sul serio bisogna dire esplicitamente «fermati qui finché la GPU non ha finito», e lo si dice due volte, una prima di far partire il cronometro, perché nella coda può esserci ancora il lavoro di poco fa, e una alla fine, prima di leggere il tempo. Vale anche al contrario, quando si legge un risultato: se una riga sembra lentissima, spesso a essere lenta è la prima che ha avuto bisogno del risultato e ha dovuto aspettare tutta la coda accumulata prima.
La coda però è anche un’occasione. Il vassoio di esempi successivo può mettersi in viaggio verso la scheda mentre quella sta ancora lavorando su quello di adesso, e il viaggio finisce per non costare niente, perché avviene nel frattempo. C’è una condizione, che si dimentica quasi sempre. Il vassoio deve stare in un punto fisso, non su uno scaffale che ogni tanto viene riordinato; se qualcuno nel frattempo lo ha spostato, chi va a prenderlo deve prima cercarlo, e allora il viaggio comincia quando la scheda è già ferma ad aspettare. Chiedere la partenza anticipata senza la sua condizione non fa guadagnare niente.
Le chiamate CUDA sono asincrone rispetto all’host: vengono inserite in uno
stream e ritornano immediatamente. La sincronizzazione avviene solo in punti
precisi, e conviene conoscerli perché sono anche i punti dove il codice
rallenta senza motivo apparente: un .item(), un .cpu(), una print del
tensore, un if che dipende da un valore calcolato sulla GPU. Ognuno di questi
è una barriera implicita, ed è il motivo per cui loggare la loss a ogni passo
può costare parecchio.
Per cronometrare correttamente serve torch.cuda.synchronize() prima di
far partire il cronometro (per svuotare la coda pregressa) e dopo il blocco
da misurare. In alternativa si usano i torch.cuda.Event, che si registrano
nello stream e misurano sul lato GPU senza bloccare l’host, ed è ciò che fanno
i profiler seri.
Da qui anche un pattern utile: tensore.to(device, non_blocking=True)
sovrappone il trasferimento al calcolo, ma solo se la memoria sorgente è
pinned (bloccata in pagine non swappabili), che è ciò che fa
pin_memory=True nel DataLoader. Senza quella condizione l’opzione non ha
effetto, ed è una delle micro-ottimizzazioni più spesso copiate senza le sue
premesse.
Ecco un programma che misura la stessa identica cosa in due modi, una volta aspettando che la scheda abbia finito e una volta no, e stampa i due tempi affiancati.
import time
import torch

dispositivo = "cuda" if torch.cuda.is_available() else "cpu"
A = torch.randn(1024, 1024, device=dispositivo)

def cronometra(sincronizza):
    """Il parametro decide se aspettare la GPU alla fine: True sì, False no."""
    if dispositivo == "cuda":
        torch.cuda.synchronize()          # parti da una coda vuota
    t0 = time.perf_counter()
    for _ in range(10):
        B = A @ A
    if sincronizza and dispositivo == "cuda":
        torch.cuda.synchronize()          # aspetta che la GPU abbia finito DAVVERO
    return time.perf_counter() - t0

for _ in range(3):                        # riscaldamento, fuori dal cronometro
    A @ A

print(f"dispositivo: {dispositivo}")
senza = min(cronometra(False) for _ in range(3))   # il minimo, non la prima misura
con   = min(cronometra(True)  for _ in range(3))
print(f"senza synchronize: {senza * 1000:8.2f} ms")
print(f"con synchronize  : {con   * 1000:8.2f} ms")
if dispositivo == "cpu":
    print(f"(su CPU non c'è coda asincrona: i due numeri sono dello stesso "
          f"ordine, qui a {abs(con - senza) / senza:.0%} di distanza)")
Due precauzioni in questo codice sono la regola per cronometrare qualunque cosa, e non solo questa. La prima è il riscaldamento: le prime chiamate pagano costi che le successive non pagano (l’avvio dei thread di calcolo, la memoria che si scalda), quindi si fanno girare a vuoto e non si misurano. La seconda è prendere il minimo di più ripetizioni invece della prima misura: il minimo è il giro in cui il computer è stato meno disturbato da altro, ed è la statistica meno rumorosa che si possa usare su una macchina condivisa.
Su CPU, con queste due precauzioni, i due numeri si equivalgono a meno del rumore di misura (qualche punto percentuale, in un senso o nell’altro), perché lì la coda non c’è: la CPU esegue e basta. Questa è la prova in bianco, quella che si fa apposta dove il fenomeno non deve comparire, e serve a dimostrare che la differenza che vedremo sulla GPU è del fenomeno e non del modo di misurare. Su una GPU, invece, la prima riga stampa un tempo assurdamente piccolo e la seconda quello vero. Conviene rifare questo esperimento su una scheda vera appena se ne ha una sottomano: se non la si ha, la presta gratis Google Colab, che è un servizio con cui si eseguono notebook dal browser su macchine altrui, purché si ricordi di chiedere una GPU nelle impostazioni del notebook prima di partire.
Il cronometro dice quanto, non dove. Per sapere dove va il tempo serve un
profilatore, che registra ogni operazione eseguita con la sua durata:
torch.profiler lo fa su un giro di addestramento del modello della precisione
mista, con i suoi tre batch finti, e la tabella che stampa (i tempi cambiano da
una macchina all’altra) mette in testa le operazioni più care.
from torch.profiler import profile, ProfilerActivity

attivita = [ProfilerActivity.CPU]
if dispositivo == "cuda":
    attivita.append(ProfilerActivity.CUDA)
with profile(activities=attivita) as prof:
    for X, y in train_loader:
        X, y = X.to(dispositivo), y.to(dispositivo)
        optimizer.zero_grad()
        criterion(model(X), y).backward()
        optimizer.step()
print(prof.key_averages().table(sort_by="cpu_time_total", row_limit=5))
Se in testa alla tabella ci sono copie e attese sui dati invece dei prodotti fra matrici, il collo di bottiglia è la catena dei dati; se ci sono moltissime operazioni minuscole, ciascuna con il suo viaggio in memoria, conviene fonderle, ed è il mestiere della compilazione.
Una riga per compilare: torch.compile#
Il grafo che si costruisce mentre il codice gira, visto nell’apertura del capitolo (in inglese si dice define-by-run), ha un costo: eseguire il modello un’operazione alla volta significa che ogni operazione paga il viaggio verso la memoria della GPU. Da PyTorch 2.0 (2023) esiste il rimedio, e sta in una riga:
model = torch.compile(model) # tutto qui: il resto del codice non cambia
È la differenza tra un cuoco che legge la ricetta una riga alla volta, apre il
frigo, prende il burro, chiude il frigo; apre il frigo, prende le uova…, e
uno che la legge tutta in anticipo e si organizza: un solo viaggio al frigo
con tutto l’occorrente. torch.compile legge il tuo modello per intero, si
accorge che tre operazioni consecutive possono diventare una sola, e riscrive
i passaggi in una versione ottimizzata. Il patto è chiaro: la prima esecuzione
è più lenta, perché studiare la ricetta costa; le successive sono più
veloci. Conviene quindi quando lo stesso piatto va cucinato migliaia di volte
(un addestramento lungo su un modello grande) e non conviene per un assaggio:
su un esperimento di due minuti il tempo di compilazione mangia tutto il
guadagno.
E il piano vale finché il servizio resta quello. Se cambia il numero di coperti, cioè la forma dei dati che arrivano (un vassoio di esempi più grande, frasi più lunghe), la ricetta studiata non torna più, così il cuoco si rimette a leggere da capo e paga di nuovo lo studio. Per accorgersene in tempo, prima di ogni piatto dà un’occhiata di controllo, e anche quell’occhiata costa. Su un piatto da due ingredienti costa più di quanto la riorganizzazione faccia risparmiare, e allora la cucina organizzata resta più lenta di quella disordinata anche dopo il primo giro. Si può finire in perdita e restarci, altro che pareggiare. E se nella ricetta c’è un passaggio che si decide solo assaggiando (quanto sale, a seconda di com’è venuto), il cuoco non può organizzare tutto prima: la studia a pezzi, prima e dopo l’assaggio, e il guadagno si riduce.
Sotto la riga lavorano due componenti: TorchDynamo intercetta il bytecode
Python e ne estrae un grafo di operazioni; TorchInductor genera kernel fusi
(su GPU, in Triton). La kernel fusion è il guadagno principale: tre
operazioni elemento-per-elemento in sequenza diventano un kernel unico che
legge e scrive la memoria una volta invece di tre; decisivo perché molte reti
sono memory bound, limitate dalla banda più che dal calcolo. Il grafo è
protetto da guard: se cambiano le forme dei tensori o i valori Python da cui
dipende un ramo del codice, si ricompila (altro overhead). Sulle forme, PyTorch
si difende da sé: alla prima ricompilazione dovuta a una dimensione cambiata la
tratta come simbolo, e dynamic=True lo fa fin dall’inizio. Dove il codice
Python non si lascia tracciare (un if su un valore del tensore, un print,
una chiamata a una libreria esterna) il grafo si spezza in più pezzi, i graph
break, ciascuno compilato a parte: torch._dynamo.explain ne elenca i punti,
e fullgraph=True trasforma uno spezzamento in un errore. Le modalità contano
anche loro: mode="default" bilancia guadagno e tempo di compilazione,
"reduce-overhead" usa i CUDA graph contro il costo del lancio dei kernel,
"max-autotune" prova più implementazioni dei prodotti fra matrici e compila
più a lungo. Nei benchmark con cui PyTorch 2.0 è stato presentato (163 modelli
open source su una GPU A100) il guadagno medio in addestramento era del 43%,
una media pesata fra il 21% in float32 e il 51% con precisione mista, ma la
varianza è alta: modelli grandi e statici guadagnano di più, modelli piccoli o
dalle forme variabili poco, nulla, o meno di zero: il pavimento non è la
parità. Sulla MLP di MNIST in CPU la prima compilazione costa da sola una
decina di secondi, contro un addestramento che dura minuti, e a regime il
compilato resta più lento dell’eager, da una frazione a più del doppio a
seconda del carico. Su CPU l’inductor gioca in trasferta, e il fattore non si
trasferisce a una GPU, dove va rimisurato. La regola pratica: attivalo quando
l’addestramento dura ore, misura, e tienilo solo se il cronometro dà ragione.
Più GPU, un solo modello: il parallelismo dati#
Quando una GPU non basta, la strategia più comune divide i dati e lascia intero il modello. Ogni GPU riceve una copia identica della rete e una fetta del mini-batch, e calcola i gradienti sulla propria fetta; poi le copie si riallineano con un’operazione collettiva, l’all-reduce, in cui ogni processo contribuisce con il proprio vettore e tutti ricevono la somma dei vettori di tutti, qui divisa per il numero di copie, cioè la media (Fig. 7.16). Quanto costi, e perché quasi non cresca con il numero di schede, lo racconta la sezione sul parallelismo distribuito.

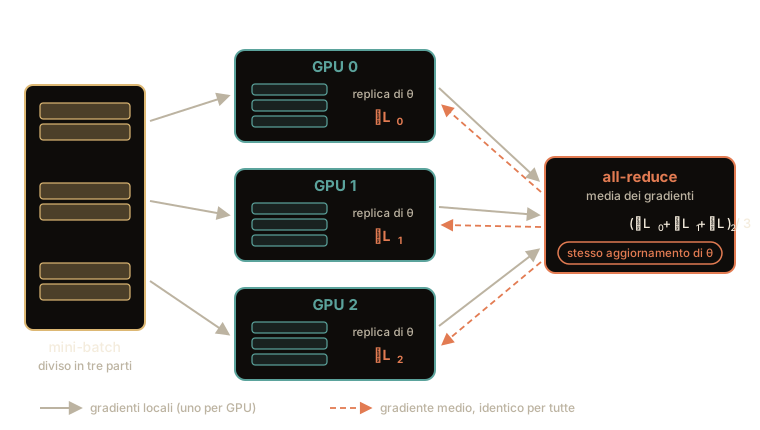
Fig. 7.16 Parallelismo dati: ogni GPU calcola i gradienti sulla propria fetta di batch; l’all-reduce ne fa la media e la restituisce a tutte, che restano così copie identiche.#
Trecento verifiche da correggere, tre insegnanti, una sola griglia di valutazione, che si migliora strada facendo come se imparasse dai compiti che vede. Ognuno prende cento compiti e una fotocopia della griglia, e correggendo annota le modifiche che farebbe: «questa domanda va pesata di più», «qui l’errore è meno grave». A fine pila i tre si riuniscono, fanno la media delle proposte e la applicano tutti e tre, identica, alla propria fotocopia. Risultato: hanno corretto in un terzo del tempo, e le tre griglie sono ancora perfettamente uguali, come se avesse corretto una persona sola, ma tre volte più in fretta.
Le pile però devono essere uguali, e per questo si contano prima. Se uno ne corregge centocinquanta e un altro cinquanta, la media delle tre proposte pesa i cinquanta compiti quanto i centocinquanta, e la griglia che ne esce non è quella che sarebbe uscita correggendo tutta la pila di seguito. E il trucco funziona perché ogni compito si giudica per conto suo: se il voto di un compito dipendesse dagli altri della stessa pila, per esempio dalla media della pila, tre pile darebbero tre medie diverse, e le proposte messe insieme non sarebbero più quelle di una persona sola. Ogni ritocco, poi, nasce ora da trecento compiti e non dai cento che vede un correttore da solo: un compito strano capitato nella pila lo sposta di meno, e per questo lo si può fare un po’ più deciso.
Le GPU fanno lo stesso: ognuna elabora la sua fetta di esempi, poi tutte mettono in comune i gradienti, ne fanno la media e si aggiornano allo stesso modo. La riunione ha un nome tecnico, all-reduce, e un costo: se gli insegnanti passano più tempo a riunirsi che a correggere, il gioco non vale la candela.
Con \(R\) repliche e il batch spartito in fette, ogni replica \(r\) calcola \(\nabla_\theta \mathcal{L}_r\) sulla propria fetta; l’all-reduce calcola
dove \(\mathcal{L}_r\) è la loss media sulla fetta della replica \(r\). Se le
fette hanno la stessa dimensione, questa media è il gradiente sull’intero
batch, a meno degli arrotondamenti: cambia solo chi fa i conti. L’uguaglianza
richiede però che la loss sia una media di termini per esempio, e che nessuno
strato accoppi gli esempi del batch. Non vale con la batch normalization, che
calcola le sue statistiche sulla sola fetta (a meno di SyncBatchNorm), né con
le loss che usano gli altri esempi come negativi, come quelle contrastive: ogni
replica vede solo i negativi della propria fetta. Lo standard è
DistributedDataParallel (DDP): un processo per GPU, comunicazione NCCL, e
l’all-reduce eseguito durante il backward, a pacchetti (bucket), così che
comunicazione e calcolo si sovrappongano. Il batch efficace diventa \(R\) volte
quello per replica: al crescere di \(R\) va ritoccato il learning rate, con le
regole di scalatura della sezione sul replicare un paper. Il vecchio DataParallel (processo unico, multi-thread)
sopravvive nei tutorial ma è sconsigliato dalla documentazione stessa: il GIL
di Python (un thread alla volta esegue bytecode, come si è visto nel capitolo
su Python) e lo sbilanciamento sulla GPU 0 ne fanno un reperto storico. DDP
gira un processo per GPU proprio per questo: un GIL a testa.
In codice questo si chiama DDP, da DistributedDataParallel, ed è più uno
schema che una libreria da imparare. Questo schema non si
lancia con python: serve un programma di avvio, torchrun, che fa partire
un processo per ogni GPU e dice a ciascuno chi è.
# SCHEMA, si lancia con: torchrun --nproc_per_node=4 addestra.py
import os
import torch
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP
from torch.utils.data import DataLoader
from torch.utils.data.distributed import DistributedSampler

dist.init_process_group("nccl")                 # collega i 4 processi
rank = int(os.environ["LOCAL_RANK"])            # chi sono io? (0, 1, 2 o 3)
torch.cuda.set_device(rank)

model = DDP(model.to(rank), device_ids=[rank])  # replica sincronizzata

sampler = DistributedSampler(train_data)        # a ognuno la sua fetta
loader = DataLoader(train_data, batch_size=64, sampler=sampler)

for epoca in range(epoche):
    sampler.set_epoch(epoca)                    # rimescola in modo coordinato
    for X, y in loader:
        ...                                     # il corpo del ciclo e' quello
                                                # di sempre: l'all-reduce
                                                # avviene da solo dentro
                                                # loss.backward()
dist.destroy_process_group()
Il punto notevole sono gli ultimi commenti: il corpo del ciclo non cambia. DDP
intercetta il backward() e ci innesta la media dei gradienti; tutto il resto
(loss, ottimizzatore, precisione mista) è il codice che già conosci. Cambia
quello che sta attorno: i dati vanno sul dispositivo del proprio processo, log
e checkpoint si scrivono da un processo solo, di solito il primo (quello con
rank uguale a 0), e una metrica calcolata nel ciclo (la loss media,
l’accuratezza di validazione) vale per la fetta di quel processo, quindi va
messa in comune con dist.all_reduce prima di riportarla.
Partire col piede giusto: nn.init#
Fin qui si è guadagnato tempo su ogni passo dell’addestramento. Resta il numero di passi che servono, e dipende anche da dove partono i pesi.
Prima di imparare qualunque cosa, i pesi di una rete sono numeri a caso, e la domanda è quanto grandi. Se sono troppo piccoli, il segnale che entra da una parte si smorza attraversando gli strati e dall’ultimo esce quasi zero, e con lui si smorzano le correzioni che dovrebbero tornare indietro: l’addestramento stenta a partire. Se sono troppo grandi succede il contrario, segnale e correzioni si gonfiano strato dopo strato fino a esplodere.
Le due ricette classiche sono quella di Glorot (detta anche Xavier, dal nome di battesimo dell’autore) [GB10] e quella di He (da Kaiming He) [HZRS15]. Fissano la varianza dei pesi in base al numero di collegamenti: \(2/(n_{\text{in}} + n_{\text{out}})\) per Glorot e \(2/n_{\text{in}}\) per He, con \(n_{\text{in}}\) e \(n_{\text{out}}\) il numero di ingressi e di uscite dello strato. Più ingressi, pesi più piccoli, perché tanti contributi sommati devono restare della stessa misura. La prima è pensata per le attivazioni simmetriche attorno allo zero, come la tangente iperbolica, che trattano positivi e negativi allo stesso modo; la seconda per la ReLU, che i negativi li schiaccia a zero e quindi lascia passare circa metà del segnale, e per compensare raddoppia la varianza: con tanti ingressi quante uscite, \(2/n_{\text{in}}\) contro il \(1/n_{\text{in}}\) di Glorot. La sezione sull’inizializzazione ne dà la derivazione; qui vediamo il gesto con cui si applicano.
I default di PyTorch non sono né Glorot né He, benché si legga spesso il
contrario: per nn.Linear il default è una variante uniforme ereditata dal
vecchio Torch, che sorteggia i pesi fra \(-1/\sqrt{n_{\text{in}}}\) e
\(+1/\sqrt{n_{\text{in}}}\) (nel sorgente di nn.Linear è kaiming_uniform_ con
a=math.sqrt(5), che nonostante il nome dà proprio questa uniforme). Su uno
strato da mille ingressi, \(\sqrt{1000}\) fa circa \(31{,}6\), quindi i pesi
nascono tutti fra \(-0{,}032\) e \(+0{,}032\): piccoli, e più piccoli di He. La
loro dispersione attorno allo zero, la varianza, vale \(1/(3n_{\text{in}})\), un
sesto dei \(2/n_{\text{in}}\) di He, e in una pila di strati con la ReLU il
segnale perde a ogni strato un fattore \(\sqrt{6} \approx 2{,}4\) in ampiezza
(trascurando i bias). Su tre strati l’uscita parte già circa quindici volte più
piccola che con He (\(6^{3/2} \approx 14{,}7\)), e su una rete profonda, dove il
fattore si moltiplica a ogni strato, il segnale svanisce: è il caso in cui la
ricetta esplicita serve davvero. Le ricette pronte stanno in torch.nn.init, e
i loro nomi finiscono tutti con un trattino basso: è la convenzione con cui
PyTorch segna le funzioni che riscrivono il tensore che ricevono, invece di
restituirne uno nuovo.
from torch import nn

def inizializza(m):
    if isinstance(m, nn.Linear):
        nn.init.kaiming_normal_(m.weight, nonlinearity="relu")  # ricetta He
        nn.init.zeros_(m.bias)

model.apply(inizializza)   # applica la funzione a ogni sotto-modulo
apply() visita ricorsivamente tutti i sotto-moduli e passa ciascuno alla
funzione; l’if isinstance fa da filtro, così solo gli strati nn.Linear
ricevono la ricetta He (kaiming, dal suo nome di battesimo). Lo stesso
schema
serve per qualunque intervento mirato sui pesi di una rete già costruita.
E chi non ha otto GPU?#
Per imparare non serve un cluster, cioè un gruppo di computer collegati che lavorano insieme: AlexNet, da cui siamo partiti, girava su due schede da videogiocatori dentro un PC. Per chi ha una GPU, o nessuna, le leve che spostano il cronometro sono più modeste e più vicine:
Riempi la GPU: alza il
batch_sizefinché la memoria regge (quando non regge più, PyTorch protesta con un out of memory: si abbassa e si riprova). Una GPU mezza vuota spreca tempo; un batch più grande cambia però anche l’ottimizzazione, e il learning rate va ricontrollato con le regole della sezione sul replicare un paper.Rifornisci la GPU: se l’utilizzo della scheda langue, il collo di bottiglia è spesso la catena dei dati, non il calcolo. Nel
DataLoader,num_workers(fino a quanti sono i core del processore, cheos.cpu_count()conta) prepara i batch in parallelo mentre la GPU lavora, epin_memory=Trueaccelera il trasferimento.Precisione mista anche in piccolo: i tensor core li hanno tutte le GeForce RTX, e quelle cinque righe sono spesso il guadagno più grande per riga di codice su una GPU da videogiocatori.
Nessuna GPU? Google Colab ne offre una gratis, con limiti di tempo e di disponibilità; gli esempi che usano una scheda sola ci girano, lo schema DDP, che ne chiede più d’una, no.
E prima di ogni ottimizzazione, la regola che vale a ogni scala: misura. Un
cronometro attorno a un’epoca, con time.perf_counter(), dà il tempo totale;
un’epoca è abbastanza lunga perché il riscaldamento pesi poco, ma su una scheda
grafica, prima di leggere il cronometro, serve la sincronizzazione della coda
asincrona, o si misura soltanto il tempo di accodare. Dove va quel tempo lo
dice il profilatore. E nvidia-smi, un comando che si scrive nel terminale
mentre l’addestramento gira, mostra in GPU-Util la percentuale di tempo in
cui la scheda stava eseguendo almeno un’operazione: può essere vicina al cento
per cento anche quando lavora soltanto una piccola parte dei circuiti, quindi
dice se la scheda sta ferma, non quanto è piena. Ottimizzare senza misurare è
potare un albero al buio.
Da ricordare
I conti di una rete neurale, visti dall’hardware, sono quasi soltanto moltiplicazioni di tabelle di numeri: milioni di conti identici e in gran parte indipendenti. È il lavoro perfetto per una scheda grafica, che è fatta di migliaia di operai semplici invece che di pochi bravissimi, purché i numeri le arrivino abbastanza in fretta.
La precisione mista usa numeri corti dove bastano e lunghi dove servono: dove il tempo se ne va a spostare numeri, quasi il doppio della velocità, quasi gratis, e di più sulle schede con i tensor core. L’unica insidia sono i numeri piccolissimi, e c’è una lente d’ingrandimento apposta.
Un cronometro attorno a un conto su GPU misura il tempo di accodarlo: per quello vero bisogna aspettare che la scheda abbia finito. Dove va il tempo lo dice un profilatore.
torch.compilelegge il modello tutto insieme e riorganizza i passaggi: conviene sugli addestramenti lunghi, non sugli assaggi, perché studiare la ricetta costa e su un modello minuscolo può costare più di quanto rende.Se le schede sono più d’una, ognuna prende una fetta del vassoio, e alla fine tutte mettono in comune le correzioni e ne fanno la media. Il corpo del giro di addestramento non cambia, e funziona finché ogni esempio si giudica per conto suo.
Anche da quali numeri si parte conta: troppo piccoli e il segnale si spegne attraversando la rete, troppo grandi e esplode. Ci sono ricette pronte.
Su una macchina sola le leve che spostano il cronometro sono tre: riempire la scheda, rifornirla di dati, usare i numeri corti. E prima di tutto, misurare: ottimizzare senza misurare è potare un albero al buio.
Da ricordare
I conti delle reti neurali sono soprattutto prodotti di matrici: \(MN\) componenti indipendenti, ciascuna una somma di \(K\) prodotti, il lavoro perfetto per le migliaia di core semplici di una GPU, se la banda di memoria li tiene riforniti. Il deep learning moderno nasce da questo incontro [KSH12].
La precisione mista [MNA+18] usa 16 bit dove basta e 32 dove serve:
autocast+GradScaler(obfloat16senza scaler) per un guadagno quasi gratuito su qualunque GPU con tensor core. Quali operazioni restano infloat32dipende dal dispositivo.Le chiamate CUDA sono asincrone: si cronometra con
torch.cuda.synchronize()prima e dopo, e il tempo per operazione lo dàtorch.profiler.GPU-Utildinvidia-smimisura la frazione di tempo con almeno un kernel in esecuzione, non l’occupazione della scheda.torch.compile(PyTorch 2.0) fonde i kernel in una riga: paga su modelli grandi e addestramenti lunghi, non sugli esperimenti brevi, dove il compilato può risultare più lento dell’eager. I graph break lo frenano, e le forme che cambiano costano ricompilazioni, chedynamic=Trueprova a evitare.Il parallelismo dati replica il modello su ogni GPU, spartisce il batch e media i gradienti con l’all-reduce: lo standard è
DistributedDataParallel, lanciato contorchrun; il corpo del ciclo non cambia. La media dei gradienti delle fette è il gradiente del batch solo se nessuno strato accoppia gli esempi (non con la batch normalization, non con le loss contrastive), e log, checkpoint e metriche vanno scritti tenendo conto delrank.nn.initconapply()applica le inizializzazioni di Glorot e di He (kaiming_normal_) che la sezione sull’inizializzazione motiverà; il default dinn.Linearnon è nessuna delle due.Su una macchina sola contano
batch_size,num_workers, la precisione mista, e il cronometro prima di tutto: riscaldamento fuori dalla misura e minimo di più ripetizioni, non la prima.
Gli attrezzi per far correre un addestramento ora ci sono tutti: numeri corti
dove bastano, il cronometro con la sincronizzazione e il profilatore, la
compilazione, più schede che si spartiscono il batch, i pesi che partono dalla
scala giusta. Una riga, però, l’hai usata senza aprirla: .to(device),
quella che sposta il modello e i dati sulla scheda grafica. Funziona, cambia i
tempi di un addestramento, e finora ne hai visto il perché, non il come. Il
capitolo su GPU e calcolo parallelo apre quella scatola:
che cos’è un kernel, perché a decidere è così spesso la banda di memoria invece
del calcolo, come lavorano i tensor core, e che cosa si fa quando il modello in
una scheda sola non ci sta e dividere i dati non basta più. Da lì in poi
«lento» smette di essere un’impressione e diventa qualcosa che si sa dove
andare a cercare.