


La ciliegina: il dibattito sul rinforzo#
Nella torta di LeCun l’apprendimento per rinforzo è la ciliegina: un’immagine efficace e una retrocessione netta, per una materia che ha richiesto due capitoli, Reinforcement Learning e Deep Reinforcement Learning. La critica va presa sul serio, perché a muoverla sono ricercatori del campo, e perché l’argomento che le sta sotto è quello del conto d’apertura del capitolo: quanto è grande la correzione che il modello riceve.
Le posizioni che seguono sono di persone in attività su una questione aperta, e ciascuna va attribuita a chi l’ha sostenuta. La cautela serve, perché due di queste tesi si somigliano abbastanza da essere scambiate.
L’argomento, in due mosse#
Le critiche all’apprendimento per rinforzo «puro» (cioè usato da solo per costruire un sistema a partire da zero) sono quattro. Due riguardano la scarsità del segnale, che porta pochissima informazione, e l’assegnazione del credito, cioè il dover dividere quel poco fra tutte le decisioni che l’hanno preceduto; e vanno viste come due mosse dello stesso ragionamento, non come obiezioni separate.
Le altre due sono la ricompensa scritta male e ottimizzata alla lettera (nel capitolo sul deep reinforcement learning e nella sezione sul post-addestramento) e il costo in esperienza dell’imparare per tentativi nel mondo invece che dentro un modello del mondo, che è la tesi del capitolo sui world model.
Torniamo alla giornata nel bosco, quella al termine della quale qualcuno ti dice soltanto «oggi hai fatto bene».
La prima obiezione è quella che già conosciamo: è pochissimo. Una frase per una giornata intera. Se invece qualcuno ti avesse commentato ogni singolo avvistamento, avresti ricevuto migliaia di volte più informazione.
La seconda obiezione è più insidiosa, e non riguarda la quantità: riguarda il fatto che quella frase, per essere utile, va distribuita. Nella giornata hai fatto centinaia di cose. Hai preso il sentiero giusto, ti sei fermato troppo presto a una radura, hai avuto la pazienza di aspettare mezz’ora sotto un faggio, e a un certo punto hai fatto rumore e hai fatto volare via tutto. Alla fine il giudizio è positivo. Che cosa impari? Che la giornata è andata bene: quindi, non sapendo distinguere, tendi a ripetere tutto, compresa la sosta inutile e il rumore.
Rimediare si può, in parte. Confronta la giornata con le tue solite, e un «bene» come quello di sempre smette di giustificare tutto. Fatti accompagnare da qualcuno che, dopo tante uscite, provi a dirti come sta andando mentre ancora cammini. E da” più peso a quello che hai fatto poco prima di un avvistamento riuscito che a quello che avevi fatto sei ore prima, perché a quella distanza la colpa e il merito si perdono comunque. Sono rimedi veri, e aiutano a smistare. Ma nemmeno chi ti accompagna ha mai sentito altro che la frase della sera: nessuno di quei rimedi inventa quello che nessuno ha detto.
Le due obiezioni si moltiplicano invece di sommarsi. Poca informazione sarebbe già un problema; poca informazione, e da spalmare su centinaia di decisioni che non sai distinguere, è un problema di un altro ordine. E più lunga è la giornata, più sono le decisioni fra cui dividerla. Rifare la stessa giornata dieci volte, con dieci frasi la sera, non cambia la sostanza: ogni giornata riceve ancora una frase sola, da dividere fra tutto quello che ci hai fatto.
La prima mossa è quantitativa, ed è il tetto già calcolato: con una ricompensa binaria, come quella verificabile dei problemi di matematica, il bersaglio nel rinforzo porta al più un bit per episodio, mentre nel pre-addestramento auto-supervisionato il tetto è dell’ordine di \(10^5\) bit per esempio, e anche contando l’entropia reale del testo, fra \(2 \cdot 10^4\) e \(4 \cdot 10^4\) bit, restano quattro ordini di grandezza. È il rapporto che stampa il programma dell’apertura del capitolo. Campionare più risposte allo stesso problema, come fanno i metodi a gruppi della sezione sul post-addestramento, moltiplica i bit per problema al più per il numero delle risposte, ma non cambia niente di quello che segue, perché ciascuna risposta riceve ancora un voto solo.
La seconda mossa è strutturale e riguarda l’assegnazione del credito (credit assignment). Un ritorno osservato \(R\) alla fine di una traiettoria \(\tau = (s_0, a_0, \dots, s_{T-1}, a_{T-1})\) non dice quale delle \(T\) azioni abbia contribuito. Nella forma più semplice del gradiente di policy, con la ricompensa soltanto alla fine dell’episodio e senza sconto (il caso della ricompensa verificabile), il ritorno accumulato dal passo \(t\) in poi è lo stesso numero \(R\) per ogni \(t\), e la stima del gradiente diventa
dove \(M\) è il numero di traiettorie campionate e \(J(\theta)\) il ritorno atteso della politica. Lo scalare \(R^{(m)}\) è uno per traiettoria, e moltiplica il gradiente di ogni azione di quella traiettoria: le azioni buone e quelle cattive di un episodio riuscito ricevono lo stesso coefficiente, tutte spinte verso l’alto. Con ricompense passo per passo i ritorni dal passo \(t\) in poi differirebbero da un passo all’altro, ma resterebbero comunque somme di tutto quello che viene dopo. La sezione su REINFORCE e actor-critic mostra come si attenua il problema (una linea di base per ridurre la varianza, un critico che stima il vantaggio azione per azione, lo sconto che accorcia l’orizzonte di attribuzione), e sono attenuazioni vere; ma nessuna di esse fabbrica informazione che nel segnale non c’era.
Le due mosse si compongono: pochi bit, e per giunta da distribuire su un numero di decisioni che cresce con la lunghezza dell’episodio.
Il disegno di Fig. 30.2 mostra la seconda mossa mentre avviene, che è l’unico modo di vederla: da ferma sembrerebbe soltanto una fila di riquadri tutti uguali, ed è proprio quell’«uguali» il problema.

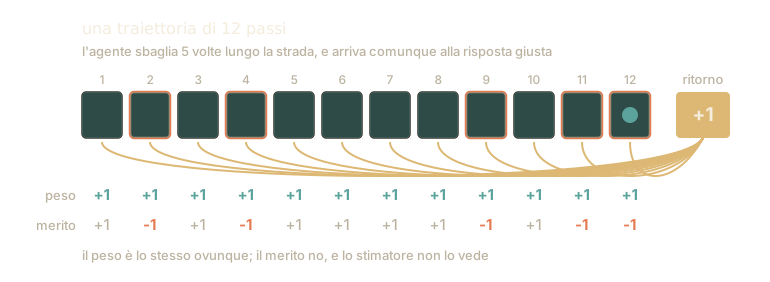
Fig. 30.2 Un solo numero alla fine, e poi indietro su tutto. La riga del peso è quella che l’algoritmo applica davvero a ciascun passo, ed è la stessa dappertutto; la riga del merito è quella che l’algoritmo non vede, e cambia da passo a passo fra più uno e meno uno. I passi bordati di terracotta sono quelli in cui l’agente ha sbagliato, e ricevono la stessa spinta di tutti gli altri.#
Che cosa propone LeCun al suo posto#
Per LeCun la conseguenza di questo argomento non è che il rinforzo sia inutile, ma che sia nel posto sbagliato: va bene per rifinire una policy, cioè la regola con cui un agente sceglie che cosa fare, quando la comprensione del mondo è già stata costruita altrove, e non va bene come modo di costruirla.
Nel capitolo sui modelli a energia c’è l’elenco delle quattro rinunce che LeCun ripete nelle sue conferenze, e la quarta dice: abbandonare l’apprendimento per rinforzo in favore del controllo predittivo basato su modello, cioè costruirsi un modello di come va il mondo, pianificare dentro quello, e ricorrere ai tentativi soltanto per correggere il modello quando la previsione sbaglia.
Il conto sui bit dell’apertura del capitolo spiega quella rinuncia. Se ogni interazione col mondo vero paga pochi bit, allora un sistema che impara soltanto interagendo è condannato a un numero di interazioni che nessun corpo fisico può permettersi; se invece la comprensione del mondo si costruisce guardando, cioè con un segnale grande quanto il dato, l’interazione serve solo là dove la previsione fallisce, ed è pochissima. È la stessa aritmetica, letta come progetto di macchina.
È una posizione dentro un dibattito aperto, non un risultato: dice come andrebbe costruita una macchina, e le macchine costruite così non sono ancora quelle che funzionano meglio. La via di LeCun, nel capitolo sui world model, la prende sul serio esattamente in questi termini.
Come lo dice Karpathy#
Andrej Karpathy, fra i fondatori di OpenAI e dal 2017 al 2022 responsabile dell’intelligenza artificiale in Tesla, ha formulato l’argomento in modo particolarmente netto in un’intervista del 17 ottobre 2025 [Kar25b]. Descrive che cosa succede quando si addestra un modello a risolvere un problema di matematica generando centinaia di tentativi e tenendo quelli che arrivano alla risposta giusta. Ogni tentativo è una traiettoria, la sequenza dei passi con cui il modello arriva a una risposta, e alzarne il peso vuol dire rendere più probabili, la volta dopo, tutte le scelte che la compongono:
Il modo in cui mi piace dirlo è che stai aspirando la supervisione attraverso una cannuccia. Hai fatto tutto questo lavoro, che poteva essere un minuto di svolgimento, e stai aspirando i bit di supervisione del segnale di ricompensa finale attraverso una cannuccia, e li stai diffondendo a tutta la traiettoria, e usi quello per alzare o abbassare il peso di quella traiettoria.[1]
E sulla seconda mossa, l’assegnazione del credito, è ancora più netto:
Assume quasi che ogni singolo pezzetto della soluzione che hai prodotto e che è arrivato alla risposta giusta fosse la cosa corretta da fare, il che non è vero. Puoi essere finito in vicoli ciechi prima di arrivare alla soluzione giusta. Ognuna di quelle cose sbagliate che hai fatto, purché tu sia arrivato alla soluzione corretta, verrà rinforzata come «fanne ancora». È terribile. È rumore.[2]
Nella stessa risposta, però, dice anche altro, e senza quel pezzo la posizione diventa un’altra:
L’apprendimento per rinforzo è terribile. Si dà solo il caso che tutto quello che avevamo prima sia molto peggio, perché prima ci limitavamo a imitare le persone.
e, poche righe dopo, che il rinforzo permette di fare meglio della sola imitazione, che su certi problemi si può migliorare senza avere traiettorie di esperti da copiare, e che «il modello può anche scoprire soluzioni che una persona potrebbe non trovare mai. È incredibile. Eppure, è ancora stupido».
Non è dunque una richiesta di abbandonare il rinforzo. È la tesi che lo strumento che oggi si usa sia molto peggiore di come viene percepito, e che il campo abbia bisogno di qualcosa in più.
Un’attribuzione da rimettere a posto#
Accanto alla critica di Karpathy ce n’è un’altra, abbastanza vicina da essere scambiata con la sua, e tenerle distinte serve: si fa presto ad attribuire una posizione a chi non l’ha espressa, solo perché il racconto suona plausibile.
La tesi è questa: l’apprendimento per rinforzo applicato ai modelli linguistici non aggiungerebbe capacità nuove, si limiterebbe a restringere e selezionare percorsi di ragionamento che il modello aveva già acquisito nel pre-addestramento.
È una tesi tecnica precisa, ed è di Yang Yue e colleghi [YCL+25], in un lavoro uscito nell’aprile 2025. È una misura e non un’opinione, e come è fatta è la parte interessante.
Come si fa a misurare se un addestramento ha aggiunto capacità o solo messo ordine in quelle che c’erano? Gli autori usano un’idea semplice: invece di chiedere al modello una risposta, gliene chiedono tante alla stessa domanda, e contano se almeno una è giusta.
Se ne chiedi una sola, il modello addestrato col rinforzo vince: è più affidabile, azzecca più spesso al primo colpo. Ma se gliene chiedi moltissime, succede il contrario: è il modello di partenza, quello che il rinforzo non ha mai toccato, a risolvere problemi che l’altro non risolve, e nelle misure degli autori il sorpasso arriva già a qualche decina o qualche centinaio di tentativi, non a numeri irraggiungibili.
La lettura degli autori è che l’addestramento non abbia quasi mai insegnato qualcosa di nuovo: abbia reso più probabili alcune strade che il modello sapeva già percorrere, e nel farlo abbia reso improbabili le altre. Più preciso, e più stretto.
Attenzione a non tirare la conclusione più in là di dove arriva la misura, e sono gli autori i primi a dirlo. Il trucco delle tante risposte non si può spingere all’infinito: se i tentativi fossero un numero assurdo, prima o poi anche battendo i tasti a caso salterebbe fuori la risposta giusta, e il confronto non direbbe più niente. Quello che è stato misurato è il modo in cui questo addestramento si faceva nella primavera del 2025, non un limite di principio. E infatti un lavoro di poche settimane dopo, allungando di molto l’addestramento e variando i problemi, ha trovato un modello che risolve problemi su cui quello di partenza non riesce mai, comunque si insista.
Il protocollo è il pass@\(k\): la probabilità che almeno una fra \(k\) risposte campionate indipendentemente alla stessa domanda sia corretta. È una misura del confine delle capacità, non della loro affidabilità: per \(k = 1\) premia chi azzecca al primo colpo, per \(k\) grande premia chi possiede la soluzione da qualche parte nella propria distribuzione, anche se raramente. Non lo si stima con \(k\) tentativi soli, che darebbero una stima molto variabile: per ogni problema si campionano \(n \ge k\) risposte, di cui \(c\) corrette, e si usa lo stimatore non distorto introdotto per la generazione di codice [CTJ+21],
mediato sui problemi; nel lavoro di Yue e colleghi \(n\) è il \(k\) più grande delle curve, cioè 128, 256 o 1024.
Il risultato, nelle parole della versione finale dell’articolo (RLVR è il rinforzo con ricompensa verificabile, quella che un controllo automatico assegna senza il giudizio di nessuno): «l’addestramento attuale suscita di rado schemi di ragionamento fondamentalmente nuovi. Mentre i modelli addestrati con RLVR superano i loro modelli base per valori più piccoli di \(k\) (per esempio \(k=1\)), i modelli base ottengono un punteggio pass@\(k\) più alto quando \(k\) è grande» [YCL+25]. La prima versione, dell’aprile 2025, era più netta sul primo punto («non» suscita) e più cauta sul secondo (punteggio «paragonabile o perfino più alto»). Gli autori osservano inoltre che il confine delle capacità di ragionamento spesso si restringe al procedere dell’addestramento. Sui problemi di matematica i modelli base sono Qwen2.5 da 7, 14 e 32 miliardi di parametri e LLaMA-3.1-8B, confrontati con le loro versioni addestrate con GRPO; un confronto a parte riesegue sei algoritmi diffusi di RLVR nelle stesse condizioni, e li trova simili fra loro. Si campiona a temperatura \(0{,}6\), con top-\(p\) \(0{,}95\) e fino a \(16\,384\) token per risposta. Le curve pubblicate arrivano al più a \(k = 1024\), e il sorpasso non richiede di arrivare fin lì: avviene «man mano che \(k\) cresce fino a decine o centinaia», e sul banco di prova Minerva, con il modello da 32 miliardi di parametri, a \(k = 128\) il modello base risolve circa il 9% di problemi in più di quello addestrato.
Tre avvertenze, e le pone il lavoro stesso. La prima: la misura riguarda gli schemi di ragionamento accessibili per campionamento, quindi la conclusione è sulla distribuzione del modello base, non sull’impossibilità in linea di principio. La seconda: il pass@\(k\) non si estrapola all’infinito, e sono gli autori a dirlo, perché «con un \(k\) astronomicamente grande perfino il campionamento uniforme sul dizionario dei token inciamperebbe nel percorso di ragionamento corretto». La terza: il titolo è una domanda, e la risposta che dà è sull’impostazione di addestramento corrente, con gli algoritmi e i benchmark esaminati. Trasformarla in «il rinforzo non serve» è un salto che il lavoro non autorizza.
E l’impostazione corrente ha una data. Sei settimane dopo la prima versione, ProRL [LDL+25] risponde esplicitamente a Yue e colleghi, attribuendo il loro risultato a due limiti di metodo: problemi quasi solo di matematica, su cui i modelli sono spesso già addestrati fin troppo, e addestramenti di poche centinaia di passi. ProRL ne fa più di duemila, tiene sotto controllo la divergenza da una politica di riferimento che di tanto in tanto viene aggiornata, e allarga i compiti a codice, problemi scientifici, rompicapi logici e istruzioni da seguire; e riporta un modello da un miliardo e mezzo di parametri che supera il modello di partenza su un ampio intervallo di \(k\), compresi problemi su cui il modello di partenza fallisce «qualunque sia il numero di tentativi». Riconosce anche che su alcune prove di matematica il proprio modello ha un confine uguale o più stretto di quello di partenza, come avevano osservato Yue e colleghi. Le due misure non si contraddicono su un fatto: dicono che la risposta dipende da quanto, e su che cosa, si addestra, e la domanda resta aperta.
Le due posizioni sono compatibili e vanno tenute distinte: Karpathy dice che il segnale è povero e mal distribuito; Yue e colleghi misurano che, con l’impostazione della primavera del 2025, il confine delle capacità non si allarga. Ma questa seconda tesi non è di Karpathy, e chi le fonde gli attribuisce una misura che non ha fatto e una conclusione che lui stesso contraddice nella stessa intervista, quando dice che il rinforzo fa scoprire soluzioni che una persona potrebbe non trovare.
E chi non è d’accordo#
Fermarsi alle critiche darebbe un’impressione falsa: mentre si discuteva di ciliegine l’apprendimento per rinforzo ha ottenuto due risultati grossi, e non si possono ignorare.
La prima è che gli assistenti conversazionali che tutti usano sono rifiniti così. La sezione sul post-addestramento mostra il conto: un modello piccolo ma rifinito sulle preferenze umane batteva, nel giudizio delle persone, un modello più di cento volte più grande. Se il rinforzo è una ciliegina, è una ciliegina che ha cambiato il sapore della torta (e oggi parte di quell’effetto si ottiene anche senza rinforzo, con l’ottimizzazione diretta delle preferenze che la stessa sezione racconta).
La seconda è più recente e più diretta al punto. I modelli cosiddetti «ragionanti» si addestrano col rinforzo su problemi a risposta verificabile (la correttezza di un risultato matematico, il superamento di una batteria di test per il codice), dove la ricompensa non richiede il giudizio di nessuno. Lì non solo il metodo funziona, ma fa emergere comportamenti che non erano stati programmati, come rileggere i propri passaggi e cambiare strada. Il resoconto è quello del lavoro su DeepSeek-R1, uscito come rapporto tecnico nel gennaio 2025 e in forma estesa su Nature nel settembre dello stesso anno [GYZ+25], e il comportamento compare nella variante addestrata con il solo rinforzo a partire dal modello base. Se quel comportamento nasca dal rinforzo o fosse già in germe nel modello base è proprio la questione di Yue e colleghi. L’osservazione convive senza contraddizione con il loro risultato, e le due cose insieme dicono una terza cosa: l’addestramento sposta massa di probabilità verso strade che pagano, e questo è utilissimo e non è la stessa cosa che insegnare una strada nuova.
C’è infine un argomento di prospettiva da tenere presente. Le critiche fin qui riguardano il rinforzo come unico maestro, cioè l’idea di costruire un sistema per tentativi ed errori a partire da zero. Nessuno dei due critici propone questo: la ciliegina è una ciliegina perché viene dopo, su una torta già cotta. Criticare il rinforzo come unico maestro non è quindi criticarlo come rifinitura, e le due frasi si somigliano tanto che vengono scambiate di continuo.
Cambiare la quantità, invece di arricchire il premio#
Tutte queste critiche hanno la stessa forma: il segnale è povero. La risposta più ovvia è allora arricchirlo, e infatti è quello che si fa (un critico che dà un voto passo per passo, un premio interno per la novità, un giudice che commenta le soluzioni parziali). C’è però una risposta diversa, che non arricchisce il premio ma cambia la quantità che si sta ottimizzando, e merita un posto qui perché è l’unica obiezione di principio, non di rimedio.
Viene da fuori dall’informatica. Nelle neuroscienze teoriche esiste un quadro, l’inferenza attiva, che descrive percezione, pianificazione e azione come un unico problema di inferenza [PPF22]. Al posto della ricompensa mette una grandezza da minimizzare, l’energia libera attesa, che misura, per un piano d’azione, quanto le osservazioni che farebbe arrivare si discosterebbero da quelle preferite e quanto lascerebbero incerti sullo stato del mondo. È la versione rivolta al futuro dell’energia libera variazionale che l’apertura del capitolo ha nominato come tetto alla sorpresa delle osservazioni già arrivate. Il punto che interessa qui è come è fatta, perché si scompone in due pezzi.
Uno vuole un caffè, e l’esempio è degli autori. In città ci sono due buoni bar: uno apre dal lunedì al venerdì, l’altro solo nel fine settimana. Lui però non sa che giorno è.
Che cosa fa per prima cosa? Non va a un bar: guarda il calendario. È un’azione che non gli porta nessun caffè, e nemmeno un passo verso il caffè: gli porta soltanto informazione. Solo dopo, sapendo che giorno è, va al bar giusto, e quella seconda azione è quella che gli porta la cosa che voleva.
Le due azioni valgono per ragioni diverse: la prima risolve un’incertezza, la seconda realizza una preferenza. Ed è qui il punto: un sistema che sappia valutare solo la seconda non ha modo di scegliere il calendario, perché il calendario non porta caffè. Può solo tirare a caso fra i due bar, e come dicono gli autori, spesso il caffè non se lo beve.
Il rinforzo classico è in quella situazione. La ricompensa dice quanto ti è andata bene, non quanto hai imparato; e per questo, quando l’esplorazione serve, gliela si deve pagare a parte, con un premio aggiunto apposta. Nell’inferenza attiva il valore di sapere è già dentro la quantità da minimizzare, accanto al valore di ottenere, e si conta nella stessa moneta: nessuno deve decidere a parte quanto valga un’occhiata al calendario rispetto a un sorso di caffè.
Il dosaggio fra guardare e prendere, però, non sparisce. Se in città aprisse un terzo bar, mai provato, entrarci gli porterebbe informazione e forse nessun caffè: ci va o no? Dipende da quanto è forte la voglia. Chi ne ha una voglia disperata va dritto al bar che conosce, chi è tranquillo può concedersi la scoperta; e quanto è forte la voglia lo decide chi costruisce l’agente.
Se poi al nostro uomo si toglie del tutto la voglia di caffè, resta solo il calendario: lo guarda per il gusto di sapere che giorno è, e nient’altro. È il premio per la curiosità che il rinforzo aggiunge a parte, cioè quello che resta quando del caffè non importa niente.
L’energia libera attesa di una politica \(\pi\) si scompone in
dove \(\tilde{o}\) e \(\tilde{s}\) sono le osservazioni e gli stati futuri sotto \(\pi\),
è il guadagno di informazione atteso, cioè di quanto quelle osservazioni ridurrebbero l’incertezza sugli stati, e \(C\) codifica le preferenze dell’agente, cioè quali osservazioni si aspetta di incontrare. Quel \(C\) è la lettera con cui la letteratura dell’inferenza attiva scrive le preferenze, e non è il compressore \(C\) di «Capire è accorciare». Minimizzare \(G\) significa massimizzare tutti e due i pezzi insieme. La scomposizione usa per la previsione congiunta di stati e osservazioni la forma \(Q(\tilde{o}, \tilde{s} \mid \pi) = Q(\tilde{s} \mid \pi)\, P(\tilde{o} \mid \tilde{s})\), che è quella che gli autori le danno; con la stessa forma \(G\) si riscrive anche come rischio più ambiguità, come mostra la sezione sull’inferenza attiva.
Gli autori enunciano una conseguenza diretta: non c’è da preoccuparsi di bilanciare esplorazione e sfruttamento con un coefficiente scelto a mano. Poiché «l’utilità e il valore dell’informazione emergono come due componenti dell’energia libera attesa», entrambe «sono al servizio dell’ottimizzazione della stessa funzione» [PPF22]: i due valori si misurano nella stessa unità, il nat. Il bilanciamento però non sparisce, e gli stessi autori scrivono che è il peso relativo dei due termini a decidere se il comportamento è prevalentemente esplorativo o di sfruttamento. Quel peso dipende da quanto sono nette le preferenze. Scrivendole come \(P(\tilde{o} \mid C) \propto e^{\beta\, u(\tilde{o})}\), con \(u\) un’utilità e \(\beta > 0\) la loro precisione, la differenza di valore pragmatico fra due politiche risulta proporzionale a \(\beta\): preferenze più nette spingono a sfruttare, e \(\beta\) lo sceglie chi costruisce il modello.
Il quadro ha inoltre una proprietà che aiuta a collocarlo: togliendo pezzi a \(G\) si riottengono schemi già noti. Tolte le preferenze, cioè annullato il valore pragmatico, quel che resta, cambiato di segno, «è variamente noto come sorpresa bayesiana attesa o motivazione intrinseca», che è esattamente la curiosità che la sezione sull’esplorazione costruisce come bonus aggiunto. Il che dice in che rapporto stanno le due letture: non sono in concorrenza, una è il caso particolare dell’altra.
Restano due avvertenze, perché su questo punto sarebbe facile promettere troppo. La prima: non è così che si addestrano oggi i sistemi di cui si è parlato fin qui. L’inferenza attiva nasce come teoria del comportamento biologico, e le sue realizzazioni sono modelli di laboratorio, non i sistemi su cui gira il mondo. La seconda la dicono gli autori stessi in apertura, ed evita di trasformarli in avversari di qualcuno: il quadro «non mira a rimpiazzare altri quadri di riferimento, come la psicologia comportamentale, la teoria delle decisioni e l’apprendimento per rinforzo», ma a comprenderli.
L’inferenza attiva serve a mostrare una cosa precisa: la povertà del segnale non è una fatalità dell’imparare agendo, ma la conseguenza di quale quantità si è scelto di ottimizzare. E l’oggetto della discordia, a ben vedere, non è se il rinforzo serva, ma se basti a spiegare da dove venga la comprensione. Su quella domanda si apre il capitolo sui world model.
Da ricordare
Nella torta di LeCun l’apprendimento per rinforzo è la ciliegina, e la ragione è quella del conto sui bit: il segnale che porta è pochissimo, una frase per un’intera giornata.
A quella si aggiunge una seconda obiezione, che è peggiore perché moltiplica la prima: quella frase va anche distribuita fra le centinaia di cose fatte durante la giornata, e nessuno dice quali erano quelle buone. Se la giornata è andata bene si tende a ripetere tutto, compresi gli sbagli.
Karpathy lo dice così: si sta aspirando la supervisione attraverso una cannuccia, e quel poco lo si spalma su tutto quello che si è fatto. Nella stessa risposta però dice anche che il rinforzo è oggi il meglio che si abbia, e che fa scoprire soluzioni che una persona potrebbe non trovare mai.
Una tesi da non confondere con la sua: che il rinforzo restringa invece di allargare le capacità del modello non l’ha detta Karpathy, l’hanno misurata Yue e colleghi, chiedendo al modello tante risposte alla stessa domanda invece di una. Con una sola risposta vince il modello addestrato; con moltissime vince quello di partenza. Vale per come questo addestramento si faceva nella primavera del 2025, e un lavoro di poche settimane dopo, con addestramenti molto più lunghi, ha trovato il contrario; e spinto a un numero assurdo di tentativi il confronto non direbbe più niente, perché la risposta giusta salterebbe fuori anche battendo i tasti a caso.
Il contraddittorio esiste ed è forte: gli assistenti che usiamo tutti i giorni sono rifiniti proprio così, e i modelli «ragionanti» si addestrano così sui problemi dove la risposta si può verificare. Nessuno propone di buttare il rinforzo: si discute se basti a spiegare da dove venga la comprensione.
LeCun non dice che sia inutile: dice che è nel posto sbagliato, buono per rifinire e non per costruire la comprensione, che va costruita guardando. È una posizione dentro un dibattito aperto, e le macchine fatte così non sono ancora quelle che funzionano meglio.
C’è poi una risposta di tipo diverso, che non arricchisce il premio ma cambia la cosa da massimizzare: chi vuole un caffè e non sa che giorno è guarda prima il calendario, e quel gesto non porta caffè, porta informazione. Se il valore di sapere sta già dentro la quantità da minimizzare, l’esplorazione non va pagata a parte con un premio; quanto esplorare, però, resta da decidere, e lo decide quanto sono forti le voglie che chi costruisce l’agente gli dà. Non è così che i sistemi di oggi si addestrano.
Da ricordare
Le critiche al rinforzo «puro» sono quattro; due sono trattate altrove (la ricompensa scritta male e ottimizzata alla lettera, e il costo in esperienza dell’imparare per tentativi nel mondo), e le due discusse qui sono due mosse dello stesso argomento.
Quanti bit: il bersaglio è uno scalare per episodio, al più un bit con una ricompensa binaria, contro un tetto dell’ordine di \(10^5\) bit per esempio del pre-addestramento auto-supervisionato (fra \(2 \cdot 10^4\) e \(4 \cdot 10^4\) con l’entropia reale del testo): quattro ordini di grandezza in ogni caso.
Assegnazione del credito: nel gradiente di policy elementare, con ricompensa solo terminale e senza sconto, lo stesso ritorno \(R^{(m)}\) moltiplica \(\nabla_\theta \log \pi_\theta(a_t \mid s_t)\) per ogni \(t\) della traiettoria. La linea di base riduce la varianza, il critico stima il vantaggio azione per azione e lo sconto accorcia l’orizzonte di attribuzione; nessuno dei tre fabbrica informazione assente dal segnale.
Karpathy [Kar25b]: «sucking supervision through a straw», e il ritorno finale «diffuso a tutta la traiettoria». Nella stessa risposta: il rinforzo resta il meglio disponibile e «può scoprire soluzioni che una persona potrebbe non trovare mai».
Attribuzione da tenere dritta: la tesi che l’RLVR restringa il confine delle capacità è di Yue e colleghi [YCL+25], misurata col pass@\(k\) (stimato con \(1 - \binom{n-c}{k}/\binom{n}{k}\) su \(n \ge k\) campioni): i modelli addestrati vincono a \(k\) piccolo, i modelli base a \(k\) grande. Vale per gli addestramenti dell’aprile 2025, non in linea di principio: ProRL [LDL+25], con più di duemila passi, controllo della divergenza dal riferimento e compiti vari, riporta un modello che supera il base anche dove questo fallisce a ogni \(k\).
Il contraddittorio: post-addestramento sulle preferenze e RLVR sui domini verificabili funzionano, e non contraddicono il risultato precedente. Spostare massa di probabilità verso strade che pagano è utile e non equivale a insegnare una strada nuova.
La proposta di LeCun: il rinforzo va sostituito, come costruttore della comprensione, dal controllo predittivo basato su modello, e resta per la rifinitura. È una posizione dentro un dibattito aperto, non un risultato.
Inferenza attiva [PPF22]: l’energia libera attesa \(G(\pi)\) si scompone in valore epistemico e valore pragmatico (con la previsione fattorizzata \(Q(\tilde{o},\tilde{s}\mid\pi) = Q(\tilde{s}\mid\pi)\,P(\tilde{o}\mid\tilde{s})\)), quindi i due si misurano nella stessa unità e non serve un coefficiente di conversione; il bilanciamento resta, ed è fissato dal peso relativo dei due termini, cioè da quanto sono nette le preferenze; tolte le preferenze resta, cambiata di segno, la motivazione intrinseca, cioè il bonus di curiosità come caso particolare. Quadro di laboratorio, non il modo in cui i sistemi si addestrano oggi.
Se ne esce con un criterio: prima di chiedersi se un modo di addestrare funzioni, conviene chiedersi quanta informazione porta il segnale su cui si regge, e a quante scelte quel poco va poi diviso. Nel capitolo sui world model il segnale resta la previsione, ma cambia l’oggetto: si prevede la rappresentazione invece dei pixel e, per chi deve agire, come cambia il mondo dopo un’azione, invece di ricostruire la parte coperta di un dato.