


Sistemi di Raccomandazione#
Un milione di dollari a chi riesce a migliorare del 10% Cinematch, il sistema di raccomandazione di Netflix: è il premio che l’azienda, all’epoca un servizio di noleggio DVD per posta, mette in palio il 2 ottobre 2006.
Del 10% che cosa, perché la gara si gioca tutta lì. Cinematch prevede quante stelle un utente darà a un film, e il metro della gara è la radice dell’errore quadratico medio, l’RMSE (root mean square error):
dove \(r_{ui}\) è il voto che l’utente \(u\) ha dato al film \(i\), \(\hat{r}_{ui}\) la previsione e \(\mathcal{K}\) l’insieme dei voti su cui si misura. Il quadrato fa pesare gli errori grandi più dei piccoli: con due previsioni sbagliate di 1 e di 3 stelle il conto fa \(\sqrt{(1^2 + 3^2)/2} = \sqrt{5} \approx 2{,}24\), più della media semplice degli errori, che sarebbe 2. La radice, alla fine, riporta il risultato in stelle. La sezione sulle metriche lo definisce per esteso. Misurato così, l’errore di Cinematch valeva \(0{,}9525\) stelle: togliere il 10% vuol dire scendere sotto \(0{,}8572\), ed è quella la soglia dell’assegno.
Per partecipare basta scaricare un dataset che all’epoca sembra sterminato: poco più di 100 milioni di voti, da una a cinque stelle, dati da circa 480.000 utenti anonimi a 17.770 film (un anonimato fragile, come racconta la sezione su privacy e robustezza). La gara diventa un caso mondiale: migliaia di squadre, forum incandescenti, ricercatori universitari e ingegneri che di notte inseguono decimali. Il regolamento non fissava una data di chiusura: la gara finiva quando qualcuno superava la soglia, e se nessuno ci fosse riuscito sarebbe andata avanti almeno fino al 2 ottobre 2011. Ci vogliono quasi tre anni, e la chiusura è a orologeria: chi supera la soglia apre a tutti una finestra di trenta giorni per consegnare ancora, e a parità di risultato vince chi ha consegnato per primo. Solo il 21 settembre 2009 Netflix consegna l’assegno al team BellKor’s Pragmatic Chaos, che chiude a \(0{,}8567\) stelle: il 10,06% meglio di Cinematch, cioè la soglia superata per un soffio. E sul filo di lana anche in gara: i rivali di The Ensemble erano arrivati allo stesso punteggio, ma avevano consegnato venti minuti più tardi.
L’ironia arriva dopo, e vale come lezione per tutto il capitolo. Quella soluzione da un milione di dollari non fu mai adottata per intero. Era un mosaico di oltre cento modelli combinati, e Netflix scrisse che il guadagno di precisione misurato non sembrava giustificare il lavoro di ingegneria che serviva a portarlo in produzione, cioè a farlo girare davvero, tutti i giorni, per i clienti veri [AB12]. Nel frattempo il business stava migrando dai DVD allo streaming, dove prevedere il voto in stelle conta meno di prevedere che cosa guarderai stasera. In produzione finirono invece i due modelli migliori della squadra che nel 2007 aveva vinto il primo premio intermedio, e nessuno dei due era nato per l’occasione. Il primo è la macchina di Boltzmann ristretta, una rete neurale degli anni Ottanta che Salakhutdinov, Mnih e Hinton applicarono ai voti di Netflix [SMH07]; la sezione sulle macchine di Boltzmann racconta com’è fatta. Il secondo è la fattorizzazione di matrici, che qui fa da protagonista [KBV09]: approssima la matrice dei voti con il prodotto di due matrici molto più piccole, e la gara le diede la ricetta di addestramento con cui è arrivata fino a oggi, la discesa del gradiente sui soli voti noti che Simon Funk descrisse in un post del dicembre 2006 [Fun06].
Una parola sul nome, perché in italiano «raccomandazione» significa due cose e una delle due è la spintarella. Qui vale l’altra, quella del consiglio: raccomandare è consigliare, e un sistema di raccomandazione è una macchina che consiglia. Il senso brutto, però, non è del tutto fuori luogo. Una macchina che decide cosa vedi ti sta servendo, o ti sta spingendo? La domanda torna in fondo, nella raccomandazione neurale, e accompagna tutto il resto.
Non «qual è il film più bello», ma «quale piacerà a te»#
Un motore di ricerca risponde a una domanda che fai tu. Un sistema di raccomandazione risponde a una domanda che non hai fatto: tra queste centomila cose, quali conviene mostrarti? Quelle cose sono film, canzoni, prodotti, articoli, video, a seconda del catalogo. Nel gergo del settore si chiamano tutte oggetti (in inglese item), e qui useremo spesso «film», perché l’esempio è quello. La differenza cruciale è che non esiste una risposta valida per tutti.
Chiedere «qual è il film più bello?» è come chiedere «qual è il piatto più buono?»: una classifica unica (la media dei voti di tutti) accontenta la maggioranza e non entusiasma nessuno. Un buon libraio non ti indica il libro più venduto: ti guarda, ricorda cosa hai comprato l’ultima volta, e ti mette in mano un titolo che a te probabilmente piacerà. Un sistema di raccomandazione prova a fare il libraio su scala industriale: milioni di clienti, milioni di scaffali, un consiglio diverso per ciascuno. Con una differenza che decide tutto il resto: di quasi tutti i clienti ha visto due acquisti in croce, e di quasi tutti i libri non sa niente.
Formalmente, dati un insieme di utenti \(\mathcal{U}\) e un insieme di oggetti (item) \(\mathcal{I}\) (film, prodotti, brani, articoli), un sistema di raccomandazione stima una funzione di utilità \(f:\mathcal{U}\times\mathcal{I} \to \mathbb{R}\) che assegna a ogni coppia (utente, oggetto) un punteggio di affinità, e per ogni utente restituisce gli oggetti con punteggio massimo. Non è una classifica globale ma una famiglia di classifiche personalizzate: la stessa \(f\), valutata su utenti diversi, produce ordinamenti diversi. Il problema di apprendimento consiste nello stimare \(f\) dalle interazioni passate, che coprono una frazione minuscola di \(\mathcal{U}\times\mathcal{I}\).
Il carburante: quello che diciamo e quello che facciamo#
Da dove impara, una macchina che consiglia? Da quello che le persone lasciano dietro di sé. Ogni volta che qualcuno incontra un film e lascia una traccia (un voto, un click, un acquisto, dieci minuti di visione, un brano saltato), quella traccia si può registrare, ed è tutto ciò che il sistema ha in mano. Le tracce si chiamano interazioni, e sono di due specie molto diverse: quelle che diciamo apposta e quelle che ci scappano mentre facciamo altro. In inglese si chiamano feedback esplicito e implicito, e la distinzione conta più di quanto sembri.
Il feedback esplicito è quando dichiari il tuo giudizio: le cinque stelle su un film, il pollice in su, la recensione. È chiaro ma raro: quante cose hai guardato o comprato quest’anno, e quante ne hai recensite? E quelle poche stelle arrivano quasi tutte dallo stesso posto: un film lo voti dopo averlo scelto, e l’avevi scelto perché pensavi ti sarebbe piaciuto. Chi legge quei voti legge il parere di gente che partiva ben disposta.
Il feedback implicito è tutto ciò che fai senza pensare di stare giudicando: i click, gli acquisti, i minuti di visione, i brani saltati dopo dieci secondi. È abbondante (ogni gesto ne produce) e per certi versi più sincero delle dichiarazioni: puoi dire che ami i documentari, ma la cronologia rivela le serie poliziesche. Ha però un difetto: è ambiguo. Un click non è una promozione (magari il film ti ha deluso), e un film ignorato non è una bocciatura: forse non l’hai mai visto passare. Nei sistemi veri è l’implicito a farla da padrone, perché ce n’è tantissimo; ma proprio perché è ambiguo va maneggiato con più cautela. E cambia la domanda, perché non ci sono stelle da prevedere. Una strada è segnare ogni titolo con un sì o con un no, guardato o non guardato, e fidarsi poco dei no e molto dei sì ripetuti: una serie vista fino in fondo dice più di un click. L’altra è rinunciare al voto e decidere soltanto quale titolo mettere in cima alla vetrina.
Il feedback esplicito produce una matrice di voti \(\mathbf{R}\) con entrate \(r_{ui}\) su scala ordinale (ad esempio \(1\)–\(5\)): segnale ad alta qualità ma estremamente scarso, e per di più non mancante a caso [MZ09]; gli utenti votano soprattutto ciò che hanno scelto di consumare, quindi le celle osservate sono un campione distorto. Il feedback implicito produce eventi che hanno un verso solo (c’è stata interazione, e basta), conteggi o durate: click, acquisti, minuti di visione. Copertura enormemente maggiore, ma niente segnale negativo esplicito. L’assenza di interazione confonde due casi indistinguibili («non gli piace» e «non l’ha mai visto») e questo cambia la formulazione del problema. Non c’è più un voto su cui fare regressione: o si fa regressione su una preferenza binaria, pesata da una confidenza che cresce con le interazioni (è iALS [HKV08], nella sezione sul filtraggio collaborativo), o si impara un ranking da osservazioni positive e non osservazioni, come fa BPR [RFGST09]. Nei sistemi industriali l’implicito domina per volume (ordini di grandezza di differenza) e perché misura il comportamento effettivo, non quello dichiarato; resta però il segnale più ambiguo dei due, e la cautela che l’ambiguità impone non si compra con la quantità.
Un problema di machine learning anomalo#
Visto da lontano sembra un normale apprendimento supervisionato: dati storici in ingresso, una predizione in uscita. Tre caratteristiche lo distinguono.
La prima si vede guardando la materia prima, la matrice dei voti: una riga per ogni persona iscritta (nel gergo del settore, un utente), una colonna per ogni film, i voti nelle celle, come in Fig. 33.1. È lo stesso dato del grafo bipartito con cui si è chiuso il capitolo sulle reti neurali su grafo, utenti da una parte e film dall’altra, scritto come tabella: un arco diventa una cella piena, e al grafo si torna nella sezione sulla raccomandazione neurale. Il punto è quante celle sono vuote. Nel Netflix Prize i 100 milioni di voti sembrano tanti, ma la tabella completa avrebbe \(480.000 \times 17.770 \approx 8{,}5\) miliardi di celle. La frazione di celle piene si chiama densità, e lì valeva l’1,2%: cento milioni su otto miliardi e mezzo. Nei cataloghi industriali di oggi, con milioni di oggetti, si scende facilmente sotto lo 0,1%. Quel vuoto si chiama sparsità, e raccomandare vuol dire prevedere le celle vuote.

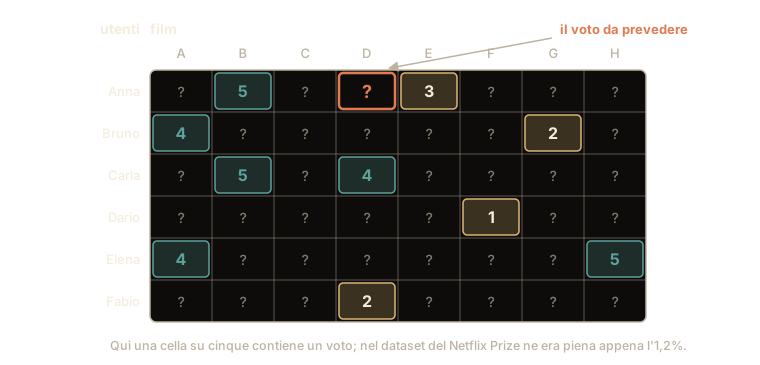
Fig. 33.1 La tabella dei voti: poche celle di cui conosciamo il voto (le cornici distinguono i voti alti, 4 e 5, dai bassi), e in quattro celle su cinque un punto interrogativo. Prevedere il valore di una cella vuota (qui, il voto di Anna al film D) è l’intero problema.#
La seconda è che non esiste una «risposta giusta» da guardare. Un modello che riconosce le cifre scritte a mano si può confrontare con l’etichetta vera, perché quell’immagine o è un 7 o non lo è, e qualcuno lo sa. Qui invece la domanda riguarda un fatto che non è avvenuto: se ti avessimo mostrato quel film, ti sarebbe piaciuto? Una domanda così si dice controfattuale, e per la stragrande maggioranza delle coppie utente-film non avrà mai una risposta osservata. Per valutare un modello si usa allora un riferimento sostitutivo: si nasconde una parte delle interazioni che si conoscono, e si guarda se il modello le ritrova. E quale parte si nasconde pesa sul verdetto: nascondere l’ultimo titolo che ciascuno ha visto, oppure delle interazioni prese a caso, può ribaltare la graduatoria fra due metodi [JSZL23]. Ci torna sopra il paragrafo sul misurare una classifica, nella raccomandazione neurale.
La terza è la più insidiosa: il sistema influenza i dati che raccoglie.
Un cameriere consiglia sempre gli stessi tre piatti. Dopo un mese, i piatti più ordinati del ristorante saranno… quei tre. Se il ristoratore guardasse le ordinazioni per capire cosa piace ai clienti, concluderebbe che i tre piatti sono i favoriti, ma è una profezia che si autoavvera: i clienti hanno scelto dentro il menù che il cameriere ha proposto, e le ordinazioni del mese gli danno una ragione in più per riproporli. I sistemi di raccomandazione vivono in questo cerchio: ciò che mostri determina ciò che viene cliccato, e ciò che viene cliccato determina ciò che mostrerai.
Uscirne si può, ma ogni strada ha un prezzo. Per sapere com’è il quarto piatto bisogna portarlo a qualcuno che non l’ha chiesto, e quel qualcuno cenerà peggio perché il locale aveva bisogno di saperlo.
Oppure si correggono i conti a tavolino. Il risotto, proposto duecento volte, è stato ordinato cinquanta: ha convinto un cliente su quattro. La zuppa, proposta due volte, è stata ordinata una: ha convinto un cliente su due. Se si contano le ordinazioni vince il risotto, cinquanta a uno, ma solo perché il cameriere lo nomina sempre. Il rimedio è contare ogni ordinazione al contrario di quanto spesso quel piatto veniva proposto: le cinquanta del risotto valgono un duecentesimo l’una, l’unica della zuppa vale mezzo, e in testa passa la zuppa, cioè il ristorante che si sarebbe visto se il cameriere avesse proposto tutto allo stesso modo. Il conto però ha due debolezze. Un piatto che il cameriere non nomina mai resta a zero, e nessun peso lo recupera. E la zuppa sta in testa grazie a un cliente solo: se quell’unico cliente avesse scelto altro, sarebbe in fondo. Per questo il conto si fa con due accortezze: a nessuna ordinazione si lascia pesare più di tanto, per quanto raro fosse il piatto, oppure si divide per il totale dei pesi invece che per il numero dei clienti, e un colpo di fortuna isolato conta meno. Per fare il conto, infine, bisogna sapere quante volte ogni piatto è stato proposto, e quel registro nessuno lo tiene da solo.
I dati di addestramento non sono campionati dalla distribuzione «vera» delle preferenze, ma filtrati dalla politica di esposizione del sistema stesso: osserviamo interazioni solo sugli oggetti che il modello precedente ha deciso di mostrare. È un feedback loop: il modello al tempo \(t\) genera i dati con cui si addestra il modello al tempo \(t+1\), e i bias si amplificano invece di mediarsi. È un caso particolarmente severo del dataset shift incontrato nella sezione Quando i dati cambiano [QuinoneroCSSL09], con l’aggravante che qui lo shift non è un incidente esterno, ma è prodotto dal sistema stesso. Le contromisure esistono, ma nessuna è gratis. L’esplorazione controllata mostra a qualche utente qualcosa che il modello non avrebbe scelto, ed è il problema dei bandit a più braccia; la correzione per propensità ripesa i dati che si hanno, e ha una forma precisa. Detta \(P_{ui}\) la probabilità che la coppia \((u,i)\) venga osservata sotto la politica che ha raccolto i dati, \(o_{ui} \in \{0,1\}\) l’indicatore di osservazione e \(\delta_{ui} = \ell(r_{ui}, \hat{r}_{ui})\) la perdita del modello su quella coppia (per esempio l’errore quadratico), lo stimatore a propensità inversa
è non distorto per la perdita media su tutte le coppie, osservate e no, a due condizioni: che ogni coppia abbia \(P_{ui}>0\) (una cella che la politica non mostra mai non si recupera con nessun peso) e che le \(P_{ui}\) siano quelle vere: con propensità stimate la distorsione torna, nella misura dell’errore di stima [SSS+16]. Il prezzo è la varianza: le coppie mostrate di rado entrano con pesi enormi. I due rimedi sono quelli dell’importance sampling dei metodi Monte Carlo: lo stimatore autonormalizzato (SNIPS)
che è la variante pesata di quella sezione, distorta ma di varianza molto minore; e il troncamento, che al posto di \(P_{ui}\) usa \(\max(P_{ui}, \tau)\) con una soglia \(\tau > 0\). Tutti e due cedono un po’ di distorsione in cambio di molta meno varianza.
Chiedere all’amico giusto#
Il percorso va dall’idea classica a quella neurale.
Si parte da un’idea che usiamo tutti i giorni senza chiamarla così: chiedere all’amico giusto. Vedremo come si rende calcolabile, e il metodo si chiama filtraggio collaborativo. Vedremo poi perché la versione che confronta le righe della matrice si arena sul vuoto, e come se ne esce: riassumendo ogni utente e ogni film in un vettore di pochi numeri, un embedding, e prevedendo il voto con il prodotto scalare dei due. È la fattorizzazione di matrici, che al Netflix Prize si dimostrò superiore ai metodi a vicinato, e la scriveremo in PyTorch in una ventina di righe.
Poi le reti neurali entrano nel problema. Il prodotto scalare è un conto elementare, moltiplicare e sommare; la domanda è ovvia (una rete farà meglio?) e la risposta non è quella che ci si aspetta. Vedremo che cosa è successo quando ci hanno provato, e perché di solito non conviene. Torneremo poi al grafo bipartito, dove consigliare vuol dire prevedere gli archi che mancano. Cambieremo infine obiettivo: quando non ci sono voti non si prevede un numero, si mette in ordine una lista, e per giudicarla serve un altro metro. Chiuderemo con il funzionamento vero della macchina che ti consiglia i video, e con la domanda che le sta sotto: quando un consiglio smette di essere un consiglio.
Da ricordare
Consigliare non è riconoscere: non esiste una risposta valida per tutti, e lo stesso sistema deve mettere le cose in un ordine diverso per ogni persona.
Il carburante sono le interazioni: o dichiarate (le stelle, il pollice in su: chiare ma rarissime, e per giunta date quasi solo da chi il film l’aveva scelto perché pensava gli sarebbe piaciuto) o lasciate senza pensarci (click, acquisti, minuti di visione: abbondanti ma ambigue, perché un titolo ignorato non è una bocciatura). Nei sistemi veri dominano le seconde.
Il dato di partenza è una tabella quasi tutta vuota: nel Netflix Prize era piena all’1,2%, nei cataloghi di oggi si scende sotto lo 0,1% di celle piene. Consigliare vuol dire riempire quei buchi in modo sensato.
Non c’è una risposta giusta da guardare: nessuno saprà mai se ti sarebbe piaciuto il film che non hai visto, e per valutare si nasconde una parte di ciò che si sa, per poi vedere se il modello la ritrova.
Il sistema si fabbrica da solo i dati con cui impara: mostra quello che ha scelto lui, e ciò che mostra è ciò che verrà cliccato. È il cameriere che consiglia sempre gli stessi tre piatti, ed è un problema da cui un sistema di raccomandazione non si libera mai del tutto. Uscirne si può, ma non gratis: per sapere com’è il quarto piatto bisogna portarlo a qualcuno che non l’ha chiesto, oppure contare ogni ordinazione al contrario di quanto spesso quel piatto viene proposto, e per farlo serve un registro che nessuno tiene da solo.
Da ricordare
Il problema è prevedere le preferenze mancanti nella matrice di interazione \(\mathbf{R}\), utenti per oggetti, di cui si osserva una frazione minima: nel Netflix Prize l’1,2% delle celle, nei cataloghi industriali di oggi meno dello 0,1%. Quel vuoto ha un nome, sparsità, ed è il vincolo che detta quasi tutte le scelte che seguono.
Il segnale è di due specie. Esplicito: voti su una scala, cioè un target continuo o ordinale su una matrice incompleta, raro e non mancante a caso [MZ09], perché si vota soprattutto ciò che si è scelto di consumare. Implicito: click, acquisti, minuti di visione, cioè dati binari, di conteggio o di durata, abbondanti ma senza negativi certi, perché un oggetto mai mostrato non è un oggetto rifiutato. E l’abbondanza non toglie l’ambiguità: va maneggiato con più cautela, non con meno.
La verità di riferimento è controfattuale e per la gran parte delle coppie non esisterà mai. Si valuta con un riferimento sostitutivo: si nascondono interazioni note e si guarda se il modello le ritrova. Quale parte si nasconde può ribaltare la graduatoria fra due metodi [JSZL23].
I dati non vengono dalla distribuzione vera delle preferenze ma dalla politica di esposizione del sistema che li ha raccolti: è un feedback loop che amplifica i bias invece di mediarli, cioè un caso severo di dataset shift, con l’aggravante di essere prodotto dal sistema stesso. Le contromisure esistono e nessuna è gratis: l’esplorazione controllata costa esperienze peggiori a qualche utente, la correzione per propensità (IPS, o SNIPS che ne riduce la varianza) chiede propensità note e positive.