


Processi gaussiani: prevedere con l’incertezza#
C’è una differenza sottile ma decisiva tra due previsioni del tempo. «Domani 24 gradi» è una cifra secca: sembra sicura, ma non dice nulla su quanto fidarsi. «Domani tra 21 e 27» dice di meno e comunica di più: oltre alla stima, dichiara quanto il modello non sa. Quasi tutti i modelli visti finora (la retta di best fit, la regressione logistica, il k-NN) restituiscono una stima puntuale. La regressione logistica dice anche quanto è sicura della classe, ma nessuno dei tre dice quanto il modello stesso è incerto sulla funzione che ha imparato, un’incertezza che dovrebbe crescere lontano dai dati. Il processo gaussiano (Gaussian process, GP) restituisce la stima insieme a questa incertezza.
Il nome si spiega in una riga. La grandezza da prevedere (la temperatura in ogni punto di una regione, per esempio) è una funzione sconosciuta \(f(\mathbf{x})\). In probabilità un processo è una famiglia di quantità casuali, una per ogni punto: qui, per ogni punto \(\mathbf{x}\), il valore \(f(\mathbf{x})\). Gaussiano perché i valori in un qualunque gruppo di punti, presi insieme, si distribuiscono secondo la curva a campana di Gauss, con un valore centrale e un margine attorno.
L’idea ha più di una radice. La previsione con processi gaussiani risale almeno a Kolmogorov (1941) e a Wiener (1949), che la studiavano sulle serie temporali, cioè su misure prese una dopo l’altra nel tempo [RW06]. Un’altra radice, indipendente, viene dalle miniere. Nel 1951 Danie Krige, un giovane ingegnere sudafricano, affrontava il problema più costoso delle miniere d’oro del Witwatersrand: ogni carotaggio (un pozzo di assaggio per misurare la concentrazione del minerale) costava una fortuna, e i punti campionati erano per forza pochi e sparsi. Come stimare quanto oro c’è tra un pozzo e l’altro? Krige propose di usare medie pesate dei campioni vicini, con pesi scelti in modo statistico. Nei primi anni Sessanta il matematico francese Georges Matheron formalizzò il metodo e lo battezzò kriging, in suo onore, ed è il nome che porta ancora in geostatistica. Nel machine learning la stessa matematica è arrivata dalla statistica bayesiana, con il nome che aveva in probabilità, ed è oggi uno degli strumenti più eleganti della disciplina [RW06].
Una distribuzione sulle curve, non una sola#
La regressione lineare dell’inizio del capitolo restituisce una retta, quella di best fit. Il processo gaussiano restituisce una distribuzione su tutte le funzioni compatibili con i dati, ciascuna con la sua plausibilità.
Un fascio di fili elastici tesi sopra un tavolo, ognuno una possibile curva «vera», un modo in cui il mondo potrebbe comportarsi. Prima di misurare qualsiasi cosa i fili si affollano attorno alla stessa altezza in ogni punto del tavolo, moltissimi vicini a quella quota, pochi scostati parecchio, pochissimi in cima o in fondo. Punta il dito su un punto qualunque del tavolo e guarda soltanto le altezze dei fili lì sopra. La loro forma è la campana. Puntane tre insieme, prendi da ogni filo la terna di altezze, e ritrovi la stessa storia. Vale per una manciata qualsiasi di punti, ed è la regolarità che dà il nome al metodo.
Ogni misura che facciamo è un chiodo piantato nel tavolo: da quel momento i fili devono passare lì vicino, quasi toccarlo, e chi passa lontano esce di scena. Vicino ai chiodi il fascio è costretto, i fili quasi si sovrappongono; lontano dai chiodi si riapre a ventaglio, perché nulla lo vincola. I chiodi però non cambiano la natura del fascio. Anche dopo, in ogni punto del tavolo, le altezze si affollano attorno a un centro con la loro campana; solo che il centro si è spostato sui dati e la campana si è ristretta.
La previsione del processo gaussiano è doppia: dove passa in media il fascio (la stima) e quanto è largo lì (l’incertezza). È esattamente la previsione «tra 21 e 27»: stretta dove abbiamo misurato, larga dove stiamo tirando a indovinare.
Un processo gaussiano è una distribuzione di probabilità sulle funzioni:
dove \(\mu(\mathbf{x})\) è la funzione media (spesso posta a zero dopo aver centrato i dati) e \(k(\mathbf{x}, \mathbf{x}')\) è la funzione di covarianza, o kernel. La proprietà che lo definisce: per qualunque insieme finito di \(q\) punti \(\mathbf{x}_1, \dots, \mathbf{x}_q\), il vettore dei valori \(\big(f(\mathbf{x}_1), \dots, f(\mathbf{x}_q)\big)\) ha distribuzione gaussiana multivariata, con medie \(\mu(\mathbf{x}_i)\) e covarianze \(k(\mathbf{x}_i, \mathbf{x}_j)\). È un prior sulle funzioni: prima di vedere i dati, tutte le curve coerenti con il kernel sono possibili; condizionare sulle osservazioni restringe la distribuzione, e il risultato è ancora un processo gaussiano [RW06].
Non ogni funzione \(k\) va bene: perché quelle covarianze definiscano una gaussiana per ogni scelta di punti, ogni matrice \([k(\mathbf{x}_i, \mathbf{x}_j)]_{ij}\) deve essere simmetrica e semidefinita positiva, la stessa condizione vista in Il kernel trick. Il legame con i modelli già visti si vede dal lato dei pesi: se \(f(\mathbf{x}) = \boldsymbol{\phi}(\mathbf{x})^\top\mathbf{w}\) con \(\mathbf{w} \sim \mathcal{N}(\mathbf{0}, \boldsymbol{\Sigma}_p)\), allora \(f\) è un processo gaussiano con \(k(\mathbf{x},\mathbf{x}') = \boldsymbol{\phi}(\mathbf{x})^\top\boldsymbol{\Sigma}_p\,\boldsymbol{\phi}(\mathbf{x}')\), e con \(\boldsymbol{\phi}(\mathbf{x}) = \mathbf{x}\) è la regressione lineare bayesiana: anche su una retta si può tenere una distribuzione invece di una stima sola. Un kernel come l’RBF corrisponde a infinite funzioni di base, e il processo gaussiano lavora direttamente con il kernel, come la SVM. La media a posteriori coincide con la kernel ridge regression (la regressione ridge con il kernel trick) con penalità \(\lambda = \sigma_n^2\): quello che il processo gaussiano aggiunge è la covarianza [RW06].
Il kernel: chi è vicino si somiglia#
Che cosa rende lisce, e non frastagliate, le curve che il modello considera possibili? Con media nulla, la funzione di covarianza \(k(\mathbf{x}, \mathbf{x}')\), il kernel: una regola che dice quanto i valori della funzione in due punti \(\mathbf{x}\) e \(\mathbf{x}'\) devono somigliarsi, e la regolarità delle curve è quella che il kernel impone. È lo stesso oggetto del kernel trick, usato qui come covarianza.
Quaranta chilometri separano Modena da Bologna. Se a Modena il termometro segna 24 gradi, a Bologna ci aspettiamo quasi la stessa temperatura; ad Ancona, duecento chilometri più giù, quella lettura ci dice ormai poco. Il kernel mette la faccenda in numeri fra 0 e 1: quasi 1 per due città a un passo, quasi 0 per due lontanissime.
Fin dove arriva una lettura lo decide una manopola, il raggio d’influenza. Corto, Modena non impegna Bologna, che resta libera di segnare qualunque cosa, e fra un termometro e l’altro la curva zigzaga. Lungo, Modena tiene stretta Bologna e Bologna tiene Ferrara: una catena del genere non fa scatti bruschi, e ne escono curve morbide e distese.
Le distanze si contano in raggi, e con un raggio di quaranta chilometri Bologna sta a distanza \(1\). La somiglianza cala come una campana: si prende la distanza in raggi, la si eleva al quadrato, se ne prende la metà e la si mette all’esponente con il segno meno, \(e^{-d^2/2}\) (con \(e \approx 2{,}718\)). A Bologna, distanza \(1\), vale \(e^{-0{,}5} \approx 0{,}61\); a ottanta chilometri, distanza \(2\), \(e^{-2} \approx 0{,}14\); a centoventi, distanza \(3\), \(e^{-4{,}5} \approx 0{,}01\), e Ancona è fuori. A un raggio pieno la somiglianza è ancora sopra la metà, a tre raggi è praticamente sparita: la campana scende dolce vicino, ma oltre qualche raggio l’influenza di un termometro si spegne quasi del tutto.
Una seconda manopola, l’ampiezza, dice quanto ballano le letture: un grado di scarto o dieci. Nessuna delle due la giriamo a mano; la posizione la scelgono i termometri che abbiamo già, provando e dando un voto.
Il voto tira in due versi. Col raggio cortissimo ogni città è libera dalle altre, e il modello andrebbe bene con qualsiasi tabella di temperature, anche quaranta gradi a Modena e zero a Bologna: chi accetta tutto non ha indovinato niente, e il voto lo punisce. Col raggio lunghissimo mezza Italia dovrebbe segnare la stessa cifra, e le nostre letture dicono di no: anche questo il voto lo punisce. Così una parte del voto premia chi spiega le nostre letture, l’altra toglie punti a chi avrebbe spiegato altrettanto bene troppe tabelle diverse dalla nostra. Vince una posizione di mezzo.
Le posizioni buone però sono più di una, e chi gira la manopola sempre nello stesso verso si ferma sulla prima. Per questo il giro si rifà cinque volte, da posizioni sorteggiate, tenendo il voto più alto.
Sotto tutto c’è un’ipotesi, che il tempo cambi sempre dolcemente da una città all’altra. Su un valico, sulla costa, sul bordo di un temporale non è vero: cinque gradi se ne vanno in due chilometri, e quel salto il fascio non lo sa fare. Ci passa in mezzo con una rampa, e non avverte. La banda si stringe dove i termometri sono fitti, non dove le loro letture ci hanno sorpreso: sopra il valico, con due misure lì accanto, resta stretta e sbagliata.
Il kernel più usato è l’RBF (Radial Basis Function, o gaussiano):
dove \(\sigma_f^2\) è la varianza di segnale (l’ampiezza tipica delle
oscillazioni delle funzioni campionate) e \(\ell\) è la lunghezza-scala
(lengthscale; qui \(\ell\) è una lunghezza, non la perdita su un esempio
indicata altrove con la stessa lettera): l’unità in cui il kernel misura le
distanze. A distanza \(\ell\) due valori sono ancora ben correlati, e la
correlazione diventa trascurabile solo verso \(3\ell\). È lo stesso kernel del
kernel trick, con \(\gamma = 1/(2\ell^2)\): la larghezza che
là si chiamava \(\sigma\) qui si chiama \(\ell\). In scikit-learn la si passa come
length_scale \(=\ell\) a RBF, mentre SVC vuole gamma \(=1/(2\ell^2)\). Con
\(\ell = 1\) due punti a distanza \(1\) hanno correlazione \(e^{-0{,}5} \approx
0{,}61\); a distanza \(3\), \(e^{-4{,}5} \approx 0{,}01\). Una \(\ell\) piccola
produce funzioni nervose che dimenticano in fretta; una \(\ell\) grande, funzioni
lisce e a lungo raggio. Con input di scale diverse si usa una lunghezza-scala
per dimensione (automatic relevance determination; in scikit-learn
RBF(length_scale=[…])). Il kernel RBF genera funzioni infinitamente
derivabili: un’ipotesi di regolarità forte, che Stein giudica irrealistica per
molti processi fisici. L’alternativa standard è la famiglia di Matérn, con un
parametro di regolarità \(\nu\): le funzioni sono \(j\) volte derivabili in media
quadratica se e solo se \(\nu > j\), e l’RBF è il limite \(\nu \to \infty\). I due
casi più usati hanno forma chiusa, con \(r = \lVert\mathbf{x} -
\mathbf{x}'\rVert\):
(Matern(nu=1.5) e Matern(nu=2.5) in scikit-learn)
[RW06]. Un salto vero, come quello di un valico, non lo
rappresenta nessun kernel stazionario: servono kernel che cambiano con la
posizione, o un modello con un punto di rottura.
I suoi iperparametri \((\sigma_f, \ell)\)
non si fissano a mano: si stimano massimizzando la verosimiglianza
marginale dei dati, cosa che scikit-learn fa da sola durante il fit. È il
pezzo di matematica più elegante dei processi gaussiani:
dove \(\mathbf{K}\) è la matrice del kernel fra i punti di addestramento (\(K_{ij} = k(\mathbf{x}_i, \mathbf{x}_j)\)), \(\sigma_n^2\) la varianza del rumore di misura (da non confondere con la \(\sigma_f^2\) di segnale del kernel), \(\mathbf{I}\) la matrice identità e \(m\) il numero di esempi.
Il primo termine premia l’aderenza ai dati, il secondo (il logaritmo del
determinante) penalizza i kernel «capaci», quelli che ammettono troppe funzioni
diverse. È il rasoio di Occam scritto dentro il criterio: la complessità è già
penalizzata nella stima degli iperparametri, e non serve un validation set per
sceglierli. Non sostituisce il giudizio sul modello finito: massimizzare la
verosimiglianza marginale può sovradattare quando gli iperparametri sono molti
e i dati pochi [RW06], e non protegge da un kernel mal
scelto. E c’è un’avvertenza pratica: quella funzione non è concava negli
iperparametri e ha massimi locali [RW06], ed è la
ragione per cui l’ottimizzazione si fa ripartire cinque volte da
inizializzazioni sorteggiate (n_restarts_optimizer=5 in scikit-learn, il
cui valore predefinito è zero) tenendo il massimo più alto.
La previsione: media e incertezza insieme#
Resta il passaggio decisivo: dal prior («ciò che viene prima»), la distribuzione sulle funzioni prima di vedere una sola misura, al posteriore, quella che resta dopo aver condizionato sulle osservazioni. La previsione è il posteriore valutato nei punti che interessano.
Ogni punto osservato stringe il fascio lì vicino: le curve che non passano nei paraggi vengono scartate, quelle che restano sono quasi d’accordo tra loro, e la banda d’incertezza si riduce a un filo. Lontano dai punti (tra un dato e l’altro, o fuori dalla zona esplorata) sopravvivono curve molto diverse, e la banda si riapre. Il risultato, per ogni punto in cui vogliamo una previsione, sono due numeri, e nessuno dei due si cerca per tentativi. Piantati i chiodi e fissate le manopole, escono da un conto diretto.
Il primo numero è la stima, e si ottiene come faceva Krige nelle miniere: si prendono le misure che abbiamo, ciascuna con un peso, e si sommano. I pesi li decide il kernel, e non guardano solo quanto ogni misura è vicina al punto che ci interessa, ma anche quanto le misure si somigliano fra loro: due termometri nella stessa piazza dicono quasi la stessa cosa, e insieme non contano il doppio di uno. Per prevedere a Bologna, il termometro di Modena conta quasi da solo. Lontano da tutti i termometri i pesi si spengono, e la stima torna al valore da cui il modello era partito prima di misurare.
Il secondo numero è la larghezza del fascio, e si ottiene per sottrazione. Si parte da quanto eravamo ignoranti prima di misurare, cioè dall’apertura del ventaglio libero, e si toglie quello che le misure hanno già spiegato. Accanto a un chiodo la sottrazione porta via quasi tutto e resta un filo; lontano non c’è niente da togliere, e si torna all’apertura di partenza.
Se la stima è 24 gradi e la banda va da 21 a 27, il modello sta dicendo: «quasi certamente la temperatura vera è lì in mezzo». Quella banda risponde alla domanda «quanti gradi fa davvero adesso a Bologna». C’è una domanda vicina, «quanto segnerà il termometro che ci piazzo domani», e la banda che le risponde è più larga, perché porta con sé anche lo sbaglio dello strumento. La differenza si vede nel caso estremo. Su una città dove abbiamo cento misure la banda sulla temperatura vera si assottiglia fino quasi a sparire, mentre quella sulla lettura di domani non scende mai sotto l’errore del termometro.
Una banda larghissima è il modello che alza la mano e ammette di non avere dati per rispondere.
Siano \(\mathbf{X}\) gli \(m\) punti di addestramento \(\mathbf{x}_1, \dots, \mathbf{x}_m\) con osservazioni rumorose \(\mathbf{y}\) (la solita \(m\) del capitolo: il numero di esempi), e \(\mathbf{X}_*\) gli \(m_*\) punti dove vogliamo predire. Il conto è un condizionamento gaussiano. Per definizione di processo gaussiano, con un prior a media nulla e un rumore di misura gaussiano e indipendente da un punto all’altro, osservazioni e valori nuovi sono congiuntamente gaussiani,
e la legge di un blocco dato l’altro è ancora gaussiana, con media e covarianza in forma chiusa (il complemento di Schur) [RW06]:
dove \(\mathbf{K} \in \mathbb{R}^{m \times m}\) è la matrice del kernel tra i
punti di addestramento (\(K_{ij} = k(\mathbf{x}_i, \mathbf{x}_j)\)), \(\mathbf{K}_*
\in \mathbb{R}^{m \times m_*}\) quella tra addestramento e punti nuovi,
\(\mathbf{K}_{**}\) quella tra i punti nuovi, \(\sigma_n^2\) la varianza del rumore
di misura, \(\mathbf{y}\) il vettore delle osservazioni e \(\mathbf{I}\) la matrice
identità. Le due formule si leggono bene. La media è un predittore lineare,
\(\boldsymbol{\mu}_* = \mathbf{W}^\top\mathbf{y}\) con \(\mathbf{W} =
(\mathbf{K}+\sigma_n^2\mathbf{I})^{-1}\mathbf{K}_*\): il kriging di Krige, nella
variante a media nota. I pesi non misurano soltanto la vicinanza: tengono conto
di quanto le osservazioni sono correlate fra loro, possono essere negativi e non
sommano a uno. Lontano dai dati \(\mathbf{K}_* \to \mathbf{0}\) e la media torna a
quella del prior, zero: è per questo che, nell’esempio con scikit-learn, a \(x =
8{,}0\) la media vale \(+0{,}12\), e non un valore vicino a \(\sin 8 \approx
0{,}99\), che resta comunque dentro la banda. Il prior a media nulla è una
scelta: con normalize_y=True scikit-learn centra le osservazioni, e lontano
dai dati la stima torna alla loro media. La covarianza \(\boldsymbol{\Sigma}_*\) è
la varianza del prior (\(\mathbf{K}_{**}\)) meno l’informazione che le
osservazioni danno sulla funzione, e non dipende da \(\mathbf{y}\): a
iperparametri fissati la banda dice dove si è misurato, non che cosa si è
misurato, e una misura sorprendente non la allarga
[RW06]. Vicino ai dati la sottrazione mangia quasi tutto
e l’incertezza crolla; lontano non sottrae nulla e si torna all’incertezza del
prior.
La banda al 95% sulla funzione, punto per punto, è \(\boldsymbol{\mu}_* \pm
2\sqrt{\operatorname{diag}(\boldsymbol{\Sigma}_*)}\) (per ogni \(\mathbf{x}_*\)
preso da solo, non per la curva intera). È quella che scikit-learn restituisce
con return_std=True quando il rumore entra da alpha, come nell’esempio con
scikit-learn; se il kernel contiene un WhiteKernel, la deviazione standard
restituita include già il rumore ed è quella per una nuova osservazione.
Attenzione a non confonderla con l’intervallo su una nuova osservazione, che è
un’altra cosa: lì al posteriore sulla funzione va aggiunto il rumore di misura,
cioè \(\boldsymbol{\mu}_* \pm 2\sqrt{\operatorname{diag}(\boldsymbol{\Sigma}_*) +
\sigma_n^2}\). La differenza non è cosmetica: dove le misure si infittiscono la
prima si assottiglia fino quasi a sparire, mentre la seconda non scende mai
sotto \(\sigma_n\). Se la domanda è «che valore misurerò domani» serve la seconda;
se è «quanto vale la grandezza vera», la prima. Per la classificazione la
verosimiglianza non è più gaussiana e il posteriore non ha forma chiusa: servono
approssimazioni (Laplace, expectation propagation), e
GaussianProcessClassifier di scikit-learn usa quella di Laplace
[RW06].
La Fig. 4.42 mostra tutto il meccanismo in un colpo d’occhio: la banda si stringe sui punti osservati fin quasi a toccarli (quasi, perché ogni punto è una misura sola, e rumorosa: più misure nello stesso punto la stringerebbero ancora) e si riapre nel buco centrale e ai bordi, dove i dati mancano.

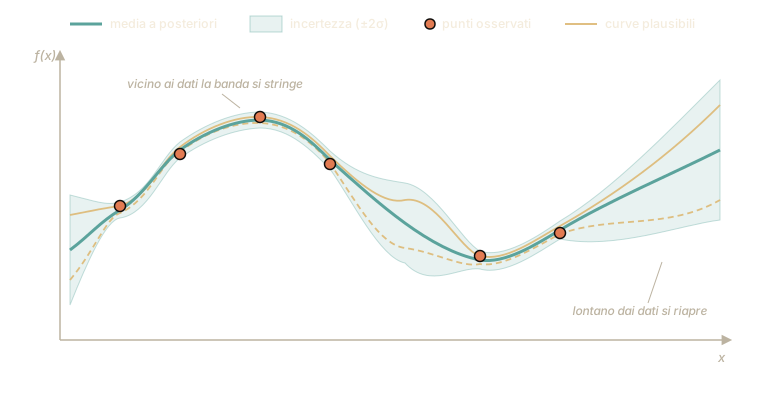
Fig. 4.42 La previsione di un processo gaussiano: la banda d’incertezza si stringe sui punti osservati e si riapre dove i dati mancano.#
In pratica, con scikit-learn#
Proviamo su un caso da manuale: pochi punti rumorosi di una sinusoide, come fossero otto esperimenti costosi.
import numpy as np
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF

# Otto misure "costose" di una sinusoide, con rumore
rng = np.random.default_rng(0)
X_train = rng.uniform(0, 6, size=(8, 1))
y_train = np.sin(X_train).ravel() + rng.normal(0, 0.1, size=8)

# Kernel RBF; alpha è la varianza del rumore delle osservazioni
kernel = 1.0 * RBF(length_scale=1.0)
gp = GaussianProcessRegressor(kernel=kernel, alpha=0.1**2,
                              n_restarts_optimizer=5, random_state=0)
gp.fit(X_train, y_train)          # stima anche sigma_f e l dai dati

# Previsione CON incertezza: media e deviazione standard
X_test = np.array([[1.5], [3.0], [8.0]])
media, dev_std = gp.predict(X_test, return_std=True)

print("i punti misurati:", np.sort(X_train.ravel()).round(2))
for x, mu, s in zip(X_test.ravel(), media, dev_std):
    print(f"x = {x:.1f}  ->  f(x) = {mu:+.2f} ± {2 * s:.2f}")
print("kernel stimato:", gp.kernel_)
i punti misurati: [0.1  0.25 1.62 3.64 3.82 4.38 4.88 5.48]
x = 1.5  ->  f(x) = +0.83 ± 0.20
x = 3.0  ->  f(x) = +0.07 ± 0.36
x = 8.0  ->  f(x) = +0.12 ± 1.38
kernel stimato: 0.706**2 * RBF(length_scale=1.27)
La riga chiave è return_std=True: accanto a ogni previsione arriva la sua
deviazione standard, quella sulla funzione (il rumore entra da alpha), cioè di
quanto il valore vero, tipicamente, si scosta dalla stima. Nella stampa la
raddoppiamo, e non a caso: in una curva a campana, fra due deviazioni standard
sotto la media e due sopra cade circa il \(95\%\) dei casi. È una proprietà della
campana, non una scelta nostra, ed è la ragione per cui un intervallo largo due
deviazioni standard per parte si legge come «quasi certamente il valore sta lì
dentro».
Le tre righe stampate raccontano la storia della figura in tre gradini, non in due. A \(x = 1{,}5\), accanto a un dato osservato, la banda è strettissima (\(\pm 0{,}20\)). A \(x = 3{,}0\) siamo ancora dentro l’intervallo esplorato, ma in mezzo a un buco: fra \(1{,}62\) e \(3{,}64\) la prima riga stampata non ha nessun punto, e \(3{,}0\) sta proprio in quel vuoto. La banda si allarga già a \(\pm 0{,}36\), quasi il doppio, pur restando utile. A \(x = 8{,}0\), fuori da tutto ciò che il modello ha visto, la banda arriva a \(\pm 1{,}38\), vicina all’ampiezza del prior, \(2\sigma_f = 2 \cdot 0{,}706 \approx 1{,}41\) (dal kernel stimato, stampato nell’ultima riga): lontano dai dati il modello torna all’incertezza di partenza, e lo dichiara. L’incertezza non distingue «dentro» da «fuori» l’intervallo esplorato: dipende dalla distanza dal dato più vicino.
Il conto da pagare, e dove conviene#
Il processo gaussiano esatto ha un costo cubico nel numero di esempi, e questo ne limita l’uso ai problemi con pochi dati.
Il processo gaussiano non si costruisce un riassunto dei dati da consultare poi: tiene tutte le osservazioni. Prima di rispondere le confronta tutte a due a due, come un medico che, prima di aprire l’ambulatorio, rileggesse e mettesse a confronto le cartelle di tutti i pazienti mai avuti; e poi, a ogni visita, confronta il paziente nuovo con ciascuna cartella. Con qualche centinaio di pazienti funziona benissimo; verso le decine di migliaia comincia a non stare più in piedi, e sopra servono scorciatoie o molte schede grafiche.
E il conto della preparazione è peggiore di quanto l’immagine suggerisca. Confrontare tutte le coppie sarebbe già un lavoro che cresce col quadrato del numero di pazienti: raddoppiandoli, le coppie quadruplicano. Ma non basta guardarle una per una: quelle somiglianze vanno risolte tutte insieme, come un sistema di equazioni in cui ogni riga tira le altre, e questo aggiunge un fattore. Il risultato è che il lavoro cresce col cubo: raddoppiare i dati lo moltiplica per otto (\(2 \times 2 \times 2\)), e passare da mille a diecimila punti lo moltiplica per mille. Dopo la preparazione, ogni risposta costa molto meno: la stima cresce come il numero dei pazienti, la banda come il suo quadrato. Ma è la preparazione il motivo per cui non si addestra un processo gaussiano sulle foto di tutto internet.
Una scorciatoia esiste, ed è proprio il riassunto che il metodo si rifiutava di fare. Invece di tenere tutte le cartelle se ne scelgono un centinaio, casi rappresentativi a cui ricondurre gli altri, e il conto torna abbordabile. Il prezzo si paga sull’ingrediente per cui si era scelto questo modello: le stime reggono, le bande d’incertezza diventano meno affidabili. E resta in piedi la scommessa di partenza, la regola di somiglianza che abbiamo adottato, che è un’ipotesi sul mondo e sul mondo va controllata.
Il collo di bottiglia è la fattorizzazione di Cholesky di \(\mathbf{K} + \sigma_n^2 \mathbf{I}\): \(O(m^3)\) in tempo e \(O(m^2)\) in memoria, il caso peggiore dell’\(O(m^2)\)–\(O(m^3)\) visto per la SVM con kernel. Fatta una volta, ogni previsione costa \(O(m)\) per la media e \(O(m^2)\) per la varianza. Con la fattorizzazione esatta il limite pratico è di qualche decina di migliaia di punti, e lo si sposta in due modi. Le approssimazioni sparse riassumono il dataset con \(u \ll m\) punti induttori e scendono a \(O(m\,u^2)\) [Tit09], ma pagano in fedeltà proprio sulla merce di casa, la qualità delle incertezze. I metodi iterativi tengono il modello esatto e sostituiscono Cholesky con il gradiente coniugato, che chiede soltanto prodotti per \(\mathbf{K}\): su più GPU hanno addestrato processi gaussiani esatti su oltre un milione di punti [WPG+19]. A ciò si aggiunge la sensibilità alla scelta del kernel, che incorpora ipotesi forti (con l’RBF, la regolarità infinita, che Matérn allenta) da verificare sul problema reale.
Il suo territorio, allora, è l’opposto del big data: pochi dati costosi. Esperimenti di laboratorio dove ogni misura vale una giornata di lavoro, simulazioni ingegneristiche da ore di calcolo l’una, prove sul campo che non si possono ripetere. È il caso che abbiamo già incontrato: l’ottimizzazione bayesiana degli iperparametri [SLA12], dove ogni «dato» è un intero addestramento e il processo gaussiano fa da mappa (stima più incertezza) per decidere quale configurazione provare dopo. Trovare gli iperparametri racconta quel meccanismo dal lato di chi lo usa: il processo gaussiano è il surrogato classico, quello di Snoek e coautori, anche se Optuna di default ne usa un altro, il TPE, che costa meno quando le prove sono migliaia.
Da ricordare
Un processo gaussiano non sceglie una curva: tiene in mano tutte quelle che i dati non hanno ancora escluso, e per ogni punto risponde con due numeri, la stima e quanto fidarsene. «Domani tra 21 e 27», non «domani 24».
L’ingrediente che tiene insieme il fascio è la regola del buon senso: punti vicini hanno valori simili. Quanto lontano arrivi l’effetto di una misura lo decide soprattutto una manopola, il raggio d’influenza: corto, curve nervose; lungo, curve morbide. L’altra, l’ampiezza, dice quanto ballano i valori.
La banda d’incertezza si stringe accanto ai dati e si riapre dove mancano, compresi i buchi in mezzo alle misure. A distinguere una previsione affidabile da una azzardata è avere o non avere un dato vicino, più che stare dentro o fuori dall’intervallo esplorato.
Una banda larghissima vale come ammissione: il modello dichiara di non sapere, e pochi altri metodi lo fanno.
Il prezzo è che regge male i dati numerosi: tiene tutte le misure e le confronta fra loro, e raddoppiare i dati moltiplica per otto il lavoro per prepararlo (per ogni previsione serve poi ancora l’archivio intero). È perfetto quando i dati sono pochi e costosi (un esperimento, una simulazione, un addestramento intero da provare) e molto costoso quando sono milioni.
Da ricordare
Un processo gaussiano non impara una curva sola: mantiene una distribuzione su tutte le curve compatibili con i dati e per ogni punto restituisce una media e un’incertezza; «tra 21 e 27», non «24 e basta».
Il kernel codifica la somiglianza («punti vicini hanno valori simili»); la lunghezza-scala \(\ell\) decide fin dove arriva l’influenza di un’osservazione. I suoi iperparametri si stimano massimizzando la verosimiglianza marginale, che contiene già il rasoio di Occam, ma non è concava (da qui le ripartenze multiple) e con molti iperparametri può sovradattare.
La banda d’incertezza si stringe sui punti osservati e si riapre dove i dati mancano, buchi interni compresi: il modello dichiara quanto non sa. \(\boldsymbol{\mu}_* \pm 2\sqrt{\operatorname{diag}(\boldsymbol{\Sigma}_*)}\) è la banda sulla funzione; per una nuova osservazione va aggiunto \(\sigma_n^2\).
L’addestramento esatto costa \(O(m^3)\) (raddoppiare i dati costa otto volte il tempo), ogni previsione \(O(m)\) per la media e \(O(m^2)\) per la varianza; sopra qualche decina di migliaia di punti servono approssimazioni sparse o metodi iterativi su GPU. Perfetto con pochi dati costosi (esperimenti, simulazioni, ottimizzazione bayesiana degli iperparametri).
Fin qui la forma del modello l’abbiamo scelta noi, una per problema: una retta, un albero, un margine massimo, una distribuzione sulle funzioni, dei gruppi trovati senza etichette. Cambiava il problema e cambiava il modello, e cambiava anche il metro: dove una risposta giusta non esiste, il criterio si dichiara invece di calcolarlo. Dove una risposta giusta c’era, però, l’errore misurato sugli esempi è stato preso come stima dell’errore su quelli nuovi, a una condizione che Quando i dati cambiano ha messo in dubbio: che gli uni e gli altri vengano dalla stessa distribuzione. Perché quella stima regga, con quanti esempi e per quali famiglie di modelli, lo dice la teoria dell’apprendimento; e quello che stabilisce va portato intatto in Reti neurali, dove il modello è uno solo e prende la forma che serve impilando pezzi tutti uguali.