


Machine Learning: imparare dai dati#
Nel 1959 un ingegnere dell’IBM di nome Arthur Samuel pubblicò un articolo dal titolo modesto (Some Studies in Machine Learning Using the Game of Checkers [Sam59]) che oggi suona profetico. Samuel aveva scritto un programma che giocava a dama, e la parte sorprendente è questa: giocando contro sé stesso, il programma arrivò a giocare meglio del suo autore. Non perché Samuel gli avesse insegnato le mosse giuste una per una, ma perché le aveva ricavate dall’esperienza.
Se giocava contro sé stesso, però, chi gli diceva quale mossa fosse quella buona? Nessuno, ed è qui l’idea. Il programma dava un voto alla posizione che aveva davanti, poi guardava qualche mossa più in là, e correggeva il voto di adesso avvicinandolo a quello che vedeva dopo. Nessuno gli diceva chi avesse ragione: a fare da maestro era la propria stessa valutazione, presa un passo più avanti, dove si vede meglio. Qualcosa di vero entrava comunque: Samuel fissava a mano una delle voci del voto (i pezzi in più o in meno rispetto all’avversario) e il programma non la cambiava, e guardando più avanti le catture si vedevano. Ripetuto per tutta la partita e per tutte le partite, quel voto diventa un fiuto per le posizioni che portano bene. È l’idea da cui nascerà l’apprendimento per differenze temporali: il nome torna nella pagina sul Q-learning, ed è lì che si vede per intero.
In quell’articolo del 1959 compare, fra le prime volte, l’espressione machine learning: la capacità di un calcolatore di migliorare a un compito senza essere riprogrammato a mano. Il capitolo di matematica si era chiuso sull’ultimo strato di un modello linguistico, cioè su un punto d’arrivo; qui si torna all’origine dell’idea.
È un’idea che ribalta il modo consueto di pensare al software.
Scrivere le regole, o farle emergere#
Il salto concettuale del machine learning si capisce meglio mettendolo accanto alla programmazione di sempre.
Con la programmazione di sempre, le regole di un filtro antispam le scrivi tu: «se l’email contiene la parola vincita, segnala come spam», «se il mittente è sconosciuto, sospetta». Ogni regola la pensi, la scrivi, la correggi a mano. Funziona finché gli spammer non cambiano trucco, e allora ricominci da capo.
Il machine learning fa il contrario. Tu non scrivi le regole: raccogli migliaia di email già etichettate come «spam» o «non spam» e le dai in pasto al programma. È lui a trovare da solo le regolarità: quali parole, quali mittenti, quali combinazioni ricorrono nello spam. Le regole emergono dai dati, non le scrivi tu.
E devono reggere fuori dal mucchio. Le email che gli hai dato qualcuno le ha già smistate a mano, quindi rismistarle non serve a nessuno: quello che ti serve è che se la cavi sulla prossima, quella che nel mucchio non c’era.
Nella programmazione tradizionale il programmatore conosce la funzione \(f\) che trasforma un input in un output e la codifica esplicitamente: \(\text{output} = f(\text{input})\). Le regole sono note a priori.
Nel machine learning \(f\) è ignota. Disponiamo invece di una collezione di coppie input-output osservate, e cerchiamo una funzione \(f_\theta\), presa da una famiglia parametrizzata da \(\theta\), che le riproduca bene e (soprattutto) generalizzi a input mai visti. Il compito non è più scrivere \(f\), ma stimare i parametri \(\theta\) a partire dai dati. Il codice resta fisso; ciò che cambia, con l’esperienza, sono i numeri dentro \(\theta\).
Il risultato dell’addestramento è il modello: la funzione \(f_\theta\), cioè la regola con i suoi parametri \(\theta\) (i numeri regolabili) fissati dai dati. Per il filtro antispam, \(\theta\) contiene i numeri che dicono quanto conta la parola «vincita» o un mittente sconosciuto; il codice che li usa è sempre lo stesso, e cambiano solo quei numeri. Le tecniche per trovare i valori di \(\theta\) e le caratteristiche dell’input da esaminare variano da un metodo all’altro; quello che tutti hanno in comune è che la regola non viene scritta a mano.
Che cosa vuol dire «imparare»: la definizione di Mitchell#
La definizione operativa più citata è quella di Tom Mitchell, nel manuale Machine Learning del 1997 [Mit97]. Ha il pregio di essere verificabile: dice quando un programma sta davvero imparando e quando no.
Un programma impara se, facendo pratica, diventa più bravo in un compito, e questo «più bravo» lo possiamo misurare. Servono tre ingredienti:
il compito, cosa deve fare (giocare a dama);
l’esperienza, su cosa fa pratica (le partite giocate);
la misura, come contiamo i progressi (la percentuale di partite vinte).
Il programma di Samuel diventava più bravo (vinceva di più) man mano che accumulava partite. Questo, e solo questo, è imparare. Se dopo mille partite ne vincesse la stessa quota di prima non avrebbe imparato niente, per quante ne avesse giocate, perché a decidere è il numero che sale e non il tempo passato al tavolo.
I tre ingredienti non parlano di dama. Al posto del compito metti il riconoscere una firma falsa, al posto dell’esperienza le firme già controllate una per una, al posto della misura quante ne sbagli su cento. La domanda da fare resta la stessa, e cioè se quegli errori calano man mano che le firme controllate aumentano. Funziona con un programma qualunque, senza sapere niente di come è fatto dentro.
Mitchell la formula così: un programma apprende da un’esperienza \(E\) rispetto a una classe di compiti \(T\) e a una misura di performance \(P\), se la sua performance sui compiti in \(T\), misurata da \(P\), migliora con l’esperienza \(E\).
\(T\) (task): il problema, per esempio classificare email.
\(E\) (experience): i dati da cui apprende, per esempio \(m\) email etichettate.
\(P\) (performance): una metrica scalare, per esempio l’accuratezza sul test.
La formulazione è deliberatamente astratta: non nomina reti neurali né alberi di decisione. È un contratto che qualunque algoritmo di apprendimento deve rispettare: se all’aumentare di \(E\) la \(P\) non migliora, non c’è apprendimento.
Tre modi di imparare#
A seconda del tipo di esperienza a disposizione, il machine learning si divide in tre grandi famiglie (chi scrive di ricerca le chiama paradigmi).
Apprendimento supervisionato. Ogni esempio arriva con la sua risposta giusta, l’etichetta, come nel filtro antispam, e il modello impara a prevedere l’output (quello che esce) a partire dall’input (quello che entra). Se l’output è una categoria si parla di classificazione (spam o non spam, gatto o cane); se è un numero che può assumere qualunque valore intermedio (2,5 metri quadri esistono, 2,5 stanze no), di regressione (il prezzo di una casa dai suoi metri quadri).
A fianco di ogni esercizio c’è la soluzione. Chi studia così prova a rispondere da solo, poi scopre il riquadro accanto e vede di quanto ha sbagliato. Su ogni esercizio gli resta un numero, lo scarto fra la sua risposta e quella giusta.
Un singolo scarto dice poco. Quello che conta è la media su tutta la raccolta: cinque esercizi sbagliati di 2, 0, 1, 0 e 2 punti fanno 5 punti in tutto, cioè 1 punto a esercizio, ed è quella media che chi studia cerca di far scendere. Si guarda lei, e mai il singolo esercizio. Un modo di rispondere che azzecca un esercizio solo e manda fuori strada gli altri quattro alza la media, quindi vale meno, per quanto sia perfetto lì. Fra due modi di rispondere si tiene sempre quello con la media più bassa.
Le «soluzioni a fianco» sono le etichette: senza di esse non c’è niente contro cui misurare lo scarto, e questo tipo di apprendimento non funziona. La raccolta, poi, si fa per gli esercizi che ancora non ci sono, quelli senza soluzione a fianco, dove si vede se qualcuno ha davvero imparato.
Dato un insieme di addestramento \(\{(\mathbf{x}^{(i)}, y^{(i)})\}_{i=1}^{m}\), dove \(\mathbf{x}^{(i)}\) è il vettore delle feature dell’esempio \(i\)-esimo e \(y^{(i)}\) la sua etichetta, si cerca \(f_\theta\) che minimizzi una funzione di costo (o loss) che penalizza le previsioni sbagliate:
Qui \(f_\theta(\mathbf{x}^{(i)}) = \hat{y}^{(i)}\) è la predizione del modello e \(\ell\) misura la sua distanza dal valore vero \(y^{(i)}\); la media di tutti gli \(\ell\) è la loss sull’intero insieme, \(\mathcal{L}\). L’addestramento supervisionato consiste in questo problema di minimizzazione; la regolarizzazione vi aggiunge una penalità, e la validazione controlla ciò che interessa davvero, l’errore su dati nuovi.
Apprendimento non supervisionato. Qui le etichette non ci sono: il modello riceve solo gli input e deve scoprire da sé una struttura nascosta. L’esempio classico è il clustering: raggruppare i clienti di un negozio in segmenti simili senza sapere in anticipo quali segmenti esistano. Rientrano qui la riduzione della dimensionalità, cioè descrivere ogni esempio con meno numeri conservandone il più possibile l’informazione, e il rilevamento di anomalie, per esempio una transazione che non somiglia alle altre in assenza di esempi etichettati. (Le «dimensioni» sono le colonne della tabella, una per caratteristica: la sezione sull’apprendimento supervisionato spiega perché si chiamino così).
Apprendimento per rinforzo. Non ci sono etichette, e non c’è nemmeno un mucchio di esempi fissato in partenza: c’è un agente (un programma che agisce, non una persona) che compie azioni in un ambiente e riceve, di tanto in tanto, una ricompensa. L’agente impara per tentativi la strategia che massimizza la ricompensa nel tempo. È il modo in cui il programma AlphaGo, del laboratorio DeepMind, imparò nel 2016 a battere i campioni del go, un antico gioco da tavolo orientale: quella prima versione studiò anche partite umane etichettate, mentre la versione dell’anno dopo imparò solo giocando contro sé stessa. Di questo il programma di dama di Samuel è un antenato: giocava contro una copia di sé stesso e, dopo ogni mossa, spostava la valutazione della posizione verso quella che otteneva guardando qualche mossa più avanti. Non c’era una ricompensa esplicita, e nemmeno un trattamento speciale della vittoria.
Dall’idea al modello: il flusso di un progetto#
Addestrare un modello è solo uno dei passaggi di un progetto di machine learning, e i passaggi non stanno su una linea retta ma su un ciclo: i risultati della valutazione ti dicono come tornare indietro e fare meglio (Fig. 4.1).

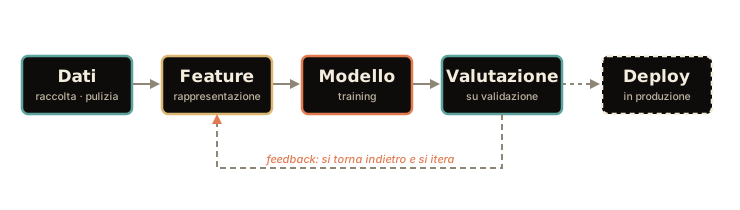
Fig. 4.1 Il flusso tipico di un progetto ML. Dopo la valutazione, fatta su dati tenuti da parte, si torna quasi sempre indietro a rivedere le feature, e si ricomincia il giro.#
I passaggi, in ordine:
Dati: raccogliere esempi e ripulirli (valori mancanti, duplicati, errori). Spesso è la fase più lunga e ingrata dell’intero progetto. Di solito si organizzano in una tabella: una riga per ogni esempio, una colonna per ogni cosa che ne abbiamo misurato.
Feature: un modello non legge un’email, calcola su numeri. Le feature (in italiano le caratteristiche, cioè le colonne della tabella) sono i numeri con cui si descrive ogni esempio. Di un’email si possono prendere il numero di parole, quello dei punti esclamativi, quante volte compare «vincita», se il mittente è in rubrica: quattro numeri, e per il modello l’email diventa quei quattro numeri. Nel machine learning classico le sceglie chi progetta il sistema, e cambiandole cambia la risposta; le reti profonde, tema del capitolo sulle reti neurali, le ricavano in parte dai dati grezzi.
Modello: decidere che forma dare al modello (una retta? un albero di domande? una rete?) e poi addestrarlo sui dati. Dentro un modello ci sono dei numeri regolabili, i parametri (nelle formule, tutti insieme, \(\theta\), la lettera greca theta). Addestrare vuol dire modificarli finché il modello sbaglia il meno possibile sui dati, e «quanto sbaglia» è a sua volta un numero, che si chiama loss (la perdita): la media, su tutti gli esempi, di quanto costa ogni risposta sbagliata. Si scrive \(\mathcal{L}(\theta)\) (si legge «elle di theta»: la loss calcolata con quei parametri), perché dipende dai parametri. Attenzione a non confondere i due momenti: la forma la scegliamo prima, i numeri dentro li trova l’addestramento, e «modello» in senso stretto è il risultato dei due messi insieme.
Valutazione: misurare le prestazioni su dati mai visti in addestramento. Gli esempi già usati non servono allo scopo: su di essi un modello può avere un errore bassissimo limitandosi a riprodurli, e quell’errore non dice come si comporterà su un’email nuova. Quello che interessa è l’errore su dati mai visti, l’errore di generalizzazione.
Deploy: se i numeri convincono, mettere il modello in produzione, cioè lasciarlo lavorare sul serio, con utenti veri e dati che arrivano ogni giorno, e sorvegliarlo, perché i dati del mondo cambiano nel tempo.
La freccia di ritorno è la parte più importante: quasi mai il primo tentativo è quello buono. Si osserva dove il modello sbaglia su dati tenuti da parte per giudicare, si ritoccano le feature o il modello, e si ricomincia il giro; su quali dati si giudica lo stabilisce la sezione su overfitting e validazione.
In pratica l’addestramento (in inglese training, ed è la parola che si sente
più spesso) è sorprendentemente breve da scrivere. Con una libreria, cioè
una cassetta di attrezzi già pronti che qualcun altro ha costruito, addestrare
un modello e usarlo sono due sole richieste: .fit() per imparare dai dati,
.predict() per prevedere su casi nuovi. La cassetta degli attrezzi si chiama
scikit-learn.
Il metodo fit cerca i parametri che rendono piccola la loss sugli esempi di
addestramento, in modo esatto o approssimato a seconda del modello. L’albero di
decisione dell’esempio lo fa in modo approssimato: costruisce le domande una
alla volta, senza tornare indietro, e a ogni passo sceglie quella che riduce di
più una misura di impurità (per default l’indice di Gini), che fa le veci della
loss. predict applica la \(f_{\theta^\star}\) appresa. La separazione tra dati
di addestramento e dati di test serve a stimare l’errore di generalizzazione,
non la mera memorizzazione degli esempi già visti.
from sklearn.tree import DecisionTreeClassifier   # un albero di decisione,
                                                  # cioè una catena di domande
                                                  # sì/no: lo vediamo fra poco

# X_train: le feature di ogni esempio, y_train: l'etichetta da prevedere.
# Per convenzione le X sono maiuscole (una tabella) e le y minuscole (una
# sola colonna di risposte); X_test sono gli esempi tenuti da parte.
modello = DecisionTreeClassifier()
modello.fit(X_train, y_train)       # training: il modello impara dai dati
y_pred = modello.predict(X_test)    # previsione su dati mai visti in training
Dati tabellari: dove il machine learning classico resta competitivo#
Una scena frequente nelle squadre alle prime armi. Arriva un problema (prevedere quali clienti abbandoneranno il servizio, a partire da una tabella di età, contratti, consumi, reclami) e qualcuno propone subito una rete neurale profonda, perché è quella di cui parlano tutti. Passano due settimane di messa a punto, e alla fine la rete arriva faticosamente a pareggiare un gradient boosting, cioè tanti piccoli modelli semplici messi in fila, ognuno a correggere gli errori del precedente. Quel gradient boosting l’aveva addestrato in dieci minuti un collega scettico, senza toccare nemmeno un’impostazione.

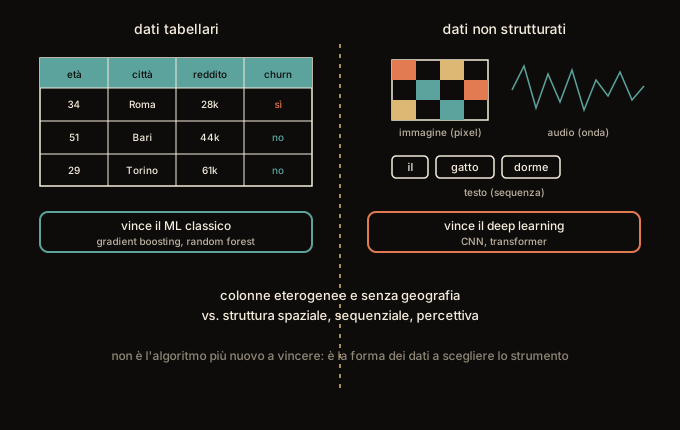
Fig. 4.2 Non c’è un vincitore assoluto, c’è un confine. A sinistra i dati già in tabella, dove le colonne sono già le caratteristiche buone; a destra le foto, il suono e il testo, dove le caratteristiche vanno ricavate dai puntini di un’immagine o dall’onda di un suono, ed è lì che le reti profonde non hanno rivali.#
C’è un confine, e Fig. 4.2 lo disegna. È quello che la scena di prima ignora ogni volta.
Sullo schermo c’è la tabella dei clienti, una riga per persona e in colonna l’età, il codice postale, il reddito annuo, i giga consumati il mese scorso, i reclami aperti. Fra la colonna del codice postale e quella del reddito non c’è nessun rapporto: unità diverse, scale diverse, significati diversi. Si possono scambiare di posto e la tabella dice le stesse cose. Sono colonne senza geografia.
In una fotografia la geografia c’è, perché due puntini vicini appartengono allo stesso occhio e scambiarli sfigura la faccia. In una frase c’è un ordine, e spostare una parola cambia chi fa che cosa. Le reti profonde hanno ridefinito quello che si può fare con immagini, suono e linguaggio proprio perché sono costruite su quella geografia, con pezzi fatti apposta per i puntini vicini e altri per capire quali parole si riferiscono a quali. Davanti alla tabella dei clienti quei pezzi non hanno niente da guardare, e il vantaggio evapora.
I modelli semplici che il collega scettico ha messo in fila lavorano una domanda alla volta: «i giga consumati sono più di ottanta?», poi «il contratto è ancora attivo?», poi «il quartiere è Milano?», e avanti così fino a una risposta. Una catena di domande con risposta sì o no, ciascuna su una colonna sola, si chiama albero di decisione. Che le colonne abbiano unità e scale diverse non gli dà nessun fastidio, perché non le mescola mai fra loro.
Dentro quella tabella le cose cambiano di scatto. La promozione parte a cinquanta euro di ricarica. Chi si ferma a quarantanove e novanta non prende i giga in regalo, chi arriva a cinquanta e un centesimo sì, e di due clienti quasi identici uno rinnova e l’altro se ne va. Una rete neurale tira volentieri curve morbide, e attraverso un salto del genere ci passa arrotondandolo, sbagliando proprio sui clienti a ridosso della soglia. L’albero quel salto lo fa netto, perché la sua domanda è già «la ricarica supera i cinquanta euro?», e di soglie così ne mette una dietro l’altra.
Nella stessa tabella parecchie colonne non dicono niente sul problema: il codice interno del cliente, la data in cui la riga è stata digitata, un campo che qualcuno ha smesso di compilare due anni fa. La rete se le porta dietro tutte, e da quel rumore raccoglie qualcosa che scambia per un segnale. L’albero a ogni passo sceglie una colonna sola, e la sceglie perché divide bene chi resta da chi se ne va: una colonna muta, che non divide bene niente, di solito perde contro le colonne che contano. Con poche righe e moltissime colonne mute qualcuna vince per caso, ma l’albero ne risente meno di una rete, che le usa tutte.
Quella gara è stata rifatta nel 2022 su decine di tabelle vere, dando ai due contendenti lo stesso tempo di messa a punto, e gli alberi hanno vinto, su tabelle come quella sullo schermo, intorno alle diecimila righe. Su tabelle più grandi il divario si riduceva; su quelle più piccole non era stato misurato, e da allora sono arrivati modelli pre-addestrati che dichiarano di vincere proprio lì. Una rete profonda sa costruirsi da sola le caratteristiche buone dai dati grezzi, cosa che un albero non sa fare, ma di esempi ne vuole tantissimi.
Resta il conto da pagare. Il modello del collega si è addestrato sul suo portatile e va in servizio così com’è, senza macchine speciali. Prima di firmare per una rete profonda si mette in piedi il modello semplice e lo si regola per bene, e molto spesso la risposta è già quella.
L’osservazione è stata misurata su decine di dataset: Grinsztajn, Oyallon e Varoquaux (NeurIPS 2022) [GOV22] hanno confrontato modelli ad albero e reti neurali su 45 dataset tabulari, trovando che i primi restavano superiori anche a parità di ricerca degli iperparametri, cioè delle scelte che si fissano a mano prima di addestrare, sui dati di taglia media, dell’ordine dei diecimila esempi. Il confronto è di quell’anno: da allora modelli pre-addestrati su dati sintetici, come TabPFN [HMullerP+25], dichiarano di superare sotto i diecimila esempi i metodi precedenti, boosting compresi. Le ragioni che seguono spiegano il risultato del 2022, e restano utili per capire dove una rete ha difficoltà su una tabella.
Le ragioni identificate sono strutturali:
le reti hanno un bias induttivo verso funzioni regolari, mentre i target tabulari sono spesso irregolari a tratti, esattamente ciò che una serie di split assiali approssima bene;
le reti sono più sensibili degli alberi alle feature non informative, di cui una tabella reale abbonda: un albero sceglie a ogni nodo la divisione che migliora di più un’impurità, e le colonne senza relazione con il bersaglio vincono di rado nei nodi alti, anche se con pochi esempi per nodo qualcuna vince per caso;
l’addestramento di un MLP con la discesa del gradiente, partendo da pesi a simmetria sferica (per esempio gaussiani indipendenti), è invariante per rotazione. Se si ruotano le colonne con una matrice ortogonale, le previsioni ottenute restano invariate in distribuzione, impedendo alla procedura di sfruttare la base in cui la tabella è scritta. Una tabella, al contrario, possiede una sua base naturale composta da colonne con significati diversi, che una mescolanza cancellerebbe. Questo aspetto si lega al punto precedente: una procedura invariante per rotazione richiede, nel caso peggiore, un numero di esempi che cresce almeno linearmente con il numero di feature irrilevanti [Ng04].
Il corollario pratico riguarda il costo: un gradient boosting si addestra in minuti su CPU e si mette in produzione senza GPU. Prima di pagare il conto del deep learning conviene avere una linea di base classica ben tarata (la baseline dei paper), e succede spesso che quella linea di base sia già la risposta.
Per questo il machine learning classico viene per primo, e non per ragioni cronologiche: le quattro parole (modello, feature, parametri, loss) e i due gesti (addestrare, valutare su dati mai visti) valgono anche per le famiglie di modelli che seguono, dove cambierà semmai che cosa si misura con la loss. Si comincia dall’apprendimento supervisionato.
Da ricordare
Nel machine learning non si scrivono le regole: si danno migliaia di esempi già etichettati (le email marchiate «spam» e «non spam») e le regole emergono da sole dai dati.
Nei confronti fatti fino al 2022 su tabelle intorno alle diecimila righe gli alberi battevano le reti profonde: fra le colonne di una tabella non c’è quella vicinanza che le reti sanno sfruttare fra i puntini di una foto o fra le parole di una frase. Modelli pre-addestrati più recenti dichiarano di aver ribaltato il risultato sulle tabelle piccole.
Quattro parole valgono per tutti i modelli (modello, feature, parametri, loss), e due gesti: addestrare, e valutare su dati mai visti.
Un programma impara (Mitchell) se, facendo pratica, diventa più bravo in un compito e questo «più bravo» si può misurare: servono il compito, l’esperienza e la misura.
Tre modi di imparare: con le soluzioni a fianco (supervisionato), senza etichette, cercando una struttura nascosta (non supervisionato), per tentativi e ricompense (per rinforzo).
Il flusso (dati, feature, modello, valutazione, deploy) è un ciclo: la valutazione rimanda indietro, e si ricomincia il giro.
Da ricordare
Nel machine learning non si scrivono le regole: si forniscono esempi e le regole emergono dai dati, cioè si stimano i parametri \(\theta\) minimizzando una loss \(\mathcal{L}\) sugli esempi osservati.
Nel confronto di Grinsztajn et al. (2022), su dati tabulari di taglia media, dell’ordine dei diecimila esempi, i modelli ad albero restavano superiori alle reti anche a parità di ricerca degli iperparametri [GOV22]. Modelli pre-addestrati più recenti dichiarano di aver ribaltato il risultato sotto i diecimila esempi.
Le ragioni sono strutturali: il bias induttivo delle reti verso funzioni regolari, contro target irregolari a tratti; la loro maggiore sensibilità alle feature non informative; l’invarianza per rotazione del loro addestramento, dannosa dove mescolare linearmente le colonne cancella il significato di ciascuna.
Un programma impara (Mitchell) se la sua performance \(P\) su un compito \(T\) migliora con l’esperienza \(E\).
Tre paradigmi: supervisionato (dati etichettati), non supervisionato (struttura nascosta, senza etichette), per rinforzo (agente e ricompense).
Il flusso (dati, feature, modello, valutazione, deploy) è un ciclo: la valutazione rimanda indietro, e si itera.