


Paesaggi di oggi#
Le reti di Hopfield non si usano più, e nemmeno le macchine di Boltzmann ristrette, le RBM della sezione sulle macchine di Boltzmann. Sarebbe facile archiviare l’energia come un pezzo di storia del deep learning, e sarebbe sbagliato: il modo di ragionare è rimasto, e tre luoghi diversi lo praticano oggi correntemente. Nel primo lo si dichiara, e sono i ricercatori che scrivono «modello a energia» nel titolo; negli altri due no, e sono i generatori di immagini e le memorie associative di oggi, che quel linguaggio lo usano senza nominarlo.
Il ritorno dichiarato: modelli a energia sulle immagini#
L’idea di far calcolare l’energia di un’immagine a una rete convoluzionale, e di campionarla con la ricetta di Langevin, risale al 2016, a Jianwen Xie e colleghi [XLZW16]. Il ritorno su scala arriva nel 2019, quando Yilun Du e Igor Mordatch mostrano che un modello a energia (in inglese energy-based model, che nella letteratura si abbrevia in EBM) si addestra su CIFAR-10, un archivio di fotografie a colori di animali e mezzi di trasporto, e più su fino alle immagini di ImageNet [DM19]. Gli attrezzi sono quelli della sezione sulla funzione di partizione, con aggiustamenti che contano.
Le immagini che ottengono sono migliori di quelle dei modelli che imparavano dalle probabilità, vicine a quelle delle GAN più semplici e lontane dalle migliori. Il valore del lavoro, però, è un altro: mostrare che la famiglia è viva, e mettere in luce la proprietà che le è tipica. Un solo modello serve a generare, a completare immagini a cui manca un pezzo, a segnalare quello che è fuori posto e a mescolare concetti sommando i loro paesaggi.
A dare il voto a ogni immagine c’è una rete convoluzionale come quelle del capitolo sul deep learning. Il paesaggio non è disegnato da nessuna parte: esiste solo nel senso che quella rete, per ogni immagine che le si dà, sa dire quanto in alto sta. Le risposte sbagliate su cui alzare il terreno se le fabbrica il modello stesso, lasciando rotolare qualche pallina giù per il paesaggio con addosso un po’ di rumore. Le palline di Du e Mordatch, però, rotolano molto e tremano pochissimo, molto meno di quanto la ricetta di Langevin vorrebbe, e si fermano dopo qualche decina di passi: più che una camminata che rispetta le proporzioni, è una discesa con un filo di rumore. La rete che dà i voti va tenuta a freno, perché non dia voti enormi e le palline non schizzino via. E le palline non ripartono da capo ogni volta: si tengono in un cesto e riprendono da dove erano arrivate, con qualcuna nuova buttata dentro ogni tanto. È il sogno che prosegue della macchina di Boltzmann, undici anni dopo e su fotografie a colori invece che su minuscole cifre in bianco e nero.
Mescolare concetti merita due numeri, perché è la proprietà più bella e la meno ovvia. Si prende il paesaggio di «giovane» e quello di «sorridente» e si sommano le due altezze punto per punto. Una faccia giovane e imbronciata sta a 3 nel primo paesaggio e a 10 nel secondo: sommati, 13, ed è una cima. Una faccia giovane e sorridente sta a 3 e a 2: sommati, 5, ed è ancora una valle. Sopravvivono insomma soltanto le conche che le due richieste hanno in comune, e cercare il punto più basso del paesaggio somma vuol dire cercare una faccia giovane e sorridente. Il riferimento rispetto a cui 13 è una cima e 5 una valle è il paesaggio stesso: contano i confronti fra punti, non i numeri presi da soli. E per sommare due paesaggi non serve misurarli: le palline sentono soltanto la pendenza della somma.
L’energia \(E_\theta(\mathbf{x})\) è una rete convoluzionale, e i campioni della fase negativa vengono da una discesa rumorosa
con passo e rumore scelti ciascuno per conto suo (\(\lambda = 10\), \(\sigma = 0{,}005\)), mentre la ricetta di Langevin li lega, \(\lambda = \epsilon/2\) e \(\sigma = \sqrt{\epsilon}\). Così tarata la catena è una discesa con un filo di rumore, fermata dopo qualche decina di passi, e non campiona \(p_\theta\). A tenerla stabile servono una normalizzazione spettrale su ogni strato e una penalità \(L^2\) sulla grandezza delle energie, senza le quali la catena diverge. Le catene ripartono per il 95% da un serbatoio di campioni passati e per il 5% da rumore uniforme [DM19]: è la persistent contrastive divergence [Tie08] con un serbatoio al posto della singola catena. Erik Nijkamp e colleghi prendono la strada opposta, catene corte che ripartono sempre dal rumore, senza serbatoio, e trattano il generatore che ne esce come un oggetto a sé, lo short-run MCMC [NHZW19].
La composizione è un prodotto di esperti nel senso di Hinton [Hin02]: per \(K\) concetti con energie \(E_k\),
una densità alta solo dove tutti i fattori sono alti, cioè una congiunzione. La partizione del prodotto non è il prodotto delle partizioni dei fattori, ma né l’\(\arg\min\) né la dinamica di Langevin ne hanno bisogno: basta \(\nabla_{\mathbf{x}} E = \sum_k \nabla_{\mathbf{x}} E_k\).
Tutte queste cose, generare e completare e segnalare e mescolare, sono poi la stessa cosa: portarsi verso il basso. Non «nel punto più basso di tutti», che sarebbe la stessa risposta ogni volta: si scende con addosso il rumore, come nella prima delle tre vie, e ogni volta si finisce in una valle diversa. A cambiare, da un mestiere all’altro, è solo il vincolo con cui si scende.
Nel 2020 Will Grathwohl e colleghi prendono sul serio una lettura che la cornice di LeCun conteneva già, quella per cui un classificatore è un modello a energia, e ne ricavano una conseguenza: i punteggi che il classificatore dà alle classi definiscono anche una densità sulle immagini, e quella densità si può addestrare insieme al classificatore [GWJ+20].
Una rete che classifica immagini produce, per ogni immagine, un pugno di numeri: uno per classe, tanto più alto quanto più la rete crede in quella classe. Di solito la softmax ne fa percentuali che sommano a cento, esaltando il più alto: si legge la classe vincente e il resto si butta via.
Si butta via più di quel che sembra. Le percentuali guardano solo le differenze fra i punteggi, non quanto sono grandi: 8, 2, 1 e 9, 3, 2 danno le stesse percentuali (99,7%, 0,2%, 0,1%), perché sono gli stessi numeri spostati tutti in su di uno. Ma i secondi sono più forti dei primi, e quella forza si perde per strada.
Recuperarla costa poco: si prende il punteggio più alto e gli si aggiunge una correzione che dipende da quanto gli altri gli stanno vicino. Con 8, 2, 1 gli altri due sono lontanissimi e la correzione è quasi zero: viene 8,003, cioè il massimo tale e quale. Con 8, 7, 7 sono a un passo e la correzione conta: viene 8,55. Il conto si rifà con una calcolatrice scientifica: per ogni altro punteggio si prende \(e\) elevato alla sua distanza dal più alto, col segno meno, si sommano i risultati, si aggiunge 1 e se ne prende il logaritmo. Con 8, 2, 1 viene \(e^{-6} + e^{-7} \approx 0{,}003\), e il logaritmo di 1,003 è 0,003; con 8, 7, 7 viene \(e^{-1} + e^{-1} \approx 0{,}74\), e il logaritmo di 1,74 è 0,55. Tre voci che gridano insieme fanno più chiasso di una sola. Chiamiamolo «quanto forte grida questa immagine».
Perché dovrebbe dirci se l’immagine è tipica? La rete quei punteggi li ha imparati sulle immagini vere, e davanti a quelle grida forte; davanti a qualcosa che non ha mai visto, nessuna classe si accende e i punteggi restano fiacchi tutti quanti. Il grido finisce così per dire quanto l’immagine somiglia a ciò che la rete conosce, e non quale classe sia. Nessuno però gliel’aveva chiesto: l’addestramento guardava le differenze, e il volume è cresciuto da sé. E siccome nel nostro paesaggio le cose sensate stanno in basso, l’energia è quel grido con il segno cambiato: chi grida forte sta in fondo a una valle, chi non grida sta in cima.
Una cosa al grido non si può chiedere: che probabilità ha questa immagine di esistere. Confrontare due gridi funziona sempre; una probabilità vera vuole la pioggia raccolta da tutto il paesaggio, e se il paesaggio, allontanandosi, continua a scendere senza mai toccare un fondo, quella pioggia è infinita, e una percentuale di un totale infinito non vuol dire niente. Nessuno promette che il paesaggio di una rete qualunque non sia di questi.
Addestrando la stessa rete a fare bene tutte e due le cose (riconoscere la classe, e insieme dare energia bassa alle immagini plausibili) gli autori ottengono un classificatore che sbaglia con più prudenza: quando è incerto lo dice, riconosce le cose che non ha mai visto ed è più difficile da ingannare con immagini manipolate.
Il secondo mestiere si insegna facendo rotolare palline giù per il paesaggio, come nella via del campionamento, e quelle ogni tanto scappano in regioni dove il paesaggio non ha ancora forma: chiedere le due cose insieme rende l’addestramento fragile. È il difetto di famiglia dei modelli a energia, non di questo in particolare.
Sia \(f_\theta(\mathbf{x}) \in \mathbb{R}^K\) il vettore dei logit di un classificatore a \(K\) classi. La lettura usuale è \(p_\theta(y \mid \mathbf{x}) = \operatorname{softmax}(f_\theta(\mathbf{x}))_y\). Grathwohl e colleghi osservano che gli stessi logit definiscono anche una densità congiunta, se si pone \(E_\theta(\mathbf{x}, y) = -f_\theta(\mathbf{x})[y]\):
dove \(\operatorname{logsumexp}_y f[y] = \log \sum_y e^{f[y]}\) è il massimo «ammorbidito» dei logit (vale sempre almeno quanto il più grande, e un po’ di più quando anche gli altri gli stanno vicino), da cui l’energia marginale \(E_\theta(\mathbf{x}) = -\operatorname{logsumexp}_y f_\theta(\mathbf{x})[y]\) [GWJ+20]. Se in un classificatore normale non la si vede mai, è questione di gradienti e non di assenza: la softmax è invariante alla traslazione dei logit, quindi la cross-entropy non vincola il loro livello assoluto, che resta libero di andare dove capita. L’informazione è lì (tanto che il logsumexp di una rete addestrata alla maniera solita si usa così com’è per riconoscere il fuori distribuzione, come mostrano Weitang Liu e colleghi nel 2020 [LWOL20]); semplicemente nessuno le ha mai chiesto di essere sensata. JEM (Joint Energy-based Model) gliela chiede, massimizzando la log-verosimiglianza congiunta nella forma \(\log p_\theta(\mathbf{x}, y) = \log p_\theta(y \mid \mathbf{x}) + \log p_\theta(\mathbf{x})\): il primo termine è la solita cross-entropy cambiata di segno, il secondo è un EBM addestrato con Langevin e serbatoio, come in [DM19]. Resta una riserva sulla funzione di partizione: quel \(Z(\theta)\) esiste solo se \(\int \sum_y e^{f_\theta(\mathbf{x})[y]}\, d\mathbf{x}\) converge, che per una rete convoluzionale qualunque nessuno garantisce. La lettura «un classificatore è un’energia» è sempre vera; la densità che ne segue, sotto condizione. Il risultato riportato è un classificatore con calibrazione migliore, rilevamento di fuori distribuzione più affidabile e maggiore robustezza agli attacchi avversari, al prezzo di un addestramento più fragile, che è il difetto ereditario di tutta la famiglia.
I due ritorni non dichiarati#
Il primo lo abbiamo già incontrato nella sezione sulla funzione di partizione, ed è il ponte più solido del capitolo: i modelli di diffusione sono modelli a energia che hanno smesso di dirlo. Il compito con cui si addestrano è quello della seconda delle tre vie, quella che rinuncia alle probabilità e impara soltanto la pendenza: «indovina il rumore che ti ho aggiunto» [Vin11]. Quello che imparano, però, è la pendenza di una successione di paesaggi, uno per livello di rumore, e generare è una discesa rumorosa che li attraversa in fila, parente stretta della dinamica di Langevin [SSDK+21].
Un modello di diffusione parte da un’immagine di puro rumore e attraversa mille gradi di sporco decrescente. A ogni grado corrisponde un paesaggio diverso: quando l’immagine è ancora tutta rumore il paesaggio è liscio, con poche valli larghe in cui è difficile sbagliare direzione; scendendo di grado diventa più dettagliato, con valli più strette, quelle che distinguono un volto dall’altro.
A ogni passo si fanno le tre mosse del capitolo sulla diffusione. Si cancella una scheggia del disturbo, quella che la rete indica, ed è la discesa lungo la pendenza del paesaggio di quel grado. Si moltiplica tutta l’immagine per un numero appena sopra uno, perché all’andata, mentre la si sporcava, la si rimpiccioliva un poco a ogni passo, e al ritorno va riportata alla sua taglia; la mossa ingrandisce insieme il disegno e lo sporco che lo copre. E si getta sopra una manciata di rumore appena sorteggiato, che è la scossa. La manciata è molto più grande della scheggia, eppure lo sporco cala: la scheggia punta sempre dalla parte giusta, mentre le manciate, sorteggiate ogni volta in una direzione diversa, a lungo andare si disfano fra loro. Nessuno toglie un velo alla volta.
È la pallina della ricetta di Langevin, spinta a valle e scossa insieme, con una differenza sola: il paesaggio sotto di lei cambia a ogni passo, dal più liscio al più dettagliato. Ed è il rimedio al guaio della prima via. In un paesaggio dettagliato, con valli strette e creste alte, una pallina resterebbe prigioniera vicino a dove è caduta, per quanto la si scuota; partendo da quello liscio arriva prima nella regione giusta, dove le valli sono larghe e si passa dall’una all’altra, e solo dopo nei particolari.
Un passo del campionatore di DDPM, con \(\bar\alpha_t = \prod_{s \le t} \alpha_s\) e la notazione del capitolo sulla diffusione (che chiama \(\beta_t\) la quantità \(1 - \alpha_t\); qui la lettera \(\beta\) resta alla temperatura inversa delle reti di Hopfield), è
La rete predice il rumore, e \(\boldsymbol{\varepsilon}_\theta / \sqrt{1 - \bar\alpha_t}\) approssima \(-\nabla_{\mathbf{x}} \log q_t\), cioè \(+\nabla_{\mathbf{x}} E_t\) per l’energia \(E_t = -\log q_t\) della densità dei dati al livello di rumore \(t\). Sostituendo,
una discesa sull’energia del livello \(t\) con passo \(1 - \alpha_t\), una riscalatura per \(1/\sqrt{\alpha_t} > 1\) che inverte l’attenuazione dell’andata e ingrandisce segnale e disturbo insieme, e rumore gaussiano fresco. È un passo di tipo Langevin in cui l’energia cambia a ogni passo, dalla più liscia (\(t = T\)) alla più dettagliata (\(t = 1\)), e il rumore iniettato supera la correzione di parecchie volte per quasi tutto il percorso, come il capitolo sulla diffusione misura. Percorrere una scala di livelli di rumore, con una dinamica di Langevin per livello, è la proposta di Song ed Ermon [SE19]: una ricottura in cui a scendere è il rumore invece della temperatura. Il motivo è quello della legge di Kramers: ai livelli alti le barriere fra le valli sono basse e la catena le scavalca in fretta, e quando il paesaggio si fa dettagliato la catena è già nella regione giusta.
Resta la differenza con un modello a energia dichiarato, già raccontata con le quattro frecce in tondo: un modello di diffusione impara le frecce e non l’altezza, e che siano la pendenza di un paesaggio vero nessuno lo garantisce.
Il secondo ritorno è più sorprendente, e chiude un cerchio con il capitolo sui Transformer, cioè con l’architettura su cui sono costruiti i modelli di linguaggio. Le reti di Hopfield di oggi non sono quelle del 1982: i neuroni non sono più soltanto accesi o spenti, e la formula dell’energia è stata riscritta in tre tappe, da Dmitry Krotov e dallo stesso Hopfield nel 2016 [KH16], da Mete Demircigil e colleghi l’anno dopo [DHLowe+17] e da Hubert Ramsauer e colleghi nel 2021 [RSchaflL+21]. L’ultima tappa porta a una scoperta: il conto con cui una di queste memorie richiama un ricordo è, a tre condizioni, lo stesso con cui un Transformer presta attenzione. L’articolo si intitola Hopfield Networks is All You Need, «le reti di Hopfield sono tutto ciò che serve», e cita il titolo di quello che nel 2017 ha introdotto i Transformer, Attention Is All You Need [VSP+17].
Nella rete del 1982 ogni ricordo abbassa il paesaggio in proporzione al quadrato di quanto somiglia allo stato della rete: un ricordo che somiglia il doppio scava quattro volte più a fondo. Mettendo al posto del quadrato una potenza più alta, le valli dei ricordi diventano più strette e ripide, si pestano meno i piedi, e nello stesso numero di neuroni ne stanno di più. Con il quadrato, raddoppiando i neuroni si raddoppiano i ricordi; con il cubo, raddoppiandoli, i ricordi diventano quattro volte tanti. Spingendo l’idea fino all’esponenziale, ogni due neuroni aggiunti i ricordi che la rete può tenere quasi raddoppiano, come gli interessi composti.
Portati i neuroni dall’acceso e spento a numeri qualsiasi, il richiamo diventa un gesto noto a chi ha letto il capitolo sui Transformer. Lo stato da cui si parte, la domanda fatta alla memoria, si confronta con tutti i ricordi in archivio, e ciascuno riceve un punteggio di somiglianza; la softmax trasforma i punteggi in pesi che sommano a uno, esaltando il più alto; e il nuovo stato è la media dei ricordi presi con quei pesi. È l’attenzione: la domanda è la query, i ricordi in archivio sono le key, e quello che si restituisce sono i value. Perché sia proprio l’attenzione servono tre condizioni: un solo passo, invece di continuare a scendere fino in fondo come farebbe una rete di Hopfield; la temperatura fissata al valore con cui i Transformer dividono i loro punteggi, la radice quadrata della lunghezza dei vettori; e un’ultima moltiplicazione che trasformi i ricordi grezzi, cioè le key, nei value.
La sorpresa arriva guardando con questa lente dentro un modello di linguaggio addestrato davvero. In ogni strato l’attenzione ha parecchie copie che lavorano in parallelo, le teste. Nei primi strati quasi nessuna testa richiama un ricordo solo: fa la media di moltissimi. Più avanti la media si stringe, a metà rete qualche testa arriva vicino a un ricordo singolo, e negli ultimi strati si torna a medie su gruppetti di ricordi. La discesa c’è sempre; il punto d’arrivo è un ricordo preciso solo quando i ricordi sono ben separati fra loro.
Con \(M\) ricordi \(\boldsymbol{\xi}^\mu\) nelle righe di \(\boldsymbol{\Xi} \in \mathbb{R}^{M \times d}\) e lo stato \(\mathbf{s}\), la famiglia si scrive con una funzione di interazione \(F\):
Con \(F(x) = x^2/(2N)\) e stati in \(\{-1, +1\}^N\) si ritrova la rete del 1982, nella forma di Hebb e a meno della costante \(M/2\); con \(F(x) = x^n\) la memoria densa di Krotov e Hopfield, la cui capienza cresce come \(N^{n-1}\) [KH16]; con \(F(x) = e^x\) quella di Demircigil e colleghi, che tiene \(M = e^{\alpha N}\) ricordi per ogni \(\alpha < \tfrac{1}{2}\ln 2\) [DHLowe+17]. Ramsauer e colleghi portano gli stati nei reali, prendono il logaritmo della somma esponenziale e aggiungono un termine quadratico che tiene lo stato limitato [RSchaflL+21]:
dove \(\beta\) è la temperatura inversa. L’aggiornamento è un passo della procedura concavo-convessa (CCCP): non fa mai salire \(E\) e converge a un punto stazionario; con i ricordi ben separati basta un passo, e la capienza cresce in modo esponenziale con \(d\). Un passo costa \(O(Md)\): la capienza è esponenziale nella dimensione, il tempo resta lineare nel numero di ricordi. Messi in riga gli stati come query \(\mathbf{Q}\), con \(\mathbf{K} = \boldsymbol{\Xi}\) e \(\beta = 1/\sqrt{d_k}\), un passo è \(\operatorname{softmax}(\mathbf{Q}\mathbf{K}^\top/\sqrt{d_k})\,\mathbf{K}\), e diventa la scaled dot-product attention \(\operatorname{softmax}(\mathbf{Q}\mathbf{K}^\top/\sqrt{d_k})\,\mathbf{V}\) quando una proiezione lineare porta i ricordi nei value. Sulle teste di BERT gli autori classificano i punti fissi: nei primi strati medie globali su moltissimi pattern, negli strati intermedi stati metastabili stretti, fino al quasi richiamo di un pattern solo, negli ultimi stati metastabili di ampiezza media.
Le quattro rinunce#
Chi ha seguito le conferenze di Yann LeCun degli ultimi anni (il keynote di AAAI del febbraio 2024, per esempio) conosce la sua diapositiva delle raccomandazioni: quattro cose da abbandonare, «almeno in parte, o da ridurre al minimo», sulla via di un’intelligenza artificiale di livello umano, ciascuna con la sua alternativa. L’argomento esteso sta nel documento di posizione del 2022 [LeC22]. Sono la mappa del programma di ricerca in cui i modelli a energia stanno, e tre delle quattro toccano cose già incontrate.

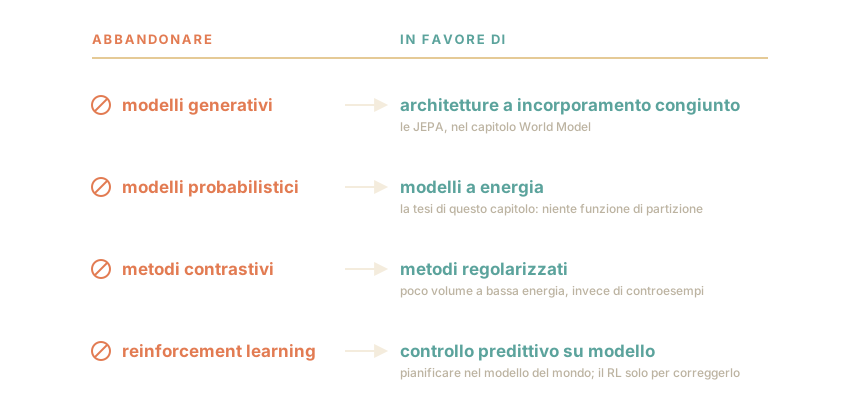
Fig. 29.5 Le quattro rinunce che ricorrono nelle conferenze di LeCun, ridisegnate. In parole: via i modelli che rifanno il dato pezzo per pezzo, meglio reti che si limitano a confrontare due riassunti; via le probabilità, meglio l’energia; via il mostrare al modello anche gli esempi sbagliati perché impari a respingerli, meglio costruirlo in modo che non possa dire di sì a tutto; via l’imparare per tentativi, meglio pianificare dentro un modello del mondo. L’argomento esteso è in A Path Towards Autonomous Machine Intelligence, il documento di posizione di LeCun del 2022; la riga sulle probabilità è la tesi dei modelli a energia.#
Le quattro righe di Fig. 29.5 non poggiano sulla stessa roccia. Quella sulle probabilità poggia su un conto, la funzione di partizione; quella sui metodi contrastivi su una scommessa su come si comportano in alta dimensione; quella sul reinforcement learning su un conto sui bit; quella sui modelli generativi su una previsione sul futuro della ricerca, ed è quella su cui si litiga di più. Conviene prenderle in quest’ordine, dalla più solida.
La riga sulle probabilità chiede di sostituire il modello probabilistico con l’energia, e l’argomento tecnico è il più solido dei quattro, con la sua condizione: per un’energia scelta senza vincoli sull’architettura, misurare il paesaggio intero, il conto che trasforma le altezze in probabilità, è fuori portata, e moltissimi compiti non l’hanno mai richiesto. Chi quel conto lo fa esatto esiste, e paga in vincoli sulla forma della rete: i modelli di linguaggio, autoregressivi, sono modelli probabilistici e funzionano benissimo.
La riga sui metodi contrastivi chiede di abbandonarli in favore di quelli regolarizzati, ed è la scelta discussa nella cornice di LeCun: mostrare al modello dei controesempi, oppure costruirlo in modo che non possa dire di sì a tutto. È una questione di ricerca aperta con risultati da entrambe le parti. L’apprendimento contrastivo ha prodotto sistemi che funzionano molto bene, e la scommessa di chi sta dall’altra parte è che non reggeranno il passaggio ai video, dove il numero di risposte possibili è tale che nessuna quantità di controesempi basterebbe a puntellarlo.
La riga sul reinforcement learning chiede di sostituirlo con il controllo predittivo basato su modello, cioè, nel lessico dei capitoli sull’apprendimento per rinforzo: invece di imparare per tentativi ed errori, costruirsi un modello di come va il mondo e pianificare dentro quello, ricorrendo ai tentativi soltanto per correggere il modello (o il giudice che dà il voto alle mosse) quando la previsione sbaglia.
Il perché di quella riga non sta nella diapositiva, e sta in un conto. Quando un sistema impara per tentativi, la correzione che riceve alla fine di un tentativo è una quantità sola: è andata bene oppure male. Quando impara guardando, la correzione è grande quanto il pezzo di mondo che stava provando a indovinare, e contata in bit può valere decine di migliaia di volte tanto. È l’argomento che LeCun riassume dicendo che l’apprendimento per rinforzo è la «ciliegina sulla torta» [LeC16], e il dibattito sul rinforzo lo misura per intero, quel conto compreso, insieme alle obiezioni dei suoi critici.
La riga sui modelli generativi è la più contestata. Rinunciare ai modelli generativi in favore delle architetture a incorporamento congiunto, cioè delle JEPA nominate in apertura di capitolo, quelle che confrontano due riassunti del mondo invece di ridisegnarlo, è una tesi sul modo giusto di costruire un modello del mondo. Non è un verdetto sulla generazione in quanto tale, e i fatti lo mostrano: mentre la diapositiva circolava, i modelli generativi hanno prodotto i generatori di immagini a diffusione e i modelli linguistici che hanno cambiato il dibattito pubblico.
L’argomento di LeCun ammette che quei sistemi funzionano. Sostiene che predire ogni pixel costringe la rete a spendere i suoi neuroni e il suo addestramento su dettagli che nessuno potrebbe indovinare, la forma esatta di una foglia mossa dal vento, e che per prevedere il mondo convenga prevedere non i pixel ma il riassunto che la rete se ne fa. È una previsione sul futuro della ricerca, e come tutte le previsioni va tenuta distinta dai risultati che abbiamo in mano. Il capitolo sui world model la prende sul serio proprio perché la tratta così: come una scommessa argomentata, con i suoi risultati e i suoi limiti, non come una profezia.
Da ricordare
Un paesaggio si può scavare anche su immagini vere, e allora un solo modello fa quattro mestieri: genera, completa un’immagine a cui manca un pezzo, segnala quello che è fuori posto e mescola concetti. Sono la stessa cosa: cercare il punto più basso, con vincoli diversi.
Un classificatore è già un modello a energia senza saperlo: dal più alto dei punteggi che dà alle classi, corretto un poco verso l’alto quando anche gli altri gli stanno vicino, si ottiene quanto quell’immagine è plausibile, non quale classe sia. Addestrarlo a fare bene anche questo lo rende più prudente: dice quando è incerto, riconosce le cose mai viste ed è più difficile da ingannare.
I modelli di diffusione sono modelli a energia che non lo dichiarano: imparano la pendenza di un paesaggio per ogni grado di sporco, e generare un’immagine è scendere, con addosso il rumore, lungo quella fila di paesaggi, dal più liscio (dove è difficile sbagliare direzione) al più dettagliato. Con la riserva delle quattro frecce in tondo: imparano le pendenze, e che siano le pendenze di un paesaggio vero nessuno lo garantisce.
Le reti di Hopfield di oggi tengono in memoria molti più ricordi di quelle del 1982, e il modo in cui li richiamano è, a tre condizioni, l’attenzione dei Transformer: la domanda che si fa alla memoria è la stessa cosa che nell’attenzione decide a quali parole guardare. Con una sorpresa: guardando con questa lente dentro un modello di linguaggio vero, nei primi strati quasi nessuna testa richiama un ricordo solo, ne fa la media di moltissimi; più avanti la media si stringe, e solo a metà rete qualcuna arriva vicino a un ricordo singolo.
Le quattro rinunce di Yann LeCun: via i modelli che rifanno il dato pezzo per pezzo (meglio reti che si limitano a confrontare due riassunti, invece di ridisegnare ogni pixel), via le probabilità (meglio l’energia), via il mostrare al modello anche gli esempi sbagliati perché impari a respingerli (meglio costruirlo in modo che non possa dire di sì a tutto, come stringere la porta invece di istruire il buttafuori), via l’imparare per tentativi (meglio pianificare dentro un modello del mondo). Quella sulle probabilità è la tesi dei modelli a energia, e vale per un paesaggio disegnato senza vincoli; quella sui modelli generativi resta una scommessa, e il capitolo sui modelli del mondo la discute per quello che è.
Da ricordare
Gli EBM sulle immagini [DM19, XLZW16] addestrano una rete come \(E_\theta\) con campioni negativi da una discesa rumorosa parente di Langevin (rumore tarato a parte, catene corte) e un serbatoio persistente: un solo modello genera, completa, rileva anomalie e compone concetti, perché sommare energie è moltiplicare densità (un prodotto di esperti).
JEM [GWJ+20]: i logit di un classificatore definiscono anche una densità sugli ingressi, con \(E_\theta(\mathbf{x}) = -\operatorname{logsumexp}_y f_\theta(\mathbf{x})[y]\) (che esiste se l’integrale di \(e^{-E_\theta}\) converge). Addestrarla insieme al classificatore migliora calibrazione, rilevamento del fuori distribuzione e robustezza, al prezzo di un addestramento fragile.
I modelli di diffusione sono modelli a energia che non lo dichiarano: loss di denoising score matching (riponderata per livello di rumore), campo dello score \(-\nabla_{\mathbf{x}} E_t(\mathbf{x})\) a ogni livello \(t\), campionamento parente di Langevin lungo la successione di paesaggi, dal più liscio al più dettagliato. Con la riserva detta nella sezione sulla partizione: imparano le frecce, e che siano la pendenza di una superficie vera nessuno lo garantisce.
Le Hopfield moderne sostituiscono il quadrato della sovrapposizione con una potenza \(x^n\), capienza \(\propto N^{n-1}\) [KH16], o con un esponenziale, capienza esponenziale [DHLowe+17]. Agli stati continui la regola di aggiornamento è la scaled dot-product attention [RSchaflL+21] a tre condizioni: \(\beta = 1/\sqrt{d_k}\) (la temperatura è il divisore \(\sqrt{d_k}\) dell’attenzione, e \(\beta\) il suo inverso), un solo passo di aggiornamento e una proiezione dei pattern sui value. Sulle teste vere il punto fisso è raramente un ricordo singolo: nei primi strati è una media su moltissimi pattern, negli strati intermedi compaiono stati metastabili stretti, fino al quasi-richiamo di un ricordo solo, e negli ultimi prevalgono stati metastabili di ampiezza media.
Le quattro rinunce delle conferenze di LeCun, argomentate in [LeC22]: generativo → incorporamento congiunto, probabilistico → energia, contrastivo → regolarizzato, RL → controllo predittivo. Quella sulle probabilità è la tesi dei modelli a energia, ed è solida per un’energia senza vincoli sull’architettura; quella sul generativo resta una scommessa, e il capitolo sui world model la discute per quello che è.
L’energia, più che un modello, è una lente, ed è come lente che conviene tenerla: un punteggio di compatibilità fra due cose, basso quando stanno bene insieme, e nessun obbligo di trasformarlo in una probabilità. Resta aperta la domanda che questi modelli hanno incontrato a ogni passo: che cosa tiene alto il resto del paesaggio, cioè dove si trovano i controesempi, e che cosa impedisce al modello di dire sì a tutto. Il capitolo sull’auto-supervisione riparte da lì, dal segnale di addestramento che si ricava dai dati quando nessuno ha etichettato niente, e dedica una sezione intera al collasso, la risposta sbagliata più comoda.