


Conclusioni#
Siamo partiti, nell’introduzione, da una frase di Joseph Weizenbaum: «si dice che spiegare sia dissolvere l’incanto» [Wei66]. Voleva dire che quando capisci come è fatto un trucco, il trucco smette di essere magia. Adesso possiamo dire com’è andata. Sono passati trentotto capitoli, dall’algebra lineare alle reti che generano immagini, dagli alberi di decisione agli agenti che usano strumenti, dal codice che fa correre una scheda grafica alle domande su chi risponde quando un modello sbaglia. Dei meccanismi non è rimasto quasi niente di prodigioso: guardati da vicino, sono conti.
Ma adesso abbiamo qualcosa che all’inizio non avevamo: gli strumenti per capire come queste macchine funzionano davvero, e per distinguere ciò che sanno fare da ciò che sembrano fare, cioè una valutazione fatta su esempi che il modello non ha mai visto e qualche modo di guardargli dentro. Voltiamoci a guardare la strada percorsa, perché da qui si vede un disegno che i singoli capitoli, da vicino, non lasciavano intravedere.
Il percorso, guardato dall’alto#
Ripercorso per domande, e non capitolo per capitolo, il cammino è cominciato dai mattoni: vettori, matrici, derivate, probabilità. Non erano un rito d’iniziazione, ma il vocabolario di tutto il resto. Un neurone calcola un prodotto scalare fra ingressi e pesi, lo stesso conto dello scontrino alla cassa, ci somma un termine fisso, il bias, e passa il risultato per una funzione non lineare: \(g(\mathbf{w}^\top\mathbf{x}+b)\). L’apprendimento è una discesa del gradiente: a ogni passo i parametri si spostano nella direzione opposta al gradiente della perdita, quella in cui l’errore scende più in fretta. E un modello probabilistico non risponde con un valore solo, ma con una distribuzione: un elenco di risposte possibili, ciascuna con la probabilità che il modello le assegna.
Da lì il machine learning classico ci ha insegnato la disciplina che regge tutto il resto: tenere separati i dati su cui si impara da quelli su cui si misura, tenere d’occhio l’overfitting (imparare a memoria gli esempi visti, e restare poi senza risposta davanti a uno nuovo), misurare con onestà. La separazione vale identica per un modello con dieci parametri (le manopole che l’addestramento regola) e per uno con mille miliardi. Il modo in cui l’overfitting si presenta, invece, cambia: nei modelli molto grandi la curva a U dell’errore lascia il posto alla doppia discesa. Perché un modello capace di imparare a memoria qualunque cosa vada bene lo stesso su esempi nuovi è la domanda su cui si chiude la teoria dell’apprendimento, e una risposta completa ancora non c’è.
Poi le reti neurali, che hanno cambiato la scala e ci hanno costretti a guardare anche sotto il cofano. Con PyTorch abbiamo impilato strati e scritto a mano il ciclo di addestramento (il training loop); studiando la GPU abbiamo visto perché una moltiplicazione di matrici è veloce solo se i numeri arrivano dalla memoria abbastanza in fretta da tenere occupato il processore. Le reti convoluzionali hanno insegnato alle macchine a vedere, e lo spartiacque è AlexNet, che nel 2012 vince la gara di riconoscimento di immagini ImageNet staccando di quasi undici punti il miglior metodo costruito a mano, cioè con i dettagli da guardare scelti da un esperto invece che imparati.
Le reti che leggono un testo una parola dopo l’altra, e dopo di loro i Transformer, che per capire una parola la confrontano con tutte le altre, hanno insegnato alle macchine a leggere e a scrivere [VSP+17]; e poi a tenere insieme visione e linguaggio nello stesso modello, imparando quasi tutto con l’auto-supervisione, cioè da etichette che nessuno scrive perché stanno già dentro i dati. La stessa matematica ha poi cambiato mestiere a seconda della forma dei dati: il suono, la voce, i grafi (nodi e archi), i sistemi che ti raccomandano cosa guardare, le serie temporali, le equazioni della fisica. E accanto alle architetture è cresciuto il mestiere di farle stare nei conti, l’efficienza: far entrare in una scheda sola, e in una bolletta sola, un modello che non ci starebbe.
Un’altra domanda è stata generare quello che non c’è (una foto di un gatto che non esiste), non più soltanto riconoscere quello che c’è (questa foto è un gatto). Sono i modelli generativi, che il libro percorre in cinque famiglie: i modelli latenti, che comprimono i dati in poche coordinate, le variabili latenti, e da lì li ricostruiscono; le GAN, dove un generatore e un discriminatore si addestrano uno contro l’altro, finché il primo produce esempi che il secondo non distingue più da quelli veri; la diffusione, che parte dal rumore e lo ripulisce un poco alla volta; la verosimiglianza esatta, che sa dire con un numero quanto è probabile ogni singolo esempio, e lo paga legando le mani all’architettura; e i modelli a energia, che nascono dalla fisica degli anni Ottanta, danno un’energia bassa alle configurazioni plausibili e alta alle altre, e sono il linguaggio in cui, a meno di un cambio di variabili, si riscrive anche l’addestramento della diffusione.
E accanto al generare, l’agire. La ricerca esplora i futuri possibili dentro regole che conosce; il reinforcement learning impara agendo, senza che nessuno gli dica la risposta giusta per ogni mossa, e spesso senza conoscere nemmeno le regole del mondo in cui si muove. Le due strade si incontrano in AlphaGo: una ricerca ad albero che usa le regole del go, guidata da reti addestrate prima sulle partite di giocatori esperti e poi giocando contro sé stesse; nel marzo 2016 batte Lee Sedol per 4 a 1. Gli agenti di oggi portano la stessa domanda ai modelli di linguaggio: usano strumenti, si programmano a parole, a volte lavorano in molti; e i modelli del mondo provano a immaginare le conseguenze di un’azione prima di compierla.
Restano le architetture nate da un conto che non si regge: per capire un testo un Transformer confronta ogni parola con tutte le altre, e su un testo lungo quel confronto diventa proibitivo. Da lì l’attenzione lineare e i modelli a spazio di stati, che leggono il testo tenendo un riassunto di grandezza fissa invece di riconfrontare tutto con tutto.
Queste idee non sono nate nell’ordine in cui le hai incontrate. Alcune sono molto più vecchie del posto che occupano nel libro, e più vecchie delle reti che hanno reso famoso il deep learning. I modelli a energia nascono dalla fisica dei primi anni Ottanta; la matematica su cui poggia il reinforcement learning è degli anni Cinquanta; e l’idea di un modello del mondo, una piccola copia della realtà su cui provare le mosse prima di farle, qualcuno l’aveva scritta già nel 1943. Quello che è successo dopo il 2012 è che finalmente c’erano i dati e le macchine per far funzionare quelle idee, non che qualcuno le avesse inventate.
Altre invece sono giovanissime: le due reti che si sfidano sono del 2014, e gli agenti che usano strumenti si sono diffusi fra il 2023 e il 2024. Nel libro stanno fianco a fianco, come vicini di casa, mentre nella storia sono nonni e nipoti: l’ordine in cui le si legge segue le domande, non il calendario.
La cronologia va disaccoppiata dall’ordine dell’esposizione, perché il gruppo è tutt’altro che coetaneo. Alcuni pezzi risalgono a decenni fa: la rete di Hopfield è del 1982 [Hop82] e l’algoritmo di apprendimento della macchina di Boltzmann del 1985 [AHS85]; l’impalcatura del reinforcement learning Bellman comincia a pubblicarla nel 1952 e la raccoglie nel libro del 1957 [Bel57]; e i modelli del mondo risalgono al «modello in scala ridotta» della realtà di Craik, del 1943 [Cra43], e all’architettura Dyna di Sutton, che nel 1990 alternava passi vissuti e passi immaginati [Sut90]. Altri nascono a metà degli anni Dieci (le GAN nel 2014, la diffusione fra il 2015 e il 2020, AlphaGo nel 2016), e altri ancora prendono velocità dal 2020 in poi: l’attenzione lineare e i modelli a spazio di stati, gli agenti costruiti attorno a un modello di linguaggio, la nuova ondata dei modelli del mondo.
Nemmeno l’indice è cronologico: il reinforcement learning, per esempio, è una parte a sé, collocata prima del linguaggio e dei Transformer. L’indice segue le domande, la storia segue le date, e i due ordini non vanno confusi.
Infine i capitoli che non parlano di architetture ma di mestiere: portare un modello in produzione e tenerlo in vita (MLOps), aprirlo per capire perché ha deciso così (interpretabilità), rispondere delle sue conseguenze (AI responsabile): chi può scoprire che eri nei dati, chi lo inganna con una frase nascosta in una pagina web, quale numero gli abbiamo dato da far salire. Sono la parte del lavoro che decide se quello che hai costruito serve a qualcuno o fa danni, non appendici morali messe in fondo per buona educazione.
Argomenti diversissimi, e in mezzo settant’anni di storia: dal percettrone di Rosenblatt del 1958, il primo neurone artificiale che imparava dagli esempi, ai modelli di oggi. Eppure, sotto, tornano sempre le stesse tre idee.
Tre fili, un solo tessuto#
Se dovessimo comprimere l’intero libro in tre parole, sarebbero dati, rappresentazioni e ottimizzazione. Sono i fili che attraversano quasi ogni capitolo, dal più elementare al più avanzato (Fig. 39.1).

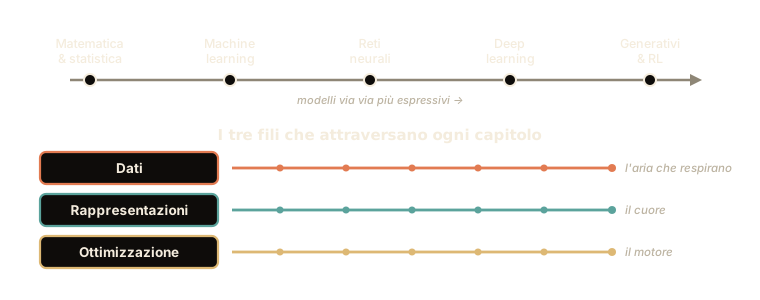
Fig. 39.1 I modelli cambiano da sinistra a destra, via via capaci di rappresentare cose più complicate, ma sotto di loro scorrono sempre gli stessi tre fili. I capitoli sul mestiere (produzione, interpretabilità, responsabilità) non stanno su questo asse: stanno attorno a tutto.#
I dati vengono prima di tutto: quasi tutto quello che un modello sa del mondo gli arriva dagli esempi su cui è addestrato, e il resto da ciò che il progettista ha scritto nella sua forma (la simmetria di una convoluzione, l’equazione di un PINN, le regole di un gioco). L’introduzione li ha paragonati all’ossigeno, e adesso che il percorso è finito quel paragone si può stringere. L’ossigeno è l’avanzo di una vita che non era la nostra, e noi siamo diventati quello che siamo imparando a respirarlo. Allo stesso modo i dati sono l’avanzo del nostro passaggio nel mondo digitale, e ogni famiglia di modelli del libro è costruita per respirarne una forma: le reti convoluzionali le immagini, i Transformer il testo, le reti su grafo le relazioni fra entità. Cambia il polmone, l’aria è sempre quella.
Ed è il filo che spiega perché il libro insista tanto su cose che sembrano noiose accanto alle architetture: come si dividono i dati, che cosa succede quando cambiano sotto i piedi, chi li ha lasciati e se era d’accordo. Un modello addestrato su dati storti impara la stortura, con tutta la precisione di cui è capace.
Le rappresentazioni apprese sono il cuore, cioè la parte che il deep learning ha cambiato più di ogni altra: le caratteristiche con cui un modello descrive un esempio non le sceglie più una persona, le trova l’addestramento, uno strato dopo l’altro.
Per decenni, per far riconoscere un gatto a un computer, un esperto doveva spiegargli a mano cosa guardare: i baffi, le orecchie a punta, la forma degli occhi. Il salto del deep learning è stato smettere di dettare quella lista. Diamo alla rete milioni di foto e la lasciamo scoprire da sola quali dettagli contano. Impara a vedere prima i bordi, poi le forme, poi interi oggetti: una gerarchia che nessuno le ha imposto. Questa capacità di costruirsi le proprie «lenti» per guardare i dati è ciò che chiamiamo rappresentazione appresa.
Le lenti mettono anche in ordine. Attraverso di esse, due foto di gatti finiscono vicine anche se una è in giardino e l’altra sul divano, e un camion finisce lontano da tutte e due. Le stesse lenti servono poi per un lavoro che non era il loro: distinguere le razze dei cani, senza ricominciare da capo.
L’esperto però non è uscito di scena, ha cambiato mestiere: non scrive più la lista dei dettagli, costruisce l’apparecchio in cui le lenti andranno montate, cioè la forma della rete, quanti strati ha e come sono collegati. È lui a decidere che lo stesso dettaglio si cerchi con la stessa lente in ogni punto della foto, e non solo dove stava negli esempi; o che una rete che legge un elenco di amicizie dia la stessa risposta in qualunque ordine gli amici siano elencati. Sono regole scritte nella forma della rete: valgono già prima che abbia visto un solo esempio, e qualunque lente impari dopo le rispetta. Sul bordo della foto la prima vale un po’ meno, perché lì una parte della lente cade fuori dall’immagine.
Una rete profonda è una funzione composta di \(L\) strati, \(f_\theta = f^{(L)} \circ \dots \circ f^{(1)}\), che trasforma l’input grezzo \(\mathbf{x}\) in una sequenza di rappresentazioni intermedie sempre più astratte. Gli strati nascosti non sono altro che feature apprese: coordinate in uno spazio latente dove esempi semanticamente simili finiscono vicini. È il principio degli embedding, e la ragione per cui una sola rete pre-addestrata si riadatta a molti compiti.
Il feature engineering manuale del machine learning classico non è sparito, ma va detto dove è finito, perché le destinazioni sono due e il libro le insegna in capitoli diversi. Una parte è stata assorbita dentro \(\theta\) e delegata all’ottimizzazione, ed è la parte che si racconta di solito. L’altra si è spostata nell’architettura, come bias induttivo. La convoluzione condivide i pesi fra le posizioni, e questo rende la mappa delle attivazioni equivariante alla traslazione: spostato il motivo, l’attivazione si sposta con lui. Equivariante e non invariante: l’invarianza, quando c’è, la porta la testa della rete con il pooling globale (sezione sulle reti convoluzionali). Un’aggregazione simmetrica fra i vicini rende una rete su grafo equivariante alla permutazione dei nodi, e invariante se la risposta riguarda il grafo intero. Sono proprietà della forma della funzione, vere per ogni valore di \(\theta\) e anche a rete non addestrata, ma con un perimetro diverso: la permutazione è rispettata esattamente, la traslazione solo lontano dal bordo, dove la cornice di zeri la rompe, e con un passo maggiore di uno solo per gli spostamenti multipli del passo. Non sono state imparate: le ha scritte a mano il progettista prima che l’ottimizzazione cominciasse.
E l’ottimizzazione è il motore che rende tutto questo possibile: apprendere significa, quasi sempre, cercare i parametri che minimizzano una funzione di perdita, cioè una misura dell’errore.
Su un vecchio mixer audio regoli le manopole per far suonare bene una canzone. Giri un po’ una manopola, ascolti se è migliorato, correggi. Addestrare un modello è la stessa cosa, con milioni di manopole: a ogni passo il modello guarda quanto ha sbagliato e sposta ciascuna manopola nella direzione che riduce l’errore, un pochino. Spesso al conto dell’errore si aggiunge una piccola multa per le manopole girate troppo, che tiene la regolazione sobria. Ripetuto abbastanza volte, funziona.
Con un mixer vero la direzione giusta la scopri provando, e con milioni di manopole non finiresti mai. Il modello non prova: la calcola. Per ogni manopola si chiede «se la giro di un pelo in su, l’errore sale o scende, e di quanto?», e ottiene tutte le risposte insieme con un conto solo, invece che con milioni di tentativi. Quel conto è il gradiente, e il modo di ottenerlo in una passata sola è la retropropagazione, che sta nel capitolo sulle reti neurali. Senza, niente di tutto questo sarebbe possibile.
Il modello si ferma quando nessun piccolo giro migliora più le cose, e quel punto non è per forza il suono più bello che il mixer sappia fare: con le manopole messe in tutt’altro modo potrebbe uscire qualcosa di meglio, e per arrivarci bisognerebbe prima peggiorare. Con milioni di manopole, però, il guaio vero è un altro: le hai regolate ascoltando una canzone, ma quello che ti interessa è come suoneranno le prossime. Per questo spesso ci si ferma prima, appena una canzone di prova, tenuta da parte, comincia a suonare peggio.
E non tutti imparano al mixer. Ci sono modelli che lavorano in coppia, uno che inventa e uno che smaschera, e quello che cercano è un equilibrio fra i due invece di un errore sempre più basso. Ce ne sono che gli esempi devono andarseli a prendere agendo, e allora il materiale su cui si esercitano cambia mentre imparano. Quasi tutti cercano il meglio secondo una misura: cambia la misura, non la ricerca. Qualche metodo, però, una misura da migliorare non ce l’ha affatto: mette insieme i dati che si somigliano seguendo una regola fissa, un passo dopo l’altro, e guarda che cosa ne esce.
La forma che copre il grosso del libro è la minimizzazione del rischio empirico su un campione etichettato:
dove \(\theta\) sono i parametri, \(\mathcal{L}\) la perdita media sull’insieme, \(\ell\) la perdita sul singolo esempio, \(f_\theta\) il modello, e \(\mathbf{x}^{(i)}\), \(y^{(i)}\) l’input e il target dell’\(i\)-esimo degli \(m\) esempi di addestramento, con la convenzione fissata nella sezione sull’apprendimento supervisionato. Due avvertenze sulla scrittura, prima di usarla. A quella media si aggiunge spesso un termine di regolarizzazione \(\lambda R(\theta)\), come il weight decay o le penalità della ridge e del lasso, che sposta il minimo senza cambiare la natura del problema. E «etichettato» va inteso in senso largo: nel pre-addestramento auto-supervisionato l’etichetta esiste, solo che non la scrive nessuno, ed è il token successivo in un modello autoregressivo, il pezzo nascosto in un modello mascherato, l’altra vista dello stesso esempio in uno contrastivo.
Cambia \(f_\theta\) e, per i modelli differenziabili (dalla regressione lineare al Transformer), la macchina che ci si avvicina è la discesa del gradiente stocastica. Su una rete profonda la perdita non è convessa, e sotto ipotesi precise sul passo e sulla regolarità di \(\mathcal{L}\) la discesa si avvicina a un punto stazionario, che non è detto sia un minimo e tanto meno quello globale (sezione su analisi e ottimizzazione); in pratica l’addestramento si interrompe prima, per budget o quando l’errore di validazione smette di scendere. Per una rete sovraparametrizzata, poi, i parametri che azzerano o quasi la perdita di addestramento abbondano (la rete impara perfino etichette tirate a sorte), e la domanda pratica diventa quale di loro generalizzi, che è la questione aperta della sezione sulle garanzie e le reti.
Il perimetro di quella scrittura, però, va dichiarato, perché è più stretto del libro, e le eccezioni sono istruttive. Le GAN non ci stanno: l’ottimizzazione simultanea di un gioco minimax non equivale a minimizzare una singola funzione, ed è una delle cause della loro instabilità, accanto ai gradienti che si spengono quando il discriminatore diventa troppo accurato. Sfugge anche il reinforcement learning: la distribuzione dei dati dipende dalla politica che si sta cercando e l’obiettivo è massimizzare un ritorno atteso; perfino nella variante offline, dove un campione fisso di traiettorie esiste, l’obiettivo resta un ritorno e non una media su coppie. Ne restano fuori i modelli a energia: la verosimiglianza che vorrebbero massimizzare contiene una funzione di partizione che non si sa calcolare, e si ripiega su surrogati come lo score matching. E nemmeno sul versante classico la copertura è totale: \(k\)-means almeno un obiettivo ce l’ha, l’inerzia, che l’algoritmo di Lloyd però minimizza solo localmente; DBSCAN è una procedura sulla densità e il clustering gerarchico una fusione greedy, e nessuno dei due è il minimo di un obiettivo globale; anche un albero di decisione cresce con split localmente ottimi, non minimizzando una funzione sull’albero finito.
Resta vero che sono quasi tutti problemi di ottimizzazione, ed è questo che tiene insieme il libro. Da una famiglia all’altra cambia la natura dell’obiettivo: una somma su un campione, un equilibrio fra due giocatori, un ritorno atteso lungo traiettorie che il modello stesso genera, una verosimiglianza inaccessibile. Per DBSCAN, il clustering gerarchico e gli alberi cambia anche se un obiettivo ci sia. Tre idee, infinite architetture.
Dove sta andando#
Per capire dove va un campo, la domanda utile non è quale modello sia il più bravo adesso: quella risposta scade in pochi mesi. La domanda utile è che cosa succede quando si dà a un modello più risorse.
Tre grafici rispondono proprio a quella: quanto migliora un modello se gli diamo più potenza di calcolo, più dati o più parametri? Ogni retta mostra l’errore che il modello commette (la loss: più è bassa, meglio è) al crescere di una delle tre, con le altre due abbastanza abbondanti da non fare da freno. E in nessuno dei tre la retta si piega verso l’orizzontale: non c’è, cioè, un punto oltre il quale aggiungere risorse smette di servire. Quella piega ha un nome, il «ginocchio», e in questi grafici non compare.

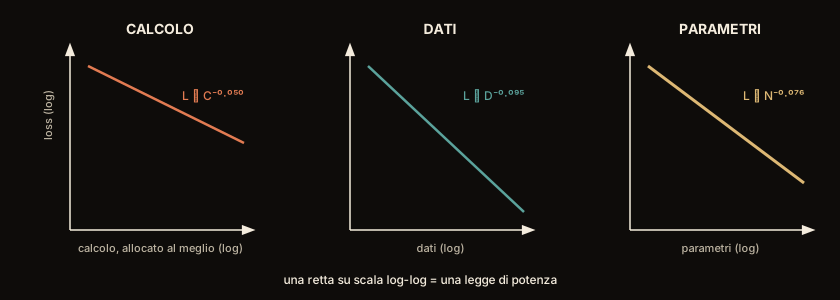
Fig. 39.2 Tre risorse, tre rette. Gli assi sono in scala logaritmica: un passo lungo l’asse non aggiunge una quantità, la moltiplica per dieci. Una retta che scende vuol dire quindi che per guadagnare ancora un poco bisogna moltiplicare la risorsa, non aggiungerne un pezzetto. Il numero accanto a ogni retta è l’esponente della sua legge di potenza, e dice quanto si accorcia la loss quando la risorsa si moltiplica per dieci: si fa dieci elevato a quel numero. Per il calcolo viene \(10^{-0{,}050} \approx 0{,}89\), cioè la loss scende a poco meno di nove decimi di quanto era; per i dati a 0,80, quattro quinti; per i parametri a 0,84, poco più di cinque sesti. La retta più ripida è quella dei dati, ma le tre non si confrontano come prezzi: moltiplicare per dieci i dati di un modello che resta della stessa taglia non dà quel guadagno. Schema ridisegnato sugli esponenti misurati da Kaplan e colleghi nel 2020; nel primo pannello il calcolo è quello «allocato al meglio», cioè speso, per ogni budget, con la taglia di modello e la durata di addestramento che rendono di più.#
L’assenza di un ginocchio in Fig. 39.2 ha orientato gli anni che sono seguiti, e ha un limite: quelle rette raccontano soltanto il tratto che qualcuno ha davvero misurato. Che prima o poi la discesa debba fermarsi lo scrivono gli autori stessi di quelle misure: il linguaggio naturale ha un’entropia non nulla, cioè in un testo scritto da esseri umani c’è un tanto di imprevedibilità che nessun modello potrà mai togliere [KMH+20]. Sotto quella soglia la loss non scende, ed è il pavimento. A che altezza stia si può stimare, non misurare, e la stima cambia con il testo e con il modo in cui lo si spezza in token.
Quelle rette, poi, tacciono su due cose. I dati non sono infiniti: secondo una stima del 2022, rivista nel 2024, se le tendenze restano quelle i modelli verranno addestrati su raccolte grandi quanto tutto il testo umano pubblico fra il 2026 e il 2032 [VHS+24]. E le rette riguardano il solo pre-addestramento, mentre una parte del miglioramento più recente viene da un’altra risorsa, il calcolo speso al momento della risposta dai modelli che ragionano a lungo prima di rispondere (sezione su tendenze e limiti).
Nel 2021 un rapporto di Stanford dava un nome al modo di costruire i modelli che stava diventando la regola: foundation model, modello di fondazione [BHA+21]. Il modo conta oggi più che mai, ed è il nome a servire meno, perché quando quasi tutti i modelli si costruiscono così non distingue più niente; nel libro l’idea non ha nemmeno un capitolo suo, sta dentro quello sui Transformer, divisa fra addestrare un modello su tutto il testo del web e adattarlo poi a quello che deve fare.
Al posto delle profezie, i fronti su cui si lavora adesso: dire su che cosa si sta lavorando è un’affermazione molto più piccola che dire come andrà a finire, e si può controllare. Con un avvertimento, perché questa è la parte più deperibile del libro: è scritta al presente, e il presente a cui si riferisce è l’autunno del 2026. Trattala come una fotografia con una data sopra, non come una previsione.
Non si addestra più un modello nuovo per ogni problema. Se ne addestra uno solo, enorme, su una montagna di testo o immagini, e poi lo si adatta a mille compiti diversi con poco sforzo, o riaddestrandolo un altro po’ su qualche migliaio di esempi del compito nuovo, o semplicemente spiegandogli a parole che cosa vogliamo. Una base unica su cui si costruisce tutto, un po’ come una persona con una solida cultura generale che, con una breve formazione, impara mestieri molto diversi.
Le domande aperte, oggi, sono più concrete di quelle di una volta, quando ci si chiedeva ancora se una macchina potesse riconoscere un gatto in una foto: a quella si è risposto, a queste no. Sono quattro, e hanno una cosa in comune: in nessuna delle quattro basta fare più grande.
Quanto costa. Per capire un testo, un Transformer confronta fra loro tutte le sue parole, e quel confronto costa quanto il quadrato della lunghezza: raddoppia il testo e quel pezzo di conto si moltiplica per quattro. Su un testo corto è una spesa fra le tante, e lo resta più a lungo di quanto quel quadrato lasci temere: passa in testa a tutte le altre solo da qualche decina di migliaia di parole in su. Prima ancora si riempie la memoria della scheda grafica, dove il modello tiene un appunto per ogni parola già letta, e quello è un guaio diverso. C’è una gara in corso per pagare meno, ed è il mestiere del capitolo sull’efficienza e dei due sulle architetture nate apposta.
Se capisce o indovina. Un modello che risponde bene non è per forza un modello che ha capito. Certe scorciatoie si scoprono da fuori, cambiando la domanda e guardando che cosa cambia nella risposta: è così che si è visto un riconoscitore di lupi che in realtà guardava la neve sullo sfondo. Per le altre bisogna guardarci dentro, e non è facile: quello che ha imparato non sta scritto in chiaro da nessuna parte, è spalmato su miliardi di numeri, e un singolo pezzo di rete si accende per cose che fra loro non c’entrano niente. Chi ci prova da qualche anno ha letto dei pezzi, mai un modello grande intero.
Se ci si può fidare. Un agente lavora da solo per venti passi di fila, e ogni passo gli riesce 95 volte su 100. Quante volte gli riescono tutti e venti? Il conto si fa con la calcolatrice moltiplicando le probabilità, perché ogni passo aggiunge una condizione da soddisfare: 0,95 per venti volte fa 0,3585, appena 36 su 100. Quel conto però suppone che un solo inciampo rovini tutto e che i venti passi non si influenzino fra loro, e per un agente vero non vale nessuna delle due. Se l’agente si accorge dello sbaglio e torna indietro, va meglio. Se i passi si influenzano, può finire ovunque. Su cento prove ogni passo inciampa cinque volte, cento inciampi in tutto: se cadono sempre in prove diverse ne rovinano cento, una per una, e non ne finisce nessuna; se cadono tutti nelle stesse cinque, perché i passi sbagliano insieme per la stessa ragione, le altre novantacinque vanno lisce. Il 36 su 100 è quindi il caso di riferimento, non il peggiore; quello che non cambia mai è che ogni passo in più è una condizione in più, e per questo i compiti lunghi restano difficili.
Quanto consuma. Addestrare e far girare questi modelli costa corrente, acqua per raffreddare i calcolatori e chip che sanno fabbricare pochissime aziende al mondo. I centri di calcolo del mondo, non solo quelli dell’AI, usavano già nel 2024 una parte e mezza su cento di tutta l’elettricità, e una stima li vede più che raddoppiare entro il 2030. E sotto sotto la questione è politica prima che tecnica: chi può pagare tutto questo decide anche chi costruisce questi modelli, e dove.
E una scommessa, una sola: i modelli del mondo. Un modello normale impara che cosa viene di solito dopo che cosa; un modello del mondo prova a imparare le regole con cui una cosa ne fa succedere un’altra, e allora può immaginare come andrebbe a finire una mossa che non ha mai visto fare. Chi ci scommette di più pensa che i modelli di oggi, per quanto grandi, senza questo pezzo non arriveranno lontano; altri rispondono che un modello addestrato soltanto a indovinare la mossa dopo, una mappa del suo mondo, in parte se la costruisce già da solo.
I foundation model funzionano così: pre-addestramento auto-supervisionato su corpora enormi, poi adattamento via fine-tuning o prompting [BHA+21]. Le scaling laws hanno mostrato che la cross-entropy loss cala in modo prevedibile con parametri, dati e calcolo [KMH+20], e Hoffmann e colleghi ne hanno poi corretto la conclusione operativa sull’allocazione fra parametri e dati [HBM+22]. Il pavimento è una stima. Kaplan e colleghi, incrociando la legge del calcolo con quella dei dati, trovano un punto, a una loss di circa 1,7 nat per token, prima del quale le loro leggi devono rompersi; avvertono che quei valori sono molto incerti, e congetturano che quella loss sia una stima grezza dell’entropia per token del linguaggio naturale. L’adattamento di Hoffmann e colleghi dà un termine irriducibile \(E \approx 1{,}69\), la rianalisi di Besiroglu e colleghi \(E \approx 1{,}82\) [BEBY24] (sezione sulle leggi di scala). Sono numeri legati a un corpus e a un tokenizzatore, e non si trasferiscono da un testo all’altro. Che a una loss più bassa corrispondano capacità nuove è un’affermazione diversa, e più fragile: è la faccenda delle abilità emergenti, che la stessa sezione discute con il dubbio, motivato, che siano in buona parte un artefatto della metrica scelta. In ogni caso le leggi di scala non promettono che scalare basti a risolvere tutto, e i quattro fronti aperti sono, non per caso, quelli in cui scalare non basta.
L’efficienza dell’attenzione. Sui contesti lunghi il costo quadratico dell’attenzione diventa il vincolo economico dominante. «Sui contesti lunghi» è un’ipotesi con una soglia, e conviene calcolarla, perché la scrittura asintotica la fa sembrare più vicina di quanto sia. Detta \(n\) la lunghezza del contesto in token e \(d\) la dimensione del modello, per strato l’attenzione costa \(2n^2d\) moltiplicazioni: \(n^2 d\) per i punteggi \(\mathbf{Q}\mathbf{K}^\top\) e altrettante per combinare i valori. Tutto il resto ne costa \(12nd^2\): \(4nd^2\) per le quattro proiezioni (query, chiavi, valori, uscita), tutte \(d \times d\), e \(8nd^2\) per il feedforward, la cui dimensione interna è per convenzione \(4d\). I due termini si pareggiano dove \(2n^2d = 12nd^2\), cioè a \(n = 6d\); e in un decoder che elabora il contesto tutto insieme, dove la maschera causale rende inutile metà dei punteggi, la soglia raddoppia a \(n = 12d\), che è la regola scritta anche in [KMH+20]. Con un \(d\) di qualche migliaio siamo comunque a decine di migliaia di token, e sotto quella soglia il collo di bottiglia aritmetico sta altrove. Quello di memoria no. Con un’attenzione a teste piene la cache di chiavi e valori tiene \(2\,n_{\text{strati}}\,d\) numeri per token, cresce linearmente con \(n\) e si paga per ogni sequenza del batch: per un modello da sette miliardi di parametri a 16 bit è mezzo megabyte per token, e circa 2 GB per una finestra di 4.096 token (sezione sulla KV cache). Stringe molto prima, ed è un vincolo diverso che conviene non confondere con questo. Da qui l’attenzione lineare e i modelli a spazio di stati, che sostituiscono l’attenzione softmax con calcoli in forma ricorrente, il cui stato occupa una memoria costante nella lunghezza. Le architetture ibride alternano i due tipi di strato: il costo resta quadratico, perché qualche strato ad attenzione piena resta, ma la costante davanti è più piccola.
La comprensione del modello. Le spiegazioni locali perturbano l’ingresso e guardano che cosa si sposta nell’uscita, e da fuori trovano scorciatoie come quella del classificatore di husky e lupi che guardava la neve [RSG16]; ma descrivono il calcolo senza leggerlo. L’interpretabilità meccanicistica prova a leggere i circuiti dentro i pesi, ed è lo strumento più diretto per distinguere una risposta corretta da una risposta corretta per il motivo giusto, perché guarda dentro il modello invece di fermarsi al comportamento. È però un campo giovane: che le feature estratte facciano davvero una cosa sola resta un giudizio dato a campione, e nessuno ha ancora letto per intero un modello di grande scala (sezione su attribuzione e interpretabilità meccanicistica).
L’affidabilità degli agenti. Componendo più passi gli errori si accumulano: detta \(p\) la probabilità di sbagliare un singolo passo e \(T\) la lunghezza della traiettoria, se i passi sono indipendenti e ogni errore è fatale la probabilità di arrivare in fondo senza inciampi è \((1-p)^T\), che precipita. Le due ipotesi vanno dichiarate, perché nessuna delle due vale per un agente vero: i passi sono correlati, e riflessione e re-planning recuperano una parte degli errori. E attenzione a come si chiama quel numero, perché un caso peggiore non è. Con le probabilità di ogni singolo passo fissate, la correlazione può portare l’esito ovunque fra \(\max(0,\,1-Tp)\), se i fallimenti si escludono a vicenda, e \(1-p\), se cadono tutti insieme: con \(p = 0{,}05\) e \(T = 20\) è l’intervallo \([0;\ 0{,}95]\), e il valore indipendente \(0{,}3585\) sta comodamente in mezzo. L’indipendenza è il caso di riferimento, non il peggiore. Resta però la morale, e non basta essere bravi a un passo. Difficile è anche misurarlo: valutare un agente vuol dire giudicare una traiettoria e non una risposta, distinguendo il successo raggiunto per la strada giusta da quello arrivato per caso, e ripetere le prove, perché lo stesso tasso di successo per tentativo dà un pass@\(k\) quasi perfetto e un pass\(^k\) (tutti e \(k\) i tentativi riusciti) molto basso [YSRN24] (sezione su architetture e valutazione).
Il conto fisico. Energia, acqua, silicio e la concentrazione di tutto questo in pochi attori: un problema di politica industriale travestito da problema tecnico. L’Agenzia internazionale dell’energia stima per i centri dati del mondo, non solo per quelli dell’AI, circa 415 TWh nel 2024, l’1,5% dell’elettricità mondiale, e circa 945 TWh nel 2030 nello scenario di base [InternationalEAgency25]; è una previsione, e le cifre di questo campo sono quasi tutte stime (sezione su energia e impronta).
E una direzione che è più una scommessa che una tendenza, una sola e dichiarata come tale: i modelli del mondo, cioè imparare la dinamica dell’ambiente invece delle sole correlazioni nei dati. È la posizione di Yann LeCun, per cui i modelli di linguaggio autoregressivi, per quanto grandi, non basteranno [LeC22]. Il capitolo sui modelli del mondo la espone insieme a chi non è d’accordo, e alla domanda se un modello addestrato sul solo token successivo una rappresentazione del proprio mondo non se la costruisca già.
Il campo di casa#
Prima o poi la domanda arriva, di solito a cena: è più intelligente di noi?
Messa così non ha risposta, e non per prudenza: manca il dove. È come chiedere se un pesce si muove meglio di un uomo. In acqua vince lui senza sforzo; su un prato perde senza appello. Stessi due, risposta rovesciata.
Il posto dove queste macchine nuotano ha un nome preciso, ed è il mondo digitale. Lì tutto è già nella forma che serve a loro. Ogni cosa è già un numero, e non c’è da andare a misurarla. Ogni singola prova costa pochissimo e si può ripetere un miliardo di volte (è la somma di quel miliardo, semmai, a pesare sulla bolletta). In molti casi il giudizio non bisogna chiederlo a nessuno, perché sta già dentro il materiale: una partita finita dice chi ha vinto, un programma bocciato dai suoi test lo dice al primo lancio, e in una frase basta nascondere la parola che viene dopo e chiedere di indovinarla, che è il trucco visto nell’introduzione. Infine, sbagliare mentre si impara non rompe niente: si ricomincia. Gli scacchi, il go, il codice dei programmi e la previsione della parola dopo sono mondi fatti di quella sostanza, ed è lì che sono arrivati per primi i risultati che hanno fatto notizia. Non tutto il digitale lo è: se una risposta sia utile, o un’immagine riuscita, nel materiale non sta scritto, e a dirlo è ancora una persona, che è il lavoro del post-addestramento. Torna il discorso dell’aria: nel mondo digitale i dati abbondano, costano poco e spesso portano con sé il proprio giudizio, ed è lì che un polmone respira a pieno.
Non è una gara alla pari, è una partita in casa. E la cosa da portarsi via è che buona parte del vantaggio non viene dall’intelligenza, viene dal terreno.
Questa però è una lettura, e c’è chi ne dà un’altra. Chi parte dalle leggi di scala, dove le rette non si piegano, risponde che il terreno dice soltanto da dove si è cominciato, cioè dove era più facile misurare, e che una bravura cresciuta al chiuso, con abbastanza dati e calcolo, poi esce e serve anche all’aperto. Una parte della questione si misura già: i modelli che ragionano si addestrano col rinforzo proprio sul terreno di casa, su problemi di matematica e di codice dove la risposta si controlla in automatico, e se quell’addestramento insegni strade nuove o metta soltanto in ordine quelle che il modello già aveva è conteso. Due misure del 2025 rispondono in modo diverso a seconda di quanto, e su che cosa, si addestra (sezione sul dibattito attorno al rinforzo). Il resto non si stabilisce discutendone: si guarda che cosa succede quando la partita si sposta all’aperto.
Fuori, il conto si rovescia, ed è un’osservazione vecchia di decenni. Un computer ha battuto il campione del mondo di scacchi nel 1997; costruire il braccio che sposta i pezzi sulla scacchiera è rimasta la parte difficile. Nel 1988 Hans Moravec lo mise così: dare a un computer le prestazioni di un adulto in un test di intelligenza, o a dama, è relativamente facile; dargli le capacità di un bambino di un anno nel percepire e nel muoversi è difficile o impossibile [Mor88].
Moravec attribuiva la differenza ai tempi dell’evoluzione: nel vedere e nel muoverci abbiamo dietro un miliardo di anni di mestiere, mentre il pensiero astratto è un trucco recente, forse di meno di centomila anni. È un racconto che convince, ed è per questo che gira; ma la spiegazione è una cosa e l’osservazione un’altra, e secondo Arvind Narayanan, che nel gennaio 2026 ha provato a controllarla, nemmeno l’osservazione è mai stata messa alla prova: nessuno ha preso un campione di compiti, misurato quanto sono difficili per noi e per una macchina, e guardato se le due difficoltà vadano davvero insieme. Il guaio, nota, sta proprio nel campione. La ricerca si occupa dei compiti in cui la differenza fra noi e la macchina c’è, e lascia perdere quelli facili per tutti e due (quanto è luminosa una foto, come si gioca a tris) e quelli difficili per tutti e due; guardando solo quelli rimasti, il paradosso si vede per forza [Nar26].
Quando la differenza c’è, il terreno la spiega in modo più semplice, e un pezzo lo suggerisce lo stesso Narayanan: forse a deciderla è il verificatore. Negli scacchi un programma può giocare milioni di partite e sapere ogni volta, senza ambiguità, com’è finita; di un ragionamento giuridico nessuno può dire altrettanto. Dove il giudizio è già nel materiale si impara in fretta; dove bisogna andarselo a prendere nel mondo, no. Anche questa è un’ipotesi, ed è quella che il percorso fatto mette in mano.
Da qui viene la tentazione di rilassarsi, perché a noi resterebbe il mondo vero. È giusto a metà, e la metà che manca conta.
Il campo, intanto, si allarga. Ogni sensore, ogni telecamera, ogni pagamento tracciato prende un pezzo di mondo vero e lo trasforma in numeri, cioè lo porta dentro casa loro. È l’altra faccia di quello che l’introduzione chiamava scarto: ciò che lasciamo dietro è l’aria che respirano e anche il terreno su cui giocano. La robotica è il tentativo di portare la partita all’aperto, e lì il conto si vede a occhio nudo: una prova dura il tempo vero che ci vuole, il braccio si consuma, i sensori vedono il mondo con il loro rumore, e una caduta non si annulla premendo un tasto. Questa non è una previsione sulla robotica: dice soltanto perché lì ogni tentativo costa più che al chiuso, e che se un giorno costerà meno sarà perché uno di quei pezzi è cambiato. Una strada c’è già, ed è il simulatore: il robot impara in un mondo finto, dove le prove sono infinite e le cadute non rompono niente, e un robot a quattro zampe impara così a camminare in meno di venti minuti di addestramento [RHRH22]. Il costo allora si sposta nello scarto fra simulatore e mondo, il sim-to-real gap: attriti, ritardi dei motori e rumore dei sensori che il simulatore non riproduce mai del tutto (sezione sul controllo continuo).
E quello che resta nostro va detto con precisione. Un elenco di compiti si erode, uno alla volta, ogni volta che un pezzo di mondo diventa numeri e qualcun altro comincia a giocarci. Quello che non si erode è un mestiere, e ha due parti: rispondere di una scelta, e decidere quale partita giocare.
Rispondere, in italiano, vuol dire due cose: dare una risposta, e assumersene le conseguenze. Una macchina la prima la sa fare, e spesso bene; la seconda no. Non perché le manchi qualcosa di misterioso: quando una decisione fa un danno, davanti a chi l’ha subìto deve andarci qualcuno che possa scusarsi, risarcire e cambiare le regole, e quel qualcuno è sempre una persona o un’organizzazione fatta di persone. Vale anche per un’azienda, che di suo non ha faccia né braccia: la responsabilità non si trova, si assegna, e la si assegna a chi può portarla.
Decidere quale partita giocare è l’altra metà. A un sistema si dà un punteggio da far salire, e lui lo fa salire con una costanza che noi non abbiamo: se il punteggio è «quanti minuti resti a guardare», diventerà bravo a tenerti lì, e ci riuscirà. Se quello sia il numero giusto da far salire non lo decide l’ottimizzazione: il punteggio glielo dà qualcun altro, e quando è solo un sostituto di quello che si voleva davvero, spingerlo al massimo finisce per tradirlo. È la legge di Goodhart (sezione su allineamento e governance).
Sapere dove si sta giocando è anche il modo migliore per leggere la prossima notizia che ti capiterà sotto gli occhi. Prima di chiederti quanto sia brava, chiediti se giocava in casa.
Una nota onesta#
Sarebbe disonesto chiudere con il solo entusiasmo. Questi sistemi hanno limiti che, con le tecniche di oggi, non spariscono facendo il modello più grande: dipendono da come sono fatti, addestrati e messi alla prova. Un modello dà per veri fatti che non esistono, e si porta dietro i pregiudizi dei testi da cui ha imparato; nessuna delle due cose è una sorpresa, e tutte e due hanno le radici nel modo in cui viene addestrato e misurato.
Un modello linguistico non «sa» le cose: prevede la parola più probabile dopo le precedenti. Funziona perché nei testi da cui ha imparato, il più delle volte, le parole che seguono sono anche quelle giuste. Ma non sempre, e per questo a volte inventa con perfetta sicurezza fatti falsi: le chiamiamo allucinazioni. Ci si mette anche il modo in cui lo si interroga: molte delle prove con cui i modelli vengono messi a confronto danno zero punti a chi risponde «non lo so», esattamente come a chi sbaglia, e così premiano chi tira a indovinare. Le allucinazioni si riducono, facendogli cercare le fonti prima di rispondere o insegnandogli a dire quanto è sicuro, ma toglierle del tutto nessuno sa ancora come.
E siccome impara da testi scritti da noi, assorbe anche i nostri pregiudizi: se i dati riflettono discriminazioni, il modello le ripete e a volte le rafforza, perché puntare sempre sulla risposta più frequente fa sparire le eccezioni. I pregiudizi non si riparano tutti allo stesso modo. Se di qualcuno nei dati ci sono quattro fotografie invece di quattromila, altre fotografie rimettono le cose a posto. Se invece i dati ritraggono con precisione un mondo che quel qualcuno lo tiene fuori dalla porta, raccoglierne altri conferma soltanto quello che c’è: lì la cosa da cambiare è che cosa stiamo chiedendo al modello di indovinare. Lo stesso succede quando è la risposta giusta a essere storta, «è stato arrestato» scritto al posto di «ha commesso un reato»: finché non si trova un altro modo di misurare la cosa che interessa, mille esempi in più ripetono la stessa domanda sbagliata. Uno strumento potente non è uno strumento neutrale, e quello che ti dice lo verifichi tu.
Un modello linguistico è pre-addestrato a massimizzare la verosimiglianza del testo, non la verità: la fluidità di una frase non ne garantisce la correttezza, e la sicurezza con cui una risposta è formulata non è un indicatore affidabile della sua correttezza. Le allucinazioni sicure di sé hanno almeno due radici: l’obiettivo di pre-addestramento e una valutazione che nella maggior parte dei benchmark dà zero punti a un «non lo so» e premia così chi tira a indovinare [KNVZ25]. Si mitigano, con il recupero di fonti esterne e la calibrazione, ma eliminarle resta un problema aperto (sezione su tendenze e limiti).
I bias non sono un bug ma una conseguenza attesa: un modello addestrato su corpora enormi e non curati ne assorbe la visione dominante, la riproduce e può amplificarla [BGMMS21]. Conviene però non ridurli a una sola causa. In parte i dati sotto-rappresentano qualcuno, e allora raccoglierne altri aiuta. In parte, e peggio, i dati rappresentano fedelmente un mondo già iniquo: lì la regolarità che il modello apprende è la disuguaglianza, e nessuna quantità di dati aggiuntivi dello stesso tipo la corregge, perché il difetto sta in che cosa si chiede al modello di imparare. La sezione sull’equità e i bias distingue quattro sorgenti, scelte dal catalogo di Mehrabi e colleghi che ne elenca molte di più [MMS+21], perché richiedono rimedi diversi; e due di quelle quattro non si correggono raccogliendo altri dati dello stesso tipo. Sono il bias storico e il bias di misura, dove l’etichetta è un sostituto storto della grandezza che interessa e si corregge soltanto cambiando la grandezza misurata o modellandone la distorsione [FGSellC20].
A valle restano questioni aperte: impatto ambientale dell’addestramento, concentrazione di potere in pochi attori, effetti sul lavoro e sull’informazione. L’AI Act europeo [EuropeanPaCouncil24], in vigore dall’agosto 2024 ed emendato nel luglio 2026 [ParlamentoeeCdellUnioneeuropea26], ne tocca una parte: regola i sistemi in base al rischio del loro uso e i modelli di uso generale anche in base alla loro capacità (sezione su allineamento e governance). Il fact-check umano, per noi, non è opzionale.
Verificare, però, non è possibile a tutti allo stesso modo, e la domanda che si fa di rado è chi sia nella posizione di accorgersene. Dipende da come il modello viene messo a disposizione, e i modi sono due. Di alcuni modelli si possono scaricare i pesi, cioè i numeri che l’addestramento ha regolato, le manopole di prima: sono un file che chiunque può tenersi, e quindi misurarne i difetti, sondarlo, smentirlo. Altri si raggiungono solo attraverso un’interfaccia, cioè mandando domande al server di chi li possiede e ricevendo risposte: quelli si verificano solo con il permesso di quel qualcuno, e quel permesso può essere tolto. È una questione di chi può sapere cosa, non di mercato.
Quella distinzione, poi, non è una classifica di bravura (Fig. 39.3).

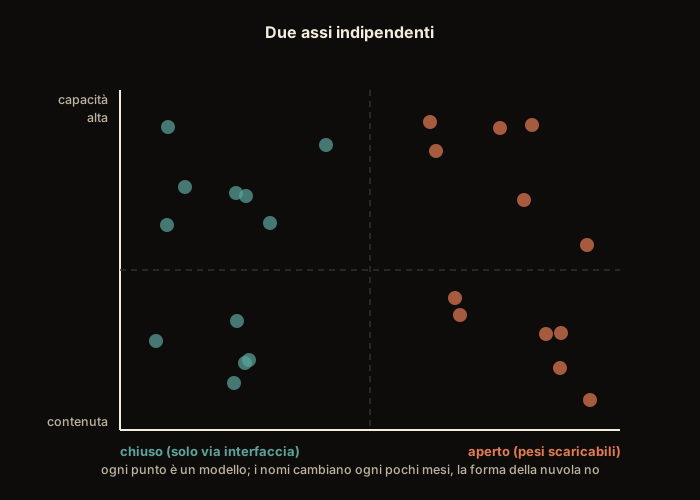
Fig. 39.3 Uno schema, senza dati: ogni punto è un modello. Due assi indipendenti: aperto non vuol dire debole e chiuso non vuol dire potente, e in tutti e quattro i quadranti c’è qualcuno. I punti non hanno un nome di proposito, perché i nomi cambiano ogni pochi mesi; e chi stia davanti sulla frontiera della capacità cambia anch’esso, e va controllato su una misura con una data.#
Come continuare a imparare#
Questo libro è una mappa, non il territorio. Per proseguire: leggi i paper originali, cioè gli articoli scientifici in cui ciascuna di queste idee è stata proposta per la prima volta. Quelli degli ultimi quindici anni stanno quasi tutti su arXiv, l’archivio pubblico e gratuito dove i ricercatori depositano i propri lavori. I più vecchi no: Weizenbaum, Rosenblatt, Hopfield sono su riviste, e in biblioteca. E quello che sta su arXiv non è tutto uguale: alcuni sono la versione definitiva di un articolo già passato da una revisione fra pari (il giudizio di altri ricercatori del campo, che la rivista o il congresso chiede prima di pubblicare), altri sono preprint che nessuno ha ancora letto oltre a chi li ha scritti, e da fuori i due si distinguono male. Vanno letti come va letto un modello: senza prendere per buono niente solo perché è scritto bene.
E soprattutto riproduci il codice, perché un modello lo capisci quando lo fai girare e lo rompi. Il metodo per farlo sta nella sezione su come si replica un paper del capitolo su PyTorch: quattro mosse, e i controlli che contano si fanno senza nemmeno addestrare.
Se è la prima volta e un paper ti sembra un altro pianeta, comincia da qui: apri il notebook di un capitolo con il pulsante «Esegui il codice», cambia un numero e guarda che cosa si rompe. È lo stesso mestiere, a un decimo della fatica, e insegna più di una lettura.
Tieni i classici a portata: Géron [Geron25] per la pratica, Chollet e Watson [CW25] per l’intuizione (la terza edizione si legge integralmente online), Goodfellow, Bengio e Courville [GBC16] per la teoria, la documentazione di scikit-learn e PyTorch come compagne quotidiane. Un’avvertenza sulle librerie. Il libro di Géron del 2025 lavora su scikit-learn e PyTorch, le stesse librerie di qui; quello che lo ha preceduto, ancora molto diffuso nella terza edizione del 2022 [Geron22], arrivato alle reti neurali passa a Keras su TensorFlow, un’altra coppia di librerie per le reti. Chollet e Watson scrivono in Keras 3, che fa girare lo stesso codice sopra motori diversi, e la terza edizione gli esempi li dà anche in PyTorch. Quello che insegnano non dipende dalla libreria, ma è meglio saperlo prima di aprirli.
E, capitolo per capitolo, questo libro ha già in bibliografia i manuali di riferimento, che sui rispettivi argomenti dicono molto più di un generalista: Sutton e Barto [SB18] per il reinforcement learning, Jurafsky e Martin [JM26] per il linguaggio e la voce, Szeliski [Sze22] per la visione, Hamilton [Ham20] per i grafi, Hyndman e Athanasopoulos [HA21] per le serie temporali, Huyen [Huy22] per la messa in produzione, Molnar [Mol22] per l’interpretabilità, Barocas, Hardt e Narayanan [BHN23] per l’equità. Diversi si leggono integralmente e gratuitamente online. Sono tutti in inglese, come quasi tutta la letteratura di questo campo: è una delle ragioni per cui questo libro esiste in italiano.
Poi mettiti alla prova. Kaggle è il sito dove chiunque può misurarsi su un problema di dati vero, con una classifica e il codice degli altri partecipanti sotto gli occhi. Partecipa a una competizione: è il modo più rapido per vedere la differenza fra un modello che gira sul tuo computer e un modello che regge dati che non hai scelto tu. Contribuisci a un progetto open source, cioè a un programma il cui codice è pubblico e chiunque può migliorarlo. E tieni un quaderno degli esperimenti falliti, che insegnano più dei successi.
E torna qui: questa versione del libro si aggiorna, e i capitoli nascono anche dalle segnalazioni di chi legge. Se un passaggio non ti torna, selezionalo e mandamelo: i pulsanti che compaiono servono esattamente a questo.
Da ricordare
Tutto il libro poggia su tre idee ricorrenti: i dati (da lì viene quasi tutto quello che un modello sa), le rappresentazioni apprese (le «lenti» che la rete si costruisce da sola, dentro una forma che l’esperto disegna ancora a mano) e l’ottimizzazione (le manopole del mixer, regolate un pochino alla volta).
Addestrare vuol dire quasi sempre la stessa cosa: misurare quanto il modello ha sbagliato e spostare ogni manopola nella direzione che riduce l’errore, finché nessun piccolo giro migliora più. Il punto dove ci si ferma non è per forza il migliore, e quello che conta davvero è come va su esempi nuovi. Qualche famiglia ci arriva per un’altra strada (due reti che si sfidano, oppure imparare agendo invece che da esempi già pronti), ma anche lì si tratta di migliorare qualcosa, un passo alla volta.
Le rette delle leggi di scala non si piegano nel tratto misurato, ma sotto c’è un pavimento, un tanto di imprevedibilità del linguaggio che nessun modello toglie, e la sua altezza si può solo stimare. E le «direzioni future» invecchiano in fretta: un modello solo, enorme e riadattato a mille compiti, pochi anni fa era una novità con un nome suo, oggi è la normalità.
I fronti davvero aperti sono quelli in cui fare più grande non basta: il costo dei testi lunghissimi, il capire perché un modello ha risposto così, la fiducia in un agente che lavora da solo per una ventina di passi (il 36 su 100 è il caso di riferimento, non il peggiore), e il conto di corrente, acqua e chip che tutto questo presenta a qualcuno.
Prima di chiederti quanto sia brava una macchina, chiediti se giocava in casa: nel mondo digitale tutto è già un numero, provare costa poco e spesso il giudizio sta nel materiale. Quello che resta nostro è rispondere delle scelte e decidere quale punteggio far salire.
Potenza e responsabilità crescono insieme: i fatti inventati con sicurezza e i pregiudizi ereditati dai dati dipendono da come i modelli sono fatti, addestrati e messi alla prova, e verificare quello che il modello dice non è opzionale.
Gli ultimi capitoli non parlano di architetture ma di mestiere: portare un modello in produzione, aprirlo per capire, rispondere delle sue conseguenze. È la parte che decide se quello che hai costruito serve o fa danni.
Da ricordare
Tutto il libro poggia su tre idee ricorrenti: dati, rappresentazioni apprese e ottimizzazione. Una parte del sapere non viene dai dati: il bias induttivo dell’architettura (equivarianza alla traslazione della convoluzione, lontano dal bordo; equivarianza alla permutazione di una rete su grafo) vale per ogni \(\theta\), anche a rete non addestrata.
L’apprendimento è, per il grosso del libro, la minimizzazione di un rischio empirico, \(\theta^\star = \arg\min_\theta \mathcal{L}(\theta)\), spesso con un termine di regolarizzazione; della discesa stocastica si garantisce al più che si avvicini a un punto stazionario, e per le reti sovraparametrizzate la domanda aperta è perché generalizzino. Le eccezioni sono istruttive e vanno tenute a mente: GAN (gioco minimax), reinforcement learning (dati che dipendono dalla politica) e modelli a energia (verosimiglianza intrattabile) restano problemi di ottimizzazione, con obiettivi di natura diversa.
Le leggi di scala del pre-addestramento non mostrano un ginocchio nel tratto misurato, e il pavimento si stima, non si misura (\(E \approx 1{,}69\) per Hoffmann, \(1{,}82\) per Besiroglu, su un corpus e un tokenizzatore precisi). E le «direzioni future» invecchiano in fretta: il foundation model è diventato così normale che il nome non distingue più niente.
I fronti davvero aperti sono quelli in cui scalare non basta: il costo dell’attenzione sui contesti lunghi (la soglia aritmetica è \(n = 6d\), o \(12d\) con la maschera causale, e la memoria della cache stringe prima), l’interpretabilità, l’affidabilità degli agenti (con \(p\) errore per passo e \(T\) passi, \((1-p)^T\) è il caso di riferimento sotto indipendenza, dentro \([\max(0,1-Tp);\ 1-p]\)) e il conto energetico e industriale.
Buona parte dei successi più visibili sta in ambienti dove osservazioni, costo per prova e giudizio sono già numerici; fuori da lì pesano il costo della prova e lo scarto fra simulatore e mondo. È una lettura, non un risultato. Quello che resta umano è rispondere di una scelta e scegliere l’obiettivo, che l’ottimizzazione da sola non sa giudicare.
Potenza e responsabilità crescono insieme: allucinazioni (obiettivo e valutazione) e bias (quattro sorgenti, due non correggibili con dati dello stesso tipo) dipendono da come i modelli sono fatti, addestrati e valutati, e il fact-check umano non è opzionale.
Gli ultimi capitoli non parlano di architetture ma di mestiere: produzione, interpretabilità, responsabilità. È la parte che decide se quello che hai costruito serve o fa danni.
Un ultimo messaggio#
Ho scelto di raccontare l’intelligenza artificiale in italiano, su due livelli, senza mai barare sulla difficoltà. Non perché l’inglese non basti, ma perché credo che capire davvero una cosa significhi poterla spiegare nella propria lingua: a un collega, a uno studente, a te stesso alle due di notte davanti a un errore che non torna.
Se c’è un’eredità che vorrei lasciarti, non è una libreria né un’architettura: quelle invecchiano in fretta. È un modo di stare davanti a questi strumenti: curiosità senza reverenza, entusiasmo senza fede, e quell’onestà intellettuale che fa dire «non lo so, verifichiamo» invece di «l’ha detto il modello». È la differenza fra chi ripete una formula e chi sa come funziona la cosa di cui parla, e nella Prefazione aveva la forma di un pappagallo.
E resterà vero quello che Weizenbaum aveva notato nello stesso paragrafo del 1966 da cui siamo partiti: quando il funzionamento di un programma viene spiegato in modo abbastanza chiaro «l’incanto si sgretola», e chi guarda lo sposta «dallo scaffale marcato intelligente a quello riservato alle curiosità». È successo con ELIZA, il programma che faceva lo psicoterapeuta rigirando a chi gli scriveva le sue stesse frasi, e succede ancora: è uno dei motivi per cui l’intelligenza artificiale non si lascia definire, perché ogni pezzo capito smette di sembrare intelligenza e diventa «solo» un algoritmo. Smettere di sembrare intelligenza, però, non è smettere di funzionare, e nemmeno di contare. Per te queste macchine non sono più una scatola nera: sai di che cosa sono fatte, dati, rappresentazioni, ottimizzazione. Quello che resta chiuso non è più la macchina ma quello che ha imparato, e adesso sai anche perché leggerlo sia un problema aperto. Il resto è pratica.
Buon lavoro, e in bocca al lupo.