


Context engineering: la finestra come sistema#
Se potessimo aprire una di quelle applicazioni che le aziende costruiscono attorno a un modello, e guardare che cosa gli arriva davvero a ogni richiesta, troveremmo che quasi nulla di quel testo è stato digitato da una persona sulla tastiera. C’è il system prompt, cioè le istruzioni di fondo che il programma antepone sempre, il messaggio system della sezione sul prompt engineering. Ci sono alcuni esempi già svolti, tenuti da parte in un archivio e ripescati perché somigliano al caso di adesso. C’è un pezzo di manuale, la pagina che serve a questa domanda e non le altre mille, andata a prendere in quel momento perché il manuale intero nella finestra non ci starebbe mai. C’è il riassunto degli scambi precedenti, perché il modello non ricorda nulla da solo. C’è il risultato dell’ultima operazione che il modello ha chiesto al programma di eseguire per lui: una ricerca sul web, un calcolo, una domanda a un archivio. E in fondo, ultima, la breve frase dell’utente.
Quella frase è la punta dell’iceberg; sotto c’è tutto il carico montato dal programma, il payload. Il nome che Karpathy ha appoggiato nel 2025, context engineering, è quello del mestiere di montarlo [Kar25a], e sposta l’oggetto del lavoro: non più la singola frase ma il governo dell’intero contesto che riempie la finestra a ogni passo.
Dal singolo messaggio si passa così alla finestra intera, da progettare come un sistema. Cole Medin, che queste applicazioni le costruisce, lo dice con uno slogan [Med25]: il prompt engineering bada alla formulazione furba di una richiesta, il context engineering è un sistema completo (documentazione, esempi, regole, schemi da seguire, prove di collaudo), e i due stanno fra loro come un post-it e una sceneggiatura. Un post-it dice cosa fare in una riga; una sceneggiatura dà a ogni scena il contesto per recitarla bene. È un’affermazione di chi costruisce, non un risultato misurato.
La sezione sul contesto come interfaccia ha guardato la finestra di un agente: quanto se ne mangiano gli strumenti e la traccia, quanto costa riempirla, dove si tengono i ricordi che non ci stanno. Qui il contesto si prende per intero: come lo si pensa (una scala di complessità), come lo si monta dentro un budget, quali mosse lo governano, come si guasta, e come lo si rende una procedura ripetibile.
Una scala di complessità: dagli atomi agli organi#
Il primo passo è avere un’immagine di quanto è complesso il contesto che stiamo montando. David Kim, in una raccolta di appunti pubblicata su GitHub [Kim25], propone una metafora presa in prestito dalla biologia: come la materia vivente sale di complessità dagli atomi agli organismi, così il contesto sale da una singola istruzione fino a interi sistemi di componenti che collaborano. È una metafora didattica, un modo di ordinare le idee e non una classificazione scientifica, e come tale la usiamo, nella versione ridotta ai gradini che oggi si mettono in pratica.
Qualcosa di vivo si costruisce a strati. Alla base ci sono gli atomi, i pezzi più piccoli: una singola regola, «rispondi in italiano». Metti insieme più atomi e ottieni una molecola: l’istruzione più due o tre esempi che mostrano cosa intendi. Un gradino sopra ci sono le cellule, e quello che si aggiunge è la memoria: come una cellula, che a differenza di una molecola conserva qualcosa da un momento all’altro, il sistema si ricorda chi sei da un messaggio all’altro. Le cellule si organizzano in organi, cioè in lavori a più passi divisi fra più parti, dove il modello può chiedere al programma di fare qualcosa per lui (cercare, calcolare, aprire un archivio) e poi usare il risultato. La scala di Kim ha ancora due gradini: sopra gli organi mette gli schemi di ragionamento da riusare («scomponi il problema», «verifica il risultato»); in cima, l’idea di trattare tutto il contesto come un tutto continuo invece che come pezzi distinti, che per ora è un’idea di ricerca e non un attrezzo.
Della biologia non ti serve altro. Quello che serve è l’idea che il contesto non è tutto uguale, che ce n’è di semplice come un atomo e di complesso come un corpo, e che l’altezza dice dove intervenire quando qualcosa va storto. Un compito che sta negli atomi si aggiusta riscrivendo la frase; uno che sta negli organi si aggiusta solo decidendo meglio che cosa entra e che cosa esce a ogni passo.
La scala, dal basso verso l’alto, si legge come una progressione di ciò che il contesto deve contenere e coordinare:
Livello |
In pratica |
Cosa mette nel contesto |
|---|---|---|
Atomi |
singola istruzione |
un vincolo, una direttiva isolata |
Molecole |
few-shot |
istruzione + esempi svolti (condizionamento) |
Cellule |
memoria / stato |
informazione che persiste tra i turni |
Organi |
flussi a più passi |
passi coordinati, sotto-agenti, tool use |
I quattro livelli corrispondono a pratiche consolidate: gli esempi few-shot sono lo stesso condizionamento visto nella sezione sul prompt engineering; la memoria persistente, gli strumenti e la divisione del lavoro fra più agenti sono il pane degli agenti. La scala della fonte ne ha altri due. Il quinto, i «sistemi neurali», raccoglie gli strumenti cognitivi, schemi di ragionamento messi nel contesto, e ha almeno una misura alle spalle, quella di Ebouky e colleghi che chiude il discorso sul PRP. Il sesto modella il contesto come un campo continuo, e non ha finora né una definizione operativa né una misura: resta fuori da questo discorso.
La scala non è solo ordine mentale: dice anche dove va speso lo sforzo. Un compito semplice vive negli atomi e nelle molecole, e lì un buon prompt basta. Un agente vive negli organi: lì il collo di bottiglia diventa amministrare quello che entra ed esce dalla finestra a ogni giro, invece della frase.
Montare il contesto dentro un budget#
La finestra è un budget, e ogni token che ci entra si paga in memoria, in attesa e in denaro, come conta la sezione sul contesto come interfaccia. Prima di decidere che cosa ci entra, però, serve sapere dove il modello legge bene, perché c’è un fatto che va contro l’intuizione: anche quando lo spazio ci sarebbe, riempirlo può danneggiare la risposta. Nelson Liu e colleghi lo hanno misurato in un articolo dal titolo eloquente, Lost in the Middle [LLH+24]: i modelli usano bene l’informazione che sta all’inizio e alla fine del contesto, e trascurano quella sepolta in mezzo.
Sulla tua scrivania ci sta solo un certo numero di fogli davanti a te: oltre quelli finiscono nel cassetto e li dimentichi. C’è poi un secondo effetto, più sottile, che chiunque abbia studiato conosce: di una pila di fogli, l’occhio cade sul primo e sull’ultimo. Quelli in mezzo li sfogli distrattamente, e più la pila cresce più quel centro si allarga. Se metti l’informazione che conta proprio lì, rischi di non «vederla» nemmeno se ce l’hai sotto il naso: rispondi come se la pila non l’avessi mai avuta, e certe volte peggio, come se le carte scorse in fretta ti avessero confuso invece di aiutarti. Vale per te alla scrivania e, sorprendentemente, vale anche per il modello: il posto peggiore dove mettere la cosa importante è il centro di un contesto lungo.
Liu e colleghi (2023) variano la posizione del documento che contiene la risposta dentro un contesto di 10, 20 o 30 documenti, su GPT-3.5-Turbo, Claude 1.3 e due modelli aperti (MPT-30B-Instruct e LongChat-13B), e misurano l’accuratezza al variare di quella posizione; lo stesso andamento lo ritrovano su un secondo compito, sintetico, dove si chiede di recuperare il valore associato a una chiave. La curva non è piatta: ha una forma a U. Detta \(j\) la posizione del passaggio rilevante su \(n\) passaggi totali, l’accuratezza è massima agli estremi (\(j = 1\) e \(j = n\)) e cala vistosamente verso il centro (\(j \approx n/2\)): con l’informazione a metà contesto GPT-3.5-Turbo scende sotto il proprio risultato a libro chiuso, cioè senza nessun documento in ingresso, che su quella prova vale il \(56{,}1\%\). Il calo si accentua man mano che il contesto si allunga. Sono misure su modelli del 2023: quanto pesi la posizione dipende dal modello, mentre il calo con la lunghezza del contesto lo ritrova anche il context rot di cui parla Anthropic nel 2025 [Anthropic25a]. Due implicazioni operative dirette. Primo: allungare il contesto non è un pasto gratis; più passaggi si infilano, più è probabile seppellire quello giusto in una zona cieca. Secondo: l’ordine conta. Se recuperiamo dei passaggi (per esempio con un sistema RAG) e ne conosciamo la rilevanza stimata, conviene collocare i più importanti in testa o in coda, non nel ventre molle del contesto.
Il budget e la curva a U si mettono insieme in un pezzo di codice. Il programma che a ogni passo cuce insieme il testo da mandare al modello è il montatore del contesto (in inglese context builder): il punto in cui quelle decisioni smettono di essere opinioni e diventano righe che qualcuno esegue.
È come fare la valigia con un limite di peso. Alcune cose non si discutono (documenti, biglietti) ed entrano comunque. Per il resto non provi tutte le combinazioni possibili di ciò che entra e ciò che no (sono troppe, e il taxi è sotto): scendi per ordine finché lo spazio dura, prima l’indispensabile, poi il molto utile, e fra due cose che servono uguale quella che pesa meno. Ciò che resta fuori resta fuori.
Se qualcosa quasi ci sta, a volte lo porti a metà, sapendo che è un compromesso zoppo: mezzo maglione non tiene caldo, e mezza frase non dice niente.
E se sai che chi la aprirà guarderà per prima cosa quello che sta sopra e quello che sta sotto, mentre quello sepolto in mezzo rischia di non vederlo, le cose che contano le metti ai due estremi. Il montatore del contesto fa la valigia del modello: gli obbligatori dentro, il resto per priorità fino a esaurire il budget, e il più prezioso mai nel mezzo.
È, in piccolo, un problema di zaino (knapsack): scegliere il sottoinsieme di passaggi che massimizza la rilevanza totale \(\sum_i r_i\) sotto il vincolo che la somma dei costi in token \(\sum_i c_i\) non superi il budget disponibile, con system prompt e domanda pre-allocati come costi fissi. Con \(n\) passaggi e un budget di \(B\) token, lo zaino 0/1 si risolve esattamente con la programmazione dinamica in \(O(nB)\) (un costo pseudo-polinomiale, praticabile per qualche decina di passaggi e budget di decine di migliaia di token); in pratica si usa spesso un’euristica greedy (passaggi in ordine di rilevanza decrescente, accettati finché entrano) con due raffinamenti.
Il primo: l’ultimo passaggio che sfora viene troncato per riempire lo spazio residuo invece di essere buttato del tutto. Il raffinamento è discutibile: un troncamento a metà frase occupa token e restituisce un frammento che non afferma niente, quindi spesso conviene tagliare a confine di frase, e scartare il passaggio se non ne resta almeno una intera.
Il secondo: i passaggi scelti vengono riordinati, e non semplicemente messi in ordine crescente di rilevanza. La curva di Liu e colleghi è una U, si legge bene all’inizio e alla fine, quindi disporre per rilevanza crescente ottimizzerebbe un estremo solo e regalerebbe l’altro, quello di apertura, al pezzo peggiore. La disposizione che segue la curva è a V: i due passaggi migliori ai due estremi, e i meno rilevanti sepolti nel mezzo, dove perderli costa meno. Quale dei due estremi meriti il migliore la curva non lo dice, e qui il più rilevante va in fondo, a ridosso della domanda, mentre il secondo va in testa. Nelle librerie di RAG questo riordino porta il nome di long-context reorder.
Avendo ammesso il troncamento, lo zaino è diventato frazionario. Per questo problema l’ottimo greedy si ottiene ordinando per densità \(r_i / c_i\) (rilevanza per token), non per la sola rilevanza \(r_i\); e nello zaino 0/1, senza troncamento, il migliore fra il greedy per densità e il singolo passaggio di rilevanza massima garantisce almeno metà dell’ottimo. Con un’avvertenza che il troncamento stesso solleva: lo zaino frazionario assume che mezzo oggetto valga mezzo valore, e mezza frase non afferma mezza cosa, quindi la garanzia di ottimalità vale sul modello, non sul contesto. Sui numeri dell’esempio in Python i due criteri scelgono gli stessi passaggi, ma la regola enunciata non è quella che il modello dello zaino richiederebbe. E sotto tutto c’è un’ipotesi che i passaggi ridondanti smentiscono: che la rilevanza totale sia la somma delle rilevanze. Due passaggi quasi uguali non valgono il doppio di uno, ed è il problema da cui parte l’MMR.
Ecco il montatore del contesto in puro Python, nessuna libreria, il conteggio
dei token approssimato contando le parole, così che il meccanismo resti in
piena vista. Una cautela: nel budget entrano anche
i marcatori che il montaggio aggiunge ([fonte 0.95] e simili). Sono
testo, il modello li legge, e un budget che non conta ciò che il montaggio
aggiunge non è un budget.
# Un "context builder": dato un budget di token, assembla il prompt
# scegliendo i passaggi piu' importanti, troncando o scartando il resto,
# e collocando il pezzo piu' rilevante IN FONDO (contro il "lost in the middle").

def conta_token(testo):
    """Stima i token contando le parole: grezza, e per l'italiano sta sotto."""
    return len(testo.split())

# System prompt e domanda sono obbligatori: entrano sempre, non si toccano.
system_prompt = (
    "Sei un assistente che risponde citando solo i passaggi forniti. "
    "Se l'informazione non c'e', dillo."
)
domanda = "In che anno e' stato pubblicato il paper sui Transformer?"

# I passaggi recuperati, ciascuno con una rilevanza (piu' alta = piu' utile).
passaggi = [
    (0.95, "Il paper 'Attention Is All You Need' introduce i Transformer nel 2017."),
    (0.20, "Le reti convoluzionali dominarono la visione artificiale negli anni 2010."),
    (0.60, "L'architettura Transformer abbandona la ricorrenza in favore dell'attenzione."),
    (0.10, "Il primo modello GPT fu addestrato su un corpus di libri."),
    (0.75, "L'attenzione scaled dot-product e' il cuore del Transformer."),
]


def riga_fonte(punteggio, testo, troncato=False):
    """La riga come finira' nel prompt. Il marcatore e' testo anche lui:
    entra nella finestra, quindi si paga e va contato."""
    return f"[fonte {punteggio:.2f}{' (troncata)' if troncato else ''}] {testo}"


COSTO_MARCATORE = conta_token(riga_fonte(0.0, "", troncato=True))


def costruisci_contesto(system_prompt, passaggi, domanda, budget):
    """Assembla un prompt che sta nel budget di token.
    Obbligatori: system prompt e domanda. I passaggi entrano per rilevanza
    decrescente finche' c'e' spazio; l'ultimo che sfora viene troncato; la
    disposizione finale e' a V, il migliore in fondo e il secondo in testa."""
    coda = f"Domanda: {domanda}"
    residuo = budget - conta_token(system_prompt) - conta_token(coda)
    if residuo < 0:
        raise ValueError("budget insufficiente perfino per system prompt e domanda")

    ordinati = sorted(passaggi, key=lambda p: p[0], reverse=True)
    scelti = []  # (punteggio, testo, troncato?), gia' per rilevanza decrescente
    for punteggio, testo in ordinati:
        costo = conta_token(riga_fonte(punteggio, testo))
        if costo <= residuo:                          # ci sta intero
            scelti.append((punteggio, testo, False))
            residuo -= costo
        elif residuo >= COSTO_MARCATORE + 2:          # non ci sta: lo tronco
            quante = residuo - COSTO_MARCATORE - 1    # -1 per il segno di taglio
            troncato = " ".join(testo.split()[:quante]) + " …"
            scelti.append((punteggio, troncato, True))
            residuo -= conta_token(riga_fonte(punteggio, troncato, True))
            break
        # altrimenti lo scarto e provo il prossimo (piu' corto o meno rilevante)

    # "lost in the middle": la curva e' a U, si legge bene all'inizio E alla
    # fine. Disposizione a V: il migliore in coda (a ridosso della domanda),
    # il secondo in testa, i peggiori sepolti nel mezzo.
    testa, fondo = [], []
    for n, scelto in enumerate(scelti):
        (fondo if n % 2 == 0 else testa).append(scelto)
    corpo = "\n".join(riga_fonte(p, txt, t) for p, txt, t in testa + fondo[::-1])

    prompt = f"{system_prompt}\n\n{corpo}\n\n{coda}"
    return prompt, conta_token(prompt)   # il conto vero, marcatori compresi


BUDGET = 58
prompt, usati = costruisci_contesto(system_prompt, passaggi, domanda, BUDGET)
print(prompt)
print(f"\nToken usati: {usati}/{BUDGET}")

# quanto pesa il montaggio: anche i marcatori [fonte 0.95] sono testo
righe = [r for r in prompt.split("\n") if r.startswith("[fonte")]
testo = (conta_token(system_prompt) + conta_token(f"Domanda: {domanda}")
         + sum(conta_token(r.split("] ", 1)[1]) for r in righe))
print(f"il testo, senza i marcatori: {testo} token; i marcatori: {usati - testo}, "
      f"cioe' il {(usati - testo) / testo:.0%} in piu'")
Sei un assistente che risponde citando solo i passaggi forniti. Se l'informazione non c'e', dillo.

[fonte 0.75] L'attenzione scaled dot-product e' il cuore del Transformer.
[fonte 0.60 (troncata)] L'architettura Transformer abbandona la …
[fonte 0.95] Il paper 'Attention Is All You Need' introduce i Transformer nel 2017.

Domanda: In che anno e' stato pubblicato il paper sui Transformer?

Token usati: 58/58
il testo, senza i marcatori: 51 token; i marcatori: 7, cioe' il 14% in piu'
L’esecuzione mostra le decisioni prese: dei cinque passaggi, i due più rilevanti entrano interi, il terzo viene troncato per riempire l’ultimo spazio, i due meno rilevanti restano fuori. E la disposizione finale ha la forma di una V: molto ai due estremi, poco nel mezzo. È il ricalco della curva a U di Lost in the Middle, buona agli estremi e cattiva nel mezzo. Il passaggio decisivo, quello che contiene il 2017, finisce in fondo, a ridosso della domanda; il secondo apre; il frammento troncato, che è la parte meno utile perché tagliato a metà non afferma niente, finisce nel mezzo, dove perderlo costa meno.
Le ultime due righe dell’uscita sono il punto. Il contesto davvero montato costa
cinquantotto token; il testo che ci abbiamo messo, marcatori esclusi, ne pesa
cinquantuno. I sette che mancano all’appello sono i [fonte 0.95] e simili,
cioè un quattordici per cento in più di quanto sembrava di aver speso. È
esattamente il tipo di sforamento che si scopre tardi, quando il modello tronca
la risposta a metà.
Alla selezione per sola rilevanza manca però un occhio: i passaggi più rilevanti per la stessa domanda tendono a somigliarsi fra loro, e un budget speso su due passaggi quasi uguali è mezzo budget. Il correttivo classico si chiama maximal marginal relevance (MMR) [CG98], e a ogni giro non prende il passaggio più rilevante: prende quello che offre il miglior compromesso fra rilevanza e novità rispetto a ciò che è già entrato.
Stai preparando una relazione e hai cinque articoli fra cui scegliere, ma nella pagina ce ne stanno tre. Il primo lo prendi per la sola pertinenza, perché non c’è ancora niente accanto a cui confrontarlo. Dal secondo in poi la pertinenza non basta: un articolo che dice quasi le stesse cose di quello già scelto non insegna niente di nuovo a chi legge, e quel pezzo di pagina è buttato.
Allora a ogni articolo si danno due voti, quanto c’entra con la domanda e quanto assomiglia a quelli già presi, e si tiene quello che ha il primo alto e il secondo basso. Con i due voti pesati a metà, il valore di un articolo è metà di quanto c’entra meno metà di quanto assomiglia: uno che c’entra \(0{,}9\) ma assomiglia \(0{,}9\) a uno già dentro vale \(0{,}45 - 0{,}45 = 0\); uno che c’entra \(0{,}6\) e non assomiglia a niente vale \(0{,}3 - 0 = 0{,}3\), e passa avanti al primo.
Quanto pesare i due voti è una manopola. Tutta dalla parte della pertinenza e si torna a scegliere come prima, con il rischio che i tre articoli dicano la stessa cosa tre volte.
A ogni giro si sceglie il passaggio che massimizza
dove \(d\) è il passaggio candidato, \(q\) la domanda e \(S\) i passaggi già scelti: la somiglianza con la domanda meno la somiglianza con il più vicino fra i già scelti, pesate da un \(\lambda\) fra zero e uno (al primo giro \(S\) è vuoto e quel massimo vale zero). Il secondo termine compra la novità: un passaggio rilevantissimo ma fotocopia di uno già dentro perde il posto a favore di uno un po’ meno rilevante che aggiunge qualcosa. Con \(\lambda = 1\) si torna alla pura rilevanza. La somiglianza è quella dell’archivio vettoriale, cioè il coseno fra due vettori di rappresentazione, e nella formula originale i due \(\mathrm{sim}\) possono essere metriche diverse.
Il montatore del contesto sta in poche decine di righe che non capiscono nulla, ma codificano tre scelte di progetto: che cosa è obbligatorio, che cosa entra per priorità, dove va il pezzo più importante. In un sistema reale la rilevanza esce dalla ricerca nell’archivio; il conteggio dei token si fa con lo stesso programma che li taglia davvero per quel modello, il tokenizzatore, perché su un testo italiano, dove una parola si spezza spesso in più token, contare le parole sta parecchio sotto al conto vero; e le politiche sono più ricche. Le scelte di fondo, però, restano quelle tre.
Quattro mosse: scrivere, selezionare, comprimere, isolare#
Più si sale di scala, più il contesto va amministrato invece che scritto e basta. Una divisione comoda raccoglie le tattiche in quattro mosse sole: l’ha proposta nel luglio 2025 LangChain, una delle cassette di attrezzi già pronti con cui questi sistemi si costruiscono [LangChain25]. Non è l’unica in circolazione: le pratiche descritte da Anthropic nel 2025, già incontrate nella sezione sul contesto come interfaccia (la compattazione, gli appunti tenuti fuori dalla finestra, i sotto-agenti), organizzano le stesse idee in modo diverso [Anthropic25a]. Queste quattro mosse formano un comodo repertorio di base.
È la scrivania del capitolo sugli agenti, con il suo foglio di brutta e il suo schedario, e stavolta alla scrivania ci sei tu, nei panni del modello: sul tavolo ci sta poca roba, e accanto hai uno schedario grande quanto vuoi. Da qui i quattro gesti.
Scrivere fuori: quello che adesso non ti serve lo annoti e lo metti nello schedario, così liberi il tavolo e non è perso. Selezionare: quando ti serve qualcosa, vai a prendere solo quella cosa, non svuoti il cassetto sul tavolo. Comprimere: una pila di appunti lunga la riscrivi in tre righe di sunto, che occupano molto meno spazio. Isolare: se il compito è grosso, lo spezzi e ne affidi un pezzo a un collega che ha la sua scrivania, così la tua non si intasa. Il collega è un’altra copia del modello, con una scrivania sua: riceve un pezzo di lavoro e ti restituisce solo il risultato.
Ogni gesto ha il suo prezzo. Quello che metti nello schedario serve solo se poi torni a prenderlo; se dal cassetto prendi la cartella sbagliata, lavori su quella; il sunto perde dettagli e non ti dice quali; e del lavoro del collega ti arriva solo il suo riassunto. E c’è un’abitudine che fa risparmiare: i fogli che non cambiano mai stanno sempre in cima, nello stesso ordine, perché se la pila comincia con gli stessi fogli di ieri, quella parte la ritrovi già letta; basta un foglio nuovo infilato in cima, e devi rileggere tutto.
Le quattro operazioni:
Write, persistere informazione fuori dalla finestra per riusarla dopo: un file di appunti per gli stati intermedi, una memoria esterna per i fatti a lungo termine. Esempio: l’agente salva su un file il piano che sta seguendo, invece di riportarlo in ogni prompt.
Select, recuperare dentro la finestra soltanto ciò che serve al passo corrente: per i documenti è il recupero in-context, discendente del RAG di Lewis e colleghi [LPP+20] (che però addestrava insieme il lato query del retriever e il generatore, tenendo fissi l’encoder dei documenti e l’indice, perché riaddestrarlo avrebbe imposto di ricostruire l’indice durante il training; qui invece tutti i pesi restano congelati); ma è anche il recupero della memoria giusta o della descrizione dello strumento giusto. Esempio: su una domanda di fatturazione, si iniettano le tre pagine di policy pertinenti, non l’intero manuale.
Compress, ridurre i token di ciò che deve restare: riassunto progressivo della cronologia, potatura delle osservazioni verbose degli strumenti. Esempio: dopo venti scambi, la conversazione diventa un sunto di poche righe.
Isolate, partizionare il contesto tra ambienti separati: sotto-agenti con finestre proprie, sandbox, contesti dedicati. Esempio: un agente «ricercatore» e uno «scrittore», ciascuno con il suo contesto, che si scambiano solo il risultato.
Nessuna delle quattro è gratuita, e ciascuna perde in un modo suo. Write rende solo se quello che si è scritto viene poi riletto; select vale quanto la ricerca che sceglie, e un recupero sbagliato porta in finestra il materiale sbagliato; compress perde informazione, e di solito non sa quale; isolate paga il contesto due volte, nel sotto-agente che rilegge istruzioni e compito e nel riassunto che torna indietro, e la qualità dipende da quanto quel riassunto è fedele.
Le forme di memoria della sezione sul contesto degli agenti sono le stesse mosse tagliate lungo un altro asse: là si guardava dove sta l’informazione, qui che cosa se ne fa. Il database vettoriale e i fatti strutturati sono write quando si archivia e select quando si ripesca; il riassunto progressivo, cioè la compattazione, è compress; i sotto-agenti sono isolate; e la politica di ammissione, che decide che cosa di quel materiale merita la finestra a questo passo, è select. Il montatore del contesto ne esegue due sotto il cofano, select (i passaggi per rilevanza, finché il budget regge) e una forma grezza di compress (il troncamento dell’ultimo passaggio), e aggiunge una scelta che le quattro mosse non coprono: dove mettere ciò che è entrato, con il passaggio migliore in fondo, a ridosso della domanda, per la curva a U del lost in the middle. Write lì manca, perché quel montatore non conserva niente da un passo all’altro, ed è la mossa che il loop engineering trasformerà in stato su file. La quarta, isolate, apre verso la progettazione multi-agente, e chiama in causa il loop engineering: decidere quando delegare a un sotto-contesto è già una scelta sul ciclo, non sul singolo messaggio.
L’ordine conta anche per il costo. I fornitori riusano i calcoli fatti su un prefisso del contesto già visto, a patto che sia identico fino all’ultimo token, e il meccanismo è lo stesso con cui i motori di inferenza condividono la KV cache fra richieste che cominciano allo stesso modo [ZYX+24]. Ne segue una regola di montaggio: in testa ciò che non cambia (istruzioni, descrizioni degli strumenti, documenti fissi), in fondo ciò che cambia a ogni giro, perché un’informazione variabile messa in testa invalida la cache di tutto quello che la segue. Nel 2026 Anthropic e OpenAI vendono questo riuso come prompt caching, a prezzo ridotto sul prefisso riletto; tariffe e durate cambiano da un modello all’altro, e si leggono nella documentazione corrente.

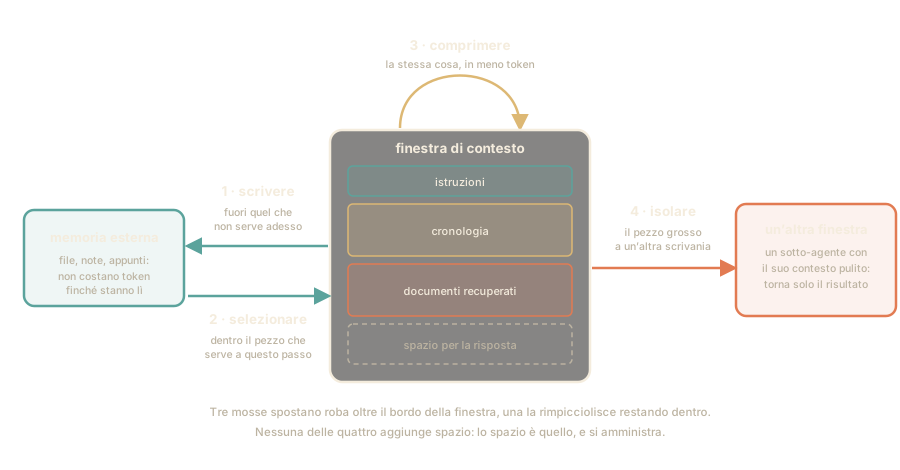
Fig. 21.8 Le quattro mosse, disegnate rispetto al bordo della finestra. Tre lo attraversano (scrivere e isolare verso fuori, selezionare verso dentro), una rimpicciolisce il materiale restando dentro, e nessuna delle quattro aggiunge spazio.#
Messe una accanto all’altra come in Fig. 21.8, le quattro mosse rivelano di essere quattro risposte alla stessa domanda: dove sta il materiale rispetto al bordo della finestra. Fuori e recuperabile (scrivere), fuori e da riportare dentro un pezzo alla volta (selezionare), dentro ma più corta (comprimere), fuori e affidata a qualcun altro che ha un bordo suo (isolare). La finestra resta grande quanto era: quello che cambia è la disciplina con cui la si riempie.
Comprimere più di una finestra: riassumere a pezzi#
La compressione ha un caso limite: il documento da riassumere è più lungo della finestra stessa, e il riassunto non si può chiedere in una chiamata sola. È il caso di chi chiede a un assistente il riassunto di un documento di qualche centinaio di pagine, o di un archivio di mail lungo anni. Allora lo si spezza, e i modi di rimettere insieme i pezzi sono due. Il primo è il riassunto in fila (refine, o aggiornamento incrementale): un sunto corrente che si riscrive pezzo dopo pezzo. Il secondo è il riassunto ad albero (map-reduce, o fusione gerarchica): ogni pezzo riassunto da solo, poi i riassunti riassunti fra loro, fino a uno.
Sulla scrivania arriva un fascicolo di duecento pagine, e sul tavolo ne stanno sei alla volta. Nella prima maniera lo si legge in fila tenendo accanto una scheda di mezza pagina: si leggono le pagine che ci stanno, si scrive la scheda; si leggono le successive, si riscrive la scheda tenendo conto di quello che c’era; e così fino in fondo. La scheda occupa mezza pagina del tavolo, quindi di pagine nuove ne entrano cinque e mezza per volta, e la scheda, contando la prima stesura e tutte le riscritture, si scrive trentasette volte. È lavoro per una persona sola, perché ogni scheda nuova ha bisogno di quella vecchia, e quello che si è letto all’inizio arriva in fondo solo passando per tutte le riscritture.
Nella seconda maniera il fascicolo si divide fra i colleghi, sei pagine a testa, e ognuno restituisce la sua scheda: trentaquattro schede. Sul tavolo ne stanno dodici alla volta (dodici mezze pagine fanno sei pagine), quindi si raggruppano a dodici, e un altro giro di tre colleghi fa le schede delle schede; le tre schede che ne escono stanno insieme sul tavolo, e un ultimo collega ne fa quella finale. Il lavoro si fa in pochi giri, perché in ogni giro i colleghi lavorano insieme, e dall’inizio del fascicolo alla scheda finale ci sono pochi passaggi. Il prezzo è che ogni collega legge le sue sei pagine senza sapere che cosa c’era prima: se a pagina 150 torna un personaggio presentato a pagina 3, chi ha pagina 150 non sa chi sia.
Verrebbe da pensare che la scheda in fila, che si porta dietro tutto il fascicolo, sia la più coerente, e invece no. Chi ha messo a confronto le due maniere su cento libri ha contato gli errori di coerenza (un salto nel racconto, un fatto importante dimenticato, una cosa detta due volte): la scheda in fila ne fa più del doppio, anche se esce più ricca di dettagli. Riscritta trentasette volte, ha trentasette occasioni di sbagliare; i colleghi che non sanno che cosa c’era prima, a conti fatti, sbagliano meno.
Siano \(n\) i token del documento, \(w\) quelli di testo che una chiamata può leggere (la finestra meno le istruzioni e lo spazio per la risposta) e \(s\) la lunghezza di un riassunto, supposta la stessa a ogni livello qualunque cosa condensi, che è la semplificazione del conto. Se \(n \le w\) basta una chiamata sola, che nel lessico di LangChain si chiama stuff.
Il riassunto in fila mantiene uno stato, il sunto corrente di al più \(s\) token, e a ogni chiamata legge lo stato e \(w - s\) token nuovi: servono \(m = \lceil n/(w-s) \rceil\) chiamate, tutte sequenziali. È una ricorrenza con uno stato di taglia fissa, e ne eredita il collo di bottiglia sequenziale: l’informazione del primo pezzo raggiunge l’uscita attraverso \(m\) riscritture, mentre ogni chiamata vede, compresso, tutto ciò che la precede.
Il riassunto ad albero fa \(\lceil n/w \rceil\) chiamate indipendenti sui pezzi (la fase map), poi raggruppa i riassunti a \(k = \lfloor w/s \rfloor\) per chiamata e ripete (reduce), finché ne resta uno; serve \(k \ge 2\), cioè un riassunto lungo al più metà di quello che legge, o l’albero non converge. I livelli sono circa \(1 + \lceil \log_k \lceil n/w \rceil \rceil\), le chiamate in tutto circa \(\lceil n/w \rceil \cdot k/(k-1)\), e il cammino critico, cioè il numero di turni che non si possono sovrapporre, è pari ai livelli: logaritmico invece che lineare. Il prezzo è simmetrico: nella fase map ogni chiamata vede un pezzo solo, e un riferimento che attraversa il confine fra due pezzi (un nome introdotto prima, un pronome) non si può risolvere lì.
È la decomposizione ricorsiva con cui Wu e colleghi hanno riassunto romanzi interi con un modello addestrato sul giudizio umano: prima sezioni brevi, poi riassunti dei riassunti [WOZ+21]. Il confronto controllato fra le due strategie è di Chang e colleghi, su riassunti di cento libri usciti di recente (per non trovarli già nei dati di addestramento), con 1193 annotazioni umane: l’aggiornamento incrementale produce più errori di coerenza (840 segnalati dagli annotatori, contro 353) ma più dettaglio; la fusione gerarchica fa meno errori di ogni tipo tranne le incoerenze, e dà meno dettaglio; e gli annotatori a volte preferiscono il primo compromesso [CLGI24]. Il confine fra i pezzi farebbe prevedere il contrario sulla coerenza, e la misura lo smentisce. È una misura di qualità, riportata e non rifatta qui; il conto sulle chiamate misura soltanto quante sono e quanto devono aspettarsi.
Il conto prende un documento da duecentomila token, pezzi da seimila e riassunti da cinquecento, e conta le chiamate delle due strategie, livello per livello, e i turni che devono aspettarsi l’un l’altro.
from math import ceil

documento = 200_000     # token del documento
pezzo = 6_000           # token di testo letti da una chiamata
sunto = 500             # token del riassunto restituito


def ad_albero(n_token):
    """Chiamate per livello: i pezzi, poi i riassunti raggruppati, fino a uno."""
    livelli = [ceil(n_token / pezzo)]
    while livelli[-1] > 1:
        livelli.append(ceil(livelli[-1] / (pezzo // sunto)))  # k = w // s
    return livelli


def in_fila(n_token):
    """Una chiamata per pezzo, in fila: ognuna legge il sunto e il testo nuovo."""
    return ceil(n_token / (pezzo - sunto))


livelli = ad_albero(documento)
print(f"ad albero: chiamate per livello {livelli}, in tutto {sum(livelli)}, "
      f"turni in fila {len(livelli)}")
print(f"in fila: {in_fila(documento)} chiamate, e altrettanti turni in fila")
letti_albero = documento + sum(livelli[:-1]) * sunto
letti_fila = documento + (in_fila(documento) - 1) * sunto
print(f"token letti in tutto: ad albero {letti_albero}, in fila {letti_fila}")
ad albero: chiamate per livello [34, 3, 1], in tutto 38, turni in fila 3
in fila: 37 chiamate, e altrettanti turni in fila
token letti in tutto: ad albero 218500, in fila 218000
Le chiamate sono quasi le stesse, trentotto contro trentasette, e i token letti differiscono di cinquecento su più di duecentomila. Cambia il tempo: l’albero ha tre turni, perché le trentaquattro chiamate del primo livello partono insieme, mentre la fila ne ha trentasette, uno dopo l’altro. E cambia la strada che fa l’informazione del primo pezzo prima di arrivare al riassunto finale: tre riassunti in un caso, trentasette passaggi di scheda nell’altro.
Come si guasta un contesto#
Un contesto più lungo non è per forza un contesto migliore, e molti dei modi in cui le risposte peggiorano via via che si va avanti hanno a che fare con un contesto che si sporca. Drew Breunig, che scrive di queste applicazioni, ne ha proposto un catalogo utile [Bre25]. I guasti ricorrenti sono quattro:
L’avvelenamento (context poisoning): un errore, o una cosa che il modello si è inventato di sana pianta (un’allucinazione), entra nel contesto e ci resta. Da lì in poi il modello la tratta come un fatto acquisito e ci costruisce sopra. È il guasto peggiore, perché si alimenta da sé.
La distrazione (context distraction): il contesto cresce tanto che il modello si fissa su ciò che ci legge dentro e trascura quello che sapeva già da prima, cioè quello che aveva imparato durante l’addestramento. Si perde fra i propri passi passati invece di guardare avanti, e nei casi osservati arriva a rifare azioni che aveva già fatto.
La confusione (context confusion): informazione inutile ma presente, che il modello usa soltanto perché è lì, e che tira la risposta fuori fuoco. L’esempio di Breunig riguarda l’elenco degli strumenti fra cui il modello deve scegliere per rispondere: un modello piccolo, di quelli che girano su un computer normale, messo davanti a quarantasei strumenti prende quello sbagliato e la richiesta fallisce; con lo stesso compito e diciannove strumenti in elenco sceglie giusto.
Il conflitto (context clash): pezzi di contesto che si contraddicono fra loro, due documenti che si smentiscono, il regolamento vecchio accanto a quello nuovo. Il modello non sa a chi credere, e la risposta ne risente.
Il più insidioso è il primo, l’avvelenamento, e funziona come una diceria. Basta che in un gruppo entri una voce falsa («il negozio chiude alle 18») e da quel momento tutti la ripetono come vera: chi arriva dopo la sente già «confermata» da tre persone e non la mette in dubbio. Nel contesto succede lo stesso: se al passo tre il modello «decide» per sbaglio che l’utente si chiama Marco, ai passi quattro, cinque, sei quel Marco è ormai lì, scritto, e il modello ci parla come se fosse sempre stato vero. L’errore non resta un errore: diventa una premessa. È per questo che, con gli agenti, conviene ripulire il contesto invece di lasciarlo crescere all’infinito.
Da qui il gesto che costa un secondo: quando una conversazione comincia a dire cose sbagliate, aprine una nuova invece di insistere. Correggere il modello dentro la stessa chat lascia l’errore dov’è, in mezzo a tutto quello che si è detto prima, e lui continua a rileggerlo. Una chat nuova parte dal foglio bianco, ed è l’unico modo che hai, da fuori, di togliere la diceria dal gruppo.
Che «più lungo» non voglia dire «migliore» è stato misurato. La prova è quella di Liu e colleghi, la stessa dei fogli sepolti in mezzo alla pila che si è vista montando il contesto; qui conta l’altra metà del risultato, la lunghezza. Si dava al modello una domanda e un mucchio di documenti in cui cercare la risposta, spostando quello giusto ora in cima, ora in mezzo, ora in fondo. Con venti o trenta documenti, e quello giusto nel mezzo, il modello rispondeva peggio di quando non gliene davano nessuno e doveva rispondere a memoria. Era un modello solo, e di allora: quello che si porta via è che oltre un certo punto aggiungere documenti peggiora la risposta, non il numero preciso a cui succede. Una finestra più capiente non bastava: gli stessi modelli, nella versione che ne teneva molto di più, non usavano meglio quello che ci trovavano dentro. Lo spazio dichiarato non è lo spazio che il modello sa sfruttare.
Per distraction e confusion una lettura possibile (interpretativa, non presa dalla letteratura) è la diluizione dell’attenzione: man mano che il contesto si allunga, il segnale rilevante si distribuisce su più token e la capacità del modello di isolarlo cala. Le evidenze si sovrappongono più di quanto la distinzione dei nomi suggerisca. Liu e colleghi [LLH+24] misurano la posizione (la curva di accuratezza in funzione di dove sta l’informazione ha la forma a U, come si è visto montando il contesto) e insieme la lunghezza: sul QA multi-documento fanno variare il numero di documenti in finestra e trovano che, su GPT-3.5-Turbo, nel caso peggiore (cioè quando il documento rilevante capita in mezzo) con venti o trenta documenti l’accuratezza scende sotto quella a libro chiuso, cioè sotto il 56,1 per cento di risposte esatte che quel modello ottiene senza alcun documento davanti. Il numero è di un modello solo e di quel momento, e non va portato in giro come una soglia universale; quello che si porta in giro è il fatto che la curva, a un certo punto, gira verso il basso. Aggiungere contesto, oltre una certa soglia, costa più di quanto renda. Dallo stesso lavoro viene un secondo punto che conviene tenere: i modelli a contesto esteso non usano il proprio contesto meglio di quelli da cui derivano, dove i due si possono confrontare, e quindi la finestra dichiarata non è la finestra utile. RULER, nel 2024, misura lo stesso scarto su diciassette modelli: tutti dichiarano una finestra di almeno 32.000 token, e a quella lunghezza solo la metà mantiene prestazioni soddisfacenti [HSK+24]. La distraction del catalogo è quest’ultimo effetto visto dal lato pratico, con soglie osservate dalle decine di migliaia di token in su, a seconda del modello; confusion è invece il caso in cui token irrilevanti ma presenti attirano indebitamente l’attenzione. Il poisoning è di natura diversa (è un problema di veridicità dello stato, non di posizione) e il clash è un problema di coerenza dell’insieme. A ogni guasto si può abbinare un gesto: compress contro distraction, select contro confusion, l’igiene dello stato (rimuovere ciò che si è rivelato falso) contro poisoning, la deduplicazione delle fonti contro clash. È un abbinamento plausibile, non misurato. Contro il poisoning il rimedio più semplice è anche il più drastico: azzerare la sessione e ripartire da un contesto pulito, portandosi dietro soltanto ciò che è stato verificato.
Scrivere il contesto una volta sola: il PRP#
Un contesto montato bene costa fatica, e quella fatica si può fare una volta sola: invece di rimettere insieme tutto da capo a ogni lavoro, si prepara in anticipo un foglio con dentro quello che serve, e si consegna quello. L’idea nasce per gli assistenti che scrivono codice, ma il gesto vale anche per chi usa soltanto la chat: un foglio di istruzioni preparato bene, da incollare all’inizio, fa la stessa cosa. Il nome è PRP, Product Requirement Prompt, cioè il prompt che descrive per intero che cosa si vuole ottenere: l’ha proposto Rasmus Widing nel giugno 2025 [Wid25], e lo ha reso noto poche settimane dopo il modello di progetto pubblicato da Cole Medin [Med25].
A un falegname puoi dire «fammi un tavolo», oppure puoi consegnargli un progetto completo: le misure, il tipo di legno, la foto di un tavolo che ti piace, perché il tuo venga di quello stile, e le due pagine del catalogo della ferramenta con le viti giuste, non il catalogo intero. In fondo al foglio c’è il dettaglio decisivo, la regola con cui si stabilisce se il tavolo è venuto bene, «deve stare in piano e reggere 40 chili». Con il progetto in mano il falegname lavora quasi da solo e sbaglia di meno, perché ha davanti tutto prima di iniziare. E quella regola finale non serve soltanto a te. Quando il tavolo è pronto, lui lo appoggia, ci carica sopra il peso, e se traballa ripialla la gamba corta prima di consegnartelo. Il PRP è quel foglio, scritto per un assistente che programma: regole, esempi, le pagine di manuale che servono e la prova finale, tutto insieme, pronto da riusare al prossimo lavoro.
Un PRP tipico raccoglie quattro ingredienti: (1) le regole di progetto in un
file versionato accanto al codice (CLAUDE.md, AGENTS.md a seconda
dell’assistente), con convenzioni, vincoli, cosa evitare; (2) esempi di codice
del repository, che condizionano l’assistente sullo stile reale invece che su
uno generico; (3) la documentazione pertinente (API, riferimenti), selezionata
e non l’intera libreria; (4) un validation gate, cioè il criterio oggettivo
(i test da far passare, il linter, il comando che deve tornare a zero) con
cui verificare che il lavoro sia effettivamente finito. I primi tre ingredienti
sono context engineering allo stato puro: sono le mosse select e write rese
esplicite in un artefatto versionabile. Il quarto anticipa la sezione sul loop engineering: il validation gate è il seme del loop
engineering, perché trasforma un colpo solo in un ciclo (genera, verifica
contro il gate, e se fallisce reitera con l’esito in contesto). Che dare al
modello più contesto strutturato riduca gli errori è l’affermazione di chi
propone il metodo [Med25]: un’intuizione sensata, ma
senza un confronto controllato alle spalle.
C’è una variante «leggera» della stessa idea che merita una riga. Al posto del progetto per un lavoro solo, si mette nel contesto un metodo di lavoro: schemi di ragionamento riusabili, «scomponi il problema», «verifica il risultato», che fanno da impalcatura a come il modello procede. Ebouky, Bartezzaghi e Rigotti li hanno studiati sotto il nome di cognitive tools, strumenti cognitivi, e misurano che con questi nel contesto il modello risolve più problemi di matematica senza che dentro gli si sia toccato niente [EBR25]. È lo stesso spirito del PRP applicato non al codice ma al pensiero, e sta un gradino sopra gli «organi» della scala di prima, nel gradino che Kim chiama dei «sistemi neurali»: non un singolo prompt, ma uno schema che mette in fila più passi.
Che la materia stia prendendo la forma di una disciplina lo mostra un’indagine del 2025 che ha ordinato oltre millequattrocento articoli scientifici sul tema [MYG+25]: da una parte i componenti di base (come il contesto si recupera o si genera, come lo si elabora, come lo si gestisce e lo si comprime), dall’altra i sistemi che li mettono insieme, il RAG, le memorie, il ragionamento con gli strumenti, i sistemi multi-agente. La finestra è un sistema e non una casella di testo, e va progettata come tale.
Da ricordare
Quello che arriva al modello è tutto un carico e non la tua frase: lo monta il programma ogni volta rimettendoci dentro le istruzioni di fondo, gli esempi, i pezzi di documento che servono e il riassunto di quanto già detto. Progettare quel carico è il mestiere; la tua frase ne è l’ultima riga.
Il contesto non è tutto uguale: c’è quello semplice come un atomo (una regola sola) e quello complesso come un corpo (più passi coordinati). L’altezza dice dove intervenire: in basso si riscrive la frase, in alto si governa quello che entra ed esce a ogni passo. Le proposte in cima a quella scala sono ancora ricerca, non tecniche pronte.
Montare il contesto è come fare la valigia con un limite di peso: prima l’indispensabile, poi il resto per priorità finché entra, e quel che quasi ci sta lo porti a metà. E siccome il modello usa bene l’inizio e la fine di quello che legge e trascura il centro (lost in the middle [LLH+24]), la cosa più importante va messa a un estremo e mai nel mezzo: qui va in fondo, appena prima della domanda, e la seconda apre.
Sulla scrivania piccola ci sono quattro gesti: scrivere fuori quel che non serve adesso, selezionare quel che serve e nient’altro, comprimere in poche righe una pila di appunti, isolare un pezzo di lavoro affidandolo a un collega con la sua scrivania. Ognuno ha un prezzo, e i fogli che non cambiano stanno in cima, sempre uguali, così non si rileggono.
Un documento più lungo del tavolo si riassume a pezzi, in fila (una scheda riscritta pezzo dopo pezzo, più ricca di dettagli) o ad albero (schede delle schede, più rapido e, misurato, più coerente).
Un contesto si guasta in quattro modi: un errore che ci entra e da lì in poi viene ripetuto come se fosse vero; un contesto così lungo che il modello si fissa su quello che c’è scritto dentro e dimentica quello che sa; dettagli inutili che tirano la risposta fuori strada; pezzi che si contraddicono a vicenda. Più lungo non vuol dire migliore: nella prova di Liu e colleghi, con venti o trenta documenti in finestra e quello giusto nel mezzo, le risposte erano peggiori di quelle date senza alcun documento; e una finestra più capiente non è una finestra usata meglio. Quando una conversazione comincia a sbagliare, si apre una conversazione nuova.
Il contesto si può preparare una volta e riusare: un foglio di progetto (il PRP) con dentro le regole, gli esempi, i pezzi di manuale che servono e, decisivo, la prova con cui si stabilisce se il lavoro è finito. Quest’ultima è il ponte verso il loop engineering.
Da ricordare
Il context engineering [Kar25a] sposta l’unità del mestiere dal singolo messaggio (il prompt) all’intero payload che riempie la finestra a ogni passo: un sistema (regole, esempi, documentazione, validazione) non una «frase magica».
Una scala di complessità utile (metafora biologica di Kim): atomi (istruzioni) → molecole (few-shot) → cellule (memoria) → organi (flussi a più passi, sotto-agenti, strumenti). La fonte ha due gradini in più: i sistemi neurali (strumenti cognitivi, con qualche misura) e i campi, che sono frontiera speculativa, non risultato consolidato.
Montare il contesto è un problema di budget (uno zaino, e per giunta frazionario una volta ammessa la troncatura): obbligatori fissi, passaggi finché entrano, e disposizione a V, il più rilevante in fondo e il secondo in testa, perché la curva del lost in the middle [LLH+24] è a U (nelle misure del 2023, bene l’inizio e la fine, male il centro). L’ordine d’uso è per rilevanza \(r_i\); quello che lo zaino frazionario richiederebbe è per densità \(r_i/c_i\), mentre lo 0/1 si risolve esatto in \(O(nB)\). Nel budget vanno contati anche i marcatori che il montaggio aggiunge, e la rilevanza non è additiva quando i passaggi si ripetono: per questo l’MMR.
Quattro mosse per governare il contesto (la divisione di LangChain; Anthropic ne usa un’altra): write (fuori dalla finestra), select (andare a prendere solo ciò che serve al passo corrente, il gesto che sta anche dietro ai sistemi che recuperano documenti prima di rispondere [LPP+20]), compress (riassumere/potare), isolate (partizionare tra sotto-agenti). Ognuna perde qualcosa; e la cache dei prompt premia un prefisso stabile, con ciò che cambia in fondo.
Un documento più lungo della finestra si riassume in fila (\(\lceil n/(w-s) \rceil\) chiamate sequenziali) o ad albero (circa altrettante chiamate, cammino critico logaritmico); il confronto su cento libri dà all’albero meno errori di coerenza e meno dettaglio [CLGI24].
Quattro guasti (catalogo di Breunig [Bre25]): poisoning (un errore che si sedimenta e si autoalimenta), distraction (il contesto lungo che fa prevalere ciò che vi si legge su ciò che il modello ha appreso), confusion (token irrilevanti usati perché presenti) e clash (contesto contraddittorio). Il lost in the middle [LLH+24] misura sia la posizione (curva a U) sia la lunghezza: sul modello lì misurato, con venti o trenta documenti e nel caso peggiore (rilevante in mezzo) si scende sotto il risultato a libro chiuso, e la finestra dichiarata non è la finestra utile (anche RULER [HSK+24]). Contro il poisoning, il rimedio più semplice è azzerare la sessione.
Il PRP (Widing, 2025 [Wid25]) rende il context engineering una procedura ripetibile: regole, esempi, documentazione e validation gate (il criterio oggettivo che dice se il lavoro è finito). Quest’ultimo anticipa il loop engineering: verificare l’esito e reiterare.
Il costo della finestra e la memoria di un agente stanno nella sezione sul contesto come interfaccia; le sue forme di memoria si rileggono come write, select, compress e isolate, e la posizione nella finestra resta una scelta a parte.