


Analisi numerica: quando i numeri hanno precisione finita#
Apri un terminale Python e somma due decimali semplici:
>>> 0.1 + 0.2
0.30000000000000004
Succede in qualunque linguaggio che usi i numeri binari in virgola mobile (lo
standard IEEE 754), e non per un difetto di Python. Un computer non conserva i
numeri reali, ma loro approssimazioni con un numero finito di cifre. Di solito
la differenza è invisibile; a volte no. Il 4 giugno 1996 un numero troppo
grande, convertito in un formato più piccolo, «straripò» a bordo del razzo
europeo Ariane 5: successe \(37\) secondi dopo l’avvio della sequenza di
accensione del motore principale, e due secondi più tardi il lanciatore, ormai
fuori assetto, si disintegrò e fu fatto esplodere dal sistema di
autodistruzione [Lio96]. Un errore di conversione numerica da
centinaia di milioni di dollari. L’analisi numerica studia questi limiti e
insegna a conviverci. Nel machine learning se ne accorge chiunque abbia visto
un addestramento fermarsi su NaN, che è la sigla con cui un calcolatore
segnala «questo non è un numero» (dall’inglese not a number) ed è ciò che
resta quando un conto è andato a finire fuori strada, per esempio dividendo
zero per zero.
La virgola mobile: un budget fisso di cifre#
Un calcolatore conserva ogni numero in una sequenza di cifre binarie, i bit,
ciascuna con valore \(0\) o \(1\). Il bit di memoria e il bit della teoria dell’informazione coincidono quando le due cifre sono
ugualmente probabili; in generale una cifra binaria porta al più un bit di
informazione. La sequenza ha lunghezza fissata: trentadue bit nel formato
float32, il più usato nel deep learning (Python e NumPy usano invece
float64, a sessantaquattro), sedici nei formati ridotti. I bit sono spartiti
in tre campi, come nella notazione scientifica \(3{,}0\cdot10^8\), qui con la
base due al posto della dieci:
un bit di segno, positivo o negativo;
un campo per l’esponente, la potenza di due per cui si moltiplica, che fissa la portata, cioè quanto grande e quanto piccolo può essere il numero;
il campo più lungo per la mantissa, le cifre significative (\(3{,}0\) nell’esempio), che fissa la precisione, cioè con quanta finezza il numero è descritto.
Spartire i bit è un baratto: quelli dati all’esponente non sono dati alla mantissa.

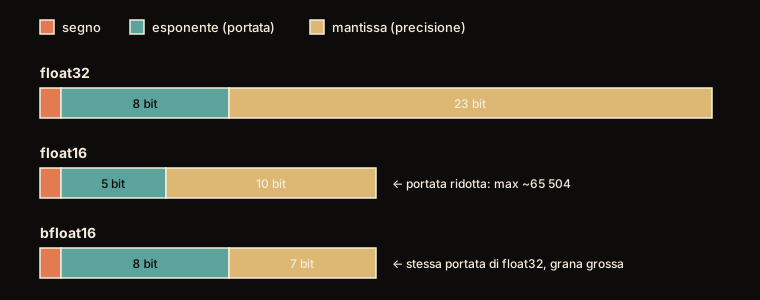
Fig. 3.29 Lo stesso budget di sedici bit, speso in due modi. Rispetto al float32
tutti e due perdono qualcosa, perché hanno metà delle caselle; la scelta è
che cosa. Il float16 sacrifica la portata e si tiene più cifre; il
bfloat16 fa l’opposto, tiene la stessa portata del float32 e paga con la
grana più grossa, e per addestrare una rete è quasi sempre il baratto giusto.
(La b sta per brain: il formato nasce nel gruppo Google Brain, non è una
sigla tecnica.)#
La distinzione di Fig. 3.29 fra portata e
precisione attraversa tutto quello che segue. Sono due budget separati, e i
guai di cui parleremo nascono dall’esaurirsi ora dell’uno (si finisce fuori
dai numeri rappresentabili) ora dell’altro (restano troppo poche cifre buone).
Il bfloat16 della terza barra ha lo stesso esponente del float32, e quindi
la stessa portata, e sette bit di mantissa invece di ventitré: un terzo della
precisione, contando anche l’uno implicito (otto bit contro ventiquattro). Per
l’addestramento conviene conservare la portata, perché i gradienti coprono
molti ordini di grandezza.
Il display di una calcolatrice tascabile mostra solo una decina di cifre. Se le chiedi \(1/3\) ti risponde \(0{,}3333333\) e si ferma: le altre cifre le butta via. I computer fanno lo stesso, in binario, con un budget fisso di cifre per ogni numero.
Con questo budget si scrive un numero come nella notazione scientifica («tante
cifre significative, moltiplicate per una potenza»), così lo stesso formato
copre sia \(0{,}0000001\) sia \(10^{30}\). Il prezzo è che tra due numeri vicini
resta sempre un piccolo «gradino» vuoto. E un numero come \(0{,}1\), semplice da
scrivere in decimale, in binario non finisce mai, come \(1/3\) in decimale: il
computer ne tiene un pezzo, quindi già \(0{,}1\) e \(0{,}2\) sono un poco diversi
da quelli veri. Sommati, cadono tra due gradini e vengono arrotondati, ed ecco
lo 0.30000000000000004.
Lo standard IEEE 754 rappresenta un numero come
dove \(1+f\) è la mantissa (o significando: le cifre significative) ed \(e\)
l’esponente (la scala). Di quel numero si memorizza solo la parte
frazionaria \(f\), con \(0 \le f < 1\), perché l’\(1\) davanti è implicito e non
serve scriverlo: è la ragione per cui il formato float32 spende 1 bit di
segno, 8 di esponente e 23 per \(f\). Da quei 23 bit (non dai 24 del
significando, che comprendono l’uno implicito) esce l’\(\varepsilon\) di due
righe più sotto: a \(x=1\) l’esponente è nullo, quindi il numero rappresentabile
successivo è esattamente \(1+2^{-23}\). Il float64 (doppia precisione) dà 52
bit a \(f\). La granularità relativa è l’epsilon macchina \(\varepsilon\): la
distanza fra \(1\) e il numero rappresentabile immediatamente successivo, pari a
\(2^{-23}\approx 1{,}19\cdot10^{-7}\) per float32 e \(2^{-52}\approx
2{,}22\cdot10^{-16}\) per float64. Ogni operazione arrotonda al numero
rappresentabile più vicino, e l’errore relativo che ne deriva è limitato
dall’unità di arrotondamento \(u=\varepsilon/2\) (metà del gradino, perché si
arrotonda all’estremo più vicino), purché il risultato non cada fuori dalla
portata. Per i formati da sedici bit gli stessi conti danno: il float16 ha
\(\varepsilon=2^{-10}\approx 9{,}8\cdot10^{-4}\) e un massimo di \(65\,504\), il
bfloat16 ha \(\varepsilon=2^{-7}\approx 7{,}8\cdot10^{-3}\) e la portata del
float32. Il float16 ha anche il più piccolo normalizzato a \(2^{-14}\approx
6{,}1\cdot10^{-5}\); sotto quella soglia i numeri diventano subnormali,
perdono cifre fino a \(2^{-24}\approx 6\cdot10^{-8}\) e poi finiscono a zero, e
molti gradienti di una rete stanno proprio lì. L’addestramento in precisione
mista tiene allora una copia float32 dei pesi, calcola in float16 e
moltiplica la loss per un fattore di scala prima della retropropagazione, per
poi annullarlo dividendo i gradienti per lo stesso fattore
[MNA+18]. Col bfloat16 quel fattore di norma non serve,
ed è la ragione pratica per cui lo si preferisce.
L’esempio \(0{,}1+0{,}2\) si spiega per intero. In float64, \(0{,}1\) e \(0{,}2\)
non sono rappresentabili (il loro sviluppo binario è periodico) e diventano
\(0{,}1000000000000000055511\ldots\) e \(0{,}2000000000000000111022\ldots\). La
loro somma esatta, \(0{,}3000000000000000166533\ldots\), sta esattamente a metà
fra i due numeri rappresentabili vicini, \(0{,}29999999999999998889\ldots\) e
\(0{,}30000000000000004441\ldots\); l’arrotondamento al pari sceglie il secondo,
che ha la mantissa pari, ed è quello che Python stampa come
0.30000000000000004. Il numero \(0{,}3\) scritto nel codice è invece il primo
dei due.
Quando un bit si gira da solo
Le tre parti appena descritte (segno, esponente, mantissa) non sono soltanto un modo di spartire lo spazio: decidono anche quanto è grave un guasto, ed è un caso in cui la struttura di un formato numerico ha una conseguenza che di solito non si associa alla matematica.
I bit in memoria non sono eterni. Una particella ionizzante, un disturbo elettromagnetico, una cella difettosa: ogni tanto un bit si ribalta senza che nessuno lo abbia chiesto, cioè passa da \(0\) a \(1\) o viceversa. Su un computer da scrivania è un evento raro; su decine di migliaia di acceleratori (le schede di calcolo specializzate su cui si addestrano i modelli grandi) che macinano per settimane, diventa un’occorrenza ordinaria, e i grandi operatori la trattano come tale.
Non tutti i bit sono uguali, e la differenza è enorme. Se a girarsi è l’ultimo della mantissa, l’effetto è invisibile: il numero cambia nella settima cifra, un peso che valeva \(0{,}5\) diventa \(0{,}50000006\). Se a girarsi è il bit del segno, quel peso diventa \(-0{,}5\): cambia verso, ma resta della stessa taglia, e una rete se ne accorge poco. Il caso che conta davvero è il terzo: se a passare da \(0\) a \(1\) è il primo bit dell’esponente, quello che vale di più, il peso non cambia un po’, cambia scala. Da \(0{,}5\) salta a \(1{,}7\cdot10^{38}\), cioè a metà del più grande numero che quel formato riesca a scrivere.
È la differenza fra un errore e una catastrofe. Quel singolo numero, entrando nei conti dello strato successivo, sovrasta da solo tutti gli altri contributi, e da lì in poi la risposta della rete non ha più niente a che vedere con l’immagine che ha davanti.
Qualcuno è andato a misurarlo. Hong e colleghi hanno ribaltato i bit di diciannove reti addestrate [HFK+19]: uno per uno e in tutte e due le direzioni sulle otto più piccole, a campione sulle più grandi, dove provarli tutti non si poteva (per una sola rete da 138 milioni di parametri il conto completo avrebbe richiesto più di due anni e mezzo di calcolo). Il risultato è netto. Il danno indiscriminato viene dai bit dell’esponente, e in una sola direzione, da \(0\) a \(1\), quella che fa crescere il numero; il bit del segno, che ribalta il verso di un peso senza toccarne la taglia, non produce danni sistematici. E tutte e diciannove le reti avevano almeno un parametro capace, da solo, di spazzare via oltre il novanta per cento dell’accuratezza.
Per una ResNet50 (una rete per il riconoscimento di immagini, fra le più usate come termine di paragone) vuol dire scendere dal suo \(76\%\) di risposte corrette su ImageNet, la raccolta di fotografie etichettate su cui si misurano questi modelli, a meno dell’otto per cento: un bit solo, e la rete non riconosce quasi più niente.
La differenza rispetto al software tradizionale è che qui non si vede. Un bit sbagliato in un programma normale di solito produce un crash o un risultato palesemente assurdo; in una rete produce una risposta plausibile e sbagliata, indistinguibile da una risposta giusta se non si conosce quella giusta. È il motivo per cui il tema ha un nome tutto suo, corruzione silenziosa dei dati, e per cui la robustezza di un sistema di ML ha due facce distinte. C’è quella ai dati, che a sua volta si sdoppia: il mondo può cambiare sotto il modello (è la deriva, e ne parla Quando i dati cambiano) oppure qualcuno può sottoporgli apposta immagini costruite per ingannarlo (sono gli esempi avversari, e ne parla Privacy e robustezza). E c’è quella all’hardware, che non riguarda il modello ma il silicio su cui gira.
Overflow e underflow: i bordi del mondo rappresentabile#
Il budget di cifre ha due confini. Oltre il più grande numero rappresentabile si va in overflow (il risultato diventa \(\pm\infty\)); sotto il più piccolo si va in underflow (il risultato collassa a \(0\)).
È come un contachilometri con un numero fisso di caselle: superato il massimo,
il valore «sballa». Il formato a trentadue caselle, il float32, arriva a
circa \(3{,}4\cdot10^{38}\), un \(34\) seguito da trentasette zeri: sembra enorme,
e invece basta chiedere la crescita esponenziale \(e^{89}\) per sfondarlo,
perché quella cresce in un modo che le nostre intuizioni non seguono. Basta
\(89\), non un milione.
All’estremo opposto, \(e^{-120}\) è così vicino a zero che un float32 lo
registra proprio come \(0\): non «molto piccolo», proprio zero. Il guaio arriva
subito dopo, perché ci sono due operazioni che con lo zero non si possono
fare. Se dividi per quel numero diventato zero, il risultato è infinito; se
ne fai il logaritmo, cioè chiedi «a che esponente devo elevare per
ottenere zero», la risposta non esiste. In entrambi i casi esce infinito o
NaN, e da lì in poi ogni conto che tocca quel valore diventa NaN a sua
volta: l’addestramento si rompe, e spesso senza dire dove.
A zero non si arriva solo con numeri estremi come \(e^{-120}\): bastano tante
moltiplicazioni per numeri più piccoli di uno. La probabilità di ottenere
duecento teste di fila lanciando una moneta è un prodotto di duecento fattori
\(0{,}5\); il risultato vero è un numero minuscolo e positivo, eppure un
float32 registra zero tondo, senza avvisare. La difesa usa la notazione
scientifica di prima: invece di moltiplicare i numeri, si sommano i loro «per
dieci alla…», e duecento dimezzamenti diventano un esponente di circa \(-60\),
un numero qualunque, che si scrive senza fatica. Il conto è lo stesso, fatto
per una strada che non passa mai da quantità fuori portata.
Per float32 l’estremo superiore è \(\approx 3{,}40\cdot10^{38}\) e il più
piccolo positivo normalizzato è \(\approx 1{,}18\cdot10^{-38}\). Poiché
\(\exp\) compare ovunque (softmax, verosimiglianze gaussiane, funzioni di
partizione), è la sorgente tipica di overflow: \(e^{z}\) supera il limite già per
\(z \gtrsim 88{,}7\). L’underflow è insidioso perché silenzioso: un prodotto di
molte probabilità, \(\prod_i p_i\) con \(p_i < 1\), tende esponenzialmente a zero e
sparisce senza segnalazioni. La difesa standard è lavorare nel dominio
logaritmico, dove i prodotti diventano somme.
Il trucco log-sum-exp#
La softmax trasforma i punteggi grezzi che escono dagli ultimi strati di un
modello che sceglie fra alternative (i logit, logaritmi delle probabilità a
meno di una costante) in una distribuzione di probabilità: componenti positive
e somma uno. Contiene esponenziali, che in float32 vanno in overflow già per
punteggi sopra \(88{,}7\). Una riscrittura esatta lo evita.
La softmax risponde alla domanda «che quota di probabilità spetta a ciascuna classe?», e la ricetta è: eleva \(e\) a ciascun punteggio, poi dividi ognuno di quei risultati per la loro somma, così il totale fa uno.
Se i punteggi sono \(1000\), \(1001\) e \(1002\) la ricetta fallisce, perché
\(e^{1000}\) è ben oltre quello che un float32 sa scrivere: tre overflow, e
il conto si arrende.
Ma c’è una scappatoia, e sta nel fatto che alla fine si divide. Se moltiplico tutti e tre gli esponenziali per uno stesso numero, sopra e sotto la frazione compare lo stesso fattore e le quote non cambiano: è la stessa ragione per cui \(\tfrac{2}{4}\) e \(\tfrac{20}{40}\) sono lo stesso numero. Ora, moltiplicare tutti gli \(e^{z}\) per una stessa quantità equivale a sottrarre uno stesso numero a tutti i punteggi prima di esponenziare, perché è così che si comportano le potenze. Sottraendo il massimo, \(1002\), i punteggi diventano \((-2,\ -1,\ 0)\), e adesso gli esponenziali sono tre numeri comodissimi: \(e^{-2}=0{,}135\), \(e^{-1}=0{,}368\), \(e^{0}=1\). La loro somma fa \(1{,}503\), e dividendo ciascuno per la somma vengono le tre probabilità: \(9{,}0\%\), \(24{,}5\%\) e \(66{,}5\%\). Sono quelle che sarebbero uscite dal conto impossibile di prima, e adesso il conto si può fare. Sottrarre il massimo prima di esponenziare: tutto qui.
La softmax è
dove \(\mathbf{z}\) è il vettore dei logit e \(z_i\) la sua componente \(i\)-esima. Sia \(m = \max_j z_j\). Moltiplicando numeratore e denominatore per \(e^{-m}\) il valore non cambia, ma ogni esponente diventa \(\le 0\):
La stessa mossa stabilizza il logaritmo della somma di esponenziali, l’identità log-sum-exp:
Da qui la log-probabilità della classe corretta,
\(\log \hat{p}_i = z_i - \operatorname{logsumexp}(\mathbf{z})\), si calcola senza mai
formare \(e^{z_i}\) crudo; la cross-entropy è semplicemente il suo opposto,
\(\operatorname{logsumexp}(\mathbf{z}) - z_i\). È per stabilità numerica, e non
per pigrizia d’API, che i framework espongono log_softmax e loss che
lavorano direttamente sui logit (come la nn.CrossEntropyLoss di PyTorch,
che torna nella sezione sul training loop).
Arrotondamento e cancellazione#
Ogni operazione arrotonda, e di solito l’errore relativo resta dell’ordine dell’epsilon macchina. La cancellazione fa eccezione: sottraendo due numeri quasi uguali le cifre significative comuni si annullano, e l’errore che i due operandi già portavano diventa grande rispetto al risultato.
Si pesa un capitano con la sua barca (\(80\,000\) kg), poi si pesa la sola barca (\(79\,930\) kg), ciascuna misura accurata al chilo. La differenza (il peso del capitano) è \(70\) kg, ma l’incertezza di un chilo su ciascuna misura ora pesa tantissimo in proporzione. Le cifre affidabili si sono «cancellate»: l’errore possibile, due chili su settanta, in proporzione è migliaia di volte più grande di quello delle due pesate. Al posto del capitano metti un gabbiano, e succede di peggio: due pesate sbagliate di un chilo in versi opposti possono dare una differenza sotto zero, cioè un peso negativo, una risposta impossibile. La via d’uscita esiste: il capitano sale sulla bilancia da solo, una pesata sola e l’errore torna a un chilo su settanta. In pratica: evita di calcolare una quantità piccola come differenza di due quantità grandi; quando puoi, misura direttamente la cosa piccola.
Il caso da manuale è la varianza stimata da un campione (si scrive \(s^2\), ed è lo stimatore della sezione su probabilità e statistica, non la \(\mathrm{Var}(X)\) della distribuzione) calcolata con la formula «ingenua» \(s^2 \propto \overline{x^2}-\bar{x}^2\): con dati grandi e varianza piccola i due termini sono quasi uguali e la sottrazione perde quasi tutte le cifre significative (può perfino dare un valore negativo). Le librerie evitano la formula ingenua: NumPy calcola prima la media e poi la media degli scarti quadratici, in due passate; quando i dati arrivano in flusso e di passata se ne può fare una sola, si usa l’algoritmo di Welford, numericamente stabile. Regola generale: riformula le espressioni per non sottrarre grandezze vicine; la stessa quantità matematica può perdere molte o poche cifre a seconda di come la si calcola. La ragione sta in una riga. Se \(\tilde{x}=x(1+\delta_1)\) e \(\tilde{y}=y(1+\delta_2)\), con \(|\delta_i|\le u\), allora
e il fattore \((|x|+|y|)/|x-y|\) è il numero di condizionamento della
sottrazione: per le due pesate della barca vale \(159\,930/70\approx 2\,300\).
La sottrazione di per sé non sbaglia (per il lemma di Sterbenz, due numeri in
virgola mobile entro un fattore due l’uno dall’altro si sottraggono
esattamente): amplifica l’errore che gli operandi portano già. Per la stessa
ragione le librerie offrono log1p(x) ed expm1(x), che calcolano
\(\log(1+x)\) ed \(e^x-1\) per \(x\) piccolo senza formare \(1+x\), ed è con loro che si
scrivono in modo stabile la softplus e la perdita logistica.
Lo stesso programma, due calcolatori, due risultati#
Stesso codice, stessi dati, stesso seme del generatore casuale, librerie alla stessa versione fino all’ultima cifra: su due calcolatori diversi i numeri stampati possono non combaciare. Quasi sempre la differenza resta in fondo, nella quindicesima o sedicesima cifra significativa. Se arriva alle prime cifre, serve capire da dove viene. Il fenomeno si riproduce anche su una macchina sola, cambiando soltanto l’ordine in cui si somma, perché l’addizione in virgola mobile non è associativa: \((a+b)+c\) e \(a+(b+c)\) sono lo stesso numero in matematica e in generale due numeri diversi nel calcolatore, perché ogni somma parziale viene arrotondata e le somme parziali dei due ordini sono diverse.
import numpy as np

def in_fila(valori):
    """Somma uno dopo l’altro, senza correzioni: è quello che fa un ciclo."""
    totale = 0.0
    for v in valori:
        totale += v
    return totale

x = np.random.default_rng(0).random(10_000).tolist()

avanti = in_fila(x)                # gli stessi diecimila numeri...
indietro = in_fila(reversed(x))    # ...sommati dall’ultimo al primo

print(f"in avanti:    {avanti!r}")
print(f"all’indietro: {indietro!r}")
print("uguali?", avanti == indietro)
print(f"differenza:   {abs(avanti - indietro):.3e}")
in avanti:    4994.106600608079
all’indietro: 4994.106600608084
uguali? False
differenza:   4.547e-12
Gli addendi sono gli stessi e cambia solo l’ordine: i due totali differiscono
di \(4{,}5\cdot10^{-12}\), cioè di cinque unità dell’ultima cifra. (Il ciclo è
scritto a mano per una ragione: da Python 3.12 la funzione sum() applica ai
numeri in virgola mobile la somma compensata di Neumaier, che recupera le cifre
perse, e con lei i due totali tornerebbero uguali.)
Resta da spiegare perché due calcolatori dovrebbero sommare in ordine diverso, visto che il programma è lo stesso.
Un negozio vende a peso, con prezzi al millesimo di euro, e deve totalizzare uno scontrino lunghissimo; la cassa arrotonda al centesimo ogni volta che aggiorna un totale. Due cassiere fanno lo stesso conto in due modi. La prima somma gli articoli uno dopo l’altro, tenendo un totale solo. La seconda divide lo scontrino in otto colonne, fa il totale di ogni colonna e alla fine somma gli otto totali. Stessi prezzi, e perfino lo stesso numero di addizioni; ma gli arrotondamenti non cadono negli stessi punti, e i due totali possono differire di un centesimo.
Nel calcolatore i centesimi sono l’ultima cifra che il formato riesce a tenere, e a decidere in quante colonne si divide la somma è il processore: le sue istruzioni lavorano su due, quattro o otto numeri per volta, e la libreria di calcolo, appena parte, sceglie la versione fatta apposta per il processore che si trova sotto. Quella versione ha un nome: si chiama kernel, la stessa parola che il capitolo sulle GPU userà per il programma che gira sulla scheda grafica. Il senso è quello: un pezzo di codice specializzato per la macchina su cui deve girare.
Una libreria di algebra lineare non contiene una sola implementazione di ciascuna routine: ne contiene molte, compilate ciascuna per un insieme di istruzioni vettoriali, cioè per una delle SIMD di cui parla la sezione su NumPy. Su un processore x86 sono generazioni successive, e a distinguerle è la larghezza dei registri su cui lavorano: 128 bit per SSE2, 256 per AVX2, 512 per AVX-512 (solo in quest’ultimo il numero nel nome è la larghezza; negli altri due indica la generazione). In doppia precisione vuol dire due, quattro e otto numeri per istruzione.
Al caricamento la libreria sceglie la variante adatta a quello che la CPU
dichiara di saper fare: in OpenBLAS il meccanismo si chiama DYNAMIC_ARCH.
Fa lo stesso PyTorch, la libreria con cui si
addestrano le reti neurali da lì in avanti: anche lui smista le proprie
operazioni su CPU fra più varianti compilate.
La larghezza dei registri decide quanti accumulatori parziali la riduzione tiene aperti insieme: sommare \(N\) numeri con quattro accumulatori è un albero di somme diverso dal sommarli con otto, e due alberi diversi arrotondano in punti diversi. Lo standard IEEE 754 garantisce che ogni singola operazione sia arrotondata correttamente, non che una riduzione abbia un ordine canonico; per la stessa ragione conta anche il numero di thread, perché una riduzione parallela spezza la somma in tanti pezzi quanti sono gli esecutori.
La scelta si può fissare dall’esterno, con OPENBLAS_CORETYPE per OpenBLAS e
ATEN_CPU_CAPABILITY per le operazioni su CPU di PyTorch, e fissarla rimette
d’accordo la parte di conto che passa da quelle due strade.
Fissare queste variabili non basta però a garantire l’accordo in generale. I
prodotti fra matrici di PyTorch su CPU x86, che sono la parte di calcolo che
conta di più, non passano da OpenBLAS ma da Intel MKL, che ignora quelle
variabili e usa le proprie (per la riproducibilità condizionale, MKL_CBWR); e
basta una terza macchina, con le stesse variabili fissate, perché l’ultima
cifra ricominci a discostarsi. La riproducibilità bit a bit fra calcolatori
diversi non è una casella da spuntare: si perde di nuovo appena un pezzo del
conto sceglie una strada per conto proprio, e per questo due esecuzioni su
macchine diverse si confrontano con una tolleranza, non con l’uguaglianza.
Quanto può cambiare, una somma, cambiando ordine? Nel caso peggiore l’errore
della somma in fila di \(n\) numeri è al più circa \((n-1)\,u\sum_i|x_i|\); la
somma a coppie, che è quella di np.sum, lo riduce a circa
\(\log_2 n\cdot u\sum_i|x_i|\), e la somma compensata (Kahan, Neumaier) a circa
\(2u\,|s|\) più termini di ordine \(u^2\), indipendente da \(n\)
[Hig02]. Con i diecimila numeri del blocco, la cui somma dei
valori assoluti è circa \(5\cdot10^3\), il caso peggiore in fila sarebbe
\(5\cdot10^{-9}\); la differenza misurata è \(4{,}5\cdot10^{-12}\).
Una differenza nella sedicesima cifra è quasi sempre irrilevante. Smette di esserlo quando il numero serve da ingresso a un calcolo lungo che amplifica le differenze. La discesa del gradiente su una funzione convessa le smorza: due traiettorie partite a distanza \(10^{-16}\) restano a quella distanza. Nell’addestramento di una rete, che non è convesso, possono invece separarsi di molti ordini di grandezza in migliaia di passi, e due esecuzioni con lo stesso codice e gli stessi dati arrivano a pesi che differiscono molto più dell’ultima cifra.
Da qui tre abitudini che costano poco. Un numero che esce da un calcolo lungo
si racconta con le cifre che reggono, non con tutte quelle che il calcolatore
stampa. Due risultati in virgola mobile non si confrontano con == ma con una
tolleranza dichiarata, che np.allclose prende come argomento. E le cifre
di un residuo di arrotondamento non si leggono come un risultato: un residuo
dell’ordine di \(10^{-16}\) vuol dire zero, a meno dell’epsilon macchina, e le
sue cifre sono l’impronta del processore su cui è girato il conto, non
un’informazione sul problema.
Condizionamento: quanto un problema amplifica gli errori#
Il condizionamento misura quanto un problema amplifica le perturbazioni dell’input. Un problema è ben condizionato se a piccole variazioni dell’input corrispondono piccole variazioni dell’output, mal condizionato se le amplifica molto. È una proprietà del problema e non dell’algoritmo: la cancellazione ne è un esempio (la sottrazione di numeri vicini è mal condizionata), mentre l’overflow della softmax è un difetto dell’algoritmo.
La bilancia del capitano e della barca risponde a due domande molto diverse. Se ti chiedo quanto pesa la barca, un chilo di errore sulla misura ti dà un chilo di errore sulla risposta: un chilo su ottantamila è lo \(0{,}00125\%\), cioè poco più di un millesimo di punto percentuale, e la domanda è ben condizionata.
Se ti chiedo quanto pesa il capitano, invece, la risposta la ricavo da due pesate, e le due imprecisioni si sommano: nel caso peggiore sbaglio di un chilo in un verso sulla prima e di un chilo nell’altro sulla seconda, cioè di due chili sulla differenza. Due chili su settanta sono il due virgola nove per cento. La stessa imprecisione, sulla stessa bilancia, in proporzione pesa più di duemila volte tanto (\(2{,}9\) diviso \(0{,}00125\) fa circa \(2\,300\)). Non è colpa di chi fa i conti né della bilancia: è la domanda a essere fatta male.
Quando un risultato numerico esce sbagliato, le cause possibili sono due e si confondono spesso. Una è che il problema amplifichi gli errori per conto suo, e allora non c’è programma che tenga: bisogna cambiare domanda. L’altra è che il programma sia scritto male e ne introduca di suoi, e allora si riscrive il programma (la softmax senza il trucco del massimo è esattamente questo). La regola «evita di calcolare una quantità piccola come differenza di due quantità grandi» funziona nei due modi: se le due quantità sono dati misurati, come le due pesate, la cura è cambiare misura (pesare il capitano da solo); se sono risultati intermedi del programma, la cura è riscrivere il programma. Standardizzare i dati è una cura del primo tipo, il trucco del massimo nella softmax del secondo.
Su un problema mal condizionato anche il codice perfetto fatica, perché eredita l’errore di arrotondamento già presente negli input. Per un sistema lineare \(\mathbf{A}\mathbf{x} = \mathbf{b}\) lo si misura con il numero di condizionamento di \(\mathbf{A}\), il rapporto tra la massima e la minima «amplificazione» che la matrice può imprimere a un vettore. In norma \(2\) è
il rapporto fra il più grande e il più piccolo dei valori singolari della
sezione di algebra lineare. La precisazione «in norma \(2\)» serve, perché
\(\kappa(\mathbf{A}) = \lVert\mathbf{A}\rVert\,\lVert\mathbf{A}^{-1}\rVert\)
dipende dalla norma scelta, e su
\(\mathbf{A}=\begin{pmatrix}1&2\\3&4\end{pmatrix}\) vale \(14{,}9\) in norma \(2\) e
\(21\) in norma \(1\). np.linalg.cond restituisce il primo solo perché è il
default; LAPACK stima abitualmente il secondo, che costa meno. Il valore
cambia, il significato no, e sta in una disuguaglianza. Se il termine noto è
perturbato, \(\mathbf{A}(\mathbf{x}+\delta\mathbf{x})=\mathbf{b}+\delta\mathbf{b}\),
allora
Bastano due righe: \(\delta\mathbf{x}=\mathbf{A}^{-1}\delta\mathbf{b}\) dà
\(\lVert\delta\mathbf{x}\rVert\le\lVert\mathbf{A}^{-1}\rVert\,\lVert\delta\mathbf{b}\rVert\),
e \(\mathbf{b}=\mathbf{A}\mathbf{x}\) dà
\(\lVert\mathbf{b}\rVert\le\lVert\mathbf{A}\rVert\,\lVert\mathbf{x}\rVert\); si
dividono membro a membro. In norma \(2\) la maggiorazione è raggiunta, con
\(\mathbf{b}\) lungo il vettore singolare sinistro di \(\sigma_{\max}\) e
\(\delta\mathbf{b}\) lungo quello di \(\sigma_{\min}\). Poiché gli ingressi portano
già un errore relativo dell’ordine di \(u\), se ne ricava la regola pratica: si
perdono circa \(\log_{10}\kappa\) cifre decimali. Con \(\kappa=10^{8}\) un
float64 ne conserva otto, un float32 nessuna. È il conto che fa preferire
la QR alle equazioni normali, dove \(\kappa\) si eleva al quadrato.
L’altra metà del binomio riguarda invece l’algoritmo, e senza di essa un lettore attribuisce al problema ogni guaio numerico. Un algoritmo si dice stabile all’indietro (backward stable) se il risultato che produce è la soluzione esatta di un problema di poco perturbato rispetto a quello dato. La regola che tiene insieme le due cose: se l’algoritmo restituisce una \(\hat{\mathbf{x}}\) che risolve esattamente \((\mathbf{A}+\delta\mathbf{A})\hat{\mathbf{x}}=\mathbf{b}\), con errore all’indietro \(\eta=\lVert\delta\mathbf{A}\rVert/\lVert\mathbf{A}\rVert\), allora, finché \(\kappa\eta\ll 1\),
Un algoritmo stabile all’indietro ha \(\eta=O(u)\): la fattorizzazione QR di Householder lo è sempre, l’eliminazione di Gauss con pivoting parziale lo è in pratica. Con loro l’errore relativo finale è dell’ordine di \(\kappa(\mathbf{A})\,u\), e per fare di meglio bisogna cambiare problema oppure calcolare il residuo in precisione più alta, come fa il raffinamento iterativo [Hig02].
Sono due cause indipendenti. Welford e il log-sum-exp curano la seconda, non la prima; standardizzare i dati cura la prima, non la seconda.
Perché normalizzare i dati aiuta#
Il condizionamento ha una conseguenza pratica immediata: la standardizzazione dei dati prima dell’addestramento.
L’appartamento di sempre, descritto questa volta dal valore catastale in euro, dai metri quadri e dal numero di stanze, porta con sé un problema che non si vede a occhio: quei tre numeri vivono su scale lontanissime. Il valore catastale è nell’ordine delle centinaia di migliaia, le stanze sono tre. Ciascuna di queste caratteristiche (in gergo si dicono feature, «caratteristiche» appunto) parla una lingua sua.
Per il modello è un guaio, ed è esattamente il guaio del condizionamento appena visto. Il modello moltiplica ogni caratteristica per un peso, e il peso è una delle sue manopole. Ma il valore catastale arriva in centinaia di migliaia, quindi al suo peso basta muoversi di un pelo perché il risultato cambi moltissimo; il numero di stanze arriva in unità, quindi al suo peso tocca muoversi parecchio per farsi sentire. Una manopola sensibilissima e una insensibile, da regolare insieme e con lo stesso passo: è come cercare il fondo di una valle lunga trenta chilometri e larga dieci metri, dove la direzione più ripida punta quasi sempre contro la parete più vicina e non verso il fondo, e la discesa del gradiente della sezione sull’analisi passa il tempo a rimbalzare da un fianco all’altro invece di avanzare (Fig. 3.30).
Il rimedio si chiama standardizzare e consiste in due gesti su ciascuna colonna di dati, presa una alla volta: togliere a tutti i valori la loro media, così che il nuovo centro sia lo zero, e poi dividerli tutti per lo scarto tipico, così che sparpagliamenti diversi diventino confrontabili. Alla fine ogni caratteristica è centrata sullo zero e larga circa uno, e gli euro del valore catastale e il numero di stanze sono finalmente sulla stessa scala. La valle diventa molto più tonda e la discesa punta quasi dritta al fondo.
Non è una cura completa. Mette tutte le caratteristiche sulla stessa scala, ma non cambia il modo in cui si somigliano fra loro: se due di esse crescono e calano quasi sempre insieme (i metri quadri e il numero di stanze, per dire) la valle resta un po’ storta e qualche zig-zag la discesa lo fa ancora. Resta il rimedio più economico che ci sia: due righe di codice.
Prima di dare i dati a un modello quasi sempre li standardizziamo, sottraendo la media e dividendo per la deviazione standard: al posto di ogni valore \(x\) si scrive \((x - \mu)/\sigma\), dove \(\mu\) e \(\sigma\) sono la media e la deviazione standard della colonna. Così ogni caratteristica (feature) ha media \(0\) e scala \(1\). Il motivo è il condizionamento: è un intervento sul problema, non sull’algoritmo.
Se una feature vale in migliaia di euro e un’altra in numero di stanze, i loro prodotti dentro la rete stanno su scale lontanissime (invito all’overflow) e la superficie della loss si allunga in una valle stretta, mal condizionata. La discesa del gradiente vi rimbalza da una parete all’altra a zig-zag, convergendo con lentezza esasperante. Standardizzare rende le curve di livello molto più tonde: il gradiente punta quasi dritto verso il minimo (Fig. 3.30). Detto con il numero di condizionamento: per un modello lineare con \(m\) esempi e perdita \(\frac{1}{2m}\lVert\mathbf{X}\mathbf{w}-\mathbf{y}\rVert^2\) l’hessiana è \(\mathbf{X}^\top\mathbf{X}/m\), e dopo la standardizzazione diventa la matrice di correlazione delle feature, con diagonale di soli \(1\) (senza il \(\tfrac12\) è il doppio, e \(\kappa\) non cambia). Il suo \(\kappa=\lambda_{\max}/\lambda_{\min}\) fissa il fattore di contrazione \((\kappa-1)/(\kappa+1)\) della discesa del gradiente visto nella sezione su analisi e ottimizzazione. Un teorema di van der Sluis dimostra che questa riduzione, per quanto non garantisca l’ottimo, vi si avvicina molto: fra tutte le riscalature diagonali delle colonne di \(\mathbf{X}\) (già centrate), quella che le rende di norma uguale ha un \(\kappa_2(\mathbf{X})\) al più \(\sqrt{p}\) volte l’ottimo, dove \(p\) è il numero di colonne. Se ne ricava un’hessiana con \(\kappa\) al più \(p\) volte l’ottimo, perché \(\kappa(\mathbf{X}^\top\mathbf{X})=\kappa_2(\mathbf{X})^2\) [Hig02].
Non è una cura completa, perché mette tutte le feature sulla stessa scala ma non cambia la loro correlazione: se due di esse crescono e calano quasi sempre insieme, la matrice resta mal condizionata fuori dagli assi, la valle resta un po’ storta e qualche zig-zag la discesa lo fa ancora (a togliere anche quella servirebbe una trasformazione che decorrela, come lo sbiancamento). Resta il rimedio più economico che ci sia: due righe di codice, e il problema è molto meglio condizionato di prima. Una sola avvertenza operativa: media e deviazione standard si calcolano sul solo training set e si riusano tali e quali su validazione e test, altrimenti si travasa nell’addestramento un’informazione che al momento della previsione non ci sarebbe.

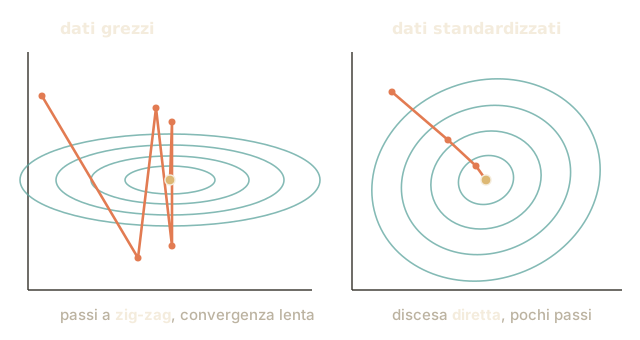
Fig. 3.30 Con dati grezzi (sinistra) la loss forma una valle stretta e il gradiente rimbalza a zig-zag; standardizzando (destra) le curve di livello diventano molto più tonde e la discesa punta quasi dritta al minimo.#
Con tre appartamenti in tabella (una riga per appartamento, una colonna per
caratteristica), la standardizzazione è una riga di scikit-learn:
import numpy as np
from sklearn.preprocessing import StandardScaler

# tre feature su scale lontanissime: valore catastale in euro, metri quadri,
# numero di stanze
X = np.array([[250_000, 75, 3], [180_000, 62, 2], [410_000, 120, 5]])

scaler = StandardScaler()
X_std = scaler.fit_transform(X)   # ogni colonna: media 0, deviazione std 1
print(X_std.round(2))
# -> [[-0.31 -0.43 -0.27]
#     [-1.04 -0.95 -1.07]
#     [ 1.35  1.38  1.34]]
Le tre colonne, che prima andavano da \(2\) a \(410\,000\), ora vivono tutte nello stesso intervallo: il valore catastale non domina più il conto solo perché è scritto in euro.
Da ricordare
Un calcolatore non conserva i numeri con tutte le loro cifre, ma con un numero fisso di caselle: per questo
0.1 + 0.2non fa esattamente0.3, e per questo esistono un numero troppo grande da scrivere (si va in overflow) e uno troppo piccolo, che diventa zero (underflow).Le caselle si dividono fra portata (fin dove si arriva) e precisione (con quante cifre): darne di più all’una vuol dire darne di meno all’altra, ed è la scelta che distingue i formati ridotti fra loro.
Due conti si riscrivono sempre nello stesso modo, per non uscire di strada: la softmax si calcola sottraendo prima il punteggio più grande (log-sum-exp), e le quantità piccole non si ricavano mai come differenza di due quantità grandi (la barca e il capitano).
Standardizzare i dati, cioè portare ogni caratteristica a centro zero e larghezza uno, rende la valle da scendere più tonda, e quindi la discesa più svelta.
Lo stesso programma, sugli stessi dati, può stampare ultime cifre diverse su due calcolatori diversi, e non è un guasto: cambia l’ordine in cui il processore somma. Un numero che cambia solo in fondo di solito non è cambiato, a meno che non serva da ingresso a un calcolo lungo che amplifica le differenze.
Da ricordare
I numeri in virgola mobile hanno precisione finita:
0.1 + 0.2non fa esattamente0.3, ed esiste un limite oltre il quale si va in overflow o underflow.La softmax e le verosimiglianze si calcolano nel dominio logaritmico con il trucco log-sum-exp (sottrai il massimo) per evitare che gli esponenziali straripino.
Condizionamento e stabilità sono due cause indipendenti di un risultato sbagliato: il primo è del problema (\(\kappa_2 = \sigma_{\max}/\sigma_{\min}\)), la seconda dell’algoritmo, e finché il loro prodotto resta piccolo l’errore finale è circa \(\kappa\) per l’errore all’indietro.
Standardizzare i dati non è solo buona educazione statistica: riduce il condizionamento del problema e fa convergere l’ottimizzazione molto più in fretta.
L’addizione in virgola mobile non è associativa: l’ordine della riduzione dipende dal kernel che la libreria sceglie per la CPU e dal numero di thread, quindi la riproducibilità bit a bit fra macchine diverse non è garantita. Due risultati si confrontano con una tolleranza, non con
==.
Con l’analisi numerica gli attrezzi sono al completo. Resta da vederli lavorare insieme su un oggetto solo, un modello linguistico.