


Dentro la GPU: come è fatta e come esegue#
Nel 1999 NVIDIA lanciò la GeForce 256 e la vendette come «la prima GPU al mondo»: da lì in poi Graphics Processing Unit è il nome con cui chiamiamo questi chip. Il compito era disegnare i mondi dei videogiochi: milioni di punti da spostare e milioni di pixel da colorare, sessanta volte al secondo. Se il personaggio gira la testa, ogni singolo punto della sua sagoma va spostato dove la rotazione lo manda: lo stesso conto, per centinaia di migliaia di punti, uno indipendente dall’altro. Nessuno di quei conti è difficile; sono soltanto tantissimi.
Da qui la scommessa costruttiva opposta a quella delle CPU. Una CPU è fatta per finire in fretta un programma, cioè per correre lungo un’unica fila di istruzioni, e per questo i suoi core sono pochi e complicati. I progettisti delle GPU ne misero migliaia, ciascuno lento e limitato, tutti attivi nello stesso istante.
Di quella folla, che la sezione «Prestazioni e scala» chiamava una squadra di operai semplici, qui si guarda com’è fatta dentro e, soprattutto, come esegue il codice: la velocità non viene dal singolo operaio, che è lento, ma da come gli operai sono organizzati in squadre e da come si coprono a vicenda i tempi morti.
Due filosofie: latenza e throughput#
CPU e GPU risolvono lo stesso problema di fondo (far girare istruzioni su dati) partendo da due domande diverse. La CPU chiede: «come faccio a finire questo compito il prima possibile?». La GPU chiede: «come faccio a finire il maggior numero di compiti per unità di tempo?». Le due domande hanno un nome ciascuna, e li useremo per tutto il capitolo: la prima è la latenza, cioè quanto si aspetta perché una singola cosa sia pronta; la seconda è il throughput, cioè quante cose vengono fuori in un’ora. Ottimizzare l’una spesso significa sacrificare l’altro.
Una lepre e un formicaio devono consegnare dei pacchi. La lepre è velocissima: prende un pacco, sfreccia, lo consegna, torna indietro, ne prende un altro. Se hai un pacco urgente, la lepre è imbattibile. Ma se ne hai diecimila, quella corsa avanti e indietro non basta più. Il formicaio funziona all’opposto: ogni formica è lenta, ma sono migliaia e partono tutte insieme. Il primo pacco arriverà un po’ più tardi che con la lepre (nessuna formica è veloce) ma nello stesso tempo ne arrivano diecimila. La lepre ha la latenza più bassa (il singolo pacco arriva prestissimo), il formicaio il throughput più alto (nella giornata ne arrivano molti di più).
Perché allora non si tengono diecimila lepri? Perché una lepre costa. Le servono le gambe lunghe, la memoria di tutte le scorciatoie, una borsa di attrezzi per quando la strada è chiusa: roba da portarsi dietro e da nutrire. Una formica non ha niente di tutto questo, e proprio per questo nello stesso formicaio ce ne stanno migliaia. Lo spazio è quello, e si spende in un modo o nell’altro: o poche lepri attrezzate, o una folla di operaie spoglie che sanno fare una cosa sola.
Il formicaio ha poi un vantaggio che si vede solo quando qualcosa va storto. Una formica che trova una pozzanghera si ferma ad aspettare che scoli, ma nessuno la aspetta: le altre le passano avanti, la fila continua, e a sera i pacchi consegnati sono più o meno gli stessi. Il tempo perso da quella formica c’è tutto, ma nel conto della giornata non si vede. La lepre davanti alla stessa pozzanghera tira fuori i suoi attrezzi e prova a passare lo stesso; quando non le riesce, si ferma la consegna, perché di lepri ce n’è una.
La CPU è la lepre: pochi processori potentissimi, pensati per finire in fretta il singolo compito. La GPU è il formicaio: tante unità lente, pensate per smaltire una montagna di compiti tutti insieme. Per aprire un file o rispondere a un clic vuoi la lepre; per fare i centoventotto milioni di conti tutti uguali di un solo strato di una rete, vuoi il formicaio.
Una CPU è latency-oriented: pochi core (da qualche unità a qualche centinaio sui processori da server, ciascuno con unità vettoriali SIMD fino a 512 bit), ma complessi, con grandi cache per tenere i dati vicini, predizione dei salti ed esecuzione fuori ordine per non fermarsi mai su un singolo flusso di istruzioni. Gran parte del silicio è spesa in logica di controllo e memoria, non in unità di calcolo. Una GPU è throughput-oriented: rovescia il bilancio. Il silicio va quasi tutto in ALU (le unità aritmetiche, i «CUDA core»), pochissimo in controllo e cache per core. Il singolo thread è lento e non ha trucchi per nascondere le proprie attese; la GPU nasconde la latenza in un altro modo, statisticamente: tiene moltissimi thread pronti e, quando uno si ferma in attesa di un dato dalla memoria, ne fa partire un altro già pronto. Non accorcia l’attesa del singolo: la copre con il lavoro degli altri. È una scelta sensata solo se il problema offre parallelismo a valanga, ed è esattamente il caso delle reti neurali: come richiamato nella sezione «Prestazioni e scala», il prodotto di due matrici \((M,K)\) e \((K,N)\) costa circa \(2MNK\) operazioni, raccolte in \(MN\) prodotti scalari indipendenti l’uno dall’altro (dentro ciascuno le \(K\) somme restano una catena, che si accorcia a profondità \(\log_2 K\) solo sommando ad albero).
Lo Streaming Multiprocessor: le unità in cui la GPU è divisa#
Vista da lontano, una GPU sembra un blocco unico. Da vicino è un insieme di unità quasi autonome, gli Streaming Multiprocessor (SM), ciascuna delle quali esegue per conto suo una parte del lavoro. Una GPU moderna ne ha da qualche decina a oltre un centinaio, e la sua potenza cresce, prima di tutto, moltiplicando gli SM.
Prima di aprirne uno serve una distinzione, su cui si regge tutto il resto. Le ALU (le unità aritmetiche, quelle che eseguono materialmente una moltiplicazione o una somma) sono circuiti, in numero fisso, stampati nel silicio: migliaia per chip. Un thread è invece un compito: «occupati tu del numero in posizione 4173». La parola inglese vuol dire «filo», ed è un filo di lavoro da sbrogliare, non qualcosa che si possa toccare. Una GPU ha migliaia di ALU e centinaia di migliaia di thread in carico, cioè qualche decina di compiti per ogni ALU, ed è proprio da quell’eccedenza che verrà il trucco che tiene la macchina sempre occupata.
Quella parola, però, ha già fatto un altro mestiere. Nelle basi di Python i thread erano i cuochi che si contendono un coltello solo: una manciata, ciascuno con la propria fila di istruzioni, e la morale era che per i calcoli scritti in Python non servivano a niente. Qui sono centinaia di migliaia, la fila di istruzioni la ricevono a gruppi di trentadue, e calcolare è l’unica cosa che fanno. Di là resta il nome, e cambiano tutti e tre gli altri: quanti sono, come ricevono gli ordini, e a che cosa servono.
Ogni SM è una piccola macchina completa, e contiene:
le ALU, che NVIDIA chiama «CUDA core» anche se non sono core completi come quelli di una CPU, ma soltanto i circuiti dove il conto avviene; sulle schede recenti, accanto a esse, ci sono anche i tensor core, unità costruite apposta per moltiplicare fra loro due piccole matrici, a cui è dedicata la sezione sul GEMM;
uno o più warp scheduler, che a ogni ciclo scelgono quale gruppo di 32 thread far avanzare (il gruppo si chiama warp, e il perché dei 32 lo spiega il modello SIMT);
un grande register file (in inglese file qui non vuol dire documento, vuol dire schedario): la memoria più veloce dell’SM, dove ogni thread tiene i numeri su cui sta lavorando in quell’istante;
la shared memory, una memoria di lavoro condivisa dai thread di uno stesso blocco, il gruppo in cui CUDA li organizza, e gestita da chi scrive il programma; la sezione sulla memoria la tratta per esteso, perché è la chiave delle prestazioni.
Gli ordini di grandezza aiutano a fissare le proporzioni, senza inseguire il numero esatto di un modello specifico (che cambia a ogni generazione): da parecchie decine a oltre un centinaio di SM per GPU, e dentro ogni SM un centinaio di ALU, per un totale di migliaia o decine di migliaia sul chip.
Da lì si ricava il picco di calcolo che compare nelle schede tecniche: il
numero di SM, per le unità di moltiplicazione-e-somma che ciascuno contiene,
per due (ogni unità fa una moltiplicazione e una somma a ogni ciclo, la
cosiddetta FMA, fused multiply-add), per la frequenza di clock. In simboli,
\(P_\text{picco} = n_\text{SM} \cdot n_\text{FMA} \cdot 2 \cdot f\), dove
\(n_\text{SM}\) è il numero di SM, \(n_\text{FMA}\) le unità di
moltiplicazione-e-somma per SM e \(f\) la frequenza. Su una NVIDIA A100, una
scheda da datacenter del 2020, si ottengono \(108 \cdot 64 \cdot 2 \cdot 1{,}41
\cdot 10^9 \approx 19{,}5 \cdot 10^{12}\) conti al secondo sui numeri float32
(quelli da quattro byte), quasi ventimila miliardi: l’ordine di grandezza che
serve alle moltiplicazioni fra matrici di cui una rete neurale è fatta.
Quei conti hanno un nome che ricorrerà per tutto il capitolo. Sono operazioni in virgola mobile, cioè conti sui numeri con la virgola, che sono quelli di cui una rete neurale è fatta; l’inglese le chiama floating-point operations e da lì viene la sigla FLOP. Un FLOP è un conto elementare, una moltiplicazione o una somma: quando serve dire quanti se ne fanno al secondo si scrive FLOP/s, e le due cose non vanno confuse, come non si confondono i chilometri con i chilometri all’ora.
La gerarchia dei thread: griglia, blocchi, warp#
Con centinaia di migliaia di thread, la vera domanda diventa organizzativa: come si dice a ciascuno che cosa fare, senza scrivere centinaia di migliaia di istruzioni diverse? La risposta di CUDA [NBGS08] è organizzarli su tre livelli: tutti i thread lanciati insieme formano la griglia, la griglia è divisa in blocchi, e ogni blocco è fatto di thread. La Fig. 8.4 li mette in fila.
In una città si fa il censimento, e bisogna bussare a tutte le porte. Il thread è il singolo rilevatore, che si occupa di una casa. Per non impazzire, i rilevatori si organizzano in squadre (i «blocchi»): quelli di una squadra lavorano nello stesso quartiere, si passano informazioni e si coordinano tra loro. Tutte le squadre insieme formano l’operazione cittadina (la «griglia»), che copre l’intera città. Il capo del censimento non dà ordini a ogni singolo rilevatore: dice «voglio una griglia di 100 squadre da 256 rilevatori l’una», e lascia che l’organizzazione si dispieghi da sola.
Dove appoggiarsi, però, le squadre non lo scelgono: c’è chi assegna ognuna a un ufficio di zona, e gli uffici di zona sono gli Streaming Multiprocessor. La squadra resta lì fino a rilevazione finita, perché è lì che tiene le sue carte e si ritrova a confrontarle. Gli uffici aperti sono quelli che sono, e in ognuno ci sta qualche squadra per volta, non di più: se gli uffici sono venti e le squadre cento, parte chi ci sta e le altre aspettano che si liberi posto. Il capo non ha bisogno di saperlo: lo stesso ordine («100 squadre da 256») funziona in un paese con due uffici e in una metropoli che ne ha centoventi, e a cambiare è quanto ci si mette, non il piano. Sulle schede più recenti c’è un livello in più, facoltativo, fra la squadra e l’operazione intera: alcune squadre vengono messe apposta in uffici confinanti, e possono guardare le carte l’una dell’altra, cosa che con un ufficio dall’altra parte della città non si può fare.
C’è poi un dettaglio che viene dall’hardware: dentro ogni squadra i rilevatori marciano in plotoni da 32 (i warp), che ricevono l’ordine tutti nello stesso istante. Una squadra da 256 rilevatori, quindi, sono otto plotoni, e i conti tornano sempre così: le squadre si scelgono di una taglia che sia un multiplo di 32, altrimenti l’ultimo plotone parte mezzo vuoto. Ricordati quel 32, perché è il battito del cuore della GPU.
Il modello di programmazione CUDA espone tre livelli:
thread: l’unità elementare, esegue il kernel (il programma che la GPU manda in esecuzione) su un proprio pezzo di dato;
block (o CTA, Cooperative Thread Array): un gruppo di thread che condividono la shared memory dell’SM e possono sincronizzarsi tra loro;
grid: l’insieme di tutti i blocchi lanciati per un kernel.
Dalle GPU Hopper in poi (compute capability 9.0) fra griglia e blocco c’è un quarto livello, facoltativo: il thread block cluster, un gruppetto di blocchi che l’hardware garantisce residenti su SM vicini e che possono leggere e scrivere la shared memory l’uno dell’altro (distributed shared memory).
Il programmatore sceglie forma e dimensione di griglia e blocchi al momento del lancio; l’hardware assegna ciascun blocco a uno SM e lo tiene lì fino alla fine. Un SM può ospitare più blocchi in parallelo, se le risorse (registri, shared memory) bastano; i blocchi che non entrano restano in coda e partono quando un SM si libera. Questo rende un programma CUDA scalabile in modo trasparente: lo stesso codice gira su una GPU con 20 SM o con 120, distribuendo gli stessi blocchi su più o meno SM, senza cambiare una riga.
Sotto il blocco c’è un livello ulteriore, che il programmatore non specifica ma non può ignorare: l’hardware esegue i thread di un blocco in warp da 32. Un blocco da 256 thread è, fisicamente, 8 warp. Il warp è l’unità di schedulazione: il warp scheduler non muove un thread alla volta, muove un warp intero.

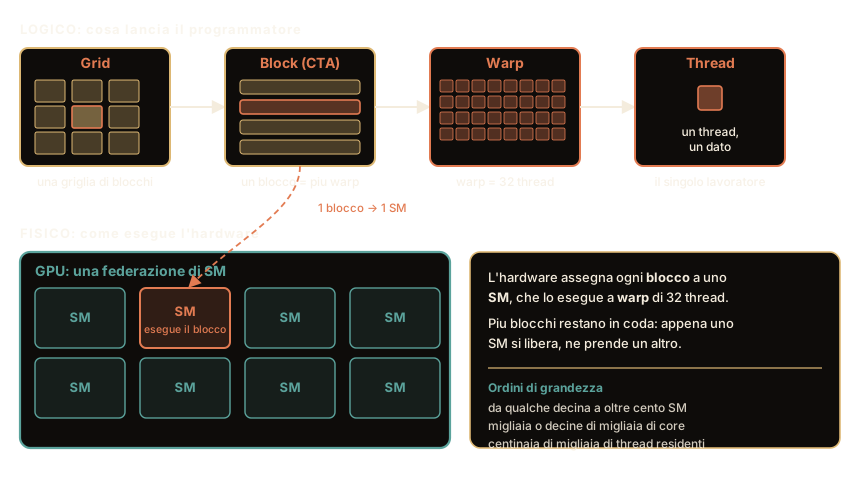
Fig. 8.4 Gli stessi tre livelli in figura, dalla griglia al singolo thread. In alto come li pensa chi scrive il programma: una griglia di blocchi (NVIDIA chiama il blocco anche CTA, ed è la sigla che compare nel disegno), ogni blocco fatto di warp, ogni warp fatto di 32 thread, ognuno su un proprio dato. In basso come li esegue la macchina: ogni blocco finisce su uno degli Streaming Multiprocessor, e lì avanza un warp per volta.#
SIMT: stessa mossa, dati diversi#
Perché i thread avanzano a gruppetti, e non ciascuno per conto proprio? Perché dentro un chip non c’è solo la parte che calcola: ce n’è un’altra, altrettanto ingombrante, che a ogni passo va a prendere l’istruzione seguente, la decifra e dice alle unità di calcolo cosa devono fare. Chiamiamola l’apparato di comando. Il silicio è una superficie limitata, e ogni millimetro speso a comandare è un millimetro non speso a calcolare: far condividere quell’apparato a 32 thread, invece di darne uno a testa, libera spazio per altre unità di calcolo, e più unità di calcolo vuol dire più conti al secondo a parità di chip. Tutti e 32 ricevono così la stessa istruzione nello stesso momento e la eseguono insieme, ognuno sul proprio dato. NVIDIA chiama questo modello SIMT: Single Instruction, Multiple Threads, una istruzione sola per molti thread.
Il gruppo ha un nome, warp. Sul perché siano proprio 32 la risposta onesta è che non c’è una ragione profonda: è la scelta di chi ha progettato queste GPU, e AMD, l’altro grande produttore di GPU, sulle proprie ne ha usati a lungo 64. Ma è una scelta che NVIDIA non cambia da vent’anni, e su cui è tarato il codice di mezzo mondo: conviene trattarla come una costante dell’hardware, ed è per questo che il 32 va ricordato anche se è arbitrario.
Un ordine, trentadue esecuzioni. Il sergente grida «fai un passo avanti!» e tutti e trentadue lo eseguono insieme, ciascuno sul proprio pezzo di strada. È efficientissimo, finché tutti devono fare la stessa cosa.
Il guaio nasce a un bivio. In ogni programma esistono istruzioni della forma «se è vero questo fai una cosa, altrimenti fanne un’altra»: sono quelle che fanno prendere al programma strade diverse a seconda dei dati, e senza di esse non saprebbe fare niente di interessante. Arriva allora l’ordine «se il tuo numero è pari vai a destra, se è dispari vai a sinistra». Il sergente ne può gridare uno per volta, e ogni ordine vale solo per quelli che nomina: fa marciare a destra i pari mentre i dispari stanno fermi ad aspettare; poi fa marciare a sinistra i dispari mentre i pari aspettano. I due gruppi hanno percorso strade diverse, ma in fila invece che insieme, impiegando il doppio del tempo. E se il bivio fosse così fine da mandare ognuno dei trentadue da una parte sua, si andrebbe avanti uno alla volta: trentadue turni per un passo solo.
Sui plotoni di oggi, poi, c’è una libertà in più. Fino alle schede del 2016 il plotone aveva un segnalibro solo, e i trentadue si trovavano sempre allo stesso punto della strada; adesso ognuno tiene il proprio, e due che si trovano in punti diversi possono perfino aspettarsi a un incrocio e scambiarsi una parola. Gli ordini, però, escono ancora uno per volta, e chi non è nominato sta fermo: il bivio costa come prima. E il sergente che dava per scontato di trovarli sempre tutti allineati, adesso, prima di farli parlare fra loro deve fare l’appello e aspettare che rispondano tutti.
Morale: sulla GPU i bivi in cui i 32 compagni di plotone prendono strade diverse costano cari, e il codice più veloce è quello in cui tutti fanno la stessa mossa.
In un warp, i 32 thread condividono il fetch e il decode dell’istruzione: una sola istruzione, emessa una volta, guida trentadue percorsi di dati. È un compromesso a metà strada tra il puro SIMD (una istruzione su un vettore di dati, senza thread distinti) e il multithreading indipendente: da qui il nome SIMT. Il costo si paga sulla warp divergence. Quando un ramo condizionale manda thread dello stesso warp su percorsi diversi, l’hardware non può eseguirli davvero in parallelo: serializza i rami, attivando di volta in volta solo i thread che seguono quel ramo e mascherando gli altri. Nel caso peggiore (32 percorsi distinti) un warp divergente costa fino a 32 volte un warp coerente.
Il meccanismo, qui, è cambiato, e molti testi descrivono ancora
la macchina di prima. Fino a
Pascal (2016) il warp aveva un unico program counter condiviso dai 32
thread, più una maschera di attivazione che diceva quali fossero vivi in quel
momento: i thread di un warp, letteralmente, non potevano trovarsi in due punti
diversi del programma. Da Volta (2017) ogni thread ha program counter e
stack di chiamata propri (independent thread scheduling), e a raggruppare
per l’emissione i thread che eseguono la stessa istruzione pensa uno schedule
optimizer. L’esecuzione resta SIMT e la divergenza costa ancora, perché rami
diversi non possono essere emessi nello stesso ciclo; ciò che cambia è che
thread divergenti dello stesso warp possono ora sincronizzarsi e scambiarsi
dati (ed è possibile scrivere lock e schemi produttore-consumatore dentro un
warp). Il rovescio della medaglia riguarda chi scrive kernel: i vecchi kernel
«warp-sincroni», che davano per scontato l’avanzamento in blocco senza
sincronizzarsi esplicitamente, non sono più corretti, e servono le primitive
come __syncwarp().
La regola pratica, invece, non cambia: tieni i rami condizionali allineati alla granularità del warp, così che i 32 thread restino il più possibile coerenti e nessuno sprechi tempo restando mascherato.
Warp, SM, shared memory e tensor core sono nomi di NVIDIA. Sulle GPU AMD lo SM si chiama compute unit (CU), il warp wavefront (64 thread sulle schede da calcolo della famiglia CDNA, 32 o 64 su quelle RDNA), la shared memory local data share (LDS), e i tensor core matrix core, le unità MFMA; Triton, il linguaggio della sezione sui kernel, compila per entrambe.
Quanto costi, quel bivio, la Fig. 8.5 lo fa vedere contando le caselle.
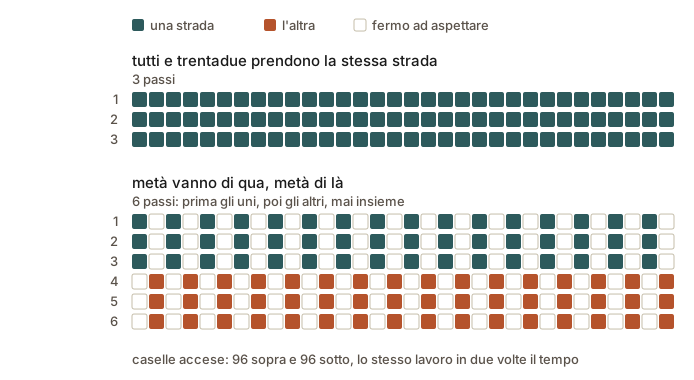
Fig. 8.5 Una casella per thread, una riga per passo. Il lavoro utile è lo stesso nei due casi, novantasei caselle accese, ma sotto ci vogliono sei passi invece di tre, perché a ogni passo metà del warp sta ferma. È tutto qui il costo di un ramo condizionale che divide i thread di un warp: non si fa più lavoro, si occupa più tempo per farne altrettanto.#
Nascondere la latenza: l’occupancy#
Resta la domanda cruciale. Ogni thread, prima o poi, chiede un dato alla memoria e deve aspettare: centinaia di cicli, un’eternità per un processore. Un ciclo è un battito del clock, e una GPU ne fa più di un miliardo al secondo: centinaia di cicli sono meno di un milionesimo di secondo, ma per la GPU è come se noi, che di conti ne facciamo uno al secondo, restassimo fermi otto minuti davanti a una porta chiusa. Se si fermasse a ogni attesa, tutta la sua potenza sarebbe sprecata. La mossa che la salva non è aspettare meno, ma avere sempre qualcos’altro da fare.
Dieci pentole sui fornelli, e un capocuoco solo a girarci intorno, che a ogni momento sceglie a quale pentola dare un giro. Il capocuoco è il warp scheduler di uno SM, l’officina in cui lavora, e ogni pentola è un warp.
La pasta della prima deve bollire dieci minuti, e chi ne avesse una sola se ne starebbe lì a fissare l’acqua. Il nostro invece, mentre la prima bolle, mescola la seconda, assaggia la terza, impiatta la quarta. Quando torna alla prima, i dieci minuti sono passati «gratis», coperti dal lavoro sulle altre. L’attesa c’è stata tutta, e nel conto della serata non si vede. Ma bastano due pentole sul fuoco invece di dieci, e il capocuoco torna a fissare l’acqua.
Quante pentole ha sul fuoco un’officina, in rapporto a quante potrebbe averne, si chiama occupancy, che in italiano suonerebbe «riempimento».
Girare da una pentola all’altra non costa niente, e c’è una ragione. Ogni pentola ha il suo tagliere fuori sul ripiano, col coltello e gli ingredienti già pronti, e nessuno li toglie mai, così lui si sposta e trova tutto dov’era. Dove invece si sparecchia a ogni cambio, mettere via e rimettere fuori costa più della mescolata. Quel ripiano è il register file dell’officina, dove ogni warp tiene i numeri con cui sta lavorando finché non ha finito. Ecco perché in una GPU è grande fuori misura.
Il ripiano però è largo quel tanto, ed è lui a decidere quante pentole stiano sul fuoco. Una ricetta ingombrante, che pretende mezzo ripiano per sé, lascia posto a due o tre pentole; una ricetta sobria ne fa stare dieci. Vale allo stesso modo per il pezzo di tavolo comune che ogni squadra si tiene occupato. Chi cucina se ne accorge da un sintomo strano: cambi una riga della ricetta, e all’improvviso i fornelli si svuotano.
Quello che conta davvero, però, si vede nel corridoio che porta gli ingredienti dalla dispensa, lo stesso della cucina dell’inizio del capitolo. Il corridoio consegna il suo massimo solo se è sempre pieno di roba in cammino, e a riempirlo è la roba chiesta e non ancora arrivata, più del numero di pentole accese. Otto pentole che chiedono un cucchiaio per volta mettono in strada otto cucchiai. Due pentole che chiedono una cassa da quattro cucchiai l’una ne mettono in strada otto anche loro, e il corridoio è pieno uguale con quattro volte meno pentole. Riempire i fornelli resta il modo più semplice per riempire il corridoio, e un’officina con due pentole accese che chiedono un cucchiaio per volta spreca il suo capocuoco; ma a chi si fa portare una cassa per volta di pentole ne bastano poche.
La misura di «quanti warp l’SM tiene in volo» si chiama occupancy: il rapporto tra i warp attivi su un SM e il massimo che potrebbe ospitarne. Il passaggio da un warp all’altro è a costo zero, perché a differenza della CPU la GPU non salva e ripristina il contesto: i registri di tutti i warp residenti restano allocati contemporaneamente nel register file dell’SM. Ecco perché il register file è così grande. Ma è anche una risorsa finita, e da qui il compromesso: più registri usa ogni thread, meno thread (quindi meno warp) entrano insieme nell’SM; lo stesso vale per la shared memory consumata da ogni blocco. Un’alta occupancy dà allo scheduler tanti warp tra cui scegliere e nasconde bene la latenza di memoria; un’occupancy troppo bassa lascia lo scheduler a corto di lavoro e l’SM inattivo durante le attese. Attenzione però: l’occupancy massima non è un fine in sé (un kernel può rendere di più con occupancy moderata, se ogni thread tiene in volo più richieste di memoria indipendenti e riusa di più i dati nei registri [Vol10]), ma un’occupancy troppo bassa, senza quel parallelismo dentro il thread, è quasi sempre un sintomo di potenza sprecata.
Il «dipende» diventa una regola usabile se si guarda alla quantità giusta, che
non è il numero di warp ma il numero di accessi in volo: per saturare la
banda servono byte in viaggio pari a banda × latenza (è la legge di Little).
Su una A100 80 GB PCIe la banda è di \(1{,}935\) TB/s, e la latenza della HBM,
che NVIDIA non pubblica, i microbenchmark la misurano in circa 466 cicli, cioè
circa \(330\) ns a \(1{,}41\) GHz (sulla versione da 40 GB, con lo stesso chip
[LFL+24]). Fanno circa \(640\) KB su tutto il chip, cioè circa 6 KB
per ciascuno dei 108 SM. Se ogni thread legge 4 byte, un warp in volo ne porta
128 e servono una quarantina abbondante di richieste pendenti per SM, più di
due terzi dei 64 warp che un SM può ospitare: occupancy alta. Se invece ogni
thread legge un float4 (16 byte, cioè 512 byte per warp) ne bastano una
dozzina, e la banda si satura con meno di un quinto dei warp. Stesso kernel,
stessa occupancy nominale, due regimi opposti: quel che va tenuto alto sono le
richieste in volo, e ci si arriva sia con tanti warp sia con pochi warp che
leggono largo.
Abbiamo così il quadro dell’esecuzione: una GPU è un insieme di SM, ogni SM esegue warp da 32 thread in stile SIMT, e nasconde le attese tenendo in volo tanti warp insieme. Ma quelle attese sono attese di dati che arrivano dalla memoria, e questo sposta il problema: quando una GPU è lenta, spesso è perché i dati arrivano più piano di quanto le unità di calcolo li consumino. Come è organizzata la memoria, e quando è lei a fissare il limite, lo mostra la sezione sulla memoria.
Da ricordare
CPU e GPU sono la lepre e il formicaio. La CPU ha pochi calcolatori velocissimi e finisce in fretta il singolo compito (bassa latenza, cioè poca attesa); la GPU ne ha migliaia lenti e smaltisce montagne di conti uguali (alto throughput, cioè tanta roba per ora).
Una GPU è divisa in officine quasi autonome, gli Streaming Multiprocessor (SM), da qualche decina a oltre un centinaio, ognuna con le proprie unità di calcolo, il proprio warp scheduler (il capocuoco che sceglie a chi dare un giro) e la propria memoria di lavoro.
Un thread è un compito, «occupati tu di questo numero», non un pezzo di silicio: una GPU ne tiene in carico centinaia di migliaia, qualche decina per ogni unità di calcolo vera. Non sono i thread di Python, che erano una manciata e, per i calcoli scritti in Python, non servivano a niente: qui calcolare è l’unica cosa che fanno. Sono organizzati come in un censimento: l’operazione intera (la griglia), le squadre di quartiere (i blocchi), ciascuna assegnata a uno SM, e dentro ogni squadra i plotoni da 32 (i warp). Il 32 è arbitrario ma non cambia da vent’anni: se lo ricordi, ricordi metà del capitolo.
Il sergente dà un ordine solo a tutto il plotone. Efficientissimo finché tutti fanno la stessa mossa; a un bivio («se pari a destra, se dispari a sinistra») il plotone si divide e le due strade si percorrono una dopo l’altra, nel doppio del tempo. Nel codice per GPU i «se… allora…» che dividono i compagni di plotone costano cari.
L’attesa non si accorcia, si nasconde: il warp scheduler manda avanti un altro warp mentre il primo aspetta i dati, come il capocuoco che gira fra dieci pentole. Quanti warp ha pronti, in rapporto a quanti potrebbe averne, si chiama occupancy. Tenerla decente è il modo più semplice per non lasciare l’officina a mani vuote; quello che conta davvero, però, è che il corridoio verso la memoria sia sempre pieno di roba in viaggio, e ci si arriva anche con pochi warp che chiedono molto per volta.
Le attese che si nascondono così sono attese di dati che arrivano dalla memoria: spesso sono loro il vero collo di bottiglia, ed è l’argomento della sezione sulla memoria.
Da ricordare
CPU e GPU incarnano due filosofie opposte: la CPU è latency-oriented (pochi core complessi, finisce in fretta il singolo compito), la GPU è throughput-oriented (migliaia di ALU semplici, smaltisce montagne di conti identici e indipendenti).
La GPU è un insieme di Streaming Multiprocessor (SM): da parecchie decine a oltre un centinaio di SM, per un totale di migliaia o decine di migliaia di CUDA core e centinaia di migliaia di thread residenti. Ogni SM ha ALU, warp scheduler, un grande register file e la shared memory.
Il programmatore lancia una griglia di blocchi di thread; l’hardware assegna ogni blocco a uno SM e lo esegue in warp da 32 thread: l’unità di schedulazione. Lo stesso codice scala su GPU con più o meno SM [NBGS08].
In stile SIMT i 32 thread di un warp eseguono la stessa istruzione su dati diversi. I rami condizionali che li mandano su strade diverse (warp divergence) vengono serializzati: costano. Fino a Pascal il warp aveva un program counter unico; da Volta ogni thread ha PC e stack propri (independent thread scheduling), il costo della divergenza resta ma i thread di un warp possono sincronizzarsi fra loro.
La GPU nasconde la latenza della memoria con l’occupancy: tanti warp residenti, così che mentre uno aspetta un altro lavora. Il cambio di warp è a costo zero perché i registri restano tutti allocati. Ciò che va davvero tenuto alto sono gli accessi in volo (banda × latenza, la legge di Little): tanti warp, o pochi warp che leggono largo e tengono in volo più richieste indipendenti, per cui l’occupancy massima non è un fine in sé [Vol10].
Le attese che l’occupancy nasconde sono attese di memoria: spesso il collo di bottiglia, e l’argomento della sezione sulla memoria.