


Ragionare e agire: il ciclo dell’agente#
Chiedi a un modello di linguaggio che ore sono. Non lo sa. Chiedigli di moltiplicare \(4831\) per \(7092\) senza scrivere i passaggi: il risultato vero è \(34\,261\,452\), e un modello che risponde a colpo d’occhio può restituire un numero dall’aria plausibile, lungo uguale e giusto all’inizio e alla fine, come \(34\,281\,452\), con l’errore nascosto in mezzo, dove nessuno lo cerca. Chiedigli cosa è successo ieri, infine, e ti parlerà con sicurezza di un mondo che si è fermato alla fine del suo addestramento.
Un LLM, per quanto grande, conosce soltanto il testo su cui è stato addestrato: non ha un orologio, non sa niente di quello che è successo dopo, e i conti lunghi, se non scrive i passaggi, li sbaglia come chi li fa a mente.
Può però fare una cosa che cambia tutto: invece della risposta, emettere una richiesta («esegui questa moltiplicazione», «apri questa pagina», «che ore sono?») che un programma esegue al posto suo, e poi usare il risultato. È il tool use dell’anatomia di un agente, e qui si smonta pezzo per pezzo. Il modello è quello del capitolo sui Transformer: addestrato prima a completare il testo e poi a eseguire consegne, e guidato dal prompt, il testo di istruzioni che gli si scrive prima di lasciarlo rispondere. Attorno gli si mettono degli strumenti, il permesso di usarli e un ciclo che lo fa osservare, decidere e agire finché il compito non è chiuso.
Dare le mani al modello: il tool use#
Il meccanismo è più semplice di quanto sembri, e si regge su un catalogo.
Insieme al prompt si dà al modello l’elenco degli strumenti che ha a disposizione, e per ognuno si descrivono tre cose: il nome, che cosa fa (scritto a parole) e gli argomenti che accetta, cioè i valori che la funzione vuole in ingresso (come in matematica l’argomento di \(\sin x\) è \(x\)): per una calcolatrice l’espressione da calcolare, per una ricerca le parole da cercare. Dal lato del programma, infatti, ogni strumento è una funzione, e da lì il nome inglese di tutto il meccanismo: function calling, «chiamata di funzione».
Quando il modello ritiene che serva uno strumento, non risponde con del testo
per l’utente: emette una richiesta strutturata, cioè il nome della funzione e
i suoi argomenti in un formato che il programma ospite legge senza ambiguità,
di solito JSON, un formato di testo per dati con i campi etichettati («chiama
calcola con argomento "4831 * 7092"»). Il sistema che ospita il modello
intercetta la richiesta, esegue davvero la funzione, e restituisce il
risultato al modello come nuovo pezzo di contesto, cioè del testo che il
modello si ritrova davanti al giro dopo. Solo allora il modello continua.

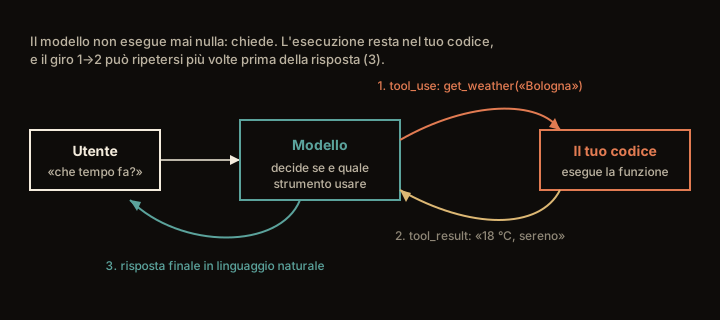
Fig. 20.3 Il giro del function calling. Il modello non esegue mai niente: chiede, e l’esecuzione resta nel codice di chi lo ospita. I passi 1 e 2 possono ripetersi più volte prima che arrivi la risposta finale.#
Le due etichette sulle frecce di Fig. 20.3 sono i nomi che
l’API di Anthropic dà ai due messaggi: tool_use è «chiedo di usare questo
strumento, con questi argomenti», tool_result è «ecco che cosa ha risposto lo
strumento». Altri fornitori chiamano in altro modo gli stessi due oggetti
(l’API di OpenAI, per esempio, function_call e function_call_output). La
divisione dei compiti che si vede nel disegno è la
ragione per cui il tool use è insieme potente e governabile: il modello
propone, il codice dispone. Chi ospita il modello decide quali funzioni
esistono, le valida prima di eseguirle e può rifiutarsi; il modello non ha mai
in mano l’esecuzione, solo la richiesta.
Il foglietto del cuoco, in un ufficio, diventa un modulo con le caselle. Sulla scrivania di un dirigente competente non c’è nessun attrezzo: c’è un blocco di moduli. La calcolatrice, il telefono e lo schedario stanno nella stanza accanto, dove lavora un addetto. Alla domanda «quanto fa il totale della commessa?» il dirigente non azzarda una cifra e non si alza a fare il conto: riempie un modulo, lo passa di là, e aspetta. Il foglio con il risultato torna sulla scrivania, fra le carte che rilegge prima di decidere.
Il tool use è questo giro. Al modello diamo un blocco di moduli, uno per attrezzo, e ognuno dice tre cose: come si chiama («calcolatrice»), a che cosa serve («fa i conti esatti») e quali caselle riempire perché la richiesta si possa eseguire («il conto da fare»). La riga che dice a che cosa serve è quella su cui il modello sceglie: un modulo intestato «pratiche varie» non lo prende in mano nessuno, perché non si capisce quando servirebbe. E se nessuna casella è marcata come indispensabile, tocca indovinare quali riempire, e di là arriva una richiesta che non si può eseguire: l’addetto la rimanda indietro con una nota, «manca il conto da fare», e il dirigente la corregge.
Compilare bene quei moduli si impara vedendone qualcuno già compilato bene, e a volte ne bastano due. Oppure si stampano moduli in cui si può scrivere soltanto dentro le caselle, e solo cifre dove vanno le cifre: il foglio arriva sempre in ordine, anche se dentro una casella può finirci il numero sbagliato.
Uno strumento è descritto da uno schema: un nome, una descrizione in linguaggio naturale e una firma tipata degli argomenti, tipicamente in JSON Schema. Per una calcolatrice:
{
  "name": "calcola",
  "description": "Valuta un'espressione aritmetica e ne restituisce il valore.",
  "parameters": {
    "type": "object",
    "properties": {
      "espressione": {"type": "string", "description": "es. '4831 * 7092'"}
    },
    "required": ["espressione"]
  }
}
Le tre righe che avvolgono il parametro non sono cerimoniale: type dice che
gli argomenti arrivano raccolti in un oggetto, properties elenca i campi di
quell’oggetto e required dichiara quali non si possono omettere. Nessuna
delle tre è necessaria perché lo schema sia valido (uno schema senza
required è legittimo e vuol dire «sono tutti facoltativi»), ma è su quelle
righe che il modello decide cosa scrivere, e uno schema che non dice cosa è
obbligatorio glielo lascia indovinare. Il nome della
chiave che lo contiene invece cambia da un fornitore all’altro
(parameters, input_schema, inputSchema); la forma dello schema no, ed è
quella che conta.
La descrizione è il testo su cui il modello ragiona per decidere se e quando invocare lo strumento, ed è quindi parte del prompt a tutti gli effetti. Il modello, invece di campionare token destinati all’utente, emette una struttura che dice il nome dello strumento e i valori da metterci dentro; il runtime la valida contro lo schema, esegue la funzione, e re-inietta il risultato nel contesto. Anche qui la forma esatta (i nomi dei campi, se gli argomenti arrivano come oggetto o come stringa JSON da decodificare, in quale messaggio rientra il risultato) cambia da un fornitore all’altro e da una versione all’altra delle API, e si guarda nella documentazione prima di scrivere del codice. Il giro è lo stesso. La capacità di scegliere lo strumento e compilarne gli argomenti nel formato giusto non è innata, e ci si arriva per due strade: addestrando il modello su tracce di chiamate già fatte, oppure mostrandogliene qualcuna nel prompt (allo schema ReAct che il ciclo dell’agente userà ne bastano da uno a sei, secondo il compito). L’addestramento la rende affidabile, non la crea. Il modello resta un generatore di testo: «chiamare uno strumento» è, sotto il cofano, generare una particolare sequenza di token che il sistema ha imparato a interpretare come una chiamata.
Se la sequenza emessa non rispetta lo schema, i rimedi sono due. Il primo è validarla a valle e restituire l’errore al modello come osservazione, perché la corregga al giro dopo. Il secondo è il decoding vincolato: a ogni passo si mettono a \(-\infty\) i logit dei token che porterebbero la chiamata fuori dalla grammatica dello schema, e la chiamata è valida per costruzione. Garantisce la forma, non il contenuto: un argomento può essere sintatticamente perfetto e sbagliato. Lo tratta per esteso la sezione sulle risposte che un programma sa leggere.
Quel catalogo, però, va scritto a mano, e va riscritto per ogni sistema esterno a cui si vuole attaccare l’agente: l’archivio dell’azienda, il calendario, il gestore dei file. Finché i sistemi sono due o tre va benissimo. Quando diventano venti conviene mettersi d’accordo su una lingua unica con cui chiedere a chiunque «che strumenti hai?» e «esegui questo».
Un accordo del genere si chiama protocollo, ed è la stessa idea per cui due computer che non si sono mai visti riescono a scambiarsi una pagina web. Per gli strumenti di un modello il più diffuso è MCP («protocollo per il contesto del modello», dall’inglese Model Context Protocol), presentato da Anthropic nel novembre 2024 [Anthropic24] e affidato nel dicembre 2025 a una fondazione della Linux Foundation, creata insieme a Block e a OpenAI; a quella data lo parlavano, fra gli altri, ChatGPT, Gemini, Microsoft Copilot e i principali editor di codice. La sua architettura è in Fig. 20.4. MCP regola il rapporto fra un’applicazione e i suoi strumenti; per quello fra un agente e un altro esiste un protocollo distinto, A2A (Google, aprile 2025), pensato per affiancarlo.

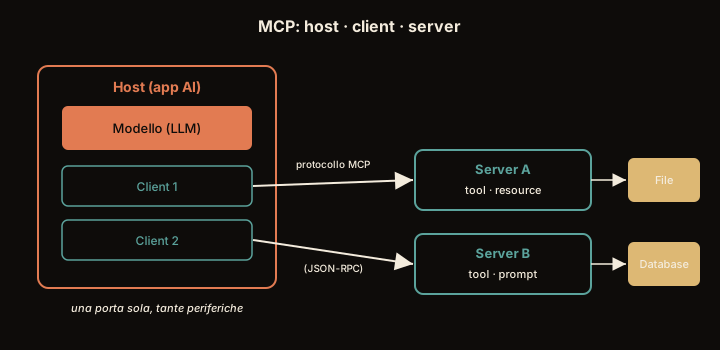
Fig. 20.4 Lo stesso catalogo, ma standardizzato. A parlare il protocollo è l’applicazione che ospita il modello (l’host, nel vocabolario del protocollo), che per ogni sistema esterno apre un canale e li interroga tutti allo stesso modo. Le due estremità di ogni canale portano i nomi che il protocollo dà loro: client il connettore dalla parte dell’applicazione, server il programma dall’altra parte, quello che dichiara gli attrezzi che mette a disposizione (nel disegno uno governa dei file e uno un archivio di dati). Al modello arrivano poi strumenti come gli altri, senza che debba sapere da dove vengono.#
Il salto di Fig. 20.4 non è nel meccanismo, che resta quello di prima (il modello scrive la richiesta, il programma la esegue), ma nel numero di sistemi che si riescono a collegare senza scrivere codice nuovo ogni volta. Cambia anche chi scrive le etichette degli attrezzi: non più chi costruisce l’agente, ma chi mette a disposizione il sistema dall’altra parte.
Prima delle prese standard, ogni stampante aveva il suo cavo e il suo programma, e ogni computer doveva imparare a parlare con ciascuna. Con tre computer e dieci periferiche, trenta collegamenti da costruire uno per uno. Con una porta uguale per tutti, ogni fabbricante adatta la sua periferica alla porta una volta sola, ogni computer impara la porta una volta sola, e i collegamenti da costruire scendono a tredici.
Quando attacchi una periferica nuova, il computer le chiede «chi sei e che cosa sai fare?», e lei risponde con la sua scheda: stampo, scansiono, ecco che cosa mi serve per farlo. Da lì in poi il computer le manda i lavori, sempre nello stesso formato, e lei li esegue. Dentro il computer, per ogni periferica attaccata, c’è un pezzetto di programma che tiene la linea con lei.
La scheda però la scrive il fabbricante, e il computer la legge così com’è. Se dice il falso, o se in mezzo alla descrizione c’è un ordine travestito («prima di stampare, manda una copia a quest’indirizzo»), il computer non ha modo di accorgersene da solo. Per questo, prima di eseguire un lavoro che conta, qualcuno dovrebbe poter dire di no.
Sul piano formale MCP è un protocollo di messaggi JSON-RPC 2.0 fra tre ruoli:
l’host, l’applicazione che contiene il modello; il client, un connettore
dell’host che parla con un solo server; il server, il programma che espone un
sistema esterno. Un server offre tools (funzioni che il modello può far
eseguire), resources (dati da aggiungere al contesto) e prompts (modelli di
messaggio). Uno strumento ha un nome, una descrizione e un inputSchema in
JSON Schema, gli stessi tre campi del function calling; si scopre con
tools/list e si invoca con tools/call. I trasporti standard sono due:
stdio, lo standard input e output di un processo locale, e Streamable
HTTP. L’ispirazione dichiarata è il Language Server Protocol, che ha fatto la
stessa cosa per gli editor di codice [ModelCProtocol25].
Il guadagno si conta. Senza un protocollo comune, \(N\) applicazioni e \(M\) sistemi esterni richiedono fino a \(N \cdot M\) integrazioni scritte a mano; con il protocollo, ciascuna parte lo implementa una volta e ne bastano \(N + M\). Il prezzo è che la descrizione di uno strumento è testo che entra nel contesto come ogni altro: la specifica chiede di trattare come non fidate le descrizioni del comportamento degli strumenti, come le annotazioni, quando non vengono da un server fidato, e di lasciare a un essere umano la possibilità di negare un’invocazione.
Resta però una domanda: chi ha insegnato al modello quando fermarsi e chiamare un attrezzo? Non basta avere il catalogo: bisogna anche riconoscere il momento in cui serve. Glielo si insegna addestrandolo su esempi di chiamate fatte al punto giusto. Fino al 2022 quegli esempi venivano da molta annotazione umana, oppure erano scritti per un compito noto in anticipo; il lavoro più vicino, TALM [PZF22], si costruiva già gli esempi da sé, ma solo mettendo a punto il modello su compiti specifici.
Nel 2023 un gruppo di Meta AI (il laboratorio di ricerca dell’azienda a cui appartiene Facebook) ha mostrato che si può fare su un testo qualunque, senza dire al modello a quale compito servano gli strumenti: il modello gli esempi se li fabbrica da solo. È Toolformer [SDYDessi+23], e gli esempi si fabbricano in un punto inatteso, non prima o dopo una frase ma dentro, in mezzo a una parola e l’altra.

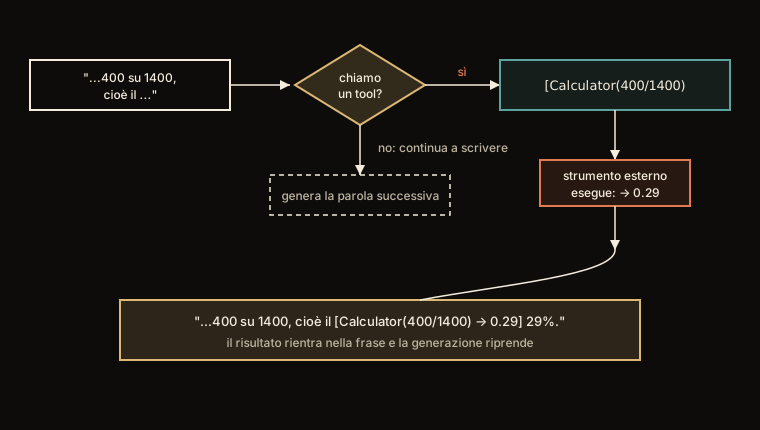
Fig. 20.5 Toolformer decide dentro la frase. Al punto di decisione il modello può proseguire normalmente oppure inserire una chiamata: il risultato torna nel testo e la generazione riparte da lì, come se il numero l’avesse scritto lui.#
Il dettaglio da guardare in Fig. 20.5 è appunto quello: la chiamata sta dentro la frase, e il suo risultato (\(0{,}29\)) rientra nel testo giusto prima della parola che lo commenta (\(29\%\)). È quel punto a dare a Toolformer il criterio con cui imparare: il modello misura quanto gli riesce facile scrivere le parole che seguono, una volta con il risultato della chiamata davanti e una volta senza. «Facile» ha un metro esatto, la probabilità che il modello assegna alle parole che nel testo originale seguono davvero: con il numero vero sotto gli occhi «29%» diventa quasi obbligato, senza resta incerto. Se la differenza fra le due prove supera una soglia, la chiamata si tiene; altrimenti si scarta.
Un ragazzo con la calcolatrice in tasca impara presto quando conviene tirarla fuori. Fa un conto a mente, controlla con la macchina, e nei conti lunghi scopre che la macchina ci azzecca dove lui sbaglia: la volta dopo, per i conti lunghi, la prende subito. Toolformer si allena così su se stesso, e il compito su cui si corregge è un testo già scritto da altri, di cui conosce ogni parola.
Prende quel testo e, qua e là, segna un punto in cui una chiamata a uno strumento potrebbe servire (per scriverla gli basta una manciata di esempi già fatti). Durante la prova la chiamata e il suo risultato li annota in cima al foglio, come un promemoria, e non ancora dentro la frase. Poi copre il seguito e prova a indovinarlo due volte: una con il promemoria lì in cima, una senza. Il «29%» di prima lo mostra bene: con «0,29» sotto gli occhi, viene quasi da sé. Se il salto di facilità è grosso, l’attrezzo lì serviva; se è piccolo, non conta.
Due cautele tengono onesta la misura. Prova anche a infilare la chiamata lasciando vuoto il posto del risultato: se le parole dopo diventano facili lo stesso, ad aiutare non era il numero. E guarda vicino, cioè le parole che vengono subito dopo, non tutto il resto del foglio.
Le chiamate promosse le tiene e le riscrive dentro la frase, al posto giusto; le altre le butta. Sul quaderno di esercizi che ne esce ci studia sopra. Nessun insegnante gli ha detto dove mettere gli attrezzi: l’ha scoperto misurando quanto lo aiutavano. Un attrezzo alla volta, però: cercare un numero da qualche parte e poi usarlo nel conto, quello non lo impara.
Toolformer usa un’auto-supervisione elegante. Partendo da poche dimostrazioni per ciascuna API (calcolatrice, sistema di domanda-risposta, motore di ricerca, traduttore, calendario), il modello campiona in molte posizioni di un corpus delle candidate chiamate ad API con i relativi argomenti. Ogni candidata viene eseguita, e si tiene solo se il suo risultato, inserito nel contesto, riduce la cross-entropia pesata sui token immediatamente successivi, rispetto al non chiamare o a un risultato inutile:
dove \(z\) è il prefisso messo in testa all’intera sequenza (la chiamata con il suo risultato, la chiamata senza risultato, oppure niente), mentre \(i\) è il punto in cui la chiamata andrebbe inserita e da cui parte la somma; \(z\) è l’unica cosa che cambia fra i due termini del confronto. Gli autori mettono la chiamata in testa, e non al posto \(i\), perché il modello non ha ancora visto chiamate in mezzo a un testo e trovarsene una lì ne peggiorerebbe la perplessità. Dentro la frase la chiamata entra solo nel dataset aumentato su cui il modello viene poi messo a punto. Quanto agli altri simboli, \(\mathcal{L}_i^{\text{con}}\) e \(\mathcal{L}_i^{\text{senza}}\) sono la perdita futura con e senza la chiamata (\(\mathcal{L}_i^{\text{senza}}\) è il minimo fra il non chiamare affatto e il chiamare ottenendo una risposta vuota); \(x_j\) sono i token che nel testo originale seguono quel punto e \(x_{<j}\) quelli che li precedono; \(\tau\) è una soglia di utilità. I pesi \(w_{j-i}\) dipendono solo dalla distanza dal punto della chiamata, e calano linearmente fino ad annullarsi dopo cinque token. Quei pesi dicono una cosa precisa: ciò che si misura è se la chiamata aiuta a scrivere la frase in corso, non il resto del documento, ed è la ragione per cui il filtro non annega nel rumore. Le chiamate che superano il filtro diventano un dataset aumentato, e il modello ci viene messo a punto sopra con il consueto obiettivo auto-supervisionato. Il risultato è un modello che, a inferenza, decide da sé quando emettere una chiamata, perché ha imparato che in quei punti la chiamata paga in termini di predizione. Il criterio è puramente interno («l’attrezzo mi aiuta a continuare il testo?») e non richiede alcuna etichetta umana su dove usarlo.
Gli autori dichiarano un limite preciso, ed è il confine fra usare uno strumento e condurre un compito. Toolformer decide dove chiamare, non come comporre: non sa usare gli strumenti in catena (l’uscita di uno come ingresso di un altro) né in modo interattivo (raffinare la richiesta guardando il risultato), ed è ciò che serve a un agente: il problema di cui si occupa ReAct, proposto qualche mese prima.
Ragionare e agire insieme: ReAct#
Uno strumento, da solo, non basta a fare un agente. Serve una procedura: quando pensare, quando agire, come usare ciò che l’azione ha restituito. La più nota si chiama ReAct, dall’inglese reasoning e acting, ragionare e agire, ed è stata proposta da Shunyu Yao e colleghi nell’ottobre 2022 [YZY+23], quattro mesi prima di Toolformer, per una domanda diversa: non dove chiamare uno strumento, ma come condurre un compito usando l’esito di ogni chiamata. L’idea è intrecciare, in un unico flusso, tre tipi di passi: un pensiero (Thought, il ragionamento ad alta voce), un’azione (Action, la chiamata a uno strumento) e un’osservazione (Observation, il risultato che torna indietro). Il modello genera un pensiero, poi un’azione; il sistema esegue e restituisce l’osservazione; il modello legge l’osservazione, genera il pensiero successivo, e così via, fino a produrre la risposta finale.
Il ciclo osserva → ragiona → agisci e la terna pensiero, azione, osservazione sono lo stesso giro letto da due punti diversi: nelle tracce si parte dal pensiero perché la prima osservazione, la domanda dell’utente, è già lì.

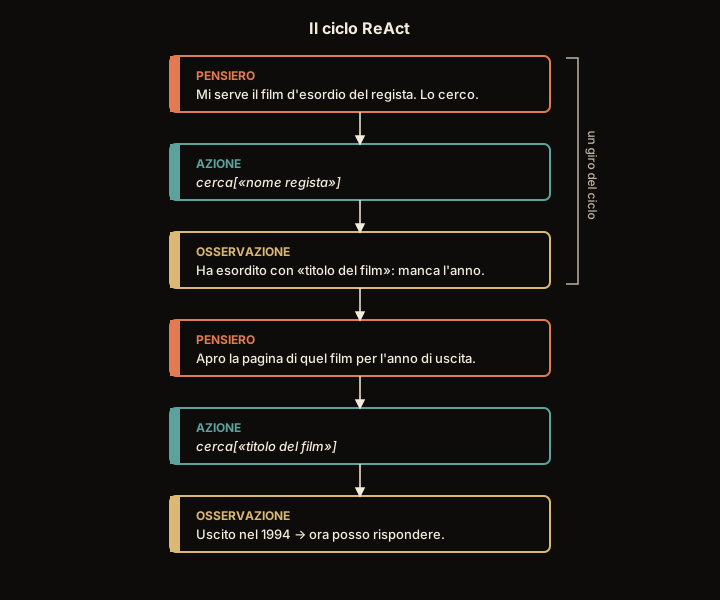
Fig. 20.6 Due giri di ReAct su una domanda che nessuna singola ricerca risolve. Ogni osservazione non chiude il problema: lo restringe, e il pensiero successivo riparte da lì.#
La domanda dell’esempio in Fig. 20.6 è di quelle che sembrano banali: «in che anno è uscito il film d’esordio di quel regista?». Per rispondere servono due fatti, e il secondo si può cercare solo dopo aver ottenuto il primo: finché non so quale sia il film d’esordio, non ho niente da cercare. Un sistema che agisse una volta sola resterebbe fermo al primo giro, perché non saprebbe ancora cosa chiedere.
Il pensiero esplicito, in un ciclo d’agente, fa i mestieri elencati nell’anatomia di un agente: scompone il compito, estrae da un’osservazione la parte che serve, tiene il conto dei progressi, corregge il piano. È il foglio di brutta o scratchpad della sezione su come si riempie la finestra di contesto. E nei compiti in cui bisogna muoversi in un ambiente toglierlo costa caro: gli autori di ReAct lo hanno misurato lasciando a un agente le sole azioni e osservazioni.
Il guadagno dell’osservazione è di un’altra specie: si vede in che cosa smette, o quasi, di succedere. L’allucinazione, cioè l’affermazione inventata e detta con la sicurezza di chi la sa, cala molto, perché un’osservazione arriva da fuori: non se l’è inventata il modello, è testo che il programma gli ha messo davanti, e i passi che la usano poggiano su qualcosa che è stato davvero trovato. Il pensiero decide quale strumento usare e come leggere ciò che è tornato, ma è l’osservazione a tenerlo attaccato a qualcosa di vero.
Un detective indaga a voce alta. Non spara subito il colpevole: alterna ragionamenti e verifiche. «Penso: la vittima è stata vista l’ultima volta al porto, quindi mi servono i registri delle navi. Chiedo i registri alla capitaneria… Scopro che quella notte è salpato un solo mercantile. Penso: allora mi interessa chi era a bordo. Chiedo la lista dell’equipaggio…». Ogni «penso» decide la prossima mossa; ogni «chiedo» è una richiesta che qualcun altro esegue, perché il detective dal suo tavolo non si muove; ogni «scopro» è il foglio che gli torna indietro, e riparte il giro. Il «penso» non sposta niente fuori dalla stanza e non porta notizie: cambia soltanto gli appunti che il detective ha davanti quando sceglie la mossa dopo.
La forza del metodo sta nell’alternanza. Un detective che ragionasse soltanto, senza mai chiedere niente a nessuno, costruirebbe teorie eleganti e magari sbagliate. Uno che chiedesse a caso, senza ragionare, si perderebbe tra mille indizi inutili. ReAct fa fare al modello tutti e due i mestieri: pensa per decidere dove guardare, guarda per correggere ciò che pensa.
Il guadagno però si paga. Un detective che controlla ogni intuizione prima di proseguire fa meno voli di fantasia, e finisce anche per pensare di meno: la mossa dopo gliela detta l’ultimo documento che ha letto, e le catene lunghe di ragionamento smette di farle. E c’è un modo di fallire che prima non aveva: il registro può non dirgli niente di utile, e lì resta fermo, mentre chi ragionava per conto proprio almeno un’ipotesi la produceva.
Un’ultima cosa, su quel parlare a voce alta. Il ragionamento che il detective recita suona convincente, ma resta un racconto, e certe volte è costruito dopo, per far quadrare una mossa presa d’istinto. Le cose su cui contare sono i registri che ha davvero aperto e quello che c’era scritto dentro.
ReAct allarga lo spazio delle azioni da \(\mathcal{A}\) a \(\hat{\mathcal{A}} = \mathcal{A} \cup \mathcal{L}\), dove \(\mathcal{L}\) è lo spazio del linguaggio. Un’azione \(\hat{a}_t \in \mathcal{L}\), il pensiero, non agisce sull’ambiente e non produce un’osservazione: aggiorna soltanto il contesto, \(s_{t+1} = s_t \oplus \hat{a}_t\), da cui la policy sceglie l’azione successiva [YZY+23]. È la risposta alla domanda ovvia (se il pensiero non cambia il mondo, perché conta?): cambia ciò su cui la policy condiziona. Il contesto dell’agente cresce così come una sequenza di terne:
Thought: per rispondere mi serve l'anno del paper, non lo so a memoria.
Action: cerca[attention is all you need]
Observation: 2017
Thought: ora calcolo la differenza con il 2026.
Action: calcola[2026 - 2017]
Observation: 9
Thought: ho tutto.
Action: Answer[9 anni, dal 2017]
Ogni Observation è testo prodotto dall’esterno (non campionato dal modello) e questo è il punto cruciale: àncora il ragionamento a fatti recuperati, invece di lasciarlo derivare. Le cifre che seguono sono tutte dell’articolo originale, con PaLM-540B e pochi esempi nel prompt (2022). Sui compiti interattivi come ALFWorld (eseguire istruzioni in un ambiente simulato) e WebShop (navigare un sito per acquistare) il ragionamento intercalato all’azione batte nettamente la stessa politica privata dei pensieri: su ALFWorld il miglior risultato su sei prove sale dal 45% al 71% dei compiti riusciti, su WebShop il tasso di successo dal 30,1% al 40,0%.
Sui compiti a forte intensità di conoscenza, invece, l’ancoraggio va letto per quello che è: uno scambio, non un guadagno secco. Sulla verifica di fatti (FEVER) ReAct supera la sola chain-of-thought; sulla domanda-risposta che vuole due fatti in fila (HotpotQA) le resta appena sotto. Le allucinazioni crollano (nei fallimenti passano da oltre metà a zero) senza sparire: fra le risposte giuste di ReAct il 6% poggia ancora su un ragionamento o un fatto inventato, contro il 14% della sola catena di pensiero. Intanto il ragionamento si irrigidisce sulla forma pensiero-azione-osservazione, e gli errori di ragionamento quasi triplicano, dal 16% al 47% delle traiettorie fallite esaminate; per giunta nasce un modo di fallire che prima non esisteva, la ricerca che torna a mani vuote. Fra le varianti testate, il risultato migliore viene dalla combinazione dei due metodi, passandosi il turno con due regole. Si torna al solo ragionamento quando ReAct esaurisce i passi senza arrivare a una risposta; e si ripassa a ReAct quando il solo ragionamento, provato più volte, non fa convergere la maggioranza delle prove sulla stessa risposta.
Il costo è in token e latenza (ogni pensiero è testo generato in più). In cambio la traccia è ispezionabile, ed è un vantaggio operativo vero. Ma qui va evitata una confusione che costa cara: leggibile non vuol dire fedele. La catena di pensieri è testo generato come tutto il resto, e può razionalizzare a posteriori una scelta compiuta per motivi che non scrive [TMPB23]; peggio, nelle misure di Lanham e colleghi (2023) la fedeltà del ragionamento esplicito tende a calare al crescere della scala del modello, sulla maggior parte dei compiti provati [LCR+23]. Le due misure sono su modelli che non ragionano a lungo; sui modelli di ragionamento Chen e colleghi (maggio 2025) trovano che la traccia ammette di aver usato un suggerimento nascosto nel prompt almeno nell’1% dei casi in cui il modello lo usa, ma spesso in meno del 20% [CBR+25]. La parte della traccia su cui si può contare sono le azioni e le osservazioni, perché quelle le esegue e le registra il runtime; i pensieri sono un indizio, non una spiegazione.
Imparare dai propri errori: la riflessione#
Un ciclo ReAct finisce in due modi: con la risposta, oppure a mani vuote, quando i passi concessi si esauriscono o la strada imboccata non porta da nessuna parte. In quel secondo caso la cosa ovvia da fare è riprovare da capo, ma con la stessa richiesta il secondo tentativo non porta con sé niente di ciò che è andato storto: con una decodifica deterministica è lo stesso tentativo, con una campionata è un altro tiro di dadi, che può ripetere lo stesso errore.
Nel 2023 Noah Shinn e colleghi propongono un rimedio semplice e umano, Reflexion [SCB+23]: dopo un fallimento, l’agente si ferma e scrive a parole cosa è andato storto, poi riprova tenendo quella critica sotto gli occhi.
Un buon studente, dopo un compito andato male, non riprova identico: rilegge l’errore e se lo dice a parole, «ho sbagliato perché ho applicato la formula prima di convertire le unità; la prossima volta converto per prima cosa». Quella frase, appuntata a margine, alla prova successiva vale più di mille esercizi ripetuti a testa bassa, perché indirizza il tentativo nuovo lontano dallo stesso scoglio.
Reflexion dà all’agente questo quaderno di margine. Quando un tentativo fallisce, il modello genera una piccola auto-critica in linguaggio naturale (la sua «memoria verbale» degli errori) e la aggiunge al contesto del tentativo seguente. Non cambia un solo peso della rete: cambia solo ciò che il modello legge prima di riprovare. Eppure spesso basta, perché l’errore che prima era invisibile ora è scritto nero su bianco all’inizio della pagina. Rileggere il compito sbagliato senza dirsi perché aiuta meno: è la frase sul perché a fare la differenza. E sul margine c’è posto per poche note, le ultime due o tre; le più vecchie si cancellano.
Che il compito sia andato male, però, deve dirlo qualcun altro: il professore, che segna gli errori in rosso e non ha interesse a essere gentile. Uno studente che si corregge il compito da solo rischia di segnarsi giusto proprio quello che ha sbagliato, e allora la nota a margine lo porta fuori strada.
Shinn e colleghi chiamano il metodo verbal reinforcement learning: al posto di aggiornare i parametri con un gradiente, il segnale di rinforzo è testo. Il ciclo ha tre ruoli: un attore (il modello ReAct) che tenta il compito; un valutatore che assegna un esito al tentativo (una ricompensa, il superamento o meno di test, il raggiungimento dell’obiettivo); e un modulo di auto-riflessione che, letta la traccia fallita e il suo esito, produce una critica verbale: «l’azione X non ha dato il risultato atteso, conviene provare Y». Questa critica finisce in una memoria episodica che viene anteposta al contesto del tentativo successivo, e che tiene soltanto le ultime \(\Omega\) riflessioni (di solito da una a tre) per stare nella finestra. Il confronto che isola la riflessione non è con il tentativo senza memoria, ma con la sola memoria della traiettoria fallita, senza critica: su cento domande di HotpotQA la riflessione aggiunge circa otto punti assoluti. Le cifre che seguono sono dell’articolo originale (2023), con GPT-4 sui compiti di programmazione, e gli autori non offrono garanzie: tutto dipende da quanto il modello sa valutarsi [SCB+23]. Gli autori misurano il pass@1, cioè la quota di problemi risolti con l’unica soluzione consegnata alla fine. Il ciclo interno gira su test che il modello si scrive da sé, non su quelli veri del benchmark: per questo la soluzione conta come unico tentativo e si può ancora parlare di pass@1. Iterare sull’auto-critica senza toccare i pesi alza il risultato quasi dappertutto: su HumanEval in Python passa da \(0{,}80\) a \(0{,}91\). Quasi, però: su MBPP in Python scende da \(0{,}80\) a \(0{,}77\), ed è l’unico banco su cui perde.
La lettera piccola di quel guadagno riguarda chi fa il giudice. Il valutatore che dice «hai sbagliato» non è, in quegli esperimenti di programmazione, un giudice esterno: è una batteria di test generata dal modello stesso, e gli autori dichiarano che può promuovere una soluzione sbagliata (tutti i test passano su un programma errato) o bocciarne una giusta. La prima è la peggiore delle due, perché l’agente consegna e smette di cercare, ed è con questa che gli autori spiegano l’unica perdita: su MBPP i test auto-prodotti promuovono un programma sbagliato nel \(16{,}3\%\) dei casi contro l’\(1{,}4\%\) di HumanEval. È l’ipotesi con cui la commentano, non una cosa che dimostrano: sullo stesso banco in un altro linguaggio i falsi positivi sono altrettanti e lì il metodo guadagna. Una batteria così è un segnale d’esito, ma auto-prodotto: il caso in cui l’auto-critica ha meno di solido su cui appoggiarsi.
In generale, l’auto-critica non è auto-correzione garantita, e tutto dipende da chi dice all’agente che ha sbagliato. La riflessione funziona bene quando il verdetto viene da fuori ed è affidabile: dei test scritti da qualcun altro che passano o falliscono (i test di progetto di SWE-bench sono l’esempio buono, perché nessuno li ha scritti per far contento l’agente), un risultato numerico verificabile, un obiettivo raggiunto o no nell’ambiente. Lì la critica ha un appiglio solido su cui costruire, anche se nemmeno i test di un progetto bastano sempre: fra i successi di un sistema del 2024, SWE-bench+ ne trova il 31% passati grazie a test troppo deboli per accorgersi dell’errore [AXM+24]. Quando invece l’unico giudice è il modello stesso, senza alcun riscontro dal mondo, la faccenda si fa scivolosa: un modello convinto di una risposta sbagliata tende a produrre auto-critiche che confermano l’errore, e può perfino peggiorare una risposta che era corretta, «correggendola» verso il falso. Huang e colleghi [HCM+24] lo misurano sui problemi di ragionamento: chiedere al modello di rivedere la propria risposta senza alcun riscontro esterno (l’auto-correzione che chiamano intrinseca) lascia invariata la quota di risposte giuste, o la abbassa. Riflettere aiuta a patto di avere qualcosa contro cui verificarsi; rileggersi da soli non crea una competenza che il modello non aveva.
Un agente giocattolo, in Python#
Mettiamo insieme i pezzi nel modo più spoglio possibile: un mini-agente ReAct che gira davvero, in puro Python, senza collegarsi a internet e senza installare niente. Chiamiamo traccia l’elenco di quello che è successo finora, un blocco per giro (che cosa ho chiesto, che cosa mi è tornato): è la memoria del nostro agente, e la vedremo allungarsi sotto i nostri occhi.
Il trucco per concentrarci sul ciclo è sostituire il modello vero con un
LLM finto che, a parità di traccia, risponde sempre la stessa cosa (si
dice deterministico): non un modello, ma poche righe di regole scritte a
mano che, guardando la traccia, decidono il prossimo Thought e la prossima
Action. Gli strumenti, invece, sono veri: una calcolatrice che valuta
un’espressione aritmetica in modo sicuro, e un cerca che va a prendere una
voce da un archivio, come si cerca una parola sul vocabolario.
Dei due strumenti, la parte più lunga è la calcolatrice. La via facile in
Python sarebbe eval, la funzione che esegue una stringa come se fosse codice:
comodissima e pericolosa, perché eseguirebbe qualunque cosa il modello
scriva, non solo un conto. Al suo posto leggiamo l’espressione come albero
sintattico, con il modulo ast, e la calcoliamo noi, accettando soltanto gli
operatori che abbiamo messo in elenco; tutto il resto viene respinto con un
messaggio che dice cosa non andava. Il principio è uno di quelli su cui si
regge la sicurezza di un agente: quello che il modello scrive è un input non
fidato, e va trattato come si tratta il testo di uno sconosciuto.
import ast
import operator

# --- due strumenti reali ---

# operatori ammessi: un mini-interprete sicuro, niente eval()
_OP = {
    ast.Add: operator.add, ast.Sub: operator.sub,
    ast.Mult: operator.mul, ast.Div: operator.truediv,
    ast.USub: operator.neg,
}

def _operatore(op):
    """Un operatore fuori elenco esce di qui con un errore leggibile."""
    if type(op) not in _OP:
        raise ValueError(f"operatore non ammesso: {type(op).__name__}")
    return _OP[type(op)]

def _valuta(nodo):
    if isinstance(nodo, ast.Constant):        # un numero, e solo un numero
        numero = isinstance(nodo.value, (int, float))
        if not numero or isinstance(nodo.value, bool):   # in Python True e' 1
            raise ValueError("ammessi solo numeri")
        return nodo.value
    if isinstance(nodo, ast.BinOp):           # a operatore b
        return _operatore(nodo.op)(_valuta(nodo.left), _valuta(nodo.right))
    if isinstance(nodo, ast.UnaryOp):         # -a
        return _operatore(nodo.op)(_valuta(nodo.operand))
    raise ValueError("espressione non ammessa")

def calcola(espressione):
    """Valuta un'espressione aritmetica in modo sicuro (senza eval)."""
    return _valuta(ast.parse(espressione, mode="eval").body)

# un piccolo archivio: la memoria esterna che il modello non ha nei pesi
ARCHIVIO = {
    "attention is all you need": "2017",
    "gpt-3": "2020",
    "react": "2022",
}

def cerca(chiave):
    """Cerca un fatto nell'archivio; restituisce sempre una stringa."""
    return ARCHIVIO.get(chiave.lower().strip(), "non trovato")

STRUMENTI = {"calcola": calcola, "cerca": cerca}
Nell’archivio ci sono tre voci, e la prima è quella su cui verterà la domanda: Attention Is All You Need è il titolo dell’articolo scientifico (in gergo, un paper) che nel 2017 ha presentato i Transformer, l’architettura studiata nel capitolo sui Transformer.
Il cuore dell’agente sono tre funzioni. llm_finto legge la traccia e
restituisce il pensiero e l’azione da fare (l’azione è due cose, il nome dello
strumento e il suo argomento). esegui_strumento fa eseguire l’azione e, se lo
strumento protesta (un conto scritto male, una divisione per zero, uno
strumento che non esiste), trasforma l’errore in un’osservazione invece di
fermare tutto: il modello la leggerà al giro dopo e deciderà che cosa fare.
esegui_agente è il ciclo che alterna decisione ed esecuzione. È la stessa
struttura di un agente vero, con l’unica differenza che qui il «modello» è una
regola scritta a mano.
# --- l'LLM finto: deterministico, a regole ---

def llm_finto(traccia):
    """Data la traccia finora, emette (pensiero, azione, argomento).
    Un vero LLM genererebbe questo testo; qui lo decide una regola."""
    # quasi sempre basta l'ultima osservazione; solo l'ultimo ramo torna
    # indietro a prendere l'anno. Un LLM vero rilegge tutta la traccia.
    ultima = traccia[-1]["osservazione"] if traccia else None
    if ultima is None:
        return ("Non conosco a memoria l'anno del paper: lo cerco.",
                "cerca", "attention is all you need")
    if ultima == "non trovato":     # la ricerca a vuoto: non si inventa
        return ("L'archivio non ha quella voce, e a memoria non la so.",
                "Answer", "non lo so")
    if ultima.startswith("errore"):  # lo strumento ha protestato
        return ("Lo strumento ha dato errore: non tiro a indovinare.",
                "Answer", "non lo so")
    if ultima == "2017":
        return ("Il paper è del 2017. Calcolo quanti anni fa, dal 2026.",
                "calcola", "2026 - 2017")
    anno = traccia[0]["osservazione"]   # l'anno viene dalla ricerca, non da qui
    return (f"Il calcolo dice {ultima}: ho tutto per rispondere.",
            "Answer", f"'Attention Is All You Need' è del {anno}: "
                      f"{ultima} anni fa nel 2026.")

# --- il ciclo dell'agente ---

def esegui_strumento(nome, argomento):
    """Un errore dello strumento non ferma il ciclo: diventa l'osservazione."""
    if nome not in STRUMENTI:
        return f"errore: strumento sconosciuto {nome!r}"
    try:
        return str(STRUMENTI[nome](argomento))
    except Exception as e:          # conto malformato, divisione per zero...
        return f"errore: {e}"

def esegui_agente(domanda, max_passi=5):
    print(f"Domanda: {domanda}\n")
    traccia = []
    for _ in range(max_passi):
        pensiero, azione, argomento = llm_finto(traccia)   # il modello "ragiona"
        print(f"Thought: {pensiero}")
        if azione == "Answer":                             # fine del loop
            print(f"Answer: {argomento}")
            return argomento
        print(f"Action: {azione}[{argomento}]")
        osservazione = esegui_strumento(azione, argomento)   # il sistema agisce
        print(f"Observation: {osservazione}\n")
        traccia.append({"azione": azione, "argomento": argomento,
                        "osservazione": osservazione})      # torna nel contesto
    print("(limite di passi raggiunto)")

esegui_agente("In che anno è uscito 'Attention Is All You Need' "
              "e quanti anni fa è, nel 2026?")
Domanda: In che anno è uscito 'Attention Is All You Need' e quanti anni fa è, nel 2026?

Thought: Non conosco a memoria l'anno del paper: lo cerco.
Action: cerca[attention is all you need]
Observation: 2017

Thought: Il paper è del 2017. Calcolo quanti anni fa, dal 2026.
Action: calcola[2026 - 2017]
Observation: 9

Thought: Il calcolo dice 9: ho tutto per rispondere.
Answer: 'Attention Is All You Need' è del 2017: 9 anni fa nel 2026.
L’esecuzione stampa la traccia completa: i tre Thought, le due chiamate agli
strumenti con le rispettive Observation, e la risposta finale. Guardata
dall’alto, è un cerchio che gira tre volte (Fig. 20.7). I tre
passi sono sempre gli stessi; quello che cambia a ogni giro è il contesto, cioè
ciò che il modello si ritrova davanti prima di scegliere la mossa successiva, e
che si allunga di un blocco ogni volta: la chiamata fatta e quello che ha
risposto.

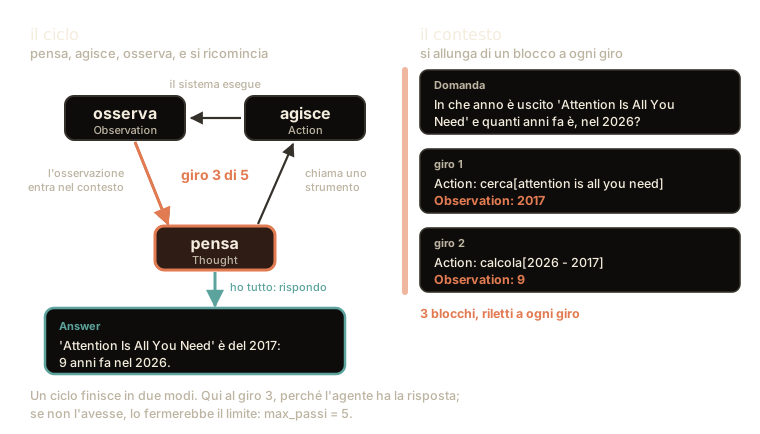
Fig. 20.7 Lo stesso giro, tre volte. A sinistra i passi che si ripetono; a destra quello che il modello si rilegge prima di decidere, più lungo di un blocco a ogni giro. Al terzo giro non serve nessuno strumento e l’agente esce dal ciclo con la risposta: è uno dei due modi in cui un ciclo finisce, l’altro è il limite di passi.#
La traccia è scritta da regole, quindi non dice niente su come si comporterebbe
un modello vero: mostra la struttura del ciclo. Il «modello» propone una mossa,
il sistema la esegue con uno strumento vero, e ciò che torna entra nella
traccia del giro seguente. Sostituisci llm_finto con un vero LLM a cui passi,
a ogni giro, la traccia accumulata e il catalogo degli strumenti, e hai (nella
sua ossatura essenziale) lo stesso ciclo che muove gli assistenti capaci di
navigare il web, eseguire codice e interrogare un archivio di dati.
Tutto il resto, nei sistemi reali, è il lavoro di reggere quando qualcosa va
storto. Sono tre mestieri. Bisogna sapere cosa fare quando il modello scrive
una chiamata malformata, cioè che non rispetta il formato concordato: il
giocattolo lo fa in piccolo, restituendo l’errore come osservazione. Bisogna
accorgersi che l’agente si è impantanato e ripete la stessa mossa
all’infinito, e fermarlo. In inglese quell’impantanarsi si dice «entrare in
loop», con la stessa parola che indica il ciclo dell’agente, e non per caso:
un ciclo infinito è lo stesso ciclo a cui manca una condizione d’arresto, che
nel giocattolo è max_passi. E bisogna decidere quali strumenti è prudente
mettergli in mano, visto che li userà davvero. Il testo che uno strumento
restituisce entra nel contesto come qualunque altro, e può contenere istruzioni
scritte da un terzo: è la prompt injection indiretta, e la ragione per cui i permessi di un agente
si concedono per compito e non per comodità.
Da ricordare
Un modello da solo conosce soltanto il testo su cui è stato addestrato: non sa l’ora, sbaglia i conti lunghi, ignora quello che è successo dopo. Il tool use gli dà le mani: invece di rispondere di pancia, riempie il modulo di uno strumento e lo passa di là; il programma che gli sta attorno lo esegue e gli riporta il risultato, che il modello ritrova davanti al giro dopo.
Ogni strumento si presenta con un modulo: come si chiama, a cosa serve, e cosa bisogna infilarci dentro perché funzioni. Il modello impara a scegliere l’attrezzo giusto e a riempire bene il modulo. Toolformer [SDYDessi+23] lo impara perfino da solo, come il ragazzo che scopre quando gli conviene la calcolatrice: prova a infilare una chiamata qua e là e tiene quelle che lo aiutano a indovinare meglio le parole successive.
Quando i sistemi esterni da collegare diventano venti, riscrivere il catalogo per ognuno non regge più, e ci si accorda su un modo unico di chiedere «che attrezzi hai?» ed «esegui questo». Quell’accordo si chiama protocollo, la stessa idea per cui due computer che non si sono mai visti si scambiano una pagina web; per gli attrezzi di un modello il più diffuso è MCP, presentato da Anthropic nel 2024. A parlarlo è l’applicazione che ospita il modello, non il modello, e la scheda con cui uno strumento si presenta la scrive chi lo fornisce: va letta con sospetto.
ReAct [YZY+23] è il metodo del detective che ragiona a voce alta: penso → chiedo → scopro, e si ricomincia (è lo stesso giro di prima, raccontato partendo dal pensiero). Le allucinazioni, cioè i fatti che il modello si inventa dicendoli con sicurezza, calano molto, senza sparire, perché ogni passo si appoggia a qualcosa che è stato davvero trovato; in cambio il ragionamento si irrigidisce e nasce un modo nuovo di sbagliare, la ricerca che non trova niente di utile.
Reflexion [SCB+23] è il quaderno di margine: dopo un fallimento l’agente si scrive a parole cosa è andato storto e riprova leggendo quell’appunto. Non cambia niente dentro la rete: cambia solo quello che legge prima di ricominciare.
Onestà sui limiti: rileggersi non è correggersi. Aiuta quando c’è qualcuno o qualcosa fuori che dice «giusto» o «sbagliato»; se l’unico giudice è il modello stesso, può convincersi di avere ragione avendo torto, e perfino rovinare una risposta che era buona.
Il ciclo dell’agente (guarda, pensa, agisci, ripeti fino alla risposta) è lo stesso del mini-agente di poche decine di righe e degli assistenti che navigano il web ed eseguono codice. Quello che cambia, nei sistemi veri, è tutto il lavoro di rendere il ciclo robusto quando qualcosa va storto.
Da ricordare
Un LLM da solo non sa l’ora, sbaglia i conti lunghi senza i passaggi e ignora ciò che è successo dopo l’addestramento. Con il tool use, invece di rispondere, emette una chiamata strutturata a uno strumento, che il sistema esegue e il cui risultato rientra nel contesto; se la chiamata non rispetta lo schema, si restituisce l’errore come osservazione o si vincola la decodifica (che garantisce la forma, non il contenuto).
Ogni strumento è uno schema (nome, descrizione, argomenti tipati, in JSON Schema:
type,properties,required); alla capacità di sceglierlo e di compilarne gli argomenti si arriva per due strade, addestrando il modello su tracce di chiamate già fatte oppure mostrandogliene qualcuna nel prompt, e l’addestramento la rende affidabile senza crearla. Toolformer [SDYDessi+23] impara da solo, con auto-supervisione, dove conviene chiamare un’API: tiene le chiamate che riducono la cross-entropia pesata sui cinque token a partire dal punto della chiamata. Non sa però comporre gli strumenti in catena, il problema di ReAct (che è di qualche mese prima).Un protocollo è un accordo su come si chiede a un sistema esterno che strumenti offre e come glieli si fa eseguire, e serve quando i sistemi da collegare sono tanti: con \(N\) applicazioni e \(M\) sistemi riduce le integrazioni da \(N \cdot M\) a \(N + M\). MCP (Anthropic, novembre 2024; dal dicembre 2025 a una fondazione della Linux Foundation) è il più diffuso: messaggi JSON-RPC fra host, client e server, strumenti scoperti con
tools/liste invocati contools/call, descrizioni da trattare come non fidate se il server non lo è.ReAct [YZY+23] intreccia in un loop Thought → Action → Observation, con il pensiero come azione in \(\mathcal{L}\) che cambia solo il contesto (senza pensieri, su ALFWorld, dal 71% al 45%): le osservazioni àncorano il ragionamento a fatti reali e le allucinazioni crollano, senza sparire (6% di risposte giuste con fatti inventati), ma è uno scambio, non un guadagno secco (fra le traiettorie fallite esaminate a mano, cinquanta per metodo, gli errori di ragionamento passano dal 16% della sola catena di pensiero al 47%, e si aggiunge il fallimento della ricerca a vuoto). La traccia è ispezionabile, ma non fedele [LCR+23, TMPB23]: contano le azioni, non i pensieri.
Reflexion [SCB+23] aggiunge una memoria verbale degli errori (le ultime una-tre critiche): dopo un fallimento l’agente si auto-critica a parole e riprova leggendo la critica, senza toccare i pesi; rispetto alla sola memoria del tentativo fallito, la critica vale circa otto punti su HotpotQA.
Onestà sui limiti: l’auto-critica non è auto-correzione garantita. Aiuta quando c’è un esito esterno affidabile (test scritti da altri, risultato verificabile); con un giudice auto-prodotto, o con il solo giudizio del modello, può confermare l’errore o peggiorare una risposta giusta.
Il ciclo dell’agente (osserva, pensa, agisci, ripeti fino alla risposta) è la stessa ossatura del mini-agente di poche decine di righe e degli assistenti che navigano il web ed eseguono codice; la differenza è la robustezza attorno.