


Neural style transfer: la tua foto dipinta da van Gogh#
Nell’estate del 2015 tre ricercatori dell’Università di Tubinga (Leon Gatys, Alexander Ecker e Matthias Bethge) misero online una manciata di immagini destinate a fare il giro del mondo: la Neckarfront, la fila di case sul fiume che è la cartolina della loro città, ridipinta nello stile della Notte stellata di van Gogh, dell’Urlo di Munch, di una composizione di Kandinsky [GEB16]. Nessun pittore e nessun filtro fotografico: solo una rete convoluzionale e la solita correzione a piccoli passi. Il metodo aveva un difetto (minuti di calcolo per una singola immagine) ma l’idea era irresistibile, e l’anno dopo scappò dal laboratorio: nel giugno 2016 l’app Prisma la portò in tasca a milioni di persone, con dieci milioni di download nelle prime settimane e settanta milioni in quattro mesi. Per un’estate i social si riempirono di gatti dipinti alla van Gogh.
Dietro il giocattolo c’è una domanda seria: che cosa sono, per una rete neurale, il contenuto di un’immagine e il suo stile? E si possono separare? Lo schema della risposta è in Fig. 11.15.

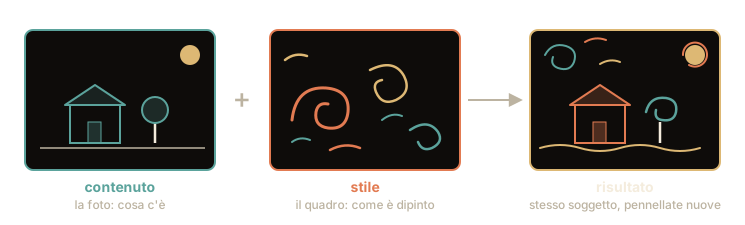
Fig. 11.15 Il neural style transfer combina il contenuto di una foto (cosa c’è) con lo stile di un quadro (come è dipinto) in un’unica immagine nuova.#
L’idea capovolta: si ottimizza l’immagine, non la rete#
Fin qui «addestrare» ha voluto dire una cosa sola: si correggono a piccoli passi i pesi della rete, cioè i numeri interni che decidono come si comporta, finché le sue risposte non migliorano. Il neural style transfer capovolge lo schema. La rete, una VGG (il nome viene dal laboratorio di Oxford che la costruì) già addestrata a riconoscere oggetti sul grande archivio di foto etichettate ImageNet [SZ15], non impara nulla: i suoi pesi restano congelati. A muoversi, un piccolo passo alla volta, sono i pixel dell’immagine.
Un critico d’arte dal giudizio infallibile ma immobile: non cambia mai idea, sa solo valutare. Gli mostri una tela e lui ti dice due cose: quanto la scena somiglia ancora alla tua foto, e quanto la pennellata somiglia a quella del quadro che vuoi imitare. E non si ferma ai due voti: per ogni puntino della tela sa dirti se, per migliorarli, conviene schiarirlo o scurirlo, e di quanto. Tu ritocchi la tela un pochino in quella direzione, gliela rimostri, ritocchi ancora: centinaia di volte. Alla fine la tela è la tua foto, ma dipinta.
Una domanda che viene naturale: da che cosa si parte, la prima volta? Da quello che si vuole, e cambia meno di quanto si creda. Partire dalla foto stessa dà al critico metà del lavoro già fatto, e il risultato si piega un poco verso la disposizione della foto; partire da una tela di puntini a caso, quello che si chiama rumore, come uno schermo televisivo senza segnale, chiede più pazienza. Alla fine le tele si somigliano, con una differenza: da una partenza sempre uguale esce sempre lo stesso quadro, mentre da puntini diversi escono quadri diversi.
Il critico è la rete convoluzionale: ha già imparato a «vedere» su milioni di immagini e qui non deve imparare altro. Ciò che cambia, ritocco dopo ritocco, è soltanto l’immagine.
Formalmente è lo stesso problema di ottimizzazione, con le variabili scambiate. L’addestramento classico cerca i parametri migliori a dati fissati,
qui cerchiamo l’immagine migliore a parametri fissati:
dove \(\mathbf{X}\) è il tensore-immagine che stiamo generando e \(\theta\) sono i
pesi (congelati) della VGG. Per autograd non fa differenza: basta dichiarare
\(\mathbf{X}\) come foglia con requires_grad_(True) e la backpropagation
restituisce \(\partial \mathcal{L} / \partial \mathbf{X}\), il gradiente della
loss rispetto ai pixel. È lo stesso meccanismo che rende possibili gli esempi
avversari (immagini ritoccate in modo impercettibile apposta per ingannare una
rete), qui usato a uno scopo diverso.
Perché proprio una rete già addestrata? Perché, come abbiamo visto nel capitolo sul Deep Learning e ritrovato nella sezione sul transfer learning, i suoi strati formano una gerarchia: i canali dei primi strati rispondono a bordi, colori e piccole trame, quelli profondi a parti di oggetti e a oggetti interi, perché a ogni strato cresce il campo recettivo, la porzione d’immagine che ciascun canale vede [ZF14]. Serve proprio questo, perché una pennellata e un campanile stanno a due scale diversissime e qui vanno giudicati tutti e due, dalla stessa rete, nello stesso momento: il contenuto si legge in uno strato profondo, lo stile in strati di ogni profondità, dai granelli di colore alle volute larghe.
Contenuto e stile: cosa c’è, come è dipinto#
La scoperta di Gatys e colleghi è che dentro questa gerarchia contenuto e stile si lasciano in buona parte separare e ricombinare. Non del tutto: di solito non esiste un’immagine che soddisfi alla perfezione insieme il contenuto di una foto e lo stile di un quadro, ed è per questo che la loss, più avanti, sarà un compromesso fra due termini.
In un quadro ci sono due cose sovrapposte: il soggetto (una notte, un paese, un cipresso) e la mano del pittore (la tavolozza dei colori, lo spessore e la direzione delle pennellate, il ritmo delle trame). Riconosci un van Gogh da tre centimetri quadrati di cielo, senza sapere cosa rappresenta il quadro: quella è la mano, non il soggetto. È come la grafia di un amico: la riconosci su qualunque parola, perché non dipende da cosa scrive ma da come scrive.
Nella rete succede lo stesso. Il «cosa c’è» abita negli strati profondi, quelli che si accendono sugli oggetti e sulla loro disposizione. Lassù la rete registra che c’è una casa con un albero a destra, e non di che colore sia ogni singolo puntino. Due tele possono avere un colore diverso in ogni punto e accendere gli stessi filtri profondi. Sul contenuto il critico si accontenta di quella somiglianza, ed è la ragione per cui una foto si può ridipingere da cima a fondo senza che la scena vada perduta.
Il «come è dipinto» abita invece in una domanda diversa, e conviene arrivarci per gradi. Prendi uno dei primi strati: dentro ci sono qualche decina o centinaio di filtri, le lenti piccole che scorrono sull’immagine, e ciascuno si accende su una cosa diversa, uno sulle righe oblique, uno sul giallo acceso, uno sulle curve strette, uno sul blu scuro. Quelli sono i motivi elementari: non li ha scelti nessuno, se li è costruiti la rete addestrandosi su ImageNet, e sono gli stessi qualunque quadro le si metta davanti.
Adesso la domanda: quali di questi filtri si accendono insieme, negli stessi punti del quadro? Nella Notte stellata «curva stretta» e «blu scuro» si accendono quasi sempre nello stesso posto, perché van Gogh disegna le spirali col blu; «riga obliqua» e «giallo» pure. Si prendono allora tutte le coppie possibili di filtri e si conta, per ciascuna, quanto spesso e con quanta forza i due si accendono insieme, senza segnarsi dove. Quella tabella di conteggi è la carta d’identità della mano del pittore: dice quali ingredienti vanno assieme e non dice niente su dove stiano, ed è esattamente per questo che si può appiccicare a un’altra scena. Con la sola tabella, senza nessuna foto da rispettare, si può perfino fabbricare una superficie nuova con la stessa mano: una stoffa, una corteccia, un cielo a spirali.
Il contenuto è codificato dalle attivazioni di uno strato profondo (nel
paper, conv4_2 della VGG-19): due immagini con attivazioni profonde simili
mostrano gli stessi oggetti nella stessa disposizione, anche se differiscono
pixel per pixel.
Lo stile è codificato dalle correlazioni tra i canali di uno strato. Allo strato \(l\) la rete produce \(N_l\) mappe di attivazione, ciascuna di \(M_l\) posizioni (l’altezza per la larghezza della mappa); srotolando ogni mappa in una riga si ottiene la matrice \(\mathbf{F}^{(l)} \in \mathbb{R}^{N_l \times M_l}\). La matrice di Gram è
dove l’elemento \(G^{(l)}_{ij}\) è il prodotto scalare tra il canale \(i\) e il canale \(j\): misura quanto i due filtri si attivano insieme, sommando su tutte le posizioni spaziali. In quella somma la geometria della scena sparisce: resta solo la statistica delle co-occorrenze di texture e colori, cioè lo stile. È per questo che il risultato conserva la disposizione della foto ma non copia i cipressi di van Gogh: della Notte stellata sopravvivono solo le correlazioni. L’idea viene da un lavoro degli stessi autori di pochi mesi prima, sulla sintesi di texture: lì una texture è descritta dalle matrici di Gram di una rete convoluzionale, e se ne generano di nuove cercando un’immagine che abbia le stesse Gram [GEB15]. Il trasferimento di stile è quella sintesi con un vincolo in più, il contenuto di un’altra immagine da tenere fermo, ed è così che lo presentano gli autori stessi.
La loss composita: due giudizi in un voto solo#
Per fondere le due cose serve un numero che dica quanto la tela è ancora sbagliata, e che sommi i due giudizi del critico. Quel numero si chiama loss (alla lettera «perdita»), come in ogni addestramento visto finora: più è alto, più c’è da correggere, e il gradiente serve appunto ad abbassarlo. Qui la loss, scritta \(\mathcal{L}\), è la somma di due voci, una per giudice:
dove \(\mathcal{L}_{\text{contenuto}}\) misura quanto la tela si è allontanata dalla foto di partenza, \(\mathcal{L}_{\text{stile}}\) quanto la pennellata è ancora diversa da quella del quadro, e \(\alpha\) e \(\beta\) sono i due coefficienti che decidono a quale delle due voci dare più importanza.
\(\alpha\) e \(\beta\) sono due manopole. Con \(\alpha\) alto comanda il giudice del contenuto: la foto resta quasi intatta, con una leggera patina pittorica. Con \(\beta\) alto comanda il giudice dello stile: le pennellate prendono il sopravvento, e oltre un certo punto della casa non resta niente di riconoscibile.
Il giudice dello stile, poi, non è uno solo. Guardare una tela col naso attaccato o dall’altra parte della stanza sono due esami diversi. Da vicino si vedono i granelli di colore, a un passo le singole pennellate, da lontano le volute larghe che attraversano il cielo. Si compila allora una tabella di conteggi per ciascuna di queste distanze, si confronta ognuna con la tabella corrispondente del quadro e si sommano gli scarti, dando a ogni distanza la sua importanza. Uno stile copiato a una distanza sola si riconosce subito, perché o le pennellate sono giuste e il ritmo grande del cielo non c’è, o il ritmo c’è e la materia resta liscia come una stampa.
I voti dei due giudici nascono di taglia diversa. Uno confronta scene, l’altro tabelle di conteggi, e i loro numeri stanno su scale lontane come metri e chilometri; le manopole servono prima di tutto a rimetterli in pari. In pratica allo stile tocca il numero molto più grande, per esempio \(\alpha = 1\) contro \(\beta = 1000\). Il voto dello stile arriva minuscolo, e quel mille lo rialza fino a farsi sentire accanto all’altro. Trovato l’ordine di grandezza, l’equilibrio fine è questione di gusto, letteralmente: si prova e si guarda il risultato.
Attenzione però a un tranello: quel mille non è un numero universale. Basta cambiare la ricetta con cui i due voti si calcolano e cambia anche il rapporto che li mette in pari, perché un conto che restituisce voti più piccoli chiede un \(\beta\) molto più grande per arrivare allo stesso equilibrio. Un numero del genere va sempre riletto insieme alla ricetta che lo accompagna, e mai copiato da solo.
Il termine di contenuto confronta le attivazioni dello strato scelto \(l\) tra immagine generata e foto:
dove \(\mathbf{F}^{(l)}\) e \(\mathbf{P}^{(l)}\) sono le mappe di attivazione
dell’immagine generata e della foto di contenuto: qui \(i\) è il canale e \(j\) la
posizione, mentre nella Gram poco sopra erano canali tutti e due. Il termine di
stile
confronta le matrici di Gram su più strati (nel paper, il primo strato di
ogni blocco: conv1_1, conv2_1, conv3_1, conv4_1, conv5_1):
dove \(\mathbf{G}^{(l)}\) e \(\mathbf{A}^{(l)}\) sono le Gram dell’immagine generata e del quadro di stile allo strato \(l\), \(w_l\) è il peso dello strato (nel paper \(1/5\) per ciascuno dei cinque) e il fattore \(1/(4 N_l^2 M_l^2)\) rende confrontabili strati di taglia diversa: ogni entrata della Gram è una somma su \(M_l\) posizioni, quindi il suo scarto al quadrato cresce come \(M_l^2\), e le entrate sono \(N_l^2\). La scelta della Gram ha una lettura precisa. Trattando le \(M_l\) colonne di \(\mathbf{F}^{(l)}\) come campioni di una distribuzione di feature, \(\mathbf{G}^{(l)}/M_l\) ne è il momento secondo non centrato, e se le due immagini hanno la stessa taglia il termine di stile di uno strato è, a meno della costante \(1/(4N_l^2)\), la maximum mean discrepancy al quadrato fra le feature dell’immagine generata e quelle del quadro, con il nucleo polinomiale \(k(\mathbf{a}, \mathbf{b}) = (\mathbf{a}^\top \mathbf{b})^2\) [LWLH17]. Lo stile, in questo senso, è una distribuzione di feature a cui si è tolta la posizione, confrontata sui soli momenti del secondo ordine. Usare più strati cattura lo stile a più scale: dai granelli di colore alle volute larghe. Nel paper il rapporto \(\alpha/\beta\) è dell’ordine di \(10^{-3}\)–\(10^{-4}\), ma quel numero è solidale con la normalizzazione appena scritta: cambiandola cambia il rapporto utile, e un’implementazione che normalizza le Gram in un altro modo chiede un \(\beta\) di tutt’altra taglia.
In pratica, con PyTorch#
Bastano poche decine di righe: una VGG-19 congelata da cui leggere le attivazioni, un’immagine dichiarata «ottimizzabile» e il solito loop, con l’ottimizzatore che riceve i pixel al posto dei pesi. Contenuto e stile, qui, sono due fotografie che scikit-learn porta con sé, un tempio e un fiore, ridotte a 128 pixel di lato perché il conto resti breve anche senza una GPU.
import torch
from torch import nn, optim
from torchvision import models
from torchvision.transforms import functional as TF
from sklearn.datasets import load_sample_images

device = "cuda" if torch.cuda.is_available() else "cpu"

# 1. VGG-19 pre-addestrata: solo la parte convoluzionale, congelata
#    (alla prima esecuzione scarica circa 550 MB di pesi)
vgg = models.vgg19(weights=models.VGG19_Weights.IMAGENET1K_V1)
vgg = vgg.features.to(device).eval()
for p in vgg.parameters():
    p.requires_grad_(False)

STRATI_STILE = [1, 6, 11, 20, 29]   # conv1_1 ... conv5_1, dopo la loro ReLU
STRATO_CONTENUTO = 22               # conv4_2, dopo la sua ReLU

def attivazioni(x):
    stile, contenuto = [], None
    for i, strato in enumerate(vgg):
        x = strato(x)
        if i in STRATI_STILE:
            stile.append(x)
        elif i == STRATO_CONTENUTO:
            contenuto = x
        if i == STRATI_STILE[-1]:
            break                    # oltre la ReLU di conv5_1 non serve
    return stile, contenuto

def gram(f):
    _, c, h, w = f.shape             # f: (1, c, h, w)
    F = f.view(c, h * w)
    return F @ F.T / (c * h * w)     # Gram (c, c), normalizzata a modo nostro:
                                     # non e' la 1/(4 N^2 M^2) del paper, quindi
                                     # il beta qui sotto non e' quello del paper

# Due fotografie che scikit-learn porta con sé: un tempio fa da contenuto,
# un fiore da stile. Si riducono a 128x128 e si normalizzano come ImageNet.
def prepara(a, lato=128):
    x = torch.from_numpy(a.copy()).permute(2, 0, 1).float().div(255)[None]
    x = TF.resize(x, [lato, lato], antialias=True)
    media, dev = [0.485, 0.456, 0.406], [0.229, 0.224, 0.225]
    return TF.normalize(x, media, dev).to(device)

tempio, fiore = load_sample_images().images
img_contenuto, img_stile = prepara(tempio), prepara(fiore)

with torch.no_grad():
    stile_rif, _ = attivazioni(img_stile)
    _, contenuto_rif = attivazioni(img_contenuto)
    gram_rif = [gram(f) for f in stile_rif]

# 2. Si ottimizza l'IMMAGINE: parte dalla foto, il gradiente scende sui pixel
img = img_contenuto.clone().requires_grad_(True)
opt = optim.Adam([img], lr=0.02)
alpha, beta = 1.0, 1e5           # la taglia di beta dipende da come si
                                 # normalizza la gram() qui sopra: quella del
                                 # paper ne chiede un'altra

for passo in range(300):
    opt.zero_grad()
    stile_gen, contenuto_gen = attivazioni(img)
    l_contenuto = nn.functional.mse_loss(contenuto_gen, contenuto_rif)
    l_stile = sum(nn.functional.mse_loss(gram(f), g)
                  for f, g in zip(stile_gen, gram_rif))
    loss = alpha * l_contenuto + beta * l_stile
    loss.backward()
    opt.step()
    if passo % 100 == 0:
        print(passo, round(loss.item(), 1))
0 44.4
100 17.4
200 15.8
Quattro dettagli pratici separano questo codice dall’articolo originale di Gatys, oltre alla normalizzazione della Gram già segnalata nei commenti.
Da dove si parte. Qui si parte dalla foto, mentre nell’articolo si partiva dai puntini a caso. Partire dalla foto fa arrivare al risultato in meno passi e piega un po’ l’esito verso la struttura della foto, ma non lo rende «più fedele» in generale: gli autori osservano che il punto di partenza incide poco sull’esito finale. Quello a cui si rinuncia è la varietà, perché da una partenza sempre uguale esce sempre la stessa immagine, mentre dai puntini a caso se ne possono generare quante se ne vuole.
Chi decide i passi. Il ritocco della tela è affidato a un ottimizzatore, cioè al pezzo di codice che, calcolato l’errore, decide come muovere i pixel. Gli autori usavano L-BFGS, un metodo che oltre alla pendenza stima anche quanto la loss si incurva, e che su un problema come questo arriva in meno passi ma va richiamato in un modo tutto suo; noi usiamo Adam, che è lo stesso del ciclo di addestramento già visto, e funziona benissimo.
Un ritocco alla rete. Gli autori, dove la VGG tiene solo il valore più
grande di ogni quadratino, preferivano tenerne la media
(MaxPool2d sostituito da nn.AvgPool2d(2, 2)), che a loro dire dà risultati
leggermente più gradevoli, e le immagini famose sono fatte così. Qui usiamo la
vgg19 di torchvision com’è, come fa anche il tutorial ufficiale di PyTorch.
Una rete riscalata. Gli autori riscalavano i pesi della VGG in modo che l’attivazione media di ogni filtro, su immagini e posizioni, valesse uno. In una rete che ha solo ReLU e nessuna normalizzazione questo non cambia l’uscita, ma cambia la taglia dei numeri da cui escono le due voci della loss [GEB16]. Qui la rete non è riscalata, ed è un’altra ragione per cui il rapporto fra \(\alpha\) e \(\beta\) non si copia da un’implementazione all’altra.
L’eredità: da minuti a millisecondi#
Il limite del metodo di Gatys è strutturale: ogni immagine è un problema di ottimizzazione a sé, centinaia di passi di gradiente ogni volta. Johnson, Alahi e Fei-Fei [JAFF16] lo aggirarono con una mossa elegante: usare la loss di Gatys non per generare un’immagine, ma per addestrare una rete che trasforma qualunque foto in quello stile con una passata sola, senza ritocchi successivi (in gergo, una rete feed-forward). L’ottimizzazione costosa si paga una volta sola, in fase di addestramento; dopo, applicare lo stile costa circa mille volte meno (tre ordini di grandezza), abbastanza per un video in tempo reale. È la famiglia di tecniche che ha reso possibili app come Prisma, con il compromesso di una rete da addestrare per ciascuno stile. Il compromesso è durato poco: già nel 2016 c’erano reti capaci di più stili, e la forma rimasta è quella di Huang e Belongie [HB17]: per trasferire uno stile qualunque basta allineare, canale per canale, media e deviazione standard delle attivazioni del contenuto a quelle dello stile. Ogni motivo della foto viene acceso, in media, quanto nel quadro, e con la stessa variabilità:
dove \(\mu\) e \(\sigma\) si calcolano per canale sulle posizioni: una rete sola, un quadro qualunque, una passata. È una versione ridotta della matrice di Gram, la tabella di quanto ogni coppia di canali si accende insieme: invece della tabella intera confronta soltanto la media e l’ampiezza di ciascun canale, e lascia cadere le correlazioni fra canali. È anche l’operazione che StyleGAN porterà dentro il suo generatore di volti, livello per livello, nella sezione sulle evoluzioni delle GAN (GAN sta per generative adversarial network, le «reti generative avversarie»).
La storia poi è proseguita altrove. Per insegnare a un programma a tradurre una foto in un quadro il modo ovvio sarebbe mostrargli tante coppie, la stessa identica scena fotografata e dipinta, e nessuno le ha: Monet è morto e non torna a dipingere su commissione. CycleGAN [ZPIE17] ha risolto il problema imparando senza coppie, da due mucchi separati e non corrispondenti, tante foto da una parte e tanti Monet dall’altra. E oggi il trasferimento di stile è una delle tante abilità dei modelli di diffusione, i generatori di immagini che partono dal rumore e lo ripuliscono un passo alla volta [RBL+22]: partendo da una fotografia e da un’istruzione scritta, la ridipingono nello stile richiesto [BHE23]. Di tutti e due parla la stessa sezione sulle GAN. Ma l’idea di fondo, contenuto e stile come due conteggi diversi dentro una stessa rete, nasce qui, da una passeggiata sul Neckar.
Da ricordare
Qui non si addestra la rete: il critico d’arte (una rete che ha già imparato a vedere) non cambia mai idea, e a essere ritoccata centinaia di volte è la tela, cioè l’immagine stessa.
Il contenuto (cosa c’è: la casa, il cipresso) si legge negli strati profondi della rete; lo stile (come è dipinto) sta in quali motivi elementari si accendono insieme, e con quanta forza: è la carta d’identità della mano del pittore, e non dipende da dove quei motivi si trovino nell’immagine.
Il giudizio da migliorare somma due voci, fedeltà al soggetto e fedeltà alla pennellata, pesate da due manopole: alzando quella dello stile le pennellate prendono il sopravvento, alzando quella del contenuto la foto resta quasi intatta. Una tela che accontenti tutte e due alla perfezione di solito non esiste: è un compromesso.
Chi ha fretta fa la fatica una volta sola: invece di ritoccare la tela per ogni foto, addestra una rete apposta per un solo stile, e da quel momento dipingere una foto qualunque è questione di un istante, abbastanza da stare dietro anche a un video. Nelle prime versioni serviva una rete per ogni stile; dal 2017 ne basta una, che del quadro prende soltanto la media e l’ampiezza di ogni motivo.
Da ricordare
Nel neural style transfer non si addestra la rete: i pesi della VGG restano congelati e il gradiente scende sui pixel dell’immagine.
Il contenuto vive nelle attivazioni degli strati profondi (cosa c’è); lo stile nelle correlazioni tra canali, riassunte dalla matrice di Gram \(\mathbf{G} = \mathbf{F}\mathbf{F}^{\top}\) (come è dipinto), la stessa statistica della sintesi di texture. I due si separano solo in parte, e la loss è un compromesso.
La loss è composita: \(\mathcal{L} = \alpha\,\mathcal{L}_{\text{contenuto}} + \beta\,\mathcal{L}_{\text{stile}}\), con \(\alpha\) e \(\beta\) a bilanciare fedeltà e pennellata.
Il fast style transfer sposta il costo nell’addestramento di una rete feed-forward: stile applicato in una sola passata, in tempo reale. Con AdaIN basta una rete per qualunque stile, allineando media e deviazione standard di ogni canale.
In tutto il capitolo, da qualche parte, c’era sempre un bersaglio già scritto, la risposta giusta con cui confrontare quella della rete: l’etichetta della foto, il riquadro intorno all’oggetto, la maschera dei pixel, le fotografie vere che una scena ricostruita doveva rifare, e perfino qui, dove il bersaglio era un quadro appeso in un museo. Quando il bersaglio mancava, la rete se lo fabbricava da sé, confrontando due viste della stessa foto oppure nascondendone un pezzo e provando a indovinarlo. Da qui il bersaglio sparisce del tutto, in due tempi: prima con programmi che non imparano niente e se la cavano guardando avanti nelle mosse possibili, poi con agenti che imparano e a cui nessuno dice mai la risposta giusta, perché l’unica cosa che torna indietro è come è andata a finire.