


Moduli: costruire il modello#
Verso la metà degli anni Novanta, Yann LeCun e i suoi colleghi ai Bell Labs presero decine di migliaia di cifre scritte a mano (raccolte su formulari cartacei da impiegati dell’ufficio del censimento statunitense e da studenti delle scuole superiori), le normalizzarono e le centrarono in quadratini di \(28\times 28\) pixel. Ne nacque MNIST (Modified NIST): 70.000 immagini in scala di grigi, ciascuna una cifra da \(0\) a \(9\), divise in 60.000 esempi di addestramento e 10.000 di test [LBBH98]. Da allora MNIST è il «Hello, world!» del deep learning: piccolo abbastanza da addestrarsi in pochi secondi, ricco abbastanza da mostrare tutto il ciclo di vita di un modello. Qui costruiamo il modello che leggerà quelle cifre; addestrarlo viene subito dopo.
nn.Module: il mattone di ogni rete#
In PyTorch qualunque pezzo di rete (un singolo strato, un blocco, il modello
intero) è un modulo, cioè una classe che eredita da nn.Module. (Il
nn che da qui in poi si incontra quasi a ogni riga sta per neural
networks: è la parte di PyTorch che contiene i pezzi con cui si montano le
reti.) È la scelta di design più caratteristica di PyTorch: il modello non
si descrive in un elenco a parte da consegnare alla libreria, ma si scrive come
una normale classe Python.
Abbiamo incontrato le classi e l’ereditarietà nella sezione sulle basi di Python, con l’immagine dello stampo per biscotti: una classe è
lo stampo, l’oggetto è il biscotto, ed ereditare vuol dire partire da uno
stampo che esiste già e aggiungergli qualcosa. Nel codice l’eredità si scrive
mettendo il nome della classe di partenza fra parentesi,
class MLP(nn.Module):. Il metodo __init__ (il costruttore, eseguito quando
l’oggetto viene creato) costruisce i pezzi della rete e li assegna ad
attributi, e la sua prima riga è super().__init__(): prepara gli elenchi
interni di nn.Module, quelli in cui finiranno i pezzi, e senza di lei la
prima assegnazione di uno strato si ferma con un AttributeError. Per questo
la si ritroverà, identica, in ogni modello del capitolo. Ciò che si eredita da
nn.Module è molto: tenere il conto di tutti i pesi sparsi nella rete,
spostarli tutti insieme sulla scheda grafica, salvarli su un file, consegnarli
all’ottimizzatore. Dei gradienti si occupa autograd: i pesi sono
nn.Parameter, cioè tensori con requires_grad=True, e vengono tracciati
senza altro lavoro.
Ecco il modello per MNIST, intero; le righe che contano sono i due metodi, e li smontiamo subito sotto.
import torch
from torch import nn

class MLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.flatten = nn.Flatten()          # da griglia 28x28 a vettore 784
        self.hidden = nn.Linear(28 * 28, 128)  # ogni ingresso collegato a ogni neurone
        self.out = nn.Linear(128, 10)        # 10 uscite: una per cifra 0-9

    def forward(self, x):
        x = self.flatten(x)
        x = torch.relu(self.hidden(x))       # ReLU: i numeri negativi diventano zero
        return self.out(x)                   # punteggi grezzi, non probabilità

model = MLP()
print(model)          # elenca i pezzi che compongono il modello
# MLP(
#   (flatten): Flatten(start_dim=1, end_dim=-1)
#   (hidden): Linear(in_features=784, out_features=128, bias=True)
#   (out): Linear(in_features=128, out_features=10, bias=True)
# )
Due metodi, due domande. In __init__ si dice di quali pezzi è fatta la rete:
qui uno strato che srotola l’immagine, uno nascosto da 128 neuroni e uno
d’uscita da 10. I 784 in ingresso sono obbligati (\(28 \times 28\), i pixel
dell’immagine) e i 10 in uscita pure (le cifre da 0 a 9); il 128 nel mezzo no,
l’abbiamo scelto noi. Un valore più grande dà una rete più capiente e più
lenta, uno più piccolo il contrario: si prova, e come si sceglie è l’argomento
della sezione sul flusso di lavoro.
Scrivere un pezzo come self.qualcosa lo fa entrare da solo nell’inventario
della rete. È quell’inventario che l’addestramento andrà a regolare, e basta
una riga per salvarlo tutto su un file o per spostarlo tutto insieme sulla
scheda grafica. Se invece i pezzi si mettono in una normale lista di Python,
per esempio self.strati = [nn.Linear(784, 128), nn.Linear(128, 10)],
funzionano benissimo quando i dati ci passano attraverso, ma nell’inventario
non compaiono: nessuno li addestra, nessuno li salva, e restano com’erano
appena creati. E il giorno in cui la rete trasloca sulla scheda grafica quei
pezzi restano indietro, perché a spostare l’inventario ci pensa una riga sola e
loro nell’inventario non ci sono: lì il guasto smette di essere silenzioso e il
programma si ferma. Per una fila di pezzi c’è una lista apposta,
nn.ModuleList, che li mette in inventario uno per uno.
In forward si dice che strada fanno i dati: entra l’immagine, viene
srotolata, passa per lo strato nascosto e poi per la ReLU (che è un filtro
semplicissimo: lascia passare i numeri positivi e schiaccia a zero i
negativi), ed esce come 10 punteggi, uno per cifra. Dentro lo strato non
succede niente di misterioso: ogni neurone guarda tutti i numeri che gli
arrivano, li somma dopo aver moltiplicato ciascuno per un numero suo, e al
totale ne aggiunge un altro. Il filtro non sta dentro lo strato: lo si applica
a parte, ai numeri che dallo strato escono, e chi scrive la rete deve
ricordarsi di metterlo.
Tutto il resto lo fanno altri: nn.Module tiene il conto dei pesi, li sposta e
li salva, e il registratore di autograd, già acceso su ciascun peso, ne calcola
i gradienti. E siccome forward è normale Python, ci si può mettere un print
per sbirciare o un if per cambiare strada: il modello è codice che gira, non
una descrizione da consegnare a qualcun altro. Nessuno, però, chiama forward
per nome: il modo di farlo partire è model(x), con le parentesi attaccate
all’oggetto come a una funzione, e non model.forward(x). Le due righe
sembrano la stessa cosa e danno lo stesso risultato, ma la seconda salta i
ganci che altri strumenti attaccano al passaggio dei dati: quello che stampa la
forma dei numeri a ogni strato, o quello che spegne una parte dei pesi per
alleggerire la rete. Non arriva nessun errore, e quegli strumenti smettono di
lavorare senza dirlo.
nn.Module fornisce la contabilità dei parametri: ogni attributo che sia
a sua volta un modulo (o un nn.Parameter) viene registrato automaticamente,
e model.parameters() restituisce l’iteratore su tutti i parametri
registrati, anche su quelli con requires_grad=False (è quello che passeremo
all’ottimizzatore). Ciò che invece finisce in una lista Python ordinaria non
viene registrato: il forward lo usa lo stesso, ma resta fuori da
parameters() e dallo state_dict(). Per una sequenza di moduli di lunghezza
variabile si usa nn.ModuleList (o nn.ModuleDict se servono i nomi,
nn.ParameterList per i parametri), che li registra: i loro parametri
compaiono in parameters() e le chiavi dello state_dict portano l’indice
(strati.0.weight). Un tensore che fa parte dello stato ma non dei parametri
si registra con register_buffer, e con persistent=False resta fuori dallo
state_dict. nn.Linear(d, u) realizza la trasformazione affine
dove \(\mathbf{x}\) sono i \(d\) numeri che entrano e \(\mathbf{h}\) i \(u\) che escono
(scritti come colonne), \(\mathbf{W} \in \mathbb{R}^{u \times d}\) è la matrice
dei pesi e \(\mathbf{b} \in \mathbb{R}^{u}\) il vettore dei bias. Sono
nn.Parameter, cioè tensori con requires_grad=True, e autograd li traccia
senza altro lavoro (con bias=False il termine \(\mathbf{b}\) non c’è). Il loro
valore iniziale è un sorteggio uniforme in \(\left[-1/\sqrt{d},\,
1/\sqrt{d}\right]\), per i pesi come per i bias (nel sorgente kaiming_uniform_
con a=math.sqrt(5), che nonostante il nome è un’altra ricetta rispetto a
quella di He: la varianza è \(1/(3d)\), un sesto della sua); nn.Conv2d fa lo
stesso con \(d = C_{\text{in}} k^2\), il numero di valori che ogni filtro legge.
Il motivo per cui conta, e che cosa usare al suo posto, si trovano nella
sezione sull’inizializzazione. Su un batch la libreria
lavora nell’altra forma, quella con una riga per ogni esempio: dato \(\mathbf{X}
\in \mathbb{R}^{B \times d}\), con \(B\) esempi nel batch, calcola
\(\mathbf{X}\mathbf{W}^\top + \mathbf{b}\), che è la stessa trasformazione
trasposta, e .weight conserva la forma \(u \times d\). Si noti che
l’attivazione non è «dentro» lo strato, come accade in altre librerie: è una
funzione (torch.relu) o un modulo (nn.ReLU) applicato esplicitamente in
forward; coerente con la filosofia «il modello è il codice». La chiamata
model(x) invoca forward attraverso __call__, che esegue anche gli hook
registrati sul modulo (register_forward_pre_hook, register_forward_hook,
register_full_backward_hook). Ci si appoggiano strumenti come torchinfo,
che con un forward hook legge la forma di ogni strato, e la potatura di
torch.nn.utils.prune, che con un pre-hook applica la maschera ai pesi prima
di ogni passata: model.forward(x) li salta tutti senza nessun errore, ed è
per questo che non lo si chiama mai direttamente.
mm = nn.Linear(2, 2)
chiamate = []
mm.register_forward_hook(lambda modulo, ingresso, uscita: chiamate.append(1))
mm(torch.randn(1, 2))           # passa da __call__: l'hook scatta
mm.forward(torch.randn(1, 2))   # chiamata diretta: l'hook no
print(len(chiamate))
1
La scorciatoia: nn.Sequential#
Quando la rete è una semplice catena (l’uscita di uno strato entra nel successivo, senza rami), la classe si può evitare del tutto:
model = nn.Sequential(
    nn.Flatten(),
    nn.Linear(28 * 28, 128),
    nn.ReLU(),
    nn.Linear(128, 10),
)
Un autolavaggio a tunnel: l’auto entra da un capo, incontra il prelavaggio, le
spazzole, il risciacquo, la cera e l’asciugatura, sempre in quest’ordine, e ne
esce dall’altro capo. nn.Sequential descrive la rete esattamente così:
elenchi i passaggi nell’ordine in cui il dato li attraversa, e i collegamenti
si fanno da soli. Nota che qui anche la ReLU è un passaggio del tunnel
(nn.ReLU()): l’asciugatura non lava niente, ma sta in fila come tutti gli
altri passaggi, e senza di lei quello che esce non è la stessa cosa. È la
stessa ReLU di prima in un’altra veste: torch.relu è il verbo, da scrivere
dentro forward, nn.ReLU() è il pezzo, da mettere in fila.
Si usa questa scrittura finché la rete è una fila. Si torna
alla classe il giorno in cui la fila non basta più, cioè quando il dato deve
prendere due strade e ricongiungersi dopo, o saltare un passaggio: un tunnel a
corsia unica non lo sa fare, e un elenco non lo sa scrivere; in forward sì,
perché lì sono normali variabili Python.
nn.Sequential modella una funzione composta
\(f = f_L \circ \dots \circ f_2 \circ f_1\), dove la lista ne fissa l’ordine di
composizione. È adatta a topologie lineari (un ingresso, un’uscita, nessuna
ramificazione); per più input, skip connection o rami paralleli (come le
ResNet che incontreremo nel capitolo sul deep learning) si torna a nn.Module
con un forward esplicito, dove le ramificazioni sono semplici variabili
Python. È la differenza rispetto a Keras, che per descrivere un grafo con rami
affianca all’API Sequential un’API funzionale separata: in PyTorch non serve,
perché la composizione arbitraria è già Python. Il limite di nn.Sequential è
preciso: da un modulo al successivo passa un solo tensore, e un modulo che ne
vuole due solleva un TypeError. Per MNIST la pila lineare basta e avanza.
Quanti parametri ha questa rete?#
I parametri sono i numeri che il modello impara, quelli che l’addestramento regolerà: pesi e bias tutti insieme. Non tutti i pezzi ne hanno: quello che srotola l’immagine sposta i numeri e non li cambia, quindi non ha parametri. Contarli è il primo controllo da fare su qualunque modello, prima ancora di addestrarlo: se il numero non è quello che ci si aspetta, la rete montata non è quella che si aveva in mente.
Ogni collegamento tra un ingresso e un neurone ha il suo peso, più un piccolo termine di aggiustamento (il bias) per neurone. Lo strato nascosto collega 784 ingressi a 128 neuroni: \(784 \times 128 + 128 = 100\,480\) numeri da imparare. Lo strato d’uscita: \(128 \times 10 + 10 = 1\,290\). In tutto \(101\,770\) numeri che l’addestramento dovrà regolare, tanti, ma una rete moderna ne ha miliardi: MNIST è davvero una palestra in miniatura.
Per nn.Linear(d, u) i parametri sono \(u \cdot d + u\). Verifichiamolo:
n_params = sum(p.numel() for p in model.parameters() if p.requires_grad)
print(n_params)   # 101770
p.numel() conta gli elementi di ciascun tensore; il filtro su
requires_grad esclude eventuali parti congelate (tornerà utile nel
transfer learning). La pila per MNIST è riassunta in
Fig. 7.5: \(784 \cdot 128 + 128 = 100\,480\) per lo strato
nascosto, \(128 \cdot 10 + 10 = 1\,290\) per l’uscita.

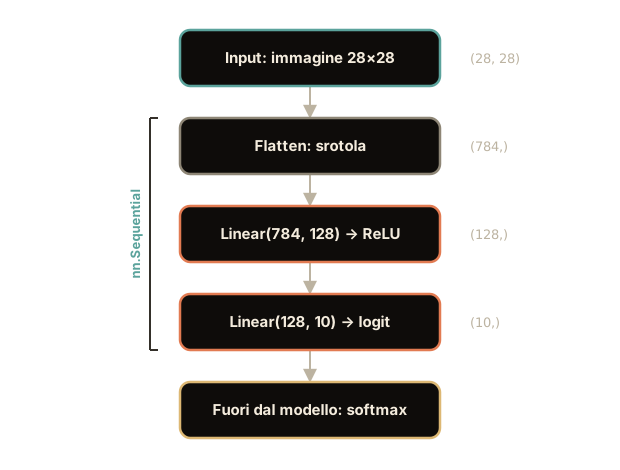
Fig. 7.5 Il percettrone multistrato per MNIST: l’immagine viene srotolata in 784 numeri, compressa a 128, infine proiettata su 10 punteggi grezzi, uno per cifra. La trasformazione di quei punteggi in probabilità (si chiama softmax) non sta nel modello: ce l’ha dentro la funzione di perdita, che li riceve grezzi.#
Misurare l’errore: le funzioni di perdita#
Il modello esiste, ma non ha ancora imparato niente: i pesi sono numeri
casuali. Per addestrarlo serve prima di tutto un modo di misurare quanto
sbaglia: la funzione di perdita, o loss. Anche le loss sono moduli di
torch.nn: non sono pezzi della rete, ma si costruiscono, si spostano su un
dispositivo e si chiamano come gli strati. Le due che useremo più spesso
coprono i due grandi casi: quando la risposta giusta è un numero, e quando è
una scelta fra categorie.
loss_regressione = nn.MSELoss()            # per predire numeri continui
loss_classi = nn.CrossEntropyLoss()        # per scegliere tra classi

# esempio: 2 immagini finte date in pasto al modello non ancora addestrato.
# (2, 1, 28, 28) = 2 immagini, 1 canale (MNIST è in scala di grigi), 28x28 pixel
logits = model(torch.randn(2, 1, 28, 28))  # shape (2, 10): 10 punteggi per immagine
target = torch.tensor([3, 7])              # le cifre vere sono un 3 e un 7
errore = loss_classi(logits, target)       # un numero solo: la loss media
print(errore.item())                       # circa 2,3 (con due sole immagini balla)
Il numero stampato cambia a ogni esecuzione, perché sia i pesi sia le due immagini sono estratti a sorte; con due immagini sole balla parecchio, fra \(1{,}8\) e \(2{,}9\). Il valore attorno a cui balla è \(2{,}3\), ed è il metro con cui leggere tutte le loss di un classificatore a dieci classi: il logaritmo naturale di dieci, \(\ln 10 = 2{,}3026\), cioè quanto vale la cross-entropy per chi dà a ciascuna delle dieci cifre la stessa probabilità, una su dieci. Un modello appena creato parte da lì vicino, in media un poco sopra, perché i pesi sorteggiati gli fanno già preferire qualcuna delle cifre, e una preferenza data a caso costa più di quanto rende; il programma su MNIST della sezione sull’addestramento stampa il punto da cui parte il nostro. Un addestramento che funziona scende da lì; uno che resta lassù non ha imparato niente.
Un perito passa la mattina in due appartamenti e su ogni scheda scrive tre numeri, il prezzo, le spese annue e i giorni che ci vorranno a vendere. Mesi dopo si sa com’è andata, e l’agenzia gli manda il conto: ogni numero mancato si paga al quadrato. Sbagliare di \(2\) costa \(4\), sbagliare di \(10\) costa \(100\). Un errore cinque volte più grande non ne vale cinque, ne vale venticinque. È la MSE (errore quadratico medio), la misura per quando la risposta è un numero, un prezzo o la temperatura di domani.
Sulle due schede ci sono sei numeri, quindi sei multe. Sbagliati tutti di \(2\), sono sei multe da \(4\) e la media è \(4\), perché l’agenzia divide per le multe uscite e non per gli appartamenti visitati. Un ufficio che invece somma le tre multe di ogni scheda, dodici per scheda, e divide per le due schede, arriva a ventiquattro diviso due, cioè a \(12\): tre volte tanto, tante volte quanti sono i numeri chiesti per appartamento, sugli stessi identici errori. Con un numero solo per scheda i due conti coincidono e la differenza non si vede. Il perito più bravo resta il più bravo in tutti e due i casi; cambia quanto pesa la multa, cioè quanto lo spinge a correggere il tiro, e una multa tre volte più grossa spinge tre volte di più. Chi aveva tarato la lunghezza del passo dell’addestramento sul primo conto, passando al secondo, se la ritrova tre volte più lunga.
Un piano più sotto un’impiegata legge le cifre scritte a mano sui formulari. Invece di scommettere tutto su una cifra sola, distribuisce la fiducia su tutte e dieci, e paga secondo quanta ne aveva data a quella vera. Alla cifra vera il 90%, e la multa è \(0{,}11\); il 10%, cioè fiducia in parti uguali su tutte e dieci, tirando a indovinare, e la multa è \(2{,}3\); l’1%, e la multa è \(4{,}6\). Guarda gli ultimi due: dal 10% all’1% la fiducia si divide per dieci e la multa raddoppia esatta, e ogni ulteriore divisione per dieci aggiunge sempre quegli stessi \(2{,}3\). A contare è il rapporto fra le fiducie e non il loro divario, e verso il basso la multa non trova fondo: escludere ancora un po” la risposta vera costa altri \(2{,}3\), e nessuno dice basta. È la cross-entropy, la misura per quando la risposta è una scelta fra categorie, quale cifra o quale animale. Di multa ce n’è una per formulario, e con dieci formulari in una volta esce la media di quelle dieci.
Sul foglio, però, l’impiegata non scrive percentuali: scrive un punteggio per
cifra, alto per il \(3\) che le sembra di vedere e basso per l’\(8\) che le pare
improbabile. A farne percentuali ci pensa l’agenzia, nello stesso momento in
cui calcola la multa, e i due conti insieme escono più precisi che uno dopo
l’altro, perché con percentuali piccolissime il secondo passaggio perde cifre
per strada. Anche nn.CrossEntropyLoss vuole i punteggi grezzi (i logit, il
nome tecnico di quei numeri prima che diventino probabilità) e la
trasformazione la fa lei, al suo interno. Nel modello la softmax non ci va, e
metterla è un errore che non dà nessun messaggio. Se allo sportello serve dire
quanto l’impiegata è sicura, le percentuali si ricavano dai punteggi in un
passaggio a parte, che serve a leggere il risultato e non ad addestrare.
Per la regressione, nn.MSELoss calcola
dove \(i\) scorre i \(B\) esempi del batch e \(k\) le \(D\) uscite di ciascun
esempio: la media è su tutti gli elementi del tensore, non sugli esempi.
Quando l’uscita è una sola le due letture coincidono e la distinzione non si
vede; in regressione multi-uscita no. Chi somma i quadrati di un esempio e poi
media sugli esempi ottiene un numero \(D\) volte più grande di quello che
restituisce il modulo. Il punto di minimo è lo stesso, la scala del gradiente
no, e con essa cambia il learning rate necessario. Per la classificazione a \(K\)
classi, nn.CrossEntropyLoss combina in un solo modulo LogSoftmax e
NLLLoss: dati i logit \(z_1, \dots, z_K\) e la classe vera \(c\) di un singolo
esempio,
dove qui \(k\) e \(j\) scorrono le \(K\) classi, non gli esempi, e \(\ell\) è il costo
di una predizione, quello che sta dentro la somma. Sul batch il modulo
restituisce la \(\mathcal{L}\), cioè la media di questi termini sui \(B\) esempi
(reduction='mean’, il default): è il «numero solo» del codice, e qui la media
è davvero calcolata sul singolo esempio, perché c’è un solo termine per
ciascuno. Con pesi per classe (weight), però, la media divide per la somma
dei pesi delle classi vere, e con ignore_index per il numero dei target non
ignorati, non per \(B\):
dove \(y_i\) è la classe vera dell’esempio \(i\) e \(w_{y_i}\) il suo peso.
Con logit indipendenti dall’etichetta e classi equiprobabili, come in un modello appena creato, la loss attesa è \(\log \sum_{k} e^{z_k} - \frac{1}{K} \sum_{k} z_k \ge \log K\), perché la media degli \(e^{z_k}\) non sta mai sotto l’esponenziale della media degli \(z_k\) (disuguaglianza di Jensen); vale l’uguaglianza solo con logit tutti uguali. È la ragione per cui un modello non addestrato parte in media poco sopra \(\ln 10\); su un insieme sbilanciato, o su un campione piccolo, un modello particolare può partire poco sotto.
Applicare la cross-entropy ai logit, e non a probabilità già normalizzate, ha due ragioni. La prima è numerica: il calcolo congiunto usa \(\log \sum_j e^{z_j} = z_{\max} + \log \sum_j e^{z_j - z_{\max}}\) (il log-sum-exp trick), che non trabocca per logit grandi e non passa mai per un \(\log 0\). La seconda è il gradiente, che rispetto ai logit vale
limitato fra \(-1\) e \(1\) e nullo soltanto quando la predizione è giusta e
sicura, quindi grande proprio dove il modello è sicuro e sbagliato. È qui la
differenza con la MSE applicata alle probabilità, il cui gradiente passa per la
Jacobiana della softmax e si spegne dove questa satura, anche a predizione
sbagliata: insieme al fatto che la cross-entropy è la log-verosimiglianza
negativa di una distribuzione sulle classi, è la ragione per cui in
classificazione si sceglie lei [GBC16]. Una softmax in più
nel modello compromette sia il calcolo congiunto sia questo gradiente: la loss
riceve probabilità in \([0, 1]\) e le tratta come logit, quindi anche la
predizione perfetta vale \(-1 + \log(e + K - 1)\), cioè \(1{,}46\) con \(K = 10\), e
sotto quel pavimento non si scende; e il gradiente attraversa la Jacobiana
della softmax in più, che si annulla proprio dove il modello è sicuro. Per
questo l’ultimo strato del modello non deve avere la softmax. Se servono le
probabilità (per leggere l’output, non per addestrare), si applica
torch.softmax(logits, dim=1) a valle. Con etichette intere il target ha shape
\((B,)\) e dtype int64, non serve il one-hot.
Le due penalità che abbiamo appena visto in cifre hanno anche una forma, e metterle una accanto all’altra dice in un colpo d’occhio quello che i numeri dicono uno alla volta (Fig. 7.6). Attenzione a come si legge: sono due disegni distinti, con due grandezze diverse sull’asse orizzontale, e non due curve sovrapposte. A sinistra scorre l’errore, cioè di quanto la predizione ha mancato il valore vero; a destra scorre la fiducia che il modello ha dato alla risposta giusta, da zero (l’ha esclusa) a uno (ne era certo). In verticale, in tutti e due, la penalità.

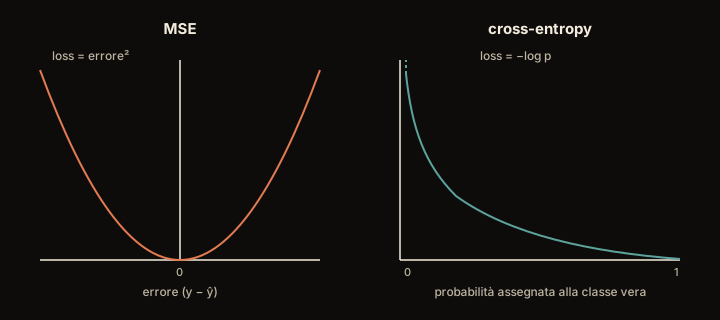
Fig. 7.6 Due disegni, due assi orizzontali diversi, due caratteri. La parabola perdona gli errori piccoli; la cross-entropy non perdona la sicurezza sbagliata, e cresce senza limite man mano che il modello esclude la risposta giusta.#
In classificazione si sceglie la seconda per due ragioni. La cross-entropy è la log-verosimiglianza negativa di una distribuzione sulle classi, come mostrato in Da dove viene la loss: minimizzarla vuol dire rendere il più probabile possibile la risposta giusta, e la penalità senza limite della figura ne è la conseguenza. E corregge di più proprio dove serve: quando il modello è sicuro e sbagliato la sua spinta resta forte, mentre quella dell’errore quadratico sulle probabilità, lì, quasi si spegne.
Il modello esiste e sa dire quanto sbaglia. Manca chi usa quel numero per correggerlo, ed è l’argomento della sezione sull’addestramento.
Da ricordare
Ogni pezzo di rete è un modulo: in
__init__si elencano i componenti, inforwardsi dice che strada fanno i dati. È normale codice Python, quindi ci si può mettere unprintper sbirciare. I pezzi vanno assegnati aself(o messi in unann.ModuleList), altrimenti nessuno li addestra.nn.Sequentialè la scorciatoia quando la rete è una catena di montaggio; se ci sono rami o scorciatoie, si torna a scrivereforwarda mano.Uno strato che collega ogni ingresso a ogni neurone ha un peso per collegamento più un aggiustamento per neurone: ingressi per neuroni, più i neuroni. Contarli è il primo controllo da fare su qualunque modello, e costa una moltiplicazione per strato.
La funzione di perdita misura quanto il modello sbaglia:
nn.MSELossquando la risposta è un numero,nn.CrossEntropyLossquando è una scelta fra categorie. A quest’ultima si danno i punteggi grezzi, non le probabilità: la trasformazione la fa lei. Con dieci classi, chi tira a indovinare prende 2,3: un addestramento che funziona scende da lì.
Da ricordare
Ogni pezzo di rete è un
nn.Module: in__init__i componenti, inforwardla strada dei dati (normale Python, ispezionabile riga per riga). I sottomoduli in una lista vanno innn.ModuleList; si chiamamodel(x), che esegue gli hook, e nonmodel.forward(x).nn.Sequentialè la scorciatoia per le catene semplici; per topologie con rami si scrive ilforwarda mano.nn.Linear(d, u)calcola \(\mathbf{W}\mathbf{x}+\mathbf{b}\) e ha \(u \cdot d + u\) parametri;model.parameters()li consegna all’ottimizzatore, il componente che nella prossima sezione applicherà le correzioni.Le loss sono moduli:
nn.MSELossper la regressione,nn.CrossEntropyLossper la classificazione; quest’ultima è la log-verosimiglianza negativa, vuole i logit (la softmax ce l’ha dentro) e su un modello non addestrato vale in media poco più di \(\ln K\).