


Il futuro nei numeri: serie temporali e forecasting#
Una macchina di ottone, corde e pulegge che prevedeva le maree: la fece costruire a Londra, negli anni Settanta dell’Ottocento, William Thomson, professore a Glasgow (il mondo lo avrebbe conosciuto come Lord Kelvin). Osservando anni di misure del livello del mare, Kelvin lo aveva scomposto nella somma di tante oscillazioni regolari (quella lunare, quella solare, quelle più sottili) e la macchina, girando una manovella, sommava meccanicamente quelle onde per disegnare la marea di un anno intero prima che accadesse. È la stessa idea che regge tutta la previsione delle serie temporali: il futuro si stima dal passato, purché il passato conservi delle regolarità.
Prevedere è un mestiere antico. Il contadino che legge il cielo per decidere quando seminare, il mercante che anticipa il prezzo del grano, il meteorologo che stende le isobare (le linee che uniscono i punti di uguale pressione, e da cui si legge dove sta andando il tempo): tutti fanno lo stesso gesto, guardare la storia di un fenomeno per indovinarne il seguito. In inglese quel gesto si chiama forecasting, ed è la parola che si trova nella letteratura e nel codice.
Come metodo sistematico la disciplina nasce nel 1970, con un libro di George Box e Gwilym Jenkins destinato a diventare un classico dell’econometria (la statistica applicata ai fenomeni economici) e dell’ingegneria [BJRL15]. La loro ricetta sta in tre mosse: identificare che forma ha la serie, stimare i numeri del modello, verificare che il modello non abbia lasciato fuori niente. Non è la prima idea di previsione statistica: spiegare un valore con quelli che lo precedono, cioè l’autoregressione, è un’idea che George Udny Yule usava già nel 1927, sulle macchie solari. Il contributo di Box e Jenkins è una procedura completa, che dice come scegliere il modello invece di lasciare che se ne inventi uno diverso ogni volta. Dal 1982 lo statistico greco Spyros Makridakis mette alla prova quei metodi su larga scala con le competizioni M, gare pubbliche di previsione su un migliaio di serie reali nella prima edizione e su centomila nella quarta, del 2018 [MSA20]. La lezione che ne esce è tanto tecnica quanto morale: si prevede, sì, ma con umiltà. Nessun modello domina sempre, e dichiarare quanto siamo incerti conta quanto la previsione stessa.
Che cos’è una serie temporale#
Il punto di partenza è la forma dei dati: valori che arrivano in ordine, uno dopo l’altro nel tempo, e che in quell’ordine vanno letti.
Un diario in cui ogni riga porta una data: il peso segnato ogni mattina, la temperatura misurata ogni ora, il numero di scontrini di un negozio giorno per giorno. Una serie temporale è esattamente questo: una fila di numeri con accanto un orologio.
La differenza con gli altri dati del libro è sottile ma decisiva. Nell’apprendimento supervisionato (riconoscere gatti, filtrare lo spam) gli esempi erano palline pescate da un’urna, come nella sezione sui dati che cambiano: potevi rimescolarle a piacere senza perdere nulla, l’ordine non contava. Con una serie temporale non puoi. La temperatura di oggi somiglia a quella di ieri; se mescoli le date, distruggi proprio l’informazione che ti serve. L’ordine è il dato.
E c’è una seconda differenza. Le palline uscivano tutte dalla stessa urna, oggi come l’anno scorso; il negozio del diario invece cambia mentre lo guardi: apre una filiale, gli mettono un concorrente di fronte, e da lì in poi gli scontrini seguono un’altra regola.
Una serie temporale è una sequenza di osservazioni \(x_1, x_2, \dots, x_T\) indicizzate da un tempo discreto \(t\), tipicamente a passo costante (orario, giornaliero, mensile). Formalmente è la realizzazione di un processo stocastico \(\{X_t\}_{t \in \mathbb{Z}}\), cioè una famiglia di variabili casuali ordinate nel tempo.
Il punto cruciale è che le \(X_t\) non sono indipendenti e identicamente distribuite (non i.i.d.). Tutto l’apprendimento supervisionato che abbiamo incontrato nel capitolo sul Machine Learning poggia, esplicitamente o meno, sull’ipotesi che gli esempi \((\mathbf{x}^{(i)}, y^{(i)})\) siano campionati in modo indipendente da un’unica distribuzione; è ciò che rende lecito mescolarli e separare a caso train e test. Qui l’ipotesi cade due volte: le osservazioni sono dipendenti (\(X_t\) è correlata con \(X_{t-1}, X_{t-2}, \dots\)) e la loro distribuzione può cambiare nel tempo. Ogni tecnica del capitolo nasce per convivere con questa doppia rottura.
I problemi che si pongono#
«Serie temporale» è la forma dei dati. Le domande che ci si può fare sopra sono diverse, e conviene distinguerle subito, perché ciascuna vuole i suoi strumenti e il suo modo di dare un voto al risultato.
I compiti sono quattro, e il primo è il più importante: il forecasting, stimare i valori futuri della serie a partire dai passati. È l’unico in cui la cosa da indovinare è la serie stessa, più in là nel tempo. Attorno a lui ruotano gli altri tre:
Classificazione di serie, assegnare un’etichetta a un’intera sequenza: un elettrocardiogramma è normale o aritmico? una vibrazione del motore segnala un guasto imminente?
Rilevamento di anomalie, individuare i punti in cui la serie si comporta in modo inatteso: una frode su una carta, un picco anomalo di traffico, un sensore che impazzisce.
Imputazione: ricostruire i valori mancanti dentro la serie, quando un sensore si è spento per qualche ora e restano dei buchi da riempire.
Il forecasting, poi, non è sempre lo stesso mestiere: due cose ne cambiano la difficoltà, e conviene guardarle una per volta.
Il primo asse riguarda quante cose guardiamo insieme. Prevedere la temperatura di domani dalle sole temperature passate è il caso univariato: una sola grandezza che scorre. Spesso conviene guardarne tante insieme (temperatura, umidità, pressione), perché si aiutano a vicenda, ed è il caso multivariato.
Il secondo asse riguarda quanto lontano guardiamo. Prevedere il valore di domani è un passo singolo; prevedere l’intera settimana che verrà è a più passi.
Per arrivare a domenica le strade di base sono due. Una: prevedi lunedì, tratti il lunedì previsto come se l’avessi misurato, e da lì vai a martedì, e così fino in fondo. Costa poco, e se su lunedì hai sbagliato di due gradi quei due gradi entrano nel conto di martedì e ci restano fino a domenica. L’altra: un metodo apposta per domenica, che guarda solo i giorni veri. Costa un metodo per ogni giorno della settimana, e non si porta dietro i propri errori.
Nemmeno il metodo fatto apposta, però, indovina domenica come indovina lunedì: fra oggi e domenica devono succedere sei giorni che nessuno ha visto, e ognuno aggiunge la sua incertezza. Le previsioni del tempo a un giorno ci azzeccano quasi sempre, quelle a dieci molto meno.
Ma l’incertezza non cresce all’infinito. La temperatura di una città torna verso un suo valore di riposo: marzo non se ne andrà mai a cento gradi. Se a marzo, un anno con l’altro, si sta fra i 10 e i 18 gradi, prevedere il marzo di fra dieci anni vuol dire esattamente quello: fra 10 e 18, e l’incertezza si ferma lì. Più ignoranti di così non si diventa.
Il prezzo di un’azione un valore di riposo non ce l’ha: dopo un crollo riparte da dove è arrivato, e il livello di prima non lo rincorre. Lì l’incertezza cresce e basta.
Nel caso univariato la serie è scalare, \(x_t \in \mathbb{R}\); nel multivariato è vettoriale, \(\mathbf{x}_t \in \mathbb{R}^N\) con \(N\) il numero di serie osservate insieme, e si vuole sfruttare la correlazione tra le \(N\) componenti. Sul secondo asse, il forecasting one-step stima
mentre quello multi-step, su un orizzonte \(h\), stima l’intero blocco \(\hat{x}_{T+1}, \dots, \hat{x}_{T+h}\). Le due strategie principali sono la previsione diretta (un modello per ciascun orizzonte) e quella ricorsiva (un modello one-step riapplicato, alimentando le proprie previsioni come input),
dove \(j\) è il passo corrente e va da \(1\) a \(h\). La ricorsiva è economica ma soffre di error compounding: l’errore al passo \(j\) entra nell’input del passo \(j+1\) e si propaga. Su un modello lineare ben specificato questo non costa niente, perché la media condizionata di un AR si propaga per linearità e la ricorsione è la previsione ottima; il costo nasce in due punti da tenere distinti. Il primo è la non linearità: in una ricorsione \(x_{t+1} = f(x_t) + \varepsilon_{t+1}\) reiniettare la previsione puntuale sbaglia la media, perché \(\mathbb{E}[f(X)] \neq f(\mathbb{E}[X])\), ed è la ragione per cui i modelli probabilistici che vedremo campionano traiettorie invece di propagare la media. Il secondo è la specificazione: se il modello a un passo è sbagliato, lo sbaglio viene riapplicato \(h\) volte, mentre la strategia diretta stima per ogni orizzonte la migliore proiezione di \(x_{T+h}\) sul passato e resta robusta dove la ricorsiva si allontana. In cambio la diretta paga in varianza (un modello per orizzonte, nessun vincolo di coerenza fra orizzonti vicini) e non sfugge all’errore di stima: il coefficiente \(\hat\phi_h\) di una regressione di \(x_{t+h}\) su \(x_t\) è distorto in campione finito come lo è \(\hat\phi^{\,h}\), e nessun campionamento lo corregge. La ricorsiva è la più efficiente quando il modello a un passo è ben specificato, la diretta la più robusta quando non lo è, e quale delle due vinca sui dati veri è una questione empirica [MSW06].
Questa distorsione va tenuta separata dalla ragione per cui l’incertezza cresce con l’orizzonte, che è un’altra e vale per tutte le strategie, diretta compresa: fra \(T\) e \(T+h\) cadono \(h\) innovazioni ancora da osservare, e i loro contributi si sommano. Un processo lineare causale si scrive \(x_t = \mu + \sum_{j\ge0}\psi_j\,\varepsilon_{t-j}\), con \(\psi_0 = 1\) ed \(\varepsilon_t\) rumore bianco di varianza \(\sigma^2\) (è la sua rappresentazione a media mobile infinita, \(\mathrm{MA}(\infty)\)). A parametri noti, l’errore della migliore previsione lineare a \(h\) passi è \(e_{T+h} = \sum_{j=0}^{h-1}\psi_j\,\varepsilon_{T+h-j}\), e la sua varianza
non decresce mai con \(h\) [HA21]. Se \(\sum_j \psi_j^2 < \infty\), cioè se il processo è stazionario, converge a \(\mathrm{Var}(x_t)\) e la banda di previsione smette di allargarsi; altrimenti cresce senza limite. Per un AR(1) i pesi sono \(\psi_j = \phi^j\) e la varianza vale \(\sigma^2(1-\phi^{2h})/(1-\phi^2)\); per la passeggiata aleatoria sono tutti uguali a uno, la varianza vale \(h\sigma^2\) e la banda si allarga come \(\sqrt{h}\). Con innovazioni gaussiane la banda al livello \(1-\alpha\) è \(\hat{x}_{T+h} \pm z_{1-\alpha/2}\,\sigma\big(\sum_{j<h}\psi_j^2\big)^{1/2}\).
Perché è un problema diverso (e difficile)#
Se le serie temporali meritano un capitolo a sé, e non un paragrafo dentro il Machine Learning, è perché ognuna delle loro proprietà rompe qualcosa che altrove davamo per scontato.
La prima è l’autocorrelazione: la correlazione fra la serie e sé stessa spostata indietro di \(k\) passi, che si scrive \(\rho_k\). Il numero \(k\) si chiama ritardo, in inglese lag, ed è la parola che si trova nel codice e nei manuali. Il conto è quello di una correlazione fra due file di numeri, la serie e la sua copia spostata, messe a coppie, il primo con il primo e il secondo con il secondo. Stimato su \(n\) punti di media \(\bar{x}\), è
In parole: si toglie la media a ogni valore, si moltiplicano a due a due i valori che distano \(k\) passi, si somma, e si divide per la somma dei quadrati, che tiene il risultato fra \(-1\) e \(+1\). Sulla serie \(2, 4, 2, 4, 2, 4\), di media \(3\) e scarti \(-1, +1, -1, +1, -1, +1\), a un passo di ritardo ogni scarto finisce accanto a uno di segno opposto: i cinque prodotti valgono tutti \(-1\), e \(\hat\rho_1 = -5/6 \approx -0{,}83\), un legame rovesciato (a un valore alto segue regolarmente un valore basso). A due passi ogni scarto ritrova il proprio segno, i quattro prodotti valgono \(+1\), e \(\hat\rho_2 = 4/6 \approx 0{,}67\). È il modo più diretto di vedere quanto una serie sia lontana dai dati indipendenti del resto del libro.
Il codice fa il conto su una serie inventata da noi, che sale piano e ha un
ciclo di dodici passi, e stampa sei righe: il coefficiente a un passo sulla
serie così com’è; lo stesso a uno, sei e dodici passi dopo averle tolto la
salita (la serie detrend è la serie meno la retta che ne segue la crescita);
quello a un passo con le date rimescolate; e quanto oscilla un coefficiente
nato dal solo caso.
import numpy as np

rng = np.random.default_rng(0)
n = 200
t = np.arange(n)
# serie sintetica: tendenza + stagionalità (periodo 12) + rumore
serie = 0.05 * t + 2.0 * np.sin(2 * np.pi * t / 12) + rng.normal(0, 0.5, n)

def autocorr(x, lag):
    x = x - x.mean()
    return np.sum(x[lag:] * x[:-lag]) / np.sum(x * x)

print(f"autocorrelazione a lag 1:   {autocorr(serie, 1):.3f}")

# la tendenza gonfia ogni confronto: la togliamo (sottraendo la retta
# che segue la salita) e rifacciamo il conto, a un passo e sul ciclo
detrend = serie - np.polyval(np.polyfit(t, serie, 1), t)
print(f"senza tendenza, a lag 1:    {autocorr(detrend, 1):.3f}")
print(f"senza tendenza, a lag 6:    {autocorr(detrend, 6):.3f}")
print(f"senza tendenza, a lag 12:   {autocorr(detrend, 12):.3f}")

# rimescolando l'ordine, la dipendenza temporale svanisce
mescolata = rng.permutation(serie)
print(f"lag 1, date rimescolate:    {autocorr(mescolata, 1):.3f}")

# e quanto vale una somiglianza dovuta al solo caso? si rimescola duemila
# volte e si guarda di quanto oscilla il coefficiente
caso = np.random.default_rng(1)
prove = [autocorr(caso.permutation(serie), 1) for _ in range(2000)]
print(f"oscillazione del caso:      {np.std(prove):.3f}"
      f"   (1 diviso radice di n: {1 / np.sqrt(n):.3f})")
autocorrelazione a lag 1:   0.942
senza tendenza, a lag 1:    0.778
senza tendenza, a lag 6:    -0.869
senza tendenza, a lag 12:   0.826
lag 1, date rimescolate:    0.143
oscillazione del caso:      0.070   (1 diviso radice di n: 0.071)
Sulla serie ordinata l’autocorrelazione a un passo vale \(0{,}94\), cioè quasi il massimo: ogni valore anticipa quasi perfettamente il successivo. Una parte di quel numero, per onestà, la mette la salita: in una serie che cresce sempre due giorni consecutivi si somigliano più di due giorni presi a caso in tutta la storia, e questo succede anche se di memoria vera non ce n’è nessuna. Per neutralizzarla si traccia la retta che segue meglio la salita e si tiene, di ogni punto, soltanto quanto sta sopra o sotto quella retta: sono due righe di codice, e il codice le ha già fatte. Su quel che resta il coefficiente scende a \(0{,}78\), che è ancora tanto: la dipendenza è vera, non è solo la salita.
La retta va tolta anche per leggere la stagionalità, e per lo stesso motivo: altrimenti terrebbe alta l’autocorrelazione a qualunque distanza. Fatto questo, il contrasto è netto. A sei passi di ritardo, cioè mezzo ciclo, la serie si trova nel punto opposto del giro (dove prima c’era un picco adesso c’è un avvallamento) e la somiglianza è fortemente negativa, \(-0{,}87\); a dodici passi di ritardo, cioè un ciclo intero, torna alta, \(0{,}83\), perché il fenomeno è tornato dov’era.
Rimescoliamo adesso le date: teniamo gli stessi duecento numeri e li rimettiamo in fila a caso. Il coefficiente crolla a \(0{,}14\). Non è esattamente zero, e non poteva esserlo: rimescolando duecento numeri qualche somiglianza per puro caso ci scappa sempre. Quanta, lo dice il rimescolamento rifatto duemila volte invece di una: il coefficiente oscilla attorno a zero con una deviazione standard di \(0{,}070\), e la teoria la prevede in \(1/\sqrt{n}\), cioè \(0{,}071\) con duecento punti. È la legge con cui cala l’errore di ogni media, quella della sezione su probabilità e statistica, e vale anche qui perché su una serie senza memoria \(\hat\rho_1\) è, in sostanza, la media di \(n\) prodotti incorrelati fra loro. Ecco allora il metro per leggere qualunque coefficiente: dentro \(\pm 2/\sqrt{n}\), qui quattordici centesimi, un valore non si distingue dal caso, ed è la fascia che i programmi di statistica disegnano attorno allo zero nel grafico dei coefficienti. Il nostro \(0{,}14\) cade proprio sul bordo della fascia: è il genere di somiglianza che il caso da solo produce, ogni tanto, rimescolando duecento numeri. Di quel \(0{,}94\), invece, non è rimasto niente. Gli stessi identici valori, in un altro ordine, non prevedono più niente: quello che rendeva prevedibile la serie non stava nei numeri, stava nel loro ordine.
Tre ritardi sono tre assaggi, e il metro del caso vale per tutti: la Fig. 34.1 li mette in fila dal primo al ventiquattresimo, con la fascia disegnata attorno allo zero.
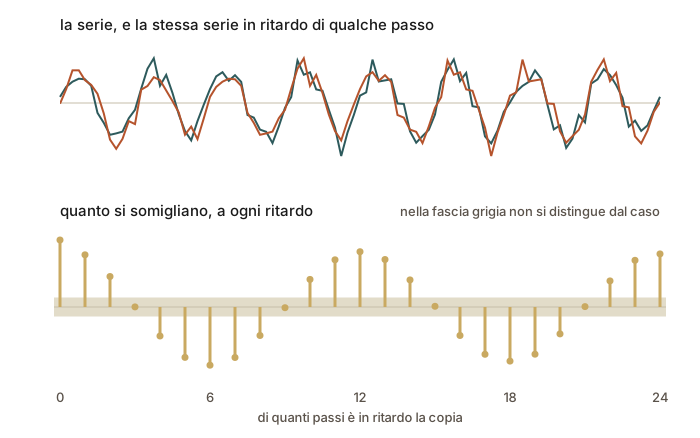
Fig. 34.1 Sopra, la serie e la stessa serie in ritardo: a sei passi le due onde sono capovolte, a dodici tornano a sovrapporsi. Sotto, la somiglianza a ogni ritardo, che è il modo in cui la stagionalità si presenta quando la si guarda così: un’onda che scende, risale e si smorza, con il passo del ciclo. Dentro la fascia grigia non resta niente che si distingua dal caso.#
Ecco perché nel forecasting futuro e passato non si mescolano mai. La regola si dimentica soprattutto dove costa di più, cioè quando si tratta di dare un voto al modello (in gergo, la validazione). Se per giudicarlo gli si fanno indovinare dei giorni che stanno in mezzo a quelli su cui si è allenato, gli si sta chiedendo di riempire un buco avendo davanti i due bordi, che è tutt’altro mestiere che indovinare il seguito. Il voto che ne esce è gonfiato, e non se ne accorge nessuno finché il modello non va a lavorare sul futuro vero. È il mestiere della sezione su validazione e feature; per ora basti la regola: ci si allena sul prima, si verifica sul dopo, mai il contrario.
La seconda proprietà è la non stazionarietà, ed è quella che manda in crisi i metodi statistici classici, quelli della prossima sezione.
Un fiume la cui portata oscilla attorno allo stesso valore medio, con piene e magre di ampiezza costante, è un fiume «stabile»: chi lo studia oggi può usare le stesse regole di chi lo studiava vent’anni fa. Devono restare fermi il valore attorno a cui la portata balla, l’ampiezza con cui balla, e il modo in cui due giorni si somigliano, che dipende da quanto distano fra loro e non da quando cadono nel calendario (due giorni di fila si somigliano allo stesso modo, che siano di marzo o di settembre). Questa stabilità è ciò che i tecnici chiamano stazionarietà.
Molte serie vere non sono così. Il prezzo di una casa cresce di decennio in decennio (la media sale: c’è una tendenza), i consumi di gelato salgono ogni estate e calano ogni inverno (la stagionalità), e ogni tanto una crisi o una pandemia cambia le regole di colpo: un cambio di regime. Buona parte del lavoro consiste nel togliere tendenza e stagionalità, per riportare la serie a qualcosa di stabile.
Ma per togliere una salita i gesti sono due, e non sono intercambiabili. Se il fiume sale lungo una linea regolare, tiri la linea e tieni di ogni giorno quanto stava sopra o sotto. Se invece ogni piena gli lascia il letto un po’ più alto per sempre, una linea da tirare non c’è: lasci perdere il livello e guardi di quanto è cambiato da ieri. Sul fiume delle piene la linea non basta: il letto continua a spostarsi sotto.
Quale dei due casi hai davanti lo dicono due prove sui dati, che si chiamano ADF e KPSS e si leggono in coppia, perché partono da sospetti opposti: l’ADF dal sospetto che il letto si sposti, il KPSS da quello che il fiume sia stabile. Nessuna delle due, però, certifica qualcosa. Funzionano come un esame del sangue, che può trovare un valore fuori posto ma non può dichiarare che tu stia bene: ciascuna dice soltanto se l’acqua misurata dà motivi per abbandonare il proprio sospetto.
Un processo \(\{X_t\}\) con momenti secondi finiti (\(\mathbb{E}[X_t^2] < \infty\), senza cui la richiesta non avrebbe senso) è stazionario in senso debole (o in covarianza) se i suoi primi due momenti non dipendono dal tempo:
cioè media e varianza costanti e autocovarianza \(\gamma(k)\) funzione solo del divario \(k\) tra due istanti, non della loro posizione assoluta. È l’ipotesi su cui poggia l’intera famiglia dei modelli ARMA. Le serie reali la violano in tre modi ricorrenti: una tendenza rende \(\mu\) variabile nel tempo, la stagionalità rende \(\mu\) periodica (e, quando è stocastica anziché deterministica, fa dipendere l’autocovarianza dalla posizione \(t\) oltre che dal divario \(k\)), un cambio di regime (rottura strutturale) altera \(\mu\), \(\sigma^2\) o entrambi da un certo istante in poi.
La strategia standard è ricondurre la serie alla stazionarietà prima di modellarla, e lo strumento dipende da quale delle violazioni si ha davanti. Contro una tendenza stocastica (una radice unitaria: ogni scossa sposta il livello per sempre) si usa la differenziazione, \(\nabla x_t = x_t - x_{t-1}\), ed è la «I» (integrated) dell’ARIMA [BJRL15]; contro una tendenza deterministica (la serie oscilla attorno a una retta) si stima la retta e si tengono i residui. La sezione seguente mostra perché scambiare le due non è affatto neutro. Per decidere esistono test appositi, ADF e KPSS, che hanno ipotesi nulle opposte e vanno letti insieme; li usa, al suo primo passo, la procedura in tre tempi di Box e Jenkins nella forma in cui la si pratica oggi. Nessuno dei due, però, «dimostra» qualcosa, esattamente come nessuna diagnostica dimostra che un modello sia giusto: ciascuno dice soltanto se i dati contengono prove contro la propria ipotesi nulla, che per l’ADF è la radice unitaria e per il KPSS la stazionarietà.
Autocorrelazione e non stazionarietà sono due rotture distinte della stessa comodità, quella su cui abbiamo costruito il resto del machine learning supervisionato: che gli esempi siano indipendenti fra loro e vengano tutti dalla stessa distribuzione. L’autocorrelazione rompe l’indipendenza; la non stazionarietà, di cui il cambio di regime è la forma brusca, rompe la distribuzione unica. Una serie può avere l’una senza l’altra (una serie stazionaria può essere fortemente autocorrelata), e ogni metodo del capitolo è un modo di fare i conti con tutte e due.
Dai modelli classici alle reti#
Per prevedere una serie ci sono due grandi famiglie di metodi, i modelli statistici classici e le reti neurali, e in quest’ordine sono anche la storia della disciplina; una terza, i modelli additivi come Prophet, sta a metà strada e si incontra insieme alle reti. In mezzo, nell’ordine del capitolo, sta il mestiere che dice quale metodo stia funzionando, cioè dare un voto a una previsione senza barare col futuro.
Componenti e modelli classici, come scomporre una serie in tendenza, stagionalità e residuo, e i due cavalli di battaglia storici: la famiglia ARIMA di Box e Jenkins e il lisciamento esponenziale nella forma Holt-Winters. Sono ancora oggi la linea di base, cioè l’avversario banale che un metodo più sofisticato deve battere per meritare la fatica che costa.
Validazione temporale e feature (le feature sono le colonne di una tabella, quelle che si danno in pasto a un modello). Perché la k-fold mescolata della sezione su overfitting e validazione (dividere gli esempi in fette a caso e provare il modello su una fetta per volta) qui è vietata, e come si valida sul tempo facendo scorrere in avanti il confine fra passato e futuro (è il backtesting). Poi come si trasforma una serie in una tabella di quelle: una colonna per il valore di ieri, una per la media degli ultimi giorni, una per il giorno della settimana, e a quel punto la sanno leggere tutti i modelli del capitolo sul Machine Learning.
Forecasting neurale e modelli additivi: i modelli additivi come Prophet, che disegnano la serie sul calendario; le reti convoluzionali che possono guardare solo all’indietro (TCN); quelle che invece di un numero prevedono un ventaglio di futuri possibili (DeepAR); le reti fatte di soli strati densi (N-BEATS); i Transformer adattati alle serie, e il modello lineare che li ha messi in discussione; e infine i foundation model (come Chronos), addestrati una volta sola su grandi collezioni di serie e poi usati su fenomeni che non hanno mai visto.
I metodi statistici classici sono trasparenti e sorprendentemente difficili da battere; quelli neurali hanno fame di dati, ma colgono regolarità più intricate e, guardando insieme migliaia di serie diverse, portano a ciascuna quello che hanno imparato dalle altre. La lezione delle competizioni M è che la rivalità fra le due famiglie è meno netta di quanto sembri. Nella quarta edizione, la M4, correvano centomila serie e sessantuno metodi, e a vincere non fu né la statistica pura né il deep learning puro: fu un ibrido, l’ES-RNN di Slawek Smyl, in cui per ogni serie il lisciamento esponenziale della prossima sezione stima livello e stagionalità, e una rete ricorrente addestrata su tutte le serie insieme prevede il resto [Smy20]. Fra i primi, a fare meglio dei metodi singoli, c’erano poi le combinazioni, cioè la media delle previsioni di più metodi messi insieme [MSA20].
Attraversa tutte e tre le sezioni un filo rosso, ed è quella stessa lezione: la previsione seria non è un numero, è un numero con la sua incertezza. Un modello che dice «domani 24 gradi» vale meno di uno che dice «domani fra 22 e 26 gradi, e sono sicuro all’80%», dove quell’80% vuol dire: otto volte su dieci il valore vero cade dentro la forbice. Il secondo sa quanto poco sa.
Su questo, però, le bande dei metodi del capitolo, come la maggior parte delle bande di previsione, tendono a uscire più strette del dovuto [HA21]: la forbice che promette di contenere il valore vero otto volte su dieci lo contiene meno spesso. Non è una fatalità. Quanto sia stretta di troppo si misura, e la sezione sulla validazione mostra come.
Da ricordare
Una serie temporale è un diario di numeri con la data accanto. A differenza degli esempi del resto del libro, che si potevano rimescolare, qui l’ordine è l’informazione: se mescoli le date distruggi proprio quello che rendeva la serie prevedibile.
Il compito principale è la previsione (forecasting): dire come andrà avanti la serie, guardando una grandezza sola o molte insieme, per il solo giorno dopo o per l’intera settimana. Più lontano guardi, più cose ancora da vedere ci sono in mezzo, e più larga è l’incertezza: fino a fermarsi, se il fenomeno torna sempre verso un suo valore di riposo, e senza fermarsi mai se non ce l’ha. Accanto ci sono altri tre compiti: dire che tipo di serie è, trovarci dentro i punti anomali, e ricostruire i valori mancanti.
La difficoltà ha due facce, e non sono la stessa: ogni valore somiglia a quelli vicini (l’autocorrelazione), e le regole del gioco cambiano nel tempo (una tendenza che sale, una stagione che torna, o un cambio improvviso). Una serie si dice stabile (i tecnici dicono stazionaria) quando balla sempre attorno allo stesso valore, con la stessa ampiezza, e quando due giorni si somigliano in base a quanto distano fra loro e non a quando cadono nel calendario.
Nel valutare un modello non si mescolano futuro e passato: ci si allena sul prima e si verifica sul dopo, sempre.
Il capitolo procede in tre tappe: i modelli classici, come si valuta onestamente una previsione e come si trasforma una serie in una tabella, e infine le reti neurali, con accanto i modelli che disegnano la serie sul calendario. Con un filo comune: prevedere vuol dire anche dichiarare quanto poco si sa.
Da ricordare
Una serie temporale è una sequenza di osservazioni ordinate nel tempo, realizzazione di un processo stocastico \(\{X_t\}\); a differenza degli esempi i.i.d. del resto del machine learning, i suoi valori sono dipendenti e l’ordine è l’informazione: rimescolarli la distrugge.
I compiti principali sono forecasting (uni/multivariato, a passo singolo o a più passi), classificazione di serie, rilevamento di anomalie e imputazione. Nel multi-step l’incertezza cresce con l’orizzonte perché si sommano i contributi delle \(h\) innovazioni non ancora osservate: la varianza dell’errore a \(h\) passi è \(\sigma^2\sum_{j<h}\psi_j^2\), non decresce mai, e su un processo stazionario converge alla varianza del processo, cioè la banda smette di allargarsi; l’error compounding della strategia ricorsiva è un fenomeno distinto, e riguarda la distorsione che la reiniezione introduce con modelli stimati o non lineari.
Ciò che rende il problema difficile è che l’ipotesi i.i.d. cade in due modi distinti: dipendenza fra le osservazioni (autocorrelazione) e distribuzione che cambia nel tempo (non stazionarietà: tendenza, stagionalità, cambi di regime). Un processo è stazionario in senso debole se media e varianza sono costanti e l’autocovarianza fra due istanti dipende solo dal loro divario \(k\), non dalla loro posizione assoluta.
Nella validazione non si mescolano futuro e passato: si addestra sul passato e si verifica sul futuro, sempre.
Il capitolo procede in tre tappe, modelli classici (ARIMA, Holt-Winters), validazione temporale e feature, forecasting neurale e modelli additivi (Prophet, TCN, DeepAR, N-BEATS, Transformer, foundation model), con un filo comune: prevedere significa anche dichiarare la propria incertezza.