


La memoria: il vero collo di bottiglia#
Il racconto dell’architettura si è chiuso su un’osservazione scomoda, che la sezione «Prestazioni e scala» aveva già lasciato cadere di sfuggita: il collo di bottiglia, più spesso del calcolo, è il movimento dei dati. È il momento di prenderla sul serio, perché è una delle verità meno intuitive di tutto l’hardware moderno.
Si tende a pensare a una GPU come a una macchina che divora numeri. Spesso, invece, a limitarla è il rifornimento: le sue migliaia di unità di calcolo consumano in un lampo i dati che hanno a portata, e poi restano ferme ad aspettare i successivi.
Nella sezione sull’architettura abbiamo visto la mossa che salva la GPU da quelle attese: mentre un warp aspetta i suoi dati, il warp scheduler ne fa avanzare un altro, così lo SM non resta mai inattivo. Quel meccanismo però nasconde l’attesa del singolo, non fa arrivare i dati più in fretta. Le due cose vanno tenute distinte, e da qui in avanti le chiameremo sempre con lo stesso nome: la latenza è il tempo che passa prima che arrivi il primo dato; la banda è quanti byte al secondo la memoria riesce davvero a consegnare a regime, cioè una volta avviato il flusso (è il throughput di prima, misurato in byte invece che in compiti finiti). I warp coprono la latenza. La banda è finita e non si nasconde, ed è lei, più della potenza di calcolo, a decidere le prestazioni di moltissimi programmi: è il «muro della banda». Raddoppiare le unità di calcolo non serve, se i byte non arrivano più in fretta.
Per capire dove i byte si perdono bisogna conoscere la geografia della memoria di una GPU. È una piramide di livelli e non un unico serbatoio, ognuno un compromesso diverso tra quanto è veloce e quanto è capiente.
La piramide della memoria#
La regola, valida per ogni computer ma spietata su una GPU, è che veloce e capiente non stanno mai nello stesso posto. La memoria vicina ai core è velocissima ma minuscola; quella grande abbastanza da contenere un modello è lontana e lenta. In mezzo, una scala di compromessi (Fig. 8.6).

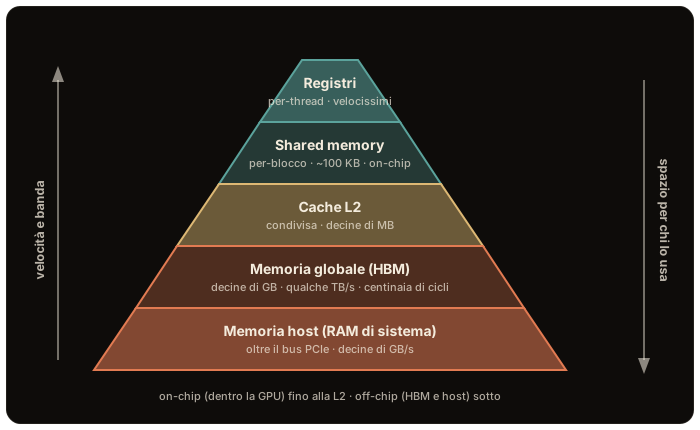
Fig. 8.6 I cinque piani della memoria di una GPU. Salendo verso l’apice si trova memoria più veloce; scendendo verso la base memoria più lenta, perché più lontana dalle unità che fanno i conti. La larghezza dice quanta ne tocca a chi la usa (a un thread, a un blocco, a tutta la scheda), non quanta ce ne sia in tutto a quel piano: sul totale il triangolo inganna, perché i registri di tutti i thread di uno SM, messi insieme, superano la sua shared memory. I primi tre piani stanno dentro il chip della GPU (in inglese on-chip); gli ultimi due, la memoria grande della scheda e quella del computer, stanno fuori dal chip (off-chip), ed è per questo che raggiungerli costa tanto.#
La penna che hai in mano è a distanza zero: la usi senza pensarci. Sono i registri, e ciascuno ha i suoi, che nessun altro può toccare: velocissimi, e ci sta appena un pugno di numeri.
Sul piano della scrivania c’è un ripiano in comune con tutta la squadra che siede al tavolo. Ci sta l’equivalente di qualche decina di pagine, e un separatore lo divide in due. Da una parte ci metti tu i fogli del momento, e scegli quali tenere e per quanto: è la shared memory, la memoria condivisa. Dall’altra parte finisce da sé, senza che nessuno lo decida, quello che hai usato di recente, nel caso serva ancora: è la cache L1 (cache si pronuncia cash e vuol dire ripostiglio; la L sta per level, livello, e questo è il primo). Il separatore si sposta, lo spazio no: la parte che scegli tu si allarga rubando all’altra.
Il cassetto grande sotto il tavolo è la cache L2, il secondo livello: stesso
mestiere, più capiente e in comune con gli altri tavoli. In fondo alla stanza
c’è l’armadio, il magazzino comune a ogni tavolo: ci sta tutto il progetto, ma
ogni volta ti tocca alzarti e attraversare la stanza. È la memoria globale,
che i tecnici chiamano HBM, tre lettere per «memoria a banda larga»,
costruita apposta per consegnare tantissimi byte al secondo. E in un altro
edificio c’è il deposito, la memoria del computer, di là dal cavo che collega
CPU e GPU (il cavo si chiama PCIe): enorme, e andarci è una spedizione. Per
questo, di là, ci si va il meno possibile: quello che serve a tutti (i pesi del
modello) si porta nell’armadio una volta sola e resta lì, e il viaggio si ripete
soltanto per i dati nuovi, un carico per ogni gruppo di esempi da elaborare. È
la spedizione che fa la riga .to(device) del capitolo su PyTorch.
A quel tavolo lavorano più di mille persone. Le penne sono minuscole una per una, ma tutte insieme sono più roba di quanta ne stia sul ripiano: su una A100, una scheda da datacenter, le penne di un tavolo valgono 256 kilobyte e il ripiano intero 192. Il pugno di numeri è quello che tocca al singolo, non quanto ce n’è in tutto, ed è così che va letta la piramide. E chi vorrebbe più penne di quante gliene stiano in mano non le perde: quelle di troppo le appoggia sul ripiano, dalla parte che si riempie da sé, e ogni volta che gli servono deve allungare il braccio a riprenderle. Oltre un certo punto, quindi, chiedere più penne rallenta invece di aiutare: il lavoro si riempie di allungate di braccio.
Contano le proporzioni, più dei nomi. Se prendere la penna che hai già fra le dita costa un secondo, cercare fra i fogli sul piano ne costa una ventina, aprire il cassetto grande un paio di centinaia, attraversare la stanza fino all’armadio cinquecento, e mandare qualcuno al deposito dell’altro edificio è una gita che dura un’ora. Fra la penna e il deposito ci sono migliaia di volte, non il doppio. Tutto questo è tempo di attesa, cioè la latenza, e l’attesa si può coprire: mentre uno aspetta il foglio che ha chiesto il vicino lavora su quello che ha già ricevuto, e il tavolo non si ferma mai.
C’è però una seconda misura, sullo stesso armadio, e quella non si copre. Chi torna dall’armadio non porta un foglio solo: porta una bracciata, e quante bracciate al minuto l’armadio riesca a consegnare è deciso una volta per tutte. Se in un minuto arrivano meno fogli di quanti la squadra ne consuma, i mille al tavolo restano fermi comunque, bravi quanto si vuole. Quel numero, i fogli che arrivano al minuto, è la banda, ed è lui, più spesso di quante persone siedano al tavolo, a decidere la velocità del lavoro. Per l’armadio vero, la HBM, sono qualche migliaio di miliardi di byte al secondo (qualche terabyte al secondo, TB/s); il cavo verso il deposito ne porta qualche decina di miliardi (decine di gigabyte al secondo, GB/s), da dieci a cento volte meno. Chi programma una GPU fa lo stesso mestiere di chi si tiene in ordine la scrivania: vicino quello che serve adesso, e in giro per la stanza il meno possibile.
I livelli, dall’alto verso il basso, sono cinque e differiscono per ordini di grandezza (le cifre esatte cambiano con la generazione: qui contano le proporzioni).
Registri, privati del singolo thread: ciascun thread ne ha appena un pugno, dell’ordine del kilobyte (il tetto architetturale è 255 registri da 32 bit, cioè 1020 byte, appena sotto il kilobyte), con latenza di fatto nulla. Sono la memoria più veloce che esista sul chip. Il singolare però inganna: per SM il register file è il banco on-chip più grande di tutti, 256 KB su A100 contro i 192 KB di L1 e shared messe insieme, e sull’intera GPU sono 27 MB di registri. È questa abbondanza, non il «pugno» del singolo thread, a rendere possibile il secondo livello di tiling di cui si parlerà nel GEMM, quello che vive nei registri.
Shared memory e cache L1: on-chip, all’interno dell’SM. La shared memory è condivisa dai thread di uno stesso blocco, dell’ordine di un centinaio di KB per unità di calcolo, e la sua particolarità è che non è una cache automatica: la gestisci a mano, decidendo tu cosa metterci. La L1 sì, è automatica. Il punto che la piramide disegnata nasconde è che oggi le due sono lo stesso banco di SRAM (lo erano con Fermi e Kepler, dal 2010, furono separate con Maxwell e Pascal, e da Volta, nel 2017, lo sono di nuovo), ripartito fra le due funzioni da un parametro che il programmatore imposta (192 KB combinati per SM su A100, di cui fino a 164 configurabili come shared; 256 KB su H100). Tre conseguenze pratiche: chiedere tutta la shared possibile non è gratis, perché toglie cache; questa L1, la L2 e il broadcast dentro il warp recuperano insieme il riuso «sperato» che il GEMM ingenuo strappa alle cache; e negli spill dei registri (quando un thread ne chiede più di quanti ne ha) è lì che si riversa il traffico che rende improduttivo alzare ancora i registri per thread. Latenza di poche decine di cicli.
Cache L2: condivisa da tutte le unità di calcolo, dell’ordine di decine di MB (40 MB su A100), con latenza di un paio di centinaia di cicli. È l’ultimo livello dentro il chip.
Memoria globale (HBM), la High Bandwidth Memory off-chip: decine di GB, banda dell’ordine di qualche TB/s, ma latenza di centinaia di cicli. È dove vivono tensori, pesi e attivazioni.
Memoria host, la RAM di sistema, di là dal bus PCIe che separa CPU e GPU: capiente quanto vuoi, ma raggiungibile solo attraverso quel bus, che consegna qualche decina di GB/s (uno o due ordini di grandezza sotto la HBM). Il collo di bottiglia è il PCIe, non la RAM, che presa da sola è molto più svelta. È il motivo per cui, come ricordava la sezione «Prestazioni e scala»,
.to(device)va fatto una volta per batch e non tensore per tensore.
Due parametri descrivono ogni livello: la latenza (quanto aspetti il primo byte) e la banda (quanti byte al secondo, a regime). I warp nascondono la latenza (mentre un warp aspetta la HBM, l’hardware ne fa girare un altro) ma non moltiplicano la banda. Salendo la piramide la banda cresce e la latenza cala: la memoria on-chip (registri, shared) ha banda di un ordine di grandezza superiore alla HBM, che a sua volta ne ha uno o due sul PCIe.
Sulla capienza, invece, la forma a piramide va interpretata con cautela, perché diminuisce per unità che ne dispone (per thread, per blocco, per SM, per GPU), non in assoluto: come si è visto, su A100 il register file di un SM è più capiente della sua L1 più shared, ed è la punta della piramide a essere il banco on-chip più grande (sulla generazione successiva i due si equivalgono, e in nessuno dei due casi il triangolo racconta le capienze totali). Il triangolo dice bene la scarsità che si affaccia al singolo lavoratore, non quanta memoria ci sia a ciascun piano.
Tenere il lavoro il più in alto possibile nella piramide è, in una frase, l’intera arte dell’ottimizzazione su GPU.
Accessi coalescenti: leggere in fila#
Sapere dove stanno i dati non basta: conta anche come li si chiede. Qui entra in gioco un dettaglio che può far buttare via i sette ottavi della banda senza che nessuno se ne accorga. Il fatto è che la memoria non consegna un byte alla volta: consegna a pacchi di indirizzi vicini, e chiedere numeri che stanno in fila costa molto meno che chiedere gli stessi numeri sparsi. Quando i 32 thread di un warp chiedono indirizzi contigui, l’hardware fonde le richieste in poche consegne piene, e quel fondersi ha dato il nome alla cosa: coalescenza degli accessi, dal verbo coalescere, che si dice di due gocce quando diventano una sola.
Un fattorino ha 32 pacchi da consegnare e un furgone che ne carica otto per volta. C’è però una regola del magazzino, ed è la regola che rende questo esempio vero: il furgone può scaricare in una via sola, e in una via ci stanno otto numeri civici esatti. Se i 32 indirizzi sono in fila, uno dopo l’altro, occupano quattro vie, e gli bastano dunque quattro giri, a ognuno dei quali scarica il furgone pieno: otto pacchi, otto consegne. Se invece i 32 indirizzi sono sparsi ai quattro angoli della città, ogni giro consegna un pacco solo e riporta indietro sette posti vuoti: servono 32 giri per consegnare esattamente gli stessi 32 pacchi. Il lavoro utile è identico, i viaggi sono 32 invece di 4: otto volte tanto, e l’otto viene da qui, dai posti del furgone.
La memoria di una GPU funziona proprio così, e nessuno dei due numeri è inventato. Il plotone è da 32 perché così è fatta la GPU, e il furgone porta otto numeri perché la memoria consegna a blocchi da 32 byte, dentro i quali di numeri da quattro byte ce ne stanno appunto otto. Se i 32 lavoratori di un plotone chiedono dati messi in fila, l’hardware li serve in quattro consegne piene; se li chiedono sparsi, deve fare una consegna quasi vuota per ognuno, e la banda va in fumo. La regola del magazzino, poi, dipende da come sono fatti i collegamenti dentro il chip, e non si può cambiare.
La morale pratica è sistemare i dati in modo che lavoratori vicini leggano posizioni vicine, e la si viola anche senza accorgersene. Un elenco di schede, una per persona, con tre numeri ciascuna (altezza, peso, età) scritti uno accanto all’altro: se ognuno dei 32 vuole soltanto l’altezza della propria scheda, le altezze stanno a tre posti di distanza, i 32 pacchi occupano dodici vie invece di quattro, e il furgone riporta indietro due posti vuoti su tre. Tenere tutte le altezze in un elenco a parte, e i pesi e le età in altri due, riporta i giri a quattro.
La memoria globale viene servita in segmenti di indirizzi contigui da 32
byte: sulle schede NVIDIA dalla compute capability 6.0 in poi, gli accessi
concorrenti dei thread di un warp si fondono in tante transazioni quanti sono
i segmenti da 32 byte che servono a soddisfarli. Consideriamo un warp di 32
thread che legge un vettore di float32 (4 byte ciascuno).
Accesso coalescente: i thread leggono 32 elementi consecutivi, cioè \(32 \times 4 = 128\) byte contigui. Servono \(128 / 32 = 4\) segmenti; 128 byte trasferiti, 128 utili → efficienza 100%.
Accesso sparso: per uno stride tale che ogni thread cada in un segmento diverso, servono 32 segmenti da 32 byte, cioè \(32 \times 32 = 1024\) byte trasferiti per consegnare gli stessi 128 byte utili → efficienza 12,5%, ovvero \(8\times\) di banda buttata via.
L’efficienza è il rapporto \(\text{byte utili} / \text{byte trasferiti}\). Su un
carico limitato dalla banda, un fattore 8 di traffico sprecato è un fattore 8 di
tempo: ecco perché il modo in cui un tensore è disposto in memoria (il suo
layout, l’ordine row-major di righe e colonne) e l’indice con cui ogni
thread vi accede non sono dettagli, ma spesso la differenza tra un kernel che
satura la GPU e uno che la lascia mezza spenta.
Un caso comune di accesso sparso non ha niente di esotico: è l’array of
structures. Leggere il campo x di un vettore di struct {float x, y, z;}
vuol dire un passo di 12 byte, e un warp tocca 12 segmenti (384 byte) per 128
byte utili, un’efficienza del 33%; la disposizione structure of arrays, un
array per campo, riporta l’accesso a 4 segmenti. Il 12,5% di prima, poi, è il
caso peggiore: le cache ne recuperano una parte quando warp vicini rileggono
presto gli stessi segmenti, come succede con un accesso in fila ma
disallineato, mentre con un passo largo si arriva davvero a un segmento per
thread.
Caricare una volta, servire in tanti#
C’è un secondo modo di risparmiare banda, complementare al primo: non ri-leggere dalla HBM ciò che ti serve più volte. Se un blocco di dati verrà usato da molti thread, conviene portarlo una sola volta nella shared memory e da lì servirlo a tutti.
Di questo principio l’esempio più puro si chiama FlashAttention, ed è il modo in cui oggi si eseguono i confronti fra le parole di un testo dentro un modello linguistico; lo racconta per esteso la sezione sulla FlashAttention. La cosa da sapere fin da adesso è una sola: quel metodo non fa meno conti di prima. Ne fa altrettanti, e in un passaggio addirittura qualcuno in più. Va molte volte più veloce soltanto perché muove molti meno byte.
Lo stesso manuale, consultato decine di volte da tutta la squadra: i modi di farlo sono due. La mossa sciocca è che ognuno, ogni volta, corra in magazzino a prendere una copia, la legga e la riporti. La mossa intelligente è portare una copia sul tavolo comune all’inizio, e lasciare che tutti la consultino lì, a portata di mano, per tutto il tempo. Il viaggio in magazzino (la lettura dalla memoria lontana) si paga una volta sola invece di decine: trenta consultazioni e un viaggio, cioè un trentesimo della strada. Il tavolo comune, poi, non si riempie da sé, e qui sta il suo vantaggio: qualcuno sceglie che cosa metterci e quando toglierlo per far posto al pezzo dopo. Questo «carica una volta, riusa in tanti» è il segreto di quasi tutti i kernel veloci (un kernel è il programmino che gira sulla GPU, quello che tutti i lavoratori eseguono insieme ciascuno sul proprio pezzo di dato: gli è dedicata la sezione sui kernel), e sarà il cuore della sezione sulla moltiplicazione fra matrici.
Il tavolo comune ha però una regola sua, e a ignorarla si perde per strada quello che si era appena guadagnato. Il piano è uno scaffale con trentadue caselle, e le pagine ci vanno a giro: la prima nella prima casella, la seconda nella seconda, fino alla trentaduesima, poi si ricomincia. Una casella la può aprire una persona alla volta. Se i trentadue della squadra chiedono pagine che stanno in trentadue caselle diverse, si servono tutti nello stesso istante. Se invece chiedono pagine diverse che stanno nella stessa casella, devono fare la fila: in due, due turni; in trentadue sulla stessa casella, trentadue turni, e del vantaggio di avere il manuale sul tavolo resta poco (i tecnici la chiamano bank conflict: le caselle, dentro una GPU, si chiamano banchi). Un caso non costa niente: quando tutti vogliono la stessa pagina, uno la legge ad alta voce e la sentono tutti insieme.
Se la squadra legge di seguito, riga per riga, la fila non si forma: pagine vicine stanno in caselle vicine. Si forma quando si legge una tabella per colonne, e ogni riga della tabella è larga esattamente trentadue pagine: allora una colonna intera cade tutta nella stessa casella, e servono trentadue turni per una lettura sola. Il rimedio sembra uno scherzo e funziona: si lascia una casella vuota in fondo a ogni riga, larghezza trentatré invece di trentadue. Ogni riga slitta di uno, la colonna si sparpaglia su tutte le caselle, la fila sparisce. Si butta via un trentatreesimo dello scaffale e si guadagna un fattore trentadue.
La leva quantitativa è il fattore di riuso: quante volte un dato caricato in shared memory viene poi letto dai thread del blocco prima di essere scartato. Se lo carichi una volta e lo usi \(r\) volte, hai diviso per \(r\) il traffico verso la HBM per quel dato, e, come vedremo tra poco con il roofline, ridurre i byte spostati a parità di conti è esattamente ciò che sposta un kernel dal regime memory-bound verso quello compute-bound. La shared memory è gestita dal programmatore proprio per questo: a differenza di una cache automatica, sei tu a decidere quale tessera trattenere e per quanto, adattando il riuso alla struttura del calcolo. È un potere che si paga in complessità, ed è il motivo per cui i kernel di alte prestazioni si scrivono a mano (o li genera un compilatore come Triton, che incontreremo).
Ha però un secondo prezzo, ed è l’esatto analogo della coalescenza un piano più su. La shared memory è divisa in 32 banchi da 32 bit, con le parole consecutive assegnate a banchi consecutivi, e i banchi sono tanti quanti i thread di un warp proprio perché nel caso favorevole ciascun thread acceda a un banco diverso e i 32 accessi vengano serviti insieme. Se invece più thread dello stesso warp chiedono parole diverse dello stesso banco (un bank conflict) l’hardware spezza la richiesta in tante richieste prive di conflitto quante servono, e la banda effettiva si divide per quel numero: fino a \(32\times\) nel caso peggiore. Fa eccezione il caso in cui i thread chiedono la stessa parola: quello è un broadcast, ed è gratis.
Nel tiling classico del GEMM il problema non si pone (la tessera di
\(\mathbf{A}\) si legge in broadcast, quella di \(\mathbf{B}\) per parole
consecutive) e proprio per questo l’avvertenza è necessaria: quello è il caso
favorevole, mentre ogni variante che percorre una tessera per colonna (una
trasposta, il caricamento dei frammenti per i tensor core, il tile di
\(\mathbf{K}^\top\) in FlashAttention) cade nel caso scomodo. Il rimedio canonico
sta in una riga: si dichiara la tessera con una colonna in più ([32][33]
invece di [32][32]), così l’indirizzo di ogni riga slitta di un banco e la
colonna smette di ricadere sempre sullo stesso.
Questo schema (portare in shared memory un pezzo di dati, farlo usare a tutti i thread del blocco e solo allora passare al pezzo successivo) si chiama tiling, «piastrellare»: i dati si spezzano in tessere come un pavimento (in inglese tile, parola che resta per gli oggetti del codice). È il motore del prodotto fra matrici, l’operazione in cui sta quasi tutta l’aritmetica di una rete, a cui è dedicata la sezione sul GEMM, dal nome (GEneral Matrix Multiply) con cui le librerie di calcolo chiamano quel prodotto. La shared memory esiste proprio per rendere possibile questo riuso.
Il modello roofline: limitati dai conti o dai byte?#
Mettiamo ora insieme i due limiti (quanto sa calcolare la GPU e quanti byte le arrivano) in un unico quadro. Lo strumento si chiama roofline, cioè «linea del tetto», e viene da un lavoro del 2009 di Williams, Waterman e Patterson [WWP09]. Il titolo lo presenta come «un modello visuale illuminante delle prestazioni», e la promessa è mantenuta: riassume in un solo grafico il perché un programma va veloce o lento (Fig. 8.7).
L’idea ruota attorno a una sola quantità, l’intensità aritmetica: quanti conti fai per ogni byte che sposti dalla memoria. Si misura in FLOP per byte (un FLOP, come si è detto nell’architettura, è un conto elementare: una moltiplicazione o una somma). Poche operazioni per tanti byte significa che passi la vita ad aspettare i dati; tante operazioni per pochi byte significa che i dati ti bastano e sei limitato solo da quanto calcoli. Le due situazioni hanno un nome, e sono due parole inglesi che ricorreranno in ogni pagina che segue: nel primo caso si è memory-bound, alla lettera «legati alla memoria», e il tempo lo decide la banda; nel secondo compute-bound, «legati al calcolo», e il tempo lo decide il picco di conti al secondo.

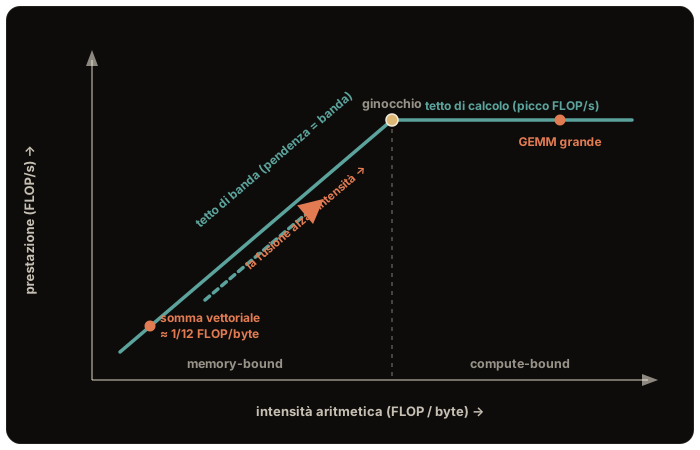
Fig. 8.7 Come si legge il roofline. In orizzontale, quanti conti si fanno per ogni byte portato dalla memoria: più a destra, più conti. In verticale, la velocità che se ne ricava. Il «tetto» ha due falde: quella inclinata a sinistra è il limite imposto dalla banda, quella piatta a destra è la velocità massima di calcolo della scheda, che non si può superare in nessun modo. Il punto in cui le due falde si incontrano, e il tetto cambia pendenza come una gamba che si piega, si chiama ginocchio. Un calcolo che cade a sinistra del ginocchio è bloccato dalla memoria (memory-bound), uno a destra dal calcolo (compute-bound). Fondere più operazioni in una sola alza i conti per byte e sposta l’operazione verso destra.#
In cucina la velocità con cui escono i piatti dipende da due cose: quanto sono bravi i cuochi e quanto in fretta arrivano gli ingredienti dal magazzino. I cuochi sono le unità che fanno i conti, il magazzino è la memoria grande della scheda, e la velocità dei piatti è quella del più lento dei due.
Una ricetta che chiede pochissima preparazione e tantissimi ingredienti (apri mille scatolette e svuotale in una ciotola) lascia i cuochi fermi ad aspettare il carico dopo: sei limitato dal magazzino, e si dice memory-bound. Un brodo che sobbolle per ore lavora a lungo su pochi ingredienti: la roba basta e avanza, e a contare è solo la mano dei cuochi, cioè si è compute-bound.
Il roofline è il grafico che dice, per ogni ricetta, da quale delle due parti sei bloccato, e per leggerlo basta una misura: quanti conti fai per ogni byte che ti sei fatto portare. Prendi due lunghe liste di numeri da sommare. Per ogni somma il fattorino porta i due addendi e riporta indietro il risultato: tre numeri da quattro byte l’uno, dodici byte per un conto. Un dodicesimo di conto per byte, e sei nel magazzino fino al collo.
Adesso due tabelloni da quattromila numeri di lato, da moltiplicare. Il fattorino porta i tre tabelloni, 48 milioni di numeri, cioè 192 milioni di byte. I cuochi, per ciascuna delle 16 milioni di caselle del risultato, fanno quattromila moltiplicazioni e altrettante somme: 128 miliardi di conti. Dividendo, quasi settecento conti per ogni byte portato, e il magazzino smette di essere il problema. Quel settecento però suppone che ogni ingrediente entri in cucina una volta sola, cioè che tutta la roba stia sul tavolo accanto ai cuochi mentre lavorano. Per tabelloni di quella taglia sul tavolo non ci sta, e altri viaggi si fanno comunque: settecento è il massimo sperabile. Fatta nel modo più ingenuo, una casella alla volta, la moltiplicazione ne resta lontanissima, in fondo alla classifica; quanto la cucina vera ci si avvicini dipende da come organizza il lavoro, ed è la storia della sezione sulla moltiplicazione fra matrici.
In mezzo c’è il pareggio, il ginocchio, che su una scheda di qualche anno fa sta intorno ai dieci conti per byte: sotto comanda il magazzino, sopra comandano i cuochi. È un numero che si sposta, e sempre nella stessa direzione. Accendi le unità costruite apposta per moltiplicare due tabelloni, i tensor core, e il pareggio sale oltre i centocinquanta: i cuochi sono diventati sedici volte più svelti, mentre il magazzino consegna alla stessa velocità di prima. Da qui la cura, per chi sta sotto: fare più conti con gli stessi ingredienti prima di rimandarli indietro.
Formalizziamo. Sia \(I\) l’intensità aritmetica in FLOP/byte, \(B\) la banda di memoria in byte/s e \(P_\text{picco}\) il picco di calcolo in FLOP/s. La prestazione raggiungibile è
dove il primo termine è il tetto di calcolo (piatto: non puoi superare il picco di FLOP dell’hardware) e il secondo è il tetto di banda (inclinato: con banda \(B\), se sposti tanti byte per pochi conti, non puoi andare più veloce di \(B \cdot I\)). I due tetti si incontrano nel ginocchio
l’intensità di pareggio. A sinistra (\(I < I^\star\)) domina la banda: si è memory-bound. A destra (\(I > I^\star\)) domina il calcolo: si è compute-bound. Dietro il \(\min\) c’è un modello di tempo, \(t = \max(F / P_\text{picco},\; Q / B)\) per \(F\) FLOP e \(Q\) byte spostati, con \(I = F/Q\), e tre ipotesi. La prima: calcolo e trasferimento si sovrappongono per intero (senza sovrapposizione il tempo è la somma dei due, e a \(I = I^\star\) la prestazione si dimezza). La seconda: ci sono abbastanza accessi in volo da saturare la banda, la legge di Little della sezione sull’architettura. La terza: \(Q\) è contato su un solo livello della piramide. Ogni livello ha il suo roofline, e lo stesso kernel può essere compute-bound rispetto alla HBM e memory-bound rispetto alla shared [WWP09].
Nell’articolo il ginocchio si chiama ridge point, e l’intensità operational intensity: gli autori la contano sui soli byte che arrivano alla DRAM dopo il filtro delle cache, e scelgono quel nome proprio per distinguerla dall’arithmetic intensity, che contava il traffico fra il processore e le cache. Nella letteratura sulle GPU il termine corrente è arithmetic intensity, contata sul livello che interessa. I tetti, infine, sono nominali: la banda che un kernel sostiene davvero sta sotto quella di targa, quindi i tempi ricavati dalle schede tecniche (come i millisecondi del GEMM nella sezione dedicata) sono ottimistici, e il roofline di un kernel reale lo si misura con uno strumento di profilazione, come Nsight Compute per le schede NVIDIA.
Conviene fissare subito dove cade quel ginocchio, perché è il metro con cui il
resto del capitolo giudicherà ogni tecnica, e perché ce n’è più d’uno sulla
stessa scheda: dipende da quali unità di calcolo si stanno usando. Su una
A100 80 GB PCIe (banda \(1{,}935\) TB/s) i CUDA core in float32 danno
\(19{,}5/1{,}935 \approx 10\) FLOP/byte, ma i tensor core in float16 danno
\(312/1{,}935 \approx 161\); su una H100 SXM (banda \(3{,}35\) TB/s) si passa da
\(67/3{,}35 = 20\) a \(989/3{,}35 \approx 295\). Un calcolo che sta a destra del
primo ginocchio può stare comodamente a sinistra del secondo, e il secondo è
quello che conta appena si accende la mezza precisione. Il ginocchio però non
si sposta da solo: passando a float16 anche i byte da spostare si dimezzano,
quindi l’intensità del programma raddoppia e gli va incontro. Fra i due
movimenti il divario che resta è la metà di quello che il rapporto fra i
ginocchi lascerebbe credere.
Due esempi concreti, con dati in float32 (4 byte):
Somma elemento-per-elemento \(z = x + y\). Per ogni elemento di uscita: 1 FLOP (la somma), e \(3 \times 4 = 12\) byte spostati (leggo \(x\), leggo \(y\), scrivo \(z\)). Intensità \(I = 1/12 \approx 0{,}08\) FLOP/byte: bassissima, profondamente memory-bound. Con un ginocchio a 10 FLOP/byte questa operazione usa meno dell’1 % del picco di calcolo.
GEMM grande \(\mathbf{C} = \mathbf{A}\mathbf{B}\) con matrici \(n \times n\). Circa \(2n^3\) FLOP e, con riuso perfetto, \(3 n^2 \times 4 = 12 n^2\) byte, per un’intensità \(I = n/6\) FLOP/byte che cresce con \(n\): per \(n = 4096\) vale circa 680 FLOP/byte, saldamente compute-bound. Attenzione però a che cosa vuol dire «riuso perfetto»: leggere ogni elemento di \(\mathbf{A}\) e \(\mathbf{B}\) una volta sola, cioè tenerle intere in memoria veloce. Per \(n = 4096\) in
float32sono 128 MiB, e l’unico banco on-chip che una tessera qualsiasi può attraversare è la cache L2, 50 MB su una H100: shared memory e registri sono ripartiti per SM e per blocco, e sommarli al totale darebbe un numero che nessun calcolo può spendere. Quell’\(n/6\) è quindi un tetto ideale, non un traguardo. La sezione sul GEMM riprenderà questo conto per mostrare a che punto si arrivi davvero (e perché non serva arrivarci).
Ora è chiaro perché la kernel fusion paga: fondere tre operazioni elemento-per-elemento in un solo kernel significa leggere gli input una volta e scrivere l’output una volta invece di tre (meno byte a parità di FLOP, cioè intensità \(I\) più alta). Sul roofline l’operazione scivola verso destra, dal tetto di banda verso il tetto di calcolo. I tensor core, infine, alzano \(P_\text{picco}\) di un ordine di grandezza: spostano il ginocchio a destra, e rendono ancora più facile ritrovarsi memory-bound. Ecco perché, nell’era dei tensor core, la partita si gioca sempre più sui byte e sempre meno sui FLOP.
Ogni tecnica che segue si legge sul roofline. Il tiling del prodotto fra matrici alza l’intensità aritmetica, cioè sposta il punto verso destra sul roofline; FlashAttention [DFE+22] applica la stessa idea all’attenzione, il meccanismo con cui i modelli linguistici confrontano ogni parola di un testo con tutte le altre, e riorganizza il calcolo per non scrivere mai in memoria la tabella di quei confronti. Sotto nomi diversi la domanda è sempre la stessa: quanti conti si fanno per ogni byte spostato?
Portare i conti dove stanno i dati#
Le cure viste finora cambiano il programma perché faccia più conti per ogni byte portato. C’è anche la cura opposta, che lascia il programma com’è e cambia l’hardware: mettere le unità di calcolo dentro la memoria, o subito accanto, così che i dati non debbano più attraversare il collegamento fra la memoria e il processore che fa i conti. Si chiama elaborazione in memoria (processing-in-memory, PIM). Nella forma più spinta a calcolare sono le celle stesse che tengono i bit; in quella più diffusa, il calcolo vicino alla memoria (near-memory computing), le unità di calcolo stanno su una piastrina di silicio attaccata a quelle della memoria. Un esempio del secondo tipo, progettato per le reti neurali, è il Neurocube [KKC+16], disegnato in Fig. 8.8. Era integrato in una memoria costruita a piani, l’Hybrid Memory Cube (oggi fuori produzione, e il meccanismo è passato ad altre memorie): più piastrine di memoria, i die, impilate una sull’altra e attraversate da collegamenti verticali, sopra uno strato di circuiti che le governa, lo strato logico. La pila è divisa in colonne indipendenti, i vault, e nello strato alla base il Neurocube mette un elemento di calcolo per colonna.
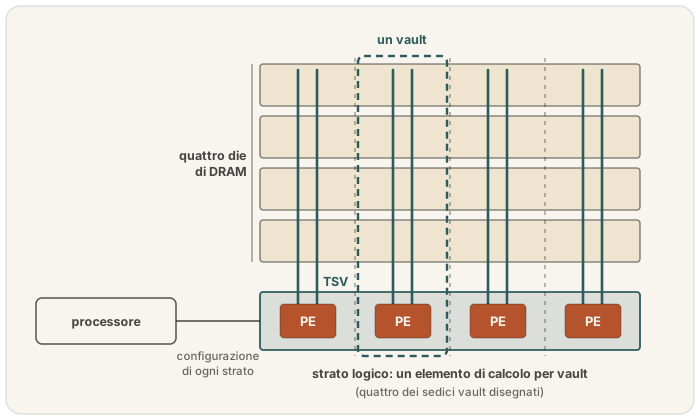
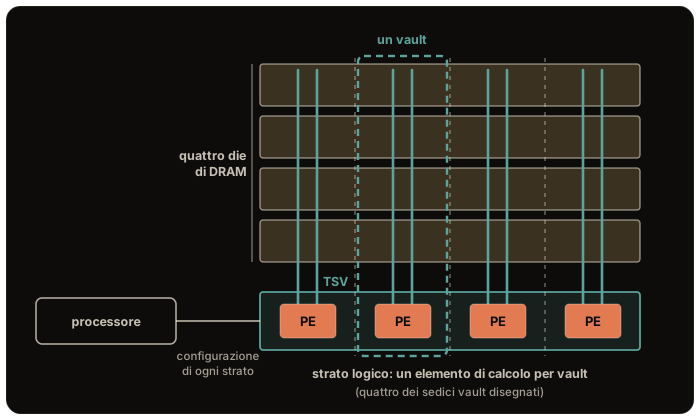
Fig. 8.8 Il Neurocube nello strato logico di un Hybrid Memory Cube: sopra, i die di DRAM divisi in vault; sotto, un elemento di calcolo per vault, che legge la propria colonna senza passare dal processore. Dal processore arriva solo la configurazione, una volta per ogni strato della rete neurale.#
La ricetta delle mille scatolette lasciava i cuochi fermi ad aspettare il fattorino. Invece di riscrivere la ricetta perché faccia più conti con gli stessi ingredienti, si può mandare qualche aiutante a lavorare dentro il magazzino. Il magazzino è un palazzo di quattro piani, e ogni corsia è una colonna di scaffali che sale per tutti i piani con il suo montacarichi; in fondo a ogni colonna, al piano terra, lavora un aiutante con un piccolo banco, che apre le scatolette dove stanno e manda in cucina (il processore) solo il risultato. Il fattorino fa molti meno viaggi, e le corsie lavorano ciascuna per conto suo, tutte insieme. Non è che le corsie, tutte insieme, aprano più scatolette al minuto di quante il fattorino ne porterebbe in cucina: il guadagno è la strada che ogni scatoletta non fa più, e la fatica di farla, mentre i cuochi restano liberi per il resto.
Gli aiutanti del magazzino, però, non sono i cuochi della cucina. Hanno banchi piccoli e attrezzi semplici, e soprattutto non devono scaldare l’ambiente: il magazzino è una cella frigorifera, e se si scalda la roba si guasta prima e va controllata più spesso, un lavoro che toglie tempo a tutto il resto. Per questo lì dentro si fanno solo i lavori semplici e ripetitivi, e i piatti elaborati restano in cucina. Ogni aiutante deve poi trovare nella propria corsia quello che gli serve, perché se deve andare a prendere le scatolette in un’altra corsia si torna a camminare. E non conviene per tutte le ricette: per il brodo che sobbolle su pochi ingredienti gli aiutanti non servono, perché lì il collo di bottiglia erano già i cuochi, e sui banchi piccoli del magazzino quel lavoro verrebbe anzi più lento.
Un’ultima cosa cambia il modo di lavorare. In cucina ogni ingrediente arriva perché qualcuno lo ha chiesto; nel magazzino l’aiutante riceve la ricetta una volta, e sa da solo quale scaffale aprire dopo, senza aspettare un ordine per ogni scatoletta, che costerebbe ogni volta un viaggio dalla cucina.
Nell’Hybrid Memory Cube (HMC) le vie verticali attraverso il silicio (TSV) collegano i die di DRAM allo strato logico. La memoria è divisa in sedici vault, colonne verticali della pila, ciascuna con il proprio controllore nello strato logico, e a ogni vault è collegato un elemento di calcolo, fatto nel progetto valutato di sedici unità di moltiplicazione e accumulo in virgola fissa a 16 bit. I dati di ogni conto non attraversano più i collegamenti seriali verso il processore, e i sedici vault si leggono in parallelo. La mossa architetturale è il programmable neurosequence generator: l’host scrive una volta per strato la descrizione della rete nei registri di configurazione, e da lì in poi la sequenza degli indirizzi la genera l’hardware, senza un’istruzione per ogni accesso. Gli autori lo chiamano calcolo memory-centric: a guidarlo è la memoria, non un programma.
Sul roofline il calcolo in memoria può alzare il tratto inclinato, perché cambia il collegamento su cui si contano i byte: con molte unità che leggono in parallelo, ciascuna dal proprio banco, la banda complessiva cresce con quante sono. Nel Neurocube però non succede: i sedici vault, a 10 GB/s l’uno, fanno 160 GB/s, e i collegamenti esterni ne portano fino a 320 (nella Tabella I del lavoro, moltiplicando la banda per canale per il numero di canali; il sistema valutato ne ha quattro, cioè 160). Il guadagno è in energia, non in banda: nella stessa tabella un bit che sale per le TSV costa 3,7 pJ, uno che esce dai collegamenti esterni 10, e la potenza è il vincolo di tutta la pila. Il vantaggio sta nel non far viaggiare ogni dato fino al processore, che resta libero e riceve solo la configurazione. Per un kernel a sinistra del ginocchio (un prodotto matrice-vettore, un’operazione elemento per elemento) è la leva giusta; per un GEMM grande, già limitato dal calcolo, non serve, e le unità semplici della memoria anzi lo rallenterebbero. È un’inferenza dal modello, coerente con le misure su un sistema commerciale dello stesso genere, con i processori sul die della DRAM (UPMEM), dove i carichi che convengono sono quelli limitati dalla memoria, con aritmetica semplice e poca comunicazione fra le unità [GomezLEHF+21]. I limiti sono fisici e di programmazione. La logica sotto la pila riscalda la DRAM, che a temperatura più alta trattiene la carica per meno tempo e va rinfrescata più spesso: il bilancio termico decide quindi quanta logica sia possibile integrare. Lo strato logico ha un bilancio di area e di potenza limitato, quindi unità semplici; e i dati vanno distribuiti fra i vault in modo che ciascuno lavori su ciò che ha, perché spostarli da un vault all’altro richiede di attraversare la rete sul die logico, e nell’articolo quel traffico laterale costa fino a un sesto della velocità sugli strati densi: gli autori lo evitano duplicando in ogni vault i dati di confine, e lo pagano in capacità di memoria.
Il conto che rende attraente il calcolo in memoria è quello di uno strato
lineare (un vettore, cioè una lista di numeri, moltiplicato per una matrice di
pesi, il mattone delle reti) applicato a pochi vettori alla volta, come quando
un modello di linguaggio genera il testo una parola dopo l’altra e ogni parola
è un vettore. Con un vettore solo, ogni peso arriva dalla memoria, serve per
una moltiplicazione e una somma, e se ne va: il fondo del roofline. Con molti
vettori insieme, ogni peso arrivato serve molte volte. In simboli, per
\(\mathbf{Y} = \mathbf{X}\mathbf{W}\) con \(\mathbf{X} \in \mathbb{R}^{b \times
n}\) e \(\mathbf{W} \in \mathbb{R}^{n \times n}\) i conti sono \(2bn^2\) e i byte, a
due l’uno, \(2(n^2 + 2nb)\): l’intensità è \(I(b) = bn/(n + 2b)\), dove \(n\) è la
larghezza dello strato e \(b\) quanti vettori passano insieme, e vale circa 1 per
\(b = 1\) e non supera mai \(n/2\). Ecco come cresce con \(b\), in float16, contro
il ginocchio di una scheda NVIDIA A100 con i tensor core accesi, poco più di
161 conti per byte.
from math import ceil

n = 4096                              # uno strato lineare con una matrice di pesi n x n
ginocchio = 312e12 / 1.935e12         # A100 80 GB PCIe, tensor core in float16
for b in (1, 8, 64, 512):             # quanti vettori passano insieme per lo strato
    flop = 2 * n * n * b              # una moltiplicazione e una somma per peso e vettore
    byte = 2 * (n * n + 2 * n * b)    # pesi, vettori in ingresso e in uscita, 2 byte l'uno
    intensita = flop / byte
    print(f"b = {b:3}: {intensita:6.1f} FLOP per byte, "
          f"{min(1, intensita / ginocchio):6.1%} del picco di calcolo al massimo")
# il pareggio: I(b) = b n / (n + 2 b) raggiunge il ginocchio per b = g n / (n - 2 g)
print(f"ginocchio a {ginocchio:.0f} FLOP per byte: lo si supera da b = "
      f"{ceil(ginocchio * n / (n - 2 * ginocchio))} vettori in su")
b =   1:    1.0 FLOP per byte,   0.6% del picco di calcolo al massimo
b =   8:    8.0 FLOP per byte,   4.9% del picco di calcolo al massimo
b =  64:   62.1 FLOP per byte,  38.5% del picco di calcolo al massimo
b = 512:  409.6 FLOP per byte, 100.0% del picco di calcolo al massimo
ginocchio a 161 FLOP per byte: lo si supera da b = 176 vettori in su
Con un vettore solo l’intensità è di un conto per byte, e al massimo si usa lo \(0{,}6\%\) del picco; solo da centosettantasei vettori insieme in su l’intensità supera il ginocchio. Il vettore solo è il caso in cui portare i conti dentro la memoria vale di più; l’altra strada, per chi serve un modello di linguaggio, è raccogliere le richieste di molti utenti in lotti, così che ogni peso arrivato serva a molti vettori. È il conto che riprende, per un modello che scrive una parola alla volta, la sezione «Starci non è rispondere» del capitolo sull’efficienza.
Da ricordare
Il collo di bottiglia di una GPU, più spesso che i conti, è portare i numeri. Tenere tanti gruppi al lavoro nasconde le attese (la latenza), ma non fa arrivare i dati più in fretta: quanti ne consegna la memoria al secondo (la banda) è un tetto che non si alza. Le due misure vanno tenute distinte, perché una si copre e l’altra no.
La memoria è una scrivania: la penna in mano (i registri, privatissimi e minuscoli), i fogli sul piano (la shared memory, il tavolo della squadra), il cassetto grande (la cache L2), l’armadio dall’altra parte della stanza (la memoria grande della scheda, la HBM, quella che nelle altre scene è «il magazzino» o «la dispensa») e il deposito in un altro edificio (la memoria del computer, dove si va con
.to(device)). Fra la penna e il deposito non c’è il doppio di distanza: ce n’è migliaia di volte.Conta anche come si chiedono i dati, non solo dove stanno. Trentadue pacchi sulla stessa via si consegnano in quattro giri di furgone pieno; gli stessi trentadue sparsi per la città vogliono trentadue viaggi quasi vuoti: otto volte il tempo per lo stesso lavoro. Perciò conviene disporre i dati in modo che lavoratori vicini leggano posti vicini: un elenco per ogni campo, per esempio, invece di schede con tutti i campi uno accanto all’altro.
L’altra mossa che risparmia viaggi è portare il manuale sul tavolo comune una volta sola e lasciare che tutti lo consultino lì. Ripetuta su blocchetti di dati (le tessere), è la tecnica che rende veloce la moltiplicazione fra matrici, ed è il motivo per cui la shared memory esiste.
Ogni calcolo è bloccato o dal magazzino o dai cuochi, e il grafico che lo dice si chiama roofline: si guarda quanti conti si fanno per ogni byte portato. Poche operazioni su tanti dati (sommare due liste di numeri) sono bloccate dal magazzino; tanti conti su pochi dati (una grande moltiplicazione fra matrici) sono bloccati dai cuochi.
Più i «cuochi» diventano veloci di generazione in generazione, più è facile ritrovarsi bloccati dal magazzino: è la ragione per cui tutto il capitolo parla di byte e non di conti.
Si può anche portare il lavoro nel magazzino: aiutanti con banchi piccoli, uno per corsia, che fanno i lavori semplici dove stanno le scatolette. Conviene per le ricette bloccate dal magazzino, non per quelle bloccate dai cuochi, e solo se ogni aiutante trova nella sua corsia quello che gli serve.
Da ricordare
Su una GPU il collo di bottiglia è spesso il movimento dei dati, non il calcolo: i warp nascondono la latenza, ma la banda resta finita; è il «muro della banda».
La memoria è una piramide: registri (per-thread, immediati) → shared memory e cache L1, lo stesso banco di SRAM ripartito da un pomello (per-blocco, on-chip) → cache L2 → memoria globale HBM (decine di GB, centinaia di cicli di latenza) → memoria host, oltre il PCIe. Salendo cresce la velocità; la capienza cala per unità che ne dispone, non in assoluto (su A100 il register file di un SM è più grande della sua L1+shared).
La coalescenza conta: se i 32 thread di un warp leggono indirizzi contigui, l’hardware fonde gli accessi in poche transazioni piene da 32 byte; sparsi, spreca banda (fino a \(8\times\) nell’esempio, e un array of structures a tre campi lascia il 33%, dove una structure of arrays torna al 100%). L’analogo un piano più su sono i bank conflict della shared memory, divisa in 32 banchi: due parole diverse dello stesso banco si serializzano, fino a \(32\times\).
Caricare un blocco una volta in shared memory e riusarlo da tutti i thread (il tiling) risparmia letture dalla HBM: è il motore del GEMM efficiente.
Il roofline [WWP09] mette l’intensità aritmetica (FLOP/byte) contro la prestazione: a sinistra del ginocchio si è memory-bound, a destra compute-bound. La somma vettoriale (\(1/12\)) è memory-bound; un GEMM grande è compute-bound. Nell’articolo il ginocchio è il ridge point e l’intensità l’operational intensity, contata sulla DRAM; i tetti delle schede tecniche sono nominali, e i tempi che se ne ricavano ottimistici.
La kernel fusion aiuta perché alza l’intensità aritmetica; i tensor core alzano il picco di calcolo e spostano il ginocchio a destra (da \(\approx 10\) FLOP/byte con i CUDA core a \(\approx 160\) su A100 in
float16), rendendo la banda ancora più decisiva.Il calcolo in memoria (PIM; il Neurocube lo mette nello strato logico di un HMC) toglie il collegamento verso il processore dal conto dei byte: aiuta i kernel memory-bound con aritmetica semplice e dati ripartiti fra le unità, non un GEMM grande.