


Backpropagation: come impara una rete#
Le poche pagine che Rumelhart, Hinton e Williams pubblicano su Nature nel 1986, «Learning representations by back-propagating errors» [RHW86], sono il testo che mostra al mondo come una rete neurale possa correggersi da sola, un errore alla volta, ed è la stessa ricetta con cui ancora oggi imparano modelli da miliardi di parametri.
L’algoritmo però non era nuovo. Le sue radici stanno in un’idea più generale, la differenziazione automatica: far calcolare a un programma non soltanto il risultato di un conto, ma anche di quanto quel risultato cambierebbe muovendo ciascuno dei suoi ingressi. A pubblicarne per primo la forma generale è il finlandese Seppo Linnainmaa, nella tesi di laurea del 1970 [Lin70], che uscirà in inglese soltanto sei anni dopo. Paul Werbos ne propone l’uso per le reti neurali nella tesi di dottorato del 1974 [Wer74], e la applica a una rete in un lavoro del 1982 [Wer82]. Prima ancora, nei primi anni Sessanta, chi calcolava le traiettorie di volo migliori (il controllo ottimo) faceva già un conto all’indietro dello stesso genere, su grandezze che cambiano con continuità invece che a strati.
L’idea sta in due movimenti, come un respiro. In avanti la rete produce una risposta; all’indietro misura di quanto ha sbagliato e distribuisce la «colpa» a ogni peso. Vediamo i due movimenti uno per uno.
Il forward pass: dai dati all’uscita#
Un dato di partenza (in gergo un esempio: una foto, una frase, una riga di tabella) entra nella rete e attraversa gli strati uno dopo l’altro, finché l’ultimo non emette una previsione. Ogni strato prende ciò che riceve, lo combina con i propri pesi e lo passa avanti.
In una catena di montaggio, alla prima postazione arrivano i dati grezzi (per esempio i pixel di una foto). Ogni postazione ha un pannello di «manopole» (i pesi) con cui mescola ciò che riceve, poi fa passare il risultato nel passaggio delle funzioni di attivazione (la «piega») e lo consegna alla postazione successiva.
Ogni pezzo che esce da una postazione lo prepara un addetto, che ha una manopola su ciascuno dei pezzi che entrano: una postazione che riceve dieci pezzi e ne consegna tre ha tre addetti e trenta manopole. Ogni addetto aggiunge in più un valore di partenza tutto suo, comunque, anche quando ciò che gli arriva è zero: è il bias, lo zero regolabile di una bilancia, e sposta in su o in giù tutto quello che esce da lui.
L’ultima postazione affaccia il prodotto finito: la previsione della rete, per esempio «gatto: 0,92». La sua rifinitura è diversa da quella delle altre, perché diverso è ciò che deve consegnare. Se la risposta è una scelta fra più nomi, l’ultimo passaggio trasforma i punteggi in percentuali che sommano a uno; se la risposta è una quantità, un prezzo per esempio, lascia passare il numero com’è.
Nessuna postazione risolve il problema da sola: ognuna riceve per intero quello che le passa la precedente, lo rimescola un po’ e lo consegna alla successiva. Questo scorrere in avanti, dai dati alla risposta, è il forward pass.
Indichiamo con \(\mathbf{a}^{[0]} = \mathbf{x}\) l’input. Per ogni strato \(l = 1, \dots, L\) il forward pass calcola una combinazione lineare seguita da una non linearità:
Qui \(\mathbf{W}^{[l]}\) è la matrice dei pesi dello strato \(l\), \(\mathbf{b}^{[l]}\) il vettore di bias, \(\mathbf{z}^{[l]}\) la pre-attivazione e \(\mathbf{a}^{[l]}\) l’attivazione. Come nell’apertura del capitolo, \(g\) è l’attivazione degli strati nascosti (per esempio la ReLU, \(g(z)=\max(0,z)\)) e \(\varphi\) quella dello strato d’uscita, che di norma è un’altra: softmax per la classificazione, identità per la regressione; \(\sigma\) resta il nome della sigmoide. L’uscita finale è la previsione \(\hat{\mathbf{y}} = \mathbf{a}^{[L]}\). Ogni strato non è che il prodotto matrice-vettore già incontrato in algebra lineare, «avvolto» in una non linearità.
Fissare le forme dei tensori rende verificabile a mano ogni formula che segue, a partire dalla trasposta che comparirà nel passaggio all’indietro. Se lo strato \(l\) ha \(n_l\) neuroni, allora
una riga di \(\mathbf{W}^{[l]}\) per ogni neurone di arrivo, una colonna per ogni neurone di partenza. Chi ha un dubbio su una formula la controlli così: se le forme non combaciano, la formula è sbagliata, e non serve altro per accorgersene.
Quanto abbiamo sbagliato: la funzione di loss#
Il numero che dice quanto la rete ha sbagliato rispetto alla risposta giusta è la loss, e da dove venga la sua forma lo ha già ricavato la sezione Da dove viene la loss. Imparare significa renderla il più piccola possibile, e a questo scopo servono le sue derivate.
La loss è il totale delle multe del gioco dei gettoni, e quando la risposta è un numero, con la campana, la multa è la distanza al quadrato fra la risposta della rete e la verità. Con i soldi il conto si vede bene. La rete deve stimare il prezzo di una casa che vale davvero 200.000 €, e ne prevede 170.000: l’errore è di 30.000, e al quadrato fa \(30.000 \times 30.000 = 900\) milioni. Sbagliare di 60.000, il doppio, dà \(3.600\) milioni, quattro volte tanto: raddoppiare l’errore ne quadruplica il costo, come con la campana, e la rete impara a evitare le cantonate prima delle imprecisioni. La cifra in sé conta poco: se tutte le multe si dimezzassero, resterebbe identico quale sbaglio costa più di quale, e la rete andrebbe a finire nello stesso posto.
Più la stima è vicina al vero, più la multa è piccola, e se le due coincidono è zero. Le case però sono tante: la multa si calcola su ciascuna, una alla volta, e poi se ne prende la media. Quella media dipende dalle manopole, perché sono loro a decidere le stime: girarle cambia le previsioni, e quindi il numero. Tutto l’addestramento è una caccia a quel numero più basso. Ogni modo di regolare tutte le manopole insieme è un punto di un paesaggio, lo stesso fatto di colline e conche (le buche del terreno) della matematica dell’ottimizzazione, e la media delle multe è l’altezza del terreno in quel punto. Con due manopole il paesaggio è un terreno vero, due direzioni in cui camminare più l’altezza; con mille le direzioni sono mille, e nessuno riesce a figurarselo, ma il conto per scendere si fa nello stesso modo.
Quando la risposta è un sì o un no (gatto oppure non gatto), la rete dichiara quanto ci crede con un numero fra zero e uno. Quel numero non nasce così: dentro c’è un punteggio, alto quanto si vuole, che l’ultima postazione schiaccia fra zero e uno, e non dappertutto con la stessa forza. Con il punteggio a metà strada il numero dichiarato è 0,5, e una piccola spinta al punteggio lo muove di un quarto di quella spinta; con il numero già a 0,99 la stessa spinta lo muove venticinque volte meno, perché sopra l’uno non c’è spazio dove andare.
Prova allora a dare la multa al quadrato, come per le case, e guarda che spinta a correggersi ne esce. È il prodotto di due cose: quanto il numero dichiarato era lontano dalla verità, e di quanto quel numero si sposta quando si sposta il punteggio. Chi ha dichiarato 0,99 mentre la verità era zero è lontano 0,99, ma il suo numero si muove di appena 0,0099: la spinta vale 0,0098. Chi ha dichiarato 0,5, senza sbilanciarsi, è lontano la metà, ma il suo numero si muove di 0,25: la spinta vale 0,125, più di dodici volte tanto. Chi ha torto marcio si corregge meno di chi era soltanto incerto, ed è l’ultima cosa che si vorrebbe.
Per questo, quando la risposta è una scelta fra nomi, la multa si conta in un altro modo, con la cross-entropia del gioco dei gettoni nelle caselle: con lo schiacciamento della sigmoide si incastra così bene che il fattore dello schiacciamento si semplifica e sparisce dal conto. Resta soltanto la lontananza dalla verità, 0,99 contro 0,5, e chi sbaglia di più riceve la spinta più forte.
Per la regressione si usa spesso l’errore quadratico medio su \(m\) esempi:
Per la classificazione si preferisce la cross-entropia, che confronta la distribuzione prevista \(\hat{\mathbf{y}}\) con l’etichetta \(\mathbf{y}\): \(\ell = -\sum_{k} y_k \log \hat{y}_k\) per un esempio, dove \(k\) scorre le classi, \(y_k\) vale \(1\) per quella giusta e \(0\) per tutte le altre, e \(\hat{y}_k\) è la probabilità che il modello le assegna; \(\mathcal{L}\) è la media di \(\ell\) sugli \(m\) esempi. In entrambi i casi \(\mathcal{L}\) è una funzione dei parametri \(\theta = \{\mathbf{W}^{[l]}, \mathbf{b}^{[l]}\}\): cambiando i pesi cambia la loss, e il nostro obiettivo è trovare i \(\theta\) che la minimizzano. Messi in fila tutti i pesi e tutti i bias, \(\theta\) è un vettore di \(\mathbb{R}^d\), con \(d\) il numero totale di parametri, e \(\mathcal{L}\) è una funzione \(\mathbb{R}^d\to\mathbb{R}\) su questo spazio dei parametri: il paesaggio di colline e conche di Analisi e ottimizzazione, con \(d = \sum_{l=1}^{L} n_l\,(n_{l-1}+1)\), che per una rete vera va dalle migliaia a oltre mille miliardi.
Che per la classificazione si «preferisca» la cross-entropia ha una ragione in più di quella probabilistica da cui la si è ricavata, e questa è meccanica: riguarda proprio il gradiente. Prendiamo il caso più piccolo, una sola uscita sigmoide \(\hat{y} = \sigma(z)\), e scriviamo la MSE su quel singolo esempio con un \(\tfrac{1}{2}\) davanti. Quel mezzo non c’era nella definizione di poco fa ed è messo qui apposta, perché si semplifica con il \(2\) che scende derivando: chi rifà il conto partendo dalla formula di sopra ottiene lo stesso risultato moltiplicato per \(2\), un fattore costante che cambia i numeri e non la direzione. Con questa scrittura la derivata rispetto a \(z\) porta un fattore \(\sigma'(z)\):
Ma \(\sigma'(z) = \sigma(z)(1-\sigma(z))\) vale quasi zero agli estremi, cioè proprio quando il neurone è sicuro e sbagliato: il modello che ha torto marcio è quello che impara più lentamente, che è l’esatto contrario di quel che serve. Sostituiamo allora la MSE con la cross-entropia dello stesso caso a due classi, la cross-entropia binaria: è quella di poco fa quando le classi sono due e l’uscita è una sola, perché allora la probabilità della seconda classe è \(1-\hat{y}\) e la somma su \(k\) ha due soli termini. Quel fattore si semplifica:
e il gradiente diventa proporzionale all’errore: più si sbaglia, più si corregge. È lo stesso fenomeno di saturazione che nella sezione sulle funzioni di attivazione motivava l’abbandono della sigmoide, visto però dal lato della loss invece che da quello dell’attivazione, e la cancellazione ha una ragione. La sigmoide è l’inversa del legame canonico della Bernoulli, la softmax quella della categorica, l’identità quella della gaussiana; e per ogni famiglia accoppiata al suo legame canonico la derivata della log-verosimiglianza negativa rispetto all’uscita lineare è predizione meno bersaglio. Per questo \(\boldsymbol{\delta}^{[L]} = \hat{\mathbf{y}} - \mathbf{y}\) vale, a meno del fattore costante della definizione, per l’errore quadratico con uscita lineare, per la cross-entropia binaria con la sigmoide e per quella multiclasse con la softmax: è la scelta della coppia, loss e ultima attivazione, a decidere se il gradiente sopravvive.
L’idea della backpropagation#
Sappiamo di quanto la rete ha sbagliato. La domanda vera è quanto cambierebbe la loss muovendo di poco ciascun peso, cioè la derivata parziale \(\partial\mathcal{L}/\partial w\) per ogni peso \(w\): è la «colpa» del peso, nel senso preciso di quanto l’errore dipende da lui. La backpropagation calcola tutte queste derivate insieme, ripercorrendo la rete a ritroso.

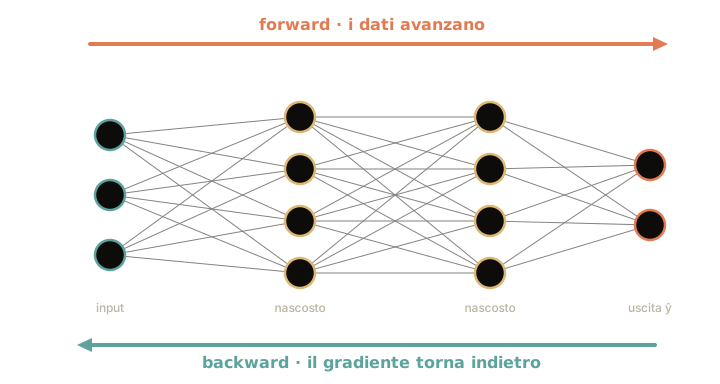
Fig. 6.12 I due movimenti dell’addestramento. In avanti (in alto) i dati diventano una previsione; all’indietro (in basso) la quota di errore che spetta a ciascuno risale la rete e raggiunge anche i primi strati.#
La catena di montaggio ha consegnato la sua stima, 170.000 € per una casa che ne vale 200.000. Adesso il reclamo torna indietro lungo la linea, dall’ultima postazione verso la prima, e a ogni tappa qualcuno deve dire quanta parte di quello scarto è sua (Fig. 6.12).
Sul foglio del reclamo non c’è scritta la penalità, i 900 milioni: il quadrato serviva a decidere quale sbaglio conta più di quale. A risalire la linea è lo scarto, 30.000 €, con il suo segno, che dice che la stima era bassa. (A rigore risalirebbe il doppio, perché la pendenza del quadrato è il doppio dello scarto; ma è di nuovo un fattore che moltiplica tutte le quote allo stesso modo e non sposta di un millimetro dove si va a finire.) All’ultima postazione arrivano due pezzi, preparati da due addetti della postazione prima, e l’addetto finale tiene la manopola su 2 per il primo pezzo e su 1 per il secondo: al primo dei due addetti tocca il doppio del rimprovero, 60.000 contro 30.000. Che sommati superino i 30.000 di partenza è normale, perché la colpa non si spartisce come una torta: viaggia lungo un filo e si moltiplica per la manopola che incontra.
Ogni addetto passa poi la sua quota a chi lo riforniva, moltiplicata per la manopola del filo e per la pendenza della piega attraversata. Chi sta in mezzo riforniva parecchi addetti a valle, quindi di rimproveri ne riceve uno per ciascuno, e li somma. Così il foglio arriva fino alla prima postazione. Tutto questo per una casa sola: le case però si mandano avanti a gruppetti, il giro si rifà per ciascuna e a ognuno spetta la media.
Nessuno rifà i conti da capo, ed è questo che rende la faccenda praticabile. La colpa che arriva si porta dietro due fattori in più a ogni postazione, la manopola e la piega, e allungare un prodotto di un pezzo costa una moltiplicazione, quindi un giro solo all’indietro serve tutta la linea. È lo stesso prodotto degli ingranaggi della regola della catena e degli specchietti della panoramica sulle reti neurali, raccontato con un’altra macchina.
Si potrebbe fare il contrario, girare una manopola di un pelo e rimandare avanti tutto per vedere di quanto cambia la stima. Dà la risposta giusta, e costa una linea intera per ogni manopola: un milione di manopole, un milione di giri. All’indietro si parte dall’unico numero che c’è alla fine, e un giro solo consegna la quota di tutti. Conviene entrare dalla parte dove le cose sono poche.
Il ritorno si paga in spazio. Per dare a una manopola la sua quota bisogna sapere che pezzo aveva portato il suo filo all’andata, quindi all’andata niente si butta: ogni pezzo resta su uno scaffale finché il reclamo non passa a riprenderlo. Gli scaffali crescono con il numero delle postazioni e con quante case si mandano avanti in una volta, e con tante case occupano più posto delle manopole stesse. Se lo spazio finisce se ne svuota qualcuno, e quel tratto di andata si rifà al volo quando il reclamo ci arriva, spendendo tempo per risparmiare spazio.
Il rimprovero arriva agli addetti, ma a doversi correggere sono le manopole. Ciascuna ne prende in proporzione a quanto il suo filo aveva portato per quella casa. Lo zero regolabile della bilancia, che si aggiunge comunque, prende la quota intera senza moltiplicarla per niente, perché contribuisce sempre nella stessa misura. E la quota ha il suo segno. La stima era bassa, quindi le manopole che spingevano il numero in su vanno alzate e quelle che lo tiravano in giù abbassate; con una stima troppo alta, il contrario. Di quanto e da che parte: basta questo, e girare le manopole è il gesto dopo.
Il meccanismo è la regola della catena di Analisi e ottimizzazione, qui allungata di un anello per strato e percorsa a ritroso. Scriviamo tutto per un singolo esempio, con la sua loss \(\ell\): il gradiente della loss media di un mini-batch (il gruppo di esempi su cui si fa un aggiornamento) è la media di questi contributi, uno per esempio.
Diamo un nome alla quantità che si propaga: il segnale d’errore dello strato \(l\) è la derivata della loss \(\ell\) rispetto alla sua pre-attivazione,
cioè, componente per componente, di quanto cambierebbe la loss se il neurone \(i\) dello strato \(l\) ricevesse un pelo di somma pesata in più. Per il layout al denominatore del libro (la derivata di uno scalare ha sempre la forma dell’oggetto rispetto a cui si deriva) \(\boldsymbol{\delta}^{[l]}\) ha la stessa forma di \(\mathbf{z}^{[l]}\): un numero per neurone.
Da questa definizione la ricorsione si ricava in tre righe. La loss vede \(z^{[l]}_i\) soltanto attraverso l’attivazione \(a^{[l]}_i = g(z^{[l]}_i)\), e quell’attivazione entra in tutte le pre-attivazioni dello strato successivo, \(z^{[l+1]}_j = \sum_i W^{[l+1]}_{ji}\,a^{[l]}_i + b^{[l+1]}_j\): la catena passa quindi per ogni \(j\), e i contributi si sommano.
Quella somma è la componente \(i\)-esima di \(\left(\mathbf{W}^{[l+1]}\right)^{\!\top}\boldsymbol{\delta}^{[l+1]}\), ed è tutta qui la ragione della trasposta: andando avanti l’indice dello strato \(l\) è quello di colonna, tornando indietro diventa quello di riga. In forma compatta, con lo strato d’uscita che fa da innesco:
Lo stesso conto dà i gradienti che servono per aggiornare i parametri: \(z^{[l]}_i\) dipende da \(W^{[l]}_{ij}\) solo attraverso il prodotto \(W^{[l]}_{ij}\,a^{[l-1]}_j\), quindi \(\partial\ell/\partial W^{[l]}_{ij} = \delta^{[l]}_i\,a^{[l-1]}_j\). Rimesse insieme, quelle derivate formano una matrice della stessa forma di \(\mathbf{W}^{[l]}\) (è la promessa del layout al denominatore), cioè un prodotto esterno:
Il simbolo \(\odot\) è il prodotto elemento per elemento (Hadamard), \(g'\) e \(\varphi'\) le derivate delle due attivazioni: la scrittura con \(\odot\) presuppone quindi un’attivazione applicata componente per componente. La softmax, cioè la \(\varphi\) tipica della classificazione, non lo è (ogni uscita dipende da tutti i logit), ma accoppiata alla cross-entropia il conto si semplifica in due righe. La derivata della softmax è \(\partial\hat{y}_k/\partial z_i = \hat{y}_k\left(\mathbb{1}[k=i]-\hat{y}_i\right)\), dove l’indicatore \(\mathbb{1}[k=i]\) vale \(1\) quando i due indici coincidono e \(0\) altrimenti; mettendola nella cross-entropia \(\ell=-\sum_k y_k\log\hat{y}_k\) i termini si accorciano: \(\partial\ell/\partial z_i = \hat{y}_i \sum_k y_k - y_i\), cioè \(\hat{y}_i - y_i\), perché l’etichetta è one-hot e la somma vale \(1\). Il termine d’uscita diventa quindi \(\boldsymbol{\delta}^{[L]} = \hat{\mathbf{y}} - \mathbf{y}\): è la combinazione che i framework implementano. Il punto cruciale: ogni \(\boldsymbol{\delta}^{[l]}\) riusa \(\boldsymbol{\delta}^{[l+1]}\), così un solo passaggio all’indietro basta a calcolare tutti i gradienti. È questo che rende l’addestramento praticabile su reti enormi.
Che il verso giusto sia questo ha una ragione, ed è il contenuto della differenziazione automatica. Derivare automaticamente si può in due modi. Nel modo diretto si propaga in avanti, insieme al calcolo, la derivata rispetto a una direzione fissata dei parametri: una passata dà la derivata lungo quella direzione, e per il gradiente completo servono \(d\) passate, una per parametro. Nel modo inverso si propaga all’indietro dall’uscita, e una passata sola le dà tutte quante. Quando l’uscita è una sola (la loss è uno scalare) e gli ingressi sono milioni, il verso conveniente è ovviamente il secondo, e il gradiente finisce per costare un multiplo costante della funzione, qualunque sia il numero di parametri: è il cheap gradient principle. Sull’MLP la costante si conta. Su un mini-batch di \(B\) esempi messi in colonna, \(\mathbf{A}^{[l-1]}\in\mathbb{R}^{n_{l-1}\times B}\), l’andata di uno strato è un prodotto \(\mathbf{W}^{[l]}\mathbf{A}^{[l-1]}\), circa \(2\,n_l n_{l-1} B\) operazioni; il ritorno ne fa due della stessa taglia, \((\mathbf{W}^{[l]})^{\top}\boldsymbol{\Delta}^{[l]}\) per il segnale da passare indietro e \(\boldsymbol{\Delta}^{[l]}(\mathbf{A}^{[l-1]})^{\top}\) per il gradiente dei pesi, dove \(\boldsymbol{\Delta}^{[l]}\in\mathbb{R}^{n_l\times B}\) raccoglie in colonna i \(\boldsymbol{\delta}^{[l]}\) dei singoli esempi. Il ritorno costa quindi circa due andate, e il prodotto \(\boldsymbol{\Delta}^{[l]}(\mathbf{A}^{[l-1]})^{\top}\) fa da sé la somma sugli esempi: diviso per \(B\), è il gradiente della loss media del mini-batch. La backpropagation è il modo inverso applicato a una rete.
Il conto però non è gratis, e il prezzo è in memoria. Per calcolare \(\partial\ell/\partial \mathbf{W}^{[l]} = \boldsymbol{\delta}^{[l]}(\mathbf{a}^{[l-1]})^{\!\top}\) serve l’attivazione \(\mathbf{a}^{[l-1]}\): il forward deve quindi conservare le attivazioni di tutti gli strati finché il gradiente non torna indietro a prenderle. È l’unica voce che cresce con la profondità e insieme con la dimensione del batch, mentre i pesi restano gli stessi. Quanto pesi rispetto al modello si stima a mente, su una rete di venti strati da \(512\) unità: i pesi sono venti matrici \(512\times512\), le attivazioni trattenute venti vettori da \(512\) numeri per ciascun esempio del batch (l’ingresso di ogni strato; quella dell’ultimo non serve a nessun gradiente), quindi con \(B\) esempi per batch il rapporto è circa \(B/512\) (a meno dei bias e di ciò che serve trattenere per le derivate delle attivazioni), e a \(B=512\) le due voci si pareggiano: a batch \(32\) le attivazioni pesano un sedicesimo del modello, a batch \(512\) lo pareggiano, a batch \(2048\) pesano quattro volte tanto, cioè sessantaquattro volte più che a batch \(32\) per un batch sessantaquattro volte più grande. Da qui il gradient checkpointing, che ne butta via una parte e la ricalcola in avanti quando serve: memoria contro tempo.

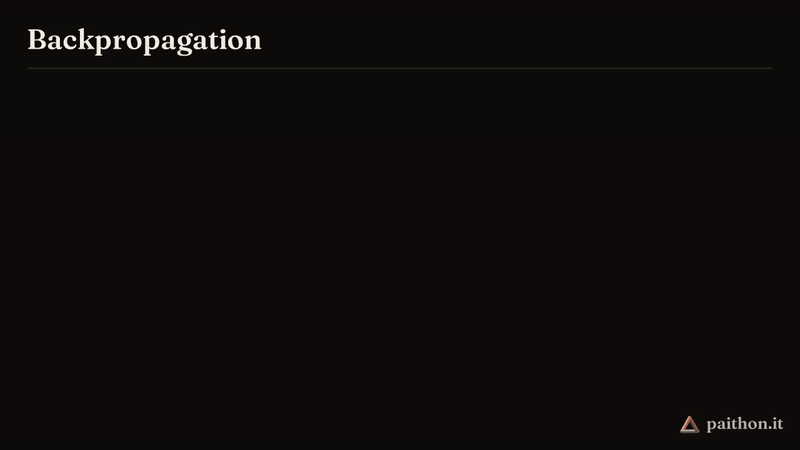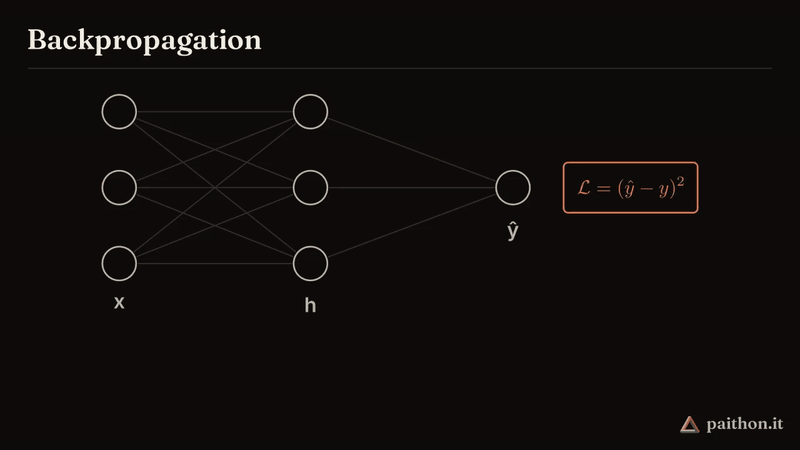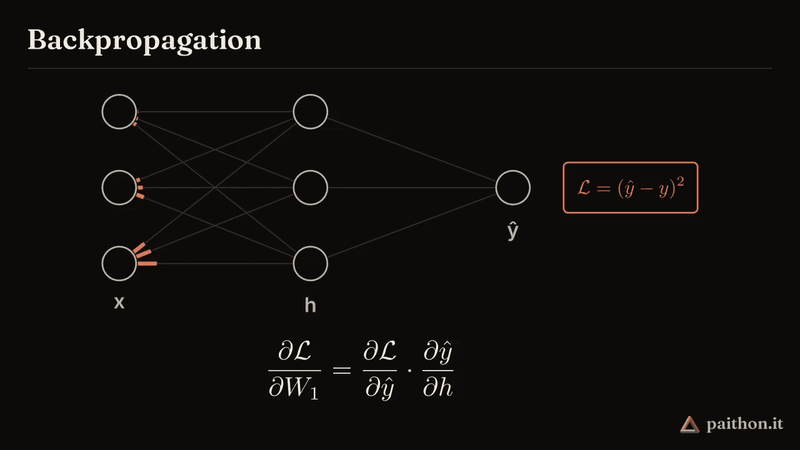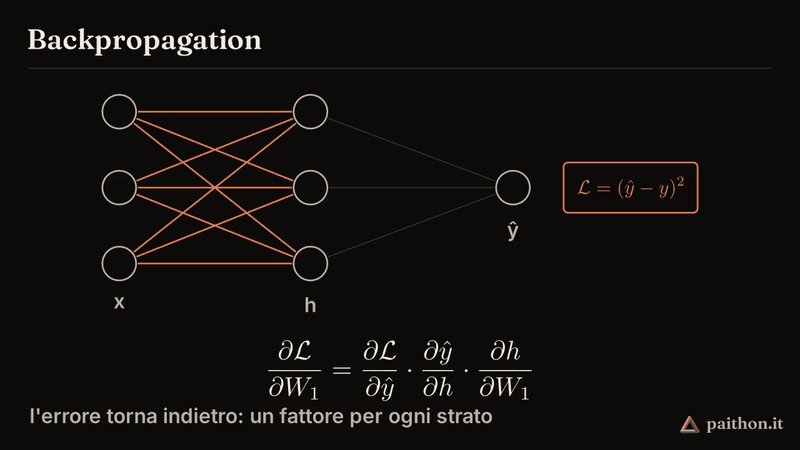
Fig. 6.13 I due movimenti, uno dopo l’altro: il segnale va avanti fino all’errore, poi la colpa torna indietro. Tornando, a ogni strato che attraversa viene moltiplicata per un pezzo in più, come nella sezione sulle attivazioni: sullo schermo è il prodotto che si allunga, e ogni suo fattore è il contributo di uno strato.#
La Fig. 6.13 fa vedere anche perché questo conto è sostenibile: un modello grosso si addestra ripetendo il giro milioni di volte, quindi il tempo che il giro costa decide se addestrarlo è possibile oppure no. Il ritorno costa più o meno quanto un paio di andate; una rete di cento strati costa naturalmente più di una da dieci, ma il rapporto fra ritorno e andata resta quello, perché niente viene ricalcolato da capo: a ogni strato si aggiunge soltanto un fattore a un prodotto che esiste già. È la regola della catena della sezione su analisi e ottimizzazione, applicata a ritroso: il prodotto che si allunga di un fattore a ogni strato.
Aggiornare i pesi: discesa del gradiente e learning rate#
Le derivate parziali della loss rispetto a tutti i parametri, messe in un vettore, formano il gradiente \(\nabla_\theta\mathcal{L}\): la backpropagation lo calcola, la discesa del gradiente lo usa, e sono la prima e la seconda metà dello stesso gesto. La «colpa» di un peso e la sua pendenza sono quindi la stessa cosa, due nomi per una: quanto l’errore sale o scende per ogni passettino che fa quel peso.
Il gradiente indica, per ogni peso, la direzione in cui la loss cresce. Per farla calare basta muoversi nel verso opposto, a piccoli passi, e ogni passo si fa lungo in proporzione alla pendenza che si sente lì: ripido, passo lungo; quasi piatto, passo corto.

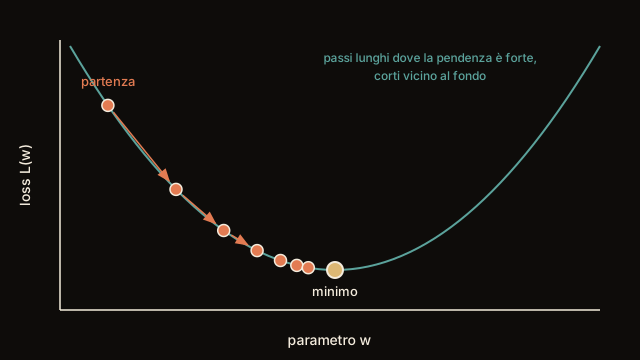
Fig. 6.14 In orizzontale il valore di un peso, in verticale l’errore che ne risulta: muovere il peso vuol dire spostarsi lungo questa valle, e imparare vuol dire scendere. I passi si accorciano da soli, e nessuno li rimpicciolisce: la lunghezza è proporzionale alla pendenza, che vicino al fondo è quasi nulla.#
Torna l’escursionista nella nebbia della sezione su analisi e ottimizzazione: sei su una collina e devi scendere a valle. Non vedi lontano, ma puoi sentire la pendenza sotto i piedi e fare un passo nella direzione più ripida verso il basso. Ripeti, passo dopo passo.
Quanto è lungo il passo lo decidono due cose insieme: la pendenza che senti sotto i piedi, e un moltiplicatore fisso che scegli tu, il learning rate (di solito un numero piccolo, \(0{,}01\) o \(0{,}001\)). La pendenza è quella che accorcia i passi da sola vicino al fondo, come nella Fig. 6.14; il moltiplicatore è la manopola che hai in mano. Con un moltiplicatore troppo grande scavalchi la valle e rimbalzi avanti e indietro senza arrivare mai; con uno troppo piccolo scendi lentissimo, e rischi di fermarti nel primo avvallamento che incontri credendolo il fondo, con i passi ormai troppo corti per uscirne. Trovare un buon moltiplicatore è metà del mestiere.
Quel moltiplicatore non deve restare lo stesso per tutta la discesa, e nemmeno essere identico in ogni direzione. Chi scende può tenere conto dello slancio, allungando la falcata quando gli ultimi passi andavano tutti dalla stessa parte, e può usare un moltiplicatore diverso per ciascuna direzione, corto dove il terreno cambia bruscamente e lungo dove scende regolare. Il gesto sotto resta quello: senti la pendenza, fai un passo, ripeti.
L’aggiornamento è la discesa del gradiente:
dove \(\theta\) sono i parametri, \(\nabla_{\theta}\mathcal{L}\) il gradiente calcolato dalla backpropagation ed \(\eta > 0\) il learning rate (o tasso di apprendimento). Il confine fra troppo e abbastanza lo dà la curvatura: vicino a un minimo, dove la loss è quasi una quadratica con hessiana \(\mathbf{H}\), la discesa converge se \(\eta < 2/\lambda_{\max}(\mathbf{H})\) e diverge lungo la direzione più curva appena \(\eta\) supera quella soglia, che è la stessa del lemma di discesa di Analisi e ottimizzazione. Un \(\eta\) troppo piccolo rende la convergenza lentissima o la blocca in un minimo mediocre. Gli ottimizzatori moderni aggiungono memoria delle direzioni già prese (Momentum, che però conserva un solo \(\eta\) per tutti i parametri), un passo diverso per ciascun parametro (RMSProp), o tutte e due le cose (Adam [KB15]), ma il cuore resta questo.
Che i passi si accorcino da soli, come in Fig. 6.14, è comodo e insieme un problema. Comodo perché l’algoritmo rallenta da sé arrivando a destinazione, senza che nessuno glielo dica. Problema perché rallenta altrettanto sui tratti piatti che non sono il fondo: quelli in cui il terreno si stende in piano pur essendo ancora in quota, e quelli in cui scende da una parte e sale dall’altra, come una sella da cavallo. Sono i plateau e le selle di Analisi e ottimizzazione.
Mini-batch, epoche e SGD#
Calcolare il gradiente su tutti i dati a ogni passo sarebbe accuratissimo ma lentissimo. In pratica l’insieme dei dati si divide in piccoli gruppi, i mini-batch (per esempio 32 o 64 esempi per volta): per ciascuno si fa un’andata, un ritorno e un aggiornamento dei pesi. Un giro completo su tutti i mini-batch è un’epoca, e un addestramento ne conta decine o centinaia.
Ogni mini-batch però è solo un campione dei dati, preso a caso, quindi il gradiente che vi si calcola è una stima: giusta in media, perché la media su tutti i mini-batch possibili è il gradiente vero, ma rumorosa, e rumorosa in modo diverso a ogni passo. Il nome del metodo viene da lì, perché «a caso» in matematica si dice stocastico: discesa del gradiente stocastica (SGD, Stochastic Gradient Descent).
Il risultato è che la discesa non scivola liscia, traballa. E quel traballare, che sembrerebbe un difetto, è utile, anche se non per la ragione che si racconta più spesso. Si sente dire che serva a scavalcare i minimi locali, cioè le conche poco profonde in cui la discesa si può fermare credendo di essere arrivata in fondo; ma nelle reti profonde quelle conche sono rare [DPG+14]. Serve piuttosto a staccarsi dai tratti piatti e dalle selle di poco fa, dove la pendenza vera è quasi zero. Senza rumore dalle selle si esce lo stesso, ma con calma. Un algoritmo perfettamente preciso, con un passo abbastanza piccolo e partito da un punto a caso, esce da ogni sella vera, cioè da una sella dove in almeno una direzione il terreno scende curvando verso il basso [LSJR16]; il numero di passi, però, può crescere esponenzialmente con il numero dei parametri, cioè moltiplicarsi per un fattore fisso a ogni parametro in più [DJL+17]. Un po’ di rumore accorcia di molto quell’attesa: lo si è dimostrato per una discesa a cui si aggiunge apposta una piccola spinta casuale quando la pendenza si fa quasi nulla, che del traballare dei mini-batch è la versione controllata [JGN+17].
Si racconta anche che i mini-batch piccoli portino a fermarsi in valli larghe invece che in fessure strette, e che sia un bene: una soluzione che regge anche spostandola un po’ dovrebbe reggere meglio sui dati nuovi, quelli che la rete non ha mai visto. Il fenomeno è documentato [KMN+17]; la spiegazione, invece, è contestata, benché continui a essere ripetuta come assodata.
L’obiezione è che «larga» e «stretta», misurate così, non dicono niente sul modello. In una rete con la ReLU si possono moltiplicare per dieci i pesi di uno strato, bias compreso, e dividere per dieci soltanto i pesi dello strato dopo, lasciandone il bias dov’era, e la rete calcola la stessa identica funzione: la ReLU lascia passare i fattori positivi (dieci volte l’ingresso dà dieci volte l’uscita), quindi quel dieci attraversa lo strato e si semplifica con la divisione per dieci che trova subito dopo. Il bias del secondo strato resta fermo perché non moltiplica niente: si aggiunge alla fine, e il dieci da correggere lì non ci passa. Stessa funzione, stesse previsioni, ma i pesi adesso sono altri numeri, e attorno a quei numeri la valle può essere stretta quanto si vuole. «Stretta» vuol dire che basta spostare i pesi di pochissimo perché l’errore schizzi in alto, e i pesi del secondo strato li abbiamo appena divisi per dieci: sono dieci volte più piccoli, quindi uno spostamento della stessa misura di prima adesso conta dieci volte di più (un centesimo, su un peso che valeva uno, era l’uno per cento; su un peso che vale un decimo è il dieci per cento). Se una stessa rete può stare in una valle larga o in una stretta a piacere, la larghezza da sola non può spiegare perché una rete se la cavi bene sui dati nuovi [DPBB17]. Il fenomeno si osserva, il perché è ancora aperto.
Non per questo è sbagliata la pista della solidità che la teoria dell’apprendimento segue con la garanzia PAC-Bayes. Quella garanzia non guarda la larghezza da sola: la mette a confronto con la grandezza dei pesi e con la loro distanza da una distribuzione fissata prima di vedere i dati, e il trucco del dieci, che gonfia i pesi di uno strato e stringe la valle dell’altro, lì si paga. A non dire niente è la larghezza contata senza quel confronto.
Reti profonde: attenzione ai gradienti#
Più la rete è profonda, più il gradiente deve viaggiare lontano per raggiungere i primi strati, e lungo il tragitto può degradarsi.

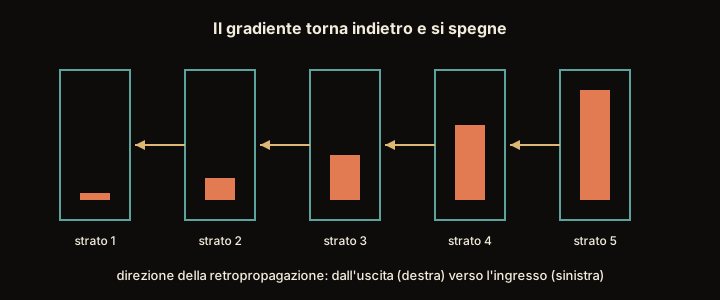
Fig. 6.15 Il gradiente si spegne tornando indietro. Gli strati vicini all’uscita ricevono un segnale forte e imparano; i primi, quelli che dovrebbero imparare le cose più elementari (in una foto: i bordi, le macchie di colore), quasi non lo sentono.#
C’è un dettaglio crudele in Fig. 6.15: la rete non smette di addestrarsi, e la loss continua a calare. A imparare sono gli ultimi strati. Si arrangiano su quello che i primi strati passano loro, che è rimasto quasi com’era all’inizio, cioè quasi a caso. Dal di fuori sembra addestramento; dal di dentro, metà della rete è ferma.
«A caso» è da prendere alla lettera, perché all’inizio i pesi di una rete si estraggono a sorte, piccoli, e non si mettono a zero. Il percettrone, nella sezione che porta il suo nome, poteva permetterselo perché aveva un neurone solo; in uno strato di cento, con tutti i pesi a zero i cento neuroni calcolerebbero lo stesso identico numero, riceverebbero la stessa identica correzione e resterebbero uguali fra loro per sempre, come già diceva il biglietto vincente della sezione su overfitting e validazione. Il caso iniziale serve a rompere quella simmetria. Quanto piccoli, e con quale regola, è una scelta che pesa parecchio, e la tratta la sezione su ottimizzazione e regolarizzazione del capitolo sul deep learning.
È il gioco del «telefono senza fili». Il messaggio (il gradiente) parte dall’uscita e viene sussurrato all’indietro di strato in strato. Se a ogni passaggio si affievolisce, arriva ai primi strati talmente flebile da non insegnare loro nulla: sono i gradienti che svaniscono e la rete non impara. Può succedere anche il contrario, e qui il paragone col telefono senza fili si rompe, perché di sussurri che diventano urla passando di bocca in bocca non se ne sono mai visti: se a ogni strato il messaggio viene moltiplicato per un numero maggiore di uno, dopo cinquanta strati arriva assordante e manda tutto in tilt. Sono i gradienti che esplodono.
Sono i numeri a farlo capire meglio di qualunque parola. Moltiplicare cinquanta volte per \(0{,}9\) lascia cinque millesimi di quello che c’era (\(0{,}9\) elevato a \(50\) fa \(0{,}005\)); moltiplicare cinquanta volte per \(1{,}1\) lo fa diventare centodiciassette volte tanto. In mezzo, fra \(0{,}9\) e \(1{,}1\), c’è tutta la differenza fra una rete che impara e una che non parte.
I due guasti però si somigliano meno di quanto quei due conti lascino credere, e la ragione è che il messaggio porta più di una parola alla volta: ogni passaggio ne tratta ciascuna a modo suo, alzandone qualcuna e abbassandone altre. Se un passaggio le abbassa tutte quante, e così fa quello dopo, e quello dopo ancora, allora in fondo non arriva niente, ed è garantito. Ma un passaggio che ne alza qualcuna non garantisce nulla, perché il passaggio successivo può abbassare proprio quelle e alzare le altre. Mettiamo in fila trenta passaggi che raddoppiano una parola e dividono per dieci l’altra, a turno: ogni parola finisce raddoppiata quindici volte e divisa per dieci altre quindici, e dividere per dieci vince. Di quello che c’era resta poco più di tre centomiliardesimi, cioè un bisbiglio, benché a ogni passaggio qualcosa venisse raddoppiato.
Per essere certi della valanga servirebbe che ogni passaggio alzasse tutte le parole, nessuna esclusa, e nelle reti che usano la ReLU (la piega delle funzioni di attivazione, quella che azzera tutto ciò che arriva negativo) non capita mai: a ogni strato una parte dei neuroni è spenta, e quello che passa di lì viene azzerato invece che alzato. Ne basta uno spento perché la certezza salti. La certezza manca, ma la media si sa prevedere, e nei due versi: se i pesi di partenza sono un po” troppo grandi il messaggio cresce in media a ogni strato, se sono un po” troppo piccoli cala, e scegliendo bene quanto grandi farli partire si evitano tutti e due i guasti all’inizio. Quello che la partenza non può prevedere è il viaggio: durante l’addestramento i pesi cambiano, e il messaggio può impennarsi di colpo. Per quello si misura quanto è forte il messaggio che sta tornando indietro e, se supera una soglia, lo si abbassa prima di passarlo.
Le reti profonde vanno quindi progettate perché il messaggio arrivi integro fino in fondo, e un rimedio lo conosci già: è la ReLU stessa, che dal lato positivo non appiattisce il segnale e quindi non lo indebolisce a ogni passaggio. Gli altri, da dove far partire i pesi e le scorciatoie che saltano gli strati, sono il mestiere del capitolo sul deep learning: delle sezioni su ottimizzazione e regolarizzazione e sulle architetture che hanno fatto la storia.
Il gradiente verso i primi strati è un prodotto di molti fattori: le Jacobiane \(\mathbf{J}^{[l]} = \partial\mathbf{a}^{[l]}/\partial\mathbf{a}^{[l-1]} = \mathrm{diag}\big(g'(\mathbf{z}^{[l]})\big)\,\mathbf{W}^{[l]}\) strato per strato, cioè le derivate dell’uscita di uno strato rispetto al suo ingresso (la ricorsione di \(\boldsymbol{\delta}\) è la stessa cosa letta al contrario, un prodotto per una jacobiana trasposta come nella regola della catena in più variabili), la cui «grandezza» si misura con i valori singolari (e non con gli autovalori, perché sono matrici diverse l’una dall’altra e non c’è nessuna potenza di una matrice sola da diagonalizzare: è l’avvertimento della sezione di algebra lineare, ed è qui che serviva).
Se i valori singolari massimi restano sistematicamente sotto \(1\), il prodotto tende a zero esponenzialmente con la profondità (vanishing gradient), e la garanzia è immediata: la norma di un prodotto non supera il prodotto delle norme, \(\lVert\prod_l \mathbf{J}^{[l]}\rVert \le \prod_l \sigma_{\max}(\mathbf{J}^{[l]}) \le c^{\,L}\), dove \(c<1\) è il maggiorante comune dei valori singolari massimi e \(L\) il numero di strati attraversati.
Nell’altro verso, però, non c’è simmetria, ed è l’errore che si fa a scrivere la frase di getto. Che ogni fattore allunghi qualche direzione non basta a far esplodere niente, perché lo strato successivo può accorciare proprio quella: il prodotto di trenta matrici con \(\sigma_{\max}=2\) ciascuna può avere norma \(3\cdot10^{-11}\) (basta alternare \(\mathrm{diag}(2;\,0{,}1)\) e \(\mathrm{diag}(0{,}1;\,2)\)). A garantire l’esplosione è il valore singolare minimo sopra \(1\), che è una condizione molto più forte: allora \(\lVert\prod_l \mathbf{J}^{[l]}\,\mathbf{v}\rVert \ge \prod_l \sigma_{\min}(\mathbf{J}^{[l]})\, \lVert\mathbf{v}\rVert\) e non c’è scampo.
Solo che quella garanzia, sulle reti fatte con la ReLU, non scatta mai. La Jacobiana di uno strato del genere azzera le righe delle unità spente, e su uno strato che non allarga ne basta una sola perché \(\sigma_{\min}\) valga esattamente zero: in uno strato da \(64\) unità con ingressi casuali le spente sono decine, e il prodotto si ritrova \(\sigma_{\min}=0\) per costruzione. La condizione è sufficiente e non necessaria, e su queste reti è vacua: come garanzia valida per ogni ingresso, per l’esplosione non ne esiste una comoda. In media, però, il conto si fa, e vale nei due versi insieme. In una rete ReLU con pesi indipendenti di varianza \(\kappa\cdot 2/n\) la norma quadratica del gradiente cambia in media di un fattore \(\kappa\) a ogni strato attraversato, quindi all’inizializzazione svanisce per \(\kappa<1\) ed esplode per \(\kappa>1\), come \(\kappa^{L/2}\) in norma: su cinquanta strati, \(1{,}2^{25}\approx 95\). È la condizione \(\tfrac{1}{2}\,n\,\mathrm{Var}[w]=1\) di He [HZRS15], e l’inizializzazione la sceglie proprio per evitare tutti e due i guasti in partenza. Quello che la partenza non controlla è l’addestramento: lungo la traiettoria la loss può presentare pareti ripidissime che nessuna analisi a priori prevede, soprattutto nelle reti ricorrenti [PMB13], e lì l’esplodere si tampona a valle quando accade, con il gradient clipping, che taglia la norma del gradiente sopra una soglia.
L’analisi è quella resa celebre da Hochreiter [Hoc91] e da Bengio [BSF94] sulle reti ricorrenti. I rimedi standard: attivazioni ReLU al posto della sigmoide [GBB11], inizializzazione accorta dei pesi ([GB10], [HZRS15]), batch normalization [IS15], connessioni residue delle ResNet [HZRS16a] e, appunto, il gradient clipping. Sono queste tecniche ad aver reso addestrabili reti da centinaia di strati.
In pratica, con PyTorch#
Nella pratica non scriviamo la backpropagation a mano: la fanno le librerie, con la differenziazione automatica di Linnainmaa e Werbos (in PyTorch si chiama autograd). A noi restano tre dichiarazioni e un ciclo. Le dichiarazioni sono: com’è fatta la rete, con quale loss misurare l’errore, e con quale regola spostare i pesi una volta note le colpe (quella regola si chiama ottimizzatore, e qui è la discesa del gradiente di poco fa). Il ciclo è il respiro dell’andata e del ritorno, ripetuto.
Il problema qui è il riconoscimento delle cifre scritte a mano, il classico esercizio di prima prova: ogni immagine è un quadrato di \(28\times 28\) pixel in scala di grigio, che disteso in fila fa \(784\) numeri in ingresso, e le risposte possibili sono \(10\), le cifre da \(0\) a \(9\). Il \(64\) dello strato in mezzo, invece, non lo detta nessuno: quanti neuroni nascosti mettere è una scelta di chi progetta, e \(64\) è un valore ragionevole per cominciare.
import torch
from torch import nn, optim

model = nn.Sequential(
    nn.Linear(784, 64), nn.ReLU(),   # strato nascosto
    nn.Linear(64, 10),               # uscita: un punteggio per classe
)

criterion = nn.CrossEntropyLoss()                   # la loss
optimizer = optim.SGD(model.parameters(), lr=0.01)  # discesa del gradiente

for epoca in range(20):
    for X_batch, y_batch in train_loader:  # mini-batch di 32 esempi
        y_pred = model(X_batch)            # forward: la previsione
        loss = criterion(y_pred, y_batch)  # quanto abbiamo sbagliato
        optimizer.zero_grad()              # azzera i gradienti vecchi
        loss.backward()                    # backpropagation automatica
        optimizer.step()                   # aggiornamento dei pesi
Le righe dentro il ciclo sono cinque e sono esattamente i movimenti che abbiamo
descritto: i dati avanzano, la loss misura l’errore, loss.backward() fa
tornare indietro il gradiente, optimizer.step() aggiorna i pesi. La quinta,
optimizer.zero_grad(), è una pulizia, e dimenticarla è un errore frequente:
PyTorch somma i gradienti nuovi a quelli che trova, invece di sostituirli,
quindi senza quella riga il mini-batch di adesso si porterebbe addosso anche i
gradienti di quello di prima. Il nn.ReLU() fra i due nn.Linear, invece, è la
piega delle funzioni di attivazione messa dove va messa: fra uno strato e
l’altro. Manca invece la softmax che la stessa sezione mette in fondo a un
classificatore, e non è una dimenticanza: ce l’ha dentro nn.CrossEntropyLoss,
che la applica lei ai punteggi grezzi. Chi la mette anche fuori la applica due
volte, e non se ne accorge nessuno, perché la loss cambia numero e non solleva
niente. E train_loader è il pezzo che serve i dati un mini-batch alla volta:
per ora diamolo per dato, lo costruisce la sezione sul training loop.
Il 20 delle epoche non è un numero magico, ed è anzi la domanda che il codice
lascia aperta: quand’è che si smette? Non quando la loss sui dati di
addestramento smette di calare, perché quella può calare anche mentre il
modello sta imparando a memoria gli esempi che ha visto invece della regola che
li governa. È l’overfitting già incontrato in
Overfitting e validazione, e
si riconosce nello stesso modo: tenendo da parte dei dati che la rete non vede
mai, e fermandosi quando è sui dati tenuti da parte che i risultati smettono
di migliorare.
Da ricordare
Il forward pass è la catena di montaggio: i dati passano di postazione in postazione, ognuna li mescola con le proprie manopole, e all’ultima esce la previsione. La loss dice quanto quella previsione è lontana dalla verità.
La backpropagation riparte dal fondo e chiede a ogni strato quanto ha contribuito all’errore: la risposta di uno serve a calcolare quella dello strato prima, e un solo giro all’indietro basta per tutte le manopole.
La quota di colpa di una manopola è la sua pendenza, cioè di quanto cambierebbe l’errore muovendola di pochissimo. Sono la stessa cosa in due parole diverse, e l’elenco di tutte queste pendenze si chiama gradiente.
Poi ogni manopola si sposta di poco nel verso che fa calare la loss, ed è la discesa del gradiente. Il passo è lungo quanto la pendenza moltiplicata per il learning rate, che è l’unica manopola in mano a noi: decide se si scende a valle, se si rimbalza o se non si arriva mai.
Si procede a piccoli gruppi di esempi (i mini-batch), ripassando più volte su tutti i dati (le epoche). Nelle reti molto profonde il messaggio che torna indietro può affievolirsi fino a non insegnare più niente ai primi strati, oppure amplificarsi fino a diventare assordante e mandare tutto in tilt. In partenza tutte e due si evitano scegliendo bene quanto grandi far nascere i pesi; durante l’addestramento, un’impennata improvvisa si tampona quando arriva. Per questo una rete profonda va progettata apposta per far arrivare il messaggio integro fino in fondo, e un rimedio è già noto: la ReLU, che non appiattisce il segnale.
Da ricordare
Il forward pass trasforma i dati in una previsione, strato per strato; la loss misura di quanto quella previsione sbaglia.
La backpropagation è la regola della catena applicata all’indietro, cioè il modo inverso della differenziazione automatica: con una sola passata dà tutte le derivate, perché l’uscita è una sola e gli ingressi sono milioni. In tempo costa un paio di andate; in memoria costa le attivazioni di tutti gli strati, che crescono con la profondità e con il batch.
I pesi si aggiornano con la discesa del gradiente, \(\theta \leftarrow \theta - \eta\,\nabla_\theta\mathcal{L}\); il learning rate \(\eta\) dosa il passo, la cui lunghezza è \(\eta\,\lVert\nabla_\theta\mathcal{L}\rVert\).
Si lavora a mini-batch ed epoche (SGD), e il rumore del campionamento aiuta a staccarsi da selle e altipiani, non tanto dai minimi locali.
Nelle reti profonde i gradienti possono svanire o esplodere. Come garanzia per ogni ingresso le due cose non sono simmetriche: \(\sigma_{\max} < 1\) su ogni Jacobiana basta a garantire lo svanire, mentre per l’esplodere servirebbe \(\sigma_{\min} > 1\), che con la ReLU non capita mai. In media, all’inizializzazione, le decide tutte e due lo stesso numero, \(\tfrac{1}{2}\,n\,\mathrm{Var}[w]\), e l’inizializzazione di He le evita entrambe; durante l’addestramento aiutano batch norm e connessioni residue, e l’esplosione che arriva lo stesso si tampona a valle, con il gradient clipping.
Adesso sappiamo come si fa, passo per passo, una cosa che a mano non fa quasi più nessuno: seguire il gradiente all’indietro, strato per strato, fino a ogni singolo peso. Continua a servire, perché quando un addestramento non parte uno dei primi posti dove guardare è lì, in un gradiente che si è spento per strada oppure è esploso. Nel capitolo su PyTorch quel giro all’indietro lo farà una libreria al posto nostro, in una riga: noi scriveremo soltanto l’andata, e sapremo riconoscere che cosa sta facendo il ritorno.