


LLMOps: operare i grandi modelli#
Il 30 novembre 2022 OpenAI mette online ChatGPT. Cinque giorni dopo Sam Altman annota su Twitter che ha superato il milione di utenti. Lo stesso giorno, rispondendo a due persone diverse, dice le due cose rimaste celebri: i costi di calcolo sono eye-watering, da far venire le lacrime agli occhi, e siamo nell’ordine di qualche centesimo di dollaro a conversazione. Omette però una premessa: il modello dietro ChatGPT, un GPT-3.5, era già pronto da mesi, addestrato e poi rifinito perché rispondesse come ci si aspetta da un assistente e non come da un completatore di testi. La sfida vera, quella che teneva svegli gli ingegneri, era operarlo invece che costruirlo: servirlo a milioni di persone, in fretta, in modo affidabile, senza che la bolletta della GPU divorasse l’azienda.
È lo stesso salto dal notebook alla produzione raccontato fin qui. Ma quando il «modello» è un grande modello linguistico, in sigla LLM (large language model), da miliardi di parametri, i problemi visti finora si ripresentano amplificati, e con sfumature nuove. Due soprattutto. La prima: il modello, spesso, non lo addestri tu. Lo prendi già fatto (pesi aperti da ospitare, o un’API di terzi da interrogare) e il tuo lavoro è adattarlo e servirlo, non allenarlo da zero. La seconda: l’output non è più una classe o un numero, ma testo aperto, difficile da misurare quanto è difficile giudicare un tema di italiano. Quel territorio ha un nome: LLMOps.
Che cosa cambia con gli LLM#
Cambia l’unità di misura: il token. Da qui in avanti si conta tutto così, tempi e costi. Un token è il frammento di testo (una parola corta, o parte di una parola) che il modello legge e scrive in blocco.
Con un LLM il collo di bottiglia si sposta. Fin qui il problema era caricare i pesi dal disco alla memoria: si fa una volta all’avvio, poi non ci si pensa più. Qui il problema è un altro viaggio, molto più corto ma molto più frequente: portare quei pesi dalla memoria della scheda alle unità che fanno i conti, e questo viaggio va rifatto per intero a ogni singolo token. Il modello scrive la risposta un token alla volta, e ogni token lo decide guardando tutti quelli già scritti (è il modo di generare, autoregressivo, studiato nei grandi modelli linguistici); a ogni passo tutti i miliardi di parametri vengono riletti. Finché le richieste servite insieme sono poche, è questa lettura a decidere il tempo e il costo di ogni token.

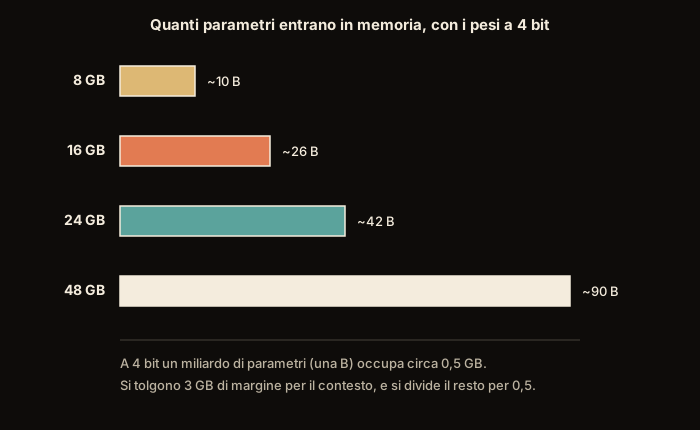
Fig. 36.10 La domanda pratica che precede ogni altra. Non «quale modello è migliore», ma
«quale entra», perché sotto quella soglia nessuna ottimizzazione serve. A
sinistra ci sono i gigabyte di memoria disponibili, a destra i miliardi di
parametri che ci stanno dentro, scritti come si usa nel settore con la B dei
miliardi (70B sono settanta miliardi di parametri: attenzione a non
confonderla con la G dei gigabyte, che sta dall’altra parte).#
I quattro numeri di destra non vanno imparati: escono dalla riga in fondo, che è tutta la figura. Si tolgono tre gigabyte, che servono per tenere in memoria la conversazione in corso, e si divide il resto per mezzo gigabyte a miliardo, che è quanto occupa un miliardo di parametri se ogni peso è scritto con quattro cifre binarie invece delle solite sedici (il perché è più avanti, in «Comprimere per servire»). Da 16 gigabyte, per esempio, restano 13, e tredici diviso mezzo fa 26.
Il vincolo di Fig. 36.10 ha la precedenza su tutte le tecniche di ottimizzazione, e ne fissa l’ordine. Si stabilisce prima cosa entra nella memoria disponibile, poi si discute di quanto vada veloce: un modello che non ci sta non è lento, semplicemente non parte.
Fin qui servire un modello era come guidare un’automobile: la accendi, parte, sterzi dove vuoi, la fermi. Un LLM è un transatlantico. Ha una massa enorme (miliardi di «manopole» che devono stare tutte in memoria) e ogni manovra richiede tempo e spazio: non lo parcheggi in garage, non lo giri in una stradina. Servirlo non è più una questione di accenderlo, ma di manovrarlo: dove lo ormeggi (quanta memoria serve per ospitarlo), quanti passeggeri imbarchi in una volta sola per far quadrare i conti, come eviti che resti fermo al largo a bruciare carburante mentre aspetta. E c’è un dettaglio contro l’intuizione: a scandire il ritmo, più che il pensare, è il ricordare. A ogni nuova parola il modello deve rileggere l’intero carico dei suoi numeri, e finché a bordo ci sono pochi passeggeri è quella rilettura, più del calcolo, a decidere quanto si va veloci. Quando la nave è piena, il calcolo torna a pesare: ogni passeggero in più chiede i suoi conti, mentre la rilettura resta una sola per tutti.
Nella fase di decodifica, quando le sequenze in volo sono poche, la generazione autoregressiva rende l’inferenza di un LLM memory-bound: per produrre un solo token il modello deve leggere tutti i suoi pesi dalla memoria della GPU, e l’aritmetica che ci fa sopra non basta a tenere occupate le unità di calcolo. In una mixture of experts ne legge i soli parametri attivi, e con poche sequenze in volo il risparmio è reale: i totali dicono se il modello ci sta, gli attivi quanto costa un token. Appena il mazzo di richieste si riempie, però, token diversi chiamano esperti diversi e la lettura torna quasi completa. L’aritmetica per token è modesta, il traffico di memoria è enorme. Un conto d’ordine di grandezza lo rende concreto: un modello da 7 miliardi di parametri in 16 bit pesa circa 14 GB, e una GPU con banda di memoria attorno a 2 TB/s impiega \(14/2000 \approx 0{,}007\) s, cioè circa 7 ms, solo per far scorrere quei pesi. Una singola sequenza è così limitata a circa \(1/0{,}007 \approx 140\) token al secondo, mentre le unità di calcolo restano quasi inattive.
La condizione si scrive in una riga. Con \(N\) parametri che occupano \(M_w\) byte, banda \(B\) e potenza di calcolo di picco \(F\), un passo di decodifica su \(b\) sequenze legge i pesi in un tempo \(M_w/B\) e fa circa \(2Nb\) operazioni in un tempo \(2Nb/F\): i due si equivalgono per \(b^\ast = F M_w/(2NB)\), che in 16 bit, dove \(M_w = 2N\), vale \(F/B\), circa 150 sequenze per una scheda da 312 TFLOP/s e 2 TB/s di banda e circa 300 per una da 989 TFLOP/s e 3,35 TB/s. Sotto \(b^\ast\) la lettura domina e aggiungere sequenze costa quasi niente; sopra, il limite diventa il calcolo. Il prefill, che elabora tutti i token del prompt in parallelo, ha già molti token per ogni lettura dei pesi, ed è limitato dal calcolo fin dall’inizio.
A questo si somma la KV cache vista nel capitolo sui Transformer (key e value dei token già letti, tenuti in memoria per non ricalcolarli), che a differenza dei pesi è di ciascuna sequenza e non si ammortizza sul batch. Per token tiene \(2\,n_\ell\,h_{kv}\,d_k\) numeri, con \(n_\ell\) strati, \(h_{kv}\) teste di chiave e valore e \(d_k\) la loro dimensione, due byte ciascuno in 16 bit (il conto di L’attenzione in pratica): per un modello da 70 miliardi con 80 strati, 8 teste di chiave e valore da 128 e 16 bit sono \(327\,680\) byte per token, cioè circa 1,3 GB a \(4\,000\) token di contesto e 42 GB a \(128\,000\), per una sequenza sola. Due grandezze, quindi, governano tutto: la memoria (contiene pesi e cache) e la sua banda (limita quanti token al secondo si producono). Buona parte dell’ingegneria di LLMOps è lotta contro questi due limiti.
Servire un LLM#
Il problema centrale è la lettura dei pesi, che a ogni token costa più del calcolo aritmetico. Da lì viene anche la conseguenza che salva i conti: la lettura è la stessa qualunque cosa il modello stia scrivendo. Farla per servire una persona sola, o per servirne cento nello stesso istante, costa quasi uguale, finché le richieste in volo restano sotto la soglia in cui il calcolo prende il sopravvento: i pesi passano una volta e si usano per tutte e cento le risposte in corso. Vale per i pesi e non per la KV cache, che ogni risposta si porta dietro e si rilegge per conto suo. È lo stesso mazzo di richieste, il batch, che la sezione sul servire un modello usava per tenere occupata la scheda; qui quel mazzo è il motivo per cui un LLM è economicamente sostenibile, più che un’ottimizzazione fra le altre.
Solo che formare il mazzo, qui, è molto più difficile, e per due ragioni.
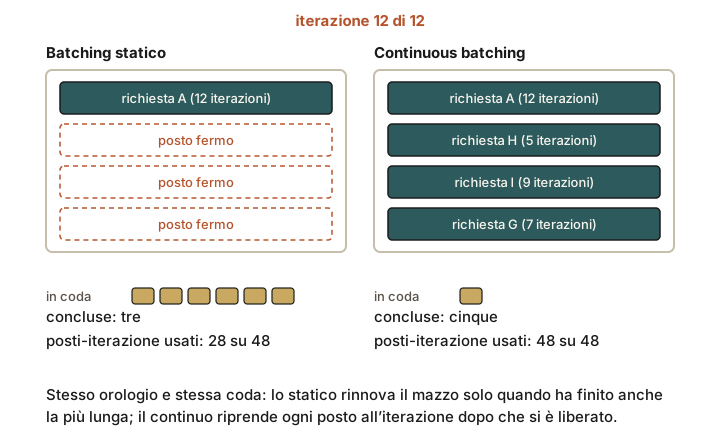
Fig. 36.11 Quattro posti sulla stessa GPU e una coda di dieci richieste, sullo stesso orologio, che batte un’iterazione a ogni giro in cui ogni posto occupato scrive un token. Il batching statico non rinnova il mazzo finché la risposta più lunga non ha finito, e alla dodicesima iterazione ha tre richieste concluse, tre posti fermi e la coda intatta. Il continuous batching, il mazzo continuo, riprende ogni posto all’iterazione dopo che si è liberato: alla stessa iterazione ne ha concluse cinque, i quattro posti pieni e la coda quasi finita. In dodici iterazioni quattro posti offrono 48 turni di lavoro: il primo ne usa 28, il secondo tutti e 48, senza contare quel che costa far entrare una richiesta nel mazzo.#
Una è quella che Fig. 36.11 mette in evidenza: le risposte non durano tutte uguale, e non si sa in anticipo quanto dureranno. Se si forma il mazzo e lo si tiene insieme fino alla fine (è il batching statico), chi ha finito presto lascia il suo posto vuoto e nessuno lo occupa finché non ha finito anche il più lento. In un mazzo grande basta una risposta lunga per tenere fermi tutti gli altri.
L’altra riguarda la memoria. Mentre scrive, il modello tiene degli appunti su ciò che ha già letto, per non doverlo rileggere da capo a ogni parola nuova: sono la KV cache già incontrata nel capitolo sui Transformer. Ogni risposta in corso porta con sé i propri appunti, e quegli appunti crescono a ogni token senza che si sappia fin dove. Chi gestisce la memoria si trova quindi davanti a una scelta scomoda: o riserva a ciascuno lo spazio del caso peggiore, e allora in memoria ci stanno pochissime conversazioni, o rischia di restare senza spazio a metà di una risposta.
Una sala sola, cinquanta coperti, la fila alla porta. Il modo ingenuo di gestirla fa due errori. Il primo: a ogni comitiva si riserva in anticipo un tavolone lungo, nel caso arrivino altri amici, e due sedie su tre restano vuote «per sicurezza» mentre la gente in fila se ne va. Il secondo: prima di far accomodare qualcuno si aspetta che un tavolo si liberi del tutto, e intanto le sedie già libere non le usa nessuno.
Un buon maître fa il contrario, e le sue due mosse portano i nomi con cui si parla di questa faccenda dappertutto.
Tavoloni non ne riserva. Sistema gli ospiti su gruppetti di sedie sparsi dove c’è posto, tutti della stessa misura, e tiene un foglietto con scritto chi siede dove; le sedie vuote scendono a meno di una su venticinque. È la PagedAttention: gli appunti di ogni conversazione non stanno più in un blocco unico prenotato in anticipo, ma in tanti pezzetti sparsi, e un indice dice quali pezzetti sono di chi.
E appena una sedia si libera ci fa accomodare la prossima persona in fila, senza aspettare che se ne vada l’intera comitiva, ed è il continuous batching, il mazzo continuo.
E c’è una ragione per cui conviene riempirla, quella sala: il cameriere fa un giro solo, e con quel giro serve tutti i tavoli pronti, dieci o cinquanta che siano, perché il tempo se ne va nel giro e non nei piatti che porta. Più coperti vogliono dire più clienti serviti nella stessa serata, ed è ciò che permette a un LLM di rispondere a migliaia di persone con lo stesso hardware. Un prezzo però c’è, e lo paga chi è già seduto, perché con la sala piena anche il giro si allunga un po’ e il piatto arriva più tardi. Dove mettere l’ago dipende dal locale, visto che una mensa vuole coperti e un ristorante vuole il piatto puntuale.
La gestione ingenua della KV cache riserva un blocco di memoria contiguo grande quanto il contesto massimo possibile, anche se la sequenza resterà corta. Ne nascono due sprechi, frammentazione interna (lo spazio riservato e mai usato) ed esterna (i buchi fra blocchi di taglia diversa), che negli approcci precedenti bruciavano tra il 60% e l’80% della memoria della cache. La soluzione di vLLM, la PagedAttention [KLZ+23], prende in prestito un’idea vecchia di sessant’anni dai sistemi operativi: la paginazione della memoria virtuale. La cache di ogni sequenza è spezzata in blocchi di taglia fissa, sistemati in modo non contiguo dove c’è spazio, con una block table che mappa posizioni logiche a fisiche. Lo spreco scende sotto il 4%, e i blocchi possono perfino essere condivisi tra sequenze (un prompt comune, o le ipotesi di una beam search) senza duplicarli.
L’altra metà è il continuous batching (o in-flight batching), proposto da Orca con il nome di iteration-level scheduling [YJK+22]: invece di attendere che tutte le sequenze di un batch finiscano (costringendo le più brevi ad aspettare la più lunga) lo scheduler lavora a livello di singola iterazione, e appena una sequenza emette il suo token di fine, un’altra richiesta ne prende il posto nel batch. Finché c’è una coda, la sala resta piena. vLLM usa tutti e due, e con la PagedAttention il batch può crescere a parità di memoria: nella misura degli autori serve da due a quattro volte più richieste a parità di latenza, contro FasterTransformer e contro Orca, cioè contro un sistema che il continuous batching lo aveva già. Quel guadagno è quindi soprattutto della gestione della memoria. Resta il compromesso di fondo, già incontrato nella sezione sul servire un modello: batch più grandi alzano il throughput ma allungano la coda della latenza; il punto di equilibrio dipende dal prodotto.
Resta il caso in cui il modello, alla precisione a cui lo si vuole servire, non entra in una scheda sola: settanta miliardi di parametri a sedici bit sono 140 gigabyte, più degli 80 di molte schede da centro dati (a quattro bit ci starebbero, con il prezzo in qualità di «Comprimere per servire»). Allora lo si spezza su più schede, con gli stessi tagli che la sezione sul parallelismo distribuito ha visto per l’addestramento. Quando il modello risponde, però, conviene tagliare in un altro modo, perché la grandezza da proteggere è il tempo di ogni token e non la durata di un passo di addestramento.
Due contabili che si dividono il registro per il lungo, come nella sezione sul parallelismo distribuito, finiscono ogni pagina in metà tempo, perché ciascuno scorre metà delle colonne. Per chi aspetta una parola alla volta è proprio quello che serve: il tempo di ogni parola se ne va a rileggere il registro, e rileggerne metà a testa lo dimezza. Il prezzo è la sosta a ogni pagina per mettere insieme i conti, brevissima (un foglietto con pochi numeri), e le pagine sono due per strato: un modello da settanta miliardi di numeri ha ottanta strati, quindi le soste sono centosessanta per ogni parola. Fra due contabili seduti allo stesso tavolo non si sentono; fra due edifici diventano la spesa principale.
La catena di montaggio fa un altro mestiere. Mettere metà degli strati su una scheda e metà sull’altra non fa arrivare prima nessuna parola, che deve comunque passare per tutte le postazioni, una dopo l’altra, con il viaggio fra l’una e l’altra in più. E c’è un vincolo che nell’addestramento non c’era: la parola successiva di una risposta non entra in catena prima che la precedente ne sia uscita, perché dipende da lei. Una risposta sola occupa una postazione alla volta, e le altre stanno ferme. La catena lavora piena solo se ci sono in viaggio tante risposte diverse, una per postazione: aumenta le risposte servite, non la velocità di ciascuna. In compenso ci si ferma a passare il lavoro solo al cambio di postazione, e non a ogni pagina come i contabili: le postazioni possono stare in capannoni diversi.
Da qui la disposizione che si trova quasi sempre. Una macchina contiene di solito otto schede, unite da una linea velocissima, e dentro la macchina si divide il registro. Quando il modello non entra nemmeno in tutte le schede di una macchina, fra le macchine, collegate dalla rete, si divide la catena.
I modelli fatti di tanti esperti hanno un problema loro. Ogni parola chiede pochi esperti, e con poche richieste in corso ogni esperto riceve una parola ogni tanto: una rilettura intera per pochissimo lavoro. Se ogni gruppo di schede tenesse tutti gli esperti, ciascun esperto vedrebbe soltanto le parole delle richieste di quel gruppo. Conviene il contrario: un esperto per scheda, su moltissime schede, e a ciascuna vengono mandate le parole che scelgono il suo esperto da tutte le richieste di tutto il gruppo, così che il mazzo di ogni esperto sia abbastanza grande da valere la rilettura. Gli esperti più richiesti si copiano su più schede, perché nessuna resti indietro mentre le altre aspettano.
Nel decode il tempo di un passo è dominato dalla lettura dei pesi, \(t \approx M_w/B\), con \(M_w\) i byte dei pesi e \(B\) la banda della memoria. Con un parallelismo tensoriale di grado \(g_{\text{tp}}\) (il taglio di Megatron [SPP+19]) ogni scheda legge \(M_w/g_{\text{tp}}\), e
dove \(n_\ell\) è il numero di strati, \(t_{\text{ar}}(n)\) il tempo di un all-reduce su un messaggio di \(n\) numeri, e i due all-reduce per strato agiscono sulle attivazioni di \(b\) sequenze per un token ciascuna, cioè \(b\,d_{\text{model}}\) numeri. Nel decode quel messaggio è minuscolo (16 KB a \(b = 1\) e \(d_{\text{model}} = 8192\) in 16 bit), quindi l’all-reduce paga la latenza di avvio e non la banda: una manciata di microsecondi su NVLink, molto di più attraverso la rete fra nodi. Per un modello da \(70 \cdot 10^9\) parametri, \(M_w = 140\) GB, su \(g_{\text{tp}} = 8\) schede da 3 TB/s la lettura scende a \(140/24\,000 \approx 5{,}8\) ms per passo, e i 160 all-reduce degli 80 strati aggiungono da uno a tre millisecondi, secondo quanto costa un all-reduce breve (da una manciata a una ventina di microsecondi). La formula tace un terzo termine, il lancio: con kernel otto volte più piccoli, gli ottocento lanci circa di un passo, a qualche microsecondo ciascuno, valgono fra un terzo e due terzi della lettura, e senza i CUDA Graphs di Kernel e CUDA si mangiano buona parte del guadagno. Con i lanci coperti, dentro il nodo il parallelismo tensoriale abbassa il tempo per token in uscita (il TPOT, time per output token, cioè il tempo medio fra due token successivi della stessa risposta) di un fattore vicino a \(g_{\text{tp}}\), anche se non proporzionale.
Il parallelismo a pipeline su \(g_{\text{pp}}\) stadi [HCB+19] non accorcia la latenza di un token, che attraversa gli stadi in sequenza: \(t_{\text{PP}} \approx g_{\text{pp}} \cdot M_w/(g_{\text{pp}}B) + (g_{\text{pp}}-1)\,t_{\text{salto}} = M_w/B + (g_{\text{pp}}-1)\,t_{\text{salto}}\), con \(t_{\text{salto}}\) il passaggio delle attivazioni da uno stadio al successivo. Il decode di una sequenza, inoltre, è strettamente sequenziale, perché il token in posizione \(i+1\) non entra nel primo stadio prima che quello in posizione \(i\) sia uscito dall’ultimo: una sequenza sola tiene occupato uno stadio su \(g_{\text{pp}}\), la bolla \((g_{\text{pp}}-1)/g_{\text{pp}}\) dello schema di GPipe con un solo micro-batch. La pipeline si riempie con \(g_{\text{pp}}\) micro-batch di sequenze diverse in volo, e allora moltiplica il throughput, non la velocità di ciascuna richiesta. Ha però il traffico più leggero, \(b\,d_{\text{model}}\) numeri per passo a ogni confine fra stadi invece che due volte per strato, ed è il taglio che si usa fra nodi, su InfiniBand, quando il modello non entra nella memoria di un nodo solo. La disposizione tipica di un modello servito su più nodi è quindi parallelismo tensoriale dentro ogni nodo e pipeline fra i nodi.
Per una mixture of experts il taglio naturale è il parallelismo sugli esperti, con due all-to-all per strato MoE, lo smistamento dei token verso gli esperti e il ritorno delle uscite. In inferenza lo si spinge per aumentare i token per esperto. Nel deployment di DeepSeek-V3 [DeepSeekAI24b] l’unità minima per il decode è di 40 nodi e 320 schede: l’attenzione usa un parallelismo tensoriale di grado 4 con un parallelismo dati di grado 80, la parte MoE un parallelismo sugli esperti di grado 320, con un esperto per scheda e 64 schede per l’esperto condiviso e per copie ridondanti degli esperti più carichi, scelte periodicamente dalle statistiche del traffico; al prefill, che ha già mazzi grandi, bastano 32 schede. Il principio è quello del batching: la lettura di un esperto si ammortizza sui token che lo scelgono, e per averne abbastanza bisogna raccoglierli da molte richieste.
Speculative decoding: far indovinare a un modello piccolo#
C’è una seconda strada per accelerare la generazione, e vive dove il batching non arriva: quando le richieste sono poche e quello che conta è vedere la risposta subito. Ha anche una proprietà rara: il testo che esce resta testo del modello grande.

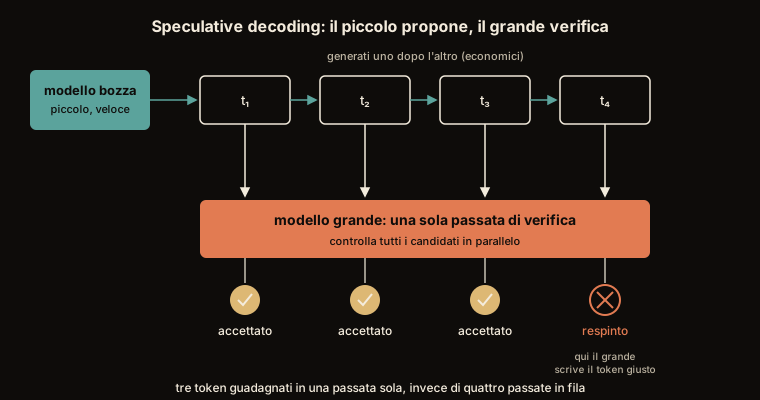
Fig. 36.12 Il modello piccolo tira a indovinare, che gli costa poco; il grande verifica tutte le sue proposte in un colpo solo, che gli costa quanto scriverne una. Se il piccolo azzecca quasi tutto, quella singola verifica consegna quattro token (i tre accettati più quello che il grande scrive di suo) al prezzo di uno: sono tre giri risparmiati. E se il piccolo sbaglia, la correzione del grande è comunque quella giusta.#
La proprietà rara, che il testo resti quello del modello grande, si legge nella metà inferiore di Fig. 36.12: il modello grande non si fida mai del piccolo, lo controlla, e il controllo mette a confronto le due probabilità. Se il grande dava a quella parola almeno la fiducia che le dava il piccolo, la prende senz’altro; se gliene dava meno, la prende tanto più di rado quanto più i due erano in disaccordo, e quando la scarta scrive lui. Il conto è costruito perché quello che esce sia sorteggiato come lo avrebbe sorteggiato il grande da solo: se davanti a una frase quel modello sceglie sempre la stessa parola, esce parola per parola il suo testo; se sorteggia fra più continuazioni, escono le stesse continuazioni con le stesse probabilità. Cambia il tempo, non il testo.
Fig. 36.13 fa il conto su sei parole.
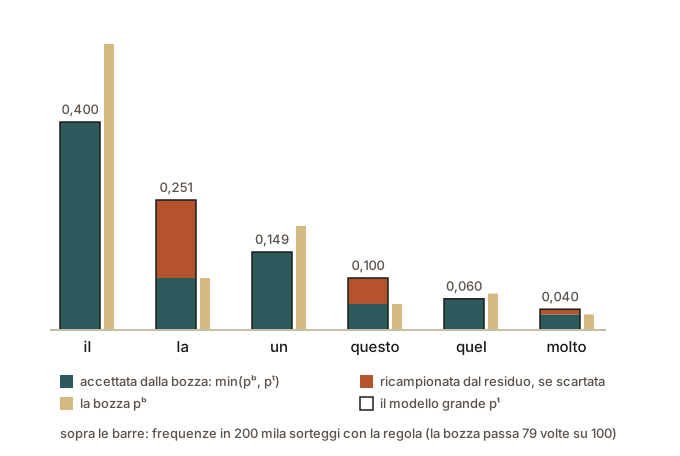
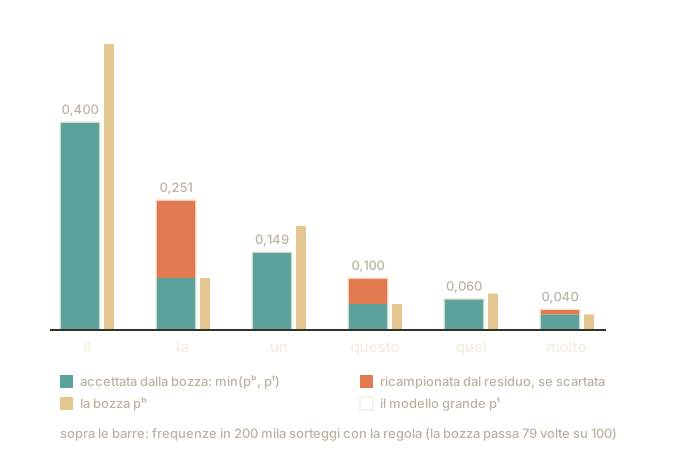
Fig. 36.13 La regola di accettazione, parola per parola. Della proposta della bozza resta la parte che il modello grande condivide; quando la proposta è scartata si sorteggia fra le parole a cui il grande dava più fiducia della bozza (il residuo), e il residuo riempie esattamente quello che mancava: ogni barra finisce alta quanto la probabilità del modello grande, e le frequenze di un sorteggio vero lo confermano.#
Un revisore esperto non manda in stampa una riga senza aver ricontrollato il manuale di stile, settecento pagine che si rilegge da capo ogni volta. Controllare una riga o quattro gli costa quasi uguale, perché il grosso del tempo se ne va nel manuale. Vale lo stesso per il modello, che per scrivere una parola rilegge tutti i suoi numeri e con la stessa passata potrebbe controllarne quattro.
Accanto al revisore siede uno stagista veloce, che il manuale non lo apre. Butta giù quattro righe in avanti tirando a indovinare, e ci prende spesso, perché scrivere non è difficile dappertutto: dopo «la capitale della Francia è» viene «Parigi», e a sbagliare si fa fatica. Sui pochi punti che contano (un numero, una svolta del discorso) invece sbaglia. Lo stagista è un secondo modello, piccolo e rapido, il modello bozza; il revisore è quello grande.
Il revisore legge le quattro proposte in un colpo, con una rilettura sola del manuale. Quelle su cui è convinto almeno quanto lo era lo stagista passano subito; quelle su cui è convinto meno di lui passano solo ogni tanto, tanto più di rado quanto più i due la pensavano diversamente, e alla prima bocciata butta il resto e riscrive la riga di suo pugno. Senza il suo assenso non passa niente.
Se lo stagista ne azzecca tre su quattro, escono quattro righe nel tempo di una. Se sbaglia quasi sempre si va più piano che senza di lui, perché il revisore riscrive tutto e per giunta ha aspettato le bozze. E se ha già la scrivania piena di lavoro suo non stava aspettando nessuno: le proposte dello stagista non gli fanno guadagnare niente.
Il metodo è dovuto a Leviathan, Kalman e Matias di Google Research [LKM23] e, indipendentemente, a Chen e colleghi di DeepMind [CBI+23]. Il passo è:
il modello bozza \(p_{\text{b}}\) genera \(\gamma\) token in autoregressione;
il modello target \(p_{\text{t}}\) valuta le \(\gamma+1\) posizioni in parallelo, in una sola passata: il costo è quello di un forward, non di \(\gamma\);
ogni token proposto \(x_i\) è accettato con probabilità \(\min\!\bigl(1,\ p_{\text{t}}(x_i)/p_{\text{b}}(x_i)\bigr)\); al primo rifiuto si campiona un token correttivo dalla distribuzione residua normalizzata \(\bigl[p_{\text{t}}(x)-p_{\text{b}}(x)\bigr]_+\) e si scarta la coda; se tutti i \(\gamma\) token sono accettati, dalla distribuzione del target già calcolata nella posizione \(\gamma+1\) si campiona un token in più, gratis.
Questa regola di accettazione-rifiuto è ciò che rende il metodo esatto, e la verifica sta in una riga. Sia \(\beta = \sum_x \min\bigl(p_{\text{b}}(x), p_{\text{t}}(x)\bigr)\) la probabilità di accettare; allora \(\sum_x [p_{\text{t}}(x)-p_{\text{b}}(x)]_+ = 1-\beta\) e
La distribuzione dei token emessi è quindi identica a quella del solo modello target, qualunque sia il modello bozza: un modello bozza peggiore abbassa \(\beta\) e con esso la velocità, mai la qualità. L’uscita è la stessa, solo più in fretta, senza nessuno scambio fra qualità e velocità.
Il guadagno dipende dal tasso di accettazione \(\alpha\), la media di \(\beta\) sulle posizioni: sotto l’ipotesi semplificatrice (dichiarata dagli autori) che le accettazioni siano indipendenti con tasso costante \(\alpha\), il numero atteso di token per passata è
che per \(\alpha=0{,}8\) e \(\gamma=4\) dà circa \(3{,}4\) token contro \(1\). Il tempo, però, dipende anche da quanto costa la bozza. Detto \(c\) il rapporto fra il tempo di una passata della bozza e quello di una del target, e supponendo che le \(\gamma+1\) valutazioni parallele del target costino quanto una, il fattore di accelerazione atteso è
che con gli stessi \(\alpha\) e \(\gamma\) vale circa \(2{,}8\) per \(c = 0{,}05\) e \(1{,}5\) per \(c = 0{,}3\) [LKM23]. In pratica si osservano accelerazioni di 2–3 volte. Il modello bozza dev’essere quindi molto più economico del target e allineato nella distribuzione, altrimenti \(\alpha\) crolla e il costo delle bozze rifiutate mangia il guadagno.
Le varianti che evitano un secondo modello completo (in letteratura self-drafting, da non confondere con il self-speculative decoding, che è un metodo preciso e fa la bozza saltando strati del modello stesso) vanno distinte proprio sulla proprietà appena rivendicata. Alcune cambiano solo chi propone e tengono la verifica standard, quindi restano esatte: il prompt lookup, che pesca le proposte dal testo già presente nel contesto, ed EAGLE, che fa proporre le bozze a una testina leggera addestrata sulle rappresentazioni interne del modello grande. Medusa, nella configurazione che propone e misura, no: al posto del campionamento per rifiuto adotta la typical acceptance, un criterio a soglia scelto apposta per accettare più token al prezzo di allontanarsi dalla distribuzione del modello target. Il campionamento per rifiuto resta disponibile anche lì, ma senza il guadagno in più. È un compromesso legittimo, e va saputo: chi lo adotta credendo di stare ancora nel metodo esatto sta scambiando qualità per velocità senza essersene accorto.
Un avvertimento pratico: il metodo aiuta nel regime memory-bound, cioè batch piccoli e bassa latenza. A batch molto grandi la GPU è già satura di lavoro utile e il vantaggio si assottiglia: si combina male, non bene, con la spinta al throughput del batching visto poco sopra.
Il modello bozza, però, è un secondo modello da scegliere, tenere in memoria e mantenere: deve spezzare il testo negli stessi token del grande, e ogni volta che il grande cambia va riaddestrato o cercato di nuovo. Due varianti molto usate lo sostituiscono con qualcosa di molto più piccolo, appoggiato al modello grande, che ne usa gli stati interni e il vocabolario: anche questo si addestra una volta per ogni modello, ma costa una frazione di un modello bozza, e cambia soprattutto il modo di fare la bozza.
Lo stagista ha un costo che non si vede finché non lo si assume: va scelto e pagato a parte, deve usare le stesse abbreviazioni del revisore, e se arriva un revisore nuovo va cercato o istruito da capo, perché il suo mestiere è tirare a indovinare come lui. Ci sono due modi di rendere la bozza meno cara.
Il primo fa a meno dello stagista: il revisore stesso, mentre scrive una riga, annota a margine come secondo lui continueranno le tre dopo, tirando a indovinare dall’idea che ha in testa in quel momento, senza riaprire il manuale. (Per il modello, «l’idea che ha in testa» è l’ultima fila di numeri che calcola dentro di sé, un attimo prima di scegliere la parola.) Per ogni riga a margine segna due o tre possibilità, e alla verifica le prova tutte insieme, come i rami di un albero: la prima riga ha due versioni, ciascuna può proseguire con tre seconde righe, e la rilettura unica sceglie il ramo più lungo che regge, confrontando quanto il revisore è convinto adesso con quanto lo era scrivendo a margine. Il limite è la distanza. La terza riga a margine è scritta senza sapere che cosa diranno la prima e la seconda, e più la riga è lontana più l’indovinello è cieco. È il metodo chiamato Medusa.
Il secondo tiene uno stagista, ma gli cambia il materiale. Invece di indovinare le parole, legge l’idea che il revisore aveva in testa per la riga appena finita, prima ancora delle parole, e da quella ricava l’idea della riga dopo, poi di quella dopo ancora. Le idee si indovinano meglio delle parole, perché cambiano poco da una riga all’altra mentre le parole saltano (due frasi con parole diverse possono dire la stessa cosa). Da sola, però, l’idea lascia un dubbio: «il treno è arrivato» può proseguire con «in ritardo» o con «alle nove», e quale delle due strade sia stata presa lo dice solo la parola che il revisore ha davvero scritto. Per questo allo stagista si passa anche quella. È uno stagista che costa poco e impara in fretta, perché non deve leggere il testo da capo: parte da un’idea che il revisore ha già. È il metodo chiamato EAGLE.
In tutti e due i casi la verifica resta del revisore, e se la verifica è quella di sempre il testo che esce è il suo, solo più in fretta. Medusa, però, nella versione che i suoi autori hanno misurato, chiude un occhio sulla verifica in cambio di qualche riga in più; e in una delle sue due versioni rimette a studiare anche il revisore, che da quel momento scrive in modo un po’ diverso.
Medusa [CLG+24] aggiunge al modello target \(K\) teste di decodifica sull’ultimo stato nascosto \(\mathbf{h}_i\), quello da cui la testa originale ricava il token in posizione \(i+1\). La testa \(k\) predice il token in posizione \(i+k+1\) con uno strato solo e una connessione residua,
dove \(\mathbf{W}_1^{(k)} \in \mathbb{R}^{d_{\text{model}}\times d_{\text{model}}}\), \(\mathbf{W}_2^{(k)} \in \mathbb{R}^{V\times d_{\text{model}}}\) e \(V\) è il vocabolario; \(\mathbf{W}_2^{(k)}\) parte dalla testa originale e \(\mathbf{W}_1^{(k)}\) da zero, così che all’inizio ogni testa ripeta la predizione del modello. I candidati nascono dai primi \(s_k\) token di ciascuna testa, combinati in un albero (il prodotto cartesiano nella forma più semplice, un albero sfoltito di qualche decina di nodi nelle configurazioni misurate), e si verificano in una sola passata con una tree attention: una maschera per cui ogni candidato vede soltanto i propri antenati, con gli indici di posizione riallineati sul ramo. Medusa-1 addestra le sole teste su un modello congelato, con il costo \(\ell_k = -\log p^{(k)}_i(y_{i+k+1})\) sul token vero \(y_{i+k+1}\), e lascia intatto il modello: con la verifica per rifiuto il testo resta esattamente il suo. Medusa-2 addestra le teste insieme al modello, con una ricetta apposta per non degradarlo, e ne cambia quindi i pesi: il testo che esce è quello di un modello diverso, qualunque sia la verifica. Gli autori riportano accelerazioni di circa 2,2× per la prima e fra 2,3× e 2,8× per la seconda, fino a 3,6× su una categoria di prompt. Il limite è strutturale: la testa \(k\) vede solo \(\mathbf{h}_i\) e non i token \(i+1, \dots, i+k\), e gli autori osservano che \(\ell_k\) cresce con \(k\).
EAGLE [LWZZ24] fa l’autoregressione sulle rappresentazioni. Parte dallo stesso stato \(\mathbf{h}_j\) di Medusa, quello da cui la testa del modello ricava \(p_{j+1} = \mathrm{LMHead}(\mathbf{h}_j)\) (gli autori lo chiamano la rappresentazione del penultimo strato, contando come ultimo la testa). La bozza riusa lo strato di embedding e la testa del target, e fra i due mette un solo strato di decoder, con uno strato lineare che ne riduce l’ingresso (sotto il miliardo di parametri per un target da 70 miliardi); da \(\mathbf{h}_{1:j}\) e dai token \(x_{2:j+1}\), cioè la sequenza avanzata di un passo, predice \(\hat{\mathbf{h}}_{j+1}\), la testa ne ricava la distribuzione del token successivo, il token campionato rientra nella bozza, e si prosegue. L’argomento degli autori è doppio: l’autoregressione sulle rappresentazioni è più facile di quella sui token, ma porta un’incertezza sua, perché la stessa \(\mathbf{h}_j\) è compatibile con token campionati diversi, e ciascuno cambia \(\mathbf{h}_{j+1}\); dare in ingresso il token effettivo la risolve. La bozza è ad albero, e la verifica è il campionamento speculativo esteso agli alberi, che resta esatto: la distribuzione del target è conservata. Su LLaMA2-Chat 70B gli autori misurano un’accelerazione della latenza fra 2,7× e 3,5×.
Comprimere per servire#
Se il vincolo è la memoria (quanta ce n’è, e quanto in fretta la si legge), la leva più diretta è far pesare meno i pesi. È il principio della quantizzazione (introdotta nella sezione sul servire un modello): riscrivere i decimali finissimi dei pesi come interi grossolani, arrotondati ai gradini di una scala; passando da sedici a quattro cifre binarie ogni peso occupa quattro volte meno. È da qui, per inciso, che veniva il mezzo gigabyte a miliardo della prima figura.
Sugli LLM questa leva conta doppio, per due ragioni. La prima è che qui il tempo se ne va nel rileggere i pesi: alleggerirli non fa solo risparmiare spazio, accorcia direttamente il tempo di ogni token. La seconda è che riaddestrare un modello da centinaia di miliardi di parametri è fuori portata per quasi tutti, quindi la quantizzazione va fatta dopo l’addestramento, senza rimettere mano alla ricetta originale.

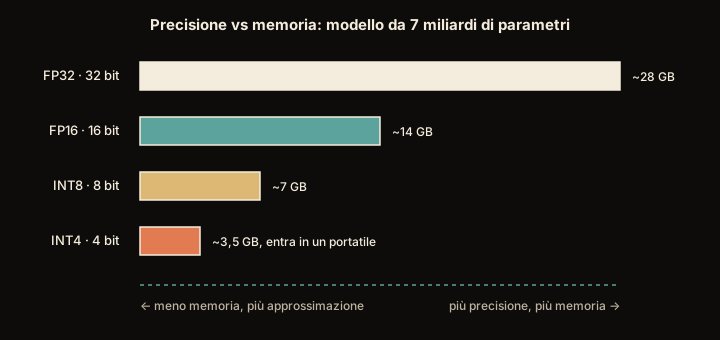
Fig. 36.14 Lo stesso modello, quattro ingombri. Le sigle sono i nomi tecnici delle quattro
scritture (quanti bit occupa ciascun numero, e se ha o no la virgola: FP32
sono trentadue bit con la virgola, INT4 quattro bit senza), ma a decidere
sono i gigabyte, e la decisione è un sì o un no: ventotto vogliono una macchina
da centro dati, tre e mezzo entrano in un portatile.#
Quello che Fig. 36.14 racconta non è un risparmio graduale, ed è per questo che la quantizzazione conta più di quanto un taglio del 75% suggerisca. Le quattro barre sono quattro risposte a una domanda che ammette solo sì o no, cioè «ci sta nella memoria che ho?», e non quattro sconti sempre più generosi. Sul portatile da 8 gigabyte della prima figura, che dopo il margine per la conversazione ne lascia liberi cinque, le prime tre righe sono tutte e tre un no, e la differenza fra loro non serve a niente: l’unica che cambia la vita è la quarta.
In un trasloco quasi tutto si schiaccia in scatoloni fitti fitti, e si risparmia un mucchio di spazio. Quasi tutto. I bicchieri buoni e il vaso della nonna, pigiati come il resto, si rompono, e hai rovinato il trasloco per due centimetri di spazio.
Fra i miliardi di numeri di un modello succede lo stesso. Una manciata è fragile e portante, e arrotondarla come le altre fa crollare la qualità. Riconoscerla è il difficile, perché non si vede dalla stazza: quei pochi numeri non sono i più grossi ma quelli da cui passa tutto, come il corridoio di casa, che è il pezzo più stretto e ci deve passare tutto quello che entra ed esce.
Poi ognuno ha il suo modo di proteggere i pochi delicati. C’è chi li tiene in una scatola a parte, senza schiacciarli. C’è chi li imbottisce prima e poi li pigia insieme agli altri, e occupano poco lo stesso. E c’è chi schiaccia un oggetto per volta, risistemando dopo ognuno quelli che restano, così l’ammaccatura non si accumula tutta sull’ultimo.
Il guadagno non arriva a quattro volte esatte, e la colpa è dei biglietti d’istruzioni. Ogni scatolone ne porta uno che dice come è stato chiuso, per poterlo riaprire, e occupa spazio anche lui. Scatoloni più piccoli vogliono dire biglietti più fitti, quindi meno spazio guadagnato e meno roba rotta, e si resta poco sotto le quattro volte. All’arrivo le scatole delicate si aprono per controllare.
E perché proprio quattro volte, e non otto? Perché il furgone è quello che è: la memoria della scheda non si allarga, e quello che conta è quanta roba arriva intera a destinazione. Stringendo, nel furgone ci sta più roba, e fino a un certo punto ne arriva intera di più; stringendo ancora, si rompe più di quanto se ne guadagni, e il furgone arriva pieno di cocci. Due ricercatori hanno cercato il punto in cui la bilancia si rovescia, provando molti traslochi di misura diversa, e l’hanno trovato lì, alle quattro volte. Con la premessa che si stia imballando a occhio: chi guarda prima che cosa sta mettendo in scatola riesce a stringere un po” di più.
La mappa affine \(\hat{w} = s\,(q - z)\) della sezione sul deployment vale qui identica, e il principio che la regge, guardare che cosa un peso fa invece di quanto vale, lo costruisce Meno bit: qui interessa che cosa cambia quando il modello non si può riaddestrare. Tre metodi post-training si sono affermati. Condividono l’intuizione che non tutti i numeri contano uguale, e tutti e tre guardano le attivazioni, cioè i numeri che attraversano il modello mentre risponde: si distinguono per che cosa ne fanno, ed è la distinzione che di solito si perde.
Il primo, LLM.int8(), ci cerca dentro i valori anomali
[DLBZ22]. Scopre che oltre una certa scala ne emergono, e
che sono concentrati in poche dimensioni. Siccome la scala di quantizzazione
la fissa il valore più grande, quelle poche dimensioni enormi schiacciano
tutte le altre in pochi gradini, e una scala sola per tutti distrugge la
qualità. La soluzione è una moltiplicazione di
matrici a precisione mista, con la stragrande maggioranza dei valori in
int8 e le poche dimensioni anomale tenute in 16 bit. Così la qualità regge
fino a 175 miliardi di parametri.
Il secondo, GPTQ, le usa per stimare la curvatura [FAHA23]. Fa passare per il modello un piccolo insieme di testi di calibrazione, e dagli ingressi di ogni strato ricava la matrice hessiana, cioè l’informazione del second’ordine che dice quanto l’uscita di quello strato soffre se un peso si sposta. Poi quantizza uno strato alla volta, un peso dopo l’altro, correggendo man mano sui pesi rimasti l’errore appena introdotto. Così scende a 3 o 4 bit per peso; un modello da 175 miliardi di parametri gli costa circa quattro ore su una sola A100, con degrado trascurabile.
Il terzo, AWQ (Activation-aware Weight Quantization), le usa per decidere quali pesi proteggere [LTT+24]. I pesi che contano non sono i più grandi ma quelli attraversati dai valori più grandi, e sono circa l’uno per cento: i canali salienti. La mossa poi sta nel riscalarli prima di quantizzarli, non nel tenerli in 16 bit, e questo evita sia la retropropagazione sia la ricostruzione su un obiettivo di regressione: è l’obiezione che gli autori di AWQ muovono a GPTQ, cioè che aderendo al proprio insieme di calibrazione rischi di generalizzare peggio fuori da quello.
Un’avvertenza sul «circa quattro volte». A 8 bit per tensore i due scalari di calibrazione sono trascurabili e il conto torna esatto; a 4 bit non più, perché né GPTQ né AWQ usano una scala per tensore, ma gruppi di pesi (tipicamente 128), ed è proprio quella granularità a rendere i 4 bit praticabili. Ogni gruppo si porta dietro la sua scala e il suo zero (mettiamo sedici bit per la prima e quattro per il secondo, venti in tutto): spalmati su 128 pesi fanno \(4{,}16\) bit effettivi per peso, su 32 pesi ne fanno \(4{,}625\). Il rapporto reale rispetto ai 16 bit è quindi \(3{,}8\times\), non \(4\times\): qualche punto percentuale di bit in più, speso per comprare qualità.
Il compromesso è sempre lo stesso (meno bit significano meno memoria e più velocità, ma più rischio per la qualità) e vale la regola d’oro della sezione sul deployment: la quantizzazione va misurata su dati di validazione, mai data per gratuita. E i 4 bit sono il punto in cui la convenienza si rovescia, almeno quando si arrotonda e basta. Dettmers e Zettlemoyer lo ricavano confrontando, a parità di bit totali occupati, modelli di taglia diversa scritti a precisioni diverse: l’accuratezza zero-shot sale mano a mano che si scende da 16 a 4 bit, e torna a scendere a 3 [DZ23]. Vale su cinque famiglie di modelli densi, da 19 milioni a 176 miliardi di parametri, e quasi dappertutto, con qualche eccezione che gli autori nominano; e i blocchi da 128 pesi o meno sono la loro raccomandazione operativa, non la condizione che tiene in piedi il verdetto, perché a 3 bit il ribaltamento arriva comunque.
Due riserve, e la prima gliela muovono gli autori a sé stessi: dalla loro misura resta fuori tutta la famiglia che si tara su dei dati, e la nominano citando GPTQ (AWQ, che è della stessa famiglia, sarebbe arrivato qualche mese dopo). Non è una riserva di forma: sulla perplessità di WikiText-2 un GPTQ a 2 bit batte un arrotondamento a 3. Sotto i 4 bit, quindi, la partita resta aperta per chi guarda i dati, ed è chiusa solo per chi arrotonda senza guardarli. La seconda: il verdetto è sul compromesso fra memoria e qualità, non sulla velocità, e gli autori scrivono che a molte richieste al secondo, cioè proprio nel regime della sala piena, quelle leggi di scala con la latenza non c’entrano quasi più.
Anche gli appunti con meno cifre#
I pesi non sono l’unica cosa che la scheda rilegge a ogni token. Con molte conversazioni aperte e contesti lunghi, la KV cache pesa quanto i pesi o di più (è il conto di L’attenzione in pratica), e si può comprimere anche lei. Le varianti dell’attenzione che condividono chiavi e valori fra le teste ne riducono il numero, e le sceglie chi progetta il modello; la quantizzazione ne riduce le cifre, e si fa dopo. In memoria le due riduzioni si moltiplicano, ma non sono indipendenti: su un modello che ha già una sola testa di chiavi e valori, ogni cifra tolta pesa di più.
Gli appunti del modello sono due tabelle che crescono di una riga a ogni parola: una di chiavi, che serve a decidere quali righe guardare, e una di valori, che dice che cosa prendere da ciascuna. Scriverle con meno cifre ha lo stesso problema dei pesi, il numero grande che allarga il passo per tutti, ma qui i numeri grandi hanno un’abitudine precisa, e la si sfrutta.
Nella tabella delle chiavi i numeri enormi stanno sempre nelle stesse colonne, riga dopo riga, come in un registro delle spese dove la colonna dell’affitto ha sempre cifre grandi e quella del caffè sempre cifre piccole. Arrotondando riga per riga, con un passo solo per tutta la riga, l’affitto detta il passo e il caffè sparisce. Arrotondando colonna per colonna, ciascuna col suo passo, l’affitto resta affitto e il caffè resta caffè.
Nella tabella dei valori quell’abitudine non c’è, eppure conviene arrotondare al contrario, riga per riga. La ragione sta in come la risposta usa la tabella: prende quasi tutto da poche righe, quelle a cui il modello presta attenzione, e il resto quasi lo ignora. Arrotondando per colonna, il passo di quelle poche righe importanti lo deciderebbero anche tutte le altre; arrotondando per riga ognuna ha il suo, e l’errore delle righe che non contano resta dove non conta.
Le ultime righe, in tutte e due le tabelle, si tengono per esteso: un po’ perché per arrotondare una colonna serve un gruppo di righe, un po’ perché sono le più guardate mentre il modello scrive. E decidono la qualità: senza, sui compiti in cui il modello ragiona a lungo, l’errore si sente.
Con due cifre binarie per numero, più i biglietti che dicono come è stato arrotondato ciascun gruppo e le ultime righe per esteso, gli appunti diventano da tre a quattro volte più piccoli, non otto. Nella stessa memoria entrano allora molte più conversazioni, e il mazzo più grande serve più persone con la stessa scheda. Due cifre però sono poche: sui modelli che tengono già un solo foglio di appunti per tutte le teste ne servono quattro. La via più prudente sono otto cifre con la virgola, che dimezzano gli appunti con un rischio molto minore, ma chiedono di tarare prima l’unità di misura su qualche esempio.
KIVI [LYJ+24] parte da un’analisi degli elementi della cache di Llama-2-13B e Falcon-7B. Nella cache delle chiavi pochi canali fissi portano elementi molto più grandi degli altri, per tutti i token: la quantizzazione va fatta per canale, raggruppando lungo la dimensione dei token (gruppi di 32), così che l’errore resti confinato in ciascun canale. Ogni gruppo è quantizzato in modo asimmetrico, \(Q(\mathbf{x}) = \lfloor (\mathbf{x} - m)/s \rceil\) con \(m = \min \mathbf{x}\) e \(s = (\max \mathbf{x} - \min \mathbf{x})/(2^b - 1)\), scala e minimo in 16 bit (il minimo fa la parte dello zero-point della mappa affine, \(m = -s\,z\)). La cache dei valori non ha anomalie così marcate, ed entra nell’uscita dell’attenzione come \(\mathbf{o} = \sum_j a_j \mathbf{v}_j\), dove \(a_j\) è il peso che la softmax dà al token \(j\) per la query corrente e \(\mathbf{v}_j\) la riga \(j\) della cache dei valori. L’errore d’uscita è \(\sum_j a_j \mathbf{e}_j\) con qualunque schema; quello che lo schema decide è \(\mathbf{e}_j\), che per token dipende dalla sola riga \(j\) e per canale anche dagli altri token del gruppo. Siccome l’attenzione è sparsa (nelle misure degli autori poche posizioni prendono quasi tutto il peso), l’uscita la fanno poche righe, e la quantizzazione per token rende la loro precisione indipendente da quella di tutte le altre.
In tutte e due le cache gli ultimi token restano in 16 bit, in una coda di al più 128 (32 nelle misure di velocità): per le chiavi perché servono gruppi da riempire, per tutte e due perché la coda regge la qualità. Gli autori lo mostrano su GSM8K: senza la coda, Llama-2-13B a 2 bit scende da 22,7 a 12,2, con la coda si ferma a 20,8. Nell’attenzione i punteggi della parte quantizzata e della coda si concatenano prima di un’unica softmax, e i prodotti con la parte quantizzata fondono la dequantizzazione nel kernel. Con 2 bit e nessuna calibrazione la qualità resta quasi invariata su Llama e Mistral, mentre su Falcon-7B, che ha una sola testa di chiavi e valori, servono 4 bit. Contando scala e minimo per gruppo i bit effettivi sono circa 3, e con la coda in 16 bit la cache si riduce di tre-quattro volte, non di otto. Su Llama-2-7B e una A100, contro un’implementazione a 16 bit della stessa libreria, gli autori riportano con la coda da 32 token un picco di memoria 2,6 volte più basso (pesi compresi) e batch fino a 4 volte più grandi, e un throughput maggiore di 2,35 volte con la coda da 128 e di 3,47 volte con quella da 32.
La via più prudente è la cache a 8 bit, in particolare in FP8 con un fattore di scala, il formato di Meno bit: dimezza la memoria rispetto ai 16 bit con un errore relativo limitato finché i valori restano nel campo normale, ma chiede scale tarate su un insieme di dati, per tensore o per testa. Il kernel dell’attenzione di solito riporta i valori a 16 bit nei registri; alcuni fanno il prodotto direttamente in FP8, quantizzando anche le query. In tutti i casi il guadagno è di memoria e di banda, cioè di token al secondo nel regime memory-bound, e il degrado va misurato soprattutto sui compiti che generano a lungo, come il ragionamento matematico: nelle misure di KIVI i compiti a contesto lungo perdono quasi niente.
L’altra leva: togliere pesi invece di accorciarli#
La quantizzazione scrive gli stessi pesi con meno cifre. La potatura (pruning) fa una cosa diversa: ne butta via una parte.
Quanto se ne possa buttare, e perché toglierne il novanta per cento non renda un modello dieci volte più veloce, li costruisce Meno pesi. Qui interessa quello che rende gli LLM un caso a sé.
Comprimere i numeri è come riscrivere lo stesso quaderno con una grafia più piccola: ci sono ancora tutti. Potare è strappare delle pagine. Su una rete piccola si può strappare e poi rileggere tutto da capo per rimettere insieme il senso, ed è quello che si fa; su un modello da miliardi di numeri quella rilettura costerebbe quanto costruirlo, e nessuno la fa dopo un rilascio. Per questo qui si strappa molto meno, e si sceglie con cura: le pagine da togliere sono quelle scritte in piccolo e che nessuno rilegge mai, non quelle scritte in piccolo e basta. Con questa cautela si arriva a buttarne circa metà senza danni evidenti; oltre, il conto si fa salato. E un quaderno con metà pagine strappate qua e là non si legge in metà tempo: chi lo sfoglia deve comunque passare di buco in buco. Si guadagna tempo solo se si strappa con una regola fissa che il lettore conosce in anticipo, due fogli su ogni quattro, e anche così il senso ne soffre un po” di più che strappando dove si vuole.
Sugli LLM la potatura post-training è più delicata che sulle reti di visione, perché non si può riaddestrare. SparseGPT [FA23] e Wanda [SLBK24] affrontano proprio questo: il secondo, in particolare, sceglie cosa togliere pesando ogni peso per la norma dell’attivazione corrispondente; lo stesso principio di AWQ, che i pesi importanti si riconoscono guardando cosa ci passa attraverso, non quanto sono grandi. Con questi metodi il \(50\%\) di sparsità è raggiungibile senza riaddestramento e con degrado contenuto; oltre, il conto si fa salato. Metà dei pesi a zero, però, non vuol dire metà del tempo per token: la sparsità non strutturata riduce i parametri e non il tempo, perché una GPU non sa saltare zeri sparsi a caso, e il servizio accelera soltanto con la sparsità strutturata 2:4 sull’hardware che la esegue, che perde qualche punto in più del \(50\%\) libero e accelera meno del doppio, perché i byte da leggere non si dimezzano. Le misure sono in Meno pesi.
Su una rete piccola il riaddestramento è il passaggio che riporta la rete dov’era, e Meno pesi lo misura; su un LLM quel passaggio non c’è, perché riaddestrare un modello da miliardi di parametri non è una cosa che si fa a valle di un deploy. I metodi che si usano sugli LLM esistono proprio per sostituirlo: invece di riaddestrare tutto, aggiustano strato per strato i pesi rimasti, guardando che cosa ci passa attraverso. È un rimedio locale, e si vede dal traguardo: metà dei pesi, non i nove decimi. Da qui la regola pratica: a parità di rischio si comincia dalla quantizzazione, che il riaddestramento non lo chiede. E vale la regola di sempre, misurare, perché il degrado si distribuisce in modo diseguale fra i compiti e una media aggregata lo nasconde.
Valutare l’invalutabile#
Un modello servito e compresso va poi tenuto d’occhio: funziona ancora bene? I modi consueti di dargli un voto qui mostrano tutti un limite.
Il primo è la misura che il modello porta con sé, la perplessità, vista nel capitolo sui Transformer: dice quanto il modello è indeciso a ogni token, ed è come contare le facce del dado che gli servirebbe per tirare a indovinare al suo posto. Due facce vuol dire che esita fra due parole, mille facce che non ne ha idea. È una misura ottima mentre il modello impara la lingua, ma non dice quasi niente di ciò che conta poi: la risposta è utile? corretta? ben scritta?
Il secondo metro sono gli esami standard, i benchmark (già visti nel capitolo sui Transformer), compiti in classe uguali per tutti i modelli. Vanno letti con un sospetto preciso, quello della contaminazione: se le domande dell’esame erano già finite dentro i testi su cui il modello si è allenato, il suo bel voto non dice niente, perché quelle domande le aveva già viste.
E poi c’è il problema di fondo, che nessuno dei due risolve: per una richiesta aperta («scrivi una mail di scuse al cliente») non esiste la risposta giusta con cui confrontarsi.

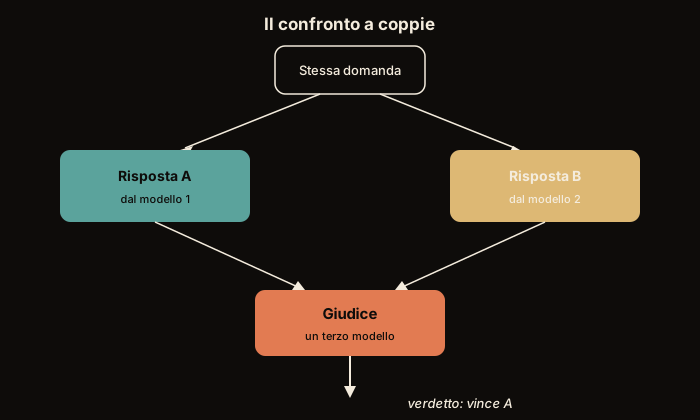
Fig. 36.15 Nessuna risposta giusta, solo un confronto. Il giudice non dice se una risposta è corretta: dice quale delle due preferisce, ed è una domanda a cui si può rispondere anche quando la prima non ha risposta.#
Il cambio di domanda in Fig. 36.15 è ciò che rende praticabile il metodo, che si chiama LLM-as-a-judge, «il modello che fa da giudice», e insieme ciò che ne fissa i limiti. Un ordine fra due risposte si può stabilire senza un riferimento assoluto. Ma un giudice che preferisce porta con sé i propri gusti, e due di quei gusti ricorrono in tutti i giudici misurati, con intensità diverse: premia chi gli è stato presentato per primo, e premia chi scrive di più. Un terzo, la simpatia per chi scrive come scriverebbe lui, Zheng e colleghi non riuscivano a stabilirlo con i loro dati [ZCS+23]; lo hanno misurato in seguito Panickssery e colleghi, sui riassunti, anche con un giudice che non sa quale testo sia suo [PBF24]. Il legame con l’auto-riconoscimento resta una correlazione, e un giudice di un’altra famiglia sposta il problema più che toglierlo, perché un modello premia anche i testi che somigliano ai propri. Questi pregiudizi si attenuano scambiando l’ordine, con giudici più forti, con istruzioni di valutazione più precise, ma nessuna delle misure li azzera: chiedere una preferenza invece di una verifica lascia al giudice lo spazio per usare i suoi.
Chi corregge il tema, se non c’è una risposta esatta? A scuola lo fa un insegnante, che legge, soppesa e dà un voto. Ma di temi da correggere ne arrivano migliaia al minuto, e un insegnante costa tempo. La scorciatoia è promuovere a esaminatore uno studente molto bravo, che legge e dà il voto in un lampo, a costo quasi nullo.
Il suo voto vale qualcosa? Messo a scegliere il migliore fra due temi, quando anche l’insegnante in carne e ossa ha un preferito, va d’accordo con lui più di quattro volte su cinque, quanto due insegnanti fra loro. Se si contano anche le volte in cui uno dei due dà pari, l’accordo scende a due volte su tre, e anche quello è l’accordo fra due insegnanti. Per quello che costa, è un ottimo affare.
Ha però le sue manie, sempre le stesse. A parità di tutto il resto dà il voto più alto al tema che ha letto per primo. Premia il tema lungo, scambiando l’abbondanza di parole per competenza, anche quando una risposta breve e centrata sarebbe migliore; i più svegli ci cascano molto meno, ma nessuno ne è immune. Apprezza anche chi scrive come scrive lui: con i temi raccolti la prima volta non lo si poteva dire, misure successive lo hanno trovato, e più l’esaminatore riconosce un tema come suo, più lo premia. Cambiare esaminatore aiuta poco, perché ognuno premia i temi che somigliano ai propri. Contro la mania dell’ordine un rimedio c’è: dargli i due temi anche nell’ordine opposto, e tenere per buono solo chi vince tutte e due le volte; se i due giri si contraddicono, è pari. La mania del tema lungo resta. E sui compiti di matematica, se non ha la soluzione davanti, si lascia convincere da un risultato sbagliato più spesso che no; con la soluzione accanto sbaglia di rado. Prima di affidargli una classe, quindi, lo si mette alla prova su un mucchio di temi già corretti da un insegnante.
Il guaio grosso arriva se la classe capisce come ragiona l’esaminatore. Da quel momento tutti scrivono lungo, e per primi quando possono: i voti salgono e i temi peggiorano. È lo stesso guaio del palato artificiale che votava i piatti al posto dell’assaggiatore in Dopo il pre-addestramento. Quel voto serve a tenere d’occhio la classe, non a decidere che cosa si insegna.
Il pattern, LLM-as-a-judge [ZCS+23], usa un modello forte (nel lavoro originale, GPT-4) per assegnare un punteggio o per scegliere la migliore fra due risposte. Zheng e colleghi lo validano su due banchi di prova (MT-Bench, ottanta domande a più turni, e Chatbot Arena, confronti a coppie raccolti dal pubblico e aggregati con un punteggio Elo) e misurano che il giudice-GPT-4 concorda con le preferenze umane oltre l’80% delle volte: lo stesso livello di accordo che due esseri umani hanno fra loro. Quell’oltre l’80% ha un protocollo, e sta nella tabella: è l’85% sui soli voti non pari, dove due giudici a caso concorderebbero già nella metà dei casi (fra due umani, 81%); contando anche i pareggi e le incoerenze si scende al 66%, quanto due umani fra loro (che stanno al 63% sul primo turno e al 67% sul secondo), là dove il caso darebbe 33. Il giudice automatico non è poi neutro, e i suoi bias hanno nomi precisi: il position bias (tende a preferire la risposta presentata per prima) e il verbosity bias (favorisce le risposte lunghe), misurati tutti e due, il secondo con un attacco che allunga la risposta senza aggiungerci niente e a cui GPT-4 resiste molto meglio degli altri giudici provati (ci casca nell’8,7% dei casi, contro il 91,3%). Il terzo, il self-enhancement bias, gli autori lo osservano senza poterlo dimostrare, perché qualche giudice preferisce sé stesso (GPT-4 di dieci punti di win rate, Claude-v1 di venticinque) ma preferisce anche modelli diversi da sé, e GPT-3.5 non preferisce sé stesso; lo hanno misurato poi Panickssery e colleghi, sui riassunti, e il giudice riconosce i propri testi tanto più spesso quanto più li preferisce [PBF24]. Il position bias si mitiga chiamando il giudice due volte a ordini scambiati e dichiarando vincitore solo chi vince in tutti e due i giri, pari quando i due giri si contraddicono; il resto non sparisce. Un giudice senza riferimento, poi, non verifica la correttezza: su dieci problemi di matematica, giudicati due volte a ordini scambiati, GPT-4 promuove la risposta sbagliata 14 volte su 20 con il prompt di serie, 6 chiedendogli di ragionare per passi e 3 dandogli la soluzione di riferimento. E quelle cifre stanno su campioni piccoli: l’8,7% dell’attacco alla verbosità sono 2 risposte su 23. Un giudice usato in produzione si valida quindi sul proprio compito, misurandone l’accordo con etichette umane su un campione, con una statistica corretta per il caso come il \(\kappa\) di Cohen, \(\kappa = (p_o - p_e)/(1 - p_e)\) con \(p_o\) l’accordo osservato e \(p_e\) quello atteso per caso, e con un intervallo di confidenza, perché l’accordo misurato per GPT-4 su MT-Bench non si trasferisce da sé a un altro giudice o a un altro compito. È la stessa lezione del reward model del capitolo sui Transformer: un giudice appreso è un surrogato del giudizio umano, e ottimizzare troppo contro un surrogato porta al reward hacking.
Alla valutazione si affianca, quando il servizio è acceso, la sicurezza di ciò che esce. Al modello, durante l’addestramento, si è già insegnato quali risposte sono preferibili e quali no, a partire da coppie di risposte di cui delle persone avevano indicato la migliore: le tecniche RLHF e DPO, discusse nel capitolo sui Transformer. Quell’insegnamento lo rende meno incline a rispondere in modo dannoso, ma non offre garanzie: resta una disposizione appresa, e una disposizione si aggira. Per questo i sistemi reali aggiungono dei guardrail, filtri e classificatori indipendenti dal modello che esaminano quello che entra e quello che esce. Servono a bloccare contenuti dannosi e dati personali, ma anche due mosse che hanno un nome preciso: le istruzioni nascoste dentro un testo che il modello deve leggere, scritte apposta perché le prenda per ordini (la prompt injection), e i tentativi di farsi dire ciò che il modello non dovrebbe dire, aggirandone le regole (il jailbreak). Nessuno di questi strumenti è perfetto; messi insieme, riducono il rischio senza azzerarlo. Quanto lo riducano si misura come il resto, con una batteria di attacchi noti (iniezioni dirette e nascoste nei documenti che il modello legge [GAM+23], tentativi di jailbreak) che gira a ogni cambio di prompt o di modello e conta quanti ne passano. Il filtro, però, non sostituisce il confine vero, che sta nei permessi dati al sistema: come si attacca e come si difende un modello di linguaggio lo racconta Attaccare e difendere un modello di linguaggio, nel capitolo sull’AI responsabile.
Il ciclo LLMOps#
L’anello dell’MLOps resta quello di sempre (dati, addestramento, valutazione, consegna, sorveglianza), ma con gli LLM cambia quello che ci gira dentro, cioè le cose di cui si conserva ogni versione. Spesso non sono i pesi, che arrivano già fatti da qualcun altro: è il prompt, la riga d’istruzione con cui si spiega al modello che cosa deve fare. Quella riga è codice a tutti gli effetti, ed è fragile: basta una parola diversa per cambiare la risposta, come illustrato nel capitolo sui Transformer. Si versiona quindi come il codice: un identificativo (l’impronta del testo e dei parametri di generazione, come quella della configurazione in Dal notebook alla produzione), il modello fissato alla versione con cui è stato provato, e la batteria di casi che lo ha approvato. Una versione nuova si prova prima fuori linea, su quella batteria, e solo se supera quella in uso si mette alla prova sul pubblico, con un test A/B come in Sorvegliare un modello vivo. Con un modello offerto da terzi il rischio è doppio, perché anche sotto lo stesso nome il servizio cambia versione, e il comportamento cambia con lei: le versioni di marzo e di giugno 2023 di GPT-3.5 e GPT-4 rispondevano in modo diverso alle stesse domande, dal riconoscere un numero primo al formato del codice prodotto [CZZ24a].
Il monitoraggio, a sua volta, insegue bersagli nuovi: le allucinazioni (risposte sicure di sé e sbagliate), la deriva dell’uso rispetto a ciò per cui il sistema era tarato, e il costo per token, che scala con quanto testo entra ed esce; un prompt gonfio è una bolletta più salata. E poiché il testo aperto non si collauda con i test unitari del software classico, serve una valutazione continua: la batteria di esempi che gira a ogni cambio di prompt o di modello, spesso con l’LLM-as-a-judge a fare da metro automatico, e che con un modello di terzi fa anche da sensore della sua deriva.
Resta fuori, di proposito, tutto ciò che sta sopra il modello: ancorare le risposte a documenti recuperati al momento (Cercare per rispondere, e nella forma avanzata il capitolo sugli Agenti), comporre prompt, contesto e cicli di lavoro (Prompt, contesto e loop), far usare al modello strumenti esterni e comporre più passi in un agente, di nuovo negli Agenti.
Da ricordare
Con un grande modello linguistico, finché le richieste servite insieme sono poche, la parte lenta è la rilettura: per scrivere una sola parola il modello deve rileggersi tutti i suoi numeri, e sono miliardi. Il calcolo, in confronto, è quasi fermo.
La prima domanda è quale ci sta nella memoria che si ha, prima ancora di quale sia migliore: se non ci sta, non è lento, proprio non parte.
Servendo tante richieste insieme quella rilettura si paga una volta per tutte, quindi conviene servirne più che si può: per questo un buon maître non riserva tavoloni e riempie ogni sedia appena si libera.
Si può far indovinare in anticipo un modello piccolo e far verificare al grande in blocco quello che ha indovinato: se il piccolo azzecca si va molto più veloci, e passa solo quello che il grande avrebbe potuto scrivere lui. Serve però quando le richieste sono poche: con la sala piena il grande ha già da fare per conto suo.
Per far entrare il modello nella memoria si comprime: si arrotondano i numeri, o se ne buttano via una parte (e buttarne metà qua e là non fa andare più veloci). Ma alcuni numeri sono fragili e portanti, come i bicchieri buoni in un trasloco, e vanno trattati a parte. Anche gli appunti si possono arrotondare, le chiavi colonna per colonna e i valori riga per riga, tenendo per esteso le ultime righe: da tre a quattro volte più piccoli, ma sui modelli con un solo foglio di appunti per tutte le teste due cifre non bastano.
Giudicare un testo aperto non ha una risposta esatta: si usa un altro modello come esaminatore, comodo ed economico, sapendo che ha le sue manie (il tema che ha letto per primo, quello più lungo e, come hanno mostrato misure successive, il proprio) e che senza la soluzione davanti si fa convincere da conti sbagliati. Prima di fidarsene lo si prova su temi già corretti.
E quello che il modello scrive va comunque filtrato all’ingresso e all’uscita: quel che ha imparato a non dire è una disposizione, e una disposizione si aggira.
Quello che qui si conserva versione per versione non sono i pesi, che spesso arrivano già fatti: è l’istruzione con cui si parla al modello, che è fragile come il codice e come il codice va provata prima di sostituirla.
Da ricordare
Con gli LLM il collo di bottiglia si sposta sulla generazione autoregressiva: la decodifica è memory-bound finché il batch resta sotto \(b^\ast = F M_w/(2NB)\) (\(F/B\) in 16 bit, circa 150 sequenze su una scheda da 312 TFLOP/s e 2 TB/s), mentre il prefill è limitato dal calcolo; e la KV cache, \(2\,n_\ell\,h_{kv}\,d_k\) numeri per token, cresce col contesto ed è di ciascuna sequenza, quindi non si ammortizza sul batch.
Servire un LLM significa batchare tante richieste per ammortizzare la lettura dei pesi: la PagedAttention di vLLM pagina la KV cache come un sistema operativo, e lo spreco passa dal 60–80% a meno del 4% [KLZ+23]; il continuous batching, l’iteration-level scheduling di Orca [YJK+22], tiene il batch sempre pieno. Contro FasterTransformer e contro Orca stesso, vLLM serve da due a quattro volte più richieste a parità di latenza: un guadagno soprattutto della gestione della memoria.
Lo speculative decoding è esatto grazie alla regola di accettazione-rifiuto [LKM23], e non tutte le sue varianti lo restano: EAGLE e il prompt lookup sì; Medusa solo nella versione che lascia intatto il modello e verifica per rifiuto, perché la typical acceptance scambia la distribuzione del target per un tasso di accettazione più alto, e Medusa-2 riaddestra il modello stesso [CLG+24]. L’accelerazione attesa è \((1-\alpha^{\gamma+1})/\big((1-\alpha)(\gamma c+1)\big)\), con \(c\) il costo relativo della bozza, e si assottiglia a batch grandi.
Comprimere per servire: quantizzazione post-training (riaddestrare è fuori portata) con la mappa affine \(\hat{w} = s\,(q - z)\) della sezione sul deployment, ma per gruppi di pesi, non per tensore: a 4 bit i bit effettivi sono circa 4,2. I tre metodi guardano tutti le attivazioni e ne fanno cose diverse: LLM.int8() ci isola le dimensioni anomale [DLBZ22], GPTQ ne ricava l’hessiana su un insieme di calibrazione e scende a 3–4 bit [FAHA23], AWQ le usa per scegliere l’1% di pesi da proteggere [LTT+24]. Sempre da misurare. Che i 4 bit siano l’ottimo lo si misura a parità di bit totali occupati e sulla sola accuratezza zero-shot [DZ23], e per chi arrotonda senza guardare i dati: i metodi che si tarano su un insieme di calibrazione restano fuori da quella misura, e sotto i 4 bit la partita resta aperta. La potatura al 50% (SparseGPT, Wanda) riduce i parametri ma accelera il servizio solo nella forma strutturata 2:4.
Anche la KV cache si quantizza: KIVI [LYJ+24] a 2 bit, chiavi per canale e valori per token, con gli ultimi token in 16 bit, che reggono la qualità; circa 3 bit effettivi, quasi senza perdite su Llama e Mistral, ma su un modello MQA ne servono 4. La via prudente è l’FP8 con scale tarate.
Valutare l’invalutabile: la perplessità non basta e i benchmark si contaminano; per l’output aperto si usa LLM-as-a-judge, che sui soli voti non pari concorda con l’uomo l’85% delle volte contro l’81% fra due umani [ZCS+23], coi suoi bias di posizione e di verbosità; l’auto-preferenza, che i dati di Zheng e colleghi non bastavano a dimostrare, l’hanno misurata poi Panickssery e colleghi come correlazione con l’auto-riconoscimento [PBF24]. Senza una soluzione di riferimento il giudice non verifica la correttezza, e va validato sul proprio compito (accordo con etichette umane, corretto per il caso). In produzione servono guardrail su ingresso e uscita, misurati con batterie di attacchi noti; il confine vero sono i permessi dati al sistema.
Il ciclo LLMOps versiona i prompt come codice (impronta, modello fissato alla versione, batteria di casi), li prova fuori linea prima dell’A/B, e monitora allucinazioni, deriva (anche quella del fornitore, quando il modello è di terzi [CZZ24a]) e costo per token, con valutazione continua. RAG, ingegneria di prompt e contesto, tool use e agenti hanno capitoli loro, che abbiamo già percorso.