


Python: il linguaggio dell’intelligenza artificiale#
Nel Natale del 1989 un programmatore olandese, Guido van Rossum, si annoia. Gli uffici del centro di ricerca dove lavora ad Amsterdam sono chiusi per le feste, e lui riempie il tempo scrivendo, per hobby, un nuovo linguaggio di programmazione. Lo chiama Python: non per il serpente, ma per i Monty Python, il gruppo comico inglese di cui è fan. La prima versione pubblica esce nel 1991. Trent’anni dopo, quel passatempo è il linguaggio in cui si scrivono i principali framework di deep learning e gran parte del codice che accompagna la ricerca sul machine learning, dalla rivoluzione del deep learning del 2012 ai grandi modelli linguistici di oggi. Ci è arrivato con una divisione del lavoro: i conti pesanti li fanno programmi scritti in linguaggi più veloci e più faticosi da usare, e Python li comanda.
La divisione c’era già in AlexNet, la rete che nel 2012 aprì la stagione del deep learning: il calcolo in C++ e in CUDA, il linguaggio con cui si programmano le schede grafiche, e sopra uno strato di Python per configurarla e lanciarla. Che quel livello superiore fosse Python non era scontato. Negli anni subito dopo, i laboratori di punta scrivevano il codice in Lua, mentre Python aveva già Theano, nato in ambito accademico prima del 2012; la partita si è chiusa con librerie che si scrivono in Python e calcolano in C++, e la storia di PyTorch, cioè Torch rifatto per Python, la racconta l’apertura del capitolo che porta il suo nome.
Com’è successo? Python non è il linguaggio più veloce, né il più elegante in senso accademico. Ha vinto per altre ragioni.
Perché proprio Python#
Un programma è un elenco di istruzioni scritte in un file di testo, che il
computer esegue una dopo l’altra dall’alto in basso. Nient’altro: niente di
misterioso, un foglio di ordini in fila. E Python si legge quasi come inglese
scarno. Una riga come if voto >= 18: print("promosso") si indovina prima
ancora di aver scritto il primo programma: è come la diresti a voce, «se il
voto è almeno diciotto, scrivi promosso» (all’università i voti vanno in
trentesimi, e il diciotto è la sufficienza). Le regole di scrittura di
un linguaggio (dove vanno i due punti, gli a capo, le parentesi) si chiamano la
sua sintassi, e quella di Python è breve e leggera: sta in un pomeriggio, e
poi il tempo lo passi a pensare a cosa dire, non a come scriverlo. Per chi
arriva dalla matematica, dalla fisica o dalla biologia e vuole esprimere un
ragionamento, è una liberazione.
A questo si aggiungono due cose decisive: è gratuito e ha una comunità
enorme. Per quasi ogni problema (leggere un file, disegnare un grafico,
addestrare una rete neurale), qualcuno ha già scritto una libreria pronta:
un pacchetto di istruzioni già confezionate da altri, che ti risparmia il
lavoro. Non devi reinventare la ruota: la importi e la usi. Importare vuol
dire scrivere una riga in cima al programma, import numpy, per dire a Python
«da qui in poi voglio usare anche questa»: da quel momento tutti gli strumenti
della libreria sono a disposizione. Python porta con sé una libreria standard
già pronta (math per le funzioni matematiche, time per misurare il tempo,
e decine di altre), ma le librerie scientifiche no: vanno installate, una
volta sola, con un programma apposta che si chiama pip. La riga di
importazione ha due varianti che si incontrano subito: import numpy as np dà
alla libreria un nome più corto, e from math import sqrt porta dentro un
solo nome, da usare senza prefisso.
C’è poi una cosa che si vede solo standoci dentro: quando esce un lavoro nuovo, di solito esce con il suo codice allegato, ed è quasi sempre codice Python. Chi legge può rifare l’esperimento invece di crederci sulla parola, e chi lo rifà parte da dove l’altro è arrivato. Un linguaggio solo per tutti vuol dire questo.
Sui calcoli pesanti, da solo, Python è lento; quei calcoli però non li fa quasi mai lui. Le librerie importanti sono scritte in linguaggi più veloci ma più faticosi da usare, e Python fa il capocantiere, quello che legge il progetto e dà gli ordini alle squadre. Tu scrivi la riga chiara; il muro lo tira su chi ha gli attrezzi per farlo in fretta.
CPython, l’implementazione di riferimento, compila il sorgente in bytecode e lo esegue su una macchina virtuale a pila. I tipi sono dinamici, quindi ogni operazione va risolta a runtime sul tipo degli operandi: l’interprete adattivo della PEP 659 (Python 3.11) specializza il bytecode sui tipi che osserva, il JIT della PEP 744 (sperimentale dal 3.13) prova ad andare oltre, e il costo per operazione resta comunque molto sopra quello del codice compilato. Paghi in velocità di esecuzione ciò che guadagni in velocità di sviluppo. Il calcolo scientifico in Python convive con il problema dei due linguaggi (prototipare in un linguaggio comodo e riscrivere in uno veloce, il problema da cui è nato Julia) e lo risolve spartendolo per ruoli: il secondo linguaggio lo scrive chi sviluppa le librerie, e chi le usa resta nel primo. Le operazioni pesanti non girano affatto in Python puro: NumPy è scritto in C, PyTorch e TensorFlow in C++ e CUDA. Python fa da collante (glue language), orchestrando componenti compilate che sfruttano BLAS, SIMD e GPU. Scrivi codice ad alto livello, leggibile; sotto, gira codice nativo alla massima velocità.
Attorno al linguaggio è cresciuto un ecosistema di centinaia di migliaia di
pacchetti (distribuiti via PyPI e pip) e una prassi di ricerca in cui i
paper arrivano con il codice allegato: la riproducibilità diventa la norma, e
Python il denominatore comune.
Un linguaggio pensato per essere letto#
La filosofia di Python è così esplicita da essere scritta dentro il linguaggio stesso, e basta un’istruzione per farsela stampare:
import this # stampa lo "Zen of Python"
Metà di quella riga non è un’istruzione: il cancelletto # apre un
commento, e tutto ciò che lo segue sulla stessa riga è scritto per chi legge,
non per il computer, che lo salta. I commenti dicono che cosa fa la riga
accanto, e la freccia -> dentro un commento significa «e viene fuori questo».
Su quel «viene fuori» c’è una convenzione da chiarire subito. Nell’interprete,
la finestra in cui le istruzioni si scrivono una per volta, un’espressione
digitata e confermata con Invio mostra il proprio valore: scrivendo 2 + 3
compare 5. In un programma salvato in un file, invece, la stessa riga
calcola e non mostra niente, e per vedere il risultato bisogna stamparlo con
print. Gli esempi che seguono sono scritti come li si digiterebbe
nell’interprete, ed è per questo che spesso una riga mostra un valore senza
print accanto.
Eseguendo import this compaiono i diciannove aforismi che Tim Peters
codificò nel 1999.
Tra questi: «Explicit is better than implicit» («meglio esplicito che
implicito»), «Simple is better than complex» («meglio semplice che
complicato»), «Readability counts» («la leggibilità conta»). Non è poesia:
il codice si legge molte più volte di quante lo si scriva, e in un progetto
condiviso ciò che non si capisce non si può nemmeno verificare. Questa
chiarezza rende Python adatto a insegnare e a comunicare l’AI; per lavorarci
serve anche altro, e lo dà l’ecosistema.
L’ecosistema scientifico#
La forza di Python nell’AI non è il linguaggio da solo, ma la torre di librerie costruite l’una sull’altra (Fig. 2.1; in inglese quella torre si chiama stack). Ognuna fa una cosa e la fa bene.
NumPy: il fondamento. Introduce l’array N-dimensionale, una griglia di numeri con quante dimensioni si vuole (una fila, una tabella, una pila di tabelle) su cui i conti si fanno tutti insieme, e rende veloce l’algebra lineare, cioè la matematica delle tabelle di numeri; quasi tutto il resto poggia su di lui.
Pandas: dati tabellari. Il
DataFrameè un foglio di calcolo programmabile: caricare, pulire e trasformare i dati prima di passarli a un modello.Matplotlib: visualizzazione. I grafici con cui esplori i dati e racconti i risultati.
scikit-learn: la cassetta degli attrezzi del machine learning classico, quello che viene prima delle reti neurali. Dentro ci sono decine di modelli diversi, e li si comanda tutti con le stesse due parole:
fit(impara da questi dati) epredict(adesso prevedi). Dopo averne usato uno, l’interfaccia degli altri è già nota, ed è quel che si intende con API uniforme (l’API di una libreria è l’insieme dei comandi con cui le si parla).PyTorch (Facebook AI Research, oggi Meta), deep learning: costruisce reti neurali e le addestra, calcolando da sé le derivate che servono a correggerne i parametri (la differenziazione automatica), anche sulla GPU, la scheda grafica. Non sta sopra NumPy: il calcolo lo fa con un motore proprio, scritto in C++, e con NumPy scambia soltanto i dati: sulla CPU,
torch.from_numpyeTensor.numpy()condividono la stessa memoria invece di ricopiarli. Il suo concorrente storico è TensorFlow (Google, 2015), che accanto alla torre sta allo stesso modo.

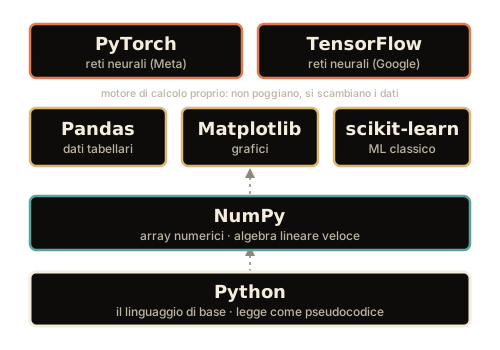
Fig. 2.1 La torre delle librerie scientifiche di Python. Le due frecce sono i due «poggia su» veri: NumPy sul linguaggio, e Pandas, Matplotlib e scikit-learn su NumPy, senza il quale non funzionano. Sopra il secondo strato, la freccia manca, ed è il punto: PyTorch e TensorFlow stanno accanto alla torre più che sopra, perché i conti li fanno da sé, con un motore tutto loro, e con NumPy si limitano a scambiarsi i dati.#
Dire che Pandas o scikit-learn sono «costruiti su NumPy» vuol dire che tengono i numeri in array di NumPy e fanno i conti con le sue operazioni, invece di riscriverle: Pandas aggiunge le etichette, le colonne e il raggruppamento delle righe, e quando c’è da sommare un milione di valori la somma la fa NumPy.
Il modo in cui NumPy esegue quella somma ha un nome, vettorizzazione: invece di dire al calcolatore che cosa fare a un numero e poi ripeterglielo un milione di volte, glielo si dice una volta sola sul blocco intero. Da dove venga il guadagno è meno ovvio di quanto sembri.
Dieci centesimi di pedaggio non sono cari. Un milione di volte, sì.
Con il solo Python, raddoppiare un milione di numeri vuol dire percorrerli uno per uno in un ciclo (un’istruzione che si ripete tante volte, spiegata fra le basi del linguaggio), e a ogni giro Python paga il suo pedaggio: apre la casella, guarda che cosa c’è dentro, si ricorda che quello è un numero, cerca come si moltiplicano i numeri, e solo alla fine moltiplica. La moltiplicazione dura un istante; il pedaggio è tutto il resto, e si paga a ogni giro.
Con NumPy si scrive 2 * x, dove x è il blocco intero dei numeri, e il
pedaggio si paga una volta sola, all’ingresso. Da lì in poi Python resta fuori:
dentro lavora un programma già tradotto in linguaggio macchina, che percorre il
blocco senza fermarsi a chiedersi che cosa contiene, e che i numeri li prende a
manciate invece che uno per volta, perché il processore sa moltiplicarne
parecchi con una mossa sola. Perché possa farlo, però, i numeri devono stare in
fila ed essere tutti dello stesso tipo, ed è la condizione che NumPy impone e
che una lista di Python non rispetta.
Per i conti fra intere tabelle di numeri il lavoro passa oltre, a librerie specializzate che qualcuno ha passato decenni a limare, le stesse che girano nei centri di calcolo.
Fra il ciclo e la riga sola c’è un fattore cento, a volte mille. Ed è la ragione per cui le librerie scientifiche si sono messe d’accordo tutte sullo stesso blocco di numeri: chi lo produce e chi lo consuma non hanno niente da tradursi.
La vettorizzazione è una singola operazione dichiarata su un intero array e
delegata in blocco a codice compilato, invece di riattraversare il ciclo di
valutazione dell’interprete a ogni elemento. Un ndarray di NumPy è una vista
tipizzata su un blocco di memoria, contiguo nel caso più comune, ed è la
tipizzazione a rendere la delega possibile: il codice chiamato sa in anticipo
quanti byte è largo ogni elemento e come si combinano, mentre su una lista di
oggetti Python dovrebbe scoprirlo caso per caso.
Il costo che sparisce è dunque l’overhead dell’interprete su ogni iterazione, e la sua scomparsa vale due o tre ordini di grandezza sul ciclo Python equivalente. Le operazioni elemento-per-elemento vanno a cicli in C ottimizzati e spesso a istruzioni SIMD, che fanno operare il processore su più numeri con una sola istruzione; i prodotti fra matrici passano invece per librerie BLAS dedicate, codice specializzato di terzi. Da qui la scelta dell’array come struttura dati comune a tutto l’ecosistema: è insieme il formato di scambio fra librerie e l’unità su cui il calcolo è veloce.
L’interprete, i notebook e il cloud#
Python si può usare in tre modi, di crescente comodità per chi sperimenta.
Il modo più diretto è l’interprete interattivo: apri una finestra, scrivi un’istruzione, premi Invio e vedi subito il risultato, come una calcolatrice con cui puoi conversare. Un passo avanti è il notebook Jupyter: un quaderno digitale fatto di celle, dove testo, codice, grafici e formule convivono nella stessa pagina. Scrivi una cella, la esegui, guardi il grafico che appare lì sotto. È il modo in cui gran parte del machine learning viene davvero insegnato e praticato.
Le celle però condividono la memoria: quello che una ha calcolato resta a disposizione delle altre. La comodità ha un tranello. Se esegui le celle in un ordine diverso da come stanno sulla pagina, il quaderno segue l’ordine dei tuoi clic, non quello delle righe, e può mostrare un risultato che, rileggendo la pagina, non torna. Il rimedio, quando succede, è rieseguire tutto da capo, dall’alto in basso.
E se non vuoi installare nulla? Google Colab ti dà un notebook nel browser, gratuito, e spesso con una scheda grafica in prestito: abbastanza per addestrare un modello senza possedere un computer potente.
L’interprete interattivo è un REPL (read–eval–print loop); la versione
arricchita IPython ne è il motore. Un notebook Jupyter è un documento
.ipynb (JSON di celle) eseguito da un kernel che mantiene lo stato tra una
cella e l’altra: da qui la potenza (e i tranelli) dell’esecuzione fuori
ordine. Google Colab è un ambiente Jupyter gestito, con acceleratori
hardware (GPU/TPU) accessibili gratuitamente entro certi limiti, ideale per
prototipazione e didattica riproducibile.
Preparare l’ambiente: la prima riga eseguita davvero#
Il codice si può leggere, ma è fatto per essere provato.
Senza installare niente#
Quasi ogni capitolo esiste anche come notebook su Google Colab, con tutte le sue celle in ordine e già pronte: gira nel browser, le librerie sono già installate, e per eseguire una cella si preme il triangolino che ha accanto. Non serve altro che un browser e un account Google. È il modo più rapido per provare gli esempi mentre si legge.
Il collegamento, dove c’è, sta in testa al capitolo («Esegui il codice»).
Sul proprio computer#
Serve un terminale, cioè la finestra in cui si scrivono comandi al computer
invece di cliccare: si chiama Terminale su macOS e Linux, Prompt dei comandi
(o PowerShell) su Windows. Serve anche Python 3.11 o successivo: le versioni
delle librerie usate negli esempi (NumPy 2, Pandas 3, Matplotlib 3.11) non
girano su un Python più vecchio. Su Linux un Python di solito c’è già, ma va
controllato, perché una distribuzione non recente ne ha uno più datato. Su macOS
no: /usr/bin/python3 è un segnaposto che esiste per gli strumenti da
sviluppatore di Apple, al primo uso propone di installarli e contiene una
versione vecchia, quindi anche lì Python si scarica da python.org, come su
Windows. Su Windows, durante l’installazione, si spunta «Add Python to PATH»: è
la casella che dice al terminale dove si trova Python, e senza di essa il
terminale risponderà che Python non lo trova. Poi, quattro gesti (su Windows il
comando si chiama python, oppure py, al posto di python3):
python3 --version        # c'è? risponde con il numero, per esempio "Python 3.12.3"
python3                  # apre l'interprete: compaiono tre maggiori, >>>
>>> import this          # si scrive un'istruzione, si preme Invio
>>> exit()               # si esce
Quei tre maggiori si chiamano prompt: sono l’invito a scrivere, il modo in cui l’interprete dice «tocca a te». Finché li vedi, sei dentro l’interprete e non nel terminale.
Le istruzioni scritte all’interprete si perdono quando lo si chiude. Per tenere
un programma lo si scrive in un file di testo con estensione .py (per esempio
primo.py, con dentro print("ciao")) e lo si esegue con python3 primo.py.
Il file lo si può scrivere con qualunque editor di testo, ma conviene
usarne uno che conosca Python e segnali gli errori mentre scrivi: i due più
diffusi sono Visual Studio Code e PyCharm, gratuiti entrambi. Se un
programma non finisce più (capita: basta un ciclo scritto male) si ferma
premendo Ctrl+C.
Le librerie, e l’ambiente in cui metterle#
Le librerie scientifiche non arrivano con Python: si installano con pip, il
programma che va a prenderle in rete (da PyPI, l’archivio pubblico dei
pacchetti Python) e le mette al posto giusto. Prima di installarle, però,
serve un posto dove metterle, per una ragione che di solito si impara a proprie
spese. Hai un lavoro che gira, non lo tocchi da mesi, e nel frattempo per un
esercizio nuovo aggiorni una libreria. La versione nuova ha cambiato il nome di
un comando, il lavoro di prima smette di funzionare, e nessuno ti dice che è
stato l’aggiornamento: te ne accorgi settimane dopo, quando riapri quel
progetto e non parte più.
Il rimedio è un ambiente virtuale: una cartella dentro il progetto con un
proprio interprete e le proprie librerie, separate da quelle di tutti gli altri
progetti. Si crea una volta, si attiva, e da lì pip installa dentro
l’ambiente:
python3 -m venv .venv           # crea l'ambiente dentro la cartella del progetto
source .venv/bin/activate       # lo attiva (su Windows: .venv\Scripts\activate)
pip install numpy pandas matplotlib scikit-learn
Su Debian e su Ubuntu il primo dei tre comandi può fermarsi lamentando che
manca ensurepip. Quelle due distribuzioni consegnano Python senza il modulo
che crea gli ambienti, e il modulo va chiesto a parte, una volta sola, con
sudo apt install python3-venv. La parola sudo davanti a un comando
significa «questo lo faccio da amministratore», e il terminale chiederà la
password: serve perché stiamo aggiungendo qualcosa al computer intero, e non al
singolo progetto.
Due parole sui comandi. Il -m vuol dire «esegui il modulo che si chiama
così», dove un modulo è un file di Python che si può tanto eseguire quanto
importare; è il modo di lanciare uno strumento incluso in Python invece
che un file scritto da te, e venv è quello strumento. source esegue le
istruzioni contenute in un file senza aprire una finestra nuova, e serve
proprio perché l’attivazione deve valere per il terminale che hai davanti. Che
abbia funzionato lo vedi subito: all’inizio della riga del terminale compare
(.venv), e resta lì finché l’ambiente è attivo.
Finito di lavorare, dall’ambiente si esce con deactivate, e quel (.venv)
sparisce. Per ritrovare le stesse librerie su un’altra macchina,
pip freeze > requirements.txt ne scrive l’elenco con le versioni in un file,
e pip install -r requirements.txt le reinstalla.
Ci sono anche altri strumenti per gli ambienti: se in una guida senti nominare
conda oppure uv, fanno lo stesso lavoro con altri comandi. venv e pip
bastano per tutto quello che serve qui.

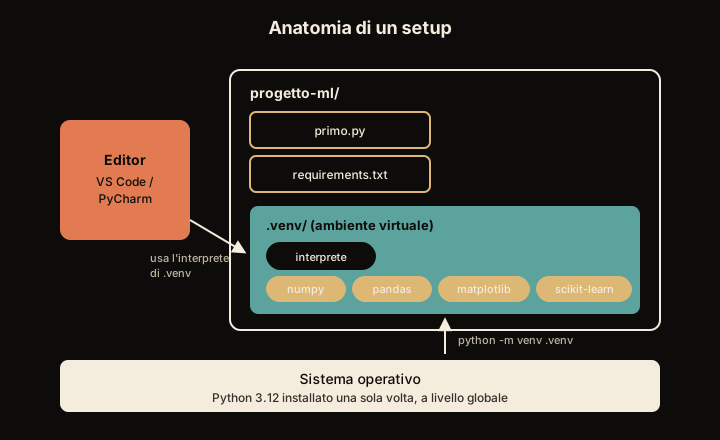
Fig. 2.2 L’ambiente virtuale è una scatola dentro il progetto. Le librerie che installa non escono da lì, e due progetti sulla stessa macchina possono usare versioni diverse della stessa libreria senza incontrarsi.#
La separazione di Fig. 2.2 è quella che evita il progetto che non parte più: l’aggiornamento resta dentro l’ambiente del progetto che lo ha chiesto. Il Python di sistema resta intoccato, e cestinare un progetto significa cestinare anche il suo ambiente.
Per usare i notebook sulla propria macchina, pip install jupyterlab e poi
jupyter lab li aprono nel browser, come su Colab.
Dagli strumenti al linguaggio#
L’ambiente è pronto e manca il linguaggio: la sintassi di base e i contenitori che Python offre di suo (liste, tuple, dizionari, insiemi), poi le tre librerie con cui si lavora sui numeri, sulle tabelle e sui grafici. Sono gli attrezzi con cui il capitolo di matematica fa i suoi conti e quello sul machine learning costruisce i primi modelli.
Da ricordare
Python domina l’AI perché si legge, perché per quasi tutto c’è già una libreria pronta e perché lo usa moltissima gente. Veloce non lo è, e non ne ha bisogno: i conti pesanti li fa fare a librerie scritte in linguaggi più vicini alla macchina, e si limita a dare gli ordini.
Le librerie sono una torre: NumPy alla base (i numeri), sopra Pandas (le tabelle), Matplotlib (i grafici) e scikit-learn. PyTorch, con cui si costruiscono le reti neurali, sta accanto alla torre più che sopra: i conti se li fa da sé, e con NumPy si limita a scambiarsi i dati.
Il guadagno di scrivere il conto sul blocco intero invece che numero per numero sta nel pedaggio che Python paga a ogni giro di un ciclo, e che così si paga una volta sola.
Il codice si prova in tre posti: l’interprete (scrivi una riga, risponde subito), i notebook (quaderni fatti di celle) e Colab, che dà notebook e schede grafiche gratis nel browser.
Nei notebook le celle condividono la memoria, e c’è un tranello: eseguirle in disordine può far comparire un risultato che, rileggendo la pagina, non torna. Si rimedia rieseguendo tutto dall’alto in basso.
Sul proprio computer le librerie di ogni progetto vanno in un ambiente virtuale (
python3 -m venv), una cartella-scatola che le tiene separate da quelle di tutti gli altri progetti.
Da ricordare
Python domina l’AI per leggibilità, ecosistema e comunità più che per velocità bruta: fa da collante a librerie compilate in C/C++/CUDA.
Lo stack scientifico è a strati: NumPy alla base, poi Pandas, Matplotlib e scikit-learn, che su di lui poggiano davvero. PyTorch e TensorFlow stanno invece a fianco: hanno un motore di calcolo proprio, e con NumPy si limitano a scambiare i dati.
Il guadagno della vettorizzazione viene dall’overhead dell’interprete che sparisce a ogni iterazione: due o tre ordini di grandezza sul ciclo Python equivalente. I prodotti fra matrici passano per BLAS.
Si lavora nell’interprete, nei notebook Jupyter (un kernel che mantiene lo stato, da cui i tranelli dell’esecuzione fuori ordine) e su Colab, che offre GPU gratuite nel browser; in locale, un ambiente virtuale per progetto (
python3 -m venv) tiene separate le dipendenze.
L’ambiente adesso c’è, e finora è rimasto vuoto. Quello che ci va dentro sono poche cose ripetute molte volte: dare un nome a un valore, tenerne insieme tanti, decidere, ripetere, e mettere da parte un pezzo di lavoro perché risponda a un nome. Sono le basi del linguaggio, e bastano già a scrivere il primo programma che serva a qualcosa.