


Attenzione lineare#
Centomila parole sono la lunghezza di un romanzo, e per leggerlo un Transformer deve confrontare ogni parola con tutte le altre: centomila per centomila, cioè dieci miliardi di confronti, e non una volta sola, ma in ognuno degli strati della rete, che sono decine. Nel 2020 Angelos Katharopoulos e tre colleghi, fra la Svizzera e gli Stati Uniti, provano ad aggirare quel conto. Il mondo dell’intelligenza artificiale celebrava allora i Transformer come il modello che aveva chiuso l’epoca delle reti ricorrenti, quelle che leggono una parola alla volta; il loro articolo si intitola invece Transformers are RNNs, «i Transformer sono reti ricorrenti» (RNN è la sigla inglese) [KVPF20].
La tesi è tanto semplice quanto spiazzante. Nell’attenzione la somiglianza fra due parole passa per l’esponenziale della softmax, la funzione che trasforma i punteggi in pesi. Se al suo posto si mette una somiglianza più semplice, un prodotto scalare fra versioni trasformate della query e della chiave, che si spezza in un pezzo per chi interroga e uno per chi risponde, l’attenzione causale (quella in cui ogni parola guarda soltanto le precedenti) si riscrive esattamente come una rete ricorrente. Il Transformer, il modello che aveva appena spodestato le reti ricorrenti, ricade in una di loro. Il re, sotto il mantello, era un vecchio parente.
Questa equivalenza apre una porta. L’attenzione dei Transformer si paga due volte, e il primo conto è quello appena fatto: ogni parola guarda tutte le altre, quindi raddoppiando la lunghezza del testo il lavoro quadruplica. È il costo quadratico, che si scrive \(O(n^2)\), con \(n\) il numero di token (un token è quasi sempre una parola o un pezzo di parola, e qui li chiameremo spesso parole): dieci volte il testo, cento volte il lavoro.
Il secondo conto si paga durante la generazione, quando il modello scrive un token dopo l’altro. Per non ricalcolare a ogni passo quello che ha già calcolato, il modello conserva per ogni token, in ogni strato, la sua chiave (l’etichetta con cui lo si ritrova) e il suo valore (l’informazione che porta): è la KV cache, descritta nella sezione sull’attenzione in pratica. Cresce di una coppia chiave-valore a ogni token e non si libera mai; sui contesti lunghi, e moltiplicata per le richieste servite insieme, è questa memoria la prima voce a limitare quanto testo un modello riesce a tenere aperto.
La provocazione di Katharopoulos indica una via per aggirare tutti e due i conti. Se l’attenzione, cambiata la somiglianza, è una rete ricorrente, allora la si può calcolare come una ricorrenza, cioè aggiornando a ogni token una memoria di dimensione fissa, lo stato \(\mathbf{S}_t\), a partire da com’era al token prima. Il lavoro torna a crescere in modo lineare, cioè proporzionale alla lunghezza (il doppio di testo, il doppio di lavoro), e la memoria non cresce affatto. Da qui il nome, attenzione lineare: da quadratico a lineare.

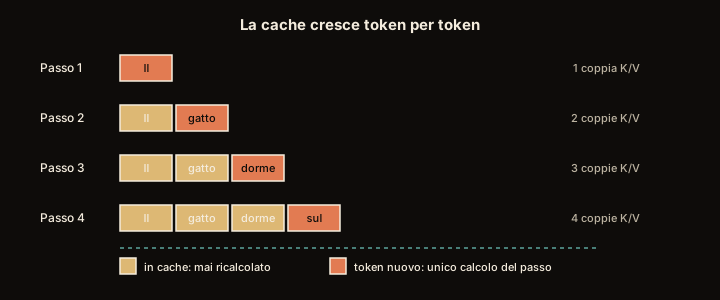
Fig. 17.1 La cache che non smette di crescere. Ogni token generato ne aggiunge un pezzo, e quel pezzo resta: la memoria occupata cresce con quanto si è scritto finora, e nessun passo la libera.#
Fig. 17.1 mostra la KV cache che cresce un token dopo l’altro: è il secondo dei due conti, quello che si paga durante la generazione. Una ricorrenza a stato fisso non fa crescere niente: comprime il passato in una memoria di taglia costante, e la domanda diventa quanto si perde nel comprimerlo.
Il compromesso che tutti inseguono#
Addestramento e generazione costano in modo diverso, ed è su questa differenza che giocano le architetture lineari.
L’addestramento si fa una volta sola: il testo esiste già tutto, e il modello lo attraversa per imparare. La generazione viene dopo, quando il modello è in uso e scrive parola per parola un testo che non esiste ancora (si chiama anche inferenza, che è il nome tecnico di questa fase). Le due cose costano in modo diverso, e un modello può essere bravo in una e disastroso nell’altra.
Le due grandi famiglie di modelli per sequenze hanno infatti un pregio e un difetto speculari. I Transformer si addestrano in fretta, perché guardano tutta la frase in una volta e sfruttano a pieno le schede grafiche; ma per farlo devono tenere tutto sott’occhio, e più il testo è lungo più questo costa, finché il conto diventa insostenibile. Le vecchie reti ricorrenti fanno il contrario: leggono una parola alla volta portandosi dietro un riassunto di dimensione fissa, quindi quando generano costano poco, e il conto da fare per ogni parola resta lo stesso anche dopo mille pagine; ma proprio perché procedono in fila, addestrarle è lento.
Il sogno è avere le due cose insieme: la velocità di addestramento dei Transformer e il basso costo in generazione delle reti ricorrenti. Sembra una richiesta contraddittoria, perché guardare tutto in una volta e procedere in fila sono due modi opposti di lavorare. La via d’uscita sta nel fatto che si tratta di uno stesso conto, e uno stesso conto si può fare in due maniere. Tutto insieme, ed è così che il modello impara; una parola alla volta, ed è così che il modello scrive. Il risultato che ne esce è lo stesso. È ciò che promette l’attenzione lineare, e con lei tutta la famiglia di ricorrenze che le sta intorno.
Formalizziamo il compromesso. L’attenzione softmax costa \(O(n^2 d)\) nella lunghezza \(n\) della sequenza, dove \(d\) è la dimensione di query, chiavi e valori di una testa (la matrice di affinità è \(n \times n\)), e in generazione autoregressiva conserva tutte le chiavi e i valori passati: memoria che cresce linearmente con il contesto. Una rete ricorrente il cui stato ha anch’esso dimensione \(d\) costa invece \(O(n d^2)\), lineare in \(n\), e quello stato non cresce mai; ma il passo \(t\) dipende dal passo \(t-1\): niente parallelismo lungo la sequenza.
L’attenzione lineare vive nel punto d’incontro: espone due forme equivalenti dello stesso calcolo. Una forma parallela, per addestrare sull’intera sequenza sfruttando le GPU (in pratica spezzata a blocchi di \(B\) token, per tenere il costo lineare); e una forma ricorrente, per generare a costo e memoria costanti per token: senza una cache che cresce. La tabella mette i costi a confronto per il solo mescolamento fra token, con una testa di dimensione \(d\) (le proiezioni che producono query, chiavi e valori costano lo stesso in tutti i casi); i «passi in sequenza» sono quelli che devono aspettare il precedente, cioè il lavoro che una GPU non può fare insieme.
addestramento: lavoro |
addestramento: passi in sequenza |
generazione: lavoro per token |
generazione: memoria |
|
|---|---|---|---|---|
attenzione softmax, con KV cache |
\(O(n^2 d)\) |
\(O(1)\) |
\(O(n d)\) |
\(O(n d)\) |
rete ricorrente, stato vettoriale di dimensione \(d\) |
\(O(n d^2)\) |
\(n\) |
\(O(d^2)\) |
\(O(d)\) |
attenzione lineare, forma ricorrente |
\(O(n d^2)\) |
\(n\) |
\(O(d^2)\) |
\(O(d^2)\) |
attenzione lineare, a blocchi di \(B\) token |
\(O(nBd + nd^2)\) |
\(n/B\) |
\(O(d^2)\) |
\(O(d^2)\) |
È la proprietà che inseguono, con ingredienti diversi, le architetture lineari e gli State Space Model: in addestramento il lavoro lineare e i pochi passi in sequenza della forma a blocchi, in generazione il costo fisso per token della forma ricorrente.
Una sola ricorrenza, molti modelli#
Una sola struttura tiene insieme l’attenzione lineare e gli State Space Model (in italiano modelli a spazio degli stati, che alla stessa forma arrivano partendo dai sistemi dinamici). Quasi tutti questi modelli conservano uno stato di dimensione fissa e a ogni token lo riscrivono come la somma di due pezzi: ciò che sopravvive dello stato precedente, e ciò che il token scrive. Si distinguono soprattutto per la regola con cui lo stato precedente sopravvive: se ci si limita ad accumulare, se si impara a dimenticare, se si corregge ciò che è già scritto. Passare dall’attenzione lineare a RetNet, a Mamba, a DeltaNet significa cambiare quella regola, e i nomi che seguono sono varianti di uno stesso schema. L’eccezione è la cella sLSTM di xLSTM, la cui ricorrenza non è lineare: la si incontra con le architetture lineari.
Lo stato è una tabella di numeri, righe e colonne, sempre della stessa taglia (in matematica una tabella così si chiama matrice, e la parola tornerà spesso). Le reti ricorrenti dei modelli di sequenza lo chiamavano il riassunto di quello che si è letto fin lì, e il nome è giusto a metà: un riassunto fa pensare a un foglio con delle frasi sopra, e qui di frasi non ce ne sono, ci sono solo numeri.
Che una tabella di numeri possa contenere delle parole suona strano, e su questo regge tutto il resto: dentro un modello una parola è una fila di qualche centinaio di numeri (le posizioni di quella fila si chiamano canali). Etichetta e informazione sono due file di numeri anche loro, ricavate dalla parola. Quindi «scrivere nello stato» vuol dire sommare dei numeri alle caselle, e «rileggerlo» vuol dire rifare dei conti.
Ogni parola che passa deposita così un’associazione, «a questa etichetta corrisponde questa informazione», che si somma a quello che c’è già scritto invece di aggiungere una riga nuova. Ecco perché la memoria non cresce: a cambiare sono i numeri dentro le caselle, non il numero di caselle.
Il passaggio da una parola alla successiva è fatto di due gesti. Uno decide che fine fanno i numeri già scritti: possono restare com’erano, possono affievolirsi tutti un poco, oppure si può tornare su un’associazione sbagliata e correggerla. L’altro deposita l’associazione della parola appena letta. Il modo di depositare cambia poco da un modello all’altro (al più se ne dosa la quantità); il modo di trattare quello che c’era già cambia parecchio, ed è soprattutto lì che un modello si distingue dagli altri.
Sono reti ricorrenti lineari con uno stato di dimensione fissa, aggiornato a ogni token da una ricorrenza della forma
Lo stato \(\mathbf{S}_t\) è una piccola matrice (una memoria che associa chiavi a valori) e il pedice \(t\) è il passo, cioè il token appena letto: \(\mathbf{S}_{t-1}\) è la memoria al passo precedente, la transizione decide che cosa ne sopravvive, la scrittura è ciò che il token corrente aggiunge. Il fattore di transizione è ciò che più distingue un modello dall’altro. Il termine di scrittura cambia meno: al più lo moltiplica un fattore scalare (\(\beta_t\) nella delta rule, \(i_t\) nella cella mLSTM di xLSTM) o, in RWKV-7, la chiave con cui si scrive è diversa da quella con cui si cancella.
Una memoria di taglia fissa#
Il percorso ha tre tappe. La prima, dalla softmax alla ricorrenza, mostra che cosa va cambiato nella somiglianza fra query e chiave (il trucco del kernel) perché il lavoro smetta di crescere col quadrato della lunghezza, come il nuovo conto diventi una ricorrenza con uno stato di dimensione fissa, e perché uno stato che sa soltanto sommare si confonde presto: le scritte si sovrappongono fin da subito, e bastano poche voci perché non ci si legga più niente di preciso. La seconda, scrivere meglio nella memoria, porta i due rimedi: il gate, che lascia sbiadire ciò che è vecchio, e la delta rule, che prima di scrivere corregge ciò che c’è già. Li riassume in una tabella in cui i modelli si distinguono soprattutto per come trattano lo stato precedente. La terza, le architetture lineari, rimonta questi pezzi in tre modelli completi, RetNet, RWKV e xLSTM. Chiude un notebook, una pagina di codice da eseguire, che calcola lo stesso strato nei due modi, tutto insieme e una parola alla volta, e controlla che il risultato coincida.
Da ricordare
Cambiato il modo di misurare quanto due parole si somigliano (con un calcolo che si spezza in un pezzo per ciascuna delle due, al posto di quello della softmax), il Transformer che scrive, dove ogni parola guarda soltanto quelle venute prima, si riscopre una rete ricorrente [KVPF20]: legge una parola alla volta portandosi dietro una memoria di dimensione sempre uguale, lo stato.
È la via per aggirare i due conti che i Transformer pagano sui testi lunghi: il lavoro che cresce a valanga con la lunghezza (raddoppiando il testo quadruplica) e la KV cache, la memoria di appoggio che si allunga a ogni parola generata. Lineare vuol dire proprio questo: il lavoro torna a essere proporzionale, il doppio di testo per il doppio di lavoro, e la memoria non si allunga affatto.
Il compromesso che tutta la famiglia insegue: la velocità di addestramento dei Transformer (quando il modello impara, e il testo c’è già tutto) e il basso costo in generazione delle vecchie reti ricorrenti (quando il modello scrive, una parola alla volta), perché lo stesso calcolo si può fare in due modi equivalenti, tutto insieme oppure una parola alla volta.
Il filo che lega l’attenzione lineare e gli State Space Model: quasi tutti questi modelli tengono uno stato di taglia fissa e lo aggiornano a ogni parola, e a distinguerli è soprattutto il modo di trattare quello che c’era già: chi si limita ad aggiungere, chi impara a dimenticare, chi corregge ciò che è già scritto.
Il percorso: come l’attenzione diventa economica, poi come si scrive meglio nello stato (dimenticare e correggere), infine le architetture concrete (RetNet, RWKV, xLSTM).
Da ricordare
Con una somiglianza che si fattorizza, \(\text{sim}(\mathbf{q},\mathbf{k}) = \phi(\mathbf{q})^\top\phi(\mathbf{k})\), al posto dell’esponenziale della softmax, l’attenzione causale diventa una rete ricorrente a stato fisso [KVPF20]: è la via per aggirare il costo quadratico e la KV cache crescente dei Transformer.
Il compromesso inseguito da tutta la famiglia: addestramento parallelo come i Transformer e inferenza a memoria costante come le RNN, grazie a due forme equivalenti (parallela e ricorrente) dello stesso calcolo.
Il filo comune all’attenzione lineare e agli State Space Model: RNN lineari con stato di dimensione fissa, \(\mathbf{S}_t = \mathbf{S}_{t-1}\,(\text{transizione}_t) + (\text{scrittura}_t)\), che si distinguono soprattutto per la transizione di stato (la scrittura cambia al più per un fattore scalare, o per una chiave di scrittura diversa da quella di rimozione). Fa eccezione la sLSTM di xLSTM, ricorrente non lineare.
Il percorso: dall’attenzione lineare (kernel e ricorrenza) → a come scrivere meglio nella memoria (gate e delta rule) → alle architetture concrete (RetNet, RWKV, xLSTM).