


Imparare insieme: quando l’ambiente impara anche lui#
Negli anni Venti il biologo marino Umberto D’Ancona mise in fila i registri dei mercati ittici dell’alto Adriatico (Venezia, Trieste e Fiume) per gli anni dal 1905 al 1923, e trovò un fatto che non sapeva spiegare. Durante gli anni della Grande Guerra, quando la pesca si era quasi fermata, la quota dei pesci predatori (squali, razze) sul totale del pescato era cresciuta parecchio, e finita la guerra era tornata a scendere. Meno pesca per tutti, e a guadagnarci erano stati solo quelli che mangiano gli altri.
D’Ancona portò il problema a Vito Volterra, di cui nel 1926 sarebbe diventato genero. Volterra rispose quello stesso anno, nelle memorie dell’Accademia dei Lincei, con Variazioni e fluttuazioni del numero d’individui in specie animali conviventi. La risposta erano due formule, una per le prede e una per i predatori, che dicono con che velocità cresce o cala ciascuna popolazione; e in ciascuna delle due compare l’altra, perché i predatori crescono se ci sono molte prede e le prede calano se ci sono molti predatori. Oggi si chiamano equazioni di Lotka-Volterra, perché alle stesse era arrivato l’anno prima Alfred Lotka, studiando le reazioni chimiche che oscillano.
La risposta al quesito di D’Ancona c’era, ma il punto decisivo è un altro: quelle due popolazioni non si fermano mai su un valore di equilibrio, ci girano attorno all’infinito. Segnate su un piano, le prede in orizzontale e i predatori in verticale, gli anni disegnano un anello chiuso che ripassa sempre da dove era partito. Ognuna insegue l’altra, e l’altra nel frattempo si è spostata.
Quelle orbite torneranno alla fine della sezione, con altri nomi. Le sezioni precedenti hanno progettato il coordinamento: chi parla con chi, con quali messaggi, con quale regola di decisione. Qui il coordinamento non lo progetta nessuno: gli agenti devono impararlo, per tentativi e ricompense, come il bambino in bicicletta del capitolo sul reinforcement learning. E il primo fatto da mettere in chiaro è che, con più agenti che imparano insieme, le garanzie di convergenza viste in quel capitolo non valgono più.
Il terreno si muove sotto i piedi#
Il reinforcement learning classico poggia su un’ipotesi precisa: l’ambiente è un processo decisionale di Markov stazionario, cioè la transizione \(P(s' \mid s, a)\) e la ricompensa \(r(s, a)\) non cambiano nel tempo. Fisse sono le regole del mondo (se faccio questa mossa in questa situazione, quello che succede dopo obbedisce sempre alla stessa legge) e fissi sono i premi (la stessa cosa vale sempre altrettanto). Su quell’ipotesi si dimostra che il Q-learning tabellare converge al valore ottimo, e quindi a una strategia ottima, purché ogni mossa venga provata in ogni situazione abbastanza spesso. Se l’ambiente cambia mentre si impara, a cadere è proprio quella dimostrazione.
Vai al lavoro e hai due strade: il viale grande o una scorciatoia fra le case. Provi la scorciatoia per un mese intero e tieni il conto: risparmia dieci minuti. Non è un’impressione, l’hai misurata trenta volte.
Il mese dopo la stessa scorciatoia ne risparmia cinque. Il terzo mese, nessuno. Il quarto ci metti di più che sul viale. Non è cambiata la strada, non ci sono lavori in corso, e la sfortuna non c’entra: anche gli altri automobilisti hanno un navigatore, e anche loro hanno imparato la stessa cosa che avevi imparato tu. Quando eri l’unico a saperlo la scorciatoia era vuota; adesso che lo sanno tutti, la scorciatoia è la coda.
Il punto è più fondo di quanto sembri. Hai misurato bene, hai fatto trenta prove, e il risultato è comunque scaduto. Un agente che impara da solo può fidarsi di quello che ha misurato ieri, perché il mondo di ieri è quello di oggi. Quando anche gli altri imparano, la misura di ieri parlava di un mondo che non c’è più: non perché il mondo sia capriccioso, ma perché il mondo, in buona parte, sono loro.
Il quadro formale è il gioco stocastico enunciato nella pagina d’apertura del capitolo: \(N\) agenti, uno spazio di stati \(\mathcal{S}\), uno spazio di azioni per ciascun agente, una transizione \(P(s' \mid s, a)\) che dipende dall’azione congiunta \(a = (a^1, \dots, a^N)\) e una ricompensa \(r^i\) per ciascuno. Dal punto di vista del solo agente \(i\), il processo osservato ha transizione
dove \(a^{-i}\) è l’azione congiunta di tutti tranne \(i\), \(\pi^j_t\) è la policy dell’agente \(j\) al passo di addestramento \(t\) e \(a = (a^i, a^{-i})\). La transizione vera \(P\) è fissa; quella indotta \(P^i_t\) no, e lo si legge dal pedice: cambia mentre gli altri aggiornano i propri parametri. L’agente \(i\) non vive in un MDP, e sul suo stato la proprietà di Markov non regge, perché per prevedere \(s'\) non bastano \((s, a^i)\): servirebbe sapere a che punto dell’addestramento sono gli altri.
Cade con essa la garanzia di convergenza del Q-learning tabellare, che si dimostra come approssimazione stocastica su un operatore di Bellman fisso: contrazione di fattore \(\gamma\), punto fisso unico, convergenza da qualunque inizializzazione purché ogni coppia stato-azione sia visitata infinite volte e i passi soddisfino le condizioni di Robbins-Monro. Se \(P^i_t\) si muove, l’operatore cambia a ogni passo e il punto fisso inseguito non sta fermo. In pratica la stessa coppia \((s, a^i)\) restituisce ritorni diversi non per la stocasticità di \(P\), ma perché l’avversario di oggi non è quello di ieri; e il campione pescato dal buffer di experience replay descrive una partita che non si sta più giocando. Il capitolo sul deep reinforcement learning aveva già elencato le fragilità di quella famiglia di algoritmi (campioni correlati, bersaglio mobile, la deadly triad): il caso multi-agente le aggrava tutte, perché il bersaglio si muove per una ragione in più.
C’è un secondo strato di difficoltà, e nei sistemi reali non è evitabile: quasi mai un agente vede lo stato globale. Il difensore non vede l’attaccante alle sue spalle, il drone non vede l’altro lato del capannone, l’agente che scrive il codice non vede la conversazione dell’agente che ha letto la specifica. Ognuno decide su un’osservazione parziale e deve dedurre il resto, compreso quello che gli altri stanno per fare.
Una squadra di soccorso entra in un capannone pieno di fumo, senza radio. Ciascuno vede tre metri davanti a sé e nient’altro, e non può chiedere niente a nessuno. Tutto quello che la squadra farà deve essere deciso prima di entrare, e deve essere un piano completo: non «vai a destra», ma «se davanti a te vedi una porta chiusa vai a destra, se vedi una scala scendi, se non vedi niente prosegui», per ogni cosa che ciascuno potrebbe trovarsi davanti.
Contiamo quanti piani diversi si potrebbero scrivere, nel caso più misero immaginabile: due soccorritori, due sole cose che ciascuno può vedere, due sole cose che può fare, e tre passi in tutto.
Il piano di una persona deve dire che cosa fare al primo passo, e lì il caso è uno solo perché non ha ancora visto niente. Al secondo passo deve dire che cosa fare per ciascuna delle due cose che può aver visto: due casi. Al terzo, per ciascuna delle combinazioni di due osservazioni di fila, cioè le due del primo passo per le due del secondo: quattro casi. Uno più due più quattro fa sette decisioni da prendere, e ognuna è fra due azioni: bisogna quindi moltiplicare il due per sé stesso sette volte, e vengono 128 piani diversi. Per due persone insieme le coppie di piani sono 128 per 128, cioè 16.384.
Sembra poco. Portiamo i passi da tre a cinque, e le decisioni per persona diventano uno più due più quattro più otto più sedici, cioè trentuno: adesso il due va moltiplicato per sé stesso trentuno volte, e fa poco più di due miliardi di piani per una persona sola. Le coppie da confrontare sono due miliardi per due miliardi, cioè oltre quattro miliardi di miliardi. E siamo ancora a due soccorritori, due cose da vedere, due da fare, cinque passi. Provarli tutti, dunque, non si può, e un computer più veloce non cambierebbe le cose: i teorici della complessità hanno dimostrato che di questo problema non esiste una soluzione esatta in tempo utile, e che non basta nemmeno accontentarsi di una risposta approssimata con la garanzia di sbagliare poco, perché anche quella resta fuori portata [OA16]. Restano le risposte approssimate senza garanzia, che è quello che si fa.
Il modello che raccoglie i due strati (più agenti che imparano, ciascuno con osservazione parziale, ricompensa comune) è il Dec-POMDP, la tupla \((N, \mathcal{S}, \{\mathcal{A}^i\}, P, R, \{\Omega^i\}, O, \gamma)\): gli agenti, gli stati, le azioni di ciascuno, la transizione \(P(s' \mid s, a)\) sull’azione congiunta, una ricompensa unica \(R(s,a)\) per tutta la squadra, gli insiemi di osservazioni \(\Omega^i\) e la funzione \(O(o \mid a, s')\) che dà la probabilità di ricevere le osservazioni \(o = (o^1, \dots, o^N)\) [OA16]. La policy dell’agente \(i\) non è una funzione dello stato ma della propria storia di osservazioni, \(\pi^i(a^i \mid \bar{o}^i)\), perché nessuna osservazione locale è markoviana; e il modello non prevede alcun canale di comunicazione esplicito: gli agenti si influenzano solo in modo implicito, attraverso azioni che cambiano lo stato e quindi le osservazioni altrui, e il coordinamento dev’essere interamente contenuto nelle policy fissate in anticipo (la comunicazione esplicita richiede un’estensione, il Dec-POMDP-Com, in cui i messaggi sono azioni con un costo).
Il prezzo di questa generalità si vede già contando. Una policy deterministica di \(i\) a orizzonte \(h\) assegna un’azione a ogni storia di osservazioni di lunghezza \(0, \dots, h-1\), e le storie sono \((|\Omega^i|^h - 1)/(|\Omega^i| - 1)\); le policy sono quindi \(|\mathcal{A}^i|^{(|\Omega^i|^h - 1)/(|\Omega^i| - 1)}\), e i profili congiunti il loro prodotto su \(i\): doppiamente esponenziale in \(h\), esponenziale in \(N\). Con due agenti, \(|\mathcal{A}^i| = |\Omega^i| = 2\) e \(h = 5\) fanno \(2^{62} \approx 4{,}6 \cdot 10^{18}\) profili, e il conto non esagera la difficoltà. Risolvere esattamente un Dec-POMDP a orizzonte finito è NEXP-completo, e lo è già con due soli agenti; per confronto lo stesso problema è P-completo per un MDP e PSPACE-completo per un POMDP, quindi la sola decentralizzazione fa saltare due gradini di complessità. A differenza di quanto succede con NP, qui non c’è nessuna congettura di mezzo: dal teorema di gerarchia temporale segue \(\mathrm{P} \subsetneq \mathrm{NEXP}\), e un problema NEXP-completo non può stare in P. Un algoritmo polinomiale esatto non esiste, ed è dimostrato. Né serve accontentarsi: anche calcolare una soluzione approssimata entro un errore assoluto fissato resta NEXP-difficile, quindi la rinuncia all’ottimo non compra un algoritmo trattabile [OA16].
Nessun metodo, quindi, risolve esattamente un Dec-POMDP: tutti approssimano. I metodi che seguono (la baseline controfattuale, l’addestramento centralizzato, la fattorizzazione del valore, il self-play) sono approssimazioni diverse, e di ciascuna conta l’ipotesi su cui si regge.
Chi è stato bravo?#
Il libro ha già incontrato l’assegnazione del merito, ma su un altro asse. Nel reinforcement learning il problema era temporale: il premio arriva alla fine della partita, e bisogna capire quale mossa se lo sia guadagnato. La prima risposta era distribuirlo all’indietro sulle mosse della partita, pesando meno quelle più lontane nel tempo (lo sconto \(\gamma\)).
Poi si è affinata nell’architettura attore-critico della sezione sui gradienti di policy: l’attore è la policy che sceglie le mosse, il critico una stima di quanto valga la situazione \(s\) in cui ci si trova, il valore \(V(s)\): non sceglie niente e fa da termine di paragone, così che l’attore venga corretto dal vantaggio («hai preso due più di quanto ci si aspettasse») invece che dal ritorno grezzo («hai preso otto»).
Con più agenti, al merito nel tempo se ne aggiunge uno fra compagni, e la domanda cambia di natura: la squadra ha vinto, chi è stato bravo?
È il lavoro di gruppo a scuola, con un voto solo per tutti. Cinque studenti, una relazione, un otto. Ognuno dei cinque porta a casa lo stesso otto: quello che ha scritto metà del testo, quello che ha corretto le note, e quello che ha mandato tre messaggi e poi è sparito.
Sul quaderno di un agente che impara succede una cosa precisa, e non è che diventi furbo. L’agente sparito registra «quello che ho fatto ha fruttato otto», ma lo registra per qualunque cosa abbia fatto: stare fermo, scrivere una riga a caso, andarsene. Tutte le sue azioni ricevono lo stesso voto, e un voto uguale per tutte le risposte non insegna niente, esattamente come un professore che dà otto a chiunque. Non impara a essere pigro: non impara e basta.
E c’è la seconda metà del problema, che riguarda anche chi lavora sul serio. Chi ha scritto metà del testo vorrebbe capire quali sue scelte hanno alzato il voto, ma il voto si muove anche per merito (o per colpa) degli altri quattro, che nel frattempo cambiano anche loro. Il suo contributo c’è, ma è coperto dal rumore di quello che fanno i compagni: più sono, meno si sente.
Con ricompensa comune, \(r^i = r\) per ogni \(i\), il gradiente di policy dell’agente \(i\) è
dove \(\theta^i\) sono i parametri dell’agente \(i\), \(\pi^i_{\theta^i}\) la sua policy, \(o^i_t\) la sua osservazione al passo \(t\) e \(G_t\) il ritorno scontato della squadra. Il fattore di sinistra riguarda solo \(i\); quello di destra riguarda tutti. L’agente \(i\) vede il proprio ritocco moltiplicato per un numero a cui hanno contribuito anche gli altri \(N-1\).
Quantifichiamo, su un modello dichiaratamente di comodo: lo stimatore così com’è, senza alcuna baseline, e un ritorno che si scompone in contributi indipendenti \(G = \sum_j g^j\) con \(\mathrm{Var}(g^j) = \sigma^2\) per ogni \(j\). Il segnale che interessa a \(i\) è \(g^i\) mentre il rumore che gli arriva addosso è la somma degli altri, di varianza \((N-1)\sigma^2\). Il rapporto segnale-rumore, misurato in deviazioni standard, vale
(il fattore \(\nabla_{\theta^i}\log\pi^i\) moltiplica allo stesso modo il termine utile e il resto, e nel rapporto si semplifica: se i contributi dei compagni hanno media zero e non dipendono dalle mosse di \(i\), la parte che portano nel gradiente ha media zero e varianza \((N-1)\,\sigma^2\,\mathbb{E}\|\nabla_{\theta^i}\log\pi^i\|^2\)), e sotto quelle ipotesi si degrada come la radice del numero di compagni: con nove compagni (dieci agenti in tutto) il segnale utile vale un terzo del rumore che lo copre, e con cento compagni un decimo. Il modello additivo è, si noti, il caso facile, quello in cui il credito sarebbe in linea di principio separabile: già lì lo stimatore ingenuo affoga, e nei casi in cui i contributi si intrecciano non va meglio. È il passeggero a scrocco in forma di gradiente, e la cosa da notare è che nessuno bara: il problema sta nell’informazione che distinguerebbe l’utile dal passivo e non arriva a destinazione.
Quel rumore ha un antidoto parziale ma diretto: una baseline controfattuale. Invece di moltiplicare il gradiente per il ritorno di tutti, si sottrae al valore dell’azione congiunta quello che la squadra avrebbe ottenuto se \(i\) avesse giocato una mossa media, a mosse degli altri fissate:
dove \(s\) è lo stato globale, disponibile solo in addestramento, \(a^{-i}\) le azioni di tutti tranne \(i\), \(\bar{o}^i\) la storia locale di \(i\) e la somma corre sulle sue azioni possibili \(b\). È l’idea di COMA [FFA+18], ed è il vantaggio dell’architettura actor-critic ricalcolato sull’asse strutturale invece che su quello temporale.
Conviene però dire con precisione che cosa si guadagna, perché la formula promette meno di quanto sembri. Il termine sottratto non dipende da \(a^i\), quindi è una baseline legittima (non altera il valore atteso del gradiente) e toglie di mezzo la parte di ritorno che \(i\) incasserebbe comunque, cioè esattamente il rumore contato sopra. Ma \(A^i\) resta in generale una funzione anche delle azioni \(a^{-i}\): il valore congiunto non si scompone, ed è solo nel modello additivo di comodo di poco fa che la differenza collassa sul solo \(g^i\). Quello che la baseline controfattuale garantisce è la riduzione della varianza, non l’isolamento del contributo di \(i\).
La contromisura ovvia, dare a ciascuno un premio suo, sposta il problema invece di risolverlo. Premi individuali scritti a mano espongono al reward hacking della sezione su esplorazione e ricompensa: l’agente trova il modo di far salire il proprio punteggio senza fare la cosa per cui il punteggio era stato inventato, e un agente che insegue il proprio numero può danneggiare la squadra in perfetta buona fede.
La strada che ha funzionato è l’opposta: tenere un premio solo e ricavarne il merito di ciascuno, invece di dichiararlo in anticipo. Le vie sono due. La prima misura per differenza: si confronta come è andata con come sarebbe andata se quel membro, al posto della mossa che ha fatto, ne avesse fatta una a caso fra quelle che di solito fa, e tutti gli altri avessero giocato esattamente come hanno giocato. Sulla relazione di gruppo, è chiedersi che voto avrebbe preso lo stesso lavoro se uno dei cinque avesse scritto la sua parte come gli capitava, mentre gli altri quattro scrivevano la loro esattamente come l’hanno scritta. L’idea non nasce qui: si chiamano difference rewards, li propongono David Wolpert e Kagan Tumer, e COMA li porta dentro l’attore-critico. Il rumore dei compagni si abbassa; il merito del singolo, però, non viene isolato, perché come è andata dipende comunque anche da quello che hanno fatto loro.
La seconda impara a scomporre il risultato, cioè a stimare quanto ciascuno ha contribuito partendo dal solo voto di squadra, e si porta dietro anche il modo di addestrare insieme e poi giocare ognuno per conto proprio. È lo stesso problema che la sezione sulle topologie aveva lasciato aperto, cioè attribuire una colpa lungo un organigramma; ma con una differenza che conta. Qui il merito si può inseguire perché c’è un punteggio, e un punteggio si può derivare, cioè si può chiedere di quanto cambierebbe ritoccando ciascun parametro. Là la catena era fatta di riassunti in italiano, e nessuno di questi metodi vi si trasferisce.
Addestramento centralizzato, esecuzione decentralizzata#
L’asimmetria che salva è questa. Agenti come questi non imparano nel mondo vero, imparano dentro un simulatore: un mondo finto costruito al computer, in cui si può rigiocare la stessa situazione mille volte senza causare danni. E quel simulatore è nostro, quindi in allenamento possiamo ispezionarlo a piacimento: la situazione completa, le mosse di tutti, perfino cose che nessun agente potrà mai osservare. Usarle è legittimo, perché il simulatore le mette a disposizione, ed è un’ipotesi esplicita del metodo. In partita no, e ciascuno ha soltanto quello che vede lui.
La ricetta che ne discende si chiama CTDE, addestramento centralizzato ed esecuzione decentralizzata, e la sua regola d’oro sta in una riga: l’informazione privilegiata si usa solo dove non servirà durante la partita. Il critico serve ad addestrare l’attore, e poi si butta via. L’unica cosa che deve sopravvivere alla fine dell’addestramento è la regola con cui ciascun agente sceglie la propria mossa a partire da quello che vede lui, e soltanto da quello. Se sopravvivesse qualcosa che per funzionare ha bisogno di sapere anche che cosa vedono gli altri, in partita non funzionerebbe.
Il calcio ha già inventato tutto. In allenamento l’allenatore ha la ripresa dall’alto, vede tutti e ventidue i giocatori insieme e può dire al terzino: «quel passaggio era sbagliato, il tuo compagno stava arrivando alle tue spalle». La domenica il terzino ha soltanto i suoi occhi, e l’allenatore resta a bordo campo. Nessuno grida allo scandalo: la ripresa dall’alto serviva prima.
La prima ricetta (nei lavori si chiama MADDPG) è esattamente questa. Ogni agente ha due parti. L’attore è il giocatore in campo, che guarda solo il proprio pezzo di campo e decide; il critico, cioè quello che dà i voti, è il suo allenatore, che c’è solo in allenamento e ha la ripresa: la situazione completa e la mossa di ciascuno. Quando giudica il passaggio sa già dove stava correndo il compagno, e quindi il voto non scade appena il compagno cambia abitudini. Il terreno si muove molto meno.
Molto meno, però, non vuol dire fermo: il voto riguarda come va a finire l’azione, e quello dipende da come giocheranno gli altri da lì in poi. Se il centravanti impara a smarcarsi, lo stesso identico passaggio merita un voto più alto. Basta a far funzionare la cosa in pratica; a garantirla, no.
La ripresa ha poi un limite di taglia. Il critico deve farsi un’idea di ogni combinazione di mosse, e le combinazioni si moltiplicano a ogni giocatore in più: con una squadra si fa, con mille droni non c’è stagione abbastanza lunga per vederle tutte.
La seconda ricetta (si chiama QMIX) serve quando il premio è uno solo per tutta la squadra, il risultato della partita. L’allenatore impara a dare un voto a ogni giocatore, scritto soltanto con quello che quel giocatore vedeva, come una pagella del lunedì; e impara una regola per comporre le pagelle nel voto di squadra, con un vincolo che sembra innocuo: se sale la pagella di un giocatore, il voto di squadra non può scendere. Quel vincolo basta, e la domenica nessuno ha bisogno di consultarsi: ciascuno fa la mossa che alza la propria pagella, e così porta al massimo anche il voto di squadra. Non è l’unica regola che lo permette, ma è quella che si impara senza fatica.
Il vincolo però costa, e il conto si vede su quattro numeri. Due giocatori devono sovrapporsi sulla stessa fascia, e ciascuno sceglie se salire a destra (A) o a sinistra (B). Il punteggio di squadra è questo:
l’altro fa A |
l’altro fa B |
|
|---|---|---|
io faccio A |
2 |
0 |
io faccio B |
0 |
1 |
Il meglio è che salgano tutti e due a destra, e vale due. Ora prova a dare le pagelle. Se quella del primo dice che A è meglio di B, il vincolo pretende che, qualunque cosa faccia il secondo, spostare il primo da B ad A non faccia scendere il punteggio di squadra. Ma con il secondo su B la tabella dice il contrario: «io A, l’altro B» vale zero, «io B, l’altro B» vale uno. Lo stesso vale, scambiando i ruoli, se è il secondo a preferire A. Resta che tutti e due preferiscano B, e allora il vincolo pretende che «B, B» valga almeno quanto «A, A»: uno contro due, sbagliato di nuovo. In qualunque modo si diano le pagelle, quella tabella non si ricopia.
È il caso in cui bisogna accordarsi su una convenzione arbitraria, tutti a destra o tutti a sinistra, e la mossa giusta per me dipende da quella dell’altro. Il conto dice soltanto che con questa ricetta quel punteggio non si ricopia esatto: QMIX può ancora avvicinarsi, e non è detto che i due finiscano per scegliere male; ma in pratica è su questi giochi che inciampa.
MADDPG [LWT+17] è la forma canonica del principio. Ogni agente \(i\) ha un attore deterministico \(\mu^i_{\theta^i}(o^i)\), che riceve solo la propria osservazione, e un critico
dove \(x\) raccoglie l’informazione di stato disponibile in addestramento (nel caso più semplice la concatenazione delle osservazioni di tutti) e \(a^1, \dots, a^N\) sono le azioni di tutti gli agenti. L’attore è decentralizzato, il critico no, e a fine addestramento il critico si getta. L’attore si aggiorna con il gradiente deterministico calcolato sul critico centralizzato,
e il critico minimizza \(\big(Q^i_{\phi^i}(x, a^1, \dots, a^N) - y^i\big)^2\) con il bersaglio
dove \(\mathcal{D}\) è il buffer delle transizioni già giocate, \(x'\) e \(o'^j\) lo stato e le osservazioni al passo dopo, e \(Q'\) e \(\mu'\) le reti target, copie dei parametri aggiornate in ritardo [LWT+17]. Nel bersaglio compaiono le policy di tutti, ed è da lì che entra la non stazionarietà che resta.
La ragione per cui questo attenua la non stazionarietà si scrive in una riga:
cioè condizionando sulle azioni di tutti la transizione non dipende più dalle policy, e quindi non cambia quando le policy cambiano; è il critico decentralizzato, che vede solo \(a^i\) e dovrebbe marginalizzare sulle altre azioni usando le policy correnti, a vedersi muovere il terreno sotto i piedi.
Attenzione a non chiedere a quella riga più di quanto dica, perché è un passo che si sbaglia facilmente. Ciò che è stazionario per costruzione è il nucleo di transizione condizionato all’azione congiunta. Ciò che il critico deve regredire è invece \(Q^i(x, a^1, \dots, a^N)\), un valore atteso lungo la traiettoria futura, e quella traiettoria la generano le policy \(\pi^{-i}\) dal passo successivo in poi. Tenendo \(P\) e \(r\) identiche e cambiando soltanto la policy dell’avversario, il numero da regredire a parità di ingresso cambia, e per vederlo basta scrivere un passo di ricorsione: il valore atteso dallo stato successivo è una media sulle azioni che gli altri giocheranno lì, pesate con le loro policy correnti, che è esattamente la cosa che si muove. La transizione è ferma; il bersaglio no.
Nel lavoro originale MADDPG aggiunge al critico centralizzato gli ensemble di policy: ogni agente allena \(K\) sotto-policy e a ogni episodio ne sorteggia una, così che gli altri non possano adattarsi a un avversario solo. È una contromisura esplicita alla non stazionarietà residua, e non servirebbe se questa fosse stata eliminata «per costruzione». Le reti target invece non dimostrano nulla né in un senso né nell’altro: MADDPG le eredita da DDPG, dove esistono già con un agente solo, perché anche lì il bersaglio \(r + \gamma\,Q'\) si calcolerebbe altrimenti con la stessa rete che si sta aggiornando. Da cui la conseguenza già enunciata in apertura di sezione, che qui va ribadita perché è facile crederla revocata: le garanzie di convergenza del reinforcement learning a un agente solo, qui, non valgono. Il Q-learning converge perché itera un operatore di Bellman fisso; qui l’operatore si muove insieme alle policy altrui, e per gli algoritmi CTDE una dimostrazione analoga non c’è. Funzionano in pratica, che è un’affermazione diversa e va tenuta distinta.
I costi sono due e vanno detti. Il primo: l’ingresso del critico cresce linearmente in \(N\), ma quello che deve coprire è lo spazio delle azioni congiunte, che cresce come \(|\mathcal{A}|^N\), e i campioni necessari con esso; è il vero limite di scala del metodo, e non si legge dalla dimensione dell’ingresso. Il secondo: serve un critico per agente non appena le ricompense non coincidono, cioè in ogni scenario competitivo o misto.
Il termine di paragone di tutta la famiglia è l’independent Q-learning [Tan93]: ogni agente esegue il Q-learning sulla propria \(Q^i(\bar{o}^i, a^i)\) e tratta gli altri come parte dell’ambiente, cioè ignora proprio la non stazionarietà di \(P^i_t\). Non ha garanzie, eppure resta una base sorprendentemente robusta, e il lavoro su QMIX la usa come tale. Un passo oltre sta VDN [SLG+18], che impara le \(Q^i\) dalla sola ricompensa di squadra imponendo \(Q_{tot} = \sum_i Q^i\): la somma rende banale l’argmax congiunto e insieme restringe la classe rappresentabile alle funzioni additive. QMIX [RSSdW+18] allarga quella classe e affronta così l’altro pezzo, l’assegnazione strutturale del merito, nel caso puramente cooperativo. Ogni agente stima un’utilità \(Q^i(\bar{o}^i, a^i)\) sulla sola storia locale, e una rete di miscelazione le compone nel valore di squadra \(Q_{tot}\) sotto il vincolo
cioè \(Q_{tot}\) è monotona non decrescente in ciascuna utilità individuale; in pratica i pesi della rete di miscelazione sono vincolati a essere non negativi, e li produce una hypernetwork che riceve lo stato globale \(s\), disponibile solo in addestramento. La monotonia è sufficiente e non necessaria per decentralizzare l’esecuzione, ed è il lavoro stesso a dirlo: la classe delle \(Q_{tot}\) il cui argmax si decompone è più larga, e altri metodi la coprono meglio al prezzo di essere più difficili da addestrare. Sufficiente lo è perché implica
dove \(a = (a^1, \dots, a^N)\) è l’azione congiunta: massimizzare individualmente equivale a massimizzare globalmente, e il \(\max\) sull’azione congiunta, che costerebbe \(|\mathcal{A}|^N\), si calcola in \(N|\mathcal{A}|\) operazioni. In esecuzione nessuno consulta nessuno. La proprietà espressa da questa uguaglianza ha preso il nome di IGM (Individual-Global-Max) in QTRAN, uno degli altri metodi appena ricordati, dove additività e monotonia compaiono come due sue condizioni sufficienti [SKK+19].
Ciò di cui il vincolo priva è altrettanto preciso, e va enunciato per quello che è: una rappresentazione esatta, non una scelta. Per dimostrarlo basta un gioco a due agenti con due azioni a testa. Poniamo \(Q_{tot}(A,A)=2\), \(Q_{tot}(A,B)=Q_{tot}(B,A)=0\), \(Q_{tot}(B,B)=1\), e supponiamo esista una \(f\) monotona con \(Q_{tot}(a^1,a^2) = f\big(Q^1(a^1), Q^2(a^2)\big)\). Se \(Q^1(A) \ge Q^1(B)\), la monotonia nel primo argomento dà \(Q_{tot}(A,B) \ge Q_{tot}(B,B)\), cioè \(0 \ge 1\): falso, quindi \(Q^1(A) < Q^1(B)\). Per simmetria \(Q^2(A) < Q^2(B)\). Ma allora la monotonia nei due argomenti insieme dà \(Q_{tot}(A,A) \le Q_{tot}(B,B)\), cioè \(2 \le 1\): falso di nuovo. Nessuna \(f\) monotona rappresenta quella matrice, ed è quanto dice il lavoro originale: una funzione valore in cui la mossa migliore di un agente dipende dalle mosse degli altri allo stesso passo non si fattorizza in modo appropriato, e QMIX non la può rappresentare perfettamente (cannot be represented perfectly, scrivono gli autori), anche se la approssima meglio di VDN [RSSdW+18]. Il coordinamento su una convenzione arbitraria ne è il caso da manuale. Il teorema si ferma qui: dice che la miscelazione monotona non riproduce quel valore, non che l’argmax decomposto scelga male. A far fallire QMIX su quei giochi è la dinamica dell’apprendimento, e la distinzione conta: è la ragione per cui avvicinarsi di più a quel valore, pur senza riprodurlo, serve a qualcosa.
C’è una terza ricetta, e il suo interesse è di metodo prima che tecnico. MAPPO [YVV+22], cioè PPO multi-agente, non inventa nulla: prende PPO (proximal policy optimization), l’algoritmo dei gradienti di policy che a ogni aggiornamento impedisce a un agente di cambiare troppo il proprio modo di giocare, lascia a ciascuno il suo attore, che vede solo il proprio pezzo, e gli affianca un critico solo per tutta la squadra, che in allenamento guarda tutto. Il titolo del lavoro dichiara la sorpresa: un metodo semplice, con le manopole girate per bene, regge il confronto con architetture costruite apposta per il caso multi-agente. E sono manopole noiose: rimettere i punteggi su una scala comune, non insistere troppe volte sugli stessi dati prima di buttarli, spostarsi poco per volta. Va tenuto accanto alla regola prudente della sezione sul costo del coordinamento: prima di credere che serva la macchina complicata, si misura fin dove arriva quella semplice messa a punto per bene.
Self-play e curriculum#
Il programma di dama di Arthur Samuel, con cui si apre il capitolo sul machine learning, arrivò a giocare meglio del suo autore. Il congegno con cui ci riuscì è ancora quello di oggi. Il programma giudicava una posizione con una formula che sommava alcune caratteristiche (quanti pezzi ho io, quanti ne ha lui, chi controlla il centro), ciascuna con un peso che diceva quanto contava; e per allenarlo Samuel ne teneva due copie, che chiamava alpha e beta (due copie del programma, senza legami con la potatura alfa-beta della ricerca nei giochi). Alpha aggiustava i propri pesi dopo ogni mossa, e ogni tanto buttava via le caratteristiche che sembravano non servire sostituendole con altre pescate da una lista di riserva; beta teneva la sua formula ferma per tutta la partita.
Il contrasto è lì, ed è tutto: uno dei due si muove dentro la partita, l’altro sta fermo finché la partita non è finita, ed è proprio questo a farne un avversario stabile contro cui misurarsi. Quando alpha vinceva, la sua formula passava a beta e si ricominciava. Quando invece perdeva, alpha si prendeva un segno nero, e raggiunto un certo numero di segni neri (di solito tre) la sua formula veniva scombinata di forza, azzerando il peso della caratteristica più importante. È un guasto provocato apposta, e la ragione che Samuel ne dà è proprio quella: se il programma si è arenato su un modo di giocare che sembra buono soltanto perché non ne ha provati altri, l’unico modo di scoprirlo è costringerlo a cambiare. Il programma non aveva un maestro: aveva se stesso, un passo indietro.
Quella scala che sale, la formula vincente di alpha che passa a beta e diventa l’avversario da battere al giro dopo, ha un nome: si chiama curriculum, nel senso in cui la parola indica un programma di studi. Una successione di esercizi ordinati dal più facile al più difficile, invece del problema intero servito subito. Yoshua Bengio e colleghi l’hanno studiata nel 2009 come tecnica di addestramento generale [BLCW09], misurandola su compiti che con i giochi non c’entrano niente: riconoscere forme geometriche, e indovinare la parola successiva in un testo.
Giocare contro copie di sé si chiama self-play, e il suo meccanismo prezioso sta nel curriculum che si genera da solo, più che nel risparmio di partite umane. Un avversario troppo forte non insegna niente (perdi comunque, e non sai per che cosa); uno troppo debole nemmeno (vinci comunque, e qualunque cosa tu faccia va bene). L’avversario che insegna è quello che ti sta appena sopra, e deve cambiare man mano che migliori. Progettare quella scala a mano, per un gioco complesso, è fuori portata: nessuno sa scrivere l’esercizio giusto per un giocatore di Go di livello intermedio. Nel self-play la scala non si progetta, si ottiene per costruzione, perché l’avversario è forte quanto te, sempre, essendo te. Nessuno dei due vince troppo spesso, e le partite restano informative. Almeno, finché «più bravo» vuol dire qualcosa.
È la linea che porta ad AlphaGo [SHM+16], già raccontato nella sezione MCTS e AlphaGo. Lì una rete sceglie la mossa: è addestrata prima sulle partite dei giocatori umani, poi affinata col gradiente di policy contro una versione precedente di sé, sorteggiata ogni volta da un archivio invece di prendere sempre l’ultima, perché la rete non si adatti alla sola policy corrente (è il guasto che sasso, carta e forbici mostrano fra poco). Una seconda rete dice chi sta vincendo, e si addestra proprio sulle partite così generate. Le due guidano la ricerca ad albero Monte Carlo, che prima di muovere prova a immaginare come proseguirebbe la partita. L’anno dopo la stessa squadra toglie di mezzo anche il punto di partenza umano: AlphaGo Zero [SSS+17] parte dalle sole regole del gioco e da pesi casuali, e tutto il suo addestramento è self-play. È la prova più netta del punto: le partite umane erano un acceleratore, non un ingrediente necessario.
Quando la scala non esiste#
Arriva qui la parte più istruttiva, ed è un fallimento. Il self-play ingenuo, cioè allenarsi sempre contro l’ultima versione di sé, funziona benissimo quando «essere più bravi» è una relazione d’ordine: se A batte B e B batte C, allora A batte C. In molti giochi non lo è, e allora l’idea stessa di una classifica lineare della bravura non ha un referente.
Il caso più piccolo lo conoscono tutti: sasso, carta, forbici. Il sasso batte le forbici, le forbici battono la carta, la carta batte il sasso. Chi è il più forte? La domanda non ha risposta, e non perché manchino i dati: non c’è proprio, un più forte.
Guarda cosa succede se ti alleni contro l’ultima versione di te stesso. Cominci giocando sasso. La versione 2 impara a batterlo e gioca carta. La versione 3 impara a battere la carta e gioca forbici. La versione 4 impara a battere le forbici e gioca… sasso, cioè la versione 1. Sei tornato al punto di partenza dopo tre giri, e continuerai a girare per sempre.
Adesso la parte che dovrebbe far paura. Se misuri i progressi come si fa di solito, cioè guardando quanto la versione nuova batte quella precedente, vedi il cento per cento di vittorie a ogni generazione, per sempre: una curva che sale e non scende mai, il grafico più rassicurante che esista. Se invece metti la versione nuova contro quella di due generazioni prima, perde sempre. E se la metti contro il mucchio di tutte le versioni passate, in media non guadagna niente. Il progresso era un’illusione ottica prodotta dal metro di misura.
Il fenomeno si chiama non transitività. In un gioco simmetrico a somma zero con matrice di payoff antisimmetrica \(\mathbf{A}\) (\(A_{ij} = -A_{ji}\), il guadagno di chi gioca \(i\) contro chi gioca \(j\)), la relazione «\(i\) batte \(j\)» può contenere cicli, e quando li contiene non esiste alcuna funzione \(f\) su una scala reale, nessun punteggio di tipo Elo, tale che \(A_{ij} > 0 \iff f(i) > f(j)\): un ordine totale semplicemente non c’è. Quanto un gioco sia ciclico si misura: ogni matrice antisimmetrica si scompone in modo ortogonale in una parte transitiva, \(A_{ij} = r_i - r_j\) per un punteggio \(r\) di tipo Elo, e in una parte ciclica, che nessun punteggio cattura [BTPG18], e la scomposizione si estende ai giochi con infinite strategie [BGB+19]. Più pesa la parte ciclica, più il self-play ingenuo rischia di girare in tondo; in sasso-carta-forbici la parte transitiva è nulla.
Il self-play ingenuo è, in questa notazione, l’iterazione della miglior risposta alla strategia corrente: si sceglie l’indice \(i_{t+1} \in \arg\max_i (\mathbf{A}\,\boldsymbol{\pi}_t)_i\) e si pone \(\boldsymbol{\pi}_{t+1} = \mathbf{e}_{i_{t+1}}\), il versore della strategia pura corrispondente. In un gioco ciclico l’orbita di quell’iterazione è un ciclo, e la quantità che si sta massimizzando (il guadagno contro \(\boldsymbol{\pi}_t\)) resta massima a ogni passo mentre la quantità che interessa davvero, la sfruttabilità \(\varepsilon(\boldsymbol{\pi}) = \max_i (\mathbf{A}\,\boldsymbol{\pi})_i\), cioè quanto ricava contro \(\boldsymbol{\pi}\) il miglior avversario possibile, resta al valore peggiore. Una strategia pura in sasso-carta-forbici ha \(\varepsilon = 1\) qualunque essa sia; l’unico equilibrio è la miscela uniforme, che ha \(\varepsilon = 0\) e che nessuna strategia pura realizza, né è il limite della successione appena descritta, la quale di vertici è fatta e sui vertici resta. A convergerci è la frequenza empirica di una successione di strategie pure, ed è precisamente quello che fa il rimedio della popolazione.
Il rimedio è cambiare l’avversario: non l’ultima versione, ma la popolazione di tutte quelle passate. La miglior risposta alla media empirica delle versioni precedenti è il gioco fittizio di Brown, di cui Julia Robinson ha dimostrato che in un gioco a due giocatori e somma zero la frequenza empirica converge a un equilibrio di Nash [Rob51], anche se lentamente; fuori dalla somma zero può non convergere, e Shapley ne dà un controesempio con tre strategie per giocatore, in cui la frequenza gira attorno all’equilibrio senza raggiungerlo [Sha64]. Sono i due regimi, l’ultima versione e la popolazione, che il programma mette in colonna.
import numpy as np

# Gioco ciclico a somma zero. A[i, j] e' il guadagno di chi gioca i contro
# chi gioca j: +1 vittoria, -1 sconfitta, 0 pareggio.
#             sasso  carta  forbici
A = np.array([[  0,   -1,    +1],    # sasso
              [ +1,    0,    -1],    # carta
              [ -1,   +1,     0]])   # forbici
NOMI = ["sasso", "carta", "forbici"]


def miglior_risposta(q):
    """L'azione che rende di piu' contro un avversario distribuito come q."""
    return int(np.argmax(A @ q))


def pura(i):
    """La distribuzione concentrata su una sola azione."""
    e = np.zeros(3)
    e[i] = 1.0
    return e


# Self-play ingenuo: ogni versione e' la miglior risposta all'ULTIMA versione.
storia = [0, 1]                      # gen 1 gioca sasso, gen 2 e' la sua risposta
print("gen  gioca     vs gen-1  vs gen-2  vs le passate  sfruttabilita'")
for t in range(3, 9):
    nuova = miglior_risposta(pura(storia[-1]))
    popolazione = np.mean([pura(p) for p in storia], axis=0)
    print(f"{t:3d}  {NOMI[nuova]:9s} {A[nuova, storia[-1]]:+7.2f} "
          f"{A[nuova, storia[-2]]:+8.2f} {(A @ popolazione)[nuova]:+13.2f} "
          f"{np.max(A @ pura(nuova)):+14.2f}")
    storia.append(nuova)

# Contro una POPOLAZIONE: miglior risposta alla media di tutte le versioni.
freq = np.array([1.0, 0.0, 0.0])
for _ in range(2000):
    freq[miglior_risposta(freq / freq.sum())] += 1
p = freq / freq.sum()
print("\npopolazione dopo 2000 generazioni: "
      + " ".join(f"{n}={v:.3f}" for n, v in zip(NOMI, p)))
print(f"sfruttabilita' della popolazione:  {np.max(A @ p):+.3f}")
gen  gioca     vs gen-1  vs gen-2  vs le passate  sfruttabilita'
  3  forbici     +1.00    -1.00         +0.00          +1.00
  4  sasso       +1.00    -1.00         +0.00          +1.00
  5  carta       +1.00    -1.00         +0.25          +1.00
  6  forbici     +1.00    -1.00         +0.00          +1.00
  7  sasso       +1.00    -1.00         +0.00          +1.00
  8  carta       +1.00    -1.00         +0.14          +1.00

popolazione dopo 2000 generazioni: sasso=0.326 carta=0.335 forbici=0.339
sfruttabilita' della popolazione:  +0.008
Le quattro colonne dicono quattro cose diverse. La prima è la metrica che tutti guardano, ed è una linea piatta di vittorie: ogni generazione batte la precedente, sempre, per sempre. La seconda è la stessa storia dal lato scomodo: contro la versione di due generazioni prima si perde, sempre. La terza dice che contro l’insieme delle versioni passate il guadagno resta a zero, con qualche sussulto verso l’alto nelle generazioni in cui quell’insieme è sbilanciato. La quarta è la più severa: la sfruttabilità dell’agente corrente, cioè quanto ci ricava contro di lui il miglior avversario possibile (più è alta, più l’agente è facile da battere), resta al massimo a ogni generazione. Dopo sei generazioni il campione è fragile esattamente quanto il primo giorno, e la colonna dei progressi non lo dice.
Le ultime due righe mostrano l’alternativa. Allenandosi contro la media di tutte le versioni passate, invece che contro l’ultima, in duemila generazioni la popolazione si assesta su un terzo di sasso, un terzo di carta e un terzo di forbici: è l’equilibrio di cui parlava la pagina d’apertura del capitolo, e la sua sfruttabilità scende quasi a zero. Conta però il soggetto della frase, perché è tutta la differenza: a essere imbattibile è la popolazione. Il campione da schierare è il mucchio, non l’ultimo nato: si scende in campo sorteggiando ogni volta una delle versioni, e a essere difficile da battere è quella miscela, non un singolo giocatore.
Su scala industriale, questa è la league di AlphaStar [VBC+19], il programma di DeepMind che gioca a StarCraft II: una lega in cui convivono tre tipi di partecipanti.
Ci sono gli agenti principali, quelli che devono battere tutti: si allenano contro la lega intera, ma non pescando gli avversari a caso, bensì incontrando più spesso quelli che li stanno battendo. Ci sono gli sfruttatori, che sono la parte controintuitiva: agenti premiati per non essere forti in generale, e per specializzarsi invece in una singola strategia che neutralizza un avversario specifico. Ne esistono di due tipi: chi va a caccia dei punti deboli dei campioni del momento, e chi cerca invece quelli della lega nel suo insieme; e servono a far incontrare al campione una debolezza che da solo non incontrerebbe mai. E poi ci sono le versioni congelate di tutti costoro, che una volta entrate nella lega ci restano per sempre.
La lega però non è gratis: ogni avversario in più è memoria, partite e calcolo, e il conto della sezione sul costo del coordinamento torna a presentarsi qui, sul lato dell’addestramento.
E torniamo ai pesci dell’Adriatico. Le orbite chiuse che Volterra trovò nelle sue due formule non sono una curiosità zoologica, e il legame è più stretto di un’analogia. Nel programma delle generazioni la popolazione salta di colpo da una strategia pura all’altra, cioè da un modo di giocare che è sempre lo stesso a un altro che è sempre lo stesso: tutta sasso e poi tutta carta. Ma si può anche lasciarla scivolare con continuità, facendo crescere a poco a poco la quota di chi rende di più: è la dinamica del replicatore, il modo standard di descrivere l’evoluzione di una popolazione di strategie. Se \(x_k\) è la quota di giocatori che usano la strategia \(k\), \(\dot{x}_k = x_k\,[(\mathbf{A}\mathbf{x})_k - \mathbf{x}^\top\mathbf{A}\mathbf{x}]\): cresce chi rende più della media, e in un gioco a somma zero simmetrico la media \(\mathbf{x}^\top\mathbf{A}\mathbf{x}\) vale zero. In sasso-carta-forbici il prodotto \(x_1 x_2 x_3\) resta costante lungo il moto, quindi il punto gira su una curva chiusa attorno all’equilibrio e non ci cade mai dentro; ed è un teorema che la dinamica del replicatore con \(n\) strategie ha le stesse orbite di un sistema di Lotka e Volterra con \(n-1\) specie [HS98] (Fig. 22.5).
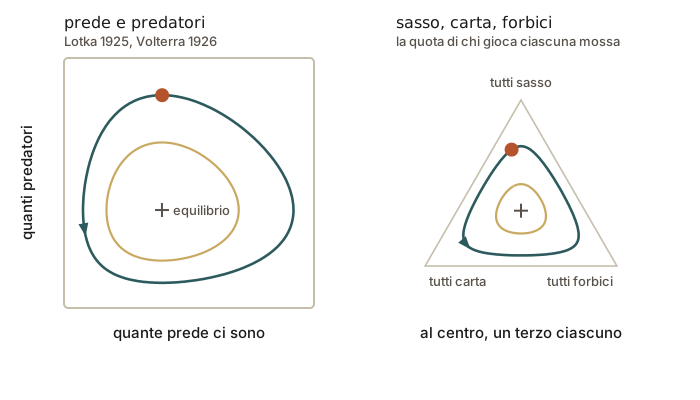
Fig. 22.5 Le due orbite, disegnate sui due piani in cui vivono. A sinistra le prede in orizzontale e i predatori in verticale; a destra ogni punto del triangolo è una popolazione di giocatori, e dice quanta parte di essa gioca sasso, quanta carta e quanta forbici. In tutti e due i casi il punto gira e non cade nel centro: l’equilibrio c’è, e nessuno ci arriva.#
Prede e predatori, sasso e carta: quando ciascuno insegue l’altro e l’altro nel frattempo si sposta, il sistema non si ferma, gira. Il salto da una strategia all’altra del programma delle generazioni è la versione a scatti della stessa storia, e allenarsi contro tutto il passato è quello che rompe l’orbita.
Una GAN è un sistema multi-agente a due#
Nella pagina d’apertura del capitolo le GAN erano comparse di passaggio: due reti che si allenano l’una contro l’altra e che finiscono in un equilibrio invece che in fondo a una valle. Il capitolo sulle GAN le racconta per esteso più avanti; qui servono soltanto i nomi. La prima rete, il generatore, fabbrica esemplari falsi (di solito immagini) partendo dal caso; la seconda, il discriminatore, guarda un esemplare e dice se è vero o falso. Il generatore vince quando inganna, il discriminatore quando smaschera.
Detta così, una GAN è un sistema multi-agente con due soli partecipanti, e riconoscerlo non è un gioco di parole: spiega i suoi guasti tipici meglio di quanto li spieghi la teoria delle reti.
Il traguardo, per cominciare, è quello già incontrato nella pagina d’apertura del capitolo: non il fondo di una valle, perché ogni passo avanti di uno rende più difficile il mestiere dell’altro, ma un equilibrio, cioè la situazione in cui a nessuno dei due conviene più cambiare mossa da solo.
Da lì si capiscono i due modi in cui l’addestramento di una GAN va storto, e sono due vecchie conoscenze sotto altro nome. Per raccontarli diamo alle due reti i nomi che si usano spesso quando si spiega una GAN a chi comincia: il falsario è il generatore, che fabbrica i falsi, e il poliziotto è il discriminatore, che cerca di riconoscerli.
Il primo modo è l’oscillazione: le due reti girano in tondo invece di avvicinarsi, come i pesci dell’Adriatico e come sasso, carta e forbici. Il falsario impara a battere il poliziotto di adesso; il poliziotto impara a battere quel falsario lì; il falsario cambia di nuovo, e si ricomincia. Ognuno insegue l’altro, e l’altro nel frattempo si è spostato.
Il secondo somiglia all’allenarsi contro l’ultima versione, visto dall’altro lato. Il falsario scopre l’unica cosa che riesce a far passare per buona al poliziotto del momento (mettiamo: un certo tipo di volto) e si mette a produrre soltanto quella. Contro l’avversario corrente vince quasi sempre, quindi il suo punteggio è ottimo; ma del resto non sa più fare niente. Quando il poliziotto lo scopre, il falsario salta a un altro tipo di volto e il poliziotto lo insegue, come nel giro di sasso, carta e forbici. Il nome che ha in letteratura è collasso dei modi, dove i «modi» sono i tipi diversi di immagine che il falsario dovrebbe saper fare, e collassare vuol dire che di tutti quei tipi ne è rimasto uno. Ci si arriva anche per altre strade, legate al modo in cui il falsario viene premiato, e le racconta il capitolo sulle GAN; questa è quella che qui si riconosce.
E allora non stupisce che fra le contromisure ce ne sia una che qui si riconosce subito, anche se il capitolo sulle GAN non la elenca fra le proprie: far vedere al poliziotto anche i falsi prodotti dalle versioni vecchie del falsario. È la lega di AlphaStar in miniatura, con la stessa identica motivazione.
Nella formulazione minimax generatore e discriminatore condividono un’unica funzione di valore: uno la minimizza, l’altro la massimizza, e il gioco è a due giocatori e somma zero esattamente. Il traguardo non è un minimo di \(\mathcal{L}\) ma un equilibrio di Nash, il punto in cui a nessuno dei due conviene più deviare da solo.
Una precisazione che la sezione su come funziona una GAN paga per intero e che qui non va persa: quella formulazione non è quella che si usa. Con la loss non-saturante, cioè la funzione obiettivo con cui le GAN si addestrano davvero, il gioco non è più a somma zero e non si lascia più scrivere con un’unica funzione di valore. La lettura come sistema a due giocatori regge comunque; la somma zero è una proprietà della sola versione minimax, e va attribuita a quella.
Riletti da qui, i guasti classici dell’addestramento avversario smettono di sembrare capricci di quella famiglia di modelli. L’oscillazione è la stessa orbita di poche righe fa: il generatore fa la miglior risposta al discriminatore corrente, il discriminatore la miglior risposta a quello, e la coppia percorre un ciclo invece di avvicinarsi all’equilibrio. Il caso minimo sta in una riga: \(\min_x \max_y\, xy\), con unico equilibrio in \((0,0)\). La discesa-ascesa simultanea, \(x \leftarrow x - \eta\,y\) e \(y \leftarrow y + \eta\,x\), è una mappa lineare i cui autovalori \(1 \pm i\eta\) hanno modulo \(\sqrt{1+\eta^2} > 1\): a ogni passo la coppia ruota e si allontana dall’equilibrio, per qualunque \(\eta > 0\). Nel limite continuo percorre cerchi chiusi, orbite dello stesso genere di quelle di Volterra (le sue, vicino all’equilibrio, diventano ellissi); aggiornando i due giocatori in alternanza le orbite restano limitate ma non convergono al centro. L’oscillazione appartiene dunque alla dinamica del gradiente sui giochi prima che alle reti. Il collasso dei modi è, in una delle sue forme, il self-play ingenuo visto dall’altro lato: il generatore si specializza sull’unica regione dello spazio che inganna l’avversario corrente, ottiene contro di lui un tasso di successo altissimo e perde il resto del supporto; quando il discriminatore lo raggiunge salta su un’altra regione, e ruota fra i modi dei dati senza mai coprirli insieme [MPPSD17]. Non è l’unico meccanismo: la stessa sezione sulle GAN lo fa discendere anche dall’ordine dei quantificatori nell’ottimizzazione alternata e dalla loss non-saturante, che un modo abbandonato quasi non lo fa pagare. Non stupisce allora che fra le contromisure note ce ne sia una che qui si riconosce a colpo d’occhio, e che il capitolo sulle GAN non elenca fra le proprie: mostrare al discriminatore anche campioni prodotti da versioni passate del generatore. È una lega in miniatura, con la stessa motivazione.
Il critico che vede tutto#
Resta da vedere quanto poco codice serva a scrivere CTDE, cioè allenarsi guardando tutto e giocare guardando poco. Il programma che segue è lo scheletro di MADDPG, la prima delle ricette viste per CTDE: un attore per agente, che vede soltanto quello che vedrà anche in partita, e accanto a ciascuno un critico che riceve invece le osservazioni e le mosse di tutti. Manca tutto il resto (l’archivio delle partite passate da cui si ripescano gli esempi, le copie congelate delle reti che servono a tenere fermi i conti mentre si impara, i passi di addestramento veri e propri), perché qui il punto è soltanto chi vede che cosa.
import torch
from torch import nn


class Attore(nn.Module):
    """Decentralizzato: vede solo la propria osservazione, in addestramento
    come in esecuzione. E' l'unica parte che sopravvive alla fine."""

    def __init__(self, dim_oss, dim_azione):
        super().__init__()
        self.rete = nn.Sequential(
            nn.Linear(dim_oss, 64), nn.ReLU(),
            nn.Linear(64, 64), nn.ReLU(),
            nn.Linear(64, dim_azione), nn.Tanh(),   # azioni continue in [-1, 1]
        )

    def forward(self, oss):
        return self.rete(oss)


class CriticoCentralizzato(nn.Module):
    """Esiste solo in addestramento: riceve osservazioni e azioni di TUTTI,
    cosi' la transizione che vede non dipende piu' dalle policy altrui.
    (Il bersaglio da regredire, invece, dipende ancora dalle policy future
    degli altri.)"""

    def __init__(self, dim_oss, dim_azione, n_agenti):
        super().__init__()
        ingresso = n_agenti * (dim_oss + dim_azione)
        self.rete = nn.Sequential(
            nn.Linear(ingresso, 128), nn.ReLU(),
            nn.Linear(128, 128), nn.ReLU(),
            nn.Linear(128, 1),                      # un solo numero: Q(x, a1..aN)
        )

    def forward(self, osservazioni, azioni):
        # due liste di N tensori (lotto, dim): si concatenano sull'asse features
        return self.rete(torch.cat(osservazioni + azioni, dim=1))


N, DIM_OSS, DIM_AZ, LOTTO = 3, 10, 2, 4

attori = nn.ModuleList([Attore(DIM_OSS, DIM_AZ) for _ in range(N)])
# un critico per agente: serve appena le ricompense non coincidono
critici = nn.ModuleList([CriticoCentralizzato(DIM_OSS, DIM_AZ, N) for _ in range(N)])

oss = [torch.randn(LOTTO, DIM_OSS) for _ in range(N)]   # cosa vede ciascuno
azioni = [attori[i](oss[i]) for i in range(N)]          # ognuno decide da solo

print(azioni[0].shape)             # torch.Size([4, 2])
print(critici[0](oss, azioni).shape)  # torch.Size([4, 1])
Due righe raccontano tutta l’architettura. La prima è l’esecuzione:
attori[i](oss[i]), ogni agente con la propria osservazione e nient’altro, ed è
ciò che girerà sul robot, o dentro il programma vero, a lavoro finito. La
seconda è l’addestramento: critici[0](oss, azioni), dove il primo argomento è
la lista di tutte le osservazioni e il secondo la lista di tutte le azioni. In
esecuzione, quel critico non esiste più.
Da ricordare
Quando più agenti imparano insieme, per ciascuno il mondo non sta fermo: è la scorciatoia che risparmiava dieci minuti finché eri l’unico a conoscerla, e che adesso è la coda. La stessa mossa nella stessa situazione rende diversamente non per sfortuna ma perché gli altri sono migliorati, e le garanzie di convergenza viste nel reinforcement learning, che presuppongono un mondo fisso, non valgono più.
Se poi ciascuno vede solo il proprio pezzo (la squadra di soccorso nel fumo, senza radio) tutto il coordinamento va deciso prima di entrare, e i piani da confrontare esplodono: bastano due soccorritori, due cose da vedere, due da fare e cinque passi per superare i quattro miliardi di miliardi di coppie di piani. Non esiste, ed è dimostrato, un modo di risolvere davvero questo problema in tempo utile, e nemmeno di approssimarlo bene [OA16]: nessuno risolve, tutti approssimano.
Al merito nel tempo (quale mossa della sequenza ha prodotto il premio) se ne aggiunge uno fra compagni: con un voto solo per tutta la squadra, come nel lavoro di gruppo a scuola, chi è sparito registra lo stesso otto degli altri e quindi non impara niente, e chi ha lavorato non distingue il proprio contributo dal rumore dei compagni; più sono, meno si sente. Il rimedio è misurare ciascuno per differenza: che voto avrebbe preso lo stesso lavoro se lui, e soltanto lui, al posto della mossa che ha fatto ne avesse fatta una a caso fra quelle che gli capita di fare, mentre tutti gli altri giocavano esattamente come hanno giocato [FFA+18]. Abbassa il rumore, non isola il merito del singolo.
La ricetta che funziona è CTDE: informazione privilegiata in allenamento, occhi veri in partita. L’allenatore ha la ripresa dall’alto e il terzino, la domenica, ha solo il proprio sguardo. Un critico che conosce le mosse di tutti dà giudizi che scadono molto più lentamente quando i compagni cambiano abitudini, ma non smettono di scadere, perché come andrà a finire dipende ancora da come giocheranno gli altri da qui in poi [LWT+17]; e se la ricompensa è una sola, si impara un voto per giocatore più una regola per comporli, con il vincolo che alzare il proprio voto non possa far scendere quello di squadra [RSSdW+18], così ciascuno sceglie da solo la mossa migliore. Il prezzo è che il voto di squadra non si riproduce più esatto là dove bisogna accordarsi su una convenzione arbitraria (tutti a destra o tutti a sinistra), ed è lì che il metodo inciampa. Un metodo semplice, regolato con cura, va misurato prima di sostituirlo con uno complicato [YVV+22].
Il self-play vale perché l’esercizio giusto se lo costruisce da solo: l’avversario è forte quanto te, sempre, essendo te. È la linea che va da AlphaGo [SHM+16] ad AlphaGo Zero [SSS+17], che parte dalle sole regole del gioco.
Ma dove non esiste un più forte in assoluto (sasso, carta, forbici) allenarsi contro l’ultima versione di sé gira in tondo: si vince sempre contro la versione precedente, si perde sempre contro quella di due generazioni prima, e la curva dei progressi è un’illusione ottica prodotta dal metro di misura. Il rimedio è allenarsi contro il mucchio di tutte le versioni passate: è la league di AlphaStar [VBC+19], con i campioni, gli specialisti pagati per trovare il punto debole di qualcuno, e tutte le versioni congelate del passato.
Da ricordare
Con più agenti che imparano insieme, per ciascuno l’ambiente non è stazionario: la transizione indotta \(P^i_t\) dipende dalle policy degli altri, che cambiano. La stessa coppia \((s, a^i)\) rende diversamente non per rumore ma perché l’avversario è migliorato, e la garanzia di convergenza del Q-learning, che presuppone un operatore di Bellman fisso, decade.
Il quadro formale è il gioco stocastico, e con osservazione parziale il Dec-POMDP [OA16]: risolverlo esattamente a orizzonte finito è NEXP-completo già con due agenti (contro P-completo per un MDP e PSPACE-completo per un POMDP), e approssimarlo resta NEXP-difficile. Nessuno risolve: tutti approssimano.
All’assegnazione temporale del merito se ne aggiunge una strutturale: con ricompensa comune il gradiente del singolo è moltiplicato per il ritorno di tutti, e quel che ha fatto lui resta sepolto sotto quel che hanno fatto i compagni. Nel caso di comodo in cui i contributi semplicemente si sommano e sono indipendenti, il rapporto fra segnale e rumore scende come \(1/\sqrt{N-1}\) (un terzo con dieci agenti). È il passeggero a scrocco in forma di gradiente. Il rimedio è misurare ciascuno per differenza: confrontare com’è andata con come sarebbe andata se lui, al posto della sua mossa, ne avesse fatta una qualsiasi fra le solite, e gli altri no. È la mossa di COMA [FFA+18], che abbatte quel rumore senza però isolare il contributo del singolo.
La ricetta che funziona è CTDE: informazione privilegiata in addestramento, osservazione vera in esecuzione. MADDPG [LWT+17] dà a ogni agente un critico che vede le azioni di tutti, e condizionando su quelle la transizione non dipende più dalle policy; il bersaglio di regressione invece sì, perché è un valore atteso sul futuro, e contro questo residuo il lavoro originale allena più policy per agente e le sorteggia. Le garanzie di convergenza del caso a un agente solo, qui, non si trasferiscono. QMIX [RSSdW+18] fattorizza \(Q_{tot}\) in modo monotono (\(\partial Q_{tot}/\partial Q^i \ge 0\)), così l’argmax individuale coincide con quello congiunto (la condizione IGM, di cui la monotonia è sufficiente e non necessaria [SKK+19]); il prezzo è che i giochi non monotoni (accordarsi su una convenzione arbitraria) non si rappresentano esattamente. MAPPO [YVV+22] ricorda che un metodo semplice ben regolato va misurato prima di sostituirlo.
Il self-play vale perché il curriculum si genera da solo, restando sempre al limite delle proprie capacità: da AlphaGo [SHM+16] ad AlphaGo Zero [SSS+17], che parte dalle sole regole.
Ma nei giochi non transitivi (sasso-carta-forbici) non esiste un ordine della bravura (la parte ciclica della matrice dei guadagni lo misura [BTPG18]), e il self-play ingenuo cicla: vince sempre contro la versione precedente, perde sempre contro quella di due generazioni prima, e la sua sfruttabilità resta al massimo. Il rimedio è allenarsi contro una popolazione, non contro l’ultimo (il gioco fittizio, che converge nei giochi a somma zero [Rob51]): è la league di AlphaStar [VBC+19], con agenti principali, sfruttatori e tutte le versioni congelate del passato.
Fin qui gli agenti erano pochi, costosi e capaci di imparare. Resta l’estremo opposto, quello da cui il capitolo era partito con gli storni: popolazioni numerose di agenti molto semplici, che non imparano a coordinarsi ma seguono regole locali fisse e, messi insieme, risolvono problemi; e accanto a loro le popolazioni simulate di agenti linguistici, in cui l’oggetto di studio diventa la società che formano. È la sezione su sciami e simulazioni.