


Le famiglie di modelli, e oltre il testo#
L’architettura del 2017 era una macchina per tradurre. Quello che è successo dopo somiglia a ciò che accadde col motore a scoppio: nato come motore fisso per le officine, finì su carrozze, navi e aerei. Il Transformer è stato scomposto nelle sue due pile, l’encoder che legge e il decoder che scrive, e ciascuna, presa da sola e ingrandita, è diventata una famiglia di modelli: da un lato quelli che rappresentano il testo per capirlo, dall’altro quelli che lo generano. Poi lo stesso meccanismo è stato applicato alle immagini, e ha funzionato anche lì.
GPT, BERT, T5: tre esercizi di pre-addestramento#
I capostipiti delle tre famiglie, una per pila e una per la coppia intera, si distinguono soprattutto per l’esercizio che fanno su miliardi di frasi prima di essere messi al lavoro, cioè per l’obiettivo del pre-addestramento, la fase generale che negli esempi pratici aveva prodotto i modelli già pronti da scaricare. A seconda dell’esercizio scelto ne esce un modello bravo a scrivere o uno bravo a capire, e le sigle lo dicono: GPT sta per Generative Pre-trained Transformer, un Transformer pre-addestrato che genera testo; BERT per Bidirectional Encoder Representations from Transformers, le rappresentazioni che un encoder costruisce guardando nelle due direzioni; T5 per Text-to-Text Transfer Transformer, un Transformer che riscrive ogni compito come testo in ingresso e testo in uscita.

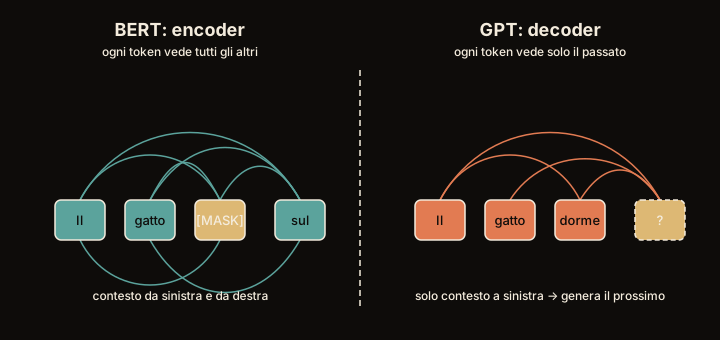
Fig. 16.8 Lo stesso blocco con due maschere. Non cambia l’architettura del blocco: cambia quali posizioni ogni parola può guardare, e da lì discende il resto.#
Fig. 16.8 mostra la differenza che conta fra i primi due: lo stesso tipo di blocco, con due maschere diverse. BERT usa la self-attention bidirezionale, quindi la rappresentazione di ogni parola dipende anche da quello che viene dopo, ed è ciò che serve per classificare una frase, trovarci dentro una risposta, confrontarla con un’altra; GPT usa la maschera causale e deve indovinare come si continua, che è esattamente l’esercizio da fare per imparare a scrivere.
Tre studenti si preparano allo stesso esame in tre modi diversi. GPT studia coprendo con la mano il resto della pagina. Legge «Il gatto nero salta sul…» e prova a indovinare la parola dopo, milioni di volte, e così diventa bravissimo a continuare un testo, cioè a scrivere. BERT studia con gli esercizi a buchi. Riceve «Il gatto ___ salta sul muro» e indovina la parola mancante guardando sia prima che dopo il buco, e così diventa bravissimo a capire le frasi, meno a scriverle. T5 studia con i buchi lunghi: non sparisce una parola sola ma un pezzo di frase intero, e al suo posto resta un segnaposto; il compito è riscrivere i pezzi tolti, ciascuno dietro il suo segnaposto. Poi trasforma ogni compito in un tema: scrive in cima al foglio «traduci:» oppure «riassumi:», e la risposta è sempre un testo, qualunque sia la domanda. Quando ChatGPT ti risponde, sotto c’è il metodo di GPT, coprire e indovinare, con miliardi di esempi alle spalle.
Nessuno dei tre, in quei milioni di ripetizioni, sta studiando il compito che gli verrà chiesto davvero. Studiano la lingua, e si correggono da soli, perché la risposta giusta sta già nella pagina, coperta dalla mano o nascosta dal buco, e nessun insegnante ha dovuto prepararla. Il compito vero (tradurre una frase, riassumere una pagina, dire se una recensione è entusiasta) arriva alla fine, e si impara con pochissimo: qualche esercizio già corretto, a volte solo le istruzioni scritte in cima al foglio, e in quel caso senza nemmeno rimettersi a studiare.
Al banco di fianco siede un quarto studente, ELECTRA, che negli esercizi a buchi vede uno spreco: sparisce circa una parola su sette, e solo su quella si viene interrogati, mentre le altre sei non fruttano nessun voto. Così si fa preparare le pagine da un compagno più piccolo, che invece di cancellare le parole ne sostituisce qualcuna con un’altra plausibile, e poi fa il controllore: parola per parola, dice se quella è l’originale o un’intrusa. Su ogni parola la domanda è più povera (sì o no, invece di indovinarne una fra decine di migliaia), ma non ne salta nessuna, e per arrivare dove arrivano i compagni degli esercizi a buchi gli basta meno di un quarto delle loro ore. Il compagno più piccolo, intanto, non gioca contro di lui: fa i suoi esercizi a buchi come sempre, e se rimette per caso la parola che c’era, quella conta come originale. Finito lo studio va a casa, e all’esame si presenta il controllore.
GPT [RNSS18] (OpenAI, 2018) è un Transformer decoder-only
con maschera causale, addestrato come modello di linguaggio autoregressivo:
massimizza la log-verosimiglianza
\(\sum_t \log p_\theta(x_t \mid x_{t-k}, \dots, x_{t-1})\), dove \(x_t\) è il token
in posizione \(t\) e \(k\) la lunghezza della finestra di contesto. La linea di
scala arriva a GPT-3 [BMR+20] (175 miliardi di parametri),
che mostra l’apprendimento in-context: adattarsi a un compito mostrato nel
prompt con pochi esempi svolti (few-shot) o soltanto descritto
(zero-shot), senza aggiornare i pesi. BERT [DCLT19]
(Google) è encoder-only e bidirezionale, pre-addestrato con masked language
modeling (si sorteggia il \(15\%\) dei token e si chiede di predirli: di quelli
scelti l’\(80\%\) diventa [MASK], il \(10\%\) un token a caso e il \(10\%\) resta
com’è) e next sentence prediction, cioè dire se la seconda frase segue
davvero la prima, un esercizio che i modelli successivi hanno lasciato cadere
(RoBERTa lo toglie e sui compiti a valle non perde, anzi migliora di poco
[LOG+19]); eccelle nei compiti di comprensione (classificazione,
estrazione di risposte) previo fine-tuning. T5 [RSR+20]
(Google, 2019) mantiene l’encoder-decoder completo, e il suo esercizio è un
denoising: si elimina il 15% dei token, a spezzoni contigui di tre in media,
e ogni spezzone lascia al suo posto un solo sentinel token, unico nella
sequenza; il bersaglio è la concatenazione degli spezzoni tolti, ciascuno
preceduto dal sentinel che lo sostituiva. Il contributo che gli ha dato il nome
sta però a valle: riformula ogni task NLP come text-to-text, mostrando che un
solo formato copre traduzione, sintesi, classificazione. La lezione comune:
pre-addestramento auto-supervisionato su corpora enormi + adattamento leggero
(il transfer learning che avevamo visto per le immagini, arrivato al
linguaggio; con una differenza che conta, perché sulle immagini quel
pre-addestramento era supervisionato, e il segnale glielo davano le etichette
di ImageNet).
ELECTRA [CLLM20] attacca l’inefficienza del masked language modeling: mascherando il \(15\%\) dei token, il segnale di addestramento arriva solo da quel \(15\%\). Sostituisce l’obiettivo con la replaced token detection. Un generatore piccolo (un MLM ordinario) rimpiazza i token mascherati con campioni plausibili; il discriminatore, che è ELECTRA, riceve la sequenza così corrotta e classifica ogni posizione come originale o sostituita. Il segnale viene da tutta la sequenza, il compito binario è più economico del softmax sul vocabolario, e a valle si getta il generatore e si rifinisce il discriminatore. Il guadagno che gli autori misurano è tutto sull’asse del calcolo: alla scala grande ELECTRA arriva alla resa dei modelli mascherati confrontabili dell’epoca spendendo meno di un quarto del loro addestramento, e la versione piccola, quattro giorni su una sola GPU, se la cava meglio di un modello autoregressivo che di calcolo ne aveva consumato trenta volte tanto. È una vittoria di obiettivo e non di architettura: la stessa rete impara di più dalle stesse frasi perché le viene chiesto qualcosa su ogni posizione invece che su una su sette.
La somiglianza con una GAN è dichiarata dagli autori stessi, e istruttiva soprattutto per dove si rompe: il generatore non è addestrato a ingannare il discriminatore (è addestrato con la sua verosimiglianza, come un normale MLM), non c’è vettore di rumore in ingresso, e quando produce per caso il token giusto quello viene etichettato come originale e non come falso. È un’architettura avversaria nella forma e cooperativa nella sostanza, e il capitolo sulle GAN mostrerà quanto dell’instabilità di quelle reti venga proprio dal pezzo che qui è stato tolto.
Fra i tre, T5 merita un disegno.

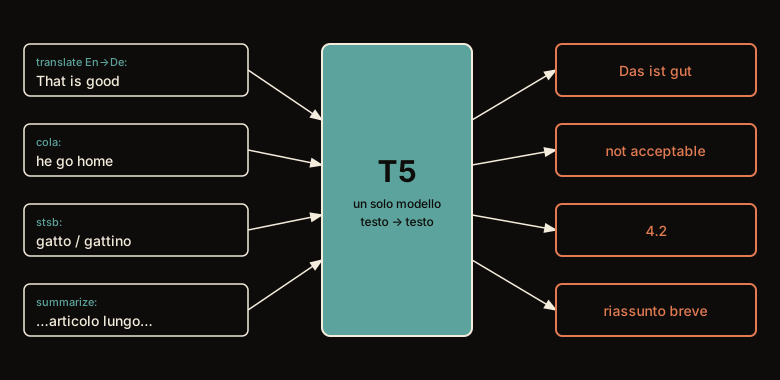
Fig. 16.9 Un solo formato per tutto. Di solito a un modello si attacca in cima un pezzo diverso per ogni mestiere, uno che sa dare voti, uno che sa scegliere fra due risposte; T5 non ne attacca nessuno: mette il nome del compito davanti alla frase, e la risposta esce come testo anche quando è un voto o un’etichetta.#
L’idea di Fig. 16.9 sembra un dettaglio ingegneristico e invece anticipa il modo in cui oggi si usano i modelli di linguaggio. Se ogni compito si può scrivere come testo in ingresso e testo in uscita, allora cambiare compito non richiede di cambiare il modello: basta cambiare quello che gli si scrive davanti. Quel «quello che gli si scrive davanti» è il prompt: le istruzioni e il testo che si consegnano al modello prima che risponda. Dentro il prompt ci si può mettere la sola consegna a parole, o anche due o tre esercizi già svolti perché il modello capisca che cosa gli si sta chiedendo. Che quei pochi esempi bastino a far eseguire un compito, senza aggiornare i parametri, è la scoperta di GPT-3 (l’in-context learning), dopo che GPT-2 [RWC+19] aveva mostrato lo stesso principio in forma grezza, con «TL;DR:» in coda a un articolo per farlo riassumere e coppie «frase inglese = frase francese» per farlo tradurre.
Oltre il testo: Vision Transformer e modelli multimodali#
Fin qui il Transformer ha sempre elaborato delle parole. Ma se si guarda bene, l’attenzione non sa niente delle parole: sa solo confrontare liste di numeri messe in fila. Qualunque cosa si riesca a ridurre a una fila di liste di numeri, allora, può entrarci dentro, e le immagini sono state fra le prime: nel 2018 l’Image Transformer [PVU+18] le generava pixel dopo pixel con l’attenzione, e nel 2020 il Vision Transformer ha mostrato che un encoder Transformer puro, senza convoluzioni, regge il confronto con le reti convoluzionali nel classificare fotografie, se è pre-addestrato su abbastanza dati.

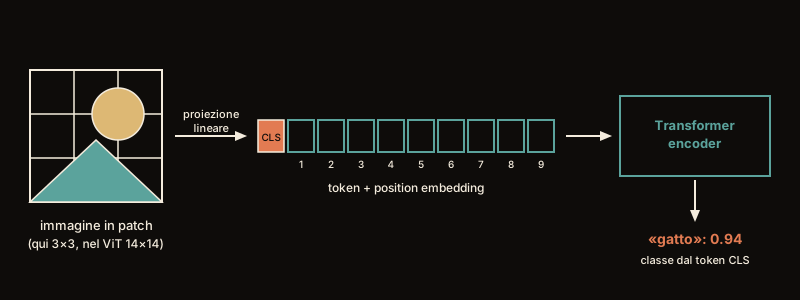
Fig. 16.10 Il Vision Transformer non inventa un meccanismo nuovo: taglia l’immagine in tessere e le tratta come parole. Da lì in poi è lo stesso encoder del testo.#
Il passaggio di Fig. 16.10 ha un costo. Le reti convoluzionali del capitolo sul deep learning, con i loro filtri che guardano un pezzetto di immagine alla volta, portano scritte nell’architettura due ipotesi sulle immagini: che i pixel vicini siano legati fra loro, e che lo stesso motivo conti dovunque compaia. È il loro bias induttivo. Con le tessere messe in fila e l’attenzione su tutte, due tessere adiacenti e due lontanissime partono alla pari, e la struttura dello spazio va imparata dai dati.
E le immagini? Si taglia la foto in tessere quadrate, come un mosaico, e si mettono le tessere in fila come se fossero le parole di una frase. A quel punto il Transformer fa quello che sa fare: per capire la tessera con l’orecchio del gatto, va a «guardare» anche quella con la coda, dall’altra parte della foto.
Quella libertà si paga. Ogni tessera porta scritto il posto da cui viene, ma nessuno le ha detto che due posti confinanti abbiano qualcosa a che fare l’uno con l’altro: la tessera accanto a quella dell’orecchio e la tessera della coda, per il Transformer, sono lontane uguale. Che i puntini vicini vadano insieme deve scoprirlo guardando fotografie, e gliene servono a milioni. Con una scatola di foto e basta il risultato è un po” peggiore di quello del metodo che guarda un pezzetto di foto alla volta, che quella regola ce l’ha scritta dentro e non deve impararla; con qualche accorgimento in più nello studio, la distanza si colma.
I modelli multimodali fanno il passo successivo: imparano testo e immagini insieme, su milioni di fotografie prese ciascuna con la sua didascalia, così puoi mostrare una foto e fare una domanda a parole, e la risposta arriva a parole. È quello che fa un assistente moderno quando gli carichi l’immagine di un modulo e gli chiedi di spiegartelo.
Il Vision Transformer (ViT [DBK+21]), che la sezione sul replicare un paper ha già costruito riga per riga, suddivide l’immagine in patch (tipicamente \(16 \times 16\) pixel), le proietta linearmente in embedding e le tratta come token, con un token di classe in testa e codifiche di posizione apprese in una dimensione sola. Gli embedding appresi ritrovano da soli la topologia bidimensionale (le patch della stessa riga o della stessa colonna finiscono con embedding simili), ed è per questo che le varianti scritte a mano in due dimensioni, o relative, non migliorano; e già dai primi strati alcune teste guardano quasi tutta l’immagine, mentre altre restano locali. Il punto essenziale è la condizione: senza il bias induttivo di località delle CNN, il ViT dell’articolo regge il confronto solo se pre-addestrato su dataset molto grandi (ImageNet-21k, JFT-300M). La soglia però si sposta con la ricetta: con aumentazione aggressiva, regolarizzazione e distillazione da una rete convoluzionale, DeiT [TCD+21] addestra lo stesso modello sul solo ImageNet-1k. La località non è gratis: o la si mette nell’architettura, o la si compra in dati. Sul fronte multimodale, CLIP [RKH+21] allinea in uno spazio comune embedding di immagini e testi tramite addestramento contrastivo su coppie immagine-didascalia; i modelli generativi di immagini usano il Transformer in due modi diversi, perché DALL·E [RPG+21] è esso stesso un Transformer autoregressivo da 12 miliardi di parametri che genera i token dell’immagine dopo quelli del testo, mentre la diffusione latente di Stable Diffusion [RBL+22] si condiziona sul testo con un encoder Transformer, attraverso la cross-attention; e modelli come GPT-4 (2023) accettano input misti testo+immagine.
Il principio, ed è il filo di tutto il discorso sui Transformer, è che tutto ciò che si riduce a una sequenza di token (le parole di una frase, le tessere di una foto, gli spezzoni di un suono) si può elaborare con l’attenzione. Come si costruisca davvero un modello che vede e parla è l’argomento di visione e linguaggio, che esplora e valuta i costi di tre strade: tenere immagini e parole ciascuna nel proprio spazio e addestrarle a mettere le cose corrispondenti nello stesso punto; innestare un encoder visivo su un modello di linguaggio già fatto, lasciando comandare il linguaggio; oppure dare a tessere e parole un unico vocabolario, come se le tessere fossero le parole di una lingua in più.
Fuori dal linguaggio: AlphaFold 2 e la forma delle proteine#
Lo stesso meccanismo lavora anche lontano da testi, foto e suoni, e il caso più noto viene da un campo che con il linguaggio non c’entra niente: la biologia.
Le proteine sono le macchine di cui siamo fatti, e ciascuna nasce come una catena di mattoncini agganciati in fila, che appena esiste si ripiega su sé stessa in una forma tridimensionale precisa. Da quella forma dipende tutto quel che la proteina sa fare, e prevederla a partire dalla sola fila di mattoncini era un problema aperto da mezzo secolo. Nel novembre 2020, alla CASP14 (la gara biennale in cui i programmi concorrenti si sfidano su proteine la cui struttura è nota solo agli organizzatori), AlphaFold 2 [JEP+21] ha predetto quelle forme con un’accuratezza confrontabile con le misure fatte in laboratorio per la maggior parte dei casi, sulle proteine formate da una catena sola.
Le due riserve, «nella maggior parte dei casi» e «una catena sola», hanno un peso preciso. Restano fuori le proteine fatte di più catene incastrate, i tratti che una forma stabile non ce l’hanno affatto, le proteine che ne assumono più d’una a seconda della situazione, e l’effetto delle mutazioni: la formula «problema risolto», che allora circolò molto, va letta con quell’elenco accanto.

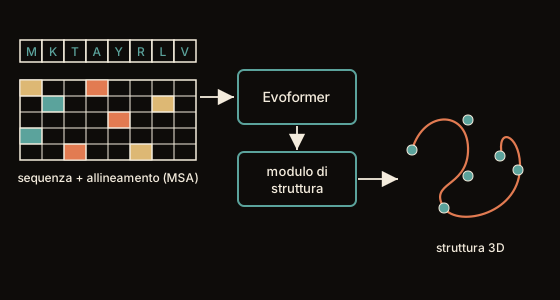
Fig. 16.11 I due ingressi contano quanto l’architettura. Oltre alla sequenza da ripiegare, AlphaFold legge l’allineamento con le proteine imparentate: l’evoluzione ha già fatto milioni di esperimenti, e quelli sono i dati.#
Il blocco centrale di Fig. 16.11 è dove l’attenzione serve di più. Gli anelli della catena, in gergo, si chiamano residui (termine senza alcun legame con la connessione residua delle reti). Due residui lontanissimi lungo la catena possono ritrovarsi appiccicati una volta che la catena si è ripiegata: è la relazione fra due elementi lontani che i filtri delle reti per immagini faticano a vedere, ed è esattamente il caso che l’attenzione tratta come normale, perché per lei ogni coppia è a un passo di distanza.
Una collana di perline di venti colori, agganciate in un ordine preciso. I venti colori sono i venti tipi di amminoacido, i mattoncini della catena. Lasciata cadere, la collana si annoda su sé stessa sempre allo stesso modo, e prevedere quel nodo dal solo ordine delle perline era il problema.
La traccia da seguire l’ha lasciata l’evoluzione. Confrontando la stessa proteina in migliaia di specie diverse si scopre che certe posizioni della catena cambiano in coppia, e se una cambia cambia anche l’altra. Il motivo è che quelle due posizioni si toccano una volta che la collana si è annodata. Se muta una sola delle due il pezzo non combacia più, la proteina lavora peggio, e quella variante per strada si perde. Quel cambiare insieme (la co-evoluzione) è una traccia indiretta della vicinanza fisica.
AlphaFold la legge tenendo due fogli aperti sul tavolo. Sul primo c’è la stessa proteina come è scritta in migliaia di specie, una riga per specie. Sul secondo c’è una casella per ogni coppia di perline, e dentro la casella quanto si crede che quelle due finiscano a toccarsi. I due fogli si correggono a vicenda: quel che si nota leggendo le righe cambia i numeri nelle caselle, e i numeri nelle caselle fanno rileggere le righe con altri occhi. Arrivati in fondo si ricomincia da capo con i fogli già mezzi riempiti, più di una volta.
Le caselle, però, non sono indipendenti fra loro. Se la perlina 3 sta a due centimetri dalla 40, e la 40 sta a tre centimetri dalla 91, allora fra la 3 e la 91 non ci possono essere sei centimetri: al massimo cinque. È una regola che si vede solo guardando tre perline alla volta, mai due, e per questo la casella di una coppia viene aggiornata andando a leggere le altre due caselle del triangolo. Nessuno ha vietato al programma di scrivere sei. Gli si è dato il modo di accorgersene, e a rispettare la regola ci arriva a forza di esempi, come per tutto il resto.
In fondo escono le coordinate di ogni perlina nello spazio, e accanto a ogni perlina un voto da zero a cento: quanto il programma si fida di quel pezzo di risposta. Sopra novanta di solito ci ha preso anche nei dettagli; dove il voto resta basso per un tratto lungo, spesso quel tratto una forma fissa non ce l’ha davvero.
Tutto questo poggia sui parenti. Di una proteina rara, che esiste in poche specie, i cugini da confrontare sono pochi: con meno di una trentina di righe nel primo foglio la traccia da leggere quasi non c’è, e la previsione peggiora parecchio, mentre oltre il centinaio aggiungerne altre cambia poco.
Il sistema lavora su due rappresentazioni tenute in dialogo dall’Evoformer, una pila di blocchi che alternano attenzione e aggiornamenti moltiplicativi sui triangoli:
l’allineamento multiplo di sequenze (MSA), la stessa proteina in molte specie, da cui emerge il segnale di co-evoluzione;
la rappresentazione di coppia, una matrice indicizzata su ogni coppia di residui \((i,j)\): di fatto un grafo pesato sulla catena.
Le due si aggiornano a vicenda a ogni blocco: quel che si scopre nell’MSA raffina le coppie, e viceversa. Sulla rappresentazione di coppia agisce la triangle attention, che aggiorna \((i,j)\) guardando i cammini attraverso un terzo residuo \(k\). Serve a rendere esprimibile un vincolo che l’attenzione ordinaria non vede: le distanze devono rispettare la disuguaglianza triangolare, perché sono distanze in uno spazio reale, non affinità arbitrarie. L’architettura non impone il vincolo: lo rende rappresentabile, facendo dipendere ogni arco dagli altri due lati del triangolo. Che venga poi rispettato è cosa che la rete impara dai dati, non una garanzia strutturale.
Il modulo di struttura finale produce le coordinate atomiche trattando ogni residuo come un sistema di riferimento rigido, e il tutto viene ripassato più volte (recycling): l’uscita rientra come ingresso e la struttura si affina.
Da questo impianto derivano due conseguenze. Innanzitutto, il modello stima la propria confidenza, il pLDDT (predicted local distance difference test), un numero da 0 a 100 per ogni residuo che stima quanto la previsione concorderebbe in quel punto con la struttura sperimentale (è una stima dell’lDDT-Cα). Sopra 90 la previsione è considerata molto accurata, sopra 70 lo scheletro della catena è in genere corretto; e le regioni lunghe sotto 50 vanno lette come previsione di disordine più che come struttura [TAW+21], un raro caso in cui l’incertezza dichiarata ha un significato fisico. Inoltre, dipendendo dall’MSA, il metodo è più debole dove l’allineamento è povero. Jumper e colleghi riportano che l’accuratezza cala sensibilmente quando la profondità mediana dell’allineamento scende sotto una trentina di sequenze, mentre oltre un centinaio i miglioramenti sono piccoli: è il caso delle proteine orfane, che di parenti ne hanno pochi.
Il database pubblico che ne è seguito copre la quasi totalità di UniProt, cioè quasi ogni sequenza proteica catalogata (restano fuori le catene troppo corte o troppo lunghe, quelle con amminoacidi non standard e le proteine virali): nel giro di due anni la predizione di struttura è passata da problema di ricerca a servizio di consultazione.
Vantaggi e sfide#
Il quadro va chiuso con la stessa onestà con cui il confronto con i modelli precedenti aveva ammesso il costo quadratico. I vantaggi sono reali: ogni posizione raggiunge ogni altra in un solo passo, l’addestramento si spartisce fra migliaia di processori, e una sola architettura serve il testo, le immagini e l’audio. Ma anche le sfide sono reali:
Risorse: addestrare un grande modello richiede da centinaia a decine di migliaia di acceleratori che lavorano insieme per settimane o mesi (il più grande dei Llama 3 fino a sedicimila schede grafiche [GDJ+24]), con i consumi elettrici che ne seguono; anche solo eseguirlo può richiedere macchine fuori dalla portata di un laboratorio piccolo.
Dati: i corpora (cioè le grandi raccolte di testi su cui i modelli studiano) da miliardi di parole contengono errori, stereotipi e contenuti tossici, e i modelli li assorbono. Se in quei testi le infermiere sono sempre donne e gli ingegneri sempre uomini, il modello impara quella regola come impara la grammatica: sono i bias, cioè le distorsioni sistematiche dei dati, che diventano distorsioni del modello.
Affidabilità: un modello autoregressivo (che scrive una parola alla volta, ogni volta scegliendo una continuazione di quello che ha già scritto) assegna una probabilità a ogni continuazione e ne produce una, e il suo obiettivo premia la plausibilità del testo, non la verità. Le «allucinazioni» (risposte fluenti e sbagliate) sono quindi una conseguenza dell’obiettivo, come già nella matematica di un modello linguistico. Per i fatti arbitrari, quelli che nei dati compaiono una volta sola, un modello pre-addestrato e ben calibrato sbaglia con una frequenza vicina alla quota di quei fatti [KV24], e a ridurre gli errori serve il post-training.
Da ricordare
Tre modi di studiare, tre mestieri. GPT copre la pagina con la mano e indovina la parola dopo: diventa bravo a scrivere. BERT fa gli esercizi a buchi guardando prima e dopo: diventa bravo a capire. T5 rimette al loro posto i pezzi di frase che gli sono stati tolti, e riscrive ogni compito come un tema, con il nome del compito davanti.
La ricetta è sempre la stessa: prima si studia tantissimo per conto proprio, su montagne di testo e senza nessuno che corregga; poi si aggiusta il tiro sul compito che serve, con pochi esempi o solo con le istruzioni scritte davanti (il prompt).
ELECTRA cambia l’esercizio invece dell’architettura: fa il controllore su ogni parola invece di indovinarne una su sette, e a parità di fatica impara molto di più.
Le immagini entrano nello stesso meccanismo tagliandole in tessere e mettendole in fila come parole; da lì un modello può guardare una foto e rispondere a parole. La comodità si paga in esempi: che due tessere vicine siano imparentate va imparato da milioni di fotografie, e quando le foto sono poche, senza accorgimenti nello studio, il metodo che ne guarda un pezzetto alla volta resta un po” avanti.
Lo stesso meccanismo che pesa le parole di una frase pesa le coppie di anelli di una proteina, e AlphaFold prevede come la catena si ripiega leggendo la stessa proteina in migliaia di specie: le posizioni che cambiano in coppia sono quelle che si toccano. Dove i parenti sono pochi la traccia quasi non c’è, e la previsione peggiora.
I limiti vanno messi in conto quanto i pregi: costano moltissimo da addestrare, si portano dentro i pregiudizi dei testi su cui hanno studiato, e scrivono con la stessa sicurezza cose vere e cose inventate.
Da ricordare
GPT = decoder-only, indovina la parola successiva, forte nel generare; BERT = encoder-only bidirezionale, forte nel capire; T5 = encoder-decoder, denoising a spezzoni, e ogni task riscritto come text-to-text.
La ricetta comune è pre-addestramento auto-supervisionato su corpora enormi + adattamento (fine-tuning o prompt).
ELECTRA mostra che l’obiettivo conta quanto l’architettura: sostituire qualche token e far dire alla rete, per ogni posizione, se è originale o intrusa, dà segnale su tutta la sequenza invece che sul solo \(15\%\) mascherato, e a parità di calcolo rende molto di più.
ViT tratta l’immagine come una frase di tessere \(16\times16\), e paga in dati la località che le CNN hanno gratis nell’architettura; i modelli multimodali (CLIP, GPT-4) allineano testo e immagini.
AlphaFold 2 tiene in dialogo l’MSA e la rappresentazione di coppia dentro l’Evoformer, e la triangle attention rende esprimibile, non obbligatoria, la disuguaglianza triangolare sulle distanze. Stima la propria confidenza (pLDDT, da 0 a 100 per residuo) e dipende dall’MSA, quindi è più debole dove l’allineamento è povero, sotto una trentina di sequenze.
Costi computazionali, bias nei dati e allucinazioni vengono dalla scala e dall’obiettivo, e vanno messi in conto quanto i vantaggi.
Dalle immagini e dalle proteine si torna al testo, con una domanda nuova: che cosa succede quando lo stesso modello impara cento lingue insieme. È il seguito della storia della traduzione, e la sezione sui modelli multilingue la riprende dal 2016, dove la sezione sulla traduzione con le reti l’aveva lasciata.