


Dentro le reti profonde: attribuzione e interpretabilità meccanicistica#
Torniamo un’ultima volta al modello che credeva di riconoscere i lupi e in realtà riconosceva la neve, quello con cui si è aperto il capitolo. Le macchie colorate che lo smascherarono le aveva disegnate LIME, il metodo delle spiegazioni locali: trattava il modello come una scatola chiusa, gli passava l’immagine con alcune porzioni spente e guardava come cambiava la risposta, senza mai aprire niente.
Eppure quel modello si poteva aprire. La parte che decideva era una regressione logistica (la somma pesata che dà una probabilità, della sezione sui modelli trasparenti), addestrata sulle venti foto; riceveva in ingresso le attivazioni del primo strato di max-pooling di Inception, una rete per immagini già addestrata da altri e lasciata com’era [RSG16]. La scorciatoia («c’è neve → lupo») l’aveva imparata la regressione logistica, non la rete sotto. E un modello così si può derivare da capo a capo, quindi i metodi che seguono le derivate ci avrebbero lavorato benissimo; LIME però non ne aveva bisogno, perché gli bastano le risposte, ed è per questo che funziona anche dove aprire non si può.
Quando il modello lo abbiamo in mano, insomma, e dentro c’è una rete neurale con tutti i suoi numeri, si può smettere di bussare da fuori e andare a guardare che cosa succede lì dentro. Qualche attrezzo che guarda dentro l’abbiamo già usato (l’importanza da impurità legge i tagli di un albero, TreeSHAP ne sfrutta la forma), ma erano alberi, e un albero si legge. Qui la cosa da aprire è una rete, e cambia tutto.
I modelli trasparenti si spiegano da soli: un modello a somma consegna un numero per ogni colonna, e quel numero è la spiegazione. Una rete neurale no. Ha milioni di numeri intrecciati, e nessuno di essi, preso da solo, dice qualcosa di sensato. Bisogna cambiare domanda. Non «quanto pesa questa colonna in generale?», ma «quanto ha contribuito questo pezzo dell’ingresso a questa risposta?». La quota di merito che si assegna a ciascun pezzo dell’ingresso si chiama attribuzione. La risposta, sorprendentemente, viene da uno strumento già usato per tutt’altro mestiere: il gradiente.
Mappe di salienza: il gradiente come misura di importanza#
Di quanto si sposta l’uscita di una rete se si cambia di un nulla uno solo dei suoi ingressi, lasciando fermi gli altri? Per ogni ingresso la risposta è una derivata parziale, e messe in fila formano il gradiente dell’uscita rispetto agli ingressi.
Nell’addestramento il gradiente si calcola rispetto ai pesi \(\theta\) della rete, e l’uscita da guardare è la perdita: spostare i pesi nel verso che la fa scendere è l’addestramento, con la backpropagation. Qui la stessa backpropagation si prosegue fino all’ingresso, con i pesi fermi, e l’uscita da guardare è il punteggio che la rete assegna alla risposta che ha scelto. Se la rete sceglie fra mille risposte possibili (cane, gatto, camion: si chiamano le classi), è il punteggio di quella classe, prima della softmax. Il gradiente rispetto ai pixel è una mappa grande quanto l’immagine, che dice quanto ciascun pixel conta per quel punteggio, e si chiama mappa di salienza, cioè di ciò che «salta all’occhio» (in inglese saliency map, ed è così che la si trova nei programmi): l’hanno proposta Simonyan, Vedaldi e Zisserman nel 2014 [SVZ14].
Quali pixel, toccati appena, cambierebbero il verdetto della rete? Sposta di un nulla il pixel del muso e la fiducia in «cane» crolla: quel pixel è importante. Tocca un pixel dello sfondo e non succede niente: quello non conta. La mappa di salienza è questa, un’immagine in bianco e nero delle stesse dimensioni della foto, che si accende dove un piccolo ritocco farebbe la differenza più grande.
È come cercare i punti fragili di un castello di carte: dai un colpetto qua e là e guardi che cosa fa tremare tutta la struttura. Il difetto più visibile è che due pixel vicini, che a occhio nostro fanno parte della stessa cosa, possono rispondere in modo molto diverso: uno fa tremare tutto, quello accanto niente. La mappa risulta allora piena di puntini sparsi (si dice che è rumorosa, come una radio male sintonizzata), e la forma dell’oggetto si intravede appena.
Il secondo difetto è meno visibile. Il colpetto dice quanto è fragile questo castello, così com’è messo adesso: sposta una carta e i punti fragili non sono più gli stessi. La mappa vale per la foto che hai davanti, non per le foto di cane in generale.
Sia \(S_c(\mathbf{X})\) il punteggio (il logit, prima della softmax) che la rete assegna alla classe \(c\) per l’immagine \(\mathbf{X}\). La saliency map è il modulo del gradiente del punteggio rispetto all’ingresso:
calcolato con una singola backpropagation fino allo strato di input anziché fermarsi ai pesi. L’idea è una linearizzazione locale: nell’intorno di \(\mathbf{X}\), \(S_c(\mathbf{X} + \boldsymbol{\Delta}) \approx S_c(\mathbf{X}) + \sum_{i,j} \big(\partial S_c/\partial X_{ij}\big)\, \Delta_{ij}\), quindi le componenti del gradiente di modulo maggiore individuano i pixel la cui piccola variazione altera di più il punteggio. Per un’immagine a colori si prende in genere il massimo del modulo sui tre canali RGB.
Il limite è duplice. Primo, il gradiente è locale: coglie la pendenza solo nel punto \(\mathbf{X}\), e le reti profonde sono tutt’altro che lineari. Secondo, è rumoroso, perché la superficie \(S_c\) ha derivate che oscillano rapidamente. Le mappe risultano granulose, e le tecniche successive nascono quasi tutte per domare questo rumore. La più diretta è SmoothGrad di Smilkov e colleghi [STK+17], che media il gradiente su copie dell’ingresso perturbate con rumore gaussiano,
con \(\sigma\) fra il 10 e il 20% dell’escursione dei pixel e \(N \approx 50\): è la stima Monte Carlo del gradiente di \(S_c\) convoluto con una gaussiana, cioè di una versione lisciata della funzione, e costa \(N\) passate avanti e indietro invece di una; la mappa è poi il modulo di \(\hat{\mathbf{M}}\). L’altra variante, che tornerà nei controlli di sanità, è gradient \(\odot\) input, \(\mathbf{X} \odot \partial S_c/\partial\mathbf{X}\): per un modello lineare senza bias restituisce esattamente il contributo \(w_i x_i\) di ciascun ingresso, ed equivale agli Integrated Gradients (il metodo che integra il gradiente lungo un cammino da una baseline all’ingresso) con baseline nulla e un solo passo di integrazione, valutato all’arrivo.
Grad-CAM: dove guarda la rete#
La salienza lavora sui pixel e paga in rumore. Un’alternativa più stabile rinuncia alla risoluzione fine e chiede una cosa più grossolana ma più robusta: in quale regione dell’immagine la rete ha trovato le prove della sua decisione? È l’idea di Grad-CAM (Gradient-weighted Class Activation Mapping), di Selvaraju e colleghi nel 2017 [SCD+17].
Serve prima una parola. Quando un’immagine attraversa una rete, ogni pezzo della rete produce dei numeri, e quei numeri sono la fotografia di ciò che la rete «ha in mente» a quel punto del percorso: si chiamano le attivazioni di quello strato.
Come abbiamo visto nella sezione su classificazione e transfer learning, in una rete fatta per le immagini le attivazioni cambiano natura salendo di strato in strato: in basso rispondono a bordi, angoli e macchie di colore, più in alto a forme via via più complesse, la trama di un pelo, un occhio, un muso. Nell’ultimo strato di quel tipo (si chiama convoluzionale) ce ne sono centinaia, una per ciascuna forma ricorrente che la rete ha imparato a riconoscere, e ognuna è accesa nei punti dell’immagine in cui quella forma compare. Ognuna, insomma, è come un faretto puntato su una parte della foto.
E adesso il passaggio: il gradiente si può puntare anche su quei faretti, non solo sui pixel. La domanda diventa «se questo faretto si accendesse un po’ di più, di quanto salirebbe la fiducia nella risposta?». Grad-CAM lo chiede per ogni faretto, facendo la media su tutta la zona che il faretto illumina; poi somma i faretti, ciascuno con la sua luce moltiplicata per quel numero. Se stiamo spiegando la risposta «cane», i faretti sul muso e sulle orecchie pesano tanto, quelli sull’erba pesano zero. Sovrapposti alla foto, danno una macchia calda (una heatmap) che dice dove sta quello che ha spinto la rete a dire «cane». Dove invece i faretti tirano dall’altra parte, verso una risposta diversa, la macchia resta fredda: tiene le prove a favore, non quelle contro. È grossolana (la risoluzione è quella dell’ultimo strato, non dei pixel), ma è pulita, ed è fatta per l’uso diagnostico: su un modello che avesse imparato a guardare lo sfondo, ci si aspetta che la macchia calda cada sullo sfondo. Il rilevatore di lupi, però, era stato smascherato con LIME, e che Grad-CAM su quel modello avrebbe acceso la neve resta una previsione.
Sia \(\mathbf{A}^k \in \mathbb{R}^{u \times v}\) la \(k\)-esima feature map dell’ultimo strato convoluzionale e \(S_c\) il punteggio della classe \(c\). Grad-CAM procede in due mosse. Prima calcola un peso per ogni mappa, mediando spazialmente il gradiente della classe rispetto a quella mappa:
dove \(A^k_{ij}\) è il valore della mappa nella posizione \((i,j)\) e \(Z = u\,v\) è il numero di posizioni (un global average pooling del gradiente). Poi combina le mappe pesate e tiene solo il contributo positivo:
Il peso \(\alpha_k^c\) misura quanto la mappa \(k\) conta per la classe \(c\); la \(\mathrm{ReLU}\) scarta le regioni che abbassano il punteggio, tenendo solo quelle che lo sostengono. La heatmap \(\mathbf{L}^c\) ha la bassa risoluzione dello strato convoluzionale (\(7\times 7\) in una ResNet su input \(224\times 224\)) e va sovracampionata alle dimensioni dell’immagine per la sovrapposizione. A differenza della saliency, non risale ai pixel: guadagna in stabilità rispetto al rumore ciò che perde in dettaglio spaziale, e di solito mette in evidenza la regione dell’oggetto che sostiene la classe. È una mappa della regione da cui parte il calcolo, senza prova che la rete usi proprio quell’evidenza, e i controlli di sanità di Adebayo e colleghi ne delimitano la sensibilità al modello.
Uno sketch di Grad-CAM in PyTorch#
Su una rete vera, Grad-CAM si costruisce agganciando allo stadio
convoluzionale finale due hook, funzioni che PyTorch chiama da sé quando il
calcolo passa di lì: uno cattura le attivazioni in avanti, l’altro i gradienti
all’indietro. In una ResNet il punto giusto è l’uscita dell’ultimo
blocco di layer4, dopo la somma residuale: è lì che agganciano le
implementazioni di riferimento, perché fermarsi a una convoluzione interna al
blocco ignorerebbe il contributo della scorciatoia. Ecco lo scheletro su una
ResNet-18 di torchvision.
import torch
import torch.nn.functional as F
from torchvision import models

model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1).eval()
target = model.layer4[-1]                # ultimo blocco: uscita post-residuo

att, grad = {}, {}
target.register_forward_hook(lambda m, i, o: att.__setitem__("v", o.detach()))
target.register_full_backward_hook(
    lambda m, gi, go: grad.__setitem__("v", go[0].detach())
)

x = torch.randn(1, 3, 224, 224)          # immagine gia pre-processata
logit = model(x)                          # (1, 1000)
classe = logit.argmax(dim=1)              # classe predetta
model.zero_grad()
logit[0, classe].backward()               # gradiente della sola classe scelta

A = att["v"]                              # attivazioni  (1, C, h, w)
dY = grad["v"]                            # gradienti    (1, C, h, w)
alpha = dY.mean(dim=(2, 3), keepdim=True)  # peso per canale (global avg pool)
heatmap = F.relu((alpha * A).sum(dim=1))   # (1, h, w), solo contributi positivi
heatmap = heatmap / (heatmap.max() + 1e-8) # normalizzata in [0, 1]
# heatmap va poi sovracampionata a 224x224 e sovrapposta all'immagine

print("attivazioni:", tuple(A.shape))
print("gradienti  :", tuple(dY.shape))
print("heatmap    :", tuple(heatmap.shape))
attivazioni: (1, 512, 7, 7)
gradienti  : (1, 512, 7, 7)
heatmap    : (1, 7, 7)
cioè 512 mappe di attivazione da \(7 \times 7\) ciascuna, altrettanti gradienti, e una sola heatmap \(7 \times 7\) che le riassume. Quel \(7 \times 7\) è la risoluzione a cui la rete è arrivata dopo aver rimpicciolito più volte l’immagine di partenza, che era \(224 \times 224\): è per questo che una heatmap Grad-CAM è per forza grossolana, e va poi ingrandita per essere sovrapposta alla foto.
Il cuore del calcolo è tutto nelle ultime tre righe. alpha è il peso di
ciascuna delle 512 mappe, cioè il suo gradiente mediato su tutte le posizioni;
la riga dopo somma le mappe con quei pesi e con relu butta via i contributi
negativi, tenendo solo le zone che sostengono la risposta; l’ultima porta i
valori fra \(0\) e \(1\) per poterli disegnare (il \(10^{-8}\) evita una divisione per
zero nel caso, raro ma possibile su una classe non predetta, in cui relu
azzeri tutta la mappa). Qui l’immagine è rumore tirato a caso (torch.randn):
basta a controllare le forme dei numeri, ma non dà una mappa da guardare. Su
una vera foto di cane ci si aspetta la macchia calda sul muso, e su un modello
che avesse imparato la scorciatoia della neve la si aspetterebbe sulla neve:
è l’uso diagnostico per cui il metodo è fatto, e su una foto vera va provato,
non dato per scontato.
Non un punto solo, ma tutto il cammino: gli Integrated Gradients#
Sia la salienza sia Grad-CAM misurano il gradiente in un solo punto, l’immagine così com’è, e qui si nasconde un problema.
Dentro una rete ci sono funzioni che a un certo punto smettono di reagire: crescono ripide finché quello che ricevono è piccolo, e poi si appiattiscono, perché quello che restituiscono ha un massimo che non può superare. La curva a esse che si comporta così, ripida in mezzo e piatta alle due estremità, è la sigmoide vista nel capitolo sulle reti neurali; e di un neurone arrivato sul tratto piatto si dice che è saturo. Su un tratto piatto, però, il gradiente è quasi zero: toccare l’ingresso non cambia più niente, perché la rete è già convinta. Il paradosso è che il gradiente dichiara «questo pixel non conta» proprio quando quel pixel è la ragione per cui la rete è così sicura.
Nel 2017 Sundararajan, Taly e Yan hanno affrontato la questione in un modo diverso dal solito [STY17]. Il metodo che ne è uscito si chiama Integrated Gradients, cioè «gradienti integrati»: integrare, qui, vuol dire raccogliere lungo tutta una strada invece che in un punto solo, ed è esattamente quello che sta per succedere. Invece di inventare un metodo e poi guardare se le mappe venivano belle, hanno scritto prima due assiomi, cioè due proprietà che una buona spiegazione deve avere, e poi hanno cercato il metodo che le rispetta.
Prima di enunciarli, però, serve un oggetto che avrà un ruolo grosso in tutta la sezione: un ingresso «vuoto», da cui partire, che per un’immagine sarà tipicamente un rettangolo tutto nero. È la situazione in cui il modello non ha davanti niente, e si chiama baseline, che è l’inglese per «linea di partenza». È parente della risposta base delle spiegazioni locali, e i due vanno tenuti distinti: là si dava un nome a quanto risponde il modello quando non sa niente, qui all”ingresso che gli si mette davanti per non fargli sapere niente.
Il primo assioma è la sensibilità, e va enunciato con la sua condizione, altrimenti dice il falso. Prendiamo un ingresso e la baseline, e supponiamo che differiscano per una cosa sola: un pixel, e nient’altro. Se su quei due il modello risponde in modo diverso, allora quel pixel deve ricevere una quota di merito diversa da zero. Non si può dire «non conta niente» di quello che è l’unica differenza fra i due casi.
Il secondo assioma è l’invarianza all’implementazione: due reti costruite in modo diverso, ma che a conti fatti calcolano esattamente la stessa cosa, devono ricevere le stesse attribuzioni. La spiegazione riguarda cosa la rete calcola, non come è scritta, ed è questo assioma a separare i gradienti integrati dai metodi che dividono il risultato all’indietro, strato per strato.
Ed è proprio il primo assioma che il gradiente misurato nel solo punto d’arrivo viola, nei casi di saturazione: lì risponde zero anche quando quel pixel è l’unica differenza che c’è fra l’immagine e la baseline.
Invece di misurare la pendenza solo nel punto di arrivo, percorri la strada che va dalla baseline, l’immagine tutta nera, fino all’immagine vera, mescolandole a poco a poco. La strada si divide in tappe uguali, mettiamo otto, e ogni tappa copre un pezzetto di strada, un ottavo. A ogni tappa ti chiedi di quanto cambierebbe la fiducia della rete se toccassi appena quel pixel, e alla fine fai la media delle otto risposte. Così, anche se all’arrivo la rete è satura e non reagisce più, hai comunque registrato la sua reazione lungo tutta la salita, quando reagiva eccome.
Resta un ultimo passo, e c’è una ragione per farlo. Quella media dice quanto la rete reagisce a un ritocco di quel pixel; a noi serve quanto ha contato il pixel per intero, cioè tutta la strada che ha percorso dal nero al suo valore vero. Quindi si moltiplica la media per quella strada: un pixel che è passato da nero a bianco pieno l’ha fatta tutta e si prende tutto; uno che è rimasto quasi nero ne ha fatta pochissima e si prende quasi niente.
Fare la media di otto numeri e poi moltiplicarla per tutta la strada è la stessa identica cosa che sommare otto contributi, ciascuno la pendenza di una tappa moltiplicata per il suo pezzetto di strada. Media o somma, dunque, sono due modi di dire lo stesso conto.
E il conto torna, che è la proprietà bella di questo metodo: se le tappe sono abbastanza fitte, sommando le attribuzioni di tutti i pixel si ottiene quanto la fiducia della rete è cambiata fra l’immagine nera e quella vera. Con otto tappe torna quasi, e più tappe si fanno, meglio torna; con infinite tappe tornerebbe esatto. Niente si perde e niente si inventa. Quella proprietà ha un nome: si chiama completezza. È come dividere il conto di una cena tra i commensali in modo che la somma delle quote faccia, al centesimo, il totale sullo scontrino.
Sull’analogia della cena, però, c’è una domanda scomoda da fare subito: il conto torna, ma torna a partire da dove? Il punto di partenza, quell’immagine nera, non è un fatto di natura: è una scelta, e la scelta cambia le risposte. La più chiara delle conseguenze è questa: di ciò che era già nero in partenza non si può misurare nessun contributo, perché fra partenza e arrivo non è cambiato. Se la ragione della decisione fosse proprio una zona buia della foto (un’ombra, il cielo notturno, il nero di una radiografia), quel metodo le darebbe zero, e la somma tornerebbe lo stesso. Che il conto torni non dice che si è partiti dal punto giusto.
Sia \(\mathbf{x}'\) la baseline, il punto di riferimento «neutro» rispetto a cui si misura il contributo (per un’immagine, tipicamente il nero, \(\mathbf{x}' = 0\)), e \(\mathbf{x}\) l’ingresso da spiegare. In forma precisa, l’assioma di sensibilità chiede che se \(\mathbf{x}\) e \(\mathbf{x}'\) differiscono in una sola componente e \(f(\mathbf{x}) \neq f(\mathbf{x}')\), quella componente riceva attribuzione non nulla: è proprio ciò che il gradiente valutato nel solo punto \(\mathbf{x}\) non garantisce, perché in regime di saturazione è quasi zero anche quando quella componente è la ragione dell’uscita.
Gli Integrated Gradients integrano il gradiente lungo il segmento rettilineo da \(\mathbf{x}'\) a \(\mathbf{x}\):
dove \(f\) è l’uscita della rete per la classe d’interesse, \(\alpha \in [0,1]\) parametrizza il cammino e \(\mathrm{IG}_i\) è l’attribuzione della \(i\)-esima componente d’ingresso. In pratica l’integrale si approssima con una somma di Riemann su \(m\) passi. Integrando lungo il cammino, il metodo cattura anche i gradienti prima della saturazione, dove il segnale è vivo, risolvendo la cecità del gradiente locale.
La proprietà più importante è la completezza: se \(f\) è differenziabile quasi ovunque lungo il cammino (lo è una rete con ReLU), le attribuzioni sommano esattamente alla differenza di uscita tra input e baseline,
La completezza implica la sensibilità e conferisce alle attribuzioni un significato preciso: ciascuna è la quota di quel salto di punteggio imputabile a quella componente.
C’è però un limite, ed è il punto in cui il metodo si presta a essere letto per più di quel che promette: la completezza vale per qualunque baseline. Gli assiomi vincolano come si ripartisce il salto \(f(\mathbf{x}) - f(\mathbf{x}')\), non da dove il salto parte, e la scelta di \(\mathbf{x}'\) resta il grado di libertà principale del metodo. Due conseguenze concrete. La prima è che il fattore \((x_i - x'_i)\) davanti all’integrale azzera per costruzione l’attribuzione di ogni componente che coincide con la baseline: con la baseline nera ogni pixel nero riceve esattamente zero, per definizione e non per misura, mentre in una radiografia o in una foto notturna il nero non è affatto assenza di informazione. La seconda è che cambiando baseline le attribuzioni cambiano di grandezza e perfino di segno, mentre la somma continua a tornare: sulla funzione giocattolo \(f(\mathbf{x}) = \tanh(\mathbf{w}^\top \mathbf{x})\) con \(\mathbf{w} = (2,-1)\) e \(\mathbf{x} = (2,1)\), spostando la baseline da \((0,0)\) a \((2,0)\) l’attribuzione della componente con il peso maggiore passa da \(1{,}327\) a esattamente \(0\), e con la baseline \((-1,2)\) la seconda componente prende segno positivo invece che negativo; in tutti e tre i casi la completezza è verificata al quarto decimale. Gli autori raccomandano di controllare che sulla baseline il punteggio sia quasi nullo, così che le attribuzioni si leggano come funzione del solo ingresso, e vogliono che la baseline rappresenti un’assenza di segnale; e raccomandano un secondo controllo, sulla somma di Riemann: che le attribuzioni sommino approssimativamente a \(f(\mathbf{x}) - f(\mathbf{x}')\), aumentando \(m\) se non lo fanno (nei loro esperimenti bastano da 20 a 300 passi per stare entro il 5%). Le alternative d’uso comune (rumore gaussiano, immagine sfocata, media del dataset, media su più baseline) danno attribuzioni diverse, e nessun assioma le ordina [SLL20].
Il metodo si capisce guardandolo lavorare lungo tutta la strada, perché un punto solo, l’arrivo, è proprio quello in cui il gradiente non dice niente. In Fig. 37.6 c’è il cammino, percorso a passi.

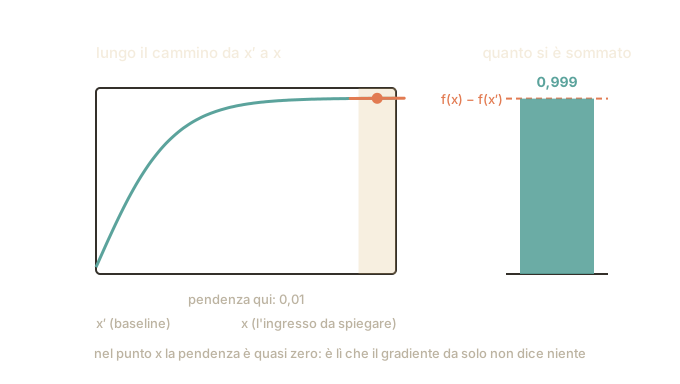
Fig. 37.6 Il cammino dall’immagine neutra a quella vera, percorso a otto tappe. A sinistra la fiducia della rete lungo la strada, e a ogni tappa un trattino che mostra quanto è ripida lì: molto all’inizio, quasi niente alla fine. A destra la somma che si accumula tappa per tappa, e la riga tratteggiata che segna dove deve arrivare. La curva del disegno è quella di un neurone che satura, la stessa forma della sigmoide, e i numeri sono calcolati su di essa.#
Il disegno di Fig. 37.6 mostra due cose che il conto, da solo, non fa vedere.
La prima è quanto la saturazione morda. Sulla curva della figura la pendenza (di quanto salirebbe la fiducia della rete a spingere un pochino sull’ingresso) vale \(3{,}76\) alla prima delle otto tappe e \(0{,}0088\) all’ultima, oltre quattrocento volte meno, e nel punto d’arrivo scende ancora. È su un numero così che lavora un metodo che guardi solo l’arrivo, e che dichiara «non conta niente» un pixel che è tutta la spiegazione.
La seconda è che la barra di destra si ferma sulla riga, e qui due cose vanno separate. Che la riga sia il posto giusto è un teorema: se si misura la pendenza in ogni punto del cammino, la somma fa esattamente il salto di fiducia fra partenza e arrivo, purché la curva sia derivabile quasi ovunque. È la completezza. Che ci arrivi una somma di otto sole tappe, invece, non lo garantisce niente: lungo ogni tappa la pendenza cala, e bisogna decidere in che punto della tappa misurarla. Nel disegno la si misura a metà, e il totale, \(0{,}999356\), si scosta dal valore vero, \(0{,}999329\), di appena \(0{,}000027\); misurandola all’inizio di ogni tappa, dove la salita è più ripida, la si sopravvaluterebbe ogni volta, e il totale verrebbe \(1{,}248939\), un quarto di troppo. Il conto torna per teorema; la sua approssimazione no.
Integrated Gradients coi numeri: un esempio eseguibile#
Il conto della completezza si può rifare su un esempio che gira. La funzione che segue non è quella disegnata poco fa: ha due variabili invece di una, così che si possano guardare due attribuzioni separate, ed è costruita apposta per saturare. È un neurone solo, \(f(\mathbf{x}) = \tanh(\mathbf{w}^\top \mathbf{x})\) con \(\mathbf{w} = (2, -1)\): la somma pesata dei due ingressi passata nella tangente iperbolica \(\tanh\), una curva a esse come la sigmoide, che però va da \(-1\) a \(1\). Nel punto \(\mathbf{x} = (2, 1)\) la somma pesata vale \(2 \cdot 2 - 1 \cdot 1 = 3\) e \(\tanh 3 \approx 0{,}995\): siamo sul tratto piatto, e il gradiente, \((1 - \tanh^2 3)\,\mathbf{w}\) per la regola della catena, è quasi nullo. Un solo gradiente direbbe che nessuno dei due ingressi conta; i gradienti integrati, partendo dalla baseline tutta a zero, recuperano l’intero contributo. In fondo il blocco rifà il conto con due baseline diverse.
import numpy as np

# funzione giocattolo che satura: f(x) = tanh(w . x)
w = np.array([2.0, -1.0])

def f(x):
    return np.tanh(w @ x)

def grad_f(x):
    z = w @ x
    return (1.0 - np.tanh(z) ** 2) * w   # regola della catena

x = np.array([2.0, 1.0])     # input da spiegare
baseline = np.zeros(2)        # baseline neutra (lo "zero")

# gradiente grezzo nel solo punto x: saturo, quasi nullo -> saliency cieca
print("gradiente in x :", np.round(grad_f(x), 4))

# Integrated Gradients: media dei gradienti lungo il cammino baseline -> x
m = 200
alphas = (np.arange(1, m + 1) - 0.5) / m   # punti medi delle m tappe
def integrati(base):
    medio = np.mean([grad_f(base + a * (x - base)) for a in alphas], axis=0)
    return (x - base) * medio

ig = integrati(baseline)
print("attribuzioni IG:", np.round(ig, 4))

# assioma di completezza: la somma delle attribuzioni = f(x) - f(baseline)
print("somma IG       :", round(ig.sum(), 4))
print("f(x) - f(base) :", round(f(x) - f(baseline), 4))

# la baseline è un grado di libertà: stessa f, stesso x, altre due baseline
for base in ([2.0, 0.0], [-1.0, 2.0]):
    base = np.array(base)
    ig_b = integrati(base)
    print(f"baseline {base}: IG {np.round(ig_b, 4)}, somma {ig_b.sum():.4f},",
          f"f(x) - f(base) {f(x) - f(base):.4f}")
gradiente in x : [ 0.0197 -0.0099]
attribuzioni IG: [ 1.3267 -0.3317]
somma IG       : 0.9951
f(x) - f(base) : 0.9951
baseline [2. 0.]: IG [ 0.     -0.0043], somma -0.0043, f(x) - f(base) -0.0043
baseline [-1.  2.]: IG [1.7095 0.2849], somma 1.9944, f(x) - f(base) 1.9944
Il gradiente nel punto è \((0{,}0197,\, -0{,}0099)\): minuscolo, come previsto per un neurone saturo. Ma le attribuzioni integrate valgono \((1{,}3267,\, -0{,}3317)\) e la loro somma, \(0{,}9951\), coincide al quarto decimale con \(f(\mathbf{x}) - f(\mathbf{0}) = 0{,}9951\): la completezza è verificata. Nota anche il segno: la prima variabile (\(w_1 = 2 > 0\)) spinge il punteggio in alto, la seconda (\(w_2 = -1 < 0\)) lo tira giù, esattamente come ci si aspetta. Le altre due baseline mostrano il grado di libertà del metodo: partendo da \((2, 0)\) la prima variabile, che non cambia fra partenza e arrivo, prende esattamente zero, e partendo da \((-1, 2)\) la seconda prende segno positivo; in tutti e tre i casi la somma torna.
I numeri della Fig. 37.6 li rifà un secondo blocco, sulla curva \(\tanh(4a)\) del disegno: la somma delle otto tappe misurando la pendenza a metà di ciascuna e al suo inizio, e la pendenza alla prima e all’ultima.
import numpy as np

# la curva della figura: tanh(4a) fra a = 0 e a = 1, percorsa in otto tappe
pendenza = lambda a: 4 * (1 - np.tanh(4 * a) ** 2)
tappe, lungo = 8, 1 / 8
vero = np.tanh(4.0)
for nome, punti in [("a metà tappa", (np.arange(tappe) + 0.5) * lungo),
                    ("a inizio tappa", np.arange(tappe) * lungo)]:
    somma = sum(pendenza(a) * lungo for a in punti)
    print(f"{nome:14}: somma {somma:.6f}, vero {vero:.6f}, "
          f"scarto {somma - vero:.6f} ({(somma - vero) / vero:.2%})")
prima, ultima = pendenza(0.5 * lungo), pendenza(7.5 * lungo)
print(f"pendenza alla prima tappa {prima:.2f}, all'ultima {ultima:.4f}, "
      f"rapporto {prima / ultima:.0f}")
a metà tappa  : somma 0.999356, vero 0.999329, scarto 0.000027 (0.00%)
a inizio tappa: somma 1.248939, vero 0.999329, scarto 0.249610 (24.98%)
pendenza alla prima tappa 3.76, all'ultima 0.0088, rapporto 425
Tre famiglie sullo stesso neurone: gradiente, propagazione, perturbazione#
Le mappe di attribuzione, a guardarle da vicino, rispondono a domande diverse, e si dividono in tre famiglie secondo la domanda. I metodi a gradiente (la salienza, i gradienti integrati, e il gradiente per ingresso, cioè la pendenza moltiplicata per il valore della variabile) chiedono di quanto cambierebbe l’uscita muovendo di poco l’ingresso, o sommano questa pendenza lungo un cammino. I metodi a propagazione (LRP, DeepLIFT) prendono l’uscita e la ridistribuiscono all’indietro strato per strato, con una regola che ne conserva la somma. I metodi a perturbazione (l’occlusione) tolgono un pezzo dell’ingresso e guardano quanto l’uscita cambia. Il neurone saturo dell’esempio eseguibile, \(f(\mathbf{x}) = \tanh(\mathbf{w}^\top\mathbf{x})\) in \(\mathbf{x} = (2, 1)\), basta a mostrare dove danno risultati diversi.
Una squadra vince 5 a 0, e si vuole sapere chi ha fatto la vittoria. Le domande possibili sono tre, e danno risposte diverse.
La prima chiede che cosa sarebbe cambiato se un giocatore avesse corso un filo di più. Sul 5 a 0, niente: la partita è già vinta, e un piccolo cambio non sposta il risultato. È la domanda del gradiente, e davanti a un risultato già saturo dice che non ha contato nessuno.
La seconda toglie un giocatore alla volta e rigioca la partita. In squadra, oltre al centravanti, c’è un difensore che ogni tanto sbaglia e regala un gol agli avversari. Tolto il centravanti, i gol li segnano solo gli avversari, grazie agli errori del difensore: la squadra perde, e fa peggio di una squadra vuota, che almeno pareggerebbe zero a zero. Contato così, il merito del centravanti è più grande di tutta la vittoria. Tolto il difensore, invece, la squadra vince sempre largo, perché la vittoria era già piena e di più non può essere: i suoi errori nel risultato quasi non si vedono più, e il suo demerito quasi sparisce dal conto. È l’occlusione: dice qualcosa di vero su ciascuno, ma i meriti dei giocatori, sommati, non fanno la vittoria.
La terza parte dal risultato e lo divide all’indietro. Il 5 a 0 si spartisce fra le azioni, e il merito di ogni azione fra chi ha toccato palla, in proporzione a quanto ciascuno ci ha messo: chi ha spinto verso la porta ne prende, chi ha regalato la palla agli avversari ne perde. Qui i conti tornano per come è fatto il metodo, perché si divide la vittoria e non si rigioca niente: i meriti sommati fanno esattamente la differenza fra la partita giocata e una partita a squadra vuota. È la propagazione, che ha due varianti, ciascuna con il suo nome, LRP e DeepLIFT; e la stessa somma la danno i gradienti integrati, che invece di dividere il risultato accompagnano la squadra da vuota a completa e sommano i piccoli cambi strada facendo.
Su una partita sola, chi divide il risultato all’indietro e chi accompagna la squadra da vuota a completa arrivano agli stessi meriti. Quando il risultato passa per più fasi, un girone che decide chi va in finale e poi la finale, i due conti cominciano a dare meriti diversi, pur sommando entrambi alla stessa vittoria. E la ragione è che chi divide all’indietro guarda come è organizzata la squadra, mentre chi la accompagna da vuota a completa guarda solo i risultati: due squadre organizzate in modo diverso, che vincono però sempre allo stesso modo, dai gradienti integrati ricevono gli stessi meriti, dalla propagazione no. Nessuna delle tre è quella vera. Il gradiente parla dei ritocchi, l’occlusione dell’assenza di un giocatore, la propagazione di come spartire il risultato rispetto alla squadra vuota. E proprio quella squadra vuota, il punto di partenza, è una scelta: cambiandola cambiano i meriti.
Sia \(f: \mathbb{R}^d \to \mathbb{R}\) il punteggio e \(\bar{\mathbf{x}}\) una baseline. Gradiente per ingresso: \(a_i = x_i\,\partial f/\partial x_i\). Occlusione [ZF14]: \(a_i = f(\mathbf{x}) - f(\mathbf{x}_{[i \leftarrow \bar{x}_i]})\), dove sulle immagini si sostituisce una pezza di pixel invece di una componente; è agnostica rispetto al modello, costa una passata in avanti per pezza, e non gode di completezza, perché in presenza di interazioni \(\sum_i a_i \neq f(\mathbf{x}) - f(\bar{\mathbf{x}})\). LRP [BBM+15] ridistribuisce il punteggio dall’uscita all’ingresso con regole locali; nella regola \(\varepsilon\), per uno strato con pre-attivazioni \(z_j = \sum_i x_i w_{ij}\), \(R_i = \sum_j \frac{x_i w_{ij}}{z_j + \varepsilon\,\mathrm{sign}(z_j)}\,R_j\), che senza bias e con \(\varepsilon \to 0\) conserva la somma delle rilevanze strato per strato; la rilevanza \(R_i\) di un ingresso è la sua attribuzione \(a_i\). DeepLIFT [SGK17] confronta ogni attivazione con la sua attivazione di riferimento (quella prodotta dalla baseline), e nella regola Rescale sostituisce la derivata di ogni non-linearità con il rapporto incrementale \(\big(f(z) - f(\bar z)\big)/(z - \bar z)\), sicché su un neurone solo \(a_i = w_i (x_i - \bar{x}_i)\,\big(f(z) - f(\bar z)\big)/(z - \bar z)\); in una rete a strati senza interazioni moltiplicative vale per costruzione \(\sum_i a_i = f(\mathbf{x}) - f(\bar{\mathbf{x}})\), ma Ancona e colleghi mostrano che la regola salta dove due ingressi si moltiplicano (i cancelli di una LSTM).
Le famiglie non sono indipendenti. Ancona e colleghi [ACOztireliG18] dimostrano che la regola \(\varepsilon\) di LRP coincide con il gradiente per ingresso se le non-linearità sono tutte ReLU, e con DeepLIFT a baseline zero se la rete non ha bias additivi e le non-linearità soddisfano \(f(0) = 0\) (ReLU, \(\tanh\)); e che nel caso lineare tutti questi metodi coincidono. Su un neurone solo, \(f(\mathbf{x}) = \tanh(z)\) con \(z = \mathbf{w}^\top\mathbf{x}\) e baseline nulla, coincidono anche con i gradienti integrati [STY17]: tutti e tre danno \(a_i = \frac{w_i x_i}{z}\tanh(z)\), perché \(\int_0^1 \tanh'(\alpha z)\,d\alpha = \tanh(z)/z\) è proprio il rapporto incrementale di DeepLIFT. Il gradiente per ingresso vale invece \(w_i x_i \tanh'(z)\), che in saturazione tende a zero. Su più strati IG si separa da LRP e DeepLIFT per l’invarianza all’implementazione: è fatto di gradienti, che la rispettano per la regola della catena, mentre gli altri due sostituiscono le derivate con rapporti incrementali calcolati strato per strato, e due reti funzionalmente equivalenti ma costruite in modo diverso ricevono da loro attribuzioni diverse (il controesempio è nell’appendice B di [STY17]). È il secondo assioma, che qui trova il suo uso.
Sul costo: il gradiente chiede una passata all’indietro, LRP e DeepLIFT una passata all’indietro con le regole modificate, i gradienti integrati \(m\) passate lungo il cammino, l’occlusione una passata in avanti per ogni pezza. L’occlusione di una variabile per volta prende il contributo marginale di \(i\) rispetto alla coalizione di tutte le altre, dove i valori di Shapley della sezione su SHAP fanno la media su tutte le coalizioni. E ogni metodo ha una baseline, anche quando non la scrive: il gradiente per ingresso è il termine di primo ordine dello sviluppo di Taylor di \(f\) attorno a \(\mathbf{x}\), valutato nell’ingresso nullo, \(f(\mathbf{x}) - f(\mathbf{0}) \approx \sum_i x_i\,\partial f/\partial x_i\). Tutti ne ereditano l’arbitrio: la scelta di \(\bar{\mathbf{x}}\) (nero, grigio, rumore, un’immagine sfocata) cambia le attribuzioni.
Il conto prende il neurone dell’esempio eseguibile e calcola le attribuzioni delle tre famiglie, con la loro somma accanto alla differenza \(f(\mathbf{x}) - f(\mathbf{0})\) che i metodi completi devono restituire.
import numpy as np

w = np.array([2.0, -1.0])
x = np.array([2.0, 1.0])
f = lambda v: np.tanh(w @ v)
z, zi = w @ x, w * x                    # la somma pesata e i suoi due pezzi
delta = f(x) - f(np.zeros(2))           # quanto l'uscita si allontana dalla baseline

grad_per_ingresso = x * (1 - np.tanh(z) ** 2) * w
occlusione = np.array([f(x) - f(np.where(np.arange(2) == i, 0.0, x))
                       for i in range(2)])     # si azzera una variabile per volta
lrp = zi / z * f(x)                             # regola epsilon, con epsilon -> 0
deeplift = (f(x) - f(np.zeros(2))) / (z - 0.0) * zi   # rapporto incrementale
m = 200
alphas = (np.arange(1, m + 1) - 0.5) / m
ig = x * np.mean([(1 - np.tanh(a * z) ** 2) * w for a in alphas], axis=0)

print("somma pesata:", z, "  senza la prima:", w[1] * x[1],
      "  senza la seconda:", w[0] * x[0])
for nome, a in [("gradiente per ingresso", grad_per_ingresso),
                ("occlusione", occlusione), ("LRP", lrp),
                ("DeepLIFT", deeplift), ("gradienti integrati", ig)]:
    print(f"{nome:23s} {np.round(a, 4)}  somma {a.sum():.4f}")
print(f"{'f(x) - f(0)':23s} {delta:.4f}")
somma pesata: 3.0   senza la prima: -1.0   senza la seconda: 4.0
gradiente per ingresso  [ 0.0395 -0.0099]  somma 0.0296
occlusione              [ 1.7566 -0.0043]  somma 1.7524
LRP                     [ 1.3267 -0.3317]  somma 0.9951
DeepLIFT                [ 1.3267 -0.3317]  somma 0.9951
gradienti integrati     [ 1.3267 -0.3317]  somma 0.9951
f(x) - f(0)             0.9951
Il gradiente per ingresso vede il neurone saturo e dà quasi zero a tutti e due. L’occlusione dà alla prima variabile più di tutta la differenza da spiegare, \(1{,}757\) contro \(0{,}995\), perché togliendola la somma pesata passa da \(3\) a \(-1\) e la \(\tanh\) attraversa tutta la sua parte ripida; alla seconda quasi niente, perché togliendola la somma sale da \(3\) a \(4\), dove la curva è piatta. Le tre attribuzioni complete coincidono fino al quarto decimale e sommano alla differenza giusta: su un neurone solo sono la stessa formula scritta in tre modi, e si separano soltanto su reti con più strati, dove conta il secondo assioma dei gradienti integrati, l’invarianza all’implementazione.
Le mappe dicono dove, non che cosa#
Salienza, Grad-CAM e gradienti integrati disegnano mappe diverse, e le tre famiglie danno, sullo stesso neurone, numeri diversi. Prima di andare avanti serve una domanda che le mappe, per come sono fatte, non suggeriscono da sole: una mappa di importanza è una spiegazione?
Ci sono due obiezioni, e sono di natura diversa. La prima riguarda cosa una mappa può dire in linea di principio; la seconda, più grave, riguarda se stia davvero parlando del modello.
La prima obiezione la mette bene Cynthia Rudin: sapere dove la rete guarda dentro l’immagine non dice che cosa stia facendo con quella parte. Una mappa che si accende sul muso del cane è compatibile con «la rete riconosce la forma di un muso», ma anche con «la rete ha imparato che in quella zona di solito c’è del pelo, e riconosce quello», o con «quel pezzo di immagine è semplicemente il più contrastato». La salienza dice ciò che la rete vede, non ciò che la rete pensa.
La seconda obiezione è più radicale ed è arrivata da un esperimento tanto semplice quanto crudele. Prendi una rete addestrata, produci la sua mappa, poi cancella quello che ha imparato: randomizza i pesi, strato per strato, e rifai la mappa. Oppure la riaddestri su etichette mescolate a caso, così che non le resti da imparare altro che rumore. Se la mappa fosse una spiegazione del modello, dovrebbe disintegrarsi, perché il modello non c’è più. Per diversi metodi popolari, la mappa cambia pochissimo, e resta riconoscibile come una sagoma dell’oggetto.
Il test però non li boccia tutti. I colpetti pixel per pixel e i faretti di Grad-CAM reagiscono, e il test lo superano; Grad-CAM con una precisazione che gli autori mettono per esteso, cioè che la mappa cambia quando a essere cancellata è la parte di rete che il suo conto attraversa. A fallirlo sono due metodi non ancora incontrati, Guided BackProp e Guided Grad-CAM: sono due raffinamenti costruiti sopra i primi due, con qualche accorgimento in più per avere mappe visivamente più nitide, e proprio quegli accorgimenti sono ciò che li rende ciechi al modello: le loro mappe restano riconoscibili anche quando alla rete si cancellano gli strati più alti.
Gli Integrated Gradients stanno in mezzo, ed è il caso più insidioso. La mappa cambia davvero, e cambia parecchio: un pixel che prima spingeva verso la risposta può ritrovarsi a spingere contro. Però resta visibile la sagoma dell’oggetto fotografato, e il motivo è nel metodo stesso. Ricordiamo l’ultimo passo: la reazione media si moltiplica per quanto il pixel è cambiato dal nero. Ma quel «quanto è cambiato», messo insieme per tutti i pixel, è l’immagine. Quindi quando la reazione media si riduce a un guazzabuglio senza senso, a restare in piedi nel prodotto è soprattutto la foto. A occhio si continua a «vedere il cane» anche quando la rete non sa più niente.
La conclusione è spiacevole: per i metodi bocciati e per quelli in mezzo, la mappa stava in buona parte descrivendo l’immagine e non la rete. Somigliava al risultato di un programmino che segna i bordi degli oggetti in una foto, uno di quelli che esistono da cinquant’anni e non hanno bisogno di imparare niente; e siccome i bordi di una foto di cane disegnano un cane, la mappa sembrava sensata.
Che una mappa dipenda dal modello, però, non dice ancora che indichi i pixel giusti. Per saperlo c’è una prova di altro tipo: si cancellano dalle foto i pixel che la mappa dichiara più importanti, si riaddestra il modello sulle foto bucate, e si guarda quanto peggiora. Se peggiora quanto cancellando pixel a caso, la mappa non indicava niente; ed è quello che succede, in quella prova, per parecchi dei metodi più usati.
L’obiezione di Rudin [Rud19] è che una mappa di salienza è compatibile con troppe spiegazioni diverse dello stesso comportamento: è un’informazione sulla posizione dell’evidenza, non sul calcolo che la usa. Nei contesti ad alto rischio, sostiene, questo la rende inadatta a sostituire un modello intrinsecamente interpretabile.
La seconda obiezione è empirica e ha una forma metodologica importante: sono i controlli di sanità di Adebayo e colleghi [AGM+18]. Il ragionamento è che un metodo di attribuzione, per essere utile, deve almeno essere sensibile alle cose da cui la predizione dipende. Da qui due test.
Nel model parameter randomization test si randomizzano progressivamente i pesi del modello, dall’ultimo strato verso il primo, confrontando ogni volta la mappa con quella originale. Nel data randomization test si riaddestra il modello su etichette permutate a caso, cosicché abbia necessariamente memorizzato rumore, e si confronta la mappa con quella del modello addestrato sulle etichette vere.
Un metodo che superi i test deve cambiare drasticamente in entrambi i casi. Diversi metodi molto usati non lo fanno, e le loro mappe restano visivamente simili all’originale: si comportano, per usare l’espressione degli autori, come un rilevatore di bordi indipendente dal modello. Quali siano è l’informazione operativa. A fallire sono Guided BackProp e Guided Grad-CAM, invarianti ai pesi degli strati alti e quindi riconoscibili anche a rete randomizzata. A passare sono il gradiente semplice e Grad-CAM, quest’ultimo con la precisazione che gli autori mettono per esteso: è sensibile ai pesi quando la randomizzazione è a valle dell’ultimo strato convoluzionale, cioè su quella parte della rete che Grad-CAM attraversa per calcolare i suoi gradienti.
In mezzo stanno i metodi che moltiplicano il gradiente per l’ingresso, cioè gradient \(\odot\) input e gli Integrated Gradients. Qui gli autori osservano che le mappe cambiano, e cambiano perfino di segno, ma che la struttura dell’ingresso resta chiaramente prevalente nelle maschere: chi moltiplica per l’ingresso, quando il gradiente si fa rumoroso, finisce per restituire soprattutto l’ingresso. È il caso più insidioso, perché il metodo è sensibile al modello e nondimeno l’occhio continua a riconoscere l’oggetto. La lezione metodologica è questa: la plausibilità visiva di una spiegazione non è una prova della sua fedeltà, e un occhio umano non distingue le due cose. Un metodo di attribuzione va sottoposto a un test che possa farlo fallire, esattamente come un modello. Nel lavoro di Adebayo e colleghi le mappe prima e dopo la randomizzazione si confrontano con la correlazione di rango di Spearman (con e senza valore assoluto), con l’indice di somiglianza strutturale SSIM e con la correlazione degli istogrammi di gradienti orientati (HOG).
I controlli di sanità dicono se la mappa dipende dal modello, non se sia fedele. Per la fedeltà si tolgono dall’ingresso le componenti che la mappa dichiara più importanti e si misura quanto peggiora il modello; poiché le immagini bucate cadono fuori dalla distribuzione di addestramento, ROAR (RemOve And Retrain) riaddestra il modello sulle immagini modificate prima di misurare, e in quel confronto molti metodi diffusi non fanno meglio di un’importanza assegnata a caso [HEKK19].
Alla domanda sul «che cosa», quella di Rudin, si può rispondere cambiando oggetto: invece di chiedere quali pixel contano per una risposta, si chiede a ogni unità interna della rete (in uno strato convoluzionale, un filtro) che cosa la accende. È la dissezione della rete (network dissection) di Bau e colleghi [BZK+17]: per ogni filtro di uno strato convoluzionale si cerca, in un archivio di immagini segnate a mano con i loro concetti, quello con cui le zone più accese del filtro coincidono meglio.
L’archivio è fatto di tantissime fotografie in cui qualcuno ha colorato a mano, punto per punto, dove c’è un cane, dove c’è erba, dove c’è il colore rosso, dove c’è una finestra: più di mille concetti, dai colori agli oggetti alle scene intere. Le trame (una stoffa a righe) e le scene (una cucina, una spiaggia) fanno eccezione, e sono segnate sull’intera fotografia, non punto per punto. Si prende un filtro della rete, lo stampino che scorre sull’immagine delle reti convoluzionali (ogni faretto di Grad-CAM è quello che uno stampino accende), e gli si fanno guardare tutte le foto. Di tutti i punti di tutte le foto si tengono solo quelli in cui il filtro si accende di più: i cinque più accesi su mille. Quei punti formano una zona, e la si confronta con la zona colorata di ogni concetto. Si contano i punti che le due zone hanno in comune e si dividono per tutti i punti che le due coprono insieme: se ne hanno trenta in comune e insieme ne coprono cento, il punteggio è trenta su cento. Il concetto che ne ha in comune di più, se supera una soglia, dà il nome al filtro: «rilevatore di cani», «rilevatore di erba». Due filtri possono avere lo stesso nome, e quello che si conta, per dire quanto uno strato è leggibile, è quanti nomi diversi ci compaiono.
Il risultato si legge a strati. Nei primi i filtri che hanno un nome sono rilevatori di colori e di trame; salendo compaiono parti di oggetti, e negli strati alti oggetti interi. E quanti nomi diversi si trovano cambia con il modo in cui la rete è stata addestrata: una rete che ha imparato senza etichette, per esempio, ha meno rilevatori di oggetti, perché nessuno le ha mai chiesto di distinguere un cane da un gatto.
Il nome però dice meno di quanto sembri. Viene dall’archivio, e un concetto che l’archivio non contiene non si può trovare, quindi un filtro senza nome non è detto che non faccia niente. E si può rimescolare uno strato. Al posto di due filtri A e B se ne mettono due nuovi, «A più B» e «A meno B»: sembrano diversi, ma sommandoli e sottraendoli si ritrovano A e B tali e quali, quindi la rete sa esattamente le stesse cose. Solo che nessuno dei due nuovi si accende più sui cani e basta. Rimescolando così tutti i filtri di uno strato, in un esperimento degli stessi autori su una rete che riconosce luoghi, i nomi diversi che si riescono a dare calano di quattro quinti: i nomi dipendono da come il sapere è spartito fra i filtri, non soltanto da che cosa la rete sa (e c’è chi, per questo, cerca i concetti in una combinazione di filtri invece che in uno solo). E un filtro che si accende sui cani non dimostra che la rete lo usi per dire «cane»: magari si accende sul pelo, e la rete lo usa per dire «animale». Per saperlo bisogna spegnerlo e guardare che cosa cambia.
Sia \(\mathbf{A}_k(\mathbf{x})\) la mappa di attivazione dell’unità \(k\) sull’immagine \(\mathbf{x}\), con \(a_k\) il valore in una posizione. La soglia \(T_k\) è il quantile superiore per cui \(P(a_k > T_k) = 0{,}005\), calcolato su tutte le posizioni di tutte le immagini dell’archivio; poi la mappa si riporta per interpolazione alla risoluzione dell’ingresso, \(\mathbf{S}_k(\mathbf{x})\), e la maschera binaria è \(\mathbf{M}_k(\mathbf{x}) = \mathbf{S}_k(\mathbf{x}) \ge T_k\). Con \(\mathbf{G}_c(\mathbf{x})\) la maschera vera del concetto \(c\) nell’archivio Broden (sei categorie, dai colori alle scene, annotate per pixel, tranne scene e trame, che valgono per l’immagine intera; è la \(L_c\) del lavoro originale, ribattezzata perché \(\mathbf{L}^c\) è già la mappa di Grad-CAM), il punteggio è l’intersezione sull’unione, con le somme estese alle immagini \(\mathcal{D}_c\) dell’archivio che portano almeno un’annotazione della stessa categoria di \(c\) (non a tutte: le trame, per esempio, sono annotate solo su una parte delle immagini, e sulle altre ogni pixel acceso conterebbe come un errore),
e l’unità è un rilevatore del concetto di punteggio massimo se questo supera \(0{,}04\) (la soglia sposta quante unità passano, ma gli autori riportano che l’ordine fra le reti resta lo stesso). Il numero di rilevatori unici diventa così una misura dell’interpretabilità di uno strato, confrontabile fra architetture e regimi di addestramento: gli strati alti hanno più rilevatori di oggetti, l’addestramento auto-supervisionato ne produce meno, e la batch normalization, scrivono gli autori, sembra ridurre l’interpretabilità in modo sensibile. Il risultato più istruttivo è negativo: applicando allo strato conv5 di un’AlexNet addestrata su Places205 una rotazione ortogonale casuale, che lascia intatto il potere discriminante della rappresentazione, i rilevatori unici calano dell’80%. L’interpretabilità misurata così dipende dalla base, cioè dall’allineamento dei concetti con le singole unità, e non è una proprietà dell’informazione contenuta. È lo stesso problema, visto da un’altra parte, di quello che la sezione sull’interpretabilità meccanicistica, più avanti, chiama sovrapposizione (superposition): niente obbliga i concetti a stare ciascuno su un asse. I limiti sono quelli della definizione, cioè la copertura dell’archivio, una soglia scelta a mano, e una misura di co-occorrenza e non di causalità, che il lavoro successivo dello stesso gruppo affronta intervenendo: spegne unità in un classificatore e misura che cosa smette di riconoscere, le accende in un generatore e guarda che cosa compare nell’immagine [BZS+20]. Chi cerca i concetti come direzioni invece che come unità singole trova la stessa domanda nei vettori di concetto di TCAV [KWG+18].
Niente di questo rende inutili le mappe, né i nomi dei filtri: li ricolloca. Servono a esplorare (dove guardare, quale ipotesi farsi, quale scorciatoia sospettare in una raccolta di dati) e non a certificare che un modello funzioni. E lo stesso dubbio, tale e quale, si è poi posto per un altro oggetto, che a differenza delle mappe non bisogna nemmeno costruire, perché nel modello c’è già.
L’attenzione è una spiegazione?#
Quell’oggetto è l’attenzione dei Transformer [VSP+17], e c’è una tentazione naturale a usarla come spiegazione. Richiamiamo in due righe di che si tratta: per costruire la nuova rappresentazione di una parola, il modello mescola le rappresentazioni delle parole del contesto, ciascuna con un peso. I pesi non sono negativi e sommano a uno (sono l’uscita di una softmax), e sembrano dire su che cosa il modello si è concentrato. Sono i pesi di attenzione, e non vanno confusi con i pesi \(\theta\) della rete: quelli li fissa l’addestramento, questi si ricalcolano per ogni frase che entra. Sono già lì, non costa niente guardarli: perché non usarli come spiegazione, gratis?
La risposta breve è: con molta cautela. Nel 2019 Jain e Wallace [JW19] hanno mostrato che spesso si possono costruire pesi di attenzione molto diversi che portano il modello alla stessa risposta. E il ragionamento che ne segue è pulito: se più modi di distribuire lo sguardo danno lo stesso verdetto, nessuno di essi può essere la ragione del verdetto. Il loro articolo si intitolava, senza giri di parole, «Attention is not Explanation». Altri hanno ribattuto, con un articolo intitolato «Attention is not not Explanation» [WP19], che dipende da che cosa si pretende, e che con richieste più modeste qualcosa quei pesi lo dicono. La morale pratica è quella: sono un indizio, non una prova, e vanno lette come una traccia, non come una confessione.
Va però messa un’avvertenza accanto al risultato, perché quel titolo è più largo dell’esperimento che lo sostiene. Jain e Wallace guardano modelli con un solo strato di attenzione, appoggiato per lo più sopra un tipo di rete che legge la frase parola per parola nei due sensi, e che non è un Transformer. Un Transformer vero, con le sue decine di strati sovrapposti, nel loro articolo non compare mai: né come esperimento né come parola. E nel lavoro stesso il risultato cambia col modello: sul più semplice fra quelli provati, gli stessi criteri trattano l’attenzione molto meglio. È quindi un monito metodologico solido, non un teorema sui Transformer.
C’è però una domanda tecnica che precede quella filosofica, e che di solito viene saltata: l’attenzione di quale strato? Un Transformer ha decine di strati di attenzione impilati, e i pesi di uno strato solo non dicono quanto ciascuna parola d’ingresso abbia influito sulla risposta finale.
Il problema è che, a ogni piano della pila, una parte dell’informazione non passa affatto dall’attenzione: prende una scorciatoia e scivola dritta al piano di sopra (sono le connessioni residuali della sezione sulla struttura del Transformer). Quindi i pesi di un singolo strato raccontano solo un pezzo del viaggio: per sapere quanto ogni parola d’ingresso ha influenzato il risultato in cima bisogna seguire l’intero percorso, scorciatoie comprese, piano dopo piano. Gli strumenti che fanno questo conto si chiamano attention rollout e attention flow, e restituiscono una mappa sulle parole di partenza, spesso più sensata di quella del singolo strato.
Rollout e flow dicono quanto ogni parola ha pesato sul risultato. C’è poi un attrezzo che risponde a un’altra domanda: se a un certo piano della rete è scritta una data informazione, per esempio se una parola è un nome o un verbo. È il probing (sondaggio): si prova a leggere quell’informazione da lì con lo strumento più semplice che c’è, un piccolo classificatore addestrato apposta. Se ci riesce, l’informazione a quel piano c’è; se fallisce, non c’è, o non è scritta in modo semplice. Che ci sia, però, non vuol dire che la rete la usi: per saperlo bisogna toglierla e guardare se la risposta cambia.
E c’è un’avvertenza: uno strumento di lettura troppo bravo rischia di indovinare da sé ciò che doveva soltanto leggere. Per accorgersene gli si dà un compito finto. A ogni parola del vocabolario si appiccica un’etichetta tirata a sorte, una volta per tutte, e da lì in avanti quella parola porta sempre quella. Nella rete quell’informazione non è scritta da nessuna parte, perché è stata inventata adesso; però uno strumento abbastanza bravo può impararla a memoria, parola per parola. Se lo strumento riesce nel compito finto quasi come in quello vero, sul compito vero non stava leggendo la rete: stava imparando lui.
Abnar e Zuidema [AZ20a] mostrano che la composizione fra strati non è affatto banale, per una ragione che il capitolo sui Transformer ha già messo in evidenza: le connessioni residuali. A ogni blocco il valore di un token non viene sostituito da ciò che l’attenzione gli porta, ma sommato ad esso; quindi una parte dell’informazione che arriva allo strato \(l+1\) non è passata dall’attenzione di quel livello, ma è scivolata lungo la scorciatoia.
Il rimedio proposto è di tenerne conto e poi comporre. Si corregge la matrice di attenzione di ogni strato mescolandola con l’identità, che rappresenta appunto il passaggio diretto,
dove \(\mathbf{W}^{(l)}_{\text{att}}\) è la matrice di attenzione grezza dello strato \(l\), mediata sulle teste (gli autori, per semplicità, non le trattano separatamente), \(\mathbf{I}\) l’identità e \(\mathbf{R}^{(l)}\) la matrice corretta. I due mezzi fanno due mestieri, e conviene separarli. Che i coefficienti sommino a uno è una necessità: le righe dell’attenzione e quelle dell’identità sommano a uno, e una loro combinazione convessa conserva la proprietà, così che il prodotto delle \(\mathbf{R}^{(l)}\) resti una matrice stocastica per righe. Che siano uguali è invece un’ipotesi: dice che in ogni strato il ramo residuale e quello dell’attenzione pesano lo stesso, e nulla nel Transformer lo garantisce (dopo la normalizzazione e la proiezione d’uscita le norme dei due rami possono differire di molto). La scelta \(\lambda\,\mathbf{W}^{(l)}_{\text{att}} + (1-\lambda)\,\mathbf{I}\) con \(\lambda \neq \tfrac{1}{2}\) è normalizzata altrettanto bene, e dà un rollout diverso. Si moltiplicano poi le \(\mathbf{R}^{(l)}\) fra loro per ottenere quanto di ogni token di ingresso è finito in ogni posizione all’altezza voluta. È l’attention rollout, che con \(L\) strati e \(T\) token costa \(L\) prodotti di matrici \(T \times T\), cioè \(O(L\,T^3)\). La variante attention flow tratta la stessa struttura come un grafo orientato aciclico e calcola il flusso massimo dal token di ingresso a quello di arrivo, uno per coppia di posizioni: è molto più costosa, e tiene conto dei colli di bottiglia lungo il cammino. In entrambi i casi il risultato è una mappa sui token d’ingresso, cioè finalmente confrontabile con le attribuzioni delle sezioni precedenti, e visibilmente diversa (spesso più sensata) della matrice del singolo strato che si è tentati di visualizzare.
Un approccio complementare, più controllato, è il probing. L’idea: se una rappresentazione interna «sa» qualcosa (poniamo, la parte del discorso di una parola), allora un classificatore lineare addestrato su quella rappresentazione dovrebbe saperlo prevedere. Si congela la rete, si estraggono le attivazioni di uno strato e ci si allena sopra una semplice regressione logistica per una proprietà a scelta. Se il probe riesce, l’informazione è presente e linearmente accessibile in quello strato; se fallisce, non lo è. È un modo economico per mappare dove, nella pila di strati, emergono le varie proprietà. Il probe stabilisce però che l’informazione è decodificabile, non che la rete la usi: per distinguere le due cose servono interventi sulle attivazioni, come il probing amnesico di Elazar e colleghi, che rimuove la proprietà dalla rappresentazione e misura quanto cambia il comportamento del modello, e che trova l’accuratezza del probe scorrelata dall’importanza della proprietà per il compito [ERJG21]. Il probe lineare è la proposta di Alain e Bengio [AB16], che lo motivano proprio con la separabilità lineare e con la convessità del problema di addestramento; l’avvertenza che ne delimita l’uso è invece di Hewitt e Liang [HL19], e va attribuita a loro: un probe troppo potente rischia di imparare lui la proprietà invece di limitarsi a leggerla. La loro proposta per accorgersene sono i control task: a ogni tipo di parola si assegna un’etichetta sorteggiata una volta per tutte (ogni occorrenza di «cane» riceve sempre la stessa, con la stessa distribuzione delle etichette vere), e si addestra lo stesso probe su questo compito. L’etichetta di controllo, lungi dall’essere rumore, è una funzione deterministica dell’identità della parola, che un probe può imparare solo memorizzando il vocabolario e non leggendo una proprietà linguistica nella rappresentazione. La selectivity è la differenza fra l’accuratezza sul compito vero e quella sul controllo: alta, il probe legge; bassa, il probe risolve da sé. Gli autori trovano che probe più capaci dei lineari raggiungono accuratezze simili sulla parte del discorso con selectivity più bassa: la capacità in più era servita a memorizzare.
Interpretabilità meccanicistica: fare reverse-engineering dei circuiti#
L’attribuzione dice cosa pesa, il sondaggio degli strati (il probing di poco fa) dice dove sta l’informazione; nessuno dei due dice come la rete la calcola. L’interpretabilità meccanicistica cerca di descrivere i calcoli interni di una rete come algoritmi: individua le variabili interne (le feature, direzioni nello spazio delle attivazioni), i sottografi di pesi che le calcolano (i circuiti), e controlla la descrizione intervenendo sulle attivazioni. È una frontiera giovane, e ancora molto aperta.
Finora abbiamo chiesto alla rete, da fuori o dai suoi strati, che cosa conta per una risposta: le mostri un ingresso, guardi l’uscita, misuri le reazioni. L’interpretabilità meccanicistica apre la scatola e prova a leggere il circuito dentro. L’obiettivo è ricostruire i circuiti: piccoli gruppi di neuroni collegati che, insieme, svolgono un compito riconoscibile (un rilevatore di curve, o un pezzo che, quando nel testo ricompare una parola già vista, propone quella che la seguiva la volta prima). Per sapere se un pezzo fa davvero quel mestiere lo si scambia. Si fa girare la rete su una frase e su una copia ritoccata quanto basta a cambiarle la risposta; poi, nella seconda corsa, a quel solo pezzo si fa uscire quello che aveva calcolato nella prima, e si guarda quanta risposta giusta torna.
C’è però un ostacolo curioso. La rete ha meno neuroni dei concetti che deve rappresentare, e allora fa come chi ha poche scatole e troppa roba: mette più concetti nella stessa scatola. Un singolo neurone si accende così per cose scollegate fra loro, un po’ per i gatti, un po’ per le automobili, un po’ per il colore verde, e diventa illeggibile: un neurone così si dice polisemantico, e l’obiettivo è arrivare a caselle che facciano una cosa sola, monosemantiche.
Il nome tecnico della faccenda, sovrapposizione, viene dal modo in cui la si disegna: non come scatole, ma come frecce su un foglio in cui ogni asse è un neurone (il primo asse dice quanto si accende il neurone 1, il secondo quanto si accende il neurone 2). Un concetto diventa una freccia, e la sua direzione dice in quale mescolanza dei due neuroni è scritto. Se «gatto» stesse tutto e solo nel neurone 1, la sua freccia punterebbe dritta lungo il primo asse, senza niente in comune con l’altro. Quando i concetti sono più dei neuroni, invece, ciascuno deve prendersi una freccia obliqua, che si sovrappone in parte a quelle degli altri: da lì il nome, ed è l’immagine di Fig. 37.7.
Una tecnica recente prova a ri-sistemare gli scatoloni. Prende le attivazioni di uno strato (la fotografia di ciò che la rete ha in mente lì dentro, quei numeri che si erano incontrati parlando di Grad-CAM) e le riscrive usando molte più caselle di quanti erano i neuroni, con una regola: a ogni esempio se ne devono accendere pochissime. E con un obbligo: dalla riscrittura si deve poter ricostruire l’originale uguale. Lo strumento si chiama, con un nome che in italiano non si traduce, sparse autoencoder: «sparso» perché accende poco, «autoencoder» perché riscrive ciò che riceve in modo da poterlo poi ricostruire.
Perché quelle due regole insieme dovrebbero dare caselle leggibili? Ogni casella, quando si accende, rimette nella ricostruzione sempre lo stesso pezzo, la sua impronta. Una casella che tenesse tre cose diverse avrebbe una sola impronta per tutte e tre: accesa per un gatto, ci rimetterebbe anche un po’ di automobile e di verde, e per correggerla servirebbero altre caselle accese, proprio quello che la regola del «poche per volta» fa pagare. Una casella che fa una cosa sola, invece, quella cosa la ricostruisce da sola, e il posto abbondante serve perché ce ne sia una per ogni cosa. È la stessa idea della rete, rovesciata: la rete mescola i concetti perché ha poco spazio, e se lo può permettere perché ogni concetto compare di rado (una foto con un gatto, un’automobile e il colore verde tutti insieme capita poco); lo sparse autoencoder li separa dando spazio in abbondanza, e sfrutta la stessa rarità. Che il risultato sia davvero una casella per concetto, però, è un’altra questione.
Uno sparse autoencoder si giudica da tre cose: quante caselle si accendono in media su un esempio, quanto la ricostruzione somiglia all’originale, e quanto peggiora la rete se al posto dei suoi numeri le si passa la ricostruzione.
Il campo è giovane e va raccontato per quello che è. La tecnica ha retto la prova della scala, e si applica ormai a modelli linguistici veri, non a giocattoli. Quello che non è dimostrato è il punto d’arrivo: che ogni casella contenga davvero una cosa sola resta un giudizio dato guardandole a campione, e si sono trovati casi in cui una casella che sembrava pulita non si accende proprio dove dovrebbe, perché un’altra casella, più specifica, le ha portato via una parte dei casi; e non basta aggiungere caselle, o accenderne meno, per evitarlo. I tentativi più recenti seguono passo passo i calcoli di un modello vero su una singola domanda, e chi li ha fatti avverte che ne vede solo una piccola parte. Nessuno, insomma, ha ancora letto una rete grande per intero.
Il programma dei circuiti è stato articolato da Olah e colleghi su Distill nel 2020 [OCS+20]: studiare una rete come un oggetto scientifico, individuando feature (direzioni nello spazio delle attivazioni che codificano un concetto) e i circuiti che le collegano; sottografi di neuroni e pesi che implementano un calcolo interpretabile, come i rilevatori di curve nelle prime reti di visione. Nei Transformer il circuito più studiato è la induction head [OEN+22]: due teste in due strati diversi, la prima più in basso, che scrive in ogni posizione l’identità del token precedente, e la seconda, che cerca nel contesto un token uguale a quello corrente e ne copia il successore, completando lo schema \([A][B]\dots[A] \to [B]\); la sua comparsa durante l’addestramento coincide con un salto nell’apprendimento in contesto. Lo strumento che trasforma un’ipotesi così in una prova è l’activation patching: si esegue il modello su un ingresso pulito e su uno corrotto che ne cambia la risposta, si sostituisce nella corsa corrotta l’attivazione di un solo componente con quella della corsa pulita, e si misura quanta risposta corretta ritorna. È un intervento, non una correlazione: con esso Meng e colleghi hanno localizzato negli MLP degli strati intermedi di GPT-2 XL il richiamo di fatti [MBAB22], e Wang e colleghi hanno ricostruito in GPT-2 small un circuito di ventisei teste [WVC+23].
L’ostacolo teorico è la sovrapposizione (superposition), studiata a fondo da Elhage e colleghi nei Toy Models of Superposition (Anthropic, 2022) [EHO+22]: una rete con \(n\) neuroni può rappresentare molte più di \(n\) feature sfruttando direzioni quasi ortogonali in \(\mathbb{R}^n\), purché ciascuna feature sia rara. La conseguenza pratica è la polisemanticità: un singolo neurone risponde a stimoli non correlati, e diventa illeggibile. Bricken e colleghi, in Towards Monosemanticity (Anthropic, 2023), affrontano il problema con uno sparse autoencoder [BTB+23]: le attivazioni \(\mathbf{x} \in \mathbb{R}^{n}\) di uno strato vengono ricodificate in un dizionario sovracompleto di \(F \gg n\) unità,
addestrate a minimizzare \(\|\mathbf{x} - \hat{\mathbf{x}}\|_2^2 + \lambda\,\|\mathbf{f}(\mathbf{x})\|_1\), con le colonne di \(\mathbf{W}_d\) vincolate a norma unitaria, perché la penalità non si possa aggirare rimpicciolendo le attivazioni e ingrandendo le colonne. Ogni colonna di \(\mathbf{W}_d\) è la direzione di una feature nello spazio delle attivazioni, e \(f_i(\mathbf{x})\) dice quanta ce n’è; nel lavoro di Bricken il rapporto \(F/n\) va da 1 a 256, sullo strato MLP da 512 neuroni di un Transformer a uno strato solo. La norma \(L_1\) è un surrogato della sparsità vera, e ha un prezzo noto: schiaccia verso zero anche le attivazioni che dovrebbero restare grandi (shrinkage). Le varianti successive lo evitano fissando la sparsità direttamente: il TopK tiene accese, per ogni esempio, solo le \(k\) unità più attive, \(\mathbf{f}(\mathbf{x}) = \mathrm{TopK}\big(\mathbf{W}_e(\mathbf{x} - \mathbf{b}_d)\big)\), ed è stato portato fino a 16 milioni di latenti sulle attivazioni di GPT-4 [GDuprelTT+24]; il JumpReLU sostituisce la ReLU con una soglia appresa e ottimizza direttamente la norma \(L_0\) [RLS+24]. Un SAE si valuta con tre numeri: la sparsità media \(L_0 = \mathbb{E}\,\lVert \mathbf{f}(\mathbf{x}) \rVert_0\), l’errore di ricostruzione (di solito normalizzato con quello di chi predice sempre l’attivazione media) e la perdita del modello quando la ricostruzione sostituisce l’attivazione vera. Le feature così estratte risultano in buona parte leggibili, e conviene prendere «in buona parte» e «leggibili» per quel che sono: il giudizio di valutatori umani (o di un modello usato come valutatore) su un campione di feature, non una proprietà dimostrata.
Il campo è nascente e va preso con l’onestà che si deve alle frontiere. La frontiera, però, oggi non passa dove si tende a metterla. La prova della scala la tecnica l’ha superata: Templeton e colleghi [TCM+24] hanno addestrato autoencoder sparsi fino a decine di milioni di feature sulle attivazioni interne di un modello linguistico di produzione, non di un giocattolo di laboratorio. Quella che non ha superato è la prova dell’affidabilità: Chanin e colleghi, nel 2024, hanno documentato modi sistematici in cui un latente apparentemente monosemantico non si accende proprio dove dovrebbe, perché un latente più specifico ne ha assorbito i casi (lo chiamano feature absorption), e che il fenomeno non si risolve cambiando la dimensione del dizionario o il grado di sparsità [CWSD+24]. La sovrapposizione resta una spiegazione teorica solida del perché i neuroni siano illeggibili; che gli sparse autoencoder siano la cura è ancora un programma di ricerca, non un risultato acquisito. Il passo successivo va dalle feature ai circuiti: Lindsey e colleghi, nel 2025, sostituiscono gli MLP di un modello linguistico di produzione con un transcoder fra strati (30 milioni di feature in tutto) e costruiscono, per un singolo prompt, un grafo di attribuzione che traccia in parte la catena di passaggi intermedi, da verificare poi con esperimenti di perturbazione [LGA+25]. Avvertono essi stessi che il modello sostitutivo riproduce l’originale in modo incompleto, e che anche i casi riusciti catturano una piccola frazione dei meccanismi. Nessuno, in ogni caso, ha ancora «letto» un modello di grande scala per intero. La posta in gioco, però, è alta.

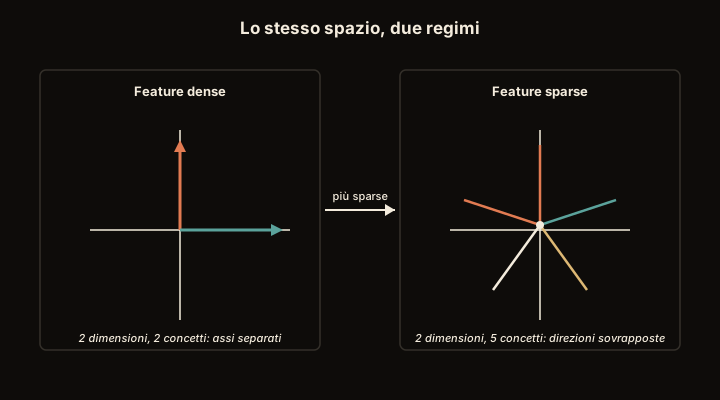
Fig. 37.7 La sovrapposizione, disegnata su un foglio. Ogni freccia è un concetto, e la sua direzione dice in quale mescolanza di neuroni quel concetto è scritto. A sinistra i concetti sono due quanti i neuroni, e ognuno si prende una direzione tutta sua, perpendicolare all’altra: leggere quel neurone vuol dire leggere quel concetto. A destra i concetti sono cinque e i neuroni sempre due, e allora le frecce si dispongono a raggiera, oblique, ciascuna un po’ addosso alle altre. Il prezzo è che nessuna ha più una direzione pulita, e infatti nessun neurone, guardato da solo, corrisponde più a un concetto.#
Come faccia la rete a cavarsela lo stesso, con cinque frecce e due soli assi, lo dice la condizione che tiene in piedi tutto: che ciascun concetto si accenda di rado, e quasi mai insieme agli altri. Conviene vedere perché, con dei numeri inventati. Se è acceso il solo concetto A, i due neuroni segnano \(0{,}9\) e \(0{,}4\), e quella coppia di numeri appartiene ad A e a nessun altro: il concetto si riconosce. Ma se A e B si accendono insieme, i loro contributi si sommano, e i due neuroni possono segnare \(1{,}2\) e \(1{,}1\), che è per esempio esattamente quello che segnerebbe il concetto C da solo. Chi legge non ha modo di distinguere i due casi. Quando le frecce sono ad angolo retto questo non succede, perché ciascuna muove un asse e lascia fermo l’altro; quando sono oblique succede, e l’unica difesa è che capiti di rado. Ecco perché smontare una rete è difficile più del previsto: la speranza naturale, un neurone un concetto, è vera solo nella metà sinistra della figura, e le reti vere stanno nella metà destra.

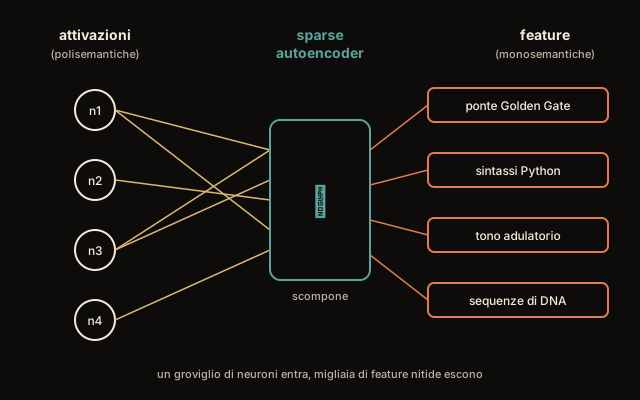
Fig. 37.8 La mossa che scioglie il groviglio. A sinistra i neuroni, con le linee che si incrociano perché ciascuno tiene dentro pezzi di cose diverse; a destra quello che ne esce, una casella per concetto leggibile. Il disegno ne mette quattro e quattro per stare in pagina, ma il numero è proprio il punto, ed è scritto in basso: le caselle in uscita sono migliaia, molte di più dei neuroni in entrata. La seconda regola, che a ogni esempio se ne accendano pochissime, il disegno non può mostrarla, e va tenuta a mente lo stesso: senza di essa il posto in più non servirebbe a niente.#
Che in Fig. 37.8 il posto si faccia più largo, invece di stringerlo, può sembrare il contrario di quello che ci si aspetta: di solito, per capire meglio, si riassume. Ma qui il problema di partenza era proprio l’opposto, troppe cose in troppo poco spazio, come nella metà destra di Fig. 37.7. Non si sta riassumendo: si sta disfando una sovrapposizione, e per disfarla serve appunto lo spazio che alla rete mancava.
Perché tutto questo conta, e non è solo un esercizio di curiosità? Per la sicurezza. Un modello linguistico di grandi dimensioni può imparare comportamenti che non vogliamo (dare risposte false, prendere scorciatoie, trattare in modo diverso persone che andrebbero trattate uguale) senza che nulla, dall’esterno, lo tradisca. Poter leggere i circuiti interni significherebbe accorgersene prima che si manifestino: è il ponte, che riprenderemo nel capitolo sull’AI responsabile, tra l’interpretabilità come curiosità scientifica e l’interpretabilità come strumento di controllo.
Da ricordare
Una rete profonda non ha numeri leggibili come i coefficienti di un modello lineare. Per capirla si cambia domanda: quanto ha pesato questo pezzo dell’ingresso su questa decisione?
Le mappe di salienza (Simonyan e colleghi, 2014) danno un colpetto a ogni pixel e guardano quanto cambia la risposta: informative, ma rumorose e valide solo attorno a quella foto. Grad-CAM (Selvaraju e colleghi, 2017) accende i «faretti» dell’ultimo strato convoluzionale in proporzione a quanto contano per la classe: più grossolana, ma più stabile nel dire dove sta quello che sostiene la risposta.
Gli Integrated Gradients (Sundararajan e colleghi, 2017) vanno da un’immagine neutra a quella vera per tappe, e così vedono anche i contributi che all’arrivo, ormai satura, la rete non segnala più. Con tappe abbastanza fitte la somma delle quote fa il salto di fiducia fra le due immagini, come un conto di cena che torna al centesimo. Ma torna da qualunque punto si parta, quindi non dimostra che il punto di partenza sia quello giusto, e di ciò che era già nero in partenza non misura nessun contributo.
Le mappe rispondono a tre domande diverse: che cosa cambierebbe con un ritocco (il gradiente), che cosa succede togliendo un pezzo (l’occlusione, i cui meriti sommati non fanno il risultato), come si divide il risultato all’indietro (la propagazione, che torna al centesimo come i gradienti integrati). Sullo stesso neurone saturo danno numeri diversissimi.
Una mappa dice dove, non che cosa (Cynthia Rudin). E cancellando ciò che il modello ha imparato, per parecchi metodi la mappa resta quasi identica: descriveva l’immagine, non la rete. I colpetti pixel per pixel e Grad-CAM questa prova la superano, Guided BackProp e Guided Grad-CAM no, e gli Integrated Gradients stanno in mezzo. Se poi una mappa indichi i pixel giusti lo dice un’altra prova: cancellarli e guardare quanto peggiora il modello. Una spiegazione che sembra sensata non è per questo fedele.
Dare un nome a ogni filtro con un archivio di foto colorate a mano (la dissezione della rete) dice con che cosa il filtro coincide, non che cosa la rete ne fa; e rimescolando i filtri di uno strato in modo reversibile i nomi diversi calano di quattro quinti, senza che la rete sappia una cosa in meno.
I pesi di attenzione dei Transformer sono un indizio, non una prova (pesi molto diversi possono dare la stessa risposta, anche se l’esperimento era su un solo strato), e un solo strato non basta comunque, perché una parte dell’informazione prende la scorciatoia: attention rollout e attention flow rifanno il conto lungo tutta la pila. Il probing dice a quale piano è scritta un’informazione, che non vuol dire che la rete la usi.
L’interpretabilità meccanicistica prova a ricostruire i circuiti con cui la rete calcola, sciogliendo la sovrapposizione (troppi concetti nella stessa scatola) con gli sparse autoencoder, che riscrivono le attivazioni su molte più caselle accendendone pochissime per volta. Si applica ormai a modelli grandi, ma che ogni casella contenga una cosa sola resta un giudizio dato guardandole, e nessuno ha ancora letto per intero una rete grande. Campo giovane, ma centrale per la sicurezza dei modelli grandi.
Da ricordare
Le reti profonde non hanno coefficienti leggibili: l’attribuzione usa il gradiente dell’uscita rispetto all’ingresso per stimare quanto ogni parte dell’input ha pesato su una singola decisione.
Le saliency maps [SVZ14] sono il gradiente sui pixel: informative ma rumorose e locali. Grad-CAM [SCD+17] pesa le mappe dell’ultimo strato convoluzionale coi gradienti della classe e localizza, in modo più stabile della salienza, dove si concentra l’evidenza per la classe, senza provare che la rete la usi.
Gli Integrated Gradients [STY17] integrano il gradiente lungo il cammino dalla baseline all’input: fondati su assiomi (sensibilità a input e baseline che differiscono in una sola componente, invarianza all’implementazione), risolvono la saturazione e soddisfano la completezza per \(f\) differenziabile quasi ovunque, \(\sum_i \mathrm{IG}_i = f(\mathbf{x}) - f(\mathbf{x}')\), che la somma di Riemann approssima (da controllare, aumentando \(m\)). La completezza vale però per qualunque baseline: \(\mathbf{x}'\) è il grado di libertà che gli assiomi non vincolano, e ogni componente uguale alla baseline riceve attribuzione nulla per costruzione [SLL20].
Tre famiglie: gradiente, propagazione (LRP [BBM+15], DeepLIFT [SGK17]), perturbazione (occlusione, senza completezza). Con sole ReLU \(\varepsilon\)-LRP è gradiente per ingresso, senza bias e con \(f(0) = 0\) è DeepLIFT a baseline zero [ACOztireliG18]; su un neurone solo coincidono con IG, su più strati no, perché LRP e DeepLIFT violano l’invarianza all’implementazione.
Una mappa dice dove, non che cosa [Rud19], e i controlli di sanità [AGM+18] mostrano che per diversi metodi popolari la mappa cambia pochissimo randomizzando i pesi del modello: descriveva l’immagine, non la rete. Nel paper i bocciati sono Guided BackProp e Guided Grad-CAM; gradiente semplice e Grad-CAM passano; i metodi che moltiplicano per l’ingresso (gradient \(\odot\) input e gli Integrated Gradients) cambiano, anche di segno, ma conservano visibile la struttura dell’ingresso. La plausibilità visiva di una spiegazione non è una prova della sua fedeltà, che si misura togliendo le feature dichiarate importanti e riaddestrando (ROAR [HEKK19]).
La dissezione della rete [BZK+17] dà a ogni unità il concetto di Broden con IoU massimo; i rilevatori unici calano dell’80% sotto una rotazione ortogonale casuale di conv5, quindi sono una proprietà della base, non dell’informazione, e misurano co-occorrenza, non causa.
I pesi di attenzione non sono di per sé una spiegazione affidabile (dibattito «Attention is not Explanation», [JW19] e [WP19], con l’avvertenza che quegli esperimenti sono su un singolo strato di attenzione sopra una BiLSTM, non su un Transformer). E prima ancora c’è un problema tecnico: comporre gli strati richiede di tener conto delle connessioni residuali, che è ciò che fanno attention rollout e attention flow [AZ20a]. Il probing con classificatori lineari [AB16] mappa invece dove sta l’informazione negli strati interni, con i control task di Hewitt e Liang [HL19] a misurare che stia leggendo e non risolvendo; che la rete la usi lo dicono solo gli interventi (probing amnesico).
L’interpretabilità meccanicistica (circuiti [OCS+20] e sparse autoencoder [BTB+23]) punta a fare reverse-engineering dei calcoli interni. La scala non è più il limite [TCM+24]; la monosemanticità delle feature estratte sì, ed è tuttora contesa. Varianti TopK e JumpReLU contro lo shrinkage dell’\(L_1\); i grafi di attribuzione portano l’analisi dalle feature ai circuiti su un singolo prompt. Campo giovane, ma centrale per la sicurezza degli LLM.
Una spiegazione convincente non è per questo vera, ed è la conclusione più scomoda dell’interpretabilità: una spiegazione va messa alla prova esattamente come si mette alla prova un modello. Nel capitolo sull’AI responsabile la stessa pretesa si sposta sulle conseguenze, perché quando un sistema decide di una persona sapere che cosa guarda non basta, bisogna stabilire se sia giusto e chi risponde quando sbaglia.