


Il suono come token: i codec neurali#
Per generare suono come un modello di linguaggio genera testo, un simbolo alla volta, serve un alfabeto finito e di dimensione ragionevole. Il testo ce l’ha dalla lingua, una ventina di lettere. L’audio, dentro il calcolatore, ne ha uno sbagliato: i 65.536 livelli con cui si misura ogni campione sono lettere troppe e troppo fitte. Quello buono va costruito. A costruirlo sono i codec neurali, che comprimono l’onda in una fila di indici presi da un elenco appreso e da quegli indici sanno rifare il suono. Senza un buon alfabeto, non c’è nulla su cui scrivere.
Comprimere imparando#
La parola codec non è nuova. Ogni volta che ascolti un brano in streaming o salvi un vocale, un codec ha ridotto l’audio a una frazione della sua dimensione. Il più famoso, l’MP3 (il cui progetto fu completato nel 1992 e pubblicato come standard ISO l’anno dopo), comprime buttando via ciò che l’orecchio non sente: si appoggia a un modello psicoacustico (un insieme di regole fisse, scritte a mano da ingegneri) che decide quali frequenze sono coperte da altre e quindi eliminabili. È un ottimo mestiere artigianale, ma è congelato: quelle regole non cambiano, non imparano, non si adattano ai dati.
Un codec neurale ribalta l’approccio. Invece di scrivere le regole, le fa imparare a una rete. La struttura ha un nome, autoencoder, e una forma da guardare: un encoder \(E\) che comprime l’ingresso \(\mathbf{x}\) in un vettore molto più piccolo, \(\mathbf{z} = E(\mathbf{x})\), e un decoder \(D\) che da \(\mathbf{z}\) cerca di rifare l’originale, \(\hat{\mathbf{x}} = D(\mathbf{z})\). I due si addestrano insieme, con un’unica regola: minimizzare una perdita \(\mathcal{L}\) che misura quanto \(\hat{\mathbf{x}}\) si discosta da \(\mathbf{x}\), cioè quanto quello che esce è diverso da quello che è entrato. Questa forma vale per qualunque cosa si voglia comprimere, non solo per il suono, ed è qui che la si monta pezzo per pezzo: Comprimere e ricostruire la riprenderà per le immagini aggiungendole l’unica cosa che manca per servire anche a generare.

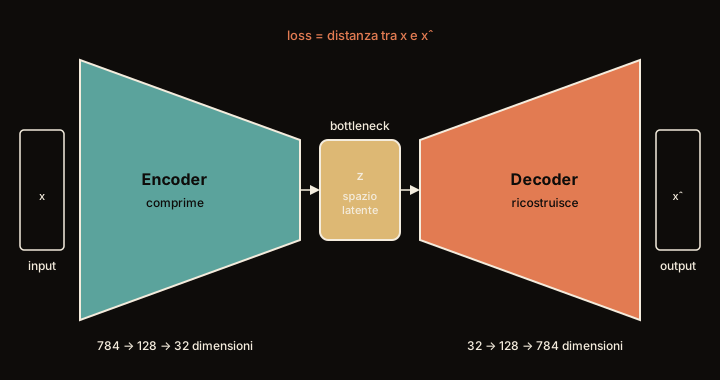
Fig. 23.7 La strozzatura è il compito. Se l’uscita deve somigliare all’ingresso ma in mezzo c’è un collo molto più stretto, la rete è costretta a tenere solo ciò che serve a ricostruire.#
La forma di Fig. 23.7 è quella di ogni compressione imparata, e tutto il resto non fa che stringere e disciplinare quel collo centrale. Nel disegno le parole sono in inglese, come si trovano nel codice: l’input è ciò che entra, l’encoder la parte che stringe, il bottleneck la strozzatura, il decoder la parte che riapre, l’output ciò che esce. Il vettore \(\mathbf{z}\) che sopravvive nella strozzatura si chiama latente, cioè nascosto: è una variabile interna del modello, che nessuno osserva né sceglie e che a guardarla non dice niente, ma dentro c’è quanto basta per rifare un suono che passi per l’originale. E siccome una fila di numeri si può sempre immaginare come un punto, l’insieme di tutti i latenti possibili prende il nome di spazio latente: tutti i riassunti che la rete potrebbe scrivere, non soltanto quelli che ha già scritto. È un nome che nel libro tornerà ogni volta che un modello preferisce lavorare sulla versione compressa dei dati invece che sui dati.
I numeri del disegno, \(784 \to 128 \to 32\), vengono dalle immagini, dove lo schema si vede meglio: una cifra scritta a mano di \(28 \times 28\) pixel, cioè 784 numeri, stretta a 32 e poi rifatta. Con l’audio gli ordini di grandezza sono quelli di EnCodec, il codec che fa da filo conduttore. Un secondo di suono misurato 24.000 volte entra come 24.000 numeri, ed esce dalla strozzatura come 75 latenti, uno ogni 320 misure, ciascuno un vettore di 128 numeri: in tutto 9.600 numeri, quindi la strozzatura da sola stringe appena due volte e mezzo. La compressione vera arriva dopo, quando ogni latente viene sostituito da un numero intero.
Una valigia si può rimpicciolire in due modi. Il primo è una lista di regole stampata sul coperchio: «togli sempre il beauty-case, arrotola le magliette, lascia a casa il terzo paio di scarpe». Vale per tutti, non cambia mai: è l’MP3. Il secondo modo è imparare facendo, viaggio dopo viaggio: provi a chiudere la valigia, vedi cosa si è sgualcito all’arrivo, e la prossima volta sistemi meglio proprio quelle cose. A giudicare, poi, non sei solo tu. A casa c’è qualcuno che non sa se la valigia l’hai disfatta e rifatta in viaggio o se è arrivata come l’avevi chiusa alla partenza, e prova a indovinarlo guardando le pieghe: tante pieghe piccole sparse gli sembrano naturali, una piega sola nel posto sbagliato lo insospettisce subito. Tu impari a rifarla in modo che non se ne accorga, cioè non identica, ma senza una piega che tradisca. Il codec ha accanto un giudice così: una seconda rete che prova a distinguere il suono rifatto da quello vero. Dopo mille viaggi hai un tuo metodo, cucito sul tuo bagaglio, che nessuno ti ha dettato. Il codec neurale fa la valigia nel secondo modo: nessuno gli dice cosa buttare, lo scopre da solo cercando di far tornare a casa la valigia il più intatta possibile.
La vera sorpresa, però, non è la compressione in sé: l’MP3 già comprime bene. È che quel riassunto compatto, imparato dalla rete, possiamo poi arrotondarlo a un piccolo insieme di valori-tipo. E un valore-tipo è un simbolo: un numero intero. È il ponte che stavamo cercando, dall’onda continua all’alfabeto.
Un codec neurale è un autoencoder addestrato per la ricostruzione. L’encoder \(E\) mappa la forma d’onda \(\mathbf{x}\) in una sequenza di vettori latenti \(\mathbf{Z} = E(\mathbf{x})\) a frequenza di frame molto più bassa del tasso di campionamento: è una pila di convoluzioni con passi \(s_1, \dots, s_B\), e ne esce un vettore ogni \(\prod_j s_j\) campioni, quindi a frequenza \(f_r = f_s / \prod_j s_j\). Con i passi \((2, 4, 5, 8)\) di SoundStream e di EnCodec il prodotto è \(320\), e \(f_r\) vale \(75\) Hz a \(24\) kHz e \(150\) Hz a \(48\) kHz, con la stessa architettura. Il decoder \(D\) ricostruisce \(\hat{\mathbf{x}} = D(\mathbf{Z})\) con le convoluzioni trasposte corrispondenti. L’obiettivo combina errori nel dominio del tempo e nello spettro, ed è affiancato da un discriminatore in stile GAN, una seconda rete che giudica l’audio rifatto e spinge \(\hat{\mathbf{x}}\) a suonare realistico, non solo a minimizzare l’errore medio. In EnCodec [DefossezCSA23] la perdita di encoder, quantizzatore e decoder è
con \(\ell_t = \lVert \mathbf{x} - \hat{\mathbf{x}} \rVert_1\) l’errore sulla forma d’onda; \(\ell_s\) una somma di errori in norma \(1\) e in norma \(2\) fra gli spettrogrammi mel di \(\mathbf{x}\) e di \(\hat{\mathbf{x}}\), calcolati a più scale (finestre da \(2^5\) a \(2^{11}\) campioni); \(\ell_g\) la perdita avversaria, nella forma hinge, contro discriminatori che guardano la STFT a cinque scale; \(\ell_{\mathrm{feat}}\) un feature matching sulle attivazioni interne di quei discriminatori; e \(\ell_w\) la commitment loss, che si incontra con la quantizzazione vettoriale. Un loss balancer normalizza poi i gradienti dei termini, così che ciascun \(\lambda_i\) fissi la frazione del gradiente che spetta al proprio termine, invece di dipendere dalla scala, molto variabile, dei gradienti del discriminatore.
Fin qui è compressione con rappresentazione continua: ogni \(\mathbf{z}\) è un vettore di numeri reali. La novità che ci interessa è renderla discreta: sostituire ogni vettore latente con un simbolo preso da un insieme finito. È il passaggio che trasforma un compressore in un tokenizzatore del suono, e apre la porta ai modelli di linguaggio sull’audio. Il come è il mestiere della quantizzazione, prima con un codebook solo e poi con una cascata di codebook.
Vector quantization: dal continuo al discreto#
Il latente che esce dall’encoder è ancora fatto di numeri che possono valere qualunque cosa, e a noi serve un elenco finito di simboli, come le lettere: serve passare dal continuo al discreto. Lo strumento che fa quel passaggio è la quantizzazione vettoriale (vector quantization, VQ), già incontrata per i pixel nella sezione sul vocabolario unico: un codebook di prototipi, e di ogni vettore resta l’indice del più vicino. Nelle reti neurali l’hanno portata van den Oord, Vinyals e Kavukcuoglu nel 2017, con il VQ-VAE [vdOVK17]; qui la si rivede sul suono, prima con un’immagine e poi con i numeri, e poi la si porta dove sulle immagini non serviva, a più livelli in cascata.
Sedici colori bastano per una fotografia che ne aveva milioni. I sedici non si tirano a sorte: si guardano tante fotografie, si tengono i colori che tornano più spesso, e quella tavolozza resta poi la stessa per tutte. Per ogni pixel scegli il colore della tavolozza che gli somiglia di più e lo sostituisci: la foto diventa un po’ più «a blocchi», ma la riconosci ancora. E adesso il colpo di genio: invece di salvare per ogni pixel i suoi tre numeri di colore, salvi un solo numero (la posizione nella tavolozza, da 0 a 15). La tavolozza la conosciamo già, ci basta l’indice. E quanti colori tenere è una scelta che si paga: con quattro la foto si sfalda e i volti diventano macchie; con mille torna quasi perfetta, ma la posizione da scrivere è un numero più lungo, e va scritto per ogni pixel.
La vector quantization fa esattamente questo, ma invece dei colori dei pixel tratta i pezzetti di suono così come escono dall’encoder: ognuno è un gruppetto di numeri, come un colore è un gruppetto di tre numeri. La «tavolozza» si chiama codebook: un elenco di pezzetti-tipo, i prototipi. Ogni pezzetto di audio, dopo l’encoder, viene avvicinato al prototipo più simile, e di lui si tiene solo il numero di posizione nell’elenco. Quel numero è il token: il nostro simbolo dell’alfabeto sonoro. E l’operazione che abbiamo appena fatto, sostituire una cosa qualsiasi con la più vicina di un elenco prestabilito, si chiama quantizzare: vuol dire arrotondare, né più né meno.
Sia \(\mathcal{C} = \{\mathbf{e}_1, \dots, \mathbf{e}_K\}\) un codebook di \(K\) vettori-prototipo, appresi durante l’addestramento. Dato un vettore latente \(\mathbf{z}\) prodotto dall’encoder, la quantizzazione sceglie il prototipo più vicino (in norma euclidea) e ne restituisce l’indice:
dove \(q(\mathbf{z})\) è il vettore quantizzato e \(k^\star\) è il token: un intero in \(\{1, \dots, K\}\). L’audio non è più una sequenza di vettori reali ma una sequenza di interi, esattamente come un testo tokenizzato.
Un dettaglio importante: l’operazione \(\arg\min\) non è differenziabile, quindi il gradiente non attraverserebbe la quantizzazione. Il VQ-VAE [vdOVK17] lo aggira con lo straight-through estimator (il gradiente del decoder viene copiato tal quale sull’uscita dell’encoder, come se \(q\) fosse l’identità) e con due termini quadratici. Il primo è la codebook loss \(\lVert \mathrm{sg}[\mathbf{z}] - \mathbf{e}_{k^\star} \rVert^2\), che tira il prototipo scelto verso i latenti che l’hanno scelto; è l’unica cosa che fa imparare il codebook, perché la scorciatoia appena vista scavalca il prototipo e dalla ricostruzione non gli arriva niente. Il secondo è la commitment loss \(\beta \lVert \mathbf{z} - \mathrm{sg}[\mathbf{e}_{k^\star}] \rVert^2\), che tira i latenti verso i prototipi (\(\mathrm{sg}\) è lo stop-gradient, e il verso della freccia sta tutto in quale dei due membri lo porta). Sommati alla perdita di ricostruzione danno la perdita completa del VQ-VAE, con \(\beta = 0{,}25\), già scritta per intero nella sezione sul vocabolario unico; e lo straight-through, nel codice, è una riga sola, \(\mathbf{z}_q = \mathbf{z} + \mathrm{sg}[\mathbf{e}_{k^\star} - \mathbf{z}]\), che in avanti vale \(\mathbf{e}_{k^\star}\) e all’indietro ha derivata rispetto a \(\mathbf{z}\) uguale all’identità. Molte implementazioni sostituiscono il primo con una media mobile esponenziale, che è la stessa idea scritta in modo più stabile: la regola alla k-means, che sposta ogni prototipo verso la media dei latenti che l’hanno scelto. Resta il compromesso di fondo: un codebook grande (\(K\) alto) ricostruisce meglio ma costa più bit per token; uno piccolo comprime di più ma perde fedeltà.
Un esempio minuscolo mostra tutto il meccanismo: un codebook di appena quattro prototipi, e pezzetti di suono descritti da due soli numeri invece che da centinaia, così che si possano scrivere su una riga. Dentro le parentesi i due numeri sono separati da un punto e virgola, perché la virgola fa già da separatore dei decimali.
Vogliamo quantizzare il latente \(\mathbf{z} = (0{,}8;\ 0{,}1)\), cioè il pezzetto che ha \(0{,}8\) nella prima casella e \(0{,}1\) nella seconda.
Calcoliamo, per ciascun prototipo, la distanza quadratica. Le due sbarrette con il quadratino, \(\lVert\,\cdot\,\rVert^2\), non chiedono niente di più di questo: per ognuna delle due caselle fai la differenza, elevala al quadrato e somma. Per \(\mathbf{e}_1 = (0;\ 0)\) viene \((0{,}8-0)^2 + (0{,}1-0)^2 = 0{,}64 + 0{,}01 = 0{,}65\); per \(\mathbf{e}_2 = (1;\ 0)\) viene invece \((0{,}8-1)^2 + (0{,}1-0)^2 = 0{,}04 + 0{,}01 = 0{,}05\), molto meno. Gli altri due si fanno allo stesso modo, con carta e penna:
Il più vicino è \(\mathbf{e}_2\): il token è 2, e il pezzetto arrotondato è
\((1;\ 0)\). Facciamo lo stesso con \(\mathbf{u} = (0{,}2;\ 0{,}9)\): le
distanze sono \(0{,}85\), \(1{,}45\), \(0{,}05\), \(0{,}65\), il più vicino è
\(\mathbf{e}_3\), token 3. Abbiamo sostituito due pezzetti fatti di numeri
qualsiasi con due soli numeri interi, 2 e 3.
Il guadagno sta nei bit. Un numero «qualsiasi» un calcolatore lo scrive di solito con 32 risposte sì/no (la virgola mobile a precisione singola), quindi il pezzetto di due numeri ne costava 64; per dire «il secondo di quattro», cioè l’indice in un codebook da quattro voci, ne bastano \(\log_2 4 = 2\). Questo è tutto ciò che serve per scrivere l’audio in un alfabeto.
Residual vector quantization: strati di precisione#
C’è un problema, e lo si vede proprio nell’esempio. Sostituire \((0{,}8;\ 0{,}1)\) con \((1;\ 0)\) è comodo ma grossolano: ci siamo persi lo scarto \(\mathbf{z} - \mathbf{e}_2 = (-0{,}2;\ 0{,}1)\), che si chiama errore di quantizzazione. In un codec quell’errore si ripete su ogni pezzetto, decine di volte al secondo, e quando è grande è ciò che fa suonare metallica una voce. La soluzione ovvia sarebbe allargare il codebook, mettendo più prototipi per avvicinarci di più. Ma allargare costa, e conviene guardare da vicino quanto, perché è tutta la ragione di quello che viene dopo.
Serve prima la parola con cui si misura il costo. Un bit è una risposta sì/no. Con 3 bit, cioè tre risposte sì/no in fila, si distinguono \(2 \times 2 \times 2 = 8\) casi; con 10 bit se ne distinguono 1024. Per dire a quale prototipo si riferisce, un token deve spendere tanti bit quanti bastano a distinguere le voci dell’elenco: quindi raddoppiare l’elenco costa una risposta in più, non il doppio. E quanti bit al secondo servano in tutto a un codec si chiama bitrate, e si misura in kbps, migliaia di bit al secondo: un CD non compresso viaggia sui 1.400 kbps, un MP3 di buona qualità sui 128, e i codec neurali scendono sotto i 10. Attenzione al verso, perché è il contrario di quasi tutti gli altri numeri che abbiamo incontrato: qui più è basso, meglio è, perché vuol dire meno roba da trasmettere a parità di suono.
Adesso il conto si può fare al contrario, ed è lì che l’idea di allargare si schianta. SoundStream, un codec neurale di Google, lo svolge sul proprio caso: 6.000 bit al secondo divisi per 75 pezzetti fanno 80 bit a pezzetto, cioè 80 risposte sì/no. Siccome ogni risposta in più raddoppia l’elenco che si può indirizzare, con 80 risposte si distinguono \(2^{80}\) prototipi, e un elenco solo dovrebbe averne tanti: un milione di miliardi di miliardi. Il problema non è il prezzo: quei prototipi bisogna tenerli in memoria e percorrerli tutti, a ogni pezzetto, per trovare il più vicino, e da nessuna parte ci stanno. Otto elenchi da 1024 voci, dieci risposte ciascuno, spendono esattamente gli stessi 80 bit, e di prototipi ne hanno 8.192 in tutto.
La soluzione è la residual vector quantization (RVQ), una tecnica di codifica del parlato a stadi multipli che risale agli anni Ottanta [JG82], portata nei codec neurali da SoundStream [ZLO+22] e adottata da EnCodec [DefossezCSA23], di Meta: invece di un solo codebook enorme, si mettono in cascata più codebook piccoli, ciascuno dei quali corregge l’errore lasciato dal precedente.
Hai presente quando devi dare un resto di 87 centesimi con le monete? Non cerchi una moneta magica da 87: prendi prima la più grossa che ci sta (50), ti restano 37; poi la più grossa che ci sta nei 37 (20), restano 17; poi 10, restano 7; poi 5, poi 2. Ogni moneta si occupa di ciò che è avanzato dalla precedente, e passo dopo passo ti avvicini alla cifra esatta. E se il resto è già in pari, quel giro lo salti: per questo una moneta in più non può allontanarti dalla cifra.
La RVQ fa la stessa cosa con i vettori del suono. Il primo codebook dà l’approssimazione grossolana: la moneta da 50. Poi calcola quanto ha sbagliato (il residuo, il resto da coprire) e chiede a un secondo codebook di approssimare quel residuo. Il secondo lascia a sua volta un residuo più piccolo, che un terzo codebook rifinisce ancora, e così via. Alla fine ogni pezzetto di audio non è più un solo token, ma una pila di token (uno per codebook) che insieme lo descrivono con la precisione che serve, spendendo pochissimi bit.
Le monete però non rendono tutte allo stesso modo: le prime coprono quasi tutto, le ultime limano centesimi che nessuno nota. Chi raddoppia il numero di monete che usa per ogni resto paga il doppio di spazio nel borsellino, e porta a casa una differenza che all’orecchio non arriva. E conta quali monete hai in tasca: a parità di numero, un assortimento scelto male ti lascia molto più lontano dalla cifra.
La RVQ applica \(N\) quantizzatori in cascata sul residuo. Posto \(\mathbf{r}_0 = \mathbf{z}\), al livello \(i\) si quantizza il residuo corrente con il codebook \(\mathcal{C}^{(i)}\) e si aggiorna il residuo:
La ricostruzione finale è la somma dei prototipi scelti, \(q(\mathbf{z}) = \sum_{i=1}^{N} \mathbf{e}_{k_i^\star}^{(i)}\), e il token di quel frame diventa la tupla di indici \((k_1^\star, \dots, k_N^\star)\): \(N\) flussi paralleli di interi. Ogni stadio quantizza ciò che è avanzato, ma questo da solo non basta a garantire un miglioramento: l’errore non può crescere con \(N\) se ogni codebook contiene il vettore nullo, perché scegliere lo zero equivale a non correggere (è il motivo per cui il secondo codebook dell’esempio in NumPy lo include). In pratica, con codebook appresi sui dati, l’errore decresce a ogni stadio. Il vantaggio sul codebook unico si conta: la cascata rappresenta \(K^N\) combinazioni di prototipi (con \(K = 1024\) e \(N = 8\), proprio \(2^{80}\)) con \(N K\) confronti per frame invece di \(K^N\). Il prezzo è che la ricerca è greedy: ogni stadio minimizza l’errore del proprio residuo, e la somma dei prototipi scelti non è in generale la migliore delle \(K^N\) combinazioni.
Il conto del bitrate è pulito. Con \(N\) quantizzatori, codebook di \(K\) voci ciascuno e frequenza di frame \(f_r\):
dove \(\log_2 K\) sono i bit per indice. EnCodec a \(24\) kHz usa codebook di \(K = 1024\) voci (\(10\) bit) a \(f_r = 75\) frame al secondo: con \(N = 8\) quantizzatori si ottengono \(8 \cdot 10 \cdot 75 = 6000\) bit/s, cioè 6 kbps. Variando \(N\) si sceglie il compromesso: da \(1{,}5\) kbps (\(N=2\)) fino a \(24\) kbps (\(N=32\)), e con un modello solo. In addestramento il numero di stadi si estrae a caso esempio per esempio (SoundStream lo chiama quantizer dropout; EnCodec pesca fra le cinque bande da \(1{,}5\) a \(24\) kbps), così i primi codebook imparano a bastare da soli e gli ultimi a rifinire, e in uso si tronca la cascata dove il canale lo chiede [ZLO+22]. La formula dà poi il bitrate nominale, quello di un indice scritto sempre con \(\log_2 K\) bit. Gli indici però non sono equiprobabili, e un codice a lunghezza variabile li scrive con un numero medio di bit vicino alla loro entropia: EnCodec addestra a questo scopo un piccolo Transformer che predice il token successivo, e il suo modello a 48 kHz, a 6 kbps nominali, ne occupa \(4{,}2\) una volta codificato [DefossezCSA23]. Una voce di codebook che nessuno sceglie è il caso estremo dello stesso fatto: bit pagati per un simbolo che non esce mai.
Due cautele sui numeri, perché è facile ricordarseli storti. La prima riguarda il paragone con l’MP3, che si legge dappertutto: la parità a 64 kbps è del gemello a 48 kHz stereo, non di questo modello a 24 kHz monofonico, i cui termini di confronto nel paper sono Opus, EVS e Lyra-v2. E quel gemello arriva ai 6 kbps per un’altra strada: a 48 kHz l’encoder produce 150 passi latenti al secondo invece di 75, quindi sono \(4 \cdot 10 \cdot 150\), non gli \(8 \cdot 10 \cdot 75\) appena calcolati. Nelle prove d’ascolto MUSHRA (voti fino a 100, e più alto è migliore) prende \(82{,}9 \pm 2{,}4\) a 6 kbps contro \(82{,}7 \pm 3{,}2\) di un MP3 a 64 kbps, e lo stesso \(82{,}9 \pm 3{,}7\) di Opus a 24 kbps, quattro volte il suo bitrate: gli intervalli, al 95 %, si sovrappongono largamente, e la qualità percepita è indistinguibile con un decimo dei bit dell’MP3. Il riferimento non compresso prende però \(95{,}1 \pm 1{,}8\), quindi entrambi si distinguono dall’originale.
La seconda: il bitrate non è una manopola monotona. Nella stessa tabella EnCodec a 12 kbps prende \(88{,}0\) e a 24 kbps \(87{,}5\), cioè sono indistinguibili entro l’incertezza dichiarata; e a parità di bit due codec diversi danno risultati lontanissimi (a 6 kbps, \(82{,}9\) contro \(17{,}7\) di Opus). Raddoppiare \(N\) aspettandosi un guadagno proporzionale è il modo più comune di sprecare bit: il bitrate dice quanto costa, non quanto suona bene.
Il risultato è una tabella con due direzioni. Lungo il tempo, il suono viene tagliato a fettine, e ogni fettina si chiama frame: dura una manciata di millesimi di secondo. Lungo la profondità, ogni frame porta non un token ma la pila di token della cascata, uno per codebook. Fig. 23.8 mostra la seconda direzione, che è quella nuova: un frame solo, la pila di token che ne esce, l’encoder che li produce e il decoder che li rilegge.
Il conto, con i valori che usa EnCodec sull’audio misurato 24.000 volte al secondo, viene così: 75 frame in ogni secondo di audio, 8 token per ogni frame, cioè 600 simboli al secondo al posto di 24.000 misure. È il salto che rende possibile tutto il resto del capitolo.
Da quei 600 numeri il decoder produce un suono che suona come l’originale, e la parola «ricostruire» va presa con cautela. Quel decoder non impara solo a sbagliare poco. Accanto a lui, durante l’addestramento, lavora un discriminatore: una seconda rete il cui unico mestiere è smascherare l’audio finto, e che quindi lo costringe a produrre qualcosa che suoni vero, non soltanto qualcosa di numericamente vicino all’originale (è il meccanismo delle GAN).
Sotto quella pressione il decoder diventa a tutti gli effetti un piccolo generatore, guidato dai token che riceve. A bitrate bassi il dettaglio più fine (la grana, le code di riverbero, le frequenze più alte) non viene recuperato: viene reinventato in modo credibile. Gli autori di DAC lo misurano su un codec a 24 kHz addestrato come EnCodec [KSL+23]: a 1,5 kbps l’errore campione per campione ha quasi la stessa energia del segnale (un rapporto segnale-distorsione, l’SI-SDR, di appena 0,32 dB), mentre un indice di qualità percepita, il ViSQOL, dà al suono 4,04 su 5. La fedeltà sul campione crolla, la qualità che si sente regge. Ed ecco anche perché in Generare suono e musica questo stesso decoder potrà fare da generatore senza cambiare una riga: a quel punto la differenza fra un codec e un modello che inventa suono sta soltanto nella provenienza dei token. I token che escono dall’encoder sono quelli su cui, là, si addestrerà un modello di linguaggio.

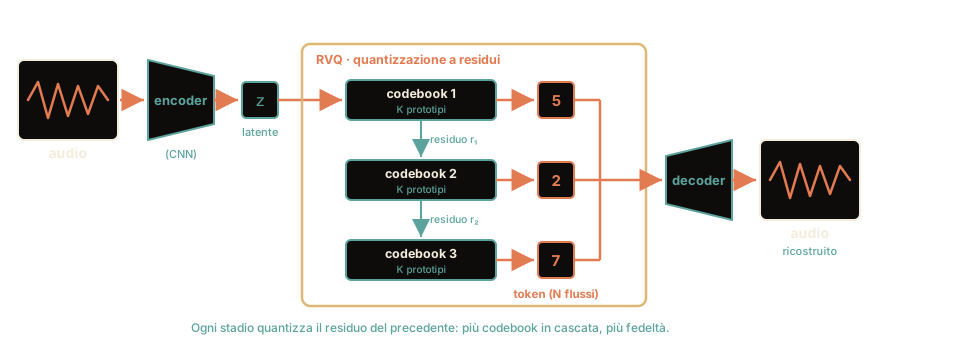
Fig. 23.8 Un codec audio neurale. L’encoder comprime l’onda in vettori latenti; la RVQ li trasforma in una pila di token (uno per codebook, ciascuno sul residuo del precedente); il decoder ripercorre la strada al contrario e ricostruisce l’audio.#
Un RVQ in miniatura#
Senza le reti neurali, la RVQ è un algoritmo di poche righe: un elenco di prototipi, la ricerca del più vicino, il calcolo di quello che è avanzato, e un secondo elenco che rifinisce l’avanzo. Il codice lo fa su sei pezzetti finti da due numeri ciascuno, presi a caso, e stampa i due «flussi» di token e, soprattutto, l’errore che cala aggiungendo il secondo stadio.
Due avvertenze prima di leggerlo, per non inciampare sui numeri. Qui i prototipi
sono numerati a partire da zero, come conta Python, mentre nella formula
partivano da uno: è solo un modo di contare. E gli elenchi del codice non sono
quelli dell’esempio a mano di poco fa, quindi i token che ne escono non devono
coincidere con il 2 e il 3 di prima.
import numpy as np

rng = np.random.default_rng(0)

# Sei pezzetti da due numeri ciascuno: quelli che uscirebbero dall'encoder
Z = rng.uniform(-1, 1, size=(6, 2)).round(2)

# Primo codebook: 4 prototipi grossolani (K = 4)
C1 = np.array([[-0.5, -0.5],
               [ 0.5, -0.5],
               [-0.5,  0.5],
               [ 0.5,  0.5]])

# Secondo codebook: 4 aggiustamenti fini per il residuo (lo zero e' incluso)
C2 = np.array([[ 0.00,  0.00],
               [ 0.30,  0.00],
               [ 0.00,  0.30],
               [-0.30, -0.30]])


def quantizza(V, C):
    """Per ogni riga di V trova il prototipo piu' vicino nell'elenco C."""
    # distanze quadratiche fra ogni pezzetto e ogni prototipo
    d = ((V[:, None, :] - C[None, :, :]) ** 2).sum(axis=2)
    idx = d.argmin(axis=1)      # posizione del prototipo piu' vicino: il "token"
    return idx, C[idx]          # le posizioni e i pezzetti arrotondati


def mse(A, B):
    """MSE, errore quadratico medio: di quanto sbaglia in media la ricostruzione."""
    return ((A - B) ** 2).mean()


# --- Stadio 1: arrotondo il pezzetto al prototipo piu' vicino ---
idx1, q1 = quantizza(Z, C1)
ric1 = q1                       # ricostruzione con 1 solo stadio

# --- Stadio 2: quantizzo il RESIDUO ---
residuo = Z - q1
idx2, q2 = quantizza(residuo, C2)
ric2 = q1 + q2                  # ricostruzione con 2 stadi

print("vettori da quantizzare:\n", Z)
print("token stadio 1:", idx1.tolist())
print("token stadio 2:", idx2.tolist())
print(f"MSE con 1 quantizzatore: {mse(Z, ric1):.4f}")
print(f"MSE con 2 quantizzatori: {mse(Z, ric2):.4f}")
vettori da quantizzare:
 [[ 0.27 -0.46]
 [-0.92 -0.97]
 [ 0.63  0.83]
 [ 0.21  0.46]
 [ 0.09  0.87]
 [ 0.63 -0.99]]
token stadio 1: [1, 0, 3, 3, 3, 1]
token stadio 2: [0, 3, 2, 3, 2, 3]
MSE con 1 quantizzatore: 0.1021
MSE con 2 quantizzatori: 0.0481
Quel numero, l’MSE, è la media di quanto ogni pezzetto ricostruito si discosta da quello vero, e più è piccolo meglio va. Aggiungendo il secondo elenco più che si dimezza, da \(0{,}1021\) a \(0{,}0481\), e ogni pezzetto adesso è descritto da due numeri interi invece che da due numeri qualsiasi. È l’intera idea della RVQ, in scala di laboratorio: nei codec veri i pezzetti hanno centinaia di numeri, gli elenchi migliaia di voci e gli stadi sono otto o più, ma la meccanica è precisamente questa.
I due elenchi del codice li abbiamo scritti noi; nei codec veri i prototipi si imparano insieme all’encoder e al decoder. La regola con cui si imparano è semplice: ogni prototipo viene spostato ogni tanto nel mezzo dei pezzetti che l’hanno scelto, così da rappresentarli meglio (è lo stesso meccanismo del k-means, l’algoritmo di raggruppamento della sezione su riduzione e clustering).
E quella regola porta con sé il guasto caratteristico di tutta la famiglia. Una voce che nessun pezzetto sceglie non viene mai spostata, quindi resta dov’è e continua a non essere scelta: è morta, e non risuscita. L’elenco che si usa davvero si riduce in silenzio a una frazione di quello dichiarato, mentre il bitrate resta quello di prima, calcolato sull’elenco intero. Si pagano tutti i bit e se ne usa una parte: è il codebook collapse. Quanto morda dipende da dove si parte: se i prototipi nascono sparsi molto più larghi dei pezzetti che dovranno descrivere, ne sopravvivono pochissimi, perché tutti i pezzetti finiscono addosso agli stessi due o tre. I rimedi sono di ingegneria e stanno dentro i codec. Il primo sostituisce le voci mai usate con pezzetti presi dal mucchietto che si sta processando in quel momento, dando loro così un posto dove sono utili, e si chiama restart: SoundStream lo prende da Jukebox, e lo adotta poi anche EnCodec [ZLO+22] [DefossezCSA23]. Il Descript Audio Codec (DAC) [KSL+23] cerca invece il prototipo più vicino in uno spazio molto più piccolo, di otto dimensioni, mentre i pezzetti veri ne hanno 1024 (i codici fattorizzati), e prima di confrontarli porta prototipi e pezzetti alla stessa lunghezza. Nelle prove dei suoi autori l’efficienza dei codebook, cioè quanta parte dei bit pagati porta davvero informazione, sale dal 97 % della sola media mobile al 99 %, e il codec comprime l’audio a 44,1 kHz in 8 kbps, circa novanta volte. Gli stessi autori mostrano che il quantizer dropout applicato a ogni esempio peggiora il suono quando si usano tutti i codebook, e lo applicano a un esempio su due. Un codebook va sempre misurato per quante voci usa davvero, non per quante ne dichiara.
Sulla misura della qualità serve poi una distinzione che il gergo tende a cancellare. Primo: l’errore quadratico medio sui campioni non è il criterio giusto nemmeno per addestrare, perché non ha orecchio, e i codec veri usano invece perdite calcolate sullo spettrogramma, più il discriminatore di cui abbiamo parlato, che premiano ciò che suona bene. Secondo, ed è il punto: quelli sono obiettivi di addestramento. Dicono al modello dove andare, non dicono a noi dove è arrivato, e un discriminatore che promuove il proprio generatore è metà di una partita, non un verdetto.
Misurare la qualità è un problema diverso, e ancora aperto. Esistono voti che una macchina può dare da sola, e si distinguono per che cosa confrontano. PESQ, STOI e ViSQOL confrontano due segnali, il suono uscito e l’originale, e in tutti e tre il numero alto è quello buono. PESQ [RBHH01], nato per il parlato che passa in una linea telefonica a banda stretta, mette a confronto i due suoni fettina per fettina dopo averli allineati nel tempo; STOI [THHJ11] stima quanto il parlato resti comprensibile, correlando gli inviluppi delle due voci su tratti di qualche centinaio di millisecondi; ViSQOL [HSKH15] misura quanto si somiglino i due spettrogrammi. La FAD (Fréchet Audio Distance) [KZRS19] confronta invece due insiemi, i suoni generati e un mucchio di suoni veri. Li passa a una rete addestrata a classificare l’audio, approssima ciascuno dei due mucchi di vettori che ne escono con una gaussiana, di media \(\boldsymbol{\mu}\) e covarianza \(\boldsymbol{\Sigma}\), e ne misura la distanza di Fréchet:
con l’indice \(r\) per i suoni veri e \(g\) per quelli generati. È una distanza, e il buono è il basso; e del singolo suono non dice niente.
Sono tutti approssimazioni, ognuna tarata su un tipo di difetto e nessuna affidabile fuori dal suo. Davanti a un decoder che il segnale se lo reinventa, PESQ trova differenze a ogni fettina anche quando all’orecchio non se ne sente nessuna, e il voto crolla per il motivo sbagliato. Per questo i lavori del settore continuano a chiudere con prove d’ascolto fatte da persone, secondo un protocollo che si chiama MUSHRA [ITUR15]. Chi ascolta ha da una parte l’originale, dichiarato, che serve da termine di confronto e non si vota; dall’altra un gruppo mescolato da votare su una scala fino a 100, in cui stanno le versioni da giudicare, due ancore, cioè l’originale privato apposta di tutto ciò che sta sopra i 3,5 e sopra i 7 kHz, che fissano i gradini bassi della scala, e una seconda copia dell’originale, questa nascosta. Chi dà alla copia nascosta meno di 90 in più del 15 % delle prove viene escluso: è per scovare gli ascoltatori distratti che la copia c’è. Quando un lavoro riporta un solo voto automatico, quel voto è un indizio, non la qualità.
Da ricordare
Un codec neurale non segue una lista di regole scritte da qualcuno, come fa l’MP3: impara a comprimere provando, come il viaggiatore che a ogni viaggio chiude meglio la valigia. Nessuno gli dice cosa buttare: glielo impone la strettoia in mezzo.
Il passo che serve a noi è la tavolozza: si tiene un elenco di pezzetti-tipo e di ogni pezzetto di suono si salva solo il numero di posizione nell’elenco. Quel numero è il token, cioè la lettera dell’alfabeto sonoro.
Una tavolozza sola è troppo grossolana, e per raffinarla servirebbero tantissimi colori. Meglio fare come con il resto in monete: una prima tavolozza dà l’approssimazione grossa, una seconda copre quel che è avanzato, una terza quel che avanza ancora. Ogni pezzetto di suono diventa così una pila di token invece di uno solo.
Il risultato è che un secondo di musica si scrive con qualche centinaio di numeri invece che con decine di migliaia di misure. Quanti bit al secondo servono si chiama bitrate, e qui più è basso meglio è.
Attenzione a due parole. Il decoder non «ricostruisce» l’originale: a bitrate bassi il dettaglio più fine se lo reinventa in modo credibile. E la qualità, alla fine, la decidono ancora delle persone che ascoltano: i numeri automatici sono indizi, non verdetti.
Da ricordare
Un codec neurale non applica regole fisse come l’MP3: è un autoencoder che impara a comprimere l’audio (encoder → latente → decoder), addestrato sulla ricostruzione.
La vector quantization [vdOVK17] rende la rappresentazione discreta: un codebook di prototipi, ogni latente sostituito dal più vicino, e il suo indice diventa il token (l’alfabeto sonoro).
Un solo codebook è troppo grossolano. La residual vector quantization [ZLO+22] [DefossezCSA23] mette più codebook in cascata: ognuno quantizza il residuo del precedente, come dare il resto con monete via via più piccole. Rappresenta \(K^N\) combinazioni con \(NK\) confronti per frame, ma la ricerca è greedy.
L’audio diventa così una griglia di token (tempo × profondità della cascata): con EnCodec a 24 kHz, 600 simboli per secondo a 6 kbps. Il bitrate è \(N \cdot \log_2 K \cdot f_r\), ma non è una manopola monotona: nelle prove MUSHRA del gemello a 48 kHz, 12 e 24 kbps sono indistinguibili, e a parità di bit codec diversi distano decine di punti.
Il decoder non ricostruisce, risintetizza: addestrato con un discriminatore è un generatore condizionato, e a bitrate bassi inventa il dettaglio fine in modo plausibile.
Due trappole di misura. Il codebook collapse: una voce mai scelta non viene più aggiornata e muore, quindi il codebook effettivo si riduce mentre il bitrate nominale resta (rimedi: il restart delle voci morte, i codici fattorizzati e normalizzati di DAC). E perdite spettrali e discriminatori sono obiettivi di addestramento, non metriche: gli indicatori oggettivi (PESQ, STOI e ViSQOL confrontano due segnali e si massimizzano, la FAD confronta due insiemi e si minimizza) sono surrogati d’ambito, e il giudizio resta MUSHRA, con riferimento nascosto e ancore.
Con due soli stadi, nell’esempio in NumPy, l’errore di ricostruzione più che si dimezza: è l’intera meccanica della RVQ in scala di laboratorio.
Ottenuto l’alfabeto, l’audio è una sequenza di simboli: tutto l’armamentario dei Transformer diventa applicabile, ed è ciò che vedremo nella sezione sulla generazione.
Dal codec escono due cose: una griglia di indici, con un frame ogni 13 millesimi di secondo (75 al secondo) e un indice per ciascun codebook della cascata, e un decoder che trasforma qualunque griglia del genere in suono. Su quella griglia si può addestrare un modello di linguaggio, ed è il tema di Generare suono e musica, dove la prima domanda sarà come mettere in fila, un simbolo dopo l’altro, una tabella che ha due direzioni.