


Oltre la GCN: GraphSAGE, GAT e applicazioni#
La Graph Convolutional Network della sezione sul message passing è semplice: a ogni strato i bigliettini dei vicini si sommano con pesi fissi dati dai gradi, il risultato si riscrive con la ricetta appresa e passa per il ritocco finale. Con due strati classifica i nodi di un grafo di citazioni meglio dei metodi a cammini casuali. Ha però due limiti che, su un grafo vero, pesano subito.
Il primo riguarda i nodi nuovi. La GCN, nel modo in cui Kipf e Welling la addestrano, vede tutto il grafo in una volta sola, quel grafo lì e nessun altro: è la situazione che la sezione «Il mondo come grafo» ha chiamato transduttiva. Un utente che si iscrive oggi a un social, quando la rete è stata addestrata, non c’era. Il limite però non sta nei numeri che la rete ha imparato, che andrebbero bene anche per lui (l’arrivo di un iscritto cambia l’elenco dei collegamenti soltanto lì attorno, dove arrivano i suoi archi), ma nella procedura di addestramento, che pretende di avere davanti l’intero grafo fin dall’inizio.
Il secondo limite è di scala, e si vede seguendo a ritroso il conto. Per calcolare un nodo servono tutti i suoi vicini; per calcolare quelli servono i vicini dei vicini; e così via, allargandosi di un anello a ogni strato. Su un grafo di miliardi di archi, dove qualche nodo-celebrità ha milioni di connessioni, bastano due o tre anelli perché quella cerchia arrivi a inghiottire mezza rete.
A tutti e due risponde GraphSAGE, che si addestra su vicinati campionati ed è alla base di PinSage, il sistema di raccomandazione che Pinterest ha messo in produzione. La Graph Attention Network (GAT) aggiunge una cosa diversa: pesare i vicini con l’attenzione, invece che con i soli gradi. Poi le applicazioni: che cosa, oggi, con questi strumenti si riesce davvero a fare.
GraphSAGE: imparare a generalizzare#
La svolta arriva nel 2017 da Will Hamilton, Rex Ying e Jure Leskovec a Stanford, con un modello che porta le sue due idee scritte nel nome: GraphSAGE, dove SAGE sta per SAmple and aggreGatE, campiona e metti insieme [HYL17]. Pescare un campione di vicini invece di guardarli tutti, e mettere insieme quel che si è pescato: due parole, due idee.
GraphSAGE cambia il modo di addestrare con una domanda semplice: e se l’addestramento, invece di guardare il grafo intero una volta per tutte, guardasse ogni volta un nodo e i suoi dintorni, così che la ricetta impari fin dall’inizio a lavorare su pezzi di rete sempre diversi? Una ricetta del tipo «prendi la persona, guarda i suoi amici, mescola nel modo giusto». Una ricetta la puoi applicare anche a qualcuno che non hai mai visto, purché tu sappia chi sono i suoi amici. Questo si chiama modo induttivo: la rete non impara i risultati, impara come si calcolano, e quel «come» funziona pure sui nuovi arrivati e su reti diverse da quella di addestramento (un antibiotico nuovo, un utente iscritto stamattina).
La seconda idea combatte l’ingombro. Se una persona ha diecimila contatti, guardarli tutti a ogni giro è impraticabile. E se ne bastasse un campione? GraphSAGE, a ogni strato, non prende tutti i vicini ma ne pesca a caso un numero fisso (diciamo venticinque) e mescola solo quelli. È come farsi un’idea di un quartiere non intervistando tutti gli abitanti, ma un campione a sorte: molto più economico. Nel pannello di sinistra della Fig. 32.6 i tre vicini pieni sono quelli campionati; gli altri, questo giro, restano fuori.
Un sondaggio a campione, però, non dà due volte lo stesso numero: rifallo domani con altre venticinque porte e il risultato si sposta. Per una media va benissimo, perché gli scarti si compensano. Per un record no: il reddito più alto del quartiere, chiesto a venticinque porte su diecimila, esce quasi sempre più basso del vero. Perciò, quando c’è tempo di bussare a tutte le porte, si bussa a tutte.
GraphSAGE riscrive lo schema \(\mathrm{AGGREGATE}\)–\(\mathrm{UPDATE}\) del message passing in forma dichiaratamente induttiva. Al passo \(k\), per ogni nodo \(v\):
dove \(\|\) è la concatenazione, \(\sigma\) una non linearità, \(\mathbf{W}^{(k)}\) i pesi condivisi dello strato \(k\), e (cruciale) \(\mathcal{S}(v) \subseteq \mathcal{N}(v)\) è un sottoinsieme campionato uniformemente dei vicini, di dimensione fissa. È il campionamento a rendere il costo per nodo indipendente dal grado: con \(S\) vicini campionati per strato e \(K\) strati, il sottografo che alimenta un nodo ha al più \(S^K\) foglie, comunque grande sia il grafo. E poiché \(\mathbf{W}^{(k)}\) e le funzioni di aggregazione non dipendono da quali nodi si stia guardando ma solo dalle loro feature, il modello si applica di peso a nodi e grafi mai visti: l’inferenza su un nuovo nodo richiede solo di conoscerne il vicinato, non di riaddestrare. La stessa condivisione dei pesi c’è anche nella GCN, che infatti si può applicare a nodi nuovi, a patto di ricalcolare \(\hat{\mathbf{A}}\) sul grafo allargato, perché il nuovo arrivato cambia i gradi dei suoi vicini; la differenza sta nell’addestramento, che GraphSAGE fa su vicinati campionati invece che sul grafo intero, e che abitua i pesi a pezzi di grafo sempre diversi. Due dettagli dell’algoritmo completano il quadro. Dopo ogni strato lo stato si normalizza, \(\mathbf{h}_v^{(k)} \leftarrow \mathbf{h}_v^{(k)} / \lVert \mathbf{h}_v^{(k)} \rVert_2\). E in assenza di etichette la rete si addestra con la loss di skip-gram sui cammini casuali, \(\mathcal{L} = -\log \sigma(\mathbf{z}_u^\top \mathbf{z}_v) - Q\, \mathbb{E}_{v_n \sim P_n}\log \sigma(-\mathbf{z}_u^\top \mathbf{z}_{v_n})\), dove \(\sigma\) qui è la sigmoide, \(v\) compare vicino a \(u\) in un cammino breve, \(P_n\) è la distribuzione dei negativi e \(Q\) il loro numero. È l’obiettivo di DeepWalk, con la differenza che \(\mathbf{z}_u = \mathbf{h}_u^{(K)}\) esce da una funzione delle feature invece che da una riga di tabella.
La funzione \(\mathrm{AGGREGATE}\) deve restare invariante all’ordine dei vicini; Hamilton et al. ne propongono tre varianti:
mean: la media (eventualmente pesata) dei vettori dei vicini. Con una piccola modifica (invece di concatenare, si somma \(v\) ai suoi vicini prima della media) si ottiene la variante convoluzionale, che gli autori stessi descrivono come «un’approssimazione lineare grossolana» di una convoluzione spettrale localizzata. Non è un caso particolare della GCN: quella media è l’operatore \(\tilde{\mathbf{D}}^{-1}\tilde{\mathbf{A}}\), la normalizzazione per righe che la sezione sul message passing aveva scartato in favore della simmetrica \(\hat{\mathbf{A}}\). Sulla catena di quattro nodi di quella sezione, con \(\mathbf{X} = (1,2,3,4)^\top\), un passo dei due operatori dà \((1{,}500,\, 2{,}000,\, 3{,}000,\, 3{,}500)\) contro \((1{,}316,\, 2{,}075,\, 3{,}300,\, 3{,}225)\): sul primo nodo la media per righe esce del \(14\%\) più alta (\(1{,}500 / 1{,}316\)), e il conto si rifà a mente, perché la prima riga è semplicemente \((1+2)/2\).
pool: ogni vicino passa per uno stesso piccolo strato denso, poi si prende il massimo elemento per elemento (max-pooling): \(\max\{\sigma(\mathbf{W}_{\text{pool}}\,\mathbf{h}_u + \mathbf{b}) : u \in \mathcal{S}(v)\}\). Simmetrico perché il massimo non dipende dall’ordine.
LSTM: più espressiva ma, di suo, sensibile all’ordine; la si rende utilizzabile applicandola a permutazioni casuali dei vicini.
Il risparmio di costo mette in ombra una cosa: il campionamento rende il forward aleatorio, e non nello stesso modo per i tre aggregatori. La media su un campione stima la media completa senza distorsione; il massimo su un campione è invece sistematicamente più basso del massimo vero, e la distorsione cresce col grado; una somma su campione sarebbe distorta di un fattore \(S/\deg(v)\). Anche il caso non distorto smette di esserlo appena attraversa la non linearità (disuguaglianza di Jensen), ed è la ragione per cui esiste tutta la letteratura sulla riduzione della varianza nel campionamento su grafo. In pratica, a inferenza si preferisce il vicinato pieno quando il grado lo consente. Una precisazione minuta e utile: \(\mathcal{S}(v)\) non è propriamente un sottoinsieme, perché quando la dimensione del campione supera il grado si campiona con reinserimento.
In PyTorch, con la libreria PyTorch Geometric, uno strato GraphSAGE si scrive
in una riga: è la SAGEConv che compare due volte nel blocco seguente. Del
campionamento dei vicini, che nel codice non si vede perché non è compito dello
strato, si occupa un componente a parte (NeighborLoader): serve alla rete un
pezzo di grafo alla volta invece del grafo intero, ed è quello che permette di
addestrare anche quando il grafo, tutto insieme, in memoria non ci starebbe.
import torch
from torch import nn
from torch_geometric.nn import SAGEConv

class GraphSAGE(nn.Module):
    def __init__(self, in_dim, hid_dim, out_dim):
        super().__init__()
        # aggr="mean" è il default; il pool del paper è aggr="max" con
        # project=True, e la norma L2 dopo ogni strato è normalize=True
        self.conv1 = SAGEConv(in_dim, hid_dim, aggr="mean")
        self.conv2 = SAGEConv(hid_dim, out_dim, aggr="mean")

    def forward(self, x, edge_index):
        x = torch.relu(self.conv1(x, edge_index))  # primo giro di vicinato
        return self.conv2(x, edge_index)           # secondo giro
La Fig. 32.6 confronta il vicinato di GraphSAGE, appena descritto, con quello della GAT, il modello successivo: nel pannello di sinistra si tengono solo alcuni vicini, scelti a sorte; in quello di destra si tengono tutti, ma pesati.

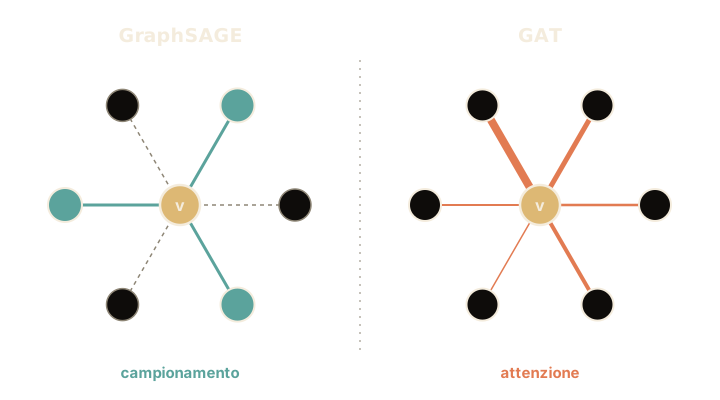
Fig. 32.6 Due modi di guardare lo stesso vicinato. GraphSAGE (sinistra) ne campiona un sottoinsieme e lo aggrega alla pari, per scalare a grafi enormi. GAT (destra) tiene tutti i vicini ma li pesa con l’attenzione: più grosso è il tratto dell’arco, più quel vicino conta.#
GAT: non tutti i vicini contano uguale#
GraphSAGE tratta i vicini campionati alla pari: nella media, ognuno pesa quanto gli altri. Ma è ragionevole? In una molecola, non tutti i legami di un atomo sono ugualmente informativi; in un social, l’amico stretto conta più del contatto occasionale. L’idea di pesare i vicini l’abbiamo già incontrata, e in grande stile: è l’attenzione del capitolo sui Transformer. La Graph Attention Network (GAT), proposta nel 2018 da Petar Veličković e colleghi, la porta sui grafi così com’è [VelivckovicCC+18].
Ricordi l’evidenziatore della sezione sull’attenzione? Davanti a una parola, il modello ripassava tutte le altre e le colorava con intensità diversa, secondo quanto contavano. La GAT fa la stessa cosa, ma l’evidenziatore lo passa sui vicini di un nodo nel grafo. Quando aggiorna un nodo non fa più una media democratica: prima decide, vicino per vicino, quanto pesarlo (dà a ognuno un voto tra 0 e 1, e i voti sommano a 1) e poi fa la media pesata con quei voti, cioè moltiplica ogni bigliettino per il voto del suo mittente prima di sommarli.
Un esempio con i numeri veri. Un nodo con tre vicini distribuisce quattro voti, uno per vicino e uno per sé stesso, e vanno così: \(0{,}53\) al primo, \(0{,}20\) al secondo, \(0{,}07\) al terzo, e \(0{,}20\) lo tiene per sé (anche qui vale la regola dei cappi: un nodo è vicino di sé stesso, se no si dimentica quello che sapeva). Sommali: fanno \(1\). Il primo vicino si prende poco più della metà del nuovo stato, il terzo è quasi ignorato, e un quinto se lo tiene il nodo. Il bello è che nessuno scrive a mano questi voti: li impara la rete, come ogni altro parametro. Nel pannello di destra della Fig. 32.6 lo spessore di ogni arco è il peso di attenzione: un vicino, quello con l’arco più grosso, si prende la fetta più grande; gli altri contano meno.
L’attenzione dei Transformer fa guardare ogni parola a tutte le altre della frase: è, in fondo, attenzione su un grafo completo, dove ogni parola è collegata a ogni altra. La GAT rifà la stessa mossa su un grafo qualunque, dove ogni nodo guarda solo i vicini a cui è davvero collegato. Il conto con cui si assegnano i voti non è lo stesso nei due casi, ma il gesto sì: un voto a testa, e poi la media pesata.
In uno strato GAT ogni nodo calcola, verso ciascun vicino, un punteggio di attenzione, poi lo normalizza con una softmax sul vicinato. Con \(\mathbf{h}_i\) le feature del nodo \(i\) e \(\mathbf{W}\) una trasformazione lineare condivisa:
dove il vicinato, come nel paper, comprende il nodo stesso (\(j\) corre su \(\mathcal{N}(i) \cup \{i\}\)): senza questo cappio il nodo dimenticherebbe la propria feature, il difetto che i self-loop della GCN erano nati per evitare. Qui \(\|\) è la concatenazione, \(\mathbf{W} \in \mathbb{R}^{F' \times F}\) è la trasformazione lineare condivisa (moltiplica a sinistra, quindi ha le dimensioni girate rispetto alla \(\mathbf{W}^{(l)}\) della GCN, che moltiplicava a destra), \(\mathbf{a} \in \mathbb{R}^{2F'}\) è un vettore di parametri appreso (la lunghezza è \(2F'\) perché deve moltiplicare due vettori concatenati, ed è quel che rende il punteggio uno scalare), \(\mathrm{LeakyReLU}\) la non linearità usata sul punteggio (pendenza \(0{,}2\) per gli ingressi negativi) e \(\sigma\) quella finale. Il coefficiente \(\alpha_{ij}\) dice quanto il nodo \(i\) pesa il vicino \(j\); la softmax garantisce \(\sum_{j \in \mathcal{N}(i) \cup \{i\}} \alpha_{ij} = 1\).
Rispetto alla scaled dot-product attention dei Transformer l’ossatura «pesi softmax, media pesata» è la stessa, ma due cose cambiano. Cambia il modo di calcolare il punteggio (qui una piccola rete con \(\mathbf{a}\) e la \(\mathrm{LeakyReLU}\), lì il prodotto scalare query·key diviso per la radice della dimensione delle chiavi, che è la ragione del nome scaled). E cambia il fatto che nella GAT non esiste una proiezione separata per i value: la stessa \(\mathbf{W}\) fa due mestieri, costruisce il punteggio e produce il vettore che poi viene mediato, mentre il Transformer tiene \(\mathbf{W}_Q\), \(\mathbf{W}_K\) e \(\mathbf{W}_V\) distinte.
Il punteggio della GAT ha però un limite che la formula nasconde. Scrivendo \(\mathbf{a} = [\mathbf{a}_1 \,\|\, \mathbf{a}_2]\) si ha \(\mathbf{a}^\top[\mathbf{W}\mathbf{h}_i \,\|\, \mathbf{W}\mathbf{h}_j] = \mathbf{a}_1^\top\mathbf{W}\mathbf{h}_i + \mathbf{a}_2^\top\mathbf{W}\mathbf{h}_j\), e la LeakyReLU è monotona crescente: l’ordine dei vicini secondo \(\alpha_{ij}\) dipende solo dal termine in \(j\), quindi è lo stesso per ogni nodo \(i\) che li guarda, e su un vicinato comune il vicino preferito da uno è il preferito da tutti. Brody, Alon e Yahav la chiamano attenzione statica e la correggono spostando la non linearità prima del prodotto con \(\mathbf{a}\), \(e_{ij} = \mathbf{a}^\top \mathrm{LeakyReLU}\big(\mathbf{W}[\mathbf{h}_i \,\|\, \mathbf{h}_j]\big)\): è GATv2, che ha attenzione dinamica allo stesso costo [BAY22]. Quel costo, per uno strato e una testa, è \(O(|V|FF' + |E|F')\), lineare nel numero di archi.
Un esempio a mano. Un nodo \(i\) ha tre vicini, e i punteggi (dopo la \(\mathrm{LeakyReLU}\)) valgono \(e_{i1}=2\), \(e_{i2}=1\), \(e_{i3}=0\); il cappio, cioè il punteggio che il nodo assegna a sé stesso, vale \(e_{ii}=1\). La softmax corre su tutti e quattro i termini, e il denominatore è \(e^{2}+e^{1}+e^{0}+e^{1} = 13{,}83\):
I quattro pesi sommano a \(1\) come devono: il primo vicino domina l’aggregazione (poco più della metà), il terzo è quasi ignorato, e un quinto del nuovo stato se lo prende il nodo stesso. Come nei Transformer, si usano più teste in parallelo (multi-head): \(H\) meccanismi di attenzione indipendenti, ciascuno con i suoi coefficienti \(\alpha_{ij}^{m}\) e la sua \(\mathbf{W}^{m}\), così che il modello possa pesare i vicini secondo criteri diversi contemporaneamente. Negli strati intermedi i risultati si concatenano,
e nello strato finale si mediano, rimandando la non linearità a dopo la media,
Anche la GAT, in PyTorch Geometric, è uno strato pronto all’uso. L’argomento
heads dice quanti evidenziatori diversi passare in parallelo sugli stessi
vicini, ciascuno libero di dare voti secondo un criterio suo: nel capitolo sui
Transformer si chiamavano teste di attenzione, e qui sono la stessa cosa.
Negli strati intermedi i risultati delle teste si mettono in fila uno dopo
l’altro (concat=True, e infatti l’uscita è tanto più lunga quante sono le
teste); nell’ultimo strato si fa invece la media, perché lì serve una risposta
sola. Su un anello di sei nodi con quattro feature ciascuno, sedici canali per
testa e tre classi in uscita:
import torch
from torch_geometric.nn import GATConv

torch.manual_seed(0)
# un anello di sei nodi, ogni arco scritto nei due versi; quattro feature
sorgenti = torch.arange(6)
destinazioni = (sorgenti + 1) % 6
edge_index = torch.cat([torch.stack([sorgenti, destinazioni]),
                        torch.stack([destinazioni, sorgenti])], dim=1)
x = torch.randn(6, 4)

# 8 teste concatenate: l'uscita ha dimensione 16 * 8 = 128
conv1 = GATConv(4, 16, heads=8, concat=True)
# strato finale: le teste si mediano invece di concatenarsi
conv2 = GATConv(16 * 8, 3, heads=1, concat=False)

h = torch.relu(conv1(x, edge_index))
print(tuple(h.shape), tuple(conv2(h, edge_index).shape))
(6, 128) (6, 3)
Dal nodo al grafo intero, e fin dove si riesce a distinguere#
Finora abbiamo prodotto una fila di numeri per ogni nodo. Ma i compiti a livello di grafo («questa molecola è tossica?», «questo composto uccide i batteri?») chiedono un solo verdetto per l’intero grafo. Serve un passo in più: comprimere le tante file di numeri dei nodi in una sola, quella del grafo. Questo passo si chiama readout, letteralmente «lettura finale», e la scelta di come farlo decide quali grafi diversi la rete riuscirà a distinguere fra loro.
Undici voti, uno per giocatore, e ne serve uno solo per la squadra intera. Le strade ovvie sono tre. Sommare tutti i voti, farne la media, oppure prendere il massimo, cioè il voto del migliore. Sono le tre ricette del readout, e tutte e tre hanno la proprietà che su un grafo serve: il risultato non cambia se i giocatori li elenchi in un altro ordine.
Sembrano equivalenti, e non lo sono. Media e massimo dimenticano quanti sono i nodi; la somma se lo ricorda.
L’esempio più pulito sono due molecole i cui atomi, agli occhi della rete, portano tutti lo stesso valore, diciamo \(7\): solo che una molecola ne ha tre e l’altra sei. Sono molecole diverse, e possono comportarsi in modo diverso. La somma dà \(21\) nella prima e \(42\) nella seconda, e le distingue. La media dà \(7\) in tutt’e due, il massimo pure: le confondono. Contare, a volte, è tutto.
Nemmeno la somma però arriva dappertutto, e il muro si tocca presto. Prendi un anello di sei atomi e, accanto, due triangoli da tre atomi ciascuno. Nell’anello come nei triangoli ogni atomo ha esattamente due vicini, i vicini di quei vicini ne hanno due a testa, e così via: il passaparola racconta a ogni atomo la stessa identica storia. Tutti finiscono con lo stesso valore, e sei numeri uguali sommati danno lo stesso totale di qua e di là. Nessuna rete che funzioni a passaparola, per quanti giri faccia, separa quelle due molecole.
Il readout aggrega il multinsieme \(\{\mathbf{h}_v^{(K)} : v \in V\}\) dei vettori dei nodi (multinsieme e non insieme: due nodi con lo stesso vettore contano due volte) in un unico vettore \(\mathbf{h}_G \in \mathbb{R}^{F_K}\) con un’operazione invariante a permutazione, che quindi accetta un numero variabile di vettori e ne restituisce sempre uno solo della stessa lunghezza; tipicamente \(\mathbf{h}_G = \sum_v \mathbf{h}_v^{(K)}\), oppure la media o il massimo. Esistono anche schemi di pooling gerarchico (per esempio DiffPool), che alternano message passing e fusione di gruppi di nodi in super-nodi, costruendo il vettore del grafo per livelli, come il pooling delle CNN accorpa regioni dell’immagine.
La scelta dell’aggregatore decide il potere espressivo della rete, cioè quali grafi diversi essa riesce a distinguere. Il risultato di riferimento è di Xu, Hu, Leskovec e Jegelka nel 2019 [XHLJ19], e lega le GNN a un classico test di isomorfismo, il 1-WL di Weisfeiler–Lehman (noto anche come color refinement; le versioni di ordine superiore, \(k\)-WL, che il paper non usa, distinguono grafi che 1-WL confonde). Lo stesso legame fra GNN e 1-WL l’hanno dimostrato in modo indipendente Morris e colleghi, che salgono anche di ordine: le loro \(k\)-GNN fanno passare messaggi fra sottoinsiemi di \(k\) nodi invece che fra nodi singoli, sono strettamente più espressive, e pagano con un numero di oggetti che cresce come \(N^k\) [MRF+19]. Il test 1-WL colora iterativamente i nodi impastando la propria etichetta con il multinsieme delle etichette dei vicini: è esattamente la struttura del message passing.
Prima di enunciare il risultato conviene dire che cos’è 1-WL, perché il nome «test di isomorfismo» promette più di quel che mantiene: è un’euristica incompleta, e lo dichiara il paper stesso. Se due grafi ricevono colorazioni diverse allora non sono isomorfi; se le ricevono uguali non si può concludere niente. Il controesempio è elementare: un ciclo di sei nodi e due triangoli separati sono entrambi \(2\)-regolari, quindi con feature iniziali costanti ogni nodo ha lo stesso stato a ogni giro in tutti e due, e 1-WL li dichiara indistinguibili. Lo sono di conseguenza anche per qualunque GNN a message passing, con qualunque MLP: non è un limite di GIN, è il tetto.
Xu et al. dimostrano appunto che nessuna GNN a message passing può distinguere due grafi che 1-WL dichiara indistinguibili (Lemma 2, il tetto teorico) e che una GNN raggiunge quel tetto (Teorema 3) se sono iniettive tutte e tre le funzioni in gioco: l’aggregazione sul multinsieme dei vicini, la combinazione con lo stato del nodo stesso, e il readout finale; e con abbastanza strati. Sopra tutto sta un’ipotesi che è facile perdere e che regge il resto: le feature d’ingresso provengono da un insieme numerabile. Da qui la gerarchia:
dove \(\succ\) va letto nel quadro di Xu et al., cioè come una gerarchia fra le informazioni che i tre aggregatori conservano dopo una mappa appresa: la somma conserva il multinsieme (feature e molteplicità, quanti vicini di ciascun tipo); la media lo riduce alla distribuzione, e perde il conteggio; il massimo lo riduce all’insieme dei tipi presenti, e perde anche le proporzioni. Non è un ordine totale sui numeri reali presi nudi, ed è utile vedere perché in una riga: i multinsiemi \(\{0, 2\}\) e \(\{1, 1\}\) hanno la stessa somma e la stessa media, e massimi diversi. È esattamente l’ipotesi di numerabilità a rendere la catena vera nel quadro del paper.
Su queste basi gli autori costruiscono la Graph Isomorphism Network (GIN), la cui regola di aggiornamento è deliberatamente semplice e iniettiva:
dove \(\mathrm{MLP}^{(k)} \colon \mathbb{R}^{F_{k-1}} \to \mathbb{R}^{F_k}\) è un piccolo percettrone multistrato ed \(\epsilon^{(k)}\) uno scalare appreso che dosa il peso del nodo rispetto ai vicini (la variante GIN-0 lo fissa a zero, e lì la garanzia cade: il Corollario 6 la dà per infinite scelte di \(\epsilon\), fra cui tutti gli irrazionali, e zero non è una di quelle). Quel termine \((1+\epsilon^{(k)})\mathbf{h}_v^{(k-1)}\) è precisamente il modo in cui GIN si compra la seconda delle tre iniettività, quella della combinazione con lo stato proprio. La somma sui vicini, seguita da un MLP, è quanto basta perché GIN eguagli il potere di 1-WL: il massimo ottenibile da una GNN a message passing, con l’avvertenza detta sopra che quel massimo lascia fuori casi elementari come il ciclo contro i due triangoli.
A cosa servono: la GNN al lavoro#
Il capitolo si è aperto su un antibiotico; è ora di mantenere la promessa e mostrare dove le GNN, oggi, fanno la differenza.
Chimica e farmaci. È il terreno naturale delle GNN: una molecola è un grafo (atomi nei nodi, legami negli archi) e prevederne una proprietà è un compito a livello di grafo. Sulle molecole le reti su grafo sono state provate fin dall’inizio. Le reti ricorsive dell’introduzione al capitolo prevedevano già nel 2000 proprietà di molecole semplici, come la temperatura di ebollizione degli alcani (gli idrocarburi più elementari), trattando ogni molecola come un albero [BMSS00]; i modelli di Scarselli e di Micheli, che reggono grafi qualunque, erano misurati su mutagenicità, tossicità e proprietà degli alcani [Mic09, SGT+09].
A rendere l’idea corrente nella chimica computazionale sono stati i fingerprint molecolari neurali di Duvenaud e colleghi del 2015 [DMAI+15]. Un fingerprint, un’impronta, è la fila di numeri con cui si descrive una molecola a un modello (quanti anelli, quali gruppi chimici, che peso). Fino ad allora la si calcolava con una ricetta fissa, scritta da un chimico; qui è la rete a ricavarla dalla struttura della molecola, imparando quali pezzi contano per la proprietà da prevedere.
Il caso più noto è halicin, la molecola con cui il capitolo si è aperto. La rete che l’ha individuata è una rete a message passing, e la molecola è attiva su batteri molto diversi fra loro, fra cui il bacillo della tubercolosi e gli enterobatteri resistenti ai carbapenemi, una delle classi di antibiotici tenute di riserva per i casi più difficili [SYS+20].
Raccomandazione su grafo. Il caso industriale più celebre è PinSage, il sistema che Pinterest mette in produzione nel 2018 [YHC+18] per suggerire contenuti. Il suo grafo ha da una parte le immagini salvate dagli utenti e dall’altra le bacheche in cui finiscono, con un arco ogni volta che un’immagine sta in una bacheca: è il grafo bipartito dell’introduzione, i nodi divisi in due squadre e archi solo fra una squadra e l’altra. PinSage è, nella sostanza, un GraphSAGE portato a scala web: campiona i vicini con brevi cammini casuali e li aggrega, girando su un grafo di tre miliardi di nodi.
Rilevamento frodi. Le transazioni finanziarie formano un grafo (conti nei nodi, pagamenti negli archi) e le frodi vivono nelle relazioni: anelli di conti che si rimpallano denaro, o decine di conti che confluiscono tutti sullo stesso, prestato da qualcuno perché il denaro ci transiti (in gergo, un «mulo»). Un classificatore che guardi i conti uno per uno non se ne accorge; una GNN, che propaga il segnale lungo gli archi, sì. Per questo l’antiriciclaggio è diventato un banco di prova delle reti su grafo, e un banco severo: sul grafo di oltre duecentomila transazioni Bitcoin pubblicato nel 2019 con le etichette lecita e illecita, una GCN non batteva ancora una foresta casuale che vedeva, di ogni transazione, le caratteristiche proprie e quelle aggregate dei vicini diretti [WDC+19].
Mappe e traffico. Dal 2020 le stime del tempo di percorrenza in Google Maps sono calcolate da una GNN sviluppata con DeepMind: la rete stradale è il grafo (i segmenti di strada nei nodi, e un arco fra due segmenti che si susseguono sulla stessa strada o che si incontrano a un incrocio) e il modello prevede i tempi propagando informazione lungo il percorso, migliorando l’accuratezza degli arrivi stimati in molte città [DPSW+21].
Scienza e fisica. Le GNN sono diventate simulatori: rappresentando un fluido o un materiale come un grafo di particelle interagenti, reti come quelle di Sanchez-Gonzalez e colleghi [SGGP+20] imparano a prevederne l’evoluzione nel tempo. La stessa impalcatura muove GraphCast [LSGW+23], che modella il pianeta come un grafo di punti sulla superficie terrestre per la previsione meteorologica, e diverse applicazioni nella fisica delle particelle, dove i segnali lasciati nei rivelatori diventano i nodi di un grafo (una rassegna del 2021 ne fa il punto [SBV21]).
I limiti, senza nasconderli#
Le GNN hanno limiti noti, e quattro hanno una letteratura propria: la profondità, la distanza, la scala e i grafi in cui chi è collegato non si somiglia. Una rassegna d’insieme è quella di Wu e colleghi [WPC+21].
Il difetto più curioso è che impilare troppi strati peggiora le cose. Con uno strato ogni nodo ascolta i vicini; con due, anche i vicini dei vicini; ma continuando così, dopo un po’ tutti finiscono per ascoltare tutti, e i nodi si somigliano sempre più, come una voce che, passando di bocca in bocca per tutto il paese, si uniforma in un unico mormorio. Si chiama oversmoothing, «levigatura eccessiva»: a furia di mediare con i vicini, si cancellano le differenze che volevamo cogliere. Non è l’unica ragione per cui le pile alte rendono male (una pila alta è anche più difficile da addestrare), ma basta a spiegare perché, per classificare i nodi di grafi come quello delle citazioni, ci si ferma di solito a due o tre strati. Per scendere più giù servono scorciatoie che portino avanti anche lo stato vecchio, prese dalle reti per immagini (che di strati ne impilano centinaia): con quelle si è arrivati a cinquantasei strati, su nuvole di punti, ma restano eccezioni costruite apposta.
Un secondo problema è opposto, e riguarda l’informazione che sta lontana, a molti passi di distanza. Il guaio è di capienza. Allargando il giro di un passo, i nodi che devono farsi sentire raddoppiano, triplicano, decuplicano; ma la fila di numeri su cui il nodo scrive quel che ha sentito ha sempre la stessa lunghezza. E c’è di peggio: se due parti del grafo sono unite da un solo arco, tutto quello che l’una ha da dire all’altra deve passare da lì. Un imbuto, e più lontano si va più si stringe. Questo schiacciamento dell’informazione lontana si chiama over-squashing. Ed è una tenaglia: per sentire chi sta lontano servirebbero più giri, e più giri sono proprio quelli che spengono le differenze.
Si aggiungono la fatica di girare su grafi da miliardi di archi, e il fatto che quasi tutte le GNN danno per scontato che i nodi collegati si somiglino (gli amici hanno gusti simili). Dove vale il contrario, e chi è connesso è diverso, possono rendere meno di un modello che il grafo non lo guarda affatto.
Oversmoothing. Li, Han e Wu [LHW18] mostrano che uno strato GCN è, in sostanza, un passo di smoothing laplaciano: iterandolo molte volte le feature dei nodi convergono verso un punto fisso che dipende dai gradi e non dai nodi, rendendoli indistinguibili. La derivazione spettrale della sezione sul message passing lo rende meccanico: \(\hat{\mathbf{A}}\) ha autovalori in \([-1,1]\) con il massimo pari a \(1\), quindi \(\hat{\mathbf{A}}^K\) spegne tutte le componenti tranne quella lungo l’autovettore dominante, che è \(\tilde{\mathbf{D}}^{1/2}\mathbf{1}\) e non distingue un nodo dall’altro. Ne segue che, senza accorgimenti, oltre pochi strati l’oversmoothing contribuisce al calo di accuratezza; non è la sola causa, perché anche il gradiente che svanisce rende difficile addestrare una pila profonda. Lo misura l’energia di Dirichlet normalizzata della sezione sul message passing, che tende a zero. I rimedi hanno nomi e forme precise, e sono tre risposte diverse alla stessa domanda. Highway GCN [RCB18] mette un gate per strato che decide quanto del vecchio stato lasciar passare accanto al nuovo, e nei loro esperimenti le prestazioni smettono di migliorare attorno ai quattro strati. Jumping Knowledge Network [XLT+18] parte da un’osservazione diversa, cioè che nodi diversi vogliono campi recettivi diversi (un hub satura in due salti, un nodo periferico no), e quindi invece di prendere l’uscita dell’ultimo strato le tiene tutte e le combina in un ultimo passo, per concatenazione, per massimo elemento per elemento o con un’attenzione fra gli strati. La concatenazione, con pesi uguali per tutti i nodi, sceglie una profondità sola per l’intero grafo; nelle altre due forme è il modello a scegliere la profondità nodo per nodo. DeepGCN [LMullerTG19] importa di peso residui e connessioni dense da ResNet e DenseNet contro i gradienti che svaniscono, e aggiunge un vicinato dilatato (si prendono i vicini saltandone alcuni) contro l’oversmoothing: con questa ricetta arrivano a 56 strati su nuvole di punti. Sono eccezioni costruite apposta: senza quegli accorgimenti, il limite pratico alla profondità resta.
Over-squashing. Alon e Yahav [AY21] osservano che il campo recettivo di un nodo cresce esponenzialmente con il numero di strati, mentre il vettore che lo riassume ha dimensione fissa: l’informazione proveniente da nodi distanti viene «schiacciata» attraverso colli di bottiglia topologici, penalizzando i compiti a lungo raggio. Profondità e portata sono così in tensione: servirebbero più strati per raggiungere nodi lontani, ma più strati innescano l’oversmoothing. La versione misurabile è di Topping e colleghi: in una MPNN che pesa i messaggi dei vicini con \(\hat{\mathbf{A}}\), l’adiacenza normalizzata con i cappi, se le derivate delle funzioni di messaggio e di aggiornamento sono limitate da due costanti \(c_1\) e \(c_2\), la sensibilità dello stato di \(v\) alla feature di un nodo \(u\) a distanza \(K\) soddisfa \(\big\lVert \partial \mathbf{h}_v^{(K)} / \partial \mathbf{x}_u \big\rVert \le (c_1 c_2)^K \big(\hat{\mathbf{A}}^K\big)_{vu}\), e quell’elemento di \(\hat{\mathbf{A}}^K\) è piccolo proprio quando i cammini fra i due passano per pochi archi. Ne ricavano una curvatura degli archi, la Balanced Forman, che individua i colli di bottiglia, e un rewiring che aggiunge archi dove la curvatura è più negativa [TDGC+22].
Scalabilità. Il campionamento di GraphSAGE e PinSage attenua il costo, ma addestrare su grafi da miliardi di nodi resta un problema aperto di sistemi, non solo di modelli.
Eterofilia. Molte GNN presuppongono l’omofilia (nodi collegati con etichette simili) che l’aggregazione dei vicini sfrutta implicitamente. Sui grafi eterofili, dove i nodi collegati tendono a differire, Zhu e colleghi (2020) trovano che le architetture standard fanno peggio di un percettrone che ignora la struttura, e propongono tre accorgimenti che ne migliorano molto l’accuratezza: tenere separati lo stato del nodo e quello dei vicini, guardare anche i vicini a due salti, combinare le uscite degli strati intermedi [ZYZ+20].
L’over-squashing ha una forma che si disegna in poche linee (Fig. 32.7): due gruppi fitti e un passaggio solo.
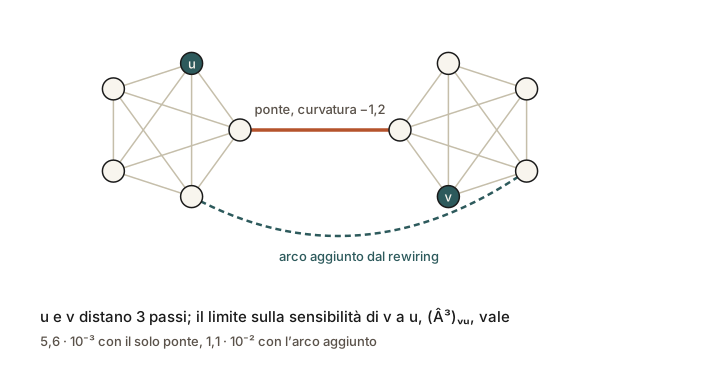
Fig. 32.7 Due gruppi di cinque nodi uniti da un ponte. Il ponte ha la curvatura più negativa del grafo, e il limite sulla sensibilità di v a u è piccolo; un arco aggiunto accanto al ponte, come fa il rewiring, apre una seconda strada e lo fa crescere.#
Graph Transformer: togliere il vincolo del vicinato#
Dei limiti appena elencati, l’over-squashing dipende da com’è fatto il grafo: il message passing fa parlare solo i nodi collegati, quindi l’informazione lontana deve attraversare molti strati e si strozza nei passaggi obbligati. Viene naturale chiedersi cosa succeda a togliere quel vincolo e a lasciar parlare tutti con tutti. La risposta arriva dall’altro capo del libro, ed è meno lieta di come la si racconta di solito.
Toglierlo tocca l’over-squashing e l’oversmoothing, e non allo stesso modo. Dell’over-squashing sparisce la parte che dipende dalla forma del grafo: se ogni nodo parla con ogni altro, ogni coppia è a un passo e non ci sono più strade strette da attraversare. Resta la parte di capienza, perché quel che dicono gli altri nodi deve comunque stare in un vettore di lunghezza fissa. L’oversmoothing invece resta tutto: non nasce dalla distanza fra i nodi, ma dal fatto che a ogni giro si fa una media con i vicini, e se i vicini diventano tutti e l’attenzione li pesa allo stesso modo, la media cancella le differenze in un passo solo. Un’attenzione appresa, con le connessioni residue e gli strati densi che un Transformer ha, lo frena senza eliminarlo.
L’attenzione dei Transformer è, di fatto, passaparola su un grafo completo: ogni parola parla con tutte le altre. Allora la strada per un grafo è ovvia: mettiamoci un Transformer sopra, e ogni nodo parlerà con ogni altro senza aspettare che il messaggio faccia il giro lungo gli archi. Gli imbuti spariscono; la fila di numeri su cui ogni nodo scrive quel che ha sentito, però, resta lunga uguale, e adesso deve riassumere le voci di tutti.
Il prezzo si vede al primo conto: con un milione di nodi i messaggi da calcolare a ogni giro sono mille miliardi, un milione per un milione. Per una molecola da cinquanta atomi va benissimo; per una rete sociale, no.
E c’è un guaio peggiore: se tutti parlano con tutti, il grafo non conta più niente. Davanti al solo elenco dei nodi un Transformer dà lo stesso risultato con qualunque insieme di archi, e anche senza nessun arco: via gli imbuti, e via con essi l’informazione. Ai Transformer era già successo con le frasi, dove l’attenzione non sa in che ordine stiano le parole: là si rimediò dando a ogni posizione una firma fatta di onde. Qui serve una firma che dica a ogni nodo dove sta nel grafo.
Quelle firme esistono già: sono le configurazioni di numeri sui nodi che nella sezione sul message passing abbiamo chiamato le frequenze del grafo, dalla più liscia alla più agitata, e il cui nome proprio è autovettori del laplaciano. La prima dice grossomodo «da che parte del grafo stai», le successive con dettaglio via via più fine. Nessuno se le inventa: gliele dà la forma del grafo.
Su una fila di nodi, il grafo più semplice che esista, quelle configurazioni sono onde, dalla più lenta alla più rapida: come le onde con cui i Transformer segnano la posizione delle parole. Imparentate, però, non le stesse: si costruiscono in modi diversi, e nessuna si ottiene dall’altra. Resta l’idea, ed è già molta: segnare una posizione con onde di frequenza crescente, qui senza sceglierle a mano e su un grafo qualunque.
Il grafo si può ridare anche in un secondo modo, senza firmare i nodi: si dice all’attenzione quanti passi separano due nodi, e le si fa scontare la distanza. Le due cose si possono anche tenere insieme, il passaparola fra vicini per quel che succede vicino e l’attenzione di tutti con tutti per quel che arriva da lontano. E quando le reti a passaparola sono state regolate con la stessa cura dei Transformer, il loro svantaggio sui compiti in cui l’informazione sta lontana, su diversi banchi di prova, è sparito: il vicinato era un aiuto, non un difetto da togliere.
Un Graph Transformer sostituisce l’aggregazione sui vicini con un’attenzione su tutte le coppie di nodi. Il beneficio è topologico: ogni nodo raggiunge ogni altro in un solo passo, quindi il collo di bottiglia dei cammini stretti sparisce e non serve profondità per avere portata. Non sparisce la capienza, su cui Alon e Yahav fondano la definizione: gli \(N\) contributi finiscono comunque in un vettore di dimensione fissa, e con un’attenzione diffusa ciascun nodo lontano pesa circa \(1/N\). E il vantaggio misurato sui compiti a lungo raggio è più piccolo di quanto sembrasse: rifacendo il Long Range Graph Benchmark con le MPNN tarate quanto i Graph Transformer, Tönshoff e colleghi trovano che su diversi insiemi di dati il divario si chiude del tutto [TonshoffRRG24].
Per l’oversmoothing il conto sta in una riga nel caso limite in cui l’attenzione pesa tutti allo stesso modo. Per un’attenzione appresa il risultato è di Dong, Cordonnier e Loukas: una pila di strati di sola self-attention, senza connessioni residue né MLP, porta le rappresentazioni verso una matrice di rango uno con velocità doppiamente esponenziale nella profondità, e sono proprio residui e MLP a frenarla [DCL21]. Il caso uniforme dà l’intuizione. Su un grafo completo con i cappi l’adiacenza \(\tilde{\mathbf{A}}\) è \(\mathbf{J}\), la matrice fatta di soli uno, tutti i gradi valgono \(N\) e quindi \(\hat{\mathbf{A}} = \tilde{\mathbf{D}}^{-1/2}\tilde{\mathbf{A}} \tilde{\mathbf{D}}^{-1/2} = \mathbf{J}/N\), il cui spettro è \(1\) una volta e \(0\) le altre \(N-1\) volte: il secondo autovalore è esattamente zero, e un solo passo porta tutti i nodi allo stesso valore. Sulla catena di quattro nodi della sezione sul message passing lo stesso autovalore valeva \(0{,}729\), cioè servivano decine di passi. Più il grafo è connesso, più il collasso è rapido, e il grafo completo è il caso estremo.
Il costo dell’attenzione piena è altrettanto strutturale del beneficio: \(O(N^2)\) nel numero di nodi, che su un grafo da milioni di nodi non è praticabile senza le stesse approssimazioni sparse viste nel capitolo sui Transformer (e il cerchio si chiude, perché quelle approssimazioni erano descritte proprio come sparsificazione di un grafo).
Il problema da risolvere è che l’attenzione piena non prende \(\mathbf{A}\) in ingresso: la sua uscita è funzione del solo multinsieme delle feature dei nodi, ed è quindi la stessa qualunque siano gli archi, o se non ce ne fosse nessuno. Senza informazione aggiuntiva il modello non distingue un anello da una stella. Attribuire questa cecità all’invarianza alle permutazioni sarebbe un errore: quella è un’altra cosa, ed è la proprietà desiderabile di cui si è parlato finora. Anche una GNN è equivariante alle permutazioni, e non è affatto cieca alla topologia. Sono due simmetrie diverse. La GNN è equivariante rispetto alle permutazioni che riordinano \((\mathbf{A}, \mathbf{X})\) insieme; il Transformer nudo lo è rispetto a quelle che riordinano \(\mathbf{X}\) da solo, qualunque cosa faccia \(\mathbf{A}\), ed è una simmetria molto più grande: pretenderla costringe la funzione a ignorare \(\mathbf{A}\). È un’informazione che non entra, più che un difetto di simmetria, e la si deve reiniettare: le due strade sono quelle che il capitolo sui Transformer già conosce.
La prima è una codifica posizionale: si calcolano i primi \(k\) autovettori non banali del laplaciano normalizzato \(\mathbf{L} = \mathbf{U}\boldsymbol{\Lambda} \mathbf{U}^\top\) e si prende la riga \(i\)-esima di \(\mathbf{U}_{:,1:k}\) come firma del nodo \(i\), che chiamiamo \(\mathbf{p}_i\). La costruzione viene dal lavoro di Dwivedi e colleghi che ha messo in fila i banchi di prova per le GNN [DJL+20], e riprende le laplacian eigenmaps della riduzione di dimensionalità; nel Graph Transformer di Dwivedi e Bresson [DB21] quella firma si somma alle feature del nodo dopo una proiezione lineare (\(\mathbf{p}_i^0 = \mathbf{C}^0\mathbf{p}_i + \mathbf{c}^0\) con \(\mathbf{C}^0 \in \mathbb{R}^{d \times k}\), poi \(\mathbf{h}_i^0 = \hat{\mathbf{h}}_i^0 + \mathbf{p}_i^0\)), non si concatena: la proiezione serve proprio perché \(k\) e \(d\) non coincidono. È la stessa mossa che il capitolo sui Transformer descrive per la codifica sinusoidale, dove la firma della posizione si somma all’embedding del token invece di affiancarglisi. Diverse implementazioni successive, invece, la concatenano; e la codifica entra solo allo strato d’ingresso, non negli strati intermedi.
La giustificazione è quella già stabilita in questo capitolo: gli autovettori sono i modi di variazione del grafo ordinati per frequenza, e su un grafo a catena sono sinusoidi. È in questo senso che la costruzione spettrale generalizza a un grafo qualunque l’idea della codifica posizionale sinusoidale, ed è esattamente ciò che gli autori rivendicano («naturally generalize»). Non è però un’identità, e conviene dire dove le due famiglie si separano, perché sono differenze misurabili: le frequenze degli autovettori del cammino sono \(\pi k/N\), spaziate linearmente e legate alla lunghezza \(N\), mentre quelle di Vaswani sono \(10000^{-2i/d}\), geometriche e indipendenti dalla lunghezza (Vaswani e colleghi le scelsero sperando che il modello potesse estrapolare a sequenze più lunghe di quelle viste in addestramento, ma le misure successive non l’hanno confermato: con la codifica sinusoidale la perplessità peggiora poco oltre la lunghezza di addestramento [PSL22]); sul cammino gli autovettori sono soli coseni, mentre la codifica sinusoidale accoppia un seno e un coseno per frequenza; e un autovettore è definito a meno del segno, una colonna di codifica posizionale no. Parenti stretti, insomma, non lo stesso oggetto.
Due avvertenze pratiche, entrambe reali. Gli autovettori sono definiti a meno del segno (\(-\mathbf{u}\) è altrettanto valido), e su autovalori ripetuti a meno di una rotazione dentro l’autospazio: al segno si rimedia campionandolo a caso in addestramento, così il modello impara a non dipenderne, alla rotazione no. E la decomposizione costa \(O(N^3)\), quindi si calcola una volta sola in preprocessing e solo per i primi \(k\) autovettori.
Esistono anche firme che l’ambiguità non ce l’hanno. La più semplice è la random-walk positional encoding di Dwivedi e colleghi, che a ogni nodo assegna le probabilità di tornare al punto di partenza con un cammino casuale di \(1, 2, \dots, k\) passi, \(\mathbf{p}_i = \big(R_{ii}, (\mathbf{R}^2)_{ii}, \dots, (\mathbf{R}^k)_{ii}\big)\) con \(\mathbf{R} = \mathbf{A}\mathbf{D}^{-1}\): sono probabilità e non direzioni, quindi non hanno segno né rotazioni da fissare [DLL+22]. Il prezzo è che due nodi con lo stesso intorno fino a \(k\) passi ricevono la stessa firma.
La seconda strada è il bias di attenzione: invece di aggiungere qualcosa ai nodi, si modifica il punteggio di attenzione fra due nodi in funzione della loro relazione. È la scelta di Graphormer [YCL+21], che somma ai logit un termine appreso dipendente dalla distanza sul grafo fra i due nodi, più un termine sugli archi lungo il cammino più breve; il grado entra a parte, sommato alle feature d’ingresso di ciascun nodo. Formalmente è una variante di attenzione relativa, la stessa famiglia di idee delle codifiche posizionali relative sulle sequenze, e gli autori mostrano che con questi accorgimenti molte GNN classiche diventano casi particolari del modello.
Le due strade non sono alternative, e la ricetta GPS di Rampášek e colleghi (2022) le combina con un ramo di message passing accanto all’attenzione globale, così che il primo curi la struttura locale e la seconda la portata [RampavsekGD+22]. Il vicinato, insomma, non era un difetto da rimuovere ma un prior utile; quanto serva davvero il canale per il lontano, dopo la rivalutazione di Tönshoff e colleghi, è meno chiaro di quanto sembrasse.
Niente di tutto questo va preso sulla fiducia, e non c’è bisogno di prenderlo: si verifica su una catena di nodi, che è una sequenza travestita da grafo. Il conto misura, una alla volta, le due affermazioni che è facile confondere: che quelle configurazioni sono onde ordinate per frequenza, e che non sono le stesse onde dei Transformer.
import numpy as np

N = 16
# grafo a catena: 0-1-2-...-15. È una sequenza travestita da grafo.
A = np.diag(np.ones(N - 1), 1) + np.diag(np.ones(N - 1), -1)
d = A.sum(1)
L = np.eye(N) - A / np.sqrt(np.outer(d, d))          # laplaciano normalizzato
val, vec = np.linalg.eigh(L)

# 1. i primi autovettori non banali sono coseni, di frequenza crescente
t = np.arange(N)
for k in (1, 2, 3):
    onda = np.cos(np.pi * k * (t + 0.5) / N)
    onda /= np.linalg.norm(onda)
    print(f"autovettore {k}: |somiglianza| con cos(pi*{k}*(n+0.5)/N) = "
          f"{abs(vec[:, k] @ onda):.4f}   (autovalore {val[k]:.3f})")

# lo stesso con il laplaciano che non pesa i nodi per il grado
vec_np = np.linalg.eigh(np.diag(d) - A)[1]
for k in (1, 2, 3):
    onda = np.cos(np.pi * k * (t + 0.5) / N)
    onda /= np.linalg.norm(onda)
    print(f"  con L = D - A, autovettore {k}: {abs(vec_np[:, k] @ onda):.4f}")

print("\ngli autovalori crescono:", np.round(val[:5], 3))
# l'ambiguità di segno: -v è un autovettore altrettanto valido
print("il segno è arbitrario: -v risolve la stessa equazione ->",
      np.allclose(L @ (-vec[:, 1]), val[1] * (-vec[:, 1])))

# 2. ma non sono la codifica posizionale del Transformer: confrontiamole
d_model = 16
omega = 10000.0 ** (-2 * np.arange(d_model // 2) / d_model)
PE = np.concatenate([np.sin(np.outer(t, omega)), np.cos(np.outer(t, omega))], axis=1)
PE = PE / np.linalg.norm(PE, axis=0)
S = abs(PE.T @ vec)              # ogni colonna di PE contro ogni autovettore

print("\nfrequenze degli autovettori (pi*k/N):", np.round(np.pi * np.arange(1, 5) / N, 3))
print("frequenze di Vaswani (10000^-2i/d):  ", np.round(omega[:4], 3))
print("colonne di PE piu' simili all'autovettore banale u0:",
      int((S.argmax(1) == 0).sum()), "su", PE.shape[1])
print(f"massima somiglianza con un autovettore non banale: {S[:, 1:].max():.3f}")
autovettore 1: |somiglianza| con cos(pi*1*(n+0.5)/N) = 0.9891   (autovalore 0.022)
autovettore 2: |somiglianza| con cos(pi*2*(n+0.5)/N) = 0.9851   (autovalore 0.086)
autovettore 3: |somiglianza| con cos(pi*3*(n+0.5)/N) = 0.9785   (autovalore 0.191)
  con L = D - A, autovettore 1: 1.0000
  con L = D - A, autovettore 2: 1.0000
  con L = D - A, autovettore 3: 1.0000

gli autovalori crescono: [0.    0.022 0.086 0.191 0.331]
il segno è arbitrario: -v risolve la stessa equazione -> True

frequenze degli autovettori (pi*k/N): [0.196 0.393 0.589 0.785]
frequenze di Vaswani (10000^-2i/d):   [1.    0.316 0.1   0.032]
colonne di PE piu' simili all'autovettore banale u0: 12 su 16
massima somiglianza con un autovettore non banale: 0.916
La prima metà del conto dà \(0{,}9891\), \(0{,}9851\) e \(0{,}9785\): sono tre misure di somiglianza, e un \(1\) vorrebbe dire «la stessa identica onda». I primi tre autovettori del laplaciano di una catena sono dunque i primi tre coseni, e gli autovalori crescono con la frequenza, esattamente come promesso dalla lettura spettrale. Che non facciano \(1{,}0000\) ha una ragione precisa e non è rumore numerico: la versione del laplaciano usata qui pesa ogni nodo per quanti vicini ha, e i due nodi agli estremi della catena ne hanno uno invece di due, il che deforma leggermente l’onda ai bordi. Con la versione che non pesa (\(\mathbf{L} = \mathbf{D} - \mathbf{A}\)) la corrispondenza è esatta, \(1{,}0000\) su tutti e tre.
La seconda metà dice dove la parentela si ferma. Le frequenze degli autovettori sono \(0{,}196\), \(0{,}393\), \(0{,}589\), \(0{,}785\): crescono a passo costante, e il passo è \(\pi/N\), cioè dipende da quanto è lunga la catena. Quelle scelte nel lavoro che ha introdotto i Transformer [VSP+17] sono \(1{,}000\), \(0{,}316\), \(0{,}100\), \(0{,}032\): calano geometricamente e non sanno niente di \(N\), tanto che su una finestra di sedici posizioni le più basse sono così lente da risultare quasi piatte. La conseguenza si misura: dodici colonne su sedici della codifica del Transformer somigliano più che altro all’autovettore banale, quello a frequenza zero, e nessuna coincide con un autovettore vero, la migliore somiglianza fermandosi a \(0{,}916\). Due basi di onde su una linea, ordinate per frequenza, costruite in due modi diversi: la parentela è reale e utile, l’identità no.
L’ultima riga della prima metà conferma l’ambiguità di segno: la stessa equazione è soddisfatta da \(\mathbf{u}\) e da \(-\mathbf{u}\), e nessuna delle due è «quella giusta». Chi usa queste firme come codifica posizionale deve conviverci, ed è il motivo per cui in addestramento se ne campiona il segno a caso.
L’ecosistema, e dove andare da qui#
Due librerie coprono la maggior parte dei casi. PyTorch Geometric (PyG, quella
degli esempi) e la Deep Graph Library (DGL) offrono, sopra PyTorch, uno strato
già pronto per ciascuno dei modelli incontrati qui (GCNConv per la GCN,
SAGEConv per GraphSAGE, GATConv per la GAT, GINConv per la variante che
somma i vicini), gli arnesi che servono a campionare i vicini e decine di
raccolte di dati su cui provare. Scrivere una GNN, oggi, è questione di poche
righe: proprio come lo è diventato scrivere una rete convoluzionale.
Il filo, intanto, non si spezza: l’attenzione che qui pesa i vicini di un nodo è la stessa dei Transformer. Le reti su grafo non sono un’isola. Sono il punto in cui convoluzione, attenzione e apprendimento di rappresentazioni si ritrovano, e si ritrovano lì per una ragione precisa, quella con cui il capitolo si era aperto: ciascuna di loro nasce dall’elenco delle cose che si possono fare al dato senza cambiarne il significato. Spostare un’immagine, riordinare i nodi di un grafo. Cambia l’elenco, cambia la rete.
Da ricordare
GraphSAGE si addestra su un nodo e i suoi dintorni per volta, e così impara una ricetta che vale anche per chi non c’era durante l’addestramento (l’utente iscritto stamattina) e per reti diverse: è il modo induttivo. E invece di ascoltare tutti i vicini ne pesca a caso un numero fisso, come un sondaggio a campione in un quartiere.
La GAT passa l’evidenziatore sui vicini: prima decide, vicino per vicino, quanto pesarlo (a ognuno un voto tra 0 e 1, e i voti sommano a 1), poi fa la media pesata con quei voti, che non scrive nessuno a mano ma impara la rete. È il gesto dell’attenzione dei Transformer, con un conto diverso per assegnare i voti; e là ogni parola guarda tutte le altre, qui ogni nodo guarda solo i vicini a cui è davvero collegato.
Per un verdetto sull’intero grafo («questa molecola è tossica?») i valori di tutti i nodi vanno ridotti a uno solo, come si ricava il voto di una squadra dai voti dei giocatori: sommandoli, mediandoli o prendendo il massimo. La somma è la scelta più fine perché è l’unica che ricorda quanti sono i nodi (tre atomi da \(7\) fanno \(21\), sei ne fanno \(42\), e la media dà \(7\) a tutte e due). Nemmeno la somma però arriva dappertutto: un anello di sei atomi e due triangoli separati restano indistinguibili per qualunque rete a passaparola.
Applicazioni reali: farmaci (halicin, 2020), raccomandazione (PinSage di Pinterest, 2018), rilevamento frodi, tempi di percorrenza in Google Maps (DeepMind, 2020–21), simulazioni di fluidi e previsioni meteo.
Limiti aperti: troppi strati appiattiscono i nodi fino a renderli indistinguibili (oversmoothing), l’informazione che sta lontana si perde passando per imbuti stretti (over-squashing), i grafi da miliardi di collegamenti restano cari da addestrare, e quasi tutte queste reti danno per scontato che chi è collegato si somigli (gli amici hanno gusti simili): nelle reti dove vale il contrario, dove chi è connesso è diverso, possono rendere molto meno. Per classificare i nodi di grafi come quello delle citazioni ci si ferma di solito a due o tre strati: di più appiattiscono i nodi, e una pila alta è anche più difficile da addestrare.
I Graph Transformer tolgono il vincolo del vicinato e lasciano parlare ogni nodo con ogni altro. Così spariscono gli imbuti per cui l’informazione lontana doveva passare, anche se ogni nodo deve ancora stipare le voci di tutti in una fila di numeri di lunghezza fissa; l’appiattimento dei nodi invece resta, e con un’attenzione che pesa tutti allo stesso modo arriva in un passo solo. E in più il grafo smette di contare, perché un modello che collega tutti con tutti non guarda mai chi è collegato a chi davvero. La struttura va ridata, assegnando a ogni nodo una firma che dica dove sta nel grafo: sono le configurazioni di numeri che qui abbiamo chiamato le frequenze del grafo (gli autovettori del laplaciano), e su una fila di nodi sono onde di frequenza crescente, parenti di quelle con cui i Transformer segnano la posizione delle parole, non le stesse.
Da ricordare
GraphSAGE rende la GNN induttiva (impara funzioni di aggregazione, non embedding fissi: generalizza a nodi e grafi mai visti) e scalabile (campiona un sottoinsieme di vicini a ogni strato). Aggregatori: mean, pool (max), LSTM.
La GAT pesa i vicini con l’attenzione: coefficienti \(\alpha_{ij}\) appresi e normalizzati con softmax sul vicinato (\(\sum_j \alpha_{ij}=1\)), con più teste in parallelo. Ha l’ossatura della self-attention dei Transformer (pesi softmax, media pesata) su un grafo qualunque anziché completo, ma calcola il punteggio con una piccola rete e non tiene una proiezione separata per i value.
I compiti a livello di grafo richiedono un readout (somma, media, massimo). La somma è la più espressiva perché conserva la molteplicità dei vicini: GIN la usa per eguagliare il test 1-WL di Weisfeiler–Lehman, che è il tetto del potere espressivo di una GNN a message passing. Il teorema chiede però tre iniettività (aggregazione, combinazione, readout), abbastanza strati e feature da un insieme numerabile; e quel tetto è un’euristica incompleta, che non distingue per esempio un ciclo di sei nodi da due triangoli.
Applicazioni reali: farmaci (halicin, 2020), raccomandazione (PinSage, Pinterest 2018), rilevamento frodi, tempi di percorrenza in Google Maps (DeepMind, 2020–21), simulazioni fisiche e meteo.
Limiti aperti: oversmoothing (troppi strati → nodi indistinguibili), over-squashing (informazione lontana schiacciata), scalabilità, eterofilia. Senza residui e connessioni fra strati, sulla classificazione di nodo convengono due o tre strati (oltre, oversmoothing e gradienti che svaniscono si sommano); con quegli accorgimenti si arriva a decine (56 in DeepGCN), ma restano eccezioni.
Un Graph Transformer sostituisce l’aggregazione sui vicini con l’attenzione su tutte le coppie: ogni nodo raggiunge ogni altro in un passo (fine del collo di bottiglia topologico dell’over-squashing, non di quello di capienza, e non dell’oversmoothing, che con attenzione uniforme sul grafo completo si compie in un passo, perché lì il secondo autovalore di \(\hat{\mathbf{A}}\) vale zero, contro lo \(0{,}729\) della catena a quattro nodi), al costo di \(O(N^2)\) e della perdita della topologia, perché l’attenzione piena non prende \(\mathbf{A}\) in ingresso. La struttura si reinietta come codifica posizionale con i primi autovettori del laplaciano, sommati alle feature dopo una proiezione lineare e solo allo strato d’ingresso, e definiti a meno del segno, che in addestramento si campiona; oppure come bias di attenzione dipendente dalla distanza sul grafo (Graphormer). Sulla catena quegli autovettori sono sinusoidi, e in questo senso la costruzione generalizza la codifica sinusoidale a un grafo qualunque; non la contiene però come caso particolare, perché le frequenze sono \(\pi k/N\) e non \(10000^{-2i/d}\). La ricetta GPS tiene i due canali insieme, message passing per il locale e attenzione per il lontano; con le MPNN tarate con la stessa cura, però, il vantaggio sul Long Range Graph Benchmark si chiude in diversi insiemi di dati (Tönshoff e colleghi, 2024).
Il grafo, da qui in avanti, è un modo di guardare più che un caso particolare. Ogni volta che i dati sono fatti di cose collegate ad altre cose, la domanda «che cosa dicono di questo nodo i suoi vicini?» è già mezza risposta. Il capitolo sui sistemi di raccomandazione parte da una domanda più vecchia delle reti su grafo, prevedere i voti di una tabella di utenti per film, e solo più avanti riscrive quella tabella come grafo bipartito, quello di chi ha guardato che cosa: lì il compito torna a essere uno che ormai sai riconoscere, dire quali collegamenti mancano.