


Visione artificiale: far vedere le macchine#
Un lavoro per l’estate: tanto doveva bastare, secondo il piano che Seymour Papert scrisse al MIT nel 1966, il Summer Vision Project, perché un gruppo di studenti costruisse un sistema capace di separare gli oggetti dallo sfondo in un’immagine e di riconoscerli. Dello stesso anno si racconta un aneddoto più famoso, e meno documentato: Marvin Minsky avrebbe chiesto a un suo studente, Gerald Sussman, di passare l’estate a collegare una telecamera a un computer e a fargli descrivere quello che vedeva [Sze22]. L’idea di fondo, in tutte e due le storie, era che un problema tanto naturale (noi vediamo senza sforzo, di continuo) si potesse sistemare in una manciata di settimane. Mezzo secolo dopo, la visione artificiale è ancora un campo di ricerca vivo e aperto. La sottovalutazione ha una ragione: vedere ci sembra facile perché il cervello lo fa senza che ce ne accorgiamo, in una frazione di secondo.
Si parte proprio da lì: da che cosa significhi, per una macchina, «vedere», e dalla scoperta, arrivata sul serio solo dopo il 2010, che il modo migliore per insegnarglielo non è scrivere regole ma mostrarle milioni di esempi. Il modello che impara così è la rete convoluzionale del capitolo sul deep learning, che lì ha imparato a dire che cosa c’è in una foto; qui la si prende già addestrata e la si piega agli altri mestieri del vedere: riconoscere con pochi esempi, dire dov’è una cosa, ritagliarne il contorno, ricostruire la profondità della scena.
Un’immagine è una griglia di numeri#
Per un computer non esistono «gatti», «cieli» o «volti»: esistono numeri. Prima di qualunque ragionamento, un’immagine dev’essere tradotta in qualcosa che una macchina possa manipolare, e quel qualcosa è una griglia.
Una foto, per il computer, è un enorme foglio a quadretti. Ogni quadretto è un pixel, e dentro ci sta un numero che dice quanto quel puntino è chiaro o scuro: \(0\) è nero pieno, \(255\) è bianco pieno, e i valori in mezzo sono le sfumature di grigio. Il \(255\) viene da come il computer conta, a gruppi di otto interruttori acceso-spento, e ogni interruttore raddoppia le combinazioni possibili, cioè \(2 \times 2 \times 2 \times 2 \times 2 \times 2 \times 2 \times 2 = 2^8 = 256\). Contando anche lo zero, i valori vanno da \(0\) a \(255\). Una foto in bianco e nero è tutta qui: una tabella di numeri fra \(0\) e \(255\).
Se la foto è a colori, ogni quadretto non ha più un numero solo ma tre, quanto rosso, quanto verde, quanto blu (il famoso RGB), che mescolati ricreano ogni tinta.
La scala da \(0\) a \(255\) è un’unità di misura come i gradi o i centimetri, e si può cambiare senza toccare la foto: dividendo ogni numero per \(255\) gli stessi quadretti diventano valori fra \(0\) e \(1\), e il grigio di mezzo, \(128\), diventa poco più di \(0{,}5\). È il cambio di scala che si fa quasi sempre prima di dare le immagini a una rete: i numeri interni di una rete partono piccoli, tarati per ingressi grandi più o meno come uno, e con valori fino a \(255\) le prime somme uscirebbero centinaia di volte più grandi del previsto.
Il foglio, però, è grande. Una foto di \(224\) quadretti per lato, la taglia con cui si lavora di solito, ne conta \(224 \times 224 = 50\,176\); a colori sono tre numeri per quadretto, cioè \(150\,528\) numeri per un’immagine che sullo schermo occupa quanto un francobollo. Viene la tentazione di prenderli e metterli tutti in fila, uno dopo l’altro, come una lunghissima lista della spesa. Il danno si vede subito: nella fila il quadretto sopra e quello sotto finiscono a centinaia di posti di distanza, e sparisce l’unica cosa che li teneva insieme, cioè che erano attaccati, e che quindi appartenevano probabilmente allo stesso bordo, allo stesso pelo, allo stesso occhio. I numeri ci sono ancora tutti; quello che non c’è più è chi sta accanto a chi.
Trovare dentro quella griglia le regolarità che corrispondono a ciò che noi chiamiamo «un gatto»: tutto il lavoro della visione artificiale è qui.
Un’immagine è un tensore \(\mathbf{X} \in \mathbb{R}^{C \times H \times W}\), nell’ordine channels-first di PyTorch: canali, altezza, larghezza (dove \(C=1\) in scala di grigi, \(C=3\) per RGB). L’elemento \(X_{c,i,j}\) è l’intensità del canale \(c\) nel pixel di riga \(i\) e colonna \(j\), tipicamente un intero in \(\{0,\dots,255\}\) che in fase di addestramento si normalizza in \([0,1]\) o si standardizza a media nulla e varianza unitaria.
Le dimensioni crescono in fretta: una modesta immagine \(3 \times 224 \times 224\) (la taglia d’ingresso classica delle reti addestrate su ImageNet) porta \(150\,528\) numeri. Trattarla come un vettore piatto, ignorando che i pixel vicini sono correlati, è proprio l’errore che le reti convoluzionali (costruite nel capitolo precedente, e qui date per acquisite) evitano per costruzione.
Perché è difficile: la distanza fra pixel e significato#
Fra la griglia di numeri e la parola «gatto» c’è un salto, e va misurato prima di provare a colmarlo: ogni tecnica delle prossime sezioni risponde a una sua voce precisa.
Sulla vetrina del bar c’è l’avviso di un gatto siamese smarrito: la foto, e un recapito da chiamare. Nel pomeriggio, sul telefono della padrona, arrivano sette foto di gatti avvistati in giro, mandate da chi ha letto l’avviso. Per il telefono ognuna è una griglia di numeri, e tanti numeri, da soli, non spaventano nessuno: un computer li macina. Il guaio è che lo stesso gatto produce griglie completamente diverse, e due gatti diversi possono produrne di molto simili.
Punto di vista. Uno è preso dal balcone: schiena e coda, mentre sull’avviso il gatto è di fronte. Le due griglie non hanno un quadretto in comune.
Scala. In un altro l’animale è in fondo alla strada, una manciata di quadretti; sull’avviso ne riempie migliaia.
Deformazione. In un terzo è accucciato sotto una macchina: un animale morbido, che in salto o disteso resta lo stesso con un’altra forma.
Occlusione. In uno metà gatto sta dietro un divano, e la risposta deve arrivare lo stesso.
Illuminazione. Uno è in controluce, e i valori dei quadretti si ribaltano; al tramonto sarebbero diventati tutti più arancioni.
Sfondo confuso. In un altro un tigrato sta su un tappeto a righe: i confini che noi vediamo senza pensarci vanno indovinati numero per numero.
Variazione dentro la classe. L’ultimo ritrae un persiano bianco: col siamese dell’avviso condivide l’etichetta e quasi nient’altro.
Dentro il telefono le foto non le guarda nessuno: ci sono solo i numeri. Si sovrappongono i due fogli a quadretti, si fa la differenza quadretto per quadretto, la si eleva al quadrato perché un quadretto più chiaro e uno più scuro non si cancellino a vicenda, e si somma tutto: ne esce un numero che dice quanto le due foto sono lontane. Nel telefono c’è anche un album di scatti già etichettati, e la regola più ovvia che esista è pescare il più vicino e copiarne l’etichetta. Sui numeri grezzi quella regola sbaglia in tutt’e due i versi: lo stesso gatto in controluce e al sole risulta lontanissimo da sé, mentre un gatto e un cane fotografati nella stessa stanza con la stessa luce risultano vicini. Quel conto misura le luci e gli sfondi, non i soggetti.
Fra i sette manca la variazione più elementare di tutte: dove sta il gatto nell’inquadratura. Manca perché a quella pensa già la forma della rete, la sua architettura. Sul foglio a quadretti passa una lente piccola, sempre la stessa, un quadretto alla volta, dall’angolo in alto a sinistra fino in fondo: è la convoluzione, e la lente si chiama filtro. La lente non sa in che punto si trova, quindi quello che impara a riconoscere in un angolo lo riconosce anche nell’altro, ed è già moltissimo.
Fra uno strato e l’altro, però, la rete ricopia il foglio più piccolo: lo divide in quadratini di pochi quadretti, e di ognuno tiene il numero più forte e lascia cadere gli altri. Finché il gatto si sposta restando dentro lo stesso quadratino il più forte resta quello e la copia non cambia; appena scavalca il confine cambia eccome, e con essa possono cambiare tutte le copie che vengono dopo. La lente è la stessa dappertutto; la risposta no. Su foto vere basta spostare di poco l’inquadratura perché anche una rete convoluzionale grande cambi risposta, e non di rado: circa una volta su dieci.
Chi addestra la rete rilegge i sette scatti come una lista di cose da fare: di foto del gatto ne ha poche e ne fabbrica centinaia, ritagliando (contro la scala), coprendo un rettangolo a caso (contro l’occlusione), schiarendo e scurendo (contro l’illuminazione). Moltiplicare le foto deformandole si chiama data augmentation: ogni gesto risponde a una voce, e insieme dicono alla rete quali cambiamenti devono lasciare la risposta dov’era. Una voce resta scoperta, il punto di vista: girare la foto imita una fotocamera tenuta storta, ma da uno scatto di fronte nessuna deformazione ricava la schiena e la coda.
Lo stesso gesto porta fino a imparare da foto che nessuno ha etichettato. Si ritagliano due pezzi dello stesso scatto, la testa e una zampa, e si pretende dalla rete la stessa descrizione per tutti e due, senza dirle mai che cosa raffigurano. Chi sceglie quali cambiamenti non devono contare sta scegliendo, in quel momento, che cosa la rete imparerà a guardare.
Il salto si chiama divario semantico (semantic gap) [SWS+00]: fra la rappresentazione numerica \(\mathbf{X} \in \mathbb{R}^{C\times H\times W}\) e la categoria semantica non c’è nessuna relazione semplice, e in particolare nessuna relazione che si possa scrivere guardando i valori dei pixel uno per uno.
Formulato con precisione, il compito è imparare una funzione \(f: \mathbb{R}^{C\times H\times W} \to \{1,\dots,K\}\) che sia invariante a una famiglia di trasformazioni di nuisance (traslazione, scala, rotazione limitata, cambi fotometrici, occlusioni parziali) e allo stesso tempo discriminativa rispetto alle differenze fra classi, che sono spesso molto più piccole, nella metrica dei pixel, delle variazioni da ignorare. Due immagini della stessa classe possono avere distanza euclidea maggiore di due immagini di classi diverse: è il motivo per cui un classificatore a vicini più prossimi sui pixel grezzi funziona male, e il primo tentativo di rimediare furono i filtri disegnati a mano.
Le invarianze si ottengono in tre modi, che il resto del capitolo percorre tutti. Per architettura: la condivisione dei pesi della convoluzione dà l’equivarianza alla traslazione, e il pooling una tolleranza locale alle piccole traslazioni. Quest’ultima, però, è un’intenzione di progetto più che una proprietà garantita: come si è visto parlando del pooling nel capitolo precedente, il sottocampionamento ignora il teorema del campionamento. Di conseguenza, a causa dell’aliasing, una CNN moderna resta sorprendentemente sensibile a uno spostamento di pochi pixel. Su ImageNet una ResNet-50 assegna la stessa classe a due copie della stessa immagine spostate a caso nell’\(89{,}2\%\) dei casi, e nel resto cambia idea [Zha19]. Per dati: la data augmentation espone il modello alle trasformazioni che deve ignorare, ed è un modo di iniettare un’invarianza senza cablarla nell’architettura. Per addestramento: l’apprendimento auto-supervisionato costruisce il compito proprio a partire dalla scelta di quali trasformazioni debbano lasciare invariata la rappresentazione, e lì la scelta delle trasformazioni coincide con la definizione del problema.
I compiti della visione#
Avere i numeri è solo l’inizio: occorre decidere che cosa chiedere alla rete di produrre. Da qui nascono i quattro compiti fondamentali, che si possono leggere come una scala di ambizione crescente (Fig. 11.1).

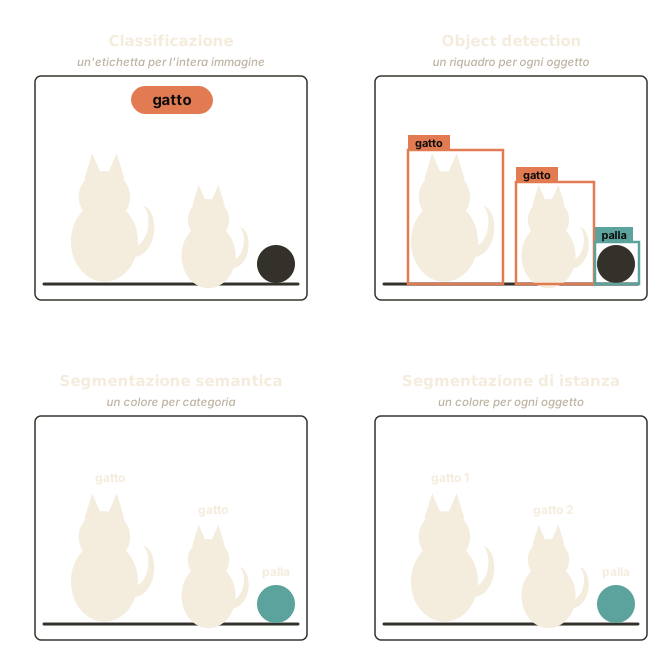
Fig. 11.1 I quattro compiti classici della visione a confronto sulla stessa scena. Si va dall’etichetta unica per l’immagine (classificazione) fino a distinguere ogni singolo oggetto pixel per pixel (segmentazione di istanza).#
Classificazione: «che cosa c’è in questa foto?». Il modello risponde con una sola parola per l’intera immagine (gatto) senza dire dove si trovi.
Rilevamento (detection): «che cosa c’è, e dove?». Il modello disegna un riquadro attorno a ogni oggetto e lo etichetta: due riquadri «gatto» e uno «palla».
Segmentazione semantica: «a quale categoria appartiene ogni singolo pixel?». Si colora l’immagine come una cartina: tutti i pixel-gatto di un colore, i pixel-palla di un altro. I due gatti finiscono nella stessa tinta, perché sono la stessa categoria.
Segmentazione di istanza: come sopra, ma i due gatti diventano due oggetti distinti, con colori diversi. È il compito più fine: separa non solo le categorie, ma i singoli individui.
Il riquadro del rilevamento non viene mai esatto al pixel, e per dire se è buono si mettono a confronto due rettangoli: quello disegnato dalla macchina e quello che avrebbe disegnato una persona. Si misura la parte in comune e la si divide per la parte coperta in tutto. Rettangoli identici danno \(1\), rettangoli che non si toccano danno \(0\); e se la macchina copre metà del riquadro giusto e sborda altrettanto, in comune c’è mezzo riquadro mentre la superficie coperta in tutto è un riquadro e mezzo, quindi \(0{,}5\) diviso \(1{,}5\), cioè un terzo. Sotto una soglia che si fissa in partenza, il riquadro conta come sbagliato.
Più la risposta è fine, più costa prepararla, e a pagare è chi prepara gli esempi. Scrivere «gatto» sotto una foto sono pochi secondi; ritagliarne la sagoma esatta, pixel per pixel, sono minuti, e per una foto sola. È la ragione per cui di foto con una parola sotto ne esistono a milioni, e di sagome ritagliate molte meno.
Formalmente, i quattro compiti differiscono per la forma dell’output.
Classificazione: \(\hat{y} = \arg\max_{k \in \{1,\dots,K\}} f_k(\mathbf{X})\), una sola etichetta su \(K\) classi per l’intera immagine.
Rilevamento: l’output è un insieme di terne \(\{(\hat{c}_i,\ s_i,\ \mathbf{b}_i)\}_{i=1}^{N}\), con \(N\) che cambia da un’immagine all’altra, dove \(\hat{c}_i\) è la classe, \(s_i \in [0,1]\) la confidenza e \(\mathbf{b}_i = (x, y, w, h)\) il bounding box (centro, larghezza e altezza). La qualità di un riquadro si misura con la Intersection over Union \(\mathrm{IoU} = \frac{|A \cap B|}{|A \cup B|}\) tra box predetto e reale; quella del rilevatore con la mean Average Precision (mAP), che scorre le predizioni per \(s_i\) decrescente.
Segmentazione semantica: una predizione per ogni pixel, \(\hat{y}_{i,j} \in \{1,\dots,K\}\). Due istanze della stessa classe condividono l’etichetta.
Segmentazione di istanza: a ogni pixel si associa una classe e un’identità di istanza, distinguendo gatto-1 da gatto-2.
Il costo di annotazione cresce nello stesso ordine: etichettare un’immagine è questione di secondi, tracciare una maschera pixel-perfetta richiede minuti.
Questi quattro compiti hanno una cosa in comune: rispondono a domande sul contenuto dell’immagine, e anche quando dicono dove sta qualcosa lo dicono dentro il piano della foto: il riquadro di un rilevatore dà la posizione in pixel, non in metri. Esiste però una seconda famiglia di domande, che il capitolo affronta più avanti e che richiede strumenti diversi: dove sono le cose nello spazio, quanto sono lontane, come si muovono, che forma hanno. Lì la risposta non si trova guardando meglio una fotografia, perché la profondità è andata perduta nel momento dello scatto, e va ricostruita da più viste o indovinata con un modello di come è fatto il mondo.
Dai filtri disegnati a mano alle feature imparate#
Per decenni la strategia fu ovvia quanto faticosa: se vuoi trovare un bordo, scrivi tu la regola per trovarlo.
È la storia che il capitolo sul deep learning racconta in generale, e sulle immagini è andata così. Un esperto progettava a mano dei «rilevatori»: una formula per scovare i bordi (dove il colore cambia bruscamente è probabile ci sia un contorno), un’altra per le forme, un’altra per gli angoli. Anche la formula più semplice nascondeva un mestiere: prima di cercare i salti di colore bisognava sfocare un poco la foto, altrimenti ogni granello di rumore sembrava un bordo. Quei rilevatori non decidevano niente da soli: passavano la foto al setaccio e ne tiravano fuori una scheda di misure (tanti bordi verticali qui, tanti obliqui là), e a dire «gatto» oppure «non gatto» ci pensava un secondo programma, addestrato su esempi già etichettati. Imparare dagli esempi si faceva già, ma riguardava soltanto l’ultimo passo: il setaccio restava quello che l’esperto aveva costruito a mano.
Funzionava, ma solo fino a un certo punto: ogni nuovo problema richiedeva nuove regole cucite a mano, e la realtà (luci, ombre, angolazioni) è troppo varia per essere ingabbiata in istruzioni fisse.
La svolta è stata spostare il confine fra ciò che si scrive a mano e ciò che si impara, perché anche il setaccio si può imparare. Invece di dire alla macchina come riconoscere un gatto, le mostriamo migliaia di gatti e lasciamo che sia lei a costruirsi i rilevatori giusti. Le «regole» non le scrive più l’ingegnere: emergono dai dati.
L’era delle feature ingegnerizzate ci ha lasciato strumenti tuttora eleganti: il rilevatore di bordi di Canny (1986), i descrittori SIFT di Lowe (1999, nella forma canonica del 2004), invarianti a scala e rotazione, e l’istogramma dei gradienti orientati HOG di Dalal e Triggs [DT05], a lungo lo standard per il rilevamento di pedoni. Canny, per dirne uno, smussa l’immagine con una gaussiana prima di derivarla, perché la derivata da sola amplifica il rumore pixel per pixel; poi tiene, lungo la direzione del gradiente, soltanto i massimi locali, e decide quali sono bordi con due soglie collegate per isteresi [Can86]. Erano feature fisse, seguite da un classificatore addestrabile (spesso una SVM).
La rottura arriva con le reti convoluzionali. LeCun e colleghi mostrano già nel 1998, con LeNet-5, che una CNN può imparare da sola i filtri leggendo cifre scritte a mano. Ma è il 2012 lo spartiacque, con la vittoria di AlexNet (Krizhevsky, Sutskever, Hinton) a ImageNet [KSH12], che le architetture storiche raccontano cifra per cifra. Da allora, per il riconoscimento, le feature non si disegnano più: si imparano, strato dopo strato, direttamente dai pixel. Quelle disegnate a mano sopravvivono nella geometria, dove SIFT resta il punto di partenza di molte pipeline di ricostruzione tridimensionale.
Il carburante: i grandi dataset#
Le reti convoluzionali non si sarebbero imposte senza enormi quantità di dati su cui addestrarsi. Il progetto ImageNet, guidato da Fei-Fei Li, viene presentato nel 2009 con 3,2 milioni di immagini etichettate ed è poi cresciuto fino a oltre quattordici milioni; la sua gara annuale (la ImageNet Large Scale Visual Recognition Challenge) usa un sottoinsieme di mille categorie ed è la palestra su cui, nel 2012, AlexNet ottiene il risultato che apre la strada alle reti convoluzionali profonde. Poco dopo arriva COCO (Common Objects in Context, 2014), con centinaia di migliaia di immagini annotate non solo con l’etichetta, ma con i riquadri e le maschere (le sagome pixel per pixel di poco fa) di circa ottanta categorie di oggetti comuni: il banco di prova naturale per rilevamento e segmentazione. La lezione vale per tutto il deep learning: un’architettura rende quanto le permettono i dati con cui la si addestra.
Dalla classificazione alla geometria#
Il mattone fondamentale, la convoluzione, e le reti che si basano su di essa sono state introdotte nella sezione sulle reti convoluzionali del capitolo precedente, insieme alle architetture che hanno fatto scuola: qui le diamo per acquisite e le mettiamo al lavoro. Si parte da dove serve davvero, cioè dai dati. Prima riusare una rete che qualcun altro ha già addestrato su milioni di immagini (il transfer learning), poi moltiplicare le foto che non abbiamo deformando quelle che abbiamo (la data augmentation), poi fare a meno delle etichette, imparando da immagini che nessuno ha mai etichettato: la risposta giusta, allora, la si ricava dalle immagini stesse, inventando un compito la cui soluzione è già nei dati (l’apprendimento auto-supervisionato). Poi salgono le pretese sulla risposta, dal riquadro attorno all’oggetto alla sua sagoma esatta: rilevamento e segmentazione.
Le sezioni successive escono dal piano dell’immagine ed entrano nello spazio. La prima riguarda la geometria che lega una fotografia alla scena da cui viene, e che permette di ricavare la profondità da due viste o dal movimento. È la parte più antica della visione artificiale, perché il modello di fotocamera che useremo è la prospettiva dei pittori del Quattrocento, ed è anche quella che le reti non hanno sostituito, ma a cui si sono appoggiate. La seconda è un modo nuovo di rappresentare una scena: invece di ricostruire un oggetto solido si addestra una funzione che a ogni punto dello spazio, guardato da ogni direzione, associa un colore e una densità, e la funzione può essere una piccola rete oppure una nuvola di milioni di granelli sfumati. Si chiamano campi di radianza, dal nome che la fisica dà alla luce che parte da un punto in una certa direzione.
Chiude il capitolo il trasferimento di stile, che di una fotografia tiene il soggetto e ne cambia la pennellata.
Da ricordare
Per un computer un’immagine è un foglio a quadretti pieno di numeri: ogni quadretto (un pixel) dice quanto quel puntino è chiaro o scuro, oppure quanto rosso, verde e blu contiene. Dentro non ci sono gatti né cieli: solo numeri, e il mestiere della visione artificiale è trovarci delle regolarità.
I quattro compiti classici (classificazione, rilevamento, segmentazione semantica e di istanza) chiedono risposte via via più precise: una parola per tutta la foto, un riquadro attorno a ogni oggetto, un colore per ogni pixel secondo la categoria, fino a distinguere un gatto dall’altro.
La grande transizione, nel riconoscere gli oggetti: prima erano gli esperti a scrivere a mano le regole per trovare bordi, angoli e forme; poi si è lasciato che fosse la rete a costruirsi da sola i propri rilevatori, guardando milioni di esempi. Il momento simbolo è la vittoria di AlexNet alla gara di ImageNet nel 2012.
Le grandi raccolte di immagini già etichettate (ImageNet, COCO) sono state il carburante: senza esempi in quella quantità le reti profonde non avrebbero avuto con che cosa imparare.
A quei compiti se ne aggiunge una famiglia diversa, che chiede dove sono le cose nello spazio, e a quale distanza, e non solo che cosa sono. Lì la difficoltà è di natura opposta: la distanza è stata cancellata dallo scatto, e si recupera confrontando più immagini o affidandosi a ciò che il modello ha imparato su come è fatto il mondo.
Da ricordare
Per un computer un’immagine è un tensore \(\mathbf{X} \in \mathbb{R}^{C \times H \times W}\): una griglia di numeri, non di oggetti.
I quattro compiti classici (classificazione, rilevamento, segmentazione semantica e di istanza) differiscono per la forma dell’output, dall’etichetta unica alla maschera per singolo oggetto.
Nel riconoscimento la grande transizione è dalle feature disegnate a mano (Canny, SIFT, HOG) a quelle imparate dalle CNN, con la svolta di AlexNet su ImageNet (2012); nella geometria quelle disegnate a mano restano in uso.
Senza grandi dataset etichettati (ImageNet, COCO) le CNN profonde non avrebbero avuto con che cosa addestrarsi.
Accanto ai quattro compiti c’è la visione geometrica, che stima posizioni e distanze invece di categorie. La proiezione prospettica non è invertibile (un pixel determina una direzione, non un punto), quindi la profondità si ricostruisce da più viste con vincoli esatti, oppure si stima da una vista sola con un prior appreso.