


GPU e calcolo parallelo#
Per trent’anni i programmatori hanno goduto di un privilegio che sembrava una legge di natura: bastava aspettare. Un programma lento oggi sarebbe stato veloce l’anno seguente, senza toccare una riga di codice, perché i processori alzavano la loro frequenza di clock a ritmo regolare. Il clock è il metronomo del chip: un tic che scandisce le operazioni una dopo l’altra, e che in un processore moderno batte qualche miliardo di volte al secondo. Farlo battere più in fretta faceva andare più in fretta ogni programma già scritto: il «pasto gratis».
Poi, intorno al 2004, il pasto finì. Un chip, mentre lavora, consuma corrente e la trasforma in calore, e la potenza che dissipa vale all’incirca \(C V^2 f\): \(C\) è la capacità dei circuiti che si caricano e si scaricano a ogni battito, \(V\) la tensione che li alimenta, \(f\) la frequenza del clock. Per decenni alzare \(f\) non era stato un problema, grazie a una regola di scala ricavata nel 1974 da Robert Dennard e colleghi [DGY+74], lo scaling di Dennard. A ogni generazione i transistor (i minuscoli interruttori di cui un chip è fatto) si rimpicciolivano di un fattore \(\kappa\), e la tensione scendeva nella stessa proporzione: ogni transistor consumava allora \(\kappa^2\) volte meno e poteva battere \(\kappa\) volte più in fretta, e siccome nello stesso quadratino di silicio ne stavano \(\kappa^2\) volte tanti, la potenza per millimetro quadrato restava la stessa. Verso la metà degli anni Duemila la tensione smise di scendere. Per abbassarla bisogna abbassare anche la tensione di soglia, quella a cui il transistor si accende, e con una soglia troppo bassa il transistor lascia passare corrente anche da spento, cioè scalda senza lavorare. Ferma la tensione, ogni aumento di frequenza diventava calore in più, e presto più calore di quanto se ne riuscisse a portare via: i chip avevano trovato un muro fisico, il power wall.
Nel 2004 Intel rinunciò ai processori che avrebbero dovuto correre a frequenze sempre più alte; nel 2005 Herb Sutter, che presiedeva il comitato di standardizzazione del linguaggio C++, mise la cosa nero su bianco in un saggio dal titolo diventato celebre, The Free Lunch Is Over. La morale era semplice e spiazzante: da lì in avanti, per andare più veloci non si sarebbe più potuto contare su un core più rapido, ma solo su più core che lavorano insieme. Un core è un calcolatore completo in miniatura, capace di portare avanti da sé un programma: fino a quel momento i chip ne avevano uno, o pochi, e li facevano correre sempre di più; da lì in avanti ne avrebbero messi tanti, ciascuno alla velocità di prima. Il futuro, scriveva Sutter, era parallelo (Fig. 8.1).

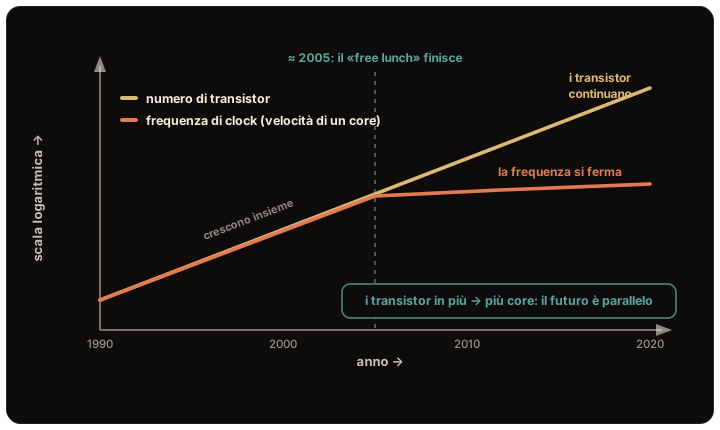
Fig. 8.1 Un andamento schematico, non i numeri veri: quello che conta è la forma delle due curve. Il numero di transistor per chip ha continuato a raddoppiare ogni due anni circa, ma intorno al 2005 la frequenza di clock (cioè la velocità di un singolo core) si è fermata. I transistor «in più» hanno smesso di rendere veloce un core e hanno iniziato a fornire più core: la ragione per cui il calcolo è diventato parallelo.#
Eppure un chip costruito fin dall’inizio proprio su quel principio (tanti piccoli esecutori invece di uno solo velocissimo) esisteva già, e faceva un mestiere che con l’intelligenza artificiale sembrava non c’entrare nulla: disegnare i videogiochi. Una scena tridimensionale, al computer, è fatta di migliaia di triangoli: è la forma più semplice che descriva un pezzetto di superficie, e con tanti triangoli piccoli si approssima qualunque sagoma, un muro come una faccia. Il mestiere della Graphics Processing Unit era prendere quei triangoli e riempirli di pixel colorati, decine di volte al secondo (rasterizzazione): un lavoro fatto di conti identici e indipendenti, il paradiso del parallelismo.
Nel 2006-2007 NVIDIA fece una mossa che avrebbe cambiato la storia dell’AI: diede a chiunque il modo di far fare a quei chip conti qualunque, e non più soltanto disegni. Quel modo si chiama CUDA [NBGS08], ed è un dialetto di un linguaggio di programmazione più il corredo di strumenti che serve a usarlo: si scrive un programma normale, e si dice quali pezzi devono girare sulla scheda video invece che sul processore.
Da lì la stessa folla di esecutori che colorava pixel si rivelò perfetta per un altro compito fatto di conti tutti dello stesso tipo e indipendenti: addestrare reti neurali. Nel 2011 una rete per immagini addestrata su GPU vinse una gara di riconoscimento dei segnali stradali, riconoscendoli meglio delle persone [CirecsanMMS11]; l’anno dopo AlexNet vinse ImageNet, la gara di riconoscimento delle fotografie, con un distacco che convinse il resto del campo [KSH12]. Da allora hardware parallelo e deep learning non si sono più lasciati.
La sezione sulle prestazioni e la scala aveva
insegnato i gesti per usare una scheda (.to(device), autocast,
torch.compile, DistributedDataParallel) e li aveva giustificati a grandi
linee, con l’analogia della GPU come squadra di operai semplici. Qui si apre il
cofano: perché quei gesti funzionano, cosa succede davvero nel silicio quando
una rete gira, e fin dove si può spingere l’hardware. Non serve saper
programmare una GPU per usarla (PyTorch lo fa per noi), ma capire come è fatta
dentro spiega quasi tutto ciò che separa un addestramento veloce da uno lento.
Due idee attraversano tutte le sezioni che seguono.
Molti, non veloci: la scommessa del parallelismo#
La prima idea è la scelta di costruzione che rovescia quella della CPU, il processore principale di ogni computer, quello che fa girare i programmi di tutti i giorni (le tre lettere stanno per Central Processing Unit, unità centrale di elaborazione). Una CPU ha pochi core, ciascuno velocissimo e capace di fare da sé qualunque cosa. La GPU mette al loro posto migliaia di unità di calcolo molto più semplici, ciascuna capace solo di fare conti, ma tutte attive nello stesso istante. (Anche quelle si chiamano «core», per estensione, ed è una parola che nelle due macchine indica cose piuttosto diverse: la sezione su com’è fatta una GPU dentro ci torna sopra.)

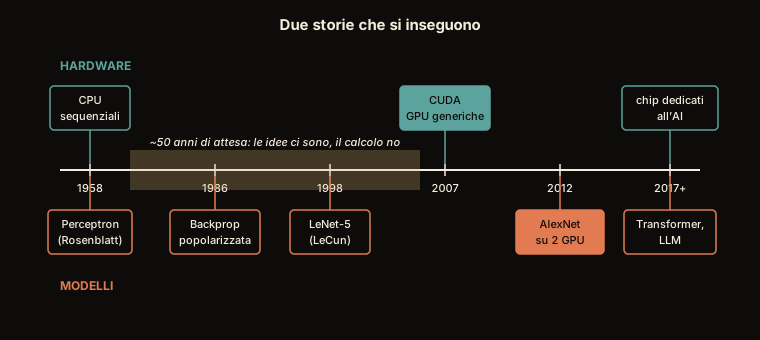
Fig. 8.2 Due storie sullo stesso asse degli anni: sopra il calcolo disponibile, sotto i modelli. Le idee delle reti a molti strati erano quasi tutte già scritte quando la potenza di calcolo non c’era, ed è la banda chiara al centro: cinquant’anni di attesa.#
Guardando la Fig. 8.2 si nota soprattutto una cosa: fra un’idea e il momento in cui quell’idea funziona possono passare decenni. Il percettrone è del 1958, la backpropagation si diffonde nel 1986, le reti convoluzionali, quelle fatte per le immagini, sono in piedi nel 1998; il risultato che convince tutti arriva nel 2012, cinque anni dopo CUDA. Non è una curiosità da tecnici dei computer: per lunghi tratti della storia dell’AI il limite non è stato capire cosa fare, ma poterlo calcolare.
Puoi affidare un lavoro a un genio solitario, capace di risolvere in fretta qualunque problema difficile, oppure spendere la stessa cifra in una folla di persone comuni, ognuna capace di fare solo un conticino elementare ma tutte insieme, nello stesso momento. Il budget è quello, e la scelta è secca: pochi bravissimi, o moltissimi lenti.
Per un problema che cambia di continuo (decisioni, eccezioni, imprevisti), vince il genio: è la CPU. Per una montagna di conti dello stesso tipo (la stessa moltiplicazione, ripetuta su numeri diversi) e indipendenti fra loro vince la folla, perché non serve intelligenza, serve manodopera.
C’è un secondo guadagno, meno ovvio, e riguarda i tempi morti. In mezzo alla folla capita spesso di restare fermi: uno aspetta il foglio di numeri che gli devono portare, e quel foglio arriva quando arriva. Il caposquadra non sta a guardarlo, dà il lavoro a un altro tavolo che il suo foglio ce l’ha già. L’attesa del singolo dura esattamente quanto durava prima, e intanto la sala lavora lo stesso. Con il genio da solo, invece, mentre lui aspetta si ferma tutto.
La scommessa si può perdere, e si perde in un caso preciso: quando il lavoro è una catena, e ogni passo ha bisogno del risultato del passo che lo precede. Allora una persona lavora e tutte le altre la guardano, mentre il genio avrebbe già finito da un pezzo. E basta un pezzo di catena piccolo per pesare molto: se anche solo un ventesimo del lavoro va fatto in fila, mille persone vanno al massimo venti volte più in fretta di una sola, perché quel ventesimo nessuno lo può accorciare. La folla conviene se c’è davvero da fare la stessa cosa migliaia di volte insieme.
Una rete neurale è fatta esattamente di quella montagna, e il conto si può fare. Prendi uno strato solo, di quelli che hanno mille numeri in ingresso e mille in uscita: ogni numero in uscita nasce da mille moltiplicazioni, e ognuna si porta dietro la somma che la accumula, quindi lo strato chiede un milione di moltiplicazioni e un milione di somme. Adesso dagli non un esempio ma un mazzetto di sessantaquattro (il mini-batch, cioè quello che la rete guarda in una volta sola prima di correggersi) e i conti diventano centoventotto milioni, per un solo strato di una rete piccola: sessantaquattro milioni di moltiplicazioni, quelle che contava la sezione sulle prestazioni, più altrettante somme. Sono tutti fatti nello stesso modo, e nessuno deve aspettare il risultato di un altro: è il lavoro perfetto per la folla. La GPU è quella folla, e la sezione sull’architettura racconta come è organizzata davvero, in squadre che si danno il cambio proprio per coprire i tempi morti.
È il contrasto fra un’architettura latency-oriented e una throughput-oriented, e lo misura la legge di Little [Lit61]: per tenere occupata una risorsa che consegna \(X\) operazioni per ciclo con una latenza di \(t_\text{lat}\) cicli servono \(X \cdot t_\text{lat}\) operazioni indipendenti in volo. La CPU spende il silicio per abbassare \(t_\text{lat}\) (cache grandi, predizione dei salti, esecuzione fuori ordine) e le bastano poche operazioni in volo; la GPU accetta un \(t_\text{lat}\) di centinaia di cicli verso la memoria e alza il numero di operazioni in volo, con decine di warp residenti per SM e centinaia di migliaia di thread sul chip.
Paga solo se il problema offre quel parallelismo, e quanto lo dice la legge di Amdahl [Amd67]: se una frazione \(p\) del lavoro si divide su \(u\) unità e il resto deve procedere in sequenza, l’accelerazione vale
che per \(u \to \infty\) tende a \(1/(1-p)\): con \(p = 0{,}95\) non supera 20, per quante unità si aggiungano. Le reti neurali quel parallelismo lo offrono: il prodotto di due matrici \((M,K)\) e \((K,N)\) costa circa \(2MNK\) operazioni, raccolte in \(MN\) prodotti scalari indipendenti. La sezione sull’architettura ne scioglie i pezzi: Streaming Multiprocessor, warp, SIMT, occupancy.
La copertura delle attese si legge meglio istante per istante, ed è quello che Fig. 8.3 disegna: le stesse attese, con un’unità di calcolo sola e con quattro che si danno il cambio.
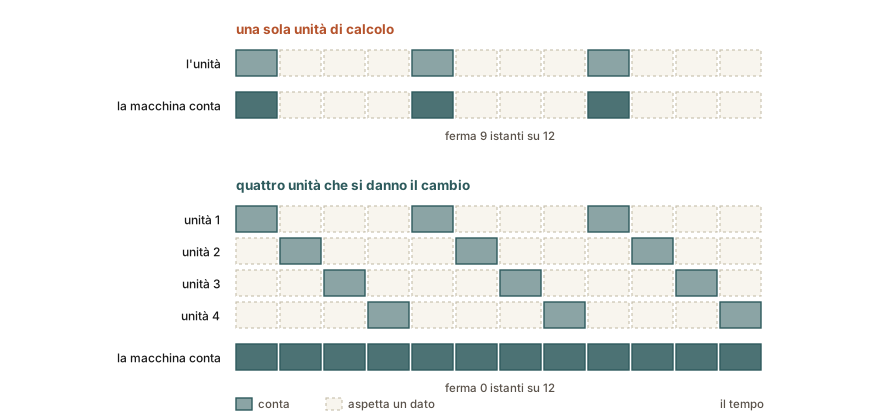
Fig. 8.3 Dodici istanti, con un’unità di calcolo e con quattro. L’attesa di ciascuna è la stessa nei due casi, tre istanti per ogni conto fatto, e nessuno l’ha accorciata. Quello che cambia è la macchina: da sola sta ferma nove istanti su dodici, con quattro che si danno il cambio non sta ferma mai.#
Il collo di bottiglia è muovere i dati#
La seconda idea è meno intuitiva: il limite di una GPU è spesso la quantità di byte che le arrivano, più che il numero di conti che sa fare. Succede quando un’operazione fa pochi conti per ogni byte che legge o scrive, e allora le unità di calcolo restano ferme ad aspettare i dati.
L’unità di misura è il byte, otto cifre binarie: una rete neurale ne usa quattro per ogni numero, oppure due. Un miliardo di byte fa un gigabyte, e la memoria di una scheda si misura in decine di gigabyte.
Portare i byte fino alle unità di calcolo costa tempo, e con migliaia di unità da rifornire è quel costo, più che il numero delle unità, a decidere le prestazioni di molti programmi.
Cento piatti al minuto: un cuoco fulmineo ci arriverebbe, se solo avesse gli ingredienti sotto mano. Sotto mano però ce ne stanno pochissimi: sul tagliere ci sta quello che serve per un piatto, sul tavolo che divide con la squadra quello per una decina, e tutto il resto sta nella dispensa in fondo a un lungo corridoio, dove qualcuno deve andare e tornare per ogni cassetta. Più un posto è vicino, meno ci sta, e nessuna cucina è mai riuscita a rompere questo patto.
Andare e tornare prende tempo, e intanto il cuoco aspetta. L’attesa, presa da sola, si copre come si è appena visto, tenendo al lavoro gli altri tavoli. Il corridoio è un’altra faccenda. Di lì passa un numero fisso di cassette al minuto, per quanti fattorini ci si mettano, e se i cuochi ne vorrebbero di più è il corridoio a decidere la velocità della cucina: i cuochi stanno fermi anche se sono i più bravi del mondo. Quel numero di cassette al minuto è la banda della memoria, ed è il muro contro cui vanno a sbattere tanti programmi. Una GPU è spesso così, una bestia affamata più che un mostro di calcolo.
Da qui la domanda che conta, ricetta per ricetta: quanto lavoro c’è da fare su ogni cassetta? Sciacquare le verdure e impiattarle è un minuto di lavoro per cassetta, e i cuochi passano la giornata ad aspettare il corridoio. Un ragù che cuoce due ore su una cassetta sola è l’estremo opposto: le cassette arrivano molto prima che servano, e a decidere la velocità sono i cuochi. Quasi tutte le tecniche che seguono servono a portare le ricette dalla parte del ragù: fare più lavoro con ogni cassetta prima di rimandare qualcuno in dispensa, e tenere le cassette vicino a chi cucina. La sezione sulla memoria misura questa cucina piano per piano.
La memoria di una GPU è una piramide di livelli, ciascuno un compromesso diverso fra velocità e capienza: registri velocissimi ma minuscoli, shared memory on-chip, cache, e la grande HBM off-chip dove vivono pesi e attivazioni. I gruppi di thread nascondono la latenza di ogni accesso, ma la banda (quanti byte al secondo la memoria consegna davvero) è finita, ed è lei il vero muro. Lo strumento che formalizza tutto questo è il modello roofline [WWP09]: mette a confronto l’intensità aritmetica di un calcolo (quanti conti fai per ogni byte spostato) con i due tetti dell’hardware, la banda e il picco di calcolo, e dice se un programma è memory-bound o compute-bound. Da qui un filo conduttore che ritroverai in ogni sezione, in forme diverse (accessi coalescenti, riuso in shared memory o tiling, fusione dei kernel, fino alla FlashAttention [DFE+22]) che sono variazioni sullo stesso tema: fare più conti per ogni byte e tenerlo il più vicino possibile ai core.
Un gradino alla volta#
Le sei sezioni scendono dal modo in cui una GPU esegue il codice fino a come si addestrano le reti che non entrano in una scheda sola.
Dentro la GPU: come è fatto il chip e come esegue centinaia di migliaia di thread, i compiti in cui si spezza il lavoro. Gli Streaming Multiprocessor, le unità in cui il chip è diviso; il warp, il gruppo di 32 thread che ricevono la stessa istruzione; l’occupancy, cioè quanti warp sono pronti a coprire le attese.
La memoria: perché sono spesso i byte, più dei conti, a fissare il tempo. La gerarchia che va dai registri alla HBM, la memoria grande della scheda; gli accessi in fila, che costano meno di quelli sparsi; il roofline, il grafico che dice se un calcolo è limitato dai byte o dai conti.
Kernel: il programma che gira sulla GPU, come lo si scrive in Triton, e perché fondere più operazioni in un kernel solo taglia i viaggi in memoria.
GEMM: il prodotto fra matrici, l’operazione in cui sta quasi tutta l’aritmetica di una rete. Il tiling che lo rende veloce, i tensor core che ne calcolano un pezzo a ogni ciclo, e l’array sistolico della TPU di Google, dove sono i dati a scorrere fra le unità di calcolo.
FlashAttention: l’attenzione dei Transformer, il meccanismo che confronta ogni parola di un testo con tutte le altre, calcolata senza mai scrivere in memoria la tabella di quei confronti.
Parallelismo distribuito: come si spartiscono fra più schede gli esempi, le matrici, gli strati e lo stato dell’addestramento, e come queste strategie si combinano.
Da ricordare
Il «pasto gratis» è finito: da metà anni Duemila un singolo calcolatore in miniatura (un core) non diventa più veloce da solo, perché alzarne la frequenza lo scalderebbe più di quanto si riesca a raffreddarlo, e per correre bisogna metterne tanti a lavorare insieme. La GPU è il chip fatto così: nata per disegnare i videogiochi, aperta ai conti di ogni tipo da CUDA [NBGS08], e sposata al deep learning quando AlexNet vinse ImageNet su due schede da videogiocatore [KSH12].
Il genio contro la folla: la GPU rinuncia ad avere pochi esecutori velocissimi e ne mette moltissimi lenti. È un pessimo affare per un lavoro che cambia a ogni passo o che va fatto in fila, ed è l’affare perfetto per milioni di conti tutti uguali e indipendenti, che è esattamente ciò di cui una rete neurale è fatta.
Spesso il collo di bottiglia sta nel portare i numeri dalla memoria fin sotto ai calcolatori, più che nel fare i conti: succede quando su ogni numero c’è poco lavoro da fare. Il cuoco è veloce, la dispensa è lontana.
Da qui il filo conduttore di tutto il capitolo, che tornerà con nomi diversi in ogni sezione: fare più lavoro con ogni carico di ingredienti, e tenere gli ingredienti il più vicino possibile a chi cucina.
A programmare la GPU ci pensa PyTorch. Sapere com’è fatta serve lo stesso, ed è quello che spiega perché un addestramento va veloce o lento.
Quando una scheda non basta, il lavoro si spartisce fra più schede: è così che nascono i modelli di cui leggiamo i nomi ogni settimana.
Da ricordare
Il «free lunch» è finito: da metà anni 2000 un core non diventa più veloce da solo, perché con la fine dello scaling di Dennard la tensione non scende più e la potenza, circa \(CV^2f\), cresce con la frequenza; per correre serve il parallelismo. La GPU è il chip parallelo per eccellenza: nato per i videogiochi, aperto al calcolo generico da CUDA [NBGS08], sposato al deep learning da AlexNet [KSH12].
Throughput contro latenza: la GPU baratta la velocità del singolo core con il numero di core, e la legge di Little dice quante operazioni deve tenere in volo per coprire le attese. Paga quanto concede la legge di Amdahl, al più \(1/(1-p)\) con una frazione \(p\) parallelizzabile, e i conti identici e indipendenti di una rete neurale (le moltiplicazioni di matrici) sono il caso più favorevole.
Il collo di bottiglia è spesso il movimento dei dati più che il calcolo: succede alle operazioni con pochi FLOP per byte spostato, per le quali la banda di memoria è il muro. Il roofline [WWP09] distingue i carichi memory-bound da quelli compute-bound.
Un unico filo conduttore lega tutto il capitolo (coalescenza, tiling, kernel fusion, FlashAttention [DFE+22]): fare più conti per ogni byte spostato, e tenerlo vicino ai core.
A programmare la GPU ci pensa PyTorch: sapere come funziona resta quello che spiega perché un addestramento va veloce o lento.
Quando una GPU non basta, il lavoro si divide su più schede (parallelismo dati, tensor, pipeline, sharding): è così che nascono i modelli di frontiera.