


Quando un’equazione è una media#
Nel 1905 Albert Einstein pubblicò un articolo sul tremolio dei granelli sospesi in un liquido, quello che Robert Brown aveva osservato al microscopio quasi ottant’anni prima nelle particelle uscite da granelli di polline sospesi in acqua (lo stesso moto browniano che la prima via dei modelli a energia ha incontrato con Langevin). Ogni granello è spinto a caso dalle molecole che lo urtano, e Einstein mostrò che una folla di granelli così si allarga secondo la stessa equazione che descrive il calore in una sbarra, con una distanza tipica dal punto di partenza che cresce come la radice del tempo (in un tempo quattro volte più lungo si va lontano il doppio, in uno nove volte più lungo il triplo) [Ein05]. Da una parte un’equazione alle derivate parziali, che lega il modo in cui il calore cambia nel tempo a come è distribuito nello spazio; dall’altra una folla di cammini casuali: da allora sono la stessa cosa, letta da due parti. La densità della folla obbedisce all’equazione del calore, e la temperatura in un punto è una media fatta sulla folla.
Le PINN hanno lasciato un conto in sospeso. Le griglie dei metodi classici diventano proibitive quando le variabili sono molte, perché i nodi crescono in modo esponenziale con la dimensione, e la molla ha appena mostrato quanto sia fragile una rete che minimizza il residuo in un campione di punti. Per una famiglia intera di equazioni, quelle che diffondono (che spargono una grandezza come il calore si sparge in una sbarra), la lettura dal lato dei cammini offre un’altra strada. La formula di Feynman-Kac scrive la soluzione in un punto come una media su cammini casuali, e una media non ha bisogno di una griglia: si stima sorteggiando, e l’errore della stima scende con il numero di cammini sorteggiati alla stessa velocità in qualunque dimensione, cioè qualunque sia il numero delle variabili. Su quella media si possono anche addestrare delle reti, il cui errore però ha altre parti, e lì la dimensione può rientrare.
Il calore come media dei cammini#
L’equazione è quella della sbarra, \(\partial u/\partial t = \alpha\,\partial^2 u/\partial x^2\), con la temperatura iniziale \(u(x, 0) = \varphi(x)\) assegnata: la temperatura \(u\) in un punto cambia nel tempo in proporzione a quanto il profilo della sbarra è curvo in quel punto (\(\partial^2 u/\partial x^2\), la derivata seconda lungo la sbarra), con la diffusività \(\alpha\) a fare da fattore, e \(\varphi\) è il profilo da cui si parte.
Per sapere quanto è calda la sbarra nel punto \(x\) dopo un tempo \(t\) si può fare a meno dell’equazione. Da \(x\) si fanno partire tanti camminatori ubriachi: a ogni istante ciascuno fa un passettino a caso, a destra o a sinistra, tanti a destra quanti a sinistra in media. Al tempo \(t\) ci si ferma, si legge la temperatura iniziale nel punto in cui è arrivato ogni camminatore, e si fa la media. Quella media è la temperatura in \(x\) al tempo \(t\): se tre camminatori arrivano dove all’inizio c’erano \(10\), \(20\) e \(30\) gradi, la stima è \(20\). I camminatori fanno all’indietro il viaggio del calore: il calore che al tempo \(t\) si trova in \(x\) è arrivato da tutti quei punti, e siccome un passo a caso verso destra è probabile quanto uno verso sinistra, la strada da \(x\) a un punto è probabile quanto quella dal punto a \(x\).
Si capisce perché la media funziona. Più passa il tempo, più i camminatori si allontanano, e la media mescola le temperature iniziali di tratti sempre più larghi della sbarra: è il calore che si spande, e che spiana le differenze. La distanza a cui arrivano cresce come la radice del tempo, come aveva visto Einstein; detto meglio, il quadrato della distanza percorsa vale in media \(2\alpha t\), quindi cresce in proporzione al tempo e alla diffusività \(\alpha\), e in una sbarra che conduce bene i camminatori arrivano lontano in poco tempo. Da qui un conto che si fa a mano. Con la temperatura iniziale uguale al quadrato della posizione, il camminatore partito da \(x\) arriva in \(x\) più il suo spostamento, e la media del quadrato è il quadrato di \(x\) più la media del quadrato dello spostamento (il termine misto si annulla, perché lo spostamento è positivo quanto negativo): \(x^2 + 2\alpha t\). Partendo da \(x = 0{,}3\) e con \(2\alpha t = 0{,}5\) il valore esatto è \(0{,}3^2 + 0{,}5 = 0{,}59\): all’inizio in \(0{,}3\) c’erano \(0{,}09\) gradi, e il calore è arrivato dai tratti più caldi ai lati. Duecento camminatori danno una media di \(0{,}599\) (Fig. 35.4).
La ricetta si allarga ad altre sbarre. Se agli estremi la temperatura è tenuta fissa, un camminatore che tocca un estremo si ferma lì e riporta quella temperatura. Se lungo la sbarra un tratto assorbe calore (un pezzo bagnato, che l’acqua raffredda), ogni camminatore parte con un gettone che vale 1 e che perde valore per ogni istante passato in quel tratto: chi non ci passa torna con il gettone intero, chi ci resta a lungo con mezzo gettone, e nella media la sua temperatura conta la metà. Quello che la ricetta non sa fare sono le sbarre in cui il calore prodotto dipende dalla temperatura in un modo che non è una proporzione fissa, come una reazione chimica che si accende solo oltre una certa temperatura: lì, per sapere quanto vale il gettone, bisognerebbe conoscere già la temperatura, cioè la risposta.
Sia \(\mathbf{W}_s\) un processo di Wiener in \(\mathbb{R}^d\) e \(u\) la soluzione di \(\partial_t u = \alpha\,\Delta u\) con \(u(\mathbf{x}, 0) = \varphi(\mathbf{x})\), con \(\varphi\) continua e \(u\) a crescita al più polinomiale (senza un vincolo di crescita l’equazione del calore su \(\mathbb{R}^d\) ha più soluzioni, e la formula sceglie questa). Allora
La dimostrazione passa per il lemma di Itô. Fissati \(\mathbf{x}\) e \(t\), il processo \(v_s = u\big(\mathbf{x} + \sqrt{2\alpha}\,\mathbf{W}_s,\ t - s\big)\), per \(0 \le s \le t\), ha differenziale \(\mathrm{d}v_s = \big(\alpha\Delta u - \partial_t u\big)\,\mathrm{d}s + \sqrt{2\alpha}\,\nabla u \cdot \mathrm{d}\mathbf{W}_s\) (il \(\sqrt{2\alpha}\) serve a far uscire dal termine di Itô, \(\tfrac12 \cdot 2\alpha\,\Delta u\), esattamente l’operatore dell’equazione), e il termine in \(\mathrm{d}s\) si annulla perché \(u\) risolve l’equazione. Resta un integrale stocastico, che è una martingala locale, e la crescita al più polinomiale di \(u\), con le sue derivate, basta a farne una martingala vera, per cui \(\mathbb{E}[v_t] = v_0\), cioè \(\mathbb{E}[\varphi(\mathbf{x} + \sqrt{2\alpha}\,\mathbf{W}_t)] = u(\mathbf{x}, t)\).
La forma con un potenziale porta il nome di Mark Kac. Nel 1949 la studiò per via della trasformata di Laplace [Kac49], ispirato dagli integrali sui cammini che Feynman aveva appena pubblicato [Fey48] e che Kac aveva sentito esporre a Cornell, dove insegnavano entrambi. Nella scrittura dei manuali di oggi, per \(\partial_t u = \alpha\Delta u - V u\),
Con una deriva e una diffusione generiche il moto browniano diventa la soluzione di un’equazione differenziale stocastica, quella delle SDE della diffusione, e l’operatore \(\alpha\Delta\) il suo generatore infinitesimale (l’operatore che dà la derivata in tempo delle medie \(\mathbb{E}[f(\mathbf{X}_t)]\)); con condizioni di Dirichlet sul bordo di un dominio il cammino si ferma al tempo di uscita e riporta il valore al bordo. Le due letture dell’apertura sono due equazioni diverse e duali: la densità \(p_t\) del processo obbedisce all’equazione di Fokker-Planck, quella in avanti già scritta per le SDE della diffusione (con deriva nulla e \(g^2 = 2\alpha\) è proprio l’equazione del calore), mentre la formula di Feynman-Kac risolve l’equazione all’indietro di Kolmogorov, quella delle medie. Per il calore coincidono perché il nucleo è simmetrico, \(p_t(\mathbf{x}, \mathbf{y}) = p_t(\mathbf{y}, \mathbf{x})\); con una deriva generica no.
La rappresentazione vale per equazioni lineari paraboliche (ed ellittiche, con i tempi di uscita). Per quelle semilineari, \(\partial_t u = \alpha\Delta u + F(u, \nabla u)\) con \(u(\cdot, 0) = \varphi\), la media semplice non basta, e serve una coppia di equazioni stocastiche all’indietro. Posti \(Y_s = u(\mathbf{X}_s, t - s)\) e \(\boldsymbol{\zeta}_s = \sqrt{2\alpha}\,\nabla u(\mathbf{X}_s, t - s)\), lo stesso lemma di Itô dà
con \(Y_0 = u(\mathbf{x}, t)\); per \(F = 0\) resta la martingala di prima, e la formula di Feynman-Kac. Il metodo deep BSDE [HJE18] tratta \(Y_0\) come un parametro, rappresenta \(\boldsymbol{\zeta}_s\) con una rete a ogni passo della discretizzazione in tempo, simula in avanti e minimizza \(\mathbb{E}\big|Y_t^\theta - \varphi(\mathbf{X}_t)\big|^2\); provato in cento dimensioni, dà errori relativi fra lo \(0{,}17\) e lo \(0{,}46\%\). Il caso senza potenziale è il teorema 8.1.1 di Øksendal, enunciato per \(\varphi\) di classe \(C^2\) a supporto compatto (l’estensione alla crescita polinomiale è standard), quello con il potenziale il suo teorema 8.2.1 [Oksendal03].
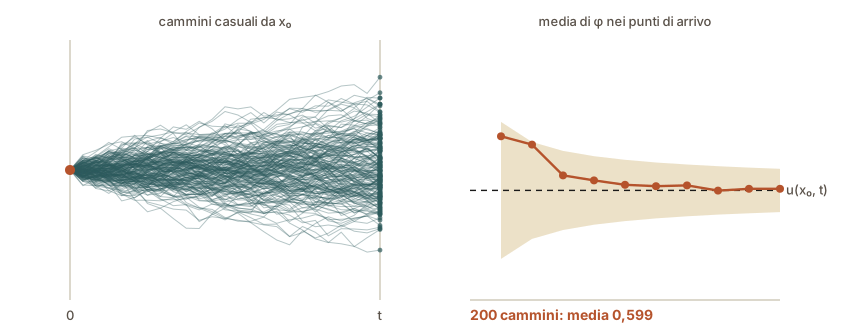
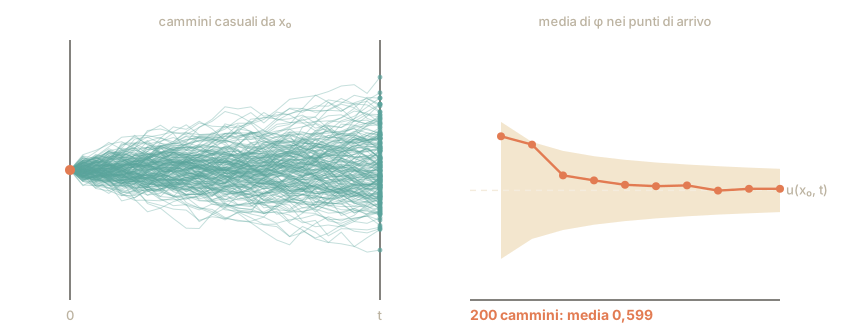
Fig. 35.4 A sinistra i cammini casuali che partono dal punto \(x_0 = 0{,}3\), a gruppi di venti, fino al tempo \(t\). A destra la media della temperatura iniziale, \(\varphi(y) = y^2\), nei punti di arrivo, con il valore esatto tratteggiato e la fascia entro cui la media cade quasi sempre (due deviazioni standard della media), che si stringe come uno diviso la radice del numero di cammini, in orizzontale.#
La dimensione non entra nell’esponente#
La dimensione è il numero delle variabili: una sbarra ne ha una, una piastra due, una stanza tre, e il prezzo di un’opzione su cento titoli di borsa ne ha cento. La media si stima con \(N\) cammini indipendenti, e l’errore della stima scende come \(\sigma/\sqrt{N}\), come per ogni media di campioni indipendenti (è la legge dei grandi numeri), cioè come uno diviso la radice del numero di cammini: cento volte più cammini, un errore dieci volte più piccolo. Il numeratore \(\sigma\) è la deviazione standard di \(\varphi\) nei punti di arrivo, cioè quanto sono sparse le temperature che i camminatori riportano; la dimensione dello spazio può renderlo più grande o più piccolo, ma non entra nella velocità con cui l’errore scende. Entra nel costo di ogni cammino, che in \(d\) dimensioni sorteggia \(d\) numeri: il conto totale cresce come \(N\,d\), lineare nella dimensione, dove una griglia a dieci nodi (i puntini) per lato ne ha \(10^d\).
Per sapere quanto sono alti in media gli italiani non si misura tutta l’Italia: se ne misurano mille, presi a caso, e la media di quei mille sbaglia di poco. Di quanto dipende da due cose sole: da quanto sono diverse le altezze fra loro (se fossero tutti alti uguale ne basterebbe uno) e da quante persone si misurano, con una regola precisa: per sbagliare dieci volte meno ne servono cento volte di più. Non dipende da quante cose si annotano di ciascuno, l’età, la regione, il mestiere, il numero di scarpe: annotarne di più allunga un po’ il lavoro per ogni persona, ma non chiede più persone.
Una griglia, invece, è un censimento per caselle. Dieci classi d’età per dieci regioni per dieci mestieri fanno mille caselle, e in ogni casella serve qualcuno; con dieci cose da annotare le caselle diventano dieci miliardi. I camminatori sono il sondaggio, e le variabili del problema sono le cose annotate di ciascuno: ogni camminatore sorteggia un passo per ogni direzione, il suo costo cresce con le direzioni, e l’errore della media resta governato da quanti camminatori si fanno partire.
Il sondaggio però ha due limiti. Dà la temperatura in un punto solo, e per averla in un altro bisogna rifarlo. E se una corrente spinge i camminatori in modo diverso da un posto all’altro, bisogna farli avanzare a passi piccoli, ricalcolando la spinta a ogni passo: la media si porta dietro anche l’errore dei passi, e per dimezzarlo servono passi lunghi la metà, cioè il doppio dei conti per ogni camminatore.
Siano \(Y_i = \varphi(\mathbf{x} + \sqrt{2\alpha t}\,\mathbf{Z}_i)\), per \(i = 1, \dots, N\), indipendenti con media \(u(\mathbf{x}, t)\) e varianza \(\sigma^2\). Lo stimatore \(\hat u_N = \frac{1}{N}\sum_i Y_i\) è corretto, il suo errore quadratico medio è \(\sigma^2/N\), e per il teorema del limite centrale \(\hat u_N \pm 1{,}96\,\hat\sigma/\sqrt{N}\) è un intervallo di confidenza asintotico al 95%. Per un errore \(\varepsilon\) servono dunque \(N \sim (\sigma/\varepsilon)^2\) cammini, ciascuno da \(d\) gaussiane: un costo \(O(d\,\sigma^2\varepsilon^{-2})\), contro gli \(O(\varepsilon^{-d/p})\) nodi di una griglia con un metodo di ordine \(p\). La dimensione entra in \(\sigma^2\) e nel costo del singolo cammino, non nell’esponente; con \(\varphi = \|\mathbf{x}\|^2\), \(\|\mathbf{x}\| = 1\) e \(2\alpha t = 1/2\) vale \(\sigma^2 = 2 + d/2\), lineare in \(d\).
L’equazione del calore è il caso fortunato, perché \(\mathbf{X}_t\) si campiona esattamente in un passo. Con una deriva e una diffusione che dipendono dal punto il cammino si integra a passo \(h\) con lo schema di Eulero-Maruyama, che ha ordine debole uno [KP92]: l’errore ha una parte statistica, \(\sigma/\sqrt{N}\), e una sistematica, \(O(h)\), e ogni cammino costa almeno \(d\,t/h\) operazioni. Bilanciando le due parti (\(N \sim \sigma^2\varepsilon^{-2}\), \(h \sim \varepsilon\)) il costo per una tolleranza \(\varepsilon\) diventa \(O(d\,\varepsilon^{-3})\): peggio del caso esatto, ma ancora lineare in \(d\), e con l’esponente di \(1/\varepsilon\) che non dipende dalla dimensione. Resta il limite strutturale: la formula dà \(u\) in un punto per volta.
Il programma stima la soluzione dell’equazione del calore per la temperatura iniziale \(\varphi(\mathbf{x}) = \|\mathbf{x}\|^2\), il quadrato della distanza dall’origine. La soluzione esatta (che qui si sa calcolare) è \(\|\mathbf{x}\|^2 + 2\alpha t\,d\), e il calcolo viene ripetuto in un punto a distanza \(1\) dall’origine in dimensioni da \(1\) a \(1000\), sempre con diecimila cammini.
import numpy as np

rng = np.random.default_rng(0)
alfa, t, N = 0.25, 1.0, 10_000
print(f"{'dimensione':>10} {'esatta':>9} {'stima':>9} {'errore':>7}  nodi di una griglia a 10 per lato")
for d in (1, 10, 100, 1000):
    x = np.full(d, 1 / np.sqrt(d))                 # un punto a distanza 1 dall'origine
    esatta = x @ x + 2 * alfa * t * d              # la soluzione: |x|^2 + 2 alfa t d
    arrivi = x + np.sqrt(2 * alfa * t) * rng.standard_normal((N, d))
    stima = (arrivi ** 2).sum(axis=1).mean()       # la media di phi nei punti di arrivo
    print(f"{d:>10} {esatta:9.3f} {stima:9.3f} {abs(stima - esatta) / esatta:7.2%}  10^{d}")
dimensione    esatta     stima  errore  nodi di una griglia a 10 per lato
         1     1.500     1.507   0.47%  10^1
        10     6.000     5.993   0.12%  10^10
       100    51.000    51.063   0.12%  10^100
      1000   501.000   500.518   0.10%  10^1000
In mille dimensioni diecimila cammini sbagliano di un millesimo, mentre la griglia più grossolana che si possa immaginare avrebbe un uno seguito da mille zeri di nodi. In questo esempio l’errore relativo (l’errore diviso per il valore esatto) addirittura scende con la dimensione, perché la dispersione di \(\varphi\) cresce come la radice di \(d\) mentre il valore esatto cresce come \(d\), e il loro rapporto cala come \(1/\sqrt{d}\): è una proprietà di \(\varphi = \|\mathbf{x}\|^2\), non della formula, e con un’altra \(\varphi\) potrebbe salire. Il prezzo è che la formula dà la soluzione in un punto per volta: per averla in un’intera regione bisognerebbe ripetere il conto per ogni punto, e con molti punti si torna a pagare.
Una rete che impara tutte le medie insieme#
Il metodo di Kolmogorov profondo [BBG+21] fa imparare a una rete la soluzione su un’intera regione, cioè la funzione che a ogni punto \(\mathbf{x}\) associa \(u(\mathbf{x}, t)\), ancora con i cammini, e senza mai calcolare una media.
Si pesca un punto a caso nella regione, si fa partire da lì un camminatore solo, e si legge la temperatura iniziale dove arriva: la rete, che per quel punto deve rispondere con un numero, viene punita con il quadrato della differenza. Un camminatore solo è una risposta rumorosissima: stesso punto, camminatore diverso, numero diverso. La rete però non impara un punto alla volta: risponde con una curva liscia, e quello che sente in un punto lo sente anche nei punti vicini. Così, da tanti punti vicini, ognuno con il suo camminatore, raccoglie l’effetto di tanti camminatori diversi; e siccome la punizione è il quadrato, la risposta che le conviene dare è la media di tutti i numeri che quel punto potrebbe ricevere, come nella sezione su da dove viene la perdita quadratica. E quella media è proprio la temperatura cercata.
Così la rete impara la temperatura in tutti i punti insieme, anche in dieci dimensioni, e dopo l’addestramento risponde in un attimo in punti che nessun camminatore ha mai visitato. Il limite è la regione. Fuori da dove si sono pescati i punti la rete non ha imparato niente. L’errore diventa quello della rete, cioè quanto bene sa disegnare la temperatura e quanto bene l’addestramento la trova, e il rumore dei camminatori entra solo negli strattoni che la spingono a ogni passo. E il metodo copre le stesse sbarre dei camminatori, non di più: dove il calore prodotto dipende dalla temperatura in un modo che non è una proporzione fissa, una media da cui partire non c’è, e la rete non ne ha una da imparare.
Sia \(\boldsymbol{\xi}\) uniforme su una regione \(D \subset \mathbb{R}^d\) e \(Y = \varphi\big(\boldsymbol{\xi} + \sqrt{2\alpha t}\,\mathbf{Z}\big)\) con \(\mathbf{Z}\) gaussiana standard indipendente. Il problema
ha per soluzione, in \(L^2\) rispetto alla legge di \(\boldsymbol{\xi}\), la media condizionata \(\mathbb{E}[Y \mid \boldsymbol{\xi}] = u(\boldsymbol{\xi}, t)\): è il risultato della teoria statistica della decisione applicato a un bersaglio che è un solo campione del cammino. Beck, Becker, Grohs, Jaafari e Jentzen parametrizzano \(f\) con una rete, stimano il rischio con minibatch di coppie \((\boldsymbol{\xi}, Y)\) sempre nuove e lo minimizzano con la discesa del gradiente stocastica [BBG+21]; sull’equazione del calore in cento dimensioni riportano un errore relativo \(L^1\) dello \(0{,}08\%\) dopo 750 000 passi. La varianza di \(Y\) attorno a \(u\) entra solo come rumore del gradiente; l’errore finale è quello di approssimazione e di ottimizzazione della rete, più quello di generalizzazione, che qui ha una forma particolare, perché ogni passo vede esempi nuovi invece di tornare su un campione fisso. La garanzia vale su \(D\) e non fuori, e il metodo copre le stesse equazioni lineari della formula su cui poggia.
Un esperimento addestra una rete piccola sull’equazione del calore in dieci dimensioni, con \(\varphi(\mathbf{x}) = \|\mathbf{x}\|^2\) e i punti pescati nel cubo \([-1, 1]^{10}\) (ogni coordinata fra \(-1\) e \(1\)), e la confronta con la soluzione esatta su diecimila punti nuovi. Come per ogni addestramento, i numeri esatti cambiano un poco da una macchina all’altra, e il codice stampa i confronti che non ne dipendono.
import torch
from torch import nn

torch.manual_seed(0)
d, alfa, t = 10, 0.25, 1.0
phi = lambda y: (y ** 2).sum(dim=1, keepdim=True)                # la temperatura iniziale
esatta = lambda x: (x ** 2).sum(dim=1, keepdim=True) + 2 * alfa * t * d

rete = nn.Sequential(nn.Linear(d, 64), nn.SiLU(), nn.Linear(64, 64), nn.SiLU(),
                     nn.Linear(64, 1))
ottimizzatore = torch.optim.Adam(rete.parameters(), lr=1e-2)
riduci = torch.optim.lr_scheduler.StepLR(ottimizzatore, step_size=1000, gamma=0.3)
for passo in range(4000):
    X = 2 * torch.rand(1024, d) - 1                              # punti nuovi nel cubo
    Y = phi(X + (2 * alfa * t) ** 0.5 * torch.randn(1024, d))    # un cammino solo per punto
    perdita = (rete(X) - Y).pow(2).mean()
    ottimizzatore.zero_grad()
    perdita.backward()
    ottimizzatore.step()
    riduci.step()

X = 2 * torch.rand(10_000, d) - 1                                # punti mai visti
with torch.no_grad():
    u, previsto = esatta(X), rete(X)
    errore_rete = ((previsto - u).pow(2).mean() / u.pow(2).mean()).sqrt().item()
    Y = phi(X + (2 * alfa * t) ** 0.5 * torch.randn(10_000, d))
    errore_cammino = ((Y - u).pow(2).mean() / u.pow(2).mean()).sqrt().item()
    errore_phi = ((phi(X) - u).pow(2).mean() / u.pow(2).mean()).sqrt().item()
print("errore relativo della rete sotto il 3%:", errore_rete < 0.03)
print("un cammino solo sbaglia più di dieci volte tanto:", errore_cammino > 10 * errore_rete)
print("la temperatura iniziale, presa per soluzione, sbaglia più di dieci volte tanto:",
      errore_phi > 10 * errore_rete)
errore relativo della rete sotto il 3%: True
un cammino solo sbaglia più di dieci volte tanto: True
la temperatura iniziale, presa per soluzione, sbaglia più di dieci volte tanto: True
Su diecimila punti che nessun cammino ha mai visitato la rete sbaglia di meno del tre per cento, mentre un cammino solo, preso come risposta, sbaglia più di dieci volte tanto, e lo stesso fa la temperatura iniziale scambiata per la soluzione. La rete ha imparato la media, e non i campioni rumorosi da cui l’ha ricavata.
Punti sempre nuovi: il Galerkin profondo#
La lettura dal lato dei cammini vale per le equazioni che diffondono. Per le altre resta il residuo, e anche lì la dimensione ha un rimedio parziale.
La PINN del capitolo controlla l’equazione in un insieme di punti scelto una volta, all’inizio, e poi sempre quello, come un esame con le stesse domande a ogni appello; il rimedio già incontrato nella legge dentro la loss, sorteggiare punti nuovi a ogni giro, è il cuore di un metodo uscito qualche mese prima delle PINN. Il metodo di Galerkin profondo fa la stessa verifica pescando punti nuovi a ogni passo dell’addestramento: la rete non può imparare a rispondere bene solo nei punti dell’esame, perché l’esame cambia ogni volta. È lo stesso trucco della rete che impara la media. Il prezzo resta: controllare la regola vuol dire misurare quanto la curva si piega in ogni direzione, e le direzioni sono tante quante le dimensioni, per questo il rimedio è solo parziale.
Il Deep Galerkin Method di Sirignano e Spiliopoulos [SS18] (preprint dell’agosto 2017, tre mesi prima di quelli sulle PINN) minimizza la stessa somma di residuo quadratico dell’equazione e di scarti sulle condizioni iniziali e al bordo, ma valutata su punti estratti di nuovo a ogni passo da una distribuzione sul dominio: una stima stocastica del funzionale integrale, e non una somma su un insieme fisso (la PINN di Raissi, Perdikaris e Karniadakis [RPK19] usa invece un insieme fisso di punti di collocazione, generato una volta con un campionamento a ipercubo latino). Gli autori lo provano su problemi fino a 200 dimensioni, fra cui le opzioni americane con frontiera libera. Il nome viene dal metodo di Galerkin, che proietta l’equazione su uno spazio di funzioni. Qui lo spazio è quello delle reti, e il metodo non ha maglia. Il residuo va calcolato con le derivate seconde della rete, che in dimensione \(d\) costano \(d\) passaggi all’indietro in più per il laplaciano, e gli autori usano un’approssimazione Monte Carlo delle derivate seconde nei problemi ad alta dimensione.
Le due letture non si escludono. Dove l’equazione diffonde, la formula dei cammini dà una stima del valore in un punto, con un errore che si sa stimare, ed è anche il metro con cui giudicare una rete dove la soluzione vera non la conosce nessuno; dove non diffonde, resta il residuo, e una rete che lo controlla in punti sempre nuovi.
Da ricordare
L’equazione del calore ha una seconda lettura: la temperatura in un punto dopo un certo tempo è la media della temperatura iniziale nei punti in cui arrivano camminatori casuali partiti da lì.
La media si stima con tanti camminatori, come un sondaggio, e l’errore scende come uno diviso la radice di quanti sono, in qualunque dimensione: in mille dimensioni diecimila camminatori sbagliano di un millesimo, dove una griglia avrebbe un uno seguito da mille zeri di nodi. Il sondaggio dà però la temperatura in un punto solo, e se i passi non sono tutti uguali va fatto a passi piccoli.
Una rete impara la temperatura in tutta una regione ascoltando un camminatore solo per punto: punita col quadrato, la risposta che le conviene è la media.
La ricetta vale per le equazioni che diffondono; per le altre si controlla quanto la rete viola l’equazione, e controllarlo in punti sempre nuovi aiuta quando le dimensioni sono tante.
Da ricordare
Feynman-Kac: per \(\partial_t u = \alpha\Delta u\) vale \(u(\mathbf{x}, t) = \mathbb{E}[\varphi(\mathbf{x} + \sqrt{2\alpha t}\,\mathbf{Z})]\), per il lemma di Itô applicato a \(u(\mathbf{x} + \sqrt{2\alpha}\,\mathbf{W}_s, t - s)\); con un potenziale \(V\) compare il peso \(\exp(-\int_0^t V)\) di Kac.
Il Monte Carlo sbaglia come \(\sigma/\sqrt{N}\): la dimensione entra in \(\sigma\) e nel costo di ogni cammino, lineare in \(d\), non all’esponente; con Eulero-Maruyama, per una SDE generica, il costo per una tolleranza \(\varepsilon\) è \(O(d\,\varepsilon^{-3})\). Per i metodi con una rete l’errore ha anche una parte di approssimazione e di ottimizzazione, e su quella la dimensione può rientrare.
Metodo di Kolmogorov profondo: il minimo di \(\mathbb{E}[(f(\boldsymbol{\xi}) - \varphi(\boldsymbol{\xi} + \sqrt{2\alpha t}\,\mathbf{Z}))^2]\) è la media condizionata, cioè \(u(\cdot, t)\) su \(D\).
La rappresentazione vale per equazioni lineari; le semilineari passano per le BSDE (deep BSDE), le altre per il residuo, e il Deep Galerkin lo stima su punti ricampionati a ogni passo.
La sbarra del capitolo lascia due cose: la seconda lettura del calore, quella dei camminatori, e un modo di battere la dimensione che non passa per una griglia. È la stessa idea che torna nei limiti e nelle applicazioni di dove la fisica aiuta: scegliere, fra le forme in cui si può scrivere lo stesso problema, quella in cui il calcolatore paga di meno.