


GEMM: la moltiplicazione di matrici sull’hardware#
Prendi l’addestramento di una rete neurale qualunque e mettici sopra un profiler: uno strumento che cronometra il programma pezzo per pezzo e dice quanto tempo se ne va in ciascuno. Guarda poi dove il tempo è finito. In cima alla lista trovi quasi sempre la stessa voce: la moltiplicazione fra due matrici.
Quell’operazione, nelle librerie di calcolo, porta da decenni una sigla: GEMM, GEneral Matrix Multiply. La sigla viene dalle BLAS, le librerie che dal 1979 fissano i nomi delle operazioni di algebra lineare (quelle fra matrici arrivano nel 1990), e il «generale» non riguarda l’operazione ma la matrice: dice che le due tabelle sono qualunque. Altre sigle sono riservate ai casi speciali, dove si risparmia: su una matrice triangolare (nulla da una parte della diagonale) i conti si dimezzano, su una simmetrica si dimezza quello che si legge, su una a banda (diversa da zero solo vicino alla diagonale) si risparmia molto di più. È uno dei kernel più ottimizzati che esistano: a ogni generazione di schede i produttori lo riscrivono per sfruttarla fino in fondo.
E la ragione c’è. La sezione sulle prestazioni ha descritto i conti di una rete neurale come quasi soltanto moltiplicazioni fra matrici, ed è così: nelle reti fatte di strati densi, come i perceptron multistrato e i Transformer, e nelle convoluzioni (le operazioni delle reti per le immagini), che le librerie spesso riconducono a prodotti fra matrici, quasi tutte le operazioni sono di quel tipo. Per il tempo il conto è diverso: in un passo di addestramento di BERT, un modello linguistico del 2018, i prodotti fra matrici facevano il 99,8% delle operazioni ma il 61% del tempo, perché le operazioni con pochi conti per byte costano molto più di quanto pesino nel conteggio [IDBN+21]. E la sezione sulla memoria ha lasciato in sospeso una promessa, mostrare per esteso il trucco con cui la moltiplicazione fra matrici si rende veloce, il tiling: è il momento di mantenerla.
Il conto, e il problema della versione ingenua#
Moltiplicare due matrici vuol dire riempire una tabella di risultati, e ogni casella del risultato è una somma di prodotti: si prende una riga della prima tabella e una colonna della seconda, le si moltiplica numero per numero e si somma il tutto. In simboli, \(\mathbf{C} = \mathbf{A}\,\mathbf{B}\), con \(\mathbf{A}\) di forma \((M, K)\) (cioè con \(M\) righe e \(K\) colonne) e \(\mathbf{B}\) di forma \((K, N)\), dà una matrice \(\mathbf{C}\) di forma \((M, N)\). I conti da fare si contano: una moltiplicazione e una somma per ogni casella del risultato e per ogni passo lungo il lato in comune, e per due tabelle da mille caselle di lato fanno due miliardi di operazioni. Il problema della versione ingenua, come spesso su una GPU, sta meno nei conti da fare che nei byte da muovere per farli.
Una riga per una colonna, moltiplica e somma: facile. Ma immagina di farlo davvero una casella alla volta, andando ogni volta a ripescare la riga e la colonna dal magazzino lontano, cioè dalla memoria globale della scheda. Due caselle vicine sulla stessa riga usano la stessa riga della prima tabella: eppure, alla cieca, vai a riprenderla da capo per ognuna. È come cucinare cento piatti identici correndo in dispensa a prendere gli stessi ingredienti cento volte.
Attenzione a non fraintendere: i conti da fare sono tantissimi, ed è proprio per questo che qui se ne va il tempo di un addestramento. Il punto è che i conti fatti per ogni viaggio in dispensa sono pochissimi, e la sezione sulla memoria ha stabilito che è quel rapporto, e non il totale, a decidere se un calcolo va veloce: quanti conti si fanno per ogni byte che ci si è fatti portare. Fatta una casella alla volta, senza riusare niente, la moltiplicazione fra matrici finisce in fondo a quella classifica, lontanissima dal settecento che il riuso perfetto prometteva: consuma tutti i byte al secondo che la memoria riesce a consegnare, e tiene le unità di calcolo per lo più ferme. E ingrandire le tabelle non le cambia posto in classifica: raddoppia i lati, e conti e viaggi crescono insieme, nella stessa misura, mentre il rapporto fra i due resta quello di prima.
Un aiuto arriva soltanto per caso. Fra la dispensa e le cucine c’è un cassetto in comune fra tutte le squadre, dove resta per un po’ quello che è appena passato di lì (i tecnici lo chiamano cache L2), e ogni tanto la riga che ti serve è ancora lì: te la ritrovi a due passi invece che in fondo al corridoio. Qualche viaggio lo risparmi davvero, e le cose vanno un po’ meglio di così. Ma qui è un colpo di fortuna, che nessuno ha organizzato: il tiling farà di meglio, perché quel risparmio se lo prende per iscritto invece di sperarlo.
Il prodotto costa circa \(2 M N K\) operazioni in virgola mobile: per ognuno
degli \(M \times N\) elementi di \(\mathbf{C}\), una somma di \(K\) prodotti, cioè \(K\)
moltiplicazioni e \(K\) addizioni. La versione ingenua assegna un thread a ogni
elemento di uscita e legge dalla memoria globale, per calcolare
\(C_{ij} = \sum_{k} A_{ik} B_{kj}\), un’intera riga di \(\mathbf{A}\) (\(K\) valori)
e un’intera colonna di \(\mathbf{B}\) (\(K\) valori). Sommando su tutte le uscite sono
\(2 M N K\) letture di elementi, a fronte di \(2 M N K\) FLOP: in float32
(4 byte per elemento) l’intensità aritmetica vale
indipendente dalla taglia delle matrici. Il conto assume il modello più crudo: ogni lettura emessa viene servita dalla HBM, senza cache di mezzo. Nella realtà la L1, la L2 e il broadcast dentro il warp recuperano una parte del riuso, e il kernel ingenuo fa un po’ meglio di \(\tfrac14\); ma è un riuso sperato, affidato alla cache, mentre il tiling che segue lo rende garantito dal programma. Sul roofline della sezione sulla memoria è comunque un punto incollato in basso a sinistra: profondamente memory-bound. La radice dello spreco è la ri-lettura: la stessa riga di \(\mathbf{A}\) torna dalla HBM per ognuna delle \(N\) colonne di \(\mathbf{C}\), la stessa colonna di \(\mathbf{B}\) per ognuna delle \(M\) righe. Si spostano montagne di byte per rileggere all’infinito gli stessi numeri.
Tiling: il prodotto a tessere#
La cura è quella già anticipata nella sezione sulla gerarchia della memoria: caricare una volta, riusare in tanti. Invece di calcolare \(\mathbf{C}\) una casella alla volta, la si spezza in tessere (i tile); per ogni tessera si portano i blocchi corrispondenti di \(\mathbf{A}\) e di \(\mathbf{B}\) nella shared memory una sola volta, e da lì si riusano per tutti i prodotti della tessera (Fig. 8.10).

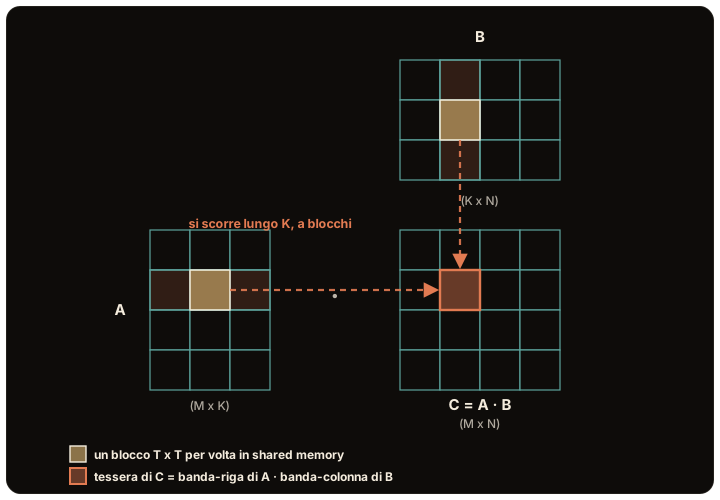
Fig. 8.10 Il tiling del GEMM: una tessera del risultato nasce dalla striscia di righe che ha a sinistra per la striscia di colonne che ha sopra. Le strisce si scorrono a blocchi; ogni blocco, portato una volta in shared memory, vicino alle unità di calcolo (in ocra), serve tutti i prodotti della tessera prima di essere scartato.#
Cento piatti identici, e la dispensa in fondo al corridoio. Chi va a prendere gli ingredienti per ogni piatto passa la giornata nel corridoio; chi carica una cassetta all’inizio e cucina con quella l’infornata intera paga il viaggio una volta sola. La cassetta, qui, è un blocchetto della prima tabella e uno della seconda, portati sul ripiano accanto ai fornelli (la shared memory) e tenuti lì finché non hanno servito tutti i prodotti della tessera che la squadra sta calcolando. Ogni numero arriva una volta e viene riusato molte volte prima di essere buttato.
Più grande la cassetta, più lavoro si fa con ogni viaggio: i numeri portati crescono come il lato della tessera al quadrato, i conti che se ne ricavano come il lato al cubo, quindi a ogni raddoppio del lato ogni numero lavora il doppio. Con una tessera da 32 caselle di lato ogni viaggio porta \(2\,048\) numeri, due blocchetti da 32 per 32, e da quei numeri escono \(32\,768\) moltiplicazioni con altrettante somme, cioè \(65\,536\) conti: 32 per ogni numero portato. Siccome un numero pesa quattro byte, sono otto conti per ogni byte che ci si è fatti portare. Non basta: il pareggio fra dispensa e cuochi, quello stabilito nella sezione sulla memoria, sta a dieci, e i cuochi restano un po’ fermi ad aspettare. Qualche casella in più colma il divario: con 41 caselle di lato si arriva al pareggio, e una cassetta da 144 arriva a 36 conti per byte, tre volte e mezzo il pareggio.
Solo che la soglia non sta ferma. Le unità costruite apposta per moltiplicare tabelloni lavorano con numeri corti, che pesano due byte invece di quattro: ogni byte porta allora il doppio dei conti, ma il pareggio da tenere sale oltre il centocinquanta. A due byte per numero, la cassetta da 32 fa 16 conti per byte, quella da 128 dei programmi veri 64, e nemmeno la più grande immaginabile, 256 di lato, ci arriva: si ferma a 128. A fermarla non è il ripiano: i risultati parziali della tessera, uno per casella, restano in mano ai cuochi per tutto il lavoro, e le mani sono poche. E quei risultati crescono in fretta, perché la tessera è un quadrato: per fare il doppio dei conti su ogni byte il lato raddoppia, e le caselle da tenere in mano diventano quattro volte tante.
Come mai, allora, le moltiplicazioni vere volano? Perché in fondo al corridoio ci si va molto meno di quanto la cassetta, da sola, farebbe pensare. Le squadre che lavorano fianco a fianco hanno bisogno delle stesse cassette, e chi organizza il lavoro le fa partire apposta insieme: la prima che ordina una cassetta la lascia nel cassetto comune, e le altre la trovano lì, a due passi. Stavolta il cassetto non aiuta per caso, perché il lavoro è disposto in modo da riempirlo con la roba giusta. I due risparmi si sommano: la cassetta sul ripiano decide quanta roba la squadra chiede fuori dalla cucina, il cassetto comune quanta di quella deve arrivare davvero dalla dispensa. Su una moltiplicazione grande, da ottomila caselle di lato, la differenza è tutta qui. Se ogni cassetta arrivasse dalla dispensa, si passerebbe due volte e mezzo più tempo a trasportare che a cucinare; se il cassetto bastasse a servire tutto, il trasporto scenderebbe sotto un decimo della cottura. Il secondo conto è il meglio che si possa sperare, perché nel cassetto le due tabelle intere non ci stanno, e il vero sta in mezzo: se il trasporto resta più corto della cottura comandano i cuochi, se no la dispensa. Le moltiplicazioni grandi delle librerie vere stanno dalla parte dei cuochi, ed è per questo che volano.
Dentro la cassetta grande i programmi veri ne infilano una seconda, piccola. Ogni cuoco prende dal ripiano sedici numeri, otto di una tabella e otto dell’altra, e da quegli otto per otto ricava sessantaquattro prodotti senza tornare al ripiano nemmeno una volta. Quei sedici numeri non risparmiano un solo viaggio in dispensa, perché quelli li decide la cassetta grande. Servono contro una coda diversa: al ripiano ci vanno tutte le mani della squadra, e se ognuna ci torna per ogni singolo prodotto si fa la fila. Un cuoco da solo, però, non ha abbastanza mani per tenere i risultati che servirebbero ad accorciarla quanto basta. Allora i cuochi della squadra lavorano per plotoni, quelli che ricevono l’ordine tutti insieme: il plotone va al ripiano una volta per tutti, si spartisce quello che ha preso, e ciascuno tiene in mano la sua parte dei risultati, che messi insieme coprono un pezzo di tessera molto più grande di quello che un cuoco reggerebbe da solo. Stessa mossa, scala diversa.
Spezziamo \(\mathbf{C}\) in tessere \(T \times T\). Per calcolare una tessera si scorre la dimensione \(K\) a blocchi: a ogni passo si caricano una volta un blocco \(T \times T\) di \(\mathbf{A}\) e uno di \(\mathbf{B}\) nella shared memory, e si accumulano nella tessera i \(T^3\) prodotti che quei due blocchi generano, distribuiti sui \(T^2\) accumulatori, prima di passare al blocco \(K\) successivo. Ogni valore caricato entra in \(T\) moltiplicazioni invece che in una: il fattore di riuso (la grandezza già incontrata nella sezione sulla memoria) è \(T\). Le letture dalla HBM scendono da \(2 M N K\) a circa \(2 M N K / T\) elementi, e siccome ogni moltiplicazione consuma due valori caricati, uno per tabella, l’intensità aritmetica sale da \(\tfrac14\) a
Con \(T = 32\) sono \(8\) FLOP/byte: trentadue volte l’intensità della versione ingenua, e sul roofline la tessera scivola di parecchio verso destra.
Il confronto, però, va portato fino in fondo, perché la conclusione non è
quella che ci si aspetta: otto FLOP/byte non bastano ancora. Il ginocchio del
roofline sta a \(\approx 10\) con i CUDA core in float32 e a \(\approx 161\) con
i tensor core in float16 su A100. I due numeri vanno confrontati a parità di
formato: la stessa tessera in float16 fa 16, non 8, e resta a sinistra anche
di quello. Da sola è ancora memory-bound. Il primo ginocchio il tiling lo
supera da sé: basta \(T \ge 41\). Il secondo no: in float16 (dove \(I \approx
T/2\)) servirebbe \(T \ge 323\). E il limite non viene dalla shared memory. Con
una tessera rettangolare \(B_M \times B_N\) di \(\mathbf{C}\) e un passo \(B_K\)
lungo \(K\), a ogni passo entrano \((B_M + B_N)\,B_K\) elementi e si fanno
\(2B_MB_NB_K\) FLOP, quindi \(I = 2B_MB_N / \big((B_M+B_N)\,s\big)\), con \(s\) byte
per elemento: \(B_K\) si semplifica, e lo si tiene piccolo (32 o 64) perché la
tessera in shared costi pochi KB. Quello che non si semplifica sono gli
accumulatori, \(B_MB_N\) valori in float32 che restano nei registri del blocco
per tutto il ciclo su \(K\): con \(T = 323\) sarebbero oltre 400 KB, contro un
register file da 256 KB per SM. Anche dedicandogli l’intero register file, cosa
che nessun kernel può fare, la tessera \(256 \times 256\) darebbe \(I = 128\);
quella \(128 \times 128\) dei GEMM industriali si ferma a 64. Nessuna tessera
arriva a 161.
La domanda diventa allora che cosa salvi davvero quei GEMM, dato che sono
veloci. La risposta sta un piano più giù ed è la cache L2. Il modello usato
finora (ogni lettura che esce dall’SM arriva fino alla HBM) è lo stesso modello
crudo del kernel ingenuo, e sbaglia allo stesso modo: le tessere di
\(\mathbf{A}\) e di \(\mathbf{B}\) che blocchi diversi si portano in shared memory
sono le stesse, e a servirle è la L2 senza disturbare la memoria. Il conto,
su un GEMM \(8192 \times 8192 \times 8192\) in float16 con tessere \(128 \times
128\): nel modello crudo dalla HBM escono \(2MNK/T\) elementi, cioè circa 17 GB,
che a \(1{,}935\) TB/s valgono \(8{,}9\) ms contro i \(3{,}5\) ms di calcolo dei
tensor core. All’altro estremo, se dalla HBM \(\mathbf{A}\) e \(\mathbf{B}\)
uscissero una volta sola e \(\mathbf{C}\) ci rientrasse una volta sola, sarebbero
circa 400 MB e \(0{,}21\) ms. Quel secondo numero è un pavimento e non una
misura: perché le due matrici escano una volta sola dovrebbero stare tutte
on-chip, e in float16 sono 128 MiB l’una contro i 40 MB di L2 di una A100. Il
traffico vero sta fra i due estremi, ed è la posizione che conta: finché dalla
HBM escono più dei circa 7 GB che in quei \(3{,}5\) ms la banda fa in tempo a
portare, il kernel è bloccato dalla memoria; sotto quella soglia comandano i
tensor core. Le librerie lavorano per starci sotto, e non lo affidano al caso:
lanciano i blocchi in un ordine scelto perché quelli eseguiti insieme si
ripassino le stesse tessere nella L2 (il raggruppamento del tutorial di Triton
sul prodotto fra matrici, la threadblock rasterization di CUTLASS). La guida
di NVIDIA sulle prestazioni del GEMM classifica proprio il caso \(8192^3\) fra
quelli limitati dal calcolo, avvertendo che il confronto fra intensità e
ginocchio è una regola pratica.
A che cosa serve, allora, il secondo livello di tessere nei registri che le
implementazioni industriali del GEMM impilano sotto il primo? Non a spostare il
punto sul roofline della HBM: lì il traffico lo decide soltanto la tessera in
shared memory, e la micro-tessera nei registri non ne cambia un byte. Serve a
un problema diverso e altrettanto reale, un piano più su: la banda della shared
memory. Ogni SM la serve con 32 banchi da 4 byte per colpo di clock, cioè 128
byte per ciclo, che sui 108 SM di una A100, a \(1{,}41\) GHz, fanno circa 19 TB/s
aggregati (la stessa cifra che il paper di FlashAttention attribuisce alla SRAM
on-chip). Per alimentare 312 TFLOP/s di tensor core servono dunque 16 FLOP per
ogni byte letto dalla shared, e un thread che vada a prendersi i due operandi
di ogni singolo prodotto ne fa \(0{,}5\): due FLOP ogni quattro byte in
float16. Con una micro-tessera \(R \times R\) tenuta nei registri, invece, ogni
thread legge \(2R\) valori e ne ricava \(R^2\) prodotti, cioè \(R/2\) FLOP per byte.
Per arrivare a 16 servirebbe però \(R = 32\), cioè 1024 accumulatori a testa,
quattro volte il tetto di 255 registri per thread. Il riuso che basta si
ottiene un gradino più su, sul warp: con i tensor core il frammento \(W \times
W\) di \(\mathbf{C}\) sta nei registri dei 32 thread insieme (\(W^2/32\)
accumulatori a testa), a ogni passo il warp legge dalla shared \(2W\) valori e ne
ricava \(W^2\) prodotti, e l’intensità torna \(W/2\): la tessera di warp \(64 \times
64\) tipica dei GEMM su Ampere dà 32 FLOP per byte con 128 accumulatori per
thread. È la stessa aritmetica del tiling, con la shared al posto della HBM e i
registri al posto della shared: il riuso si ricompra un piano più giù, ed è
possibile per la ragione vista nella sezione sulla memoria, che il register
file di un SM è il banco on-chip più capiente che ci sia.
Il fatto generale, più della gerarchia in sé, è questo: c’è un roofline per
ogni livello della piramide, ciascuno con la sua banda e il suo ginocchio, e
ogni livello di tiling esiste per superare il proprio. Quanto al tetto, l’\(n/6\)
del roofline (dove \(n\) è il lato di due matrici quadrate) è un ideale che
richiederebbe \(\mathbf{A}\) e \(\mathbf{B}\) intere on-chip, e per fortuna non
serve raggiungerlo: l’intensità realmente raggiungibile non cresce con \(n\), ma
con la radice della memoria veloce disponibile. È il risultato classico di Hong
e Kung sulla complessità di I/O [HK81], che dà
\(\Omega(n^3/\sqrt{M_\text{chip}})\) trasferimenti e quindi \(I =
O(\sqrt{M_\text{chip}})\), dove \(M_\text{chip}\) è la memoria veloce disponibile
(da non confondere con le \(M\) righe di \(\mathbf{A}\)). Il risultato vale per
l’algoritmo che esegue tutti gli \(n^3\) prodotti (non per quelli alla Strassen,
che ne eseguono meno) e per una memoria veloce di \(M_\text{chip}\) elementi
davanti a una lenta illimitata, ed è raggiungibile: tenendo in memoria veloce
tre tessere \(T \times T\), una per matrice, con \(T \approx
\sqrt{M_\text{chip}/3}\), i trasferimenti sono \(2n^3/T = O(n^3 /
\sqrt{M_\text{chip}})\). I livelli di tessere dei GEMM veri hanno i nomi della
documentazione di CUTLASS: la threadblock tile (per esempio \(128 \times
128\)), la warp tile (\(64 \times 64\)) e, in fondo, la forma dell’istruzione
mma dei tensor core (\(16 \times 8 \times 16\) su Ampere in float16).
La struttura del tiling si scrive per esteso, senza GPU, in puro NumPy. Il
codice non è veloce, e non deve esserlo, perché i prodotti veri li fa già NumPy
meglio di così: serve a rendere visibile il nido di cicli. Con tre cicli uno
dentro l’altro, si scorre il risultato a tessere e per ogni tessera si sommano
i contributi dei blocchi lungo \(K\). Ogni a e b è un blocco «caricato in
shared memory»; a @ b è il lavoro che lo riusa, e alla fine il risultato
coincide con la moltiplicazione diretta A @ B.
import numpy as np

def matmul_a_blocchi(A, B, T=32):
    """Moltiplica A (M,K) per B (K,N) lavorando a tessere T×T.
    Stesso risultato di A @ B, ma esplicita il riuso: ogni blocco di A
    e di B, caricato una volta, serve tutti i prodotti della tessera."""
    M, K = A.shape
    _, N = B.shape
    C = np.zeros((M, N))
    for i in range(0, M, T):              # scorre le tessere di righe di C
        for j in range(0, N, T):          # scorre le tessere di colonne di C
            acc = np.zeros((min(T, M - i), min(T, N - j)))
            for k in range(0, K, T):      # somma sui blocchi lungo K
                a = A[i:i+T, k:k+T]       # blocco di A -> "shared memory"
                b = B[k:k+T, j:j+T]       # blocco di B -> "shared memory"
                acc += a @ b              # riuso: un blocco, molti prodotti
            C[i:i+T, j:j+T] = acc
    return C

A = np.random.randn(96, 80)
B = np.random.randn(80, 64)
print(np.allclose(matmul_a_blocchi(A, B), A @ B))
True
Il triplo ciclo su tessere è lo scheletro di base di una moltiplicazione fra matrici veloce, dalla CPU alla GPU: le librerie serie ne impilano cinque o sei, e prima di usare un blocco lo ricopiano in un’area contigua, perché si legga in fila (l’impacchettamento). Quello che cambia da una macchina all’altra sono solo due cose: chi esegue i conti di una tessera (su una GPU, i thread di uno stesso blocco) e dove la tessera viene tenuta mentre la si usa (la shared memory del blocco). La logica è questa.
I tensor core: un intero prodotto in un colpo#
Il tiling risolve il problema dei byte. Resta quello dei conti: anche saturando la banda, ogni moltiplicazione la deve pur fare qualcuno. Dal 2017 quel qualcuno non è più il generico CUDA core, ma un’unità costruita apposta per il prodotto tra matrici: il tensor core.
Un ragioniere compila a mano una tabellina di quattro righe per quattro colonne. Cella per cella è un lavoro noioso: sono sedici celle, e ognuna è una somma di quattro prodotti, quindi in tutto sessantaquattro moltiplicazioni. Poi gli arriva un timbro speciale, che riempie la tabellina intera in un colpo solo: lo appoggia, preme, fatto. E non cancella quello che c’era: somma, così che tabellina dopo tabellina il totale cresca. Il tensor core è quel timbro. Là dove una postazione di calcolo normale fa una moltiplicazione per ogni battito del metronomo del chip (il clock dell’inizio del capitolo, che batte più di un miliardo di volte al secondo), il tensor core ne fa sessantaquattro.
Il guadagno sull’intera scheda però non è di sessantaquattro volte, ed è un conto che si fa in testa. Sulla scheda che li ha introdotti i timbri erano uno ogni otto postazioni normali: otto postazioni fanno otto conti a battito, il timbro che sta al loro posto ne fa sessantaquattro, cioè otto volte tanto. Sulle schede di oggi il rapporto è salito a quindici o sedici, perché i timbri sono diventati più grandi e a ogni battito ne stampano di più.
C’è poi un secondo gesto, e spiega perché il timbro possa correre tanto. Per fare le moltiplicazioni lavora con numeri «arrotondati», scritti con la metà dello spazio (quelli della mezza precisione incontrata nella sezione «Prestazioni e scala»: due byte invece di quattro, meno cifre e più velocità di lettura); il totale che va accumulando, però, lo tiene nel formato lungo, per non perdere per strada le cifre che contano. È il gesto di chi pesa gli ingredienti a occhio, perché tanto un grammo non cambia il piatto, ma il conto della spesa lo tiene all’ultimo centesimo, perché lì gli errori si sommano.
Un timbro così veloce, però, sposta il problema invece di chiuderlo. La dispensa consegna alla velocità di sempre, e chi timbra quindici volte più in fretta pretende quindici volte più conti da ogni cassetta che gli arriva. Più il timbro corre, più conta portare sul tavolo poca roba e spremerla fino in fondo: cassetta e timbro lavorano insieme, e nessuno dei due basta da solo. Il timbro, poi, non lo prende in mano chi scrive il programma: lo appoggiano da sé le librerie che PyTorch chiama ogni volta che una rete gira, a patto che i numeri siano quelli corti.
Introdotti con l’architettura Volta (la GPU V100, 2017), i tensor core calcolano in un solo colpo di clock un piccolo prodotto-matrice con accumulo, della forma
su tessere \(4 \times 4\), cioè 64 moltiplicazioni-accumulo per colpo di clock
per unità (l’operazione è esposta al programmatore, a livello di warp, su
tessere \(16 \times 16\)). Qui \(\mathbf{C}\) non è il risultato del prodotto, che
è \(\mathbf{D}\): è il valore già accumulato a cui il prodotto si somma, ed è la
convenzione con cui NVIDIA espone l’istruzione. Le forme sono quelle di Volta:
le generazioni successive ne usano di più grandi, e da Hopper l’unità che
emette l’istruzione non è più il singolo warp ma un gruppo di quattro. Il cuore
è la precisione mista [MNA+18]: gli ingressi \(\mathbf{A}\)
e \(\mathbf{B}\) sono a 16 bit (float16 sulla V100; le architetture successive,
da Ampere in poi, aggiungono anche bfloat16), mentre l’accumulo di
\(\mathbf{C}\) e \(\mathbf{D}\) può restare a float32: è la modalità
dell’addestramento in precisione mista, così la somma di molti prodotti non
degrada (il silicio offre anche l’accumulo a 16 bit, usato talvolta in
inferenza). È, non a caso, la forma «generale» del GEMM delle BLAS cablata nel
silicio: l’operazione è \(\mathbf{C} \leftarrow \alpha \mathbf{A}\mathbf{B} +
\beta \mathbf{C}\), dove \(\alpha\) e \(\beta\) sono due numeri che pesano il
prodotto nuovo e il valore già accumulato (moltiplica e accumula). Il
guadagno è di circa un ordine di grandezza sul throughput di matmul rispetto ai
CUDA core normali (un fattore 8 sulla V100, 16 sull’A100, 15 sulla H100): è
l’innalzamento di \(P_\text{picco}\) che, come notava il roofline, sposta il
ginocchio verso destra e rende la banda ancora più decisiva. Tutti i picchi
citati sono densi. Le schede tecniche NVIDIA mettono in evidenza anche il
valore con sparsità strutturata 2:4, doppio (624 TFLOP/s in float16 su A100,
1979 su H100 SXM), che vale solo per matrici con due valori nulli in ogni
gruppo di quattro: usato per calcolare il ginocchio, lo raddoppierebbe. Non li
programmi tu direttamente: cuBLAS e cuDNN li usano dietro le quinte ogni volta
che una nn.Linear o una convoluzione girano su una GPU recente in mezza
precisione. Da Ampere c’è anche una terza via, il tf32: ingressi float32
troncati a 10 bit di mantissa e accumulo a 32 bit, che su una A100 dà 156
TFLOP/s contro i 19,5 dei CUDA core, e quindi un ginocchio intermedio a circa
81 FLOP/byte. In PyTorch il tf32 è acceso per default nelle convoluzioni di
cuDNN e spento nelle moltiplicazioni fra matrici, dove lo accende
torch.set_float32_matmul_precision("high").
L’altra strada: far scorrere i dati invece dei conti#
Il tiling e i tensor core sono la risposta della GPU a una domanda che si può affrontare anche in un modo completamente diverso. La domanda è sempre quella: come si moltiplicano due matrici muovendo il meno possibile.
Un capannone con i banchi disposti a scacchiera, e su ogni banco un numero solo, consegnato prima che il turno cominci: sono i numeri di una delle due tabelle, uno per banco, e lì resteranno fermi fino alla fine. In una GPU sono i dati a stare fermi in memoria e i calcolatori ad andarseli a prendere, e il tiling accorcia quei viaggi senza toglierli. Qui è il contrario.
Da sinistra entra in ogni fila un carrello con i numeri dell’altra tabella, e scorre lungo la fila da un capo all’altro. Dall’alto scende, di banco in banco, un foglio con un totale ancora incompleto. Ogni postazione sa fare un gesto solo: prende il numero che le passa davanti, lo moltiplica per il proprio, aggiunge il risultato al foglio che sta scendendo e passa il foglio al banco sotto. In fondo alla colonna il foglio esce compilato, ed è una casella del risultato.
Che cosa resti fermo sul banco è una scelta di chi progetta, e cambia la macchina che ne esce. In un altro capannone a restare fermo è il totale che si va accumulando, e a passargli davanti sono i numeri di tutt’e due le tabelle. Ha avuto più fortuna il primo, quello con il numero fermo sul banco, ed è quello che hanno adottato gli acceleratori più noti, cioè i chip costruiti per fare una cosa sola invece di tutte.
Il guadagno sta tutto in quel passaggio da un vicino all’altro. Un numero prelevato una volta sola dal magazzino attraversa un’intera fila di banchi e li serve tutti, senza che nessuno debba andare a ripescarlo, e il totale si costruisce camminando lungo la colonna come un pezzo su una catena di montaggio. Una macchina fatta così si chiama array sistolico, dove array è la schiera dei banchi; chi la inventò, alla Carnegie Mellon alla fine degli anni Settanta, prese il resto del nome dal cuore, perché i dati attraversano la scacchiera a ondate regolari come il sangue spinto dalla sistole.
Capannoni del genere si costruiscono davvero, ed è così che sono fatti i chip pensati apposta per l’intelligenza artificiale: la TPU di Google (Tensor Processing Unit, l’unità che macina tensori) ha una scacchiera di 256 banchi per 256. Il guadagno più grosso si legge sul contatore della luce, perché mandare un numero da un capo all’altro del chip vuol dire caricare e scaricare un filo lungo millimetri, e quello costa più corrente che moltiplicare; qui invece i numeri camminano da un banco al vicino.
C’è una riserva da mettere subito, però, prima di paragonarlo a una GPU: il capannone che ha reso famosa l’idea, quello da 256 banchi per lato, lavorava con numeri interi corti e serviva soltanto a far rispondere un modello già addestrato, non a costruirlo. Le generazioni venute dopo addestrano anche; confrontare quel primo capannone con una scheda che addestra resta un confronto fra due mestieri.
Il prezzo, poi, è la rigidità, e si vede appena il lavoro cambia. Se la tabella da moltiplicare è più piccola della scacchiera, molti banchi passano il turno a moltiplicare zeri. E se quello che c’è da fare non è una moltiplicazione fra tabelle, il capannone non serve, e bisogna uscirne per farlo altrove. Una GPU, su quel terreno, è più lenta del capannone, ma sa fare tutto il resto. È la stessa scelta che separava la lepre dal formicaio, spostata di un livello: qui la lepre, attrezzata per ogni imprevisto, è la GPU, e il formicaio che sa fare una cosa sola è il capannone.
Un array sistolico [Kun82] è una griglia di elementi di elaborazione identici, ciascuno collegato soltanto ai vicini immediati e capace di una sola operazione: moltiplicare due ingressi, sommare il prodotto a un valore che gli arriva, e propagare ai vicini al ciclo successivo. Non c’è memoria condivisa, non c’è arbitraggio, non c’è un file di registri da indirizzare: il movimento dei dati è cablato nella topologia. Che cosa stia fermo e che cosa scorra, però, è la scelta di dataflow, e cambia la macchina. I nomi con cui queste scelte si chiamano oggi vengono dalla tassonomia di Chen, Emer e Sze [CES16], non dagli array sistolici originali; per le convoluzioni i tre ne propongono un’altra, la row stationary, che la sezione sulle reti convoluzionali racconta accanto all’algoritmo di Winograd.
Nella variante output stationary è il totale a restare nell’elemento (un accumulatore interno) mentre entrambi gli operandi scorrono. Nella variante weight stationary, che è quella adottata dagli acceleratori più noti, l’elemento non tiene un totale: tiene un peso, precaricato e fermo. Le attivazioni entrano da sinistra e attraversano le righe; le somme parziali scendono di riga in riga raccogliendo un prodotto per volta, e i totali completi escono in fondo all’array, in una memoria di accumulatori posta sotto di esso. In entrambi i casi ogni valore letto una volta dalla memoria esterna viene riusato lungo tutta una dimensione dell’array, e il riuso non è ottenuto da una cache che spera di essere colpita, ma dalla geometria.
La prima TPU di Google [JYP+17] è la realizzazione più nota del secondo schema: un array \(256 \times 256\), cioè \(65\,536\) moltiplicazioni-accumulo per ciclo di clock in una sola unità (le generazioni dalla seconda alla quinta usano più unità \(128 \times 128\), e dalla sesta si torna a \(256 \times 256\)), con i pesi precaricati dall’alto, i dati che entrano da sinistra e 4 MiB di accumulatori a 32 bit sotto la matrice, che raccolgono una somma parziale da 256 elementi per ciclo. Quell’unità, però, moltiplica interi a 8 bit e serve solo per l’inferenza, quindi il confronto con una GPU che addestra in mezza precisione non è alla pari. Il confronto non è comunque «chi calcola di più» ma «chi si muove di meno», ed è per questo che gli acceleratori dedicati guadagnano soprattutto in energia per operazione, che è poi la voce di spesa della sezione sul conto in energia.
Il prezzo della specializzazione è la rigidità. Un array sistolico è bravo esattamente a una cosa. Se la matrice è più piccola dell’array, gran parte degli elementi calcola zeri; se l’operazione non è un GEMM (una convoluzione sparsa, un gather irregolare, un’operazione elemento per elemento), la struttura non serve e bisogna uscire dall’array. La GPU, con la sua gerarchia di memoria programmabile e i suoi CUDA core generici, perde in efficienza di picco e guadagna in tutto il resto: è la stessa tensione fra specializzazione e generalità che oppone una GPU a una CPU, spostata di un livello.
In pratica: forme «tonde» e mezza precisione#
Quasi certamente non scriverai mai a mano una moltiplicazione fra matrici: esistono librerie che la fanno meglio di quanto convenga scrivere da sé, sfruttando tessere a più livelli e tensor core in modi che cambiano a ogni generazione di schede. Sono le stesse che PyTorch chiama ogni volta che una rete gira (cuBLAS per le matrici, cuDNN per le convoluzioni, fornite da NVIDIA), a cui si aggiungono due strumenti che quel codice lo generano invece di offrirlo già pronto: CUTLASS, la raccolta di modelli in C++ di NVIDIA con cui si compongono i propri GEMM, e Triton [TKC19].
Perché allora capire il tiling? Perché spiega due regole pratiche che spostano davvero il cronometro, e che altrimenti sembrerebbero magia:
Dai alle matrici forme «tonde», cioè misure che siano multipli di numeri come 8, 16 o 64 invece di misure qualsiasi. Se le dimensioni sono multiple della tessera (e dei blocchetti che i tensor core elaborano) le tessere si riempiono senza avanzi, e nessun thread resta a lavorare su un bordo incompleto. È il motivo per cui conviene portare al multiplo di 8 successivo (per eccesso: per difetto si buttano via delle righe) la dimensione nascosta di un modello (quanti numeri usa per rappresentare al proprio interno una parola o un’immagine) o la taglia del vocabolario (quante parole diverse conosce): un guadagno spesso gratuito. Una forma «storta» lascia i tensor core mezzi vuoti.
Usa la mezza precisione (
float16obfloat16, 16 bit per numero invece di 32). I byte da spostare si dimezzano, e i tensor core raggiungono il loro picco con i formati a 16 bit e con altri ancora più corti, come FP8; con ifloat32, per default, PyTorch fa le moltiplicazioni fra matrici sulle unità normali, a un sedicesimo di quel picco su una A100. Il gestore di contestotorch.autocast, visto nella sezione sulle prestazioni, è l’interruttore che manda le moltiplicazioni sui tensor core, ed è utile su qualunque scheda recente, non solo su quelle da datacenter.
Tutte e due queste regole promettono un guadagno quasi gratuito, e tutte e due capita che non lo diano. Le ragioni sono due, e nessuna delle due riguarda la tessera, che è la cosa a cui si dà la colpa.
Succede di arrotondare le misure e di non vedere cambiare niente, e la prima ragione è che non conta solo quante caselle ha una riga: conta da che punto della memoria la riga comincia. Torniamo al furgone della sezione sulla memoria, quello che consegna solo pacchi già ordinati per via: le consegne piene partono solo dall’inizio di una via, mai da metà. Una tabella con le misure giuste, ma il cui primo numero si trova a metà via, costringe a spezzare ogni consegna in due, e la strada veloce si chiude lo stesso. Capita più spesso di quanto si creda: per esempio quando si lavora su un ritaglio di una tabella più grande invece che sulla tabella intera.
La seconda ragione non riguarda le tessere né le misure della tabella: riguarda quante officine restano ferme all’ultimo giro, cioè quante ne restano inutilizzate quando il lavoro non si divide in parti uguali (le officine sono gli Streaming Multiprocessor, le unità in cui la GPU è divisa: su una A100 sono 108). Il lavoro si distribuisce a giri: una tessera a testa, e quando hanno finito un’altra a testa. Se le tessere da calcolare sono, poniamo, centodieci, le prime cento vanno in un giro pieno e le dieci rimaste ne occupano un secondo tutto per loro, con novanta officine a guardare. Due giri per fare poco più del lavoro di uno: il tempo quasi raddoppia. È il motivo per cui certe misure «tonde» vanno peggio di misure vicine, e chi non conosce questo secondo effetto dà la colpa alla tessera, che non c’entra.
La prima precisazione: il requisito vero non è sulle dimensioni logiche ma sull’allineamento in byte (multipli di 16 byte sulla dimensione principale), quindi una matrice con \(M\), \(N\) e \(K\) multipli di 8 ma con un passo di riga storto (lo stride, cioè la distanza in memoria fra l’inizio di una riga e l’inizio della successiva, che in una vista o in una fetta non coincide con la larghezza) esce comunque dalla strada veloce.
La seconda: esiste una quantizzazione gemella che non dipende dalla tessera ma dal numero di SM, la wave quantization. Se il numero di tessere da calcolare supera di poco un multiplo degli SM disponibili (108 su A100), l’ultimo giro impegna pochissimi SM e tutti gli altri restano fermi: il tempo raddoppia quasi. È per questo che certe taglie di batch «tonde» vanno peggio di taglie vicine, e chi non conosce questo secondo effetto lo attribuisce alla tessera, che non c’entra.
Il tiling, insomma, avvicina i due limiti che il roofline della sezione sulla memoria metteva uno di fronte all’altro: riusa quel che ha già in shared memory, e così taglia i byte da spostare. Da solo, però, non basta a tenere occupati i tensor core: lo completano il riuso fra blocchi nella cache L2 e quello nei registri. La stessa idea, cioè riorganizzare un calcolo per non tornare mai a rileggere dalla memoria lontana ciò che si può tenere vicino, applicata ai confronti fra le parole di un testo dà la FlashAttention [DFE+22]. La moltiplicazione fra matrici è il primo, e più puro, esempio di una lezione che tornerà a ogni pagina.
Da ricordare
Quasi tutti i conti di una rete neurale sono moltiplicazioni fra tabelle di numeri, anche se non quasi tutto il tempo: le operazioni con pochi conti per numero pesano più di quanto contino. Quell’operazione ha un nome che si incontra ovunque, GEMM, e a ogni generazione di schede i produttori la riscrivono per sfruttarla fino in fondo.
Farla nel modo ovvio, una casella del risultato alla volta, vuol dire correre in dispensa a riprendere gli stessi ingredienti centinaia di volte. I conti che si fanno a ogni viaggio sono pochi, i viaggi tantissimi: si finisce bloccati dal magazzino.
La cura è il tiling: portare sul tavolo di lavoro un blocchetto di ciascuna tabella e usarlo per tutti i prodotti che può servire prima di buttarlo. Un viaggio invece di cento. Più grande il blocchetto, meglio è, ma le mani che tengono i conti a metà sono poche. I programmi veri lo fanno allora due volte, a due scale: blocchetti grandi sul tavolo, che tagliano i viaggi in dispensa, e blocchetti piccolissimi in mano a ciascun lavoratore, che di viaggi non ne tolgono nemmeno uno ma sciolgono la fila al tavolo.
Il tiling da solo, però, non basta: supera il pareggio dei calcolatori ordinari, ma a quello molto più alto che pretendono le unità costruite per moltiplicare tabelloni non arriva nessuna tessera, perché i risultati parziali restano in mano ai cuochi e le mani sono poche. A far volare le moltiplicazioni vere è il cassetto comune fra le squadre (la cache L2): chi organizza il lavoro fa partire insieme le squadre che chiedono le stesse cassette, e la cassetta che una ordina la ritrovano lì tutte le altre.
I tensor core sono il timbro che stampa un pezzo intero di tabellina in un colpo solo, sessantaquattro moltiplicazioni per battito, con i numeri arrotondati ma il totale tenuto preciso. È il pezzo di silicio più veloce di una GPU, e si accende dicendo a PyTorch di usare la mezza precisione.
Ci si può muovere anche dall’altro capo: invece di andare a prendere i dati, si può far scorrere i dati fra postazioni vicine, come su una catena di montaggio, dove il totale scende lungo la colonna raccogliendo un pezzo per postazione. Si chiama array sistolico [Kun82] ed è la scelta della TPU di Google [JYP+17]: bravissima a fare questa cosa, inadatta a tutto il resto. La riserva da tenere accanto al confronto: il primo di quei capannoni lavorava con numeri interi corti e serviva a far rispondere un modello già addestrato, non a costruirlo.
Le due regole pratiche che restano, e che valgono anche per chi non scriverà mai un programma per GPU: dare alle tabelle misure tonde (multipli di 8 o 16) e usare la mezza precisione, i numeri scritti nella metà dello spazio. Sono guadagni quasi sempre gratuiti, e quando non arrivano la colpa non è della tessera: o la tabella comincia nel punto sbagliato della memoria, o l’ultimo giro di lavoro lascia quasi tutte le officine a guardare.
Da ricordare
GEMM (GEneral Matrix Multiply) concentra quasi tutti i FLOP di una rete, non tutto il tempo (in un passo di addestramento di BERT il 99,8% dei FLOP e il 61% del tempo [IDBN+21]): il prodotto \(\mathbf{C} = \mathbf{A}\mathbf{B}\) con \(\mathbf{A}\) di forma \((M,K)\) e \(\mathbf{B}\) di forma \((K,N)\) costa circa \(2 M N K\) FLOP.
La versione ingenua rilegge dalla HBM le stesse righe e colonne all’infinito: nel modello senza cache l’intensità aritmetica resta ferma a \(\tfrac14\) FLOP/byte, indipendente dalla taglia (nella realtà la L1, la L2 e il broadcast dentro il warp recuperano qualcosa, ma è riuso sperato, non garantito dal programma). Il kernel resta, in ogni caso, profondamente memory-bound.
Il tiling spezza \(\mathbf{C}\) in tessere e carica i blocchi di \(\mathbf{A}\) e \(\mathbf{B}\) in shared memory una volta sola, riusandoli: con tessere \(T \times T\) l’intensità sale a circa \(T/4\) FLOP/byte. Con \(T = 32\) fa 8 in
float32e 16 infloat16(dove \(I \approx T/2\)). Il primo ginocchio, 10 con i CUDA core, il tiling lo supera da sé; il secondo, 161 con i tensor core su A100, no: con tessere \(B_M \times B_N\) l’intensità è \(2B_MB_N/((B_M+B_N)s)\), e a limitarla sono gli accumulatori in registro (256 KB per SM), non la shared: \(256 \times 256\) darebbe 128, la \(128 \times 128\) dei GEMM industriali dà 64. A tenere i GEMM veri lontani dal muro della HBM è la cache L2, che serve le tessere che i blocchi si ripassano, e le librerie ordinano il lancio dei blocchi apposta (su un GEMM \(8192^3\) infloat16il traffico crudo è 17 GB, cioè \(8{,}9\) ms contro \(3{,}5\) ms di calcolo; il pavimento del riuso perfetto è 400 MB, cioè \(0{,}21\) ms, e il traffico vero sta in mezzo). Il secondo livello di tessere, quello nei registri, risolve un problema diverso: alimentare i tensor core dalla shared memory vuole 16 FLOP per byte letto, e un thread che vada a prendersi i due operandi di ogni prodotto ne fa mezzo. C’è un roofline per ogni livello della piramide, e ogni tiling supera il proprio. L’\(n/6\) è un tetto ideale; il raggiungibile cresce come \(\sqrt{M_\text{chip}}\), non come \(n\), per l’algoritmo che esegue tutti gli \(n^3\) prodotti [HK81].I tensor core (dal 2017, Volta) eseguono un piccolo prodotto-matrice con accumulo \(\mathbf{D} = \mathbf{A}\mathbf{B} + \mathbf{C}\) per colpo di clock (64 FMA per unità, su tessere \(4\times4\) nella forma Volta), in precisione mista [MNA+18] (ingressi 16 bit, accumulo 32 bit): circa un ordine di grandezza di throughput in più, a picchi densi (le schede tecniche mostrano anche il doppio, con sparsità 2:4).
cuBLAS/cuDNNli usano da soli.L’array sistolico [Kun82] risolve lo stesso problema dall’altro capo: invece di andare a prendere i dati, li fa scorrere fra unità adiacenti, e il riuso è nella geometria invece che in una cache. La TPU [JYP+17] usa la variante weight stationary: pesi precaricati e fermi, attivazioni da sinistra, somme parziali che scendono verso gli accumulatori sotto l’array. Massima efficienza sul GEMM, rigidità su tutto il resto; e la riserva sul confronto, perché quell’array moltiplica interi a 8 bit e serve la sola inferenza.
Raramente scriverai un GEMM a mano, ma capire il tiling spiega perché le forme «tonde» (allineamento a 16 byte, più che multipli logici di 8/16) e la mezza precisione vanno più veloci; e perché esiste una wave quantization legata al numero di SM, che le forme tonde non curano.
Riuso in shared memory + tensor core: la stessa ricetta tornerà, applicata all’attenzione, in FlashAttention [DFE+22].