


Il percettrone e la sua regola di apprendimento#
Nel 1958 uno psicologo di Cornell, Frank Rosenblatt, presenta alla stampa il percettrone [Ros58], un modello di neurone artificiale che impara a riconoscere forme dagli esempi. Il New York Times riporta l’attesa della Marina: è l’embrione di un computer elettronico che un giorno saprà camminare, parlare, vedere, scrivere, riprodursi e avere coscienza di sé. Due anni dopo l’idea prende corpo in una macchina grande come un armadio, il Mark I Perceptron. Davanti c’è una griglia di quattrocento fotocellule, che è l’occhio. Le manopole, però, non stanno lì: le fotocellule sono collegate a caso, con fili fissi, a un banco di cinquecentododici scatolette intermedie, ognuna delle quali guarda un pugno di fotocellule e dà il suo verdetto, e regolabili sono le manopole che pesano quei verdetti. Girarne una vuol dire cambiare quanto conta il verdetto di una scatoletta, non di un singolo puntino di luce. A girarle, ogni volta che la macchina sbaglia, è un motorino: l’apprendimento, lì, era fatto di ferro. Il clamore era smisurato, e lo pagheremo caro. Ma sotto c’è un’idea sobria e duratura, che ancora oggi è il mattone di ogni rete neurale: un neurone artificiale non è altro che un pezzo di aritmetica.
Un neurone fatto di aritmetica#
Un neurone biologico riceve segnali da altri neuroni, li combina e «scarica» un impulso se lo stimolo complessivo supera una soglia. Rosenblatt cattura questa idea con tre gesti: pesare gli ingressi, sommarli, decidere.
Ogni ingresso arriva con un peso che ne misura l’importanza: il primo ingresso lo chiamiamo \(x_1\) e il suo peso \(w_1\), il secondo \(x_2\) e \(w_2\), e avanti così, con \(x_i\) e \(w_i\) per uno qualunque di loro. Il neurone li combina in una somma pesata e vi aggiunge un termine costante, il bias \(b\), che sposta la soglia: quanto il neurone pende verso il sì prima ancora di guardare gli ingressi. Poi il totale passa a un ultimo gesto, che decide sì o no, e quel gesto si chiama funzione di attivazione (Fig. 6.3).

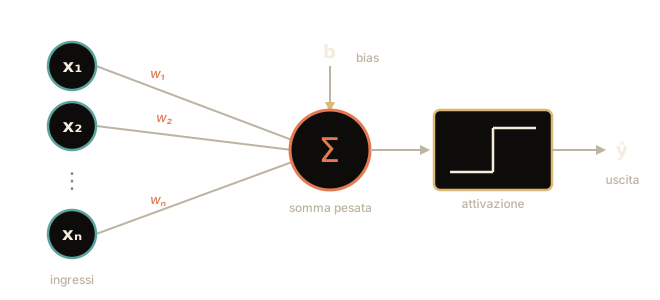
Fig. 6.3 Il neurone artificiale: ogni ingresso ha il suo peso, il sommatore (la lettera greca \(\Sigma\), che in matematica vuol dire «somma tutto») mette insieme i contributi e aggiunge il bias \(b\), la funzione di attivazione decide l’uscita.#
Stai per uscire di casa e devi decidere se prendere l’ombrello. Guardi due indizi: quanto è nuvoloso e cosa dice l’app del meteo. Dai a ciascun indizio un peso (l’app conta più del colore del cielo) e fai una somma: indizio per il suo peso, il tutto sommato. Il bias è la tua indole di partenza: un pessimista parte già orientato verso il «sì, prendilo». Se il totale arriva a una soglia, esci con l’ombrello.
Con due ingressi la somma è semplicemente
Proviamo con i numeri. Nuvolosità \(x_1 = 7\) (su una scala da 0 a 10) con peso \(w_1 = 0{,}3\); l’app che dice pioggia \(x_2 = 1\) con peso \(w_2 = 2\) (ti fidi molto dell’app); indole pessimista \(b = 0{,}5\). Totale: \(z = 0{,}3 \cdot 7 + 2 \cdot 1 + 0{,}5 = 4{,}6\). Se la tua soglia è «esco con l’ombrello sopra il 3», oggi l’ombrello lo prendi.
Raccogliamo gli ingressi in un vettore \(\mathbf{x}\in\mathbb{R}^n\) e i pesi in \(\mathbf{w}\in\mathbb{R}^n\). La somma pesata è un prodotto scalare più il bias:
È la stessa operazione della sezione di algebra lineare: \(z\) è grande e positivo quando \(\mathbf{x}\) «punta nella direzione» di \(\mathbf{w}\). Il luogo dei punti in cui \(z = 0\), cioè \(\mathbf{w}^\top\mathbf{x} + b = 0\), è un iperpiano: la frontiera che il neurone traccia per separare lo spazio degli ingressi in due regioni.
La funzione a gradino: decidere sì o no#
La somma pesata \(z\) è un numero qualsiasi. Per trasformarla in una decisione serve un ultimo passo, la funzione di attivazione. Nel percettrone classico è la più netta possibile: la funzione a gradino (detta anche di Heaviside, dal nome del fisico inglese che la mise in uso), e la Fig. 6.4 ne mostra il grafico per intero.
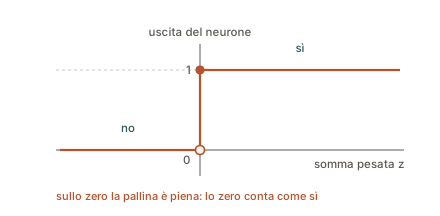
Fig. 6.4 Il gradino da cui la funzione prende il nome. La somma pesata può valere qualunque numero, la risposta soltanto \(0\) o \(1\), e il passaggio dall’una all’altra avviene tutto in un punto. La pallina piena dice dove finisce lo zero: la soglia lo zero lo raggiunge, quindi la risposta lì è sì.#
Un interruttore non conosce le mezze misure. Se la somma raggiunge la soglia l’uscita è \(1\) («sì»), altrimenti è \(0\) («no»): sommati gli indizi, o esci con l’ombrello o non lo prendi.
Le manopole da girare sembrano di tre tipi (i pesi, il bias, la soglia), e sono di due. Chiedere che il totale superi \(3\) è la stessa identica cosa che togliere \(3\) dal totale e chiedere che superi lo zero. La soglia si nasconde dentro il bias, e da lì in avanti resta sempre lo zero: a spostare il punto in cui il neurone cambia idea è il bias.
Sui numeri dell’ombrello: il bias era \(0{,}5\) e la soglia \(3\), quindi il bias nuovo è \(0{,}5 - 3 = -2{,}5\), e la regola diventa «esci con l’ombrello se \(0{,}3 \cdot x_1 + 2 \cdot x_2 - 2{,}5\) è sopra lo zero». La giornata di prima non cambia: \(0{,}3 \cdot 7 + 2 \cdot 1 - 2{,}5 = 1{,}6\), sopra zero, e l’ombrello lo prendi come prima.
Adesso un foglio a quadretti, con la nuvolosità in orizzontale e l’app in verticale. Ogni giornata diventa un puntino, e anche l’app diventa un numero: \(x_2 = 1\) se dice pioggia, \(x_2 = 0\) se dice sereno. Segna le giornate in bilico, quelle in cui il totale fa esattamente zero. Sono due conti di seconda media.
Con l’app che dice sereno resta \(0{,}3 \cdot x_1 - 2{,}5 = 0\), quindi \(0{,}3 \cdot x_1 = 2{,}5\) e la nuvolosità in bilico è \(x_1 = 2{,}5 : 0{,}3 = 8{,}33\ldots\), in pratica \(8{,}3\): ci vuole quasi tutto il cielo grigio. Con l’app che dice pioggia il suo contributo è \(2 \cdot 1 = 2\), resta \(0{,}3 \cdot x_1 + 2 - 2{,}5 = 0\), quindi \(0{,}3 \cdot x_1 = 0{,}5\) e la nuvolosità in bilico è \(x_1 = 0{,}5 : 0{,}3 = 1{,}66\ldots\), in pratica \(1{,}7\): se l’app promette pioggia basta molto meno.
Un punto a \(8{,}3\) in basso, un punto a \(1{,}7\) in alto. Per due punti una riga passa sempre, quindi ne serve un terzo per controllare. Un’app più sfumata, che dica «metà pioggia», \(x_2 = 0{,}5\), contribuisce \(2 \cdot 0{,}5 = 1\), resta \(0{,}3 \cdot x_1 + 1 - 2{,}5 = 0\), e la nuvolosità in bilico è \(x_1 = 1{,}5 : 0{,}3 = 5\): a metà altezza e proprio a metà fra \(8{,}3\) e \(1{,}7\), cioè sulla riga che unisce gli altri due. Da una parte di quella riga il neurone risponde sempre sì, dall’altra sempre no, e una terza possibilità non c’è. Quella riga è tutto ciò che un neurone sa disegnare: cambiare i pesi la inclina, cambiare il bias la sposta avanti e indietro, ma resta dritta.
L’uscita del neurone è \(\hat{y} = g(z)\), con \(g\) la funzione a gradino:
Lo zero sta con l’uno, ed è una convenzione: la funzione di Heaviside in zero
si definisce anche \(1/2\). Qui vale \(1\), come in np.where(z >= 0, 1, 0) del
codice, e la scelta ha un effetto che si vede subito: con i pesi e il bias a
zero il neurone risponde \(1\) a ogni ingresso, ed è da quel sì indiscriminato
che partono le correzioni. Due proprietà di \(g\) contano più della
convenzione. La prima: la decisione è binaria, \(\hat{y}\in\{0,1\}\). La seconda,
che si paga cara più avanti: \(g'(z)=0\) per ogni \(z\neq 0\) e in \(0\) la derivata
non esiste, quindi un metodo che corregga i pesi seguendo la pendenza qui
moltiplica per zero e non si muove.
Il neurone assegna la classe \(1\) ai punti da un lato dell’iperpiano \(\mathbf{w}^\top\mathbf{x}+b=0\) e la classe \(0\) a quelli dall’altro. È un classificatore lineare: sposta il bias \(b\) e trasli la frontiera; ruota \(\mathbf{w}\) e la inclini.
Imparare dagli errori: la regola del percettrone#
Fin qui il neurone sa calcolare, ma non ancora imparare: chi sceglie i pesi? L’intuizione di Rosenblatt è di lasciarli trovare alla macchina, un esempio alla volta. Le si mostra un input di cui conosciamo la risposta giusta \(y\); se sbaglia, si correggono i pesi nella direzione che riduce l’errore.

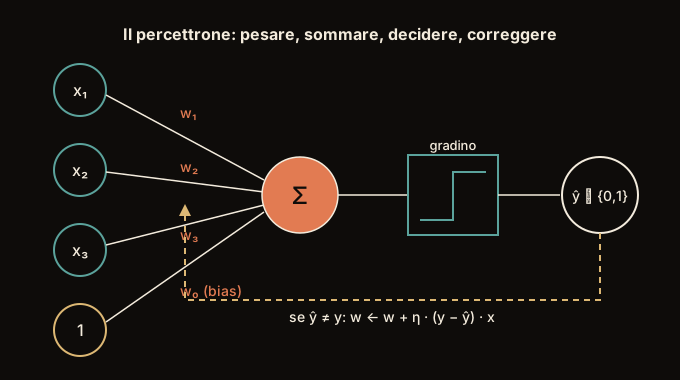
Fig. 6.5 Lo stesso neurone, con la freccia di ritorno: è quella a fare la differenza fra un circuito che calcola e un modello che impara. Un dettaglio del disegno, per chi lo nota: il bias qui non è tenuto da parte come nella figura precedente, ma è disegnato come un ingresso in più che vale sempre \(1\), con il suo peso \(w_0\). È la stessa cosa scritta in un altro modo, perché un peso moltiplicato per \(1\) dà il peso stesso, e quindi \(w_0\) fa esattamente il mestiere del bias. Comodo, perché così anche il bias si corregge con la regola degli altri pesi.#
La freccia di ritorno in Fig. 6.5 è, in miniatura, tutto ciò che si chiama addestramento. Cambierà la funzione al posto del gradino, cambierà il modo di calcolare la correzione, ma lo schema resta: si misura lo scarto dalla risposta attesa e lo si rimanda sui pesi.

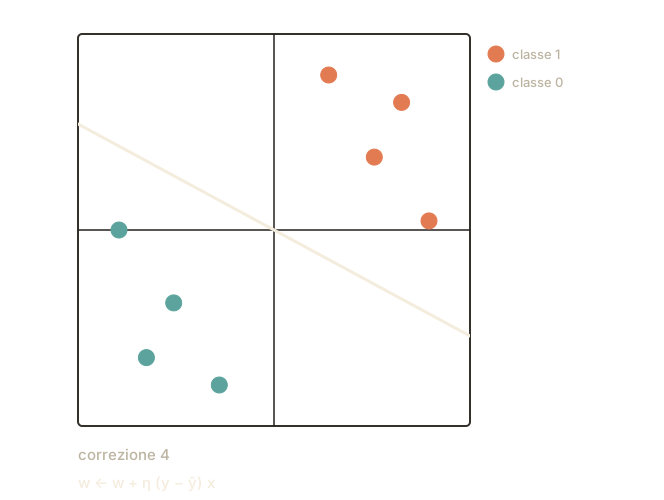
Fig. 6.6 La regola all’opera su otto esempi di cui conosciamo già la risposta giusta: quattro vogliono uscita \(1\) (i punti color terracotta, arancione di vaso) e quattro uscita \(0\) (i punti color teal, il verde-azzurro). Ciascuno dei due gruppi si chiama classe. La retta parte sbagliata e a ogni punto messo dal lato sbagliato ruota un po’. Dopo quattro correzioni le due classi sono separate, e da lì in poi nessun esempio provoca più un aggiornamento.#
Nella Fig. 6.6 si vede la proprietà che rese famoso l’algoritmo: quando una retta separatrice esiste, il percettrone la trova in un numero finito di correzioni. È il teorema di convergenza di Rosenblatt, dove convergere vuol dire che a un certo punto la ricerca si ferma, invece di andare avanti per sempre. Attenzione però a quel «quando esiste»: fra poco diventerà il problema principale.
Torni a casa la sera e sai com’è andata: è il momento di girare le manopole per il giorno dopo. Se stamattina il neurone ha azzeccato non tocchi nulla; se ha detto \(0\), cioè niente ombrello, e ti sei bagnato, alzi i pesi; se ha detto \(1\) e c’era il sole, li abbassi. Di quanto? Ogni manopola gira in proporzione a quanto valeva il suo indizio quella mattina: chi segnava molto si muove molto, chi segnava zero resta ferma. Si corregge chi ha parlato più forte.
Il giro si moltiplica poi per un numeretto che scegli tu, il passo di
apprendimento (in inglese learning rate, nel codice eta), e qui,
curiosamente, decide soltanto di quanto gira la manopola. Il vicino di casa
parte dalle stesse manopole a zero e le gira dieci volte più forte: si ritrova
pesi dieci volte più grandi, ma il neurone guarda soltanto se il totale sta
sopra o sotto lo zero, quel confine un fattore dieci non lo sposta, e tutte le
mattine il vicino esce di casa come te. Finché i conti sono esatti, almeno: il
calcolatore arrotonda, e ogni tanto l’ultima cifra cambia strada (il codice
della porta AND ne mostra un caso). Il passo diventerà una scelta che conta
davvero quando la correzione smetterà di essere fissa, nella sezione sulla backpropagation.
La prima sera, per esteso, con le manopole tutte a zero e il passo a \(0{,}1\).
Stamattina il cielo era quasi sereno, \(x_1 = 1\), e l’app diceva sereno,
\(x_2 = 0\). Il totale faceva zero, e lo zero la soglia la raggiunge, quindi il
neurone ha risposto \(1\): con le manopole a zero dice sì a qualunque giornata, ed
è la prima cosa che dovrà disimparare. Sei uscito con l’ombrello e c’era il
sole: doveva dire \(0\). La manopola della nuvolosità scende di
\(0{,}1 \cdot 1 = 0{,}1\), quella dell’app di \(0{,}1 \cdot 0 = 0\), perché l’app
valeva zero, non ha detto niente e non paga niente: adesso segnano \(-0{,}1\) e
\(0\). Scende di \(0{,}1\) anche il bias, da \(0\) a \(-0{,}1\): è una manopola
attaccata a un indizio che vale sempre \(1\), quindi parla tutte le mattine, e a
ogni correzione si sposta del passo intero, in su se la risposta era troppo
bassa e in giù se era troppo alta (nel codice, b += eta * errore).
Poi si ricomincia, e si ripassa più volte sulle stesse giornate: ogni giro
completo è un’epoca, le epoche del codice. Quante giornate sbagliate servono,
prima che le manopole si fermino? Torna al foglio a quadretti con i puntini. Se
fra il gruppo del sì e quello del no c’è un corridoio vuoto, prima o poi si
fermano, e a decidere quando è la sua larghezza. Giornate chiaramente da
ombrello o da occhiali da sole lasciano un corridoio comodo, e bastano poche
correzioni; due giornate quasi identiche che vogliono risposte opposte lo
assottigliano, e ogni volta che il corridoio si dimezza le correzioni che
possono servire diventano quattro volte tante.
Largo in proporzione al disegno, però, non in centimetri. Fotocopia il foglio al doppio: il corridoio raddoppia, ma raddoppiano anche le distanze dei puntini, e il rapporto resta quello. Resterebbe uguale anche il numero di correzioni, se il foglio non avesse un punto fermo, l’angolo da cui si misurano i due numeri di ogni giornata. L’\(1\) del bias non è una distanza sul foglio e la fotocopia non lo raddoppia, così le correzioni cambiano, e di solito crescono; restano le stesse soltanto se la riga passa per l’angolo, cioè senza bias. E mille giornate in più, purché cadano dentro lo spazio già occupato, non aggiungono una correzione a quelle che possono servire: conta soltanto quanto è largo il corridoio rispetto alla distanza del puntino più lontano dall’angolo.
La riga prudente, però, la macchina non la promette. Si ferma appena nessun puntino resta dalla parte sbagliata, e la riga può restare lì, appiccicata a un puntino: una giornata nuova appena diversa finirebbe dal lato sbagliato. Cercare la riga che passa in mezzo al corridoio, il più lontano possibile da tutti i puntini, è un altro mestiere, quello delle macchine a vettori di supporto.
Sia \(\eta > 0\) il tasso di apprendimento. Per ogni esempio \((\mathbf{x}, y)\) si calcola la predizione \(\hat{y}\) e si aggiornano pesi e bias:
Il fattore \((y-\hat{y})\) vale \(0\) quando la predizione è corretta (nessun
aggiornamento), \(+1\) o \(-1\) altrimenti. Qui \(\eta\) è cosmetico: partendo da
\(\mathbf{w}=\mathbf{0}\) e \(b=0\) ogni aggiornamento è proporzionale a \(\eta\),
quindi cambiarlo riscala \(\mathbf{w}\) e \(b\) dello stesso fattore, e la
decisione dipende solo dal segno di \(\mathbf{w}^\top\mathbf{x}+b\), che un
riscalamento positivo non tocca. Con \(\eta=1\) e \(\eta=7{,}3\) la porta AND esce
identica, con pesi \((2,\ 1)\) e bias \(-3\) in unità di \(\eta\). Il riscalamento
esatto vale però in aritmetica esatta, e con \(\eta=0{,}1\) si rompe proprio su
questo esempio: \(0{,}1\) in binario non è esatto, e a un certo passo il totale
sul caso \((1,0)\), che doveva valere zero e far scattare una correzione, esce
\(-2{,}8\cdot 10^{-17}\). Il neurone risponde \(0\), nessuno corregge, e la corsa
si ferma sulla retta \(2x_1 + x_2 - 2 = 0\), che passa esattamente per \((1,0)\):
separa solo grazie all’arrotondamento. Per questo il codice chiama addestra
con \(\eta = 1\), dove tutti i conti sono interi. Interi, non comodi: anche la
retta che ne esce, \(2x_1 + x_2 - 3 = 0\), passa esattamente per \((1,1)\), e a
metterlo dalla parte giusta è la convenzione \(g(0) = 1\). Il blocco della porta
AND prova anche gli altri due passi e lo XOR, e stampa pesi e bias in unità di
\(\eta\) e il totale sul caso \((1,0)\) a fine corsa. Diventerà una scelta vera
nella sezione sulla backpropagation, dove
la correzione non sarà più proporzionale all’errore ma al gradiente di una
loss.
C’è poi il teorema di convergenza del percettrone: se i dati sono linearmente separabili, l’algoritmo trova in un numero finito di passi un iperpiano che li separa. Rosenblatt lo dimostra in Principles of Neurodynamics (1962) [Ros62], non nell’articolo del 1958 che presenta il modello. Il teorema dice di più di quanto sembri, nella forma che si deve a Novikoff [Nov62]: il numero di correzioni, partendo da \(\mathbf{w}=\mathbf{0}\), è al più \((R/\gamma)^2\), dove \(R = \max_i \lVert\mathbf{x}_i\rVert\) è la norma massima degli esempi e \(\gamma\) il margine geometrico del miglior separatore, cioè la distanza dall’iperpiano al punto più vicino, che è metà del corridoio vuoto fra le due classi, misurata nello stesso spazio in cui si vive dopo aver assorbito il bias (\(\gamma = \min_i |\mathbf{w}^{*\top}\mathbf{x}_i|\) con \(\lVert\mathbf{w}^*\rVert = 1\): senza quel vincolo il rapporto non sarebbe nemmeno un numero puro, perché basterebbe raddoppiare \(\mathbf{w}^*\) per raddoppiare \(\gamma\)). Il limite vale per la versione senza bias, o con il bias assorbito come ingresso costante: è il trucco della Fig. 6.5, l’ingresso sempre pari a \(1\), e serviva proprio qui (assorbito il bias, quella coordinata in più entra anche in \(R\)). La dimostrazione sta in due disuguaglianze. Si scrivono le etichette come \(t_i = 2y_i - 1 \in \{-1,+1\}\): la \(k\)-esima correzione aggiunge \(\eta\,t_i\mathbf{x}_i\) su un esempio con \(t_i\,\mathbf{w}_{k-1}^\top\mathbf{x}_i \le 0\). Ogni correzione fa salire la proiezione su \(\mathbf{w}^*\) di almeno \(\eta\gamma\), perché \(t_i\,\mathbf{w}^{*\top}\mathbf{x}_i \ge \gamma\), quindi \(\mathbf{w}_k^\top\mathbf{w}^* \ge k\eta\gamma\); e fa crescere il quadrato della norma di al più \(\eta^2R^2\), perché il termine incrociato \(2\eta\,t_i\,\mathbf{w}_{k-1}^\top\mathbf{x}_i\) non è positivo, quindi \(\lVert\mathbf{w}_k\rVert^2 \le k\eta^2R^2\). Per Cauchy-Schwarz \(k\eta\gamma \le \mathbf{w}_k^\top\mathbf{w}^* \le \lVert\mathbf{w}_k\rVert \le \sqrt{k}\,\eta R\), da cui \(k \le (R/\gamma)^2\): \(\eta\) si semplifica, ed è un altro modo di vedere che qui è cosmetico. In quel limite non compaiono né il numero di esempi né la dimensione: quel che conta è il rapporto fra quanto sono lontani gli esempi e quanto è sottile il corridoio fra le due classi (la dimensione rientra dentro \(R\)), e raddoppiare il dataset non raddoppia il numero di correzioni. È lo stesso rapporto fra raggio e margine che decideva la garanzia della strada larga, qui al servizio di un’altra domanda: quante correzioni bastano. E non dice l’altra metà: l’iperpiano trovato è uno qualunque fra quelli che separano, senza alcuna garanzia di margine, che è esattamente la differenza con le Support Vector Machine. Il seme dell’apprendimento moderno è già qui, e si può dire con precisione: la regola è la discesa del gradiente stocastica, un esempio alla volta, sul criterio del percettrone \(\mathcal{L}(\mathbf{w}) = \sum_i \max\big(0,\,-t_i\,\mathbf{w}^\top\mathbf{x}_i\big)\), con \(t_i = 2y_i - 1\) e il bias assorbito. Sugli esempi classificati bene il termine è nullo e non spinge; su quelli sbagliati il suo gradiente è \(-t_i\mathbf{x}_i\), e un passo lungo \(\eta\) è esattamente la correzione di Rosenblatt. Sull’angolo, dove \(\mathbf{w}^\top\mathbf{x}_i = 0\), la regola sceglie un sottogradiente, quello che vuole la convenzione \(g(0) = 1\): \(-t_i\mathbf{x}_i\) se l’etichetta è \(-1\), zero se è \(+1\). È ciò che fa partire la corsa da \(\mathbf{w} = \mathbf{0}\), dove il criterio vale già zero, il suo minimo: la loss ha una soluzione banale, e il separatore lo trova la dinamica, non il minimo. Il margine della hinge, \(\max\big(0,\,1 - t_i\,\mathbf{w}^\top\mathbf{x}_i\big)\), toglie proprio quella soluzione. È una loss lineare a tratti, con un angolo dove il gradino salta: la discesa del gradiente su loss derivabili ovunque verrà dopo.
Tradotta in NumPy (la libreria di calcolo della sezione che porta il suo nome), la ricetta è quasi identica a come l’abbiamo raccontata:
import numpy as np

def gradino(z):
    return np.where(z >= 0, 1, 0)          # decisione binaria 0/1

def addestra(X, y, eta=0.1, epoche=10):
    w = np.zeros(X.shape[1])               # pesi iniziali a zero
    b = 0.0
    for _ in range(epoche):
        for xi, target in zip(X, y):
            # la chiocciola @ è la somma pesata: w1*x1 + w2*x2 + ...
            pred = gradino(w @ xi + b)
            errore = target - pred
            w += eta * errore * xi          # aggiorna i pesi
            b += eta * errore               # aggiorna il bias
    return w, b

# La porta logica AND (vale 1 solo se entrambi gli ingressi valgono 1):
# i suoi quattro casi si separano con una retta
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
y_and = np.array([0, 0, 0, 1])
w, b = addestra(X, y_and, eta=1.0)   # con 1 i conti sono interi, quindi esatti
print(gradino(X @ w + b))                   # ha imparato la AND

# altri due passi: pesi e bias in unità di eta, e il totale sul caso (1,0)
for eta in (7.3, 0.1):
    w_e, b_e = addestra(X, y_and, eta=eta)
    print(f"eta {eta}: pesi {w_e / eta}, bias {b_e / eta:.1f},",
          f"totale su (1,0) {w_e @ X[2] + b_e:.1e}")

# lo XOR: nessuna retta lo separa, e la regola gira in tondo
y_xor = np.array([0, 1, 1, 0])
for epoche in (10, 100):
    w_x, b_x = addestra(X, y_xor, epoche=epoche)
    print(f"XOR, {epoche} epoche: pesi {w_x}, bias {b_x:.1f},",
          f"uscita {gradino(X @ w_x + b_x)}")
[0 0 0 1]
eta 7.3: pesi [2. 1.], bias -3.0, totale su (1,0) -7.3e+00
eta 0.1: pesi [2. 1.], bias -2.0, totale su (1,0) -2.8e-17
XOR, 10 epoche: pesi [-0.1  0. ], bias 0.0, uscita [1 1 0 0]
XOR, 100 epoche: pesi [-0.1  0. ], bias 0.0, uscita [1 1 0 0]
Con \(\eta = 7{,}3\) la corsa finisce dove finiva con \(\eta = 1\), pesi \((2,1)\) e
bias \(-3\) in unità di \(\eta\). Con \(\eta = 0{,}1\) si ferma prima, con bias \(-2\):
\(0{,}1\) in binario non si scrive esatto, e sul caso \((1,0)\) il totale, che
doveva fare zero e far scattare un’ultima correzione, esce \(-2{,}8\cdot10^{-17}\)
(il -2.8e-17 della stampa, cioè sedici zeri dopo la virgola e poi \(28\), con
il segno meno). Il neurone risponde no, nessuno corregge più, e la corsa resta
dov’è: in aritmetica esatta il passo non deciderebbe niente, in macchina ogni
tanto decide dove ci si ferma. Le ultime due righe sono lo XOR, il caso in cui
una retta che separa non esiste.
Il muro dello XOR#
Ed eccolo, il muro. Merita di essere raccontato per quello che è, perché la versione che si sente di solito è comoda e sbagliata.
Perceptrons, il libro di Minsky e Papert del 1969 [MP69], è ricordato per lo XOR («o esclusivo», che vale \(1\) quando i due ingressi sono diversi e \(0\) quando sono uguali), e cioè per l’osservazione che un neurone solo non ce la fa. Ma quella osservazione non era loro: che un elemento a soglia da solo tracci una riga e nient’altro si sapeva da decenni, ed è il motivo per cui già nel 1943, in McCulloch e Pitts, per calcolare le funzioni logiche gli elementi si collegavano fra loro invece di usarne uno. Nel 1969 era materia da manuale. Vediamo prima l’ostacolo come lo si racconta di solito, poi che cosa dimostra davvero quel libro.

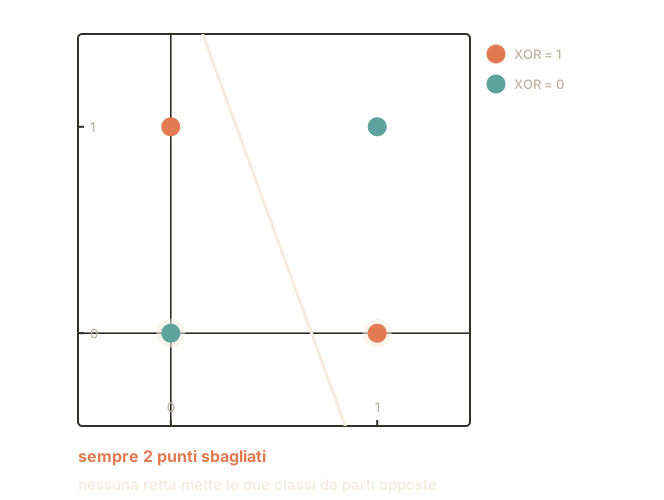
Fig. 6.7 La stessa retta della figura precedente, questa volta sui quattro casi dello XOR: gli assi portano i due ingressi, \(0\) e \(1\), e ogni angolo del quadrato è uno dei quattro casi. Come là, il terracotta è la classe con uscita \(1\). Per quanto la si giri, la retta lascia sempre due punti dalla parte sbagliata.#
Il contrasto con la Fig. 6.6 è tutto il punto: là la rotazione finiva, qui non finisce mai. La Fig. 6.7 non è una dimostrazione, perché mostra alcune inclinazioni e non tutte quelle possibili; ma rende evidente da dove viene l’ostacolo: le due classi occupano angoli opposti del quadrato.
Sul foglio a quadretti i quattro casi dello XOR sono gli angoli di un quadrato di lato \(1\), e i due che vogliono uscita \(1\), \((0,1)\) e \((1,0)\), stanno in angoli opposti. Che nessuna riga li separi lo si vede con un conto breve. Il totale del caso \((1,1)\) è quello di \((1,0)\), più quello di \((0,1)\), meno quello di \((0,0)\): sommando i primi due ci sono tutti e due i pesi, come in \((1,1)\), ma il bias due volte, e togliere il totale di \((0,0)\), che è il bias da solo, lo riporta a una. I primi due devono stare sopra lo zero, il terzo sotto, e togliere un numero negativo vuol dire aggiungere: il totale di \((1,1)\) finisce sopra lo zero per forza, e il neurone dice \(1\) dove doveva dire \(0\). Un singolo percettrone, sullo XOR, è condannato a sbagliare almeno un caso.
Adesso lascia provare alla macchina, con la regola delle correzioni, e a ogni caso sbagliato la riga si sposta un po’. Dopo due o tre giri completi succede una cosa curiosa. Le quattro correzioni di un giro si annullano fra loro, e alla fine del giro la riga è tornata esattamente dov’era. Il giro dopo è identico, e quello dopo ancora.
Da fuori sembra una macchina rotta e ferma: dà sempre le stesse quattro risposte, sbaglia sempre gli stessi casi, al decimo giro come al centesimo. Dentro invece si muove a ogni esempio, e gira in tondo. I pesi intanto non scappano verso numeri enormi, restano piccoli come all’inizio. La macchina non esplode, non si arrende, e continua a sbagliare con calma.
Lo XOR non è linearmente separabile: non esiste alcun \((\mathbf{w}, b)\) tale che \(g(\mathbf{w}^\top\mathbf{x}+b)\) riproduca la tabella. Lo si vede sommando le disuguaglianze: servirebbero \(b<0\) da \((0,0)\), \(w_2+b\ge0\) da \((0,1)\), \(w_1+b\ge0\) da \((1,0)\) e \(w_1+w_2+b<0\) da \((1,1)\); sommando la seconda e la terza, \(w_1+w_2+b\ge -b>0\), contro la quarta. Le classi \(\{(0,0),(1,1)\}\) e \(\{(0,1),(1,0)\}\) non sono divisibili da un iperpiano in \(\mathbb{R}^2\). Non è un difetto dell’ottimizzatore, è un limite di capacità del modello.
Lanciato addestra su y_xor = np.array([0, 1, 1, 0]), quello che si vede non
è quello che ci si aspetta. Non
converge, e fin qui è ovvio; ma nemmeno diverge, e nemmeno vaga. Le prime due
epoche sbagliano tre esempi su quattro; dalla terza in poi li sbagliano
tutti e quattro, tutti e quattro producono una correzione, e le quattro
correzioni si annullano fra loro: alla fine di ogni epoca i parametri sono
tornati esattamente dov’erano (\(\mathbf{w} = (-0{,}1,\ 0)\), \(b = 0\)), e l’uscita
stampata è [1 1 0 0] alla decima epoca come alla centesima.
Le quattro correzioni si seguono sul foglio, e conviene farlo perché è il modo più rapido per vedere da dove nasce il ciclo. Si parte da \(\mathbf{w} = (-0{,}1,\ 0)\) e \(b = 0\). Il primo esempio, \((0,0)\), riceve \(1\) e doveva ricevere \(0\): la correzione tocca solo il bias, perché ogni peso si muove in proporzione al proprio ingresso e qui gli ingressi valgono zero, e \(b\) scende a \(-0{,}1\). Il secondo, \((0,1)\), e il terzo, \((1,0)\), ricevono \(0\) e dovevano ricevere \(1\): ciascuno alza di \(0{,}1\) il peso del proprio ingresso acceso, e ciascuno rialza il bias. Il quarto, \((1,1)\), riceve \(1\) e doveva ricevere \(0\): riabbassa entrambi i pesi e riporta il bias dov’era. Fine dell’epoca, e siamo al punto di partenza. Da fuori una risposta immobile e sbagliata (due casi su quattro), da dentro un ciclo. È il perceptron cycling theorem, enunciato nello stesso Perceptrons e dimostrato per intero da Block e Levin [BL70], che su dati non separabili garantisce almeno che i pesi restino limitati.
Che cosa dimostra davvero Perceptrons#
Lo XOR è il ricordo che è rimasto, ma non è il risultato.
Prima di tutto, una parola che cambia significato. Nel loro libro «percettrone» non indica il neurone di poco fa, ma una macchina più generale, e conviene saperlo, altrimenti i loro risultati sembrano parlare di una cosa che non è.
Una fotografia, e una squadra di ispettori (sono le scatolette del Mark I, ognuna attaccata a un pugno di fotocellule): ciascuno può guardare solo qualche punto dell’immagine e risponde sì o no, poi un capo raccoglie le risposte, dà a ognuna un peso, somma e decide. Il neurone di poco fa è il caso più semplice di questa macchina, quello in cui ogni ispettore guarda un punto solo. La domanda dei teoremi non è se la squadra ce la fa, ma quanti punti deve guardare in una volta sola l’ispettore più affamato: quel numero si chiama ordine, e misura quanto il problema si lascia dividere in pezzetti.
C’è un compito in cui va malissimo: dire se i punti accesi sono in numero pari o dispari (i matematici lo chiamano la parità). Qui nessun ispettore può accontentarsi della propria zona, perché accendere o spegnere un punto qualunque, in un angolo qualunque, ribalta la risposta.
Verrebbe da obiettare: e se ogni ispettore dicesse «nella mia zona gli accesi sono pari», lasciando al capo il compito di mettere insieme? Non funziona, perché il capo non ragiona: sa fare una cosa sola, sommare le risposte con dei pesi e confrontare il totale con una soglia. Combinare «pari» e «pari» e «dispari» per sapere com’è il totale è di nuovo lo stesso problema di partenza, e una somma pesata non lo risolve. Non resta che guardare l’immagine intera in un colpo solo, e l’ordine è grande quanto l’immagine. Un altro compito difficile è dire se una figura disegnata è tutta d’un pezzo o spezzata in due: più la figura è grande, più punti bisogna guardare insieme.
E lo XOR è il caso più piccolo della parità, quello con due punti soli. Provaci: nessuno acceso fa zero, che è pari, e la risposta è no; uno acceso solo fa uno, dispari, risposta sì; tutti e due accesi fa due, di nuovo pari, di nuovo no. È esattamente la tabella dello XOR. Ed è anche per questo che è rimasto nella memoria di tutti: si disegna su un foglio in un secondo.
Ma è la punta di una famiglia, e la conclusione vera è più interessante di un semplice «non si può». Non «una riga non basta», bensì: mettere insieme la risposta a partire da ispettori che guardano ciascuno il proprio pezzetto funziona sui casi piccoli e diventa impraticabile appena il problema cresce. Che è un difetto peggiore, perché non si vede finché non si prova a ingrandire.
Nel libro «percettrone» indica una macchina più generale del neurone di poco fa: una somma pesata di predicati qualsiasi, ciascuno dei quali però può guardare solo un pezzetto dell’immagine in ingresso (le unità intermedie del Mark I, collegate a caso a poche fotocellule, sono predicati di questo tipo), e il numero di punti che il predicato più affamato deve guardare si chiama ordine. I teoremi sono su quello. Il più celebre dice che per calcolare la parità di \(n\) bit (rispondere «quanti sono accesi, pari o dispari?») serve ordine \(n\): qualche predicato deve guardare tutti gli ingressi in una volta sola, e non c’è modo di cavarsela con pezzetti. Un altro dice che per decidere se una figura disegnata è tutta d’un pezzo o spezzata in due, il numero di punti da guardare insieme cresce con la figura. Lo XOR è la parità a due bit, cioè il caso più piccolo di una famiglia: non un impossibile, ma il primo gradino di un costo che esplode. Il messaggio non era «una retta non basta», era «questo modo di costruire le caratteristiche non scala».
E sulle reti a più strati, cioè sulla cosa per cui il libro è stato usato come condanna, Perceptrons non dimostra niente, e lo dichiara: parla di un «giudizio intuitivo» che l’estensione al multistrato sia sterile, e chiede esplicitamente a qualcuno di confermarlo o smentirlo. È una congettura, cioè un sospetto che nessuno ha ancora dimostrato, dichiarata come tale e letta per vent’anni come se fosse un teorema.
Quello che venne dopo lo riassume la Fig. 6.8.

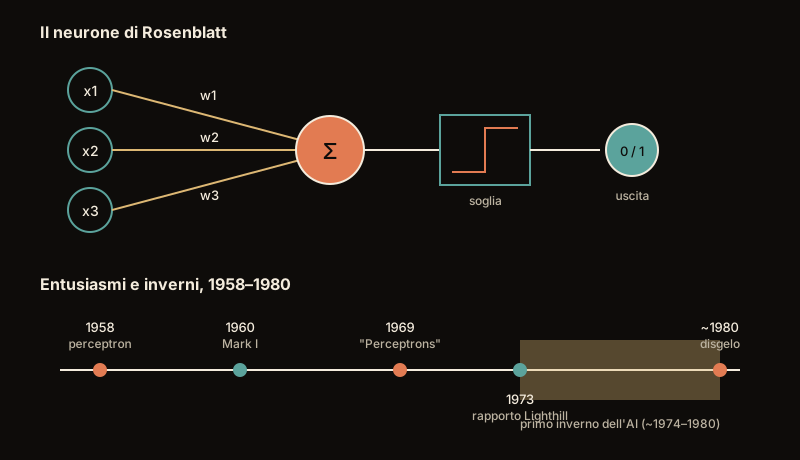
Fig. 6.8 In alto il neurone di Rosenblatt; sotto, vent’anni di storia in cinque tappe, dal percettrone del 1958 al disgelo attorno al 1980, con il rapporto Lighthill del 1973 in mezzo. La banda colorata è il primo inverno dell’AI.#
Seguirono anni magri, che oggi si chiamano il primo inverno dell’AI: i finanziamenti si ritirarono, i gruppi di ricerca si svuotarono e il campo quasi si fermò. A far scattare i tagli veri, però, non fu questo libro, e non fu subito. Nel Regno Unito fu il rapporto Lighthill del 1973, una stroncatura commissionata dallo Science Research Council che riguardava l’intelligenza artificiale tutta intera, reti neurali o no. Negli Stati Uniti, negli stessi anni, la DARPA, che finanziava gran parte della ricerca sull’intelligenza artificiale, tagliò quella che non avesse uno scopo militare diretto.
La sproporzione fra la portata dei risultati e l’ampiezza della reazione è una lezione che vale oltre questa storia. I teoremi erano corretti e limitati, e riguardavano macchine a uno strato; la loro lettura pubblica fu che le reti neurali non funzionavano, e servì quasi un ventennio per rimediare. Il libro contribuì a spostare risorse verso l’altro modo di fare intelligenza artificiale, quello dei programmi a regole scritte a mano (l’AI simbolica); ma la ragione tecnica per cui le reti restarono ferme la indicarono gli stessi autori, ed è quella che il libro non prova a nascondere: nessuno sapeva come correggere i neuroni in mezzo. È da lì che sarebbe arrivata la via d’uscita.
Oltre la linea: strati nascosti e non linearità#
Se un neurone traccia una sola riga, mettiamone di più. Un primo strato di neuroni traccia più righe insieme: è uno strato nascosto, che lavora in mezzo fra l’ingresso e l’uscita. Un secondo strato poi lavora sulle risposte del primo, e il confine che ne esce non è più una riga sola. Tanto basta per lo XOR, e fra poco lo vediamo disegnato.
C’è però una condizione: fra uno strato e l’altro deve succedere qualcosa che non sia moltiplicare e sommare. Se no cento strati si schiaccerebbero in uno solo, capace di disegnare quello che sapeva disegnare prima, cioè una riga dritta, e lo XOR resterebbe fuori portata. Quel qualcosa da mettere in mezzo si chiama non linearità, e sono funzioni come la ReLU o la sigmoide. Saranno loro, insieme al percettrone multistrato (MLP) e all’algoritmo che lo addestra (la backpropagation), il tema delle sezioni sulle funzioni di attivazione e sulla backpropagation.
La Fig. 6.9 fa vedere il passaggio per intero, ed è la risposta che aspettavamo: lo XOR risolto. Il trucco è lo stesso di tutto il deep learning.
I due neuroni del primo strato tracciano due righe parallele, e lasciano fra loro una fascia. Dentro la fascia stanno i due casi che vogliono risposta \(1\); fuori, uno da una parte e uno dall’altra, i due che vogliono risposta \(0\).
Una precisazione prima dei numeri: questi due neuroni non usano l’interruttore secco di prima. Usano la ReLU, che lascia passare il totale quando è positivo e dà zero quando è negativo, quindi la loro risposta dice «quanto» e non solo «sì o no». Le due regole si leggono in fondo alla figura, e sono \(h_1 = \mathrm{ReLU}(x_1 + x_2 - 0{,}5)\) e \(h_2 = \mathrm{ReLU}(-x_1 - x_2 + 1{,}5)\). Applicate ai quattro casi danno questo:
ingresso |
risposta voluta |
\(h_1\) |
\(h_2\) |
|---|---|---|---|
\((0,0)\) |
\(0\) |
\(0\) |
\(1{,}5\) |
\((0,1)\) |
\(1\) |
\(0{,}5\) |
\(0{,}5\) |
\((1,0)\) |
\(1\) |
\(0{,}5\) |
\(0{,}5\) |
\((1,1)\) |
\(0\) |
\(1{,}5\) |
\(0\) |
Guarda le ultime due colonne, perché è lì che succede tutto. I due casi con risposta \(1\) danno la stessa identica coppia, \((0{,}5;\ 0{,}5)\): erano due punti diversi e adesso sono lo stesso punto. I due casi con risposta \(0\) danno \((0;\ 1{,}5)\) e \((1{,}5;\ 0)\), cioè due punti lontani e da parti opposte. Adesso prendi un foglio nuovo, mettici \(h_1\) in orizzontale e \(h_2\) in verticale, segna i tre punti: una riga sola li separa, e a tracciarla è il neurone di uscita. Il primo strato non ha risolto il problema: lo ha spostato in un posto dove era facile, ed è questo il mestiere degli strati nascosti in tutto il libro.

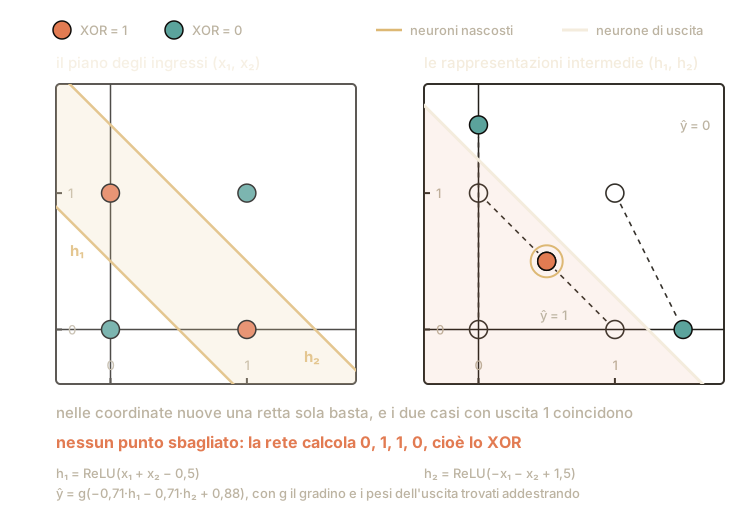
Fig. 6.9 Il seguito della Fig. 6.7, cioè lo XOR risolto. A sinistra il piano di partenza: il primo strato sono due neuroni, quindi due rette invece di una, e la fascia che lasciano in mezzo contiene i due casi con uscita \(1\). A destra gli stessi quattro punti ridisegnati nelle coordinate \((h_1, h_2)\) che quei due neuroni calcolano: i due casi con uscita \(1\) sono finiti nello stesso posto, i due con uscita \(0\) ai lati opposti, e lì il neurone di uscita li separa con una retta sola. I due neuroni nascosti sono scelti a mano, e le loro formule si leggono in fondo alla figura; i pesi del neurone d’uscita no, li trova la discesa del gradiente, il metodo di aggiustamento automatico di cui parla la sezione sulla backpropagation. Che di un interruttore secco non saprebbe che farsene, quindi ad addestrarsi è un neurone dall’uscita morbida, che scivola da zero a uno invece di saltare, e l’interruttore torna alla fine, a leggere il risultato. Messi in fila i quattro ingressi, la rete risponde \(0, 1, 1, 0\): lo XOR, per intero.#
Da ricordare
Un neurone artificiale è un pezzo di aritmetica: dà a ogni indizio in ingresso un peso, somma tutto, aggiunge la propria indole di partenza (il bias) e passa il totale a un interruttore che risponde sì o no.
Il percettrone impara sbagliando: quando azzecca non tocca niente, quando dice «no» e doveva dire «sì» alza i pesi, e viceversa. Ogni peso si sposta in proporzione a quanto valeva il suo ingresso in quell’esempio: si corregge chi ha parlato più forte. Le correzioni sono piccole e si ripetono su tutti gli esempi.
Un neurone solo sa tracciare una riga dritta fra le due classi, e il motivo è che somma e confronta con una soglia: i casi in cui il totale pareggia la soglia stanno tutti su una riga. Se quella riga esiste la trova, ma è una qualunque fra quelle che separano e può restare appiccicata a un puntino; sullo XOR non esiste, perché i casi da separare stanno negli angoli opposti del quadrato, e allora la macchina non si ferma e non esplode: gira in tondo, sbagliando sempre gli stessi casi.
Per piegare la frontiera servono più neuroni impilati in strati e, fra uno strato e l’altro, un passaggio che non sia una semplice riga: è il ponte verso le reti neurali profonde.
Da ricordare
Un neurone artificiale calcola una somma pesata degli ingressi più un bias, \(\mathbf{w}^\top\mathbf{x}+b\), e la fa passare in una funzione di attivazione.
Il percettrone impara correggendo i pesi in proporzione all’ingresso, perché con il gradino l’errore vale sempre \(0\), \(+1\) o \(-1\): \(w_i \leftarrow w_i + \eta\,(y-\hat{y})\,x_i\). Se i dati sono separabili e si parte da \(\mathbf{w}=\mathbf{0}\) con il bias assorbito, converge in al più \((R/\gamma)^2\) correzioni, un limite che non dipende dal numero di esempi ma dal rapporto fra la norma massima e il margine; l’iperpiano che trova però è uno qualunque fra quelli che separano, senza garanzia di margine. Se non lo sono, i pesi restano comunque limitati.
Un solo neurone è un classificatore lineare: separa lo spazio con un iperpiano e fallisce su problemi non separabili come lo XOR. Quel che Perceptrons dimostra però è sull’ordine dei predicati (la parità su \(n\) bit lo richiede pari a \(n\)); sul multistrato il libro avanza una congettura e lo dichiara.
Servono strati nascosti e non linearità per superare quel limite: è il ponte verso le reti neurali profonde.