


Speech Recognition: dalla voce al testo#
Nel 1952, nei laboratori della Bell Telephone, un apparecchio ingombrante fatto di valvole e relè (l’elettronica di allora: bulbi di vetro incandescenti e interruttori che scattano da soli) imparò a riconoscere le cifre da zero a nove pronunciate ad alta voce. Lo chiamarono poi Audrey, e aveva un limite quasi comico: funzionava con un solo parlante, che poteva parlare a velocità normale ma doveva staccare nettamente una cifra dall’altra, con una pausa in mezzo. Attaccate, non le riconosceva più. Settant’anni dopo diciamo «metti la sveglia alle sette» al telefono mentre carichiamo la lavastoviglie, e la frase diventa testo (e poi azione) in una frazione di secondo. In mezzo c’è la storia dell’ASR (Automatic Speech Recognition), il riconoscimento vocale automatico.
Gli attrezzi del mestiere li ha già costruiti il capitolo sull’audio, e qui si mettono in fila sulla voce.
Che cosa fa, in fondo#
Il compito è facile da enunciare: prendere un segnale audio e restituire le parole che contiene.
Ascolti una registrazione e la trascrivi a mano: ricevi un flusso continuo di suono (alti, bassi, pause) e produci una riga di parole scritte. Dieci secondi di registrazione diventano una ventina di parole, e nessuno ti dice quanti centesimi di secondo tocchino a ciascuna. Dove il parlato è impastato torni indietro, riascolti, provi due letture possibili e scrivi quella che ti convince di più. Il riconoscitore vocale fa esattamente questo: in ingresso l’onda sonora catturata dal microfono, in uscita del testo. Del significato non capisce niente: il suo mestiere finisce con le lettere giuste.
Formalmente l’ASR è un problema di trasduzione di sequenze: da una sequenza di vettori acustici \(\mathbf{X} = (\mathbf{x}_1, \dots, \mathbf{x}_T)\) vogliamo la sequenza di parole \(\hat{W}\) più probabile,
Qui \(\mathbf{X}\) è tipicamente lunga centinaia o migliaia di passi (uno ogni dieci millisecondi circa), mentre \(W\) conta poche decine di parole: input e output hanno lunghezze molto diverse e non allineate una-a-una. Gestire questo disallineamento temporale è il cuore tecnico del problema.
Perché è difficile#
Nessuno pronuncia due volte la stessa parola allo stesso modo. La voce cambia con la persona (timbro, accento, velocità), con lo stato d’animo, con il raffreddore. C’è il rumore di fondo: traffico, musica, altre voci sovrapposte. C’è la coarticolazione, il fenomeno per cui i suoni si contaminano a vicenda: la «n» di un cane non è la stessa «n» di un pane, perché la bocca si sta già preparando al suono che segue. E ci sono gli omofoni: l’ago e lago suonano identici, e solo il contesto della frase dice quale sia quello giusto. Un microfono non «vede» gli spazi tra le parole: il parlato è un flusso continuo, e trovare dove finisce una parola e inizia l’altra è già metà del lavoro.
Da Audrey a Whisper: una breve storia#
I primi sistemi, fino agli anni Settanta, lavoravano per somiglianza: tenevano in memoria una registrazione di ogni parola del loro piccolo vocabolario e cercavano quella più simile al suono appena arrivato, allungandolo o comprimendolo nel tempo per farlo combaciare. L’operazione ha un nome che ogni tanto si incontra ancora, dynamic time warping, «deformare il tempo». Andava bene per pochissime parole e un solo parlante: aggiungerne una voleva dire registrarla.
Il salto di qualità, preparato negli anni Settanta all’IBM e a Carnegie Mellon e diventato la norma nel decennio seguente, arrivò da due idee, non da macchine più potenti. La prima: smettere di ragionare per parole intere e ragionare per fonemi, i suoni minimi che distinguono una parola dall’altra (pane e cane differiscono per uno solo). Le parole di una lingua sono centinaia di migliaia, i fonemi qualche decina, e una parola mai sentita prima è comunque fatta di fonemi già sentiti. La seconda: dividere il lavoro in due pareri.
Un pezzo del sistema giudica quanto questo suono somiglia alla parola «cane»; un altro pezzo, che ha letto montagne di testo italiano, giudica quanto è plausibile la frase «il cane abbaia» rispetto a «il cane abbaglia». La trascrizione finale è quella che i due giudizi promuovono insieme, e basta che uno dei due la bocci perché sia fuori, per quanto l’altro la lodi. Ecco perché il contesto risolve gli omofoni: da solo il suono non basta, serve sapere che frasi hanno senso.
Applicando il teorema di Bayes, il problema si scompone nel classico modello a canale rumoroso:
(Il denominatore \(P(\mathbf{X})\) di Bayes è sparito legittimamente: non dipende da \(W\), quindi non altera l’argmax.) Il modello acustico \(P(\mathbf{X} \mid W)\) misura quanto i suoni osservati siano compatibili con una data sequenza di parole, e storicamente si scompone ancora in due: un dizionario di pronuncia traduce \(W\) in fonemi, e ogni fonema, preso nel contesto del precedente e del successivo (il trifone), è un Hidden Markov Model sinistra-destra di tre stati. Gli HMM dei trifoni, messi in fila nell’ordine delle parole di \(W\), formano un HMM composto; con \(Q = (q_1, \dots, q_T)\) una sequenza dei suoi stati e \(q_0\) il suo stato iniziale,
dove l’emissione di ogni stato è una mistura di \(M\) gaussiane (GMM) con covarianze \(\boldsymbol{\Sigma}_{jm}\) diagonali. Gli stati dei trifoni sono decine di migliaia, troppi per stimarli uno per uno: per questo si raggruppano con alberi di decisione fonetici e si addestrano con l’algoritmo EM di Baum-Welch. In decodifica la somma su \(Q\) diventa il massimo di Viterbi, e in questa fase il modello di linguaggio entra elevato a un peso, \(P(W)^{\lambda}\) con \(\lambda\) di solito fra \(5\) e \(15\). Il peso serve perché il modello acustico moltiplica le densità di centinaia di frame come se fossero indipendenti, mentre frame vicini si somigliano molto: i suoi punteggi escono fuori scala rispetto a quelli del linguaggio, e \(\lambda\) li riequilibra. Il modello di linguaggio \(P(W)\) assegna una probabilità a priori alle frasi (\(n\)-grammi, oggi reti neurali) ed è quello che disambigua gli omofoni. Dal 2012 le reti neurali profonde sostituiscono le GMM nel modello acustico [HDY+12]: su una prova di conversazioni telefoniche (Switchboard, RT03S), con le stesse trecento ore circa di addestramento, l’errore sulle parole scende dal \(27{,}4\%\) del sistema a GMM al \(18{,}5\%\), un terzo in meno.
I due pareri hanno un nome che tornerà spesso: il primo, quello che giudica il suono, si chiama modello acustico; il secondo, quello che giudica se la frase è italiano plausibile, si chiama modello di linguaggio. Li ritroveremo in La voce sintetica, dove il viaggio si fa al contrario e il modello acustico, invece di ascoltare suoni, decide quali produrre.
Su questa divisione del lavoro il riconoscimento vocale si è retto per trent’anni, dagli anni Ottanta al 2010 circa, e chi legge qualsiasi cosa scritta in quel periodo trova sempre la stessa sigla, HMM-GMM: due modelli già incontrati, che qui lavorano in coppia.
Il primo, l’HMM («modello di Markov nascosto»), descrive una parola come una fila di stati che non si vedono: ogni fonema ne ha tre, il suo attacco, il suo centro e la sua coda, e la voce passa dall’uno all’altro senza che nessuno lo osservi. Si osservano soltanto i frame, le fettine di suono lunghe pochi centesimi di secondo in cui il segnale viene tagliato (ne comincia una ogni dieci millisecondi), e da quelli si risale agli stati. È la stessa macchina di POS tagging ed entità, dove gli stati nascosti erano le categorie grammaticali e quello che si osservava erano le parole.
Il secondo, la GMM (mistura di gaussiane), dice che aspetto hanno i frame che ciascuno stato produce. Ogni frame è ridotto a un vettore di poche decine di misure, e la «a» di mille persone diverse non dà mai lo stesso vettore: dà una nuvola di vettori vicini, fitta attorno a un centro e sempre più rada man mano che ci si allontana. Una gaussiana è la curva che descrive una nuvola così, e dove la nuvola è storta se ne sommano parecchie: è lo strumento di Riduzione e clustering, dove serviva a trovare gruppi nei dati, e qui ogni stato dell’HMM ha la sua.
L’ultimo salto è l’approccio end-to-end («da un capo all’altro»): una sola rete neurale che impara direttamente il passaggio dall’audio al testo, senza scomporre a mano acustica e linguaggio. Tecniche come la CTC (Connectionist Temporal Classification [GFernandezGS06]) e i modelli con attenzione (una parte della rete ascolta tutto, l’altra scrive, e mentre scrive torna a guardare il punto dell’audio che le serve: quel tornare a guardare è l’attenzione) hanno reso possibile addestrare l’intero sistema da coppie (audio, testo). Il trasduttore è nato dalla CTC per aggiungerle ciò che le manca, la memoria di quello che ha già scritto, senza toglierle l’andatura frame per frame che permette di trascrivere mentre si parla. Le vedremo una per una in I modelli di riconoscimento: qui bastano i nomi.
L’esempio più noto è Whisper di OpenAI (2022): con un unico modello trascrive quasi cento lingue, italiano compreso, e traduce in inglese il parlato delle altre. È stato addestrato su circa 680.000 ore di audio multilingue: per farsi un’idea, sono quasi settantotto anni di parlato ininterrotto, giorno e notte, senza una pausa. Il modello alla sua base è un Transformer, l’architettura del capitolo sui Transformer, montata in due metà: un encoder, che ascolta l’audio e lo riassume, e un decoder, che da quel riassunto scrive il testo.
La catena di montaggio, passo per passo#
Dal microfono al testo il suono passa per alcune tappe, sempre le stesse (Fig. 24.1). Nei sistemi end-to-end di oggi il modello acustico e il modello di linguaggio sono finiti dentro un’unica rete e non si vedono più dall’esterno, mentre l’estrazione delle feature resta un calcolo fisso, fatto prima che il suono entri nella rete; i nomi delle tappe però sono rimasti in uso. La catena nel suo insieme, in inglese, è la pipeline del riconoscimento vocale.

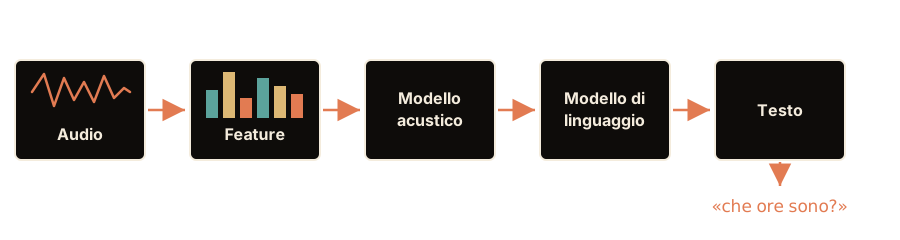
Fig. 24.1 Le cinque tappe del riconoscimento vocale. Dall’onda sonora si ricavano poche misure per ogni frammento (le feature), il modello acustico giudica a quali suoni somigliano, il modello di linguaggio sceglie fra le frasi che quei suoni consentono, e in fondo esce il testo.#
La prima tappa riduce il suono all’essenziale, e si chiama estrazione delle feature («caratteristiche», in inglese): al posto dell’onda grezza, poche misure per ogni frammento di suono. È il passaggio che rende trattabile tutto il resto, e merita un approfondimento.
Il segnale grezzo è troppo minuto e dettagliato per lavorarci direttamente. Allora lo si taglia in fettine di pochi centesimi di secondo e, per ognuna, si misura «quanta energia c’è a ciascuna altezza sonora»: un po’ come le barrette colorate che ballano nelle app della musica, dove le più a sinistra si alzano sui suoni gravi e le più a destra sugli acuti. Le fettine si prendono accavallate, così una consonante a cavallo di un taglio non va persa. Questa sequenza di istantanee sonore è lo spettrogramma costruito passo per passo in Dal suono alle feature, ed è questo che il modello acustico ascolta al posto dell’onda. Un tempo lo riceveva anche più spremuto, una dozzina di numeri per fettina, perché lavorava bene solo con poche misure che non si ripetessero fra loro, e le bande vicine dello spettrogramma salgono e scendono quasi insieme; oggi le reti se lo prendono così com’è.
Il segnale continuo viene diviso in frame sovrapposti e trasformato nello spettrogramma log-mel costruito in Dal suono alle feature: è la matrice \(\mathbf{X}\) che entra nel modello acustico. I sistemi classici applicavano un ultimo passaggio, la trasformata coseno discreta (DCT), che decorrelava i coefficienti e riduceva ogni frame a una dozzina di MFCC (Mel-Frequency Cepstral Coefficients, una quarantina con le derivate prima e seconda): serviva alle covarianze diagonali delle GMM; i sistemi neurali end-to-end, Whisper compreso, non lo fanno più.
Dove lo incontriamo#
Il riconoscimento vocale è ormai ovunque: gli assistenti vocali (Siri, Alexa, Google Assistant) che aspettano un comando; la sottotitolazione automatica di YouTube e delle videochiamate, preziosa per l’accessibilità; la dettatura che trasforma la voce in documenti, dai referti medici ai messaggi scritti mentre si guida. È la porta d’ingresso di quasi ogni sistema che «capisce» il parlato: una volta che la voce è diventata testo, tocca agli strumenti del linguaggio naturale interpretarne il significato. Ma quel primo, difficile passo (dall’onda alla parola) comincia sempre qui.
Ed è un passaggio in cui si sbaglia ancora, ogni giorno, sotto i nostri occhi: i sottotitoli automatici che scrivono una parola per un’altra, o che riempiono di frasi inventate un pezzo di video in cui nessuno parla, sono la parte visibile di limiti precisi, che I modelli di riconoscimento racconta uno per uno.
Il viaggio ha anche un ritorno: La voce sintetica percorre la strada opposta, dal testo all’onda sonora, e chiude il cerchio tra ascoltare e parlare.