


La via di LeCun: predire nello spazio delle idee#
Il documento di LeCun che l’apertura del capitolo ha nominato ha una data precisa: il 27 giugno 2022 Yann LeCun deposita su OpenReview (la piattaforma dove di solito si caricano gli articoli in attesa di revisione) 62 pagine intitolate A Path Towards Autonomous Machine Intelligence [LeC22]. Già il sottotitolo è insolito: «versione 0.9.2», come un software non ancora finito. Non è un paper di risultati ma un documento di posizione, la visione dell’autore su come costruire macchine intelligenti, e la bozza è dichiarata: in un’epoca in cui si tende a mostrare solo ciò che già funziona, un premio Turing espone il proprio programma alle obiezioni di tutti.
Dentro c’è il disegno di una macchina autonoma, fatta di sei pezzi che si passano il lavoro. La percezione stima com’è messo il mondo adesso; il world model, che è il cuore del progetto, dice come andrà avanti, anche se l’azione è soltanto immaginata; il modulo di costo misura quanto la situazione sia sgradita all’agente, con una parte fissata da chi progetta (l’analogo del dolore e del piacere) e una che si impara, il critico, che prevede quanto costerà il seguito. Completano il disegno l’attore, che propone le azioni, una memoria a breve termine e un configuratore, che regola gli altri pezzi a seconda del compito.
Un agente così può agire in due modi. Di riflesso, con la percezione che pilota direttamente l’azione; oppure di testa, usando il world model per provare le sequenze di azioni e scegliere quella dal costo previsto più basso. È un’eco della distinzione fra pensiero veloce e pensiero lento resa celebre da Daniel Kahneman, che LeCun richiama esplicitamente.
Sei pezzi sono tanti, e in gran parte sono ancora sulla carta. Ma tutto il progetto sta o cade su una domanda sola: come si addestra il world model? La risposta di LeCun è: guardando, come il neonato dell’inizio del capitolo. Enormi quantità di video senza che nessuno ci abbia scritto sopra niente, e un solo esercizio, indovinare ciò che viene dopo; la correzione arriva da sé, perché il futuro arriva. È l’apprendimento auto-supervisionato di cui parlava l’apertura del capitolo, e fin qui non c’è niente di nuovo: anche i mondi in miniatura di Ha e Schmidhuber facevano qualcosa di simile. La rottura è nel dove si fa la previsione.
Perché non predire i pixel#
Anche nei mondi in miniatura la previsione non avveniva sui puntini dello schermo: avveniva sui 32 numeri in cui V, la rete che guardava, riassumeva il fotogramma. Quel riassunto, però, era stato addestrato a rimettere insieme i puntini: era bravo nella misura in cui il disegno rifatto somigliava all’originale. LeCun propone di tagliare anche quel cordone. Il futuro, osserva, ha due proprietà che rendono una pessima idea provare a disegnarlo: è molteplice (da uno stesso presente possono seguire tanti futuri diversi, tutti plausibili) ed è pieno di dettagli irrilevanti. Il suo esempio ricorrente è un albero in un video: nessun modello potrà mai prevedere la posizione esatta di ogni foglia mossa dal vento, e soprattutto non serve a niente provarci.
Un bicchiere è in bilico sul bordo del tavolo. «Cadrà e andrà in pezzi»: lo prevedi in un decimo di secondo, e questa previsione ti basta per allungare la mano. Ora prova invece a prevedere la fotografia esatta della scena tra due secondi: dove sarà ogni scheggia, come si rifletterà la luce su ogni frammento, che forma avrà la macchia d’acqua sul pavimento. Impossibile, e del tutto inutile: nessuna decisione sensata dipende dalla forma della terza scheggia. Un modello costretto a prevedere l’immagine pixel per pixel ha esattamente questo problema, due volte. Primo: spreca quasi tutta la sua capacità a studiare dettagli che non contano nulla. Secondo: siccome i futuri possibili sono tanti (le schegge possono disporsi in mille modi) e lui deve produrre una immagine sola, quella che gli costa meno errori è la media di tutti i futuri. Succede anche con un numero solo. Se ti chiedono di indovinare un numero che vale 2 o 8 con la stessa probabilità, e ti multano con il quadrato dell’errore, rispondere 2 costa in media 18 (zero una volta, 36 l’altra), mentre rispondere 5, che non esce mai, costa 9 ogni volta. Con un’immagine la media di tutti i futuri è una foto fantasma, sfocata, in cui mille rotture diverse si sovrappongono. La proposta di LeCun: non prevedere la foto, prevedere il succo («bicchiere in pezzi sul pavimento, acqua sparsa»), cioè prevedere nello spazio delle idee, dove i mille futuri diversi nei dettagli possono diventare un futuro solo, quello che conta, se l’allenamento insegna a buttare via le schegge e non il bicchiere.
C’è un caso in cui il succo da solo non basta. La mano l’hai allungata: se il bicchiere lo prendi al volo, il succo giusto è «bicchiere salvo», e i due futuri sono diversi davvero, non per una scheggia in più o in meno. Nel disegno del 2022 LeCun prevede per questo un ingrediente in più, una variabile che nessuno osserva e che dice quale dei due esiti si sta raccontando (in gergo una variabile latente, cioè nascosta). Nei sistemi costruiti finora quella variabile non c’è, e la risposta resta una sola.
Se si addestra un predittore \(g\) a minimizzare l’errore quadratico \(\mathbb{E}\,\lVert \mathbf{y} - g(\mathbf{x}) \rVert^2\) su un futuro \(\mathbf{y}\) intrinsecamente stocastico, l’ottimo è la media condizionata \(g^*(\mathbf{x}) = \mathbb{E}[\mathbf{y} \mid \mathbf{x}]\): quando i modi della distribuzione sono molti e distinti, la loro media è un’immagine sfocata che non corrisponde a nessun futuro reale; è la ragione per cui la predizione video nei pixel produce fantasmi lattiginosi. La proposta di [LeC22] è la JEPA (Joint-Embedding Predictive Architecture): due encoder mappano contesto e target nello spazio delle rappresentazioni, \(\mathbf{s}_x = f_\phi(\mathbf{x})\) e \(\mathbf{s}_y = \bar{f}_{\bar{\phi}}(\mathbf{y})\) (la barra dice che il secondo encoder è una copia dell’altro tenuta indietro, e la sezione sul collasso spiega perché), e un predictor \(g_\theta\) opera interamente lì:
dove \(\mathbf{z}\) è una variabile latente che assorbe la molteplicità dei futuri (quale dei tanti esiti plausibili si è realizzato) e \(\phi\), \(\bar{\phi}\), \(\theta\) sono i parametri dei due encoder e del predictor. L’energia della coppia è la seconda quantità, \(E^\star\) (nel documento del 2022 si chiama energia libera e si scrive \(F\), ma quella lettera nella sezione sull’inferenza attiva farà un altro mestiere, l’energia libera variazionale, che misura un’altra cosa): si sceglie la \(\mathbf{z}\) che spiega meglio il futuro osservato, e quel minimo misura la compatibilità tra \(\mathbf{x}\) e \(\mathbf{y}\). Il collegamento con il capitolo sui modelli a energia è letterale: una JEPA è un modello a energia non normalizzato; la compatibilità tra presente e futuro è l’errore di predizione nello spazio latente, l’inferenza è la solita \(\arg\min\) (qui, il minimo su \(\mathbf{z}\)), e della funzione di partizione non c’è alcun bisogno.
Una precisazione, perché altrimenti quel \(\min_{\mathbf{z}}\) resta un debito: \(\mathbf{z}\) è la forma generale dello schema proposto nel 2022, non la ricetta che poi è stata implementata. I due sistemi costruiti da Meta (I-JEPA per le immagini, V-JEPA per i video) istanziano il caso senza latente: il predictor è deterministico, \(g_\theta(\mathbf{s}_x)\), quindi \(E^\star(\mathbf{x}, \mathbf{y}) = E(\mathbf{x}, \mathbf{y})\) e non c’è alcun minimo da calcolare, né in addestramento né a inferenza. Quel poco di «quale futuro» che serve è passato al predictor come informazione esplicita (i token posizionali che dicono dove prevedere), non inferito come variabile nascosta: nei paper quella grandezza si chiama \(\mathbf{z}\) lo stesso, e la differenza è che gliela si passa invece di cercarla. Una JEPA con \(\mathbf{z}\) vero, capace di produrre più esiti plausibili invece di uno solo, resta al momento programma di ricerca.
La libertà nuova sta nell’encoder del target: poiché \(\mathbf{y}\) non va ricostruito ma solo rappresentato, \(\bar{f}\) può legittimamente buttare via informazione, e i gradi di libertà imprevedibili e irrilevanti (le foglie, i riflessi) possono non arrivare nello spazio in cui si calcola la loss. L’architettura lo rende possibile, non lo garantisce: che l’encoder scarti proprio quelli, e non il segnale utile, lo decide l’addestramento. Il caso limite in cui scarta tutto è il collasso, ed è per questo che serve una difesa contro di esso.
La Fig. 31.4 mette i due mondi uno sopra l’altro, introducendo i termini dell’architettura. Il contesto \(\mathbf{x}\) è la parte che il modello vede, il target \(\mathbf{y}\) (il bersaglio) la parte da prevedere. Un encoder ne produce le rappresentazioni, i vettori \(\mathbf{s}_x\) e \(\mathbf{s}_y\); il predictor stima \(\mathbf{s}_y\) a partire da \(\mathbf{s}_x\); un decoder, al contrario, ricostruirebbe l’input puntino per puntino. Riassunto, embedding, rappresentazione e «spazio delle idee» indicano qui lo stesso vettore, cambia soltanto il registro. Fa eccezione latente, che nei paper indica anche la variabile \(\mathbf{z}\) della JEPA: quella non riassume niente di visto, sceglie uno fra i futuri possibili.

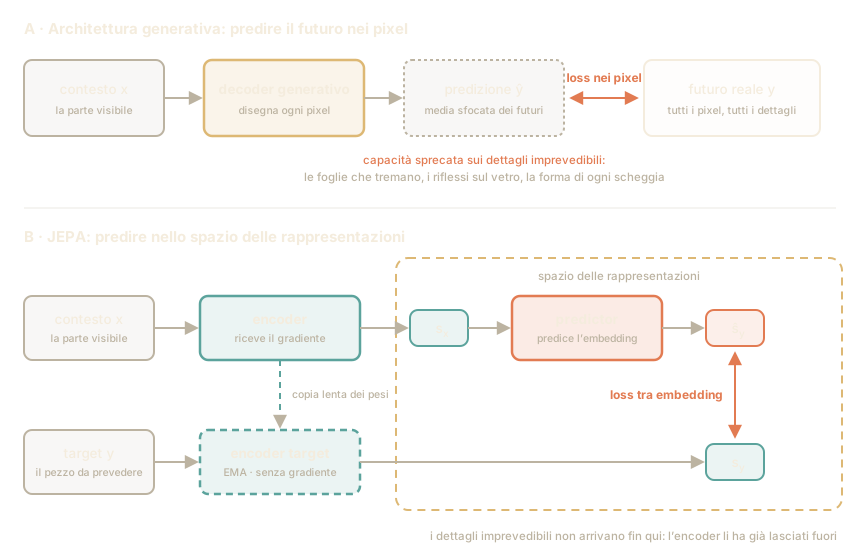
Fig. 31.4 Generativa contro JEPA: la prima predice il futuro nei pixel (e deve indovinare anche l’irrilevante), la seconda lo predice nello spazio delle rappresentazioni, dove l’irrilevante può restare fuori.#
Nel pannello A della figura il decoder deve tornare fino ai singoli puntini, e la loss lo punisce anche su ogni foglia che trema; nel pannello B la previsione parte dal contesto e arriva al target senza mai uscire dallo spazio delle rappresentazioni, che è lo spazio delle idee del titolo, e lì i dettagli irrilevanti possono restare fuori dalla porta. Quello del pannello B è lo schema che dà il nome a tutta questa linea di ricerca: JEPA, Joint-Embedding Predictive Architecture, architettura predittiva a rappresentazioni congiunte: la parola joint, congiunto, dice che i due riassunti vivono nello stesso spazio, ed è lì che si possono confrontare.
Il ritorno del collasso#
La trappola è il collasso, già incontrato nella sezione sull’energia come compatibilità: un’energia che vale zero per ogni coppia. Se la loss misura soltanto la distanza fra la rappresentazione predetta e quella del bersaglio, ha un minimo banale: due encoder che producono la stessa fila di numeri qualunque cosa guardino. Predizione perfetta, energia zero dappertutto, e rappresentazioni che non distinguono un gatto da un lampadario. Per le JEPA è il pericolo numero uno, perché qui il bersaglio è prodotto da un encoder i cui parametri dipendono dalla stessa loss, mentre in un modello generativo il bersaglio è il dato stesso, che nessun addestramento può spostare. Nel documento del 2022 LeCun indica la famiglia di rimedi che preferisce, quella già incontrata fra i modelli a energia: invece di fabbricare risposte sbagliate da bocciare, si toglie al modello la possibilità stessa di dare a tutto lo stesso riassunto, per esempio obbligandolo a tenerli diversi fra loro. Ma nei sistemi JEPA costruiti davvero da Meta la difesa concreta è un’altra, più semplice e più sottile.
I suoi pezzi sono tre, e non pesano uguale (Fig. 31.5).
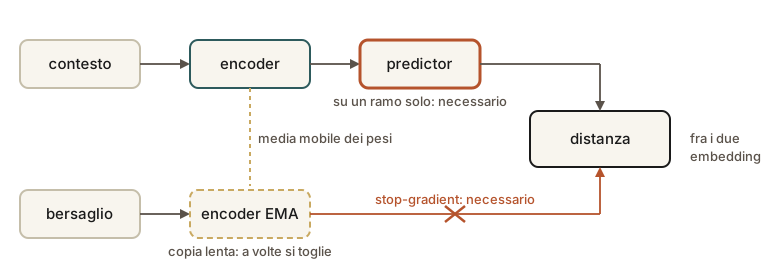
Fig. 31.5 I tre pezzi dell’asimmetria. Il predictor, che sta su un ramo solo, e lo stop-gradient sul ramo del bersaglio servono insieme; la copia lenta dell’encoder, aggiornata come media mobile dei pesi, a certe condizioni si può togliere senza che il sistema collassi.#
L’allievo guarda la parte visibile della foto e prova a descrivere che cosa c’è nella parte coperta; l’insegnante, che vede la foto intera, scrive la descrizione giusta; il voto misura quanto le due descrizioni combaciano. Se allievo e insegnante potessero mettersi d’accordo, la truffa sarebbe immediata: rispondere entrambi, sempre, «boh» (descrizioni identiche, voti perfetti, e nessuno dei due che abbia mai guardato la foto). Il trucco che rompe la truffa è togliere all’insegnante ogni voce in capitolo: le lamentele sul voto non lo raggiungono mai. In gergo si dice che non riceve gradiente, cioè quella spinta a correggersi che dopo ogni voto torna indietro nella rete e le ritocca i numeri, e il gesto di tagliargliela si chiama stop-gradient. Non potendo contrattare, l’insegnante non può accordarsi con l’allievo per abbassare l’asticella, e all’allievo non resta che inseguire le descrizioni dell’altro.
C’è poi una seconda accortezza, dalla parte dell’allievo: la sua descrizione non arriva all’insegnante così com’è, ma passa prima per un traduttore che lavora solo per lui e che l’insegnante non ha (il predictor). È quello che rende i due davvero diversi, e nei sistemi veri conta quanto il silenzio dell’insegnante: tolto il traduttore, o ridata la voce all’insegnante, la truffa ricomincia.
C’è infine una terza accortezza: come insegnante si usa una copia lenta dell’allievo, non una seconda rete addestrata a parte ma l’allievo stesso com’era in media negli ultimi tempi, cioè i suoi numeri mescolati un pochino a ogni passo (in gergo, una media mobile). Il dosaggio lo scelgono i ricercatori, e nel sistema vero è quattro parti su mille: se un numero dell’allievo passa da 10 a 20, quello dell’insegnante non salta a 20, diventa 10,04, cioè copre quattro millesimi dei dieci di divario. Per raggiungerlo davvero gli servono centinaia di passi, e nel frattempo il bersaglio cambia idea solo al ritmo a cui l’allievo migliora davvero; verso la fine il dosaggio scende a zero, e l’insegnante non cambia più idea affatto. Delle tre accortezze, la lentezza è quella di cui a volte si fa a meno. Nella mini-JEPA in PyTorch la si toglie e la truffa non ricomincia; un sistema vero, SimSiam, ne fa a meno perdendo qualche punto; un altro, BYOL, senza di essa crolla, a meno di far correre molto di più il traduttore. Chi ha costruito le JEPA la tiene e la dichiara essenziale. Che aiuti, dunque, lo dicono i risultati; perché, con precisione, è ancora oggetto di studio.
Il rimedio usato dai sistemi JEPA di Meta è l’asimmetria fra i due rami, la famiglia di rimedi che il capitolo sull’auto-supervisione chiama «rendere le due reti diverse». L’encoder del target non viene addestrato per retropropagazione ma mantenuto come media mobile esponenziale (EMA, exponential moving average) dei pesi dell’encoder di contesto:
dove \(\phi\) sono i pesi dell’encoder di contesto, \(\bar{\phi}\) quelli dell’encoder target e \(m\) un momento vicino a 1 (in BYOL e in parte della letteratura questo coefficiente si indica con \(\tau\), un simbolo che in questo capitolo è già occupato dalla temperatura del sogno; MoCo, come qui, usa \(m\)). In I-JEPA \(m\) parte da 0,996, quindi a ogni passo il target si sposta di una frazione millesimale verso l’encoder corrente, e cresce linearmente fino a 1 lungo l’addestramento: verso la fine il bersaglio smette del tutto di muoversi. All’EMA si accompagna lo stop-gradient: la loss non si propaga mai attraverso il ramo del target, che è puro riferimento. E c’è un terzo pezzo, che si dimentica volentieri perché sta dalla parte dell’allievo: il predictor, che esiste su un ramo solo ed è ciò che rende l’asimmetria un’asimmetria vera. I paper della famiglia li nominano tutti e tre insieme.
Dei tre, l’EMA è quello a cui si può rinunciare, ma a certe condizioni. Nella mini-JEPA in PyTorch toglierla e tenere il resto non produce alcun collasso (la varietà delle rappresentazioni, anzi, sale sopra 1,5), e SimSiam, che la sezione sull’imparare a vedere senza etichette ha già raccontato, ne fa a meno pagando qualche punto di accuratezza (71,3% contro il 74,3% di BYOL, a 800 epoche) [CH21]. BYOL invece, tolta la media mobile, collassa (0,3% di accuratezza nell’ablazione a 300 epoche, dove il modello completo ottiene il 72,5%), e torna al 66,9% solo dando al predictor un tasso di apprendimento dieci volte più alto [GSAltche+20]; e I-JEPA chiama l’EMA «essenziale per addestrare» architetture come questa, attribuendo la difesa dal collasso all’asimmetria fra i due rami nel suo insieme [ADM+23]. Stop-gradient e predictor servono invece insieme: in SimSiam togliere l’uno o l’altro fa collassare [CH21], e la dinamica del predictor che lo spiega l’hanno analizzata Tian, Chen e Ganguli [TCG21]. Che un sistema senza coppie negative né termini contrastivi potesse non collassare era stata la scoperta empirica di BYOL nel 2020, e aveva sorpreso la comunità. Una comprensione teorica completa del perché manca ancora.
Il documento del 2022 [LeC22] discute anche l’alternativa esplicitamente regolarizzata, alla VICReg [BPL22], dove a proteggere dal collasso è la loss e non l’asimmetria: accanto alla distanza fra le due rappresentazioni, un termine a cerniera tiene la deviazione standard di ogni componente, nel batch, sopra una soglia, e un altro penalizza le covarianze fuori diagonale. La perdita per intero, con i pesi del paper, è nella sezione sulle famiglie dell’auto-supervisione, che la mette accanto a Barlow Twins. I-JEPA e V-JEPA, nei paper, si affidano invece all’asimmetria EMA.
I-JEPA: la scommessa alla prova delle immagini#
Nel documento del 2022 la JEPA è soprattutto un diagramma. La prima incarnazione che ne porta il nome arriva l’anno dopo, dal gruppo di LeCun a Meta AI: I-JEPA (Image-based JEPA, la JEPA per le immagini) [ADM+23], presentata alla conferenza CVPR. I pezzi sono quelli di poco fa. L’encoder è un Vision Transformer, la rete che nella sezione sui modelli multimodali tagliava l’immagine in tessere e le trattava come le parole di una frase [DBK+21]. Il compito è un indovinello: dato un solo blocco di contesto dell’immagine, prevedere che cosa c’è in quattro blocchi bersaglio nascosti. La novità è tutta nel che cosa si prevede: non i puntini dei blocchi mancanti, ma i loro riassunti, calcolati dalla copia lenta di poco fa. Quella copia prende la sigla di EMA (exponential moving average, media mobile esponenziale): è il nome tecnico per il mescolare, a ogni passo, un pochino dei numeri dell’allievo in quelli dell’insegnante.
È il gioco della cartolina strappata. Ti mostro una cartolina a cui mancano quattro rettangoli e ti chiedo: che cosa c’era lì? Non ti chiedo di ridisegnare i pezzi mancanti: quello sarebbe il compito generativo, e ti costringerebbe a inventare dettagli che non puoi sapere. Ti chiedo di descriverli: «lì continua il muso del cane, girato verso destra». A correggerti è la copia lenta di te stesso, che ha visto la cartolina intera e ha scritto le sue descrizioni. Due dettagli fanno la differenza. Primo: i rettangoli nascosti sono grandi, per indovinare un pezzo grande devi aver capito la scena («è un cane, quindi là sotto c’è una zampa»), mentre per un buchino basta allungare i bordi, senza capire niente. Secondo: al modello non servono i trucchi artigianali con cui di solito si addestrano questi sistemi (versioni ritagliate, specchiate, ricolorate della stessa foto, scelte a mano da chi progetta). Basta l’indovinello. E i risultati danno ragione alla scommessa: con appena l’1% delle etichette di ImageNet (una dozzina di foto etichettate per categoria) I-JEPA classifica meglio dei metodi che ricostruiscono i pixel: 73 risposte giuste su cento contro poco più di 71. E ci arriva con molto meno calcolo. Quel risparmio è facile capirlo al contrario: non è che ogni passata sui dati costi meno (costa anzi un pelo di più, c’è una rete in più da far girare), è che di passate ne servono cinque volte meno.
L’encoder di contesto (un ViT) elabora solo le patch visibili del blocco di contesto; un predictor (un ViT più stretto) riceve \(\mathbf{s}_x\) e, per ciascuno dei \(M = 4\) blocchi bersaglio, token posizionali che indicano dove prevedere; la loss è la media sugli \(M\) blocchi delle distanze \(L_2\) al quadrato fra le rappresentazioni predette e quelle prodotte dall’encoder target:
dove \(B_i\) è l’insieme delle patch del blocco bersaglio \(i\), e \(\hat{\mathbf{s}}_{y,j}\) e \(\mathbf{s}_{y,j}\) sono le rappresentazioni predette e bersaglio della singola patch \(j\): il confronto avviene patch per patch, non fra due riassunti di blocco. V-JEPA e V-JEPA 2 sostituiscono poi la norma \(L_2\) al quadrato con la norma \(L_1\), che gli autori trovano più stabile [BGP+24], e in \(L_1\) è anche l’energia con cui V-JEPA 2 pianifica. Un dettaglio architetturale è decisivo: l’encoder target elabora l’immagine intera, e i bersagli si ottengono mascherando la sua uscita, non il suo ingresso; così ogni rappresentazione-bersaglio incorpora il contesto globale ed è semanticamente ricca. Niente augmentation artigianali: nessun crop multiplo, nessun jitter di colore. I numeri del paper [ADM+23]: su ImageNet-1K con l’1% delle etichette, un ViT-H/14 pre-addestrato con I-JEPA raggiunge il 73,3% di accuratezza top-1 (77,3% per il ViT-H/16 a risoluzione 448), contro il 71,5% di MAE (il metodo generativo che ricostruisce i pixel mascherati) e il 69,7% di iBOT (lì con un ViT-B/16, che è un modello molto più piccolo). Nella stessa tabella data2vec [BHX+22], che predice anch’esso le rappresentazioni di un maestro EMA invece dei pixel, arriva al 73,3% con un ViT-L/16, e MSN, che usa le augmentation, al 75,7%: il vantaggio netto di I-JEPA è sui metodi che ricostruiscono i pixel, non sull’intera famiglia che predice nel latente, di cui data2vec è un predecessore; e il pre-addestramento del ViT-H/14 richiede meno di 1200 ore-GPU (meno di 72 ore su 16 A100), oltre dieci volte meno di MAE a parità di architettura.
Il risparmio, però, non viene da dove sembra. Calcolare i bersagli nello spazio delle rappresentazioni, invece che nei pixel, aggiunge costo, perché c’è un secondo encoder da mandare avanti a ogni passo: il paper misura circa il 7% in più per iterazione. Quel che risparmia è il numero di iterazioni, di circa cinque volte (300 epoche di pre-addestramento contro le 1600 di MAE). Cinque volte meno passi non bastano però a fare un fattore dieci: quel rapporto confronta due addestramenti interi, che oltre alle epoche differiscono in ciò che sta attorno al backbone (un predictor fra embedding da una parte, un decoder di pixel dall’altra), non due costi per iterazione. Spostare il bersaglio nello spazio delle rappresentazioni non rende più economico il singolo passo, rende necessari molti meno passi.
Dal fotogramma al film: V-JEPA#
Le immagini erano il primo collaudo; il progetto di LeCun, però, parla di futuro, e il futuro vive nei video. V-JEPA [BGP+24] (2024) trasporta lo schema dalla dimensione spaziale a quella spazio-temporale, cioè aggiunge il tempo all’altezza e alla larghezza: si copre una regione del video (in gergo si dice mascherare) e se ne prevedono le rappresentazioni a partire dal resto.
C’è una finezza che rivela quanto i video siano un problema diverso. Un video è una pila di fotogrammi, e i vicini si somigliano quasi in tutto: se la maschera coprisse zone diverse in fotogrammi diversi, il modello potrebbe barare copiando dal fotogramma accanto quello che nel suo manca. La maschera è perciò un tubo: dentro una stessa clip la regione coperta sta ferma e attraversa la pila da parte a parte, come un foro che buca tutte le carte di un mazzo nello stesso punto (Fig. 31.6). Dove cade, quel foro, lo si sorteggia a ogni clip. Ed è una maschera generosa, perché in media copre circa il 90% del video, e il poco che resta non basta a completare i bordi di ciò che manca: per indovinare il resto bisogna aver capito la scena.
Due proprietà, però, non fanno una ricetta, e la differenza si paga cara. Coprire il 90% con tanti tubicini sottili sparsi lascia dappertutto un bordo da cui completare, e gli autori quella variante l’hanno provata: a riconoscere le azioni nei video, il modello che ne esce dà 51,5 risposte giuste su cento invece di 72,9 [BGP+24]. Quello che funziona sono blocchi grandi e contigui, ripetuti identici su tutta la clip, di due tipi: otto blocchi grandi ciascuno il 15% del fotogramma, oppure due blocchi grandi ciascuno il 70%; l’unione, dicono gli autori, copre in media il 90%. È la stessa ragione per cui sulle immagini i rettangoli nascosti sono grandi.
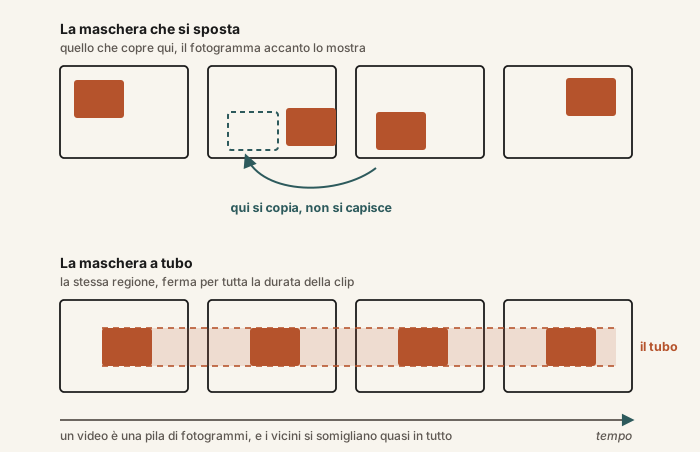
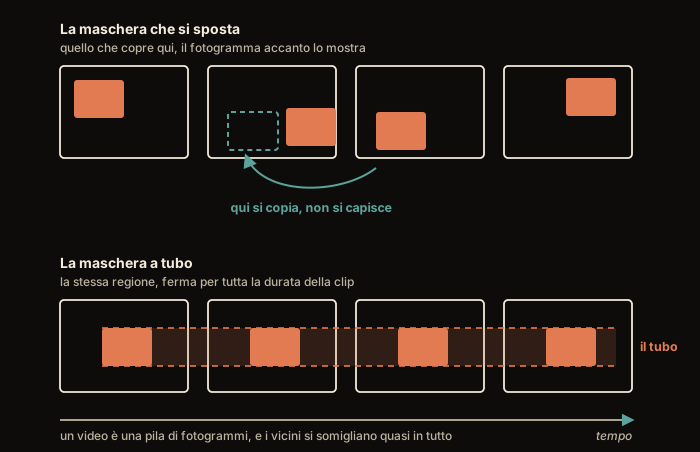
Fig. 31.6 Perché la maschera non si sposta. Sopra, una regione che cambia posto a ogni fotogramma: quello che nasconde in uno sta scoperto in quello accanto, e prevederlo è copiare. Sotto, la stessa regione tenuta ferma, che attraversa la clip da parte a parte: nessun fotogramma mostra quello che gli altri nascondono.#
Addestrato così su due milioni di video pubblici, senza etichette, senza testo e senza ricostruzione, V-JEPA produce rappresentazioni che a quel punto bisogna misurare, e il modo in cui le si misura conta quanto il risultato.
Come si controlla che cosa ha imparato un modello a cui nessuno ha insegnato niente? Prima si congela la rete, cioè la si blocca com’è e non la si addestra più, perché altrimenti non si saprebbe più che cosa sapeva prima dell’esame. Poi le si mette sopra un esaminatore, addestrato a parte, che riceve soltanto i riassunti e deve rispondere a una domanda utile: «che cosa sta facendo la persona in questo video?». Se ci riesce, l’informazione nei riassunti c’era.
Le collezioni di video su cui si dà l’esame sono sempre le stesse per tutti, così che i risultati di gruppi diversi si confrontino: si chiamano banchi di prova (in inglese benchmark), e qui sono due. Uno chiede di riconoscere che cosa succede nella scena: chi nuota, chi suona, chi taglia le verdure. L’altro, ed è quello che conta di più, misura la comprensione del movimento e non dell’aspetto: non basta riconoscere gli oggetti, bisogna distinguere «spingere qualcosa da sinistra a destra» da «spingere qualcosa da destra a sinistra», che sono la stessa scena al contrario. V-JEPA se la cava bene su tutti e due: otto risposte giuste su dieci sulla scena, sette su dieci sul movimento.
Un’avvertenza, però, e vale per tutti gli esami fatti così: più l’esaminatore è bravo, meno si capisce di chi sia il merito. Se è un programmino, quel che risponde lo ha trovato bell’e pronto nei riassunti; se è una rete capace, una parte del lavoro può averla fatta lui. E qui l’esaminatore è del secondo tipo: una piccola rete addestrata apposta, che nella versione successiva del sistema cresce ancora. Quindi quel «sette su dieci» dice quanto l’informazione sul movimento sia facile da tirare fuori dai riassunti, che non è la stessa cosa che dire che il modello «ha capito». Il confronto fra sistemi regge lo stesso, purché l’esaminatore sia identico per tutti: il punteggio si dà insieme al nome di chi ha corretto.
Con la rete congelata e una sonda addestrata a parte, V-JEPA raggiunge l’81,9% su Kinetics-400 (riconoscere l’azione: chi nuota, chi suona) e il 72,2% su Something-Something-v2, un banco di prova che richiede di capire il movimento («spingere qualcosa da sinistra a destra»), non solo l’aspetto.
La sonda del protocollo è un attentive probe, ben più di una testa lineare: uno strato di cross-attention con un token di query appreso, la cui uscita rientra nel token di query per connessione residua e passa in un MLP a due strati, poi in una LayerNorm e in un classificatore lineare. Rispetto alla semplice media delle feature, la sonda attentiva guadagna 17 punti su Kinetics-400 e 16,1 su Something-Something-v2 [BGP+24]. Uno strato di cross-attention è un aggregatore addestrato che decide quali token guardare, non un classificatore lineare: fra i due estremi «regressione logistica sopra feature congelate» e «fine-tuning completo» sta molto più vicino al secondo di quanto la parola «testa» lasci intendere. E in V-JEPA 2 la sonda cresce ancora: quattro blocchi transformer, l’ultimo dei quali sostituisce la self-attention con una cross-attention a query appresa. Quattro blocchi transformer sopra un backbone congelato formano un modello vero e proprio, più che una testa.
Da qui la cautela sulla lettura, ed è la stessa che la sezione sui simulatori e il dibattito applica al probing di Othello-GPT: il protocollo misura quanto le rappresentazioni congelate rendano estraibile l’informazione sul movimento, non quanto il modello la «capisca», e fra le due ipotesi (l’informazione c’era nel backbone, oppure a costruirla è stata la sonda) non distingue. Più la sonda è capace, meno il merito è attribuibile al solo backbone; il confronto fra metodi resta valido finché la sonda è la stessa per tutti, ed è per questo che il protocollo va dichiarato insieme al numero.
V-JEPA 2: il world model tocca il mondo#
Nel giugno 2025 arriva il passo successivo: usare il modello per agire. V-JEPA 2 [ABF+25] porta la ricetta su scala più grande, con un modello da oltre un miliardo di parametri addestrato su più di un milione di ore di video presi da internet, e i punteggi salgono di conseguenza. Sul banco di prova del movimento, quello dello «spingere da sinistra a destra», le risposte giuste passano da sette a quasi otto su dieci (77,3%, sul banco che porta il nome buffo di Something-Something-v2). Poi c’è un esame più difficile, l’anticipazione: guardando una cucina ripresa in soggettiva, indovinare che cosa farà la persona nel secondo che viene. Il modello può proporre cinque risposte, e conta quante volte quella giusta è fra le cinque; il punteggio fa poi la media sui tipi di azione, così che quelle rare pesino quanto quelle frequenti (in gergo è il recall@5). V-JEPA 2 arriva a 39,7 su cento; il miglior sistema precedente, otto volte più grosso, si fermava a 27,6. È un progresso grosso su un compito che resta largamente irrisolto, il che è già un buon motivo per diffidare di chi riassume queste cose con «ci riesce».
Ma la parte concettualmente nuova è V-JEPA 2-AC (action-conditioned, condizionato sulle azioni), ed è la parte in cui il capitolo arriva finalmente a un robot vero. Il meccanismo è quello dell’inizio, montato sopra un braccio meccanico: si dà al robot un’immagine-obiettivo (la tazza sopra il piatto), il modello immagina l’effetto di centinaia di comandi possibili e sceglie quello il cui esito previsto è più vicino all’obiettivo. Poi lo esegue, guarda com’è andata e ricomincia da capo, un comando alla volta. Dal progetto del 2022 la distanza è netta: là l’agente immaginava intere sequenze di azioni prima di muoversi, il robot vero ne immagina per ora una sola per volta, e già così ci mette sedici secondi. Immaginare prima, muovere poi: è il controllo predittivo su modello dell’apertura del capitolo, e questa volta il sistema controllato è un braccio robotico.
A questo robot nessuno mostra come si fa. Gli si fanno guardare delle registrazioni di bracci robotici al lavoro: una sessantina d’ore, prese da una raccolta pubblica che chiunque può scaricare (una raccolta di dati fatta apposta per addestrare si chiama dataset). Le registrazioni dicono anche come si è mosso il braccio istante per istante, perché è un’informazione che la macchina scrive da sé mentre lavora. Quel che nessuno ha annotato è tutto il resto: che compito si stesse svolgendo, se sia riuscito, se chi guidava fosse bravo. Quei video vengono descritti come «non etichettati», e vuol dire esattamente questo: manca il giudizio su che cosa si stesse facendo e su come è andata, non l’informazione sui movimenti. Il pezzo che guarda i video resta com’era, con quello che aveva imparato da internet: si addestra soltanto il pezzo che immagina l’effetto di un comando.
Poi lo si mette in due laboratori che non aveva mai visto, senza un solo minuto di pratica lì dentro. Si chiama zero-shot, «a colpo zero»: nemmeno un tentativo di prova.
Qui però serve la cifra, non l’aggettivo, perché «riesce» dice troppo. Raggiungere un punto gli riesce sempre. Posare un oggetto dove va, circa tre volte su quattro. Afferrare una tazza, due volte su tre. Afferrare una scatola, una volta su quattro. Posare, però, non gli riesce con una foto sola dell’obiettivo: gliene servono tre, e a sceglierle è una persona. E per ogni singolo gesto il robot passa sedici secondi a immaginare, perché non prova un comando alla volta: ne sorteggia ottocento, tiene i dieci il cui esito finisce più vicino all’obiettivo, e sorteggia gli ottocento del giro dopo tutti attorno a quei dieci. Dieci giri, ottomila futuri immaginati per muovere un dito. È un inizio notevole; non è un maggiordomo.
Sopra l’encoder congelato viene addestrato un predictor condizionato sulle azioni, usando meno di 62 ore di video del dataset pubblico DROID. La parola «non etichettati» che il paper usa è facilissima da fraintendere, perché le azioni ci sono eccome e sono l’ingrediente su cui poggia tutta la variante AC: il predictor riceve mappe di feature, stato dell’end-effector (posizione, tre angoli di Eulero, apertura della pinza) e azioni, interlacciati nel tempo, con l’azione definita come la variazione dello stato dell’end-effector fra fotogrammi adiacenti. Unlabeled, nel paper, vuol dire un’altra cosa, dichiarata a chiare lettere: nessun meta-dato su ricompensa, su quale compito fosse in corso, o su se il tentativo sia riuscito. È una distinzione che tornerà utile davanti a Genie, che le azioni davvero non ce le ha e deve inferirsele.
La pianificazione è controllo predittivo a orizzonte recedente. Con \(\mathbf{s}_k\) la rappresentazione del fotogramma corrente, \(\mathbf{e}_k\) lo stato dell’end-effector e \(\mathbf{s}_g\) la rappresentazione dell’immagine-obiettivo, si cerca
con \(g_\theta\) il predictor condizionato sulle azioni, srotolato per \(T\) passi. È un’energia della coppia (azioni, obiettivo), minimizzata sulle azioni come la JEPA generale la minimizzava sulla variabile latente [ABF+25]; se ne esegue soltanto la prima azione, si osserva il nuovo stato e si ripianifica. Il compito non è scritto come una ricompensa ma come un’immagine da raggiungere, cioè sta dentro l’energia: è la stessa scelta che l’inferenza attiva fa mettendo le preferenze nei priori del modello. A ottimizzare è il Cross-Entropy Method: si campionano 800 candidate da gaussiane, si tengono le dieci migliori, se ne ricalcolano media e varianza e si ripete per dieci giri. Nei compiti riportati l’orizzonte è \(T = 1\), cioè si ottimizza una sola azione per volta: gli autori lo dichiarano sufficiente perché i compiti considerati sono ingordi, e osservano che orizzonti più lunghi funzionano anch’essi ma costano di più. Il costo è 16 secondi di calcolo per ogni singola azione, su una sola scheda grafica da gioco. E i tassi di successo, medi sui due laboratori, dicono a che punto siamo davvero: reach 100%, pick-and-place della tazza 80% e della scatola 65%, presa della tazza 65%, presa della scatola 25%. Afferrare una scatola riesce una volta su quattro, e su numeri così piccoli il margine è largo: ogni percentuale è la media di dieci prove per laboratorio, cioè venti in tutto, e cinque successi su venti non distinguono un sistema che riesce una volta su dieci da uno che riesce quasi una volta su due. Il confronto, con lo stesso protocollo, dà la misura: Octo, addestrato per imitazione sullo stesso DROID, prende la tazza nel 15% dei casi, la scatola mai, e completa il pick-and-place nel 15% e nel 10%; Cosmos, un generatore di video usato come modello del mondo, impiega quattro minuti per ogni azione e nel secondo laboratorio non completa nessun pick-and-place. E il pick-and-place, che è il numero più alto, non si guida con un’immagine sola: gli autori ne danno tre (oggetto afferrato, oggetto vicino alla meta, oggetto posato) e passano dall’una all’altra a passi fissi. A scomporre l’obiettivo è una persona, ed è il conto che presenta l’orizzonte \(T = 1\): fra i limiti gli autori mettono proprio il pick-and-place senza sotto-obiettivi. Il sistema regge anche compiti di video question answering, una volta allineato con un modello di linguaggio. È il punto esatto in cui la via di LeCun smette di essere un diagramma e tocca, letteralmente, il mondo fisico; non è il punto in cui la partita è vinta.
Tre famiglie per imparare senza etichette#
Fermiamoci a mettere ordine, perché a questo punto i grandi modi di imparare senza annotatori umani li abbiamo incontrati tutti. Qui li si divide secondo dove avviene la previsione; il capitolo sull’auto-supervisione li divide secondo che cosa impedisce al modello di rispondere sempre la stessa cosa, e ne conta quattro. Sono due modi di tagliare gli stessi metodi, e ogni metodo ha un posto in tutti e due.
Tre studenti, stessi libri, nessun professore. Il primo studia ricopiando con i buchi: cancella pezzi del testo e si allena a riscriverli identici, parola per parola o pixel per pixel; è il metodo generativo, quello di BERT con le frasi (gli «esercizi a buchi» del capitolo sui Transformer) e di MAE con le foto (Masked Autoencoder, «autoencoder mascherato»: gli si copre un pezzo di immagine e deve ridisegnarlo). Il secondo studia col gioco delle coppie: mescola foto e didascalie e impara a dire quali vanno insieme e quali no; è il metodo contrastivo, quello di CLIP (Contrastive Language–Image Pre-training, addestramento per contrasto di lingua e immagini), che avvicina ogni immagine alla sua descrizione e la allontana dalle altre. Il terzo (la via JEPA) studia prevedendo il riassunto: copre un pezzo e, invece di ricopiarlo, ne prevede la descrizione, confrontandola con quella di una copia lenta di sé. Non è una classifica: ricopiare con i buchi ha vinto nel linguaggio, il gioco delle coppie ha unito immagini e parole, prevedere il riassunto scommette sul futuro e sul video. Sono tre risposte diverse alla stessa domanda: di ciò che manca, che cosa serve davvero prevedere?
Generativa: si ricostruisce l’input nello spazio dell’input. Il masked language modeling di BERT [DCLT19] predice i token mascherati con una cross-entropia sul vocabolario; MAE fa lo stesso con i pixel delle patch mascherate, con loss \(L_2\). Funziona magnificamente sul testo (dove i token sono discreti e la softmax rappresenta senza sforzo l’incertezza) e resta più goffa su segnali continui ad alta dimensione, dove l’equivalente della softmax non esiste e ricostruire costringe a modellare l’irrilevante: è l’argomento centrale di [LeC22]. Contrastiva: si impara una geometria, avvicinando le coppie compatibili e allontanando quelle incompatibili (CLIP [RKH+21] con la loss InfoNCE su coppie immagine–didascalia). Nel lessico dei modelli a energia: energia abbassata sulle coppie giuste e alzata esplicitamente sui controesempi, con la nota difficoltà di trovarne mai abbastanza in alta dimensione. Predittiva nello spazio latente: la famiglia JEPA; energia = errore di predizione tra embedding, nessuna ricostruzione, nessuna coppia negativa, collasso evitato per asimmetria architetturale (lo stop-gradient, con l’EMA a stabilizzare) o per regolarizzazione esplicita (varianza/covarianza), che è poi lo stesso mestiere che la famiglia contrastiva svolge per un’altra via, alzando l’energia sui controesempi. È la più giovane delle tre, e quella su cui pesa la scommessa più grossa.
Una scommessa aperta#
La via di LeCun è una linea di ricerca in corso, non un traguardo raggiunto. Le rappresentazioni JEPA reggono il confronto con i metodi concorrenti sui banchi di prova considerati, senza batterli sempre, e nel caso di I-JEPA contro MAE chiedono molto meno calcolo di pre-addestramento; V-JEPA 2-AC ha mostrato che un world model auto-supervisionato può guidare un braccio robotico in compiti semplici, con successi fra il 25% e il 100% secondo il compito. Ma dell’architettura a sei moduli del 2022 la maggior parte resta sulla carta: la JEPA gerarchica, cioè fatta a livelli, dove quello alto pianifica a grandi passi («esco di casa, vado alla stazione») e quelli sotto ne riempiono i dettagli, ciascuno sulla propria scala di tempo; il configuratore; il ragionamento a lungo orizzonte, cioè su catene lunghe di conseguenze.
I critici, dal canto loro, fanno notare che la storia recente non è stata tenera con le previsioni di insufficienza: i modelli generativi, cresciuti in taglia e in dati, continuano a mostrare capacità che quelle previsioni escludevano. Il loro argomento più forte è un esperimento, e lo racconta la sezione sui simulatori e il dibattito: un modello addestrato soltanto a indovinare la mossa successiva di un gioco da tavolo si costruisce dentro una rappresentazione della scacchiera, e la usa [LHB+23]. Va presa con cautela, invece, l’idea che la coerenza fisica dei generatori di video migliori da sé man mano che li si ingrandisce: per i sistemi più spinti le fonti sono annunci aziendali con dimostrazioni scelte, e l’affermazione va verificata, non concessa. Se per capire il mondo serva davvero smettere di generarlo, o se generare sia un modo di capire, è esattamente la domanda su cui il campo è spaccato, e LeCun, come ricordato in apertura di capitolo, ci ha legato la propria carriera. Il fronte opposto del dibattito (i simulatori generativi di video, da Sora a Genie, e la domanda se un modello che disegna futuri plausibili abbia capito la fisica o abbia solo imparato a imitarla) lo attraversa la sezione sui simulatori.
Una mini-JEPA in PyTorch#
Tutti i pezzi della sezione (encoder, copia lenta EMA, predictor, loss fra embedding) stanno in una pagina di PyTorch. L’esperimento è in miniatura: ogni «immagine» è una scena finta fatta di 8 patch, cioè di 8 tessere, come quelle in cui un Vision Transformer taglia un’immagine; qui le tessere nascono da un contenuto comune più rumore. Il modello vede 6 tessere di contesto e deve prevedere l’embedding, non i valori, delle 2 tessere coperte. Il bersaglio lo calcola la copia lenta, e non riceve gradiente: quel gesto si chiama stop-gradient, ed è la traduzione in codice dell’insegnante che non può lamentarsi del voto.
import copy
import torch
from torch import nn

torch.manual_seed(0)

DIM_PATCH, DIM_EMB = 16, 32
N_PATCH, N_CONTESTO = 8, 6          # per scena: 6 patch visibili, 2 mascherate

# Mappa fissa dal "contenuto" della scena all'aspetto delle patch
PROIEZIONE = torch.randn(4, DIM_PATCH)

def genera_batch(n=256):
    """Ogni scena nasce da un contenuto nascosto comune alle sue 8 patch."""
    contenuto = torch.randn(n, 1, 4)               # il "succo" della scena
    patch = contenuto @ PROIEZIONE                 # come il succo appare
    return patch + 0.25 * torch.randn(n, N_PATCH, DIM_PATCH)  # dettagli casuali

# Encoder (l'allievo), predictor, ed encoder target (la copia lenta)
encoder = nn.Sequential(
    nn.Linear(DIM_PATCH, 64), nn.ReLU(), nn.Linear(64, DIM_EMB))
predictor = nn.Sequential(
    nn.Linear(DIM_EMB, 64), nn.ReLU(), nn.Linear(64, DIM_EMB))

encoder_target = copy.deepcopy(encoder)
for p in encoder_target.parameters():
    p.requires_grad_(False)          # stop-gradient: il bersaglio non si allena

@torch.no_grad()
def aggiorna_target(m=0.996):
    """EMA: il target insegue lentamente l'encoder, e non ne riceve mai
    il gradiente. Quel 'mai' è la difesa dal collasso: senza gradiente il
    target non può accordarsi con l'encoder per appiattire tutti gli
    embedding sulla stessa costante. L'EMA aggiunge la lentezza."""
    for p, p_t in zip(encoder.parameters(), encoder_target.parameters()):
        p_t.mul_(m).add_((1.0 - m) * p)

opt = torch.optim.Adam(
    list(encoder.parameters()) + list(predictor.parameters()), lr=1e-3)

for passo in range(1, 601):
    patch = genera_batch()                          # (256, 8, 16)
    # contesto -> embedding riassuntivo (media delle 6 patch visibili)
    s_x = encoder(patch[:, :N_CONTESTO]).mean(dim=1)        # (256, 32)
    # target -> embedding calcolato dalla copia lenta, senza gradiente
    with torch.no_grad():
        s_y = encoder_target(patch[:, N_CONTESTO:]).mean(dim=1)  # (256, 32)
    s_y_pred = predictor(s_x)                       # predizione tra embedding
    loss = nn.functional.mse_loss(s_y_pred, s_y)    # voto fra riassunti

    opt.zero_grad()
    loss.backward()
    opt.step()
    aggiorna_target()                               # un passetto di EMA

    if passo in (1, 100, 200, 400, 600):
        # se gli embedding collassassero, questa varietà scenderebbe verso 0
        varieta = s_y.std(dim=0).mean().item()
        print(f"passo {passo}: loss {loss.item():.2g}  "
              f"varietà degli embedding {varieta:.2f}")
passo 1: loss 0.23  varietà degli embedding 0.38
passo 100: loss 0.0094  varietà degli embedding 0.46
passo 200: loss 0.0054  varietà degli embedding 0.57
passo 400: loss 0.0052  varietà degli embedding 0.77
passo 600: loss 0.0068  varietà degli embedding 1.00
In un centinaio di passi la loss crolla, da 0,23 a meno di 0,01. Nel frattempo la «varietà» degli embedding, cioè quanto i riassunti di scene diverse restano diversi fra loro (la deviazione standard di ogni componente sul batch, mediata sulle 32), non scende verso zero, che è quel che farebbe se le rappresentazioni si stessero appiattendo: passa da 0,38 a 1,00. Il modello impara a prevedere il contenuto delle tessere coperte, che è condiviso con il contesto, e ignora il rumore, che non è prevedibile.
Quale dei pezzi regga davvero il risultato, però, non lo dicono questi numeri: lo si vede spegnendo i pezzi uno alla volta, e ripetendo ogni prova con tre semi diversi.
import statistics

def prova(togli=(), seme=0, passi=600):
    """La mini-JEPA rifatta da capo, senza i pezzi nominati in `togli`."""
    torch.manual_seed(seme)
    proiezione = torch.randn(4, DIM_PATCH)
    enc = nn.Sequential(
        nn.Linear(DIM_PATCH, 64), nn.ReLU(), nn.Linear(64, DIM_EMB))
    pred = nn.Sequential(
        nn.Linear(DIM_EMB, 64), nn.ReLU(), nn.Linear(64, DIM_EMB))
    enc_lento = copy.deepcopy(enc).requires_grad_(False)
    opt = torch.optim.Adam([*enc.parameters(), *pred.parameters()], lr=1e-3)
    for _ in range(passi):
        patch = (torch.randn(256, 1, 4) @ proiezione
                 + 0.25 * torch.randn(256, N_PATCH, DIM_PATCH))
        s_x = enc(patch[:, :N_CONTESTO]).mean(dim=1)
        maestro = enc if "EMA" in togli else enc_lento  # senza EMA: l'allievo
        with torch.set_grad_enabled("stop-gradient" in togli):
            s_y = maestro(patch[:, N_CONTESTO:]).mean(dim=1)
        s_y_pred = s_x if "predictor" in togli else pred(s_x)
        loss = nn.functional.mse_loss(s_y_pred, s_y)
        opt.zero_grad()
        loss.backward()
        opt.step()
        with torch.no_grad():                           # il passetto di EMA
            for p, p_l in zip(enc.parameters(), enc_lento.parameters()):
                p_l.mul_(0.996).add_(0.004 * p)
    return loss.item(), s_y.std(dim=0).mean().item()

for togli in [(), ("EMA",), ("EMA", "stop-gradient"), ("predictor",)]:
    esiti = [prova(togli, seme) for seme in range(3)]
    nome = " e ".join(togli) or "niente"
    varieta = "  ".join(f"{v:.2f}" for _, v in esiti)
    loss = statistics.mean(l for l, _ in esiti)
    print(f"tolto {nome:<21} loss {loss:<7.1g} varietà: {varieta}")
tolto niente                loss 0.006   varietà: 1.00  0.82  0.88
tolto EMA                   loss 0.02    varietà: 1.64  1.51  1.65
tolto EMA e stop-gradient   loss 0.0005  varietà: 0.05  0.05  0.05
tolto predictor             loss 0.001   varietà: 0.39  0.36  0.37
Togliere la copia lenta, cioè calcolare il bersaglio con l’allievo stesso ma sempre senza gradiente, non fa collassare niente: la varietà sale anzi sopra 1,5, che in un giocattolo del genere non vuol dire rappresentazioni migliori. Togliere insieme la copia lenta e lo stop-gradient rimette i due rami nella stessa rete, libera di accordarsi con sé stessa: la loss scende a cinque decimillesimi e la varietà crolla a 0,05, cioè scene diverse finiscono per avere quasi lo stesso riassunto. È il collasso, l’energia zero ovunque di cui parlava la sezione. Togliere il predictor, invece, qui non fa collassare: la varietà resta dov’era all’inizio, attorno a 0,4, e non cresce. Il giocattolo mostra quindi il ruolo dello stop-gradient, non quello del predictor, che lo documenta SimSiam su dati veri, dove togliere l’uno o l’altro fa collassare [CH21].
Una cautela, infine, sulla misura stessa. La varietà è una deviazione standard media, e vede il collasso completo; non vede quello parziale, in cui gli embedding restano diversi fra loro ma si schiacciano su poche direzioni dello spazio. Quel collasso più sottile, e le misure che lo vedono, li tratta la sezione sul collasso e la sua misura.
Ciò che qui manca è la scala: un Vision Transformer al posto delle due piccole reti, l’indicazione di dove sta ogni tessera da prevedere, milioni di immagini e di ore di video. La logica è la stessa.
Da ricordare
Nel 2022 LeCun mette online un documento di 62 pagine [LeC22] che non contiene nessun risultato: è un progetto, il disegno di come dovrebbe essere fatta secondo lui una macchina che capisce il mondo. Sei pezzi, e al centro un modello del mondo che impara guardando, senza che nessuno gli spieghi niente.
Prevedere l’immagine esatta è la strada sbagliata, ed è la storia del bicchiere in bilico: il futuro può andare in mille modi e nessuna decisione dipende dalla forma della terza scheggia, quindi un modello obbligato a disegnare una foto finisce per disegnare la media sfocata di tutte. La proposta è prevedere il succo, non la foto.
Il pericolo di prevedere il succo è che allievo e insegnante si accordino per rispondere sempre «boh»: si chiama collasso. A impedirlo sono due accortezze insieme: l’insegnante non riceve mai lamentele sul voto, quindi non può accordarsi al ribasso, e l’allievo passa la sua descrizione per un traduttore che l’insegnante non ha. Che l’insegnante sia anche una copia lenta dell’allievo aiuta: chi ha costruito le JEPA non la toglie, ma in un altro sistema è stata tolta senza danni, e in un terzo no.
La prova sulle immagini è il gioco della cartolina strappata: si coprono quattro rettangoli grandi e si chiede di descriverli, non di ridisegnarli. Funziona, e impara con molto meno calcolo dei metodi che ridisegnano; ma non perché ogni passo costi meno, perché ne servono molti meno.
Sui video la copertura diventa un tubo, ferma nello stesso punto per tutta la clip, così che il modello non possa copiare dal fotogramma accanto. E l’ultima versione arriva a guidare un braccio robotico in due laboratori mai visti, con un’immagine dell’obiettivo al posto delle istruzioni: immagina prima, muove poi. Con i piedi per terra, però: afferrare una tazza gli riesce due volte su tre, una scatola una volta su quattro, e ogni gesto gli costa sedici secondi di calcolo.
Tre modi di studiare senza professore, e sono tre studenti diversi: ricopiare con i buchi, il gioco delle coppie, prevedere il riassunto. Prevedere il riassunto è la via JEPA, ed è la più giovane delle tre. L’altra campana, quella di chi scommette sul generare, suona nella sezione sui simulatori.
Da ricordare
Nel 2022 LeCun pubblica su OpenReview A Path Towards Autonomous Machine Intelligence [LeC22]: non un paper di risultati ma un progetto di architettura; sei moduli (percezione, world model, costo, attore, memoria a breve termine, configuratore) attorno a un world model appreso per auto-supervisione.
Predire nei pixel è la strada sbagliata: il futuro è molteplice e pieno di dettagli irrilevanti; la minimizzazione dell’errore quadratico produce la media sfocata dei futuri. La JEPA predice nello spazio delle rappresentazioni: è un’architettura a energia non normalizzata, dove l’energia è l’errore di predizione tra embedding. Che l’encoder del target scarti l’irrilevante e non il segnale l’architettura lo permette, non lo garantisce.
Il pericolo è il solito collasso (embedding costanti, energia bassa ovunque); la difesa dei sistemi reali è l’asimmetria fra i due rami, fatta di tre pezzi (EMA, stop-gradient, predictor su un ramo solo). All’EMA si rinuncia a certe condizioni: SimSiam la toglie senza collassare, con qualche punto di accuratezza in meno, mentre BYOL senza EMA collassa se non si accelera il predictor. Stop-gradient e predictor servono invece insieme: in SimSiam togliere l’uno o l’altro fa collassare [CH21, TCG21]; nella mini-JEPA basta lo stop-gradient, e il ruolo del predictor non si vede. L’alternativa senza asimmetria è la regolarizzazione esplicita alla VICReg (varianza per componente sopra una soglia, covarianze fuori diagonale penalizzate).
I-JEPA [ADM+23] (CVPR 2023): un ViT predice le rappresentazioni di quattro blocchi mascherati dal contesto; niente augmentation artigianali; con l’1% delle etichette di ImageNet batte i metodi a ricostruzione di pixel (73,3% contro 71,5% di MAE) con oltre dieci volte meno calcolo. Non per un costo unitario più basso: il singolo passo costa il 7% in più, i passi sono cinque volte meno, e il fattore dieci confronta due addestramenti interi, non due iterazioni.
V-JEPA [BGP+24] porta lo schema al video (maschere a blocchi contigui estesi su tutta la clip, che coprono in media il 90%; loss \(L_1\)); V-JEPA 2 [ABF+25] scala a oltre un milione di ore di video e, con meno di 62 ore di video DROID privi di annotazione su compito, ricompensa ed esito (ma con le azioni registrate), ottiene pianificazione robotica zero-shot su bracci Franka mai visti, minimizzando sulle azioni la distanza \(L_1\) fra rappresentazione predetta e immagine-obiettivo: successo fra il 25% e il 100% secondo il compito, su venti prove per compito, con 16 secondi di calcolo per azione.
I numeri a rete congelata vanno letti insieme al protocollo: la sonda è un attentive probe (per V-JEPA 2, quattro blocchi transformer), quindi misurano quanto l’informazione sia estraibile, non quanto il modello «capisca».
Tre famiglie di auto-supervisione, classificate secondo dove avviene la previsione: generativa (ricostruisci il dato: BERT, MAE), contrastiva (avvicina/allontana: CLIP), predittiva nello spazio latente (JEPA). È un asse diverso da quello del capitolo sull’auto-supervisione, che taglia invece secondo che cosa impedisce il collasso e ottiene quattro famiglie: i due elenchi non si contraddicono, si incrociano. La partita tra generare e predire-nelle-idee è aperta: l’altra sponda la visita la sezione sui simulatori.
Prima dei simulatori, una deviazione nelle neuroscienze: l’inferenza attiva, che alla stessa domanda risponde da tutt’altra parte.