


Rumore e ritorno: come funziona la diffusione#
Facciamo un gioco. Ti mostro una fotografia su cui ho sparso un pulviscolo di puntini casuali e ti faccio una domanda sola: quanto disturbo ho aggiunto? Non ti chiedo di ridipingere la foto, né di dirmi cosa rappresenta: solo di indicare il pulviscolo, punto per punto. Sembra una richiesta modesta, ed è invece quella che regge tutto il capitolo, perché chi sa rispondere sa da che parte tirare per ripulire. Non «basta togliere», si vedrà: è più sottile. Ma il verso giusto è quello.
Adesso ripetiamo il gioco per mille livelli di rovina, dalla grana appena percettibile al pulviscolo che ha inghiottito tutto. Mille non è un numero sacro (con DDIM si scende a un centinaio, o a venti) ma è quello del lavoro che ha reso famoso il metodo, e per adesso teniamolo. Chi sa rispondere a ogni livello ha in mano qualcosa di più di un restauratore: ha una scala. Può prendere del pulviscolo qualsiasi, dirsi «questo è il livello mille», chiedersi quanto disturbo c’è sopra, toglierne un pochino e ritrovarsi al livello 999; e così, gradino dopo gradino, arrivare al livello zero, che è quello senza disturbo. Sotto quel pulviscolo non c’era nessuna fotografia, eppure alla fine della scala una fotografia c’è, ed è nuova; e quale fotografia esca lo decide il pulviscolo di partenza, sorteggiato e sempre diverso.
Smontiamolo pezzo per pezzo. Cominciamo dal verso facile, quello che rovina la fotografia; poi il verso difficile, quello che si impara; e la Fig. 27.3 è la mappa dei due.

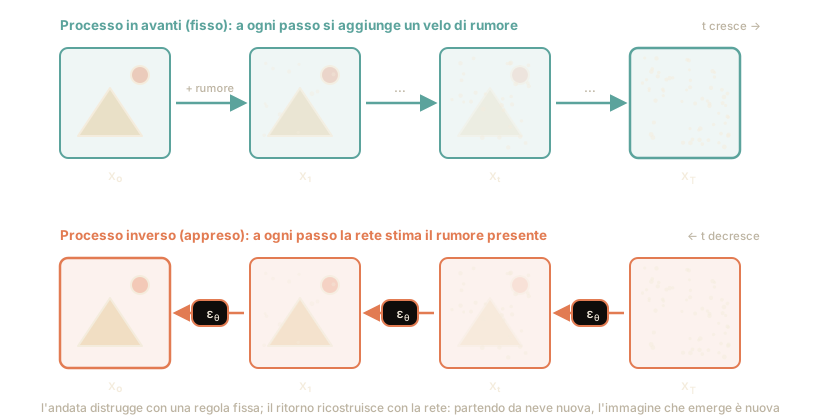
Fig. 27.3 I due processi della diffusione: l’andata (in alto) rovina l’immagine di partenza fino al rumore puro, seguendo una ricetta fissa; il ritorno (in basso) risale la catena un gradino alla volta, e a ogni gradino è una rete a dire dove sta il disturbo.#
L’andata: rovinare con metodo#
Il processo in avanti non si impara: è una ricetta fissa, la esegue un generatore di numeri casuali. Ma è una distruzione dosata e non qualsiasi, e i dosaggi sono scelti con cura, perché è su di essi che il ritorno farà affidamento.
L’ingrediente è sempre lo stesso: numeri sorteggiati dalla campana di Gauss, la distribuzione normale incontrata nei richiami di statistica. È la curva che descrive il modo più comune in cui i valori si distribuiscono attorno a una media: quasi tutti vicini allo zero, qualcuno un po’ più in là, quasi nessuno lontanissimo. E non è una scelta di comodo, perché questa curva ha una proprietà rara: sommare mille sorteggi da una campana di Gauss dà ancora un sorteggio da una campana di Gauss, solo più larga. È su questo che poggia tutto il resto della sezione.
Sotto una fotografia in bianco e nero c’è una griglia di numeri, 0 per il nero e 1 per il bianco. (Nella pratica la scala si sposta, e si usa \(-1\) per il nero e \(+1\) per il bianco, così che i valori stiano attorno allo zero come il rumore che ci si somma; a noi 0 e 1 tornano più comodi, e non cambia niente.) Seguiamo un solo pixel, un grigio chiaro che vale 0,8. A ogni passo la ricetta gli fa due gesti:
attenua il valore, moltiplicandolo per un numero appena sotto 1. Nel passo che prendiamo a esempio è 0,99, e il pixel scende a \(0{,}8 \times 0{,}99 = 0{,}792\);
aggiunge un piccolo numero sorteggiato dalla campana di Gauss, rimpicciolito di un fattore piccolo, qui 0,14. Se il sorteggio dà \(-0{,}7\), il contributo è \(-0{,}7 \times 0{,}14 \approx -0{,}10\), e il pixel finisce a circa \(0{,}69\). Con un sorteggio diverso, poniamo \(+0{,}3\), sarebbe finito a circa \(0{,}83\).
Il numero 0,99 non è lo stesso a tutti i passi. Al passo 1 la ricetta ha la mano leggerissima, un fattore di 0,99995, cioè quasi 1, che non si vede nemmeno; poi cala, fino a 0,99 al passo 1000. Prendiamo 0,99 come campione perché è il più marcato, quello in cui il gesto si vede meglio. E il sorteggio può dare numeri negativi, quindi il pixel può scendere sotto lo zero o salire sopra l’uno. Non è un errore: da qui in avanti la griglia è una lista di numeri su cui si lavora, e tornerà un’immagine da mostrare solo alla fine del viaggio di ritorno.
Perché anche l’attenuazione, e non solo il rumore? Una tazza di caffè resta sempre piena: a ogni giro si toglie un cucchiaino di caffè e se ne versa uno di latte. Il livello non cambia mai, ma il contenuto vira, giro dopo giro, dal caffè al latte. Il caffè è l’immagine e il latte è il rumore, e dopo mille giri nella tazza c’è solo latte. Il livello fermo evita il guaio opposto, cioè numeri che a forza di sommarsi diventano enormi e trascinano con sé tutto quello che viene dopo: la ricetta sporca la foto, non la fa esplodere.
Con quel fattore di 0,99 ripetuto mille volte, del nostro 0,8 resterebbe \(0{,}8 \times 0{,}99^{1000}\), tre centomillesimi e mezzo: nulla. Nella ricetta vera il fattore è più gentile all’inizio, e del pixel sopravvive circa un centocinquantesimo, mezzo centesimo su 0,8. Ed è successo a tutti i pixel insieme: la foto è diventata pulviscolo che non ricorda niente di ciò che era. Questa ricetta, però, il caffè lo toglie perfino troppo presto: al passo 700 del pixel resta l’8%, e gli ultimi passi versano latte nel latte, tanto che se ne potrebbe saltare fino a un quinto senza perdere granché; per questo le ricette venute dopo dosano i giri in modo che il caffè cali a un ritmo più regolare lungo tutta la catena.
Resta da capire da dove escono 0,99 e 0,14, ed è qui che la tazza smette di somigliare alla cosa vera. In una tazza vera, se togli 0,01 di caffè versi 0,01 di latte; nella ricetta di latte se ne versa quattordici volte tanto, e la tazza non trabocca. Il rumore sorteggiato, infatti, non si accumula come una quantità ordinaria. Fai mille passi da un metro tutti nella stessa direzione e ti ritrovi a un chilometro; falli in direzioni sorteggiate a caso e ti ritrovi a una trentina di metri, perché ogni passo disfa in parte quello di prima. La trentina è la radice quadrata di mille, 31,6: con i passi a caso a sommarsi non sono le lunghezze ma i loro quadrati (mille passi da un metro fanno mille «metri quadrati», e la distanza è la radice di quella somma). Il pizzico sorteggiato non sa niente del pixel su cui cade, come il passo a caso non sa niente di quelli prima, quindi la tazza obbedisce alla stessa regola: a restare costante è la somma dei quadrati, \(0{,}99^2 + 0{,}14^2 = 0{,}9801 + 0{,}0196 \approx 1\). Chi decide quanto attenuare ha già deciso, senza poter fare altrimenti, quanto latte versare.
Per portare una fotografia al livello di rovina 700, infine, non serve versare settecento volte. I settecento pizzichi presi dalla stessa campana, ciascuno attenuato dai giri che gli vengono dopo, sommati danno ancora un pizzico da quella campana, solo più grosso: si rimpiazzano con un unico pizzico grosso, e le settecento attenuazioni con un’unica moltiplicazione.
Il processo diretto è la catena di Markov già dichiarata all’apertura del capitolo:
dove \(\mathbf{x}_t\) è il dato al passo \(t\), \(\beta_t \in (0,1)\) è la varianza del rumore iniettato al passo \(t\) e \(\mathbf{I}\) è la matrice identità. La successione \(\beta_1, \dots, \beta_T\) è lo schedule: in DDPM è lineare, da \(\beta_1 = 10^{-4}\) a \(\beta_T = 0{,}02\) su \(T = 1000\) passi (veli sottilissimi all’inizio, più decisi verso la fine). Nessun parametro appreso: \(q\) è fissata una volta per tutte. Lo schedule lineare ha un difetto che la Fig. 27.4 lascia intravedere: a \(t = 700\) del segnale resta l’8% dell’ampiezza, e gli ultimi passi della catena lavorano su rumore quasi puro, tanto che se ne può saltare fino a un quinto senza perdere granché; a bassa risoluzione il difetto pesa di più. Nichol e Dhariwal [ND21] definiscono allora lo schedule direttamente su \(\bar{\alpha}_t\),
con \(\beta_t = 1 - \bar{\alpha}_t/\bar{\alpha}_{t-1}\) troncato a \(0{,}999\) perché l’ultimo passo non esploda: \(\bar{\alpha}_t\) scende quasi linearmente nel tratto centrale e resta piatto ai due capi. Nello stesso lavoro la varianza del passo inverso smette di essere fissata e si apprende come interpolazione in scala logaritmica fra \(\beta_t\) e la varianza del posteriore \(\tilde{\beta}_t\), il che migliora la verosimiglianza e regge il campionamento con meno passi.
Definendo \(\alpha_t = 1-\beta_t\) e \(\bar{\alpha}_t = \prod_{i=1}^{t} \alpha_i\), la catena ammette una forma chiusa che salta direttamente da \(\mathbf{x}_0\) a qualunque \(\mathbf{x}_t\):
con \(\boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\); qui \(\sqrt{\bar{\alpha}_t}\) è la frazione di segnale originale sopravvissuta al passo \(t\), \(\bar{\alpha}_t\) la sua varianza e \(1-\bar{\alpha}_t\) la varianza del rumore accumulato. La forma chiusa esiste perché la somma di gaussiane indipendenti è ancora gaussiana (richiami di statistica): componendo un passo dopo l’altro, i coefficienti del segnale si moltiplicano e la varianza si accumula secondo la ricorrenza \(v_t = \alpha_t\, v_{t-1} + \beta_t\) (ogni iniezione viene attenuata da tutti i passi successivi, non sommata tale e quale), la cui soluzione è appunto \(1-\bar{\alpha}_t\). E i dosaggi sono calibrati perché la scala resti stabile: se \(\mathbf{x}_0\) ha varianza unitaria, \(\mathrm{Var}(\mathbf{x}_t) = \bar{\alpha}_t + (1-\bar{\alpha}_t) = 1\) a ogni passo (il processo è variance-preserving). Con lo schedule di DDPM, \(\bar{\alpha}_T \approx 4 \cdot 10^{-5}\): al passo finale \(q(\mathbf{x}_T \mid \mathbf{x}_0) \approx \mathcal{N}(\mathbf{0}, \mathbf{I})\) per qualunque \(\mathbf{x}_0\), cioè \(\mathbf{x}_T\) è rumore gaussiano puro, indipendente dal dato di partenza.
La catena ha una scorciatoia, la forma chiusa \(q(\mathbf{x}_t \mid \mathbf{x}_0)\), che si legge «\(q\) di \(\mathbf{x}_t\) dato \(\mathbf{x}_0\)»: la distribuzione del fotogramma al livello \(t\), sapendo da quale fotografia si è partiti, scritta con una formula sola invece che come il risultato di \(t\) passi. È lei a rendere il metodo praticabile: al livello 700 si arriva con un solo sorteggio del rumore \(\boldsymbol{\epsilon}\) e una combinazione lineare, invece di settecento passi.
Ogni livello \(t\) è quindi descritto da due coefficienti, l’ampiezza del segnale sopravvissuto, \(\sqrt{\bar{\alpha}_t}\), e quella del rumore che lo copre, \(\sqrt{1-\bar{\alpha}_t}\), entrambi fissati dallo schedule (la tabella dei dosaggi, decisa prima ancora di cominciare): l’andata si può guardare tutta in una volta, come una manopola con mille tacche, una per livello. A essere sorteggiato ogni volta è soltanto \(\boldsymbol{\epsilon}\), cioè quali puntini escono; quanto forti sono lo decide la tacca. La Fig. 27.4 mostra i due coefficienti a sei tacche.

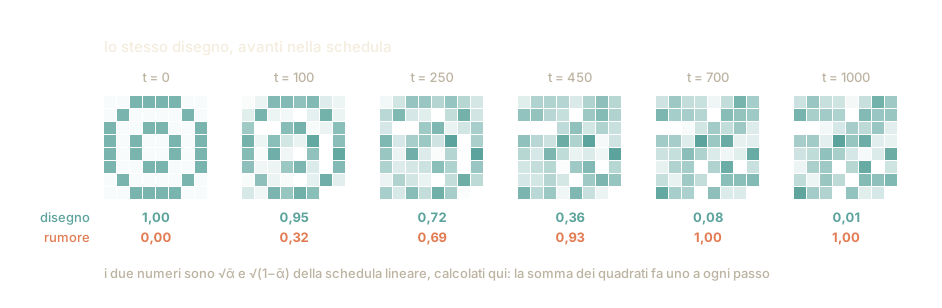
Fig. 27.4 Il verso facile, in sei tacche della manopola. Sotto ogni riquadro i due coefficienti: quanto disegno è rimasto e quanto disturbo c’è sopra. Non sono due fette di una torta, e infatti sommate non fanno 1: a fare 1 sono i loro quadrati, \(0{,}95^2 + 0{,}32^2 \approx 1\). La cosa più utile della figura è dove si incontrano, cioè poco dopo la tacca 250 e non a metà catena: già alla 450 del disegno è rimasto un terzo, e da lì in poi la manopola aggiunge poco perché non c’è quasi più niente da coprire.#
Il ritorno, che è la parte difficile, la figura non lo mostra, e non è una dimenticanza: percorrere quei sei riquadri da destra a sinistra è esattamente il compito che nessuna formula sa svolgere, ed è il motivo per cui serve una rete.
Il ritorno: indovinare il disturbo#
Ora entra in scena l’unica cosa che si impara: una rete neurale che riceve due cose soltanto, l’immagine rovinata e il numero del passo a cui è stata rovinata, e deve rispondere alla domanda del nostro gioco: quanto rumore è stato aggiunto? Non le si chiede com’era la foto pulita, le si chiede il rumore. È una scelta meno ovvia di quanto sembri, ed è uno dei motivi per cui DDPM [HJA20] funziona così bene. (Il nome per esteso è Denoising Diffusion Probabilistic Models, «modelli probabilistici di diffusione che tolgono il rumore»; nel resto del capitolo useremo la sigla.)
Il rumore da indicare è quello della forma chiusa, il \(\boldsymbol{\epsilon}\) con cui la manopola è arrivata alla tacca \(t\) in un colpo solo, e la risposta è una mappa del disturbo, un numero per pixel.
L’addestramento è un mazzo di carte per il ripasso, con le soluzioni sul retro. Una carta si prepara così: pesca una foto vera dall’archivio, pesca un livello di rovina a caso (poniamo il passo 700 su 1000), sorteggia il pulviscolo di disturbo e mescola i tre ingredienti in un colpo solo, con la scorciatoia dell’andata. Sul fronte della carta: la foto rovinata e il numero 700. Sul retro: il pulviscolo esatto che è stato usato, che conosciamo alla perfezione perché l’abbiamo fabbricato noi un istante fa.
La rete guarda il fronte e propone la sua risposta, un numero per ogni pixel. Poi si gira la carta e si dà il voto: per ogni pixel si guarda di quanto la risposta è lontana da quella del retro, si elevano al quadrato tutte queste distanze (perché contino uguale se si sbaglia in più o in meno) e se ne fa la media. Se per un pixel la rete dice 0,3 e il retro dice 0,5, la distanza è 0,2, e al quadrato 0,04. Il voto vale zero se la rete ha indovinato tutto e cresce quanto più sbaglia; addestrare vuol dire farlo scendere, ritoccando poco alla volta i pesi, cioè i milioni di numeri che la rete si porta dentro e che decidono le sue risposte. Milioni di carte dopo, la rete sa rispondere a ogni livello di rovina.
Sul retro, però, si poteva scrivere anche la foto pulita. Perché il disturbo? A prima vista la foto sembra la domanda più difficile: davanti alla carta del passo 900, una schermata quasi tutta di rumore, «dimmi la foto originale» è una richiesta da veggente. Ma chi conosce il disturbo, e sa a quale tacca della manopola si trova, ricava la foto: toglie il disturbo e ingrandisce quello che resta, i due gesti dell’andata rifatti al contrario. Le due domande sono difficili allo stesso modo, e al passo 900 la rete non indovina né l’una né l’altra: dà la risposta migliore che può, e sbaglia un po’.
La differenza la fa il voto, che conta tutte le carte allo stesso modo: uno sbaglio da un centesimo pesa uguale sulla carta del passo 10 e su quella del passo 1000. Solo che uno sbaglio sul disturbo e uno sbaglio sulla foto non valgono uguale, e il cambio fra i due varia lungo la scala. Sulla carta del passo 1000 del disegno sopravvivono poco più di sei millesimi: per ricavare la foto dal disturbo bisogna dividere per sei millesimi, cioè moltiplicare per quasi centosessanta, e uno sbaglio da un centesimo sul disturbo diventa uno sbaglio di più di un’unità e mezza sulla foto. Sulla carta del passo 1 il cambio va al contrario: di disturbo ne è stato aggiunto appena un centesimo, e per ricavarlo dalla foto bisogna dividere per quel centesimo, quindi uno sbaglio piccolo sulla foto diventa cento volte più grosso sul disturbo.
Scegliere che cosa scrivere sul retro, quindi, vuol dire scegliere quali carte pesano. Con il disturbo sul retro il voto è severo con le carte poco rovinate, dove uno sbaglio sulla foto si paga cento volte tanto, e indulgente con quelle molto rovinate, dove anche uno sbaglio grosso sulla foto costa poco: proprio dove la foto non si potrebbe comunque ricostruire. Con la foto sul retro succederebbe il contrario. Fra le scelte che DDPM ha provato, con quel voto uguale per tutte le carte, quella sul disturbo ha dato le immagini migliori. La foto sul retro non è sbagliata in sé: funziona altrettanto bene se nel voto si dà a ogni livello di rovina un peso diverso, scelto apposta per correggere il cambio.
Da qui in avanti questa rete si chiamerà \(\boldsymbol{\epsilon}_\theta\), che è il nome che le dà la letteratura: la lettera greca epsilon è il rumore, il pedice theta ricorda che dietro c’è una rete con dei pesi da imparare. Scritta con gli ingressi accanto, \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\) si legge «il rumore che la rete stima nell’immagine \(\mathbf{x}_t\), sapendo che siamo al passo \(t\)».
Il processo inverso è modellato da una gaussiana con media appresa:
dove \(\theta\) sono i parametri della rete e \(\sigma_t^2\) è una varianza fissata, non appresa. DDPM ne prova due, \(\sigma_t^2 = \beta_t\) e la varianza del posteriore \(\tilde{\beta}_t = \frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t}\beta_t\), e le trova sperimentalmente equivalenti sui mille passi; la derivazione adotta la prima, ma le due scelte smetteranno di equivalersi a poche decine di passi, con DDIM. Si noti che \(\tilde{\beta}_1 = 0\): la seconda scelta spiega da sé perché all’ultimo passo non si aggiunga rumore fresco. La scelta di modellare il ritorno con una gaussiana è legittimata dal risultato di Feller citato in apertura di capitolo: per passi \(\beta_t\) piccoli, il vero inverso \(q(\mathbf{x}_{t-1} \mid \mathbf{x}_t)\) è approssimativamente gaussiano. Il contributo chiave di Ho, Jain e Abbeel [HJA20] è la riparametrizzazione della media: invece di far predire alla rete \(\boldsymbol{\mu}_\theta\) direttamente (o la ricostruzione \(\hat{\mathbf{x}}_0\)), la si scrive in funzione del rumore stimato,
dove \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\) è la stima del rumore \(\boldsymbol{\epsilon}\) usato per produrre \(\mathbf{x}_t\) dalla forma chiusa. Con questa scelta l’addestramento si riduce a un errore quadratico medio:
dove \(\mathbf{x}_0\) è un dato del training set, \(t\) è uniforme su \(\{1, \dots, T\}\) e \(\boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\): si campiona una tripla, si costruisce \(\mathbf{x}_t\) in un colpo solo con la forma chiusa (senza percorrere la catena), e si confrontano rumore vero e rumore predetto. Si noti che predire \(\boldsymbol{\epsilon}\), predire \(\boldsymbol{\mu}\) e predire il dato pulito sono formulazioni legate da relazioni affini (dato \(\mathbf{x}_t\), l’una si ricava dall’altra: per esempio \(\hat{\mathbf{x}}_0 = (\mathbf{x}_t - \sqrt{1-\bar{\alpha}_t}\,\boldsymbol{\epsilon}_\theta)/\sqrt{\bar{\alpha}_t}\)), ma non equivalenti come problemi di regressione. Il bersaglio \(\boldsymbol{\epsilon}\) ha distribuzione \(\mathcal{N}(\mathbf{0}, \mathbf{I})\) a ogni \(t\), quindi il suo errore quadratico ottimo per componente non supera 1, l’errore di chi risponde \(\mathbf{0}\). Per \(t\) grande è vicino a 0, perché \(\mathbf{x}_t \approx \boldsymbol{\epsilon}\) e il rumore si legge dal dato; per \(t\) piccolo è vicino a 1 nelle direzioni in cui i dati hanno varianza non trascurabile, dove il rumore è una traccia minuscola sopra un segnale che varia molto di più, e resta piccolo dove i dati non variano. Per una componente gaussiana di varianza \(s^2\) vale \(\bar{\alpha}_t s^2/(\bar{\alpha}_t s^2 + 1 - \bar{\alpha}_t)\), e va da 1 a 0 al crescere di \(t\). Un tetto ce l’ha anche il dato pulito, la varianza dei dati, che è l’errore di chi risponde con la media. A distinguere le due regressioni è il cambio fra i due errori,
che vale circa \(10^{-4}\) a \(t = 1\) e \(2{,}5 \cdot 10^4\) a \(t = T\), circa \(157^2\): un errore piccolo sul rumore a \(t\) grande è un errore grosso sul dato, e un errore piccolo sul dato a \(t\) piccolo è un errore grosso sul rumore.
L’ablazione di DDPM su questo punto va letta con attenzione, perché dice qualcosa di più stretto del solito «predire il rumore è meglio». A parità di obiettivo e di varianza, cioè addestrando entrambe sul bound variazionale completo con \(\sigma_t^2\) fissata, le due parametrizzazioni si equivalgono. Il salto di qualità arriva soltanto dalla coppia: \(\boldsymbol{\epsilon}\) insieme alla \(\mathcal{L}_{\text{semplice}}\). E la coppia speculare, \(\boldsymbol{\mu}\) insieme alla loss semplificata, il paper la marca come instabile in addestramento. La lettura corretta è quindi più stretta: fra le due parametrizzazioni che il paper confronta, \(\boldsymbol{\epsilon}\) è l’unica con cui la loss semplificata addestri davvero. La sola in assoluto non è: predire il dato pulito o la velocità \(\mathbf{v}\) con una loss quadratica funziona anch’esso, scegliendo il peso sui livelli di rumore, ed è la strada della distillazione e di Stable Diffusion 2 [SH22]; la sezione sul limite continuo mostra che le parametrizzazioni differiscono soltanto per quel peso.
Generare: il viaggio dal rumore all’immagine#
Finito l’addestramento, il generatore è pronto. Non serve nessuna foto di partenza: si sorteggia rumore puro, \(\mathbf{x}_T \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\), e si percorre la catena all’indietro, un gradino alla volta, con una valutazione della rete per gradino. Ogni gradino ha tre componenti: la correzione, che sottrae una frazione del rumore stimato dalla rete; la riscalatura, che moltiplica tutto quello che resta per \(1/\sqrt{\alpha_t}\), un numero appena sopra 1 (si alza il volume); e il rimescolamento, che somma rumore appena sorteggiato.

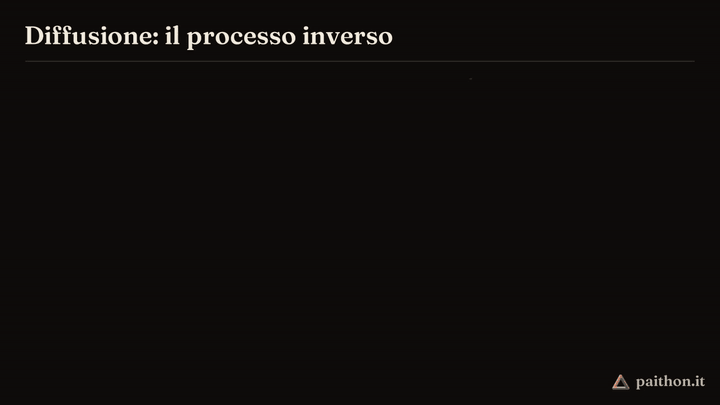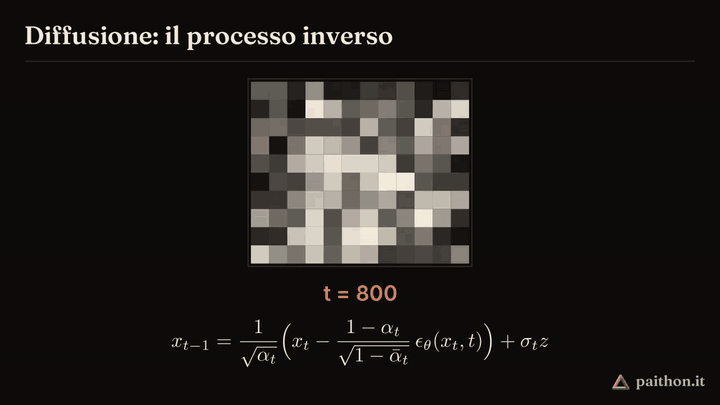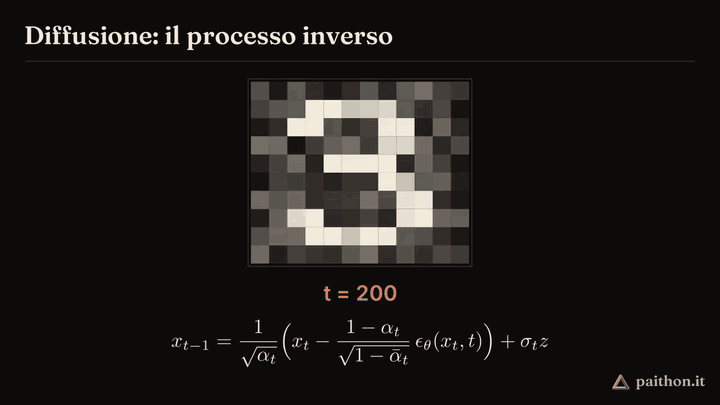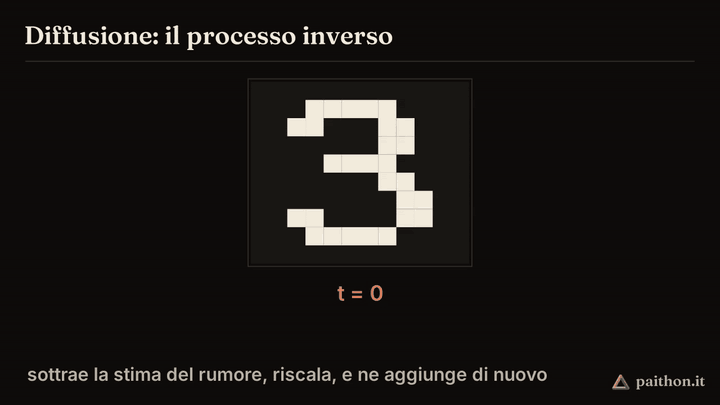
Fig. 27.5 Il processo inverso su una cifra: a ogni passo la rete dice dov’è il disturbo, se ne toglie un pezzetto, si alza il volume di quel che resta e se ne rimette del nuovo. Nessuno ha disegnato il 3: è emerso da mille rimescolamenti.#
La Fig. 27.5 comprime in pochi passi ciò che nel DDPM originale ne richiede mille. Il gesto vero, però, non è una ripulitura progressiva: per quasi tutto il viaggio il rumore rimescolato è molto più grande di quello sottratto, e l’immagine emerge per un’altra via. Si vede anche nella clip, dove il disturbo non cala in modo liscio ma resta lì a lungo e se ne va tardi.
Un rituale in tre mosse, ripetuto mille volte. Si parte da una manciata di pulviscolo appena sorteggiato, mai visto prima; poi, dal passo 1.000 al passo 1, a ogni gradino:
correggi: mostra alla rete la schermata e il numero del passo, fatti dire dov’è il disturbo, e cancellane una scheggia;
alza il volume di tutto quello che c’è sullo schermo, moltiplicandolo per un numero appena sopra 1: al passo 1000 è 1,010, al passo 1 è 1,00005. Sono gli stessi numeri dell’andata rovesciati (là si moltiplicava per 0,99 e per 0,99995), e infatti questa mossa è l’attenuazione dell’andata rifatta al contrario. Sale l’immagine che sta sotto e sale il rumore che le sta sopra, insieme;
rimescola: getta sopra una manciata di rumore nuovo, sorteggiato adesso. All’ultimo passo, e solo lì, questa terza mossa si salta.
Se la rete ha appena indicato tutto il disturbo, perché cancellarne solo una scheggia, invece di toglierlo tutto e chiudere la partita in un passo? Perché toglierlo tutto darebbe sempre la stessa specie di immagine: una macchia sfocata, la media di tutte le fotografie compatibili con quel pulviscolo. Davanti a una schermata piena di rumore la rete non sa se lì sotto c’è un gatto o un muro, e risponde con un compromesso fra tutte le possibilità. Con la scheggia si toglie quel poco su cui il compromesso è affidabile, si rimescola, e si ridomanda.
Le proporzioni fra le tre mosse sono poi l’esatto contrario di quello che il buon senso si aspetta. Al passo 500, a metà viaggio, la scheggia cancellata sposta il valore tipico di un pixel di 0,0105, la manciata di rumore nuovo di 0,1002: nove volte e mezzo tanto. E vale in generale: la manciata è dalle sette alle dieci volte più grande della scheggia per i primi novecento passi su mille; solo nell’ultimo decimo del percorso si rimpicciolisce fino a pareggiarla, e sull’ultimo gradino sparisce del tutto.
Come fa allora a uscirne un’immagine, se a ogni giro si toglie poco e si rimette molto? Conta la direzione. La scheggia è mirata: non punta sempre dalla stessa parte (il disturbo si sposta, e la rete lo insegue), ma punta dalla parte giusta, e i suoi effetti si sommano invece di elidersi. La manciata è sorteggiata, ogni volta in una direzione diversa, ed è la storia dei passi a caso: mille spintarelle così si disfano fra loro e ti lasciano più o meno dove sei, mentre mille spintarelle concordi ti portano lontano.
Il volume, intanto, sale a ogni passo e nessuno lo contrasta: a forza di moltiplicare per quei numeri appena sopra 1, sull’intera catena ingrandisce di centocinquanta volte tutto quello che sta sullo schermo. È il fattore dell’andata rovesciato (là del pixel sopravviveva un centocinquantesimo, qui si torna a grandezza piena), e ingrandisce il disegno che si va formando e insieme il disturbo che lo copre. Sul disturbo, però, e solo su di lui, lavora anche la scheggia. Al passo 500 il livello di disturbo è 0,9599: il volume lo alza di cinque millesimi, la scheggia lo abbassa di poco più di un centesimo, e la manciata nuova lo rialza di altri cinque millesimi, molto meno del suo decimo, perché va in una direzione a caso e si somma male a quello che c’era. Il saldo lo porta a 0,9595: quattro decimillesimi in meno, un’inezia, ma sempre dallo stesso lato. Mille inezie dallo stesso lato ribaltano il conto, e alla fine il disturbo è cento volte più piccolo di com’era, invece che centocinquanta volte più grande. Il conto regge finché la rete indovina il disturbo, cioè per quasi tutta la catena; negli ultimi passi il disturbo rimasto è così sottile che la rete sbaglia di quasi quanto il disturbo stesso, e la scheggia smette di puntare dritta.
Il disegno, invece, il volume lo incassa e basta. Sotto il pulviscolo di partenza non c’era nessun disegno: ce lo depositano le schegge, un poco a ogni giro, e ogni pezzetto depositato viene ingrandito da tutti i giri che gli restano. Quello che si decide presto, quindi, pesa sul risultato molto più di quello che si decide tardi. Il conto del viaggio: il disegno cresce di centocinquanta volte, il disturbo cala di cento, e rispetto al disturbo che lo copre il disegno è diventato quindicimila volte più forte. Nessuno lo ha ripulito un velo alla volta: si è alzata la voce di quello che via via si andava decidendo, mentre il disturbo perdeva un’inezia per volta.
Il rimescolamento, quindi, non è una svista da tollerare. La ricetta non dice «da qui vai lì», dice «da qui sorteggia dove andare, in questa zona», e il rumore fresco è quel sorteggio: toglierlo da questa procedura vorrebbe dire eseguirla sbagliata, con risultati peggiori. Ne viene anche che il risultato cambia a ogni esecuzione per due motivi invece che per uno, pulviscolo di partenza diverso e scossoni diversi. Il costo, invece, si vede tutto: mille valutazioni della rete per ogni immagine, il conto salato annunciato all’apertura del capitolo.
Il campionamento ancestrale di DDPM percorre la catena inversa da \(t = T\) a \(t = 1\): si parte da \(\mathbf{x}_T \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\) e si itera
dove il primo termine è la media appresa \(\boldsymbol{\mu}_\theta(\mathbf{x}_t, t)\) e \(\sigma_t \mathbf{z}\) è rumore fresco con \(\sigma_t = \sqrt{\beta_t}\); al passo finale \(t = 1\) si pone \(\mathbf{z} = 0\) e si restituisce la media.
I tre pezzi di quel passo hanno taglie molto diverse, e il loro rapporto rovescia la descrizione a parole che di solito lo accompagna. Il rumore stimato viene sottratto con coefficiente \(\beta_t / (\sqrt{\alpha_t}\sqrt{1-\bar{\alpha}_t})\), quello fresco iniettato con deviazione standard \(\sigma_t = \sqrt{\beta_t}\): il rapporto fra i due è
che con lo schedule di DDPM vale da 7 a 10 per i primi novecento passi della generazione, cioè da \(t = 1000\) fino a \(t = 100\) (7,0 a \(t = 1000\), 9,5 a \(t = 500\), 9,7 a \(t = 250\), 7,0 a \(t = 100\), con il massimo di 10,0 attorno a \(t = 350\)). Per il novanta per cento del viaggio, dunque, il rumore iniettato sposta il punto di quasi un ordine di grandezza più di quanto lo sposti la correzione. Il rapporto cede solo nella coda: negli ultimi cento passi scende fino a \(\sqrt{\alpha_1} \approx 1\), e a \(t = 1\) il rimescolamento non c’è affatto. Cioè: la ripulitura arriva a pesare quanto il rimescolamento soltanto alla fine, quando l’immagine è già decisa.
Il livello di rumore, allora, come scende? Poco per volta, e per il modo in cui i tre contributi si compongono, non per la loro taglia. Il conto che segue suppone una rete perfetta, \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) = \boldsymbol{\epsilon}\), cioè il passo di DDPM applicato a un \(\mathbf{x}_t\) di cui si conosce l’origine: è il solo modo di separare segnale e rumore, e descrive bene la parte alta della catena, dove la rete indovina quasi tutto; negli ultimi passi l’errore della rete sul rumore si avvicina alla taglia del rumore stesso, e la correzione smette di essere allineata. Scomponendo il passo \(t = 500\), dove il rumore presente ha deviazione standard \(0{,}9599\): la riscalatura per \(1/\sqrt{\alpha_t}\) lo alza di \(+0{,}0049\), la correzione lo abbassa di \(-0{,}0105\) (tutto il proprio valore, perché è allineata al rumore che c’è), l’iniezione lo rialza di \(+0{,}0052\) (molto meno del proprio \(0{,}1002\), perché è indipendente e si somma in varianza). Netto: \(-0{,}0004\), quattro decimillesimi, contro un \(\sigma_t\) di \(0{,}1\). La correzione vince un tiro alla fune contro le altre due mosse, e lo vince di pochissimo.
Il segnale, invece, la riscalatura la incassa e basta: nessuno degli altri due termini lo tocca, e \(\sqrt{\bar{\alpha}_t} \to \sqrt{\bar{\alpha}_{t-1}}\) a ogni passo. Dalla coda della catena a \(t = 1\) il rapporto fra l’ampiezza del segnale e quella del rumore passa da \(\sqrt{\bar{\alpha}_T / (1-\bar{\alpha}_T)} = 0{,}0064\) a \(\sqrt{\bar{\alpha}_1 / (1-\bar{\alpha}_1)} = 100\), un fattore quindicimila, di cui 157 dall’amplificazione del segnale e 100 dalla riduzione del rumore. Descrivere il campionamento come «togliere un velo di rumore alla volta» racconta quindi metà del guadagno e circa un decimo del gesto (a \(t = 500\) la correzione vale \(0{,}0105\) su uno spostamento complessivo di \(0{,}1007\)), e tace la riscalatura, che è l’altra metà.
Quel rapporto è fra le due ampiezze, non fra le due potenze, mentre la letteratura fa di solito l’altra scelta: chi lo definisce come \(\bar{\alpha}_t/(1-\bar{\alpha}_t)\) trova il quadrato dei numeri appena scritti. Qui servono le ampiezze perché è in quelle che si misurano le tre mosse, e la sezione sui campionatori veloci tiene la stessa scelta quando ne prende il logaritmo.
Una precisazione su che cosa sia il «segnale» quando si genera, perché la scomposizione appena fatta è quella delle marginali \(q(\mathbf{x}_t \mid \mathbf{x}_0)\) e presuppone un \(\mathbf{x}_0\) che in generazione non esiste ancora. In \(\mathbf{x}_T\) non c’è nessuna immagine sepolta: il campionatore la costruisce, ed è la correzione, a ogni passo, a iniettare la sola componente non casuale del gesto. Quello che la riscalatura amplifica è dunque ciò che le correzioni precedenti hanno già depositato, non un contenuto preesistente; e siccome l’amplificazione è cumulativa, ciò che si decide presto pesa sul risultato molto più di ciò che si decide tardi.
Il termine stocastico non è dunque un vezzo, ed è il pezzo più grosso del passo per quasi tutto il viaggio: il processo inverso è esso stesso una catena di distribuzioni, non una funzione deterministica, e campionare da \(p_\theta(\mathbf{x}_{t-1} \mid \mathbf{x}_t)\) richiede sia la media sia il rumore di varianza \(\sigma_t^2\). Il prezzo computazionale è esplicito: \(T\) valutazioni complete della rete per ogni campione, con \(T = 1000\), tre ordini di grandezza più di una GAN, che genera in una singola passata in avanti.
Sotto il cofano: da dove viene il voto, e che cosa impara la rete#
Due domande sono rimaste in sospeso. La prima riguarda il modo in cui abbiamo dato il voto alla rete (misurare la distanza fra il disturbo indicato e quello vero, e nient’altro): è un colpo di fortuna, o discende da un principio? La seconda, più profonda: che cosa sta davvero imparando la rete, oltre a vincere al nostro gioco?
Alla prima domanda la risposta è no, non è fortuna. Ma il filo che porta dal principio al voto non è pulito come l’abbiamo raccontato.
Chi costruisce modelli che inventano cose nuove parte quasi sempre dalla stessa idea. Il modello, in fondo, è una macchina che assegna a ogni immagine possibile una probabilità di uscire; e allora si prendono le fotografie vere dell’archivio e si regolano i pesi finché la macchina non dichiara quelle come le più probabili di tutte. Ragionevole: se ritiene probabile ciò che nel mondo esiste davvero, quando inventa inventerà cose del genere.
Applicata alla nostra catena di mille passi, dopo un bel po’ di conti, quella idea si riduce esattamente a «misura la distanza fra il disturbo indicato e quello vero», un livello di rovina alla volta. Con un dettaglio che DDPM aggiunge di suo. Fatti i conti, i mille livelli non contano uguale: nel voto che il principio detta, quelli quasi puliti, dove ripulire è facile, peserebbero una cinquantina di volte più di quelli pieni di rumore. DDPM li fa contare tutti uguali, e così facendo promuove proprio i passi difficili da ripulire, che nella ricetta originale contavano pochissimo. (Il confronto qui è fra due modi di pesare lo stesso voto sul disturbo, non fra chiedere il disturbo e chiedere la foto, che è il cambio di moneta di prima.) Il voto di DDPM non è quindi quello che il principio detta, ma una sua versione riequilibrata a mano; e il voto del principio, seguito alla lettera, dà immagini peggiori di quello riequilibrato. E il conto si paga dove la ricetta prometteva: davanti alle fotografie vere dell’archivio, il modello riequilibrato le dichiara meno probabili di quanto faccia quello fedele. Genera meglio e giudica peggio.
La seconda risposta è più bella. Immagina una mappa sterminata in cui ogni punto è una possibile immagine: ogni combinazione di pixel, anche le più assurde. Adesso dai a ogni punto un’altezza, e sia l’altezza la credibilità di quell’immagine, cioè quanto somiglia a una fotografia vera. Le immagini sensate (gatti, muri, volti) diventano poche colline sparse; tutto il resto, cioè quasi tutto, è pianura bassa e infinita.
La rete, allenandosi a indicare il disturbo, sta imparando senza saperlo il verso della salita: in ogni punto della mappa, in che direzione spostarsi per guadagnare quota, cioè per rendere l’immagine un po’ più credibile. Non è un nord unico e uguale dappertutto, come per una bussola vera: è un cartello diverso a ogni incrocio, che indica dove si sale da lì. Generare, allora, è partire da un punto qualsiasi della pianura e seguire i cartelli a piccoli passi, con in mezzo gli scossoni sorteggiati di cui si diceva. Per anni due scuole hanno lavorato in parallelo (chi diceva «insegniamo a togliere il rumore» e chi diceva «insegniamo il verso della salita»), finché non si è capito che stavano costruendo lo stesso oggetto con due linguaggi diversi.
Da dove viene la loss. Come per ogni modello a variabili latenti, la log-verosimiglianza \(\log p_\theta(\mathbf{x}_0)\) (l’evidenza) non è calcolabile direttamente, ma ammette un limite inferiore variazionale (ELBO). Nella convenzione del libro, dove \(\mathcal{L}\) si minimizza, si lavora con il suo opposto, \(\mathcal{L}_{\text{var}} = -\mathrm{ELBO}\) (un limite superiore sulla log-verosimiglianza negativa), ed è questa quantità che si decompone in \(T-1\) divergenze KL, una per ciascun passo interno della catena, più due termini di bordo: una ricostruzione \(-\log p_\theta(\mathbf{x}_0 \mid \mathbf{x}_1)\) e un confronto sul prior, \(D_{KL}\big(q(\mathbf{x}_T \mid \mathbf{x}_0)\,\|\,p(\mathbf{x}_T)\big)\), che non contiene parametri e si può ignorare. Ogni KL confronta il posteriore condizionato al dato, \(q(\mathbf{x}_{t-1} \mid \mathbf{x}_t, \mathbf{x}_0)\), con il passo appreso \(p_\theta(\mathbf{x}_{t-1} \mid \mathbf{x}_t)\); attenzione a non confonderlo con l’inverso vero \(q(\mathbf{x}_{t-1} \mid \mathbf{x}_t)\) incontrato sopra, gaussiano solo per approssimazione. Condizionando anche su \(\mathbf{x}_0\) la distribuzione diventa gaussiana esatta: per Bayes è proporzionale a \(q(\mathbf{x}_t \mid \mathbf{x}_{t-1})\,q(\mathbf{x}_{t-1} \mid \mathbf{x}_0)\) (la proprietà di Markov toglie \(\mathbf{x}_0\) dal primo fattore), prodotto di due gaussiane in \(\mathbf{x}_{t-1}\), e completando il quadrato
con la \(\tilde{\beta}_t\) già vista. Sostituendo \(\mathbf{x}_0 = (\mathbf{x}_t - \sqrt{1-\bar{\alpha}_t}\,\boldsymbol{\epsilon})/\sqrt{\bar{\alpha}_t}\) si ottiene \(\tilde{\boldsymbol{\mu}}_t = \frac{1}{\sqrt{\alpha_t}}\big(\mathbf{x}_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}}\boldsymbol{\epsilon}\big)\): è da qui che viene la forma di \(\boldsymbol{\mu}_\theta\) scelta sopra, che copia \(\tilde{\boldsymbol{\mu}}_t\) mettendo \(\boldsymbol{\epsilon}_\theta\) al posto di \(\boldsymbol{\epsilon}\). Fra due gaussiane isotrope di varianze fissate la KL vale, a meno di una costante, \(\lVert \tilde{\boldsymbol{\mu}}_t - \boldsymbol{\mu}_\theta \rVert^2 / (2\sigma_t^2)\), e le due medie differiscono soltanto nel rumore:
La \(\mathcal{L}_{\text{semplice}}\) è questo obiettivo con i pesi posti a 1: non più un bound, ma una sua versione ripesata che nella pratica produce campioni migliori [HJA20].
La riponderazione ha un prezzo, e il prezzo va messo in chiaro: senza, resterebbe in piedi come premessa una proprietà che qui viene ritirata. Il peso \(\lambda_t\) che l’ELBO assegna al passo \(t\), con lo schedule di DDPM e la varianza \(\sigma_t^2 = \beta_t\) scelta sopra, vale \(0{,}500\) al passo 1 contro \(0{,}0102\) al passo 1000. (A \(t = 1\), a rigore, il termine è la ricostruzione \(-\log p_\theta(\mathbf{x}_0 \mid \mathbf{x}_1)\), che DDPM approssima con la stessa forma.) Porli tutti a 1 significa moltiplicare per circa cinquanta il peso relativo dei passi ad alto rumore rispetto a quelli quasi puliti. È voluto, e Ho e colleghi lo dichiarano (la loss semplificata sottopesa i termini a \(t\) piccolo, «così che la rete possa concentrarsi sui compiti di denoising più difficili a \(t\) grande»). Il peso agisce in un posto preciso. Poiché \(t\) è un ingresso della rete, ciascun termine della somma è minimizzato dalla stessa funzione, \(\boldsymbol{\epsilon}^*(\mathbf{x}_t, t) = \mathbb{E}[\boldsymbol{\epsilon} \mid \mathbf{x}_t]\), qualunque peso gli si dia: con capacità illimitata i due obiettivi hanno lo stesso ottimo [LSK+26]. I pesi decidono dove una rete finita spende la propria capacità e quanto è rumoroso il gradiente, ed è lì che un modello addestrato con \(\mathcal{L}_{\text{semplice}}\) smette di massimizzare la verosimiglianza: la sua verosimiglianza è misurabilmente peggiore di quella dello stesso modello addestrato sul bound vero, e resta lontana da quella dei modelli autoregressivi, come gli autori dichiarano esplicitamente. È il compromesso che spiega un tratto controintuitivo della famiglia: i modelli di diffusione producono campioni migliori dei modelli che ottimizzano la verosimiglianza, pur avendo verosimiglianze peggiori.
Cosa impara la rete. Dalla forma chiusa dell’andata segue \(\nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t \mid \mathbf{x}_0) = -\boldsymbol{\epsilon} / \sqrt{1-\bar{\alpha}_t}\): il rumore iniettato è, a meno di un fattore, il punteggio della densità condizionata al dato di partenza. Il passaggio alla densità marginale \(q(\mathbf{x}_t)\) non è un corollario ma un risultato a sé: il minimo della loss quadratica è la media condizionata \(\boldsymbol{\epsilon}^*(\mathbf{x}_t, t) = \mathbb{E}[\boldsymbol{\epsilon} \mid \mathbf{x}_t]\), e si può dimostrare (è il denoising score matching di Vincent [Vin11]) che essa vale
dove \(\nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t)\), il gradiente della log-densità dei dati rumorosi, detto score (in italiano punteggio), indica in ogni punto la direzione in cui la densità sale più in fretta, verso le regioni più probabili. È la prospettiva score-based di Yang Song e Stefano Ermon, che nel 2019 addestrano una sola rete a stimare lo score su una scala geometrica di livelli di rumore e campionano con una dinamica di Langevin, un livello di rumore dopo l’altro dal più alto al più basso [SE19]. Song e colleghi la portano a compimento nel 2021 [SSDK+21]: l’andata è la discretizzazione di un’equazione differenziale stocastica (SDE) che diffonde i dati nel rumore, e la SDE inversa (che genera) dipende dai dati soltanto attraverso lo score. DDPM e i modelli score-based si rivelano così discretizzazioni di due SDE della stessa famiglia: DDPM di quella che conserva la varianza (VP), Song ed Ermon di quella che la lascia esplodere (VE), e le due si convertono l’una nell’altra riscalando lo stato. Una sola teoria, due dialetti.
Per linearità della media condizionata, dalla stessa \(\boldsymbol{\epsilon}^*\) si legge anche la media a posteriori del dato di partenza,
ed è ciò che darebbe un salto all’arrivo in un passo solo. A \(t\) grande è un’immagine sfocata, perché mescola tutti i dati compatibili con \(\mathbf{x}_t\), e il campionamento ne prende a ogni passo solo un pezzo, poi rimescola.
Accelerare il ritorno: DDIM#
Mille passi per un’immagine sono tanti, e la prima scorciatoia importante non si fa attendere: arriva a meno di quattro mesi da DDPM, nell’ottobre del 2020, e sono i Denoising Diffusion Implicit Models (DDIM) di Jiaming Song, Chenlin Meng e Stefano Ermon [SME21]. La promessa è notevole: lo stesso identico modello già addestrato, nessun riaddestramento, e campioni di qualità paragonabile in un centinaio di passi invece di mille, o anche in venti se si accetta di perdere qualcosa: dieci volte più veloce nel primo caso, cinquanta nel secondo, ed è proprio l’intervallo che gli autori dichiarano.
DDIM scopre che la scala di mille gradini appena scesa non è l’unica che porta laggiù. Ce n’è tutta una famiglia: procedure diverse che attraversano gli stessi livelli di rovina e che si possono percorrere con la stessa rete già addestrata, senza cambiarle una virgola. La procedura di DDPM, scossoni compresi, è una di loro; e nella famiglia ce n’è una che di scossoni non ne ha affatto.
Ecco il debito saldato. Gli scossoni erano parte della definizione del passo, sì, ma di quella procedura, e DDIM ne usa un’altra, in cui il passo non è un sorteggio ma un calcolo: da un punto si va in un punto solo, deciso. Non si sta eseguendo male DDPM, si sta eseguendo bene qualcos’altro. E quella procedura, non dovendo imitare passo per passo una catena, si può percorrere saltando: qualche decina di fermate scelte (venti, cinquanta, cento) invece di mille. Saltare e scuotere, però, vanno d’accordo male. Su un salto lungo lo scossone va dosato per tutto il tratto saltato, e diventa troppo grosso perché le poche correzioni rimaste lo riassorbano. Quindi meno scossoni ha la procedura, meglio regge i salti larghi: quella che non ne ha regge meglio di tutte, quella con gli scossoni pieni di DDPM peggio di tutte, e in mezzo c’è una gradazione. Meno ci si ferma, più si risparmia e peggiore viene l’immagine: è una manopola, non un pasto gratis.
Qualcosa si perde: la varietà non arriva più da due sorgenti ma da una sola. In DDPM, dallo stesso pulviscolo di partenza escono ogni volta immagini diverse, perché diversi sono gli scossoni; in DDIM no, dallo stesso pulviscolo esce sempre, esattamente, la stessa immagine. La varietà resta tutta affidata al sorteggio iniziale.
Il che, invece di essere una perdita, si rivela un regalo. Il pulviscolo di partenza diventa una specie di codice dell’immagine: quel mucchio di puntini, e solo quello, apre quella figura. E siccome un codice è una lista di numeri, si può camminare da un codice all’altro un pochino per volta, e a ogni tappa chiedere l’immagine corrispondente: si ottiene un volto che si trasforma in un altro con continuità, invece di due immagini che non c’entrano niente.
L’osservazione chiave è che \(\mathcal{L}_{\text{semplice}}\) dipende dal processo in avanti solo attraverso le marginali \(q(\mathbf{x}_t \mid \mathbf{x}_0)\): mai attraverso la struttura congiunta della catena. Esiste allora un’intera famiglia di processi non markoviani con le stesse marginali, per i quali la rete già addestrata è altrettanto valida; Song, Meng ed Ermon la parametrizzano con un grado di stocasticità \(\eta\). Il passo da \(t\) al livello successivo \(s < t\) (il precedente sulla catena, o il prossimo di una sottosequenza) è
con \(\hat{\mathbf{x}}_0 = (\mathbf{x}_t - \sqrt{1-\bar{\alpha}_t}\, \boldsymbol{\epsilon}_\theta)/\sqrt{\bar{\alpha}_t}\) la stima del dato pulito e \(\mathbf{z} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\): si stima \(\mathbf{x}_0\), lo si riporta al livello \(s\), e il rumore che a quel livello gli spetta lo si compone in parte con la direzione già stimata e in parte, quanto vuole \(\eta\), con rumore fresco [SME21]. Per \(\eta = 1\) e \(s = t-1\) si ha \(\sigma_t^2 = \tilde{\beta}_t\), e si recupera il campionamento ancestrale di DDPM nella variante con la varianza del posteriore, non in quella con \(\sigma_t^2 = \beta_t\) usata sopra; per \(\eta = 0\) il passo diventa deterministico, e dato \(\mathbf{x}_T\) l’uscita \(\mathbf{x}_0\) è una funzione, non un campione. Qui la distinzione fra le due varianti, irrilevante sui mille passi, diventa decisiva: a una cinquantina di passi la scelta \(\sigma_t^2 = \beta_t\) produce campioni molto peggiori della variante con \(\tilde{\beta}_t\), che a sua volta è peggiore del caso deterministico. Ed è anche il motivo per cui DDIM è una scoperta e non una scorciatoia: accorciare la catena vuol dire cambiare quanto rumore si rimette a ogni gradino, e non solo saltarne qualcuno.
E poiché la generazione non deve più simulare fedelmente una catena markoviana passo-passo, può percorrere una sottosequenza \(\tau_1 < \dots < \tau_S\) di \(\{1, \dots, T\}\) con \(S \ll T\). Gli autori dichiarano qualità paragonabile a quella dei mille passi «entro i venti e i cento passi»; la loro stessa tabella, letta con attenzione, chiede qualche cautela in più. La parità vera arriva a cento passi e non a cinquanta, dove qualcosa già si paga; a venti la misura di qualità peggiora di più della metà, e sotto i venti precipita. E dipende dai dati: sul dataset di volti che gli autori usano, nemmeno cento passi bastano a raggiungere i mille. È un compromesso regolabile fra costo e fedeltà, non un pasto gratis. La mappa deterministica rumore→immagine rende inoltre significative le interpolazioni in \(\mathbf{x}_T\) e la ricostruzione (quasi) esatta di un’immagine dal suo rumore. E la somiglianza con la vista continua incontrata sotto il cofano ha una ragione: il campionatore DDIM con \(\eta = 0\) è, in effetti, una discretizzazione dell’ODE del flusso di probabilità associata alla SDE di [SSDK+21].
Chi indovina il disturbo? Una vecchia conoscenza#
Fin qui la rete è stata una scatola con due ingressi (l’immagine rovinata e il numero del passo) e un’uscita della stessa forma dell’immagine. Ma quale architettura? Guardiamo i requisiti: entra un’immagine ed esce un’immagine (la mappa del rumore stimato, pixel per pixel, alla stessa risoluzione). La sezione su detection e segmentazione ci ha già dato lo strumento su misura: la U-Net di Ronneberger, Fischer e Brox [RFB15], nata nel 2015 per segmentare immagini biomediche.
Nel capitolo sulla visione artificiale la U-Net imparava a dire, pixel per pixel, «questo è cellula, questo è sfondo»; il nostro restauratore le fa fare lo stesso identico gesto, ma la risposta ora è «ecco quanto rumore c’è su questo pixel». Il suo trucco è guardare la foto due volte: prima si allontana, e da lontano il pulviscolo sparisce e restano le forme grandi; poi si riavvicina per scrivere la risposta punto per punto. E siccome allontanandosi i dettagli minuti andrebbero perduti (e il disturbo è fatto proprio di dettagli minuti), la rete tiene dei ponti diretti fra la fase in cui si allontana e quella in cui si riavvicina, che li traghettano intatti. A mezza distanza, e solo lì, si ferma anche a confrontare ogni zona della foto con tutte le altre: da più vicino le zone sarebbero troppe per farlo senza pagarlo caro, da più lontano sarebbero così poche da non avere quasi niente da dirsi. (Attenzione: l’allontanarsi e il riavvicinarsi avvengono dentro la rete, in una sola interrogazione, e non hanno niente a che vedere con l’andata e il ritorno della diffusione, che sono i mille passi.)
Resta da dirle a che punto della scala sta lavorando. Il numero del passo entra come un’etichetta attaccata alla foto («questo è il livello 700 su 1000»), e la rete se la ripete a ogni stadio del lavoro, da lontano come da vicino. Così una sola rete serve tutti i livelli di rovina: quando il rumore è tanto sgrossa le forme, quando è poco rifinisce i dettagli.
La stessa rete che nella segmentazione colorava ogni pixel con la sua classe, qui gli attribuisce la sua quota di rumore: un encoder che comprime, un decoder che riespande, e le skip connections che traghettano i dettagli fini dalla discesa alla risalita; preziose, perché il rumore è per sua natura un dettaglio ad alta frequenza.
Resta da iniettare il tempo. Il passo \(t\) entra nella rete come embedding sinusoidale (lo stesso trucco degli encoding di posizione dei Transformer [VSP+17], con \(t\) al posto della posizione nella frase) trasformato da un piccolo MLP e sommato alle feature di ogni blocco della U-Net. Così una sola rete serve tutti i mille livelli di rumore: \(t\) le dice a quale punto della scala sta lavorando, se sgrossare forme globali (rumore alto) o rifinire texture (rumore basso). La U-Net di DDPM aggiunge infine blocchi di self-attention a una sola risoluzione intermedia (nei modelli \(32 \times 32\), la mappa \(16 \times 16\), e non le due più basse), dove i pixel sono già pochi abbastanza perché guardarli tutti insieme costi poco, ma non così pochi da non avere più struttura da confrontare.
Questa composizione, una rete di visione con il numero del passo cucito addosso, è un equilibrio provvisorio: il Diffusion Transformer butterà via la U-Net intera e ci metterà al suo posto un Transformer, che invece di guardare l’immagine da lontano e poi da vicino la taglia in tessere e le tratta come le parole di una frase. Era già successo nella visione, con i Vision Transformer [DBK+21].
La diffusione in miniatura: una spirale di punti#
Tutto il meccanismo sta in poche decine di righe di PyTorch, a patto di scegliere dati abbastanza piccoli da vederci dentro. Useremo punti del piano disposti a spirale: ogni «dato» qui non è una fotografia da un milione di numeri ma una coppia di coordinate, cioè due numeri soltanto. La ricetta dell’andata li disperderà in una nuvola informe, e la rete imparerà a ridisporli in spirale. Gli ingredienti sono esattamente quelli delle immagini; cambia solo la taglia.
I quattro blocchi sono, nell’ordine, i quattro pezzi del meccanismo: i dati con la forma chiusa dell’andata, la rete \(\boldsymbol{\epsilon}_\theta\), il ciclo che minimizza \(\mathcal{L}_{\text{semplice}}\) e il campionamento ancestrale.
Prima i dati e la ricetta dell’andata:
import numpy as np
import torch
from torch import nn

torch.manual_seed(0)
rng = np.random.default_rng(0)

# --- Dati: 2000 punti disposti a spirale, coordinate in [-1, 1] ---
n = 2000
angolo = 3.0 * np.pi * np.sqrt(rng.uniform(size=n))    # angolo lungo la spirale
raggio = angolo / (3.0 * np.pi)                        # il raggio cresce con l'angolo
spirale = np.stack([raggio * np.cos(angolo),
                    raggio * np.sin(angolo)], axis=1)  # shape (2000, 2)
spirale += 0.02 * rng.standard_normal(spirale.shape)   # leggero spessore del tratto
x0 = torch.tensor(spirale, dtype=torch.float32)        # (2000, 2)

# --- Schedule del rumore: lo stesso di DDPM ---
T = 1000
beta = torch.linspace(1e-4, 0.02, T)       # beta_t, shape (T,)
alpha = 1.0 - beta                         # alpha_t
alpha_bar = torch.cumprod(alpha, dim=0)    # alpha_t barrato, shape (T,)

def rumorizza(x0, t, eps):
    """Forma chiusa dell'andata: x_t dato x_0, per t interi in [0, T-1]."""
    ab = alpha_bar[t].unsqueeze(1)                     # (B, 1)
    return ab.sqrt() * x0 + (1.0 - ab).sqrt() * eps    # (B, 2)
La successione dei mille dosaggi (le variabili beta, alpha e alpha_bar)
si chiama in gergo lo schedule del rumore, ed è la manopola con le mille
tacche di cui si diceva sopra, scritta una volta per tutte prima di cominciare.
Il giocattolo trascura un dettaglio, su cui la sezione su Stable Diffusion tornerà. Lo schedule di DDPM presuppone dati con varianza vicina a 1 per componente: è la condizione sotto cui \(\mathrm{Var}(\mathbf{x}_t) = 1\) a ogni passo. I punti della spirale hanno invece una deviazione standard di circa mezza unità per coordinata, cioè una varianza attorno a un quarto (nella tazza di caffè e latte, una tazza che parte mezza vuota). Il segnale è quindi più debole del previsto a ogni livello, e il rumore lo copre a livelli più bassi di quelli su cui lo schedule è tarato. Qui non fa danno, perché la spirale riemerge lo stesso; in Stable Diffusion sì, e il rimedio, una moltiplicazione che riporta i dati alla scala giusta, diventa una costante scritta dentro il modello.
Poi la rete. La U-Net qui non serve, perché i dati non sono immagini: basta la rete più semplice che c’è, qualche strato di neuroni uno dopo l’altro, che in gergo si chiama MLP. Il numero del passo entra come l’etichetta attaccata alla foto di cui si parlava sopra, appesa in coda alle due coordinate. Solo che un numero da 0 a 999, scritto così com’è, una rete lo legge male; lo si riscrive allora come una fila di numeri fra \(-1\) e \(1\), ricavati da seni e coseni, che è quello che le prossime tre righe chiamano embedding sinusoidale, lo stesso trucco degli encoding di posizione dei Transformer:
def embedding_tempo(t, dim=16):
    """Embedding sinusoidale del passo t: da (B,) a (B, dim)."""
    freq = torch.exp(torch.arange(dim // 2) * (-np.log(10000.0) / (dim // 2)))
    ang = t.float().unsqueeze(1) * freq.unsqueeze(0)   # (B, dim/2)
    return torch.cat([ang.sin(), ang.cos()], dim=1)    # (B, dim)

class PredittoreRumore(nn.Module):
    """La rete epsilon_theta(x_t, t): un MLP al posto della U-Net."""
    def __init__(self, dim_t=16, dim_h=128):
        super().__init__()
        self.dim_t = dim_t
        self.rete = nn.Sequential(
            nn.Linear(2 + dim_t, dim_h), nn.SiLU(),
            nn.Linear(dim_h, dim_h), nn.SiLU(),
            nn.Linear(dim_h, 2),                       # stima del rumore 2D
        )

    def forward(self, x, t):
        emb = embedding_tempo(t, self.dim_t)           # (B, dim_t)
        return self.rete(torch.cat([x, emb], dim=1))   # (B, 2)
Il ciclo di addestramento minimizza \(\mathcal{L}_{\text{semplice}}\) su
gruppetti di 256 punti (in gergo un minibatch): per ciascun punto estrae un
livello \(t\) uniforme e un rumore \(\boldsymbol{\epsilon}\), costruisce
\(\mathbf{x}_t\) con rumorizza e confronta il rumore vero con quello stimato.
È il mazzo di carte con le soluzioni sul retro, riga per riga. L’errore
quadratico medio che ne esce si chiama loss, il nome inglese con cui lo si
trova ovunque, ed è quello che il ciclo fa scendere:
modello = PredittoreRumore()
ottimizzatore = torch.optim.Adam(modello.parameters(), lr=2e-3)

for passo in range(30000):
    idx = torch.randint(0, n, (256,))         # minibatch di 256 punti
    batch = x0[idx]                           # (256, 2)
    t = torch.randint(0, T, (256,))           # un livello di rumore per esempio
    eps = torch.randn_like(batch)             # il rumore "vero" (la soluzione)
    x_t = rumorizza(batch, t, eps)            # (256, 2)
    predetto = modello(x_t, t)                # (256, 2), rumore stimato
    loss = ((eps - predetto) ** 2).mean()     # MSE: la loss semplice di DDPM
    ottimizzatore.zero_grad()
    loss.backward()
    ottimizzatore.step()
    if passo % 5000 == 0:
        print(f"passo {passo:5d}  loss {loss.item():.3f}")
Infine la discesa della scala, quella delle tre mosse (correzione, riscalatura, rimescolamento). In letteratura si chiama campionamento ancestrale, perché ogni gradino si sorteggia a partire da quello che lo precede, come in un albero genealogico, e per arrivare all’ultimo discendente bisogna passare da tutti gli antenati: rumore in ingresso, mille valutazioni della rete, spirale in uscita. Le tre mosse sono segnate nei commenti; la terza si riconosce anche a occhio, perché è l’unica che chiama di nuovo il generatore di numeri casuali:
@torch.no_grad()
def campiona(n_campioni=1000):
    """Percorre la catena inversa da x_T (rumore puro) a x_0."""
    x = torch.randn(n_campioni, 2)                        # x_T ~ N(0, I)
    for t in reversed(range(T)):
        t_batch = torch.full((n_campioni,), t)            # (B,), tutti uguali a t
        eps_pred = modello(x, t_batch)                    # rumore stimato
        coeff = beta[t] / (1.0 - alpha_bar[t]).sqrt()     # quanto se ne toglie
        # mossa 1 (correzione) e mossa 2 (riscalatura): mu_theta(x_t, t)
        media = (x - coeff * eps_pred) / alpha[t].sqrt()
        if t > 0:
            # mossa 3 (rimescolamento): sigma_t * z, sigma_t = sqrt(beta_t).
            # E' il termine piu' grande dei tre, non un ritocco
            x = media + beta[t].sqrt() * torch.randn_like(x)
        else:
            x = media                    # ultimo passo: niente rumore fresco
    return x                             # (n_campioni, 2)

nuovi = campiona()
print(nuovi.shape)   # torch.Size([1000, 2]): mille coppie di coordinate

# "nuovi" e' una parola grossa: verifichiamola senza disegnare niente. Si
# confronta quanto dista un punto generato dal piu' vicino dell'archivio con
# quanto distano fra loro due punti dell'archivio: se i due numeri si
# somigliano, i generati cadono *fra* quelli di partenza, cioe' sulla spirale
# ma in posti dove non c'era nessuno
da_archivio = torch.cdist(nuovi, x0).min(dim=1).values
fra_archivio = torch.cdist(x0, x0).fill_diagonal_(float("inf")).min(dim=1).values
print(f"generato -> archivio: {da_archivio.median():.3f}   "
      f"archivio -> archivio: {fra_archivio.median():.3f}")
# generato -> archivio: 0.009   archivio -> archivio: 0.006
Disegnando nuovi con un grafico a dispersione si vede la spirale riemergere
dalla nuvola informe, e i due numeri stampati dicono la stessa cosa senza
bisogno di disegnare. Sono due mediane, cioè il valore che sta esattamente
in mezzo alla fila quando si ordinano tutte le distanze dalla più piccola alla
più grande: metà stanno sotto, metà sopra. Un punto generato dista dal punto
d’archivio più vicino \(0{,}009\); due punti d’archivio vicini distano fra loro
\(0{,}006\); le distanze sono misurate sul piano dove sta la spirale, che è largo
circa due unità. Non sono
uguali, e non devono esserlo: quello che conta è che siano dello stesso ordine,
perché è la differenza fra «i generati cadono in mezzo agli originali» e «i
generati sono copie» (in quel caso il primo numero sarebbe stato vicino a zero,
non una volta e mezza il secondo). Punti nuovi, quindi, non copie dei duemila
di partenza.
Due avvertenze pratiche prima di lasciare il giocattolo. La prima: il ciclo di addestramento fa trentamila giri, che sono i giri dell’allenamento e non hanno niente a che vedere con i mille livelli di rovina (a ogni giro se ne pesca uno solo, a caso). Trentamila giri da 256 punti fanno quasi otto milioni di carte del mazzo. E servono davvero: con poche migliaia di giri la forma esce appena abbozzata. La seconda: in tutto è questione di meno di un minuto su un portatile.
Restano due esperimenti istruttivi. Interrompere il campionamento a metà strada,
per vedere la forma «mezza decisa». E passare da questi punti alle immagini,
dove l’unica modifica sostanziale è sostituire l’MLP con una U-Net e le coppie
di coordinate con griglie di pixel: schedule, voto e cicli restano gli stessi,
salvo le forme dei tensori (in rumorizza il coefficiente va allargato a (B, 1, 1, 1) invece che a (B, 1), e campiona sorteggia griglie (n, 3, H, W)
invece di coppie).
Da ricordare
L’andata non si impara, è una ricetta fissa: a ogni passo il valore di ogni pixel si attenua un pochino e riceve un pizzico di disturbo casuale, come nella tazza sempre piena in cui a ogni giro un cucchiaino di caffè lascia il posto a uno di latte. Dopo mille giri resta solo pulviscolo, e c’è una scorciatoia per arrivare a un livello di rovina qualsiasi senza ripercorrere i passi uno per uno.
La rete impara a indicare il disturbo, non l’immagine pulita, e non il pizzico dell’ultimo passo ma tutto quello accumulato dalla foto pulita in poi. Chiedere il disturbo invece della foto decide quali livelli di rovina contano di più nel voto (i passi poco rovinati), e con quel voto ha dato le immagini migliori; la risposta esatta la conosciamo sempre, perché il disturbo l’abbiamo fabbricato noi (il mazzo di carte con le soluzioni sul retro).
Generare vuol dire partire da un pulviscolo mai visto e ripetere mille volte tre mosse: cancella la scheggia di disturbo che la rete ti indica, alza il volume di tutto quello che resta, getta sopra una manciata di rumore nuovo (tranne all’ultimo passo, dove la terza mossa si salta). Si toglie solo una scheggia perché togliere tutto il disturbo in un colpo darebbe una macchia sfocata, la media di tutte le immagini possibili sotto quel pulviscolo.
La cosa da non dimenticare è che quella manciata è dalle sette alle dieci volte più grande della scheggia (al passo 500: 0,1002 contro 0,0105), e lo è per i primi novecento passi su mille; nell’ultimo decimo cala fino a pareggiarla, e sull’ultimo gradino sparisce del tutto. Il passo non «solleva un velo»: rimescola molto più di quanto pulisca. L’immagine esce fuori lo stesso per due ragioni che vanno tenute insieme: la cancellatura è mirata (finché la rete indovina, cioè quasi fino in fondo) mentre il rumore nuovo è sempre sorteggiato, e il volume, salendo a ogni passo, ingrandisce di centocinquanta volte tutto quello che le cancellature hanno depositato. Alla fine il disegno è cresciuto di centocinquanta volte e il disturbo è calato di cento: quindicimila volte di guadagno, e nessuna ripulitura.
Sotto il cofano la rete sta imparando il verso della salita: su una mappa sterminata in cui ogni punto è un’immagine possibile e l’altezza è la sua credibilità, in ogni punto la direzione in cui spostarsi per guadagnare quota. Le due scuole che hanno lavorato in parallelo per anni («insegniamo a togliere il rumore» e «insegniamo il verso della salita») stavano costruendo lo stesso oggetto.
DDIM cambia procedura, non modello. La scala di mille gradini non è l’unica che attraversa quei livelli di rovina: ce n’è una famiglia, tutte percorribili con la stessa rete già addestrata, e una di loro non ha scossoni. Meno scossoni ha la procedura, meglio regge i salti, e quella senza si può percorrere a qualche decina di fermate invece di mille. La varietà resta tutta affidata al pulviscolo di partenza, che diventa così un codice dell’immagine: dallo stesso pulviscolo esce sempre la stessa figura, e camminando da un codice all’altro un’immagine sfuma nell’altra.
La rete che indovina il disturbo è la U-Net già vista nella segmentazione, che guarda la foto da lontano e poi da vicino tenendo dei ponti fra le due viste; il numero del passo entra come un’etichetta attaccata alla foto, che la rete si ripete a ogni stadio del lavoro. Più avanti nel capitolo un Transformer prenderà il suo posto.
Da ricordare
L’andata è fissa: \(q(\mathbf{x}_t \mid \mathbf{x}_{t-1}) = \mathcal{N}(\sqrt{1-\beta_t}\,\mathbf{x}_{t-1},\ \beta_t \mathbf{I})\) con schedule \(\beta_t\); la forma chiusa \(\mathbf{x}_t = \sqrt{\bar{\alpha}_t}\,\mathbf{x}_0 + \sqrt{1-\bar{\alpha}_t}\,\boldsymbol{\epsilon}\) salta da \(\mathbf{x}_0\) a qualunque passo, e \(\mathbf{x}_T\) è rumore gaussiano puro.
La rete \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\) impara a predire il rumore, non l’immagine: bersaglio a scala costante per ogni \(t\), loss MSE \(\mathbb{E}\lVert\boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta\rVert^2\) [HJA20] (una regressione, stabile come un problema supervisionato).
Generare = partire da \(\mathbf{x}_T \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\) e risalire la catena in \(T\) passi, e ogni passo fa tre cose: sottrae una frazione del rumore stimato, riscala per \(1/\sqrt{\alpha_t}\), inietta rumore fresco di deviazione standard \(\sigma_t\) (tranne all’ultimo).
Il rapporto fra iniezione e sottrazione è \(\sqrt{\alpha_t(1-\bar{\alpha}_t)}/\sqrt{\beta_t}\), cioè da 7 a 10 per i primi novecento passi (scende a 1 solo negli ultimi cento): si inietta molto più di quanto si sottragga. Il livello di rumore cala lo stesso, ma pochissimo per passo (quattro decimillesimi a \(t = 500\)), perché la sottrazione è allineata al rumore mentre l’iniezione si somma in varianza. E metà del guadagno sul rapporto fra le ampiezze di segnale e rumore (fattore \(157\) su \(15\,000\) complessivi) non viene dalla sottrazione ma dalla riscalatura; la letteratura definisce quel rapporto sui quadrati, e allora i numeri vanno al quadrato anche loro.
Sotto il cofano: la loss è una versione ripesata di \(-\mathrm{ELBO}\) (il bound variazionale da minimizzare, con i passi ad alto rumore favoriti di un fattore ~50, al prezzo di verosimiglianze peggiori), e predire il rumore equivale a stimare lo score \(\nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t)\); DDPM e modelli score-based discretizzano due SDE della stessa famiglia (VP e VE) [SSDK+21].
DDIM [SME21]: stesso modello, campionamento deterministico (\(\eta = 0\)) su qualche decina di passi (su CIFAR-10 la qualità dei mille passi si raggiunge verso i cento, sui volti di CelebA nemmeno lì; a venti è già degradata); possibile perché la loss dipende solo dalle marginali \(q(\mathbf{x}_t \mid \mathbf{x}_0)\), non dalla catena markoviana. Con \(\eta = 1\) si ritrova il campionatore ancestrale nella variante \(\sigma_t^2 = \tilde{\beta}_t\), non in quella \(\sigma_t^2 = \beta_t\) usata qui.
\(\boldsymbol{\epsilon}_\theta\) è una U-Net [RFB15] (la stessa della segmentazione) con il passo \(t\) iniettato come embedding sinusoidale; nella sezione su DiT verrà sostituita da un Transformer.
Fin qui la diffusione è una scala di mille gradini, e la rete impara a scenderla. Ma mille è un numero scelto, non un fatto di natura: se i gradini diventano infiniti e bassissimi, la scala diventa una rampa. In formule, l’andata diventa un’equazione differenziale stocastica, il ritorno la sua inversa, e di quell’inversa esiste anche una versione deterministica che attraversa le stesse nuvole di punti negli stessi istanti. È il tema della sezione sul limite continuo, e spiega perché il campionamento ancestrale e DDIM, che sembrano due procedure diverse, percorrono due equazioni con le stesse distribuzioni a ogni istante.