


Robotica e AI#
Un rover su Marte sceglie da solo dove mettere le ruote fra le rocce, un braccio meccanico riconosce il pacco da afferrare, in un magazzino decine di carrelli si incrociano senza toccarsi. In tutti e tre i casi c’è un corpo che si muove e un sistema che decide come muoverlo. La robotica progetta il corpo (la meccanica, i sensori, i motori), l’intelligenza artificiale la parte che decide; in un robot moderno le due cose nascono insieme, e vedere, riconoscere e decidere si fanno con tecniche di AI.
Un robot, in generale, è una macchina che sente l’ambiente fisico e agisce su di esso attraverso degli attuatori, cioè le parti che si muovono: motori, ruote, bracci, pinze. Il mestiere della robotica è tutto lì: far muovere quelle parti nel modo voluto e dosare la forza con cui toccano le cose. E non pensiamo solo agli «umanoidi», i robot con sembianze umane: sono robot anche i bracci meccanici delle catene di montaggio, i rover che esplorano Marte, gli aspirapolvere che girano per casa. Per essere un robot non serve nemmeno spostarsi: il braccio di una catena di montaggio ha la base fissa e muove soltanto le giunture, e nessuno gli nega il titolo. Basta sentire e agire.
Fin dove si può tirare questa definizione? Esiste un vocabolario internazionale, la norma ISO 8373, rivista nel 2021, in cui i tecnici di tutto il mondo si mettono d’accordo su che cosa chiamare robot. È più stretta della nostra: chiede che la macchina si sposti, maneggi oggetti o porti qualcosa in un punto preciso, e che lo faccia con un certo grado di autonomia, cioè decidendo da sé in base a quello che sente. Ne resta fuori la lavatrice, che pure sente (il carico, la temperatura) e agisce (apre la valvola, ferma il cestello). A noi qui interessa lo schema, sentire e agire, perché è quello con cui l’intelligenza artificiale ha a che fare; ma una lavatrice resta fuori anche dall’altra definizione, quella dei compiti per cui nessuno sa scrivere una ricetta: la ricetta per fermare il risciacquo esiste, ed è corta.
Un modo di ottenere il comportamento senza scriverlo a mano è il reinforcement learning (apprendimento per rinforzo), già incontrato fra i tre nomi dell’apprendimento: il programma agisce, riceve un punteggio numerico, la ricompensa, e modifica il proprio comportamento per ottenerne di più, per tentativi ed errori. È una delle strade con cui oggi si insegna a un robot a camminare, ad afferrare oggetti o a mantenere l’equilibrio, e quando a fare il lavoro sono le reti neurali si parla di deep reinforcement learning, cioè lo stesso con le reti a molti strati.
Un robot deve imparare a camminare, e nessun ingegnere gli spiega come piegare le ginocchia: si stabilisce solo la regola del gioco, per esempio un punto per ogni secondo in cui resti in piedi. Ai primi tentativi crolla quasi subito: \(2\) punti, poi \(3\), poi di nuovo \(2\).
Ogni tentativo lascia una traccia: il robot si segna che cosa ha fatto e quanti punti ne ha ricavato. Un punto incassato subito conta più di uno che arriverà fra dieci secondi, e quelli lontanissimi quasi niente. Serve a una cosa precisa: un robot che non cadesse mai accumulerebbe infiniti punti, e fra due infiniti non si sceglie; pesando meno il futuro, anche una prova senza fine vale una somma finita, e due prove si possono sempre confrontare.
Le mosse non le sceglie a colpo sicuro, le sorteggia, come tirando un dado; e quale dado tira dipende da com’è messo il corpo in quel momento, sbilanciato in avanti, piegato su un ginocchio, in equilibrio. Un dado strano, però, perché quello che sorteggia è la spinta da dare a un motore, e quella può valere qualunque cosa fra il minimo e il massimo: più che scegliere fra alcune mosse, decide con quanta forza fare quella che sta facendo.
All’inizio i dadi non preferiscono niente in particolare: la spinta esce a caso, e le spinte piccole escono un po’ più spesso di quelle forti. Dopo ogni tornata di prove il programma li ritocca di pochissimo, ed è qui che l’imparare succede: sui dadi tirati nelle prove andate bene rende un po’ più facile l’uscita delle mosse fatte, su quelli delle prove andate male un po’ più difficile. Ripeti migliaia di volte e i dadi si sbilanciano sempre di più verso il camminare; il punteggio sale a \(10\), poi a \(50\), poi a \(500\).
Restano le migliaia di cadute, che il robot vero non potrebbe permettersi: si sfascerebbe alla decima. Al posto suo cade una copia dentro una simulazione al computer, una specie di videogioco fedele del suo corpo. È lì che il gioco si può rompere: il pavimento vero è un filo più scivoloso di quello simulato, i motori veri rispondono con un soffio di ritardo, e la camminata che nella copia era perfetta inciampa appena tocca il mondo. Portare quel che ha imparato dal videogioco al metallo, senza perderlo per strada, resta un problema aperto.
Nel formalismo dei due capitoli sul reinforcement learning: un agente osserva lo stato \(s_t\) dell’ambiente, sceglie un’azione \(a_t\) secondo una policy \(\pi(a \mid s)\) e riceve una ricompensa \(r_{t+1}\). L’obiettivo è trovare la policy che massimizza il ritorno atteso \(\mathbb{E}_{\pi}\!\left[\sum_{t=0}^{\infty} \gamma^{\,t} r_{t+1}\right]\), dove la media è presa sulle traiettorie che la policy \(\pi\) genera e \(\gamma \in [0, 1)\) sconta le ricompense future. Se le ricompense sono limitate, \(|r_t| \le r_{\max}\), lo sconto rende finita la somma di infiniti termini (\(\left|\sum_{t \ge 0}\gamma^t r_{t+1}\right| \le r_{\max}/(1-\gamma)\), serie geometrica), mentre con \(\gamma = 1\) la somma può divergere. Per la robotica, con azioni continue (coppie ai motori), si usano i metodi a gradiente di policy. La policy è una distribuzione parametrica \(\pi_\theta(a \mid s)\), tipicamente una gaussiana la cui media esce da una rete, e \(\theta\) sale lungo il gradiente del ritorno atteso \(J(\theta) = \mathbb{E}_{\pi_\theta}\big[\sum_t \gamma^{t} r_{t+1}\big]\). Questo gradiente vale:
dove \(G_t\) è il ritorno scontato dal passo \(t\) in poi (a meno di un fattore \(\gamma^{\,t}\) che nella pratica si omette). Così, le azioni seguite da un ritorno alto diventano più probabili, le altre meno (REINFORCE [Wil92]). La formula segue da \(\nabla_\theta \pi_\theta = \pi_\theta \nabla_\theta \log \pi_\theta\), che porta il gradiente dentro l’attesa senza derivare attraverso l’ambiente. La stima ha varianza alta, e in pratica a \(G_t\) si sottrae una baseline \(b(s_t)\) che non dipende dall’azione. La sottrazione di solito riduce molto la varianza senza introdurre errore sistematico, perché \(\mathbb{E}_{a \sim \pi_\theta}[\nabla_\theta \log \pi_\theta(a \mid s)] = \nabla_\theta \int \pi_\theta(a \mid s)\,\mathrm{d}a = \nabla_\theta 1 = 0\). L’addestramento avviene in simulazione, con il passaggio al robot fisico (sim-to-real) come problema aperto.
I nomi di questo problema tornano per intero nei due capitoli sul reinforcement learning. Si chiama agente chi decide, cioè il robot che impara a camminare, e ambiente tutto il resto con cui ha a che fare: il pavimento, la gravità, la regola che assegna i punti. Lo stato \(s_t\) è la fotografia della situazione nel momento in cui l’agente deve decidere: com’è messo il corpo, a che velocità sta cadendo. L’agente sceglie un’azione \(a_t\), cioè una mossa, e l’ambiente risponde con la ricompensa \(r_{t+1}\), il punteggio di quella mossa, e con il nuovo stato \(s_{t+1}\). La policy \(\pi\) è la regola con cui l’agente sceglie l’azione in ogni stato, ed è la cosa che deve imparare; in italiano si traduce «politica», ma è una parola che porta fuori strada, e ovunque si trova scritto policy.
La Fig. 1.3 mette in fila queste parole e nient’altro. I pedici, i piccoli indici in basso a destra delle lettere, segnano soltanto il momento: \(t\) è il passo in cui l’agente decide, \(t+1\) quello subito dopo.

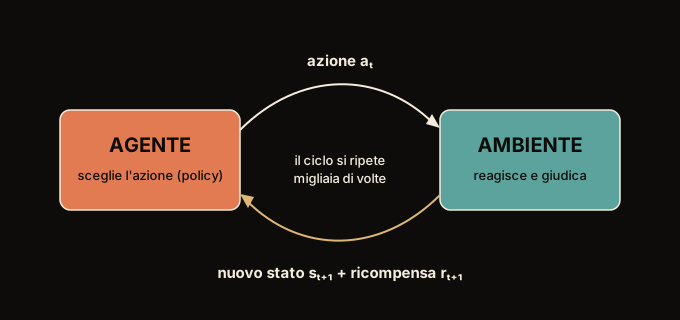
Fig. 1.3 L’anello fra l’agente e l’ambiente: l’agente manda la sua mossa, l’ambiente risponde con la nuova situazione e con la ricompensa, e si ricomincia. Non passa nient’altro.#
Fra i due passa poco: il nuovo stato e un numero. Quel numero è l’unico giudizio che l’agente riceve sul proprio operato, e arriva spesso con molte mosse di ritardo rispetto alla scelta che lo ha causato: il robot cade adesso per un passo storto di tre secondi fa. Nessuna spiegazione, nessuna indicazione della mossa giusta. Stabilire a quale mossa, fra le tante, vada attribuito il merito di un punteggio arrivato dopo è il problema dell’assegnazione del credito (credit assignment), uno dei problemi centrali del campo.
Fuori dai corpi meccanici, poi, l’intelligenza artificiale sconfina sempre più spesso in campi lontani dal suo: raffreddare un capannone pieno di computer accesi, leggere un elettrocardiogramma, e risolvere un problema di biologia rimasto aperto per mezzo secolo. Sono i tre esempi da cui si riparte.