


Mixture of Experts: più parametri, stesso conto#
Un’enciclopedia in trenta volumi non si legge tutta per rispondere a una domanda: si guarda l’indice, si prende il volume giusto, e gli altri ventinove restano sullo scaffale. Possedere una conoscenza e consultarla sono due costi diversi, e nessuno si sognerebbe di confonderli.
Il Transformer della sezione sull’architettura fa il contrario. Ogni token attraversa, a ogni strato, tutti i parametri dell’attenzione e della rete feed-forward, dal primo strato all’ultimo, senza saltarne uno. Il calcolo in avanti per token vale circa due operazioni per parametro, più un termine dell’attenzione che cresce con la lunghezza del contesto [KMH+20]: raddoppiare i parametri raddoppia il costo di ogni token, in addestramento come in generazione.
Le leggi di scala della sezione sui grandi modelli linguistici dicono perché si vorrebbe crescere lo stesso: la loss di un modello di linguaggio scende come una legge di potenza nei parametri, nei dati e nel calcolo, finché nessuno dei tre fa da collo di bottiglia agli altri [KMH+20] [HBM+22]. Il costo di ogni token, intanto, cresce con il modello senza sconti.
La domanda è se le due cose si possano separare. Esiste un modello con molti parametri e poco calcolo per token? Si può comprare capacità senza comprare, nella stessa misura, aritmetica? La risposta è sì, ha un nome (mixture of experts, miscela di esperti) ed è la ragione per cui si leggono due numeri di parametri per lo stesso modello. Il costo però non sparisce: passa dal calcolo alla memoria e alla comunicazione.
Molti blocchi al posto di uno#
Se si vuole risparmiare calcolo, conviene farlo dove il calcolo è più grosso. Nella sezione sull’architettura ogni strato del Transformer alterna l’attenzione, dove le parole si scambiano informazione, e la rete feed-forward (FFN), dove ogni parola si rielabora per conto suo; e la FFN, pur essendo la parte più semplice, contiene due terzi dei parametri dello strato. Il conto stava lì: quattro matrici \(d_{\text{model}} \times d_{\text{model}}\) nell’attenzione, contro due matrici quattro volte più grandi nella FFN, cioè otto della stessa taglia. Otto contro quattro, due terzi contro un terzo. Una linea di ricerca legge la FFN come la memoria del modello [GSBL21], un’interpretazione sostenuta da esperimenti; ai fini del bilancio basta che sia il blocco più pesante.

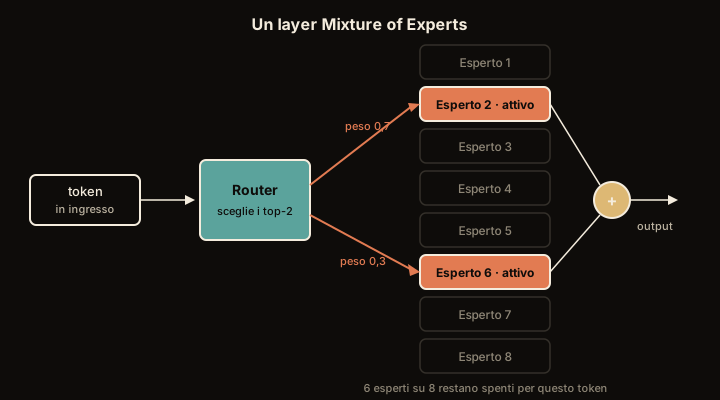
Fig. 16.18 Uno strato (in inglese layer) con otto esperti, due al lavoro: per ogni token si scelgono i due con il punteggio più alto (top-2), e gli altri sei restano spenti. Il modello contiene i parametri di tutti e otto, ma ogni token ne attraversa soltanto due: da qui il divorzio fra quanto un modello è grande e quanto costa farlo girare.#
L’idea sta in una riga: sostituire la rete feed-forward di uno strato (di ogni strato, o di uno ogni due) con \(N\) copie indipendenti, gli esperti, e mettere davanti un piccolo router che per ogni token ne sceglie \(k\): uno in Switch Transformer [FZS22], due in Mixtral [JSR+24], otto su 256 in DeepSeek-V3 [DeepSeekAI24b]. L’attenzione resta com’era. Il modello possiede i parametri di tutti gli esperti; ogni token ne attraversa soltanto \(k\).
Finché capacità e calcolo crescono insieme, l’unico modo di avere un modello più capace è pagarlo a ogni token. Lo strato di Fig. 16.18 li separa, e il prezzo è un router che può sbagliare e la memoria per esperti che quasi sempre stanno fermi.
In una redazione «densa» c’è un solo redattore, bravissimo in tutto, che rilegge e sistema ogni articolo che passa: cronaca, sport, economia, cucina. Funziona, ma per farlo bene quel redattore deve sapere tutto, e più cose deve sapere più tempo gli serve su ogni pezzo.
La versione a esperti ne assume otto, ciascuno con la sua specialità, e mette all’ingresso uno smistatore (è lui il router) che legge le prime righe e passa il pezzo a quello che c’entra di più (o ai due che c’entrano di più, se si vuole una seconda opinione). Un articolo sul mercato dei calciatori va allo sportivo; uno sul restauro di un affresco va all’esperto d’arte. (È un modo di dire: le specialità nessuno le assegna, i redattori se le trovano lavorando, e di rado coincidono con le pagine del giornale.) La redazione nel suo insieme sa molte più cose di prima, perché sono otto teste invece di una, mentre il lavoro su un articolo resta quello di sempre, perché a occuparsene è uno solo, o due. Lo smistatore, nel conto, non pesa: è una persona sola con un elenco di nomi.
Una parte del lavoro, però, non si moltiplica. Ogni pezzo passa comunque per la riunione del mattino, dove tutti si dicono quello che sanno, e di riunione ce n’è una sola: si sono moltiplicati i tavoli di rilettura, non la sala. Diamo un prezzo alle due cose, così si vede: se la sala riunioni vale uno, un tavolo di rilettura vale due. La redazione di prima valeva tre, un tavolo più la sala. Quella nuova ha otto tavoli, cioè sedici, più la sala: diciassette. Quasi sei volte, e non otto come parrebbe a contare i soli tavoli.
E un singolo pezzo quanto costa? Se lo rilegge un redattore solo, un tavolo più la sala: tre, esattamente quanto costava prima, con otto specialisti in casa al posto di un tuttologo. Se lo rileggono in due si arriva a cinque, una volta e mezza abbondante; per tornare a tre si assumono redattori a mezzo servizio, così che due di loro costino quanto il tuttologo.
Le redazioni più recenti spingono il mezzo servizio fino in fondo: tanti redattori a un quarto di servizio, quattro volte più numerosi, e su ogni pezzo ne lavorano otto insieme invece di due, così le squadre possibili sono moltissime di più. In più c’è un redattore fisso che legge ogni pezzo e si occupa di quello che serve a tutti, perché gli specialisti non debbano impararlo ciascuno per conto suo.
Separare quanto la redazione sa da quanto fatica su ogni pezzo: la miscela di esperti è tutta qui. Otto teste, però, non fanno un giornale otto volte migliore: il giornale migliora, e ogni redattore in più aggiunge un po’ meno del precedente. Il prezzo si vede in busta paga, e non lo sconta nessuno: gli otto lo stipendio lo prendono tutti, anche quelli che oggi non hanno scritto una riga. La redazione costa diciassette; il pezzo, quando lo rilegge un redattore solo, costa tre.
Facciamo il conto su un modello di taglia realistica, con \(d_{\text{model}} = 4096\), dimensione interna della feed-forward \(d_{\text{ff}} = 4\,d_{\text{model}} = 16384\) e \(n_{\text{strati}} = 32\). Per ogni strato:
dove il primo termine sono le due matrici della rete feed-forward e il secondo le quattro proiezioni dell’attenzione. In tutto \(201{,}3\) M per strato, cioè \(6{,}44\) miliardi di parametri sui 32 strati (embedding esclusi): un modello «da 7 miliardi», nel gergo corrente. La FFN è quella classica a due matrici della sezione sull’architettura; con una variante gated come SwiGLU le matrici diventano tre, e allora dipende da che cosa si tiene fisso: a \(d_{\text{ff}}\) invariato il primo termine cresce di metà, mentre riducendo \(d_{\text{ff}}\) a \(\tfrac{8}{3}d_{\text{model}}\), che è la pratica corrente vista nella sezione sull’architettura, resta identico. Il bilancio qui sviluppato usa la FFN a due matrici.
Ora sostituiamo ogni FFN con \(N = 8\) esperti della stessa taglia. I parametri totali diventano
mentre i parametri attivi, quelli che un singolo token attraversa davvero, con \(k = 1\) valgono
cioè esattamente quanto il modello denso di partenza. Quasi sei volte i parametri (\(36{,}5 / 6{,}44 \approx 5{,}7\)) a parità di aritmetica per token. Se la FFN fosse SwiGLU, a \(d_{\text{ff}}\) invariato il rapporto salirebbe a \((8 \times 201{,}3 + 67{,}1)/(201{,}3 + 67{,}1) = 6{,}25\), mentre con \(d_{\text{ff}}\) ridotto a \(\tfrac{8}{3}d_{\text{model}}\) resterebbe \(5{,}7\). Con \(k = 2\) ed esperti della stessa taglia gli attivi salgono a \(10{,}7\) miliardi, \(1{,}7\) volte il denso; per pareggiare del tutto si riduce la \(d_{\text{ff}}\) di ciascun esperto, così che due esperti dimezzati costino quanto una FFN intera. Mixtral 8x7B [JSR+24] ha scelto l’altra strada: \(k = 2\) su \(N = 8\) esperti SwiGLU di taglia piena (\(d_{\text{ff}} = 14\,336\)), su 32 strati con \(d_{\text{model}} = 4096\). La stessa formula, con tre matrici per esperto invece di due, dà circa 47,2 miliardi di parametri totali e 13,4 attivi. Le cifre dichiarate nell’annuncio di Mistral, 46,7 e 12,9 (l’articolo le arrotonda a 47 e 13), sono più basse di circa mezzo miliardo, e per due cause che spingono in versi opposti. Mixtral usa la GQA (otto teste di chiave e valore per trentadue di query: 42 M per strato invece di 67), che sui 32 strati toglie \(0{,}8\) miliardi; gli embedding e la testa di uscita, che la formula non conta, ne aggiungono \(0{,}26\). Il nome suggerirebbe \(8 \times 7 = 56\), ma l’attenzione e gli embedding non si moltiplicano: si moltiplicano solo le FFN.
Gli esperti a grana fine portano fino in fondo l’idea di ridurre la \(d_{\text{ff}}\). DeepSeekMoE [DDZ+24] divide ogni esperto in \(m\) pezzi con dimensione interna \(d_{\text{ff}}/m\) e ne attiva \(mk\) su \(mN\): parametri totali e attivi non cambiano, ma le combinazioni di esperti possibili passano da \(\binom{N}{k}\) a \(\binom{mN}{mk}\) (con \(N = 16\), \(k = 2\) e \(m = 4\), da \(120\) a circa \(4{,}4 \times 10^9\)). Isola poi \(K_s\) esperti condivisi, che ogni token attraversa sempre e che nelle intenzioni degli autori raccolgono il sapere comune, così che gli esperti instradati non debbano ripeterlo ciascuno per conto suo:
dove \(g_i(\mathbf{x})\) è la softmax dei punteggi degli esperti instradati, presa su tutti e non rinormalizzata sugli scelti. DeepSeek-V3 [DeepSeekAI24b] ha un esperto condiviso e 256 instradati, di cui 8 attivi per token, ciascuno con \(d_{\text{ff}} = 2048\), e tiene densi i primi tre strati.
Il router pesa poco: una matrice \(\mathbf{W}_g \in \mathbb{R}^{N \times d_{\text{model}}}\) per strato, cioè \(8 \times 4096 = 32\,768\) parametri, poco più di un milione sull’intero modello, lo \(0{,}003\%\) del totale.
Che cosa comprano i parametri in più? Nelle prove di Switch Transformer, a pari operazioni per token, il modello con 64 esperti raggiunge la qualità di T5-Base in un settimo del tempo di addestramento [FZS22]. Il guadagno però non è proporzionale ai parametri totali: la loss di un modello a esperti migliora come una legge di potenza nel numero di esperti, e il miglioramento si riduce al crescere della taglia del modello di base [CdlCG+22]; il modello denso con gli stessi parametri totali, che a ogni token costa molto più calcolo, ne resta il limite superiore [DDZ+24].
Un modello fatto così si chiama sparso, perché per ogni token accende solo una parte di sé; quello di prima, che accendeva tutto, si chiama denso. Un modello sparso ha due taglie, e vanno citate in coppia: i parametri totali dicono quanta memoria serve per ospitarlo, i parametri attivi quanto calcolo costa ogni token. Mixtral 8x7B ne ha circa 47 e 13 miliardi [JSR+24]; un denso da 6,44 miliardi di parametri, con la FFN di ogni strato sostituita da otto esperti di cui uno attivo per token, ne avrebbe 36,5 totali e 6,44 attivi. Citato da solo, uno dei due numeri fa credere a un modello molto più grande, o molto più piccolo, di quello che è.
Come sceglie il router#
Il router è uno strato lineare: dal vettore \(\mathbf{x}\) che rappresenta il token ricava \(N\) punteggi, uno per esperto, ciascuno con un prodotto scalare fra \(\mathbf{x}\) e una riga della sua matrice, lo stesso confronto con cui l’attenzione misura una query contro una key. Poi si tengono i \(k\) punteggi più alti, si trasformano in pesi che sommano a uno (i pesi della miscela, da non confondere con i parametri del modello), e l’uscita dello strato è la combinazione degli esperti scelti con quei pesi.
Vediamolo con quattro esperti e numeri veri. Arriva un token; il router lo guarda ed emette quattro punteggi:
esperto |
1 |
2 |
3 |
4 |
|---|---|---|---|---|
punteggio |
\(2{,}0\) |
\(0{,}5\) |
\(1{,}5\) |
\(-1{,}0\) |
Con \(k = 2\) si tengono i due migliori, l’esperto 1 e l’esperto 3, e gli altri due si buttano via: per questo token semplicemente non esistono. Restano da decidere le proporzioni della miscela, cioè da trasformare due punteggi (\(2{,}0\) e \(1{,}5\)) in due percentuali che sommino a cento. La ricetta standard si chiama softmax, ed è una divisione con un passaggio in più: si prende il numero \(e = 2{,}718\ldots\), lo si eleva a ciascun punteggio (elevare a un esponente con la virgola è la stessa idea delle potenze che si conoscono, solo più fine: lo fa una calcolatrice, e più il punteggio è alto più il risultato cresce), e si divide ciascun risultato per la somma di tutti. Sui nostri due, \(e^{2{,}0} = 7{,}39\) e \(e^{1{,}5} = 4{,}48\), che sommati fanno \(11{,}87\); quindi \(7{,}39 / 11{,}87 = 0{,}62\) e \(4{,}48 / 11{,}87 = 0{,}38\). Due pesi che sommano a uno, con il primo un po’ più pesante perché il suo punteggio era più alto. (L’elevamento a potenza serve a due cose: non far uscire mai numeri negativi, e allargare le differenze, così che mezzo punto di vantaggio conti davvero.)
L’uscita è la media pesata delle due risposte: il 62% di quella dell’esperto 1 più il 38% di quella dell’esperto 3. Il token ha attraversato due reti su quattro, e le altre due sono rimaste ferme: nessun calcolo, nessun costo.
Un dettaglio che sembra un cavillo e invece conta: la softmax si applica dopo il taglio, non prima. Applicata a tutti e quattro (stessa ricetta, ma dividendo per la somma di quattro numeri invece che di due) darebbe \(0{,}53\), \(0{,}12\), \(0{,}32\) e \(0{,}03\), e i due scelti insieme farebbero solo \(0{,}85\): buttare via il resto lascerebbe l’uscita sistematicamente più piccola del dovuto. Rinormalizzando sui soli scelti, il cento per cento viene sempre distribuito.
Con un esperto solo, però, la regola va lasciata cadere: rinormalizzato su di lui, il suo peso varrebbe sempre cento per cento, qualunque voto avesse preso, e il voto non conterebbe più niente. Chi ne sceglie uno solo gli lascia allora la proporzione calcolata su tutti e quattro, lo \(0{,}53\) di prima.
Quanto costa scegliere? Poco o niente. Un punteggio è il confronto fra due liste di numeri, e di confronti ne servono quattro, uno per esperto; la rete di un esperto, in un modello vero, di conti ne fa milioni. Il router può permettersi di dare un voto a tutti proprio perché il voto costa così poco.
C’è poi una variante che, prima di tagliare, aggiunge a ogni punteggio un pizzico di casualità. Così chi resta fuori per un soffio entra ogni tanto; e soprattutto il conto di quanti pezzi toccano a ciascun esperto smette di andare a scatti e diventa una probabilità, che si può correggere di poco alla volta. È quella probabilità che serve a tenere il lavoro bilanciato.
Sia \(\mathbf{x} \in \mathbb{R}^{d_{\text{model}}}\) la rappresentazione di un token in ingresso allo strato, \(\mathbf{W}_g \in \mathbb{R}^{N \times d_{\text{model}}}\) la matrice del router e \(E_1, \dots, E_N\) gli esperti (ciascuno una FFN indipendente). I pesi di miscelazione sono
dove \(\text{top-}k(\cdot)\) conserva le \(k\) componenti maggiori e pone le altre a \(-\infty\) (così la softmax le manda a zero esatto e normalizza sui soli sopravvissuti: è la formulazione di Shazeer e colleghi [SMM+17]). L’uscita dello strato è
dove \(G(\mathbf{x})_i\) è il peso assegnato all’esperto \(i\) (i pesi dei selezionati sommano a 1) ed \(E_i(\mathbf{x})\) la sua risposta. Con i punteggi \(\mathbf{W}_g \mathbf{x} = (2{,}0;\ 0{,}5;\ 1{,}5;\ -1{,}0)\) e \(k = 2\) sopravvivono gli indici 1 e 3, con
La rinormalizzazione sui soli \(k\) scelti ha un limite: con \(k = 1\) il peso vale sempre \(1\), qualunque sia il punteggio, e il router non riceve gradiente dalla loss principale, che lo raggiunge soltanto attraverso i pesi. Switch Transformer [FZS22], che sceglie un esperto solo, prende allora la softmax su tutti gli \(N\) punteggi, prima del taglio, e non rinormalizza:
Il peso è un numero minore di \(1\) che dipende dal punteggio, e il gradiente arriva; per di più, attraverso la normalizzazione, ne ricevono uno anche i punteggi degli esperti esclusi. Le due scritture differiscono solo per il denominatore: \(G(\mathbf{x})_i = p_i(\mathbf{x}) / \sum_{j \in \text{top-}k} p_j(\mathbf{x})\), cioè la softmax dei \(k\) punteggi sopravvissuti è la softmax su tutti divisa per la massa dei sopravvissuti (nell’esempio \(p_1 = 0{,}53\) e \(p_1 + p_3 = 0{,}85\), da cui di nuovo \(0{,}62\)).
Il costo del router è \(O(N\,d_{\text{model}})\) per token, contro \(O(k\,d_{\text{model}}\,d_{\text{ff}})\) degli esperti: con \(N = 8\), \(d_{\text{model}} = 4096\) e \(d_{\text{ff}} = 16384\), sono \(32\,768\) moltiplicazioni contro i \(134\) milioni di un solo esperto. Il costo della selezione è trascurabile.
Una variante del lavoro del 2017 aggiunge casualità: il noisy top-k gating, prima di prendere i \(k\) migliori, somma ai punteggi un rumore gaussiano di ampiezza appresa, \(H(\mathbf{x})_i = (\mathbf{W}_g\mathbf{x})_i + \varepsilon_i\, \operatorname{softplus}\bigl((\mathbf{W}_{\text{noise}}\mathbf{x})_i\bigr)\) con \(\varepsilon_i \sim \mathcal{N}(0, 1)\). Il rumore serve a rendere derivabile la stima del carico [SMM+17]: il numero di token che toccano a un esperto è un conteggio, e non si deriva, mentre la probabilità che l’esperto entri fra i \(k\) migliori, sotto il rumore, è una funzione liscia dei punteggi, e su di essa si costruisce una loss di bilanciamento. Di passaggio dà anche a un esperto sfavorito la possibilità di essere scelto ogni tanto.
La scelta dei \(k\) esperti è discreta: un esperto è dentro o fuori, senza vie di mezzo. Il gradiente non attraversa un taglio del genere: spostando di poco un punteggio, quasi sempre, non cambia chi entra e chi resta fuori, quindi la derivata della loss rispetto alla scelta è nulla. Come fa allora il router a imparare a smistare?
Impara dai pesi della miscela, che sono continui e dipendono dai punteggi. Se un esperto scelto ha dato una risposta utile, la loss scende alzando il suo peso, cioè il punteggio che il router gli aveva dato, e la volta dopo un token simile lo sceglierà più volentieri. Il router viene corretto sul risultato degli esperti che ha scelto, mai direttamente sulla scelta.
E gli esperti non scelti? Non ricevono gradiente per quel token: nessuna correzione, nessun modo di dimostrare che avrebbero fatto meglio. Chi non lavora non sbaglia, e chi non sbaglia non impara. È questa asimmetria a far risparmiare calcolo, ed è anche all’origine del guasto tipico dei modelli a esperti.
Il collasso del router#
Senza contromisure il router tende a convergere su pochi esperti, sempre gli stessi: quelli favoriti si addestrano più in fretta e vengono scelti ancora di più, un circolo che si rinforza da solo [SMM+17], e gli altri restano parametri inutilizzati. Il collasso è una proprietà della dinamica dell’addestramento.
Torniamo in redazione. All’inizio gli otto redattori valgono più o meno uguale, e lo smistatore assegna i pezzi un po’ a caso. Per puro effetto del sorteggio il numero 7 ne riceve qualcuno in più. Scrivendo di più migliora; migliorando, lo smistatore impara che i pezzi mandati a lui vengono bene; e allora gliene manda ancora. Dopo un mese il 7 e altri due lavorano diciotto ore al giorno, e cinque colleghi non hanno mai toccato un articolo. Siccome non ne hanno mai toccato uno non hanno imparato niente, e non diventeranno mai bravi abbastanza da meritarsene uno. Il circolo si stringe da solo: il giornale paga otto stipendi per tre redattori, e la ragione per cui li aveva assunti in otto è svanita.
La cura è amministrativa. A fine mese il direttore guarda un numero solo, quanto il giornale ha sbagliato, e tutto il suo mestiere è farlo scendere. Da adesso a quel numero si aggiunge una seconda voce, che sale quando il lavoro è sbilanciato. Pesa un centesimo della prima, il valore scelto da chi l’ha proposta: così poco che, quando specializzarsi rende davvero, al giornale conviene accettare un po’ di squilibrio, e abbastanza da non poter essere ignorata.
Il direttore la calcola così. Per ogni redattore segna due numeri: la quota dei pezzi che gli sono arrivati davvero, e la quota di gradimento che lo smistatore gli dà in media, contando anche i pezzi finiti poi a un altro. Moltiplica i due numeri, redattore per redattore, e somma. Con quattro redattori e otto pezzi: al primo ne arrivano cinque, al secondo due, al terzo uno, al quarto nessuno, cioè le quote \(5/8\), \(2/8\), \(1/8\) e \(0\); i gradimenti medi sono \(0{,}56\), \(0{,}24\), \(0{,}16\) e \(0{,}04\). I prodotti fanno \(0{,}35 + 0{,}06 + 0{,}02 + 0 = 0{,}43\), e moltiplicato per quattro, il numero dei redattori, \(1{,}72\). Se invece ognuno avesse ricevuto due pezzi con un gradimento di un quarto, ogni prodotto varrebbe un sedicesimo, la somma un quarto, e per quattro esattamente uno: la moltiplicazione finale serve a far valere uno il mese equo in una redazione di qualunque grandezza. Più il lavoro si concentra, più la voce sale sopra uno. Spinge, però, senza garantire: se la maggior parte dei pezzi va a un redattore preferito per un soffio, mentre il gradimento medio pende da un’altra parte, il conto può scendere sotto uno anche con il lavoro sbilanciato.
La correzione, poi, si può fare su uno solo dei due numeri. I pezzi consegnati o sono cinque o sono sei, e non si ritoccano di un’inezia; il gradimento sì. Allora si taglia il gradimento di ciascuno in proporzione ai pezzi che ha ricevuto: al primo, che ne ha presi cinque, si taglia di più, al quarto, che non ne ha preso nessuno, niente; e il quarto risale da solo, perché i gradimenti sono quote e devono sempre sommare a cento.
La contromisura standard è una loss ausiliaria di bilanciamento, sommata alla cross-entropia con un coefficiente piccolo. Nella forma di Switch Transformer [FZS22], per un batch \(\mathcal{B}\) di \(T\) token e \(N\) esperti:
dove \(p(\mathbf{x})\) è la distribuzione softmax del router sul token \(\mathbf{x}\), presa su tutti gli \(N\) punteggi prima del taglio (un vettore di \(N\) componenti, \(p_i(\mathbf{x})\) quella dell’esperto \(i\): non coincide con \(G(\mathbf{x})\), che vale zero fuori dai \(k\) scelti), \(f_i\) è la frazione di token effettivamente instradati all’esperto \(i\) (un conteggio), \(P_i\) la probabilità media che il router gli ha assegnato (una quantità continua) e \(\alpha\) il peso della penalità, \(10^{-2}\) nel paper. La definizione di \(f_i\) con l’\(\arg\max\) è quella di Switch, che sceglie un esperto solo; con \(k > 1\) si conta l’appartenenza ai \(k\) scelti, \(f_i = \frac{1}{kT}\sum_{\mathbf{x}\in\mathcal{B}} \mathbb{1}\{i\in\text{top-}k(\mathbf{x})\}\), così che \(\sum_i f_i = 1\) e il termine valga ancora \(1\) a carico uniforme. Anche la forma del peso cambia da un modello all’altro: softmax sui soli scelti in Shazeer e colleghi e in Mixtral, softmax su tutti senza rinormalizzare in Switch e in DeepSeekMoE, sigmoide normalizzata fra gli scelti in DeepSeek-V3.
Perché quel prodotto spinge verso il carico uniforme? Entrambi i vettori, \((f_i)\) e \((P_i)\), stanno sul simplesso (\(\sum_i f_i = \sum_i P_i = 1\)) e tendono a essere allineati, perché l’instradamento segue l’\(\arg\max\) delle stesse probabilità che compongono le \(P_i\): gli esperti con \(P_i\) alto sono di norma quelli con \(f_i\) alto. In quel regime si può sostituire \(f_i\) con \(P_i\) (una sostituzione dichiarata, non una conseguenza: è lecita solo dove l’\(\arg\max\) è netto) e il prodotto scalare si comporta come \(\sum_i P_i^2\). Su quella somma vale Cauchy-Schwarz, applicata al vettore \((P_i)\) e al vettore di tutti uno, che insieme al vincolo \(\sum_i P_i = 1\) dà
con uguaglianza se e solo se \((P_i)\) è proporzionale al vettore di tutti uno, cioè se e solo se il carico è uniforme. Moltiplicando per \(N\) si ottiene un termine che vale \(1\) sul carico uniforme e cresce man mano che il carico si concentra. È un argomento euristico, non un teorema: con punteggi quasi in pareggio l’allineamento fra \((f_i)\) e \((P_i)\) si allenta, ed esistono configurazioni non uniformi in cui il termine scende sotto \(1\). Fedus e colleghi, del resto, presentano la loss come un incentivo al bilanciamento, non come una garanzia. Un esempio con \(N = 4\) e \(T = 8\) token, con cinque token al primo esperto, due al secondo, uno al terzo e nessuno al quarto: \((f_i) = (0{,}625;\ 0{,}25;\ 0{,}125;\ 0)\) e \((P_i) = (0{,}56;\ 0{,}24;\ 0{,}16;\ 0{,}04)\) danno \(4 \times 0{,}43 = 1{,}72\), contro l’\(1{,}00\) del caso uniforme.
Il dettaglio elegante è dove passa il gradiente. Il conteggio \(f_i\) non è differenziabile (è la stessa selezione discreta di prima), quindi la derivata scorre solo attraverso \(P_i\):
cioè una spinta verso il basso proporzionale al carico già ricevuto. Gli esperti affollati si vedono abbassare i punteggi in proporzione a quanto sono affollati; quelli vuoti non ricevono alcuna spinta negativa e risalgono per differenza. A instradamento fissato la penalità è lineare nelle \(P_i\), e in quel regime è ben condizionata: il gradiente non dipende da dove ci si trova sul simplesso. È una linearità locale, però, non globale: \((f_i)\) dipende dagli stessi parametri del router, e quando l’instradamento cambia cambia anche il coefficiente della penalità, il che riporta il paesaggio della loss ausiliaria fra le cose che si osservano, non fra quelle che si dimostrano.
Due lavori successivi toccano il quadro. ST-MoE [ZBK+22] non sostituisce la loss di bilanciamento: le somma una router z-loss, con peso \(10^{-3}\), \(\frac{1}{T}\sum_{\mathbf{x}}\big(\log\sum_j e^{(\mathbf{W}_g\mathbf{x})_j}\big)^2\), che serve a un altro scopo, la stabilità: tiene piccoli i logit del router, e con essi gli errori di arrotondamento delle esponenziali in precisione ridotta. DeepSeek-V3 [DeepSeekAI24b] risponde invece ai difetti della loss ausiliaria, che con un peso alto peggiora anche la qualità: ne tiene solo una versione per sequenza con un peso minimo (\(10^{-4}\)), contro gli squilibri estremi dentro uno stesso testo, e il resto lo fa un bias \(b_i\) sommato a ogni punteggio, usato solo per scegliere i \(k\) esperti e non per pesarli: dopo ogni passo lo si abbassa di poco agli esperti sovraccarichi e lo si alza a quelli scarichi. Il bilanciamento passa così, per la parte maggiore, dalla loss a una regola di controllo, e il gradiente della cross-entropia ne resta quasi libero.
La capacità, e i token che cadono#
Il bilanciamento è solo una spinta statistica: in un batch qualunque un esperto può comunque ricevere più token di quanti ne possa elaborare. Molte implementazioni fissano allora in anticipo una capacità, cioè il numero massimo di token che ciascun esperto accetta per batch: il carico medio, moltiplicato per un margine di sicurezza e arrotondato per eccesso,
dove \(T\) è il numero di token del batch, \(N\) il numero di esperti, \(k\) quanti ne sceglie ogni token, così che \(kT/N\) è il carico di ciascuno in un mondo perfettamente equo, e \(c\) il capacity factor, cioè il margine, appena sopra 1 (fra \(1{,}0\) e \(1{,}25\) nelle prove di Switch Transformer [FZS22], che ha \(k = 1\); GShard [LLX+21], con \(k = 2\), dà a ogni esperto \(2T/N\) posti per ogni gruppo di \(T\) token). Le parentesi con gli angoli sono l’arrotondamento all’intero superiore. Il conto su un esempio minuscolo, con \(k = 1\): con \(T = 8\) token e \(N = 4\) esperti, in un mondo perfettamente equo ne toccherebbero due a testa; il margine \(c = 1{,}25\) li porta a \(2 \times 1{,}25 = 2{,}5\), che arrotondato per eccesso fa \(3\). Un esperto che si vedesse assegnare cinque token ne elabora dunque tre e ne lascia cadere due. Con \(k = 2\) il carico medio raddoppia, e con esso la capacità: dimenticare la \(k\) vorrebbe dire, con \(c = 1\), far cadere metà delle assegnazioni anche a carico perfettamente uniforme.
Che cosa succede ai token caduti? Nulla di drammatico e nulla di visibile. Lo strato non produce niente per quel token, e resta la connessione residua della sezione sull’attenzione (la «scorciatoia»): l’uscita del blocco si somma all’ingresso, quindi il token attraversa lo strato immutato, come se lì non ci fosse. Nessun errore, nessun messaggio: solo un po’ di qualità in meno, distribuita in modo silenzioso. Alzare \(c\) riduce i token caduti ma alloca buffer più grandi, cioè spreca memoria per posti mai occupati. E con un tetto c’è una conseguenza più insidiosa: il destino di un token dipende dagli altri token del batch, quindi lo stesso identico input, in compagnia diversa, può ricevere un trattamento diverso, e il modello smette di essere una funzione del solo esempio. Chi ne cerca un guasto deve saperlo.
Il tetto però non è obbligatorio. MegaBlocks [GNYZ23] non scarta mai un token e lascia che ogni esperto ne riceva un numero variabile (è l’implementazione che l’articolo di Mixtral indica), e DeepSeek-V3 dichiara di non scartarne né in addestramento né in inferenza [DeepSeekAI24b]. Il costo si sposta allora sui kernel, che devono moltiplicare matrici di taglia diversa per ogni esperto, e sul bilanciamento, che deve tenere corte le code.
Il conto si sposta, non sparisce#
Il risparmio riguarda il calcolo, non la memoria: gli esperti che nessun token attraversa non consumano aritmetica, ma i loro pesi devono restare caricati, perché il token successivo potrebbe sceglierli.
Otto stipendi, otto scrivanie. Anche i redattori fermi occupano il loro posto, e la sala riunioni resta lì per tutti: l’ufficio deve essere quasi sei volte quello di prima. Se non ci sta, i redattori vanno distribuiti in sedi diverse sparse per la città, e allora lavorare su un pezzo costa poco ma consegnarlo costa tanto: ogni articolo attraversa la città per arrivare al suo specialista, e la riattraversa per andare in stampa.
Le sedi sparse per la città sono vere. Un modello di questa taglia, mentre impara, non sta su una scheda grafica sola (i processori specializzati nel fare tanti conti insieme): lo si spezza fra molte schede, e gli esperti finiscono su schede diverse. Il lavoro risparmiato torna allora come traffico, due traversate della città per ogni piano, andata e ritorno. Il viavai conviene solo se ogni specialista, ricevuto il pezzo, ci lavora molto più a lungo di quanto il furgone abbia impiegato ad arrivare; e le sedi più lontane si usano il meno possibile.
I furgoni, poi, non si possono caricare la sera prima. Quanti pezzi tocchino a ciascuna sede lo decide lo smistatore la mattina stessa, un articolo alla volta (si può prenotare un furgone di misura fissa, ma allora parte spesso mezzo vuoto), e finché i furgoni sono per strada le sedi stanno ferme ad aspettare. Se il lavoro è sbilanciato, la sede affollata fa aspettare tutte le altre, che hanno finito da un pezzo. Tenere il carico pari serve a far uscire un buon giornale, e serve anche a non pagare venti sedi per farne lavorare tre.
Quando poi il giornale scrive (cioè quando il modello genera il testo, una parola alla volta), il tempo se ne va in un posto che nessuno guarda. Le scrivanie di una sede sono migliaia e le loro penne vanno velocissime, perché sono fatte apposta per quello: sono i conti. Ma la roba con cui si scrive, cioè quello che il modello ha imparato, sta in faldoni giù in archivio, e dall’archivio alle scrivanie c’è un montacarichi solo. Le penne aspettano i faldoni, e la giornata se ne va tutta in quell’attesa. E un giornale a esperti, quando scrive, sta risparmiando proprio sulle penne.
Che il risparmio si senta dipende da quanti articoli sono in lavorazione insieme. Uno alla volta, i due faldoni degli specialisti scelti sono gli unici da tirare su: il montacarichi fa pochi viaggi e il vantaggio si sente per intero. Centinaia insieme, ciascuno chiama i suoi, e su per il montacarichi finiscono per passare quasi tutti i faldoni: la fatica torna quella dell’archivio intero, tutti e trentasei i miliardi, e le penne restano quasi ferme. Il vantaggio torna con migliaia di articoli in lavorazione: allora ogni faldone salito serve a tanti pezzi che il viaggio si ripaga, l’attesa torna sulle penne, e sulle penne il giornale a esperti risparmia davvero. Nel mezzo, con qualche centinaio di articoli, le due cose tirano in direzioni opposte.
Il conto in memoria è immediato. Il modello sparso da \(36{,}5\) miliardi di parametri, in precisione a 16 bit, occupa \(36{,}5 \times 2 \approx 73\) GB di soli pesi, contro i \(12{,}9\) GB del modello denso che gli costa la stessa aritmetica per token. Quasi sei volte la memoria per lo stesso calcolo: il baratto è esplicito.
In addestramento distribuito la strategia naturale è l’expert parallelism, già nominato nella sezione sul parallelismo distribuito accanto agli assi dati, tensor e pipeline: gli esperti di ciascuno strato si spartiscono fra le schede, una manciata per GPU. Il pattern di comunicazione che ne nasce non è l’all-reduce del parallelismo dati, ma un all-to-all: ogni GPU spedisce a ogni altra i token destinati agli esperti che quella ospita, e ne riceve indietro le uscite. Due all-to-all per strato MoE, andata e ritorno: ogni token manda il suo vettore a \(k\) esperti e ne riceve \(k\) uscite, cioè \(2k\,d_{\text{model}}\) elementi a token, per strato e per passata in avanti, meno la parte che resta sulla stessa scheda. Quanto pesino lo dice il rapporto fra operazioni e byte scambiati: un esperto fa circa \(4\,d_{\text{model}}\,d_{\text{ff}}\) operazioni per token e ne scambia \(2\,d_{\text{model}}\) elementi, cioè \(d_{\text{ff}}\) operazioni per byte in 16 bit, qualunque siano \(k\) e \(d_{\text{model}}\). Per nascondere la comunicazione dietro il calcolo quel rapporto deve superare quello fra calcolo e banda della rete, che per le GPU Shazeer e colleghi stimano nell’ordine delle migliaia [SMM+17]; fra nodi diversi, dove la banda è minore, DeepSeek-V3 manda ogni token al più su quattro nodi, proprio per contenere quel costo [DeepSeekAI24b].
Due proprietà rendono l’all-to-all scomodo. Primo, con i buffer a capacità fissa
il volume è costante ma in parte vuoto, fatto di posti riservati e mai occupati,
mentre senza tetto dipende dalla distribuzione del routing, che cambia a ogni
batch: è traffico irregolare, difficile da sovrapporre al calcolo come si fa
con l’all-reduce di DistributedDataParallel. Secondo, è una barriera
implicita: la GPU con l’esperto più affollato detta il ritmo a tutte le altre.
Questa, accanto alla qualità del modello, è la ragione economica della loss di
bilanciamento.
In inferenza vale il quadro che la sezione su LLMOps riprenderà in dettaglio: la generazione è memory-bound, e il tempo per token è dominato dalla lettura dei pesi dalla memoria della GPU, non dall’aritmetica. La sparsità qui aiuta in modo condizionato, e la condizione è il batch. Con poche sequenze in volo si leggono davvero solo i \(k\) esperti selezionati, e la latenza per token è quella del modello piccolo: un vantaggio reale. Ma appena il batch cresce, token diversi scelgono esperti diversi. Con routing uniforme la probabilità che un esperto resti fuori da \(T\) token è \((1 - k/N)^T\), che con \(N = 8\) e \(k = 2\) scende sotto l’\(1\%\) già a \(T = 17\), e con i 256 esperti e \(k = 8\) di DeepSeek-V3 a \(T = 146\): la lettura torna quasi completa, e il modello si comporta, in banda, come i suoi \(73\) GB. La sparsità del calcolo non si traduce automaticamente in sparsità del traffico di memoria.
Il vantaggio ritorna quando il batch è tanto grande che ogni esperto, da solo, satura il calcolo. Un esperto che riceve \(m\) token fa circa \(2m\) operazioni per ogni parametro letto, cioè \(m\) operazioni per byte in 16 bit, e supera il ginocchio del roofline (circa 300 operazioni per byte su una H100) quando \(m\) arriva a qualche centinaio; con routing uniforme servono allora circa \(mN/k\) token in volo per strato, un migliaio per \(N/k = 4\) e quasi diecimila per i 256 esperti e \(k = 8\) di DeepSeek-V3. È il motivo per cui un modello a esperti servito su larga scala spartisce gli esperti su molte schede: DeepSeek-V3 ne usa 32 per leggere i prompt e 320 per generare, perché a ogni esperto arrivi un batch abbastanza grande [DeepSeekAI24b]. Nell’intervallo di mezzo, con batch di decine o centinaia di token, i due obiettivi tirano in direzioni opposte.
La mixture of experts sposta dunque il collo di bottiglia dal calcolo alla memoria e alla comunicazione. Conviene a chi addestra su molte macchine collegate da reti veloci, a chi serve poche richieste per volta e a chi ne serve così tante da tenere occupato ogni esperto; rende meno a chi deve stipare il modello in una macchina sola o lavora nell’intervallo di mezzo.
Da un’idea del 1991#
L’idea era pronta trent’anni prima dell’hardware che l’ha resa utile. Nel 1991 Robert Jacobs, Michael Jordan, Steven Nowlan e Geoffrey Hinton pubblicano su Neural Computation un articolo intitolato Adaptive Mixtures of Local Experts [JJNH91]. La proposta è già tutta lì: più reti separate, e una gating network (letteralmente «rete cancello», l’antenato del router) che impara a pesarle a seconda di quello che le arriva davanti, così che ciascuna si specializzi su un tipo di dati invece di fare un compromesso mediocre su tutto. Manca però il pezzo che ci interessa qui: la miscela era densa, cioè si facevano lavorare tutti gli esperti e poi si faceva la media delle loro risposte. L’architettura serviva a farli imparare meglio, senza alcun risparmio di calcolo.
Il salto è del 2017, con Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer di Noam Shazeer e colleghi [SMM+17], lo stesso anno di Attention Is All You Need [VSP+17] e con un autore in comune. Qui il gating diventa sparso: si calcolano solo i \(k\) esperti scelti, e la miscela smette di essere un modo di combinare modelli per diventare un modo di comprare parametri senza comprare aritmetica. Lo strato viene infilato fra strati LSTM (l’articolo esce a gennaio, i Transformer arriveranno cinque mesi dopo) e arriva a contenere fino a 137 miliardi di parametri. È anche il lavoro che mette a fuoco lo squilibrio di carico e il collasso del router (osservato prima da Eigen, Ranzato e Sutskever [ERS13], che lo curavano con un tetto imposto a mano sulle assegnazioni) e che introduce una loss ausiliaria per correggerlo mentre il modello impara.
Nel 2020 GShard [LLX+21], pubblicato in conferenza l’anno dopo, porta il meccanismo dentro il Transformer nella forma che ancora usiamo: la rete feed-forward di uno strato ogni due sostituita da un banco di esperti, due esperti per token, il tetto alla capacità con i token che cadono, e gli esperti sparsi su migliaia di acceleratori che si scambiano token in continuazione (il modello da 600 miliardi di parametri è addestrato su 2048 TPU in quattro giorni). Poco più di sei mesi dopo, nel gennaio 2021, Switch Transformer [FZS22], uscito su rivista l’anno dopo, fa la scelta controintuitiva di un solo esperto per token (il top-1, dove GShard teneva i primi due). Gli autori attribuiscono a Shazeer e colleghi la congettura che ne servissero almeno due perché il router ricevesse un gradiente: con le proporzioni ricalcolate sul solo esperto scelto, il suo peso vale sempre uno, qualunque punteggio gli sia stato assegnato, e un numero che non cambia non insegna niente al router.
Fedus, Zoph e Shazeer non ricalcolano le proporzioni: il peso resta la probabilità calcolata su tutti gli \(N\) esperti, un numero minore di uno che dipende dal punteggio, e il gradiente arriva al router. La rinormalizzazione serve quando gli scelti sono più d’uno, per non perdere per strada una parte dell’uscita; con uno solo il peso diventa un fattore di scala che cambia da token a token. Scegliere un solo esperto dimezza inoltre il traffico fra le schede, semplifica il codice e permette tetti di capacità più bassi.
Switch Transformer porta anche gli accorgimenti che rendono stabile
l’addestramento, e il più istruttivo riguarda la precisione dei numeri. Per
andare più in fretta il modello li scrive in un formato a 16 bit, bfloat16, ma
il router lavora in float32, a 32 bit: dei 16 bit del primo, quelli che
portano le cifre significative sono 8, contro i 24 del secondo. La ragione la
spiega un lavoro successivo, ST-MoE [ZBK+22]: l’esponenziale della
softmax amplifica gli errori di arrotondamento. Con dieci punteggi a \(128\) e uno
a \(128{,}5\), in bfloat16 il \(128{,}5\) diventa \(128\), e il peso dell’esperto
migliore scende da \(0{,}142\) a \(0{,}091\). L’ordine dei punteggi cambia di rado;
il peso che moltiplica l’uscita dell’esperto cambia di oltre un terzo.
Dal 2024 l’architettura sparsa è la scelta di diversi modelli aperti di grandi
dimensioni: Mixtral 8x7B (articolo del gennaio 2024) ha circa 47 miliardi di
parametri totali e 13 attivi [JSR+24], DeepSeek-V3 (dicembre
2024) 671 e 37 [DeepSeekAI24b]. I limiti documentati sono due. Il
primo riguarda la rifinitura: rifiniti direttamente su un compito piccolo, i
modelli sparsi tendono a sovradattarsi, e Switch Transformer alza per questo il
dropout dentro gli esperti (0,4 contro lo 0,1 del resto); se passano prima per
l’instruction tuning descritto nella sezione sul post-training, il quadro cambia, perché ne guadagnano più dei modelli densi
[SHZ+24]. Il secondo riguarda la specializzazione: nell’analisi del
routing di Mixtral la distribuzione degli esperti è quasi la stessa per
articoli scientifici di arXiv, di biologia e di filosofia, e a distinguere i
token è piuttosto la sintassi (la parola self del codice Python, i rientri)
[JSR+24]; nel 2017, su un modello a LSTM, Shazeer e colleghi
avevano visto esperti specializzati per sintassi e per significato. «Esperti» è
una metafora comoda, non una descrizione verificata.
In pratica: uno strato MoE in PyTorch#
La classe StratoMoE implementa lo strato per intero, e si legge in quattro
tempi: il router dà un punteggio a ogni esperto per ogni token, i punteggi
diventano probabilità, torch.topk tiene i \(k\) esperti migliori con i loro
pesi, e ogni esperto lavora soltanto sui token che lo hanno scelto. Mancano le
ottimizzazioni vere (lo smistamento dei token fra le schede, i buffer di
capacità preallocati), e il ciclo for sugli esperti sarebbe inaccettabile su
scala. Manca anche la loss di bilanciamento, e quella riguarda la correttezza:
chi addestrasse questo strato così com’è andrebbe incontro, con ogni
probabilità, al collasso del router. Per calcolarla bastano poche righe, a
partire da indici e probabilita, che il forward ha già in mano.
import torch
from torch import nn


class StratoMoE(nn.Module):
    """Uno strato Mixture of Experts: N esperti FFN e un router top-k."""

    def __init__(self, d_model=64, d_ff=256, n_esperti=8, k=2):
        super().__init__()
        self.k = k
        self.esperti = nn.ModuleList([
            nn.Sequential(
                nn.Linear(d_model, d_ff),
                nn.GELU(),
                nn.Linear(d_ff, d_model),
            )
            for _ in range(n_esperti)
        ])
        self.router = nn.Linear(d_model, n_esperti, bias=False)  # la matrice W_g

    def forward(self, x):                       # x: [batch, seq, d_model]
        forma = x.shape
        x = x.reshape(-1, forma[-1])            # i token diventano una lista piatta
        punteggi = self.router(x)               # [T, N]: un punteggio per esperto
        probabilita = torch.softmax(punteggi, dim=-1)   # p(x), su tutti gli N
        valori, indici = torch.topk(probabilita, self.k, dim=-1)  # i k migliori
        if self.k > 1:
            # rinormalizzati sui k scelti: e' la softmax dei soli k punteggi
            pesi = valori / valori.sum(dim=-1, keepdim=True)
        else:
            # k = 1, come in Switch: il peso resta p_i < 1 e il router impara
            pesi = valori

        y = torch.zeros_like(x)
        for i, esperto in enumerate(self.esperti):
            # quali token hanno scelto l'esperto i, e in quale delle k posizioni
            token, posto = (indici == i).nonzero(as_tuple=True)
            if token.numel() == 0:
                continue                        # esperto inutilizzato in questo batch
            contributo = esperto(x[token])      # solo i suoi token, non tutti
            y[token] = y[token] + pesi[token, posto].unsqueeze(-1) * contributo
        return y.reshape(forma)
I pesi sono le probabilità dei \(k\) esperti
sopravvissuti al topk, divise per la loro somma: è la rinormalizzazione sui
soli scelti, e coincide con la softmax dei soli \(k\) punteggi. Con \(k = 1\) quella
divisione darebbe sempre \(1\) e il router non imparerebbe, e il codice lascia
allora la probabilità com’è, come fa Switch Transformer. E l’esperto viene
chiamato su x[token], un sottoinsieme delle righe: è qui che il calcolo si
risparmia davvero, perché se nessuno lo ha scelto non viene eseguito affatto.
Un controllo dei conti, con gli iperparametri di default, e del caso \(k = 1\):
torch.manual_seed(0)
strato = StratoMoE(d_model=64, d_ff=256, n_esperti=8, k=2)

x = torch.randn(2, 5, 64)          # 2 frasi da 5 token
print(strato(x).shape)             # la forma non cambia

per_esperto = sum(p.numel() for p in strato.esperti[0].parameters())
router = strato.router.weight.numel()
totali = sum(p.numel() for p in strato.parameters())
attivi = per_esperto * strato.k
print(per_esperto, per_esperto * 8, router, totali, attivi)
print(f"{totali / attivi:.3f} {totali / (attivi + router):.2f}")

# con un esperto solo per token il router riceve ancora un gradiente?
uno = StratoMoE(d_model=64, d_ff=256, n_esperti=8, k=1)
uno(x).pow(2).sum().backward()
print(bool(uno.router.weight.grad.norm() > 1e-3))
torch.Size([2, 5, 64])
33088 264704 512 265216 66176
4.008 3.98
True
Il conto, in italiano. Ogni esperto è fatto di due matrici, una che allarga il vettore del token da 64 numeri a 256 e una che lo ricomprime a 64, più un termine costante per ciascuna delle uscite: \(64 \times 256 + 256\) per la prima, \(256 \times 64 + 64\) per la seconda, in tutto \(33\,088\) parametri. Otto esperti ne fanno \(264\,704\); il router, che tiene 64 numeri per ciascuno degli otto esperti, ne aggiunge \(512\); totale \(265\,216\).
Ogni token, però, attraversa soltanto due esperti, cioè \(33\,088 \times 2 =
66\,176\) parametri: un quarto, che è poi la frazione \(k/N = 2/8\) degli esperti
che lavorano. Lo strato sa quattro volte quello che gli costa lavorare una
parola. Il rapporto stampato è \(4{,}008\) invece di \(4\) perché nel totale ci sono
anche i \(512\) parametri del router, che negli attivi non sono contati;
contandoli da tutte e due le parti viene \(3{,}98\). L’ultima riga controlla il
caso \(k = 1\): con il peso lasciato alla probabilità, come in Switch, il router
riceve un gradiente; con la rinormalizzazione il gradiente sarebbe nullo a meno
degli arrotondamenti, qualche milionesimo, e la stessa riga stamperebbe
False.
Lo strato è intercambiabile con la FFN di un blocco Transformer: stessa forma in ingresso e in uscita, quindi si innesta in un’architettura esistente senza ridisegnarla. È una delle ragioni per cui la mixture of experts si è diffusa in fretta, insieme al guadagno di qualità a parità di calcolo per token.
Da ricordare
La miscela di esperti prende il momento di lavoro individuale di ogni strato (la parte che contiene due terzi dei numeri imparati) e lo moltiplica: molti blocchi in parallelo, gli esperti, più uno smistatore, il router, che per ogni parola ne sceglie pochi, uno o due nei modelli più noti. Un modello così non si racconta con un numero solo: uno dice quanto è grande, cioè quanta memoria occupa; l’altro quanto fatica su ogni parola, cioè quanto costa farlo scrivere. Più esperti lo rendono migliore, ma ognuno in più aggiunge meno del precedente.
Lo smistatore dà un voto a ciascun esperto, tiene i migliori e mescola le loro risposte in proporzione ai voti (il \(62\%\) di uno, il \(38\%\) dell’altro). La scelta in sé è un taglio netto, e da un taglio non si impara nulla: lo smistatore migliora guardando com’è andata a chi ha mandato il pezzo, cioè attraverso le proporzioni della miscela. Per questo, quando l’esperto scelto è uno solo, la sua proporzione resta quella calcolata su tutti: ricalcolata su di lui varrebbe sempre cento per cento, e non insegnerebbe niente.
Lasciato a sé, lo smistatore collassa: manda tutto ai soliti pochi, che lavorando migliorano ancora, mentre gli altri non toccano un articolo e non impareranno mai. La cura è amministrativa: una voce in più nella pagella del modello che punisce lo sbilanciamento (un incentivo, non una garanzia). In molti modelli c’è poi un tetto ai pezzi che un esperto accetta per turno: quelli in eccesso attraversano lo strato senza essere lavorati, in silenzio.
Si risparmia fatica, non spazio: i redattori fermi prendono lo stipendio e occupano una scrivania lo stesso. Quando stanno in edifici diversi il costo si sposta sul viavai, perché ogni articolo attraversa la città per arrivare al suo specialista e poi torna indietro. E quando il modello scrive, il tempo se ne va più ad andare a prendere quello che sa che a fare i conti: uno che sa moltissimo e fatica poco su ogni parola attacca il lato sbagliato del problema. Quanto pesi dipende però da quante richieste si servono insieme: una alla volta il vantaggio si sente tutto, a centinaia insieme sparisce, e torna solo con migliaia di richieste, tante da tenere occupato ogni specialista.
L’idea è del 1991 [JJNH91], ma allora ogni pezzo passava per tutti gli esperti e delle loro risposte si faceva la media: un buon modo di organizzare il lavoro, non di risparmiarlo. Il salto è del 2017 [SMM+17], quando si calcolano davvero solo gli esperti scelti; poi Switch Transformer [FZS22] mostra che per ogni parola ne basta uno solo, purché il suo peso non venga ricalcolato su di lui.
«Esperti» è una metafora comoda: le specialità che emergono seguono più la grammatica che l’argomento, e questi modelli sono più delicati da rifinire su compiti piccoli, meno se prima hanno imparato a seguire le istruzioni.
Da ricordare
La mixture of experts sostituisce la rete feed-forward di uno strato con \(N\) esperti paralleli più un router che per ogni token ne sceglie \(k\) (uno in Switch Transformer, due in Mixtral, otto su 256 in DeepSeek-V3). Un modello sparso si descrive con due numeri e non con uno: parametri totali (la memoria) e parametri attivi (il calcolo per token). La qualità cresce meno che in proporzione ai parametri totali: la loss migliora come una legge di potenza nel numero di esperti [CdlCG+22].
Il router è uno strato lineare: \(G(\mathbf{x}) = \operatorname{softmax}(\text{top-}k(\mathbf{W}_g \mathbf{x}))\) e \(\mathbf{y} = \sum_{i \in \text{top-}k} G(\mathbf{x})_i E_i(\mathbf{x})\). La selezione è discreta e non differenziabile: il gradiente arriva al router attraverso i pesi \(G(\mathbf{x})_i\) degli esperti scelti, e con \(k = 1\) solo se il peso non è rinormalizzato (Switch Transformer usa \(p_{i^\ast}(\mathbf{x})\), la softmax su tutti gli \(N\)).
Senza contromisure il router collassa su pochi esperti, in un circolo che si rinforza da solo. La cura è una loss ausiliaria \(\alpha N \sum_i f_i P_i\) [FZS22], che resta bassa quando il lavoro è distribuito in parti uguali e cresce quando si concentra su pochi esperti (un incentivo, non una garanzia: l’argomento regge finché l’\(\arg\max\) tiene allineati \((f_i)\) e \((P_i)\)). Un eventuale tetto di capacità, \(\lceil c\,kT/N \rceil\) token per esperto, fa cadere quelli in eccesso, che attraversano lo strato immutati grazie alla connessione residua; MegaBlocks e DeepSeek-V3 non ne usano.
Si risparmia calcolo, non memoria: tutti gli esperti devono risiedere da qualche parte. In addestramento il costo si sposta sulla comunicazione (expert parallelism, all-to-all); in inferenza il limite di banda della generazione autoregressiva pesa di più con batch di decine o centinaia di token, e si allenta quando ogni esperto riceve abbastanza token da saturare il calcolo.
La linea storica va dalla miscela densa del 1991 [JJNH91] allo strato sparso del 2017 [SMM+17], fino a Switch Transformer [FZS22], che mostra come un solo esperto per token basti, se il suo peso resta la probabilità su tutti gli \(N\).
«Esperti» è una metafora comoda: nell’analisi del routing di Mixtral la specializzazione segue la sintassi più che l’argomento, e i modelli sparsi rifiniti direttamente su compiti piccoli tendono a sovradattarsi, meno dopo l’instruction tuning.
Denso o sparso, il modello che esce dal pre-addestramento resta un completatore di testo: per farne un interlocutore serve il post-training.