


Sorvegliare un modello vivo#
Quando i dati cambiano aveva lasciato un’immagine: un modello acceso, che sta rispondendo a persone vere, va trattato «come un impianto, non come un quadro appeso». Un quadro, una volta appeso, non chiede più niente a nessuno; un impianto invece vive, consuma, si scalda, si stara, e va sorvegliato con una sala di controllo piena di spie e manometri. Lì l’immagine era servita a dire perché serve monitorare. Restava tutto il seguito: quali strumenti montare su quell’impianto, dove piazzare le spie, a che soglia farle scattare e cosa fare quando una si accende: il lato operativo di quel problema, che là era posto in termini statistici.
Il guaio dei modelli, rispetto a un impianto industriale, è che quando si guastano non fanno rumore. Una pompa che si rompe fischia, perde, si ferma; un modello che ha smesso di capire il mondo continua a rispondere con la stessa prontezza di sempre, e nessun errore segnala che le risposte, poco alla volta, stanno diventando sbagliate. Il monitoraggio fa le veci del fischio che manca: decide quali grandezze misurare, a quale soglia allarmarsi e che cosa fare quando la soglia scatta.
Che cosa si misura#
La prima domanda è banale solo in apparenza: che cosa mettiamo, esattamente, sui manometri? Le cose da tenere d’occhio stanno su tre livelli, che vanno dal più facile e immediato al più prezioso e lento. Impararli separati è importante, perché ciascuno risponde a una domanda diversa e ha tempi diversi.
Il cruscotto di un’auto ha tre famiglie di indicatori, e ti dicono cose diverse.
Il primo quadrante sono le spie di base: motore acceso, temperatura, livello della benzina. Ti dicono se la macchina funziona come macchina: si accende, non fuma, risponde all’acceleratore. Per un modello è la stessa cosa: il servizio è vivo? Risponde in fretta? Ogni tanto va in errore? Queste spie si accendono in un istante e non hanno bisogno di sapere niente di dove stai andando. E «in fretta» non si misura sulla media: una macchina che parte al primo colpo novantanove volte su cento, e alla centesima ti pianta in mezzo all’incrocio, in media parte benissimo.
Il secondo quadrante ti dice come stai guidando adesso: che tipo di strada è, quante curve, quanto vai piano. Per un modello: che tipo di richieste stanno arrivando, e che tipo di risposte sta dando. Se ieri gli arrivavano email lunghe in media 80 parole e oggi ne arrivano da 200, o se ieri segnalava spam il 20% dei messaggi e oggi il 45%, il quadrante te lo mostra subito, anche se non sai ancora se sia un bene o un male.
Il terzo quadrante è il più importante e il più lento: sei arrivato dove volevi? Lo scopri solo alla fine del viaggio, confrontando dove sei con dove volevi andare. Per un modello è la qualità vera: aveva ragione? E la risposta giusta (l’utente ha davvero cliccato, il paziente era davvero malato) spesso arriva con giorni o settimane di ritardo. A volte non arriva mai.
Il secondo quadrante si muove mentre sei ancora in strada e puoi accostare; il terzo parla a viaggio finito. Per questo le spie di mezzo contano più di quanto sembrino: sono le sole che si accendono quando puoi ancora fare qualcosa.
I tre livelli danno tre famiglie di metriche, diverse per natura e soprattutto per latenza: le prime due si leggono sul traffico così com’è, la terza aspetta le etichette vere.
Metriche di sistema (salute del servizio). Sono le stesse dell’ingegneria dei sistemi distribuiti: latenza (di norma i percentili, \(p_{50}\) e soprattutto \(p_{99}\), non la media, che nasconde le code lente), tasso di errore (risposte 5xx, eccezioni, timeout), throughput e uptime. Non dicono nulla sulla correttezza delle predizioni, ma sono disponibili in tempo reale e sono la prima cosa che si rompe.
Proprietà statistiche di input e output. Le distribuzioni delle feature in ingresso e delle predizioni in uscita: media, varianza, quantili, frazione di valori mancanti per ogni feature; e, per un classificatore, il tasso di ciascuna classe predetta \(\hat{p}_c = \frac{1}{N}\sum_{i=1}^{N}\mathbb{1}[\hat{y}_i = c]\), dove \(N\) è il numero di richieste nella finestra e \(\hat{y}_i\) la classe predetta per la \(i\)-esima. Non richiedono le etichette vere: si calcolano sul traffico così com’è, e sono l’allarme anticipato del drift.
Qualità vera (metriche di modello: accuratezza, F1, calibrazione, errore di regressione). Sono ciò che davvero ci interessa, ma richiedono le etichette vere, e qui sta il problema strutturale del label delay [Huy22]: l’etichetta arriva in ritardo (il rimborso del prestito si scopre a mesi, la diagnosi confermata a settimane) o non arriva affatto. La qualità vera è quindi una metrica ritardata, e per questo i proxy statistici del livello 2 diventano una necessità: sono l’unica spia che si accende prima che il danno sia misurabile.
I livelli due e tre sono i controlli già abbozzati nella sezione «Quando i dati cambiano» (che cosa entra, che cosa esce, quanto si sbaglia), qui resi più precisi. Il livello uno invece è nuovo, ed è lo strato più prosaico e più spesso dimenticato di tutti. Un modello può servire predizioni perfette e restare inutile: perché risponde in tre secondi quando l’utente ne aspetta uno, o perché va in errore su un input malformato che nessuno aveva previsto. La correttezza è inutile se il servizio è morto.
Rilevare il drift in pratica#
Il secondo livello, quello che guarda che tipo di richieste stanno arrivando e che risposte stanno uscendo, è dove si gioca la partita della deriva (il drift: da qui in poi le due parole valgono l’una per l’altra). Nella sezione «Quando i dati cambiano» abbiamo già classificato i modi in cui il mondo può allontanarsi da com’era durante l’addestramento [QuinoneroCSSL09], e qui non serve rifare quel discorso: basta richiamare i tre nomi, con accanto in una riga che cosa vuol dire ciascuno.
Il covariate shift è quando cambia il tipo di richieste che arrivano: arriva altra gente, con altre caratteristiche. Il label shift è quando cambiano le proporzioni delle risposte giuste: le frodi erano una su cento e adesso sono una su dieci. Il concept shift è il più insidioso: le richieste sembrano identiche, ma è cambiata la regola che lega la richiesta alla risposta giusta, e quindi il modello continua a rispondere come ha imparato mentre la risposta corretta è diventata un’altra.
Qui ci interessa il gesto operativo: come ci si accorge che uno di questi è in corso, mentre accade.
Lo strumento l’abbiamo già incontrato: un classificatore addestrato a distinguere i dati di ieri da quelli di oggi. Il suo nome è test a due campioni con classificatore (classifier two-sample test), e in «Quando i dati cambiano» lo abbiamo chiamato, più brevemente, il detective. Il numero con cui si misura quanto ci riesce è l’AUC, incontrata parlando di metriche, e qui va letta così: vale \(1\) quando il detective indovina sempre da quale dei due periodi viene un dato, e vale \(0{,}5\) quando sta tirando a indovinare: fra un dato di ieri e uno di oggi, scegliendo a caso, si indovina una volta su due.
Un’AUC vicina a \(0{,}5\) dice quindi che i due periodi sono indistinguibili per lui. È una rassicurazione, non una prova. Le colonne dei dati (nel gergo del mestiere le feature, ed è il nome che portano anche nel codice) possono essere decine, e se uno spostamento piccolo ne tocca una o due soltanto, il detective non lo distingue dalle differenze che il caso produce comunque fra due settimane qualsiasi: l’AUC non si muove. Se invece uno spostamento altrettanto piccolo tocca molte colonne insieme, il detective lo trova, anche quando ciascuna colonna, presa da sola, si è mossa di pochissimo: sommare indizi piccoli è il mestiere per cui esiste.
In quella sezione il detective era una diagnosi fatta una volta sola. Per un impianto acceso va invece trasformato in una sorveglianza continua, e questo obbliga a decidere tre cose. Primo, che cosa si confronta con che cosa: si sceglie un periodo in cui il modello stava bene (è la finestra di riferimento, e resta ferma) e lo si paragona a quello appena trascorso, che invece scorre in avanti giorno dopo giorno (la finestra corrente). Secondo, quanto in alto mettere l’asticella: sopra quale valore dell’AUC far scattare l’allarme. Terzo, come capire dove, cioè quale colonna dei dati è cambiata, perché sapere soltanto che qualcosa è cambiato non dice a nessuno che cosa fare.
Il detective è come il metal detector all’aeroporto: non deve sapere che cosa porti in valigia, gli basta accorgersi che qualcosa è diverso dal solito e far scattare un bip.
«Il solito» però va scelto, e poi va scelto con che cosa confrontarlo. Da una parte si tiene ferma una settimana in cui non era successo niente: quello è il metro. Dall’altra c’è chi sta passando adesso, e lì si decide quanto indietro guardare: con gli ultimi dieci passeggeri basta una comitiva di sciatori con gli scarponi e sembra cambiato il mondo; con l’ultimo mese, quando l’allarme suona, chi doveva passare è già passato.
Poi il metal detector va tarato con giudizio. Se è troppo sensibile suona per la fibbia della cintura di tutti, e dopo il decimo falso allarme le guardie smettono di dargli retta, che è il modo peggiore di fallire. Se è troppo sordo lascia passare il coltello. Tararlo bene significa scegliere la soglia giusta: abbastanza alta da non suonare per ogni respiro del mondo, abbastanza bassa da non perdere il cambiamento vero. E quando suona, serve una seconda ispezione che dica dove (quale tasca, quale feature) è cambiato qualcosa, altrimenti il bip da solo non aiuta a decidere.
In notazione, le tre famiglie sono il covariate shift (\(P(\mathbf{x})\) che cambia, con \(P(y \mid \mathbf{x})\) invariata), il label shift (\(P(y)\) che cambia, con \(P(\mathbf{x} \mid y)\) invariata) e il concept shift (\(P(y \mid \mathbf{x})\) che cambia). Le tre decisioni operative sono:
Finestre temporali. Si fissa una finestra di riferimento (un periodo in cui il modello era sano, spesso i dati di addestramento o un mese «buono») e la si confronta con una finestra corrente che scorre: le ultime \(n\) richieste, o le richieste dell’ultimo giorno. Finestre corte reagiscono in fretta ma sono rumorose; finestre lunghe sono stabili ma lente.
Soglia sull’indicatore. L’AUC del detective va da circa \(0{,}5\) (finestre che quel classificatore non distingue) a \(1\) (perfettamente separabili); per rumore campionario, senza alcuno shift, oscilla attorno a \(0{,}5\), anche sotto. Per un punteggio fissato, la deviazione standard dell’AUC sotto l’ipotesi nulla è quella della statistica di Mann–Whitney, \(\sqrt{(n_1+n_2+1)/(12\,n_1 n_2)}\), cioè \(0{,}009\) per due finestre di duemila record; per un classificatore addestrato e valutato in validazione incrociata la dispersione è maggiore, e la distribuzione nulla si stima per permutazione, rimescolando le etichette «ieri» e «oggi». Una soglia come \(0{,}65\) sta comunque molto oltre quell’oscillazione: non la si tara sui falsi allarmi, che a quella distanza non arrivano, ma sull’errore opposto, cioè su quanto scostamento si è disposti a lasciar passare senza accorgersene.
Test per singola feature. Il detective è un test multivariato: dice se qualcosa è cambiato, non cosa. Per localizzare si affianca un test univariato colonna per colonna, tipicamente il test di Kolmogorov–Smirnov a due campioni, la cui statistica è la massima distanza verticale tra le due funzioni di ripartizione empiriche,
\[ D = \sup_x \left| F_{\text{rif}}(x) - F_{\text{cur}}(x) \right|, \]dove \(F_{\text{rif}}\) e \(F_{\text{cur}}\) sono le CDF empiriche della feature nella finestra di riferimento e in quella corrente. Il test presuppone osservazioni indipendenti dentro ciascuna finestra e una variabile continua: con serie autocorrelate, come sono quasi sempre i dati di un servizio, il \(p\)-value esce troppo piccolo, e con valori ripetuti (interi, colonne discrete) il test diventa conservativo; l’ampiezza \(D\) resta comunque interpretabile. E un test univariato, per costruzione, non vede i cambi nella dipendenza fra colonne. Un’alternativa diffusa, basata sugli istogrammi, è il Population Stability Index. Sul versante multivariato il detective è il classifier two-sample test di [LPO17], e ha un concorrente senza addestramento, la maximum mean discrepancy [GBR+12]: con un nucleo \(k\) (per esempio gaussiano), \(\mathrm{MMD}^2 = \mathbb{E}[k(\mathbf{x},\mathbf{x}')] + \mathbb{E}[k(\mathbf{z},\mathbf{z}')] - 2\,\mathbb{E}[k(\mathbf{x},\mathbf{z})]\), con \(\mathbf{x},\mathbf{x}'\) estratti in modo indipendente dalla finestra di riferimento e \(\mathbf{z},\mathbf{z}'\) da quella corrente (vettori di feature, non etichette). Con un nucleo caratteristico vale zero se e solo se le due distribuzioni coincidono; la stima costa \(O(n^2)\) valutazioni del nucleo, la soglia si ottiene per permutazione, e la scelta della larghezza del nucleo fa la parte che nel detective fa il classificatore. Il confronto sistematico di queste procedure, riduzione di dimensione seguita da test univariati con correzione o da un classificatore, è di Rabanser, Günnemann e Lipton [RGunnemannL19]: nelle loro prove i test KS con correzione di Bonferroni sulle uscite di un classificatore già addestrato sono i migliori, e il classificatore che distingue le finestre è debole con un centinaio di campioni o meno, e recupera quando i campioni crescono.
Sul criterio di allarme il riflesso abituale è quello sbagliato. Alle taglie di una finestra di produzione (migliaia di record) il KS ha una potenza enorme: uno spostamento di due decimi di deviazione standard, che nessun modello sente, su \(n = 2000\) per finestra dà tipicamente \(p \sim 10^{-7}\), e il rifiuto arriva su ogni finestra simulata. La correzione di Bonferroni non risolve il problema, perché agisce sull’asse sbagliato: protegge dai rifiuti falsi dovuti alla molteplicità dei test, mentre qui i rifiuti sono veri, e davanti a scostamenti così i \(p\)-value stanno comunque molti ordini di grandezza sotto qualunque soglia, corretta o no. L’allarme va quindi fondato sull’ampiezza (\(D\), o una distanza normalizzata, o il PSI) con una soglia decisa sul significato pratico, tenendo il \(p\)-value al più come filtro contro il rumore delle finestre piccole.
Il PSI (Population Stability Index), lo standard di fatto nel mondo del credito, è una di quelle ampiezze. Si dividono i valori in fasce (di solito i decili della finestra di riferimento) e si somma, fascia per fascia,
\[ \mathrm{PSI} \;=\; \sum_i \,(q_i - r_i)\,\log\frac{q_i}{r_i}, \]dove \(r_i\) e \(q_i\) sono le quote di riferimento e correnti nella fascia \(i\). È la divergenza di Kullback–Leibler simmetrizzata fra le due ripartizioni, \(\mathrm{KL}(q\,\|\,r) + \mathrm{KL}(r\,\|\,q)\), e la pratica la legge con soglie di mestiere (sotto \(0{,}1\) quiete, oltre \(0{,}25\) deriva da guardare), che sono una regola empirica del credito e non il risultato di un conto. Il PSI infatti dipende dalla taglia dei campioni. Con \(B\) fasce fissate e due finestre di \(n_r\) e \(n_c\) record estratte dalla stessa distribuzione, \(\mathrm{PSI}/(1/n_r + 1/n_c)\) si distribuisce approssimativamente come un \(\chi^2\) con \(B-1\) gradi di libertà, quindi il PSI vale in media \((B-1)(1/n_r + 1/n_c)\) anche quando non è cambiato niente [YN20]: con dieci fasce e duecento record per finestra fa \(0{,}09\), già a ridosso della soglia di quiete. Gli stessi autori mostrano che con lo \(0{,}1\) i falsi allarmi sono troppi finché le due finestre non superano qualche centinaio di record ciascuna, e che la potenza delle due soglie cala al crescere della taglia. La soglia va quindi fissata sulla taglia delle finestre e sul numero di fasce, per esempio come quantile di quella distribuzione, non copiata. Una fascia vuota da una parte manda il logaritmo all’infinito, quindi nelle implementazioni si fondono le fasce troppo magre oppure si aggiunge a ciascuna una quota minima prima di dividere. E copre anche il caso a cui la KS non si applica, le colonne categoriche, dove la categoria assente da una parte è la norma e non l’eccezione: lì la stessa somma si fa con le categorie al posto delle fasce, oppure si usa un test chi-quadro sulle frequenze, con la stessa avvertenza di prima sull’eccesso di potenza.
La deriva ha una particolarità: in un fotogramma non si vede. Il grafico dei valori di oggi, da solo, non è né normale né anomalo, e lo diventa solo accanto a quello di prima. In Fig. 36.8 ci sono sei mesi di una stessa colonna: la finestra di riferimento sta ferma e quella corrente le scivola via, mese dopo mese.
Le due curve del disegno non sono i valori grezzi ma la loro cumulata: a ogni punto dell’asse orizzontale, la curva dice quale frazione dei dati sta sotto quel valore. Comincia da zero a sinistra, arriva a uno a destra, e se i dati scivolano verso destra la curva scivola con loro. Il numero che misura la deriva è allora il più semplice possibile: quanto le due curve si allontanano nel punto in cui sono più lontane, che nel disegno è il segmento verticale. Si chiama \(D\), e il controllo che lo calcola porta il nome dei due statistici che l’hanno costruito, Kolmogorov per la versione a un campione e Smirnov per quella a due campioni che serve qui, in sigla KS.

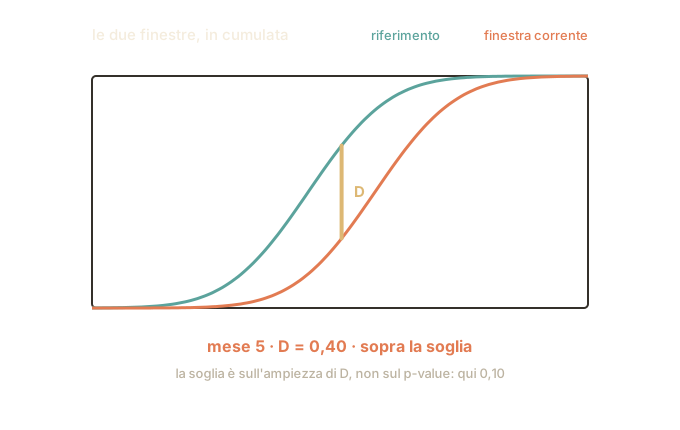
Fig. 36.8 Le due finestre in cumulata, mese per mese. Il segmento verticale è la statistica \(D\), cioè il punto in cui le due curve si allontanano di più. Il numero sotto è quello che decide se suonare l’allarme, e cresce da un mese all’altro: \(0\) al mese zero, \(0{,}06\) al mese 1, e poi \(0{,}12\), \(0{,}20\), \(0{,}29\), \(0{,}40\).#
Due cose il disegno le mostra e il numero \(D\), da solo, non direbbe. La prima è dove cade il segmento: non ai bordi, perché lì le due curve tornano comunque a coincidere, l’una partendo da zero e l’altra arrivando a uno, ma nel mezzo: quando una distribuzione simmetrica si sposta senza cambiare forma, come in questo disegno, esattamente a metà strada fra il centro di ieri e il centro di oggi (con una forma asimmetrica, o con una larghezza che cambia, il punto si sposta altrove). La seconda è che la soglia disegnata, quel \(0{,}10\), è una soglia sull’ampiezza del segmento, decisa su quanto si è disposti a lasciar scivolare le cose prima di preoccuparsi.
C’è infatti un altro numero che il KS restituisce, e usarlo come soglia è un errore comune.
Il controllo, oltre a \(D\), restituisce un secondo numero, che si chiama \(p\)-value e che dice quanto sarebbe improbabile vedere uno scarto così grande se in realtà non fosse cambiato niente. Se quel numero è minuscolo (la soglia abituale è \(0{,}05\): se nulla fosse cambiato, uno scarto così uscirebbe meno di cinque volte su cento), si conclude che qualcosa è cambiato davvero. Sembra la spia perfetta, e invece è una spia che, con i numeri di un servizio vero, suona sempre.
Il motivo è che il \(p\)-value non dipende solo da quanto le cose sono cambiate: dipende anche da quanti dati hai guardato. Con pochi dati un piccolo scarto può benissimo essere frutto del caso; con moltissimi dati, lo stesso identico piccolo scarto non può più esserlo, e il controllo lo dichiara reale.
Lo si vede sul mese 1 della figura, quello in cui la deriva è appena cominciata: lì il segmento \(D\) vale sei centesimi, cioè molto meno dei dieci centesimi della soglia. Adesso immagina di rifare la misura di quello stesso mese duemila volte, ripescando ogni volta dati diversi. Con duemila dati per finestra il controllo grida «è cambiato!» in circa il \(99\%\) di quelle duemila ripetizioni. Con cinquecento dati per finestra, e la deriva identica, grida solo in poco più della metà. Fra i due casi è cambiato quanti dati avevi in mano, non il mondo.
Morale: il \(p\)-value risponde alla domanda «è cambiato qualcosa?», che in un servizio vero è quasi sempre sì. La domanda che serve a chi deve decidere è un’altra, «è cambiato abbastanza da darmi fastidio?», e a quella risponde soltanto l’ampiezza del segmento.
L’altro numero è il \(p\)-value, e l’eccesso di potenza si legge sui sei mesi della deriva in un caso solo. Il valore critico al cinque per cento, che per finestre di uguale taglia vale circa \(1{,}36\sqrt{2/n}\), a \(n = 2000\) scende a \(0{,}043\): meno della metà della soglia di ampiezza disegnata, e già sotto il \(D\) del mese 1, che vale \(0{,}060\). (Per due normali di uguale varianza sfalsate di \(\Delta\) deviazioni standard il massimo cade a metà strada e vale \(D = 2\Phi(\Delta/2) - 1\), con \(\Phi\) la ripartizione della normale standard: \(0{,}060\) per \(\Delta = 0{,}15\).) Cioè il test rifiuta quando l’occhio non vede ancora niente.
Il conto, su quel mese: due normali di uguale varianza sfalsate di \(0{,}15\) deviazioni standard, che è lo scostamento del mese 1, duemila ripetizioni, con duemila e poi con cinquecento osservazioni per finestra.
import numpy as np
from scipy.stats import ks_2samp

rng = np.random.default_rng(0)
for n in (2000, 500):
    p = np.array([ks_2samp(rng.normal(0, 1, n), rng.normal(0.15, 1, n)).pvalue
                  for _ in range(2000)])
    print(f"n = {n}: rifiuti al 5% = {(p < 0.05).mean():.1%}, "
          f"p mediano = {np.median(p):.1e}")
n = 2000: rifiuti al 5% = 98.7%, p mediano = 8.3e-05
n = 500: rifiuti al 5% = 52.7%, p mediano = 5.0e-02
Con duemila osservazioni il test rifiuta quasi sempre, con un \(p\) mediano dell’ordine di \(10^{-4}\); alla stessa identica deriva, con cinquecento, il rifiuto scende a poco più della metà delle prove e il \(p\) mediano risale attorno a \(5\cdot 10^{-2}\). Non è cambiato lo scostamento: è cambiata la taglia del campione, e con essa la potenza del test.
Le finestre le diamo per scelte, e mettiamo in poche righe eseguibili le altre due decisioni, la soglia e la localizzazione. Il codice confronta una finestra di riferimento con una corrente, in cui iniettiamo di proposito una deriva su una sola feature: calcola l’AUC del detective come indicatore globale, stampa un allarme se supera la soglia, e in caso di allarme usa un KS per colonna per dire quale feature è cambiata. In coda ci sono due prove su una tavola più larga, quaranta colonne, che servono a vedere dove il detective arriva e dove no.
import numpy as np
from scipy.stats import ks_2samp
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.model_selection import cross_val_score

rng = np.random.default_rng(0)

# Finestra di riferimento (il "passato" su cui il modello e' tarato)
# e finestra corrente (le ultime richieste arrivate in produzione).
n, d = 2000, 4
riferimento = rng.normal(0.0, 1.0, size=(n, d))
corrente = rng.normal(0.0, 1.0, size=(n, d))
corrente[:, 1] += 1.2   # drift iniettato solo sulla feature 1

def punteggio_drift(rif, cur):
    """AUC del detective: quanto e' facile distinguere le due finestre."""
    X = np.vstack([rif, cur])
    y = np.hstack([np.zeros(len(rif)), np.ones(len(cur))])
    detective = HistGradientBoostingClassifier(random_state=0)
    return cross_val_score(detective, X, y, cv=5, scoring="roc_auc").mean()

SOGLIA = 0.65  # AUC oltre la quale scatta l'allarme
auc = punteggio_drift(riferimento, corrente)
print(f"AUC detective = {auc:.3f}")

if auc > SOGLIA:
    print(f"ALLARME: drift rilevato (AUC {auc:.3f} > {SOGLIA})")
    # Localizziamo: un test di Kolmogorov-Smirnov per ogni feature.
    for j in range(d):
        stat, p = ks_2samp(riferimento[:, j], corrente[:, j])
        # si segnala sull'ampiezza, non sul p-value: a questa taglia di
        # finestra il p e' minuscolo anche su scostamenti che nessuno sente
        sospetta = "  <-- sospetta" if stat > 0.10 else ""
        print(f"  feature {j}: KS={stat:.3f}  p={p:.1e}{sospetta}")
else:
    print("Nessun drift rilevabile: il detective non distingue le finestre.")

# Dove il detective arriva e dove no: quaranta colonne, e lo stesso
# scostamento per colonna (0,15 deviazioni standard) prima su una colonna
# sola, poi su tutte e quaranta. Il KS si legge sulle colonne DERIVATE, non sul
# massimo delle quaranta: il massimo cresce con quante colonne guardi, quindi
# confrontarlo fra i due casi misurerebbe la selezione e non la deriva.
n_colonne = 40
rif40 = rng.normal(0.0, 1.0, size=(n, n_colonne))
for etichetta, derivate in [("su una colonna sola", [1]),
                            ("su tutte e quaranta", list(range(n_colonne)))]:
    cur40 = rng.normal(0.0, 1.0, size=(n, n_colonne))
    cur40[:, derivate] += 0.15
    ks = [ks_2samp(rif40[:, j], cur40[:, j]).statistic for j in range(n_colonne)]
    tipico = sorted(ks[j] for j in derivate)[len(derivate) // 2]
    print(f"deriva {etichetta:19}: AUC = {punteggio_drift(rif40, cur40):.3f}, "
          f"KS tipico delle derivate = {tipico:.3f}, "
          f"colonne oltre la soglia: {sum(v > 0.10 for v in ks)}")
AUC detective = 0.775
ALLARME: drift rilevato (AUC 0.775 > 0.65)
  feature 0: KS=0.028  p=4.1e-01
  feature 1: KS=0.447  p=3.2e-180  <-- sospetta
  feature 2: KS=0.020  p=7.9e-01
  feature 3: KS=0.022  p=7.2e-01
deriva su una colonna sola: AUC = 0.502, KS tipico delle derivate = 0.079, colonne oltre la soglia: 0
deriva su tutte e quaranta: AUC = 0.698, KS tipico delle derivate = 0.074, colonne oltre la soglia: 1
L’output stampa AUC detective = 0.775, ben oltre la soglia di \(0{,}65\):
l’allarme scatta. Poi il controllo colonna per colonna, cioè lo stesso KS della
figura di poco fa, punta senza esitazioni la colonna 1 e lascia innocenti le
altre tre: lì lo scarto massimo fra le due curve vale \(0{,}45\), e sulle altre
resta attorno a due o tre centesimi, cioè al livello che il caso produce da
solo. (Il \(0{,}45\) è più grande del \(0{,}40\) della figura perché qui lo
scostamento non è cresciuto per sei mesi: gliel’abbiamo iniettato tutto in una
volta, e più grande.)
Le due prove su quaranta colonne dicono dove il detective arriva e dove no, con
uno scostamento piccolo, quindici centesimi di deviazione standard, cioè un
movimento minuscolo rispetto a quanto quei numeri ballano già da soli. Le
colonne toccate si spostano della stessa quantità nei due casi, e infatti il KS
tipico è quasi identico, 0.079 contro 0.074: il controllo colonna per
colonna vede la stessa cosa tutt’e due le volte, e tutt’e due le volte non
arriva a dire niente di utile. Nel primo caso nessuna colonna supera lo \(0{,}10\)
dell’allarme; nel secondo ne supera una sola, e chi guardasse quella andrebbe a
cercare il guasto in una colonna mentre a muoversi sono tutte e quaranta. A
cambiare è il detective, che passa da AUC = 0.502 con lo scostamento su una
colonna sola, cioè il livello del caso, a AUC = 0.698 quando lo stesso
scostamento tocca tutte e quaranta, e lì l’allarme scatta. Sommare quaranta
indizi piccoli gli dà quello che nessuno dei quaranta, da solo, poteva dargli.
Attenzione a non leggerla come una gara alla pari: nella seconda prova a
muoversi sono quaranta colonne invece di una, quindi il mondo si è spostato di
più (la distanza fra i centri delle due nuvole cresce come la radice del numero
di colonne: \(0{,}15\sqrt{40} \approx 0{,}95\) deviazioni standard invece di
\(0{,}15\)), e non è la deriva di prima divisa fra più colonne. È
proprio il caso che interessa, perché una deriva vera si presenta così, un po”
dappertutto; il merito del detective sta nel raccoglierla mentre il controllo
colonna per colonna, davanti allo stesso identico movimento, non vede niente.
È lo scheletro di un sistema di monitoraggio reale, e la stessa funzione, girata a ogni ora sulla finestra scorrevole, produce una serie storica dell’indicatore di drift su cui si possono appendere gli allarmi. Ha però due semplificazioni didattiche che in un impianto vero si pagano care, e conviene nominarle proprio perché il codice è breve e viene copiato.
La prima è il cancello: qui i test per singola feature girano solo se l’indicatore globale ha superato la soglia. Comodo da leggere, pericoloso da copiare. Un cambiamento piccolo, concentrato su una colonna sola fra molte, può lasciare l’indicatore globale al livello del caso, e allora il programma non guarda nessuna colonna e stampa che va tutto bene: il silenzio più costoso possibile, perché è un silenzio dichiarato. Un impianto vero calcola sempre i test per colonna e tratta l’indicatore globale come uno fra gli indizi, non come l’interruttore che decide se guardare.
La seconda è che il controllo colonna per colonna è necessario ma non sufficiente. Guarda una colonna alla volta, quindi è cieco ai cambiamenti che vivono nel rapporto fra le colonne: se altezza e peso continuano ciascuna a distribuirsi come prima ma smettono di crescere insieme, ogni singola colonna risulta innocente mentre il detective, che le guarda insieme, grida. Quando capita questo, la conclusione giusta non è «falso allarme» ma un cambiamento nelle dipendenze, da cercare con strumenti che le guardino (le importanze del detective stesso, le correlazioni a coppie).
Una cautela finale, la stessa di «Quando i dati cambiano» ma più severa di come la si racconta di solito. Il detective è addestrato sui soli ingressi: quello che rileva è che è cambiato il tipo di richieste che arrivano, e nient’altro. Non distingue un cambiamento innocuo da uno che rovina le predizioni; e non distingue nemmeno le tre famiglie fra loro. Anche un puro cambio di proporzioni fra le risposte giuste (il label shift) lo sposta, e la ragione è semplice: se le frodi passano da una su cento a una su dieci, in mezzo alle richieste in arrivo ce ne sono dieci volte tante che assomigliano a una frode. Il detective non vede le risposte, ma vede quelle richieste, e le nota. Quanto le noti, però, è un’altra faccenda, e la risposta è: poco. Con quel salto, la parte di richieste in arrivo che è cambiata è nove su cento, e con uno scarto così l’indicatore globale non arriva a \(0{,}55\) nemmeno se frodi e richieste oneste fossero distinguibili a colpo d’occhio: su quei nove casi il detective indovina sempre, sugli altri novantuno tira a caso e ci prende una volta su due, e \(0{,}09 \times 1 + 0{,}91 \times 0{,}5 \approx 0{,}545\). Resta sotto qualunque soglia che qualcuno metterebbe davvero: il label shift lo sposta, e non basta a farlo suonare. Del concept shift puro, poi, non vede niente: lì gli ingressi restano identici ed è la regola giusta a essere cambiata sotto. Per separare i tre casi le etichette vere del terzo livello restano la prova. Per il label shift, però, bastano le predizioni. Se le richieste di ciascuna classe restano fatte come prima (in formule, \(P(\mathbf{x}\mid y)\) non cambia), le proporzioni delle classi predette in produzione dipendono da quelle vere attraverso la matrice di confusione del modello, stimata una volta su dati di validazione etichettati. Invertendo quella relazione, il che si può fare se il modello distingue le classi, le proporzioni vere si stimano senza nessuna etichetta nuova [LWS18], come in Quando i dati cambiano. Il monitoraggio statistico è un allarme precoce, non un verdetto.
Quanta strada, e quanto bene ordina#
Il KS guarda lo scarto più grande fra le due curve cumulate, ed è cieco a quanto lontano i dati si sono spostati. La distanza di Wasserstein, già incontrata nelle GAN come la fatica di rifare un mucchio di sabbia con un altro, misura proprio quello. E quando le etichette arrivano, la deriva si misura sulla prestazione, con indici che nel credito hanno nomi propri: il KS fra i punteggi dei buoni e dei cattivi pagatori, e il Gini, che con l’indice di Gini degli alberi di decisione condivide il nome e l’autore, non il mestiere.
Il segmento del KS guarda un punto solo, quello in cui le due curve sono più lontane. Un’altra misura guarda tutta la striscia fra le due curve e ne prende l’area: è il movimento terra delle GAN, quanta strada dovrebbero fare in media i dati di oggi per tornare dove stavano ieri, e si misura nell’unità della colonna, in euro se la colonna è un importo. Le due misure vedono cose diverse. Se tutti i clienti spendono un po” di più, le curve si scostano un poco lungo tutto il percorso, e il KS lo vede. Se due clienti su cento cominciano a spendere cifre lontanissime da quelle di prima, le curve restano quasi sovrapposte, perché a muoversi sono pochi, e il KS quasi non se ne accorge; la strada, invece, può essere la stessa del primo caso, perché quei pochi vanno lontano. Per la stessa ragione, però, basta un solo valore assurdo, come un importo scritto con sei zeri di troppo, a gonfiarla.
Poi arrivano le risposte vere, e si guarda la prestazione, fetta per fetta dei clienti. Nel credito le domande sono due.
La prima: il modello mette ancora i cattivi pagatori in cima alla lista? Si pescano a caso un cattivo pagatore e un buono, e si guarda chi dei due ha il punteggio più alto: la frequenza con cui vince il cattivo è l’AUC. Il mestiere la scrive riscalata, due volte l’AUC meno uno, così che un modello che tira a caso faccia zero e uno perfetto faccia uno, e quel numero si chiama Gini. Lo si vede anche su un disegno, la curva CAP: si mettono in fila i clienti dal punteggio più alto al più basso, e si segna quanti cattivi pagatori si sono già presi dopo il primo dieci per cento della fila, dopo il primo venti, e così via. Un modello perfetto li prende tutti in testa, uno che tira a caso li prende in proporzione, e il Gini è quanta area la curva guadagna sul caso, divisa per quella che guadagnerebbe il modello perfetto.
La seconda: quanto sono separati i punteggi dei buoni da quelli dei cattivi? È lo stesso KS di prima, messo fra due gruppi di clienti invece che fra ieri e oggi. Guarda il solo punto della lista in cui i due gruppi sono più separati, mentre l’AUC e il Gini guardano la lista intera.
Quel Gini non ha niente a che fare con il Gini degli alberi di decisione, che misura quanto è mescolato un gruppo. Hanno in comune il nome, e l’uomo: Corrado Gini, statistico italiano, che nel 1912 propose la formula dell’uno per misurare quanto è vario un carattere come il colore degli occhi, e due anni dopo il rapporto fra aree da cui prende la forma l’altro.
Per due distribuzioni su \(\mathbb{R}\) con funzioni di ripartizione \(F\) e \(G\),
mentre il KS è \(\sup_x \lvert F(x) - G(x) \rvert\): la stessa differenza,
integrata invece che massimizzata [RGarciaTC17]. In una
dimensione il trasporto più economico abbina i quantili nello stesso ordine, e
l’estremo inferiore sui piani di trasporto della Wasserstein GAN si riduce a
questo integrale. \(W_1\) si misura nell’unità della colonna e cresce con la
distanza a cui la massa si sposta, quindi sente le code, e per lo stesso motivo
non ha un tetto: un solo valore aberrante può dominarlo. Il KS è adimensionale,
limitato a uno, invariante per trasformazioni monotone della colonna, e vede la
frazione di massa spostata, non la distanza. Per confrontare \(W_1\) fra colonne
diverse lo si divide per una scala di riferimento, per esempio la deviazione
standard nella finestra di riferimento, e la soglia, che a differenza di quelle
del PSI non ha un valore di mestiere, si decide sul significato pratico della
colonna; scipy.stats.wasserstein_distance calcola l’integrale sulle
ripartizioni empiriche.
Con le etichette, la deriva delle prestazioni si misura per sottopopolazione. Siano \(s\) il punteggio, \(F_1\) e \(F_0\) le sue ripartizioni fra i cattivi e fra i buoni pagatori. L’AUC è \(P(s^{(1)} > s^{(0)})\), con metà peso ai pari merito. Il KS di un modello di punteggio è \(\max_t \lvert F_1(t) - F_0(t) \rvert\), cioè \(\max_t\,\big(\mathrm{TPR}(t) - \mathrm{FPR}(t)\big)\) quando i cattivi stanno in alto: la massima distanza verticale della curva ROC dalla diagonale, una soglia sola. Il Gini del credito è l’accuracy ratio della curva CAP (quota di cattivi intercettati contro quota di clienti scartati, partendo dal punteggio più alto): l’area fra la curva del modello e la diagonale, divisa per quella del modello perfetto. Vale \(2\,\mathrm{AUC} - 1\) [EHT03], e ricalca il rapporto di concentrazione che Gini definì sulla curva di Lorenz [Gin14], trasportato dalla distribuzione dei redditi a quella dei cattivi pagatori. Con l’impurità degli alberi, \(1 - \sum_k p_k^2\), condivide l’autore: è l’indice di mutabilità che Gini aveva proposto nel 1912 per i caratteri qualitativi [Gin12]. AUC, Gini e KS crescono tutti con la separazione fra le classi, ma non sono intercambiabili: i primi due guardano l’ordinamento su tutte le soglie, il terzo la soglia migliore.
Il blocco confronta con il KS e con Wasserstein le due derive dell’esempio, su una colonna già riscalata in modo che la sua larghezza tipica, la deviazione standard, valga uno: tutti i clienti spostati di due decimi, oppure due su cento spostati di dieci; poi, su un modello di punteggio con un cattivo pagatore su dieci, calcola l’AUC, il Gini come \(2\,\mathrm{AUC} - 1\) e come rapporto di aree della curva CAP, e il KS fra i punteggi delle due classi.
import numpy as np
from scipy.stats import ks_2samp, wasserstein_distance
from sklearn.metrics import roc_auc_score

rng = np.random.default_rng(0)
n = 20000
riferimento = rng.normal(0, 1, n)                  # una colonna già riscalata: l'unità è la deviazione standard
# due derive diverse: tutti un po' più in là, oppure pochi molto lontano
tutti_poco = riferimento + 0.2
pochi_molto = riferimento.copy()
pochi_molto[: n // 50] += 10                       # due clienti su cento, dieci unità più in là
for nome, corrente in [("tutti di 0,2", tutti_poco), ("il 2% di 10", pochi_molto)]:
    print(f"{nome:13}: KS {ks_2samp(riferimento, corrente).statistic:.3f},"
          f" Wasserstein {wasserstein_distance(riferimento, corrente):.3f}")

# prestazioni, quando arrivano le etichette: punteggi dei buoni e dei cattivi pagatori
cattivo = rng.random(n) < 0.1
punteggio = rng.normal(0, 1, n) + 1.2 * cattivo
auc = roc_auc_score(cattivo, punteggio)
# il Gini del credito dalla curva CAP: quota di cattivi presi contro quota di clienti scartati
ordine = np.argsort(-punteggio)
presi = np.r_[0, np.cumsum(cattivo[ordine])] / cattivo.sum()
scartati = np.linspace(0, 1, n + 1)
area = np.sum((presi[1:] + presi[:-1]) / 2 * np.diff(scartati)) - 0.5   # sopra la diagonale
perfetta = 0.5 * (1 - cattivo.mean())                                      # il modello perfetto
print(f"AUC {auc:.4f}; 2 AUC - 1 = {2 * auc - 1:.4f}; Gini dalla curva CAP = {area / perfetta:.4f}")
print(f"KS fra i punteggi dei buoni e dei cattivi: "
      f"{ks_2samp(punteggio[cattivo], punteggio[~cattivo]).statistic:.3f}")
tutti di 0,2 : KS 0.082, Wasserstein 0.200
il 2% di 10  : KS 0.020, Wasserstein 0.200
AUC 0.8083; 2 AUC - 1 = 0.6166; Gini dalla curva CAP = 0.6166
KS fra i punteggi dei buoni e dei cattivi: 0.469
Le due derive costano la stessa strada, \(0{,}200\) deviazioni standard in tutti e due i casi, e il KS le vede in modo diverso: \(0{,}082\) la prima, \(0{,}020\) la seconda, quattro volte meno per lo stesso spostamento complessivo. Un allarme fondato sul solo KS dormirebbe mentre due clienti su cento si sono spostati di dieci deviazioni standard. Sulle prestazioni, il Gini calcolato con le aree della curva CAP coincide con \(2\,\mathrm{AUC} - 1\) fino all’ultima cifra stampata, \(0{,}6166\); il KS fra le due classi, \(0{,}469\), misura la stessa separazione guardando la soglia migliore invece di tutte.
Quando è cambiato: la somma che si accumula#
Le due finestre rispondono alla domanda «le due settimane sono diverse?», e ci rispondono tardi, quando la finestra corrente si è riempita di dati nuovi. Per accorgersi del momento in cui qualcosa cambia serve un altro attrezzo, che guarda i dati uno alla volta man mano che arrivano: è il rilevamento dei cambi (change-point detection), che coglie un cambio di regime, il momento in cui una serie cambia comportamento e resta cambiata, mentre avviene. Nasce dal controllo di qualità in fabbrica, dove le carte di controllo di Shewhart, grafici su cui si segnava la misura di ogni lotto di pezzi, giudicavano ogni lotto da solo [She31]. Il suo strumento classico è la somma cumulata (CUSUM, da cumulative sum), che Ewan Page propose nel 1954 per accumulare l’evidenza da un lotto all’altro [Pag54].
Ogni sera il gestore di un servizio guarda di quanto l’errore del modello ha superato il livello che considera normale, ne toglie un piccolo margine di tolleranza e annota il risultato su un registro che tiene il totale. Se il normale è 10, stasera l’errore è 11 e il margine è un quarto, annota 0,75; se domani l’errore è 9,5, annota 9,5 meno 10 meno un quarto, cioè meno 0,75, e il totale torna a zero. Il registro ha una sola regola in più: non scende mai sotto zero, così un mese tranquillo non mette da parte un credito da spendere quando le cose peggiorano. Quando il totale supera una soglia, suona l’allarme (Fig. 36.9).
Una serata storta isolata aggiunge qualcosa al totale, e le sere normali che seguono se lo riprendono, perché ognuna toglie il margine. Un peggioramento piccolo ma costante, che nessuna sera da sola lascerebbe vedere, aggiunge invece un poco ogni sera, e il totale sale finché suona. Allora il registro dà anche la sua ipotesi su quando il mondo è cambiato: la sera dopo l’ultima volta in cui stava a zero, perché da lì non ci è più tornato. È la sera più verosimile, non una data certa.
Se la risposta giusta arriva dopo settimane, gli errori della sera non si possono contare, e il gestore tiene il registro su una spia che si vede subito, per esempio la lunghezza media delle email arrivate: di quanto supera la normale, meno il margine.
Il gestore conta in punti, e un punto è quanto oscillano di solito le sere normali (la loro larghezza tipica, la deviazione standard). Il margine è la metà del peggioramento che vuole cogliere: per un errore salito di mezzo punto mette un quarto, a metà strada fra il normale e il peggiorato. In una sera normale il registro perde allora in media un quarto, e resta vicino a zero; in una sera peggiorata ne guadagna in media un quarto, e sale. Se il modello peggiora meno del margine, il registro in media non sale, e suona solo dopo una fila di sere sfortunate, come per un falso allarme. E guarda in un verso solo: si accorge di un numero che sale, non di uno che scende. Se la spia può andare storta in tutti e due i versi, il gestore tiene un secondo registro, a specchio, e con la stessa soglia sui due mette in conto il doppio dei falsi allarmi.
Poi c’è la soglia, che costa da tutte e due le parti. Bassa, l’allarme suona presto quando qualcosa cambia davvero, ma sveglia il gestore anche per una fila sfortunata di sere normali; alta, i falsi allarmi diventano rari ma il vero arriva tardi. I due lati non si muovono alla stessa velocità. Con mille registri tenuti al calcolatore su serate inventate, portare la soglia da quattro a otto punti moltiplica quasi per dieci il tempo fra un falso allarme e l’altro, e fa poco più che raddoppiare il ritardo. E un registro più svelto non esiste: c’è un teorema che dice che, a parità di falsi allarmi, nessun’altra regola si accorge prima di un peggioramento di quella misura, nel caso peggiore.
Il registro si fida di tre cose che gli dice il gestore: il normale, letto su un periodo tranquillo; quanto oscillano di solito le sere; e che ogni sera faccia storia a sé. Sull’oscillazione basta poco per sbagliare di molto: se le sere oscillano un po” più di quanto il gestore crede, è come avere la soglia più bassa, e i falsi allarmi crescono in fretta. E in una settimana di festa le sere storte arrivano tutte insieme, per una ragione che passerà: gli errori sono saliti davvero, il registro somma e suona, perché non sa distinguere una fila storta dalla fila di un mondo cambiato.
Siano \(x_1, x_2, \dots\) osservazioni indipendenti di una statistica del flusso (l’errore giornaliero, quando le etichette arrivano in tempo, o una statistica del secondo livello, che non le aspetta), con densità \(p_0\) prima del cambio e \(p_1\) dopo, a partire da un istante ignoto \(\nu\). La statistica CUSUM accumula il logaritmo del rapporto di verosimiglianza, \(z_t = \log\big(p_1(x_t)/p_0(x_t)\big)\), riportandola a zero quando scenderebbe sotto zero (Fig. 36.9):
Per osservazioni gaussiane di varianza nota \(\sigma^2\) e un aumento della media da \(\mu_0\) a \(\mu_0+\delta\), \(z_t = (\delta/\sigma^2)\,(x_t - \mu_0 - \delta/2)\). Dividendo per \(\delta/\sigma^2\) sia la somma sia la soglia, la regola diventa \(S_t = \max\big(0, S_{t-1} + x_t - \mu_0 - k\big)\) con \(k = \delta/2\) (il valore di riferimento), e la soglia passa nell’unità di \(x\): nel blocco che misura il prezzo della soglia, \(h = 8\) in unità di \(x\) vale \(4\) sulla scala del rapporto di verosimiglianza. Le due grandezze che si scambiano sono la durata media fino a un falso allarme (average run length), \(\mathrm{ARL}_0 = \mathbb{E}_\infty[\tau]\), dove il pedice dice che il cambio non arriva mai, e il ritardo nel caso peggiore sull’istante del cambio e sulla storia che lo precede,
Lorden [Lor71] ha mostrato che, fra le procedure con \(\mathrm{ARL}_0 \ge \gamma\), questo ritardo non scende sotto \((\log\gamma / I)\,\big(1+o(1)\big)\) per \(\gamma \to \infty\), con \(I = \mathrm{KL}(p_1\,\|\,p_0) = \delta^2/(2\sigma^2)\) nel caso gaussiano, e che la CUSUM lo raggiunge; Moustakides [Mou86] ne ha provato l’ottimalità esatta, per ogni \(\gamma\), secondo lo stesso criterio. Per la CUSUM il caso peggiore è il cambio che arriva con la somma a zero. Il ritardo cresce dunque come il logaritmo di \(\mathrm{ARL}_0\): la soglia \(h\) entra linearmente nel ritardo ed esponenzialmente in \(\mathrm{ARL}_0\). Il limite però è asintotico: con i valori del blocco che misura il prezzo della soglia (\(\gamma = 706\), \(I = 0{,}125\)) dà \(\log\gamma/I \approx 52\) giorni, quasi il doppio dei \(27{,}6\) misurati, perché a soglie così basse il fattore \(1+o(1)\) pesa ancora.
Per scegliere \(h\) senza simulare, nel caso gaussiano con \(\sigma = 1\) c’è l’approssimazione di Siegmund [Sie85],
che con \(k = 0{,}25\) dà circa \(77\) a \(h = 4\) e \(738\) a \(h = 8\), contro i \(72\) e i \(706\) simulati. La regola scritta qui vede soltanto gli aumenti della media: per una statistica che può peggiorare in tutti e due i versi se ne tengono due, speculari, e i loro falsi allarmi si sommano, \(1/\mathrm{ARL}_0 = 1/\mathrm{ARL}_0^{+} + 1/\mathrm{ARL}_0^{-}\), che a soglie uguali dimezza il tempo medio fra l’uno e l’altro.
La stessa regola si scrive anche come la somma cumulata degli scarti, \(m_t = \sum_{s \le t}(x_s - \mu_0 - k)\), meno il suo minimo storico, \(S_t = m_t - \min_{0 \le s \le t} m_s\) con \(m_0 = 0\): è la forma che porta il nome di Page e Hinkley, e sui flussi di dati la si usa di solito con la media progressiva delle osservazioni viste fin lì, \(\bar{x}_t = \frac{1}{t}\sum_{s \le t} x_s\), al posto di \(\mu_0\), così da non doverla conoscere in anticipo. Il prezzo è che dopo il cambio \(\bar{x}_t\) si sposta verso la media nuova e assorbe una parte dello scarto, tanto più quanto prima il cambio arriva nel flusso. Questa forma risponde anche alla domanda del titolo. Quando l’allarme scatta a \(\tau\), con \(p_0\) e \(p_1\) noti, la stima di massima verosimiglianza dell’istante del cambio è il giorno dopo l’ultimo minimo, \(\hat\nu = 1 + \arg\min_{0 \le s < \tau} m_s\), cioè il giorno dopo l’ultima volta in cui \(S\) era a zero, ed è la stima di cui Hinkley ha studiato la distribuzione [Hin71].
I punti di rottura sono le ipotesi. Serve \(\delta\), perché \(k\) va tarato sulla misura del cambio da cogliere: un cambio più piccolo di \(k\) dà alla somma una deriva negativa, e l’allarme arriva solo per le fluttuazioni, come un falso allarme più frequente, con un ritardo che cresce esponenzialmente in \(h\). Servono \(\mu_0\) e \(\sigma\), stimati sulla finestra di riferimento. Nella ricorsione \(\sigma\) non compare, ma è su di esso che si tara \(h\), e \(\mathrm{ARL}_0\) cresce esponenzialmente con \(2kh/\sigma^2\), che è la soglia nella scala del rapporto di verosimiglianza, quindi un errore piccolo su \(\sigma\) lo sposta di un fattore grande. E serve l’indipendenza: con un’autocorrelazione positiva le somme parziali hanno più varianza di quella su cui la soglia è tarata (\((1+\phi)/(1-\phi)\) volte, per un AR(1) di coefficiente \(\phi\)), le escursioni si allungano e i falsi allarmi si moltiplicano; una negativa fa il contrario.
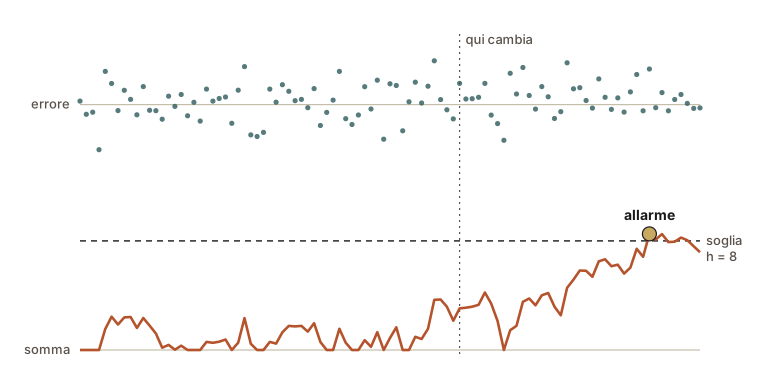
Fig. 36.9 In alto l’errore di ogni giorno, in basso la somma cumulata, che non scende mai sotto zero. Finché il modello va come sempre la somma sale e ricade senza arrivare alla soglia; dopo il cambio il peggioramento è piccolo giorno per giorno ma si accumula, e la somma supera la soglia qualche settimana più tardi. Dopo il cambio torna a zero un’ultima volta, perché il peggioramento è piccolo e ogni tanto l’errore resta basso: da lì non ci torna più, e quel giorno è la stima dell’inizio del cambio, qui qualche giorno dopo quello vero. Il flusso è simulato: dopo il cambio l’errore sale di mezza deviazione standard, il margine è un quarto e la soglia \(h\) vale otto, come nell’ultima riga della prova sul prezzo della soglia.#
Il blocco misura il prezzo della soglia su mille flussi simulati: quanto si aspetta in media un falso allarme quando niente è cambiato, e quanto ci mette l’allarme a suonare quando la media è salita di mezza deviazione standard.
import numpy as np

rng = np.random.default_rng(0)

def cusum(X, k, h):
    """Somma cumulata di Page su molte serie insieme (una per riga):
    S_t = max(0, S_{t-1} + x_t - k), allarme al primo S_t > h.
    Restituisce, per ogni serie, il giorno dell'allarme contato da 1
    (-1 se non scatta)."""
    S = np.zeros(X.shape[0])
    allarme = np.full(X.shape[0], -1)
    for t in range(X.shape[1]):
        S = np.maximum(0.0, S + X[:, t] - k)
        allarme[(S > h) & (allarme < 0)] = t + 1
    return allarme

K = 0.25                              # metà del peggioramento da cogliere (0,5)
for h in (2, 4, 8):
    quiete = rng.normal(0, 1, size=(1000, 5000))      # niente è cambiato
    falsi = cusum(quiete, K, h)
    tra_un_falso_e_laltro = np.where(falsi < 0, 5000, falsi).mean()
    dopo = rng.normal(0.5, 1, size=(1000, 1000))      # la media è salita di 0,5
    ritardo = cusum(dopo, K, h)
    assert (ritardo >= 0).all()                       # dopo il cambio suona sempre
    print(f"soglia h = {h}: un falso allarme ogni {tra_un_falso_e_laltro:4.0f} giorni"
          f" in media; dopo il cambio suona in {ritardo.mean():4.1f} giorni")
soglia h = 2: un falso allarme ogni   18 giorni in media; dopo il cambio suona in  6.4 giorni
soglia h = 4: un falso allarme ogni   72 giorni in media; dopo il cambio suona in 13.6 giorni
soglia h = 8: un falso allarme ogni  706 giorni in media; dopo il cambio suona in 27.6 giorni
Da \(h = 4\) a \(h = 8\) i giorni fra un falso allarme e l’altro passano da \(72\) a \(706\), quasi dieci volte tanto, mentre il ritardo passa da \(13{,}6\) a \(27{,}6\) giorni, poco più del doppio: i falsi allarmi si diradano in fretta, il ritardo cresce piano. È l’andamento che la teoria prevede, con il ritardo che cresce come il logaritmo del tempo medio fra due falsi allarmi, e il ritardo misurato qui ne è proprio il caso peggiore, perché ogni flusso parte con la somma a zero. La formula del limite, però, vale per soglie molto alte, e presa alla lettera con questi numeri dà un ritardo minimo più lungo di quello misurato. Quale soglia scegliere non lo dice la statistica, lo dice quanto costa un falso allarme (una persona svegliata di notte, un modello ritirato senza motivo) contro quanto costa una settimana in più di modello peggiorato.
Rispondere al drift#
Una spia che si accende non è ancora una decisione. La risposta al drift si organizza come una piramide, e la forma dice due cose insieme. Salendo, il gesto è più drastico: non più lento, più invasivo, perché tocca sempre più a fondo il servizio che sta girando. E salendo la piramide si stringe, perché i casi che arrivano fin lassù sono pochi. La regola d’oro è che la risposta sia proporzionata alla prova: la maggior parte degli allarmi non deve arrivare in cima.
Alla base c’è l’allarme: automatico, a costo quasi nullo, tanto abbondante quanto lo consente una buona soglia. Sopra c’è l’indagine: un umano guarda quale feature è cambiata e prova a capire se è un falso segnale (un sensore rotto, un bug nella pipeline dei dati; più spesso è questo che un vero mutamento del mondo), un covariate shift benigno o l’inizio di un concept shift. Solo se l’indagine conferma un degrado reale si sale al retraining: riaddestrare su dati recenti. E in cima, riservato all’emergenza, il rollback, cioè la retromarcia: rimettere in servizio il modello di prima, nel tempo di un respiro. Questo è possibile solo se di ogni modello si è conservata la copia, con il proprio numero, e quella vecchia è ancora lì dov’era.
È la spia dell’olio che si accende sul cruscotto. Non stacchi il motore al primo lampeggio: prima guardi (l’allarme), poi ti fermi a controllare il livello (l’indagine), poi semmai rabbocchi o cambi l’olio (il retraining), e solo se il motore comincia a battere in testa (e cambiare l’olio non è bastato) lo spegni e chiami il carro attrezzi (il rollback al modello vecchio). Rispondere sempre col gesto più drastico è come chiamare il carro attrezzi ogni volta che si accende una spia: costoso, e spesso inutile. In un’officina che lavora bene i quattro gesti non capitano con la stessa frequenza: le spie sono tante, i controlli meno, i cambi d’olio pochi e il carro attrezzi quasi mai. Messi in fila, dal più frequente in basso al più raro in cima, fanno una piramide: larga alla base, dove stanno le spie, e stretta in punta, dove sta il carro attrezzi.
C’è poi una scelta di fondo su quando rimettere mano al modello. Un’officina può fare due cose: il tagliando a scadenza fissa (ogni diecimila chilometri, che tu abbia problemi o no) oppure l’intervento a chiamata, quando qualcosa si guasta. Il tagliando è prevedibile e semplice, ma quello che si rompe il giorno dopo resta rotto fino al prossimo; la chiamata risparmia lavoro e vale quanto valgono le spie. I sistemi reali quasi sempre le fanno entrambe.
E c’è una trappola che riguarda proprio il riaddestramento fatto in automatico. Un modello che decide che cosa mostrare alle persone decide, con quello, anche che cosa potranno mai cliccare; un sistema che nega un prestito non saprà mai se quel cliente avrebbe restituito i soldi. I dati di domani, insomma, sono in parte una conseguenza delle scelte che il modello sta facendo oggi. Riaddestrarlo su quei dati non lo corregge: gli ridà indietro le sue stesse convinzioni come se fossero fatti, e a ogni giro le rende più forti. È l’equivalente di un microfono puntato sulla propria cassa: prima o poi fischia. Per questo, anche negli impianti più automatici, sopra una certa soglia decide una persona, e i dati con cui si riaddestra si cercano dove il modello in carica non ha messo le mani.
Sul quando riaddestrare, due strategie [SGHP22]:
Retraining periodico: riaddestrare a cadenza fissa (giornaliera, settimanale) su una finestra scorrevole di dati recenti. Semplice, prevedibile, facile da automatizzare; è ciò che molti team fanno di default. Il costo è lavoro sprecato quando nulla è cambiato, e un ritardo pari all’intervallo quando qualcosa cambia in fretta.
Retraining innescato (triggered): riaddestrare quando il monitoraggio supera una soglia. Reagisce a ciò che serve, ma dipende interamente dalla qualità degli allarmi.
Il punto delicato è l’automazione del retraining, che è il sogno di ogni pipeline MLOps ma nasconde una trappola già incontrata: il feedback loop. Se le predizioni del modello concorrono a generare i dati futuri (un sistema di credito che nega prestiti non vedrà mai come sarebbero andati quei clienti, un sistema di raccomandazione raccoglie clic solo su ciò che ha deciso di mostrare), riaddestrare automaticamente su quei dati non corregge il modello: ne amplifica i bias, cementandoli a ogni ciclo [Huy22]. Un meccanismo affine, senza riaddestramento sui propri esiti, aveva ingannato Google Flu Trends: fra le cause dei suoi errori Lazer e colleghi mettono le modifiche che Google faceva al motore di ricerca (i suggerimenti di ricerca, le diagnosi proposte accanto ai sintomi), che cambiavano il processo stesso che generava i dati letti dal modello [LKKV14]. Un retraining loop senza sorveglianza umana è un amplificatore puntato sul proprio ingresso: prima o poi fischia. Per questo anche le pipeline più automatizzate tengono un umano nell’anello alle soglie alte della piramide, e valutano ogni candidato al retraining su dati freschi e possibilmente non contaminati dalle scelte del modello in carica. Il caso limite, in cui il feedback loop non è un incidente ma la struttura stessa del problema, lo abbiamo già visto nel capitolo sui sistemi di raccomandazione: lì il modello decide che cosa l’utente può vedere, e quindi che cosa potrà mai cliccare.
Rilasciare senza rompere#
Supponiamo che l’indagine abbia dato ragione all’allarme e il retraining abbia prodotto un modello nuovo, che sui dati di test sembra migliore. Resta il passo più rischioso di tutti: sostituire il modello vivo con quello nuovo. Un modello che va benissimo in laboratorio può comportarsi in modo pessimo davanti agli utenti veri: su richieste mai viste, con tempi di risposta diversi, con effetti che nessuna prova fatta a tavolino cattura. Rimpiazzarlo di colpo per tutti gli utenti è una scommessa che non conviene fare mai. I tre modi per introdurlo in sicurezza sono quelli già nominati in fondo alla sezione sul servire un modello: qui si vede a che cosa serve ciascuno, perché non rispondono alla stessa domanda.
Hai inventato un piatto nuovo per il tuo ristorante. Non lo metti nel menù di colpo per tutti: se qualcosa non va, hai rovinato la serata a duecento clienti. Fai una cosa più furba, in tre modi.
Il primo: lo cucini in parallelo senza servirlo (il cuoco lo prepara insieme al vecchio, tu lo assaggi in cucina, al tavolo arriva ancora il vecchio). Nessun cliente corre rischi. Si chiama shadow, cioè «in ombra».
Il secondo: lo fai assaggiare a pochi tavoli. Lo metti nel piatto di due tavoli su cento, tieni d’occhio le loro facce, e se funziona allarghi a dieci, a cinquanta, a tutti; se storcono il naso, lo ritiri e nessun danno è fatto. È il canary, dal canarino che i minatori si portavano sottoterra: se il gas c’era, lo sentiva lui per primo. Che cosa voglia dire «se funziona» lo decidi prima di servirlo, non guardando le facce. E due tavoli su cento ti dicono se il piatto è immangiabile, non se è un po” meno buono del vecchio: per accorgerti di quello servirebbero moltissime serate.
Il terzo: due metà della sala, stesso momento, piatto vecchio a una metà e nuovo all’altra, e a fine serata conti chi ha lasciato il piatto pulito. Chi va in quale metà lo tira a sorte il cameriere, se no stai confrontando i tavoli alla finestra con quelli vicino alla cucina. E se il piatto nuovo torna indietro sei volte su cento invece di sette, una serata sola non basta a distinguere sei da sette. È il test A/B.
E quando si usa quale? I primi due rispondono soprattutto a una domanda, «il piatto nuovo fa danni?»: l’ombra quando non ci si fida affatto, i pochi tavoli quando ci si fida abbastanza da servirlo ma si vuole poter tornare indietro subito. Il terzo risponde a un’altra domanda, «il piatto nuovo è migliore?», e quando quella domanda si può decidere soltanto servendolo davvero è l’unico che può rispondere: il piatto in ombra nessun cliente lo assaggia, quindi di chi l’avrebbe finito non si sa niente. Dove invece il giudizio non ha bisogno del cliente (lo chef assaggia in cucina e dice se è cotto al punto giusto), l’ombra risponde anche a questa, e con meno serate. In ombra, infatti, vecchio e nuovo si preparano per le stesse comande, quindi ogni comanda dà un giudizio su tutti e due i piatti invece che su uno solo. E si confrontano comanda per comanda, contando soltanto quelle in cui uno dei due è venuto bene e l’altro no. Una comanda difficile, che fa sbagliare tutti e due, non conta né per l’uno né per l’altro; e nemmeno una facile, che riesce a tutti e due. Restano le comande in cui i due piatti si sono davvero distinti, e su quelle si decide. Di solito i tre modi si usano tutti, in fila, in quest’ordine.
Le tre tecniche, in ordine crescente di esposizione [Huy22]:
Shadow deployment: il modello nuovo riceve tutto il traffico reale e produce le sue predizioni in parallelo, ma le sue risposte non vengono mai servite all’utente; si registrano e si confrontano offline con quelle del modello in carica. Rischio per l’utente nullo; costo: si paga il calcolo doppio e non si misurano gli effetti sul comportamento reale (nessuno agisce sulle predizioni ombra); e il modello ombra non deve scrivere niente, perché una risposta che cambia lo stato (un ordine, una mail) non si può eseguire due volte. Quando però la qualità si giudica senza servire la risposta (un’etichetta che arriva dopo, un controllo offline), l’ombra dà un confronto appaiato: i due modelli rispondono alle stesse richieste, la variabilità fra una richiesta e l’altra si elide, e si decide con il test di McNemar sulle sole discordanze [McN47] (probabilità e statistica), nella sua versione esatta quando le discordanze sono poche. A parità di richieste in arrivo, \(N\), l’ombra vince due volte. Le usa tutte per giudicare entrambi i modelli, dove un A/B le spartisce fra due gruppi; con \(p_A\) e \(p_B\) le accuratezze e \(e_A, e_B \in \{0, 1\}\) gli esiti dei due modelli sulla stessa richiesta (1 se giusto), la varianza della differenza stimata vale
\[ \frac{p_A(1-p_A) + p_B(1-p_B) - 2\operatorname{Cov}(e_A, e_B)}{N} \quad\text{contro}\quad \frac{2\,[p_A(1-p_A) + p_B(1-p_B)]}{N}, \]e la prima è la metà della seconda già a covarianza nulla. E siccome i due modelli tendono a sbagliare sulle stesse richieste, la covarianza è positiva e il vantaggio cresce ancora.
Canary release: il modello nuovo serve davvero, ma solo una piccola quota del traffico (l’1%, il 5%). Si sorvegliano le metriche sulla quota canary e, se reggono, si aumenta gradualmente fino al 100%; al primo segnale cattivo si torna indietro (rollback) avendo esposto pochi utenti. «Se reggono» va scritto prima, come regola: per esempio errori e \(p_{99}\) entro il 10% del modello in carica per un’ora, a ogni passo di quota. Un’alternativa al canary è il rilascio blue/green, che tiene due ambienti completi e sposta tutto il traffico in un colpo solo, con un ritorno istantaneo al vecchio, al prezzo di una capacità doppia.
A/B test: due gruppi di utenti, assegnati a caso, ricevono contemporaneamente il modello A (vecchio) e il B (nuovo); si confronta una metrica di business su un orizzonte definito e si decide con un test statistico, verificando che la differenza sia significativa e non rumore campionario. La taglia si fissa prima: per due proporzioni \(p_A\), \(p_B\), a livello \(\alpha\) e potenza \(1-\beta\),
\[ n \approx \frac{(z_{1-\alpha/2}+z_{1-\beta})^2\,[p_A(1-p_A)+p_B(1-p_B)]}{(p_A-p_B)^2} \]utenti per gruppo, dove \(z_q\) è il quantile \(q\) della normale standard. Per distinguere \(0{,}07\) da \(0{,}06\) con \(\alpha=0{,}05\) e potenza \(0{,}8\) ne servono circa \(9\,500\) per gruppo, e la differenza minima da rilevare entra al quadrato: dimezzarla quadruplica il campione. E il test si guarda una volta sola: chi controlla il \(p\) ogni giorno e si ferma al primo \(p<0{,}05\) fa molti test invece di uno, e su due modelli identici dichiara un vincitore molto più spesso di una volta su venti. Se si vuole guardare in corsa, si usano disegni sequenziali, che spendono \(\alpha\) fra le occhiate. È lo strumento per rispondere a «il nuovo è davvero meglio?», mentre shadow e canary rispondono a «il nuovo è sicuro da servire?».
La stessa formula dice perché il canary non basta a giudicare la qualità. Per vedere un tasso d’errore che raddoppia dal 2% al 4%, con \(\alpha = 0{,}05\) e potenza \(0{,}8\), servono circa \(1\,100\) richieste nel gruppo canary, che con una quota dell’1% sono più di centomila richieste in tutto: alle quote a cui lavora, il canary vede i guasti grossolani (errori, latenza, crash) e non una piccola regressione di qualità, che resta compito dell’A/B.
Le tre non sono alternative ma un percorso: shadow per verificare che non si rompa nulla, canary per limitare l’esposizione, A/B per decidere con rigore se promuoverlo. Dietro tutte c’è il prerequisito che il modello sia versionato, così che il rollback al precedente sia sempre un’operazione di un istante.
Con questo l’anello si chiude e ricomincia. Il monitoraggio è l’occhio che, accorgendosi del drift, fa ripartire il ciclo (indagine, retraining, rilascio graduale) e riporta all’inizio. Un modello in produzione è un processo da tenere in vita; le interviste di Shankar e colleghi descrivono infatti il lavoro come un anello continuo di raccolta dei dati, sperimentazione, valutazione e sorveglianza [SGHP22], e il monitoraggio è il turno di guardia che quel processo richiede, ogni giorno, finché il modello serve.
Da ricordare
Un modello che si guasta non fa rumore: continua a rispondere con la stessa prontezza, e nessun errore segnala che le risposte, poco alla volta, diventano sbagliate. Il monitoraggio fa le veci del fischio che manca.
Si guarda un cruscotto a tre quadranti: il servizio è vivo e risponde in fretta? che tipo di richieste stanno arrivando, e che risposte sta dando? e infine, la più importante e la più lenta, aveva ragione? L’ultima si scopre solo quando arriva la risposta giusta, che spesso arriva con settimane di ritardo e a volte non arriva mai.
Per accorgersi che il mondo è cambiato si mette al lavoro un classificatore-detective, che funziona come il metal detector dell’aeroporto: prova a distinguere i dati di ieri da quelli di oggi, e se ci riesce vuol dire che qualcosa è cambiato; se tira a indovinare vuol dire che lui non lo vede, che è una rassicurazione e non una prova. Va tarato: troppo sensibile suona per tutti, e dopo il decimo falso allarme nessuno gli dà più retta.
Il detective dice che qualcosa è cambiato, non cosa e nemmeno se è grave. Soprattutto, non vede il caso peggiore: quello in cui le richieste sembrano identiche a quelle di ieri ma è cambiata la risposta giusta.
Lo scarto più grande fra le due curve (il KS) non vede quanto lontano vanno i dati: pochi clienti spostati molto lo lasciano quasi fermo, mentre la distanza di Wasserstein, la strada da fare, se ne accorge. Quando arrivano le risposte vere, nel credito si guarda il Gini, cioè due volte l’AUC meno uno: stesso nome e stesso autore dell’indice degli alberi, ma un altro mestiere.
Per sapere quando qualcosa è cambiato si tiene un registro: ogni sera si aggiunge di quanto l’errore supera il normale, meno un margine pari a metà del peggioramento da cogliere, e il totale non scende mai sotto zero. Una sera storta si riassorbe, un peggioramento piccolo e costante si accumula finché suona, e la sera dopo l’ultimo zero è la stima più verosimile di da quando; alzare la soglia rende i falsi allarmi molto più rari e il ritardo solo un po” più lungo, finché le sere normali sono quelle che si crede e ognuna fa storia a sé. Il registro guarda in un verso solo: per l’altro se ne tiene un secondo.
Quando suona, si risponde per gradi, come con la spia dell’olio: prima si guarda, poi si controlla, poi semmai si riaddestra, e solo in emergenza si torna al modello vecchio. Rispondere sempre col gesto più drastico è come chiamare il carro attrezzi ogni volta che si accende una spia.
Riaddestrare da soli su dati che il modello stesso ha contribuito a produrre non lo corregge: ne amplifica gli errori, a ogni giro. Serve una persona nell’anello e dati freschi.
Un modello nuovo non si accende di colpo per tutti: prima in ombra, poi a pochi tavoli (che vedono un piatto immangiabile, non uno un po” meno buono), poi metà sala contro metà sala, tirata a sorte.
Da ricordare
Si misura su tre livelli, dal più rapido al più prezioso: (1) salute del servizio (latenza, errori, uptime), (2) proprietà statistiche di input e output (distribuzioni, tasso di ciascuna classe predetta), (3) qualità vera, che richiede le etichette e soffre di label delay (arriva tardi o mai [Huy22]).
I proxy statistici del livello 2 sono un allarme anticipato: si accendono prima che il degrado sia misurabile con le etichette vere.
Il detective della sezione «Quando i dati cambiano» diventa sorveglianza continua con tre scelte operative: finestre (riferimento vs corrente scorrevole), soglia sull’AUC (che decide quale scostamento passa inosservato, non il tasso di falsi allarmi) e test per feature per localizzare il drift: Kolmogorov–Smirnov sulle colonne numeriche, e sulle categoriche, a cui non si applica, il PSI o un chi quadro. Essendo addestrato sui soli ingressi, rileva un cambiamento della marginale \(P(\mathbf{x})\): il covariate shift lo fa suonare, il label shift lo sposta appena e quasi mai abbastanza, e del concept shift puro non vede niente.
L’allarme si fonda sull’ampiezza dello scostamento, non sul \(p\)-value: a taglie di produzione il KS rifiuta su differenze che nessun modello sente. Ma anche le ampiezze dipendono dalla taglia: il PSI, senza nessuna deriva, vale in media \((B-1)(1/n_r + 1/n_c)\), e le sue soglie di mestiere (0,1 e 0,25) vanno ritarate sulle finestre [YN20]. E il test per colonna è necessario ma non sufficiente, per due ragioni: uno shift che vive nella struttura congiunta lascia tutte le marginali intatte, e uno shift diffuso le muove tutte di un’inezia, ciascuna sotto la propria soglia, mentre l’indicatore globale che le somma suona.
\(W_1 = \int \lvert F - G \rvert\) integra la differenza che il KS massimizza: sente le code e non ha tetto, e va normalizzato per confrontare colonne. La deriva delle prestazioni si misura per sottopopolazione con AUC, KS fra le classi e Gini \(= 2\,\mathrm{AUC} - 1\), l’accuracy ratio della curva CAP.
Per il quando, la CUSUM di Page accumula il logaritmo del rapporto di verosimiglianza, \(S_t = \max(0, S_{t-1} + x_t - \mu_0 - k)\) con \(k = \delta/2\) nel caso gaussiano: la soglia scambia \(\mathrm{ARL}_0\), esponenziale in \(h\), con il ritardo, lineare in \(h\), ed è ottima nel caso peggiore (Lorden, Moustakides) finché \(\mu_0\), \(\sigma\) e \(\delta\) sono giusti e le osservazioni indipendenti. L’ultimo zero prima dell’allarme stima l’istante del cambio; la regola vede un verso solo, e per l’altro se ne tiene una seconda, speculare.
La risposta è una piramide proporzionata: allarme → indagine → retraining → rollback. Retraining periodico (a cadenza fissa) o innescato (a soglia); i sistemi reali fanno entrambi.
Il retraining automatico su dati generati dal modello stesso amplifica i bias del feedback loop invece di correggerli: serve un umano nell’anello e dati freschi non contaminati [Huy22].
Un modello nuovo si introduce senza rompere: shadow (risponde in parallelo, non serve), canary (piccola quota di traffico, con regole di promozione scritte prima; vede i guasti grossolani, non una piccola regressione di qualità) e A/B test (confronto statistico con la taglia fissata prima), tutti poggiati sul modello versionato per un rollback immediato.