


Come si spezza il testo: il Byte Pair Encoding#
Nella rappresentazione del testo il taglio in token è stato un dato di partenza, con la ricetta appena accennata: si parte dalle lettere e si incollano le coppie che ricorrono di più. Resta la domanda di ingegneria: quali pezzi, e perché proprio quelli. Nessuno decide a mano dove spezzare una parola rara come tokenizzazione; lo decide un algoritmo che ha letto un corpus enorme e ha scelto, uno per uno, i pezzi da tenere. I due estremi, le parole intere e le lettere singole, falliscono per ragioni opposte, ed è da lì che si parte.
Un vocabolario di parole intere non si chiude mai: più testo si legge, più parole nuove si incontrano. La crescita ha una forma nota, la legge di Heaps (o di Herdan): un testo di \(N\) parole ne contiene circa \(kN^{\beta}\) diverse, con \(k\) e \(\beta\) costanti e \(0 < \beta < 1\), e i valori misurati stanno attorno a \(0{,}5\) o poco sopra, a seconda del corpus e del genere [Hea78, Her60, JM26]. In pratica, quadruplicare il testo raddoppia più o meno le parole diverse, e il conto non si ferma.
Qualunque taglia si scelga, cinquantamila, centomila, un milione, prima o poi
arriva una parola che non c’è: un cognome (Rossellini), un refuso (gattto),
un termine tecnico (ortogonalizzazione), un composto tedesco costruito sul
momento. Il sistema la sostituisce con un simbolo speciale, <UNK> (da
unknown, sconosciuto), e da quel momento quella parola per il modello non
esiste più: era il nome del paziente, il numero di serie, il soggetto della
frase, e adesso è un buco. Peggio: questi programmi non si limitano a leggere,
scrivono anche, e <UNK> non si può scrivere. Un modello che lo tirasse
fuori avrebbe prodotto un buco, e nessuno saprebbe con che cosa riempirlo.
All’estremo opposto c’è la soluzione radicale: un vocabolario di singoli caratteri. Le parole sconosciute spariscono per costruzione, perché ogni testo è fatto di lettere che il vocabolario contiene tutte. Ma si paga due volte.
Il primo costo è la lunghezza delle sequenze. Una parola italiana occupa in media cinque o sei caratteri, spazio compreso, quindi un testo tagliato in caratteri è circa cinque volte più lungo dello stesso testo tagliato in parole. E la lunghezza si paga cara, per via dell’attenzione, il meccanismo con cui un modello moderno confronta ogni posizione della frase con tutte le altre (la si incontra con la traduzione automatica, e per esteso nel capitolo sui Transformer). I confronti crescono con il quadrato della lunghezza: raddoppiare le posizioni quadruplica il lavoro dell’attenzione, e una sequenza cinque volte più lunga lo moltiplica per venticinque.
Il secondo costo è la capacità del modello. I suoi parametri sono in numero finito, e tutto ciò che impara deve starci: partendo dalle lettere, una parte va spesa per riscoprire che g, a, t, t, o stanno spesso in quest’ordine, cioè per riscoprire le parole, che un vocabolario più grande gli darebbe già fatte.
Le sotto-parole (subword) stanno in mezzo, e sono il compromesso che ha vinto: le parole frequenti restano intere, quelle rare si scompongono in pezzi noti, e niente resta fuori. L’elenco dei pezzi lo costruisce un algoritmo, e il più usato è il Byte Pair Encoding.
Il dilemma del vocabolario#
La scelta della taglia del vocabolario è un baratto fra due costi che tirano in direzioni opposte.
La scatola di mattoncini della sezione sulla rappresentazione del testo ha due estremi. Con le sole ventuno lettere dell’alfabeto si costruisce tutto, ma ogni parola chiede cinque o sei pezzi; con un pezzo già fatto per ogni parola del dizionario si costruisce in un colpo solo, ma la scatola diventa enorme, e il giorno che serve un cognome o una parola inventata non basta lo stesso.
Una scatola enorme, poi, si paga in due modi. Ogni pezzo vuole il suo scomparto, e chi costruisce deve tenere a mente che cosa c’è in ciascuno: mille scomparti, mille cose da ricordare; centomila scomparti, centomila. E per scegliere il pezzo da mettere adesso si passa in rassegna la scatola intera, quindi con dieci volte gli scomparti ci vuole dieci volte il tempo.
La soluzione è una scatola mista: i pezzi grandi per le cose che ricorrono (rosso, casa, -mente, -zione) e le lettere singole come riserva per tutto il resto. Quanti scomparti ci siano non lo decide l’algoritmo: il numero si fissa prima di cominciare, qualche decina di migliaia di solito, e chi deve cavarsela in venti lingue lo alza, perché ogni lingua porta i suoi pezzi. Resta da decidere quali pezzi grandi tenere, dato che gli scomparti sono contati, e tutti gli algoritmi che seguono rispondono allo stesso modo, almeno in spirito: quelli che fanno risparmiare di più, cioè quelli che ricorrono spesso.
Sia \(V\) il vocabolario e \(|V|\) la sua taglia. Due quantità dipendono da \(|V|\) in verso opposto.
La prima è la lunghezza media della sequenza dopo la tokenizzazione, la fertilità del tokenizzatore [RPVulic+21] (token prodotti per parola di testo). Cresce al ridursi di \(|V|\): nel limite dei caratteri vale la lunghezza media in lettere, nel limite delle parole intere vale \(1\). La lunghezza \(n\) della sequenza è la grandezza che governa il costo dell’attenzione, \(O(n^2 d_{\text{model}})\), e il consumo della finestra di contesto.
La seconda è il numero di parametri legati al vocabolario. La matrice di embedding ha forma \(|V| \times d_{\text{model}}\), e altrettanto la matrice di proiezione finale se non è condivisa con essa. Con \(|V| = 50\,000\) e \(d_{\text{model}} = 4096\) sono \(204{,}8\) milioni di parametri per la sola tabella degli embedding: circa otto volte i parametri di una ResNet-50 intera (attorno ai 25 milioni), spesi solo per dare un vettore a ciascun token. Inoltre la softmax finale corre su \(|V|\) classi, e il suo costo cresce linearmente con la taglia.
Le taglie usate in pratica (da qualche decina di migliaia a qualche centinaio di migliaia di token) stanno nella fascia in cui nessuno dei due costi domina l’altro, e la scelta si sposta verso l’alto quando il modello deve coprire molte lingue. Nessuno di questi algoritmi sceglie \(|V|\): è un iperparametro, e ciascuno si limita a riempire i posti disponibili nel modo che ritiene migliore.
Byte Pair Encoding: da compressore a tokenizzatore#
Il primo di questi algoritmi, e il più usato, non nasce nella linguistica computazionale ma nella compressione dei file, e lavora sui byte. Un byte è un gruppo di otto bit, cioè di otto caselle che valgono 0 o 1, quindi può assumere \(2^8 = 256\) valori, e un file di testo è una sequenza di byte. Di quei 256 valori, però, un testo qualunque ne usa solo una parte, quelli che corrispondono alle lettere, alle cifre e alla punteggiatura che contiene: tutti gli altri restano liberi, e sono i «byte inutilizzati» della ricetta che segue.
Nel febbraio 1994 Philip Gage pubblica sul C Users Journal un algoritmo semplicissimo [Gag94]: trova la coppia di byte adiacenti più frequente nel file, sostituiscila ovunque con uno di quei byte liberi, annota la sostituzione in una tabella, ripeti. Alla fine il file è più corto (dove c’erano due byte adesso ce n’è uno) e la tabella dice come ricostruirlo. Il nome che Gage gli dà è byte pair encoding, BPE.
Una ventina d’anni dopo, nel 2015, Rico Sennrich, Barry Haddow e Alexandra Birch [SHB16] si accorgono che quell’algoritmo di compressione risolve un problema completamente diverso: la traduzione automatica delle parole rare. Cambiano due cose: fondono caratteri (e sequenze di caratteri) invece che byte, e invece di comprimere si fermano quando il vocabolario ha raggiunto la taglia voluta. Nel loro articolo il numero di fusioni è, testualmente, l’unico iperparametro dell’algoritmo: l’unica manopola, cioè, che chi lo usa deve girare a mano, perché tutto il resto lo decidono i conteggi. Il lavoro esce nel 2016, e la sua famiglia, BPE su caratteri o su byte, è oggi alla base dei tokenizzatori della maggior parte dei grandi modelli che generano testo.

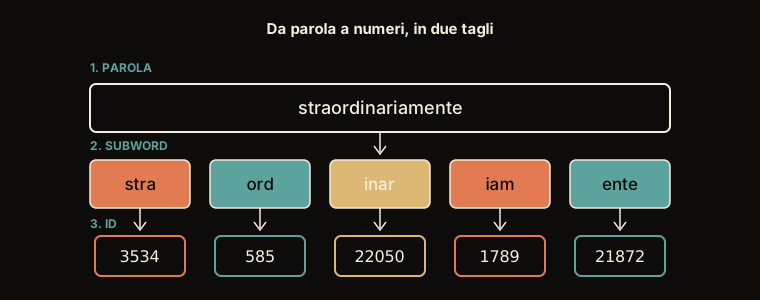
Fig. 15.7 Cosa arriva davvero al modello, nel tokenizzatore di GPT-2 (la parola è presa dentro una frase, con lo spazio che la precede). Una parola lunga e rara non entra nel vocabolario intera: si ricompone da pezzi che ci sono, e ogni pezzo diventa un numero.#
La catena della Fig. 15.7 chiarisce un equivoco diffuso: il modello non riceve né parole né caratteri, ma numeri, gli identificativi (ID) dei pezzi, cioè la posizione di ciascun pezzo nell’elenco del vocabolario. Quel numero non va preso come una quantità, che è il guaio della numerazione in fila vista con la rappresentazione del testo: il modello lo usa soltanto per scegliere una riga di una tabella, quella che contiene i numeri con cui rappresenta il pezzo (la matrice di embedding). E il confine fra un pezzo e l’altro lo ha deciso un algoritmo di frequenze, non la grammatica. Ecco che cosa fa il tokenizzatore di GPT-2 con qualche parola:
from transformers import AutoTokenizer

gpt2 = AutoTokenizer.from_pretrained("gpt2")       # il tokenizzatore di GPT-2

# dentro una frase ogni parola arriva con lo spazio che la precede
for parola in [" straordinariamente", " tokenizzazione", " ortogonalizzazione",
               " the", " casa"]:
    ids = gpt2.encode(parola)
    pezzi = [gpt2.decode([i]) for i in ids]
    print(f"{parola.strip()}: {len(ids)} token {pezzi}")
    print(f"    ID {ids}")
straordinariamente: 5 token [' stra', 'ord', 'inar', 'iam', 'ente']
    ID [3534, 585, 22050, 1789, 21872]
tokenizzazione: 4 token [' token', 'izz', 'az', 'ione']
    ID [11241, 6457, 1031, 7935]
ortogonalizzazione: 7 token [' or', 't', 'og', 'onal', 'izz', 'az', 'ione']
    ID [393, 83, 519, 20996, 6457, 1031, 7935]
the: 1 token [' the']
    ID [262]
casa: 2 token [' cas', 'a']
    ID [6124, 64]
Le parole lunghe e rare si spezzano in pezzi che ricorrono altrove:
tokenizzazione e ortogonalizzazione terminano con gli stessi tre pezzi,
izz, az e ione, con gli stessi ID, e lo spazio che precede la parola
resta attaccato al suo primo pezzo. the, frequentissima nei testi su cui
questo tokenizzatore è stato costruito, quasi tutti inglesi, è un pezzo solo;
casa, che in quei testi è rara, si spezza in due. Quanto una parola sia
frequente lo decide il corpus del tokenizzatore, non la lingua di chi lo usa.
Il meccanismo si racconta in quattro righe.
Spezza tutte le parole del corpus nelle loro lettere. Il vocabolario di partenza sono le lettere, e basta.
Guarda tutto il corpus e conta quali due simboli vicini compaiono insieme più spesso. Su un testo italiano vero vincono coppie banali e frequentissime, come
reoto.Incollali in un simbolo nuovo, dappertutto dove compaiono: da adesso quello conta come un pezzo solo, e la fusione va segnata su un elenco.
Torna a contare, e ripeti finché il vocabolario è grande quanto vuoi. I giri da fare sono la taglia della scatola meno le lettere con cui si è partiti: una scatola da 30.000 pezzi, con 100 lettere iniziali, vuole 29.900 fusioni.
Ogni giro prende la coppia migliore in quel momento, senza guardare ai giri dopo, e la scatola che ne esce non è per forza la migliore possibile; si è dimostrato però che non può scendere sotto una frazione garantita del meglio. Contare è la parte lenta: a ogni giro si rilegge tutto il testo da capo, e i giri sono migliaia. Chi ha fretta si tiene annotato in quali punti ogni coppia compare, e dopo una fusione aggiorna solo quelli che sono cambiati. In un modo o nell’altro è un lavoro che si fa una volta sola.
Alla fine hai due cose: un elenco di pezzi (il vocabolario) e, soprattutto, l’elenco ordinato delle fusioni. Il secondo è più importante del primo, perché è la ricetta. Per tokenizzare una parola nuova non serve cercarla da nessuna parte: la si spezza in lettere e le si riapplicano le stesse fusioni, nello stesso ordine in cui erano state imparate. Se la parola contiene pezzi familiari, si ricompongono da soli; se non ne contiene nessuno, resta una fila di lettere. Ripassare l’elenco intero per ogni parola sarebbe uno spreco, perché le stesse poche parole tornano di continuo: il risultato si scrive accanto alla parola la prima volta, e dalla seconda in poi si legge e basta.
Sia \(C\) il corpus, rappresentato come multiinsieme di parole con le loro frequenze, e sia \(\Sigma\) l’alfabeto dei caratteri che vi compaiono. Ogni parola è inizialmente una sequenza di simboli in \(\Sigma\). A ogni passo si sceglie
dove \(\mathrm{freq}(ab)\) è il numero di occorrenze della coppia adiacente \((a,b)\) nell’intero corpus, ciascuna pesata per la frequenza della parola che la contiene. Si sostituisce ogni occorrenza di \((a^\star,b^\star)\) con il simbolo concatenato \(a^\star b^\star\), che entra nel vocabolario, e la coppia viene accodata alla lista delle fusioni \(M = (m_1, \dots, m_k)\). Il processo si arresta quando \(|\Sigma| + k\) raggiunge la taglia \(|V|\) desiderata: il numero di fusioni è quindi \(k = |V| - |\Sigma|\), e il modello finale è la coppia \((\Sigma, M)\).
La codifica di una stringa mai vista consiste nel ripercorrere la lista: si parte dai caratteri e si applicano \(m_1, \dots, m_k\) in quest’ordine. L’ordine è sostanziale, non convenzionale: una fusione tardiva può agire su simboli che solo le precedenti sanno produrre, e invertirne due dà in generale una segmentazione diversa. La procedura è deterministica e priva di ricerca: BPE non cerca la segmentazione ottima di una parola, ma quella che le sue fusioni producono, il che è una proprietà da tenere a mente quando i risultati sorprendono.
Sul costo: contare le coppie da zero a ogni passo costa \(O(N)\) con \(N\) lunghezza totale del corpus in simboli, per un totale \(O(Nk)\). Le implementazioni serie non lo fanno: mantengono un indice dalla coppia alle posizioni in cui compare e aggiornano solo i conteggi toccati dalla fusione, con una coda di priorità sulle frequenze. L’addestramento resta comunque un’operazione da fare una volta sola. La codifica di una parola di \(L\) caratteri con l’applicazione ingenua costa \(O(kL)\), ma in pratica si tiene una cache parola \(\to\) token e il costo ammortizzato crolla, perché la distribuzione delle parole è fortemente sbilanciata.
Anche l’addestramento è greedy, e l’obiettivo che approssima è stato scritto solo di recente: né Gage né Sennrich e colleghi lo enunciano. Zouhar e colleghi [ZMG+23] formalizzano BPE come la massimizzazione di un’utilità di compressione (di quanto si accorcia il corpus con \(k\) fusioni) e dimostrano che la scelta greedy ne raggiunge almeno una frazione \(\frac{1}{\sigma}\bigl(1 - e^{-\sigma}\bigr)\) dell’ottimo, con \(\sigma\) la curvatura totale all’indietro dell’utilità rispetto alla sequenza di fusioni ottima. Il valore numerico della garanzia viene da una stima di \(\sigma\): circa \(0{,}37\) su stringhe piccole e sintetiche, \(0{,}43\) su testo inglese. Nello stesso lavoro l’indice con la coda di priorità porta l’addestramento da \(O(Nk)\) a \(O(N \log k)\).
Una precisazione tecnica che eviterà confusione più avanti. Così com’è
descritto, BPE lavora su una parola per volta e non lascia sui pezzi nessuna
traccia di dove si trovavano. Il guaio si vede in uscita: il pezzo to
ritagliato dalla fine di bassotto e il pezzo to che apre una parola come
tornare sono, per il modello, la stessa identica voce del vocabolario, anche
se il primo è una desinenza e il secondo l’inizio di un verbo. Nel rimettere
insieme i pezzi, poi, non c’è modo di sapere dove finisce una parola e comincia
la successiva. Le implementazioni reali aggiungono perciò un marcatore: nel
lavoro originale è un simbolo di fine parola, </w>; altrove è un simbolo che
segna l’inizio, attaccato allo spazio che precede la parola, ed è la strada
di SentencePiece che vedremo fra poco. Nell’esempio che segue lo omettiamo per
non appesantire i conti.
L’esempio svolto: cinque parole, quattro fusioni#
Tutto questo diventa chiaro solo facendo i conti a mano. Prendiamo un corpus giocattolo di cinque parole italiane, con le loro frequenze, scelte perché si somigliano abbastanza da condividere pezzi:
parola |
frequenza |
|---|---|
|
6 |
|
2 |
|
3 |
|
9 |
|
5 |
In tutto sono \(6 \cdot 5 + 2 \cdot 8 + 3 \cdot 5 + 9 \cdot 5 + 5 \cdot 8 = 146\)
caratteri (il totale tornerà utile con WordPiece, un criterio alternativo che
divide proprio per delle frequenze). Ogni parola parte spezzata nelle sue
lettere: b a s s o,
b a s s o t t o, e così via.
Passo 1. Contiamo ogni coppia adiacente, pesandola con la frequenza della
parola. La coppia s+s compare una volta in ciascuna delle cinque parole,
quindi vale \(6+2+3+9+5 = 25\); la coppia s+o compare in tutte tranne
rossetto (dove alla doppia s segue una e), quindi \(6+2+3+9 = 20\); la coppia
r+o solo in rosso e rossetto, \(9+5 = 14\). L’elenco completo:
coppia |
conteggio |
dove compare |
|---|---|---|
|
25 |
in tutte e cinque le parole |
|
20 |
tutte tranne |
|
17 |
|
|
14 |
|
|
8 |
|
|
8 |
|
|
7 |
|
|
7 |
|
|
5 |
|
|
5 |
|
|
3 |
|
|
2 |
|
Vince s+s con 25. Prima fusione: ss. Il corpus diventa
b a ss o, b a ss o t t o, b o ss o, r o ss o, r o ss e t t o.
Passo 2. Si ricontano le coppie sulla nuova segmentazione. Ora ss è un
simbolo unico, e le coppie che lo coinvolgono sono ss+o (in basso,
bassotto, bosso, rosso: \(6+2+3+9 = 20\)) e o+ss (in bosso, rosso,
rossetto: \(3+9+5 = 17\)). Le altre non sono cambiate: r o resta 14, b a e
a ss valgono 8, t t e t o valgono 7. Vince ss+o con 20. Seconda
fusione: sso.
Passo 3. Quattro parole su cinque contengono ora il simbolo sso:
b a sso, b a sso t t o, b o sso, r o sso; rossetto è rimasta
r o ss e t t o perché lì alla doppia s non segue una o. I conteggi:
r+o vale 14 (in rosso e rossetto), o+sso vale \(3+9 = 12\),
b+a e a+sso valgono 8 a testa. Vince r+o con 14. Terza fusione:
ro.
Passo 4. Adesso succede la cosa interessante. La coppia più frequente è
ro+sso, con 9, cioè tutte e sole le occorrenze di rosso, e la fusione
produce rosso: una parola intera diventa un singolo token. Non c’è nulla
di speciale nella regola, è sempre la stessa: ss, sso e ro si sono
formati prima perché li condividono più parole, e rosso, la parola più
frequente del corpus, è la prima a saldarsi per intero. È il motivo per cui,
nei tokenizzatori veri, le parole più frequenti nel corpus di addestramento
sono un token solo e quelle rare ne prendono parecchi: in quello di GPT-2,
come si è visto, the è un token e ortogonalizzazione ne prende sette.
I quattro passi sono illustrati nella Fig. 15.8: a sinistra le cinque parole, che a ogni fusione perdono una scatola; a destra l’elenco, che si allunga di una riga per volta con il conteggio che ha fatto vincere quella coppia.

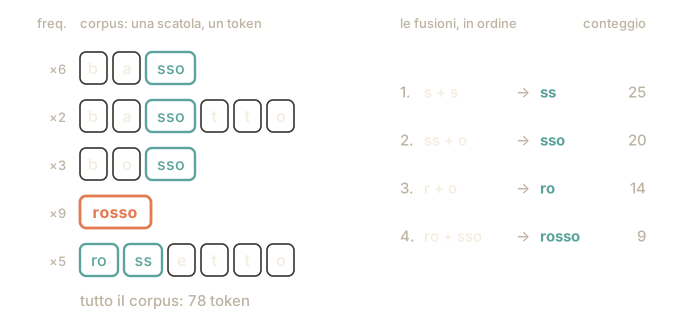
Fig. 15.8 Le quattro fusioni, una dopo l’altra. A ogni passo la coppia più frequente
diventa un pezzo solo e il corpus si accorcia: 146 pezzi, poi 121, 101, 87 e
infine 78, con rosso in una scatola sola.#
Dopo quattro fusioni il vocabolario contiene le sette lettere del corpus
(a b e o r s t) più ss, sso, ro, rosso. Al passo successivo si
presenterebbe un pareggio, b+a e a+sso a quota 8, e serve una regola
di spareggio, che il programma fissa in modo esplicito: a parità di conteggio
vince la coppia prima in ordine alfabetico. Un tokenizzatore, rilanciato
domani sullo stesso corpus, deve produrre esattamente
lo stesso vocabolario, altrimenti tutto ciò che il modello ha imparato punta ai
pezzi sbagliati.
La parola mai vista#
Il collaudo è tokenizzare qualcosa che nel corpus non c’era. Prendiamo
bassetto. Si parte dalle lettere, b a s s e t t o, e si riapplicano le
fusioni imparate nell’ordine in cui sono state imparate. Con le prime
quattro: ss si applica (b a ss e t t o), sso no (dopo la doppia s c’è
una e), ro no, rosso no.
Fermarsi a quattro fusioni sarebbe però un vocabolario ridicolo: lasciamo
correre l’algoritmo fino a dieci, come fa il programma della sezione «Il BPE in
Python». Le sei che si aggiungono sono, in ordine e con il conteggio che le ha
fatte vincere, a+sso → asso (8), b+asso → basso (8), t+o →
to (7), t+to → tto (7), e+tto → etto (5) e ro+ss → ross
(5). Con queste in mano, bassetto esce così:
b | a | ss | etto
Quattro token, nessun <UNK>, e due dei quattro sono pezzi imparati. C’è però
un dettaglio che merita attenzione, perché smonta un equivoco comune. Nel
vocabolario, a quel punto, il token basso c’è (è la sesta fusione), eppure in
bassetto la b e la a restano due token separati. Il motivo è che l’unica
strada per cui quelle due lettere si saldano passa prima per a+sso e poi
per b+asso, e in bassetto dopo la doppia s non c’è una o: la prima delle
due fusioni non scatta, la catena si spezza al primo anello, e la coppia
b+a, che pure nel corpus è frequente, non è mai stata imparata come fusione
a sé. BPE non cerca la scomposizione migliore: riapplica una ricetta. La
segmentazione che ne esce somiglia spesso alla morfologia, ma non è morfologia,
e quando le due divergono vince la ricetta.
Un caso più estremo: un cognome come rossellini, mai visto, diventa
ross | e | l | l | i | n | i
sette token per una parola sola. È il prezzo che le sotto-parole fanno pagare a ciò che è raro, e la sezione Oltre il BPE lo ritrova due volte: nei numeri, che si spezzano a casaccio, e nelle lingue diverse dall’inglese, che si frammentano di più.
E c’è dell’altro, che conviene guardare in faccia invece di girarci intorno, perché è il punto in cui la promessa «niente resta fuori» mostra la sua condizione.
Guarda le lettere di rossellini. Le l, le i e la n nel nostro corpus
giocattolo non compaiono mai: quel corpus è fatto di cinque parole, e le
lettere che ci stanno dentro sono sette in tutto, a b e o r s t. Un
tokenizzatore vero, prima di consegnare un pezzo, controlla di averlo nel
vocabolario; e siccome quelle cinque lettere nel vocabolario non ci sono, al
posto loro metterebbe cinque <UNK>, uno per ciascuna. Sette token, cinque dei
quali buchi. Il programma della sezione «Il BPE in Python» non lo fa, perché
riapplica le fusioni alla cieca, senza mai chiedersi se i simboli rimasti siano
noti: è un programma didattico, non un tokenizzatore di produzione.
Il punto vero è quello, però, e conviene metterlo per iscritto. L’affermazione «con le sotto-parole non resta fuori niente» non è una proprietà dell’algoritmo: è una scommessa sull’alfabeto di partenza. Si vince finché il corpus di addestramento conteneva ogni carattere che potrà mai arrivare. Con cinque parole la scommessa è persa in partenza; con un corpus vero è quasi sempre vinta, e a farla fallire bastano un ideogramma raro o un’emoji uscita l’anno scorso. È il buco che il livello dei byte, fra qualche pagina, chiuderà per costruzione e per sempre.
Il BPE in Python#
L’algoritmo è abbastanza piccolo da entrare in una pagina, senza librerie. Conta le coppie, fonde la vincitrice, ripete; poi riapplica le fusioni a una parola nuova.
from collections import Counter

# corpus giocattolo: parola -> quante volte compare
corpus = {"basso": 6, "bassotto": 2, "bosso": 3, "rosso": 9, "rossetto": 5}


def conta_coppie(pezzi, corpus):
    """Frequenza di ogni coppia adiacente, pesata sulle occorrenze della parola."""
    coppie = Counter()
    for parola, simboli in pezzi.items():
        for coppia in zip(simboli, simboli[1:]):
            coppie[coppia] += corpus[parola]
    return coppie


def fondi(simboli, coppia):
    """Sostituisce ogni occorrenza della coppia con il simbolo unito."""
    uniti, i = [], 0
    while i < len(simboli):
        if i < len(simboli) - 1 and (simboli[i], simboli[i + 1]) == coppia:
            uniti.append(simboli[i] + simboli[i + 1])
            i += 2
        else:
            uniti.append(simboli[i])
            i += 1
    return tuple(uniti)


def addestra(corpus, n_fusioni):
    pezzi = {parola: tuple(parola) for parola in corpus}   # si parte dai caratteri
    fusioni, conteggi = [], []
    for _ in range(n_fusioni):
        coppie = conta_coppie(pezzi, corpus)
        if not coppie:
            break
        # la più frequente; a parità di conteggio, la prima in ordine alfabetico
        coppia = min(coppie, key=lambda c: (-coppie[c], c))
        fusioni.append(coppia)
        conteggi.append(coppie[coppia])
        pezzi = {p: fondi(s, coppia) for p, s in pezzi.items()}
    return fusioni, conteggi


def tokenizza(parola, fusioni):
    """Riapplica le fusioni imparate, nello stesso ordine."""
    simboli = tuple(parola)
    for coppia in fusioni:
        simboli = fondi(simboli, coppia)
    return simboli


iniziali = {parola: tuple(parola) for parola in corpus}
print("coppie al primo passo:", conta_coppie(iniziali, corpus).most_common(5))

fusioni, conteggi = addestra(corpus, 10)
for i, ((a, b), n) in enumerate(zip(fusioni, conteggi), 1):
    print(f"{i:2d}. {a} + {b} -> {a + b}  ({n})")

print("bassetto   ->", tokenizza("bassetto", fusioni))
print("rossellini ->", tokenizza("rossellini", fusioni))
coppie al primo passo: [(('s', 's'), 25), (('s', 'o'), 20), (('o', 's'), 17), (('r', 'o'), 14), (('b', 'a'), 8)]
 1. s + s -> ss  (25)
 2. ss + o -> sso  (20)
 3. r + o -> ro  (14)
 4. ro + sso -> rosso  (9)
 5. a + sso -> asso  (8)
 6. b + asso -> basso  (8)
 7. t + o -> to  (7)
 8. t + to -> tto  (7)
 9. e + tto -> etto  (5)
10. ro + ss -> ross  (5)
bassetto   -> ('b', 'a', 'ss', 'etto')
rossellini -> ('ross', 'e', 'l', 'l', 'i', 'n', 'i')
Le prime quattro fusioni sono esattamente quelle calcolate a mano, con gli stessi conteggi (25, 20, 14 e 9). Con altre frequenze cambierebbero le fusioni e il loro ordine: quello che un tokenizzatore sa delle parole è ciò che ha contato nel corpus su cui è stato costruito, e lo trasmette a ogni modello che lo usa.
Da ricordare
La scatola dei mattoncini: con le sole lettere si costruisce qualunque parola, ma ci vuole un’eternità; con un pezzo già fatto per ogni parola del dizionario si va veloci, ma la scatola non basta mai. I pezzi sotto-parola sono il compromesso che ha vinto: pezzi grandi per ciò che ricorre, lettere singole di riserva per tutto il resto, purché il testo da cui si è partiti contenesse tutte le lettere che potranno arrivare.
BPE parte dalle lettere e incolla ogni volta la coppia di pezzi vicini che compare più spesso, segnandosi la fusione su un elenco. Per spezzare una parola mai vista non la cerca da nessuna parte: riapplica l’elenco nello stesso ordine. Non cerca la scomposizione migliore, ripete una ricetta.
Al modello arrivano numeri, gli ID dei pezzi, che servono solo a trovare la riga giusta di una tabella. Quali parole restano intere lo decide il testo su cui il tokenizzatore è stato costruito: in GPT-2 the è un pezzo solo, casa due.
Da ricordare
Un vocabolario di parole intere produce
<UNK>(informazione persa e non generabile), e per la legge di Heaps non si chiude mai; uno di caratteri allunga le sequenze e fa pagare il costo quadratico dell’attenzione: le sotto-parole sono il compromesso, e la copertura è garantita solo per i caratteri visti in addestramento.BPE [SHB16] parte dai caratteri e fonde, una alla volta, la coppia adiacente più frequente. Il modello è la lista ordinata delle fusioni, e tokenizzare una parola nuova vuol dire riapplicarle nello stesso ordine, senza cercare la segmentazione migliore. Anche la scelta delle fusioni è greedy, con una garanzia di approssimazione su un’utilità di compressione [ZMG+23].
Il modello riceve gli ID dei token, che indicizzano le righe della matrice di embedding e non portano informazione come numeri.
La ricetta ha tre punti in cui si può intervenire: il criterio con cui si sceglie la coppia da incollare (WordPiece), il modo di trattare il testo grezzo, spazi compresi, prima di contare (SentencePiece, che al posto delle fusioni può usare anche un modello diverso), e l’alfabeto di partenza, che con i 256 byte si chiude una volta per tutte. Sono i temi di Oltre il BPE, con conseguenze che arrivano fino al conto che si paga a ogni richiesta fatta a un modello.