


Reti neurali su grafo#
Nella Königsberg del primo Settecento (oggi Kaliningrad, in Russia) c’era un passatempo cittadino. Il fiume Pregel divideva la città prussiana in quattro lembi di terra, due sponde e due isole, cuciti insieme da sette ponti; e la domanda che circolava era se esistesse una passeggiata che attraversasse ogni ponte una e una sola volta. Nessuno ci riusciva, ma nessuno sapeva dire se fosse davvero impossibile o solo difficile.
A rispondere fu il matematico svizzero Leonhard Euler, e la sua mossa fu buttare via la mappa. Le distanze, la forma delle isole, la lunghezza dei ponti: niente di tutto questo contava. Contava solo quale lembo di terra fosse collegato a quale. Euler ridusse allora la città a quattro lettere, una per lembo di terra, e a sette ponti fra quelle lettere, e su quello scheletro dimostrò che la passeggiata non poteva esistere. Chi entra in un lembo di terra passando su un ponte ne deve prendere un altro per uscirne, quindi i ponti di ogni lembo vanno a coppie, salvo quello da cui si parte e quello in cui si arriva. I lembi con un numero dispari di ponti possono essere al massimo due, allora; a Königsberg erano quattro su quattro. Nel suo articolo non ci sono punti e linee, quelli che oggi chiamiamo nodi e archi: la parola grafo la introdurrà nel 1878 il matematico inglese James Joseph Sylvester, che la prese dai diagrammi con cui i chimici disegnavano le molecole. L’astrazione però è di Euler, e il suo articolo, Solutio Problematis ad Geometriam Situs Pertinentis, letto all’Accademia di San Pietroburgo nel 1735 e stampato sei anni dopo, è considerato l’atto di nascita della teoria dei grafi: la matematica delle cose collegate tra loro.
Quasi tre secoli dopo, quella stessa astrazione fa cose che Euler non avrebbe immaginato. Nel 2020 il gruppo del MIT di James Collins e Regina Barzilay pubblica sulla rivista Cell, con Jonathan Stokes primo fra gli autori, la scoperta di un nuovo antibiotico: hanno addestrato una rete neurale a leggere le molecole come grafi (atomi nei nodi, legami chimici negli archi) e a prevedere quali fermassero la crescita dei batteri. Le hanno poi fatto passare al setaccio un archivio di migliaia di sostanze già preparate, e la rete ne ha segnalata una che nessuno associava agli antibiotici; nei topi ha curato anche un’infezione da Acinetobacter baumannii resistente a tutti gli antibiotici provati [SYS+20]. L’hanno chiamata halicin, in omaggio a HAL 9000, il computer di 2001: Odissea nello spazio. Il filo che unisce i sette ponti di Königsberg a un antibiotico del XXI secolo ha un nome: le reti neurali su grafo (Graph Neural Networks, GNN).
Né griglia né sequenza#
Le reti viste finora lavorano su due forme di dato molto ordinate. Le reti convoluzionali del capitolo sul deep learning suppongono una griglia: i pixel di un’immagine hanno vicini fissi, sopra-sotto-destra-sinistra, sempre lo stesso numero. Le reti ricorrenti suppongono una sequenza: le parole di una frase arrivano in un ordine, una dopo l’altra. Sono ipotesi comode, e per immagini e testo sono anche giuste.
Ma moltissimi dati del mondo non sono né una griglia né una sequenza. Sono fatti di cose e dei legami fra quelle cose: si dice che sono dati relazionali, perché quel che conta non sono i pezzi ma le relazioni.
Una molecola è un insieme di atomi tenuti insieme da legami.
Un social network è un insieme di persone tenute insieme da amicizie.
Una mappa stradale è un insieme di incroci tenuti insieme da strade.
Una rete di transazioni collega conti che si scambiano denaro; un knowledge graph, cioè un archivio di fatti, collega concetti («Roma» (è capitale di) «Italia»).
Sotto la superficie, tutte queste cose hanno la stessa struttura: nodi e archi. È esattamente ciò che Euler aveva capito guardando i ponti.

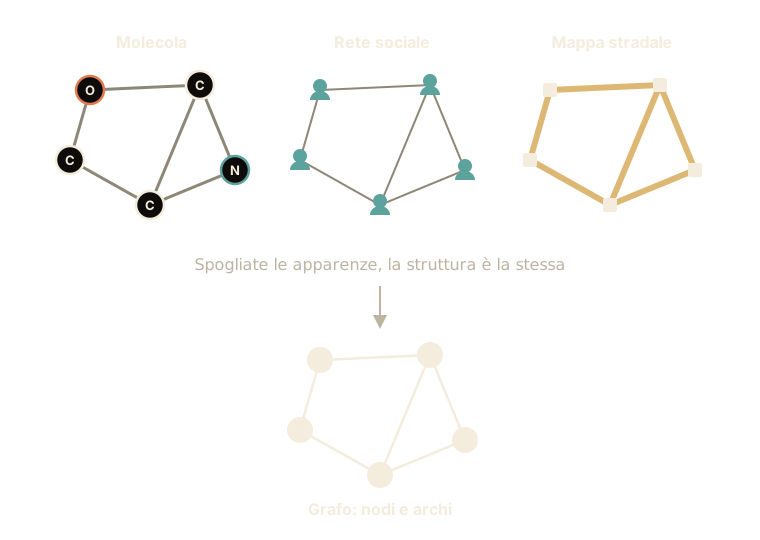
Fig. 32.1 Molecola, rete sociale e mappa stradale sembrano cose lontanissime, ma condividono lo stesso scheletro di nodi e archi (in basso). La GNN lavora su quello scheletro, qualunque cosa rappresenti.#
Come mostra Fig. 32.1, se spogliamo questi oggetti delle loro apparenze resta la stessa figura astratta. E qui nasce il problema tecnico: un grafo è ostico da dare in ingresso a una rete neurale ordinaria, per tre motivi.
Elenchi gli invitati a una cena e chi è amico di chi. In che ordine scrivi i nomi? Non c’è un ordine giusto: Anna prima o dopo Bruno è indifferente, l’importante è chi conosce chi. Se una rete neurale si accorgesse dell’ordine in cui le passi i nomi, imparerebbe una sciocchezza, perché quell’ordine non significa nulla. Una griglia di pixel e una frase, al contrario, un ordine ce l’hanno eccome: il pixel in alto a sinistra è sempre in alto a sinistra, la prima parola è sempre la prima.
Riscrivi la stessa lista in ordine alfabetico, poi fai due domande. «Alla cena ci si diverte?» riguarda la serata intera, e la risposta è una sola: deve essere quella di prima, perché la serata non cambia se scrivi i nomi in un altro ordine. «Chi rischia di restare in disparte?» riguarda invece ciascun invitato, e di risposte ne dà una per ognuno: devono essere gli stessi nomi di prima, e ciascuna deve restare attaccata alla sua persona anche adesso che il nome sta su un’altra riga.
E non è finita: a una cena ognuno ha un numero diverso di amici (c’è chi ne ha due e chi dieci), mentre in un’immagine ogni pixel ha sempre lo stesso numero di vicini. E ogni cena ha un numero diverso di invitati, mentre le foto le possiamo tagliare tutte alla stessa misura; e lo stesso modo di fare deve andare bene per una tavolata da sei e per una da sessanta. Ordine che non conta, vicini in numero variabile, dimensione variabile: ecco perché un grafo non è né una griglia né una sequenza, e serve un’idea nuova.
Formalmente un grafo è una coppia \(G = (V, E)\), dove \(V\) è l’insieme dei nodi e \(E \subseteq V \times V\) quello degli archi. Lo si rappresenta spesso con la matrice di adiacenza \(\mathbf{A} \in \{0,1\}^{N \times N}\) (con \(N = |V|\)), in cui \(A_{ij} = 1\) se esiste l’arco \((i,j)\). Ma questa rappresentazione nasconde un’insidia: \(\mathbf{A}\) dipende dall’ordine con cui numeriamo i nodi. Rietichettare i nodi con una permutazione \(\mathbf{P}\) trasforma \(\mathbf{A}\) in \(\mathbf{P} \mathbf{A} \mathbf{P}^\top\) senza cambiare il grafo. Un modello sensato deve quindi essere invariante alla permutazione (se produce un’etichetta per l’intero grafo, non deve cambiare quando rinumeriamo i nodi) o equivariante (se produce un’etichetta per ogni nodo, le etichette devono seguire la permutazione). Questa è la simmetria che le CNN hanno per la traslazione e che le GNN devono avere per la permutazione.
A ciò si aggiungono due irregolarità che rompono le architetture a griglia: il grado dei nodi è variabile (\(\deg(v)\) diverso da nodo a nodo), quindi non esiste un «vicinato di dimensione fissa» su cui far scorrere un filtro; e la dimensione \(N\) del grafo cambia da esempio a esempio, quindi il modello deve funzionare su grafi di taglia qualunque con gli stessi parametri \(\theta\).
L’idea in una frase#
Il rimedio si enuncia in una frase:
dare a ogni nodo (o a ogni arco, o all’intero grafo) una fila di numeri che lo descrive, e costruirla facendo circolare l’informazione lungo gli archi: ogni nodo ascolta i suoi vicini e si aggiorna, e si ricomincia.
Quella fila di numeri si chiama rappresentazione del nodo, ed è la parola che con i grafi torna più spesso: vuol dire sempre questo, la fila di numeri con cui il modello descrive un nodo in un certo momento. All’inizio non contiene niente di speciale, sono le informazioni che sul nodo abbiamo già noi (per una persona l’età, per un atomo il tipo di elemento); a ogni giro di ascolto diventa qualcosa di più.
Il resto è la macchina di sempre. Ogni operazione di un giro è derivabile (quasi ovunque, nel caso del massimo), quindi la rete si addestra dall’ingresso all’uscita con la retropropagazione e la discesa del gradiente della sezione sulla backpropagation, come ogni altro modello visto finora. Non serve un modo nuovo di imparare: serve solo un modo di far parlare i nodi fra loro.
Di una persona che non conosci ti fai un’idea guardando le compagnie che frequenta. «Dimmi con chi vai e ti dirò chi sei.» Una rete su grafo fa esattamente questo, a giri. All’inizio ogni nodo sa solo di sé; poi, a ogni giro, ciascun nodo guarda i suoi vicini, raccoglie le file di numeri che ciascuno di loro ha in quel momento e le riduce a una sola, per esempio facendone la media. Di quello che ha sentito gli resta quell’unica impressione d’insieme, e chi ha parlato per primo non lascia traccia, perché una media non sa in che ordine le sono arrivati i numeri. Poi il nodo mescola quell’unica fila con quella che aveva già. La regola per ascoltare e per aggiornarsi è una sola, la stessa per il più popolare e per il più schivo, e la stessa a ogni cena nuova. Dopo un giro, ogni nodo ha assorbito qualcosa dagli amici diretti; dopo due giri, anche dagli amici degli amici; e così l’informazione si diffonde per la rete come una voce che circola. Alla fine, la fila di numeri di ogni nodo non descrive più solo il nodo, ma il nodo immerso nel suo pezzo di mondo. Questo passaparola tra vicini ha un nome (message passing, «scambio di messaggi») ed è il cuore del capitolo.
A ogni nodo \(v\) si associa un vettore di stato \(\mathbf{h}_v^{(k)}\), che parte dalle sue feature iniziali \(\mathbf{h}_v^{(0)} = \mathbf{x}_v\) e viene raffinato per \(K\) iterazioni. Ogni iterazione ha la stessa forma: raccogliere (\(\mathrm{AGGREGATE}\)) i vettori dei vicini \(\mathcal{N}(v)\) e fonderli con il proprio (\(\mathrm{UPDATE}\)),
dove \(\mathcal{N}(v)\) è l’insieme dei vicini di \(v\) e le parentesi doppie segnano un multinsieme, non un insieme: due vicini con lo stesso vettore contano due volte, e senza questa distinzione cade il risultato di espressività che la sezione sulle architetture ricava dal test di Weisfeiler-Lehman. \(\mathrm{AGGREGATE}\) è un’operazione che non cambia se i vicini le arrivano in un altro ordine (una somma, una media, un massimo), proprio perché i vicini non hanno un ordine canonico; e mangia un numero variabile di vettori restituendone sempre uno solo, che è ciò che rende il modello indipendente dalla taglia del grafo. Dopo \(K\) passi, \(\mathbf{h}_v^{(K)}\) dipende soltanto dal sottografo entro distanza \(K\) da \(v\). Le funzioni \(\mathrm{AGGREGATE}\) e \(\mathrm{UPDATE}\) sono reti neurali con parametri \(\theta\) condivisi da tutti i nodi, ed è questa condivisione, unita all’indifferenza all’ordine di \(\mathrm{AGGREGATE}\), a garantire l’equivarianza alla permutazione; gli stessi parametri valgono anche da un grafo all’altro, ed è quello a permettere di addestrare su certi grafi e usare il modello su altri. La sezione sul message passing sviscera questo schema e ne ricava l’incarnazione più celebre, la Graph Convolutional Network (GCN).
L’idea non è nuova, e ha una storia in buona parte italiana. La prima forma sono le reti neurali ricorsive di fine anni Novanta, nei lavori di Alessandro Sperduti e Antonina Starita (1997) e di Paolo Frasconi, Marco Gori e Sperduti (1998). Reggevano però soltanto grafi senza giri chiusi, in cui gli archi hanno un verso e, seguendo le frecce, non si torna mai al punto di partenza: un albero genealogico sì, una rete di amicizie no. A reggere un grafo qualunque si arriva a metà anni Duemila, e per due strade italiane che nel 2009 escono a pochi mesi l’una dall’altra sulla stessa rivista: il modello del gruppo di Siena di Franco Scarselli e Marco Gori [SGT+09] e la rete di Alessio Micheli, a Pisa [Mic09]. Centrale, l’idea, lo è diventata solo nell’ultimo decennio, quando si è capito come farla girare in fretta anche su grafi enormi [Ham20].
Una volta che ogni nodo ha la sua rappresentazione, che cosa ce ne facciamo? Le domande che si fanno più spesso a un grafo sono di tre tipi. Accanto a queste ce ne sono altre, come generare un grafo nuovo (progettare una molecola invece di giudicarla) o raggruppare i nodi in comunità senza etichette, ma queste tre coprono i compiti con cui si addestra una GNN supervisionata.
Il primo tipo di domanda riguarda un singolo nodo: «questo account è un bot?», «questo utente a quale categoria appartiene?». Il secondo riguarda un arco che ancora non c’è: «queste due persone diventeranno amiche?», «a questo cliente piacerà questo prodotto?»; è la domanda che sta dietro ai suggerimenti di amicizia e alle raccomandazioni, e indovinare un collegamento che non c’è ancora si chiama link prediction, «previsione dei collegamenti». Il terzo riguarda l’intero grafo preso come un tutt’uno: «questa molecola è tossica?», «questo composto uccide i batteri?», ed eccoci di nuovo ad halicin.
Cambia anche quello che si ha in mano quando si comincia. Sul singolo nodo la risposta qualcuno l’ha già data, ma per pochi account: si impara da quei pochi, e tutti gli altri intorno fanno da contesto. Sull’arco si conoscono soltanto le amicizie che ci sono: per insegnare alla rete che aspetto ha una coppia di sconosciuti se ne pescano a caso fra quelle non collegate, sapendo che qualcuna diventerà amicizia domani. Sull’intero grafo un nodo solo non dice niente, quindi le file di numeri di tutti gli atomi si mettono insieme in un unico riassunto della molecola, e su quel riassunto si risponde; e la molecola che arriva sul tavolo quasi mai è una di quelle su cui si è imparato. Nodo, arco, grafo intero: la stessa macchina, tre domande diverse.
I tre livelli corrispondono ad altrettante famiglie di compiti. A livello di nodo: classificazione o regressione dei nodi (per esempio l’assegnazione di una categoria a partire dallo stato finale \(\mathbf{h}_v^{(K)}\)), tipicamente in regime semi-supervisionato (pochi nodi etichettati, il grafo intero come contesto). A livello di arco: link prediction, cioè stimare la probabilità che esista un arco \((u,v)\) a partire dalla coppia \((\mathbf{h}_u^{(K)}, \mathbf{h}_v^{(K)})\). A livello di grafo: si aggregano (\(\mathrm{READOUT}\)) tutti i vettori dei nodi in un unico vettore del grafo, su cui fare classificazione o regressione; qui il regime è di norma induttivo, perché ogni esempio è un grafo a sé e a test se ne incontrano di mai visti in addestramento.
Per la link prediction c’è una complicazione in più: gli esempi negativi nei dati non ci sono, e si campionano fra le coppie non collegate. Quanti se ne mettono contro ogni positivo cambia il valore della average precision e delle metriche di rango (non quello dell’AUC, che confronta coppie positivo-negativo e non dipende dalle proporzioni), e come li si sceglie (a caso, o fra le coppie vicine nel grafo, che sono le più difficili) cambia tutte e tre: il protocollo va dichiarato insieme al numero.
Dal dato all’architettura#
Il mondo come grafo. Come si mette un problema «in forma di grafo»: cosa sono nodi e archi, e che cosa c’è scritto su ciascuno (le loro caratteristiche, in gergo le feature); collegamenti con e senza verso, con e senza peso, di più tipi; e i tre tipi di domanda appena visti, con esempi concreti.
Message passing. Il meccanismo di propagazione vicino-per-vicino nella sua forma generale, e da lì, passo dopo passo, la Graph Convolutional Network (GCN): il modello che ha fatto delle GNN uno strumento pratico, presentato nel 2017 da Thomas Kipf e Max Welling.
I knowledge graph, cioè i grafi di fatti. Che cosa cambia quando ogni arco porta scritto sopra un verbo, e la coppia di nodi con il verbo in mezzo è un fatto sul mondo: («Roma», è capitale di, «Italia»). Come si mettono in numeri quei fatti, perché un arco che manca vuol dire «non lo so» e non «è falso», e perché a una domanda si può rispondere camminando sul grafo da un fatto all’altro invece di cercare la pagina che la contiene.
Oltre la GCN: GraphSAGE, GAT e applicazioni. Le due varianti che hanno reso le GNN utilizzabili su scala reale: GraphSAGE, che guarda solo un campione dei vicini e regge così grafi enormi, e la Graph Attention Network (GAT), che pesa i vicini con l’attenzione incontrata nel capitolo sui Transformer. Poi come si passa dai nodi a un verdetto sull’intero grafo, e la sorpresa che ne viene fuori: esistono coppie di grafi diversi che nessuna di queste reti riuscirà mai a distinguere. Una carrellata di applicazioni, dalla chimica alla frode, dalle mappe ai sistemi di raccomandazione; i limiti; e infine i Graph Transformer, che rifanno la strada in senso inverso: non una rete su grafo che assomiglia a un Transformer, ma un Transformer messo a lavorare su un grafo.
Tre fili che tornano#
Il primo è la convoluzione. Nella sezione sulle reti convoluzionali abbiamo visto un filtro scorrere su una griglia di pixel, combinando ogni pixel con i suoi vicini. Il message passing è la stessa idea (combinare un elemento con i suoi vicini) liberata dal vincolo della griglia: i «vicini» non sono più i quattro pixel adiacenti, ma i nodi collegati da un arco, in numero variabile. In questo senso la rete su grafo generalizza la rete convoluzionale, la CNN dei capitoli sulle immagini, a dati che una griglia non la formano.
Questo modo di guardare le cose ha un nome, geometric deep learning, cioè l’apprendimento profondo visto dalla parte della geometria [BBCVelivckovic21]. Parte da una domanda sola: che cosa si può fare a un dato senza cambiarne il significato? Un’immagine spostata di un pixel contiene sempre lo stesso gatto; una frase pronunciata un minuto più tardi è sempre la stessa frase; un grafo con i nodi rinumerati è sempre lo stesso grafo. Queste trasformazioni che non cambiano la risposta si chiamano simmetrie del dato, e una volta elencate dicono come deve essere fatta la rete che ci lavora sopra. Se la risposta riguarda il dato intero, applicare la simmetria prima della rete non deve cambiarla; se ha una posizione (un’etichetta per pixel, per parola, per nodo), deve spostarsi insieme al dato. Il modo più semplice di garantirlo è usare gli stessi pesi in tutte le posizioni che la simmetria scambia fra loro. La rete convoluzionale passa lo stesso filtro su ogni pixel, la rete ricorrente applica la stessa regola a ogni istante della sequenza, la rete su grafo la stessa regola a ogni nodo: la stessa idea, applicata a tre elenchi di simmetrie diversi.
Il secondo filo porta ai sistemi di raccomandazione. Lì il dato è, per sua natura, un grafo: da un lato gli utenti, dall’altro gli oggetti, e un arco ogni volta che un utente interagisce con un oggetto. Un grafo fatto così, con i nodi divisi in due squadre e archi solo fra una squadra e l’altra (mai fra due utenti, mai fra due prodotti), si dice bipartito. La link prediction su questo grafo è, letteralmente, il problema della raccomandazione: prevedere gli archi che ancora non ci sono. Ed è la lettura che mette a disposizione della raccomandazione tutto l’armamentario delle reti su grafo, portata in produzione da alcuni grandi servizi. Non è però la definizione del problema, e la sezione sulla raccomandazione neurale riprende il filo da vicino, dicendo anche perché i sistemi che girano davvero restano organizzati attorno al confronto fra due rappresentazioni, una per l’utente e una per il prodotto.
Il terzo filo è il meno ovvio dei tre e il più utile, perché porta a un capitolo che sembrava parlare d’altro: quello sui Transformer, i modelli che leggono e scrivono il linguaggio.
Nel capitolo sui Transformer si è visto come un modello legge una frase. Anche lì ogni parola ha la sua fila di numeri, la sua rappresentazione. Per farsi un’idea di una parola il modello non guarda solo quella: la confronta con tutte le altre della frase e decide quanto ciascuna conta, dando a ognuna un peso; poi la nuova rappresentazione di quella parola è il miscuglio di quelle delle altre, dosato secondo quei pesi. È il meccanismo che lì si chiama attenzione.
Adesso rileggi la stessa cosa con le parole di questo capitolo. «Ogni parola guarda tutte le altre» vuol dire: c’è un grafo in cui ogni parola è un nodo, e ogni nodo è collegato a tutti gli altri (un grafo così si chiama completo), e in più a sé stesso, perché ogni parola pesa anche la propria. «Decide quanto ciascuna conta» vuol dire: ogni collegamento porta un peso. E «la nuova rappresentazione è il miscuglio delle altre» è, parola per parola, il passaparola fra vicini. Un Transformer, insomma, sta già facendo message passing: solo che il grafo non glielo dà nessuno, se lo fabbrica collegando tutti con tutti.
Il che ha un vantaggio e un prezzo, e conviene vederli in coppia perché tornano per tutto il capitolo. Il vantaggio è che non gli serve sapere niente su chi è collegato a chi: funziona anche quando i collegamenti veri nessuno li conosce. Il prezzo è che collegare tutti con tutti costa, e il conto è presto fatto: ogni parola va confrontata con ogni parola, quindi con dieci parole sono dieci per dieci, cento confronti, e con mille parole un milione. Da qui una cosa che a prima vista non c’entra niente: buona parte della ricerca su come rendere l’attenzione meno costosa consiste, alla lettera, nel togliere archi da quel grafo completo.
Nel Transformer ogni token calcola la propria nuova rappresentazione come somma pesata dei valori di tutti i token della sequenza, sé compreso, con pesi appresi. Detto così è una frase su un’architettura per il linguaggio; riletta con il vocabolario delle reti su grafo è la definizione di un passo di message passing, con l’unica particolarità che il grafo è completo e porta un cappio su ogni nodo: ogni token è collegato a ogni altro e a sé stesso, e i coefficienti di attenzione sono i pesi degli archi. Vale per l’attenzione senza maschera causale; in un decoder ogni token vede solo sé stesso e quelli che lo precedono, e il grafo, invece che completo, ha soltanto gli archi che puntano in avanti nella sequenza.
Non è un’analogia costruita a posteriori. Le rassegne che hanno unificato il campo lo dicono esplicitamente: il quadro delle message passing neural network [GSR+17] copre le GNN, quello delle non-local neural network [WGGH18] copre i metodi «in stile self-attention» a partire dal Transformer, e le graph network di Battaglia e colleghi [BHB+18] li tengono insieme in un’unica formulazione, elencando fra i metodi coperti anche la GAT che incontreremo fra poco. Ne discende una lettura che vale in entrambe le direzioni: la GAT è la self-attention applicata a un grafo sparso invece che completo; e uno strato di self-attention è una GNN che ha rinunciato alla struttura, pagando in costo quadratico la libertà di non doverla conoscere. Vale dello strato, non del Transformer intero: la struttura che al linguaggio serve davvero, cioè l’ordine delle parole, un Transformer se la rimette da sé dentro le feature dei nodi, ed è la codifica posizionale. Da lì si capisce anche perché tanta ricerca sull’efficienza dell’attenzione somigli a teoria dei grafi: renderla sparsa vuol dire, letteralmente, togliere archi.
Questo terzo filo tornerà due volte: quando incontreremo la GAT, che pesa i vicini con l’attenzione, e nella sezione sulle architetture, dove si prova a fare la strada al contrario e a mettere un Transformer su un grafo qualunque.
Da ricordare
Moltissimi dati sono fatti di cose collegate fra loro (molecole, reti di amicizie, mappe stradali, pagamenti, fatti sul mondo): tutti hanno la stessa struttura di puntini e linee, cioè nodi e archi, l’astrazione che Euler inventò sui ponti di Königsberg.
Un grafo non è né una griglia di pixel né una fila di parole, e per tre motivi: l’ordine in cui si elencano i nodi non conta, ogni nodo ha un numero diverso di vicini e ogni grafo ha un numero diverso di nodi. Serve un modello per cui riordinare l’elenco non cambi la risposta che riguarda il grafo intero, e tenga attaccata a ogni nodo la risposta che riguarda lui.
L’idea delle GNN è dare a ogni nodo una fila di numeri che lo descrive, e costruirla facendo circolare l’informazione lungo i collegamenti: a ogni giro ogni nodo ascolta i vicini e si aggiorna. Il meccanismo si chiama message passing, «dimmi con chi vai e ti dirò chi sei».
Le domande sono di tre tipi: su un nodo, su un collegamento che ancora non c’è (prevederlo si chiama link prediction), sull’intero grafo.
Le GNN fanno per i grafi quello che le reti convoluzionali fanno per le immagini, e alla raccomandazione danno un modo nuovo di guardarla: consigliare un prodotto diventa indovinare un collegamento che ancora non c’è, in un grafo con gli utenti da una parte e i prodotti dall’altra. Non è però l’unico modo, né quello con cui sono fatti i sistemi che girano davvero.
Da ricordare
Moltissimi dati sono relazionali (molecole, social network, mappe, transazioni, knowledge graph) e hanno tutti la stessa struttura di nodi e archi, l’astrazione che Euler inventò sui ponti di Königsberg.
Un grafo non è né una griglia (come per le CNN) né una sequenza (come per le RNN): i nodi non hanno ordine canonico, hanno grado variabile, e il grafo ha dimensione variabile. Serve un modello invariante alla permutazione se l’etichetta è dell’intero grafo, equivariante se è una per nodo.
L’idea delle GNN è imparare una rappresentazione di nodi/archi/grafo facendo propagare l’informazione lungo gli archi, in modo differenziabile ed end-to-end. Il meccanismo si chiama message passing.
I compiti sono a tre livelli: nodo (classificazione), arco (link prediction), grafo intero (classificazione o regressione).
Le GNN generalizzano la convoluzione a domini non a griglia e portano la raccomandazione sul terreno della link prediction (grafo bipartito utente-prodotto), che non è però la definizione del problema.