


Confronto con i modelli precedenti#
Ogni nuova architettura va giudicata contro ciò che sostituisce, e prima del 2017 il testo lo trattavano le reti ricorrenti del capitolo sul Natural Language Processing: la RNN (recurrent neural network) e le due varianti con porte che l’hanno soppiantata, LSTM e GRU. Il confronto serve a capire perché il Transformer ha vinto, e anche dove non vince affatto.
Le reti ricorrenti: tre varianti, un limite#
Le tre varianti hanno un limite in comune: l’informazione sul passato attraversa uno stato che si aggiorna un passo alla volta. Il limite si vede già nella RNN più semplice.

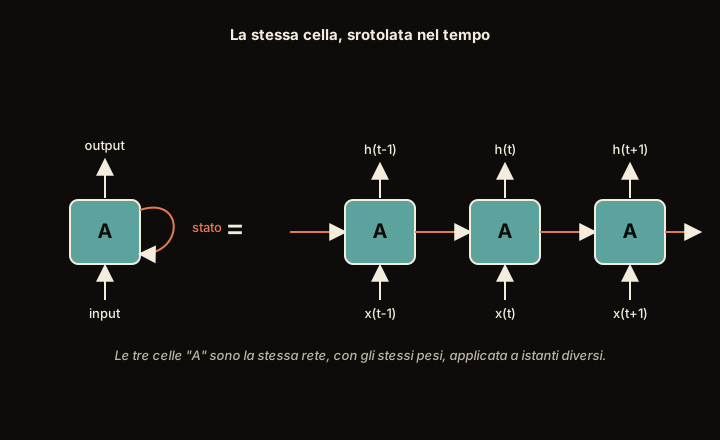
Fig. 16.6 Il cappio e il suo srotolamento. Le tre copie a destra sono la stessa rete, riusata a ogni passo, ed è per questo che una RNN funziona su sequenze di lunghezza qualsiasi.#
L’equivalenza di Fig. 16.6 è anche la radice del problema. Lo stato, il «riassunto» che la rete si porta dietro, è un vettore \(\mathbf{h}_t = f(\mathbf{h}_{t-1}, \mathbf{x}_t)\), aggiornato a ogni parola dalla stessa funzione con gli stessi parametri. Il contributo di una parola lontana, e la correzione che durante l’addestramento torna verso di lei, attraversano quindi una catena di passaggi simili, uno per parola, e a ogni passaggio si moltiplicano per un fattore simile.
Ed è lì che casca tutto, perché una moltiplicazione ripetuta non perdona: con un fattore di \(0{,}9\) per passo, dopo cento parole ne resta \(0{,}9^{100} \approx 0{,}000027\), meno di un trentamillesimo, il conto che la sezione sui modelli di sequenza ha fatto per esteso. Anche \(0{,}99\), che è quasi non perdere niente, dopo cento parole è sceso a \(0{,}37\). Qualunque fattore minore di uno finisce nello stesso posto, ed è tutta lì la ragione per cui l’inizio di un testo lungo sbiadisce; un fattore maggiore di uno fa il contrario, e il segnale esplode.
Le RNN leggono una parola alla volta portandosi dietro un riassunto mentale, che però sbiadisce in fretta: alla fine di un paragrafo lungo, l’inizio è quasi svanito. Le LSTM aggiungono un taccuino con delle regole: cosa annotare, cosa cancellare, cosa rileggere (la memoria dura molto di più, al prezzo di un meccanismo più complicato). Le GRU sono il taccuino semplificato: regole più snelle, quasi la stessa resa. Taccuino o no, però, si legge sempre una parola alla volta, e la parola dopo aspetta che sia finita quella prima. Il Transformer cambia tutto: niente riassunto da tenere aggiornato, il testo resta tutto sott’occhio e ogni parola può andare a rileggersi qualunque altra. La memoria non sbiadisce perché non c’è nulla da ricordare: basta guardare.
Due precisazioni, perché il «qualunque altra» va preso con le pinze. La prima: vale per la torre che legge (l’encoder); quella che scrive (il decoder) ha una regola ferrea, non si sbircia avanti, e guarda solo all’indietro.
La seconda riguarda la velocità. Il ricordo che non sbiadisce, da solo, non spiega la vittoria, perché il taccuino delle LSTM allungava già la memoria: quello che nessuna macchina di prima sapeva fare era mettere tante mani sullo stesso testo. Se le parole si guardano tutte insieme invece che in fila, il lavoro si può spartire fra migliaia di processori che macinano in parallelo: sono i «cento amici» dell’apertura del capitolo, quelli che con un libro da leggere in fila non servivano a niente e qui invece servono eccome. Attenzione però a quando: succede mentre il modello studia, cioè quando ha davanti tutto il testo e può lavorarci sopra in una volta sola. Quando poi scrive, le parole gli escono comunque una alla volta, perché per scegliere la prossima deve sapere quale ha appena scritto: lì i cento amici tornano a girarsi i pollici, e infatti generare resta lento.
Le RNN mantengono uno stato \(\mathbf{h}_t = f(\mathbf{h}_{t-1}, \mathbf{x}_t)\): la dipendenza tra posizioni distanti \(m\) passi attraversa \(m\) applicazioni di \(f\), e il gradiente retropropagato è un prodotto di \(m\) jacobiane \(\partial\mathbf{h}_s/\partial\mathbf{h}_{s-1}\). Se il massimo valore singolare della matrice ricorrente sta sotto \(1/\gamma\), con \(\gamma\) il massimo della derivata della non linearità (\(1\) per la tanh, \(1/4\) per la sigmoide), la norma del prodotto decade in modo esponenziale; perché esploda è necessario che lo superi [PMB13]. La derivazione sta nella sezione sui modelli di sequenza, che costruisce anche le LSTM [HS97] e le GRU [CvMerrienboerG+14]: con i gate aprono un cammino quasi lineare per il gradiente, e allungano l’orizzonte della memoria, ma restano sequenziali, perché il passo \(t\) attende il passo \(t-1\), in addestramento come in inferenza.
La Tabella 1 dell’articolo del 2017 mette a confronto quattro tipi di strato, con \(n\) la lunghezza della sequenza, \(d\) la dimensione delle rappresentazioni, \(k\) l’ampiezza del filtro convoluzionale e \(r\) quella del vicinato nell’attenzione ristretta [VSP+17]:
tipo di strato |
costo per strato |
operazioni in sequenza |
cammino massimo |
|---|---|---|---|
self-attention |
\(O(n^2 d)\) |
\(O(1)\) |
\(O(1)\) |
ricorrente |
\(O(n d^2)\) |
\(O(n)\) |
\(O(n)\) |
convoluzionale |
\(O(k n d^2)\) |
\(O(1)\) |
\(O(\log_k n)\) |
self-attention ristretta |
\(O(r n d)\) |
\(O(1)\) |
\(O(n/r)\) |
Il costo della self-attention è quello della sola operazione, senza le proiezioni, e il cammino \(O(\log_k n)\) della convoluzione vale per i filtri dilatati (con filtri contigui servono \(O(n/k)\) strati).
Il Transformer porta la lunghezza del cammino tra due posizioni qualsiasi a \(O(1)\) (ogni coppia è collegata direttamente dalla self-attention) e rende l’addestramento parallelo sull’intera sequenza. È questa combinazione (dipendenze lunghe e parallelismo) che le architetture ricorrenti non potevano offrire insieme. Il parallelismo, però, è un vantaggio soprattutto in addestramento, perché in inferenza la generazione autoregressiva resta sequenziale, un token alla volta.
Il conto da pagare: l’attenzione cresce col quadrato#
Il Transformer non è gratis, e il suo tallone d’Achille è proprio il gesto che lo definisce: far guardare ogni parola a tutte le altre.
Il conto è lo stesso dei cento sguardi dell’apertura del capitolo, con delle persone al posto delle parole. Quattro persone in una stanza, e ognuno deve parlare con ognuno: io con te, io con lui, io con lei, tu con lui, tu con lei, lui con lei. Sei coppie, contate con le dita. Senza dita: \(4 \times 3 = 12\), ognuno con tutti tranne sé, e \(12 : 2 = 6\) perché ogni coppia è finita nel conto due volte. In otto, \(8 \times 7 : 2 = 28\); in mille, \(1000 \times 999 : 2 = 499\,500\), quasi mezzo milione. Raddoppiando i presenti le chiacchiere quadruplicano, o quasi, ed è la crescita al quadrato.
Per un Transformer i presenti sono le parole, con due usanze: si parla anche da soli, e ascoltare non conta come farsi ascoltare (che «salta» guardi «gatto» è un conto, il rovescio un altro). In quattro i confronti diventano \(4 \times 4 = 16\), con la stessa crescita di prima. Una frase è una riunione svelta, dove pesa di più il lavoro che ognuno fa da solo, prima e dopo aver parlato; un libro è un’assemblea oceanica che nessun computer regge volentieri. Le reti ricorrenti, che leggono in fila, il problema non ce l’hanno: un presente in più è un turno in più. E un regolamento scritto in anticipo, con quanto ogni posto deve ascoltare ogni altro, varrebbe per un solo numero di presenti e sarebbe lunghissimo; l’attenzione le coppie le calcola al momento, con le stesse poche regole per qualunque riunione.
Poi c’è il tabellone, una casella per ogni scambio: sedici in quattro, un milione in mille. Il tempo alla peggio lo si aspetta; il tabellone, se lo si appende tutto intero, o sta nella stanza o non ci sta, ed è stato a lungo lui a decidere quanto testo un modello si tiene davanti. Lo si può anche riempire un pezzo alla volta, usarlo e cancellarlo, senza appenderlo mai intero: le chiacchiere restano tutte, ma la stanza basta. Gli altri rimedi tagliano invece le chiacchiere, e fanno parlare tutti senza convocare la plenaria.
Il primo fissa il programma prima di entrare: ognuno con i vicini di posto (poniamo i tre a destra e i tre a sinistra), qualche coppia sorteggiata per accorciare le distanze, e due o tre persone che parlano con tutti e fanno da ponte. In mille, invece di mezzo milione di chiacchiere ne servono qualche migliaio. Si arriva ancora dove arrivava la plenaria, e lo si dimostra; a reggere la dimostrazione sono i ponti, non i vicini. La riunione, però, si tiene a giri, uno per piano del modello, e in un giro i pochi ponti non ripetono tutto a tutti: c’è un compito che la plenaria sbriga in un giro solo e il programma fisso in tanti più giri quanti più sono i presenti (se regge un’ipotesi che nessuno ha ancora dimostrato). Si risparmia sulle chiacchiere di ogni giro e si paga in numero di giri.
Il secondo lascia decidere alla sala. Ognuno ha da dire qualcosa a pochissimi, e le altre conversazioni si tengono lo stesso a vuoto. All’ingresso, allora, i presenti vanno a tavoli per affinità e parlano con chi si ritrovano accanto. Il tavolo giusto si trova solo se chi cerca e chi va trovato portano lo stesso cartellino, ed è una rinuncia, perché in plenaria cercare e farsi trovare erano due mestieri distinti; chi l’ha sperimentato, su due compiti, non ha visto la riunione riuscire peggio. E i tavoli sbagliano: due che avevano da dirsi qualcosa finiscono separati. Si rifanno i tavoli più volte con criteri diversi, così l’occasione persa in una disposizione si recupera nella successiva, ma nessuno promette che non ne resti fuori una.
Gli stessi organizzatori hanno anche un accorgimento che non riguarda chi parla con chi. Di ogni giro si tiene un verbale, perché a riunione finita bisogna ripercorrerla all’indietro per capire che cosa correggere, e più giri vuol dire più verbali da conservare. Se però ogni giro si può ricostruire partendo da quello dopo, i verbali si buttano e si riscrivono quando servono, rifacendo i conti: spazio risparmiato, fatica in più, un baratto che in questo mestiere torna di continuo.
Il terzo butta la lista degli invitati invece di sfoltirla: i conti si riordinano perché le coppie non si formino mai una per una, invece di calcolarle tutte e scartarne poi quasi tutte. Costa una rinuncia (il modo in cui i punteggi diventano intensità va cambiato) e ha un capitolo suo, quello sull’attenzione lineare.
La matrice di attenzione ha \(n \times n\) elementi. Contando la sola operazione di attenzione (proiezioni escluse), il costo in tempo è \(O(n^2 \cdot d)\) nella lunghezza \(n\) della sequenza, con \(d = d_{\text{model}}\), contro l’\(O(n \cdot d^2)\) di uno strato ricorrente; la memoria per i punteggi è \(O(n^2)\), contro l’\(O(n \cdot d)\) delle attivazioni ricorrenti. Dal confronto fra i due termini l’articolo ricava che l’operazione di attenzione costa meno del passo ricorrente finché \(n < d\), il caso tipico della traduzione del 2017; le quattro proiezioni dello strato, che la sua tabella non conta, costano però \(4nd^2\), quanto lo strato ricorrente, quindi lo strato intero non costa meno, si parallelizza meglio. Dentro il Transformer, poi, il termine quadratico va messo accanto a quello delle proiezioni e della FFN: per strato il conto è \(12nd^2 + 2n^2d\), e il secondo supera il primo solo per \(n > 6d\), come ricava la matematica di un modello linguistico.
Il termine di paragone che la tabella non mette è un livello denso sull’intera sequenza, che mappi gli \(nd\) numeri d’ingresso negli \(nd\) d’uscita: avrebbe \(O(n^2 d^2)\) parametri e una lunghezza fissata una volta per tutte. L’attenzione ne ha \(O(d^2)\), condivisi fra le posizioni, e accetta qualunque \(n\); il prezzo è che l’interazione fra le posizioni non è parametrizzata ma calcolata, e costa \(O(n^2 d)\) operazioni. Sotto il vincolo della memoria, più ancora che del tempo, sono nate le finestre di contesto limitate dei grandi modelli, e una vasta letteratura di rimedi: attenzione sparsa o a finestre locali (Longformer, BigBird), approssimazioni a rango basso o kernel (Linformer, Performer [CLD+21]), e ottimizzazioni esatte come FlashAttention [DFE+22], che lascia il conto a \(O(n^2 d)\) ma non scrive mai la matrice \(n \times n\) in memoria globale e porta lo spazio aggiuntivo da \(O(n^2)\) a \(O(n)\); la costruisce la sezione sulla FlashAttention.
L’attenzione sparsa nasce da un cambio di punto di vista, più che da un trucco di calcolo. La matrice di attenzione è la matrice di adiacenza di un grafo completo sui token, e ridurne il costo è un problema di sparsificazione di grafi. Longformer [BPC20] toglie archi tenendo una finestra scorrevole attorno a ogni token, qualche finestra dilatata per allargare la portata, e alcuni token globali collegati a tutti (nel question answering, quelli della domanda): il costo scende da \(O(n^2)\) a \(O(n w)\), dove \(w\) è l’ampiezza della finestra, un numero fissato in anticipo e molto minore di \(n\). BigBird [ZGD+20] prende la stessa strada, formalizzandola: combina una finestra ad anello (un grafo «piccolo mondo» alla Watts-Strogatz), archi casuali alla Erdős-Rényi e token globali, e dimostra che il modello risultante resta un approssimatore universale di funzioni su sequenze.
Quel teorema va letto con le sue ipotesi accanto, che è facile dimenticare proprio davanti ai risultati che fanno comodo. Vale per le funzioni continue su un dominio limitato; e vale per qualunque schema sparso che contenga i token globali, cioè sono loro a portare il teorema, non la finestra. Soprattutto, gli stessi autori mostrano il rovescio nello stesso lavoro, e anche quel rovescio ha la sua ipotesi: esiste un compito che l’attenzione piena risolve in un numero costante di strati e che qualunque attenzione sparsa con un numero di archi proporzionale a \(n\) costringe a una profondità che cresce con \(n\), «under standard complexity theoretic assumptions», cioè ammettendo la congettura dei vettori ortogonali, che nessuno ha dimostrato. «Universale» vuol dire che ci si arriva, non che ci si arriva alla stessa profondità: la sparsificazione non è gratis, baratta ampiezza con altezza.
La sezione sui Graph Transformer riprende questa lettura dall’altro capo. Là il giro in cui ogni nodo raccoglie i vettori dei suoi vicini e ne fonde il riassunto col proprio ha un nome, message passing, e la self-attention è il caso in cui quel grafo è completo; da lì la conseguenza: i Graph Transformer applicano questo modello a un grafo qualunque, e per non perdere la topologia devono reintrodurla come codifica posizionale. Quella codifica nasce dallo stesso ragionamento delle sinusoidi appena viste, ma non ne è la generalizzazione matematica: là il confronto è fatto numero alla mano, e le due famiglie si somigliano senza coincidere.
Longformer e BigBird decidono in anticipo quali archi tenere, in base alla posizione. Il Reformer [KKL20] prende la strada opposta, e cioè non deciderlo affatto: lascia che siano i dati a dire quali coppie contano. L’osservazione di partenza è che dopo la softmax quasi tutta la massa di attenzione va su pochissime chiavi, quindi calcolare l’intera matrice è sprecare lavoro su valori destinati a essere quasi zero; e le chiavi che contano sono quelle con prodotto scalare grande, cioè quelle vicine alla query. Trovare i vicini senza confrontarli tutti è un problema classico, e la risposta classica è l’hashing sensibile alla località (LSH): una funzione \(g\) che manda vettori simili nello stesso secchiello con alta probabilità. Perché l’hashing funzioni, però, query e chiavi devono coincidere: se \(g(\mathbf{q}_j) \neq g(\mathbf{k}_j)\) una query può finire in un secchiello dove la sua stessa chiave non c’è. Il Reformer usa quindi la stessa proiezione per entrambe (shared-QK), rinunciando alla distinzione fra il cercare e l’essere trovati su cui si regge la Fig. 16.1; gli autori non trovano perdite sui due compiti su cui la provano (testo a livello di carattere e immagini di \(64 \times 64\) pixel). Fatto questo, si raggruppano query e chiavi per secchiello, si calcola l’attenzione piena solo dentro ciascun secchiello, e il costo scende da \(O(n^2)\) a \(O(n \log n)\). Il prezzo ulteriore è che l’hashing sbaglia: si ripete con più funzioni indipendenti per ridurre la probabilità di perdere una coppia importante, e la sparsità non è più garantita ma probabilistica.
Il secondo ingrediente del Reformer non riguarda l’attenzione ma la memoria, e merita di essere ricordato perché è trasversale: gli strati reversibili. In una rete ordinaria la retropropagazione ha bisogno delle attivazioni di ogni strato, quindi la memoria cresce con la profondità. Se però ogni strato è costruito in modo da poter essere invertito (dalle uscite si ricalcolano gli ingressi), quelle attivazioni non serve tenerle: si buttano e si ricostruiscono all’indietro quando servono. È il baratto memoria contro calcolo che l’ingegneria del deep learning ripropone a ogni scala, dalla ricomputazione delle attivazioni al modo in cui FlashAttention evita di materializzare la matrice di attenzione.
Quando conviene, e quando no#
Il Transformer rende al meglio quando ci sono molti dati di addestramento, hardware che esegue molti conti in parallelo invece che uno dopo l’altro (le GPU, le TPU) e legami fra parole molto distanti da catturare: sono le condizioni in cui si addestrano i grandi modelli linguistici. Le architetture ricorrenti restano ragionevoli dove la memoria e il calcolo per ogni parola devono restare costanti, con uno stato di dimensione fissa invece di una memoria che cresce con il testo: su un dispositivo piccolo, o davanti a un flusso che non finisce mai, come i sottotitoli in diretta o un traduttore che lavora mentre l’altro parla. E come idea non sono tramontate: due linee di ricerca recenti riportano in gioco un riassunto che si aggiorna passo per passo, proprio come facevano le RNN, ma costruito in modo da non pagare il costo quadratico dell’attenzione globale. Si chiamano attenzioni lineari e state space model (in italiano «modelli a spazio di stato», dove lo stato è appunto il riassunto che si aggiorna; il più noto si chiama Mamba), e hanno un capitolo ciascuna subito dopo quello sui Transformer: il capitolo sull’attenzione lineare e quello sugli state space model. Il Transformer ha vinto la partita del decennio, non necessariamente il campionato eterno.
Da ricordare
Le RNN leggono in fila con un riassunto mentale che sbiadisce; LSTM e GRU aggiungono un taccuino con delle regole e la memoria dura di più, ma si legge sempre una parola alla volta.
Il Transformer tiene tutto il testo sott’occhio: ogni parola può andare a rileggersi qualunque altra, e il lavoro si divide fra tanti processori. Vale però soprattutto mentre studia: quando scrive, le parole gli escono lo stesso una alla volta.
Il prezzo è la riunione dove ognuno parla con ognuno: raddoppiando i partecipanti le chiacchiere quadruplicano. E ogni conversazione va segnata su un foglio, con una casella per ciascuna: è stato a lungo lo spazio di quel foglio, più ancora del tempo, a decidere quanto testo un modello riesce a tenere davanti.
Per spendere meno si tolgono conversazioni, e i modi sono tre: decidere in anticipo chi parla con chi (ognuno con i vicini, più qualche partecipante che parla con tutti), lasciare che siano i dati a dire quali coppie contano, oppure cambiare del tutto il modo di fare i conti (il capitolo sull’attenzione lineare).
Nessuna architettura vince per sempre: i due capitoli dopo quello sui Transformer riportano in gioco l’idea del riassunto che si aggiorna, proprio dove la riunione plenaria costa troppo.
Da ricordare
RNN: memoria che sbiadisce e calcolo sequenziale. LSTM/GRU: gate che allungano la memoria (tre le prime, contando il forget aggiunto nel 2000; due le seconde), ma sempre in fila.
Il Transformer collega ogni coppia di posizioni in un passo e si addestra in parallelo: dipendenze lunghe e velocità. In inferenza, però, la generazione resta sequenziale.
Il prezzo è quadratico nella lunghezza della sequenza, e i due termini vanno tenuti distinti: la memoria per i punteggi è \(O(n^2)\) se la si scrive tutta insieme, ed è a lungo stata lei a fissare il tetto al contesto; il tempo è \(O(n^2 d)\), che supera il costo delle matrici dense solo oltre \(n \approx 6d\), cioè, per i modelli attuali, oltre qualche decina di migliaia di token (i conti sono nella sezione sui grandi modelli linguistici).
Ridurre quel costo vuol dire togliere archi da un grafo completo, e le strade sono tre: uno schema fisso deciso in anticipo (Longformer, BigBird), una scelta guidata dai dati con l’hashing sensibile alla località (Reformer, da \(O(n^2)\) a \(O(n\log n)\), al prezzo di query e chiavi condivise), oppure rinunciare del tutto alla softmax e fattorizzarla (il capitolo sull’attenzione lineare).
Nessuna architettura vince per sempre: attenzione lineare e state space model (i due capitoli dopo quello sui Transformer) rimettono in gioco idee ricorrenti proprio dove l’attenzione costa troppo.
Prima di quei capitoli resta da vedere che cosa costa l’attenzione in fase di inferenza. I conti fatti fin qui riguardano l’addestramento, con il testo già davanti; in generazione, una parola per volta, la stessa formula gira in un regime diverso e paga un prezzo diverso, più di memoria che di calcolo, e lo misura la sezione sull’attenzione in pratica.