


Modelli latenti e inferenza variazionale#
In una scuola preparatoria inglese, trentatré ragazzi fanno gli esami di quattro materie: le materie classiche, il francese, l’inglese e la matematica. I voti si somigliano più di quanto dovrebbero. Chi va bene in una tende ad andare bene anche nelle altre, e quel «tende» si può misurare: si prendono due materie, si guardano le due graduatorie della classe e si chiede quanto vadano d’accordo, con un numero che vale 0 se non c’entrano niente l’una con l’altra, 1 se sono la stessa identica graduatoria, e scende sotto zero quando una sale mentre l’altra scende. Charles Spearman fa il conto per ogni coppia di materie, e poi, per ciascuna materia, la media dei tre confronti con le altre tre: gli vengono 0,77 per le materie classiche, 0,72 per il francese, 0,70 per l’inglese, 0,67 per la matematica [Spe04]. Sono numeri alti, e fin qui nessuno si stupisce: i bravi sono bravi.
Poi Spearman fa una cosa che con la scuola non c’entra niente. Mette gli stessi ragazzi davanti a due suoni quasi identici e chiede quale dei due sia più acuto. È un compito da orecchio, non da studio: non si copia, non si ripassa la sera prima, e l’unico allenamento che conta è la musica. E il risultato mette in fila le quattro materie nello stesso ordine di prima: 0,60 con le materie classiche, 0,56 col francese, 0,45 con l’inglese, 0,39 con la matematica. (Sono le correlazioni grezze su tutta la scuola; restringendole ai ventidue ragazzi che studiavano musica salgono tutte, e l’ordine resta identico.)
Distinguere due note non ha niente a che vedere con declinare rosa, e non ha niente a che vedere con risolvere un’equazione. Eppure chi fa meglio l’una tende a fare meglio anche le altre, e sempre nella stessa graduatoria. La spiegazione che Spearman propone nel 1904 è tutta nella sua forma: sotto a tutte queste prove c’è una quantità sola, che nessuno ha misurato e che nessuno misurerà mai, e ogni prova è quella quantità più il proprio scarto. Le materie non si somigliano fra loro: si somigliano perché sono figlie della stessa cosa.
Se quella quantità esista davvero, e che cosa sia, è oggetto di una discussione che dura da oltre un secolo, e qui non serve prendere posizione: quello che ci serve è la mossa, non la conclusione. La mossa è sopravvissuta alla discussione, ha preso un nome (variabile latente, dal latino latere, «stare nascosto») e ha una macchina matematica che la rende operativa, che Spearman inventò per sostenere la sua tesi e che oggi si chiama analisi fattoriale: ogni voto è la quantità nascosta moltiplicata per un peso proprio di quella materia, più uno scarto. È l’antenata dei modelli a variabile latente continua, e ne è la versione più semplice, perché fra la quantità nascosta e le cose visibili ci sono soltanto moltiplicazioni e somme.
Anche l’altra metà del titolo si scioglie qui. Inferenza è il mestiere di risalire alla causa nascosta a partire da quello che si vede, dai voti di quei ragazzi alla quantità che nessuno ha misurato, ed è il senso che la parola ha in tutto il capitolo. Nel gergo del deep learning la stessa parola indica quasi sempre una cosa molto più modesta, il momento in cui un modello già addestrato risponde e basta, e chi la incontra di solito in quel senso qui deve lasciarla da parte. Variazionale dice come la si fa. La risposta di un’inferenza non è un numero ma una distribuzione, il ventaglio delle cause possibili con quanto ciascuna è credibile; invece di calcolarla esatta, se ne cerca la migliore approssimazione fra le distribuzioni di una forma fissata in anticipo, per esempio fra tutte le curve a campana.
La mossa: spiegare il visibile con l’invisibile#
Chi vuole costruire una macchina che fabbrica dati nuovi ha davanti un compito scoraggiante: scrivere una formula per la probabilità di un dato. Quanto è probabile questa fotografia?
La domanda suona strana, perché una fotografia c’è o non c’è, e la sciogliamo subito, perché regge tutto il capitolo: vuol dire quanto ci si aspettava di vedere una cosa così. La foto di un gatto nero su un muro è probabile; la stessa foto con il muro fatto di puntini colorati a caso non lo è. E chi sa rispondere sa anche fabbricare, perché sapere quali immagini sono attese è sapere quali produrre.
Il guaio è che quella formula nessuno la sa scrivere. Il dato è enorme (una fotografia da \(300 \times 300\) puntini, che è piccola, sono novantamila puntini, e ognuno vuole tre numeri per il rosso, il verde e il blu: duecentosettantamila numeri in tutto) e le sue parti sono legate fra loro in modi che sfuggono: due pixel vicini hanno quasi sempre lo stesso colore, tranne sui contorni, e dove passano i contorni dipende da che cosa c’è nella foto.
La mossa della variabile latente è cambiare domanda. Invece di descrivere il dato, si descrive come è nato: prima si sorteggia qualcosa che non si vede, la causa nascosta \(\mathbf{z}\), da una distribuzione semplice scelta in anticipo, il prior \(p(\mathbf{z})\); poi, a partire da lei, si sorteggia il dato \(\mathbf{x}\). Il modello si scrive allora in due pezzi, e sono due pezzi semplici; la complicazione che si vede nasce dal fatto che il primo dei due non lo si osserva mai.
Nel cassetto ci sono due sacchetti di biglie. In uno le biglie sono piccole, sui 12 millimetri, con un paio di millimetri di variazione da una all’altra; nell’altro sono grandi, sui 20 millimetri, sempre con la sua variazione. Tu peschi a occhi chiusi: prima una monetina decide il sacchetto, poi peschi una biglia da lì, e misuri solo la biglia. Quale sacchetto fosse, non lo guardi mai e non lo scrivi da nessuna parte.
Fai mille pescate e disegni l’istogramma delle misure, cioè il grafico che dice, per ogni misura, quante biglie ci sono cadute. Non viene una gobba sola: ne vengono due, una intorno a 12 e una intorno a 20, e in mezzo un avvallamento. Eppure dentro ciascun sacchetto le misure erano la cosa più semplice del mondo, una gobba e basta. La forma complicata (due gobbe) non l’ha messa nessuno: è comparsa perché una parte della storia, cioè quale sacchetto, è rimasta nascosta.
Se qualcuno ti dicesse a ogni pescata da quale sacchetto viene la biglia, il conto sarebbe una banalità: guardi il sacchetto, sai la sua gobba, hai finito. Siccome quel dato manca, per sapere quanto è probabile una biglia bisogna mettere in conto tutti i sacchetti da cui poteva venire. Con due sono due conti e si fanno a mente: il capitolo esiste perché fra poco i sacchetti non saranno due.
Nei casi che ci interessano sono infiniti. Immaginali allineati lungo un righello, uno per ogni punto: si sorteggia un punto del righello, e una regola dice attorno a che misura stanno le biglie del sacchetto che sta lì. E il sorteggio non è alla pari: i punti vicini al centro escono spesso, quelli lontani quasi mai, ed è una preferenza che decidiamo noi prima di cominciare. Quella preferenza è il prior.
E i sacchetti nessuno te li ha mostrati. Torna ai due del cassetto e cambiali di poco, 12 e 14 millimetri con la stessa variazione: l’istogramma fa una gobba sola, e a guardarla non diresti mai che i sacchetti erano due. Sei tu a supporli, perché supponendoli i conti tornano più semplici, ed è una scommessa che può anche non pagare.
Un modello a variabile latente non scrive \(p(\mathbf{x})\) direttamente: scrive una distribuzione congiunta su ciò che si osserva e su ciò che non si osserva, e ottiene la prima marginalizzando la seconda, cioè sommando su tutti i valori che la variabile nascosta poteva prendere:
dove \(\mathbf{x}\) è il dato osservato, \(\mathbf{z}\) la variabile latente, \(p(\mathbf{z})\) il prior (la distribuzione da cui \(\mathbf{z}\) viene sorteggiato, scelta da noi e di solito semplicissima), \(p_\theta(\mathbf{x} \mid \mathbf{z})\) la verosimiglianza del dato condizionata al latente, e \(\theta\) i parametri del modello generativo. L’integrale diventa una somma quando \(\mathbf{z}\) è discreto.
Il caso discreto si è già visto, e con questo nome: nella mistura di gaussiane della sezione su riduzione e clustering, \(z \in \{1, \dots, K\}\), la componente da cui l’esempio proviene, è introdotta lì proprio come variabile latente. Là \(p(z = k) = \pi_k\) è il suo peso e \(p(\mathbf{x} \mid z = k) = \mathcal{N}(\mathbf{x}; \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k)\) la sua campana, con \(\boldsymbol{\mu}_k\) il centro della componente \(k\) e \(\boldsymbol{\Sigma}_k\) la sua covarianza; la densità osservata
può essere multimodale pur essendo fatta di soli pezzi unimodali: con \(K = 2\) è la densità a due gobbe che nasce da due sole componenti. Le gobbe però non sono garantite, e la soglia si calcola: due componenti di ugual peso e ugual larghezza ne danno due soltanto se i centri distano più di due deviazioni standard (a distanza esattamente due la cima è piatta, con derivata seconda nulla), e sotto quella soglia la densità torna a una gobba sola pur restando una mistura.
Il caso continuo generalizza la stessa costruzione: se \(p(\mathbf{z}) = \mathcal{N}(\mathbf{0}, \mathbf{I})\) e \(p_\theta(\mathbf{x} \mid \mathbf{z}) = \mathcal{N}\big(\mathbf{x};\, f_\theta(\mathbf{z}),\, \sigma^2 \mathbf{I}\big)\), dove \(f_\theta\) è una rete neurale e \(\sigma^2\) la varianza del rumore che il decoder aggiunge (da non confondere con la varianza della zona proposta dall’encoder, che comparirà nella sezione sul salto probabilistico), allora \(p_\theta(\mathbf{x})\) è una mistura infinita di gaussiane sferiche, i cui centri sono le uscite della rete e i cui pesi sono dati dal prior. Una rete deterministica più due gaussiane elementari bastano quindi a descrivere una distribuzione che in forma chiusa non si saprebbe scrivere.
Con \(f_\theta\) affine, cioè \(f_\theta(\mathbf{z}) = \mathbf{W}\mathbf{z} + \boldsymbol{\mu}\) con \(\mathbf{z}\) di dimensione \(L\), il modello diventa la PCA probabilistica di Tipping e Bishop [TB99], e la massima verosimiglianza ha forma chiusa. Con \(\lambda_1 \ge \dots \ge \lambda_D\) gli autovalori della covarianza dei dati, \(\mathbf{U}_L\) la matrice dei primi \(L\) autovettori e \(\boldsymbol{\Lambda}_L\) la diagonale dei primi \(L\) autovalori,
dove \(D\) è la dimensione del dato e \(\mathbf{R}\) una qualunque matrice ortogonale \(L \times L\). La soluzione individua quindi il sottospazio generato dalle prime \(L\) componenti principali e non le singole direzioni, perché \(\mathbf{W}\) è determinata solo a meno della rotazione \(\mathbf{R}\). La varianza del rumore è la media degli autovalori scartati. Se invece \(\sigma^2\) è fissato a mano anziché stimato, la colonna di \(\mathbf{W}\) che corrisponde a un autovalore non superiore a \(\sigma^2\) resta nulla: è un fenomeno che tornerà nella sezione sul salto probabilistico a spiegare il collasso della posterior. Nel limite \(\sigma^2 \to 0\) la ricostruzione si riduce alla proiezione ortogonale, cioè alla PCA della sezione su riduzione e clustering, e il codice ne è un sistema di coordinate. Cambiando l’ipotesi sul rumore, da una sola varianza per tutte le componenti osservate a una varianza per ciascuna, si ottiene l’analisi fattoriale, e con un fattore solo è il modello di Spearman: una quantità comune a tutte le prove più uno scarto proprio di ciascuna. Nel lavoro del 1904 quel rapporto è già stimato prova per prova, sulle correlazioni corrette per l’errore di misura e non su quelle grezze dell’apertura: per le materie classiche lo scarto sta alla quantità comune come 1 sta a 99, per la matematica come 26 a 74. Stessa struttura, con una moltiplicazione di matrici al posto della rete. Più tardi sono venute la forma a più fattori e la sua stima a massima verosimiglianza, non l’idea.

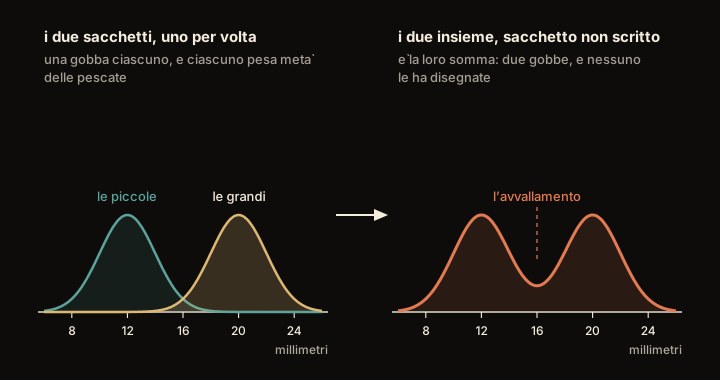
Fig. 25.1 Pezzi semplici, risultato complicato. A sinistra le due gobbe, una per sacchetto, ciascuna pesata metà, perché metà delle pescate viene di lì; a destra la loro somma, cioè quello che si misura quando il sacchetto non lo si guarda mai. La forma a due gobbe non l’ha disegnata nessuno: è comparsa perché una parte della storia è rimasta nascosta. E non è garantita: se i due sacchetti si somigliassero abbastanza, la gobba tornerebbe una sola. (Le curve sono lisce: è la forma verso cui l’istogramma tende quando le pescate sono tantissime.)#
Guardando Fig. 25.1 si capisce anche perché conviene: chi volesse descrivere la curva di destra senza sapere dei sacchetti dovrebbe inventarsi una formula per una cosa a due gobbe, mentre a noi sono bastate due gobbe semplici (in matematica si chiamano gaussiane, e «campana» è il soprannome della loro forma) e la regola con cui si sceglie il sacchetto. Gaussiane più una regola che sceglie fra loro fanno una mistura di gaussiane, la stessa della sezione su riduzione e clustering, dove la variabile latente era la componente da cui veniva un esempio.
Il prezzo: la somma che non si può fare#
La mossa costa, e il prezzo si dice subito, perché è il problema che il capitolo passa il tempo ad aggirare.

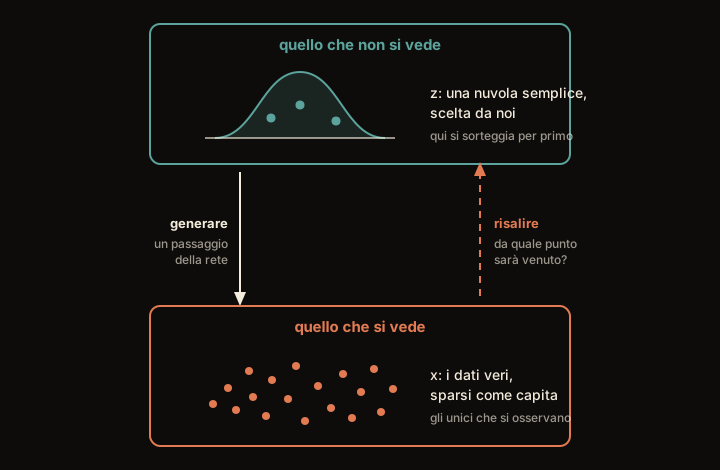
Fig. 25.2 Le due direzioni della stessa freccia. Scendere è facile: si sorteggia un punto là sopra e si applica la regola che porta da lui al dato. Risalire, cioè chiedersi da quale punto di sopra possa essere venuto un dato che si ha in mano, è la parte cara. (Le due lettere del disegno sono quelle di sempre: z la causa nascosta, x il dato che si vede.)#
La freccia tratteggiata di Fig. 25.2 costa in due modi diversi, che è bene tenere separati perché il capitolo li affronta con due strumenti distinti.
Prima difficoltà: la somma. Per sapere quanto è probabile un dato bisogna considerare tutti i valori che la causa nascosta poteva prendere, e sommare quanto ciascuno spiega il dato, contando ciascuno tanto quanto è probabile che tocchi proprio a lui: con due sacchetti pescati con una monetina sono due addendi, mezzo per uno. La causa nascosta di cui parleremo, però, è un vettore di \(L\) numeri reali (nel capitolo \(L = 8\), per comprimere una cifra scritta a mano, e si vedrà che la rete non li adopera nemmeno tutti), e siccome ciascun numero può valere qualunque cosa, la somma diventa un integrale su tutti i valori possibili. Un integrale si sa calcolare quando la funzione da integrare è semplice.
Qui non lo è. Il legame fra \(\mathbf{z}\) e \(\mathbf{x}\) passa per una rete neurale \(f_\theta\), non lineare e con migliaia di parametri, e l’integrale non ha una formula chiusa. Resta il calcolo numerico, che valuta la funzione su una griglia di punti; ma i punti della griglia si moltiplicano a ogni dimensione in più: se lungo un asse ne bastassero dieci, con due assi ne servirebbero cento, e con otto cento milioni.
Seconda difficoltà, ed è quella che sorprende: nemmeno la stima Monte Carlo funziona. La via d’uscita ovvia è sorteggiare dal prior un po’ di valori \(\mathbf{z}^{(1)}, \dots, \mathbf{z}^{(S)}\), calcolare per ciascuno quanto spiega il dato, \(p_\theta(\mathbf{x} \mid \mathbf{z}^{(s)})\), e fare la media. In media la stima è giusta, e in poche dimensioni funziona. Quando \(L\) cresce, però, quasi tutti i valori sorteggiati danno a \(p_\theta(\mathbf{x} \mid \mathbf{z})\) un valore trascurabile, e la media è dominata dai pochissimi che cadono nel posto giusto, ma che si estraggono di rado. Quando mancano, la stima esce molto più bassa del vero, quando compaiono schizza in alto, e rifacendo il sorteggio cambia ogni volta: ha una varianza enorme e, in scala logaritmica, è sistematicamente troppo bassa. La sezione sul salto probabilistico lo misura.
La stessa idea, dentro quattro macchine#
Il modello a variabile latente è già al lavoro in quattro capitoli, dove serviva la macchina e non la sua derivazione. Due sono già passati: i codec neurali, che riducono il suono a una sequenza di simboli, e il reinforcement learning offline, dove la stessa macchina dice quali mosse somigliano a quelle già viste. Due arriveranno: la generazione di immagini di Stable Diffusion e i modelli del mondo. La sezione sul latente che si usa li riprende uno per uno, con la macchina del capitolo in mano.
Il capitolo sulla verosimiglianza esatta, più avanti, mette in fila dove questa famiglia stia rispetto alle altre: là i modelli generativi incontrati fin lì sono ordinati in base a una cosa sola: che cosa ciascuno sa dire della verosimiglianza \(p_\theta(\mathbf{x})\), cioè di quel numero di poco fa, quanto il modello si aspettava di vedere il dato. Qui basta l’essenziale, e vale per la macchina che il capitolo costruisce, non per le sue antenate. Dove la causa nascosta passa per una rete neurale, la verosimiglianza si sa dire solo per difetto: si calcola un valore che sta di sicuro sotto quello vero. La mistura di gaussiane, la PCA probabilistica e l’analisi fattoriale, dove la causa prende pochi valori oppure il legame è lineare, la danno invece esatta, perché lì l’integrale si chiude. Si sa con precisione da che cosa sia formato il divario fra il valore calcolato e quello vero, e quanto valga lo si può stimare a parte, a modello addestrato, con un conto più costoso. Perché ci si debba accontentare del valore per difetto, e perché convenga, è la storia della sezione sul salto probabilistico.
Da ricordare
La mossa di questo capitolo è spiegare quello che si vede con qualcosa che non si vede: prima si sorteggia una causa nascosta, poi da quella si sorteggia il dato. La cosa nascosta si chiama variabile latente.
Il guadagno è che pezzi semplici danno un risultato complicato: due sacchetti con una gobba ciascuno, se le misure tipiche dei due sono abbastanza lontane, producono un istogramma a due gobbe, e nessuno ha dovuto scrivere la forma a due gobbe.
Il prezzo è che per sapere quanto è probabile un dato bisogna considerare tutte le cause nascoste possibili, e quando sono tante quel conto non si fa. Non si fa nemmeno tirando a sorte, perché quasi tutte le cause sorteggiate spiegano il dato malissimo.
Da ricordare
Un modello a variabile latente definisce \(p_\theta(\mathbf{x}) = \int p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})\, \mathrm{d}\mathbf{z}\): prior semplice, verosimiglianza condizionale semplice, marginale arbitrariamente complicata.
Con \(p(\mathbf{z}) = \mathcal{N}(\mathbf{0}, \mathbf{I})\) e \(p_\theta(\mathbf{x} \mid \mathbf{z}) = \mathcal{N}(\mathbf{x}; f_\theta(\mathbf{z}), \sigma^2 \mathbf{I})\) si ottiene una mistura infinita di gaussiane con centri \(f_\theta(\mathbf{z})\). La mistura di gaussiane finita della sezione su riduzione e clustering è lo stesso oggetto con \(\mathbf{z}\) discreto; con \(f_\theta\) affine si ottiene la PCA probabilistica, e l’analisi fattoriale è la variante con una varianza di rumore per ciascuna componente osservata.
Con \(f_\theta\) non lineare la marginale diventa intrattabile: nessuna forma chiusa, e la stima Monte Carlo dal prior ha varianza che esplode con la dimensione di \(\mathbf{z}\), perché quasi tutti i campioni cadono dove \(p_\theta(\mathbf{x} \mid \mathbf{z})\) è trascurabile. Con \(\mathbf{z}\) discreto e pochi valori possibili, o con \(f_\theta\) affine, il conto si chiude: mistura, PCA probabilistica e analisi fattoriale la marginale la danno esatta.
Da qui il programma del capitolo: rinunciare al valore esatto di \(\log p_\theta(\mathbf{x})\) e ottimizzare un limite inferiore, che si paga con un secondo modello (l’encoder) e si guadagna in trattabilità.
Comprimere, ricostruire, usare#
Tre sezioni, e ciascuna toglie un pezzo al problema. La prima parte dalla strada più corta, l’autoencoder, una rete che impara a comprimere un dato in un codice e a ricostruirlo senza che nessuno le parli di probabilità: funziona benissimo per comprimere e fallisce per generare, e il perché di quel fallimento è il modo migliore per capire che cosa manchi. La seconda è il cuore: la verosimiglianza intrattabile e il limite inferiore che la sostituisce, l’ELBO (dalle iniziali inglesi di evidence lower bound, «limite inferiore sull’evidenza», dove evidenza è il nome tecnico della verosimiglianza \(p_\theta(\mathbf{x})\), quanto il modello si aspettava di vedere il dato). L’ELBO si legge come una somma di due termini, uno che premia le ricostruzioni fedeli e uno che fa pagare i codici troppo lontani dal prior; e con lui arriva la riparametrizzazione, che riscrive il sorteggio in mezzo alla rete in modo che il gradiente lo possa attraversare. La terza sezione guarda che cosa si fa con il latente una volta che c’è: il \(\beta\)-VAE, che pesa di più il secondo termine e con cui si è sperato di tenere separate le cose di cui il dato è fatto (la luce, l’inclinazione, il soggetto); il VQ-VAE, con un latente fatto di simboli invece che di numeri; e i quattro capitoli in cui il modello è al lavoro.