


Il meccanismo di attenzione#
Quando leggi la frase «il gatto, che aveva dormito tutto il giorno sul davanzale, saltò», e arrivi a «saltò», il tuo cervello non ripassa tutte le parole in fila: torna dritto a «gatto». Sai a che cosa prestare attenzione. Il meccanismo di attenzione dà alle reti neurali questa capacità: davanti a una parola, guardare tutte le altre e pesare quanto ciascuna conta per capirla.
Non è nato per fare il protagonista. Nel settembre del 2014 era un rattoppo, inventato per migliorare le traduzioni delle reti che leggevano il testo una parola alla volta (le reti ricorrenti che la sezione sui modelli di sequenza monta pezzo per pezzo) [BCB15]. Tre anni dopo il Transformer ci avrebbe costruito sopra tutto il resto.
L’idea: una media pesata, con i pesi calcolati dall’ingresso#
Ogni token entra nell’attenzione come un vettore \(\mathbf{x}_i \in \mathbb{R}^{d_{\text{model}}}\), cioè una lista di \(d_{\text{model}}\) numeri: l’embedding della sezione sulla rappresentazione del testo. La ragione per cui conta è aritmetica: fra due parole una media non è definita, fra due vettori sì, coordinata per coordinata. Chi ha letto la matematica di un modello linguistico ha già visto il meccanismo per intero, con altri nomi e con le matrici scritte trasposte; qui lo si rivede con il vocabolario standard e con i pezzi che là restavano fuori.
Per ogni posizione l’attenzione calcola una media pesata dei vettori di tutte le posizioni della frase. Il risultato è una versione della parola arricchita dal contesto: non più «salta» in astratto, ma «salta» in questa frase. Da una media pesata ordinaria la distingue la provenienza dei pesi: non sono parametri fissati una volta per tutte dall’addestramento, li ricalcola ogni volta il contenuto della frase, parola per parola. Una media con pesi decisi dalla somiglianza c’era già, nella regressione a nucleo; là però il modo di misurare la somiglianza era fissato in partenza, una campana sulla distanza, qui lo impara la rete.
Il problema che l’attenzione viene a risolvere è il collo di bottiglia del modello encoder-decoder, che la sezione sulla traduzione con le reti ha raccontato insieme alla soluzione di Bahdanau: l’encoder, la parte che legge, comprimeva la frase in un solo vettore di lunghezza fissa, e il decoder, la parte che scrive, doveva tradurre da quello soltanto. I due nomi sono la terminologia standard, e la sezione sulla struttura del Transformer li smonta pezzo per pezzo. Il passo nuovo è prendere la mossa di Bahdanau, il decoder che rilegge tutte le parole d’origine pesandole di volta in volta, e farne l’unico meccanismo della rete.
Prendi la frase «Il gatto nero salta sul muro». Il modello sta elaborando la parola «salta» e si chiede: chi salta? Come un lettore con l’evidenziatore, ripassa la frase e assegna a ogni parola un’intensità di colore: «gatto» fluorescente (è il soggetto), «muro» un colore medio (è la destinazione), «il» e «sul» quasi trasparenti. Poi costruisce il significato di «salta» in questa frase mescolando le informazioni di tutte le parole, ma in proporzione all’evidenziatura: tanta parte di «gatto», un po’ di «muro», pochissimo del resto.
Le intensità sono numeri veri, e per «salta» potrebbero venire così: gatto 0,52, muro 0,24, salta 0,10, nero 0,06, sul 0,05, il 0,03. Sono sei numeri, uno per ogni parola della frase, e c’è anche «salta» stessa, perché ogni parola guarda anche sé. Sommano a 1, ed è una regola fissa: l’attenzione distribuisce sempre esattamente una unità di colore, quindi dare di più a «gatto» vuol dire togliere a qualcun altro. «Mescolare in quella proporzione» significa allora prendere il 52% della lista di numeri di «gatto», il 24% di quella di «muro», e così via, e sommare il tutto: quello che ne esce è «salta» in questa frase e in nessun’altra.
Due mestieri diversi, da tenere separati fin da subito. L’evidenziatore decide quanto ciascuna parola conta; quello che finisce nel miscuglio è invece l’informazione che ciascuna porta con sé, e per ogni parola la rete tiene le due cose in due liste di numeri diverse. Un vantaggio si vede subito: «gatto» può essere facile da trovare per una ragione (è un soggetto animato) e consegnare tutt’altro (che è un felino, che è nero, che in questa frase è il protagonista).
Quei numeri non stanno scritti da nessuna parte, e nessun programmatore li ha battuti a tastiera: escono dalla frase, e da un’altra frase ne uscirebbero altri. Quello che la rete impara durante l’addestramento è il criterio con cui il colore va assegnato; le intensità le ricalcola daccapo ogni volta che le arriva una frase nuova. E il criterio lo impara provando e correggendosi su miliardi di frasi: ogni volta che il risultato non è quello giusto (una traduzione sbagliata, la parola successiva sbagliata), viene ritoccato un pochino nella direzione che avrebbe fatto sbagliare di meno, con lo stesso provare-e-correggere del capitolo sulle reti neurali.
Ogni parola (più precisamente ogni token, l’unità in cui la sezione sui tokenizzatori ha spezzato il testo) è rappresentata da un vettore. Una funzione di attenzione prende un vettore query \(\mathbf{q}\) e un insieme di coppie chiave-valore \((\mathbf{k}_j, \mathbf{v}_j)\), e restituisce una combinazione dei valori. Per una sola query:
dove \(\tilde{z}_j\) è il punteggio di compatibilità fra la query e la \(j\)-esima chiave, \(d_k\) è la dimensione di query e chiavi, \(a_j\) è il peso che la softmax ricava dai punteggi, e \(\mathbf{o}\) è l’uscita, un vettore nello stesso spazio dei \(\mathbf{v}_j\). La somma corre sulle sole chiavi permesse.
Il meccanismo regge su alcune proprietà. La compatibilità è appresa, perché \(\mathbf{q}\) e \(\mathbf{k}_j\) non sono i vettori grezzi dei token ma proiezioni di quei vettori con matrici che l’addestramento aggiusta. La softmax rende poi i pesi non negativi e li normalizza a somma unitaria, quindi \(\mathbf{o}\) è una media pesata in senso proprio e resta nell’inviluppo convesso dei valori. Da ultimo, la ragione per cui l’operazione ha bisogno tanto di \(\mathbf{K}\) quanto di \(\mathbf{V}\): la chiave decide il peso, il valore fornisce il contenuto che viene mescolato. Sono due mestieri distinti affidati a due spazi distinti, e nulla obbliga i due a coincidere.
Un punto di vocabolario. Chiamare \(\mathbf{q}\) «la domanda» e \(\mathbf{k}_j\) «la risposta» aiuta a ricordare, ed è un uso corrente; ma il meccanismo è il prodotto scalare fra due proiezioni apprese, non un dialogo. E il prodotto scalare non c’era fin dall’inizio: nel lavoro del 2014 il punteggio lo calcolava una piccola rete a sé,
con \(\mathbf{s}_{i-1}\) lo stato del decoder al passo precedente, \(\mathbf{h}_j\) quello dell’encoder sulla parola \(j\), e \(\mathbf{W}_a\), \(\mathbf{U}_a\), \(\mathbf{v}_a\) appresi insieme al resto: è l’attenzione additiva. La forma moltiplicativa si afferma nel 2015 per due strade: nelle end-to-end memory network [SSWF15], che pesano ogni fatto \(\mathbf{m}_i\) in memoria con \(\operatorname{softmax}(\mathbf{u}^\top \mathbf{m}_i)\), dove \(\mathbf{u}\) è la domanda, e nella traduzione con Luong, Pham e Manning [LPM15], che confrontano tre punteggi fra lo stato del decoder \(\mathbf{s}\) e uno stato dell’encoder \(\mathbf{h}_j\): il prodotto scalare \(\mathbf{s}^\top\mathbf{h}_j\), la forma bilineare \(\mathbf{s}^\top\mathbf{W}_a\mathbf{h}_j\) e una variante della rete additiva. È la prima che il Transformer adotta, con le proiezioni apprese davanti e la scala, e l’articolo del 2017 ne dice il motivo: a parità di complessità teorica il prodotto scalare è un prodotto fra matrici, molto più veloce e parco di memoria della rete additiva, che però lo supera quando \(d_k\) è grande e la scala manca.
Tutte le query insieme: le forme delle matrici#
Fin qui la domanda era una sola. In un Transformer ce n’è una per posizione, e i conti si fanno tutti insieme impilando i vettori per righe, in notazione matriciale. Le posizioni che pongono una domanda, le query, sono \(L\), e impilate formano la matrice \(\mathbf{Q}\); quelle che si offrono per essere trovate, le chiavi, sono \(S\), e formano la matrice \(\mathbf{K}\). I due numeri in generale sono diversi: la matrice dei punteggi, una riga per query e una colonna per chiave, ha forma \(L \times S\), e il caso quadrato è soltanto il più frequente.
Un tabellone appeso al muro, una riga per ogni parola che fa una domanda e una colonna per ogni parola che si offre come risposta. Nella casella dove la riga «salta» incrocia la colonna «gatto» c’è un numero solo: quanto quella coppia va d’accordo. Riempito il tabellone, ogni riga viene guardata per conto suo, e le sue caselle diventano le intensità dell’evidenziatore per quella parola lì.
La parola «taglia» indica quanti numeri ci sono dentro una lista, non quanto è grande il tabellone. Domanda e risposta, cioè la riga e la colonna che si incrociano in una casella, vanno confrontate, quindi devono essere scritte con la stessa quantità di numeri; l’informazione consegnata no, quella può essere lunga a piacere, perché con nessuno si confronta. E quello che esce da una riga ha sempre la stessa taglia, che le colonne siano dieci o diecimila: il tabellone si allarga, il risultato per ogni parola no. È il motivo per cui la stessa macchina lavora su una frase e su un capitolo senza cambiare forma. Il costo, quello sì, cambia: il tabellone cresce con il quadrato della lunghezza, ed è da lì che vengono i limiti di lunghezza dei modelli.
Il tabellone è quadrato quando le due liste sono la stessa, cioè quando una frase interroga sé stessa. Ma non deve esserlo. Un traduttore ha davanti due liste diverse: le parole italiane che sta scrivendo fanno le domande, le parole inglesi che ha letto fanno le risposte, e dodici righe possono incrociare diciassette colonne senza che niente sia sbagliato. E quando un modello scrive una parola per volta, di righe ce n’è una sola, lunga quanto tutto quello che ha letto finora.
Del quadrato conviene diffidare, perché è la scorciatoia che costa di più. Chi si abitua a immaginarlo quadrato scrive regole che valgono solo per quel caso, e poi le applica agli altri: la traduzione e la scrittura parola per parola sono esattamente i due in cui quelle regole falliscono, e falliscono in silenzio, perché un tabellone rettangolare si riempie lo stesso.
Sia \(\mathbf{X} \in \mathbb{R}^{n \times d_{\text{model}}}\) la matrice delle rappresentazioni in ingresso, una riga per token. Dopo le proiezioni (di \(\mathbf{X}\) sola, o nell’attenzione incrociata di due matrici diverse, una per le query e una per chiavi e valori), e per una sola testa,
dove \(L\) è il numero di posizioni di query (non il numero di strati, che in questo capitolo si scrive \(n_{\text{strati}}\)), \(S\) il numero di posizioni di chiave e valore, \(d_k\) la dimensione per testa di query e chiavi, \(d_v\) quella dei valori. Query e chiavi devono condividere \(d_k\), perché fra loro si fa un prodotto scalare; i valori no, e \(d_v\) può essere diverso. Da qui le forme di tutto il resto:
con \(\mathbf{A}\) la matrice dei pesi dopo la softmax. L’uscita ha una riga per query e \(d_v\) colonne: la lunghezza della sequenza di chiavi è sparita nel prodotto, ed è il motivo per cui uno strato di attenzione accetta contesti di lunghezza qualsiasi senza cambiare forma in uscita.
\(L = S\) vale nella self-attention su una sequenza intera, e le due lunghezze
divergono in due casi tutt’altro che marginali: l’attenzione incrociata, dove
la sequenza di query e quella di memoria sono diverse; e la decodifica con la
cache, dove un blocco corto di query (spesso una riga sola) attende su un
prefisso lungo. La documentazione corrente di PyTorch tiene infatti \(L\) e \(S\)
distinte nella firma di scaled_dot_product_attention. Assumere \(n \times n\)
come forma universale dei pesi di attenzione è un errore che non si manifesta
finché non si esce dal caso simmetrico, e allora si manifesta come un
disallineamento della maschera.
Nel codice queste matrici hanno due indici in più davanti: uno per l’esempio del batch, cioè del gruppo di frasi elaborate insieme, e uno per la testa di attenzione, che arriva fra poco. I conti sono gli stessi, ripetuti per ogni esempio e per ogni testa, e per chiarezza quei due indici restano sottintesi.
Da dove nascono query, chiavi e valori#
Ogni token \(i\) ha tre rappresentazioni, una per ciascuno dei tre ruoli: la query \(\mathbf{q}_i\), la key \(\mathbf{k}_i\) e il value \(\mathbf{v}_i\). In italiano sono domanda, chiave e valore, ma i nomi inglesi sono quelli che si trovano ovunque, negli articoli e nel codice. Tutte e tre si ricavano dallo stesso vettore \(\mathbf{x}_i\), moltiplicandolo per tre matrici diverse e apprese durante l’addestramento: sono le proiezioni. Fig. 16.1 segue il percorso per un token solo, dalle proiezioni fino alla media dei value.
Sono i tre biglietti della matematica di un modello linguistico, che qui prendono i nomi che si useranno da ora in poi. Tre versioni della stessa parola, una per mestiere. La prima dice che cosa quella parola sta cercando nelle altre: «salta» cerca chi compie l’azione. La seconda è l’etichetta con cui si fa trovare da chi la sta cercando: «gatto» si presenta come qualcosa di animato, che può compiere azioni. La terza è l’informazione che consegna a chi l’ha scelta: di «gatto», il fatto che sia un felino, che sia nero, che nella frase sia il protagonista.
Le tre versioni escono dall’unica lista di partenza passandola attraverso tre tabelle di numeri: una tabella moltiplica una lista e ne restituisce un’altra, e siccome i numeri nelle tre tabelle sono diversi (e imparati durante l’addestramento), le tre liste che ne escono sono diverse fra loro.
Attenzione a non prendere le tre versioni per tre cartellini appiccicati addosso alla parola una volta per tutte. Le tabelle cambiano da un piano all’altro del modello, e dentro lo stesso piano ce n’è più di una copia che lavora in parallelo sulla stessa frase (fra poco quelle copie prenderanno il nome di teste). Quindi «gatto» cerca una cosa al primo piano e un’altra al ventesimo, e nello stesso piano si presenta in un modo a una copia e in un altro modo a quella accanto. Saperlo evita un errore preciso: chi si aspetta un cartellino fisso si aspetta anche che «gatto» venga scelto sempre dalle stesse parole, e poi trova due piani in cui succede il contrario, senza che nessuno dei due sia rotto.
E la separazione dei tre mestieri sembra un lusso, mentre è il punto di tutta la faccenda. Se ogni parola avesse una sola versione di sé, cercare ed essere trovati sarebbero la stessa operazione, e una parola potrebbe attirare soltanto le parole che le somigliano. Con la ricerca e l’etichetta distinte può invece cercare qualcosa di molto diverso da ciò che offre: «salta» offre un’azione e cerca un soggetto, cioè esattamente quello che non è.
Uno strato di self-attention applica tre proiezioni lineari apprese alla stessa matrice di ingresso:
con \(\mathbf{W}^Q, \mathbf{W}^K \in \mathbb{R}^{d_{\text{model}} \times d_k}\) e \(\mathbf{W}^V \in \mathbb{R}^{d_{\text{model}} \times d_v}\). Sono le trasposte delle \(\mathbf{W}^A\), \(\mathbf{W}^B\), \(\mathbf{W}^C\) della matematica di un modello linguistico, che lavora su vettori colonna; qui, come nelle librerie, le posizioni stanno nelle righe di \(\mathbf{X}\). Nell’attenzione incrociata cambia una cosa sola: le query vengono da un flusso, \(\mathbf{Q} = \mathbf{Y}\mathbf{W}^Q\) con \(\mathbf{Y}\) le rappresentazioni di quell’altra sequenza, e chiavi e valori dall’altro. Tutto il resto dell’operazione è identico.
\(\mathbf{Q}\), \(\mathbf{K}\) e \(\mathbf{V}\) sono dunque viste apprese delle rappresentazioni correnti, e non ruoli semantici attaccati ai token. Lo stesso token ha query, chiavi e valori diversi in strati diversi e in teste diverse dello stesso strato, perché diverse sono le matrici che li producono. Il modello impara due spazi con cui decidere la compatibilità (\(\mathbf{Q}\) e \(\mathbf{K}\)) e uno spazio per l’informazione da aggregare (\(\mathbf{V}\)).
La libertà di avere \(\mathbf{W}^Q \neq \mathbf{W}^K\) ha una conseguenza strutturale che si perde di vista: la matrice dei punteggi \(\mathbf{X}\mathbf{W}^Q(\mathbf{X}\mathbf{W}^K)^\top = \mathbf{X}\,\mathbf{W}^Q\mathbf{W}^{K\top}\mathbf{X}^\top\) è governata da \(\mathbf{W}^Q\mathbf{W}^{K\top}\), una matrice \(d_{\text{model}} \times d_{\text{model}}\) che in generale non è simmetrica. Che \(i\) attenda a \(j\) non implica quindi che \(j\) attenda a \(i\), ed è da questa asimmetria che viene la capacità di rappresentare relazioni orientate come «chi è il soggetto di», invece della sola somiglianza. La stessa matrice ha rango al più \(d_k\), perché è il prodotto di due fattori con \(d_k\) colonne: ogni testa confronta le posizioni in un sottospazio di dimensione \(d_k\), e non nell’intero \(\mathbb{R}^{d_{\text{model}}}\). Le varianti che legano le due proiezioni rinunciano a quella libertà nei punteggi (la matrice \(\mathbf{X}\mathbf{W}\mathbf{W}^\top\mathbf{X}^\top\) diventa simmetrica, anche se la softmax per riga lascia asimmetrici i pesi), e quanto costi dipende dal compito: il Reformer, nel confronto coi modelli precedenti, non trova perdite sui due compiti su cui la prova, e varianti simmetriche più recenti riportano su BERT risultati pari o migliori con meno parametri [COHR24].

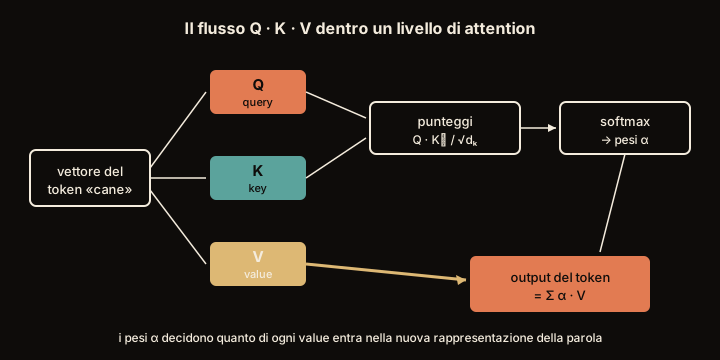
Fig. 16.1 I tre ruoli di ogni parola. La Query è la domanda che pone, la Key l’etichetta con cui si fa trovare, il Value ciò che offre a chi la seleziona: la stessa parola li ricopre tutti e tre insieme.#
La matrice dei punteggi, elemento per elemento#
Rispetto all’attenzione della sezione sulla traduzione con le reti cambia il modo di calcolare il punteggio: non lo dà più una piccola rete addestrata insieme al resto, lo dà un prodotto scalare. Presa la riga \(i\) di \(\mathbf{Q}\) e la riga \(j\) di \(\mathbf{K}\), l’elemento di posto \((i, j)\) della matrice dei punteggi è
cioè si moltiplicano le coordinate corrispondenti e si sommano i risultati. Con due vettori di tre numeri, \((2, 0, 1)\) contro \((3, 1, 0)\) dà \(2\cdot3 + 0\cdot1 + 1\cdot0 = 6\), mentre contro \((0, 4, 0)\) dà \(0\). Il punteggio viene grande quando i due vettori hanno valori grandi e dello stesso segno negli stessi posti, e piccolo, o negativo, quando non si allineano. È l’operazione che la sezione sull’algebra lineare chiama prodotto scalare, ed è l’unico confronto fra una query e una chiave che il meccanismo esegue. Il prodotto fra matrici \(\mathbf{Q}\mathbf{K}^\top\) li calcola tutti in un colpo solo: ogni riga corrisponde a una posizione di query, ogni colonna a una posizione di chiave.
Un punteggio grezzo non è una probabilità: può essere negativo, e la sua grandezza dipende dalla scala e dalla dimensione dei vettori, cioè da due cose che con la frase non c’entrano niente. Inoltre, è comodo chiamarlo «somiglianza», ma la parola promette più di quanto ci sia: l’addestramento sceglie le proiezioni perché il punteggio serva al compito, e il compito può chiedere che due parole diversissime vadano d’accordo.
Perché si divide per la radice di \(d_k\)#
I punteggi diventano pesi attraverso la softmax, la funzione della sezione sulle funzioni di attivazione che trasforma una fila di numeri qualsiasi in numeri positivi che sommano a uno. Prima di passarli alla softmax, il Transformer li divide tutti per \(\sqrt{d_k}\), la radice quadrata della dimensione di query e chiavi, cioè di quanti numeri ha ciascuno dei due vettori. Il fattore ha una giustificazione precisa, e guardarla da vicino dice anche che cosa quel fattore non promette.
Un punteggio nasce come somma di tanti pezzetti, uno per ogni numero delle due liste. I pezzetti sono un po’ positivi e un po’ negativi e in buona parte si compensano fra loro, quindi la somma non cresce in proporzione a quanti sono: cresce come la loro radice quadrata. Liste quattro volte più lunghe, punteggi grandi il doppio. Dividere per quella radice riporta i punteggi alla taglia che avevano con le liste corte, e il conto torna qualunque lunghezza si scelga.
Il guaio da cui questo difende si vede meglio sapendo che cosa succede a un evidenziatore quando i punteggi diventano enormi: il più alto si prende tutto il colore e agli altri resta zero. L’evidenziatore smette di sfumare e diventa un interruttore, acceso su una parola e spento su tutte le altre. E un interruttore non si corregge. Se qualcuno ti dice che avresti dovuto colorare «gatto» un pochino meno, con l’evidenziatore sai che cosa fare; con l’interruttore non c’è nessun «un pochino», e il consiglio non ti serve a niente. Siccome imparare, per una rete, è esattamente ricevere consigli di quel genere e seguirli un pochino per volta, un modello saturo smette di imparare in quel punto.
Una riserva importante: il conto sulla radice vale finché i numeri delle liste sono presi alla rinfusa, cioè all’inizio, quando la rete non ha ancora imparato niente. Dopo un po’ di addestramento le liste smettono di essere alla rinfusa e la radice non descrive più bene la loro taglia. Questo significa anche che quella divisione non è una promessa che l’interruttore non scatti. Con numeri abbastanza grandi scatta lo stesso, a qualunque lunghezza delle liste; quello che la divisione toglie è che scatti per colpa della lunghezza. E si divide tutto per lo stesso numero, senza guardare quanto sia grande ciascun punteggio: le proporzioni fra le caselle di una riga restano quelle di prima, cambia solo quanto sono distanti.
La scala si applica ai punteggi grezzi prima della softmax:
L’analisi dimensionale dice subito che il fattore è ammissibile: \(z_{ij}\) è uno scalare, \(\sqrt{d_k}\) è un numero puro, e la softmax vuole in ingresso degli scalari; la divisione cambia la scala dei logit e non il tipo dell’oggetto. Resta da capire perché quel numero.
Supponiamo che le componenti \(q_c\) e \(k_c\) siano a media nulla, varianza unitaria, indipendenti fra loro e indipendenti al variare di \(c\). Allora ogni addendo del prodotto scalare ha varianza \(\mathbb{E}[q_c^2 k_c^2] - (\mathbb{E}[q_c]\,\mathbb{E}[k_c])^2 = \mathbb{E}[q_c^2]\,\mathbb{E}[k_c^2] = 1\), dove la fattorizzazione dell’aspettazione usa l’indipendenza fra \(q_c\) e \(k_c\); e siccome gli addendi sono scorrelati al variare di \(c\), le varianze si sommano:
Dividere per \(\sqrt{d_k}\) la riporta a 1. Servono dunque due indipendenze diverse, una per ciascun passaggio, e una terza ipotesi che di solito non si dice: tutto questo vale all’inizializzazione, perché appena \(\mathbf{W}^Q\) e \(\mathbf{W}^K\) cominciano ad allenarsi smettono di produrre componenti a varianza unitaria. Sono ipotesi di illustrazione, non una descrizione di che cosa faccia un modello addestrato, e l’articolo del 2017 le presenta così [VSP+17].
Che cosa il fattore evita, allora. Con logit di grande modulo la softmax entra in regime saturo: un peso vicino a 1 e gli altri vicini a 0. Lì lo jacobiano della softmax, \(\partial a_i / \partial \tilde{z}_j = a_i(\delta_{ij} - a_j)\), ha tutti i termini che tendono a zero, quindi il gradiente che arriva ai punteggi svanisce, e con esso quello che arriva a \(\mathbf{W}^Q\) e \(\mathbf{W}^K\). Il fattore non impedisce la saturazione: con componenti di varianza diversa da 1 la softmax satura lo stesso, a qualunque dimensione. Ne toglie la dipendenza da \(d_k\), cioè permette di allargare le teste senza che il regime cambi per quel solo motivo. E una precisazione che evita una confusione frequente: quel fattore non normalizza \(\mathbf{Q}\) e \(\mathbf{K}\) a vettori unitari, che sarebbe un’altra operazione e cambierebbe i punteggi in modo diverso da riga a riga.
Le maschere: quali collegamenti sono permessi#
C’è un passaggio in mezzo che finora si è dato per scontato. Prima della softmax si può sommare alla matrice dei punteggi una maschera, cioè una matrice della stessa forma che vale \(0\) dove il collegamento è lecito e \(-\infty\) dove è vietato. Che la somma avvenga prima della softmax, e non dopo, fa parte della definizione: le due scelte danno risultati diversi.
Il regolamento si scrive sul tabellone prima di cominciare a colorare, e su certe caselle mette una croce: quella parola lì, per questa domanda, non si può guardare. Il modo di scriverlo è brutale e funziona benissimo: alla casella vietata si dà un punteggio di meno infinito, cioè così basso che nessun altro può scendere sotto. Quando poi si distribuisce il colore, a quella casella ne tocca esattamente zero.
I divieti che si incontrano si assomigliano poco. C’è quello di guardare avanti: chi scrive una parola alla volta non può sbirciare le parole che non ha ancora scritto, e tutto il triangolo sopra la diagonale del tabellone è crociato. C’è quello di guardare il riempitivo: per elaborare insieme frasi di lunghezza diversa le si allunga tutte con parole finte fino alla più lunga, e quelle parole finte non devono contare niente. E c’è quello di guardare lontano, che serve a risparmiare: ogni parola può guardare soltanto le vicine entro una certa distanza, e sul tabellone resta aperta solo una striscia attorno alla diagonale.
Cancellare a colorazione finita sembra equivalente a mettere le croci prima, ed è l’errore che si fa più spesso. Se distribuisci l’unità di colore su tutte le caselle e poi cancelli quelle vietate, quello che resta sulla riga non somma più a uno: somma a quel che è rimasto. Il miscuglio esce sbiadito in proporzione a quanto colore hai buttato via, e se le caselle vietate si erano prese quasi tutto, esce quasi bianco. La riga non se ne lamenta e il conto prosegue.
E sul primo divieto c’è una finezza che morde proprio dove il tabellone non è quadrato. «Non guardare avanti» si traduce in «cancella tutto quello che sta sopra la diagonale» solo se righe e colonne sono in corrispondenza uno a uno. Con una riga sola e cento colonne la diagonale non vuol dire niente, e bisogna dire da che parte le due liste sono allineate: quella riga è l’ultima parola, e le cento colonne sono tutto quello che c’è prima.
Sia \(\mathbf{M} \in \{0, -\infty\}^{L \times S}\) la maschera additiva. Allora
e poiché \(e^{-\infty} = 0\) le posizioni vietate ricevono probabilità nulla, mentre le altre restano normalizzate fra loro: la riga somma a 1 sulle sole posizioni permesse. Il decoder del Transformer originale realizza così il mascheramento autoregressivo, ponendo a \(-\infty\) i collegamenti illeciti prima della softmax [VSP+17].
Le maschere non si esauriscono nella causalità. Una maschera di padding impedisce di attendere ai token di riempimento con cui si allineano le sequenze di un batch; una maschera strutturata limita la connettività a finestre locali o a blocchi, ed è la famiglia che la sezione sul confronto coi modelli precedenti percorre. L’API corrente di PyTorch accetta maschere booleane o additive in virgola mobile, e tratta a parte la modalità causale.
Perché mascherare dopo sia un errore si vede in una riga di algebra. Azzerare
\(a_j\) dopo la softmax lascia \(\sum_j a_j = 1 - \sum_{j \in \mathcal{F}} a_j\),
con \(\mathcal{F}\) l’insieme vietato: l’uscita \(\sum_j a_j \mathbf{v}_j\) è
allora un multiplo arbitrario, e minore di uno, della media pesata voluta.
Rinormalizzare a valle recupera i valori giusti finché i conti restano in
precisione piena, perché la softmax ristretta a un sottoinsieme coincide con la
softmax dell’intero rinormalizzata; ma i logit vietati continuano a entrare nel
massimo e nella somma, e basta che uno sia abbastanza grande perché i termini
permessi vadano in underflow. A quel punto il denominatore è zero e la
rinormalizzazione produce nan.
Lo stesso nan arriva per un’altra strada anche con la maschera al posto
giusto: una riga in cui tutte le posizioni sono vietate (per esempio la prima
posizione di riempimento quando il padding sta a sinistra e la maschera è
causale) ha denominatore \(\sum_j e^{-\infty} = 0\). La softmax scritta a mano
restituisce nan, che può propagarsi nel passo all’indietro; le
implementazioni di libreria trattano il caso a parte, e nelle versioni recenti
di PyTorch scaled_dot_product_attention su quella riga restituisce zeri (non
da sempre, e non su ogni backend), quindi un confronto fra la versione a mano
e quella di libreria diverge proprio lì.
Resta la finezza dell’allineamento, che il caso quadrato nasconde. Con
\(L \neq S\) l’espressione «triangolare inferiore» è ambigua finché non si
dichiara quale colonna corrisponde a quale riga, e le convenzioni possibili
sono due. La decodifica con la cache vuole quella allineata a destra:
l’ultima riga di query vede tutte le \(S\) colonne, e la riga \(i\) vede le prime
\(S - L + i\). PyTorch le distingue per nome, LOWER_RIGHT e UPPER_LEFT, e il
suo is_causal=True prende la seconda: con una riga di query e \(S\) chiavi
quella riga vede la sola posizione iniziale, cioè il contrario di quello che
serve a generare. Costruire un triangolo \(L \times S\), o accendere una comodità
dell’API, senza guardare quale delle due si sta prendendo è uno dei modi più
efficaci di far attendere un modello al proprio futuro.
La softmax, riga per riga, e la miscela dei valori#
Restano gli ultimi due passaggi, quelli che trasformano la matrice dei punteggi in una rappresentazione nuova: la softmax, riga per riga, e la media dei valori.
Ogni riga del tabellone viene guardata da sola, e da sola diventa una distribuzione di colore. La ricetta che la produce si chiama softmax, ed è una divisione con un passaggio in più: si prende il numero \(e = 2{,}718\ldots\), lo si eleva a ciascun punteggio della riga, e si divide ciascun risultato per la somma di tutti quelli della stessa riga. Su tre punteggi \(2\), \(1\) e \(-1\): \(e^2 = 7{,}39\), \(e^1 = 2{,}72\), \(e^{-1} = 0{,}37\), che sommati fanno \(10{,}48\); le tre intensità sono allora \(0{,}71\), \(0{,}26\) e \(0{,}04\), che sommano a uno a meno degli arrotondamenti. L’elevamento a potenza serve a due cose: non far uscire mai numeri negativi (una parola non può contribuire in negativo) e allargare le differenze, così che un punto di vantaggio si veda davvero.
Che il conto si faccia per riga e non per colonna cambia il gioco, e si vede provando a immaginarlo al contrario. Per riga, ogni parola che fa una domanda si divide una sua unità di colore fra le parole che può guardare, e le domande non si tolgono niente a vicenda. Per colonna sarebbe l’inverso: ogni parola avrebbe un’unità di attenzione ricevuta da spartire fra chi la cerca, e allora due domande che vogliono la stessa parola dovrebbero contendersela. È un’operazione che si può definire, e descrive un’altra cosa.
Il gesto finale è la miscela vera e propria. Le intensità dicono quanto, e quello che si mescola è l’informazione che ogni parola consegna: prendi il 52% della lista di «gatto», il 24% di quella di «muro», e somma. Quello che ne esce è fatto della stessa stoffa delle informazioni consegnate, non dei punteggi: i punteggi hanno deciso le proporzioni e sono spariti. Da qui un limite importante: nessun dosaggio può tirare fuori qualcosa che nelle informazioni non c’era, e si mescola soltanto quello che c’è. È l’unico punto di tutta la faccenda in cui l’informazione si sposta davvero da una parola all’altra; tutto il resto serve a decidere quanta.
La softmax si applica lungo la dimensione delle chiavi, per ogni riga di query:
dove \(\tilde{z}_{ij} = \mathbf{q}_i^\top \mathbf{k}_j/\sqrt{d_k}\) è il punteggio scalato e \(M_{ij}\) la maschera. Ogni riga di \(\mathbf{A}\) è quindi una distribuzione di probabilità sulle posizioni di chiave permesse per quella query, e le sue entrate si trovano scritte anche \(\alpha_{ij}\), che è la forma usata in Fig. 16.1 e nella letteratura a partire da Bahdanau. Una softmax lungo le colonne normalizzerebbe fra query invece che fra chiavi, definendo un’operazione diversa: le righe non sommerebbero più a 1 e l’uscita non sarebbe una media pesata.
L’aggregazione è il prodotto per i valori:
Questo prodotto è facile da trascurare, e porta con sé una proprietà da enunciare per esteso: \(\mathbf{o}_i\) vive nello spazio dei valori, mai in quello dei punteggi, ed essendo una combinazione convessa dei \(\mathbf{v}_j\) sta nel loro inviluppo convesso. Una singola testa non può fabbricare direzioni che i valori non contengono già; quello che può fare è sceglierne il mescolamento in funzione del contenuto, e cambiarlo a ogni posizione. Con più teste, che arrivano fra poco, la proprietà vale per ciascuna: l’uscita di ogni testa è una media convessa dei propri valori, con pesi propri, e la proiezione \(\mathbf{W}^O\) che le ricompone è lineare, quindi l’uscita dello strato resta nel sottospazio generato dai valori di tutte le teste, proiettati. Le teste aggiungono un mescolamento diverso per ogni sottospazio. Dati i coefficienti, la combinazione dei valori è lineare: la non-linearità viene da come i coefficienti dipendono dall’ingresso, e dal fatto che li si moltiplica per valori che dall’ingresso dipendono anche loro.
Il costo sta nei due prodotti fra matrici: \(\mathbf{Q}\mathbf{K}^\top\) richiede \(L\,S\,d_k\) moltiplicazioni, ciascuna con la sua somma, e \(\mathbf{A}\mathbf{V}\) altre \(L\,S\,d_v\); un’implementazione diretta tiene poi in memoria l’intera matrice dei punteggi, \(L \times S\) numeri. Con \(L = S = n\) il tempo cresce come \(n^2 d_k\) per testa, cioè \(O(n^2 d_{\text{model}})\) sommando le teste, e la memoria come \(n^2\): sono i costi che il confronto coi modelli precedenti mette accanto a quelli delle reti ricorrenti.
I pesi \(\mathbf{A}\) restano una quantità intermedia. Scambiarli per l’uscita dello strato è un errore ricorrente, e la sezione sull’attenzione in pratica lo riprende insieme agli altri della stessa famiglia.
L’attenzione con i numeri: tre token a mano#
Messi in fila, i passaggi visti fin qui si scrivono in una formula sola, che l’articolo del 2017 chiama scaled dot-product attention:
con la softmax applicata riga per riga: punteggi, scala, maschera, softmax, media dei valori. Su una frase di tre token la si rifà a mano. I vettori hanno due soli numeri ciascuno (\(d_k = d_v = 2\)), e la maschera è quella che vieta di guardare avanti, detta causale: ogni token vede sé stesso e quelli prima. I token sono «il», «gatto», «salta»; query e chiavi sono scelte in modo che «salta» cerchi sull’asse su cui «gatto» si fa trovare.
import torch

Q = torch.tensor([[0., 1.],      # il
                  [0., 1.],      # gatto
                  [2., 0.]])     # salta: cerca sul primo asse
K = torch.tensor([[1., 0.],      # il
                  [2., 0.],      # gatto: si fa trovare sul primo asse
                  [0., 1.]])     # salta
V = torch.tensor([[1., 0.],      # l'informazione che ciascuna consegna
                  [0., 2.],
                  [1., 1.]])
d_k = Q.shape[1]

punteggi = Q @ K.T                                  # 1) la matrice L x S
scalati = punteggi / d_k**0.5                       # 2) la scala
vietato = torch.triu(torch.ones(3, 3, dtype=torch.bool), diagonal=1)
mascherati = scalati.masked_fill(vietato, float("-inf"))   # 3) la maschera
pesi = torch.softmax(mascherati, dim=-1)            # 4) softmax per riga
uscita = pesi @ V                                   # 5) la miscela

print("punteggi grezzi\n", punteggi)
print("dopo la scala\n", scalati.round(decimals=4))
print("pesi\n", pesi.round(decimals=4))
print("somme di riga", pesi.sum(dim=-1))
print("uscita\n", uscita.round(decimals=4))
punteggi grezzi
 tensor([[0., 0., 1.],
        [0., 0., 1.],
        [2., 4., 0.]])
dopo la scala
 tensor([[0.0000, 0.0000, 0.7071],
        [0.0000, 0.0000, 0.7071],
        [1.4142, 2.8284, 0.0000]])
pesi
 tensor([[1.0000, 0.0000, 0.0000],
        [0.5000, 0.5000, 0.0000],
        [0.1867, 0.7679, 0.0454]])
somme di riga tensor([1., 1., 1.])
uscita
 tensor([[1.0000, 0.0000],
        [0.5000, 1.0000],
        [0.2321, 1.5812]])
Le tre righe si leggono una per una, e nessuna richiede la macchina. La prima posizione vede solo sé stessa: peso 1 su una colonna sola, e la sua uscita \((1{,}00;\ 0{,}00)\) è il suo stesso valore. La seconda ha davanti due punteggi uguali, quindi pesi \(\tfrac{1}{2}\) e \(\tfrac{1}{2}\), e la sua uscita è la media dei due valori, \(\tfrac{1}{2}(1;\ 0) + \tfrac{1}{2}(0;\ 2) = (0{,}50;\ 1{,}00)\). La terza è l’unica interessante. La query di «salta», \((2;\ 0)\), contro le chiavi di «il», \((1;\ 0)\), e di «gatto», \((2;\ 0)\), dà i punteggi \(2\) e \(4\), che dopo la scala diventano \(1{,}414\) e \(2{,}828\); la softmax li trasforma in \(0{,}19\) e \(0{,}77\), e il resto, cinque centesimi, va a «salta» su sé stessa. «Salta» dà a «gatto» più di tre quarti del peso, e la sua uscita \((0{,}23;\ 1{,}58)\) pende verso il valore di «gatto», che era \((0;\ 2)\).
I numeri mostrano un dettaglio invisibile nella formula: nell’uscita non c’è traccia dei punteggi, che hanno deciso i pesi e sono usciti di scena. La terza riga resta peraltro una miscela: «gatto» pesa molto senza esserne una copia, perché le altre due posizioni contribuiscono con la loro parte.
Gli stessi numeri mostrano i due errori descritti nelle sezioni sulla scala e sulle maschere. Togliendo la scala i punteggi restano \(2\) e \(4\) invece di \(1{,}414\) e \(2{,}828\), e il peso di «gatto» sale da \(0{,}77\) a \(0{,}87\); spostando la maschera dopo la softmax la riga smette di sommare a uno.
# senza la scala: la stessa riga, più concentrata
senza_scala = torch.softmax(punteggi.masked_fill(vietato, float("-inf")), -1)
print("terza riga con la scala   ", pesi[2].round(decimals=4))
print("terza riga senza la scala ", senza_scala[2].round(decimals=4))

# la maschera dopo la softmax, su una riga con un punteggio vietato alto
riga = torch.tensor([[1., 2., 60.]])
fuori = torch.tensor([[False, False, True]])
prima = torch.softmax(riga.masked_fill(fuori, float("-inf")), dim=-1)
dopo = torch.softmax(riga, dim=-1).masked_fill(fuori, 0.)
print("maschera prima:", prima.round(decimals=4), "somma", float(prima.sum()))
print("maschera dopo: ", dopo.round(decimals=4), "somma", float(dopo.sum()))
print("dopo, rinormalizzata:", (dopo / dopo.sum()).round(decimals=4))

# lo stesso con il punteggio vietato a 200: i permessi vanno in underflow
riga_200 = torch.tensor([[1., 2., 200.]])
dopo_200 = torch.softmax(riga_200, dim=-1).masked_fill(fuori, 0.)
print("con 200, somma", float(dopo_200.sum()),
      "e rinormalizzata", dopo_200 / dopo_200.sum())
terza riga con la scala    tensor([0.1867, 0.7679, 0.0454])
terza riga senza la scala  tensor([0.1173, 0.8668, 0.0159])
maschera prima: tensor([[0.2689, 0.7311, 0.0000]]) somma 1.0
maschera dopo:  tensor([[0., 0., 0.]]) somma 8.850501050313119e-26
dopo, rinormalizzata: tensor([[0.2689, 0.7311, 0.0000]])
con 200, somma 0.0 e rinormalizzata tensor([[nan, nan, nan]])
La riga mascherata dopo la softmax somma a \(8{,}9 \cdot 10^{-26}\) invece che a
uno, e l’uscita che ne segue è di fatto azzerata. Rinormalizzarla recupera i
valori giusti, con questi numeri; ma il punteggio vietato continua a entrare nel
conto, e portandolo da \(60\) a \(200\) i termini permessi finiscono sotto il più
piccolo numero rappresentabile: la somma diventa esattamente zero, e la
rinormalizzazione restituisce nan (not a number, il valore con cui il
calcolatore segnala un conto senza risultato, qui zero diviso zero). Il divieto
scritto prima della softmax non ha nessuno di questi due problemi.
Auto-attenzione e attenzione incrociata#
La formula non chiede da nessuna parte che \(\mathbf{Q}\), \(\mathbf{K}\) e \(\mathbf{V}\) vengano dalla stessa sequenza, e da questa libertà nascono i due usi che si incontrano in ogni Transformer. Nella self-attention query, chiavi e valori vengono tutti dalla stessa sequenza: ogni parola pesa tutte le altre della propria frase, e anche sé stessa. Nella cross-attention le query vengono da una sequenza e chiavi e valori da un’altra: è il traduttore che, mentre scrive la frase italiana, torna a rileggere quella inglese, con le domande poste dalla frase in scrittura e le risposte prese da quella già letta.
query da |
chiavi e valori da |
collegamenti permessi |
|
|---|---|---|---|
self-attention |
la sequenza stessa |
la sequenza stessa |
tutte le posizioni |
cross-attention |
quella che si scrive |
quella letta |
tutte quelle lette |
self-attention causale |
la sequenza stessa |
la sequenza stessa |
sé stessa e quelle prima |
Due parole che il gergo confonde volentieri, e che la tabella tiene separate. «Self-attention» dice da dove vengono query, chiavi e valori; «causale» dice quali collegamenti sono permessi, cioè è una proprietà della maschera: ogni posizione vede soltanto sé stessa e quelle che la precedono, come chi scrive una parola alla volta. Una self-attention può essere bidirezionale (nell’encoder) oppure causale (nel decoder), e resta self-attention in tutti e due i casi. Chiamare causale ogni self-attention porta a cercare una maschera dove non c’è, e a non vederla dove c’è.
Multi-Head Attention: più letture in parallelo#
Con una sola attenzione, ogni posizione ha un solo insieme di pesi per riassumere tutti i tipi di relazione con le altre: chi compie l’azione, che cosa la qualifica, chi sta vicino a chi. Il Transformer ne esegue \(h\) in parallelo, ciascuna con le proprie proiezioni di query, chiavi e valori: è la multi-head attention, e ciascuna delle \(h\) attenzioni si chiama testa.
Sulla stessa frase lavorano più lettori, ognuno con un evidenziatore di colore diverso e una fissazione diversa: uno segna chi fa l’azione, un altro le parentele di significato («nero» e «gatto» vanno insieme perché uno è il colore dell’altro), un altro ancora chi sta vicino a chi nella frase. Ognuno si costruisce le sue tre versioni di ogni parola, la ricerca, l’etichetta e l’informazione da consegnare, con tabelle di numeri tutte sue: è da lì che nasce la differenza fra un lettore e l’altro, perché su tabelle diverse la stessa frase si evidenzia in modo diverso.
Ogni lettore consegna la sua versione arricchita della parola, e a questo punto di liste ce n’è una per lettore: otto, nel Transformer originale, invece di una. Come si torna a una sola? Il trucco è che ogni lettore lavora fin dall’inizio su liste corte, un ottavo di quelle intere: attaccandole una in coda all’altra si ottiene di nuovo una lista lunga quanto quella di partenza, perché otto ottavi fanno uno. Resta un ultimo passaggio, una tabella che la lunghezza non la cambia ma mescola fra loro i contributi degli otto, così che quello che ciascuno ha visto arrivi in tutte le caselle e non solo nel proprio ottavo. Alla fine il conto costa poco più di un lettore solo a lista piena: la differenza è quell’ultima tabella.
Ogni lettore si chiama, per ragioni che nessuno ricorda più, una testa di attenzione. Perché otto e non nove? Perché funzionava: è una scelta provata sul campo, non una legge di natura, e i modelli che sono venuti dopo usano numeri diversi.
Le fissazioni, poi, vengono fuori dall’addestramento come tutto il resto: nessuno assegna un compito a un lettore piuttosto che a un altro. Chi è andato a guardare dentro le teste di un modello già addestrato ne ha trovate alcune con un mestiere riconoscibile e altre senza niente di preciso, e la divisione dei compiti si vede solo in parte.
La Multi-Head Attention esegue \(h\) attenzioni indipendenti in sottospazi distinti e ne ricompone gli esiti:
dove \(\text{head}_i = \text{Attention}(\mathbf{X}\mathbf{W}_i^Q, \mathbf{X}\mathbf{W}_i^K, \mathbf{X}\mathbf{W}_i^V)\). L’argomento sono le rappresentazioni in ingresso, e non le \(\mathbf{Q}\), \(\mathbf{K}\), \(\mathbf{V}\) già proiettate di poco fa: quelle si proietterebbero due volte e le forme non tornerebbero. Nell’attenzione incrociata le query partono da un flusso e chiavi e valori dall’altro, cioè \(\text{head}_i = \text{Attention}(\mathbf{Y}\mathbf{W}_i^Q, \mathbf{X}\mathbf{W}_i^K, \mathbf{X}\mathbf{W}_i^V)\), e il resto non cambia. Le matrici apprese sono \(\mathbf{W}_i^Q, \mathbf{W}_i^K \in \mathbb{R}^{d_{\text{model}} \times d_k}\), \(\mathbf{W}_i^V \in \mathbb{R}^{d_{\text{model}} \times d_v}\) e \(\mathbf{W}^O \in \mathbb{R}^{h\,d_v \times d_{\text{model}}}\), che riporta l’uscita alla larghezza dell’ingresso qualunque sia \(d_v\). Nel Transformer originale \(h = 8\) e, con \(d_{\text{model}} = 512\), ogni testa lavora in dimensione \(d_k = d_v = d_{\text{model}}/h = 64\), così che la concatenazione sia già larga quanto l’ingresso: tenendo \(d_{\text{model}}\) fisso, aumentare il numero di teste non moltiplica per \(h\) il costo di un’attenzione a dimensione piena, perché ogni testa è più stretta. Il costo complessivo resta paragonabile a quello di una singola attenzione a dimensione piena, e anche i parametri non dipendono da \(h\): le proiezioni delle \(h\) teste ne hanno \(3\,h\,d_{\text{model}}\,d_k = 3\,d_{\text{model}}^2\), e \(\mathbf{W}^O\) altri \(d_{\text{model}}^2\), cioè \(4\,d_{\text{model}}^2\) in tutto. Il modello può dedicare teste diverse a relazioni diverse (sintattiche, semantiche, posizionali), e l’analisi delle teste addestrate lo conferma in parte: in BERT alcune hanno un ruolo riconoscibile, come seguire il complemento oggetto di un verbo o tornare a una menzione precedente della stessa entità [CKLM19], e nei modelli di traduzione poche teste portano la gran parte del lavoro, mentre molte altre si tolgono con perdite trascurabili [MLN19, VTM+19].
Su quest’ultimo punto la prudenza è d’obbligo, e riguarda il modo in cui si leggono le teste di un modello vero. Le semantiche delle teste sono emergenti: non c’è nessun vincolo che spinga una testa a corrispondere a un concetto pulito e nominabile, e trovarne alcune che lo fanno non autorizza a cercare un’etichetta per tutte.
L’attenzione, da sola, non ha ordine#
Nella formula dell’attenzione non compare mai la posizione dei token. Ogni riga di \(\mathbf{Q}\) viene confrontata con ogni riga di \(\mathbf{K}\) senza che nulla dica quale venga prima, e la proprietà ha un nome: la self-attention senza maschera è equivariante rispetto alle permutazioni, cioè rimescolare le parole in ingresso rimescola allo stesso modo le uscite, senza cambiarne i valori. Per l’attenzione, «Il gatto morde il cane» e «Il cane morde il gatto» sono lo stesso insieme di parole.
Si prendono le parole di «Il gatto morde il cane» e si rimescolano come carte, fino a «Il cane morde il gatto». Ogni parola si porta dietro le sue tre versioni, la domanda, l’etichetta e l’informazione, perché nascono dalla parola da sola, senza guardare dove sta. Sul tabellone righe e colonne cambiano di posto, ma i numeri nelle caselle restano quelli: «gatto» contro «morde» dà lo stesso punteggio in qualunque punto della fila stiano le due parole. Ogni riga si colora per conto suo, quindi anche il colore si sposta e basta, e ogni parola esce con lo stesso miscuglio di prima, soltanto in un altro posto della fila. «Gatto» esce identico che faccia il soggetto o il complemento: chi morde chi, l’attenzione da sola non lo vede.
C’è un’eccezione, ed è il divieto di guardare avanti. Se ogni parola può guardare soltanto sé stessa e quelle prima, la prima parola ne guarda una, la decima dieci, e da quante sono le parole che ha davanti una parola può ricavare a che punto della frase si trova. I modelli che scrivono una parola alla volta se ne accorgono da soli. Chi legge tutta la frase insieme non ha nemmeno questo appiglio.
La dimostrazione sta in una riga. Rimescolare le righe di \(\mathbf{X}\) con una matrice di permutazione \(\mathbf{P}\) rimescola allo stesso modo quelle di \(\mathbf{Q}\), \(\mathbf{K}\) e \(\mathbf{V}\), perché le proiezioni agiscono riga per riga; i punteggi diventano allora \(\mathbf{P}\tilde{\mathbf{Z}}\mathbf{P}^\top\), gli stessi numeri con righe e colonne rimescolate; la softmax lavora riga per riga e il rimescolamento la attraversa intatto, quindi i pesi diventano \(\mathbf{P}\mathbf{A}\mathbf{P}^\top\); e il prodotto finale lo riporta fuori tale e quale,
perché una matrice di permutazione è ortogonale e \(\mathbf{P}^\top\mathbf{P}\) è l’identità. Le righe dell’uscita si permutano come quelle dell’ingresso, e nient’altro cambia.
La maschera causale rompe la simmetria, e introduce con essa un segnale di posizione indiretto: la riga \(i\) fa la media su esattamente \(i\) vettori. Un modello causale addestrato senza nessuna codifica esplicita impara lo stesso dove si trova, con ogni probabilità proprio da quel conteggio [HRP+22], come ha già notato la matematica di un modello linguistico. Un encoder bidirezionale non ha nemmeno questo appiglio.
L’ordine va quindi reintrodotto da fuori, e il Transformer del 2017 lo fa sommando alle rappresentazioni un segnale che dipende dalla posizione, la codifica posizionale. La codifica non fa parte dell’attenzione: modifica le rappresentazioni, o l’interazione fra query e chiavi, in modo che l’attenzione possa usare la posizione, e anche nei modelli causali resta il modo diretto di dare l’ordine. Come la si calcolava nel 2017 e come la si calcola oggi (con una rotazione di query e chiavi, la RoPE, rotary position embedding) lo racconta la sezione sulla struttura del Transformer, che monta il blocco per intero.
Dove va a finire l’attenzione: encoder e decoder#
L’attenzione è un componente, e va montata dentro un blocco: la struttura che il Transformer ripete lungo tutta la rete, con la stessa forma e parametri propri a ogni ripetizione. L’encoder, la parte che legge, è una pila di blocchi che trasforma la frase d’ingresso in una sequenza di rappresentazioni, una per token; il decoder, la parte che scrive, è un’altra pila, con un passaggio in più in ogni blocco, che produce l’uscita (una traduzione, una risposta) un token alla volta. Il passaggio in più è la cross-attention di poco fa, con cui il decoder consulta le rappresentazioni dell’encoder.
Una pila di blocchi è una rete profonda, e lo è proprio in questo senso: tanti passaggi uno sopra l’altro, decine, e più di cento nei modelli più grandi. Impilarli, però, non è gratis, e ogni blocco porta con sé due accorgimenti che servono soltanto a rendere la pila addestrabile.
Una pila di blocchi è un palazzo, e ogni blocco è un piano, fatto come gli altri. A ogni piano ci sono due stanze: nella prima le parole si guardano fra loro con l’attenzione, nella seconda ognuna fa un lavoro a parte, per conto suo. La lista di numeri di ogni parola entra in una stanza, passa per i conti e ne esce cambiata. Accanto alle stanze corre un corrimano, dritto da cima a fondo: lungo il corrimano la stessa lista sale intatta, senza entrare da nessuna parte, e all’uscita di ogni stanza si somma numero per numero a quella che dalla stanza è uscita. La strada di lato è la scorciatoia.
Chi sale la usa per arrivare in alto senza sfilacciarsi per via. Serve però soprattutto a chi scende. Quando la rete scopre di aver sbagliato, dall’ultimo piano parte un messaggio che dice di quanto e in che direzione ritoccare i conti, e quel messaggio deve arrivare fino ai primi piani. Se passa per le stanze, a ogni piano viene moltiplicato per i numeri di quel piano, che di solito sono un po’ minori di uno. Nove decimi a ogni piano: dopo cinquanta piani ne resta lo \(0{,}5\%\), cioè quasi niente, e i piani bassi smettono di imparare. Lungo il corrimano il messaggio scende senza toccare i conti, e in fondo arriva ancora leggibile.
Il secondo accorgimento è una bilancia: la taratura. Piano dopo piano i numeri scappano via, qui tutti enormi, là tutti minuscoli, e una rete con addosso valori fuori misura non impara più. Allora la lista viene rimessa in riga: si sottrae a tutti la loro media, così il centro cade sullo zero, e poi si dividono tutti per quanto sono sparpagliati, così la larghezza è sempre quella. La bilancia non cambia che cosa si sta pesando: mette solo il numero letto sulla stessa scala di tutti gli altri. Dopo la pesata ogni numero viene moltiplicato per un fattore suo, imparato durante l’addestramento, con cui la rete riallarga o restringe la scala dove le conviene.
Nel palazzo del 2017 le bilance stanno sul corrimano, una subito dopo ogni punto in cui le due liste si sommano: chi scende ne attraversa una a ogni somma, cioè due volte per piano, una per stanza, e il corrimano non è sgombro fino in fondo. Lo si vedeva dall’addestramento, che partiva storto: bisognava cominciare con ritocchi piccolissimi, allargarli pian piano per qualche migliaio di passi e solo dopo tornare a stringerli, altrimenti la pila andava fuori giri alle prime correzioni. I modelli venuti dopo hanno portato le bilance all’ingresso delle stanze, il corrimano è tornato libero da cima a fondo, e quella partenza in punta di piedi si è potuta togliere.
La pesata, intanto, si è fatta più spiccia. Nei modelli linguistici di oggi la media non la si toglie nemmeno: si divide e basta per la grandezza tipica dei numeri della lista, e poi si moltiplica per i fattori imparati. Un conto in meno a ogni piano, e la pila sta ferma lo stesso.
Sono le residual connection e la layer normalization, combinate in
attorno a ogni sotto-strato (attenzione o feed-forward). La connessione residuale (la stessa idea delle ResNet che abbiamo visto fra le architetture storiche del deep learning) offre al gradiente un cammino quasi diretto verso gli strati iniziali, contrastando il gradiente che svanisce; la layer normalization [BKH16] standardizza ogni vettore sulle proprie coordinate, token per token e senza guardare il resto del batch:
dove \(d = d_{\text{model}}\), \(c\) corre sulle coordinate, \(\boldsymbol{\gamma}, \boldsymbol{\beta} \in \mathbb{R}^d\) sono guadagno e traslazione appresi ed \(\epsilon\) una costante piccola che evita la divisione per zero. Non usando statistiche del batch, si comporta allo stesso modo in addestramento e in inferenza e con sequenze di lunghezza qualsiasi, cosa che la batch normalization non garantisce; e rende l’addestramento meno sensibile a learning rate e inizializzazione.
Il cammino della connessione residua, però, è diretto solo in parte: in questa formulazione (detta Post-LN, quella del 2017) la normalizzazione sta proprio sul ramo della scorciatoia, e il gradiente la attraversa a ogni sotto-strato. I modelli successivi la spostano prima del sotto-strato, \(\mathbf{x} + \text{SubLayer}(\text{LayerNorm}(\mathbf{x}))\), il cosiddetto Pre-LN (che vuole una normalizzazione finale dopo l’ultimo blocco, e GPT-2 la aggiunge esplicitamente), ed è lì che il cammino identità diventa davvero pulito. Xiong e colleghi [XYH+20] spiegano con la teoria del campo medio perché lo spostamento conta: nel Post-LN, all’inizializzazione, i gradienti attesi dei parametri vicini all’uscita sono grandi, e con un learning rate alto l’addestramento diventa instabile; nel Pre-LN sono ben comportati. Per questo l’articolo del 2017 aveva bisogno di un riscaldamento del learning rate, che al passo \(s\) vale
cioè sale linearmente per i primi 4000 passi e poi decresce come \(s^{-1/2}\) [VSP+17]; con il Pre-LN il riscaldamento si può togliere.
Nei modelli linguistici recenti anche la normalizzazione stessa si è alleggerita: al posto della LayerNorm c’è quasi sempre la RMSNorm [ZS19], che non sottrae la media e non ha bias. Divide il vettore per la sua radice quadratica media e lo riscala con un guadagno appreso, \(\mathbf{x} \mapsto \boldsymbol{\gamma} \odot \mathbf{x}/\mathrm{RMS}(\mathbf{x})\) con \(\mathrm{RMS}(\mathbf{x}) = \sqrt{\tfrac{1}{d}\sum_c x_c^2 + \epsilon}\): meno conti per strato, e in pratica la stessa stabilità.
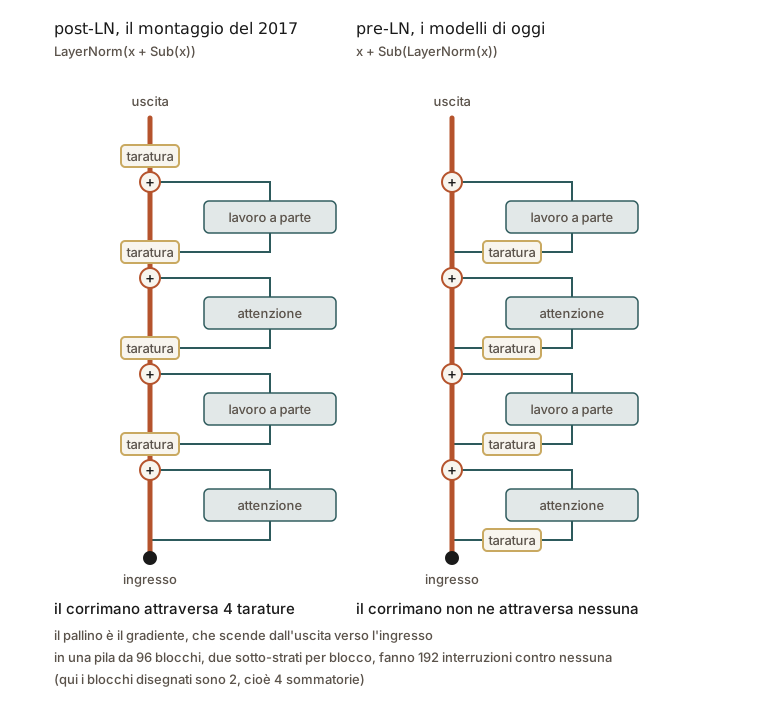
Fig. 16.2 Gli stessi tre pezzi, montati in due modi. A sinistra la taratura sta sulla scorciatoia, e il gradiente che scende la attraversa a ogni somma: quattro volte nei due blocchi disegnati, centonovantadue in una pila da novantasei. A destra è stata spostata all’ingresso dei sotto-strati, e la scorciatoia corre intera dall’alto in basso.#
Connessione residua e normalizzazione sono ciò che rende possibile impilare l’attenzione: nei modelli grandi di oggi i blocchi vanno da sessanta a più di cento, e senza questi due accorgimenti, montati come in Fig. 16.2, una pila così profonda non si addestra. Con il meccanismo in mano, la sezione sulla struttura del Transformer prende questi pezzi e li monta nelle due pile di una macchina vera.
Un cantiere parallelo: le reti a memoria
Interrogare un archivio con una domanda, pesare quanto ciascun elemento le risponde, e restituire la media pesata di ciò che quegli elementi contengono: questa struttura è stata costruita prima dei Transformer, e per un altro scopo.
Nel 2014 le memory network [WCB14] affrontavano il problema di far ragionare una rete su un elenco di fatti, con storie costruite apposta perché un fatto solo non basti. In una versione accorciata: «Giovanni è andato in ufficio. Giovanni ha posato il latte. Giovanni è andato in bagno. Dov’è il latte?», dove per rispondere «in ufficio» servono i primi due fatti, e nessuno dei due basta da solo. La rete teneva i fatti in un archivio a parte, separato dai parametri appresi, e ci pescava due volte di fila, la seconda con in mano il fatto trovato la prima: sono gli hop, i passi di lettura. In quella prima versione però la pesca era secca (si sceglieva un fatto, il più somigliante), e per addestrarla bisognava indicare alla rete, esempio per esempio, quali fossero i fatti giusti.
Il passo che ci interessa arriva l’anno dopo, con le end-to-end memory network [SSWF15]: al posto della scelta secca c’è una softmax. La domanda viene confrontata con tutti i fatti, i punteggi diventano pesi, e l’archivio si legge come media dei fatti pesata da quei pesi. Gli hop restano; ora però ogni fatto contribuisce, il gradiente attraversa anche la lettura dell’archivio, e la rete impara da sola quali fatti usare.
Quella lettura pesata è l’attenzione, con l’archivio al posto della frase. Le due strade sono partite quasi insieme: l’attenzione per la traduzione è del settembre 2014, le memory network dell’ottobre, e la seconda cita la prima fra i lavori affini, non fra le proprie basi; la versione end-to-end, del marzo 2015, si presenta invece come un’estensione del modello di Bahdanau, con più passi di lettura per ogni parola prodotta. Quello che le reti a memoria hanno di proprio è dunque l’archivio tenuto fuori dai parametri e consultato al momento della domanda: la stessa separazione ricompare, cinque anni dopo, nei sistemi che cercano documenti prima di rispondere, i RAG della sezione sul retrieval.
Da ricordare
L’attenzione rilegge la frase con un evidenziatore: per capire una parola, dà a tutte le altre un’intensità di colore e ne mescola le informazioni in quella proporzione. L’evidenziatore decide quanto; quello che si mescola è l’informazione, e la rete tiene le due cose separate.
Le intensità le ricalcola ogni frase: la rete impara, su miliardi di esempi, soltanto il criterio con cui il colore va assegnato.
Ogni parola si presenta in tre versioni: la query (la domanda che fa), la key (l’etichetta con cui si fa trovare) e il value (l’informazione che consegna), e le tre versioni cambiano da un piano all’altro del modello.
Se le parole guardano la propria frase è self-attention; se la frase che si sta scrivendo guarda quella già letta, come in un traduttore, è cross-attention.
Il tabellone dei punteggi non è per forza quadrato: nella traduzione, e quando il modello scrive una parola alla volta, chi chiede e chi risponde sono due liste di lunghezza diversa.
I divieti (non guardare avanti, non guardare il riempitivo) si scrivono prima di distribuire il colore; colorare e poi cancellare lascia una riga che non somma più a uno, e un miscuglio sbiadito.
I punteggi si dividono per la radice della lunghezza delle liste, perché con liste lunghe l’evidenziatore non diventi un interruttore, che non si corregge un pochino per volta. Con numeri abbastanza grandi, però, l’interruttore scatta comunque.
Più evidenziatori lavorano in parallelo, ognuno attento a un tipo di legame: sono le teste di attenzione, otto nel Transformer del 2017.
L’attenzione da sola non sa che cosa viene prima e che cosa dopo: l’ordine glielo si aggiunge da fuori.
Attorno a ogni blocco ci sono una scorciatoia, che lascia passare l’informazione intatta e riporta indietro la correzione degli errori, e una taratura, che rimette i numeri su una scala standard. Senza, i palazzi alti non si addestrano; e conta dove sta la taratura: nel 2017 stava sul corrimano, i modelli venuti dopo l’hanno spostata all’ingresso delle stanze.
Da ricordare
L’attenzione costruisce, per ogni posizione di query, una rappresentazione contestuale: \(\operatorname{softmax}(\mathbf{Q}\mathbf{K}^\top/\sqrt{d_k} + \mathbf{M})\,\mathbf{V}\), cioè media dei valori pesata dalle affinità query-chiave. La chiave decide il peso, il valore fornisce il contenuto, e l’uscita di ogni testa resta nell’inviluppo convesso dei suoi valori.
Le forme: \(\mathbf{Q} \in \mathbb{R}^{L \times d_k}\), \(\mathbf{K} \in \mathbb{R}^{S \times d_k}\), \(\mathbf{V} \in \mathbb{R}^{S \times d_v}\), punteggi e pesi \(L \times S\), uscita \(L \times d_v\). \(L = S\) vale nella self-attention su una sequenza intera e non oltre: assumere una matrice quadrata rompe l’attenzione incrociata e la decodifica con la cache.
\(\mathbf{Q}\), \(\mathbf{K}\) e \(\mathbf{V}\) sono viste apprese (\(\mathbf{X}\mathbf{W}^Q\) e le altre due), diverse per strato e per testa, non ruoli semantici fissi. Poiché \(\mathbf{W}^Q\mathbf{W}^{K\top}\) in generale non è simmetrica, l’attenzione può rappresentare relazioni orientate.
Il fattore \(1/\sqrt{d_k}\) neutralizza la dipendenza da \(d_k\) della varianza dei punteggi, sotto l’ipotesi di componenti indipendenti a media nulla e varianza unitaria, che vale all’inizializzazione. Non impedisce la saturazione della softmax: ne toglie una causa.
La maschera si somma ai punteggi prima della softmax, con \(-\infty\) sulle posizioni vietate. Azzerare i pesi dopo lascia righe che non sommano a 1; e con \(L \neq S\) la causalità richiede una convenzione di allineamento esplicita.
La softmax normalizza lungo le chiavi, per riga: ogni query produce la propria distribuzione. I pesi \(\mathbf{A}\) sono un intermedio, non l’uscita dello strato.
La Multi-Head Attention esegue più attenzioni in sottospazi distinti (\(h = 8\) nel modello originale) e ricompone con \(\mathbf{W}^O\); le semantiche delle teste sono emergenti e non garantite.
La self-attention senza maschera è equivariante alle permutazioni: la posizione va aggiunta da fuori. La maschera causale ne dà un segnale indiretto (la riga \(i\) media su \(i\) vettori), da cui un modello causale riesce comunque a ricavarsi dove si trova.
Residual connection e layer normalization tengono addestrabili le pile profonde di blocchi. L’articolo del 2017 le combina come \(\text{LayerNorm}(\mathbf{x} + \text{SubLayer}(\mathbf{x}))\) (Post-LN); i modelli successivi normalizzano prima del sotto-strato, \(\mathbf{x} + \text{SubLayer}(\text{LayerNorm}(\mathbf{x}))\) (Pre-LN), ed è così che la scorciatoia resta davvero libera.
Il meccanismo è completo: cinque passaggi che si rifanno a mano su tre parole, e una manciata di scelte che spiegano perché la formula ha proprio quella forma. Manca la macchina che gli sta attorno: l’architettura a due pile in cui il blocco viene impilato e il confronto strutturale con le reti che leggevano in fila.