


Tensori e autograd#
Dentro PyTorch ogni cosa è un tensore: l’immagine da classificare, la frase tradotta in numeri, e ognuno dei numeri che la rete si tiene dentro e che impara col tempo, i suoi pesi. Accanto ai tensori vive il secondo protagonista, più discreto ma decisivo: autograd, il meccanismo che registra le operazioni mentre vengono eseguite e ne calcola le derivate, cioè quello che permette a una rete di imparare.
Che cos’è un tensore#
Scalari, vettori e matrici li abbiamo già incontrati nella sezione di algebra lineare: un numero solo, una fila di numeri, una tabella di numeri. Il tensore è semplicemente il passo successivo, la stessa idea portata avanti finché si vuole: si continua ad aggiungere direzioni lungo cui i numeri si dispongono, e ciascuna di quelle direzioni si chiama asse. La parola qui fa un mestiere diverso da quello che faceva nei grafici: sull’asse di un grafico si legge un valore, lungo l’asse di un tensore si conta una posizione.

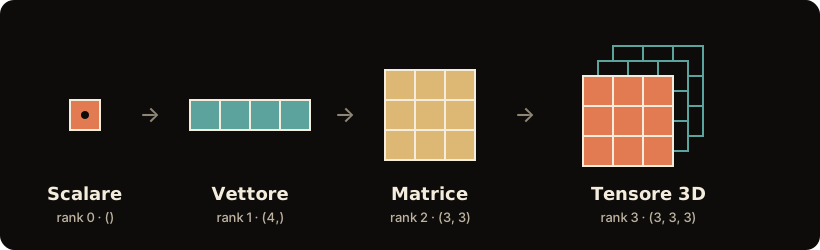
Fig. 7.2 La scala dei tensori. Ogni gradino aggiunge un asse: da un numero solo, a una fila, a una griglia, a una pila di griglie.#
Un tensore è un contenitore di numeri con un certo numero di «assi», cioè di coordinate da dare per pescare uno dei numeri che ci sono dentro (Fig. 7.2):
un numero solo (per esempio la temperatura, \(23{,}5\)) è un tensore a zero assi: uno scalare;
una fila di numeri (i voti di uno studente) è un tensore a un asse: un vettore;
una tabella di numeri (i pixel di una foto in scala di grigi) ha due assi: una matrice;
una pila di tabelle (una foto a colori: una griglia per il rosso, una per il verde, una per il blu) ha tre assi.
Gli assi si contano in un modo solo: sono le coordinate che devi dare per arrivare a un numero preciso. Per il voto di uno studente basta la posizione nella fila, una coordinata sola. Per un pixel della foto a colori ne servono tre: quale colore, quale riga, quale colonna. Per la temperatura nessuna, perché quel numero è già lì da solo.
Due parole per due cose, e conviene conoscerle in inglese perché così stanno
nei testi e nel codice: il numero di assi, che molti testi chiamano rank (in
PyTorch lo si legge con ndim), e le lunghezze lungo ciascun asse, che formano
la shape (la «forma», shape nel codice). Una foto a colori
\(256 \times 256\) è, in PyTorch, un tensore di shape \((3, 256, 256)\): rank 3, e
i tre colori vengono scritti per primi, prima delle due misure della griglia.
È una convenzione, non una legge di natura (altre librerie mettono i colori in
fondo), e conviene saperlo perché quando la forma non torna il primo sospetto è
averla invertita.
La scala non si ferma alla foto singola. Alle reti le immagini si danno a mazzetti, trentadue per volta (nel codice il mazzetto si chiama batch), e il mazzetto porta con sé il suo asse: la shape diventa \((32, 3, 256, 256)\), quattro coordinate per arrivare a un pixel (quale foto, quale colore, quale riga, quale colonna). È la forma con cui si lavora tutti i giorni. Una cosa sola resta uguale a ogni gradino della scala: dentro un tensore i numeri sono tutti dello stesso tipo, tutti interi o tutti con la virgola, e non si mescolano.
Formalmente un tensore di rank \(r\) è un array multidimensionale i cui elementi si indicizzano con \(r\) indici, \(T_{i_1 i_2 \dots i_r}\). Lo caratterizzano due attributi:
il rank (o numero di assi), \(r\), che in PyTorch si legge con
t.ndimot.dim()e che non va confuso con il rango di una matrice, cioè il numero delle sue righe linearmente indipendenti: una matrice \(3 \times 3\) ha rank 2 come tensore e può avere rango 1;la shape \((n_1, n_2, \dots, n_r)\), la dimensione lungo ciascun asse (
t.shape).
Scalare, vettore e matrice sono i casi \(r = 0, 1, 2\). Nel deep learning si
lavora costantemente con rank più alti: in PyTorch un batch di immagini RGB
è un tensore \((B, C, H, W)\) (esempi del batch, canali, altezza, larghezza;
la documentazione di PyTorch scrive \(N\) per il primo asse) quindi rank 4
(l’ordine channels-first, diverso dal \((B, H, W, C)\) di altre librerie). A
differenza dell’oggetto matematico «tensore» (che porta con sé
regole di trasformazione tra sistemi di coordinate), qui il termine indica
soltanto la struttura dati: un array \(n\)-dimensionale con un dtype omogeneo
(float32, int64, …).
Creare tensori e farci i conti#
Un tensore si può fabbricare in tre modi: scrivendo i numeri a mano in una
lista Python, chiedendo a PyTorch di riempirlo (zeros, ones, randn, fra un
attimo), oppure partendo da un array di NumPy, la libreria di calcolo
numerico della sezione su NumPy. Con
quest’ultima PyTorch va d’accordo così bene che, con torch.from_numpy, i due
si passano i dati senza nemmeno ricopiarli.
import numpy as np
import torch

s = torch.tensor(3.14)                     # scalare, rank 0
v = torch.tensor([1.0, 2.0, 3.0])          # vettore, rank 1
M = torch.tensor([[1., 2.], [3., 4.]])     # matrice, rank 2
A = torch.from_numpy(np.ones(3))           # da NumPy, senza copiare i dati

M.shape        # torch.Size([2, 2])
M.dtype        # torch.float32

torch.zeros(2, 3)        # matrice 2x3 di zeri
torch.ones(5)            # vettore di uno
torch.randn(3, 3)        # sorteggiati da una normale standard, N(0, 1)
torch.arange(0, 10, 2)   # da 0 a 10 di 2 in 2, 10 escluso: tensor([0, 2, 4, 6, 8])
Le ultime quattro righe fabbricano tensori pieni senza che si debba scrivere i
numeri a mano, e la terza, randn, serve davvero: una rete comincia la sua
vita con dei pesi sorteggiati, e randn li estrae da una normale standard
\(\mathcal{N}(0, 1)\), centrata sullo zero e con deviazione standard uno.
Sui tensori valgono le operazioni dell’algebra lineare che già conosciamo (somma, prodotto per scalare, prodotto fra matrici) e ogni riga viene eseguita nell’istante in cui la scrivi, esattamente come in NumPy:
a = torch.tensor([1., 2., 3.])
b = torch.tensor([10., 20., 30.])

a + b            # tensor([11., 22., 33.])
a * b            # prodotto elemento per elemento
a.sum()          # tensor(6.)  -> calcolato SUBITO
a @ b            # prodotto scalare: 1·10 + 2·20 + 3·30 = tensor(140.)
a.reshape(3, 1)  # nuova forma: gli stessi numeri in colonna, 3x1
I numeri escono già scritti, e così ogni passaggio si controlla come su una calcolatrice, senza «avviare» nulla.
Il simbolo @ è quello del prodotto fra matrici, e su due semplici file di
numeri come queste fa la cosa più elementare che quel prodotto sappia fare,
cioè moltiplicarle a due a due e sommare tutto
(\(1 \cdot 10 + 2 \cdot 20 + 3 \cdot 30 = 140\)); è il prodotto scalare, e
il conto è scritto per esteso nel commento apposta perché lo si possa rifare.
Il broadcasting, che conosciamo già da NumPy, funziona allo stesso modo. Se scrivi
a + 5, PyTorch capisce da solo che vuoi sommare \(5\) a ciascuno dei tre
numeri, come un insegnante che aggiunge lo stesso bonus a tutti i compiti della
classe senza riscrivere la regola una volta per studente: il risultato è
tensor([6., 7., 8.]). Vale anche fra due tensori, purché le forme si possano
affiancare: una tabella di tre righe per quattro colonne più una fila di quattro
numeri va bene, e la fila si ripete su ciascuna delle tre righe. L’appaiamento
si fa a partire dall’ultimo asse, quello delle colonne, e va all’indietro:
quindi alla stessa tabella una fila di tre numeri non si somma, anche se le
righe sono tre, perché le colonne sono quattro e la fila si affianca a quelle.
E sommare tre numeri con quattro, di nuovo, non si può: PyTorch si ferma con un
errore.
Resta la cosa che si vede meno e che spiega di più. I numeri di un tensore
stanno in fila uno dopo l’altro, come le lettere di un testo scritto su una
striscia di carta senza interruzioni; la forma è soltanto l’istruzione che dice
ogni quanto andare a capo. Cambiare forma allora non sposta nessun numero: si va
a capo in un altro punto, e la striscia resta quella di prima. Per questo
a.reshape(3, 1) è quasi gratis, e per questo un array di NumPy e un tensore di
PyTorch possono leggere la stessa striscia senza copiarsela, con l’avvertenza
che chi la cambia da una parte la cambia per tutti.
Per cambiare forma PyTorch ha due comandi, reshape e view, e la striscia
spiega perché. Ci sono riletture che dalla striscia non si ricavano. Prendi le
righe di quel testo una sì e una no: quelle scartate sono ancora lì, in mezzo
alle altre. Tagliare in due metà ciascuna riga rimasta si può, e rimettere
insieme le due metà pure, perché ogni riga è tutta attaccata; leggere il tutto
come un’unica riga continua no, perché fra un pezzo e il successivo c’è la roba
che hai saltato. Per il taglio basta dare la forma nuova, senza toccare niente;
per la riga continua i numeri vanno ricopiati altrove. reshape ricopia in
silenzio quando serve, view pretende di non ricopiare e, quando non può, si
ferma con un errore invece di farlo di nascosto. Di solito va bene reshape;
view si sceglie quando si vuole la certezza che la striscia sia la stessa, e
che cambiando un numero da una parte cambi anche dall’altra.
Fra NumPy e PyTorch il passaggio sulla CPU non copia: torch.from_numpy(arr)
e t.numpy() restituiscono un tensore e un array che condividono la stessa
memoria, quindi modificare l’uno modifica l’altro; torch.tensor(arr) invece
copia. t.numpy() vuole un tensore sulla CPU e fuori dal grafo di autograd,
quindi la forma completa è t.detach().cpu().numpy(), come nella sezione sui
tre errori più comuni. Le regole di broadcasting sono le
stesse di NumPy, gli assi si allineano da destra e le dimensioni compatibili
(uguali, o pari a 1) si espandono virtualmente: una matrice \((3, 4)\) più un
vettore \((4,)\) produce una \((3, 4)\). Il prodotto matriciale è @ (ovvero
torch.matmul), con la stessa semantica di NumPy anche sui vettori rank-1:
a @ b tra due vettori è direttamente il prodotto scalare, senza bisogno di
reshape. A proposito di reshape: restituisce una vista (stessa memoria,
solo un modo diverso di leggerla) quando la disposizione dei dati lo permette,
e altrimenti copia in silenzio; t.view(...) la vista la pretende, e solleva
un errore invece di copiare quando non può darla. La condizione non è la
contiguità, come si legge spesso: è che la nuova forma sia compatibile con gli
stride esistenti, cioè con i passi con cui si cammina lungo ciascun asse.
Spezzare o fondere assi già contigui fra loro riesce anche su un tensore non
contiguo: se x è \((8,4)\) e y = x[::2] (quindi \((4,4)\) con stride \((8,1)\),
non contigua), y.view(4, 2, 2) passa e condivide la memoria, mentre
y.view(16) solleva un errore.
x = torch.arange(32.).reshape(8, 4)   # contigua
y = x[::2]                            # una riga sì e una no
print(y.shape, y.stride(), y.is_contiguous())
print(y.view(4, 2, 2).data_ptr() == y.data_ptr())   # passa, stessa memoria
try:
    y.view(16)                        # fonde righe lontane in memoria
except RuntimeError as e:
    print(type(e).__name__)
print(y.reshape(16).data_ptr() == y.data_ptr())     # reshape ha copiato
torch.Size([4, 4]) (8, 1) False
True
RuntimeError
False
Il messaggio d’errore lo dice per esteso, e alla lettera suona così: view
size is not compatible with input tensor’s size and stride (at least one
dimension spans across two contiguous subspaces). Use .reshape(...)
instead. Molte operazioni esistono in variante in-place col suffisso
underscore (t.add_(1), t.zero_()): risparmiano memoria ma, come vedremo,
vanno evitate sui tensori tracciati da autograd.
Lo stesso codice su CPU e GPU#
Ogni tensore vive su un device. Di default è la CPU; spostarlo su una GPU
(se c’è) è una chiamata a .to(), e il resto del codice resta quello, a patto
che i tensori che lavorano insieme stiano sullo stesso dispositivo.
# se una scheda grafica c'è usa quella, altrimenti la CPU
device = "cuda" if torch.cuda.is_available() else "cpu"

M = torch.randn(1000, 1000)   # una matrice grande: un milione di numeri
M = M.to(device)              # trasloca dove dice `device`
prodotto = M @ M              # calcolato dove vive il tensore
print(prodotto.shape, prodotto.device)
# su una macchina senza scheda grafica: torch.Size([1000, 1000]) cpu
La prima riga è un modo compatto di scrivere una scelta, e si legge da
sinistra: prendi "cuda" se c’è una scheda utilizzabile, altrimenti
"cpu". È il gesto con cui comincia quasi ogni programma PyTorch, e da qui in
avanti lo ritroveremo identico. L’ultima riga stampa dove il risultato è
finito: su una macchina senza scheda grafica stampa cpu, confermando la scelta
della prima riga. Su un computer con una
scheda NVIDIA la stessa identica riga stamperebbe cuda:0.
La matrice è di mille per mille perché su matrici piccole la differenza fra i due dispositivi non si vede: il vantaggio della scheda grafica comincia quando i conti da fare sono tanti.
La regola è una sola: i conti avvengono dove stanno i numeri. Se il tensore è sulla CPU, calcola la CPU; se lo sposti sulla scheda grafica, calcola lei, e per le moltiplicazioni tra matrici grandi può essere decine o centinaia di volte più veloce, perché una GPU è nata per fare migliaia di piccoli conti in parallelo (in origine, i pixel dei videogiochi).
Due tensori lavorano insieme soltanto se stanno sullo stesso dispositivo, e se non ci stanno bisogna prima spostarne uno. Il trasloco si paga: il passaggio fra la memoria del computer e quella della scheda è stretto rispetto alla velocità con cui la scheda macina i conti, quindi chi porta i numeri avanti e indietro a ogni riga consuma nel viaggio più di quanto guadagni nel calcolo, come attraversare la cucina con una cassa per ogni singolo ingrediente. Ecco perché PyTorch i dati non li trasloca per conto suo e preferisce fermarsi con un errore: il viaggio devi deciderlo tu, e devi poterlo vedere scritto.
Il pattern idiomatico è definire device una volta all’inizio e spostare
modello e batch con .to(device); su Apple Silicon il device si chiama
"mps". Operazioni tra tensori su device diversi sollevano un errore esplicito
(nessun trasferimento implicito, che nasconderebbe costi: su una scheda
discreta il passaggio attraversa il bus PCIe ed è lento rispetto al calcolo,
mentre su Apple Silicon la memoria è unificata e il problema è un altro).
L’eccezione sono i tensori a zero assi che stanno sulla CPU: un numero solo,
lì, viene trattato come uno scalare e combinato in silenzio con un tensore che
sta altrove, mentre lo stesso numero dentro un tensore a un asse solleva un
errore. Il contrario non vale: uno scalare a zero assi che sta sulla scheda
grafica, sommato a un tensore sulla CPU, solleva un errore anche lui. Le stesse
moltiplicazioni tra matrici che scriviamo qui sono, sull’hardware, migliaia di
prodotti scalari eseguiti in parallelo dai kernel di cuBLAS (le convoluzioni
passano invece da cuDNN): è il motivo per cui le GPU (nate per la grafica) sono
diventate lo strumento del deep learning. Il codice resta lo stesso, a parte
gli spostamenti con .to(); cambiano la velocità e, di pochissimo, i numeri.
Le somme si fanno in un altro ordine, e sulle GPU NVIDIA da Ampere in poi le
convoluzioni usano di default il formato TF32, che arrotonda gli ingressi a
dieci bit di mantissa (torch.backends.cudnn.conv.fp32_precision vale
"tf32"): la documentazione di PyTorch avverte che fra CPU e GPU i risultati
possono non coincidere anche con lo stesso seme.
Autograd: la derivata calcolata da sola#
Addestrare una rete significa modificare i suoi parametri \(\theta\) (i pesi di cui si diceva in apertura) finché l’errore che commette, la loss \(\mathcal{L}(\theta)\), non diventa piccolo.
Per sapere in che verso modificare ciascun parametro serve il gradiente \(\nabla_\theta\mathcal{L}\), che raccoglie le derivate parziali \(\partial\mathcal{L}/\partial\theta_k\), una per parametro. È di nuovo una derivata, ma stavolta a spostarsi di poco è il parametro, non più il dato che entra: la \(k\)-esima dice che cosa succede alla loss se si alza appena il solo parametro \(\theta_k\), se sale o scende e di quanto. Chi vuole meno errore sposta ogni parametro dalla parte in cui la loss scende, cioè contro il segno della sua derivata. Calcolarle a mano per una rete con milioni di pesi è impensabile, e qui entra la differenziazione automatica (autodiff).

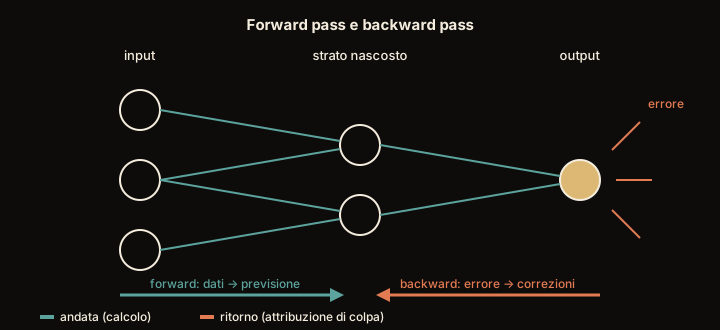
Fig. 7.3 I due sensi di marcia: all’andata i dati attraversano la rete e producono una previsione, al ritorno l’errore risale la stessa strada e diventa una correzione per ogni peso incontrato.#
Nella Fig. 7.3 c’è però una cosa che il disegno non può mostrare, e che spiega un comportamento di PyTorch altrimenti sorprendente: per poter tornare indietro, l’andata deve ricordare. Una rete è una composizione di strati, ognuno dei quali trasforma l’uscita del precedente, e il calcolo dall’ingresso all’uscita è la passata in avanti (forward pass).
Durante la passata in avanti autograd conserva i valori intermedi di ogni strato, le attivazioni, perché la passata all’indietro li rileggerà per calcolare le derivate. La memoria occupata durante l’andata cresce quindi con la profondità della rete e con il numero di esempi che la attraversano insieme.
Ecco come si accende tutto questo, sull’esempio più piccolo possibile: un solo
numero al posto di una rete, così si può controllare il risultato a mente. La
prima riga chiede a PyTorch di tenere d’occhio x; le due dopo fanno un conto
e chiedono la strada del ritorno.
x = torch.tensor(3.0, requires_grad=True)   # "osserva questo tensore"
                                            # il .0 serve: su un intero PyTorch
                                            # si rifiuta di tenere le derivate

y = x**2 + 2*x            # y = x² + 2x: il grafo si costruisce da solo
y.backward()              # passata all'indietro

x.grad                    # la derivata di y in x=3  ->  tensor(8.)
In quel conto x compare in due punti, una volta al quadrato e una volta
moltiplicata per due, e i due punti sono due strade separate che partono e
arrivano nello stesso posto: la Fig. 7.4 le percorre nei
due sensi.
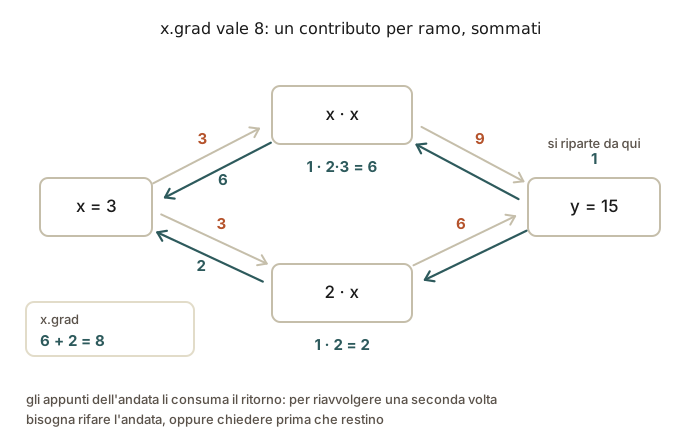
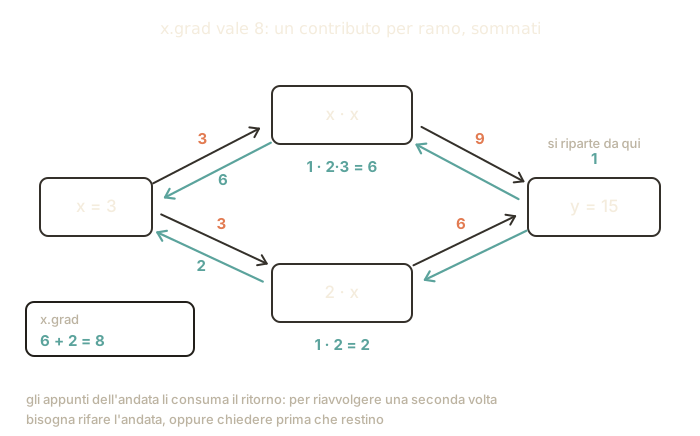
Fig. 7.4 Lo stesso conto percorso nei due sensi. All’andata ogni operazione salva il
valore che servirà alla sua derivata; al ritorno quel valore viene riletto e
liberato, e x, che compare in due punti, riceve un contributo per ciascuno:
\(6\) dal ramo del quadrato e \(2\) da quello lineare, e la loro somma è l’\(8\) che
x.grad restituisce.#
Un registratore acceso accanto al foglio annota ogni conto mentre lo fai.
requires_grad=True lo accende su x, e da lì in poi ogni operazione che parte
da quel numero finisce sul nastro. y.backward() lo riavvolge e lascia in
x.grad la derivata esatta, cioè di quanto cambia il risultato al variare di
quell’ingresso.
Il riavvolgimento riesce perché sul nastro non c’è mai un conto difficile, solo gesti elementari: un’elevazione al quadrato, una moltiplicazione, una somma. Di ognuno la derivata si sa a memoria, come una tabellina. Il registratore parte dalla fine con un \(1\) in mano, perché se il risultato si sposta di un poco, si sposta esattamente di quel poco; poi, a ogni gesto che rilegge, moltiplica il numero che ha per la derivata di quel gesto e passa il prodotto al gesto prima. All’inizio del nastro ha in mano la derivata del conto intero, e ci arriva rileggendo soltanto i gesti fatti davvero, uno alla volta. È il mestiere di autograd. I gesti annotati, con le frecce che dicono quale risultato entra in quale gesto, formano il grafo di cui si parlava presentando PyTorch: una fila, finché ogni numero serve una volta sola, che si biforca appena un numero entra in due gesti.
Nel conto \(y = x^2 + 2x\) con \(x\) che vale \(3\), dal nastro esce \(8\). Quasi lo stesso numero viene a mano spostando \(x\) da \(3\) a \(3{,}01\): \(y\) sale da \(15\) a \(15{,}0801\), cioè di \(0{,}0801\) per uno spostamento di \(0{,}01\), otto volte tanto e un centesimo. Quel centesimo di troppo è lo spostamento che non era abbastanza piccolo: partendo da \(3{,}001\) scende a un millesimo, e più corto lo si fa più il rapporto si avvicina a otto tondo. Dal nastro invece esce l’otto esatto, e nessuno ha scritto la formula della derivata.
Il verso del riavvolgimento decide il costo. Il nastro si riavvolge una volta sola, e da quel giro esce l’effetto di tutti i pesi insieme: mille pesi o un milione, il giro resta uno. Chi il registratore non ce l’ha fa il contrario: sposta di poco un peso, rifà tutto il conto in avanti, guarda di quanto si è spostato il risultato, poi ricomincia con il peso dopo. Ne escono risposte solo approssimate, come l’otto e un centesimo di prima, e un giro a testa. Con un milione di pesi, un giro contro un milione di giri è la distanza fra un addestramento che si può fare e uno che non si può.
Un numero può comparire in più punti dello stesso conto, e allora sul nastro
compare più volte. Il registratore non ne sceglie uno: per ogni punto scrive di
quanto quel punto ha spostato il risultato, e alla fine somma i pezzi, \(6\) dal
quadrato e \(2\) dal doppio. Somma anche nel taccuino su cui deposita, x.grad,
ma per un’altra ragione: PyTorch lo tiene così, e il taccuino non si cancella da
sé. Ecco la sorpresa che tocca a tutti la prima volta: rifai il conto da capo,
richiedi la derivata senza aver svuotato x.grad, e ti ritrovi in mano \(16\)
invece di \(8\). Nel ciclo di addestramento lo si azzera prima di ogni passo.
Il nastro invece si consuma mentre lo riavvolgi, perché gli appunti presi all’andata li cancella il viaggio di ritorno. Riavvolgere due volte lo stesso giro non si può, a meno di chiedere prima che gli appunti restino, e allora occupano memoria fino alla fine: non lo si chiede per abitudine. E il registratore scrive soltanto dove gli è stato detto di guardare: sui numeri dichiarati la derivata si trova, sui risultati calcolati per strada non c’è niente.
Alcuni gesti, infine, il registratore li rilegge senza cavarne niente. Arrotondare a un numero intero, o scegliere il più grande di una fila: spostando di poco quello che entra, quello che esce non si muove, quindi la derivata è zero, e chi sta prima di quel gesto non riceve nessuna indicazione su come correggersi.
Autograd implementa la differenziazione automatica in modalità reverse
(reverse-mode autodiff). Ogni operazione su tensori con
requires_grad=True aggiunge un nodo al grafo dinamico delle computazioni;
y.backward() percorre il grafo a ritroso applicando la regola della
catena vista nella sezione su analisi e ottimizzazione:
dove \(\mathbf{z} \in \mathbb{R}^m\) raccoglie le \(m\) quantità intermedie che dipendono dai \(p\) parametri raccolti in \(\theta\), \(\partial \mathbf{z} / \partial \theta \in \mathbb{R}^{m \times p}\) è la matrice delle loro derivate (la Jacobiana) e \(\nabla_{\mathbf{z}} \mathcal{L}\) è il gradiente già calcolato a valle. Composta lungo tutto il grafo, questa regola è precisamente l’algoritmo di backpropagation.
Nella forma vettoriale ci sono due cose che una catena a un solo cammino non
direbbe, e sono esattamente le due che contano nella pratica. La prima è la
trasposta: la modalità reverse non costruisce mai la Jacobiana, calcola
direttamente il prodotto fra la sua trasposta e il vettore che arriva da valle
(un vector-Jacobian product, uno per nodo). Se \(\mathbf{J}\) è la Jacobiana
dell’intera funzione, dai \(p\) parametri alle sue \(q\) uscite, una passata
all’indietro dà un prodotto \(\mathbf{v}^\top \mathbf{J}\), cioè una combinazione
delle righe di \(\mathbf{J}\) per ogni vettore \(\mathbf{v}\) scelto in partenza:
per averla tutta ne servirebbero \(q\), e con la loss \(q = 1\), quindi ne basta
una, al costo di un piccolo multiplo della passata in avanti, qualunque sia il
numero \(p\) dei parametri. Il multiplo si conta su uno strato lineare, che
riceve \(\mathbf{X} \in \mathbb{R}^{B \times d}\) (\(B\) esempi da \(d\) numeri) e
restituisce \(\mathbf{X}\mathbf{W}^\top\), con \(\mathbf{W} \in
\mathbb{R}^{u \times d}\): la passata in avanti costa \(2Bdu\) operazioni in
virgola mobile, quella all’indietro due prodotti dello stesso costo, il
gradiente rispetto ai pesi \(\mathbf{G}^\top\mathbf{X}\) e quello rispetto
all’ingresso \(\mathbf{G}\mathbf{W}\), dove \(\mathbf{G} \in
\mathbb{R}^{B \times u}\) è il gradiente che arriva da valle. Il ritorno costa
quindi circa il doppio dell’andata, e un
passo di addestramento circa tre volte la sola passata in avanti. La modalità
diretta fa il conto simmetrico, un prodotto \(\mathbf{J}\mathbf{u}\) per passata
(un Jacobian-vector product, torch.func.jvp), e per il gradiente ne
vorrebbe \(p\), una per parametro; le differenze finite, che spostano un
parametro alla volta e rifanno il conto, ne vorrebbero \(p + 1\) e darebbero in
più soltanto una stima. Il vettore di partenza, con la loss, è
\(\partial \mathcal{L}/\partial \mathcal{L} = 1\), e backward() lo mette da sé;
su un tensore \(\mathbf{y}\) non scalare si rifiuta di partire («grad can be
implicitly created only for scalar outputs») finché non glielo si passa:
y.backward(gradient=v) calcola
\(\mathbf{v}^\top\, \partial \mathbf{y}/\partial \mathbf{x}\). La seconda è la
sommatoria: un parametro che alimenta più rami riceve un contributo per ramo, e
i contributi si sommano dentro la stessa backward(), prima di arrivare in
.grad. È il punto in cui il grafo smette di essere una catena. L’accumulo fra
chiamate diverse è un’altra cosa, una scelta di progetto: .grad è un += e
non un =, così due backward() successive danno, per linearità, il
gradiente della somma delle due loss, che è quello che serve per accumulare
gradienti su più passate.
Quattro dettagli operativi che incontreremo di continuo. Primo: i gradienti si
accumulano. Una backward() successiva, su un nuovo forward, somma in
x.grad invece di sovrascrivere, per questo il training loop azzera i
gradienti a ogni passo. Ripetere la stessa chiamata sullo stesso grafo,
invece, solleva un errore.
x = torch.tensor(3.0, requires_grad=True)
for _ in range(2):
    y = x**2 + 2*x          # un forward nuovo a ogni giro
    y.backward()
    print(x.grad)           # si somma: prima 8, poi 16
try:
    y.backward()            # di nuovo sullo stesso grafo
except RuntimeError as e:
    print(type(e).__name__)
tensor(8.)
tensor(16.)
RuntimeError
La ragione dell’errore dice che cosa backward() faccia davvero: percorrendo
il grafo libera i valori intermedi salvati durante l’andata, quelli della
Fig. 7.3. Il grafo resta, i valori salvati per
percorrerlo no. Chiederli in prestito è retain_graph=True, e serve tutte
le volte che da una sola passata in avanti partono due passate all’indietro
(due loss che pescano da un tronco comune, il generatore di una GAN che
alimenta due obiettivi); costa memoria, quindi non si mette per abitudine.
Secondo: il gradiente si deposita solo sulle foglie del grafo, i tensori
creati da noi con requires_grad=True, e i parametri di un modello lo sono
tutti. Su un tensore intermedio, cioè prodotto da un’operazione, .grad
resta None con tanto di avviso: per leggerlo a metà strada si chiama
y.retain_grad() prima del backward. Terzo: il blocco
with torch.no_grad(): sospende la registrazione, indispensabile in
valutazione, quando i gradienti non servono e il grafo sarebbe solo memoria
sprecata. Infine t.detach() restituisce una vista del tensore staccata dal
grafo, e le operazioni in-place sui tensori tracciati vanno evitate perché
possono invalidare i valori salvati per la passata a ritroso. PyTorch se ne
accorge: ogni tensore porta un version counter, e se un valore salvato è
stato modificato dopo il salvataggio la backward() solleva un errore invece di
consegnare un gradiente sbagliato.
Non tutte le operazioni lasciano passare il gradiente. t.item() restituisce
un numero Python, e lì il grafo finisce; argmax, gli indici e i confronti
producono tensori interi o booleani, senza gradiente; torch.round e
torch.floor hanno derivata nulla quasi ovunque, e PyTorch restituisce \(0\).
Una rete con una di queste operazioni in mezzo non riceve segnale nei
parametri a monte: la si sostituisce con un’approssimazione liscia (la softmax
al posto dell’argmax, per esempio) o con uno stimatore apposito, come lo
straight-through estimator.
Le derivate di ordine superiore si ottengono costruendo il grafo anche per il
gradiente: torch.autograd.grad con create_graph=True restituisce una
derivata che si può derivare di nuovo, e torch.func.grad e
torch.func.hessian fanno lo stesso con una sintassi funzionale.
x = torch.tensor(3.0, requires_grad=True)
y = x**3
g, = torch.autograd.grad(y, x, create_graph=True)   # 3x² = 27, nel grafo
g2, = torch.autograd.grad(g, x)                      # 6x = 18
print(g.item(), g2.item())
27.0 18.0
I valori salvati per il ritorno sono il prezzo in memoria della modalità
reverse, e con reti profonde e batch grandi superano la memoria dei pesi (il
conto sta nella sezione sulla backpropagation). Il baratto opposto, memoria
contro calcolo, è il gradient checkpointing:
torch.utils.checkpoint.checkpoint(blocco, x, use_reentrant=False) non
conserva le attivazioni interne del blocco e le ricalcola durante il ritorno,
al prezzo di una passata in avanti in più per quel blocco. L’argomento
use_reentrant va scritto: la libreria avvisa finché non lo si passa
esplicito, e la variante consigliata è False.
Resta il caso in cui autograd non serve, che è il più comune di tutti: il
modello ha finito di imparare e lo si sta soltanto usando. Gli si dà una foto,
lui risponde, e nessuno ha intenzione di correggere niente. Lì i valori
intermedi conservati per il ritorno sono memoria sprecata, e si può dire in
anticipo di non conservarli: è il comando torch.no_grad(), che si scrive
attorno al pezzo di codice da cui non ci si aspetta nessuna correzione e che
impedisce al grafo di formarsi. Attenzione alla sfumatura, perché è il punto in
cui si sbaglia: no_grad() non svuota una memoria già piena, impedisce che si
riempia. Lo useremo a ogni valutazione, da qui alla fine del capitolo, e la
sezione sul training loop ne mostra anche la variante
più stretta, torch.inference_mode().
Tensori e autograd sono i due oggetti su cui poggia tutto il resto del capitolo: dalla prossima sezione non si farà che comporli.
Da ricordare
Un tensore è una scatola di numeri con un certo numero di assi: un numero solo, una fila, una tabella, una pila di tabelle. Il numero di assi si chiama rank (in PyTorch si legge con
ndim), le lunghezze lungo gli assi sono la shape. Una foto a colori è una pila di tre tabelle, una per colore.Ogni riga di conti viene eseguita subito, con i numeri già dentro, e le regole sono quelle di NumPy: sommare un numero a tutta una fila si scrive una volta sola.
Ogni tensore vive su un dispositivo, la CPU o la scheda grafica: i conti avvengono dove stanno i numeri, e il codice resta lo stesso a patto che i tensori che lavorano insieme stiano nello stesso posto. Cambia soprattutto la velocità.
Autograd è il registratore:
requires_grad=Truelo accende su un tensore,.backward()riavvolge il nastro e deposita la derivata. Nessuna formula scritta a mano.Due cose che il registratore fa e che sorprendono: quello che deposita si somma a quello che c’era già, quindi prima di ogni passo va azzerato; e il nastro si consuma riavvolgendolo, quindi lo stesso giro non si riavvolge due volte.
Da ricordare
Un tensore generalizza scalari, vettori e matrici a un numero qualunque di assi: lo descrivono il rank (numero di assi,
ndim, da non confondere con il rango di una matrice) e la shape (forma). In PyTorch le immagini sono channels-first: \((B, C, H, W)\).L’esecuzione è immediata e le regole (broadcasting compreso) sono quelle di NumPy, con cui i tensori sulla CPU condividono la memoria (
from_numpy,numpy();torch.tensorinvece copia).Ogni tensore vive su un device (
"cpu","cuda","mps"): i conti avvengono dove stanno i numeri, e il codice non cambia purché i tensori che si incontrano stiano sullo stesso device; fra CPU e GPU i numeri possono differire nelle ultime cifre.Autograd calcola i gradienti da solo: con
requires_grad=Truele operazioni vengono registrate nel grafo,.backward()lo percorre a ritroso; è la backpropagation, cioè la regola della catena applicata a ritroso sul grafo dei calcoli, e costa un piccolo multiplo della passata in avanti..gradsi accumula a ognibackward()(da quizero_grad()), si deposita solo sulle foglie, e la primabackward()libera i valori salvati;torch.no_grad()evita di costruire il grafo quando i gradienti non servono.t.view(...)pretende una vista e passa solo se la nuova forma è compatibile con gli stride, non solo sui tensori contigui;reshapecopia quando non può fare altrimenti.