


Spiegazioni locali: LIME, SHAP e controfattuali#
Nel 1953 Lloyd Shapley, un giovane matematico che a Princeton stava finendo il dottorato, si pose una domanda che con l’intelligenza artificiale non c’entrava nulla: se un gruppo di persone collabora a un’impresa e ne ricava un guadagno, come si divide il merito «in modo equo» tra chi ha partecipato? Alcuni contano di più, alcuni solo in combinazione con altri; non basta guardare cosa fa ciascuno da solo. Shapley rispose fissando pochi requisiti che a chiunque sembrano ragionevoli, e dimostrando che un solo modo di dividere li rispetta tutti. Nel 2012 avrebbe vinto il premio Nobel per l’economia, per un altro filone dei suoi studi. Non poteva immaginare che questa sua formula sarebbe diventata, più di sessant’anni dopo, uno degli strumenti più usati per spiegare la singola decisione di una rete neurale.
Fin qui la domanda era globale: su quali colonne dei dati (le feature) si regge il modello, in media? Ma chi si vede negare un prestito non chiede una media: chiede «perché la mia domanda?». È una domanda locale, perché riguarda una risposta sola e non l’intero comportamento del modello. I modi di risponderle sono i tre attrezzi che si incontrano più spesso, LIME, SHAP e le spiegazioni controfattuali, e altre due forme, la regola e ciò che manca, abbastanza diverse dalle prime da meritarsi un paragrafo ciascuna.
Perché proprio questa risposta#
Torniamo al modello che decide i prestiti, e immaginiamo che a Maria l’abbia rifiutato. Sapere che «in generale il reddito conta molto» non le serve: è una statistica sul modello, non una risposta sul suo caso. Maria vuole sapere cosa, nella sua pratica, ha spinto verso il no (il reddito, i debiti in corso, un ritardo di pagamento di due anni fa?) e magari quanto ciascuna cosa ha pesato.
È la differenza tra chiedere «come giudica in media questo professore» e «perché ha dato a me questo voto». La prima è una spiegazione globale, sul modello intero; la seconda è locale, su una singola risposta. Un modello può essere troppo intricato per capirlo tutto in un colpo, eppure restare semplice attorno a un punto: come una strada di montagna piena di curve che, guardata da vicino su pochi metri, sembra dritta. Quel pezzo dritto vale lì e basta: dieci tornanti più avanti non descrive più niente, e nessuno gli chiede di farlo. È su questa idea («complicato ovunque, semplice qui accanto») che si reggono gli attrezzi per rispondere a Maria.
Formalmente, una spiegazione locale riguarda il valore del modello \(f\) in un intorno del punto \(\mathbf{x}_0\), non la funzione \(f\) sull’intero dominio. La motivazione è geometrica: la superficie decisionale di un modello complesso può essere globalmente inintelligibile ma localmente regolare, cioè bene approssimabile da un modello semplice in un intorno abbastanza piccolo di \(\mathbf{x}_0\) (l’analogo di linearizzare una funzione differenziabile con il suo piano tangente). Ne discende il criterio di qualità già introdotto in apertura di capitolo, la fedeltà locale: una spiegazione è buona se il surrogato interpretabile concorda con \(f\) sui punti campionati vicino a \(\mathbf{x}_0\), senza alcuna pretesa di valere lontano da lì. Cambia anche l’oggetto restituito: non più una classifica di feature valida ovunque, ma un vettore di attribuzioni \(\phi_j\) specifiche di \(\mathbf{x}_0\), una per feature, che dicono quanto ciascuna ha spinto questa predizione sopra o sotto un riferimento.
LIME: un modello semplice, ritagliato attorno al punto#
Il primo attrezzo è LIME (Local Interpretable Model-agnostic Explanations) proposto nel 2016 da Marco Tulio Ribeiro, Sameer Singh e Carlos Guestrin [RSG16], gli stessi dell’esperimento con cui si è aperto il capitolo, quello del riconoscitore di lupi che in realtà guardava la neve. L’idea è approssimare il modello, attorno al caso da spiegare e solo lì, con un modello che si legge: un surrogato locale. Del modello vero non si apre niente: gli si fanno solo delle domande, come a una scatola chiusa.
Per capire come il modello ha deciso sul caso di Maria, LIME fabbrica tante pratiche finte, casi-fantasma con dentro numeri plausibili (redditi, debiti, età presi da altri clienti o tirati a sorte), e per ciascuna chiede al modello cosa risponderebbe. Ne esce una nuvola di casi inventati.
Su quella nuvola costruisce un modello semplice e leggibile, quello che risponde facendo una somma: tanti punti per il reddito, tanti per i debiti, tanti per l’anzianità di lavoro. Cerca i numeri che fanno somigliare la somma alle risposte della nuvola, e la tiene corta: fra due somme che vanno ugualmente bene si prende quella con meno voci.
C’è però una regola in più, ed è quella che fa tutto il lavoro: nel conto, i fantasmi più simili alla pratica vera di Maria contano di più, quelli lontani quasi niente. Un conto così, in cui ogni voce entra con un’importanza sua, si dice pesato. Quando i dati stanno in una tabella, però, i fantasmi non nascono vicini a Maria: LIME li fabbrica pescando per ogni casella un valore a caso fra quelli degli altri clienti, e quindi escono sparsi un po” dappertutto. A renderli «vicini» è solo il peso, che fa contare poco quelli lontani. E più caselle ha la pratica, più è raro che un fantasma pescato così somigli a Maria in tutte: il conto finisce per reggersi su una manciata di fantasmi che pesano davvero.
I numeri di quella somma sono la spiegazione: «il reddito basso ha spinto verso il no di tanto, i debiti di tanto, l’anzianità di lavoro ha spinto un po’ verso il sì». Se il modello vero è una strada di montagna, LIME appoggia un righello sull’asfalto nel punto in cui ti trovi. Il righello non racconta la strada, ma della salita sotto i tuoi piedi ti dice tutto. Quanto prenderlo lungo lo decidi tu, e si sbaglia in due modi: lungo, scavalca un tornante e dà una pendenza media che sotto i piedi non ha nessuno; cortissimo, si appoggia a due sassi, e basta che uno sia storto per farlo pendere.
E se il caso da spiegare non è una pratica ma una fotografia, i fantasmi si fabbricano in un altro modo, e nascono già vicini: l’immagine si divide in una manciata di pezzetti, e ogni fantasma è la stessa foto con qualcuno dei pezzetti spento. Gli spegnimenti che fanno cambiare idea al modello indicano i pezzi su cui la risposta si appoggiava, e le macchie colorate che smascherarono il riconoscitore di lupi sono nate così.
Un avvertimento, però, prima di fidarsene troppo. Di scelte, in tutto questo, ce ne sono parecchie, e nessuna la suggeriscono i dati: quanti fantasmi fabbricare, quanto largo prendere il «qui vicino», e, se al posto della pratica di Maria c’è una fotografia, in quali pezzi spezzettarla prima di spegnerli a turno. Ognuna di quelle scelte sposta i numeri della spiegazione. In più i fantasmi si fabbricano a caso, quindi rilanciando LIME sullo stesso caso escono numeri un po’ diversi: si dice che il metodo è instabile. Per sapere quanto, lo si rilancia una decina di volte e si guarda se in cima alla spiegazione restano sempre le stesse voci.
LIME cerca un surrogato \(g\) in una classe interpretabile \(G\) (tipicamente modelli lineari sparsi) che minimizzi
dove \(\mathcal{L}\) è l’infedeltà di \(g\) rispetto a \(f\) pesata dalla prossimità \(\pi_{\mathbf{x}_0}\), e \(\Omega(g)\) penalizza la complessità di \(g\) (per esempio il numero di feature non nulle, per una spiegazione corta).
Un passaggio del paper va reso esplicito, perché decide tutto il resto: il surrogato \(g\) non vive nello spazio dell’input. Vive in una rappresentazione interpretabile binaria \(\{0,1\}^{d'}\), di presenza o assenza di \(d'\) componenti: segmenti contigui di pixel (superpixel) per le immagini, parole per il testo, intervalli di valore per le colonne numeriche. Le perturbazioni si ottengono spegnendo a caso alcune di quelle componenti, non muovendo i valori originali, ed è ciò che rende LIME applicabile a un’immagine: nell’esperimento degli husky la macchia di neve che tutti hanno visto è un gruppo di superpixel acceso, non un insieme di pixel scelti uno per uno.
In pratica si campionano dei punti \(\mathbf{z}\), si valuta \(f(\mathbf{z})\) (la
sola cosa che serve del modello: LIME è model-agnostic), si pesa ciascun
campione con un kernel esponenziale
\(\pi_{\mathbf{x}_0}(\mathbf{z}) =
\exp\!\big(-d(\mathbf{x}_0, \mathbf{z})^2 / \sigma^2\big)\)
che decade con la distanza \(d\), e si adatta una regressione lineare pesata. I
coefficienti appresi sono le attribuzioni. Conviene guardare da vicino dove
entra la località, perché non è dove ci si aspetta: nell’implementazione
tabellare degli autori i campioni non si generano attorno a \(\mathbf{x}_0\), ma
dalla distribuzione marginale del training set (l’opzione
sample_around_instance è falsa per default, e le colonne continue vengono per
giunta discretizzate in quartili prima di essere perturbate). La vicinanza a
\(\mathbf{x}_0\) la introduce soltanto il peso \(\pi_{\mathbf{x}_0}\), a valle. La
conseguenza è concreta: la fedeltà locale dipende da quanti dei punti generati
globalmente cadono davvero vicino a \(\mathbf{x}_0\), e in alta dimensione sono
pochi.
Tre limiti vanno dichiarati. Primo, l’instabilità: campionamento casuale e scelta del kernel rendono la spiegazione sensibile ai dettagli; rieseguire LIME sullo stesso punto può dare coefficienti diversi, ed è in buona parte una conseguenza del punto appena visto. Si misura rilanciando il metodo con semi diversi e confrontando, fra due rilanci, gli insiemi \(\mathcal{K}_1\) e \(\mathcal{K}_2\) delle \(k\) feature in testa con l’indice di Jaccard \(|\mathcal{K}_1 \cap \mathcal{K}_2| / |\mathcal{K}_1 \cup \mathcal{K}_2|\): lontano da \(1\), la spiegazione dipende dal sorteggio, e più campioni la stabilizzano, al prezzo di una valutazione del modello per campione. Una richiesta più forte è che punti vicini ricevano spiegazioni vicine: Alvarez-Melis e Jaakkola la misurano con una stima locale della costante di Lipschitz della spiegazione \(\boldsymbol{\phi}\), il massimo di \(\lVert \boldsymbol{\phi}(\mathbf{x}_i) - \boldsymbol{\phi}(\mathbf{x}_j)\rVert_2 / \lVert \mathbf{x}_i - \mathbf{x}_j \rVert_2\) sui punti \(\mathbf{x}_j\) di una piccola palla attorno a \(\mathbf{x}_i\), e trovano che i metodi diffusi per lo più non la soddisfano, e quelli per perturbazione come LIME e SHAP meno ancora di quelli a gradiente [AMJ18]. Secondo, la larghezza del vicinato \(\sigma\) è un iperparametro senza una regola universale: un intorno troppo ampio linearizza una zona in cui \(f\) non è affatto lineare (bassa fedeltà), uno troppo stretto lascia troppo pochi campioni informativi. Terzo, e più insidioso perché non si presenta nemmeno come un parametro da tarare: la spiegazione dipende da come si è deciso di segmentare l’input, cioè da quali sono le componenti che si accendono e si spengono. Cambia la segmentazione, cambia la spiegazione, e la segmentazione la sceglie chi usa lo strumento. La spiegazione dipende quindi da scelte che l’utente raramente controlla. E c’è un quarto limite, che nasce dal campionamento e vale anche per KernelSHAP, la stima per campionamento dei valori di Shapley che arriva con SHAP: i punti perturbati cadono in buona parte fuori dal supporto dei dati, e un modello li può riconoscere. Slack e colleghi [SHJ+20] costruiscono un classificatore che sui dati veri decide in base a un attributo protetto e sui campioni perturbati risponde con una regola innocua: LIME e KernelSHAP riportano la regola innocua, e l’attributo protetto sparisce dalla spiegazione. Un’attribuzione per campionamento certifica il modello sui punti che ha interrogato, non sui clienti veri. Sono motivi per affiancarle un metodo dai fondamenti più solidi, sapendo che l’ultimo dei quattro insidia anche quello.
I valori di Shapley: dividere il merito in modo equo#
LIME risponde alla domanda, ma il modo in cui lo fa poggia su una lunga catena di scelte fatte da chi lo usa: quanti casi-fantasma fabbricare, quanto contare quelli lontani, come spezzettare l’ingresso. Rilanciandolo si ottengono numeri un po’ diversi. Serve un metodo in cui il modo di dividere il merito sia fissato prima, da proprietà dichiarate: a fornirlo è la teoria dei giochi cooperativi, con la formula di Shapley del 1953. Le colonne sono i giocatori, e il guadagno da spartire non è il punteggio che il modello ha dato a Maria, ma di quanto quel punteggio si scosta dalla risposta che il modello darebbe senza sapere niente di lei. Quella risposta a vuoto la chiameremo, qui e per tutto il resto del capitolo, la risposta base. La domanda «quanto ha contribuito il reddito a questo rifiuto?» diventa così la vecchia domanda di Shapley: «quanto merito spetta a questo giocatore?». Una scelta, però, resta anche qui, ed è proprio che cosa voglia dire per il modello «non sapere niente» di una colonna.
Il punto delicato è che i giocatori non agiscono da soli: contano anche le combinazioni. Prendiamo due colonne sole, per tenere il conto piccolo: il reddito e i pagamenti passati, cioè se in passato il cliente ha pagato puntuale. Il modello dà a ogni cliente un punteggio da 0 a 100, e sopra i 35 il prestito è approvato. Senza sapere niente del nostro cliente parte dalla risposta base, che vale 10. Se conosce solo il reddito, sale a 30; se conosce solo i pagamenti passati, sale a 20; se conosce entrambe le cose, arriva a 50, cioè al sì.
Guardiamo quanto aggiunge ciascuna colonna da sola: il reddito porta da 10 a 30, cioè aggiunge 20; i pagamenti portano da 10 a 20, cioè aggiungono 10. Sommati fanno 30, e partendo da 10 dovremmo arrivare a 40. Invece si arriva a 50. Ci sono dieci punti in più che non appartengono a nessuna delle due colonne: nascono dall’averle tutte e due. Ed è ragionevole, perché guadagnare tanto conta poco se non hai mai dimostrato di saper pagare, e aver sempre pagato conta poco se guadagni una miseria. Le due cose si rinforzano a vicenda, e un guadagno che nasce così si chiama interazione. Con un’interazione di mezzo, la domanda «quanto vale ciascuna?» smette di avere una risposta ovvia.
L’idea di Shapley è far entrare in campo le colonne una alla volta, in tutti gli ordini possibili, segnare per ognuna quanto aggiunge nel momento in cui entra, e poi fare la media. La media serve perché nessun ordine è quello vero: le colonne non entrano davvero una dopo l’altra, ci sono tutte insieme, e non c’è ragione di preferire un ordine agli altri. Si tengono tutti: è l’idea di equità di Shapley.
Con due colonne gli ordini sono due. Se entra prima il reddito, porta il punteggio da 10 a 30 e aggiunge 20; poi entrano i pagamenti, da 30 a 50, e aggiungono 20. Se entrano prima i pagamenti, portano da 10 a 20 e aggiungono 10; poi entra il reddito, da 20 a 50, e aggiunge 30. Il merito del reddito è la media di quanto aggiunge nei due ordini, \((20 + 30)/2 = 25\); quello dei pagamenti, \((20 + 10)/2 = 15\). E il conto torna: \(25 + 15 = 40\), esattamente quanto separa il punteggio finale (50) dalla risposta base (10). Tutto il bottino è stato ripartito, senza avanzi: nessun merito inventato, nessuno perso per strada.
E i dieci punti dell’interazione? Se li prende tutti chi entra per secondo: nel primo ordine i pagamenti, che da soli valevano 10 e lì aggiungono 20; nel secondo il reddito, che da solo valeva 20 e lì aggiunge 30. Ciascuno dei due arriva secondo in metà degli ordini, e intasca quei dieci una volta su due: cinque a testa. Infatti il reddito prende 25, i suoi 20 più cinque, e i pagamenti 15, i loro 10 più cinque.
Per tutto il conto al modello sono bastati quattro punteggi, uno per ogni gruppo di colonne che conosce: nessuna, solo il reddito, solo i pagamenti, tutte e due. Ogni colonna in più raddoppia i gruppi da provare.
Resta in sospeso che cosa voglia dire che il modello «conosce solo il reddito». Il modello vuole tutte le sue caselle piene, e quella dei pagamenti non la si può lasciare vuota: ci si mette qualcosa al posto del valore vero. Si possono pescare i pagamenti di tanti altri clienti presi a caso, e fare la media delle risposte; pescarli solo fra i clienti che guadagnano quanto il nostro; oppure mettere un valore fisso, la media della colonna su tutti i clienti o uno zero, che per convenzione vuol dire «niente». Il primo modo dice su che cosa si appoggia il modello, il secondo che cosa dice il dato. Ed è una scelta che sposta i numeri: cambiando ciò che si mette al posto del valore vero cambia la risposta del modello quando non sa niente, e siccome tutti i meriti sono la ripartizione della distanza da quella risposta lì, cambiano anche loro.
Il modo di dividere segue quattro richieste di buon senso, e ognuna ha il suo nome. Che il conto torni senza avanzi, come qui \(25 + 15 = 50 - 10\), è l’efficienza. Che due colonne che fanno esattamente lo stesso mestiere ricevano lo stesso merito è la simmetria. Nel conto intero reddito e pagamenti non fanno lo stesso mestiere (da soli valgono 20 e 10), e infatti prendono 25 e 15; lo fanno dentro l’interazione, dove nessuno dei due vale niente senza l’altro, ed è per questo che quei dieci punti si sono divisi a metà. Che una colonna che non aggiunge mai niente, in nessun ordine, prenda zero è il giocatore nullo. E poi c’è l’additività, la meno intuitiva delle quattro e la più utile: se il punteggio del cliente fosse la somma di due punteggi calcolati a parte, il merito di una colonna sul totale sarebbe la somma dei due meriti che si prende su ciascuno. Un conto complicato lo si spezza, si fanno i conti sui pezzi e si sommano, ed è così che si tengono in piedi i conti sui modelli in cui a rispondere sono centinaia di alberi che votano.
Sono richieste che sembrano ragionevoli a chiunque (anche se c’è chi discute che siano quelle giuste per spiegare un modello), e il motivo per cui la formula del 1953 è ancora qui è che c’è un solo modo di dividere il merito che le soddisfa tutte e quattro insieme. Uno solo, però, una volta deciso che cosa risponde il modello quando una colonna non gliela si fa sapere: quella decisione resta di chi fa il conto, e nessuna delle quattro richieste dice quale sia quella giusta.
Sia \(N = \{1, \dots, n\}\) l’insieme delle feature e \(v(S)\) il valore della coalizione \(S \subseteq N\): la predizione attesa quando si conoscono solo le feature in \(S\) e si marginalizza sulle altre, con \(v(\varnothing) = \mathbb{E}[f(\mathbf{x})]\) il valore base e \(v(N) = f(\mathbf{x}_0)\). Il valore di Shapley della feature \(i\) è la media dei suoi contributi marginali su tutti gli ordini di ingresso:
dove \(v(S \cup \{i\}) - v(S)\) è quanto aggiunge \(i\) unendosi alla coalizione \(S\), e il coefficiente combinatorio conta la frazione di permutazioni in cui \(i\) entra proprio dopo l’insieme \(S\). Questa è l’unica attribuzione che soddisfa quattro assiomi:
Efficienza: \(\sum_{i} \phi_i = v(N) - v(\varnothing) = f(\mathbf{x}_0) - \mathbb{E}[f(\mathbf{x})]\). I contributi sommano esattamente allo scarto della predizione dal valore base: niente si crea, niente si perde.
Simmetria: se due feature danno lo stesso contributo a ogni coalizione (\(v(S \cup \{i\}) = v(S \cup \{j\})\) per ogni \(S\) che non contiene né \(i\) né \(j\)), allora \(\phi_i = \phi_j\).
Giocatore nullo (dummy): una feature che non cambia mai il valore (\(v(S \cup \{i\}) = v(S)\) per ogni \(S\)) riceve \(\phi_i = 0\), e la si può togliere dal gioco: per ogni altra feature il contributo a una coalizione che contiene \(i\) è lo stesso che senza, quindi i valori delle altre non cambiano.
Additività: i valori di Shapley di una somma di modelli sono la somma dei valori; è la proprietà che rende trattabili gli ensemble.
È dibattuto se questi siano gli assiomi giusti per spiegare un modello: Kumar e colleghi mostrano che, usati come misura d’importanza, i valori di Shapley pongono problemi matematici il cui rimedio richiede di ragionare sulle cause, e che non rispondono in modo naturale a quello che una persona chiede a una spiegazione [KVSF20].
Un’avvertenza che la letteratura ha imparato a proprie spese: la funzione \(v\) non è data, va scelta, e la scelta conta. Le feature fuori da \(S\) si possono marginalizzare sulla loro distribuzione (variante interventista), condizionare a quelle presenti (variante condizionale) o fissare a un riferimento \(r\) (variante baseline, dove \(v(\varnothing) = f(r)\)): le tre scelte producono attribuzioni diverse per lo stesso modello e lo stesso punto [SN20]. Il teorema di unicità riguarda il modo di ripartire, dato il gioco; cambiare \(v\) vuol dire cambiare gioco, e nessun assioma dice quale dei tre sia quello da giocare. Non è un difetto della formula, è di nuovo la forcella dell’apertura di capitolo: la variante interventista risponde a «su che cosa si appoggia questo modello», quella condizionale a «che cosa dice il dato», e sono due domande diverse a cui è giusto rispondere con due numeri diversi. Janzing, Minorics e Blöbaum leggono la variante interventista in termini causali: togliere una feature è un intervento sull’ingresso del modello nel senso di Pearl, e per questo la ritengono la nozione giusta quando la domanda riguarda il modello [JMBlobaum20]. La causalità di cui parlano sta dentro il modello: nessuna delle due varianti stabilisce relazioni di causa-effetto fra le grandezze del mondo reale.
Sull’esempio dei due giocatori, con \(v(\varnothing)=10\), \(v(\{1\})=30\), \(v(\{2\})=20\), \(v(\{1,2\})=50\), la formula dà \(\phi_1 = 25\) e \(\phi_2 = 15\), in accordo con la media sugli ordini, e \(\phi_1 + \phi_2 = 40 = v(N) - v(\varnothing)\) verifica l’efficienza. Il costo è la maledizione combinatoria: la somma per una singola feature è su \(2^{\,n-1}\) coalizioni (i sottoinsiemi che non contengono \(i\)), e le coalizioni distinte in tutto sono \(2^n\): è quest’ultimo il miliardo abbondante che si cita per \(n = 30\). In entrambi i conteggi si è impraticabili oltre poche decine di feature. È il problema che SHAP risolve.
SHAP: i valori di Shapley, resi praticabili#
Calcolare i valori di Shapley esatti richiede di provare tutte le coalizioni, cioè tutti i gruppi di feature che si possono formare. Ogni colonna può esserci o non esserci, quindi con \(n\) colonne i gruppi sono \(2^n\): con trenta colonne, oltre un miliardo. L’idea di usarli per spiegare la singola predizione, stimandoli su un campione di ordini estratti a caso invece che su tutti, è di Erik Štrumbelj e Igor Kononenko, che la proposero nel 2010 [vStrumbeljK10] e la estesero nel 2014 [vStrumbeljK14]. Nel 2017 Scott Lundberg e Su-In Lee [LL17] hanno messo sei metodi esistenti, LIME e DeepLIFT compresi, dentro una sola famiglia, quella che spiega una risposta come somma di contributi delle feature (SHAP, SHapley Additive exPlanations), e hanno mostrato che in quella famiglia una sola soluzione rispetta le proprietà richieste, i valori di Shapley, e come stimarla in modo efficiente. LIME ha la stessa forma, e a distinguerlo è come conta la somiglianza fra i casi-fantasma, che LIME fissa a occhio e SHAP invece deriva dalla formula di Shapley. Da qui SHAP è diventato uno degli strumenti più usati per spiegare una decisione dall’esterno, a modello già addestrato.
SHAP non cambia la definizione: restituisce ancora i contributi «equi» di Shapley. Cambia il come li ottiene, con due scorciatoie a seconda del modello.
Se il modello è una scatola chiusa qualunque, si usa KernelSHAP, che prova a caso solo alcuni dei gruppi e da quelli ricostruisce i meriti di tutti. Il ricostruire è di nuovo un conto pesato, come quello di LIME, ma i pesi non sono scelti a occhio: li dà la formula di Shapley, ed è questo che garantisce di puntare ai numeri giusti.
Se invece il modello è fatto di alberi di decisione, quelli a catena di domande sì/no della sezione sui modelli trasparenti, si usa TreeSHAP, che sfrutta la forma dell’albero per calcolare i meriti esatti senza provare niente a caso. Esatti, s’intende, rispetto al modo che si è scelto per «spegnere» una colonna: quella resta una scelta anche qui.
E c’è un caso in cui quella scelta si vede tutta. Nella pratica di Maria due caselle dicono quasi la stessa cosa, lo stipendio al mese e quello all’anno, e il modello ne guarda una sola. Spegnendo una casella per volta si finisce per chiedere al modello che cosa direbbe di chi guadagna mille euro al mese e centomila all’anno, un cliente che non esiste; e il merito va tutto alla casella guardata, zero all’altra, che per Maria diceva la stessa identica cosa.
Quello che si guadagna rispetto ad altri metodi è una garanzia, e la si vede con due versioni dello stesso modello. Se nella seconda il reddito aggiunge più punti che nella prima in ogni gruppo in cui entra (da solo, con i pagamenti, con qualunque altra colonna), il merito del reddito nella seconda non può risultare più basso che nella prima. Sembra ovvio, eppure l’importanza da impurità degli alberi questa garanzia non la dà.
Il risultato si legge nel grafico a cascata della Fig. 37.5: si parte dalla risposta base e si impilano i contributi, uno per riga. Chi alza la risposta va verso destra, in terracotta (il rosso mattone); chi la abbassa torna verso sinistra, in teal (il verde-azzurro scuro). In fondo c’è la risposta per questo cliente, spiegata voce per voce.
KernelSHAP riformula il calcolo come una regressione lineare pesata sulle coalizioni: campionando sottoinsiemi \(S\) e pesandoli con il kernel di Shapley \(\pi(S) = \frac{n-1}{\binom{n}{|S|}\,|S|\,(n - |S|)}\), la soluzione ai minimi quadrati converge ai valori di Shapley; è la scelta di pesi che distingue SHAP da LIME, i cui pesi euristici non hanno questa garanzia.
A pesi giusti, però, resta da calcolare la funzione valore, e lì la garanzia si assottiglia. KernelSHAP approssima \(v(S) = \mathbb{E}\big[f(\mathbf{x}) \mid \mathbf{x}_S\big]\) con l’attesa marginale, sostituendo le feature assenti con valori pescati da un insieme di riferimento: è l’ipotesi di indipendenza fra le feature, dichiarata da Lundberg e Lee nel passaggio in cui derivano l’approssimazione [LL17]. Quando le feature sono correlate le due quantità divergono [AJLoland21], e la divergenza non è piccola: su due colonne quasi identiche di cui il modello ne usa una sola, la versione marginale dà tutto il merito alla colonna usata e zero all’altra, mentre quella condizionale lo ripartisce fra le due. È ancora la forcella dell’apertura, ed è il punto in cui morde: KernelSHAP restituisce sistematicamente la prima risposta, mentre chi la legge crede spesso di star leggendo la seconda.
TreeSHAP (introdotto in un lavoro successivo degli stessi autori [LEC+20]) elimina invece il campionamento per i modelli ad albero, con costo \(O(T L D^2)\) (\(T\) alberi, \(L\) foglie, \(D\) profondità), propagando lungo l’albero le popolazioni delle coalizioni. I valori sono esatti rispetto alla \(v\) che l’implementazione adotta: la variante path-dependent stima \(v\) dalle popolazioni dei nodi dell’albero e non riproduce la marginalizzazione pura; la variante interventional la calcola davvero, rispetto a un insieme di riferimento esplicito.
Il vantaggio teorico dei valori di Shapley, e quindi di ogni loro calcolo esatto, è la consistenza. Se si modifica il modello così che una feature contribuisca di più in ogni coalizione, il suo valore SHAP non può diminuire; è una monotonia che l’importanza da impurità della sezione sui modelli trasparenti non garantisce. Oltre al waterfall (una predizione), i grafici tipici sono il force plot, che dispone gli stessi contributi come forze contrapposte lungo una retta, e soprattutto il beeswarm: impilando i valori SHAP di migliaia di istanze, una riga per feature, si ricostruisce una vista globale (quali feature contano e in che direzione) a partire da tante spiegazioni locali. È il ponte tra il locale e il globale che rende SHAP così usato.

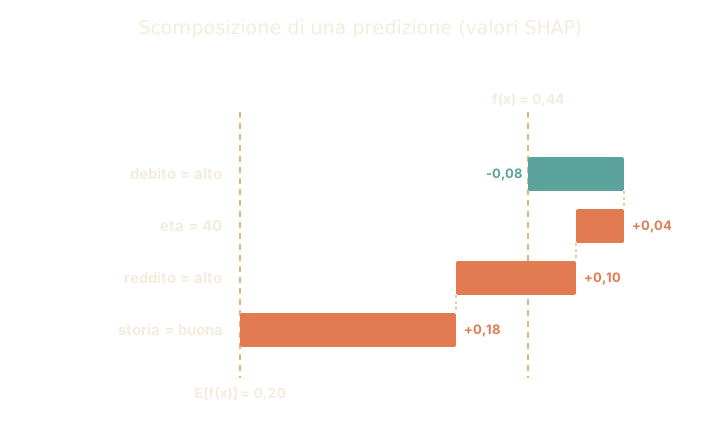
Fig. 37.5 Un grafico a cascata (waterfall) SHAP scompone una singola risposta. Qui il modello risponde con una probabilità, un numero fra \(0\) e \(1\), e non con un punteggio da 0 a 100 come nell’esempio di poco fa: la scala cambia, il ragionamento no. Si parte dalla riga tratteggiata di sinistra, la risposta base, cioè quanto risponde il modello quando di questo cliente non sa niente: \(0{,}20\). Nel disegno la si trova scritta \(\mathbb{E}[f(x)]\), che è il modo dei matematici di dire «la media delle risposte del modello su tutti i clienti». È una delle scelte possibili, ed è quella che si fa di solito: al posto di «niente» si mette la media di tutti, invece di uno zero o dei valori di un cliente preso a caso. Cambiando quella scelta si sposta la riga tratteggiata di sinistra, e con essa tutte le barre. Poi si impilano i contributi, uno per riga, partendo dal basso: le barre che vanno verso destra, in terracotta, alzano la risposta; quella che torna verso sinistra, in teal, la abbassa. La seconda riga tratteggiata è la risposta per questo cliente, \(0{,}44\), e la somma dei contributi ci arriva esattamente (\(0{,}20 + 0{,}18 + 0{,}10 + 0{,}04 - 0{,}08 = 0{,}44\)): è la proprietà che abbiamo chiamato efficienza.#
Controfattuali: cosa sarebbe dovuto cambiare#
LIME e SHAP rispondono a «perché questa decisione?». Ma a chi si è visto negare un prestito interessa spesso un’altra domanda, più pratica: «cosa devo cambiare perché la prossima volta sia un sì?». È la spiegazione controfattuale, formalizzata nel 2017 da Sandra Wachter, Brent Mittelstadt e Chris Russell [WMR17] come risposta al dibattito sul «diritto alla spiegazione» del GDPR, discusso nell’apertura del capitolo. Gli autori sostenevano che un diritto vincolante a farsi spiegare il funzionamento del modello il GDPR non lo dà, e proponevano il controfattuale come la spiegazione che serve comunque all’interessato: capire la decisione, contestarla e sapere che cosa cambiare, senza aprire il modello. Nel 2025 la Corte di giustizia, nella sentenza ricordata in apertura, ha indicato proprio questa fra le forme di spiegazione sufficienti: dire all’interessato come una variazione dei suoi dati avrebbe portato a un risultato diverso.
Un controfattuale è un’affermazione del tipo: «se il tuo reddito fosse stato 30 000 € invece di 24 000, il prestito sarebbe stato approvato». Non ti dice come funziona il modello dentro; ti dice la modifica più piccola che avrebbe ribaltato la decisione. È azionabile: indica una via d’uscita concreta, non una diagnosi astratta.
La qualità di un buon controfattuale sta in due cose. Primo, dev’essere vicino alla tua situazione reale: «guadagna 200 000 € in più» tecnicamente ribalta la decisione ma non serve a nessuno; «riduci di una rata i tuoi debiti» è molto più utile. Secondo, dev’essere plausibile e realizzabile: suggerire di cambiare l’età non ha senso, perché non è una leva su cui puoi agire. Il buon controfattuale è il consiglio minimo, concreto e onesto che ti mette dalla parte giusta della decisione.
«Minimo» però va misurato voce per voce: mille euro sul reddito di un anno sono un’inezia, mille euro sulla rata del mese sono un’altra storia. E conta quante caselle si toccano: una cosa sola da cambiare la si cambia, dodici insieme no.
La stessa ricerca serve anche a chi ha l’intenzione opposta. Trovare il ritocco più piccolo che ribalta la risposta di un modello è quello che fa chi vuole imbrogliarlo; la differenza sta in cosa se ne fa, perché lui quel ritocco lo nasconde, mentre il controfattuale lo scrive nero su bianco e te lo consegna.
Wachter e colleghi cercano un punto \(\mathbf{x}_{\mathrm{cf}}\) che ottenga l’esito desiderato \(y'\) restando il più vicino possibile all’istanza originale \(\mathbf{x}_0\), minimizzando
dove il primo termine spinge la predizione verso il valore-bersaglio \(y'\) (la soglia di approvazione) e \(d\) misura quanto \(\mathbf{x}_{\mathrm{cf}}\) si discosta da \(\mathbf{x}_0\): nel paper è una distanza di Manhattan (\(L_1\)) in cui ogni feature è divisa per la propria deviazione assoluta mediana (MAD): favorisce modifiche sparse e rende confrontabili scale diverse. Il moltiplicatore \(\lambda\) non è un compromesso da regolare a mano: lo si fa crescere finché la predizione non rientra in una tolleranza fissata attorno a \(y'\), così che il primo termine agisca da vincolo e, sotto quel vincolo, si minimizzi la distanza. Estensioni successive aggiungono vincoli di plausibilità (restare sul supporto dei dati) e di azionabilità (non modificare feature immutabili come l’età o l’etnia).
C’è poi un parallelo tecnico esatto. Cercare la perturbazione minima di \(\mathbf{x}_0\) che cambia l’uscita del modello è, formalmente, lo stesso problema degli esempi avversari: le impercettibili modifiche d’input che ingannano una rete, scoperte da Szegedy e colleghi [SZS+14] e spiegate da Goodfellow, Shlens e Szegedy [GSS15]; il capitolo sull’AI responsabile le tratta nella sezione che porta il loro nome. La matematica è la medesima, l’intento opposto: un esempio avversario nasconde la perturbazione per ingannare il modello; un controfattuale la esibisce per spiegarlo e offrire una via d’azione. Lo stesso strumento può violare o servire l’interesse di chi subisce una decisione, a seconda di come lo si usa.
Uno o molti: la diversità dei controfattuali#
Un controfattuale solo mostra una strada sola, e non è detto che chi lo riceve possa percorrerla. Mothilal, Sharma e Tan [MST20] propongono di restituirne un piccolo insieme, scelto perché sia valido, vicino alla situazione reale e vario, con un metodo noto come DiCE (Diverse Counterfactual Explanations, e con lo stesso nome ne esiste la libreria). Misurano quanto le risposte sono varie con un solo numero, che vale quasi zero quando due di esse coincidono e cresce man mano che si allontanano: è il determinante di una tabella delle loro somiglianze.
A Maria la ricerca del controfattuale più vicino dice una cosa sola: guadagna seimila euro in più all’anno. È la risposta più economica sulla carta, e per lei può essere la più impossibile, se ha appena cambiato lavoro e lo stipendio per un anno non si muove. Le sarebbe servito sapere che c’erano anche altre strade: ridurre di trecento euro al mese le rate dei debiti, oppure aspettare altri sei anni nell’impiego attuale, arrivando a otto invece di due.
La ricerca ne trova una sola, e sempre sulla stessa voce, per come conta il costo. Ogni voce si misura in «quanto si sposta rispetto a quanto varia di solito fra le persone», e così misurato ogni passo verso il sì ha un prezzo diverso a seconda della voce: per Maria il reddito è la voce dove il sì costa meno. Mescolare le voci non aiuta, perché ogni pezzo di strada fatto con la rata costerebbe più dello stesso pezzo fatto con il reddito; conviene fare tutta la strada col reddito. Chiedendo tre risposte senza chiedere che siano diverse, se ne avrebbero tre versioni della stessa: seimila euro in più, o qualche centinaio sopra.
Per avere tre strade davvero diverse bisogna premiare la differenza. Si dà un voto all’insieme delle risposte: vicine alla situazione reale, sì, ma anche sparpagliate fra loro. Tre risposte quasi uguali prendono un voto di varietà quasi nullo, tre leve diverse un voto alto; e nel conto le tre leve, un po’ più lontane in media ma molto più varie, battono le tre varianti del reddito.
La varietà però si paga in vicinanza, e non basta che le risposte siano diverse: devono restare possibili. Le voci che non si possono cambiare, come l’età, si tolgono dalla ricerca in partenza; gli anni di lavoro non si comprano, si aspettano; e certe voci vanno insieme, perché sei anni di lavoro in più portano con sé anche sei anni d’età in più, e un voto che guarda le voci una per una non lo sa. E ogni strada vale per il modello che l’ha indicata: un altro modello, bravo quasi uguale, o lo stesso modello riaddestrato l’anno dopo, potrebbe chiedere a Maria un’altra cosa.
Dati il modello \(f\), l’istanza \(\mathbf{x}_0\) e l’esito desiderato, DiCE cerca \(k\) controfattuali insieme minimizzando
con \(\ell\) una perdita a cerniera sul logit, \(\max\big(0,\, 1 - z\cdot \mathrm{logit}\,f(\mathbf{c})\big)\) con \(z = \pm 1\) secondo la classe voluta, che si annulla solo quando il controfattuale sta dalla parte giusta con un margine; \(d\) la distanza \(L_1\) pesata di Wachter; e il determinante del nucleo di un processo puntuale determinantale come misura della diversità: \(\det \mathbf{K}\) tende a \(1\) quando i controfattuali si allontanano fra loro (\(\mathbf{K} \to \mathbf{I}\)) e si annulla quando due coincidono (due righe uguali). Il paper sceglie \(\lambda_1 = 0{,}5\) e \(\lambda_2 = 1\) su una griglia (pesi fissi, a differenza del \(\lambda\) di Wachter, che cresce fino a imporre il vincolo), accetta vincoli di intervallo e l’elenco delle voci modificabili, e con una passata finale ripristina, una alla volta e finché la classe non cambia, le voci il cui scarto sta sotto una soglia, per la sparsità.
Che il singolo controfattuale di Wachter non basti si vede già con un modello lineare. Con la distanza \(L_1\) pesata il problema è un programma lineare, il minimo sta su un vertice, e si muove la sola voce che sposta il logit al costo più basso, cioè quella con \(|w_j|\,\mathrm{MAD}_j\) massimo; vale con voci continue, senza vincoli di intervallo attivi e senza pareggi fra i \(|w_j|\,\mathrm{MAD}_j\). La risposta è sempre la stessa leva, e \(k\) risposte senza il termine di diversità ne sono \(k\) varianti. Resta aperto quello che il determinante non vede: due controfattuali diversi possono essere entrambi irrealizzabili, e la diversità misurata sulle voci non dice niente sulle dipendenze fra le voci stesse. E il controfattuale vale per il modello che lo ha prodotto. Modelli quasi equivalenti sui dati, l’effetto Rashomon dell’apertura, possono trattare diversamente la stessa persona, e un controfattuale valido per uno non esserlo per un altro, o per lo stesso modello riaddestrato: Pawelczyk, Broelemann e Kasneci danno un limite superiore al costo dei controfattuali in questa molteplicità, e trovano che quelli che restano vicini ai dati reali reggono meglio dei più sparsi, a un costo maggiore sotto il singolo modello [PBK20].
Il conto usa un modello lineare, cioè un punteggio che è una somma pesata di tre voci (reddito, rata dei debiti e anni nell’impiego attuale), e Maria a un passo dal sì: il suo punteggio vale \(-1\), e il prestito si concede da \(0\) in su. (Il punteggio è il logit, e un logit zero corrisponde a una probabilità del 50%.) Per ogni voce il blocco trova lo spostamento che porta il punteggio a zero e il suo costo; poi confronta, con l’obiettivo di DiCE, l’insieme delle tre leve con tre varianti della leva più economica.
import numpy as np

# un modello lineare per il prestito: reddito (migliaia di euro l'anno),
# rata dei debiti (centinaia di euro al mese), anni nell'impiego attuale
nomi = ["reddito", "rata", "anni di lavoro"]
w = np.array([1 / 6, -1 / 3, 1 / 6])
x0 = np.array([24.0, 6.0, 2.0])
b = -1.0 - w @ x0                        # Maria sta a logit -1: negato
mad = np.array([8.0, 3.0, 4.0])          # deviazione assoluta mediana di ogni voce


def costo(c, x):
    """Distanza L1 pesata con la MAD, quella di Wachter e colleghi."""
    return np.sum(np.abs(c - x) / mad)


# con un modello lineare il controfattuale più vicino muove una voce sola:
# per ciascuna, quanto va spostata perché il logit arrivi a zero
leve = []
for j in range(3):
    c = x0.copy()
    c[j] += -(w @ x0 + b) / w[j]
    leve.append(c)
    print(f"solo {nomi[j]:15s} -> {c[j]:5.1f}   costo {costo(c, x0):.2f}")
piu_vicino = int(np.argmin([costo(c, x0) for c in leve]))
print("il controfattuale più vicino muove:", nomi[piu_vicino])


def diversita(insieme):
    """Il determinante di K, con K_ij = 1 / (1 + distanza fra c_i e c_j)."""
    K = np.array([[1 / (1 + costo(ci, cj)) for cj in insieme] for ci in insieme])
    return np.linalg.det(K)


def perdita(insieme, l1=0.5, l2=1.0):
    """L'obiettivo di DiCE: cerniera sul logit, distanza media, meno la diversità."""
    cerniera = np.mean([max(0.0, 1 - (w @ c + b)) for c in insieme])
    distanza = np.mean([costo(c, x0) for c in insieme])
    return cerniera + l1 * distanza - l2 * diversita(insieme)


varianti = [x0 + [d, 0, 0] for d in (6.0, 6.5, 7.0)]   # tre volte la stessa leva
for nome, insieme in [("tre leve diverse", leve), ("tre volte il reddito", varianti)]:
    print(f"{nome:21s} distanza media {np.mean([costo(c, x0) for c in insieme]):.4f}, "
          f"diversità {diversita(insieme):.4f}, perdita {perdita(insieme):.4f}")
solo reddito         ->  30.0   costo 0.75
solo rata            ->   3.0   costo 1.00
solo anni di lavoro  ->   8.0   costo 1.50
il controfattuale più vicino muove: reddito
tre leve diverse      distanza media 1.0833, diversità 0.7554, perdita 0.7863
tre volte il reddito  distanza media 0.8125, diversità 0.0130, perdita 1.3099
La leva più economica è il reddito, da \(24\) a \(30\) migliaia di euro, e da sola è tutto quello che il controfattuale più vicino restituisce. Le tre varianti del reddito stanno più vicine in media, \(0{,}8125\) contro \(1{,}0833\), ma la loro diversità è quasi nulla, \(0{,}0130\) contro \(0{,}7554\), e l’obiettivo, che si minimizza, le scarta: \(1{,}3099\) contro \(0{,}7863\). Il primo termine dell’obiettivo, quello che punisce chi non ha passato il confine con un margine (la perdita a cerniera), non si annulla per nessuno: si azzera solo quando il punteggio supera \(1\), e le leve si fermano esattamente a zero, dove vale \(1\); le varianti del reddito vanno un poco oltre, e lo pagano meno.
Regole invece di pesi: gli anchor#
LIME e SHAP consegnano un elenco di colonne con dei numeri accanto, e per coglierne il senso bisogna saperli interpretare. C’è una forma di spiegazione locale che non richiede questo sforzo: la regola.
La regola di cui parliamo suona così:
«Finché il reddito supera i 30 000 € e negli ultimi due anni non ci sono state rate non pagate, questo modello dice sì, qualunque cosa facciano le altre colonne.»
Una regola così si chiama anchor, àncora, e cambia il tipo di risposta. LIME dice quanto ogni feature ha pesato in questo caso; un anchor dice fin dove la risposta resta la stessa, e questa è una promessa verificabile: si prende la regola, si cercano altri casi che la soddisfano, e si controlla se il modello risponde davvero sempre allo stesso modo.
Da qui le due misure che accompagnano ogni anchor, con dei numeri in mano. La precisione dice quanto spesso la regola azzecca la risposta del modello: se su cento clienti che soddisfano la regola il modello dice sì a novantasette, la precisione è del 97%. La copertura dice su quanti clienti la regola si applica: se su diecimila clienti duemila hanno reddito sopra 30 000 e nessuna rata non pagata, la copertura è del 20%.
Le due tirano in direzioni opposte: più condizioni si aggiungono, più la regola diventa infallibile e meno gente ci ricade sotto. Dieci condizioni: quasi sempre esatta, e buona quasi per nessuno. Una condizione sola: buona per molti, e sbaglia spesso. Un buon anchor è quello che vale per più gente possibile senza scendere sotto la precisione richiesta, e di solito è anche il più corto. Su una fotografia la faccenda si complica: prima ancora di scrivere una regola bisogna decidere che cosa sia una condizione, cioè tornare a spezzettare l’immagine come fa LIME.
E quanto alta debba essere quella precisione non lo dicono i dati: lo decide chi usa lo strumento, di solito molto in alto, per esempio al 95%. La precisione, poi, non si conosce esatta: si stima provando la regola su un campione di casi, quindi si chiede che superi il 95% con buona sicurezza. E promette che la regola descrive bene il modello, non che il modello abbia ragione: un anchor precisissimo su un modello sbagliato descrive perfettamente uno sbaglio.
Gli anchor [RSG18] sono degli stessi autori di LIME, e nascono per rispondere a un difetto dichiarato di quel metodo: un modello lineare locale non dice dove finisce la sua validità, e il lettore non ha modo di sapere se l’approssimazione regge un pixel più in là o mezzo dataset.
Un anchor è un predicato \(A\) sull’istanza (una congiunzione di condizioni sulle feature) tale che, campionando perturbazioni \(\mathbf{z}\) da una distribuzione \(\mathcal{P}\) condizionata al fatto che \(A\) resti soddisfatto, il modello mantenga la stessa predizione con alta probabilità:
tipicamente con \(\tau = 0{,}95\), soglia scelta da chi analizza e non dedotta dai dati. Poiché \(\operatorname{prec}(A)\) per un modello qualsiasi non si calcola esattamente, il vincolo che si impone è probabilistico, \(P\big(\operatorname{prec}(A) \ge \tau\big) \ge 1 - \delta\), e la precisione si stima per campionamento. Fra tutti i predicati che soddisfano il vincolo si cerca quello di copertura massima, \(\operatorname{cov}(A) = \mathbb{E}_{\mathbf{z}\sim\mathcal{P}}[\mathbb{1}[A(\mathbf{z})]]\). La ricerca procede aggiungendo una condizione alla volta e stimando la precisione per campionamento; poiché ogni valutazione costa, il problema di quale candidato affinare è formulato come best-arm identification, cioè quello che risolvono i bandit a più braccia, con l’algoritmo KL-LUCB a dare intervalli di confidenza sulla precisione.
Il guadagno rispetto a LIME è la fedeltà dichiarata: un anchor non approssima, delimita, e la sua precisione è un numero misurato invece che una speranza. Il prezzo è che su feature continue e ad alta dimensione le regole diventano lunghe o la copertura crolla, e su dati non tabellari (immagini, testo) bisogna prima definire che cosa sia una «condizione», il che riporta tutti i problemi di rappresentazione di LIME.
Quel che manca: i negativi pertinenti#
I controfattuali chiedono che cosa cambiare. C’è una domanda gemella e asimmetrica da distinguere, perché risponde a un dubbio diverso: non «che cosa devo cambiare», ma «che cosa, di ciò che non c’è, sta determinando la risposta».
Cambiamo per un attimo mestiere al modello. Questo guarda una cifra scritta a mano, di quelle sulle buste da lettera, e deve dire quale cifra è; su una certa immagine risponde \(3\). Due domande diverse.
La prima: quali tratti dell’immagine bastano perché resti un \(3\)? Se si cancella tutto il resto e restano solo quelli, la risposta non cambia. Sono i positivi pertinenti: il minimo indispensabile presente.
La seconda: quale tratto, se ci fosse, la farebbe diventare un \(8\)? Un piccolo arco a sinistra, che chiuda le due pance. Quel tratto è un negativo pertinente: non c’è nell’immagine, e la sua assenza è parte del motivo per cui la risposta è \(3\) e non \(8\). È la domanda del controfattuale («che cosa avrebbe cambiato la risposta?»), fatta però solo su ciò che si può aggiungere. E il tratto si cerca fra quelli che una mano scriverebbe davvero: trenta pixel accesi a caso qua e là ribaltano la risposta lo stesso, ma nessuno li riconoscerebbe come un otto.
È la differenza fra dire «è un tre per via di questi tratti» e «è un tre e non un otto perché manca questo». La seconda frase è il modo in cui le persone spiegano davvero le cose, e in medicina è la forma standard del ragionamento: un medico che esclude l’influenza non lo fa solo per quello che il paziente ha, lo fa anche per quello che non ha (febbre alta sì, ma nessun dolore muscolare e nessuna tosse). Una diagnosi si regge tanto sui sintomi presenti quanto su quelli attesi e assenti.
Il Contrastive Explanation Method [DCL+18] formalizza le due nozioni cercando, attorno all’istanza \(\mathbf{x}_0\), due perturbazioni minime di segno opposto.
Il positivo pertinente è la porzione minima di \(\mathbf{x}_0\) che, da sola, conserva la classificazione: si cerca \(\boldsymbol{\delta}\) sparso tale che \(f(\boldsymbol{\delta})\) dia la stessa classe di \(f(\mathbf{x}_0)\), con \(\boldsymbol{\delta}\) contenuto in \(\mathbf{x}_0\). Il negativo pertinente è la perturbazione minima additiva che cambia la classe: si cerca \(\boldsymbol{\delta}\) tale che \(f(\mathbf{x}_0 + \boldsymbol{\delta})\) dia una classe diversa, con \(\boldsymbol{\delta}\) di norma minima.
La formulazione usa una regolarizzazione elastica (\(L_1\) più \(L_2\)) per ottenere perturbazioni sparse e interpretabili, e opzionalmente un autoencoder addestrato sui dati come termine di penalità, che spinge la soluzione a restare sulla varietà dei dati plausibili invece di finire in una zona dello spazio che nessun esempio reale abita. È lo stesso vincolo di plausibilità già incontrato per i controfattuali, imposto qui in modo esplicito.
La parentela con i due metodi appena visti è stretta e conviene esplicitarla: il negativo pertinente è un controfattuale, cercato però solo fra le perturbazioni additive e presentato come «ciò che manca» invece che come «ciò che cambierebbe». Il positivo pertinente, invece, è parente dell’anchor, ma risponde alla domanda «che cosa basta» in un altro modo: un anchor fissa alcune condizioni e lascia che tutte le altre feature varino liberamente; il positivo pertinente spegne tutto il resto sulla baseline e cerca la porzione minima dell’input che conserva la classe da sola.
In pratica: i valori di Shapley calcolati da zero#
Esistono librerie che calcolano tutto questo in due righe. Qui calcoleremo i valori da zero, provando tutti gli ordini a uno a uno, come nell’esempio con 10, 30, 20 e 50; e poi ripeteremo i passaggi per intero a mano, con carta e penna. Stavolta però con tre colonne invece che due, il che cambia una cosa sola e conviene dirla subito: con due colonne gli ordini erano due, con tre diventano sei (la prima entrata si può scegliere in tre modi, la seconda nei due rimasti, la terza è obbligata: \(3 \times 2 \times 1\)).
Il modellino su cui lo faremo è una formula inventata, con tre colonne che chiameremo \(x_0\), \(x_1\) e \(x_2\): si numera da zero perché così fa Python, quindi la «colonna 0» è la prima. La formula è
Tre addendi. Il primo prende la prima colonna così com’è; il secondo prende la seconda e la raddoppia; il terzo moltiplica la prima per la terza, e quindi vale qualcosa solo se tutte e due sono diverse da zero. Quel terzo addendo è un’interazione, la stessa cosa che nell’esempio dei prestiti faceva arrivare a 50 invece che a 40, ed è il motivo per cui questa formula è stata scelta: è il caso in cui i meriti non sono ovvi.
Per «spegnere» una colonna useremo la più semplice delle tre scelte elencate sopra: al posto del suo valore vero inseriremo uno zero. Il caso da spiegare è quello in cui tutte e tre le colonne valgono \(1\); la risposta base, cioè quella a tutto spento, è \(f(0,0,0) = 0\). La proprietà da verificare alla fine è l’efficienza: la somma dei tre meriti deve fare esattamente la risposta vera meno la risposta base, cioè \(f(1,1,1) - f(0,0,0) = 4 - 0 = 4\).
import itertools
from math import factorial
import numpy as np

# Un modello giocattolo con un'interazione: la feature 2 "conta" solo con la 0
def f(x):
    return x[0] + 2.0 * x[1] + x[0] * x[2]

# istanza da spiegare e riferimento (baseline) su cui "spegnere" le feature assenti
x = np.array([1.0, 1.0, 1.0])
r = np.array([0.0, 0.0, 0.0])
n = len(x)

# valore della coalizione S: le feature in S prendono il valore di x, le altre di r
def v(S):
    z = r.copy()
    for i in S:
        z[i] = x[i]
    return f(z)

# valori di Shapley per forza bruta: media dei contributi marginali su TUTTI gli ordini
phi = np.zeros(n)
for perm in itertools.permutations(range(n)):
    S = []
    for i in perm:
        prima = v(S)            # coalizione prima di aggiungere i
        S = S + [i]
        dopo = v(S)             # coalizione dopo aver aggiunto i
        phi[i] += dopo - prima  # contributo marginale di i in questo ordine
phi /= factorial(n)             # media sugli n! ordini

print("valori di Shapley:", np.round(phi, 3))
print("somma dei phi:     ", round(float(phi.sum()), 3))
print("f(x) - f(base):    ", round(float(f(x) - f(r)), 3))  # assioma di efficienza
valori di Shapley: [1.5 2.  0.5]
somma dei phi:      4.0
f(x) - f(base):     4.0
Tre numeri: \(1{,}5\), \(2{,}0\) e \(0{,}5\). Da dove escono? Verrebbe da aspettarsi \(1\) e \(2\), che sono i due numeri scritti nella formula, e niente per la terza colonna, che un numero suo non ce l’ha. Il modo più pulito di capire perché non è così è rifare il conto con carta e penna, usando le quattro proprietà, una dopo l’altra.
Si comincia dall’additività, quella dei due punteggi calcolati a parte: un conto che è una somma si può spezzare, fare i conti sui pezzi e sommare i risultati. Qui i pezzi sono i tre addendi, e su ciascuno il merito si vede a occhio. I tre numeri fra parentesi sono i meriti delle tre colonne, nell’ordine.
\(x_0\) da solo. Accendere la prima colonna porta questo addendo da \(0\) a \(1\), in qualunque ordine, e le altre due colonne non lo toccano mai. Meriti: \((1,\;0,\;0)\).
\(2\,x_1\) da solo. Stessa cosa, ma il salto è di \(2\), e tocca alla seconda colonna. Meriti: \((0,\;2,\;0)\).
\(x_0 x_2\) da solo. Qui serve il conto vero. Questo addendo vale \(1\) se le colonne \(0\) e \(2\) sono accese entrambe, e \(0\) in tutti gli altri casi; la colonna \(1\) non lo tocca mai, quindi è un giocatore nullo e la si può togliere di mezzo, restando con un conto a due giocatori come quello dei prestiti. Se entra prima la \(0\): non aggiunge niente (l’altra è ancora spenta), poi entra la \(2\) e aggiunge \(1\). Se entra prima la \(2\): non aggiunge niente, poi entra la \(0\) e aggiunge \(1\). Media per la colonna \(0\): \((0+1)/2 = 0{,}5\). Media per la \(2\): uguale. Meriti: \((0{,}5,\;0,\;0{,}5)\).
Adesso si sommano colonna per colonna: la prima prende \(1 + 0 + 0{,}5 = 1{,}5\), la seconda \(0 + 2 + 0 = 2\), la terza \(0 + 0 + 0{,}5 = 0{,}5\). Sono i tre numeri stampati dal programma, ottenuti senza programma. E la terza colonna, che nella formula non aveva un numero suo, prende comunque mezzo punto: se l’è guadagnato tutto nell’interazione.
La simmetria è entrata nel terzo pezzo, e solo lì: dentro \(x_0x_2\) le due colonne fanno lo stesso mestiere, da qui il mezzo punto a testa, mentre nel conto intero no, e infatti prendono \(1{,}5\) e \(0{,}5\). È l’additività a permettere di spezzare, ed è solo dopo aver spezzato che la simmetria si può usare, nel pezzo in cui vale.
Resta l’efficienza, che è quella che il programma verifica nelle ultime due righe: \(1{,}5 + 2{,}0 + 0{,}5 = 4{,}0\), che è esattamente la risposta vera meno la risposta base. Il conto torna.
Un’ultima nota pratica sul costo, e conviene chiarire un punto che altrimenti confonde: la stessa fatica si può contare in due modi, gli ordini di ingresso oppure i gruppi di colonne da provare, e crescono a valanga tutti e due. Qui gli ordini sono sei e i gruppi otto. Con dieci colonne gli ordini superano i tre milioni; con venti sono più di due miliardi di miliardi; e con trenta i gruppi passano il miliardo, che è il numero citato all’inizio della sezione. Nella pratica quindi non si provano tutti: se ne prova un campione a caso, oppure si usa TreeSHAP quando il modello è fatto di alberi. La definizione, però, è questa.
Da ricordare
Una spiegazione locale riguarda una risposta sola, non il modello intero: «perché hanno detto no a me», non «che cosa conta in media». Un modello può essere intricato dappertutto e semplice qui accanto, come la strada di montagna che da vicino sembra dritta.
LIME fabbrica tanti casi-fantasma, chiede al modello che cosa risponderebbe per ciascuno, e su quella nuvola costruisce un modellino a somma, contando di più i fantasmi più simili al caso da spiegare. Su una tabella i fantasmi nascono sparsi, e a renderli vicini è solo quel peso; su una fotografia sono la stessa immagine con qualche pezzo spento. I numeri di quella somma sono la spiegazione. Funziona con qualunque modello, ma è instabile: rilanciato sullo stesso caso dà numeri diversi, e cambia anche a seconda di quanto largo si prende il vicinato e di come si è deciso di spezzettare il caso in parti.
I valori di Shapley (una formula del 1953, nata per dividere fra i soci il guadagno di un’impresa) ripartiscono fra le colonne lo scarto fra la risposta su questo caso e la risposta base, cioè quella che il modello dà quando non sa niente. La quota di ogni colonna è la media di quanto aggiunge, su tutti gli ordini in cui le colonne possono entrare in campo: è il conto con 10, 30, 20 e 50.
Sono l’unico modo di dividere che rispetta quattro richieste ragionevoli: il conto torna senza avanzi; chi fa lo stesso lavoro prende uguale; chi non aggiunge mai niente prende zero; e un conto che è una somma si può spezzare in pezzi, fare i conti sui pezzi e sommare. Con un però: prima bisogna stabilire che cosa significa «non far sapere» una colonna al modello, e deciderlo in un modo o nell’altro sposta la risposta base, e con essa tutti i meriti.
SHAP è il modo di calcolarli in fretta, perché provare tutte le combinazioni è impossibile: ne prova solo alcune, se il modello è una scatola chiusa qualsiasi, oppure sfrutta la forma degli alberi per farlo in modo esatto. Il risultato si legge nel grafico a cascata, una barra per colonna. Con una riserva: spegnendo una casella per volta si finisce per chiedere al modello di clienti che non esistono, e fra due colonne che dicono la stessa cosa il merito va tutto a quella che il modello guarda.
I controfattuali dicono la modifica più piccola che avrebbe ribaltato la risposta («se il tuo reddito fosse stato 30 000 invece di 24 000»): una via d’uscita concreta, purché resti vicina alla situazione reale e riguardi qualcosa su cui si può davvero agire. Da solo, però, indica sempre la stessa leva: conviene chiederne alcuni, premiando quelli diversi fra loro. E vale per il modello che l’ha prodotto, non per un altro bravo uguale.
Gli anchor sostituiscono i numeri con una regola («finché il reddito supera 30 000, è sì») e ne dichiarano i limiti: la precisione, quanto spesso azzecca la risposta del modello, e la copertura, su quanti casi si applica. Dicono fin dove la risposta non cambia, che è la cosa che LIME non dice. Attenzione: azzeccare il modello non vuol dire aver ragione.
I positivi e i negativi pertinenti sono le due domande del tre e dell’otto: quali tratti bastano perché resti un tre, e quale tratto, se ci fosse, lo farebbe diventare un otto. La seconda è il modo in cui le persone spiegano davvero le cose, ed è la forma del ragionamento medico.
Da ricordare
Una spiegazione locale riguarda una predizione \(f(\mathbf{x}_0)\), non l’intero modello: risponde a «perché questo caso?» dove l’importanza globale della sezione sui modelli trasparenti rispondeva a «cosa conta in media?».
LIME [RSG16] approssima il modello con un surrogato lineare definito su una rappresentazione interpretabile binaria (superpixel, parole, intervalli) e adattato a punti perturbati pesati per prossimità: la località la porta il peso \(\pi_{\mathbf{x}_0}\), non il campionamento. È model-agnostic ma instabile, sensibile alla larghezza del vicinato e alla segmentazione scelta; l’instabilità si misura rilanciandolo e confrontando le feature in testa.
I valori di Shapley (teoria dei giochi, 1953) ripartiscono fra le feature lo scarto fra la predizione \(f(\mathbf{x}_0)\) e un valore base, cioè quanto risponde il modello quando delle feature non sa nulla; la quota di ciascuna è la media dei suoi contributi marginali su tutti gli ordini di ingresso. Sono l’unica attribuzione che soddisfa efficienza, simmetria, giocatore nullo e additività, una volta stabilito che cosa significa «non far sapere» una feature al modello: deciderlo in un modo o nell’altro sposta il valore base, e con esso le attribuzioni.
SHAP [LL17] li stima in modo efficiente, KernelSHAP (agnostico) e TreeSHAP (esatto per gli alberi), con la proprietà di consistenza; si legge col grafico a cascata (waterfall), il force plot e il beeswarm. KernelSHAP approssima \(v(S)\) con l’attesa marginale, cioè assumendo le feature indipendenti: con feature correlate le attribuzioni divergono da quelle condizionali [AJLoland21].
I controfattuali [WMR17] indicano la modifica minima e azionabile che ribalterebbe la decisione; sono lo stesso problema matematico degli esempi avversari [GSS15], con intento opposto: spiegare invece di ingannare. Con distanza \(L_1\) e modello lineare il minimo muove una voce sola; DiCE [MST20] ne cerca \(k\) insieme, premiando la diversità con \(\det\mathbf{K}\). Sotto molteplicità predittiva un controfattuale può non valere per un modello quasi equivalente [PBK20].
Gli anchor [RSG18] sostituiscono i pesi con una regola e ne dichiarano i limiti: precisione (quanto spesso la regola azzecca il modello, garantita con confidenza \(1 - \delta\)) e copertura (su quanti casi si applica). Dicono fin dove la risposta non cambia, cosa che LIME non fa.
Il CEM [DCL+18] distingue i positivi pertinenti (che cosa basta perché la risposta sia questa) dai negativi pertinenti (che cosa, assente, la tiene ferma). Il negativo pertinente è un controfattuale additivo; il positivo pertinente è la porzione minima che basta da sola, col resto cancellato, mentre un anchor fissa alcune condizioni e lascia variare tutto il resto.