


Dal notebook agli script#
Un notebook è il quaderno interattivo con cui si lavora quasi sempre quando si sperimenta: una pagina divisa in celle, ciascuna con dentro un pezzo di codice, che si eseguono una alla volta premendo un tasto e che lasciano il risultato stampato lì sotto. La comodità è enorme: si prova una riga, si guarda il numero, si cambia. E il difetto nasce esattamente da lì, perché le celle si possono eseguire in qualunque ordine, anche in uno diverso da quello in cui sono scritte.
C’è un esperimento che ogni tanto conviene fare sul proprio notebook preferito: premere Restart & Run All, cioè «ricomincia da zero ed esegui tutto in ordine», e guardare che cosa succede. Molto spesso non succede niente di buono. La cella 43 usa una variabile definita nella cella 12, che nel frattempo è stata cancellata; la funzione buona è la terza versione, ma le prime due sono ancora lì sotto; il modello che ha dato il risultato migliore è stato addestrato con un learning rate che nessuno ha annotato, e che ora non è più nel codice. La Fig. 7.14 mette i due ordini a confronto, quello dei clic e quello delle righe. Il notebook ha fatto il suo mestiere di laboratorio, e a un certo punto il laboratorio va trasformato in un prodotto.
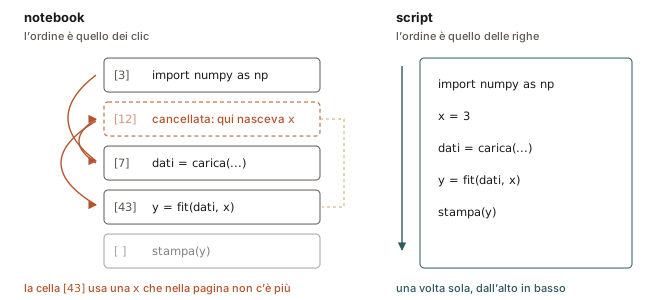
Fig. 7.14 Il numero fra parentesi quadre è l’ordine in cui la cella è stata eseguita
l’ultima volta, e le frecce lo seguono: risalgono e ridiscendono la pagina,
che invece si legge dall’alto in basso. La cella [43] gira perché una cella
cancellata, la [12], aveva lasciato la sua variabile nella memoria: chi
rilegge la pagina non trova più da dove venga. Nello script quella riga c’è,
ed è la seconda.#
Per rendere un esperimento ripetibile, restando dentro PyTorch e senza aggiungere strumenti, bastano cinque file di Python semplice e un comando che si lancia dal terminale, cioè quella finestra in cui, invece di cliccare, si scrivono comandi e il computer risponde. È il primo passo verso quello che nel mestiere si chiama «mandare un modello in produzione», cioè metterlo al lavoro per qualcuno che non l’ha scritto: la sezione dal notebook alla produzione, nel capitolo sull’MLOps, riprende il discorso da qui.
Il laboratorio e il prodotto#
Un notebook è una cucina di prova: assaggi, aggiungi, ributti, tieni tre pentole sul fuoco. È lo strumento giusto per capire se un’idea funziona, proprio perché non ti obbliga a essere ordinato. Quello che non resta è la pentola. Nella pagina salvata ci sono i piatti riusciti e i numerini che dicono in che ordine hai acceso i fornelli l’ultima volta; non che cosa bolliva dentro, e nemmeno le prove che nel frattempo hai buttato via. Uno script è invece la ricetta scritta: chiunque la legga ottiene lo stesso piatto, nello stesso ordine, senza doverti chiedere niente.
Il segnale che è arrivato il momento di passare dall’uno all’altro è sempre lo
stesso: quando cominci a rilanciare la stessa cosa cambiando un numero.
Cinque prove con cinque learning rate diversi, fatte modificando a mano una
cella, sono cinque esecuzioni di cui domani non ricorderai la differenza. Le
stesse cinque prove lanciate da terminale con --lr 0.01, --lr 0.001 e così
via restano scritte nella cronologia del terminale: sono un esperimento, non
un ricordo.
E una ricetta scritta si maneggia in modi che una cucina non permette. Metti accanto quella di ieri e quella di oggi, e in una riga vedi che cosa è cambiato, il sale da cinque grammi a otto; due fotografie della cucina a fine serata non te lo direbbero mai, e il file del notebook, che si porta dentro anche tutto quello che è uscito dal forno, somiglia più alle fotografie che alla ricetta. La ricetta puoi consegnarla a qualcuno che la esegue ogni mattina alle sei senza che tu sia lì. E puoi provare un passaggio solo, la salsa, senza cucinare tutta la cena, perché quel passaggio sta scritto per conto suo.
La differenza sostanziale è tra stato implicito e stato esplicito. Nel notebook lo stato vive nel kernel: il documento salvato registra per ogni cella il numero della sua ultima esecuzione, non la storia delle esecuzioni né le celle nel frattempo cancellate, quindi il documento non basta a dire come si riottengono i suoi output (riproducibile lo è solo se lo si riesegue da kernel pulito, dall’alto in basso, e nulla nel file dice che è andata così). Uno script ha un unico punto d’ingresso, un ordine totale delle istruzioni, e tutto ciò che varia passa dagli argomenti della riga di comando: input, output e parametri sono dichiarati.
Ne discendono tre proprietà che nello script vengono gratis: si mette sotto
controllo di versione in modo leggibile (il .ipynb è un JSON con dentro gli
output, e un diff è illeggibile); si mette in una pipeline di CI o in uno
scheduler; e si testa, perché ogni funzione è importabile da un test senza
eseguire tutto il resto.
Cinque file, cinque responsabilità#
La divisione che segue è quella del capitolo PyTorch Going Modular del corso di Daniel Bourke (Learn PyTorch for Deep Learning): i nomi dei file sono i suoi, quelli delle funzioni sono adattati. Non c’è nulla di magico: è la stessa struttura del capitolo, resa file.
progetto/
├── data_setup.py     # dai file ai DataLoader
├── model_builder.py  # la definizione del modello
├── engine.py         # un'epoca di addestramento, un'epoca di valutazione
├── utils.py          # salvataggio, semi, funzioni di servizio
└── train.py          # il punto d'ingresso: mette insieme gli altri quattro
Il pezzo centrale è engine.py: il training loop della sezione
sull’addestramento, estratto in due funzioni che non sanno
nulla del problema specifico e che quindi si riusano ovunque.
# engine.py
import torch

def passo_addestramento(modello, loader, criterio, ottimizzatore, device):
    """Un'epoca di addestramento. Restituisce (perdita media, accuratezza)."""
    modello.train()
    perdita_tot, corretti, totale = 0.0, 0, 0

    for X, y in loader:
        X, y = X.to(device), y.to(device)
        logit = modello(X)
        perdita = criterio(logit, y)

        ottimizzatore.zero_grad()
        perdita.backward()
        ottimizzatore.step()

        perdita_tot += perdita.item() * X.size(0)   # .item(): niente grafo trattenuto
        corretti += (logit.argmax(dim=1) == y).sum().item()
        totale += X.size(0)

    return perdita_tot / totale, corretti / totale


@torch.no_grad()                                    # decoratore: niente gradienti qui dentro
def passo_valutazione(modello, loader, criterio, device):
    """Un'epoca di valutazione: stessi argomenti meno l'ottimizzatore, che qui
    non serve perché nessun peso viene aggiornato."""
    modello.eval()
    perdita_tot, corretti, totale = 0.0, 0, 0

    for X, y in loader:
        X, y = X.to(device), y.to(device)
        logit = modello(X)
        perdita_tot += criterio(logit, y).item() * X.size(0)
        corretti += (logit.argmax(dim=1) == y).sum().item()
        totale += X.size(0)

    return perdita_tot / totale, corretti / totale
Due dettagli che pagano subito. La moltiplicazione * X.size(0) serve perché
la loss restituita da PyTorch è già una media sul batch, cioè sugli esempi che
hanno appena attraversato la rete, e la media delle medie non è la media. Con i
numeri: due batch, il primo con dieci esempi che sbagliano in media di \(1\), il
secondo con due esempi che sbagliano in media di \(4\). La media vera sui dodici
esempi è \((10 \cdot 1 + 2 \cdot 4)/12 = 1{,}5\); la media delle due medie è
\((1 + 4)/2 = 2{,}5\), cioè due terzi più alta del vero, perché conta i due
esempi del secondo batch come se fossero dieci. Moltiplicare ciascuna media per
il numero di esempi del suo batch, sommare, e dividere alla fine per il totale
rimette le cose a posto. E capita quasi sempre: a meno di chiedere il
contrario, il DataLoader consegna anche l’ultimo batch, più piccolo degli
altri quando gli esempi non si dividono in parti uguali.
Il secondo dettaglio è la riga @torch.no_grad() scritta sopra la seconda
funzione. Quella chiocciola in Python si chiama decoratore: è una riga che
avvolge la funzione e ne cambia il comportamento senza toccarne il corpo. Qui
dice che dentro la funzione autograd non registra il grafo dei calcoli (il
«registratore» della sezione sui tensori, che serve a
ripercorrere i conti all’indietro), e in valutazione il grafo non serve, perché
nessun peso viene corretto. Il decoratore risparmia anche di doversi
ricordare, a ogni chiamata, il blocco with torch.no_grad(): che fa la stessa
cosa a mano. La funzione è una valutazione, e non può essere altro.
Il punto d’ingresso#
train.py è l’unico file che si lancia, e l’unico che conosce i valori
concreti. Tutto ciò che potrebbe cambiare da un esperimento all’altro diventa
un argomento della riga di comando.
Leggendolo si incontrano dei nomi che qui non sono scritti da nessuna parte,
data_setup.crea_dataloader e model_builder.CNNSemplice: vengono dagli altri
due file, quelli che costruiscono i DataLoader e il modello. Nel primo ci
sono le cose della sezione sui dati; nel secondo c’è un
nn.Module come quello della sezione sui moduli, con una rete
convoluzionale al posto dei soli strati nn.Linear (la CNN del nome è la
sigla inglese di rete convoluzionale). Le convoluzioni arrivano più avanti,
nella sezione sulle reti convoluzionali: qui basta sapere che CNNSemplice è un
modulo che trasforma immagini in punteggi. È esattamente il punto della
divisione in file: train.py non ha bisogno di sapere come sono fatti dentro,
gli basta chiamarli per nome.
# train.py
import argparse
import torch
from torch import nn

import data_setup, engine, model_builder, utils

def main() -> None:
    p = argparse.ArgumentParser(description="Addestra un classificatore di immagini.")
    p.add_argument("--dati", type=str, required=True,
                   help="cartella con addestramento/ e test/")
    p.add_argument("--epoche", type=int, default=10)
    p.add_argument("--batch", type=int, default=32)
    p.add_argument("--lr", type=float, default=1e-3)
    p.add_argument("--unita-nascoste", type=int, default=128)
    p.add_argument("--seme", type=int, default=42)
    p.add_argument("--uscita", type=str, default="modelli/modello.pt")
    args = p.parse_args()

    utils.fissa_seme(args.seme)
    device = "cuda" if torch.cuda.is_available() else "cpu"

    train_loader, test_loader, classi = data_setup.crea_dataloader(
        radice=args.dati, batch_size=args.batch)

    modello = model_builder.CNNSemplice(
        unita_nascoste=args.unita_nascoste, n_classi=len(classi)).to(device)

    criterio = nn.CrossEntropyLoss()
    ottimizzatore = torch.optim.Adam(modello.parameters(), lr=args.lr)

    for epoca in range(args.epoche):
        pt, at = engine.passo_addestramento(modello, train_loader, criterio,
                                            ottimizzatore, device)
        pv, av = engine.passo_valutazione(modello, test_loader, criterio, device)
        print(f"epoca {epoca+1:>2}/{args.epoche} | "
              f"train perdita {pt:.4f} acc {at:.3f} | "
              f"test perdita {pv:.4f} acc {av:.3f}")

    utils.salva_modello(modello, ottimizzatore, args.epoche, args.uscita,
                        classi=classi, argomenti=vars(args))

if __name__ == "__main__":      # eseguito solo se si lancia questo file
    main()
A trasportare i valori da fuori a dentro il programma è argparse, la parte di
Python che legge quello che si è scritto nel terminale dopo il nome del file e
lo consegna al codice sotto forma di numeri e di parole. Ogni add_argument
dichiara una manopola: come si chiama da fuori (--lr), di che tipo è il
valore, e quanto vale se nessuno la tocca. In quest’ultimo campo si incontra
1e-3, che è il modo in cui i programmi scrivono \(0{,}001\): si legge «uno per
dieci alla meno tre», cioè uno diviso mille. Da terminale, un esperimento
diventa quindi una riga:
python train.py --dati dati/ --epoche 20 --lr 0.001
python train.py --dati dati/ --epoche 20 --lr 0.0001 --unita-nascoste 256
La riga if __name__ == "__main__": è la più misteriosa del blocco e ha una
spiegazione semplice: dice «esegui main() soltanto se qualcuno ha lanciato
questo file direttamente, non se un altro file è venuto a prendersi qualcosa da
qui». Senza, aprire train.py da un altro programma per riusarne una funzione
farebbe partire un intero addestramento senza che nessuno l’abbia chiesto.
Ce n’è anche un motivo più concreto, ed è il tranello degli aiutanti del
DataLoader già incontrato nella sezione sui dati: dove
ogni aiutante rilegge da capo il file da cui è nato (Windows e macOS, e da
Python 3.14 anche Linux), senza quella riga ognuno farebbe ripartire
l’addestramento, e Python fermerebbe tutto con un errore.
Le manopole da terminale bastano finché sono una manciata. Quando diventano quaranta, con degli incastri (se il modello è questo, quell’altra manopola non vuol dire niente) e con valori che cambiano da un computer all’altro, la riga da scrivere diventa lunga un metro. Allora si scrivono tutte su un foglio, un file di configurazione, che si tiene insieme al codice. E il foglio ricorda meglio. La cronologia del terminale è di quella macchina e di quell’utente, e con l’uso si accorcia da sé, mentre il foglio resta lì e chiunque lo può rileggere.
L’ultima riga di main() salva. E salva più dei soli pesi: insieme a quelli
finiscono nel file i nomi delle classi, tutte le manopole con cui è stato
lanciato l’esperimento, e la memoria dell’ottimizzatore vista nella sezione sul
training loop. È il gesto che distingue un modello utile da
un file misterioso: fra sei mesi quel .pt, da solo, non direbbe né che cosa
predice, né come è stato ottenuto, né da dove ripartire.
Nel file, però, ci vanno numeri e parole e nient’altro. Dentro un file si può mettere un biglietto oppure un congegno: il biglietto lo legge chiunque lo trovi, il congegno per dire quello che sa deve prima essere messo in funzione. E in un file di questi il congegno esiste davvero, perché ci si possono infilare delle istruzioni: aprirlo vuol dire lasciarle girare sul proprio computer, quindi fidarsi di chi l’ha spedito. PyTorch, da qualche versione, quando ne apre uno prende i numeri e le parole e si ferma davanti al resto, a meno di dichiarare, nella riga che lo apre, che di quel file ci si fida. Le manopole quindi finiscono lì dentro come un semplice elenco di nomi e valori.
argparse fa parte della libreria standard e per un progetto singolo basta.
Quando la configurazione cresce (decine di parametri, combinazioni annidate,
varianti per ambiente), si passa a un sistema di configurazione a file (YAML
più dataclass, oppure Hydra), che rende l’intera configurazione un artefatto
versionabile invece di una stringa nella cronologia della shell, da conservare
accanto a codice, dati e modello come in dal notebook alla
produzione.
Da PyTorch 2.6 torch.load usa weights_only=True come default, quindi un
file che contiene oggetti Python arbitrari va ricaricato con
weights_only=False, o, meglio, salvato con dentro solo tipi elementari, come
qui: vars(args) è un dizionario di stringhe e numeri, non un Namespace,
proprio per questo.
Ed ecco la funzione che salva, che mette in fila tutto quello che deve entrare in un file per riprendere (un checkpoint, nel gergo): i pesi, lo stato dell’ottimizzatore, l’epoca raggiunta, i nomi delle classi e la configurazione.
# utils.py
import pathlib, torch

def salva_modello(modello, ottimizzatore, epoca, percorso, classi, argomenti):
    """Un checkpoint completo: per *usare* il modello e per *riprendere* il lavoro."""
    percorso = pathlib.Path(percorso)
    percorso.parent.mkdir(parents=True, exist_ok=True)
    torch.save({"pesi": modello.state_dict(),
                "ottimizzatore": ottimizzatore.state_dict(),
                "epoca": epoca,
                "classi": classi,
                "config": argomenti}, percorso)
Delle cinque voci che finiscono nel file, quelle che di solito mancano sono
"ottimizzatore" ed "epoca", ed è la distinzione già vista nella sezione
sul training loop: senza lo stato dell’ottimizzatore il
file serve a usare il modello, non a riprendere l’addestramento.
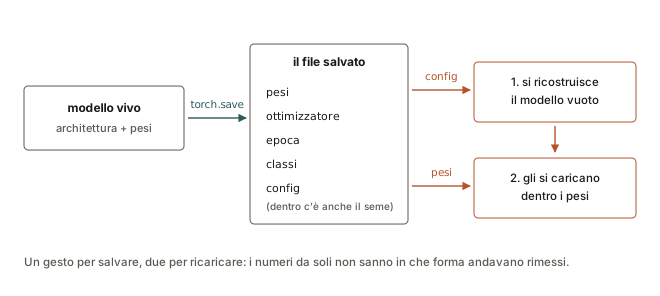
Fig. 7.15 Salvare i pesi non basta. Nel file finisce solo un elenco di numeri: per rimetterli al loro posto serve un modello fatto esattamente come quello di partenza, e quindi la configurazione va salvata insieme.#
Il salvataggio parte da un modello vivo e produce numeri, e sembra facile; il ricaricamento deve fare il contrario, e i numeri da soli non sanno dire in che forma andavano rimessi. Questa asimmetria, disegnata in Fig. 7.15, è una fonte frequente di errori di ricaricamento, ed è la ragione per cui la configurazione viaggia nello stesso file dei pesi: dentro c’è anche il seme, che di quella configurazione è una voce come le altre. I due gesti del ricaricamento, in codice, sono la ricostruzione del modello dalla configurazione e il caricamento dei pesi:
# utils.py (continua)
import model_builder

def carica_modello(percorso, device="cpu"):
    """Il gesto inverso: ricostruisce il modello e ci rimette i pesi."""
    stato = torch.load(percorso, map_location=device)  # solo tipi elementari
    modello = model_builder.CNNSemplice(
        unita_nascoste=stato["config"]["unita_nascoste"],
        n_classi=len(stato["classi"])).to(device)
    modello.load_state_dict(stato["pesi"])
    return modello.eval(), stato["classi"]
map_location dice dove mettere i tensori mentre li legge: senza, un file
salvato da una scheda grafica non si apre su una macchina che non ce l’ha. La
funzione restituisce il modello già in eval(), pronto a rispondere; per
riprendere l’addestramento servono anche stato["ottimizzatore"] e
stato["epoca"], come nella sezione sul training loop.
Riproducibilità: fissare il caso#
Un risultato che cambia a ogni esecuzione, e che nessuno può rifare uguale,
non si può controllare. Il minimo per fissare il caso sta in poche righe, ed è
la funzione che train.py chiama per prima, prima ancora di costruire il
modello e i DataLoader: se il caso lo si fissa dopo che i pesi sono già stati
sorteggiati, non si è fissato niente.
Il seme è quello già incontrato nella sezione su NumPy: il numero da cui parte la formula che produce una sequenza che sembra casuale. Stesso seme, stesso punto di partenza, stessa sequenza, e quindi stessi pesi iniziali e stesso ordine di mescolamento dei dati: sulla stessa macchina e con le stesse versioni delle librerie, lo stesso risultato, salvo le ultime cifre dei conti fatti su una scheda grafica.
Le righe sono tre perché ogni libreria ha la sua sequenza, e vanno avvisate tutte: quella di Python, quella di NumPy (che tante librerie di dati usano) e quella di PyTorch, che con una riga sola semina il processore e tutte le schede grafiche insieme.
# utils.py
import random
import numpy as np
import torch

def fissa_seme(seme: int = 42) -> None:
    random.seed(seme)             # librerie standard
    np.random.seed(seme)          # NumPy
    torch.manual_seed(seme)       # PyTorch: processore e schede grafiche
Il seme dice da quale foglio di estrazioni leggere, e quel foglio è già scritto riga per riga. Chi riparte dallo stesso foglio pesca gli stessi numeri nello stesso ordine, e rifà lo stesso esperimento fino allo stesso numero finale. Un foglio solo, però, può essere fortunato, e allora non dice se il modello è buono. Né dice se una modifica l’ha migliorato: cambi il learning rate, e anche con lo stesso foglio il modello percorre un’altra strada, così uno scarto piccolo può venire dal foglio più che dal learning rate. Per saperlo rifai la prova con tre o cinque fogli diversi, confronti le medie, e magari anche quanto ballano i valori.
C’è poi una cosa che nessun foglio garantisce: le ultime cifre. Una somma lunga, fatta in ordini diversi, dà totali diversi, e non serve sbagliare niente, basta che a ogni passaggio si arrotondi. Un conto in banca tiene i centesimi, e matura quattro decimi di centesimo di interessi al giorno. Accreditati giorno per giorno, spariscono ogni volta nell’arrotondamento, e dopo un anno il saldo è quello di partenza; sommati prima fra loro fanno un euro e quarantasei, e il saldo si muove. Stessi numeri, ordine diverso, totale diverso.
Una scheda grafica lavora proprio così, spezzando la somma fra migliaia di calcoli che avvengono nello stesso momento e consegnano appena hanno finito, e chi consegna per primo non è sempre lo stesso. Le differenze sono nelle ultime cifre, molto più piccole di quelle del conto in banca; ma le somme di un addestramento sono milioni, e alla fine due esecuzioni dello stesso codice, con lo stesso seme e sulla stessa macchina, non danno più lo stesso numero fino all’ultima cifra.
Per questo ci sono due interruttori. Il primo,
torch.use_deterministic_algorithms(True), pretende che le somme si facciano
sempre nello stesso ordine. Il secondo, torch.backends.cudnn.benchmark, va
lasciato spento, com’è di partenza. Acceso, fa provare alla macchina più modi
di fare lo stesso conto e tiene il più veloce; quale vinca dipende da com’è
messa la scheda quella sera, e la gara rende soltanto se poi lo stesso conto si
ripete mille volte identico. Con tutti e due (e, sulla scheda grafica, con
un’impostazione in più per le moltiplicazioni, scritta fuori dal programma,
senza la quale il primo interruttore ferma tutto alla prima), i numeri tornano
uguali fino all’ultima cifra, e si paga: di qualche operazione la versione
ordinata non esiste e il programma si ferma dicendolo, il resto va più piano. È
un prezzo che si accetta quando si dà la caccia a un errore e serve sapere che
fra due esecuzioni è cambiata soltanto la cosa che si è cambiata.
Poi ci sono gli aiutanti che preparano i vassoi. A ciascuno PyTorch consegna da sé un foglio diverso, e lo stesso da una sera all’altra: così i ritagli e gli specchi cambiano da un aiutante all’altro e si ripetono uguali a ogni esecuzione. Un generatore di numeri a caso creato nel tuo codice, invece, è un foglio che PyTorch non conosce. Se lo prepari una volta sola, fuori dalla parte che costruisce il singolo esempio, ogni aiutante ne riceve una fotocopia e la legge dalla prima riga: tutti pescano gli stessi numeri nello stesso ordine, e i vassoi si somigliano tutti. Il rimedio è dare a ciascuno il suo foglio, scritto quando l’aiutante comincia a lavorare.
Anche un sorteggio che conta, come la divisione dei dati, merita un foglio tutto suo. Se pesca da quello comune, basta che qualcuno aggiunga un’estrazione prima di lui perché le righe scalino di un posto, e la divisione cambia senza che nessuno l’abbia toccata. Fra versioni diverse delle librerie, poi, o fra macchine diverse, nemmeno lo stesso seme promette gli stessi numeri: chi riporta un risultato scrive anche con quali versioni l’ha ottenuto.
Fissare i semi rende riproducibile la sequenza pseudocasuale, ma non basta a garantire risultati bit-identici su GPU: molti kernel CUDA usano riduzioni atomiche il cui ordine di somma varia tra esecuzioni, e in virgola mobile l’addizione non è associativa. Il determinismo completo si chiede esplicitamente, e si paga:
torch.use_deterministic_algorithms(True)   # errore se un'op non ha versione deterministica
torch.backends.cudnn.benchmark = False     # niente autotuning degli algoritmi
# e, per cuBLAS, la variabile d'ambiente CUBLAS_WORKSPACE_CONFIG=:4096:8
cudnn.benchmark = True (spento di default, si accende per le prestazioni)
prova più algoritmi di convoluzione e sceglie il più veloce per quella forma
di input: è ottimo quando le forme sono costanti, controproducente quando
cambiano di continuo, e non deterministico in entrambi i casi. Anche i
DataLoader con più worker richiedono attenzione, ma non per i tre generatori
di prima: quelli il loader li semina già da sé, uno per worker, a partire dal
seme globale. Servono generator e worker_init_fn per gli oggetti che il
loader non conosce, tipicamente un np.random.Generator costruito a livello di
modulo, che altrimenti viene copiato identico in ogni processo.
fissa_seme, d’altra parte, è il minimo. Le estrazioni che non devono
dipendere dallo stato globale ricevono un generatore esplicito
(torch.Generator().manual_seed(seme) a random_split,
np.random.default_rng(seme) al posto di np.random.seed); l’ordine di
iterazione degli insiemi di stringhe dipende da PYTHONHASHSEED, che va
fissato nell’ambiente prima di avviare l’interprete. Nemmeno così il risultato
è garantito fra versioni di PyTorch, fra commit o fra piattaforme, e la
documentazione di PyTorch lo dice esplicitamente (Reproducibility): chi
pubblica una tabella di risultati scrive anche con quali versioni l’ha
prodotta. In pratica, nella ricerca si punta alla riproducibilità statistica
(stessa distribuzione di risultati su più semi) e si riserva il determinismo
bit-a-bit ai casi in cui serve davvero, come il debugging di una regressione.
Quando non modularizzare#
Il consiglio che si sente più spesso è l’opposto, ma si può modularizzare troppo presto. Un’idea che non si sa ancora se funzioni non ha bisogno di cinque file, di un parser degli argomenti e di un’impalcatura di oggetti; ha bisogno di essere provata in venti minuti. La divisione in moduli (qui i file del progetto, non i moduli della rete) è un investimento che si ripaga quando qualcosa si ripete, e non prima.
La regola pratica è quella delle tre volte: la prima volta si scrive nel
notebook; la seconda si copia e incolla, borbottando; la terza si estrae una
funzione. Il numero conta meno del borbottio, che è il segnale vero, e la
misura è quella piccola: una funzione, non un file. I file vengono dopo, e
ciascuno nasce quando le funzioni che ospita sono diventate un mestiere a sé
(preparare i dati, costruire il modello, addestrare). E il passaggio non è mai
tutto-o-niente: si può tenere il notebook come interfaccia di esplorazione e
importarvi engine.py, ottenendo il meglio delle due cose (grafici e assaggi
nel notebook, logica stabile e testabile nei file).
Cinque file, un comando, un seme fissato: è il minimo perché un esperimento smetta di essere un ricordo.
Da ricordare
Il notebook è una cucina di prova, lo script è la ricetta scritta. Il segnale che è ora di passare dall’uno all’altro è sempre lo stesso: «sto rilanciando la stessa cosa cambiando un numero».
La divisione standard è in cinque file, uno per mestiere: i dati, il modello, il giro di addestramento, le funzioni di servizio, e il file che si lancia. Il terzo non sa nulla del problema, e per questo si riusa ovunque.
Quando si sommano gli errori di più mazzetti bisogna pesarli per quanti esempi contengono: la media delle medie non è la media.
Tutto ciò che cambia da un esperimento all’altro si passa da terminale, non modificando il codice: così l’esperimento è una riga, e quando le manopole diventano tante quella riga si scrive su un file di configurazione, che resta.
Nel file salvato vanno i pesi, i nomi delle classi, la configurazione e la memoria dell’ottimizzatore: senza, fra sei mesi quel file non dice né che cosa predice, né come è stato ottenuto, né da dove ripartire.
Fissare il seme serve a rifare lo stesso esperimento. Per dire che una modifica ha migliorato il modello, o che il modello è buono, si ripete con tre o cinque semi diversi e si confrontano le medie.
Non dividere in file troppo presto: la regola delle tre volte.
Da ricordare
Il notebook è un laboratorio (stato implicito, ordine invisibile), lo script è un prodotto (un punto d’ingresso, tutto dichiarato). Il segnale del passaggio è: «sto rilanciando la stessa cosa cambiando un numero».
La divisione standard è in cinque file:
data_setup,model_builder,engine,utils,train(doveenginecontiene il loop, indipendente dal problema).Nell’accumulo di metriche:
perdita.item() * X.size(0), perché la loss di PyTorch è già una media sul batch.argparsepiùif __name__ == "__main__":(quest’ultimo indispensabile anche per i worker delDataLoaderquando nascono per spawn o forkserver).Si salvano pesi, classi, configurazione e stato dell’ottimizzatore insieme: uno
state_dictnudo fra sei mesi non dice che cosa predice, e da solo non permette di riprendere.Fissare i semi rende ripetibile un’esecuzione; per confrontare due configurazioni si ripete con più semi (riproducibilità statistica). Il determinismo bit-a-bit su GPU si chiede a parte e si paga in prestazioni, e niente è garantito fra versioni e piattaforme.
Non modularizzare troppo presto: la regola delle tre volte.
Ripetibilità e verifica servono anche nel lavoro opposto: rifare l’esperimento di qualcun altro partendo da un articolo scientifico, dove nessuno ha preparato né gli script né i semi. È il metodo per replicare un paper.