


Evoluzioni e applicazioni#
Le prime immagini generate da una GAN, nel 2014, erano cifre scritte a mano di \(28\times28\) pixel, volti in bianco e nero di \(48\times48\) e miniature a colori di \(32\times32\): riconoscibili, ma nessuno le avrebbe scambiate per fotografie. Cinque anni dopo un sito, thispersondoesnotexist.com, sforna a ripetizione volti fotorealistici di persone che non esistono. In mezzo c’è una sequenza di idee, quasi una all’anno, che hanno trasformato un’intuizione fragile in una delle famiglie di modelli generativi più influenti del decennio. Ripercorriamola, seguendo il filo delle idee più che il calendario.
Le due reti restano quelle, il generatore e il discriminatore, e ogni variante si legge come una modifica al regolamento del loro duello. Di volta in volta cambia il modo in cui le due reti guardano le immagini, o che cosa il generatore riceve oltre al rumore, o in che momento gli si danno le istruzioni, o che cosa deve conservare mentre dipinge; e all’ultima tappa cambia perfino lo scopo del duello.
DCGAN: dare occhi alla rete#
La prima GAN usava soprattutto strati completamente connessi (fully-connected), in cui ogni numero in uscita dipende da tutti i numeri in entrata: per uno strato così un’immagine è un vettore senza struttura spaziale, e che due pixel siano vicini non entra nel calcolo. Nelle immagini naturali, invece, pixel vicini sono fortemente correlati (un pezzo di cielo è azzurro tutto intorno), ed è la struttura che le convoluzioni sfruttano per costruzione. Una variante convoluzionale c’era già nel paper del 2014, ma addestrarla era instabile e mancava una ricetta riproducibile; la ricetta arriva a fine 2015 con la DCGAN (Deep Convolutional GAN) di Radford, Metz e Chintala [RMC16].
L’idea è dare alla rete lo strumento giusto per «vedere»: far scorrere sopra l’immagine, casella per casella, una piccola griglia di numeri che reagisce a una certa forma (un bordo verticale, una macchia chiara su fondo scuro, la grana di un tessuto). Quella griglietta si chiama filtro, e l’operazione è la convoluzione; quali numeri mettere nei filtri è precisamente ciò che la rete impara. È il discriminatore ad analizzare l’immagine così, con gli stessi filtri di un classificatore qualsiasi; il generatore fa il percorso inverso, e parte da un pugno di numeri casuali per «gonfiarli» fino a un’immagine intera.
Gonfiare come, se i numeri di partenza sono un centinaio e i puntini d’arrivo qualche migliaio? Il primo passaggio dispone quel centinaio di numeri in una griglia minuscola, \(4\times4\), ma spessa: in ogni casella non un valore solo, bensì una pila di valori. Da lì in poi ogni passaggio raddoppia il lato: da \(4\times4\) a \(8\times8\), poi \(16\times16\), fino ai \(64\times64\) che erano la taglia della DCGAN, mentre la pila si assottiglia. I puntini in più sono decisi e non copiati da nessuna parte: dove il vecchio puntino era uno solo, il passaggio successivo ne mette quattro, e quanto ciascuno debba essere chiaro o scuro lo dicono i filtri. Con questa architettura le immagini smettono di essere macchie e cominciano ad avere bordi netti e coerenza.
E su quel pugno di numeri di partenza si possono fare i conti. Si prendono i numeri che hanno fatto tre uomini con gli occhiali, si tolgono quelli di tre uomini senza, si aggiungono quelli di tre donne senza: esce una donna con gli occhiali. Con un esemplare solo per gruppo il conto salta, perché «occhiali» sta in una zona di quei numeri e non in un punto preciso.
La DCGAN codifica una serie di scelte architetturali diventate standard: il
generatore \(G\) usa convoluzioni trasposte (nel paper si chiamano
fractional-strided convolutions, ed è la ConvTranspose2d di PyTorch) per
l’upsampling, il discriminatore \(D\) usa convoluzioni con stride; nessun
pooling; batch normalization in entrambe le reti, con due eccezioni che il
paper stesso impone (niente batchnorm sullo strato di uscita di \(G\) e su
quello d’ingresso di \(D\), dove gli autori riportano oscillazioni dei campioni
e instabilità); attivazioni ReLU nel generatore (tranne l’output con \(\tanh\))
e LeakyReLU nel discriminatore. La ricetta comprende anche l’ottimizzazione:
Adam con learning rate \(2\cdot10^{-4}\), perché il \(10^{-3}\) suggerito si rivela
troppo alto, e \(\beta_1 = 0{,}5\) invece di \(0{,}9\), che dava oscillazioni e
instabilità; pesi inizializzati da \(\mathcal{N}(0,\ 0{,}02^2)\), minibatch da
\(128\), pendenza \(0{,}2\) nelle LeakyReLU, e nessuno strato completamente
connesso nascosto nelle architetture profonde.
Il paper mostra anche che lo spazio latente \(\mathcal{Z}\) è semanticamente strutturato: aritmetica vettoriale come «uomo con occhiali \(-\) uomo senza occhiali \(+\) donna senza occhiali» produce, decodificata da \(G\), il volto di una donna con occhiali. C’è però una cautela, che il paper stesso dichiara e che pesa: sui singoli vettori l’operazione è instabile, e il risultato regge mediando i \(\mathbf{z}\) di tre esemplari per concetto. La struttura c’è, ma è una proprietà di regioni dello spazio, non di punti singoli; ed è comunque un indizio precoce del fatto che la rete apprende una rappresentazione, non una tabella di memorizzazione.
Conditional GAN: prendere il controllo#
Una GAN base genera «qualcosa di plausibile», ma non possiamo chiederle cosa. La conditional GAN [MO14], proposta già a fine 2014, pochi mesi dopo il paper originale, aggiunge il timone: si passa alla rete anche un’etichetta, e la generazione la rispetta.
Insieme ai numeri casuali forniamo un’informazione in più: «voglio un 7», oppure «un gatto». Il primo esempio viene da MNIST, la raccolta di cifre scritte a mano che da decenni si usa per le prove: settantamila immaginette minuscole, 28 pixel per lato, ciascuna con accanto la cifra che rappresenta.
La richiesta si consegna alla rete come tutto il resto, cioè sotto forma di numeri. Una cifra fra zero e nove è già un numero; per un’etichetta a parole si decide una volta per tutte un numero per ciascuna parola possibile, e «voglio un gatto» diventa una manciata di numeri accodata al rumore. Sia il generatore sia il discriminatore ricevono questa etichetta: il primo la usa come istruzione, il secondo per giudicare non solo se l’immagine è verosimile, ma se corrisponde davvero all’etichetta richiesta. Così smettiamo di pescare a caso e cominciamo a ordinare su misura.
Si condiziona il gioco minimax su una variabile ausiliaria \(y\), la classe (che la rete riceve codificata come vettore, per esempio one-hot) o un’informazione qualsiasi:
Qui \(p_{\text{dati}}(\mathbf{x},y)\) è la distribuzione congiunta di dato e condizione, scritta con gli argomenti espliciti proprio per distinguerla dalla marginale sui soli dati che nel resto del capitolo abbiamo indicato con \(p_{\text{dati}}\); \(p_y\) è la distribuzione delle condizioni e \(\mathbf{z}\) il rumore latente. Entrambe le reti ricevono \(y\) come ingresso aggiuntivo, e per questo lo scriviamo come secondo argomento: \(G(\mathbf{z},y)\) è il campione generato coerente con \(y\), e \(D(\mathbf{x},y)\) il giudizio del discriminatore sulla coppia. Il paper di Mirza e Osindero usa la barra, \(D(\mathbf{x}\mid y)\) e \(G(\mathbf{z}\mid y)\); qui si scrive la virgola, perché per la rete \(y\) è un ingresso in più. Il discriminatore resta però un classificatore condizionato: se le condizioni dei falsi si estraggono con la stessa distribuzione di quelle dei dati, \(p_y = p_{\text{dati}}(y)\), il suo ottimo è
cioè il discriminatore ottimo del gioco senza condizioni, classe per classe.
Il condizionamento è il seme concettuale di quasi tutto ciò che segue: la traduzione immagine-a-immagine e, con altri modelli generativi (diffusione, modelli autoregressivi), il text-to-image sono generazione condizionata su un input sempre più ricco, da un’etichetta discreta a un’intera frase.
SAGAN e BigGAN: guardare lontano, poi crescere#
Condizionare sulla classe non basta, da solo, a far disegnare bene mille classi diverse. Nel 2018 due lavori sulle GAN condizionate di ImageNet, la raccolta di oltre un milione di fotografie divise in mille classi su cui si addestrano i classificatori d’immagini, affrontano il problema uno dopo l’altro. La SAGAN (Self-Attention GAN) di Zhang, Goodfellow, Metaxas e Odena mette l’attenzione dentro il generatore e il discriminatore [ZGMO19]; BigGAN, di Brock, Donahue e Simonyan, prende la SAGAN come punto di partenza, la ingrandisce, e introduce un modo di scegliere al momento del campionamento quanto le immagini debbano essere belle e quanto varie: il truncation trick [BDS19].
La classe qui è l’etichetta della conditional GAN: «cane», «montagna», «tazza», una per ciascuna delle mille categorie di ImageNet. Le GAN di prima dipingevano con il naso sulla tela. Ogni strato della rete guarda un pezzetto dell’immagine e i suoi vicini, e le cose lontane si parlano solo passando di strato in strato. Il risultato era riconoscibile: cieli, mari e paesaggi, che sono fatti di trama, venivano bene; i cani avevano un pelo perfetto ma zampe confuse, perché quattro zampe vanno messe d’accordo fra loro e con il corpo, e sono lontane.
L’attenzione della SAGAN dà a ogni punto la possibilità di guardare tutta la tela, e di pesare quanto gli servono i punti lontani. Serve anche all’esperto che giudica: può controllare che una zampa in basso a sinistra vada d’accordo con quella in alto a destra. E la rete impara per gradi: all’inizio il peso dell’attenzione è a zero e dipinge come prima, poi lo alza quando le conviene. Lo sguardo lungo ha un prezzo: ogni punto guarda tutti gli altri, e raddoppiando i punti le occhiate diventano quattro volte tante.
BigGAN fa la cosa che sembra la meno ingegnosa, e rende di più: tutto più grande. A ogni passo guarda otto volte più immagini, e ogni gruppo così contiene più tipi diversi di immagine: la correzione che le due reti ne ricavano, pensano gli autori, è più affidabile. Le reti sono poi più larghe, cioè con più filtri per strato, più cose guardate in parallelo. L’accorgimento più curioso riguarda il pugno di numeri a caso da cui ogni immagine parte, una fila di più di cento numeri. Durante l’addestramento sono estratti come sempre, quasi tutti vicini allo zero e qualcuno lontano, e siccome capitano soprattutto vicino allo zero è lì che la rete si è esercitata di più. Al momento di generare, invece, BigGAN ripesca ogni numero che esce da una soglia, finché non ci rientra: le immagini che nascono da numeri tranquilli sono le più tipiche. Abbassando la soglia ogni immagine diventa più bella e tutte insieme più simili, fino a disegnare sempre lo stesso cane della classe. Diventa una manopola fra qualità e varietà, da girare dopo l’addestramento.
La manopola ha un guasto, e sta nella fila intera. Durante l’addestramento ogni numero, da solo, stava spesso vicino allo zero, ma in ogni fila qualcuno era lontano: una fila tutta tranquilla la rete non l’aveva mai vista. Alcune reti, davanti a file così, rispondono con colori sparati e pezzi saturi. BigGAN ci rimedia con una regola, durante l’addestramento, che obbliga i filtri di ogni strato a non somigliarsi fra loro, e che rende la rete più docile: piccoli cambi nei numeri di partenza danno piccoli cambi nell’immagine, anche nelle zone che ha visto poco. Non funziona sempre: fra le reti che gli autori hanno addestrato con impostazioni diverse, senza la regola reggeva la manopola una su sei, con la regola sei su dieci.
SAGAN nasce da un’osservazione sulle GAN convoluzionali condizionate addestrate su ImageNet: riescono bene le classi che si distinguono per la trama più che per la geometria (oceano, cielo, paesaggi), e male quelle con una struttura geometrica ricorrente, come i cani, disegnati con il pelo realistico ma senza zampe ben separate. La spiegazione che gli autori avanzano, e che i loro confronti classe per classe sostengono, sta nel campo recettivo locale della convoluzione: una dipendenza fra regioni lontane si forma solo attraverso una pila di strati, che l’ottimizzazione fatica a coordinare, e allargare i kernel costerebbe l’efficienza computazionale e statistica della struttura locale.
Il blocco di SAGAN adatta l’operazione non-local all’interno di una GAN. Date le feature \(\mathbf{x} \in \mathbb{R}^{C \times N}\) di uno strato (\(N\) posizioni, \(C\) canali), tre proiezioni \(1\times1\), \(f(\mathbf{x}) = \mathbf{W}_f\mathbf{x}\), \(g(\mathbf{x}) = \mathbf{W}_g\mathbf{x}\) e \(h(\mathbf{x}) = \mathbf{W}_h\mathbf{x}\), fanno da chiave, query e valore, tutte verso \(\bar C = C/8\) canali, e una quarta, \(\mathbf{W}_v \in \mathbb{R}^{C \times \bar C}\), riporta il risultato a \(C\) canali (qui la posizione che guarda è \(j\) e quella guardata è \(i\), al contrario della convenzione \(z_{ij} = \mathbf{q}_i^\top\mathbf{k}_j\) del capitolo sui Transformer):
e l’uscita del blocco è \(\gamma\,\mathbf{o}_i + \mathbf{x}_i\), con \(\gamma\) scalare appreso e inizializzato a zero, così che la rete parta locale e aggiunga la dipendenza a lunga distanza quando conviene. Il blocco sta in \(G\) e in \(D\), e costa un tempo quadratico in \(N\). SAGAN applica anche la normalizzazione spettrale [MKKY18] al generatore oltre che al discriminatore, e usa learning rate diversi per le due reti (la two time-scale update rule di Heusel e colleghi [HRU+17]), che rende superflui i turni sbilanciati, più aggiornamenti del discriminatore per ogni aggiornamento del generatore.
BigGAN parte dall’architettura SAGAN e la scala: batch otto volte più grande (2048), canali più larghi del 50%, un’immersione della classe condivisa e proiettata sui guadagni e sugli scostamenti della normalizzazione condizionata di ogni strato, e skip-z, cioè \(\mathbf{z}\) spezzato in parti da 20 componenti, una per risoluzione, date ai diversi livelli del generatore (in tutto \(d_z = 120\) componenti a \(128\times128\), 140 a \(256\times256\), 160 a \(512\times512\)). Gli autori attribuiscono il vantaggio del batch più grande, come congettura, alla copertura: ogni batch contiene più modi della distribuzione, e dà gradienti migliori a entrambe le reti. Il truncation trick lavora al campionamento: addestrato con \(\mathbf{z} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\), il generatore riceve \(\mathbf{z}\) da una normale troncata, in cui le componenti di modulo oltre una soglia \(\tau\) vengono ricampionate. Abbassando \(\tau\) i campioni si avvicinano al modo della distribuzione d’uscita: l’Inception Score, che nei modelli condizionati non penalizza la mancanza di varietà, sale in modo monotono, mentre il FID prima migliora e poi peggiora, e gli autori ne leggono una curva fra fedeltà e varietà analoga a quella fra precision e recall. Osservazioni vicine c’erano già [Mar17]; la trattazione sistematica e il nome sono di BigGAN. La troncatura sposta però la distribuzione d’ingresso rispetto all’addestramento: i vettori troncati hanno \(\lVert\mathbf{z}\rVert_\infty \le \tau\), un evento che sotto \(\mathcal{N}(\mathbf{0}, \mathbf{I})\) ha probabilità \(\big(2\Phi(\tau)-1\big)^{d_z}\), esponenzialmente piccola nella dimensione (\(\Phi\) è la funzione di ripartizione della normale standard). Davanti a questi ingressi i generatori mal condizionati rispondono con artefatti di saturazione. Il rimedio è una regolarizzazione ortogonale rilassata,
con \(\lambda = 10^{-4}\) (nel paper il coefficiente si chiama \(\beta\), che qui è già il peso dell’attenzione), che penalizza la somiglianza fra filtri senza vincolarne la norma: sulle configurazioni provate, la frazione di modelli che reggono la troncatura passa dal 16% al 60%. StyleGAN applicherà la stessa idea nello spazio \(\mathcal{W}\), come interpolazione verso lo stile medio, e lì la troncatura regge in modo affidabile senza modificare la funzione di perdita.
StyleGAN: il fotorealismo#
È la famiglia dietro i volti sintetici che chi guarda senza un addestramento apposito non distingue dalle fotografie meglio che tirando a sorte [NF22], ed è quella che ha reso famose le GAN presso chi non le ha mai studiate. Il contributo di StyleGAN [KLA19], però, è architetturale: un generatore a stili che controlla gli attributi dell’immagine scala per scala. Migliora anche la qualità (a parità di rete di base il FID cala di circa un sesto rispetto al generatore tradizionale), ma il risultato che lo distingue è il controllo.
StyleGAN non «disegna» il volto tutto in una volta: lo costruisce a livelli, dal grossolano al fine. Gli strati iniziali decidono posa e forma del viso, quelli intermedi i lineamenti, quelli finali dettagli come lentiggini e ciocche di capelli. A ogni livello consegna uno «stile», che è una fila di cursori: una manciata di numeri che invece di stare tutta all’ingresso arriva al singolo livello e decide come quel livello lavorerà. I cursori non escono grezzi dai numeri casuali di partenza: fra i due c’è una piccola rete che li traduce, e serve a sbrogliarli, perché nel mazzo grezzo posa, età e taglio di capelli sono aggrovigliati, e spostando un cursore se ne muovono tre. (La sezione sul latente che si usa ha mostrato che senza aiuti questa separazione non si ottiene; qui l’aiuto c’è ed è l’impianto stesso, perché ogni fila di numeri arriva a un livello diverso. Quello che si separa bene è il grossolano dal fine; posa, età e capelli si sbrogliano meglio di prima, non del tutto.)
Cambiando i cursori dei primi livelli cambia la posa; cambiando quelli degli ultimi cambiano le lentiggini. Per questo si mescolano tratti di volti diversi: i cursori dei primi livelli da un volto, quelli degli ultimi da un altro, e viene fuori un fotomontaggio impossibile e perfettamente coerente. Un pizzico di casualità, poi, non passa dai cursori: entra dritto a ogni livello e decide i dettagli che nessuno sceglie, dove cada una ciocca e come si posi la grana della pelle. Stessi cursori e casualità diversa danno la stessa persona appena spettinata.
Una cosa StyleGAN non l’ha inventata, ed è quella che si nota per prima: le immagini grandi come una fotografia vera erano state conquistate l’anno prima dal modello da cui parte, la Progressive GAN, che faceva crescere le due reti un pezzo alla volta. StyleGAN eredita quella scala e ci aggiunge il controllo.
Che poi il risultato sia una fotografia e non un disegno non dipende dai livelli: dipende dall’esperto, allenato su fotografie vere, che boccia tutto ciò che non lo sembra. I livelli danno il controllo, il duello dà il realismo.
L’innovazione è architetturale: una rete di mapping trasforma \(\mathbf{z}\) in uno spazio latente intermedio \(\mathcal{W}\), più disaccoppiato; i vettori di stile \(\mathbf{w}\) modulano ogni strato del generatore via adaptive instance normalization (AdaIN); rumore stocastico separato controlla i dettagli ad alta frequenza. Il risultato è il controllo scale-specific. La rete di mapping è un percettrone multistrato a 8 strati, con \(\mathbf{z}\) e \(\mathbf{w}\) a 512 componenti; durante l’addestramento una quota delle immagini è generata con due vettori \(\mathbf{w}\), passando dal primo al secondo a un livello scelto a caso (style mixing), e questo impedisce agli strati di assumere che stili contigui siano correlati. In generazione si usa il truncation trick di BigGAN, spostato in \(\mathcal{W}\): \(\mathbf{w}' = \bar{\mathbf{w}} + \psi\,(\mathbf{w} - \bar{\mathbf{w}})\), con \(\bar{\mathbf{w}}\) la media degli stili e \(\psi < 1\), che avvicina i campioni alle regioni dense e ottiene fedeltà a scapito della varietà. Il FID quella rinuncia la fa pagare: nel confronto di Kynkäänniemi e colleghi [KynkaanniemiKL+19] la configurazione di StyleGAN più troncata, con volti belli e tutti simili, ha un FID di \(91{,}7\) contro il \(4{,}5\) di quella ottimizzata per il FID.
La risoluzione \(1024\times1024\), invece, StyleGAN la eredita: viene dalla Progressive GAN dello stesso gruppo [KALL18], che l’anno prima aveva imparato a salire fino a lì facendo crescere le due reti un livello per volta, e che StyleGAN dichiara come propria configurazione di base, «da cui ereditiamo le reti e tutti gli iperparametri, salvo dove indicato». Là si era imparato a salire la scala; qui si impara a decidere che cosa succede a ciascun gradino. StyleGAN2 (2020) elimina poi i caratteristici artefatti «a goccia» ridisegnando la normalizzazione: con quella revisione la ricetta si assesta, ed è la forma in cui la famiglia è entrata nell’uso corrente.
Sotto il cofano: crescere, modulare, e la goccia#
Tre meccanismi di StyleGAN meritano di essere aperti: come si fanno crescere due reti, che cosa vuol dire consegnare uno stile a un livello, e da dove veniva la macchia a goccia che StyleGAN2 ha fatto sparire. I primi due valgono oltre StyleGAN. La crescita per gradini è l’esempio più limpido di un’idea che torna ogni volta che un addestramento è troppo grosso per essere affrontato tutto insieme, e verrà abbandonata proprio da chi l’aveva inventata. La modulazione degli strati è finita dentro i generatori di immagini di oggi, e si ritrova sotto un altro nome nella sezione sul Diffusion Transformer. La goccia, invece, è un caso di studio su come si diagnostica un modello.
Crescere per gradini#
Un’immagine di \(4 \times 4\) pixel ha sedici valori per canale, e a quella risoluzione l’addestramento è molto più stabile, perché i modi da imparare sono pochi. A \(1024 \times 1024\) i pixel sono oltre un milione: distinguere i campioni generati da quelli veri diventa molto più facile per il discriminatore, il che amplifica drasticamente il problema dei gradienti verso il generatore, e la memoria impone minibatch piccoli, che tolgono altra stabilità [KALL18]. L’idea della Progressive GAN è ovvia a dirsi: si comincia da \(4 \times 4\), si aspetta che le due reti si assestino, poi si aggiunge uno strato a ciascuna e si raddoppia il lato. Sedici pixel, poi sessantaquattro, poi duecentocinquantasei, e via fino al milione.
Il punto delicato è il gradino, ed è lì che sta il mestiere. Aggiungere di colpo uno strato nuovo, coi suoi numeri ancora casuali, davanti a due reti che avevano appena trovato l’equilibrio vuol dire buttare all’aria l’equilibrio. La soluzione è una dissolvenza: per un po’ l’immagine che esce è una miscela fra quella del gradino vecchio (semplicemente ingrandita) e quella del gradino nuovo, e il peso della miscela scivola da zero a uno nel corso dell’addestramento. All’inizio comanda il vecchio, alla fine il nuovo, e in mezzo non c’è nessun salto. Lo stesso, specularmente, dalla parte del discriminatore. Nessuno dei due si sveglia una mattina in un mondo diverso.
Un maestro che insegna a copiare un volto non fa cominciare dalle ciglia: fa tracciare l’ovale, poi la posizione degli occhi, poi i lineamenti, e i dettagli per ultimi. Se si comincia dalle ciglia si sbaglia tutto, perché non c’è ancora una faccia su cui metterle.
La crescita per gradini fa esattamente questo con due allievi che si controllano a vicenda. E la dissolvenza è la cortesia di non cambiare foglio di colpo: per un po’ il disegno che si consegna è mezzo quello vecchio ingrandito e mezzo quello nuovo, e la proporzione si sposta piano. Chi giudica non se ne accorge, e continua a giudicare.
Nel paper ci sono altri tre accorgimenti, e li nominiamo perché sono il genere di cosa che non si trova sui manuali e fa la differenza fra un addestramento che regge e uno che no. Il primo: si fa in modo che tutti i pesi della rete rispondano con la stessa prontezza, perché altrimenti alcuni si aggiustano in fretta e altri restano indietro, e chi resta indietro rallenta tutti. Il secondo: dentro il falsario, dopo ogni passaggio, i numeri vengono riportati a una taglia standard, perché in una gara a chi urla più forte tendono a gonfiarsi da soli. Il terzo: si mostra all’esperto quanto sono diverse fra loro le immagini di un gruppo, che è il modo più diretto di smascherare un falsario che dipinge sempre lo stesso quadro.
La dissolvenza si applica agli strati \(1\times1\) che convertono le mappe di attivazione in tre canali RGB (toRGB) e viceversa (fromRGB). Passando da risoluzione \(R\) a \(2R\), per un certo numero di iterazioni l’uscita è
dove \(\tilde{\mathbf{x}}\) è l’immagine che esce dal generatore durante il passaggio, \(\mathbf{h}_R\) e \(\mathbf{h}_{2R}\) sono le mappe di attivazione alle due risoluzioni e \(\mathrm{up}\) un raddoppio per interpolazione: il vecchio ramo resta in funzione e cede il passo con continuità. Il discriminatore fa il percorso simmetrico sui fromRGB.
Gli altri tre contributi del lavoro:
Equalized learning rate. I pesi si inizializzano da \(\mathcal{N}(0,1)\) e si riscalano a tempo di esecuzione con la costante per-strato dell’inizializzatore di He, invece di applicarla all’inizializzazione. Il motivo è che ottimizzatori adattivi come Adam normalizzano l’aggiornamento peso per peso, quindi il tempo che un peso impiega ad adattarsi dipende dalla sua scala: con l’inizializzazione classica gli strati con pochi ingressi hanno pesi grandi e si muovono più lentamente degli altri. Scalando a runtime, tutti i pesi hanno lo stesso raggio d’azione e lo stesso passo effettivo.
Pixelwise feature normalization nel generatore: dopo ogni convoluzione il vettore di attivazioni di ciascun pixel è riscalato perché la media dei suoi quadrati sui canali valga uno. Non ha parametri appresi e serve a impedire che le magnitudini divergano durante l’escalation del duello.
Minibatch standard deviation: al discriminatore si aggiunge un canale costante che riporta la deviazione standard delle attivazioni attraverso il batch. È una misura diretta della varietà del gruppo, e rende il mode collapse visibile a chi giudica invece che invisibile.
Modulare invece di ordinare#
Detto come cresce, resta da dire che cosa StyleGAN aggiunge: la AdaIN, adaptive instance normalization. A ogni livello il segnale dentro il generatore è fatto di tanti canali, le pile di valori della DCGAN, e la AdaIN lavora su ciascuno separatamente, in due tempi. Prima lo normalizza, sottraendo la media e dividendo per la deviazione standard calcolate su tutte le sue posizioni; poi gli applica una scala e uno scarto calcolati dallo stile di quel livello. Ogni canale esce quindi con le statistiche dettate dallo stile, e poiché lo stile cambia da livello a livello il controllo è per scala: cambiando lo stile dei primi livelli cambia la posa, cambiando quello degli ultimi cambiano le lentiggini.
Il meccanismo non nasce qui: è l’AdaIN che Xun Huang e Serge Belongie [HB17] avevano proposto per il trasferimento di stile, e che la sezione sul trasferimento di stile ha già scritto in formula: allineare media e deviazione standard dei canali del contenuto a quelle dello stile. StyleGAN se lo porta dentro il generatore e lo usa livello per livello.
Dentro il falsario, a ogni livello, il segnale viaggia in tante corsie parallele, i canali, e ogni corsia ha il suo livello medio e la sua ampiezza di oscillazione. Il gesto ha due tempi. Primo tempo, si azzera: di ciascuna corsia si prende il valore medio e l’ampiezza delle oscillazioni e li si riporta a zero e a uno, come un mixer con tutti i cursori rimessi in posizione neutra. Una corsia che valeva in media \(5\) e oscillava di \(2\) in su e in giù esce con media \(0\) e oscillazioni di \(1\). Secondo tempo, si riassegna: a ciascuna corsia si rimette un valore medio e un’ampiezza, e questa volta a dirli è lo stile, la manciata di numeri consegnata a quel livello. Se lo stile dice «media \(3\), ampiezza \(4\)», la corsia esce così, qualunque cosa valesse prima; della corsia di partenza resta soltanto la forma, dove sale e dove scende.
Non c’è nessun ordine impartito all’immagine: c’è una taratura del mixer, livello per livello.
La AdaIN di StyleGAN [KLA19] agisce separatamente su ogni mappa di attivazioni \(\mathbf{x}_i\), cioè sul canale \(i\):
dove \(\mu\) e \(\sigma\) sono media e deviazione standard della mappa sulle sue posizioni spaziali, e la coppia di vettori \((\mathbf{y}_s, \mathbf{y}_b)\) è lo stile, ricavato da \(\mathbf{w}\) con una trasformazione affine appresa per ogni livello; \(y_{s,i}\) e \(y_{b,i}\), tondi perché sono due numeri e non due vettori, sono le loro componenti sul canale \(i\). Dopo l’operazione la media e la deviazione standard del canale valgono esattamente \(y_{b,i}\) e \(\lvert y_{s,i}\rvert\), qualunque fossero prima: le statistiche di primo e secondo ordine le decide lo stile, e della mappa sopravvive solo la forma spaziale. In Huang e Belongie la coppia è \(\big(\sigma(\mathbf{s}_i), \mu(\mathbf{s}_i)\big)\), le statistiche delle feature di un’immagine di stile \(\mathbf{s}\); StyleGAN la calcola da \(\mathbf{w}\), livello per livello, ed è da lì che viene il controllo per scala.
La goccia#
Le immagini di StyleGAN avevano un difetto che si vedeva a occhio nudo, e nella maggior parte dei casi anche senza cercarlo: una macchia a forma di goccia d’acqua, sempre uguale, da qualche parte nell’immagine. Quando nell’immagine finita non si vedeva, c’era comunque nelle mappe intermedie del generatore, e lì c’era praticamente sempre. Per un anno è stata una di quelle cose che si vedono e non si spiegano, e a renderla un enigma c’era anche il fatto che il discriminatore, che sta lì apposta per accorgersi di ciò che non torna, se la lasciava passare.
Karras e colleghi [KLA+20] ne propongono una spiegazione, e un esperimento la sostiene. Il primo tempo della AdaIN normalizza ogni canale separatamente, e così butta via un’informazione che al generatore può servire: quanto un canale è forte rispetto agli altri. L’ipotesi è che il generatore la reintroduca di contrabbando. Fabbrica in un punto qualunque dell’immagine un picco enorme, così alto da dominare da solo la statistica del canale; quando la normalizzazione divide per quella deviazione standard gonfiata, tutto il resto del canale esce schiacciato della quantità che serviva. Il picco è la goccia, e una macchia in un angolo costerebbe al generatore meno che perdere quel controllo: Fig. 26.4 fa il conto. A sostegno, gli autori mostrano che togliendo dal generatore il passo di normalizzazione le gocce spariscono del tutto, che è un indizio forte del movente senza esserne la prova.
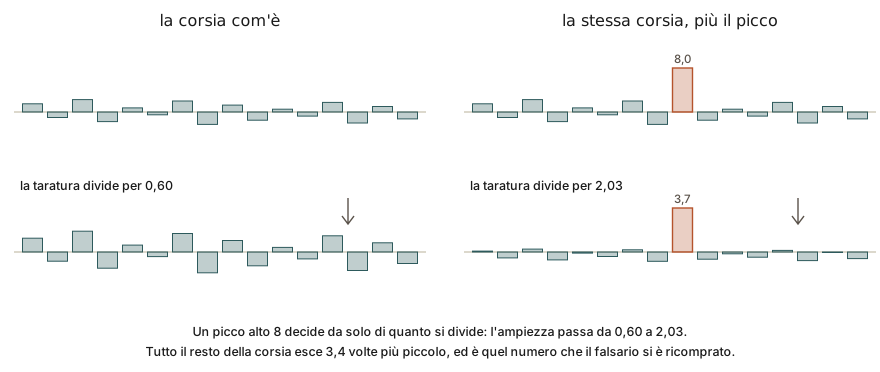
Fig. 26.4 Che cosa il picco si ricompra. A sinistra un canale qualunque (la «corsia» del disegno), a destra lo stesso canale con una casella sola cambiata. La normalizzazione divide per quanto il canale oscilla, e quel divisore adesso lo decide il picco: tutto il resto esce più di tre volte più piccolo. Quel fattore è l’ampiezza che la normalizzazione aveva tolto, e che il generatore, secondo l’ipotesi di Karras e colleghi, si riprende scegliendo quanto alto fare il picco.#
L’altra metà dell’enigma resta aperta, e sono gli stessi autori a lasciarla lì: una macchia tanto costante il discriminatore dovrebbe vederla, e perché non la penalizzi l’ipotesi non lo dice.
Il rimedio, che arriva con StyleGAN2, è elegante: invece di normalizzare le attivazioni, si normalizzano i pesi. Lo stile scala i pesi della convoluzione (la modulazione), e subito dopo i pesi vengono rinormalizzati (la demodulazione) in modo che l’uscita torni, in media, ad ampiezza unitaria. Il risultato sulla carta è quasi lo stesso, ma la seconda operazione non guarda mai il contenuto dell’immagine: lavora sui pesi, prima che l’immagine esista, e non lascia al generatore nessun varco in cui far passare un segnale. Le gocce spariscono.
Come si legge questa storia
Un difetto visibile in quasi ogni immagine è rimasto senza spiegazione per un anno, e la spiegazione proposta indica, più che un errore nel codice, una soluzione che l’ottimizzazione trova a un vincolo dell’architettura. È la differenza fra il debug di un programma, dove qualcosa è scritto storto, e la diagnosi di un modello, dove un difetto sistematico può essere la strada che l’obiettivo premia e che nessuno aveva previsto. Quando una rete fa una cosa strana e ripetuta, la domanda che paga è che cosa ci stia guadagnando, più che dove sia il guasto; il capitolo sull’interpretabilità ne fa un mestiere.
Quel rimedio, e le altre due revisioni che lo stesso lavoro si porta dietro, meritano di essere guardati da vicino.
Le altre due revisioni sono queste. La prima è che la crescita per gradini viene messa da parte. Serviva a tenere in piedi un addestramento che nel frattempo si era imparato a tenere in piedi in altri modi, e in cambio faceva un danno: inchiodava i dettagli a posizioni fisse sul foglio. Nei volti che si muovono si vedeva benissimo, perché i denti restavano orientati verso la macchina fotografica invece di seguire la testa. Al posto dei gradini, dentro ciascuna rete si aprono delle scorciatoie che portano il segnale oltre gli strati invece di farlo passare per tutti, e le due reti non prendono lo stesso genere di scorciatoia.
La seconda è una regola nuova che chiede al falsario di camminare a passo costante: spostare i cursori di un tanto deve cambiare l’immagine di un tanto, né di più né di meno, dovunque ci si trovi. Serve a togliere di mezzo i punti in cui uno spostamento minimo stravolge l’immagine, e regala un mestiere in più: un falsario che cammina a passo costante è molto più facile da percorrere al contrario, cioè da usare per scoprire quali cursori produrrebbero una fotografia che abbiamo già in mano, e quindi per dire se un volto l’ha fatto lui.
L’operazione che sparisce è la AdaIN, e il varco che l’ipotesi della goccia le attribuisce è la sua divisione per \(\sigma(\mathbf{x}_i)\), il punto in cui il calcolo si lascia dominare dai valori che il generatore stesso produce.
Al suo posto la modulazione scala i pesi della convoluzione per lo stile, e la demodulazione li rinormalizza sotto l’ipotesi che gli ingressi siano indipendenti e a varianza unitaria:
dove \(i\) indicizza i canali d’ingresso, \(j\) quelli d’uscita, \(k\) le posizioni spaziali del filtro, \(s_i\) è la scala dettata dallo stile ed \(\epsilon\) evita la divisione per zero. Questi \(w\) sono i pesi della convoluzione, e non hanno niente a che vedere con il \(\mathbf{w}\) di poche righe sopra, che è il vettore dello spazio latente intermedio: sono due notazioni consolidate dello stesso paper. Gli apici al denominatore non sono decorativi: la somma corre su tutti i canali d’ingresso e su tutte le posizioni a canale d’uscita \(j\) fissato, cioè è la norma dell’intero filtro che produce il canale \(j\), e \(i'\) e \(k'\) scorrono mentre l’\(i\) e il \(k\) del numeratore restano fermi. L’ipotesi statistica è il punto: la demodulazione non misura le attivazioni vere, le assume, e per questo non offre nessun canale in cui nascondere segnale. Gli autori la dichiarano per quello che è, cioè più debole dell’instance normalization proprio perché poggia su ipotesi sul segnale invece che sul contenuto effettivo delle mappe: il controllo sull’ampiezza vale in media e non su ogni singolo esempio. Ed è quel «in media» a chiudere il varco.
Lo stesso lavoro rivede la crescita progressiva, che a quel punto risolveva un problema di stabilità già risolto altrove e in cambio dava ai dettagli una preferenza per le posizioni fisse (i denti che restano allineati alla macchina fotografica invece di seguire la posa). Al suo posto va una coppia asimmetrica, e l’asimmetria è il risultato: fra le nove combinazioni provate, il generatore vuole connessioni skip e il discriminatore connessioni residue, mentre un generatore residuo peggiora le cose dappertutto tranne che in un caso, su un insieme di automobili.
Arriva poi la path length regularization. L’ideale che insegue è che un passo di ampiezza fissa in \(\mathcal{W}\) produca nell’immagine un cambiamento di ampiezza fissa, quale che sia il punto di partenza e quale che sia la direzione; lo scarto da quell’ideale si misura sui gradienti rispetto a \(\mathbf{w}\) di una proiezione casuale dell’immagine, e si penalizza la loro distanza da una costante:
dove \(g\) è il generatore, \(\mathbf{u}\) è l’immagine di rumore gaussiano su cui si proietta (il paper la chiama \(\mathbf{y}\), lettera che in StyleGAN è già lo stile) e \(a\) non è un iperparametro ma una media mobile esponenziale delle lunghezze osservate, cioè un bersaglio che il termine si sceglie da solo strada facendo. Lo jacobiano non si calcola mai per esteso: basta l’identità \(\mathbf{J}_{\mathbf{w}}^{\top}\mathbf{u} = \nabla_{\mathbf{w}}\big(g(\mathbf{w}) \cdot \mathbf{u}\big)\), che è una normale retropropagazione. È un vincolo di buon condizionamento numerico della mappa latente-immagine (numerico nel senso dell’analisi numerica, cioè quanto la mappa amplifica una differenza in ingresso; da non confondere con il condizionamento della GAN condizionale, che è un’etichetta data in ingresso alle due reti), e ha un effetto collaterale utile dichiarato dagli autori: i generatori così regolarizzati sono molto più facili da invertire, cioè da usare al contrario per trovare il \(\mathbf{w}\) che produce una data fotografia, e questo permette di attribuire un’immagine generata alla rete che l’ha fatta.
pix2pix e CycleGAN: tradurre le immagini#
Se condizioniamo una GAN non su un’etichetta ma su un’intera immagine, otteniamo un traduttore visivo: schizzo → foto, mappa → satellite, giorno → notte. È pix2pix [IZZE17]. Ha però un vincolo: servono coppie allineate, cioè lo stesso soggetto ripreso nei due mondi che si vogliono tradurre l’uno nell’altro (in gergo, i due domini), e coppie così sono difficili da procurare. CycleGAN [ZPIE17] rimuove il vincolo, con la regola di Fig. 26.5.

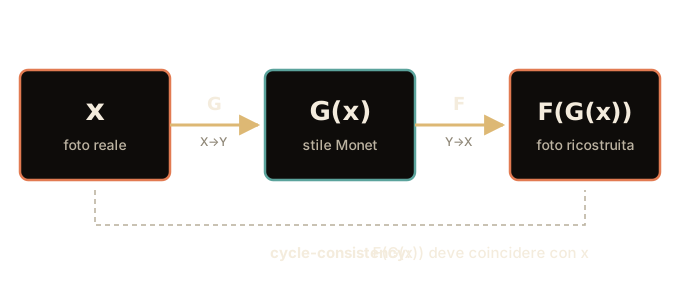
Fig. 26.5 Il vincolo di andata e ritorno (in inglese cycle-consistency): tradurre e poi ritradurre deve riportare al punto di partenza.#
CycleGAN impara a trasformare foto in quadri di Monet (e viceversa) senza mai vedere una foto e il suo quadro corrispondente: gli bastano due mucchi separati, tante foto e tanti Monet. Il trucco è il vincolo di andata e ritorno: se prendo una foto, la converto in «stile Monet» e poi la riconverto in foto, devo ritrovare la foto di partenza.
Detta così, la regola sembra avere una scappatoia grande come una casa: al traduttore converrebbe non cambiare niente, restituire la foto tale e quale e vincere senza fatica. Non gli conviene, perché il vincolo di andata e ritorno non gioca da solo: dall’altra parte c’è sempre un esperto, uno per dominio, addestrato a distinguere i veri Monet dai finti Monet. Chi non dipinge viene smascherato da lui. Le due regole si tengono a vicenda: l’esperto obbliga a cambiare stile, il ciclo obbliga a non stravolgere il contenuto.
Resta una scappatoia più fine, e i falsari la trovano. Si può dipingere un Monet vero e nasconderci dentro la foto, in una trama di puntini troppo debole perché l’occhio la veda: al ritorno il compagno rilegge la trama e ricostruisce la foto identica. L’esperto è contento e il giro si chiude, ma nessuno ha promesso che nel quadro ci siano gli stessi alberi della foto. Un andata e ritorno perfetto non dimostra che il soggetto abbia fatto il viaggio.
Si addestrano due generatori, \(G:\mathcal{X}\to\mathcal{Y}\) e \(F:\mathcal{Y}\to\mathcal{X}\), con due discriminatori. Oltre alle due perdite avversarie si aggiunge la cycle-consistency loss:
I termini misurano, in norma \(\ell_1\), quanto la doppia traduzione si discosta dall’originale: \(G(\mathbf{x})\) porta \(\mathbf{x}\) nel dominio \(\mathcal{Y}\), \(F\) lo riporta indietro, e il risultato deve coincidere con \(\mathbf{x}\); qui \(\mathbf{y}\) è un’immagine del secondo dominio, che è la lettera di Zhu e colleghi e non lo stile di StyleGAN. Nell’obiettivo completo la \(\mathcal{L}_{\text{cyc}}\) non compare da sola ma pesata da un coefficiente \(\lambda\) (nel paper, \(\lambda = 10\)) accanto alle due perdite avversarie: il rapporto fra le due spinte è un iperparametro, e non dei più innocui.
Questo vincolo rende superfluo l’allineamento a coppie. Che il vincolo «ancori il contenuto», però, è vero solo in parte, ed è un limite noto: Chu, Zhmoginov e Sandler [CZS17] hanno mostrato che CycleGAN impara a soddisfare il ciclo nascondendo l’immagine di partenza dentro quella tradotta, come un segnale ad alta frequenza quasi invisibile a occhio, che \(F\) poi rilegge per ricostruire l’originale. Il ciclo si chiude, ma per steganografia invece che per conservazione del soggetto: una \(\mathcal{L}_{\text{cyc}}\) bassa non è di per sé una garanzia di fedeltà.
Applicazioni#
L’onda applicativa è stata vasta, e tre usi mostrano bene che cosa una GAN sa fare e dove si ferma.
Il primo è la super-risoluzione. SRGAN [LTHuszar+17] ricostruisce dettagli plausibili in immagini a bassa risoluzione, e da lì vengono il restauro fotografico e l’upscaling, l’ingrandimento di un’immagine senza che diventi sgranata. La parola «plausibili» va presa alla lettera, ed è il limite dello strumento: i dettagli che nella foto piccola non c’erano la rete non li recupera, li inventa in modo verosimile. Su una foto di famiglia è una scelta estetica; su una lastra medica o su un fotogramma di sorveglianza è una trappola, perché il risultato ha l’aria di un’informazione e non lo è.
Il secondo è la generazione di dati sintetici: volti, lastre mediche, scene stradali con cui addestrare altri modelli quando i dati reali sono scarsi o sensibili. Con due avvertenze. Un dato sintetico eredita le distorsioni di chi l’ha generato (i bias: se il generatore ha visto soltanto volti chiari, soltanto quelli saprà fare). E un dato sintetico non è per questo privato: un generatore può memorizzare esempi di addestramento e riprodurli, e Carlini e colleghi ne hanno estratti da GAN addestrate su CIFAR-10, anche se meno che dai modelli di diffusione di qualità paragonabile [CHN+23]. Una garanzia di riservatezza chiede un addestramento apposito, con la privacy differenziale, e l’utilità dei dati sintetici per un compito si misura su quel compito.
Il terzo esce dalle immagini. MolGAN [DCK18] genera direttamente il grafo di una molecola, cioè i suoi atomi e i legami fra loro, e affianca alla loss avversaria un obiettivo di apprendimento per rinforzo che premia le proprietà chimiche desiderate; sulla raccolta QM9 produce composti validi quasi nel cento per cento dei casi, e soffre di mode collapse come le sorelle che generano immagini.
E l’arte. Nel 2018 il ritratto Edmond de Belamy, prodotto con una GAN dal collettivo francese Obvious, fu battuto da Christie’s per 432.500 dollari, con una stima di partenza di 7.000–10.000: la casa d’aste lo presentava come il primo ritratto generato da un algoritmo mai arrivato all’asta. Il dibattito sull’autorialità dell’arte generativa si aprì proprio lì, e con un’ironia utile: buona parte del codice era di Robbie Barrat, un altro artista, che l’aveva pubblicato con una licenza aperta, compreso il programma con cui Obvious aveva raccolto da WikiArt i quindicimila ritratti dell’addestramento [Vin18]; Obvious lo riconobbe pubblicamente. La domanda «di chi è l’opera» nasce già con due risposte possibili prima ancora di arrivare alla macchina.
VQ-GAN: il duello che fabbrica un alfabeto#
Tutte le varianti viste finora cambiano il regolamento del duello lasciandone intatto lo scopo: alla fine esce un’immagine, e a farla è il generatore. L’ultima che raccontiamo cambia lo scopo. Il duello non serve più a fare immagini: serve a fabbricare un alfabeto con cui scriverle. E chi poi le scrive è una macchina che il lettore conosce da tempo, quella che indovina il simbolo successivo.
Il ragionamento parte da un desiderio. Un Transformer sa continuare qualunque cosa gli si dia in fila, purché sia una fila corta di simboli presi da un elenco finito: è così che scrive testo, ed è così che, nella sezione sulla generazione di suono e musica, ha scritto musica. Un’immagine non è né l’una né l’altra cosa. Non è un elenco finito, perché i suoi puntini sono numeri che variano con continuità; e non è corta, perché di puntini ce ne sono centinaia di migliaia. Servono due riduzioni, e per tutte e due il libro ha già gli attrezzi: un autoencoder per accorciare, e un codebook per rendere finito, cioè la tavolozza di pezzetti-tipo dei codec audio, quella del VQ-VAE [vdOVK17].
Il guaio è che le due riduzioni si mordono la coda. Un Transformer paga l’attenzione col quadrato della lunghezza della fila (fila doppia, conto quadruplo), quindi la fila va accorciata tanto; ma comprimere tanto, con una rete addestrata a somigliare all’originale puntino per puntino, produce immagini sfocate, perché la strada più sicura per somigliare a tutto è fare la media di tutto. È qui che entra il duello. Patrick Esser, Robin Rombach e Björn Ommer [ERO21] cambiano due cose al compressore. Primo: al posto del conto puntino per puntino mettono un giudizio percettivo, che misura la somiglianza come la valuterebbe un occhio (due fili d’erba diversi nello stesso prato sono la stessa cosa, una scritta storta no). Secondo: gli mettono contro un discriminatore. A quel punto il compressore non può più cavarsela con la media, perché una media il discriminatore la riconosce, e con lo stesso accorciamento le immagini tornano nitide: un’immagine di \(256 \times 256\) pixel si riduce a una fila di \(256\) simboli, che un Transformer digerisce senza fatica. Da lì in poi generare un’immagine è, alla lettera, scrivere una frase di 256 parole.
Un quadro si può dettare al telefono, se chi ascolta ha lo stesso catalogo che hai tu: mille tessere di mosaico numerate. Il quadro lo copri con una griglia di sedici caselle per lato, per ogni casella scegli la tessera del catalogo che le somiglia di più, e detti i numeri: duecentocinquantasei numeri, e dall’altra parte qualcuno rimonta il quadro. Il catalogo è l’alfabeto, i numeri sono la frase.
Chi rimonta il quadro non ha bisogno che i numeri vengano da un quadro vero: se qualcuno gliene inventa una fila plausibile, lui la rimonta lo stesso. E inventare file plausibili di simboli è il mestiere della macchina che completa le frasi. Un’immagine nuova diventa una frase nuova.
Il catalogo però va fatto bene, e qui torna il duello. Se le tessere si scelgono soltanto col criterio «somiglia», il catalogo si riempie di tessere sbiadite: davanti a un dubbio la scelta più prudente è sempre il grigio medio, che somiglia un po’ a tutto e non è niente. Mettendo un esperto a bocciare le ricostruzioni sfocate, le tessere restano nette. È il mestiere di sempre, ma stavolta il prodotto dell’esperto è un alfabeto e non un’immagine.
Un’avvertenza: il catalogo è un soffitto. Ciò che nessuna delle mille tessere sa dire, nessuno lo recupera più a valle, per quanto bravo sia chi scrive le frasi. E le tessere devono restare grosse: se ciascuna coprisse un pezzetto minuscolo, quei duecentocinquantasei numeri basterebbero per un angolo del quadro, e chi rimonta si ritroverebbe con due mezze facce che non si guardano. Per i quadri grandi si detta a finestra, un riquadro per volta: funziona finché il quadro è fatto di roba che si somiglia dappertutto, un prato o una città; su una figura al centro bisogna dire anche in che punto si sta lavorando.
L’encoder \(E\) produce \(\hat{\mathbf{z}} = E(\mathbf{x}) \in \mathbb{R}^{h \times w \times d}\); ogni vettore spaziale è quantizzato al più vicino elemento del codebook \(\mathcal{C} = \{\mathbf{e}_1, \dots, \mathbf{e}_K\}\) con la regola e lo straight-through estimator già visti per il VQ-VAE [vdOVK17]. La differenza sta nella loss del primo stadio, e sono due mosse distinte: la ricostruzione \(\ell_2\) sui pixel viene sostituita da una loss percettiva, cioè una distanza calcolata non fra i pixel delle due immagini ma fra quello che una rete già addestrata vede in ciascuna, e sopra si aggiunge una loss avversaria con un discriminatore patch-based, quello di pix2pix [IZZE17], che giudica riquadri invece dell’immagine intera e quindi valuta la resa locale più che il contenuto globale. I due termini che tengono agganciati codebook ed encoder (la perdita sul codebook e la commitment loss) restano quelli del VQ-VAE.
L’effetto dichiarato è sul fattore di compressione ammissibile: con \(f = 16\) e \(K = 1024\) un’immagine \(256 \times 256\) si riduce a \(16 \times 16 = 256\) indici, contro i \(5\,120 = 32^2 + 64^2\) della gerarchia a due livelli di VQ-VAE-2 [RvdOV19], uscito un anno e mezzo prima, a fedeltà di ricostruzione dello stesso ordine (il modello ImageNet di punta del lavoro tiene \(f = 16\) e sale a \(K = 16\,384\)).
Sul valore di \(f\) conviene riportare esattamente ciò che il paper misura, perché le due metà del compromesso vengono da due esperimenti diversi. Verso l’alto: gli autori osservano che oltre un certo numero di dimezzamenti la qualità della ricostruzione degrada, e la soglia dipende dal dataset. Verso il basso: tenendo fissa la lunghezza della sequenza a \(16 \times 16 = 256\) e variando \(f \in \{1, 2, 8, 16\}\), la porzione d’immagine che quei 256 simboli coprono si stringe al calare di \(f\), e sotto \(f = 16\) le strutture globali non reggono più (a \(f = 8\) escono facce mezze barbute, con punti di vista incoerenti da una zona all’altra). Il vincolo dal basso, quindi, non è che la fila si allunghi: a fila costante è il campo visivo che si restringe.
Il secondo stadio è un Transformer autoregressivo sugli indici, addestrato a massimizzare \(\sum_i \log p(s_i \mid s_{<i})\) sulla sequenza serializzata in ordine di scansione. Per risoluzioni oltre quella di addestramento il campionamento avviene a finestra scorrevole, condizionando ogni blocco sul contesto che ricade nella finestra: è ciò che permette immagini di dimensione arbitraria a lunghezza di contesto fissa. Gli autori dichiarano anche a quale condizione funziona, ed è la parte che conviene non perdere: il contesto disponibile basta finché le statistiche del dataset sono all’incirca invarianti per traslazione, oppure finché c’è un condizionamento spaziale che regge la coerenza. Dove la condizione cade (sintesi non condizionata su dati allineati) si rimedia condizionando sulle coordinate.
Due fili vanno tirati, perché il libro li riprende. Il primo: la stessa ricetta di perdite (ricostruzione percettiva, avversaria di patch, più un termine che disciplina il latente) è quella con cui è addestrato l’autoencoder di Stable Diffusion, e non per caso, dato che Esser, Rombach e Ommer sono tutti e tre fra i suoi autori; là però il latente resta continuo, perché il termine che disciplina è una KL leggera invece di una quantizzazione, e a comporre non pensa un Transformer autoregressivo ma la diffusione. VQ-GAN è la fucina in cui quella ricetta è stata forgiata. Il secondo: l’idea di trattare un’immagine come una sequenza di simboli non è nuova per chi legge, perché la sezione sulla fusione precoce l’ha già usata per i generatori multimodali; qui se ne vede l’officina, cioè da dove arriva l’alfabeto e a che prezzo lo si fabbrica.
Il passaggio di testimone ai modelli di diffusione#
Verso il 2021 il primato cambia mano, e a dare il nome al sorpasso è il paper Diffusion Models Beat GANs on Image Synthesis [DN21], che lo misura su due fronti: un FID migliore di quello di BigGAN su ImageNet, e una copertura più ampia della distribuzione, misurata dal richiamo (una guida forte, che alza la fedeltà, ne fa perdere una parte, ma resta sopra quella della GAN). La ragione per cui il passaggio è stato così rapido, però, sta nei due difetti delle GAN. Un modello di diffusione si addestra minimizzando una loss di regressione, con un bersaglio che non dipende da un’altra rete, e quindi senza un duello da tenere in equilibrio; e copre i modi della distribuzione molto meglio di una GAN. L’idea è opposta a quella avversaria: si aggiunge a un’immagine rumore gaussiano in quantità crescente, si addestra una rete a stimarlo, e si genera partendo da puro rumore e togliendolo un passo alla volta. («Rumore» è la stessa parola usata finora, ma qui indica una cosa diversa: non i numeri casuali in ingresso al generatore, bensì la grana sparsa sopra un’immagine.) Su questa base nascono Stable Diffusion [RBL+22] e DALL·E 2 (OpenAI, 2022): a entrambi si descrive a parole quello che si vuole («un gatto nero seduto su un muro al tramonto») e loro lo disegnano, ed è così che la generazione di immagini su richiesta è arrivata al grande pubblico. Stable Diffusion in più toglie il rumore non dall’immagine a grandezza naturale ma da un latente, una sua versione compressa che occupa molta meno memoria: è la ragione per cui gira anche su un computer di casa. Del meccanismo parla il capitolo sui modelli di diffusione.
Le GAN non sono scomparse, e il primo motivo è la velocità: una GAN produce l’immagine in un colpo solo, un unico passaggio attraverso il generatore, mentre la diffusione parte dal rumore e lo ripulisce un po’ per volta, ripetendo l’operazione decine di volte. Il vantaggio era così evidente che la ricerca sulla diffusione ha passato anni a rincorrerlo, imparando a ottenere lo stesso risultato in pochi passi invece che in molti; e per riuscirci ha spesso rimesso in gioco un discriminatore. La distillazione avversaria (ADD, 2023) [SLBR24] addestra un modello a generare in uno-quattro passi affiancando alla guida di un modello di diffusione già addestrato una loss avversaria, con un discriminatore che giudica le feature di una rete di visione congelata; è il metodo con cui Stability AI ha costruito SDXL Turbo.
Intanto la famiglia ha continuato a crescere. StyleGAN3 (2021) [KAL+21] affronta l’ultimo difetto di StyleGAN2: nelle animazioni ottenute muovendosi nello spazio latente i dettagli restano attaccati alle coordinate dei pixel invece di seguire la superficie del volto, perché il generatore trova riferimenti di posizione assoluta che non dovrebbe avere, soprattutto nell’aliasing dei suoi strati. Trattando ogni segnale come continuo e filtrandolo come si fa in elaborazione dei segnali, il generatore diventa equivariante alle traslazioni e, in una variante, alle rotazioni, con un FID simile a quello di StyleGAN2. GigaGAN (2023) [KZZ+23] porta l’architettura a un miliardo di parametri e al testo-immagine, e genera un’immagine di \(512\) pixel di lato in \(0{,}13\) secondi, contro i quasi tre di Stable Diffusion 1.5 a FID paragonabile, pur restando, per ammissione degli autori, sotto i modelli di produzione per realismo e composizione. E R3GAN (2024) [HGKT24] riparte dalla convergenza: una loss relativistica, in cui il discriminatore giudica a coppie quanto un dato vero sembri più vero di uno generato, con le penalità \(R_1\) e \(R_2\) sul gradiente del discriminatore nei dati reali e in quelli generati, ha garanzie di convergenza locale come la GAN regolarizzata della sezione sull’addestramento avversario. Con quella loss gli autori tolgono uno per uno i trucchi accumulati da StyleGAN, montano un’architettura moderna, e superano StyleGAN2 su FFHQ, ImageNet e CIFAR-10.
C’è di più, e vale anche per chi userà soltanto la diffusione: un discriminatore è servito a costruire un pezzo di Stable Diffusion. Alla fine di tutto il lavoro c’è il decoder che riporta il latente ai pixel, quello che nel capitolo sui modelli latenti ricostruisce le immagini dopo una compressione di quarantotto volte. È stato addestrato anche con una loss avversaria, con un discriminatore patch-based come quello di VQ-GAN che finito l’addestramento si scarta, ed è quella parte a tenere nitide le ricostruzioni. Il duello, insomma, è passato dal centro della scena a un ruolo di manutenzione.
Nota etica: i deepfake
La stessa tecnologia che genera volti fotorealistici genera deepfake: video e audio falsi ma credibili di persone reali. Le implicazioni sono serie: disinformazione, frodi, abusi non consensuali. Chi lavora con questi modelli ha una responsabilità concreta: verificare le fonti, sostenere i sistemi che marchiano un contenuto generato con una filigrana invisibile (il watermarking) e ne registrano la provenienza, e ricordare che «verosimile» non significa «vero». La potenza generativa e la vigilanza critica devono crescere insieme.
Le varianti che abbiamo visto sono altrettante modifiche al regolamento del duello, e conviene ripassarle così.
Da ricordare
La DCGAN cambia il modo in cui le due reti guardano le immagini, dando loro dei filtri che scorrono sull’immagine invece di trattarla come una lista di numeri: è la variante che fa smettere alle GAN di produrre macchie.
La conditional GAN aggiunge il timone: insieme al rumore si consegna un’etichetta («voglio un 7»), e la ricevono tutti e due, perché anche l’esperto deve poter dire «sarà pure un bel disegno, ma non è un 7».
La SAGAN dà a ogni punto dell’immagine la possibilità di guardare quelli lontani, e le zampe tornano al loro posto; BigGAN la ingrandisce, e al momento di generare ripesca i numeri di partenza troppo estremi: immagini più belle e meno varie, una manopola che non tutte le reti reggono.
StyleGAN costruisce il volto a livelli e consegna a ciascun livello i propri cursori: da lì il controllo separato di posa, lineamenti e lentiggini. La risoluzione da fotografia, invece, era già stata conquistata dal modello che l’ha preceduta, la Progressive GAN.
Sotto il cofano, due meccanismi. Si cresce per gradini, da sedici pixel a un milione, e a ogni gradino si passa in dissolvenza invece che di colpo. Lo stile non impartisce ordini: rimette tutte le corsie del segnale alla stessa taratura e poi le ritara, come un mixer.
La macchia a goccia delle immagini di StyleGAN, secondo la spiegazione dei suoi autori, era il falsario che si fabbricava un picco enorme per far passare, attraverso quella taratura, un’informazione che la taratura gli toglieva; e infatti, togliendo la taratura, le gocce spariscono. StyleGAN2 la sostituisce con un controllo che l’immagine non la guarda, e mette da parte anche la crescita per gradini, sostituita da scorciatoie che portano il segnale oltre gli strati.
pix2pix e CycleGAN traducono un’immagine in un’altra (schizzo in foto, foto in Monet); la seconda ci riesce senza coppie di immagini corrispondenti, grazie alla regola dell’andata e ritorno, che però va tenuta insieme all’esperto: da sola si lascia aggirare. E nemmeno insieme garantisce il soggetto, perché il falsario può nascondere la foto dentro il quadro, in una trama che l’occhio non vede, e ritrovarsela al ritorno.
VQ-GAN cambia lo scopo del duello: l’esperto non serve più a fare immagini, serve a fabbricare un alfabeto. Un’immagine diventa una fila di 256 simboli presi da un catalogo di mille, e da lì generarne una nuova è scrivere una frase nuova, con la stessa macchina che completa il testo. Senza l’esperto il catalogo si riempirebbe di tessere sbiadite, perché per «somigliare» conviene sempre il grigio medio.
Dal 2021 il testimone passa ai modelli di diffusione (Stable Diffusion, DALL·E 2). Le GAN restano dove conta la velocità (un colpo solo contro decine di passaggi), continuano a crescere (StyleGAN3, GigaGAN, R3GAN), e l’idea avversaria serve a costruire gli strumenti di oggi, anche quando poi nel prodotto finito l’esperto non c’è più.
Da ricordare
La DCGAN porta la convoluzione nelle GAN e ne fissa la ricetta di addestramento (convoluzioni con stride al posto del pooling, batchnorm salvo lo strato d’uscita di \(G\) e quello d’ingresso di \(D\), \(\tanh\) in uscita, Adam con \(\beta_1 = 0{,}5\)); la conditional GAN aggiunge il controllo tramite una variabile ausiliaria \(y\) passata a entrambe le reti.
SAGAN [ZGMO19] aggiunge l’auto-attenzione (blocco non-local con \(\gamma\) inizializzato a zero) a \(G\) e \(D\) e la normalizzazione spettrale anche a \(G\); BigGAN [BDS19] la scala e introduce il truncation trick (normale troncata al campionamento), fedeltà contro varietà, reso praticabile dalla regolarizzazione ortogonale.
StyleGAN introduce lo spazio latente intermedio \(\mathcal{W}\), la modulazione per strato via AdaIN [HB17] e il rumore per-livello: il suo contributo è il controllo scale-specific, mentre la scala di risoluzione è ereditata dalla Progressive GAN [KALL18], che la ottiene con la dissolvenza sui toRGB/fromRGB più equalized learning rate, normalizzazione pixelwise e minibatch standard deviation.
StyleGAN2 [KLA+20] attribuisce gli artefatti a goccia a un contrabbando di segnale attraverso l’instance normalization, con un’ipotesi che l’esperimento sostiene (senza normalizzazione le gocce spariscono), e li elimina con modulazione e demodulazione dei pesi: la rinormalizzazione agisce sui filtri sotto ipotesi statistiche, mai sulle attivazioni vere, quindi non offre un canale nascosto. Con essa cade anche la crescita progressiva, sostituita da una coppia asimmetrica (skip nel generatore, connessioni residue nel discriminatore), e arriva la path length regularization, che spinge un passo di ampiezza fissa in \(\mathcal{W}\) a produrre un cambiamento di ampiezza fissa nell’immagine: migliora il condizionamento numerico della mappa \(\mathcal{W} \to\) immagine e rende il generatore molto più facile da invertire.
pix2pix e CycleGAN fanno traduzione immagine-a-immagine (la seconda senza coppie, grazie alla cycle-consistency pesata da un \(\lambda\)); il ciclo però si può chiudere per steganografia, quindi non certifica la fedeltà al soggetto.
VQ-GAN [ERO21] sposta l’obiettivo del duello sul vocabolario: encoder e codebook come nel VQ-VAE, ma primo stadio in cui la loss percettiva sostituisce l’\(\ell_2\) e un discriminatore patch-based si aggiunge, il che alza il fattore di compressione ammissibile (\(f=16\): \(256\times256 \to 16\times16 = 256\) indici su \(K = 1024\), contro i 5.120 di VQ-VAE-2). Sopra, un Transformer autoregressivo sugli indici, a finestra scorrevole oltre la risoluzione di addestramento, e regge finché le statistiche del dataset sono all’incirca invarianti per traslazione o c’è un condizionamento spaziale. È la ricetta di perdite poi riusata nell’autoencoder di Stable Diffusion, con latente continuo invece che quantizzato.
Dal 2021 i modelli di diffusione (Stable Diffusion, DALL·E 2) raccolgono il testimone della generazione di immagini, con un FID migliore e un richiamo più alto. Le GAN restano rilevanti per la velocità di campionamento, nella distillazione avversaria dei modelli di diffusione (ADD) e come componente ibrida, decodificatori dei modelli latenti compresi; e la famiglia prosegue con StyleGAN3 (equivarianza a traslazioni e rotazioni), GigaGAN (testo-immagine a un miliardo di parametri) e R3GAN (loss relativistica con \(R_1\) e \(R_2\), localmente convergente).
Il duello esce ridimensionato ma non archiviato, ed è quello il lascito: non una famiglia di architetture, ma un modo di addestrare che sopravvive dentro sistemi che non si chiamano più GAN. La domanda però resta intera, fabbricare dati nuovi e plausibili senza un originale con cui confrontarsi, e i capitoli che seguono sono altrettante risposte diverse alla stessa domanda. La prima è quella dei modelli di diffusione, che al posto di due reti che si sfidano mette un dato ridotto a rumore e una rete che rifà la strada all’indietro.