


Alzare la temperatura: le macchine di Boltzmann#
La pallina di Hopfield ha un difetto di fabbrica: può solo scendere. Se l’indizio la deposita sul pendio sbagliato, finisce nella valle sbagliata (o in un ricordo fantasma) e da lì non esce più.
E c’è un limite più profondo: la rete ricorda, ma non inventa. Le sue venticinque caselle coincidono una a una con le venticinque caselle del disegno da ricordare, e non gliene resta nessuna libera per annotarsi qualcosa di suo, per esempio che nelle tre lettere le caselle accese sono sempre nove su venticinque. Di una rete che non ha caselle libere per queste annotazioni si dice che non ha rappresentazioni interne.
La risposta a tutti e due i limiti si chiama macchina di Boltzmann, e aggiunge alla rete di Hopfield esattamente due ingredienti: la temperatura (la scossa di cui si diceva in apertura di capitolo) e i neuroni nascosti, le caselle libere per gli appunti. Si chiamano così perché non si vedono né in entrata né in uscita, come i neuroni degli strati intermedi di una rete, mentre le caselle su cui si posano i dati si dicono per contrasto visibili. Il nome compare già nel 1983, in un lavoro di Scott Fahlman, Geoffrey Hinton e Terrence Sejnowski [FHS83]; l’articolo che ne fissa l’algoritmo di apprendimento, quello di cui si parla qui, è del 1985 e porta la firma di David Ackley, Hinton e Sejnowski [AHS85].
Il nome è un omaggio a Ludwig Boltzmann, uno dei padri della meccanica statistica, cioè della fisica che spiega il comportamento di miliardi di particelle contando le configurazioni possibili invece di seguirle una per una. E non è un omaggio generico. Se si lascia scuotere questa rete abbastanza a lungo, e poi si guarda dov’è a intervalli a caso, si scopre che passa più tempo nelle valli profonde e pochissimo sulle cime, in proporzioni che Boltzmann aveva calcolato un secolo prima per un gas o per un pezzo di metallo caldo. Sono le stesse proporzioni, con la stessa formula.
Quel tempo è una probabilità. Se la rete può arrivare da ogni configurazione a ogni altra (con la temperatura sopra zero è così), la frazione di tempo che passa in una regione dello spazio degli stati tende, a lungo andare, alla probabilità \(P\) di quella regione: osservandola a intervalli regolari un milione di volte e trovandola trentamila volte in fondo a una certa valle, la probabilità di quella valle è circa il 3%. È la porta da cui un’altezza diventa una probabilità, e il pedaggio da pagare per attraversarla è la funzione di partizione, a cui è intitolata Oltre la partizione.
La temperatura è una scossa. La pallina è ferma in una conca che non è la valle giusta, e se il paesaggio resta immobile non ne esce più. Scuoti tutto, come faresti con una scatola da scarpe che ha dentro una pallina: con scossoni forti salta fuori anche dalle valli profonde e gira dappertutto; con scossoni deboli resta confinata nei fondovalle. Il trucco è scuotere forte all’inizio e sempre più piano, così esce dalle conche mediocri finché può e si assesta in una valle profonda quando la calma torna.
I neuroni nascosti sono taccuini interni: caselle che non corrispondono a nessuna casella del dato e servono alla rete per annotare regolarità sue («qui c’è una riga verticale», «questi due angoli vanno insieme»).
Imparare diventa un confronto fra due modi di stare al mondo. Nella veglia la macchina guarda i dati veri e segna quali coppie di caselle si accendono insieme. Le coppie, e non altro: i suoi legami collegano due caselle per volta, e non sa segnare altro. Una regola come «nella riga in cima le caselle accese sono sempre in numero pari» riguarda cinque caselle insieme, e con legami a due a due non si scrive. Si vede già con tre caselle: i modi di accenderne un numero pari sono quattro (nessuna, la prima e la seconda, la prima e la terza, la seconda e la terza). Guardando soltanto la prima e la seconda, in quei quattro disegni sono accese insieme una volta, spente insieme una volta, e discordi due volte, esattamente come se le avessi tirate a sorte con due monete; e lo stesso vale per ogni altra coppia. I legami, che guardano due caselle alla volta, non hanno niente da segnare.
È qui che i taccuini si guadagnano il posto. Ogni taccuino ha un legame con ciascuna casella del disegno, e può imparare ad accendersi quando ne vede accese almeno un certo numero: uno da una in su, uno da due in su, e così via. Dai taccuini accesi si legge quante caselle sono accese, e quindi se sono pari: una regolarità che riguarda parecchie caselle insieme la macchina la impara appoggiandola lì. Nel sogno la si lascia inventare configurazioni per conto suo, e si segna la stessa cosa.
Poi si ritoccano i legami, e ritoccare un legame vuol dire deformare il paesaggio: sono i legami a decidere l’altezza di ogni punto. Rinforzare quello che si vede da svegli abbassa il terreno sotto i dati veri; indebolire quello che si vede solo in sogno lo alza sotto le fantasie. Un gesto solo, guardato da due parti. Si smette quando i sogni sono indistinguibili dalla veglia: quello che la macchina si immagina ha le stesse regolarità di quello che ha visto.
Il guaio è il tempo. Sognare per bene vuol dire lasciarla scuotere finché le proporzioni non smettono di cambiare, cioè finché altre mille occhiate non spostano più i conteggi: è il momento in cui si è fotografato il paesaggio e non un pezzo di passeggiata, e arriva tardissimo. Nella macchina com’era nata nel 1985 costava carissima anche la veglia, e la ragione è che i taccuini sono collegati anche fra loro: nessuno può decidere se accendersi finché non sa che cosa stanno facendo gli altri. Anche con i dati veri sotto gli occhi, quindi, bisognava aspettare che si mettessero d’accordo, e quell’attesa andava rifatta da capo per ogni singolo dato dell’archivio.
Nella macchina di Boltzmann l’aggiornamento del neurone \(i\) diventa stocastico:
dove \(h_i = \sum_{j \neq i} w_{ij} s_j\) è il campo locale, \(\sigma\) la sigmoide e \(T > 0\) la temperatura. Il fattore 2 non è un refuso e non è universale: viene dalla convenzione \(s_i \in \{-1,+1\}\) degli spin, quella con cui la sezione precedente ha scritto l’energia; Hopfield, nel 1982, usava \(\{0,1\}\). Il conto è il rapporto di Gibbs fra i due stati possibili del neurone, che per la sezione precedente valgono \(E(s_i = \pm 1) = \mp h_i + \text{cost}\), e quindi distano \(\Delta E = 2h_i\):
È quel salto di \(2h_i\), e non \(h_i\), a produrre il 2. Chi confronta con altre fonti tenga d’occhio la convenzione: l’articolo originale di Ackley, Hinton e Sejnowski usa unità in \(\{0,1\}\), dove il salto è \(h_i\) e la formula è \(\sigma(h_i/T)\) senza il fattore, ed è la stessa forma delle condizionali dell’RBM, scritte più sotto con la contrastive divergence.
Per \(T \to 0\) si ritrova l’aggiornamento deterministico di Hopfield; per \(T\) grande la rete accetta spesso anche mosse che alzano l’energia, e può quindi evadere dai minimi locali (abbassare \(T\) gradualmente è la ricottura simulata). All’equilibrio termico la rete visita gli stati secondo la distribuzione di Boltzmann–Gibbs
dove \(Z\) (la funzione di partizione) somma su tutti i \(2^N\) stati possibili: è lei che rende la rete un vero modello probabilistico, ed è lei che costerà carissima. Anche qui le ipotesi vanno dette, perché sono quattro e sono tutte necessarie. I pesi devono restare simmetrici: senza \(w_{ij} = w_{ji}\) la dinamica ha in generale una distribuzione stazionaria diversa da questa, e di solito senza forma chiusa (ed è un altro mestiere della simmetria, rispetto a quello di garantire la discesa che aveva nella sezione precedente). L’aggiornamento dev’essere asincrono: con l’aggiornamento sincrono, quello di Little, la distribuzione stazionaria è un’altra, per la stessa differenza che nella sezione precedente faceva cadere la garanzia di discesa. Inoltre, ogni aggiornamento di un neurone è una mossa del campionamento di Gibbs che lascia invariata questa distribuzione, e scegliendo il neurone a caso vale anche il bilancio dettagliato; con una scansione in ordine fisso (o per permutazioni, come nel codice della memoria di Hopfield) resta l’invarianza ma la catena composta non è reversibile. La temperatura dev’essere \(T > 0\) (a \(T = 0\) la catena si inchioda nel primo minimo). E ogni neurone va visitato infinitamente spesso. I neuroni si dividono in visibili (dove si presentano i dati) e nascosti (variabili latenti che catturano regolarità di ordine superiore). L’apprendimento massimizza la verosimiglianza dei dati sui visibili, e il gradiente ha una forma di contrasto di rara eleganza:
dove \(\langle \cdot \rangle\) è il valore atteso (le parentesi angolari sono la notazione dei fisici per l’\(\mathbb{E}[\cdot]\) del resto del libro, e qui si tengono perché è così che la formula si trova in letteratura). Il primo termine è la correlazione media tra i neuroni \(i\) e \(j\) con i visibili bloccati sui dati (fase positiva, la «veglia»), e il secondo la stessa correlazione con la rete libera di campionare da sé (fase negativa, il «sogno»). Il «\(\propto\)» nasconde un \(1/T\): il tasso di apprendimento effettivo dipende dalla temperatura a cui si raccolgono le statistiche. La derivazione è quella che Oltre la partizione svolge per un’energia qualunque, applicata due volte: \(\partial E/\partial w_{ij} = -s_i s_j\) (il fattore 2 che cancella il \(\tfrac12\) viene dal vincolo di simmetria, che di \(w_{ij}\) e \(w_{ji}\) fa un parametro solo), e poiché i dati vincolano solo i visibili bisogna passare alla marginale, cioè sommare la congiunta su tutte le configurazioni dei nascosti: compare così una seconda media, quella sui nascosti dati i visibili. Da lì i due termini.
Nella macchina di Boltzmann originale, a connettività generale, il problema non è solo il secondo termine: lo sono tutti e due. Con i visibili bloccati sui dati la media \(\langle s_i s_j \rangle_{\text{dati}}\) non ha forma chiusa, perché le unità nascoste sono interconnesse fra loro, e va stimata anch’essa portando una catena all’equilibrio, per ogni vettore d’addestramento. Ackley, Hinton e Sejnowski, nell’esperimento 40-10-40 del loro articolo, ricuociono la rete una volta con ciascuno dei quaranta vettori bloccati e altrettante volte senza bloccare niente, per ogni passo di gradiente: ottanta ricotture per un solo aggiornamento dei pesi. La fase positiva ne costa esattamente quanto la negativa, perché va rifatta dato per dato. È questo doppio ciclo a rendere l’algoritmo originale inutilizzabile oltre i problemi giocattolo, ed è metà esatta di quel doppio ciclo che l’RBM, fra poco, farà sparire.
Il sogno abbreviato: contrastive divergence#
La via d’uscita arriva quasi vent’anni dopo, ed è di nuovo di Hinton: la contrastive divergence [Hin02], che in italiano suonerebbe «divergenza contrastiva». Il nome viene dall’obiettivo che Hinton scrive: una differenza fra due divergenze di Kullback e Leibler, la misura (costruita nel capitolo sulla teoria dell’informazione) di quanto una distribuzione si discosta da un’altra, \(\mathrm{KL}(p_0 \,\|\, p_\theta) - \mathrm{KL}(p_k \,\|\, p_\theta)\). Qui \(p_\theta\) è la distribuzione del modello, \(p_0\) quella dei dati e \(p_k\) quella del sogno abbreviato, cioè degli stati in cui arriva la rete lasciata evolvere per \(k\) passi partendo dai dati. Dentro c’è il contrasto fra veglia e sogno di cui si è appena detto. In una riga: rinunciare al sogno completo. Invece di lasciar sognare la macchina finché il sogno non si assesta, la si fa partire da una cosa vera e le si concede un istante solo di fantasia.
Si bara in due modi. Il primo è non lasciar sognare la macchina fino in fondo: la si fa partire da una cosa vera e le si concede un istante solo di fantasia. Il sogno che ne esce è appena abbozzato, costa un attimo invece di un’eternità, e basta lo stesso. Il difetto è prevedibile: partendo sempre da cose vere, la macchina non va mai a curiosare nelle regioni in cui si sbaglia di grosso, e quelle regioni restano sbagliate perché nessuno ci va ad alzare il terreno.
Il secondo modo rimedia proprio a questo, e non costa niente di più: non far ricominciare il sogno da capo ogni volta, ma lasciar continuare quello di prima. Un po’ per volta il sogno si allontana e finisce anche nei posti dove la macchina si illude. Si chiama contrastive divergence persistente, dove «persistente» è il sogno che non viene mai interrotto.
C’è un prezzo, ed è meglio saperlo che credere di aver trovato una scorciatoia gratis. Di solito, quando una macchina impara, c’è un numero che dice quanto sta sbagliando. Non è l’energia: l’energia è il voto dato a una singola risposta, questo è un voto dato all’intera macchina, e lo si guarda una volta ogni tanto. Imparare vuol dire farlo calare: finché cala si è sulla strada giusta, e quando smette si è arrivati. Quel numero, qui, resta fuori portata: calcolarlo vorrebbe dire misurare il paesaggio intero, ed è il conto a cui è intitolata la sezione dopo. Lo si può soltanto stimare, con un conto lungo e approssimato che si fa di rado, per esempio per confrontare due macchine a lavoro finito. I ritocchi del sogno abbreviato somigliano a quelli che farebbero scendere quel numero, ma non sono i suoi, e nel caso più studiato si è dimostrato che non sono nemmeno la discesa di nessun altro numero. Nessuno può garantire che la macchina stia andando verso qualcosa invece che in tondo. In pratica, sulle reti di allora, funzionava benissimo.
Invece di far girare la catena fino all’equilibrio, la si fa partire dai dati e la si ferma dopo un solo passo (o pochi), usando quel sogno appena abbozzato come surrogato della fase negativa. Funziona soprattutto sulle macchine di Boltzmann ristrette (RBM), la variante in cui i collegamenti esistono solo tra strato visibile e strato nascosto. Con unità in \(\{0,1\}\), \(\mathbf{v} \in \{0,1\}^{n_v}\) e \(\mathbf{h} \in \{0,1\}^{n_h}\) (\(T = 1\)),
dove \(\mathbf{W} \in \mathbb{R}^{n_v \times n_h}\) sono i pesi e \(\mathbf{a}\), \(\mathbf{b}\) le soglie dei due strati. Senza legami interni a uno strato, la condizionale si fattorizza: \(p(h_j = 1 \mid \mathbf{v}) = \sigma\big(b_j + (\mathbf{W}^\top \mathbf{v})_j\big)\) e \(p(v_i = 1 \mid \mathbf{h}) = \sigma\big(a_i + (\mathbf{W}\mathbf{h})_i\big)\), la sigmoide senza fattore 2 delle unità in \(\{0,1\}\). Quindi la fase positiva ha forma chiusa, e ogni strato si campiona in blocco, in parallelo. Il gradiente della log-verosimiglianza rispetto ai pesi è \(\mathbb{E}_{\text{dati}}\big[\mathbf{v}\,\mathbb{E}[\mathbf{h} \mid \mathbf{v}]^\top\big] - \mathbb{E}_{p(\mathbf{v}, \mathbf{h})}\big[\mathbf{v}\mathbf{h}^\top\big]\), e CD-\(k\) sostituisce il secondo termine con la catena di Gibbs fermata dopo \(k\) passaggi alternati partendo dal dato \(\mathbf{v}^{(0)}\):
Per \(k \to \infty\) si ritrova il gradiente esatto; a \(k\) finito l’aggiornamento trascura il termine che nasce dal fatto che anche \(p_k\) dipende dai parametri. Costa \(O(k \, n_v n_h)\) per esempio di addestramento. È l’RBM a riparare la metà cara di cui sopra; la contrastive divergence accorcia l’altra.
Nell’RBM le nascoste si sommano via una alla volta, e la marginale dei visibili è \(p(\mathbf{v}) = e^{-F(\mathbf{v})}/Z\) con l’energia libera
che si calcola in \(O(n_v n_h)\). Da lì i gradienti rispetto alle soglie hanno la stessa forma di contrasto: \(\mathbb{E}_{\text{dati}}[\mathbf{v}] - \mathbb{E}_{p}[\mathbf{v}]\) per \(\mathbf{a}\) e \(\mathbb{E}_{\text{dati}}[\hat{\mathbf{h}}] - \mathbb{E}_{p}[\mathbf{h}]\) per \(\mathbf{b}\). Fuori portata resta soltanto \(Z\), che somma \(e^{-F}\) su \(2^{n_v}\) configurazioni (o, simmetricamente, su \(2^{n_h}\) configurazioni delle nascoste): si calcola esattamente in \(O(2^{\min(n_v, n_h)}\, n_v n_h)\) finché il minimo dei due resta sotto una ventina di unità, e oltre si stima, per esempio con l’annealed importance sampling [SM08]. È così che si confrontano due RBM, perché la log-verosimiglianza che la contrastive divergence non segue si può misurare solo passando da \(Z\).
Sulla natura di quell’aggiornamento conviene essere precisi, perché due cose diverse si confondono con facilità. Una stima distorta del gradiente della log-verosimiglianza l’aggiornamento lo è per costruzione: la fase negativa esatta viene sostituita da una catena fermata dopo un passo, e la sostituzione introduce una distorsione. Quello che non è, è il gradiente esatto di qualche funzione. Sutskever e Tieleman ne danno due dimostrazioni, attribuendo il risultato a Tieleman (2007), per l’aggiornamento CD1 noiseless (cioè con le attese calcolate esattamente, non stimate) su RBM binarie [ST10]. Il perimetro finisce lì, e sono loro a dirlo: non sono riusciti a escludere che CD stia comunque minimizzando qualcosa per altra via, e chiudono scrivendo che dimostrare la convergenza di CD resta un problema aperto. Si può poi costruire un termine di penalità (artificioso, ma legittimo) che lo fa ciclare all’infinito invece di fermarsi, mentre con la penalità \(L^2\) di tutti i giorni gli stessi autori dimostrano che un punto fisso esiste per le macchine di Boltzmann completamente visibili; per le RBM esiste in modo banale, e lo fanno notare.
Il perimetro dell’enunciato è stretto e istruttivo, e i due autori lo tracciano richiamando risultati anteriori di Aapo Hyvärinen (2007): se la catena è di Langevin, al limite di rumore infinitesimo, lo stesso aggiornamento diventa il gradiente dello score matching, che Oltre la partizione prende come seconda via; e se campiona una componente a caso dalla condizionale diventa quello della pseudo-verosimiglianza. È proprio nel caso comune, Gibbs su RBM binarie, che non è il gradiente esatto di niente. In pratica funzionava lo stesso: è uno di quei casi in cui un campo ha usato per anni uno strumento senza la proprietà che gli attribuiva.
Il compromesso ha un secondo difetto, questo intuitivo: partendo sempre dai dati, la catena esplora solo i dintorni di ciò che ha già visto, e le regioni in cui il modello mette per sbaglio molta probabilità restano inesplorate, perché nessuno va a farvi salire l’energia. Il rimedio più semplice è la persistent contrastive divergence [Tie08], nota nella statistica già da prima col nome di stochastic maximum likelihood [You99]: non far ripartire la catena dai dati a ogni passo, ma tenerne una che prosegue da dove era arrivata, così che nel corso dell’addestramento il «sogno» abbia il tempo di allontanarsi e di visitare il paesaggio. È un’idea che ritroveremo intatta, con un serbatoio di campioni al posto della singola catena, nei modelli a energia sulle immagini di una decina d’anni dopo.
La macchina che ha lasciato il segno, però, non è quella di Ackley, Hinton e Sejnowski, dove ogni neurone è collegato a tutti gli altri: è una sua versione sfoltita, in cui i collegamenti restano soltanto fra un neurone visibile e uno nascosto, e nessuno più fra due visibili o fra due nascosti (Fig. 29.4). Si chiama macchina di Boltzmann ristretta, e tutti la chiamano con la sigla inglese, RBM, da restricted Boltzmann machine. La propose nel 1986 Paul Smolensky, che la chiamava harmonium [Smo86], sedici anni prima della contrastive divergence che l’ha resa praticabile.
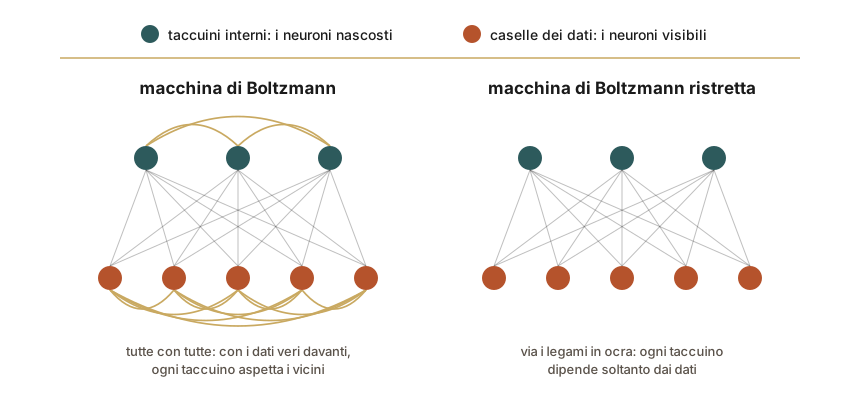
Fig. 29.4 Che cosa toglie la potatura. A sinistra ogni casella è collegata a tutte le altre; a destra restano soltanto i legami fra le due file, e i tredici in ocra spariscono. È quel taglio a far sì che, con i dati veri davanti, ogni neurone nascosto possa decidere da sé invece di aspettare i vicini.#
È quella potatura a far cadere il costo della veglia. Il motivo si dice in una riga: se i nascosti non sono collegati fra loro, con i visibili fissati sui dati ogni nascosto dipende soltanto dai dati, e nessuno deve aspettare la decisione di un altro nascosto per prendere la sua. Non c’è niente da assestare: si calcola tutto in un colpo solo. Il secondo costo, il sogno, è quello che la contrastive divergence di poco fa ha già accorciato. Insieme, le due mosse rendono praticabile ciò che nel 1985 non lo era.
Quella riga (nascosti non collegati fra loro, e con i visibili fissati ciascuno dipende soltanto dai visibili) è il caso particolare di una regola che vale per ogni disegno di legami. Una distribuzione su variabili unite da legami senza verso, che dicono soltanto che due variabili si influenzano e non quale delle due influenzi l’altra, si chiama modello grafico non orientato, o campo aleatorio di Markov. La macchina di Boltzmann ne è uno, e il suo disegno si legge come un elenco di indipendenze: chi dipende da chi, e dato che cosa [HTF09].
Il disegno dei legami funziona come un passaparola. Due caselle legate si influenzano direttamente; due che non lo sono possono influenzarsi soltanto passando per altre, lungo una strada di legami. E se ogni strada dall’una all’altra passa per variabili che si conoscono già, le due non hanno più niente da dirsi: tutto quello che una potrebbe raccontare dell’altra è già scritto in quelle che stanno in mezzo.
Nella rete ristretta ogni strada fra due taccuini passa per le caselle dei dati. Con i dati davanti, allora, i taccuini non si dicono niente, ed è la ragione per cui ognuno decide da sé; lo stesso vale al contrario, per le caselle, quando i taccuini sono fissati. Ma non bisogna leggerci più di questo. Senza guardare i dati i taccuini non sono affatto indipendenti: se due taccuini sono legati alla stessa casella, uno acceso rende più probabile che quella casella sia accesa, e la casella accesa rende più probabile che si accenda anche l’altro. Il passaparola si interrompe solo quando chi sta in mezzo è già noto. E dove fra due variabili c’è una strada sola, allungando la strada il passaparola non arriva mai più forte, e di solito arriva più debole.
Il disegno dice anche come è fatto il paesaggio. L’altezza di un punto si calcola sommando dei pezzi, e ogni pezzo può guardare soltanto caselle che si toccano tutte a due a due. Prendi tre caselle legate a triangolo. Nella macchina di Boltzmann i pezzi sono tre, uno per legame: uno guarda la prima e la seconda casella, uno la seconda e la terza, uno la prima e la terza, e ciascuno abbassa o alza il paesaggio secondo come stanno le sue due. Siccome le tre caselle si toccano tutte, il disegno permetterebbe anche un quarto pezzo che le guarda tutte e tre insieme, per esempio uno che abbassa il paesaggio solo quando se ne accendono esattamente due; la macchina di Boltzmann non se lo concede, e si ferma ai pezzi a due a due. È lo stesso motivo per cui, senza taccuini, la regola del numero pari su cinque caselle non si poteva scrivere.
Un grafo non orientato \(G = (V, E)\) sulle variabili \(\mathbf{s}\) è un grafo di Markov per \(p\) (qui la \(p\) minuscola della letteratura sui grafi: con \(T = 1\) è la \(P\) di Boltzmann-Gibbs) se l’assenza di un arco vuol dire indipendenza condizionale dato tutto il resto: \(s_i \perp s_j \mid \mathbf{s}_{V \setminus \{i,j\}}\) per \((i, j) \notin E\) (proprietà di Markov a coppie). Per distribuzioni strettamente positive questa equivale alla proprietà globale: se \(C\) separa \(A\) da \(B\), cioè ogni cammino fra i due passa per \(C\), allora \(\mathbf{s}_A \perp \mathbf{s}_B \mid \mathbf{s}_C\). Ed equivale, per il teorema di Hammersley e Clifford, alla fattorizzazione sulle cricche massimali \(\mathcal{C}\), i sottoinsiemi di nodi tutti adiacenti fra loro:
cioè un modello a energia con un termine per cricca e la sua funzione di partizione [HTF09]. Il grafo non fissa però l’ordine delle interazioni: su un triangolo stanno sia tre potenziali a coppie sia uno solo a tre. La macchina di Boltzmann è la scelta a coppie, la più parsimoniosa, con un parametro per legame: \(E(\mathbf{s}) = -\sum_{(i,j) \in E} w_{ij}\, s_i s_j\) più le soglie, che sono termini su una variabile sola; per questo una dipendenza di ordine più alto fra le visibili, come la parità, entra solo marginalizzando delle nascoste.
Nell’RBM il grafo è bipartito: \(\mathbf{v}\) separa ogni coppia di nascoste, da cui \(p(\mathbf{h} \mid \mathbf{v}) = \prod_j p(h_j \mid \mathbf{v})\), e simmetricamente per le visibili dato \(\mathbf{h}\). La separazione però vale solo condizionando. Marginalizzando \(\mathbf{v} \in \{0,1\}^{n_v}\),
e ogni fattore dipende da tutte le \(h_j\) legate alla visibile \(i\): le nascoste si accoppiano attraverso le visibili che condividono. Quanto la dipendenza si attenui lungo un cammino il grafo da solo non lo dice. Su un albero, dove il cammino fra due nodi è unico, ogni nodo intermedio li separa, e l’informazione mutua non può crescere allontanandosi (è la disuguaglianza di elaborazione dei dati); con cicli e accoppiamenti forti questa garanzia non c’è.
Il conto prende una rete ristretta minuscola, tre visibili e due nascosti, con i legami scelti a mano: il primo visibile è legato a tutti e due i nascosti, il secondo solo al primo, il terzo solo al secondo. Con così poche variabili la distribuzione si calcola per intero, \(Z\) compresa, e le indipendenze si misurano invece di supporle. La misura è la correlazione, che vale zero quando una variabile non dice niente dell’altra, uno quando si accendono e si spengono sempre insieme, ed è negativa quando vanno in senso opposto.
import itertools
import numpy as np

# tre visibili e due nascosti; i legami esistono solo fra visibili e nascosti
W = np.array([[3.0, 3.0],     # il primo visibile è legato ai due nascosti
              [3.0, 0.0],     # il secondo solo al primo
              [0.0, 3.0]])    # il terzo solo al secondo
a, b = np.full(3, -2.0), np.full(2, -2.0)          # le soglie: spenti, da soli

# la distribuzione intera, stato per stato, con la sua Z
P = np.zeros((2,) * 5)
for s in itertools.product([0, 1], repeat=5):
    v, h = np.array(s[:3]), np.array(s[3:])
    P[s] = np.exp(a @ v + b @ h + v @ W @ h)
P /= P.sum()

def correlazione(Q):
    """Correlazione fra le due variabili di una tabella 2 x 2 di probabilità."""
    Q = Q / Q.sum()
    p, q = Q[1, :].sum(), Q[:, 1].sum()
    return (Q[1, 1] - p * q) / np.sqrt(p * (1 - p) * q * (1 - q))

tutte = list(itertools.product([0, 1], repeat=3))
ignorate = lambda assi: correlazione(P.sum(axis=assi))   # sommando via il resto
fissate = max(abs(correlazione(P[v])) for v in tutte)
print(f"i due nascosti, visibili fissati:  {fissate:.3f} nel caso peggiore")
print(f"i due nascosti, visibili ignorati: {ignorate((0, 1, 2)):.3f}")
fissati = max(abs(correlazione(P[:, :, :, i, j].sum(axis=2)))
              for i in (0, 1) for j in (0, 1))
print(f"visibili 1 e 2, nascosti fissati:  {fissati:.3f} nel caso peggiore")
print(f"visibili 1 e 2, nascosti ignorati: {ignorate((2, 3, 4)):.3f}")
print(f"visibili 2 e 3, nascosti ignorati: {ignorate((0, 3, 4)):.3f}")
i due nascosti, visibili fissati:  0.000 nel caso peggiore
i due nascosti, visibili ignorati: 0.277
visibili 1 e 2, nascosti fissati:  0.000 nel caso peggiore
visibili 1 e 2, nascosti ignorati: 0.256
visibili 2 e 3, nascosti ignorati: 0.065
Con i visibili fissati la correlazione fra i due nascosti è zero anche nel caso peggiore, cioè nella combinazione di visibili accesi e spenti in cui si allontana di più da zero; e lo stesso vale per i visibili 1 e 2 con i nascosti fissati. Ignorando i visibili, i due nascosti si correlano a 0,277, perché sono legati allo stesso primo visibile; ignorando i nascosti, i visibili 1 e 2 si correlano a 0,256, perché condividono il primo nascosto. I visibili 2 e 3 non hanno nessun vicino in comune, e la strada più corta fra loro passa per tutti e due i nascosti e per il primo visibile: la loro correlazione è 0,065, più debole ma non nulla.
Fu proprio la coppia RBM più contrastive divergence a rimettere in moto il deep learning a metà anni Duemila, quando addestrare reti profonde sembrava impossibile [HOT06]. L’idea era di preparare la rete uno strato alla volta, senza etichette, prima di addestrarla tutta insieme: è il pre-training, e la ricetta si chiamava greedy layer-wise, cioè avida, strato per strato. Si addestra una RBM sui dati; la si congela, e i suoi nascosti, accesi o spenti dai dati, diventano i visibili di una seconda RBM, e così via; solo alla fine si rifinisce l’intera rete con le etichette. Bengio e colleghi mostrarono che lo schema funziona anche con gli autoencoder, le reti che imparano a ricostruire i propri dati, al posto delle RBM [BLPL07]. Erhan e colleghi misero alla prova il perché, e trovarono che il pre-addestramento serve soprattutto a tenere la rete lontana dalle soluzioni imparate a memoria, cioè fa da regolarizzatore, più che ad aiutarla a scendere più in basso nella funzione di perdita [EBC+10]. Di lì a pochi anni le ReLU, le GPU e archivi di dati più grandi avrebbero reso superfluo quel modo di partire, e oggi le RBM non si usano quasi più.
Il modo di ragionare con cui erano state costruite, invece, è vivo e vegeto: nella prossima sezione si vede perché, e quanto costi davvero misurare il paesaggio intero, cioè il gesto che trasforma un’altezza in una percentuale.
Da ricordare
La macchina di Boltzmann aggiunge alla rete di Hopfield due cose: la possibilità di risalire ogni tanto (si scuote il paesaggio, e quella scossa si chiama temperatura) e qualche neurone in più che non corrisponde a nessun pixel, buono per annotarsi le regolarità del dato.
Si scuote forte all’inizio e sempre più piano: così la pallina esce dalle conche mediocri finché può, e si assesta in una valle profonda quando la calma torna. È la ricottura simulata nominata in apertura di capitolo.
Imparare è un confronto fra veglia e sogno: si guarda che cosa succede nella rete quando le si mostrano i dati veri, poi che cosa succede quando la si lascia fantasticare da sola, e si ritoccano i legami per rinforzare la prima e indebolire la seconda. Si smette quando i sogni sono indistinguibili dalla veglia.
Il guaio è il tempo, e sono cari tutti e due i gesti: la veglia va rifatta da capo con ogni dato, e il sogno fatto per bene non finisce mai. La rete ristretta (in sigla RBM: i taccuini interni scollegati fra loro) sistema la veglia; la contrastive divergence bara sul sogno, concedendo alla macchina un istante solo di fantasia a partire da una cosa vera. Funziona, ma è una scorciatoia, non una soluzione: il numero che dice quanto la macchina sta sbagliando resta fuori portata, e nel caso più studiato si è dimostrato che i ritocchi che fa non sono la discesa di nessun numero.
Il disegno dei legami dice chi dipende da chi: due variabili non collegate si influenzano solo attraverso quelle in mezzo, e se quelle sono note non si dicono più niente. Con i dati davanti i taccuini decidono ognuno per conto suo; senza guardare i dati, due taccuini legati alla stessa casella vanno d’accordo.
Da qui in avanti l’altezza del paesaggio diventa una percentuale, e per trasformarla bisognerebbe aver misurato il paesaggio intero, valle per valle. È il conto che l’apertura del capitolo chiamava funzione di partizione, ed è il personaggio a cui è intitolata la prossima sezione.
Da ricordare
La macchina di Boltzmann [AHS85] aggiunge a Hopfield la temperatura (aggiornamenti stocastici, quindi la possibilità di risalire e uscire dai minimi sbagliati) e i neuroni nascosti (rappresentazioni interne, non solo pixel).
All’equilibrio la rete campiona dalla distribuzione di Boltzmann–Gibbs \(P(\mathbf{s}) = e^{-E(\mathbf{s})/T}/Z\): da qui in avanti l’energia definisce una probabilità, e con essa arriva la funzione di partizione \(Z\).
L’apprendimento è un contrasto fra fase positiva (dati) e fase negativa (campioni del modello). Nella macchina originale entrambe richiedono una catena portata all’equilibrio, e la positiva va rifatta per ogni dato: l’RBM rende chiusa la prima, e resta la seconda come collo di bottiglia.
La contrastive divergence [Hin02] accorcia la catena a uno o pochi passi partendo dai dati; la persistent CD [Tie08] la fa proseguire fra un aggiornamento e l’altro. È una stima distorta del gradiente della log-verosimiglianza, e l’aggiornamento CD1 noiseless su RBM binarie non è il gradiente esatto di nessuna funzione [ST10]: se stia minimizzando qualcosa per altra via resta un problema aperto. RBM e CD hanno avuto un ruolo storico nel far ripartire il deep learning, e oggi sono quasi solo storia; il linguaggio dell’energia no.
La macchina di Boltzmann è un campo aleatorio di Markov a potenziali di coppia: la separazione nel grafo dà l’indipendenza condizionale (proprietà globale), che per distribuzioni positive equivale alla proprietà a coppie e alla fattorizzazione sulle cricche (Hammersley e Clifford). Nell’RBM \(p(\mathbf{h} \mid \mathbf{v})\) si fattorizza, \(p(\mathbf{h})\) no.