


Il flusso che si può invertire#
La sezione precedente ha ottenuto la probabilità esatta scomponendo il dato in fattori condizionali, un valore alla volta. Questa la ottiene senza scomporre niente, con il cambio di variabile per le densità.
L’idea è questa. Invece di descrivere la distribuzione dei dati, che è complicatissima, si cerca una funzione invertibile \(f\) che porti i dati su una distribuzione di base semplice, di solito una gaussiana standard, di cui si conosce la densità \(p_Z\). Una \(f\) così serve a due cose. Per valutare un dato \(\mathbf{x}\) si calcola \(\mathbf{z} = f(\mathbf{x})\), si legge \(p_Z(\mathbf{z})\) e si corregge per quanto \(f\) ha dilatato o contratto lo spazio attorno a \(\mathbf{x}\). Per generare si estrae \(\mathbf{z}\) dalla gaussiana e si calcola \(f^{-1}(\mathbf{z})\), e quello che esce è un dato nuovo. Questa famiglia si chiama dei flussi normalizzanti.
La parola «flusso» è la stessa del flusso rettificato con cui il capitolo precedente genera immagini. Nella sezione sul flow matching un flusso è la mappa con cui un campo di velocità trasporta i punti dello spazio, e la parentela con le trasformazioni invertibili dei flussi normalizzanti è più stretta di quanto il vocabolario lasci pensare: la ricostruisce l’ultima sezione del capitolo.
Il fattore che nessuno si aspetta#
La matematica sta in una formula, e si capisce in una dimensione. Sia \(z\) distribuita in modo uniforme fra 0 e 1: la sua densità vale 1 dappertutto lì dentro, e l’area sotto la curva fa 1, come deve. Densità e probabilità non sono sinonimi, e conviene tenerle separate da subito: la densità è l’altezza della curva in un punto, la probabilità è l’area sotto la curva in un tratto. La trasformazione \(x = 3z + 1\) manda l’intervallo \([0, 1]\) in \([1, 4]\), tre volte più lungo, con la stessa probabilità totale, quindi la densità di \(x\) vale \(1/3\): stirando, la densità si divide per lo stiramento.
Un flusso fa la domanda nel verso opposto, ed è lì la trappola. La sua \(f\) va dai dati alla base, e la densità che si conosce è quella d’arrivo, \(p_Z\). Nell’esempio il dato è \(x\), e la funzione che lo riporta sull’uniforme è \(f(x) = (x - 1)/3\), che contrae di tre volte: la densità di \(x\) è quella della base nel punto d’arrivo, 1, moltiplicata per \(\lvert f'(x) \rvert = 1/3\). In generale, per una \(f\) invertibile e derivabile con continuità,
dove \(\mathbf{J}_f\) è la jacobiana di \(f\), la matrice delle derivate parziali \(\partial f_i / \partial x_j\), che dice di quanto si sposta ogni coordinata d’uscita quando si sposta di poco ogni coordinata d’ingresso; il valore assoluto del suo determinante dice di quante volte cambia il volume attorno al punto. A differenza del caso lineare, il fattore dipende dal punto: \(f\) può dilatare in una direzione e contrarre in un’altra, e farlo in modo diverso da un punto all’altro. Senza il fattore l’area sotto la curva non fa più uno, e una funzione la cui area non fa uno non è una densità di probabilità.
Il nome della famiglia viene da qui, e l’aggettivo circola con due letture. Danilo Rezende e Shakir Mohamed [RM15], che l’hanno reso popolare, definiscono il flusso come «una densità iniziale semplice trasformata in una più complessa applicando una successione di trasformazioni invertibili finché non si raggiunge la complessità desiderata», cioè nel senso della generazione, e spiegano il nome con il risultato: in fondo alla catena si ottiene ancora una densità normalizzata, la cui area fa uno, proprio grazie al fattore. Nei lavori di Esteban Tabak e colleghi sulla stima di densità [TT13, TVE10], da cui il principio viene e che Rezende e Mohamed citano quando lo introducono, «normalizzare» vuol dire invece portare i dati verso la normale, cioè verso la gaussiana: è il senso opposto, quello che si percorre per calcolare la probabilità. «Flusso» è il paragone con un fluido, perché la nuvola dei dati non salta da una forma all’altra, si sposta un poco alla volta, una trasformazione dopo l’altra.
Con l’uniforme il conto si fa a mente. Su una curva che non è piatta conviene vederlo: si stira di tre volte una gaussiana, se ne misura la densità contando i punti, e la si confronta con le due candidate: la densità della base nel punto \(f(x) = (x - 1)/3\) in cui \(f\) porta \(x\), con il fattore \(1/3\) e senza.
import numpy as np

rng = np.random.default_rng(0)


def gauss(v):
    """Densita' della gaussiana standard."""
    return np.exp(-0.5 * v ** 2) / np.sqrt(2 * np.pi)


# z e' la base, una gaussiana standard; il dato x = 3z + 1 la stira di tre
# volte e la sposta.
z = rng.standard_normal(2_000_000)
x = 3 * z + 1

# La densita' di x si misura contando: quanti punti per unita' di lunghezza.
bordi = np.linspace(-14, 16, 301)
larghezza = np.diff(bordi)
centri = (bordi[:-1] + bordi[1:]) / 2
conteggi, _ = np.histogram(x, bins=bordi)
misurata = conteggi / (len(x) * larghezza)

# Le due candidate: la densita' della base in f(x) = (x - 1)/3, con e senza
# il fattore 1/3.
senza = gauss((centri - 1) / 3)
con = senza / 3

print(f"scarto massimo dalla misura, senza il fattore: "
      f"{np.abs(misurata - senza).max():.4f}")
print(f"scarto massimo dalla misura, con il fattore:   "
      f"{np.abs(misurata - con).max():.4f}")
print(f"area sotto la candidata senza il fattore: "
      f"{(senza * larghezza).sum():.3f}")
print(f"area sotto la candidata con il fattore:   "
      f"{(con * larghezza).sum():.3f}")
scarto massimo dalla misura, senza il fattore: 0.2663
scarto massimo dalla misura, con il fattore:   0.0017
area sotto la candidata senza il fattore: 3.000
area sotto la candidata con il fattore:   1.000
Senza il fattore la candidata ha la forma giusta e l’altezza sbagliata: si scosta dalla curva misurata fino a 0,27, e la sua area fa 3. Con il fattore lo scarto scende a 0,002, che è il rumore di un conteggio su due milioni di punti, e l’area fa 1. È il fattore a fare della formula una densità.
Una grandezza che sta fra 0 e 1, sparsa in modo uniforme, è come un velo d’acqua alto un centimetro steso su un tavolo lungo un metro. La si stira: la si moltiplica per tre e le si aggiunge uno, così finisce fra 1 e 4. L’acqua è la stessa, non se n’è persa né aggiunta una goccia, ma il tavolo è diventato tre volte più lungo, e la stessa acqua su un tavolo tre volte più lungo sta tre volte più bassa: un terzo di centimetro. L’altezza dell’acqua in un punto è la densità; l’acqua che sta sopra un tratto di tavolo è la probabilità di quel tratto, e in tutto fa sempre uno.
Un flusso fa la domanda nel verso opposto. Conosce l’altezza dell’acqua sul tavolo d’arrivo, la nuvola semplice, e vuole quella sul tavolo di partenza, dove stanno le fotografie. La regola si legge allora in italiano, senza formule: la densità di una fotografia è la densità del punto dove la fotografia finisce, moltiplicata per quanto la macchina ha stirato lo spazio lì attorno. Il «moltiplicata» sorprende, ed è il punto in cui tutti si sbagliano. Se la macchina prende un pezzetto piccolo di fotografie e lo stira su una zona grande della nuvola, quel pezzetto si porta a casa tutta l’acqua di quella zona e la tiene in poco posto: lì l’acqua è alta, e quelle fotografie sono probabili. Se invece lo schiaccia in un puntino, si accontenta dell’acqua di un puntino, e lì le fotografie sono rare. Nel verso della generazione la macchina lavora all’inverso, e la regola si capovolge con lei: si divide, come sul tavolo allungato.
Quanto la macchina ha stirato lo dice il determinante, che abbiamo già incontrato nei richiami di matematica: di quante volte una trasformazione cambia l’area di un quadratino, il volume di un cubetto, e in mille dimensioni la stessa cosa senza più niente da disegnare. Lo si calcola da una tabella con una riga per ogni numero che esce dalla macchina e una colonna per ogni numero che entra, che in ogni casella dice di quanto si sposta quel numero d’uscita se si sposta di pochissimo quel numero d’ingresso: è la jacobiana. Passando per due trasformazioni in fila le variazioni si moltiplicano: un’area che triplica e poi raddoppia è cresciuta sei volte.
Rispetto ai richiami, però, cambia una cosa. Là il quadretto poteva stare dovunque sul foglio e il numero era sempre quello, perché lo stiramento era lo stesso dappertutto. Una macchina che raddrizza le fotografie schiaccia in un punto e allarga in quello a fianco: il numero è quello del punto in cui si sta guardando, e cambia se ci si sposta. Addestrarla vuol dire regolarla finché le fotografie vere, portate sulla nuvola e corrette per lo stiramento, finiscono dove l’acqua è più alta.
Due cose, poi, una macchina così non le può fare. La prima è buttare via: se all’andata lasciasse per strada anche un solo numero, al ritorno dovrebbe inventarselo, e quella che esce non sarebbe più la fotografia che era entrata. Per questo un flusso esce con esattamente tanti numeri quanti ne sono entrati. La seconda è schiacciare fino a zero, anche in un punto solo. Elevare al cubo, per esempio, vicino allo zero schiaccia sempre di più: il tratto fra 0 e 0,1 finisce fra 0 e 0,001, cento volte più corto, e le fotografie di quel tratto raccolgono l’acqua di un tratto cento volte più corto. Proprio nello zero lo stiramento vale zero: una fotografia che cade lì non raccoglie acqua per niente, e per riportarla indietro la macchina dovrebbe stirare all’infinito.
E adesso il guaio. Calcolare un determinante costa tantissimo: con il metodo generale servono all’incirca tante operazioni quanto è il cubo del lato della tabella. La tabella ha una riga e una colonna per ogni numero dell’immagine, e una figurina in bianco e nero di 32 pixel per lato ne ha già più di mille: mille per mille per mille fa un miliardo di operazioni, da rifare per ogni immagine e a ogni passo dell’addestramento. Su una fotografia vera non se ne parla nemmeno.
Sia \(f: \mathbb{R}^D \to \mathbb{R}^D\) un diffeomorfismo, cioè invertibile, di classe \(C^1\) e con inversa di classe \(C^1\), e \(\mathbf{z} = f(\mathbf{x})\). In forma logaritmica, che è quella che si usa, il cambio di variabile è
È la formula dei richiami su determinante e volume letta nell’altro verso. Là \(\mathbf{y} = \mathbf{f}(\mathbf{x})\) è l’immagine e la sua densità si ottiene dividendo per \(\lvert\det\mathbf{J}_{\mathbf{f}}\rvert\); qui si conosce la densità del punto d’arrivo \(\mathbf{z}\) e si risale a quella di partenza, quindi si moltiplica. Le due sono la stessa identità, perché \(\mathbf{J}_{f^{-1}}(\mathbf{z}) = \mathbf{J}_f(\mathbf{x})^{-1}\), e scritta nel verso della generazione lo stesso termine cambia segno. Per una \(f\) invertibile e \(C^1\) l’ipotesi sull’inversa equivale a \(\det\mathbf{J}_f \neq 0\) ovunque: \(x \mapsto x^3\) la viola in \(0\), dove la densità del modello si annulla e la jacobiana dell’inversa diverge. Il valore assoluto serve perché il determinante è con segno (dice anche se la trasformazione ribalta l’orientamento), mentre interessa solo il rapporto fra i volumi. Componendo più trasformazioni i logaritmi si sommano, ed è la ragione per cui in pratica si scrive tutto in scala logaritmica: una successione \(f = f_K \circ \dots \circ f_1\) dà
dove ogni jacobiana si valuta nel punto in cui quel passo lavora, e non in \(\mathbf{x}\): è la stessa dipendenza dal punto che ha la formula a un passo solo, scritta per una composizione.
Si addestra per massima verosimiglianza. Minimizzare la log-verosimiglianza negativa media su \(m\) esempi, \(\mathcal{L} = -\frac{1}{m}\sum_{i=1}^{m} \log p_X(\mathbf{x}^{(i)})\), equivale nel limite di molti dati a minimizzare \(D_{\mathrm{KL}}(p_{\text{dati}}\,\|\,p_X)\), perché le due quantità differiscono per l’entropia dei dati, che non dipende dai parametri. Con una base gaussiana standard il latente è definito a meno di una rotazione: per \(\mathbf{R}\) ortogonale, \(\mathbf{R} f\) è un flusso con la stessa verosimiglianza, perché \(p_Z\) è invariante per rotazioni e \(\lvert\det\mathbf{R}\rvert = 1\). È la stessa non identificabilità già incontrata nei modelli latenti.
Due vincoli discendono da qui, ed entrambi pesano. Il primo è che \(f\) dev’essere invertibile, quindi in particolare \(D_{\text{ingresso}} = D_{\text{uscita}}\): un flusso non riduce la dimensione, mai. Il secondo è il costo: il determinante di una matrice \(D \times D\) costa \(\mathcal{O}(D^3)\) con i metodi generali, e \(D\) qui è il numero di pixel per canali. Per \(32 \times 32\) in scala di grigi, \(D = 1024\) e il conto è \(1024^3 \approx 10^9\) operazioni per ogni immagine e a ogni passo di addestramento, con l’aggravante che serve anche il gradiente di quel determinante. Impraticabile.
Gli strati di accoppiamento#
La via d’uscita è cambiare la domanda. Invece di calcolare in fretta il determinante di una matrice qualunque, si costruisce \(f\) in modo che la sua jacobiana sia triangolare, e il determinante si legga sulla diagonale.
La ricetta si chiama strato di accoppiamento (coupling layer). Si dividono le coordinate, cioè i numeri della fotografia, in due gruppi, \(\mathbf{x} = (\mathbf{x}_a, \mathbf{x}_b)\), non per forza metà e metà. Il primo gruppo passa invariato. Il secondo viene scalato e traslato, cioè moltiplicato per un numero e spostato di un altro, coordinata per coordinata, e quei numeri li calcola una rete che legge il primo gruppo. Da uno strato al successivo i ruoli si alternano, così che ogni coordinata prima o poi venga trasformata e prima o poi faccia da guida.
L’idea è del 2014, di NICE [DKB15], dove però il secondo gruppo veniva soltanto traslato e non scalato: una traslazione non cambia i volumi, quindi quegli strati il fattore non lo toccavano affatto, e a cambiarlo restava un solo strato di scala in cima alla pila. La scala, che è quella che rende il fattore interessante, arriva con RealNVP [DSDB17], ed è la forma che il flusso sulle due lune mette in pratica.
Tre proprietà discendono tutte insieme: si torna indietro senza invertire la rete, il fattore di stiramento si legge sulle scale, e la rete che le decide può essere complicata quanto si vuole. È per questo che l’accoppiamento è diventato la ricetta più usata per un determinante a buon mercato, anche se non l’unica: i flussi autoregressivi e quelli continui sono altre due.
Una fotografia è una fila di numeri, uno per pixel, e la macchina la taglia in due parti, qui a metà. La prima passa com’è. Una rete la guarda e decide, per ogni numero dell’altra metà, di quanto moltiplicarlo e di quanto spostarlo: se per un pixel dice «per 2, più 3», un 4 diventa 11. Il moltiplicatore non può mai essere zero, perché al ritorno si dovrebbe dividere per zero: la rete non lo sceglie direttamente, ne sceglie l’esponente, e il moltiplicatore che ne esce è sempre positivo. Per tornare indietro non serve capire la rete. La prima metà è arrivata intatta: la si rilegge, si chiede di nuovo alla rete i suoi due numeri, che sono gli stessi dell’andata, e si disfa il conto, 11 meno 3 fa 8, diviso 2 fa 4. Per questo la rete non deve saper andare al contrario e può essere complicata quanto si vuole: la macchina si rovescia per come i pezzi sono montati, non per il pezzo che impara.
E il fattore di stiramento, che costava un miliardo di operazioni, qui si legge da solo. Torniamo al tavolo e all’acqua. Lungo la prima metà il tavolo non si allarga, perché quei numeri non si muovono. Lungo l’altra si allarga di quanto dice la moltiplicazione: un pixel moltiplicato per 2 raddoppia il suo pezzo di tavolo, e lo spostamento non allarga niente, come spingere il tavolo senza cambiarne la misura. L’acqua si abbassa soltanto per le moltiplicazioni, e il fattore è il loro prodotto: un pixel moltiplicato per 2 e un altro per 3 allargano il tavolo di 2 per 3, cioè 6 volte. Sono numeri che la rete ha appena dato, comunque complicato sia il modo in cui li ha calcolati, e sulla figurina di 32 pixel per lato fanno cinquecentododici moltiplicazioni invece di un miliardo.
Con \(\mathbf{x} = (\mathbf{x}_a, \mathbf{x}_b)\) e \(\mathbf{s}, \mathbf{t}\) due reti qualsiasi che leggono \(\mathbf{x}_a\) (non serve che siano invertibili):
dove \(\odot\) è il prodotto elemento per elemento e \(\mathbf{J}\) la jacobiana, triangolare a blocchi. Il blocco in basso a sinistra, l’unico che contiene le derivate delle reti, non entra nel determinante, quindi \(\log\lvert\det\mathbf{J}\rvert = \sum_j s_j(\mathbf{x}_a)\); e l’inversa, \(\mathbf{x}_b = \big(\mathbf{z}_b - \mathbf{t}(\mathbf{z}_a)\big) \odot \exp\big(-\mathbf{s}(\mathbf{z}_a)\big)\), costa quanto l’andata. RealNVP [DSDB17] alterna partizioni a scacchiera e per canali, e a ogni scala fa uscire metà delle coordinate verso il latente (l’architettura multi-scala), così che gli strati più profondi lavorano su tensori più piccoli.
La scala \(\exp(\mathbf{s})\) è sempre positiva, quindi lo strato è sempre invertibile, ma non ha limiti: su dati veri una \(\mathbf{s}\) che cresce senza freno può destabilizzare l’addestramento, e le implementazioni la vincolano. Il codice sulle due lune la passa per una \(\tanh\), che tiene ogni scala fra \(e^{-1}\) ed \(e\); l’implementazione di Glow usa una sigmoide, che permette al volume soltanto di diminuire [NMT+19]. Né la forma affine è l’unica possibile: le spline razionali-quadratiche monotone [DBMP19] danno trasformazioni coordinata per coordinata più flessibili, invertibili in forma chiusa, con la stessa jacobiana triangolare.
Uno strato di accoppiamento è poi un caso particolare di una famiglia più larga, i flussi autoregressivi. Se ogni coordinata è scalata e traslata in funzione di tutte quelle che la precedono, \(z_i = x_i\,e^{s_i(\mathbf{x}_{<i})} + t_i(\mathbf{x}_{<i})\), la jacobiana è triangolare per intero e il determinante resta il prodotto delle scale; l’accoppiamento è il caso in cui le coordinate del secondo gruppo dipendono soltanto da quelle del primo, e fra loro no. È la fattorizzazione di un pixel alla volta riletta come flusso (il MAF di Papamakarios e colleghi [PPM17]): valutare costa un passaggio, generare ne costa \(D\), il numero di coordinate. L’IAF [KSJ+16] scambia i due costi, ma solo per i propri campioni: genera in un passaggio, valuta in un passaggio la densità dei punti che ha appena generato (di cui conosce già la \(\mathbf{z}\)), e su un dato qualsiasi ne spende \(D\). Per questo si usa come distribuzione approssimante nell’inferenza variazionale, dove servono proprio i propri campioni e le loro densità, più che come stimatore di densità.
Un flusso vero, sulle due lune#
Mettiamolo alla prova su due lune, il banco di prova della sezione sulle SVM a kernel: due archi intrecciati, una forma che nessuna retta separa e nessuna gaussiana descrive. Addestriamo un flusso a raddrizzarli, con una loss sola, la verosimiglianza. Poi facciamo le tre domande che contano: si inverte davvero? È davvero una densità? E sa distinguere le lune dal resto del piano?
import math

import torch
import torch.nn as nn
from sklearn.datasets import make_moons

torch.manual_seed(0)


class Accoppiamento(nn.Module):
    """Una coordinata passa intatta; l'altra viene scalata e traslata in
    funzione della prima.

    La jacobiana e' triangolare per costruzione, quindi il suo determinante e'
    il prodotto degli elementi sulla diagonale: qui una sola scala, che il
    passo restituisce insieme al risultato. La rete che decide scala e
    traslazione NON deve essere invertibile, e infatti non lo e'.
    """

    def __init__(self, scambia, nascosto=64):
        super().__init__()
        self.scambia = scambia
        self.rete = nn.Sequential(nn.Linear(1, nascosto), nn.Tanh(),
                                  nn.Linear(nascosto, nascosto), nn.Tanh(),
                                  nn.Linear(nascosto, 2))

    def _st(self, fissa):
        s, t = self.rete(fissa.unsqueeze(1)).chunk(2, dim=1)
        return torch.tanh(s).squeeze(1), t.squeeze(1)   # tanh: scale sane

    def _ricomponi(self, fissa, mobile):
        return (torch.stack([mobile, fissa], 1) if self.scambia
                else torch.stack([fissa, mobile], 1))

    def avanti(self, x):                      # dati -> latente
        fissa, mobile = (x[:, 1], x[:, 0]) if self.scambia else (x[:, 0], x[:, 1])
        s, t = self._st(fissa)
        return self._ricomponi(fissa, mobile * torch.exp(s) + t), s

    def indietro(self, z):                    # latente -> dati
        fissa, mobile = (z[:, 1], z[:, 0]) if self.scambia else (z[:, 0], z[:, 1])
        s, t = self._st(fissa)
        return self._ricomponi(fissa, (mobile - t) * torch.exp(-s))


class Flusso(nn.Module):
    """Sei accoppiamenti a turni alterni: cosi' ogni coordinata viene
    trasformata e ogni coordinata fa da guida."""

    def __init__(self, n=6):
        super().__init__()
        self.passi = nn.ModuleList(Accoppiamento(i % 2 == 1) for i in range(n))

    def avanti(self, x):
        logdet = torch.zeros(len(x))
        for p in self.passi:
            x, s = p.avanti(x)
            logdet = logdet + s
        return x, logdet

    def indietro(self, z):
        for p in reversed(self.passi):
            z = p.indietro(z)
        return z

    def log_densita(self, x):
        """Il cambio di variabile, scritto: log p(x) = log p(z) + log|det|."""
        z, logdet = self.avanti(x)
        log_gauss = -0.5 * (z ** 2).sum(1) - math.log(2 * math.pi)
        return log_gauss + logdet


X, _ = make_moons(2000, noise=0.06, random_state=0)
X = torch.tensor(X, dtype=torch.float32)
X = (X - X.mean(0)) / X.std(0)

flusso = Flusso()
opt = torch.optim.Adam(flusso.parameters(), lr=3e-3)
for passo in range(1500):
    perdita = -flusso.log_densita(X).mean()          # verosimiglianza, e basta
    opt.zero_grad(); perdita.backward(); opt.step()

# --- Prova 1: e' davvero invertibile? Andata e ritorno, e si controlla.
with torch.no_grad():
    z, _ = flusso.avanti(X)
    errore = (flusso.indietro(z) - X).abs().max().item()
print(f"errore massimo andata e ritorno: {errore:.2e}")

# --- Prova 2: e' davvero una densita'? Si integra su una griglia fitta.
# In due dimensioni la quadratura si puo' ancora fare, e la rifacciamo due
# volte sugli stessi pesi, con il fattore |det| e senza: e' il modo di vedere
# che non e' una rifinitura.
g = torch.linspace(-6, 6, 601)
gx, gy = torch.meshgrid(g, g, indexing="ij")
griglia = torch.stack([gx.reshape(-1), gy.reshape(-1)], 1)
area = (g[1] - g[0]) ** 2
with torch.no_grad():
    z_g, logdet_g = flusso.avanti(griglia)
    log_gauss_g = -0.5 * (z_g ** 2).sum(1) - math.log(2 * math.pi)
print(f"integrale della densita', col fattore:   "
      f"{((log_gauss_g + logdet_g).exp().sum() * area).item():.4f}")
print(f"integrale della densita', senza fattore: "
      f"{log_gauss_g.exp().sum().mul(area).item():.4f}")

# --- Prova 3: la densita' distingue le lune dal resto del piano?
fuori = torch.rand(2000, 2) * 8 - 4
with torch.no_grad():
    print(f"log-densita' media sulle lune:  {flusso.log_densita(X).mean():.2f}")
    print(f"log-densita' media a caso:      {flusso.log_densita(fuori).mean():.2f}")
errore massimo andata e ritorno: 1.40e-06
integrale della densita', col fattore:   1.0000
integrale della densita', senza fattore: 0.2394
log-densita' media sulle lune:  -1.31
log-densita' media a caso:      -169.04
Le cinque misure dicono cinque cose diverse.
La prima è la prova che la trasformazione si inverte davvero: andata e ritorno riportano al punto di partenza con un errore di poco più di un milionesimo, che è il rumore dei numeri a trentadue bit e non un’approssimazione del metodo. La seconda e la terza sono quelle che importano alla verosimiglianza esatta, e vanno lette insieme: la densità del modello, integrata numericamente su una griglia che la copre tutta, fa uno, e non perché qualcuno l’abbia normalizzata a mano. Fa uno perché il cambio di variabile lo garantisce, e la terza misura lo mostra togliendo il fattore dagli stessi identici pesi: senza, l’area scende a 0,24, e una curva la cui area non fa uno non è una densità di probabilità. Nel valore 0,24 non c’è niente da leggere, dipende dal flusso che è uscito da questo addestramento; l’unica cosa che conta è che non faccia uno. Fare uno è esattamente la differenza fra questa famiglia e quella del capitolo sui modelli a energia, dove quel conto non si può fare e tutto il capitolo gira attorno a come evitarlo. Le ultime due dicono che il modello ha imparato dove stanno i dati: sulle lune assegna una log-densità media di circa \(-1{,}3\), a punti presi a caso nel quadrato circa \(-169\). La differenza, quasi 168, è in nat, l’unità del logaritmo naturale: un nat è un fattore \(e \approx 2{,}7\), e 168 nat sono un fattore \(e^{168}\), che in base dieci ha più di settanta zeri. In scala normale, cioè, la densità tipica sulle lune sta più di settanta ordini di grandezza sopra quella di un punto preso a caso.
Quello che le cinque misure dicono con i numeri si può anche guardare. La Fig. 28.2 segue gli stessi punti mentre attraversano i sei accoppiamenti, e fa vedere la cosa che nessun numero stampato mostra. A ogni passo si muove una sola delle due coordinate, e l’altra resta esattamente dov’è, che è il vincolo da cui il determinante viene gratis. Nel mezzo la nuvola si allarga a più del doppio, e poi si richiude sulla gaussiana.
Quella gaussiana d’arrivo la figura la guarda dall’alto, e la disegna con i punti che ci finiscono dentro: è la macchia tonda attorno all’origine, fitta al centro e sempre più rada verso i bordi. La campana che ci si aspetterebbe sta nella dimensione che il disegno non ha, perché è l’altezza della densità sopra il piano: massima nell’origine, e i punti si affollano proprio dove è più alta.
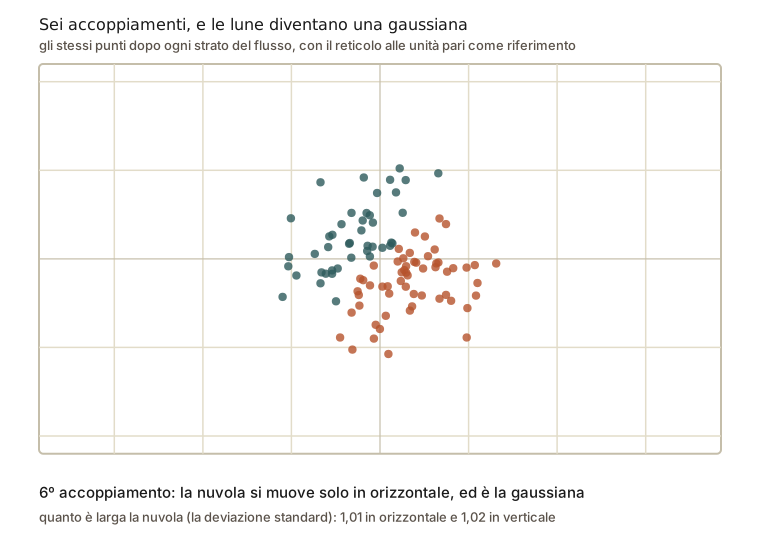
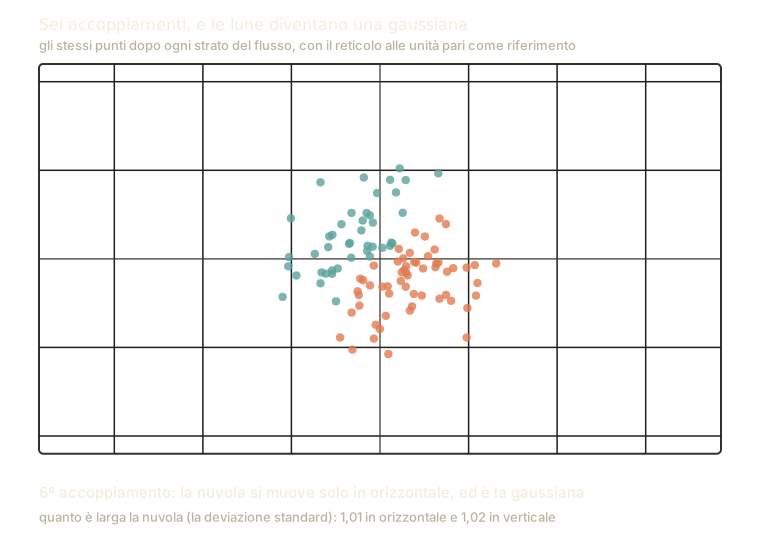
Fig. 28.2 Le due lune diventano in sei accoppiamenti una gaussiana, vista dall’alto come una macchia tonda di punti. A ogni passo si muove una sola coordinata, e la larghezza di quella ferma non cambia; l’altra intanto si allarga, si stringe, e alla fine torna a uno su tutti e due gli assi.#
Glow, e il prezzo dell’invertibilità#
Fra RealNVP e i flussi che hanno fatto notizia c’è un passo, e lo fa Glow [KD18]. Cambia il modo in cui le coordinate si rimescolano fra uno strato di accoppiamento e il successivo. In RealNVP la divisione in due gruppi è fissa (a scacchiera o per canali) e i gruppi si scambiano a turni alterni: una scelta decisa da chi progetta, uguale per tutti i dati, che ai dati non si adatta. Glow mette fra uno strato e l’altro una convoluzione invertibile \(1 \times 1\), cioè una matrice \(\mathbf{W}\) di \(c \times c\) pesi applicata ai \(c\) canali di ogni pixel, che generalizza la permutazione e si impara insieme al resto. Il guadagno lo misurano gli autori confrontando i due modelli interi: su CIFAR-10, una raccolta di piccole fotografie a colori, il costo passa dai \(3{,}49\) bit per dimensione di RealNVP (quanti bit servono in media per scrivere ciascun numero dell’immagine: meno è meglio) ai \(3{,}35\) di Glow, che però cambia anche la normalizzazione interna e divide le coordinate soltanto per canali. Il miglioramento fra i due modelli interi, quindi, non va attribuito alla sola convoluzione, il cui effetto gli autori misurano a parte, a parità del resto. Con la stessa ricetta escono i volti a \(256 \times 256\) del 2018, addestrati su immagini ridotte a 5 bit per canale, quelli che si trasformano l’uno nell’altro tirando una riga nello spazio latente.
Sulle immagini, però, i flussi sono rimasti per anni dietro la diffusione nella qualità dei campioni, e il vincolo di partenza lo spiega meno di quanto sembri. Una trasformazione invertibile conserva la dimensione, quindi un flusso sui pixel di una fotografia di \(512 \times 512\) a colori lavora su 786.432 numeri, senza poterne buttare via uno. La dimensione però la conserva anche la diffusione: il latente rumoroso ha la forma di quello pulito, e i 16.384 numeri della diffusione latente del capitolo precedente (quarantotto volte meno, lo stesso fattore che quel capitolo aveva già contato) li ottiene l’autoencoder, la rete che comprime e ricostruisce, messo davanti. Lo stesso autoencoder si può mettere davanti a un flusso, e la verosimiglianza vale allora per il latente e non più per l’immagine, come nel trasloco sui token di un pixel alla volta.
Il costo vero del vincolo è l’espressività di ogni strato: un accoppiamento, invertibile e con un determinante che si legge, deforma poco, e per piegare una gaussiana in una distribuzione di fotografie ne servono pile lunghe e costose. Il divario era quindi di architettura più che di famiglia, e lo mostrano due lavori del 2025 dello stesso gruppo. TarFlow [ZZN+25] sostituisce gli accoppiamenti con strati autoregressivi fatti di blocchi Transformer, lavora direttamente sui pixel e riporta \(2{,}99\) bit per dimensione su ImageNet a \(64 \times 64\), meno di tutti i modelli di diffusione e autoregressivi con cui si confronta; addestrato con rumore gaussiano sui pixel e ripulito alla fine, produce campioni che gli autori giudicano di qualità paragonabile a quella della diffusione. STARFlow [GCB+25] porta la stessa idea nel latente di un autoencoder. Il prezzo si sposta: uno strato autoregressivo si valuta in un passaggio ma si inverte una posizione alla volta, e la generazione torna sequenziale. È il prezzo dell’esattezza, e si paga in profondità o in tempo di generazione, più che in dimensione.
Da ricordare
Un flusso non prova a descrivere i dati: costruisce una macchina che li raddrizza, portandoli su una nuvola semplice di cui sappiamo tutto. Se la macchina si usa nei due sensi, generare è pescare un punto nella nuvola e farlo tornare indietro.
Chi deforma lo spazio deve pagare un fattore di correzione: la stessa acqua su un tavolo tre volte più largo sta tre volte più bassa, e un flusso, che fa la domanda al contrario, il fattore lo moltiplica. Senza quel fattore l’area sotto la curva non fa più uno, e una curva la cui area non fa uno non è una probabilità. Il conto su una campana stirata di tre volte lo mostra: con il fattore la curva calcolata coincide con quella misurata e la sua area fa 1, senza è tre volte troppo alta e l’area fa 3.
Il fattore, in molte dimensioni, costa già un miliardo di operazioni su una figurina. Il trucco è costruire la macchina in modo che sia già scritto: una parte delle coordinate passa intatta, l’altra viene scalata e traslata in base alla prima. E il pezzo che decide come, cioè la rete che impara, non ha nessun vincolo: l’invertibilità sta nel montaggio, non nel motore.
Il prezzo lo si paga in profondità. Una macchina che si usa nei due sensi non può buttare via niente, ma da solo questo non la condanna: anche la diffusione esce con tanti numeri quanti ne sono entrati, e a tutte e due si può mettere davanti un compressore. Quello che pesa è che ogni passo, per restare invertibile e con il fattore già scritto, deforma lo spazio di poco, e per arrivare da una nuvola a una fotografia ne servono pile lunghissime. Sulle fotografie questa famiglia è rimasta per anni dietro la diffusione, finché nel 2025 macchine con pezzi più potenti, che però generano una posizione alla volta, l’hanno quasi raggiunta. Il numero esatto che restituisce, intanto, è sempre servito, ed è la prossima sezione.
Da ricordare
Cambio di variabile: \(\log p_X(\mathbf{x}) = \log p_Z(f(\mathbf{x})) + \log\lvert\det \mathbf{J}_f(\mathbf{x})\rvert\), con \(f\) diffeomorfa e scritta nel verso che porta i dati al latente; scritta nel verso opposto lo stesso termine cambia segno. I logaritmi dei determinanti si sommano lungo la composizione, ciascuno valutato nel punto in cui il suo passo lavora. Si addestra per massima verosimiglianza, cioè minimizzando \(D_{\mathrm{KL}}(p_{\text{dati}}\,\|\,p_X)\).
Due vincoli: \(f\) conserva la dimensione, e \(\det \mathbf{J}\) costa \(\mathcal{O}(D^3)\) in generale.
Strato di accoppiamento: partizione (non necessariamente a metà) \(\mathbf{x} = (\mathbf{x}_a, \mathbf{x}_b)\), con \(\mathbf{z}_a = \mathbf{x}_a\) e \(\mathbf{z}_b = \mathbf{x}_b \odot \exp(\mathbf{s}(\mathbf{x}_a)) + \mathbf{t}(\mathbf{x}_a)\), con \(\exp\) elemento per elemento. La forma additiva (\(\mathbf{s} \equiv \mathbf{0}\)) è di NICE [DKB15] ed è a volume costante, \(\det \mathbf{J} = 1\); la scala è di RealNVP [DSDB17]. La jacobiana è triangolare a blocchi con identità in alto a sinistra, quindi \(\log\lvert\det\rvert = \sum_{i \in b} s_i(\mathbf{x}_a)\), perché \(\mathbf{s}\) è il logaritmo della scala: costo lineare. L’inversa è esplicita, e \(\mathbf{s}, \mathbf{t}\) possono essere reti arbitrarie e non invertibili.
Glow [KD18] sostituisce la permutazione fissa fra i due blocchi con una convoluzione \(1\times1\) invertibile di peso \(\mathbf{W}\) (\(c \times c\)): su un tensore \(h \times w \times c\) contribuisce \(h\,w\, \log\lvert\det\mathbf{W}\rvert\) al logaritmo del determinante, e \(\det\mathbf{W}\) costa \(\mathcal{O}(c^3)\) nei soli canali, \(\mathcal{O}(c)\) con la parametrizzazione LU.
\(f\) conserva la dimensione: su \(512\times512\times3\) sono \(786.432\) dimensioni anche in uscita. Non è questo a separare i flussi dalla diffusione, che la conserva anch’essa e lavora sulle \(16.384\) del latente di Stable Diffusion (il fattore 48 del capitolo precedente) grazie all’autoencoder messo davanti; lo stesso si fa con un flusso [GCB+25], e la verosimiglianza vale allora per il latente. Il limite strutturale è l’espressività di ciascuno strato invertibile con un determinante trattabile, che si paga in profondità: è la ragione per cui la famiglia è rimasta a lungo marginale nella generazione di immagini. I flussi autoregressivi a Transformer ne hanno chiuso buona parte del divario (TarFlow [ZZN+25], 2025: \(2{,}99\) bit per dimensione su ImageNet \(64 \times 64\)), pagando in campionamento sequenziale. La famiglia resta viva nella stima di densità, nell’inferenza variazionale e come base teorica dei metodi continui.
Il prezzo è alto, e pagarlo ha senso solo se il numero esatto serve a qualcosa. L’ultima sezione chiede a che cosa, e dove la verosimiglianza, usata come misura, non basta.